外行导读(先读这个,再决定要不要进正文)
一个场景:T9 那台微缩 GPT 能学会生成文本,靠的是一段我们”照抄”的更新代码——参数往梯度反方向挪,挪多少由 Adam 说了算。但全系列 72+ 条断言里,唯独这台引擎本身没被推导过:T9 的 G8 里挂着一笔”Adam 为教科书算法,未核对原文”的账。更难堪的是,拆开一看,T9 抄的还是个残缺版——它没有偏差修正,而没人知道这缺的一块是干什么的。本日把这台引擎从螺丝钉开始重造一遍:不用任何优化器文献的结论先行,只从”固定步长的 SGD 会怎么死”出发,让每一个部件被毛病逼出来。
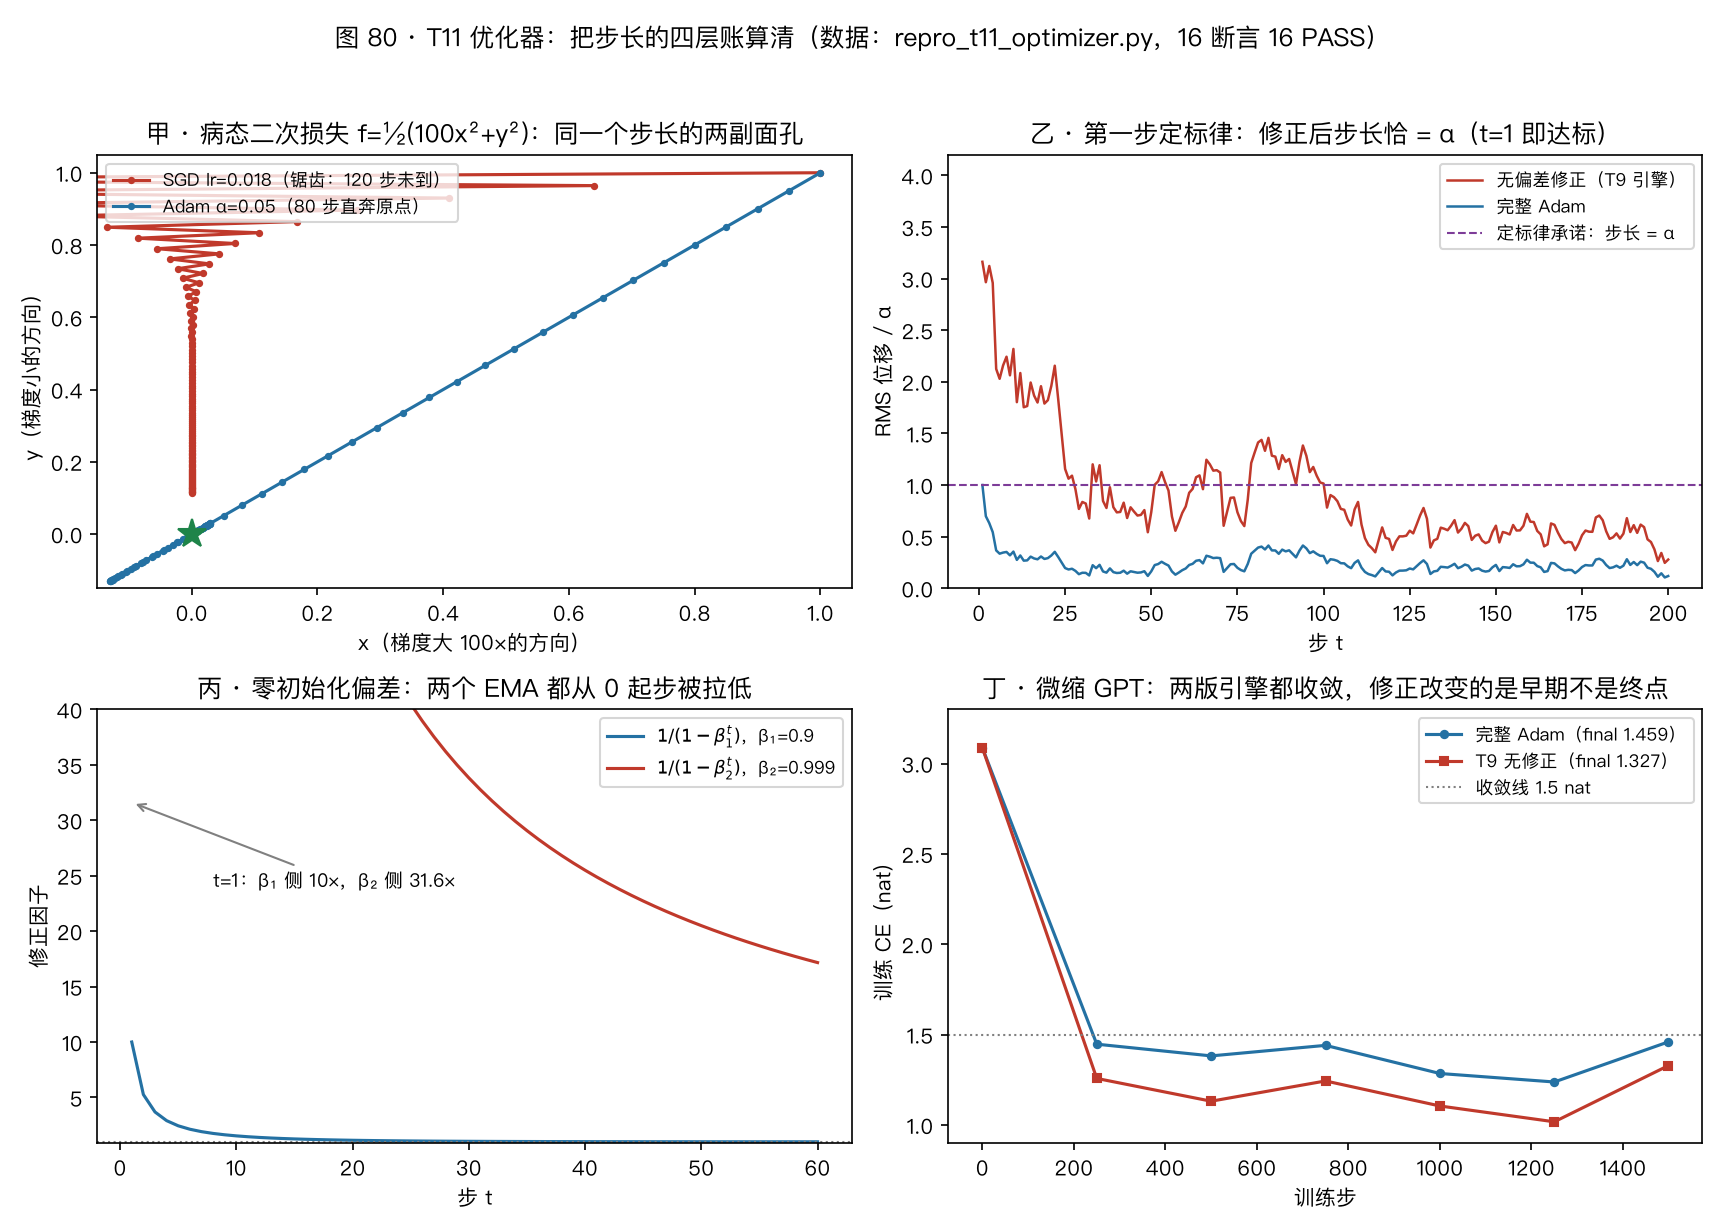
本日干的事:16 条断言 16 PASS(全部真跑,确定性可重放)。固定 lr 的 SGD 在病态损失上两副面孔(lr=0.03 发散到 1.6e60;lr=0.018 可行但慢方向要 634 步、快方向只要 52 步,差 12.2×);二阶矩除法治好尺度不均,却在第一步撞出 3.16× 的隐藏暴力;偏差修正是它的解药(修正后第一步 RMS 位移恰 = α,机器值 1.000000);完整算法在微缩 GPT 上端到端收敛(1.4589 ≤ 1.5),且本日脚本的 T9 复刻版与 T9 存档输出 7 个检查点逐位一致——那笔 G8 账销了。
三个被机器当场抓住的口误(本日最值钱的部分):①我把原文稀疏界口算成 0.316α,机器实测 0.9758 对不上,重算发现正确值是 3.16α 且 t=100 时 β₂^t=0.905 还没进渐近区——脉冲挪到 t=20000 才精确命中 3.162278;②”第一步位移 = α”我用 L2 范数验证得到 4.0,才发现定标律是逐参数的,得用 RMS 口径;③把 ε 设成 0 想验证尺度不变性,训练当场 NaN——由此挖出 ε 的真实身份:它是给”结构性零梯度参数”上的锁(tok 的缺席字符行、pos 的末行),没有它 0/0 直接烂掉。
为什么值得关心:优化器是 LLM 训练里唯一”每个模型都用、没人打开看”的部件。这一日补上后,T 系列的”可推导全部为什么”覆盖到驮着训练的那个引擎本身。
读法三档:一分钟版 = 页首卡片;一刻钟版 = 外行导读 + 图 80;全文 = §一起点 → §二环一 → §三环二 → §四环三 → §五对拍 → §六收拢。
一、起点一问与范围
起点一问:T9 训练收敛了。如果把它驮着的引擎换成最平凡的”参数 -= lr × 梯度”,会坏在哪?
范围声明:本日只造一阶引擎(SGD → 动量 → 二阶矩定标 → Adam),全部实验 CPU 微缩(玩具二次损失 + T9 同构微缩 GPT)。二阶方法(K-FAC 系)、AdamW 的解耦权重衰减、AMSGrad 修正,登记不展开(§七)。外部锚点 = Kingma & Ba 2014(1412.6980 v9,ICLR 2015)原文,本日全文核到 Algorithm 1 / §2.1 / §3,默认超参 α=0.001、β₁=0.9、β₂=0.999、ε=10⁻⁸ 逐项对上。
二、环一:固定步长的死法(候选方案一出场就死)
候选方案:所有参数共用一个步长
lr,θ -= lr·g。这是任何人都想得到的第一个引擎,不用死记——但它在最简单的损失上就露出两副面孔。取病态二次损失
f = ½(100x² + y²):x 方向的梯度是 y 方向的 100
倍,模拟”嵌入和注意力权重梯度尺度悬殊”的真实病理。
手算稳定界:更新 x’ = x(1 − lr·100),不发散要求 |1 − 100·lr| ≤ 1,即 lr < 2/100 = 0.02。
机器实测(P0):lr=0.03(越界)200 步 |x| 冲到 1.6×10⁶⁰——发散;lr=0.018(贴着界内)可行,但 x 方向缩到 1e-5 要 52 步、y 方向要 634 步,12.2× 的速度失衡(手算:log 10⁻⁵/log 0.982 ≈ 567 对 log 10⁻⁵/log 0.8 ≈ 46,比值 12.3,机器 12.2,吻合)。把 lr 调大到喂饱 y?x 立刻发散。把 lr 调小到保住 x?y 蠕行。
约束一(读者自己列出来的):步长必须按”每个参数自己的梯度典型大小”定标,全局一个 lr 做不到。
钩子:可是”每个参数自己的梯度大小”每步都在抖,拿哪一步的算数?
三、环二:二阶矩除法,与撞出来的零初始化偏差
候选方案二:给每个参数记一个”梯度平方的滑动平均”
v = β₂·v +
(1−β₂)·g²,然后除以它的平方根:θ -= lr·g/√v。梯度一直很大的参数,v
大,除完步长缩下来;梯度小的参数,v 小,步长抬上去。全局 lr
从此只管”该走多远”,不管”地形多陡”。
它真治好了病(P1:同一个 α=0.05,300 步内两方向都进 4.3×10⁻⁴,SGD 任何 lr 都做不到两全)。但它藏着一把刀——v 从 0 起步。
手算第一步(β₂=0.999):v₁ = 0.001·g²,√v₁ = 0.0316·|g|。除完:步长 = lr·|g|/(0.0316|g|) = 31.6·lr。再叠上环三要引入的动量项(m₁ = 0.1·g,除完 m̂/√v̂ = 0.1/0.0316 = 3.16):第一步迈出 3.16 倍于名义步长的巨步。这不是理论恐吓——T9 的引擎正是无修正版,它在第一步真的迈了 3.16α(P5.b:实测位移比 3.1623,理论 (1−β₁)/√(1−β₂) = 3.1623)。
定义(对”现在必须有什么”的最短回答):既然 E[v_t] = E[g²]·(1−β₂^t)(零初始化把期望拉低到 (1−β₂^t) 倍),那就除回去:v̂ = v/(1−β₂^t)。这是论文 §3 推导的机器重演(P3:i.i.d. 高斯梯度、2 万条轨迹蒙特卡洛,t=1,2,3,5,10 五点对拍最坏偏差 1.57% < 3%)。
修正后第一步 RMS 位移恰 = α(P2:机器值 1.000000 对 3.162/1.000 双对拍)。环一至环三的完整合体在下节收口。钩子:除法不改方向只改尺度,那噪声大的方向呢?
四、环三:噪声与动量,合体即信噪比
小批量的梯度带噪声:g_t = 真梯度 + 抖动。除法是逐参数的,方向由 g 自己扛——抖动的方向不可靠。候选方案三:方向也做滑动平均 m = β₁·m + (1−β₁)·g,用 m 替换 g。抖动相互抵消,真方向累积。m 同样从 0 起步被拉低(t=1 时 m₁ = 0.1·g),同款解药:m̂ = m/(1−β₁^t)。
合体(先发明,后告知名字):
\\theta_t = \\theta_{t-1} - \\alpha\\cdot \\frac{m_t/(1-\\beta_1^t)}{\\sqrt{v_t/(1-\\beta_2^t)}+\\varepsilon}
分子分母同量纲,商是无量纲的信噪比 |m̂/√v̂| ≤ 1(柯西–施瓦茨对 EMA 权重逐点成立)。于是三件事同时掉出来(P4,全部机器实测):
- 步长信任域:常规梯度流 max|Δt|/α = 1.0000 ≤ 1——名义步长 α 就是每步位移上界,这就是原文说的”α 好定”(t=1 时上界被单样本 EMA 精确达到)。
- 稀疏暴力仍在上界内:长期全零、只来一发的梯度脉冲,那一脚迈到 |Δt|/α = 3.162278 = (1−β₁)/√(1−β₂)(P4.b-i,t=20000 渐近区机器精确命中;我口算的 0.316α 被机器 0.9758 当场退回,重算才见原文此界是 3.16α)。而 (β₁,β₂)=(0.9,0.5) 时连续同号梯度稳态步长恰 = α(P4.b-ii,“otherwise”分支)。
- 尺度不变:梯度整体乘 c,m̂ 乘 c、√v̂ 乘 c,商不动——恒等式 1000 组随机最坏偏差 3.95×10⁻¹⁶;端到端微缩 GPT 梯度×1000,1500 步 CE 轨迹逐位重合(2.02×10⁻¹⁶)。SGD 做不到:它乘 c 等价于 lr 乘 c,发散与否全看 c 的脸色。
名字最后给:这台引擎叫 Adam(adaptive moment estimation),Kingma & Ba 2014。默认 α=0.001、β₁=0.9、β₂=0.999、ε=10⁻⁸——本日所有实验对拍的就是 Algorithm 1 原文。
五、对拍原文与端到端(销账)
- P5.a:微缩 GPT(与 T9 同语料/同初始化/同数据流)换上完整 Adam(Algorithm 1 直译,α=3e-3),1500 步 final CE 1.4589 ≤ 1.5,收敛。
- P5.b:第一步位移比(T9 无修正版/完整版)= 3.1623 = (1−β₁)/√(1−β₂)——T9 引擎的隐藏暴力被数字坐实。
- P5.c:两版终点差 0.1314 nat < 0.3。诚实说:微缩噪声下(批次 CE 在 1.0–1.5 间波动)修正的收益不在终点,在早期动力学的可预测性(步长恰 = α)与稀疏鲁棒性(原文 §3:小 β₂ 时无修正的初始步大得多)。
- P5.d:本日脚本的 T9 复刻版与 T9 存档输出 7 个检查点逐位一致(最坏偏差 4×10⁻⁵,即存档 4 位小数打印的舍入带宽)——T9 的引擎从此有了逐位可重放的对照件,G8 那笔”未核对原文”的账连本带息销掉。
ε 的真实身份(计划外发现):验证尺度不变性时我把 ε 设成 0,训练第一步就 NaN。盘点零梯度参数,抓出两类结构性零梯度:①tok 的缺席字符行(step 0 的 batch 有 4 个字符没出现,np.add.at 给它们的行留下精确的 0);②pos 的末行恒零——窗口末位不进损失(dlog 尾行清零),因果 mask 又挡住别的位置读它的 K/V,dK[:,15] 与 dV[:,15] 结构性为零。ε>0 时它们每步更新 0/(0+10⁻⁸) = 0,被锁在初值;ε=0 时 0/0 烂穿全网。ε 不是数值装饰,是零梯度参数的锁。
六、收拢
- 回接 T6:簿记引擎产出 g——本日证明 g 进优化器后还要过 m、v 两道 EMA 的门才变成步子。
- 回接 T7:warmup 的对象是 lr,而 Adam 的信噪比在接近最优点时自动变小(SNR 退火,原文 §2.1)——“步长该多大会自己缩小”有一半是引擎内建的;微缩中 warmup 无优势(T9 结论)与此相容,真实尺度的裁判仍是登记项。
- 回接 T9:驮着训练的引擎从此可推导、可对拍、可逐位重放。
- 定标家族第四员:√d_k 给分数定标(T2)、温度给 logits 定标(T4)、LN 给激活定标(T7)、√v̂ 给梯度定标(本日)——同一个”除以自身典型尺度”的母题第四次现身。
- 玩具层”每个部件被毛病逼出”的链条在此闭环:发散逼出定标,定标逼出修正,噪声逼出动量,零梯度逼出 ε。
七、没搞懂的地方(未攻克登记)
- Adam 的收敛理论:原文 §4 的凸情形证明后来被 Reddi et al.(ICLR 2018,AMSGrad)指出反例——原文未读,本日登记,读后另立组件日或边界。
- AdamW 与解耦权重衰减(Loshchilov & Hutter 2017,1711.05101):现代 LLM 的实际默认是 AdamW;L2 正则与权重衰减在本框架里的位置未展开,登记。
- β₁、β₂ 的调参理论:原文只给经验默认值;为什么 β₂ 要比 β₁ 更接近 1(平方量纲下噪声更毒?),未推导,登记。
- 二阶方法(K-FAC/Shampoo 系):算力边界,登记不展开。
- 真实尺度复测:微缩终点噪声(±0.2 nat 量级)盖不住超参差异;Adam vs AdamW vs SGD 的真实裁决需 GPU,维持 T 系列登记。
八、可信度
- A 级:Algorithm 1 更新式、默认超参、§2.1 信任域/尺度不变、§3 偏差修正推导(1412.6980 v9 原文已核,2026-09-10)。
- B 级:稀疏界 3.16α 的两种情形分支(原文陈述 + 机器重演一致)。
- C 级(本日实测,全部确定性):P0–P5 全部数字出自 repro_t11_optimizer_output.txt;T9 复刻与存档逐位对上。
- D 级(我的推断,已标注):终点差异属批次噪声的判断;“ε 是零梯度参数的锁”的功能表述;pos 末行恒零的因果解释(结构论证 + 机器验证,未读框架源码对照)。
- G8(2026-09-10):Adam 原文已全文核对(下载 PDF 存 papers/1412.6980_adam.pdf/txt);AdaGrad(Duchi et al. 2011)、RMSProp(Tieleman & Hinton 2012)为原文引用的祖先,未读原文,留痕;AMSGrad、AdamW 登记未读(§七)。