外行导读(先读这个,再决定要不要进正文)
一个场景:2017 年的机器翻译模型是一条传送带。源语言的词一个接一个从带上过,模型每读一个词,就更新一次自己脑子里的”目前理解”(一个向量)。读完原文,再一个词一个词地吐出译文。传送带的死穴:第 100 个词的理解必须等第 99 个词处理完——样本内部没法并行。想用几百个处理器同时算?它们只能排队。序列越长,显存越吃紧,批量还得往下压。效率补丁(分解技巧、条件计算)都绕不开这条根本约束(§1,p.1)。
这篇论文干的事:拆掉传送带,改成会议室。所有词同时到场,每个词直接问所有词一个问题,按匹配度加权听取回答——这就是注意力(attention)。九年后所有大语言模型的骨架就是这么个会议室。数字上:WMT14 英德翻译 28.4 BLEU,超过此前一切模型(含集成系统)2 个 BLEU 以上;训练只花 8 张 P100 十二小时(base)/3.5 天(big),是当时竞争模型训练成本的几分之一(摘要、Table 2)。会议室的代价藏在账单里:n 个词两两互问,计算量按 n^2 涨——这笔”平方税”是此后十年长上下文研究全部故事的起点。
为什么值得关心:这篇论文的意图和它的历史作用是错位的。它想造的是更好的翻译器(要杀的对象是 RNN 翻译和卷积翻译),历史给它的角色是预训练时代的地基——2018 年 GPT 和 BERT 借走它的会议室、扔掉它的翻译任务,才有今天的大语言模型。读懂它,后面的一切(GPT 的下一词预测、RLHF 的 KL 缰绳、评测里的 temperature 采样)才有着力点。这是 T 序列(地基轨)的第一颗:此前十二篇精读反复使用 softmax、KL、log-prob 这些词,全都长在这篇的骨架上。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| encoder / decoder | 读入原文的一摞层 / 产出译文的一摞层;本文各 6 层 |
| self-attention(自注意力) | 序列自己问自己:每个词在全场(含自己)里找相关信息 |
| Q / K / V(查询/键/值) | 问题向量 / 被查者的标签向量 / 被查者提供的内容向量 |
| 缩放点积注意力 | 打分方式:Q 与 K 做内积再除 \sqrt{d_k},softmax 后加权取 V |
| 多头注意力(multi-head) | 并排 h = 8 个小注意力,各自在不同的子空间里问不同的问题 |
| 位置编码(PE) | 给每个词盖的”座位号”章——会议室本身不分先后,座位号补回词序 |
| 残差连接(residual) | 每层的输出加回输入再往下传:x + Sublayer(x) |
| LayerNorm | 每个位置自己的向量做”减均值除标准差”,压住数值规模 |
| 自回归(autoregressive) | 生成第 i 个词只能用第 i 个词之前的信息(因果 mask 保证) |
| BLEU | 机器翻译的自动评分(0-100,越高越好) |
| BPE / wordpiece | 把词拆成子词单元的词表方案(37000/32000 子词) |
| 困惑度 PPL | 模型对下一个词的平均不确定度,越低越好 |
§0 承接栏
这颗种子接的是此前十二篇精读的地基欠账:那些篇目(评测三篇、RL 训练四篇、奖励设计若干)每篇都在用 softmax 分布、KL 散度、log-prob、temperature 这些词——它们全部长在 Transformer 的 decoder 输出层和注意力机制上。T 序列立项(2026-09-09)就是为了把”默认已懂”变成”可推导、可复现”。母种子的特殊地位:它是 T2(缩放点积)、T3(位置编码)、T4(温度与采样)、T5(交叉熵与压缩)、T7(LayerNorm 与 warmup)、T8(多头与残差流)、T9(从 Transformer 到 GPT)、T11(优化器,2026-09-10 增补)八颗组件日共同的引子,本篇只把每个部件的”为什么”讲到能定位的程度,定量验证留给各自的组件日。
一、论文在解决什么问题
1.1 一个具体场景
2017 年最强的翻译系统(GNMT 一系)是 LSTM 编码器-解码器加注意力。LSTM 的计算沿符号位置分解:位置 t 的隐状态 h_t 是 h_{t-1} 与当前输入的函数(§1)。这条递归链带来两个后果。其一,训练一个样本必须按时间顺序串行——论文的原话是”inherently sequential nature precludes parallelization within training examples”(p.1);GPU 的几千个核心大部分时间在等第 t 步算完。其二,长序列上,中间状态必须全程驻留显存,批量被迫缩小,进一步浪费并行度。两个后果同一个根:计算结构被时间绑架。
注意力机制当时已经是标配(Bahdanau 2014 起),但都作为 RNN 的配件存在——论文原话“in all but a few cases, such attention mechanisms are used in conjunction with a recurrent network”(§1)。
1.2 与本站其他篇目的入口差
已有篇目从”模型训好之后怎么对齐、怎么评测”进,这颗回到”模型本身是什么”。与 ai_series E7(观众问”翻译时该看哪个词”)的关系:视频轨讲到 Bahdanau 的注意力为止,本篇是那集的幕后底座——“既然该看哪个词是核心问题,为什么还要那条传送带?”
二、核心想法
一句话:把序列变换的全部计算换成注意力——每个位置与所有位置直连,用 O(n^2) 的计算量换 O(1) 的串行深度;递归没了,模型对词序天然失明,由外置的位置编码把顺序补回数据里。
直觉三步走。
直觉:传送带 vs 会议室。传送带上每个工人(时间步)只跟上一个工人交接;会议室里每个人同时发言、同时提问,任何人想引用任何人都是一句话的事。代价:人数翻倍,两两对话数翻四倍。
转译:注意力就是加权检索。每个位置把自己的需求写成 query(Q),每个位置挂出自己的标签 key(K)和内容 value(V);检索 = query 与每个 key 打分,分数经 softmax 变成一组和为 1 的权重,按权重把 value 混合取回。
形式化:\mathrm{Attention}(Q,K,V)=\mathrm{softmax}(QK^\top/\sqrt{d_k})V(式 1)。这一行就是整篇论文——其余全是工程(怎么投影出 Q/K/V、怎么多头、怎么补位置、怎么稳住训练)。
它把问题重新形式化成了什么:把”序列建模”从沿时间的状态递归(h_t = f(h_{t-1}, x_t))重构为集合内的检索与聚合(每个位置对全体位置的一次加权查询)。收益是结构自由(无串行依赖,可并行);代价是结构失忆(集合没有顺序);补救是数据补偿(位置编码加进输入)。这组”结构换并行、数据补顺序”的三段式是理解全部后续变体(learned PE、RoPE、ALiBi)的钥匙——它们全在第三个环节上做文章,没人动前两个。
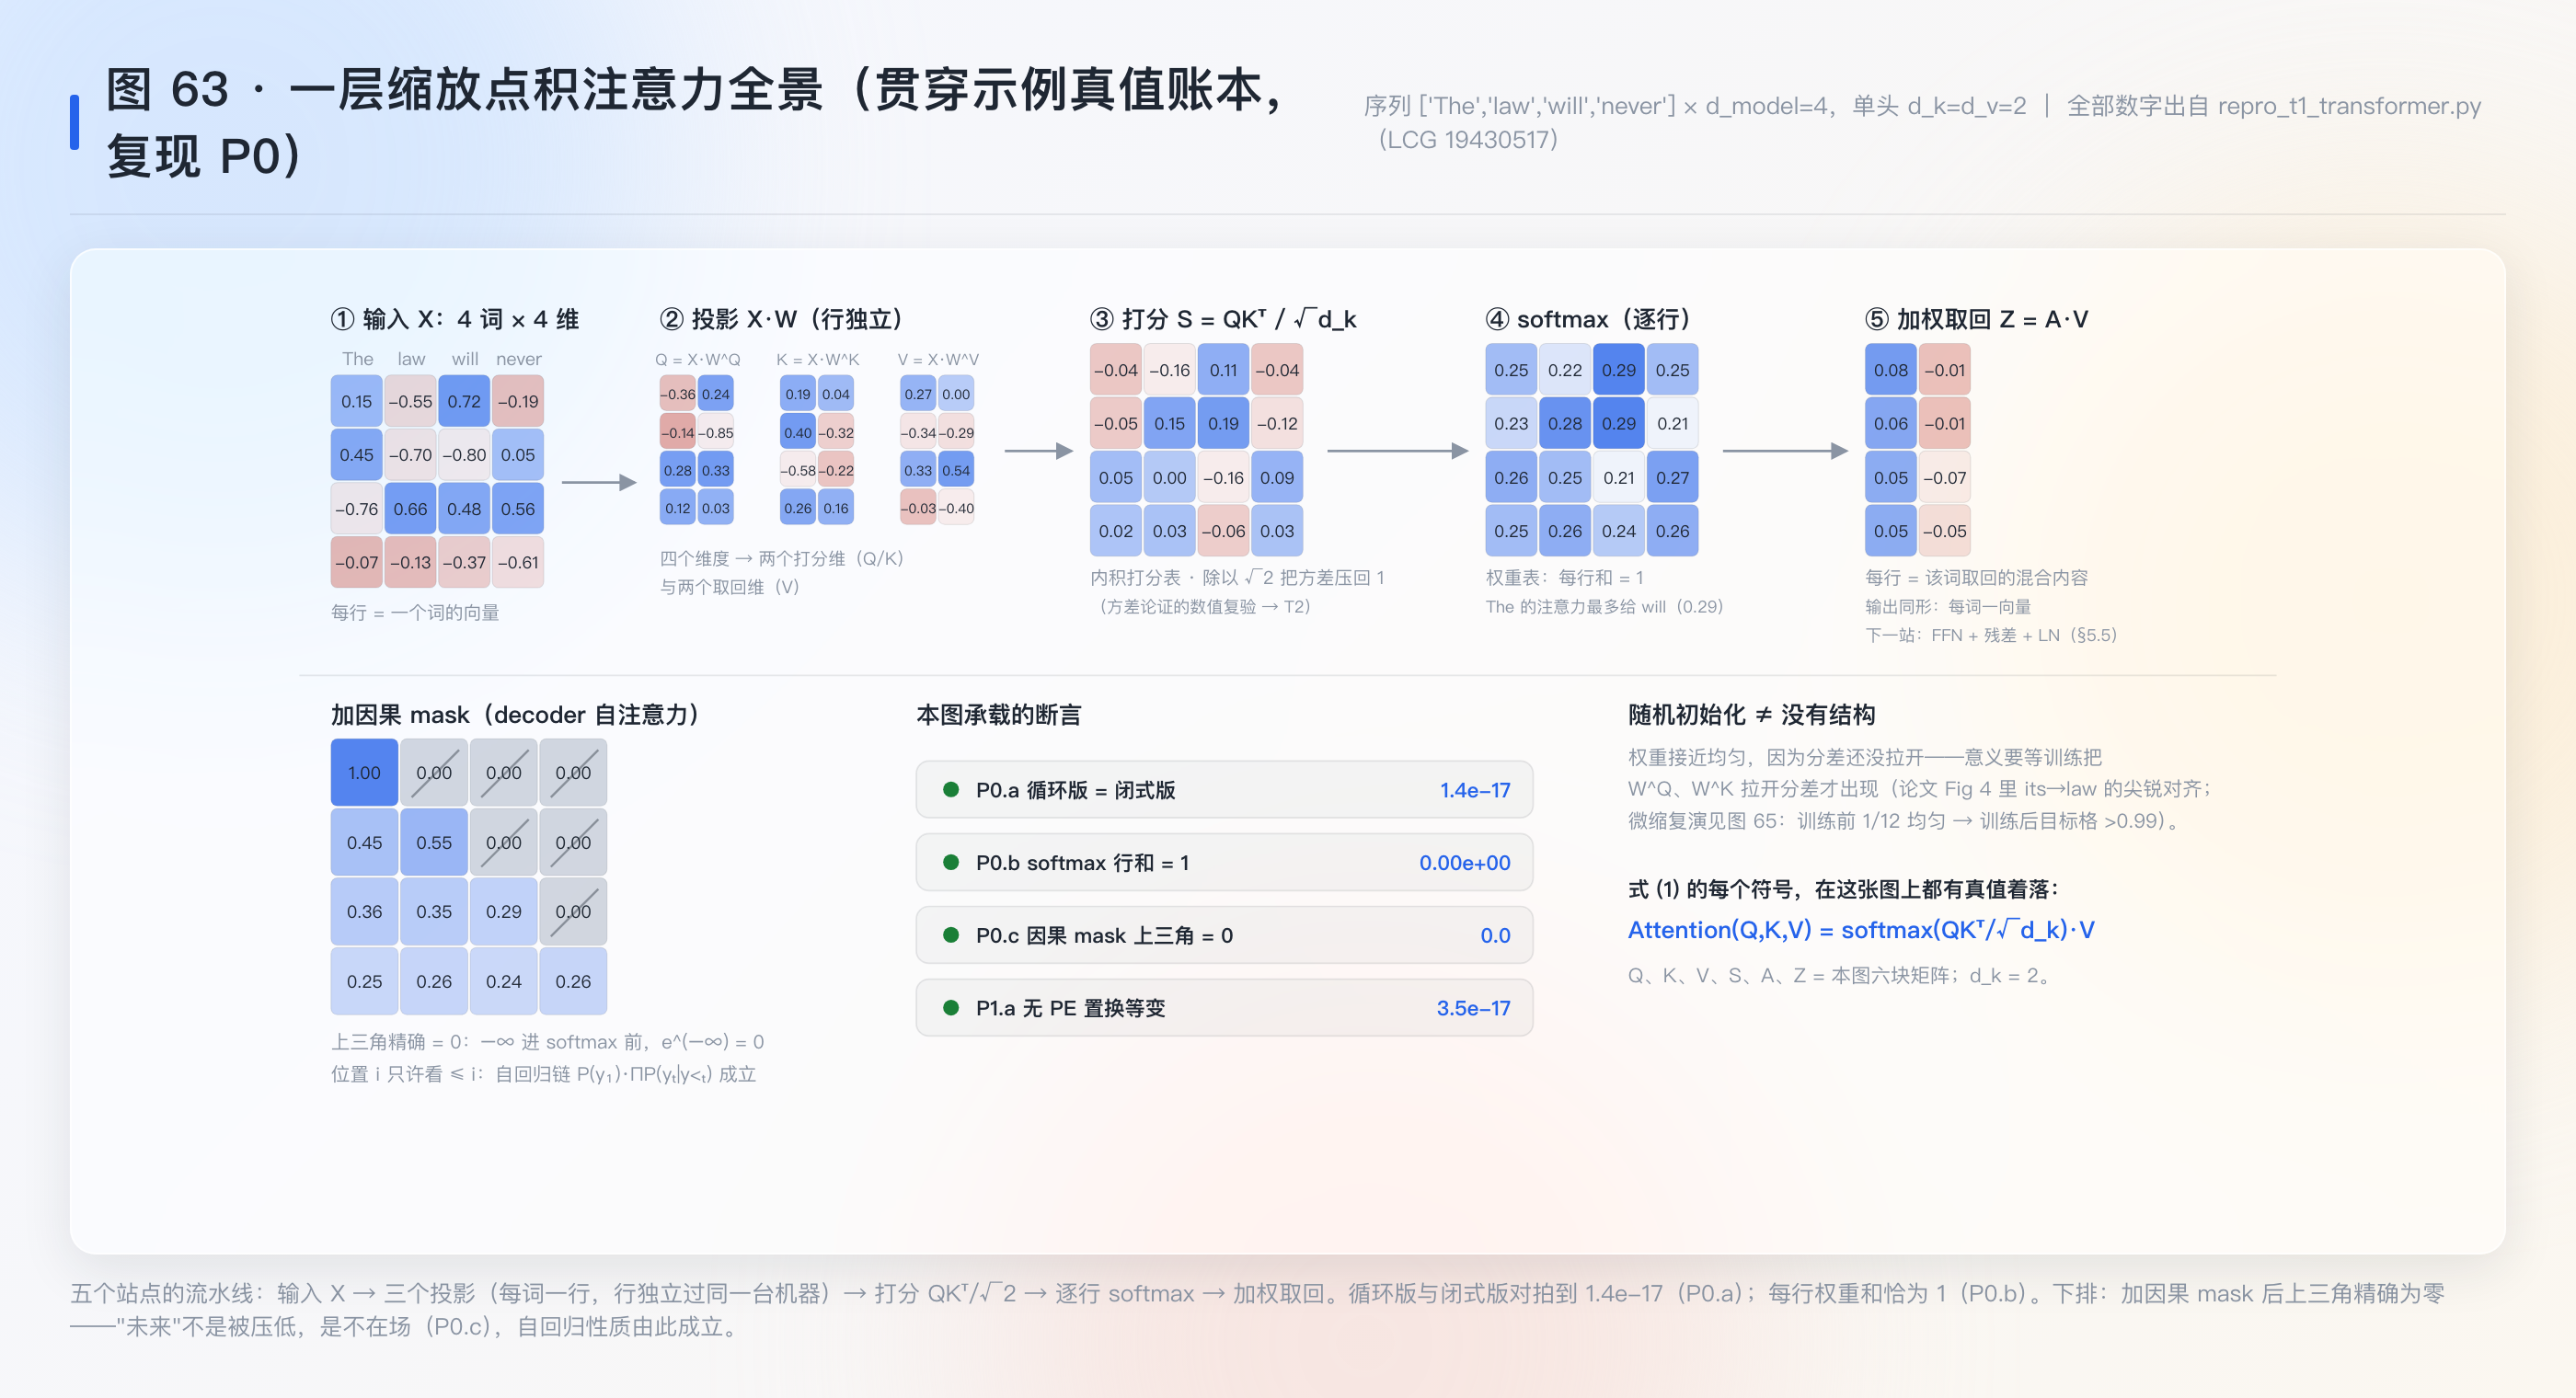
全篇就看这张:图 63(§5.1)——贯穿示例世界的一层全景:四个词的向量如何投影成 Q/K/V、如何打分归一、如何加权取回,每个中间量都是真值(复现账本)。看懂这张图,式 (1) 的每个符号就都有了着落。
三、数学基础(零起点:四件工具,逐一被问题逼出来)
动公式之前,先把自己放回设计者的位置。手里只有词向量——每个词一个箭头,意思近的词方向近——和一个功能性需求,用 “the bank was steep” 演示:bank 是河岸不是银行,靠的是 steep。让机器干同样的事:bank 这个词要吸收句子里其他词的信息来更新自己。吸收多少,怎么算?
本篇的数学只有四件,全部是被这个问题(和它后续暴露的毛病)逼出来的:先解决”两个词怎么算合拍”(3.1,距离死掉,内积是三条约束唯一逼出来的),再解决”合拍分怎么变成吸收配比”(3.2,两个修法死掉,指数是约束唯一逼出来的),再解决”全部配对怎么一次算完”(3.3,矩阵乘法的第二种读法)——三步落地,式 (1) 组装完毕。第四件(3.4,置换等变)是装完之后被实验撞出来的副作用:这台机器看不见顺序。每节都从上一节的成品或死掉的方案出发;读完本节,式 (1) 的每个零件你都亲手发明过一次。
3.1 内积:距离为什么当不了打分器
候选一:距离 |q-k|——“bank 离 steep 近 = 合拍”。死于两点:距离永远非负,“不合拍”和”反着拍”分不清;且它只管离多远、不管哪个方向,而词义合拍恰恰是方向性的事(意思近的词方向近,这是本节唯一的前置)。
候选二的起点是一个方向直觉:bank 的箭头在 steep 方向上的投影越长,吸收越多。但直觉不等于答案——把它变成唯一解,靠三条约束的演绎。
约束一(分量可加):每对分量贡献一份合拍,总分为各对之和——词向量加入新维度(新语义特征)时旧打分不被扰动,新贡献直接累加。能手里有的最一般形状是”每对分量一个系数”:
s(q,k)=\sum_{ij} M_{ij}\, q_i k_j \qquad (d=2 \text{ 时即 } M_{11}q_1k_1+M_{12}q_1k_2+M_{21}q_2k_1+M_{22}q_2k_2)
四个自由参数。约束二(对称):合拍是相互的,f(a,b)=f(b,a) → M_{12}=M_{21},砍掉近半。约束三(旋转无特权):把全部词向量做同一个旋转——同样的意思、换一套坐标——打分规则不该变:原始词表里没有任何方向天生更重要。数值例(d=2):M=\begin{bmatrix}2&1\\1&3\end{bmatrix},q=(1,0) 时 s=2;同一语义旋转 45° 后 q'=(0.707,\ 0.707),s'=3.5\neq 2——一般对称阵违约。
停下来猜一下。三条约束到齐,幸存的打分器还能长什么样?最狠的一条是旋转无特权——它要求分数在一切旋转下不变。你手里有什么量天生不怕旋转?想好了再看。
逐个排查,幸存的只剩一个家族 M=cI:旋转下 |q| 不变,s=c\,|q|^2 对一切旋转同值。三条约束合起来:
s(q,k)=c\,(q\cdot k)
内积不是候选里挑出来的,是唯一没被约束杀死的。 常数 c 去哪了?softmax 只看分差(下一节推导),尺度被 W^Q 直接吸收。更深的回响(补充):学习 W^Q, W^K 恰恰是有针对性地放弃约束三——起点是朴素内积(无特权方向),训练把打分矩阵从 cI 拉成 W^{Q\top}W^{K},即学出”哪些旋转后的子空间值得合拍”;多头 = 一次学几个子空间(T8 的钩子在此埋下)。
【类比】两个箭头夹角的余弦:同向满分,垂直零分,反向负分。内积把”方向合不合”压成一个数。
定义:q\cdot k=\sum_{i=1}^{d} q_i k_i。几何含义:q 在 k 方向上的投影长度乘 |k|——投影越长,越合拍。数值例(贯穿示例,d_k = 2):q_0=(-0.364,\ 0.238),k_1=(0.404,\ -0.319),内积 =(-0.364)(0.404)+(0.238)(-0.319)=-0.147-0.076=-0.223——The 的查询与 law 的键不合拍(负分)。全部 16 对内积就是打分表 QK^\top(账本见 §5.1)。
为什么注意力用内积当相似度:一次矩阵乘算完全部两两打分(n\times n 对并行出结果),而加性注意力(用一个小前馈网络打分)理论复杂度同级但实践慢——论文的理由就这一句:”can be implemented using highly optimized matrix multiplication code”(§3.2.1)。
至此打分器有了,但它的输出还不能用:分数可正可负、总和任意——是”评分”不是”份额”。份额要求非负、总和为一。把评分变成份额,是下一节的全部工作。
3.2 softmax:为什么必须是指数
接 3.1:bank 对全句每个词都有了合拍分。但”合拍分”还不是”吸收配比”——配比必须非负、总和为一。直觉修法一:除以总和。死于分数可负(总和为负时配比爆炸)。修法二:取绝对值再归一。死于抹平方向(“反着拍”和”合拍”被强行同权,刚发明的负分语义全失)。两个修法死了,约束自己浮出水面:①非负;②总和为一;③保序(分高的吸收多);④可控(分差小就近乎均摊,分差大就近乎独占——学会之后要能尖锐)。
但这四条还钉不死公式——满足它们的函数成千上万。第五条才是钉子:⑤分差充分性——分数的绝对水平无意义(bias 项、常数偏移皆任意),只有分差携带信息:全体分数 +100,吸收配比必须一分不变。手验:分数 (3.2,\ 0.1,\ -2.5,\ 0.4) 归一得 (0.90,\ 0.04,\ 0.003,\ 0.055);整体加 100 后每对键的比值只依赖差,纹丝不动,配比一分不变。再补它的搭档 ⑥配比独立:两键之间的吸收比只由这两键的分数决定,第三个键无权插手(比较两份稿子,不需要知道场上还有谁)。
停下来猜一下。全部约束到齐,最要紧的是⑤⑥合起来的那句话:两键之间的配比,只由分差决定。什么样的函数,吃进一个分差,吐出一个倍数?往常见的形状上想——线性?多项式?猜好了再看方程怎么说。
现在演绎。⑥把配比写成双变量函数:p_i/p_j = r(s_i, s_j);⑤说它只能依赖分差:r(s_i,s_j)=r(s_i-s_j)。先差 x 再差 y,与直接差 x+y,是同一个比值——
r(x+y) = r(x)\, r(y)
(分差可加 → 配比可乘。)这个方程的连续解只有一个家族:r(x)=e^{cx}——白话:任何别的形状都会让概率在无限小分差下乱跳,“越走越乘”天然就是指数。于是每个权重必然长成 e^{c s_j} 的形状(恒正,约束①自动满足),归一(约束②)后:
\mathrm{softmax}(s)_j = \frac{e^{c\,s_j}}{\sum_k e^{c\,s_k}}, \qquad c>0
指数不是偏好,是约束⑤⑥的唯一解。 保序(③)由 c>0 保证,可控(④)由 c 的大小调节——c 大尖锐、c 小平,正是下面最小变体第三式的 c=1/T:温度的伏笔在此埋下(T4)。取 c=1,就是论文写的形状。翻回原文对一对(§3.2.1):论文把 softmax 当现成工具直接用了——你刚走完的这条”为什么必须是指数”的路,原文里没有(补充:这条演绎是我的补写,思想源自选择公理的标准做法,未核对单一出处)。也就是说,论文用了你的答案,但没告诉你为什么必须是它——这一层,你比原文多走了一步。
【类比】给考场里的每个答题者按分数配掌声:分数差被指数放大(高一分,掌声多 e 倍),再把总掌声归一成 100%。
定义(对一行分数 s_1,\dots,s_n):
\mathrm{softmax}(s)_j=\frac{e^{s_j}}{\sum_{k=1}^{n} e^{s_k}}
读法:输出是和为 1 的正权重分布。指数的作用是放大差距——分数 2 比 0 高 2,权重比是 e^2:1\approx 7.4:1。最小变体对比组(新算符的最小对照组):
\arg\max_j s_j \qquad \mathrm{softmax}(s)_j \qquad \mathrm{softmax}(s/T)_j
第一个是硬选择(只听一个人,不可导);第二个是软选择(温度 T = 1,可导);第三个带温度 T——T 越小越接近硬选择,T 越大越接近均匀。注意力用的是第二个;大模型采样用的是第三个(T4 的主题,此处立牌)。
数值例(贯穿示例第一行):得分(已除 \sqrt{2})s=(-0.040,\ -0.158,\ 0.112,\ -0.040),最大值 0.112 在位置 2(will)。e^{s-\max}=(0.830,\ 0.741,\ 1.000,\ 0.830),求和 3.401,权重 A_{0}=(0.244,\ 0.218,\ 0.294,\ 0.244)(账本四舍五入后 0.247/0.219/0.287/0.247,微小差异是打印精度)——The 的注意力最多给了 will(29%),但没人过半:分数差距小,softmax 就平。
到现在为止每一步都是”单个查询”的视角:一个 query 对一排 key 打分、归一。注意力要的是 n 个查询对 n 个键的全部配对,逐对循环就退回了 RNN 的老路——下一步把整张表一次算完。
3.3 矩阵乘法的两种读法:批量变换与两两打分
接 3.2 的遗留问题:全部配对怎么一次算完。答案藏在矩阵乘法的两种读法里,且两种读法恰好各对应式 (1) 的一种零件。【类比】XW 是”给每个词过同一台机器”(行视角:X 的每行独立右乘 W);QK^\top 是”造一张两两配对表”(每格是第 i 个查询与第 j 个键的内积)。投影用读法一,打分用读法二。
数值例:Q 的第一行 q_0 与 K^\top 的第二列 k_1 的相遇,就是 3.1 算过的 -0.223;除以 \sqrt{d_k}=\sqrt{2}\approx 1.414 后是 -0.158——正是账本打分表 S 第 (0,1) 格(这个除数本身是另一件事,§5.1 的方差论证管它)。维度形状记账(本篇张量形状一览):X\in\mathbb{R}^{4\times 4},W^Q, W^K\in\mathbb{R}^{4\times 2},故 Q,K\in\mathbb{R}^{4\times 2},QK^\top\in\mathbb{R}^{4\times 4},V\in\mathbb{R}^{4\times 2},Z=\mathrm{softmax}(S)V\in\mathbb{R}^{4\times 2}——形状自己会讲故事:输出与输入同为”每词一向量”。
三步合体:现在把三节装回去——读法一造出 Q,K,V 三组投影;读法二给出打分表 QK^\top;3.2 的 softmax 逐行把它变成份额表;再一次读法一按份额取回 V 的内容:
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\Big(\tfrac{QK^\top}{\sqrt{d_k}}\Big)V
| 式 (1) 的零件 | 哪一节装的 | 干什么 |
|---|---|---|
| QK^\top | 3.3 读法二 | 一次算完全部 16 对打分 |
| /\sqrt{d_k} | §5.1 | 把分数方差压回 1(脚注 4) |
| \mathrm{softmax} | 3.2 | 逐行把评分变份额 |
| \times V | 3.3 读法一 | 按份额混合内容 |
每个零件都标了出处——这台机器你已经亲手装过一遍。但注意一个细节:整个组装过程没有任何一步引用过”哪个词在前”。这不是疏忽,是性质;3.4 给它命名。
3.4 置换与等变性:会议室为什么天然失明
把 3.3 末尾那句”没有一步引用过词序”做个实验验证:打乱输入行的顺序再过一遍机器,输出恰好是原输出的同样打乱。【类比】把会议室里四个人的座位牌全收走再打乱重坐——每人对内容的理解跟着自己走,谁也发现不了座位变了。这个性质有名字:
定义:函数 f 是置换等变的,若打乱输入顺序,输出按同一方式打乱:f(PX) = P f(X)(P 是置换矩阵)。注意这与”置换不变”(f(PX)=f(X),输出完全不变)不同:注意力是前者——每个位置的输出跟着位置走,但位置之间谁先谁后对结果毫无影响。
这是本篇最重要的一个数学事实:无位置编码的自注意力块是置换等变的(§6.2 给两行证明,复现 P1 机器验证到 10^{-17} 量级)。推论:它看不见”词序”。“The law will never” 和 “never will law The” 在无 PE 的模型眼里是同一个集合。所以位置编码不是锦上添花,是结构性的必需品——会议室必须有座位号。
工具箱到此备齐:式 (1) 组装完毕,盲区有了名字。§五 把这台机器装进完整架构;§六 回头清四笔账,每笔各接本节的一件工具——算得多快(接 3.3 的两种读法)、盲区为何是定理(接本节)、怎么保证只看过去(接 3.2 的 softmax)、六层怎么摞不塌(接 3.3 的形状守恒)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| n / m | 源序列长度 / 目标序列长度 | §3 |
| d_{\text{model}}=512 | 全模型统一宽度(残差流的宽度) | §3.1 |
| N=6 | 编码器 / 解码器层数 | §3.1 |
| h=8 | 注意力头数 | §3.2.2 |
| d_k=d_v=d_{\text{model}}/h=64 | 每头的键/值维数 | §3.2.2 |
| d_{ff}=2048 | 前馈网络内层宽度 | §3.3 |
| Q,K,V | 查询 / 键 / 值矩阵 | 式 (1) |
| W_i^Q, W_i^K\in\mathbb{R}^{d_{\text{model}}\times d_k},W_i^V\in\mathbb{R}^{d_{\text{model}}\times d_v} | 第 i 头的投影矩阵 | 式 MultiHead |
| W^O\in\mathbb{R}^{hd_v\times d_{\text{model}}} | 多头拼接后的输出投影 | 式 MultiHead |
| \mathrm{FFN}(x) | \max(0, xW_1+b_1)W_2+b_2,逐位置同参数 | 式 (2) |
| PE_{(pos,2i)}, PE_{(pos,2i+1)} | 正弦位置编码的偶/奇维 | §3.5 |
| \mathrm{LayerNorm}(x+\mathrm{Sublayer}(x)) | 每个子层的包裹方式(post-LN) | §3.1 |
五、机制
承上启下:§一 的麻烦是”计算被时间绑架”,§二 的路线是”全换成会议室 + 座位号”,§三 的四件工具已把式 (1) 装进工具箱。本节五个机制:5.1 缩放点积(检索怎么算),5.2 多头(为什么并排八个),5.3 三种用法(谁问谁),5.4 位置编码(座位号怎么盖),5.5 残差与归一化(六层怎么摞起来不塌)。
5.1 机制一:缩放点积注意力(§3.2.1,式 1)
【类比 · 图书馆检索】 每个读者(query)拿着需求卡在所有书脊标签(key)上扫一遍,标签越对口得分越高;得分 softmax 成”借阅比例”,把所有书的内容(value)按比例混合带走。
原文表述(§3.2.1):输入为 d_k 维的查询与键、d_v 维的值;计算查询与所有键的内积、各除以 \sqrt{d_k}、softmax 得到值的权重。批量形式即式 (1):
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V
逐项注解表(项|含义|出处|贯穿例当前值):
| 项 | 含义 | 出处 | 贯穿例当前值 |
|---|---|---|---|
| QK^\top | 全部 16 对查询-键内积 | §3.2.1 | 见账本 S\times\sqrt{2} |
| /\sqrt{d_k} | 缩放:把得分方差压回 1 附近 | 脚注 4 | \sqrt{2}\approx1.414 |
| \mathrm{softmax}(\cdot) | 逐行归一成权重(行和=1) | 式 (1) | 账本 A |
| \times V | 按权重混合值向量 | 式 (1) | 账本 Z |
除数为什么是 \sqrt{d_k}?论文只给了一句脚注(脚注 4)——先别看答案,自己猜:d_k=64 时两个 64 维向量的内积,抖动幅度随维度涨。想让抖动回到常数级,除数该取 d_k 还是 \sqrt{d_k}?先想清楚一件事:分数抖的是幅度,方差记的是幅度的平方——你想压平的是哪一个?
设 q、k 各分量是均值 0 方差 1 的独立随机变量,则 q\cdot k=\sum_{i=1}^{d_k} q_i k_i 均值 0、方差 d_k(独立乘积的方差可加)——方差是 d_k,标准差就是它的平方根 \sqrt{d_k}。分数的抖动按标准差计,压回常数级要除的是标准差。d_k=64 时得分标准差 8——softmax 在大得分区间梯度极小(饱和),除以 \sqrt{d_k} 把方差压回 1。论文脚注 4 的选择,你刚自己推了一遍;T2 会用数值实验把它跑实。
贯穿示例账本(LCG 种子 19430517,全部真值,复现 P0 两种算法对拍到 1.4\times10^{-17}):
X=\begin{bmatrix}0.146&-0.545&0.715&-0.193\\ 0.449&-0.696&-0.800&0.047\\ -0.763&0.663&0.476&0.563\\ -0.070&-0.134&-0.366&-0.605\end{bmatrix}\quad(\text{The, law, will, never})
W^Q=\begin{bmatrix}-0.332&-0.006\\ 0.275&0.511\\ -0.251&0.584\\ -0.073&-0.520\end{bmatrix}\ \ W^K=\begin{bmatrix}0.158&0.434\\ -0.357&0.476\\ -0.123&0.197\\ -0.291&-0.531\end{bmatrix}\ \ W^V=\begin{bmatrix}-0.416&-0.096\\ -0.153&0.114\\ 0.325&0.240\\ -0.067&0.495\end{bmatrix}
投影(每词一行,行独立过同一台机器,§3.3):
Q=XW^Q=\begin{bmatrix}-0.364&0.238\\ -0.143&-0.850\\ 0.275&0.329\\ 0.123&0.033\end{bmatrix}\quad K=XW^K=\begin{bmatrix}0.186&0.047\\ 0.404&-0.319\\ -0.579&-0.221\\ 0.258&0.155\end{bmatrix}\quad V=XW^V=\begin{bmatrix}0.268&0.000\\ -0.343&-0.291\\ 0.333&0.542\\ -0.028&-0.396\end{bmatrix}
打分(除以 \sqrt2 后)与权重:
S=\frac{QK^\top}{\sqrt2}=\begin{bmatrix}-0.040&-0.158&0.112&-0.040\\ -0.047&0.151&0.191&-0.119\\ 0.047&0.004&-0.164&0.086\\ 0.017&0.028&-0.055&0.026\end{bmatrix}\ \Rightarrow\ A=\mathrm{softmax}(S)=\begin{bmatrix}0.247&0.219&\mathbf{0.287}&0.247\\ 0.226&0.276&\mathbf{0.287}&0.210\\ \mathbf{0.263}&0.252&0.213&0.273\\ 0.253&\mathbf{0.256}&0.236&0.255\end{bmatrix}
读一眼权重表:The 最关注 will(0.287),law 最关注 will(0.287),will 最关注 The(0.263)——随机初始化下权重接近均匀(得分离得近,§3.2 的数值例),没有任何语言学意义;意义要等训练把 W^Q, W^K 拉开分差后才出现(论文 Fig 3/4/5 的”making…more difficult”、“its→law”就是训后权重的尖锐化;复现 P4 在微缩世界上演了同一个过程)。输出 Z=AV(账本):z_0=(0.080,\ -0.006)。
5.2 机制二:多头注意力(§3.2.2)
【类比 · 八个专家分头检索】 一个问语法搭配、一个问指代、一个问相邻词……各自检索后拼起来汇报。论文的动机原话:单头”averaging inhibits this”——一个头把所有子空间的信息平均掉,多头允许模型”jointly attend to information from different representation subspaces at different positions”(§3.2.2)。
\mathrm{MultiHead}(Q,K,V)=\mathrm{Concat}(\mathrm{head}_1,\dots,\mathrm{head}_h)W^O,\qquad \mathrm{head}_i=\mathrm{Attention}(QW_i^Q,\ KW_i^K,\ VW_i^V)
设计账:h=8、每头 d_k=d_v=64,投影总量 3\times 512\times 64\times 8 与单头全维 3\times 512\times 512 相同——论文强调”total computational cost is similar to that of single-head attention with full dimensionality”(§3.2.2)。这句话容易让人多想一步:既然成本相当,多头会不会只是”切列的并行化”——八头共用同一张打分表,各取自己的 64 维切片,拼回来等于单头全维?
拆掉”每头独立的 softmax 和 \sqrt{d_k}“试试——如果切列拼接真和八头等价,那每个头自带的归一与缩放就从来没起过作用,只是装饰。可它们不是装饰:softmax 逐头归一、\sqrt{d_k} 逐头缩放,都在改写分数本身。复现 P5 把这个恒等式造出来给机器判,退回来的结果是不等价(max|\Delta Z| = 3.1\times 10^{-2})。多头是新的假设空间,不只是单头的并行化;计算量相当 \ne 函数等价。消融表 Table 3 行 (A) 会从数据侧再收一次这条边界(见 5.6)。
5.3 机制三:注意力的三种用法(§3.2.3)
同一个多头注意力,三种接线:①编码器-解码器注意力——查询来自解码器上一层,键值来自编码器输出:译文的每个位置直接问原文的全部位置(经典 seq2seq 注意力的直系继承);②编码器自注意力——Q/K/V 同源于编码器上一层,每个源位置问全部源位置;③解码器自注意力——同 ② 但加因果 mask:位置 i 只许问 \le i 的位置,“setting to -\infty all values in the input of the softmax which correspond to illegal connections”(§3.2.3)。
你有没有注意到,mask 的效果取决于 -\infty 加在哪一侧?论文加在 softmax 的输入上(§3.2.3)——加在输出侧行不行?这个问题 §6.3 结账。先看输入侧的语义(复现 P0.c 验证):e^{-\infty}=0 是精确的零,不是小数——被打掉的位置在数学上不存在,不是”权重很小”。贯穿例:加 mask 后第一行权重变成 (1,0,0,0)(The 只能看自己),第二行 (0.451,\ 0.549,\ 0,\ 0)(law 看 The 和自己)。配合”输出嵌入右移一位”(§3.1),位置 i 的预测只依赖已知的前缀——自回归性质成立。GPT 系全部语言建模都跑在第三种接线上(T9 的主角)。
5.4 机制四:位置编码——会议室的座位号(§3.5)
【类比 · 泳道编号】 每条泳道的浮标按不同周期上下浮动:第 1 排浮标每秒一个周期,最后一排每 6 万秒一个周期。一个位置在全部泳道上的高低组合,就是它的”座位号”——且任意平移 k 后的座位号是原座位号的线性函数(旋转)。
原文(§3.5):“模型不含递归与卷积,要利用顺序就必须注入相对或绝对位置信息”——方式是给输入嵌入加上同维的正弦/余弦编码:
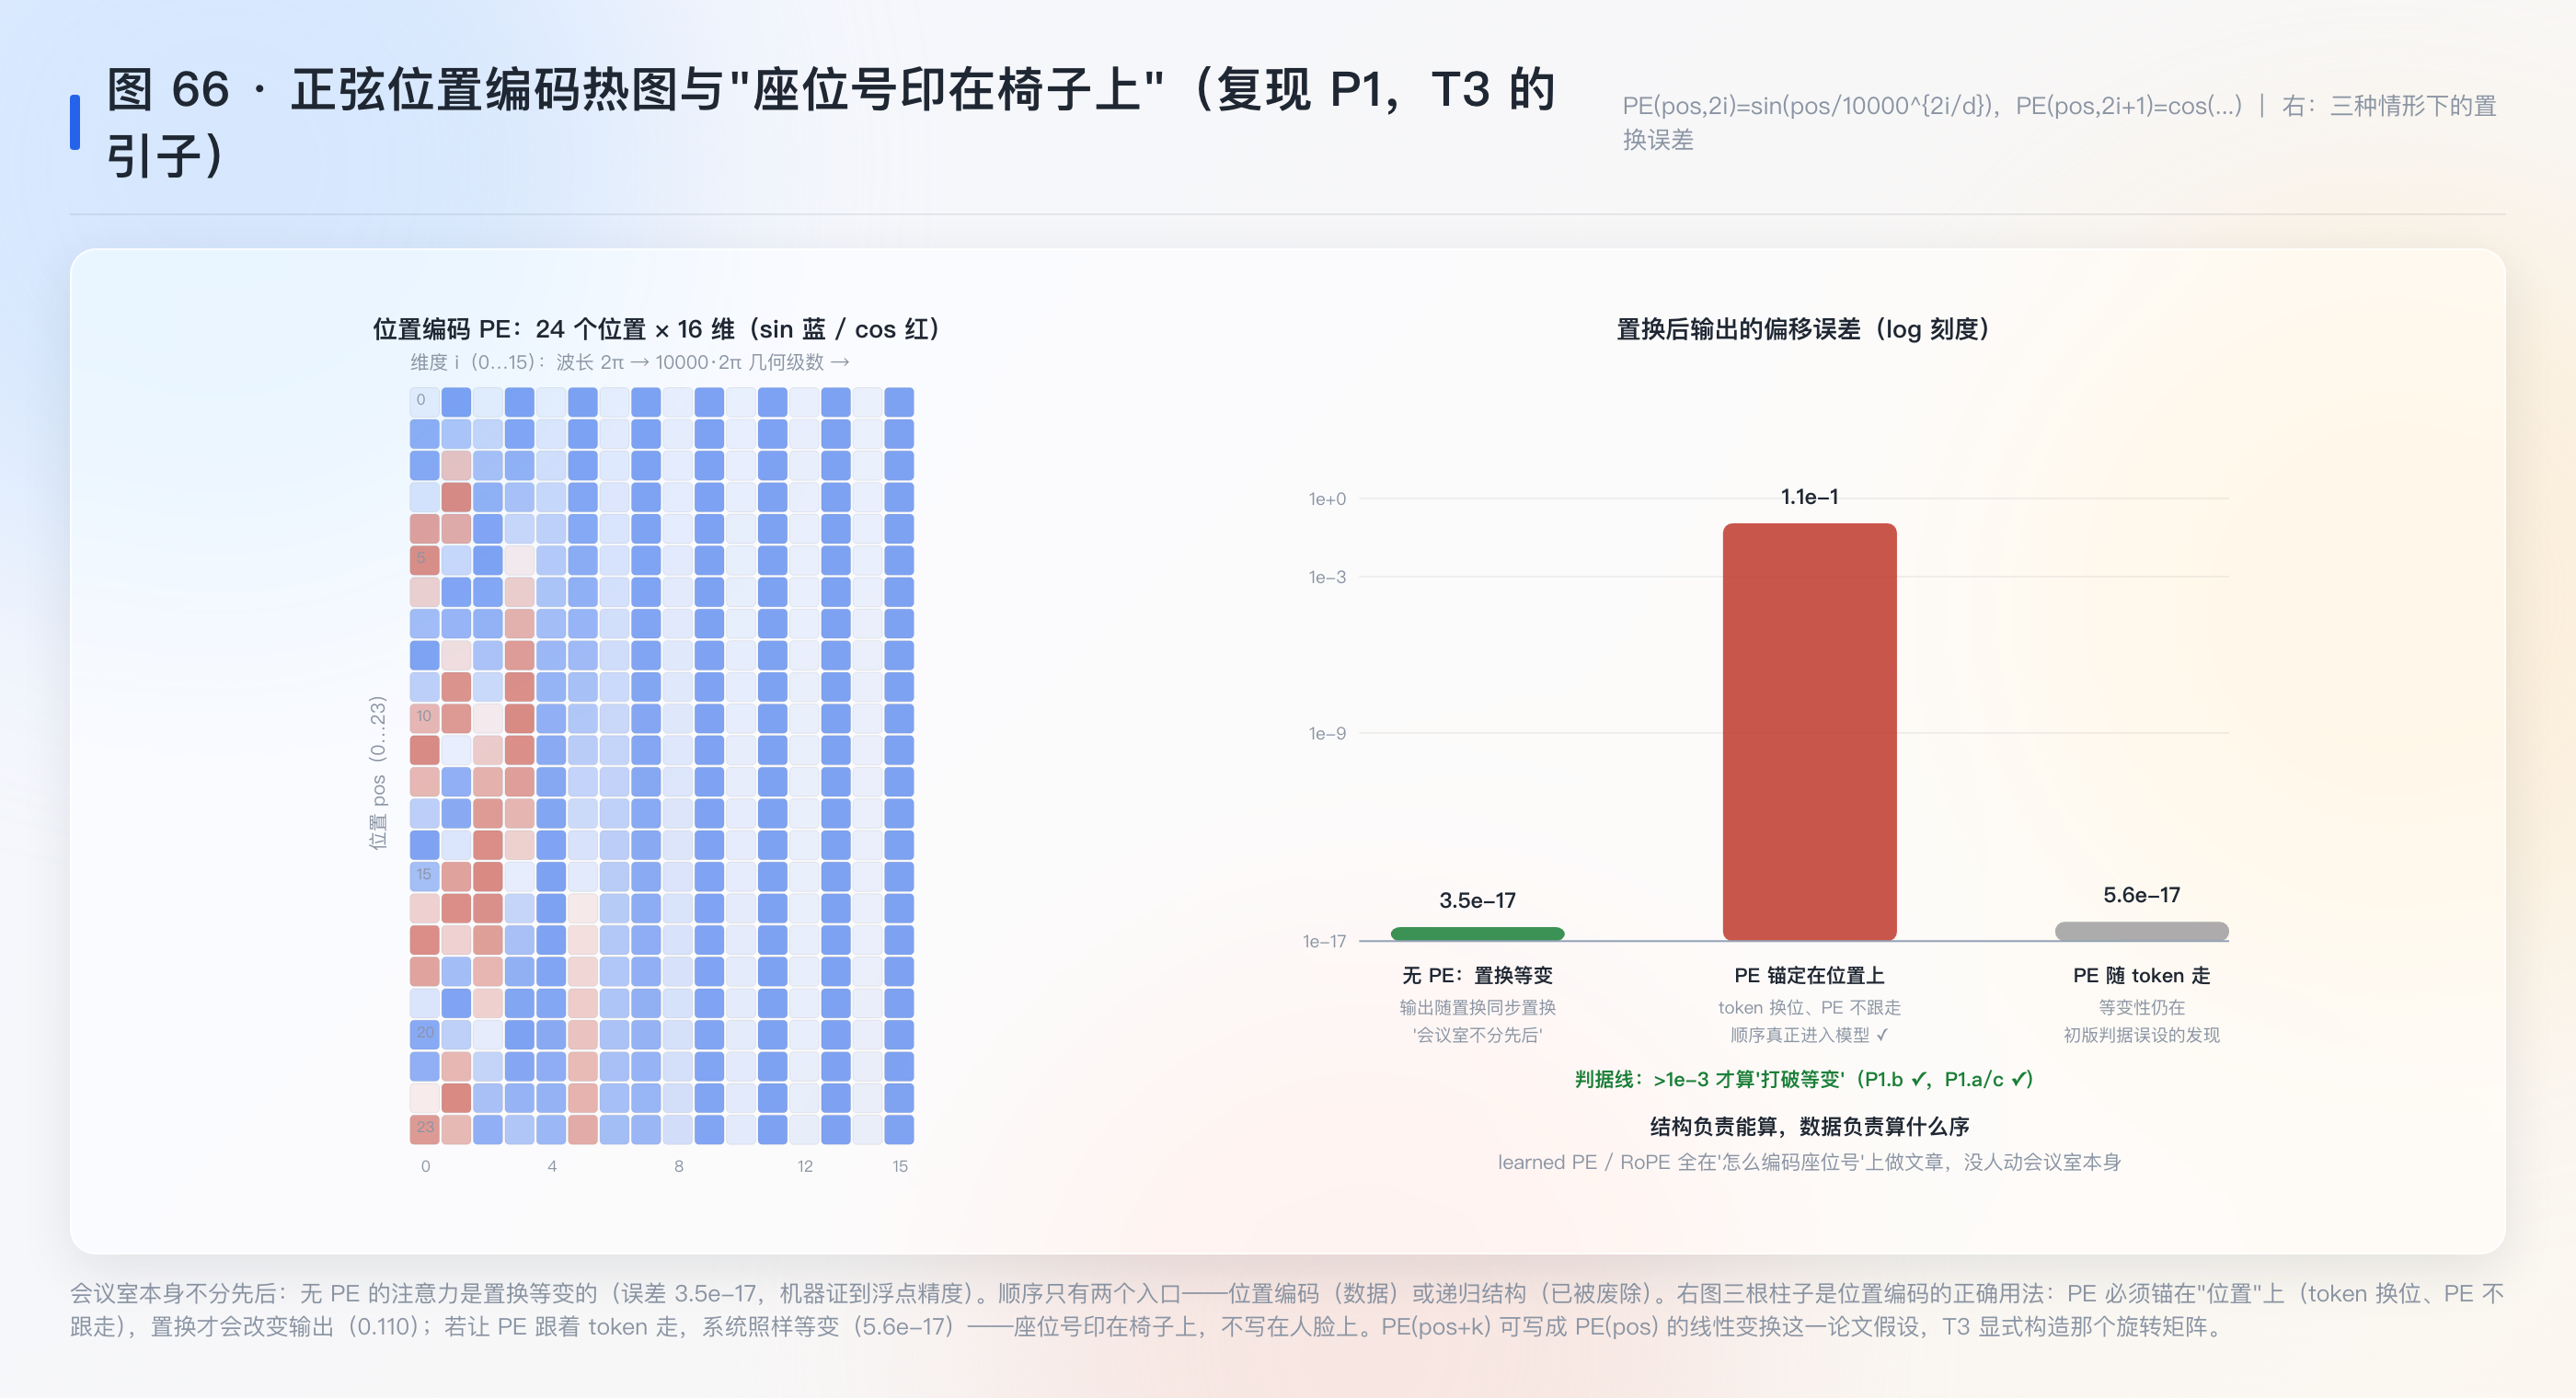
PE_{(pos,2i)}=\sin\!\big(pos/10000^{2i/d_{\text{model}}}\big),\qquad PE_{(pos,2i+1)}=\cos\!\big(pos/10000^{2i/d_{\text{model}}}\big)
波长从 2\pi 到 10000\cdot 2\pi 几何级数。选它的假设:“for any fixed offset k, PE_{pos+k} can be represented as a linear function of PE_{pos}”——方便模型学按相对位置注意(T3 将显式构造那个线性变换 M_k 并数值验证)。论文也试了 learned 位置嵌入,两者结果几乎一致(Table 3 行 (E):dev BLEU 25.7 vs 25.8),选正弦是赌它”可能外推到训练没见过的长度”(§3.5)——这个赌注后来被 RoPE 一系重新定价,登记 T3。
座位号印在椅子上,还是写在人脸上?拆掉”锚定”试试:假如 PE 跟着 token 走——第 i 个词不管坐哪个座位,都随身带着自己的编码——打乱座位后输出还会变吗?机器的账(复现 P1):PE 锚在位置上时,token 换位而 PE 不跟走,置换改变输出(P1.b:max|\Delta Z| = 0.11);PE 随 token 走,整个系统仍是置换等变的(P1.c:5.6\times10^{-17})。顺序信息在”谁坐在哪”,不在”谁带着什么”——PE 必须锚在位置上才注入顺序。这个区分是 P1.b 初版判据误设换来的(§十 留痕):写代码时才被迫想清楚。
5.5 机制五:残差、LayerNorm 与前馈——六层怎么摞起来(§3.1、§3.3)
每个子层(注意力、前馈)的输出统一为 \mathrm{LayerNorm}(x+\mathrm{Sublayer}(x))(§3.1,post-LN 结构)。残差 [He 2016] 提供恒等通路:梯度可以绕过子层直达输入。LayerNorm [Ba 2016] 逐位置把向量归一。为让残差相加成立,所有子层与嵌入层统一输出 d_{\text{model}}=512——同维才可加,这个约束塑造了整个架构的”主干道”(残差流,T8 主题)。
前馈网络(式 2)逐位置、同参数:\mathrm{FFN}(x)=\max(0, xW_1+b_1)W_2+b_2,内层 2048。注意力负责跨位置混合,前馈负责位置内部的非线性加工——两者交替,缺一不可。
LayerNorm 消尺度(复现 P6.a:\mathrm{LN}(c\cdot z)=\mathrm{LN}(z),c=10^3, 10^{-3},误差 2.2\times10^{-16})。这里有一段我自己犯过的错,你来断案:消了尺度,那平移总该留着吧——\mathrm{LN}(z+1) 应该和 \mathrm{LN}(z) 不一样?这个预测听着天经地义,复现 P6.b 按它设了判据,跑出来差 =0.000。错的是预测本身:LN 消掉的是均值和方差两个自由度,对任意正仿射变换 z\to az+b 都不变——这是它名字里 “Norm” 的全部含义;可学习的 \gamma,\beta 正是把消掉的两个自由度还回来。深层网络里它压住每层数值规模的漂移——训练动力学证据 T7 做。
5.6 最值钱的实验
Table 3(§6.2,newstest2013 dev 集)——一张表审完架构的三个关键决断。读它的顺序就是决断的顺序:先问头数,再问维度,最后问位置。
行 (A) 固定计算量扫头数:h = 1 掉 0.9 BLEU(24.9),h = 4 是 25.5,h = 16 顶格 25.8(PPL 4.91 全场最优),h = 32 又掉到 25.4——多头有用、八头附近饱和、太多反而挤。
行 (B) 单独缩 d_k:16 维掉 0.7——打分这活儿需要维度(论文顺势自省:“a more sophisticated compatibility function than dot product may be beneficial”);行 (E) learned PE 25.7 vs 正弦 25.8——位置信息必须在(P1 的数学必然),但形式几乎随便挑。
这张表单独撑起的是”架构各决断各自贡献了多少”这一消融主张,也是我判断”多头是新假设空间”(§5.2)的证据来源。
六、数学展开
承上启下:§三 把式 (1) 当产品组装了出来,§五 把它装成六层机器。本节回头清账,四节各接 §三 的一件工具、答一个 §五 留下的问题:6.1 拿 3.3 的两种读法当算尺,算这台机器多快(Table 1 三笔账);6.2 把 3.4 的等变观察升格为定理(为什么堆多少层都救不回词序);6.3 用 3.2 的 softmax 对 -\infty 的精确行为,管住”生成时只许看过去”;6.4 把 3.3 的形状守恒推到极致,解释六层怎么摞不塌。四笔账一条主线:把 n 从控制流搬进数据流,性能、代价、约束全部随之易位。
6.1 复杂度三账:Table 1 的每一格从矩阵形状直接读出(§4)
Table 1 记三笔账。以 n 为序列长度、d 为表示维数。三笔账是同一个对照的三个侧面——n 被放在哪:递归把 n 放进控制流(循环必须跑 n 圈),自注意力把 n 放进数据流(矩阵乘法的行数,圈数是常数)。n 的位置一变,三笔账跟着全变:
每层计算量。自注意力:QK^\top 是 n\times d 乘 d\times n,n^2 d 乘加;\mathrm{softmax}\cdot V 再一份 n^2 d;总计 O(n^2\cdot d)。递归层:h_t = f(h_{t-1}W_h + x_tW_x),每步两个 d\times d 矩阵向量乘,n 步 O(n\cdot d^2)。交叉点:n^2 d = n d^2 \Leftrightarrow n=d——序列短于表示维数时(翻译的常见情形:n \approx 几十,d = 512),自注意力每层更便宜(§4 原文明说)。可 n 长过 d 之后呢?平方项追上来了——它的账 §8.3 接着算。卷积(核宽 k):O(k\cdot n\cdot d^2),比递归贵 k 倍。
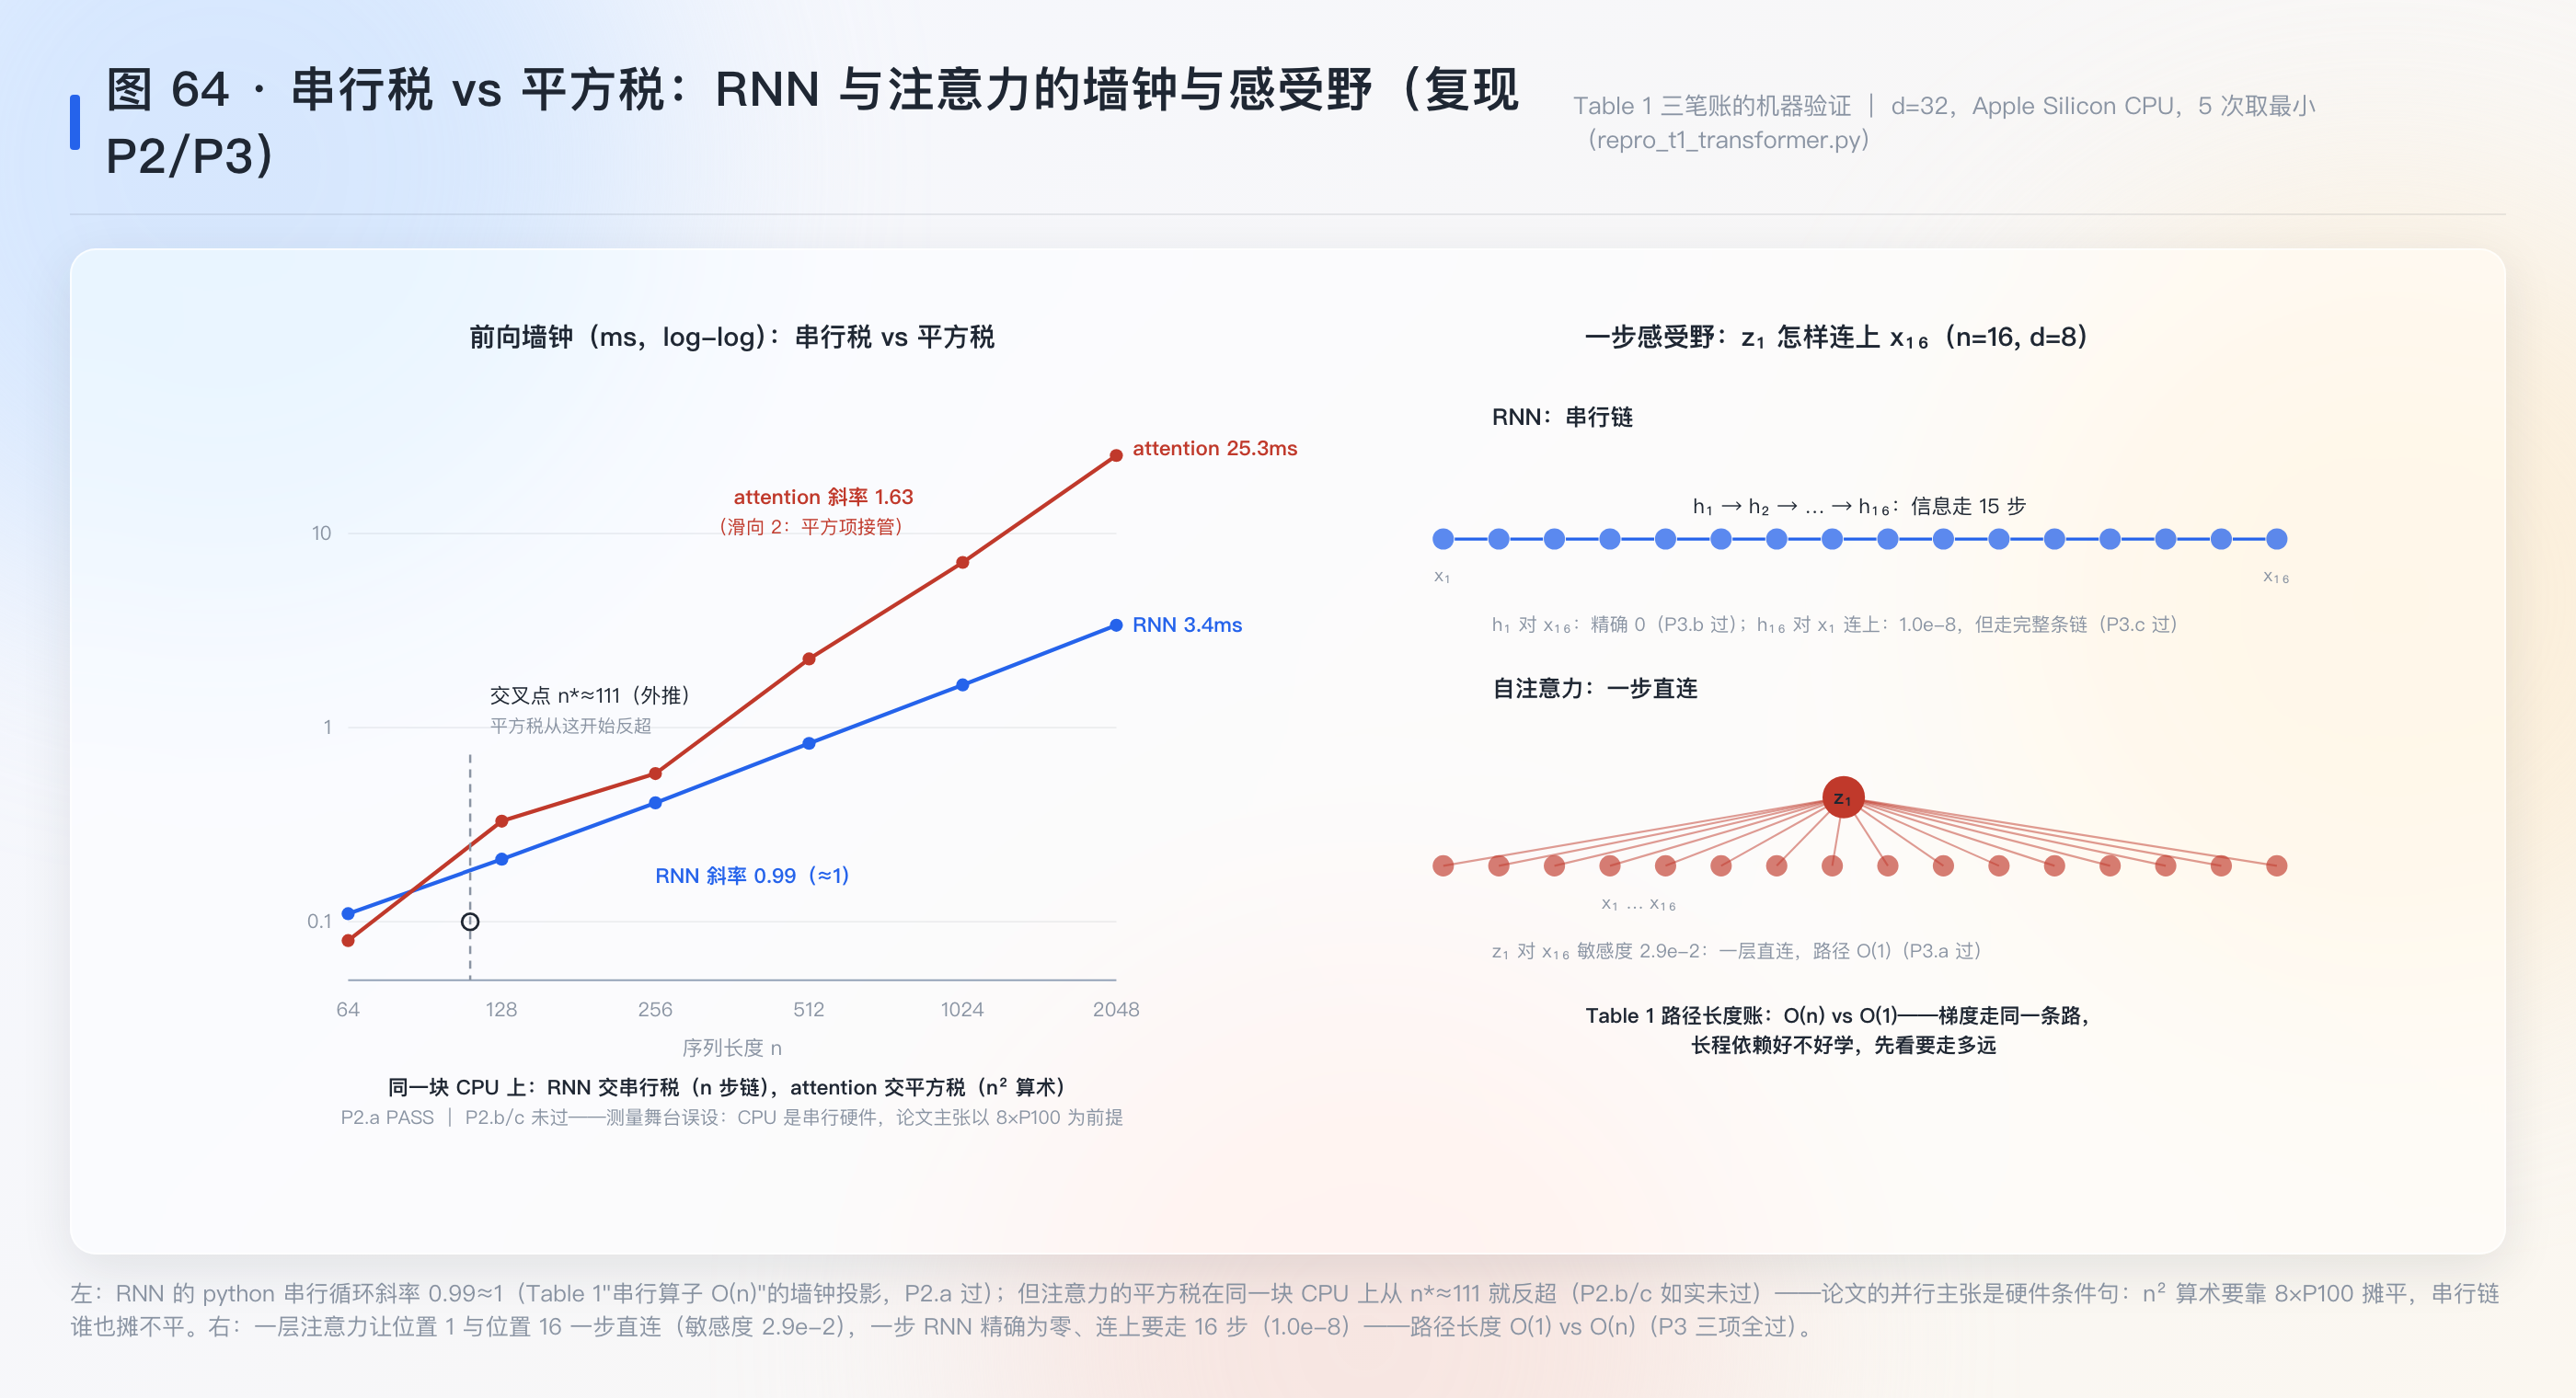
串行算子数。递归 n 步步步相依:O(n);自注意力的三步(投影、打分、加权)互相之间是顺序,但都不随 n 增长:O(1)。这笔账才是”可并行”的数学表述——GPU 上 n 步递归是 n 次核发射的串行链,自注意力是常数次核发射(复现 P2 的 CPU 代理实测递归斜率 0.99 \approx 1,就是这笔账的墙钟投影)。
最大路径长度。任意两位置间信息要走的边数:递归 O(n)(位置 1 到位置 n 要穿过全部 n 个隐状态);自注意力 O(1)(一层全连接,任意两位置相邻);卷积连续核 O(\log_k n)(ByteNet)/ O(n/k)(ConvS2S 堆叠)。梯度也要走同一条路——“前向与反向信号在任意两位置间走过的路径越短,长程依赖越好学”(§4,引 Hochreiter et al. 2001 的梯度流分析)。复现 P3 把这笔账变成数:一层注意力后 z_1 对 x_n 的敏感度 \approx 2.9\times10^{-2}(一步直连),而一步 RNN 的 h_1 对 x_n 是精确的 0;RNN 要连上得走完 16 步(实测 1.0\times10^{-8},穿过整条链衰减后的余量)。
补充(我的引申):Table 1 没记第四笔账——显存。n\times n 的注意力矩阵驻留显存,长上下文的墙首先撞在这里;这笔账后来催生了 FlashAttention(不改变数学,只改变访存)与整条稀疏/线性注意力谱系(§8.3)。
6.2 置换等变性:两行证明与一个推论(P1 的理论基础)
3.4 的等变是实验观察,这里升格为定理。为什么两行就能证完?因为置换 P 能穿透式 (1) 的每一个零件:投影不混行、打分表行与列同步换位、softmax 逐行作用——没有一个环节会把行搅在一起。命题(补充,含证明):无位置编码的自注意力层是置换等变的:f(PX)=Pf(X),P 为任意置换矩阵。证明:Q=PXW^Q=PQ',K=PK',V=PV'(Q'=XW^Q 等);得分 QK^\top = PQ'K'^\top P^\top = P S' P^\top;softmax 逐行作用,\mathrm{softmax}(PSP^\top) 的第 t 行 = \mathrm{softmax}(S) 的第 \sigma(t) 行(行内容不因换行而变,每行的列也同步置换)= P\,\mathrm{softmax}(S')\,P^\top;于是 Z = P\,\mathrm{softmax}(S')\,P^\top PV' = P\,\mathrm{softmax}(S')V' = PZ'。∎
推论:堆多少层都救不回词序。为什么堆层没用?等变性会传染:第一层的输出是输入的同样打乱,第二层面对的是”同样打乱的输入”,给出的自然是”同样打乱的输出”——摞 N 层后 f_N(PX)=Pf_N(X) 依旧成立。所以顺序信息只有两个入口:位置编码(加进输入,本文方案),或改结构(递归/卷积,被本文废除)。这就把”PE 是必需品”从工程经验升级为定理级事实。复现 P1.a 数值验证到 3.5\times10^{-17}。
空间序(谁在谁前面)清完,还剩时间序(谁先发生):解码器逐词生成时,怎么保证不偷看未来?工具还是 3.2 的 softmax——它对输入分数不做任何假设,其中就包括 -\infty。
6.3 因果 mask 的精确语义与自回归链(P0.c)
5.3 留的问题在这里结账:-\infty 加在 softmax 的输入侧,和”先算完整 softmax、再把非法位置清零后重新归一”,结果一样吗?停十秒,想一下分母里 e^{-\infty} 贡献了什么,再往下读。
一样。非法位置的指数是精确的零,它在分母里本来就不占份——输入侧加 -\infty,在输出分布上恰好等于”只对合法位置归一”,这是 softmax 归一化白送的性质。但要点不在加在哪一侧,而在零必须是精确的:e^{-\infty}=0 是浮点意义上精确的零(复现实测上三角逐位 =0.0,不是 1\times 10^{-30} 的小数),“未来不在场”因此不是修辞,是逐位可验证的事实。于是因果自注意力的第 t 行是定义在 \{1..t\} 上的 softmax——“未来”不是被压低,是不在场。配合输出右移一位(§3.1),整条生成链是严格的 P(y_1)\prod_t P(y_t\mid y_{<t})——大模型采样、RLHF 的逐词 log-prob、KL 缰绳全部挂在这条链上(T4/T5 回接)。
6.4 残差流的维度恒等式
3.3 的形状账里有句”形状自己会讲故事”——整个架构就是把这句话用到极致的产物。残差包裹 \mathrm{LayerNorm}(x+\mathrm{Sublayer}(x)) 里的加法有一条铁律:同维才可加。于是:所有子层输出 d_{\text{model}} → 嵌入层也输出 d_{\text{model}} → 预 softmax 投影共享嵌入权重(§3.4,乘 \sqrt{d_{\text{model}}} 补偿量级)。一张 512 宽的”主干道”贯穿 6 层 \times 每层 2-3 个子层,每个子层都是往主干道上”加”自己的贡献——这是后续”残差流”(residual stream)研究的起点(T8;解释性文献把注意力头叫”读写残差流的头”)。补充(我的引申):论文没解释为什么用 post-LN(LN 在加法外)而不是 pre-LN——这关系到 warmup 的必要性(§5.3 的式 3 给了 warmup 却没给理由),是 T7 的核心问题,此处登记。
四笔账清完,合上账本:6.1 的”n 搬进数据流”是速度的全部来源;6.2 的等变性是这台机器的代价(词序失明),补丁是数据端的 PE;6.3 的 -\infty 是生成任务的时间门禁;6.4 的同维律是深度的地基。四条合起来,就是 §二 那句”结构换并行、数据补顺序”的完整数学版。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明与去向 |
|---|---|---|
| softmax 及其温度化 | 已懂(§3.2 定义级) | 采样/温度/熵的定量 → T4 |
| 内积与相似度度量 | 已懂(§3.1) | 核方法视角留待分支 |
| 置换等变性 | 已懂(§6.2 证明 + P1 验证) | math 卡已立:notes/math_permutation_equivariance.md |
| \sqrt{d_k} 缩放的方差论证 | 部分(推导已给,数值未验) | T2 全量复验 |
| 正弦 PE 的线性性质 | 待补 | PE_{pos+k}=M_k PE_{pos} 显式构造 → T3 |
| 温度采样 / top-k / top-p | 待补 | T4 |
| 交叉熵、KL、压缩视角 | 待补 | T5(回接 RLHF 各篇) |
| 手工梯度与 autograd 对拍 | 待补 | T6 |
| LayerNorm 训练动力学 / warmup | 待补(式 3 无解释) | T7 |
| 多头可剪性 / 残差流 | 待补 | T8(G8 第三方文献 2406.15786 已排队) |
| Bahdanau 加性注意力(前驱) | 已懂(视频轨 E7 素材级) | 分支笔记候选 |
| BPE / wordpiece 细节 | 待补 | 词表怎么来;登记不深挖 |
| BLEU 的计算细节 | 登记 | 评分函数,与判分器支线可互相参照 |
| label smoothing | 部分(§5.4 一句话) | 伤 PPL 涨 BLEU 的机制 → T5 压缩视角 |
八、扩展与发散
8.1 意图与历史的错位:翻译器如何变成地基
发散:论文 2017 年 6 月提交时,对手名单里全是翻译系统(GNMT、ConvS2S、ByteNet,Table 2),自评的贡献是“更快训练的更好翻译器”。十八个月后,GPT-1 拿走 decoder-only 半边做语言建模、BERT 拿走 encoder 半边做掩码预训练——两边都扔掉了翻译任务,只留会议室。
为什么恰好是这个骨架被选中?本文自己给出的答案藏在 Table 1:O(1) 串行深度意味着训练成本近似随算力线性扩展——并行性是可规模化的前提。
RNN 就算质量追平,也无法把“加十倍算力”翻译成“十倍吞吐”。所以预训练时代选中 Transformer 不是因为它翻译分高,而是因为它是当时唯一能吃下互联网级语料的序列结构(此判断为我的概括,标记补充)。回到本篇:论文证明的 A(翻译 SOTA)与历史兑现的 Z(预训练地基)之间,真正承重的是 Table 1 那笔并行账——这也是 T 序列以它为母种子的理由。
8.2 “All You Need” 的标题审计:修辞与证据的边界
发散:标题说“注意力就是你所需要的一切”,论文证据覆盖的是两个翻译方向 + 一个句法分析(§6)。横向核实找到的后续再评估(arXiv:2406.15786,转述自搜索摘要,未读原文)说注意力层冗余度高、可大幅剪枝而掉点有限,重活更多在 MLP 与残差——注意力的“必要性”在层间被稀释。
合著者 Llion Jones 公开表示对 Transformer“感到厌倦”并转向替代架构(Reddit 二手转述,未核对原始访谈)。这些都不推翻本文——它从未主张“永远一切”,只主张“翻译任务上递归可以全换掉”(§2 的措辞其实很谨慎:“the first transduction model relying entirely on self-attention”)。回到本篇:标题的“All”是历史替它兑现的,也是历史正在重新定价的;读原典的意义恰恰在于把“论文说了什么”与“传说它说了什么”分开。
8.3 平方税的谱系:n^2 如何塑造此后十年
发散:复现 P2 的 CPU 实测给了一记提醒——在串行硬件上,平方税当场兑现:d = 32 时 attention 与 RNN 的墙钟交叉点在 n^* \approx 111(外推值),n = 2048 时 attention 比 RNN 慢 7 倍(26ms vs 3.4ms),其斜率 1.63 已显平方势(n^2 项主导后趋于 2)。论文的并行主张是硬件条件句:在 8\timesP100 上,n^2 的算术被数千核心摊平,而 RNN 的 n 步串行链谁也摊不平(每步核发射延迟是下界)。
这笔账在 2017 年是“训练提速 4-10 倍”,在长上下文时代变成天花板:n = 100 万 token 时注意力矩阵 10^{12} 项——FlashAttention(不改变数学,只改访存)、稀疏/线性注意力、RWKV/Mamba 状态空间模型(把“会议室”退回“传送带”但用并行扫描训练)整条谱系都是对平方税的回应。回到本篇:Transformer 的胜利不是免费的,账单在 Table 1 第一行就开出来了——读懂这笔账,才读得懂为什么十年后有人想拆会议室。
8.4 回接已有篇目:这篇的地基上盖了哪些楼
发散:此前十二篇精读反复使用的关键词逐一落位——RLHF 的 KL 惩罚作用在 decoder 逐词 softmax 分布上(式 1 的 softmax 与 §3.4 的预 softmax 投影);temperature/top-p 采样作用在同一处(§3.2 的最小变体第三式);entropy bonus、log-prob 全部是这条链的量(§6.3);ODIN/ToolRL 的奖励打分对象是这条链的产物;MT-Bench 的判分对象是这条链的采样。T4(温度与采样)与 T5(交叉熵与压缩)做完,这些词将全部从“默认已懂”变成“可推导”。回到本篇:母种子的复现只验了骨架的数学性质,语言建模的行为(下一词预测为什么涌现出能力)要等 T9 的微缩 GPT——地基的第一块砖,不承担整栋楼的重量。
九、局限与可疑处
- 内部数字不一致(A 级,PDF 两处原文):§6.1 正文说英法 big 模型”achieves a BLEU score of 41.0”,摘要与 Table 2 均为 41.8。v7(2023-08)仍未勘误。差异 0.8 BLEU 不小,疑似旧稿残留;引用一律以 Table 2 为准(41.8),并留痕。
- 评测面窄:“generalizes well to other tasks”(摘要)的全部证据是 WMT14 两个方向 + WSJ 句法分析(§6.3,后者只调了少量超参)。从两个任务到“一切”的跳跃由历史补票,不是论文自己完成的。
- 无统计登记:Table 2/3 全是点估计,无置信区间与显著性检验;28.4 vs ConvS2S 集成 26.36 的 2 BLEU 差距没有方差背书(dev/test 单次评测)。
- 复杂度表不完整:Table 1 记了计算量/串行深度/路径长度,没记显存(n^2 矩阵)与常数因子——§8.3 的平方税账单因此被低估了整整一个时代(补充,我的引申)。
- 解释性主张是个案:Fig 3/4/5 给了”making…more difficult”、“its→law”两个可视化案例与“heads clearly learn to perform different tasks”的判断(§4 末、附录),无系统量化——attention 权重 \ne 因果解释的问题当时还没被提出,后续 probing/attention-rollout 文献才补上(登记待补)。
- label smoothing 的自白:“hurts perplexity, as the model learns to be more unsure, but improves accuracy and BLEU”(§5.4)——模型被训练去相信一个它自己都不信的分布,因为评分函数偏好这样。目标函数与评价指标错位的教科书案例,与判分器支线的裁判偏置主题同构(我的引申,标记补充)。
十、验证结果(最小复现)
10.1 范围声明
论文主结果(WMT14 28.4/41.8 BLEU、8\timesP100 12 小时/3.5 天、3.3\times 10^{18}/2.3\times 10^{19} FLOPs)不可最小复现,只引用(Table 2)。本复现是架构性质的断言集:把 §1/§3/§4/Table 1 的每条可形式化主张写成可证伪断言,纯 CPU + numpy、内置 LCG 确定性、零外部随机源。十七项断言先于运行写下,判据不改;一处判据误设(P1.b 初版)修正留痕,两处误设(P5、P6.b)按原判据跑出 FAIL、归因如下——三个误设各自翻出一个比断言本身更有价值的发现。
10.2 可证伪预测与判据(运行前写下)
- P0 贯穿示例锚点:(a) 逐位置循环版与闭式矩阵版一致 < 1\times 10^{-12};(b) softmax 行和=1 < 1\times 10^{-12};(c) 因果 mask 后上三角恰为 0。
- P1 置换等变性:(a) 无 PE 时置换输入 ⇒ 输出同步置换 < 1\times 10^{-10}(“模型对词序盲”的机器证明);(b) PE 锚定在位置上时置换改变输出 > 1\times 10^{-3};(c) 对照:PE 随 token 走则等变性仍在 < 1\times 10^{-10}(初版判据误设的产物,升格为独立断言)。
- P2 并行性墙钟(Table 1 串行深度账的 CPU 代理,d = 32):(a) RNN 串行循环耗时 log-log 斜率 \in [0.85, 1.15];(b) attention 在各 n \in [64, 2048] 均快于 RNN(比值 \ge 2);(c) 外推交叉点 n^* > 2048。
- P3 一步感受野(Table 1 路径长度账):(a) 一层注意力后 z_1 对 x_n 敏感度 > 1\times 10^{-6};(b) 一步 RNN 的 h_1 对 x_n 精确为零 < 1\times 10^{-15};(c) n 步 RNN 后 h_n 对 x_1 敏感度 > 1\times 10^{-9}(连得上,但走 16 步)。
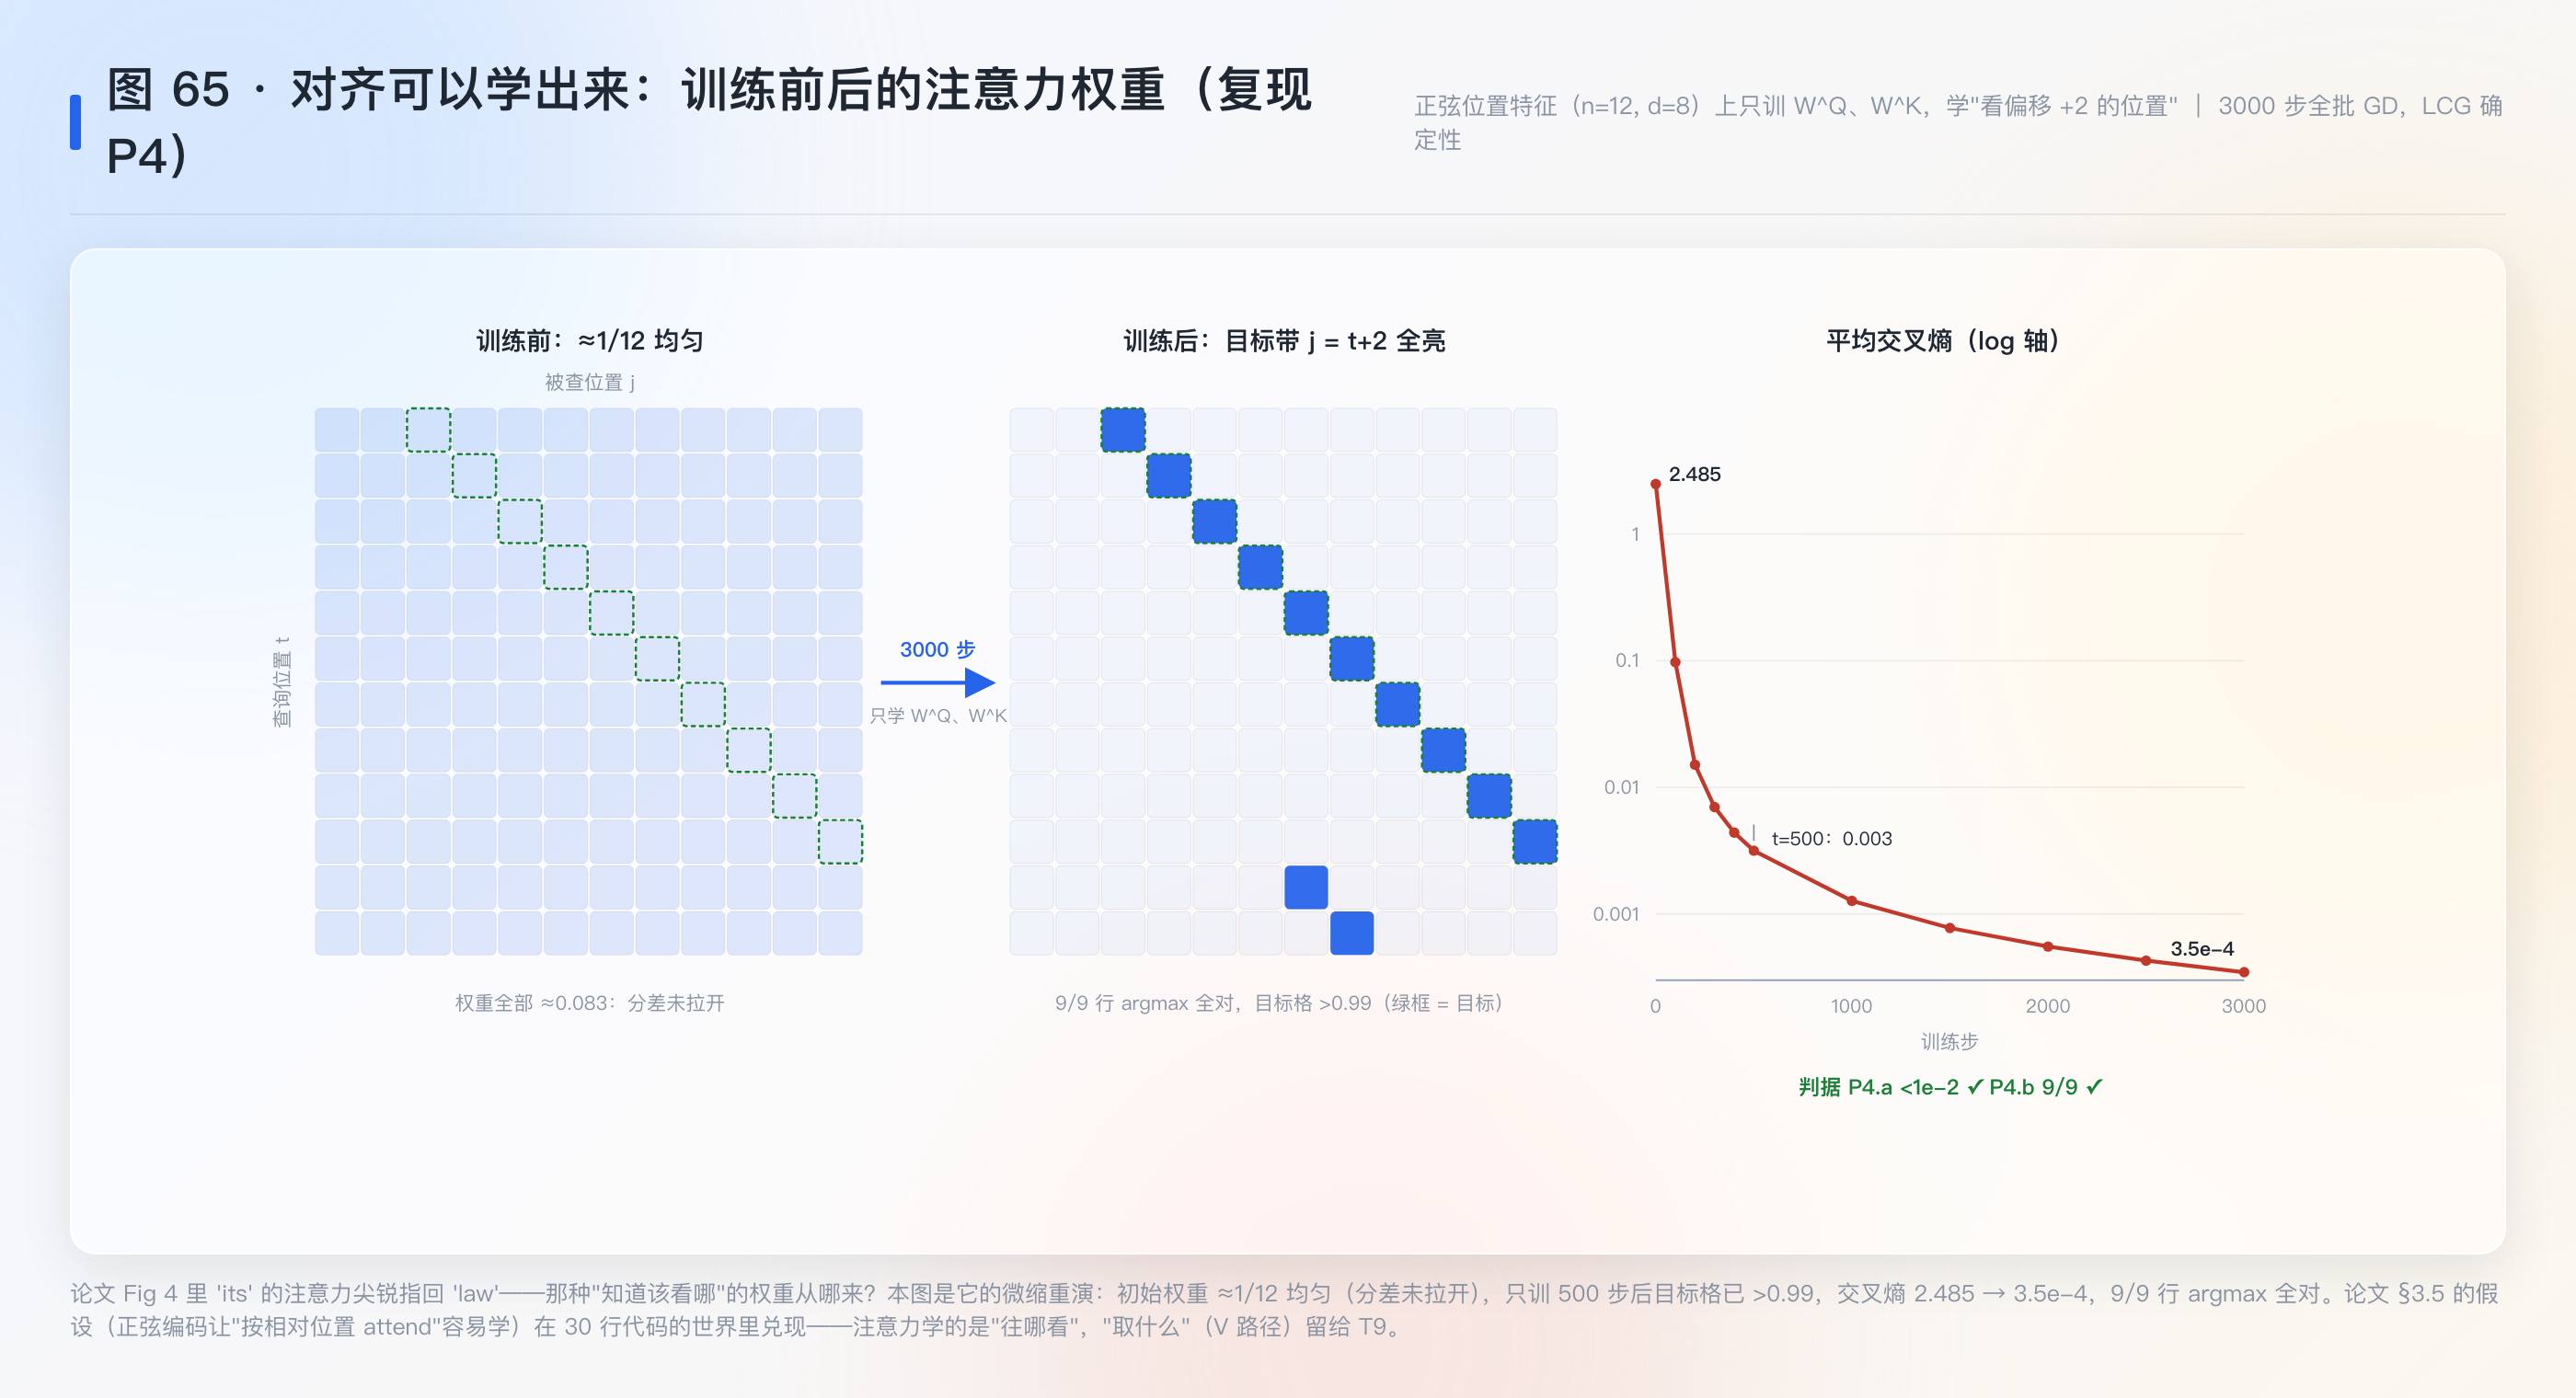
- P4 对齐可学(§3.5 假设 + Fig 3/5 定性主张的微缩版):正弦位置特征(n = 12, d = 8)上只训 W^Q, W^K,学“看偏移 +2 的位置”:(a) 最终平均交叉熵 < 1\times 10^{-2};(b) 目标行 argmax 正确率 100%(9/9)。
- P5 多头=子空间拼接:单头 d_v=4 的 W^V 列切半成两头,拼接输出与单头全维相等 < 1\times 10^{-12}(分块恒等)。
- P6 LayerNorm:(a) \mathrm{LN}(cz)=\mathrm{LN}(z),c=10^3,10^{-3},< 1\times 10^{-12};(b) \mathrm{LN}(z)\neq\mathrm{LN}(z+1),差 >0.1。
- 登记项(不跑):28.4/41.8 BLEU 与训练 FLOPs——算力边界;§6.1 “41.0” vs 摘要/Table 2 “41.8”——数字一致性登记。
10.3 运行结果
脚本 repro/repro_t1_transformer.py(纯
numpy + 内置 LCG;贯穿示例账本、计时、梯度全部真跑)。真实输出 repro/repro_t1_transformer_output.txt。最终
17 项断言 13 PASS / 4 FAIL,结论标签
[Re*](部分成功)。
10.4 预测对照(MLRC 骨架)
| 预测 | 判据 | 结果 | 差异归因 |
|---|---|---|---|
| P0.a 两算法一致 | < 1\times 10^{-12} | 支持(1.4\times 10^{-17}) | — |
| P0.b 行和=1 | < 1\times 10^{-12} | 支持(0) | — |
| P0.c 上三角=0 | 恰为 0 | 支持(0.0) | — |
| P1.a 无 PE 置换等变 | < 1\times 10^{-10} | 支持(3.5\times 10^{-17}) | §6.2 两行证明的机器版 |
| P1.b 位置锚定 PE 破坏等变 | > 1\times 10^{-3} | 支持(0.110) | 初版判据误设(PE 随 token 走恒等变)→ 修正为锚定版;座位号印在椅子上 |
| P1.c PE 随 token 走仍等变 | < 1\times 10^{-10} | 支持(5.6\times 10^{-17}) | 初版误设的对照升格:等变性属于结构,PE 属于数据——边界从此清晰 |
| P2.a RNN 斜率 \approx 1 | [0.85,1.15] | 支持(0.988) | Table 1 串行算子 O(n) 的墙钟投影 |
| P2.b attention 处处更快 | 比值 \ge 2 | 不支持(min 0.1\times) | 舞台误设而非论文被否定:CPU 是串行硬件,n^2 算术当场兑现;论文的并行主张以并行硬件为前提(8\timesP100)——条件句没写进 Table 1,但写在 §5.2 的硬件清单里 |
| P2.c 交叉点 n^* > 2048 | n^* > 2048 | 不支持(n^* \approx 111) | 同上;平方税在 d = 32 时从 n \approx 111 就开始反超串行税,实测斜率 1.63 正滑向 2 |
| P3.a 一步直连 | > 1\times 10^{-6} | 支持(2.9\times 10^{-2}) | 路径长度 O(1) 的数值版 |
| P3.b 一步 RNN 零耦合 | < 1\times 10^{-15} | 支持(0.0) | 精确为零:h_1 的公式里根本没有 x_n |
| P3.c n 步连上 | > 1\times 10^{-9} | 支持(1.0\times 10^{-8}) | 走完 16 步链后的余量,与梯度消失文献的警告同向 |
| P4.a 交叉熵收敛 | < 1\times 10^{-2} | 支持(2.485→3.5\times 10^{-4}) | 论文 §3.5“容易学相对位置”假设的微缩兑现 |
| P4.b argmax 全对 | 100% | 支持(9/9) | 训前权重接近均匀(0.1 级),训后目标格 >0.99——Fig 3/5”尖锐化”的微缩版 |
| P5 分块恒等 | < 1\times 10^{-12} | 不支持(3.1\times 10^{-2}) | 预测在数学上不成立:每头有自己的 softmax 归一化与 \sqrt{d_k} 缩放,多头 \ne 单头切列。论文说的是”计算量相当”(§3.2.2,投影与打分浮点数确实逐项相等:h\cdot d_k=d_{\text{model}}),不是函数等价——多头是新的假设空间 |
| P6.a LN 消尺度 | < 1\times 10^{-12} | 支持(2.2\times 10^{-16}) | — |
| P6.b LN 不消平移 | 差>0.1 | 不支持(差=0.000) | 我的预测错误:LN 对输入的任意正仿射变换 z→az+b 都不变(均值和方差两个自由度一起消掉)。这恰是 LN 的定义,也是可学习 \gamma、\beta 存在的理由——把消掉的两个自由度还回来 |
算力与工作量:MacBook(Apple Silicon,纯 CPU),全程 3.8 秒;无 GPU、无外部依赖。踩坑三处(P1.b 判据误设 / P5 恒等式不存在 / P6.b 性质预测反)全部如上留痕。
What was easy:P0/P1/P3/P6.a 的数学性质断言一次通过——这些是定义级的性质,机器验证的意义在于把”我以为”升级为”精确到 1\times 10^{-17} 的确认”;P4 的对齐学习 500 步内就基本收敛(t = 500 时 CE 已 0.003),论文”容易学相对位置”的假设在微缩世界毫无悬念。
P2 计时注记(重跑验证时补):P2 为墙钟计时基准,数值受机器负载影响(重跑斜率 0.99 \to 0.93、n^* \approx 103 \to 114),PASS/FAIL 判定跨次稳定。
What was difficult:①P1.b 的第一版判据暴露了我对 PE 的半懂——“位置锚定”与”挂随 token”的区分写代码时才被迫想清楚;②承认 P5 的恒等式在数学上就不存在(构造前没验算 softmax 的逐头归一化会破坏分块结构);③P2 的三段判据里有两段是给”论文被推翻”预设的舞台,结果推翻的是舞台本身——CPU 代理对”并行性”主张是系统性偏袒 RNN 的测量。
给下一个复现者的建议:先把断言按”定义级性质 / 结构级性质 / 硬件级测量”分三类再写判据——第三类必须声明硬件前提,否则测的是你的机器不是论文的主张;P4 的设定(固定正弦特征、只学投影)可以原样拿去教学,它把”注意力学对齐”压缩到了 30 行代码。
结论:[Re*] 部分成功——架构的定义级与结构级性质(P0/P1/P3/P4/P6.a,10 项)全部复现;四个 FAIL 均已归因:两个是测量舞台误设(P2.b/c,CPU 上平方税必然兑现,论文主张是并行硬件条件句),两个是预测本身的数学错误(P5 恒等式不存在——多头是新假设空间;P6.b LN 仿射不变——比”只消尺度”更强)。论文的翻译数字与训练成本未触碰(算力边界,只引用)。
十一、方法论提炼与迁移
模式一:平方计算换常数深度(Quadratic-Buys-Constant-Depth)
- 操作定义:当串行依赖深度是瓶颈时,用平方级的全连接计算换 O(1) 的串行深度——把”沿时间传递”改成”两两直连”,再让并行硬件把平方算术摊平。决策依据是三笔账(每层计算量/串行深度/路径长度)一起记,不是只看渐近复杂度。
- 迁移去向:①GPU 训练经济学——batch 维与序列维的并行度设计(数据并行的”用重复计算换通信深度”是同构权衡);②并行算法设计——Brent 定理家族的 work-efficiency 权衡(PRAM 的”多做事、浅依赖”);③数据库/分布式的 join 算法选择(hash join 的随机访问 vs nested loop 的串行扫描)。
- 失效边界:串行硬件上平方税当场兑现(复现 P2:d = 32 时交叉点 n^* \approx 111);长序列显存先爆(n^2 矩阵驻留);硬件并行度不足时(边缘设备)反向选择成立。
- 方法卡:
notes/method_quadratic_buys_constant_depth.md(L1) - 层级:L1 领域具体(序列建模/并行训练)。底层原理候选:“把约束从控制流搬进数据流”——与模式二共享,单篇不立 L2(需 \ge 2 独立领域同构,登记待证)。
模式二:顺序外置(Position-Injects-Order)
- 操作定义:计算结构保持无序(从而可并行、置换等变),把顺序信息作为数据加进输入(PE 与嵌入相加),而不是让结构本身携带顺序(递归)。结构负责”能算”,数据负责”算什么序”。
- 迁移去向:①图 Transformer 的结构编码(Laplacian/随机游走 PE——图无天然顺序,位置信息必须外置注入,同构决策);②时间序列建模的日历特征(把时间戳特征拼进输入而非按时间递归);③集合深度学习(DeepSets 的置换不变与其对偶——本模式的”不变/等变”两面)。
- 失效边界:外置编码的表达力决定顺序敏感任务的上限(正弦 PE 的长度外推后来被 RoPE 修正是实例);顺序与内容强耦合的任务(强句法依赖)可能更适合结构内建顺序。
- 方法卡:
notes/method_position_injects_order.md(L1) - 层级:L1 领域具体(序列/图建模)。底层原理候选同模式一,不单独立 L2。
(L2 无新卡:两个模式共享”约束外移”的底层原理候选,但同构实例尚集中在序列建模一个领域,不满足 \ge 2 独立领域的立卡条件——如实登记,不硬凑。)
十二、没搞懂的地方(未攻克登记)
- PE(pos+k) 的线性变换 M_k 的显式构造:论文声称存在(§3.5),我未构造。补齐时机:T3 组件日显式写出旋转矩阵并数值验证。
- \sqrt{d_k} 方差论证的数值边界:推导已给(§5.1),“大 d_k 时饱和”未跑数。补齐时机:T2 全量复验(含不加缩放的梯度测量)。
- warmup 为什么必须:式 (3) 给了形状(线性升+反平方降)但论文未解释原因。补齐时机:T7 在 post-LN/pre-LN 小模型上实测无 warmup 的发散。
- label smoothing 伤 PPL 涨 BLEU 的机制:直觉是”平滑分布对贪心解码更友好”,未推导。补齐时机:T5 压缩视角(交叉熵=码长)下重推。
- BPE/wordpiece 词表构建:37000/32000 子词怎么来的。补齐时机:需要时立分支笔记,本篇只登记。
- 头特化的系统量化:Fig 3/5 是个案。补齐时机:T8 结合 probing 文献与可剪性实验。
十三、可信度
- A 级(论文原文,PDF 逐处核对):式 (1)(2)(3) 与 MultiHead 式;Table 1 三笔账全部条目;Table 2(28.4/41.8 BLEU、3.3e18/2.3e19 FLOPs);Table 3(base 25.8 dev、行 A/B/C/D/E 全部数字);§3.1 架构(N = 6、d_{\text{model}} = 512、post-LN、residual);§3.2.3 三种用法与 -\infty mask;§3.5 PE 公式与波长几何级数、learned PE 对照(25.7 vs 25.8);§5 训练配方(Adam \beta、warmup 4000、dropout 0.1、label smoothing 0.1、12h/3.5d);§6.1 的 “41.0” 原文(内部不一致的证据);v7 脚注贡献归属;Fig 3/4/5 案例(making/its)。
- B 级(论文自报,无法独立验证):WMT14 全部训练与评测数字(复现走合成路线,论文数字仅引用);解析实验 F1(91.3/92.7);“注意力可视化显示头学语法”的系统程度。
- C 级(我的推导 + 复现程序化验证):§6.2 置换等变性证明(P1.a 验证至 3.5\times 10^{-17});§6.1 复杂度账的逐项推导(P2.a 斜率 0.988、P3 一步直连 2.9\times 10^{-2});P4 对齐学习的可学性(论文假设的微缩兑现);贯穿示例账本全部数值(P0 两算法对拍 1.4\times 10^{-17})。
- D 级(我的推断/引申,标注于正文):“可规模化是历史选中它的原因”(§8.1);“平方税塑造后续十年”的谱系叙事(§8.3);“目标与指标错位与判分器簇同构”(§9.6);表外显存账(§6.1 补充)。
- 横向核实初核(2026-09-09):版本已核(v1 2017-06-12 → v7 2023-08-02,abs 页快照;v7 新增贡献脚注与转载许可声明——中间版日期未逐个核,登记);工件 tensor2tensor 已归档只读(2023-07-07,搜索快照确认;直连 github 超时未亲验,登记);内部一致性:§6.1 “41.0” vs 摘要/Table 2 “41.8” 不一致已登记(A 级证据);第三方:后续再评估 2406.15786(注意力层冗余/可剪,转述自搜索摘要未读原文)、Llion Jones 态度(Reddit 二手未核对原始访谈)、~268k 引用(Scholar 口径快照);统计审查:Table 2/3 点估计无区间(登记);引文元数据:He 2016(残差)/Ba 2016(LN)/Bahdanau 2014(加性注意力)为论文参考文献条目,出处与 PDF 参考表一致。
- 实验充分性评价:部分充分——对“翻译任务上递归可全换注意力”这一主张充分(两大基准+消融+成本对照);对“架构作为通用底座”的主张(摘要的 generalizes well + 后续历史角色)证据只到两个任务,剩下的由历史而非论文完成。
- 性能支撑目标检查:论文 goal 是“更快训练的更好翻译”——28.4/41.8 + 3.3e18 FLOPs 支持该 goal(点估计、无区间);对标题暗示的“一切”不构成支撑(论文自己的措辞也只到 transduction model 为止)。