0. 你为什么要学这个东西
你在各种地方见过”注意力机制”这个词。Attention、自注意力、多头注意力。所有这些花式名字的底层,全部依赖一个最基本的操作:拿两个向量,算出一个数。这个数告诉你”这两个东西有多相关”。
这个操作叫内积。
大多数教程教你内积的方式是:给你定义 q \cdot k = \sum_i q_i k_i,然后证一些性质,然后说注意力用了它。你记住了公式,但你不知道为什么偏偏是这个公式——如果有人问你”换个函数行不行”,你答不上来。
这门课不这样教。我们从零开始——不告诉你内积是什么,让你自己发明它。你先试一个方案,看着它出问题,然后修。修完又出新的问题,再修。到最后你手里的东西就是内积——但那时候你不会觉得”我记住了”,你会觉得”它就该是这个样子,别的都不对”。
前置只需要两样:向量(一列数字,方向表示意思)和高中代数。
1. 一句话,一个问题
读这句话:“the bank was steep”。
bank 是河岸,不是银行。你三岁就知道——你看到了 steep,一个和地形有关的词。你的大脑自动把 bank 的意思从”银行”调成了”河岸”。
现在让机器做同样的事。机器手里的全部材料:每个词一个向量。意思近的词,方向近。
机器要做的操作只有一个:bank 这个词要吸收句子里其他词的信息来更新自己。对每个候选词,算一个分数——分数越高,吸收越多。
翻译成数学语言:需要一个函数 s(q, k),其中 q 是 bank 的向量(提问方),k 是候选词的向量(被查方)。s 越高,吸收越多。
问题只有一行:这个分数怎么算?
停下来想 30 秒。你手里有两个向量。你想给它们的”关系程度”打分。
你会怎么做?
2. 最自然的想法,和它藏不住的三个毛病
最直觉的答案:合拍 = 距离近。两个向量越接近,越合拍。打分取 s = -\|q - k\|(距离越近分越高)。
试一下。取 bank 的向量 q = (2.0,\ 0.5),steep 的向量 k = (0.5,\ 2.0)。距离是 \sqrt{(2.0-0.5)^2 + (0.5-2.0)^2} = \sqrt{4.5} \approx 2.12。
换 the 的向量 k' = (1.8,\ 1.5)。距离 \sqrt{0.04 + 1.0} = 1.02。
等一下——the 离 bank 更近?the 是个虚词,和 bank 毫无关系。但它离 bank 更近,因为 the 的向量长度短,随便丢在哪里都离别的词不太远。
所以距离的第一个毛病暴露了:它被向量长度污染了。the 的向量短不是因为意思重要,是因为 the 这个词太常见所以向量被训练得比较短。长度和方向搅在一起,你分不开。
还有第三个问题。距离永远是正的——\|q - k\| \geq 0 永远成立。
但你需要的打分要能分出三个档:方向一致给正分,无关给零分,方向相反给负分。距离只能给”近 / 中 / 远”——它没有”反向”这个概念。“方向完全相反”和”有点不合拍”在距离里看起来一样(都是某个正数)——但你需要的区分恰恰在这里。
你可能会说:那就用 -\|q-k\|,取个负号不就有负分了?
可以。但你注意——不管加不加负号,距离都同时被长度和方向影响。把 bank 的向量放大一倍(q \to 2q,意思没变),距离就变了。打分器被一个和”意思合不合拍”无关的变量绑架了。
你可能会想:那就先归一化,把所有向量拉到单位长度再算距离。可以——但你会发现归一化后的距离和内积之间有一个固定的关系:|q-k|^2 = 2 - 2(q\cdot k)(当 |q|=|k|=1 时)。距离大小和负内积完全等价。所以你绕了一圈,还是回到了内积——只不过是从距离那边绕过来的。
到这里,你已经感觉到距离不太对。但”不太对”不够精确——我们需要一个更干净的工具来描述”什么才是好的合拍分”。
3. 把直觉翻译成约束
回到起点。你需要一个函数 s(q, k),给两个词的向量打分。它应该满足什么条件?
先把你能想到的要求列出来。一条一条来。
要求一(分量可加)。 每对分量的贡献合在一起就是总分。为什么?因为词向量将来会加入新维度(新的语义特征),旧打分不能被扰动——新特征直接累加就好。翻译成公式:
s(q, k) = \sum_{ij} M_{ij}\, q_i\, k_j
每个 M_{ij} 是一个配对权重——q 的第 i 个分量和 k 的第 j 个分量一起出现时贡献多少分。d=2 时展开:
s = M_{11}\,q_1 k_1 + M_{12}\,q_1 k_2 + M_{21}\,q_2 k_1 + M_{22}\,q_2 k_2
四个自由参数。你手里现在有一族函数,不是某一个特定的。
要求二(对称)。 合拍是相互的。bank 对 steep 的打分应该等于 steep 对 bank 的打分。翻译:M_{12} = M_{21}。四个参数砍成三个。
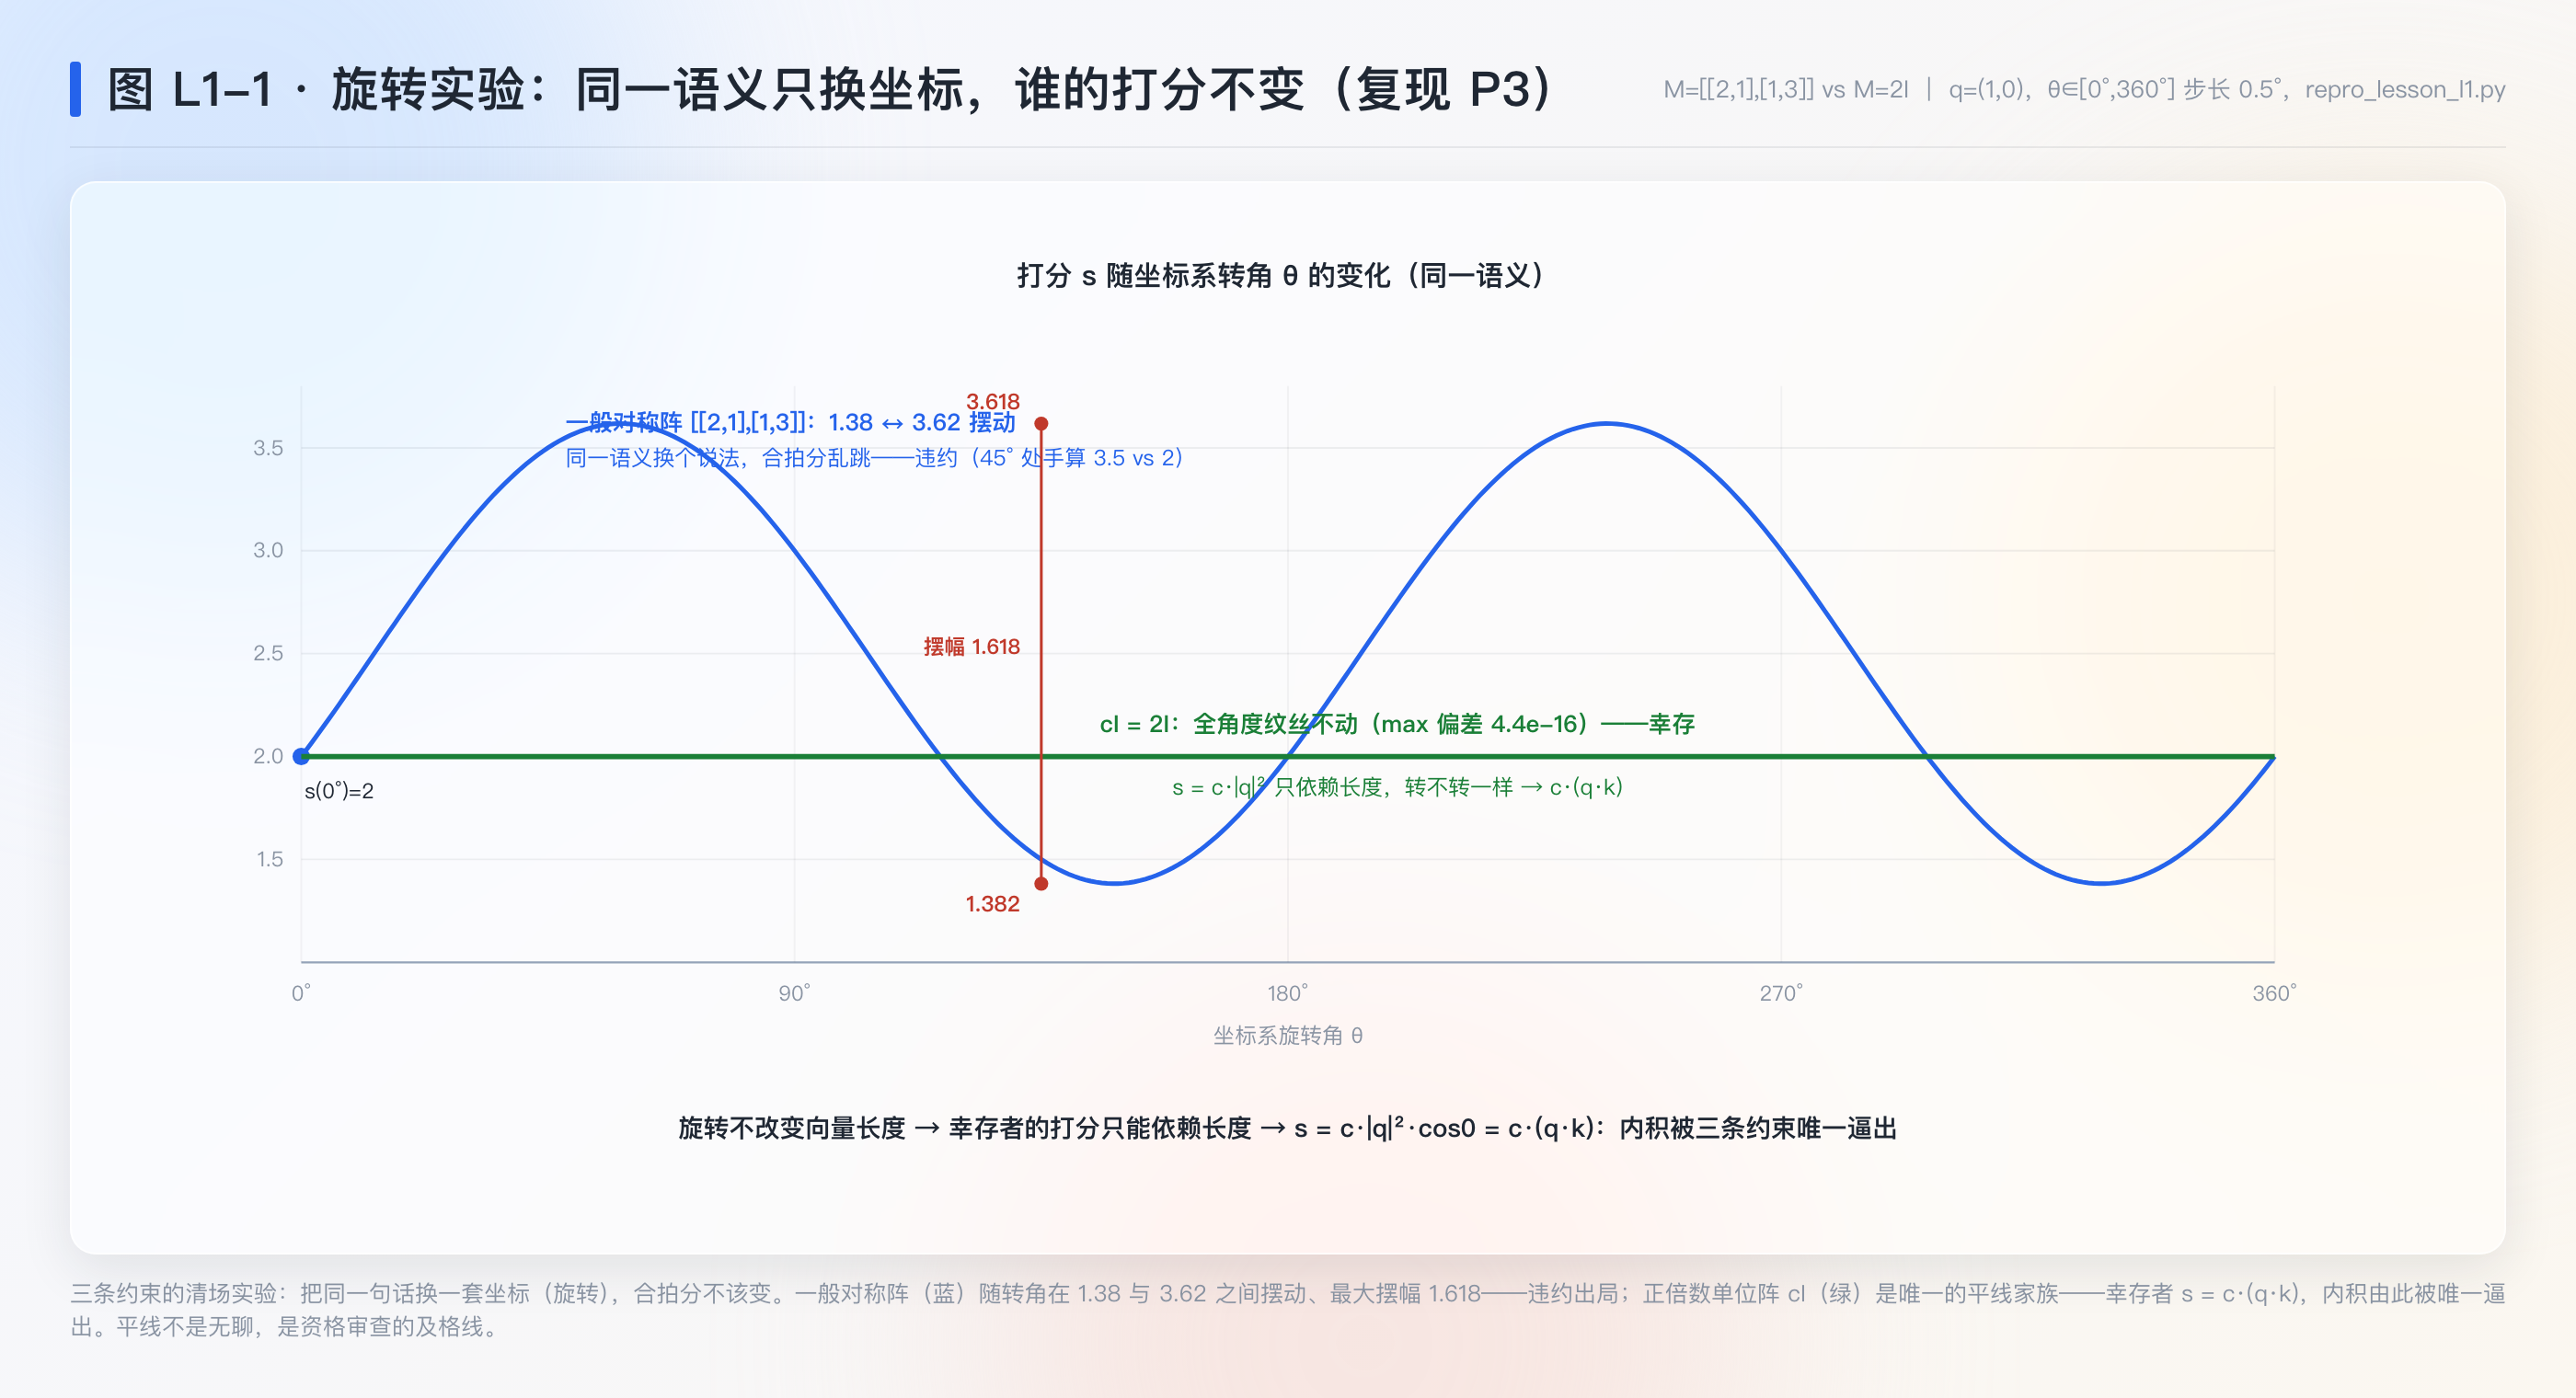
要求三(旋转不偏心)。 把全部词向量做同一个旋转——同样的意思,换一套坐标。打分规则不该变:原始词表里没有任何方向天生更重要。这条最难写成公式,但它约束力最强:它要求 M 在任何旋转下不变。数学上可以证明:唯一在所有旋转下不变的对称矩阵是 M = cI(对角线全是同一个数 c,其余全零)。
三条约束叠在一起,你的四参数函数被迫收缩成:
s(q,k) = c\,(q_1 k_1 + q_2 k_2)
推广到 d 维:s = c\sum_i q_i k_i。
内积不是候选里挑出来的,是三条约束唯一逼出来的。
常数 c 去哪了?后面的 softmax 只看分数之间的差(L3 讲为什么),尺度被 W^Q 吸收。所以 c 可以约掉。
更深的回响:学习 W^Q 和 W^K 恰恰是有针对性地放弃要求三——起点是朴素内积(无特权方向),训练把打分矩阵从 cI 拉成 W^{Q\top}W^K,即学出”哪些旋转后的子空间值得合拍”。多头 = 一次学几个子空间。
4. 分数到手,但还不是概率
内积给了一个数——可正可负、可大可小。但你要的不是评分,是配比:每个候选词分到多少比例的吸收权重,总和等于一。
直觉修法一:除以总和。死——分数可负,总和可能是零。
直觉修法二:取绝对值再归一。死——方向信息全丢(“反着拍”和”合拍”被强行同权)。
两个修法死了。你手里的约束自己浮出水面:
- 非负——配比不能是负数
- 总和为一——份额加起来是一
- 保序——分高的吸收多
- 可调——分差小接近均摊,分差大接近独占
先指数(全部变正、拉开差距),再归一(压成份额)。指数+归一恰好同时满足四条——而且后面会看到(L3/L4),指数的陡峭程度本身就是可以调的旋钮。
p_j = \frac{e^{s_j}}{\sum_k e^{s_k}}
这就是 softmax。这里你不需要它的全部性质——只需要知道:它把任意实数分数转换成了合法的概率配比,而且是满足上述四条约束的最自然方式。
5. 合体
把前面的所有零件串起来:
投影(读法一):Q = XW^Q、K = XW^K、V = XW^V
打分(读法二):QK^\top/\sqrt{d_k}——一次算完全部配对
归一:softmax 逐行变份额
取回:A \cdot V——按配比混合内容
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\Big(\tfrac{QK^\top}{\sqrt{d_k}}\Big)V
你从”bank 怎么知道自己是河岸”这个三岁小孩的问题出发,发明了整个注意力的核心公式。
6. 遗留的问题
你手里有一台能算的机器。但它有两个问题本课没有回答:
第一,\sqrt{d_k} 这个除数——你已经知道分数的方差随维度增长(因为每一对分量的贡献在独立累加),但为什么除以 \sqrt{d_k} 恰好能修——这需要”方差”这个工具,下一课的全部内容。
第二,位置——你的机器看得见”谁在场”,看不见”谁在第几个”。“the dog bites the man”和”the man bites the dog”在它眼里一样。位置编码怎么修这个——那是 L4 的事。
7. 练习
- 取 q = (2.0, 0.5)、k = (0.5, 2.0)。算 q\cdot k。然后把 q 换成 -q,再算一次——你得到了一个负数。解释为什么负分对打分器是必要的。
- 三条约束里去掉”对称”(M_{12} \neq M_{21}),打分器会多出什么能力?你会愿意用这个不对称的打分器吗?
- 如果词向量的每个分量的方差是 4 而不是 1,\mathrm{Var}(q\cdot k) 变成多少?
8. 下一课
下一课处理 \sqrt{d_k} 后面那个问题——为什么维度一大分数就失控,以及 \sqrt{d_k} 怎么把它修好。你需要的新工具只有一个:方差。
(汇编说明:素材汇编自研究轨 T1/T2/T5 实验日。断言见随课脚本可独立重跑。)