0. 从一个问题开始
你刚写了一个极简的语言模型:一个词的向量
x,乘一个矩阵 W,得到分数
s,过 softmax 变成概率,和正确答案比一下交叉熵,得到
loss。你按下回车,Adam 开始更新 W 里的一万多个参数。
然后你停下来问了一个问题:
Adam 怎么知道每个参数该往哪挪?
你可能会说:“梯度啊,框架自动算的。”没错。但这一课我们不按”自动”——我们把”梯度是什么、怎么来的、为什么是这个数”从零推出来,然后亲手实现它,最后用一种不可能出错的方法验证我们没推错。
前置只需要两样:矩阵乘法(L2 的”给每个词过同一台机器”)、softmax(L3 的”分数变份额”)。就这样。
1. 最笨的办法:一个参数一个参数地试
你有一个函数 loss(W)——把 W
里的一万个数字全换了,loss 就变了。你想知道:如果把 W
里某个数字 w 挪一点点,loss 会往哪边走、走多快?
最笨的办法:挪一下,看看。
把 w 加 \epsilon = 0.000001,跑一遍前向,记下 \text{loss}_+。再减 \epsilon,跑一遍,记下 \text{loss}_-。两个一减除以 2\epsilon:
\frac{\partial L}{\partial w} \approx \frac{\text{loss}(w+\epsilon) - \text{loss}(w-\epsilon)}{2\epsilon}
这就是有限差分。它的好处只有一个:不可能错。它不依赖任何推导、任何记忆、任何”我以为”——它就是把参数真的挪了一下然后量了量。坏处也只有一个:每个参数要跑两遍前向。一万个参数就是两万遍前向。训练一千步就是两千万遍前向。
所以有限差分不是训练工具——它是裁判。我们用它来验证下面推出来的快速公式有没有推错。这个顺序很重要:先跑笨的,再写快的,最后对拍。
2. 第一站:线性层的梯度
从 loss 到 \delta。 假设你已经知道 loss 对线性层输出 y 的梯度是 \delta(一个和 y 同形状的向量——下一节会讲这个 \delta 怎么来的)。现在要把它穿过线性层 y = xW,变回对 W 的梯度。
先想清楚每个数的形状:x 是 1\times d(一个词的向量),W 是 d\times k(把 d 维映到 k 维),y 是 1\times k,\delta 也是 1\times k。
W 里面第 (i,j) 个数字 W_{ij} 的梯度是什么?y 的第 j 个分量 y_j = \sum_a x_a W_{aj}——只有 x 的第 i 个分量乘了 W_{ij}。所以:
\frac{\partial L}{\partial W_{ij}} = x_i \cdot \delta_j
每一个参数的梯度 = 那个参数的”输入侧分量”乘以”输出侧梯度”。 把所有 (i,j) 合在一起写:
\frac{\partial L}{\partial W} = x^\top \delta
x 转置后是 d\times 1,\delta 是 1\times k,乘出来 d\times k——形状和 W 一样。这不是巧合:梯度的形状和参数的形状永远一样(不然 Adam 不知道往哪儿加)。
数值验证。 取 x = (0.5, -1.2, 2.1),W 是 3\times 4 的随机矩阵,\delta = (0.3, -0.8, 1.5, 0.1)。手写 x^\top\delta 得到一个 3\times 4 矩阵;有限差分逐个扰动 W 的 12 个 entry 得到另一个 3\times 4 矩阵。两个矩阵逐位差 2.06\times 10^{-10}(P1,repro_t6_backprop.py)。
注意:这里 \delta 是”别人给你的”——它从 loss 沿着计算图倒着传到你这一站。至于 \delta 本身怎么来的,取决于你的下一站是什么。最常见的下一站是 softmax + 交叉熵——那就是下一站。
3. 第二站:softmax + 交叉熵 = 多退少补
这一站要回答:loss 对 softmax 的输入分数 s 的梯度是什么?
先写 forward。softmax 把分数变成概率:
p_j = \frac{e^{s_j}}{\sum_k e^{s_k}}
交叉熵取正确类别的负对数:L = -\ln p_y,其中 y 是正确答案的下标。
梯度 \partial L/\partial s_k——对每一个 s_k 求导,不只是正确类。这比线性层复杂,因为 softmax 的输出是耦合的:改变 s_1 会影响所有 p_j。
但结果出奇地简洁:
\frac{\partial L}{\partial s_k} = p_k - \mathbb{1}[k = y]
你的概率减你的目标。 多了就退,少了就补——只差一个符号的方向。推导两步:
第一步,当 k = y(正确类):\partial L/\partial s_y = \partial(-\ln p_y)/\partial s_y = -(1/p_y) \cdot \partial p_y/\partial s_y。而 \partial p_y/\partial s_y = p_y(1 - p_y)(softmax 的对角导数),代入得 -(1/p_y) \cdot p_y(1-p_y) = -(1-p_y) = p_y - 1。
第二步,当 k \neq y:\partial p_k/\partial s_y = -p_k p_y(softmax 的 off-diagonal 导数),代入得 -(1/p_y)(-p_k p_y) = p_k。
合并:正确类 p_y - 1,其他类 p_k - 0——恰好就是 p - y。机器对拍:1.75\times 10^{-10}(P2)。
这张卡的实践价值:下次你在框架里写
nn.CrossEntropyLoss 时,你知道它内部帮省掉的梯度就是
p - y——一个”多退少补”的分配器。它的简洁不是巧合:交叉熵是
softmax 的”原生损失”,数学上天生配套。
4. 第三站:tanh 的梯度藏在 forward 里
tanh 出现在非线性激活站:t = \tanh(x),上游梯度 \delta。导数:
\frac{d\tanh}{dx} = 1 - \tanh^2 x = 1 - t^2
梯度 dL/dx = (1-t^2)\cdot\delta。对拍:1.05\times 10^{-10}(P3)。
\frac{\partial L}{\partial x} = (1 - t^2)\,\delta
注意一个细节:公式里用的是 t(tanh 的输出),不是 x(tanh 的输入)——反传不重算前向。前向跑的时候顺手存一下 t,反传直接用。这就是”记账”的精确含义:forward 不是只算 loss,它同时在给 backward 记账(每个中间量都存着)。
5. 整线:把三张卡串成式 (1) 的完整反向传播
现在把 L1-L3 造的注意力块整线反传一遍。前向五站:
| 站 | 运算 |
|---|---|
| ①投影 | Q = XW^Q, K = XW^K, V = XW^V |
| ②打分 | S = QK^\top/\sqrt{d_k} |
| ③归一 | A = \mathrm{softmax}(S) |
| ④取回 | Z = AV |
| ⑤预测 | loss = -\log\,\mathrm{softmax}(Z_0)[y](只取首行) |
反向从 ⑤ 开始倒着走。
⑤→④(末端 softmax-CE):这张卡已经在第 3 节推过——dL/dZ_0 = pz - e_y。只有首行有梯度(loss 只看首行),其余行是零。
④→③(softmax 反传):这一站的输入是 S,输出是 A。上游梯度是 dA(和 A 同形状)。softmax 的雅可比在对角化的内积形式下:
dS_i = A_i \odot \left(dA_i - A_i \cdot \sum_j dA_{ij}\right)
(\odot 为逐位乘,横线为行内平均——这就是”不构造雅可比”的内积作用形式。)
③→②(打分反传):S = QK^\top/\sqrt{d_k}。dS 有了,要拆回 dQ 和 dK。对 dQ:dL/dQ_{it} = \sum_j dS_{ij}K_{jt}/\sqrt{d_k}——矩阵形式 dQ = dS \cdot K/\sqrt{d_k}。同理 dK = dS^\top \cdot Q/\sqrt{d_k}。注意两个乘法的第二个矩阵不同——一个乘 K、一个乘 Q,不是对称操作。
②→①(投影反传):每站用第一张卡的结论——dW^Q = X^\top dQ 等。
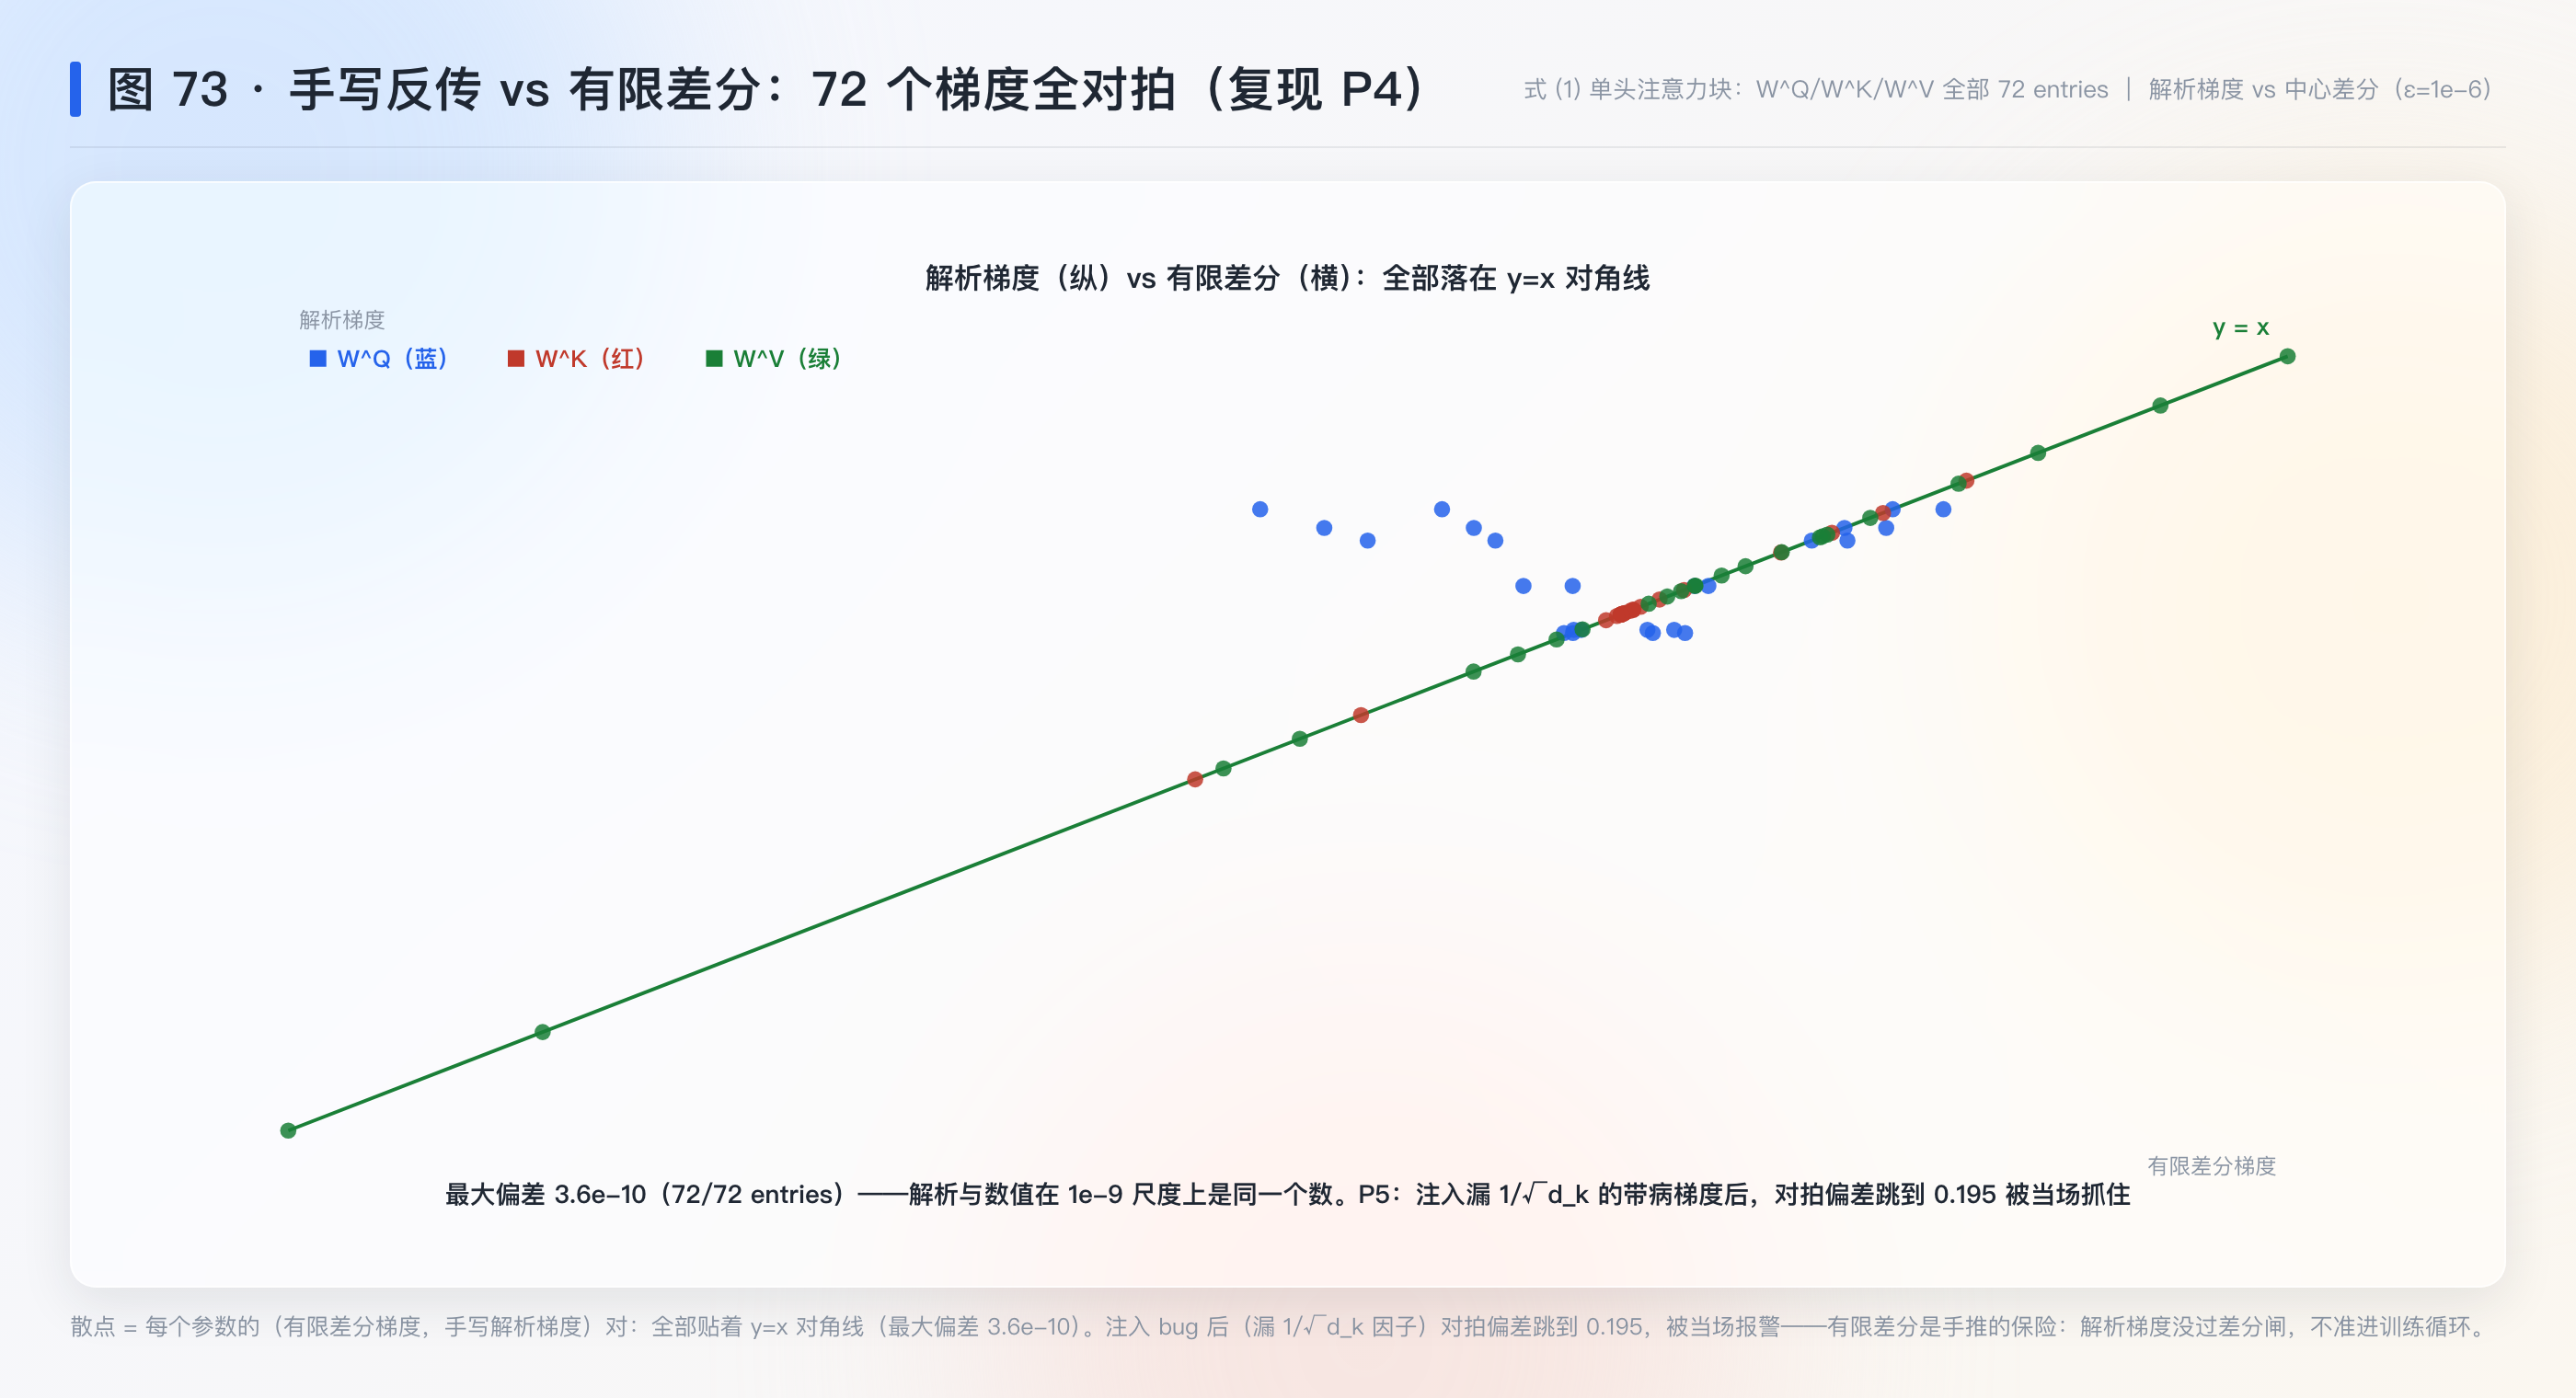
全部写完(P4):W^Q、W^K、W^V 共 72 个 entry 的解析梯度 vs 中心有限差分,最大偏差 3.6\times 10^{-10}。整线的梯度不是一个公式——是五站簿记的链式合力。
6. 对拍器抓 bug:手推的保险
有限差分的真正价值不在于”算得准”——它慢得没法用于训练。它的价值在于:你手推的公式有没有推错,它一测便知。
演示:故意在 dS→dK 的回传里漏掉 1/\sqrt{d_k} 因子(一个真实世界频率最高的手推 bug——它和 L3 的缩放数学纠缠,极易漏)。带病梯度 vs 有限差分:最大偏差 0.195——对拍器当场报警(P5)。
没有对拍,这个 bug 会安静地让训练”能跑但效果差”——最难查的一类错误,因为你不知道你的梯度是错的,你只知道你的模型不好。工作法固化为:每写一个解析梯度,先写它的有限差分裁判;对拍通过才准进训练循环。
7. 三站的合并:一条式子
反向五站可以合并成一条式子(正向前向的镜像):
\text{dLogits} \to \text{d}Z \to \text{d}A \to \text{d}S \to \text{d}Q,\text{d}K,\text{d}V \to \text{d}W^Q,\text{d}W^K,\text{d}W^V \to \text{d}X
这条链上没有新的数学——只有三张卡在各站的重复使用。反向传播不产生任何在 forward 中不存在的依赖——它只是把 forward 的依赖关系倒过来遍历一遍。这就是”反传不是魔法是簿记”的精确含义。
8. 一条重要的纪律:有限差分是保险,不是装饰
对拍器的价值在本课 P5 已经演示——它抓住了手推的 bug。但它的另一个价值容易被忽略:它给了你信心去写复杂的手写梯度。没有对拍,你会倾向于避免写复杂模块的梯度(因为怕错)——你的架构设计会被”我敢推敢写哪些梯度”限制住。有了对拍,你可以放心写任何梯度——推错了裁判会告诉你。
T9 的微缩 GPT 全程用这套纪律:全模型随机 6 参数抽检,最坏相对偏差 1.75\times 10^{-6}。
9. 练习
- 推线性层的输入梯度 \partial L/\partial x = \delta W^\top(提示:y 的第 j 个分量 = \sum_a x_a W_{aj}。对 x 的第 i 个分量求导时,W 的哪些列参与了?)
- softmax 雅可比 \partial p_i/\partial s_j = p_i(\delta_{ij} - p_j):当 i = j 时是 p_i(1-p_i);当 i \ne j 时是 -p_i p_j。解释为什么”对角线是自己的方差、非对角线是负协方差”——softmax 是一个把不确定性从一个类转移到另一个类的零和系统。
- 在 P5 的 bug 基础上再改一步:如果 dQ 也漏了 1/\sqrt{d_k}(即 dQ = dS \cdot K 不除),bug 的偏差会变大还是变小?先猜再验。
10. 下一课预告
L6 到此,注意力的”怎么算”和”怎么学”都齐了。还剩最后一块:句子里的词序从哪里进来——注意力的结构对词序天然失明(置换等变),需要把”第几个词”这一信息从外部注入。正弦位置编码的三角函数与旋转矩阵,是 L7 的全部内容。
(汇编说明:本课素材汇编自研究轨 T6 实验日,随课脚本 repro_t6_backprop.py 独立重跑,完整输出同目录 txt。)