外行导读(先读这个,再决定要不要进正文)
一个场景:你让 AI 助手替你干一件要四十分钟的活:上网下资料、进文档排版、导出 PDF。它一路都”说”自己干完了,最后交上来的文件却缺了一条引用——中途改样式时误删的,可它的账上还记着”引用已写入、已完成”。长程任务里,agent 的上下文塞满了几十条”文件已保存”“样式改好了”这样的观察,哪些是真完成、哪些只是它当时以为真,它自己分不清;分不清,下一步就押在错的账上。
这篇论文干的事:给 agent 发一本带生命周期的任务账,让它凭账干活,不凭记忆干活。每条需求记账带三态标签——待办、已验证、已作废;改账只有一种合法方式,拿验证凭证改,而且优先用确定性”探针”(查文件、查来源、重算数字)而不是听执行者自述;已完成的成果被后来的操作推翻,账上标作废并留原因;说”做完了”只算提案,审计员拿着证据链从零复核;失败了先归因到角色再决定怎么修。整个框架推理时搭、不训练模型;在 OSWorld-Verified 这个真实电脑操作基准上,小模型档的提升稳稳过显著线,强模型档的提升则小到噪声以内。
为什么值得关心:它治的是一切”边干边变、靠反馈记账”的系统的通病。只要你的系统要在动态世界里维护”什么已经完成”的判断,就躲不开三件事:完成可能过期、证据可能造假、重试可能帮倒忙。这本账的三条纪律——验证后才记账、作废不撕页、完成是提案不是结论——搬到任何记录系统上都成立。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 任务状态三元组 | 账本记三样:最小充分的需求集、干活途中的中间值、已验证的证据 |
| Pending / Verified / Invalidated | 待办 / 拿凭证验证过 / 曾经验证过但后来被推翻(作废不撕页) |
| 探针(probe) | 对环境的确定性检查——查文件内容、查来源 URL、重算数值,仪器读数而非目测 |
| VerifySpec | 一张化验单:查哪条需求、用哪个探针、参考值是什么 |
| 双级验证 | 干活中每步快查一遍(低层);里程碑处再把证据链整体复核(边界) |
| 证据链 | 每条”完成”挂着依据,依据还挂着依据,可一路溯源到原始测量 |
| fresh eyes | 完成审计员不带干活的思路进场,从零对着账与证据重查 |
| advice vs task truth | 记忆存”这类事怎么做”;“这件事做到哪了”只许进状态账 |
| OSWorld-Verified | 真实电脑操作基准的修订评分版,本篇的主基准 |
§0 承接栏
这篇接的是上一课 LH 留下来的一个根本问题:任务状态外置之后,状态本身的生命周期怎么管? LH 给了半个回答——“状态只用环境里核实过的事实来更新”——但没说清状态的”生老病死”:一条记录从被创建、被验证到被推翻,完整的生命周期怎么建模。这篇来还这笔账:给状态加三态生命周期(Pending/Verified/Invalidated),配双级验证和撤销复查。到这里,执行侧两篇(LH + SA)的”状态中心 + 验证式推进”骨架搭完。
一、论文在解决什么问题
1.1 一个具体场景
你让 agent 替你做任务 T(BibTeX → Writer 排版 → PDF):从 arXiv 下载三篇论文的引用,写进文档、排好版、导出 PDF。它打开浏览器搜论文,下了一个 .bib 文件;打开 Writer 建文档,贴进去发现格式乱了;改样式时误存了一次半成品;回头重新下载第二篇……四十分钟后你过去查看,它的上下文里有几十条观察(“文件已保存”“页面加载完成”“样式改好了”),其中有几条是真的、几条只是它当时以为真——而它自己无从分辨。
此刻三个麻烦逐一登场(§1):
- 剩余工作难推理。哪些需求已满足、哪些还悬着,散在几万 token 的历史里。模型要决定”下一步干什么”,就得先”考古”整个上下文——考古会漏、会错、越长越难(这正是 LH 说的上下文腐烂,两篇在这里会师)。
- 中间假设被当成已完成。上下文里那句”样式改好了”是执行器当时的一句观察。观察不等于事实:可能只改了选中段落,可能改完又被后续操作覆盖。后续步骤把这句观察当事实用,错误就沿着”假设→当作事实→当作前提”链条放大——这与 LH 的”自评偏差”是同一个病,本文把它更精确地叫做”观察出的已完成不等于真完成”(§2.3)。
- 失败后无从恢复。要么从头重放整个轨迹(贵、且会重复踩坑),要么在污染的上下文里继续错下去。
1.2 对两条已有路线的批评
§1 各打了一刀:
- 纯 workflow 结构(固定分解、扁平进 prompt):结构有了,但”不知道已完成什么、剩余什么”——没有状态语义的工作流是空转的骨架。失败时把原始历史折叠压缩(context folding 一类),仍然缺”当前任务状态”这一层表示,且部分完成与错误假设照样留在折叠结果里污染推理。
- agent memory:记忆保存的是可复用知识(怎么做这类事),不是本任务的当前事实(这件事做到哪了)。两者的区别本文用一句话钉死:记忆是 knowledge,不是 task state;而且观察得来的建议带操作风险(§2.3)——错误建议被执行,比没有建议更糟。
结论一句话:state 才是长程 workflow 的中心(§1)——workflow 要成为可泛化的骨架,前提是 agent 维护一个足够丰富的状态。
1.3 与 LH 的入口差
LH 从”自评偏差”进(干活的人不能自己裁决完成),本文从”状态表示”进(没有一张带验证状态的账)。两个入口撞在同一面墙上——跨步一致性由什么承载。差别在后续:LH 造的是角色(管理者/执行者/审计者),本文造的是账本本身的结构(记录长什么样、怎么生、怎么死)。这个差别会在 §八 的对照表里逐行兑现。
二、核心想法
一句话:把”长征程执行”理解为”维护一张带因果生命周期的任务账”。
这个理解往深一层想,之所以能收拢 §一 的三个麻烦,是因为它把每一步决策的输入从”整个执行历史”换成了”账本本身”:剩余工作难推理,是因为要在几万 token 里考古——账在,“还欠什么”直接读账;中间假设被当成已完成,是因为观察和事实没有区分——账带验证标签,两者从此分属两栏;失败后无从恢复,是因为账只会加不会减——账可撤销,推翻就不再是静默事故。
先打个比方。工地施工有一本施工日志:哪道工序验收过、哪道被后来的返工推翻了、哪道还没做。工头安排下一道工序看日志,不看工人昨天说过什么。验收要有凭证(实测、复量),不是听工人说”干完了”。返工不撕日志,划掉并注明原因。
再把比方译回工程语言。agent 也需要这本账。账上每条记录 = 一条需求 + 它当前的生命周期;改账只有一种合法方式——拿着验证凭证改;账要能”销账”(后面把前面推翻了,前面的要标失效);安排下一步看账,不看执行历史。
落到形式上,账本是一个三元组状态(§3.1,Figure 3):
s_t=\left(s^{\text{req}}_t,\ s^{\text{val}}_t,\ s^{\text{ver}}_t\right)
- s^{\text{req}}:需求集。注意论文的措辞是 minimum sufficient 的需求集合(§3.1)——不是把任务书全文抄进去,是抄”做对下一步决策所需的最小充分子集”。示例任务 T 的任务书可能有一页纸,但 s^{\text{req}} 只需要五条(下文 3.1 逐条列)。为什么最小?账越短,planner 每轮读的上下文越小、越不易腐烂;“最小充分”的严格含义在 §6.5 用充分统计量讲。
- s^{\text{val}}:有用值——解决需求途中的”参数”。示例里:.bib 文件的路径、三篇论文的 arXiv 编号、Writer 文档的文件名、导出 PDF 的目标路径。它们不是需求,是需求之间传递的中间产物。
- s^{\text{ver}}:已验证证据——对部分完成的监控测量与 verifier 判定的审计记录,组织成 evidence chains(证据链:一个验证结果的依据是另一些验证结果)。
账本上每条记录带一个生命周期标签:
\sigma_i \in \{\text{Pending},\ \text{Verified},\ \text{Invalidated}\}
两条记账纪律(§3.5、§3.6):
- 只有 verifier-backed 的判定能改账(推进到 Verified,或撤销到 Invalidated);
- Invalidated 不删除——保留因果记录,供诊断和后续避免。
工作流五个机制全部从账本长出来(§3.7–3.11):状态接地的规划、可复用工作流记忆、检查点/恢复、证据驱动的完成判定、定向失败恢复。下面 §三 逐个拆开,每个都拿示例任务 T 走。
所以这篇真正改变的是什么:它把”长程 agent 不可靠”从”上下文不够长、模型不够强”重新形式化成了账本质量问题——缺一张带验证状态的账。问题一旦落在账本上,“账怎么生、怎么死、怎么验”就有了明确的工程答案(§五),状态也就第一次逼近”对未来的充分统计量”(详见 §六 的”状态作为充分统计量”一节)。
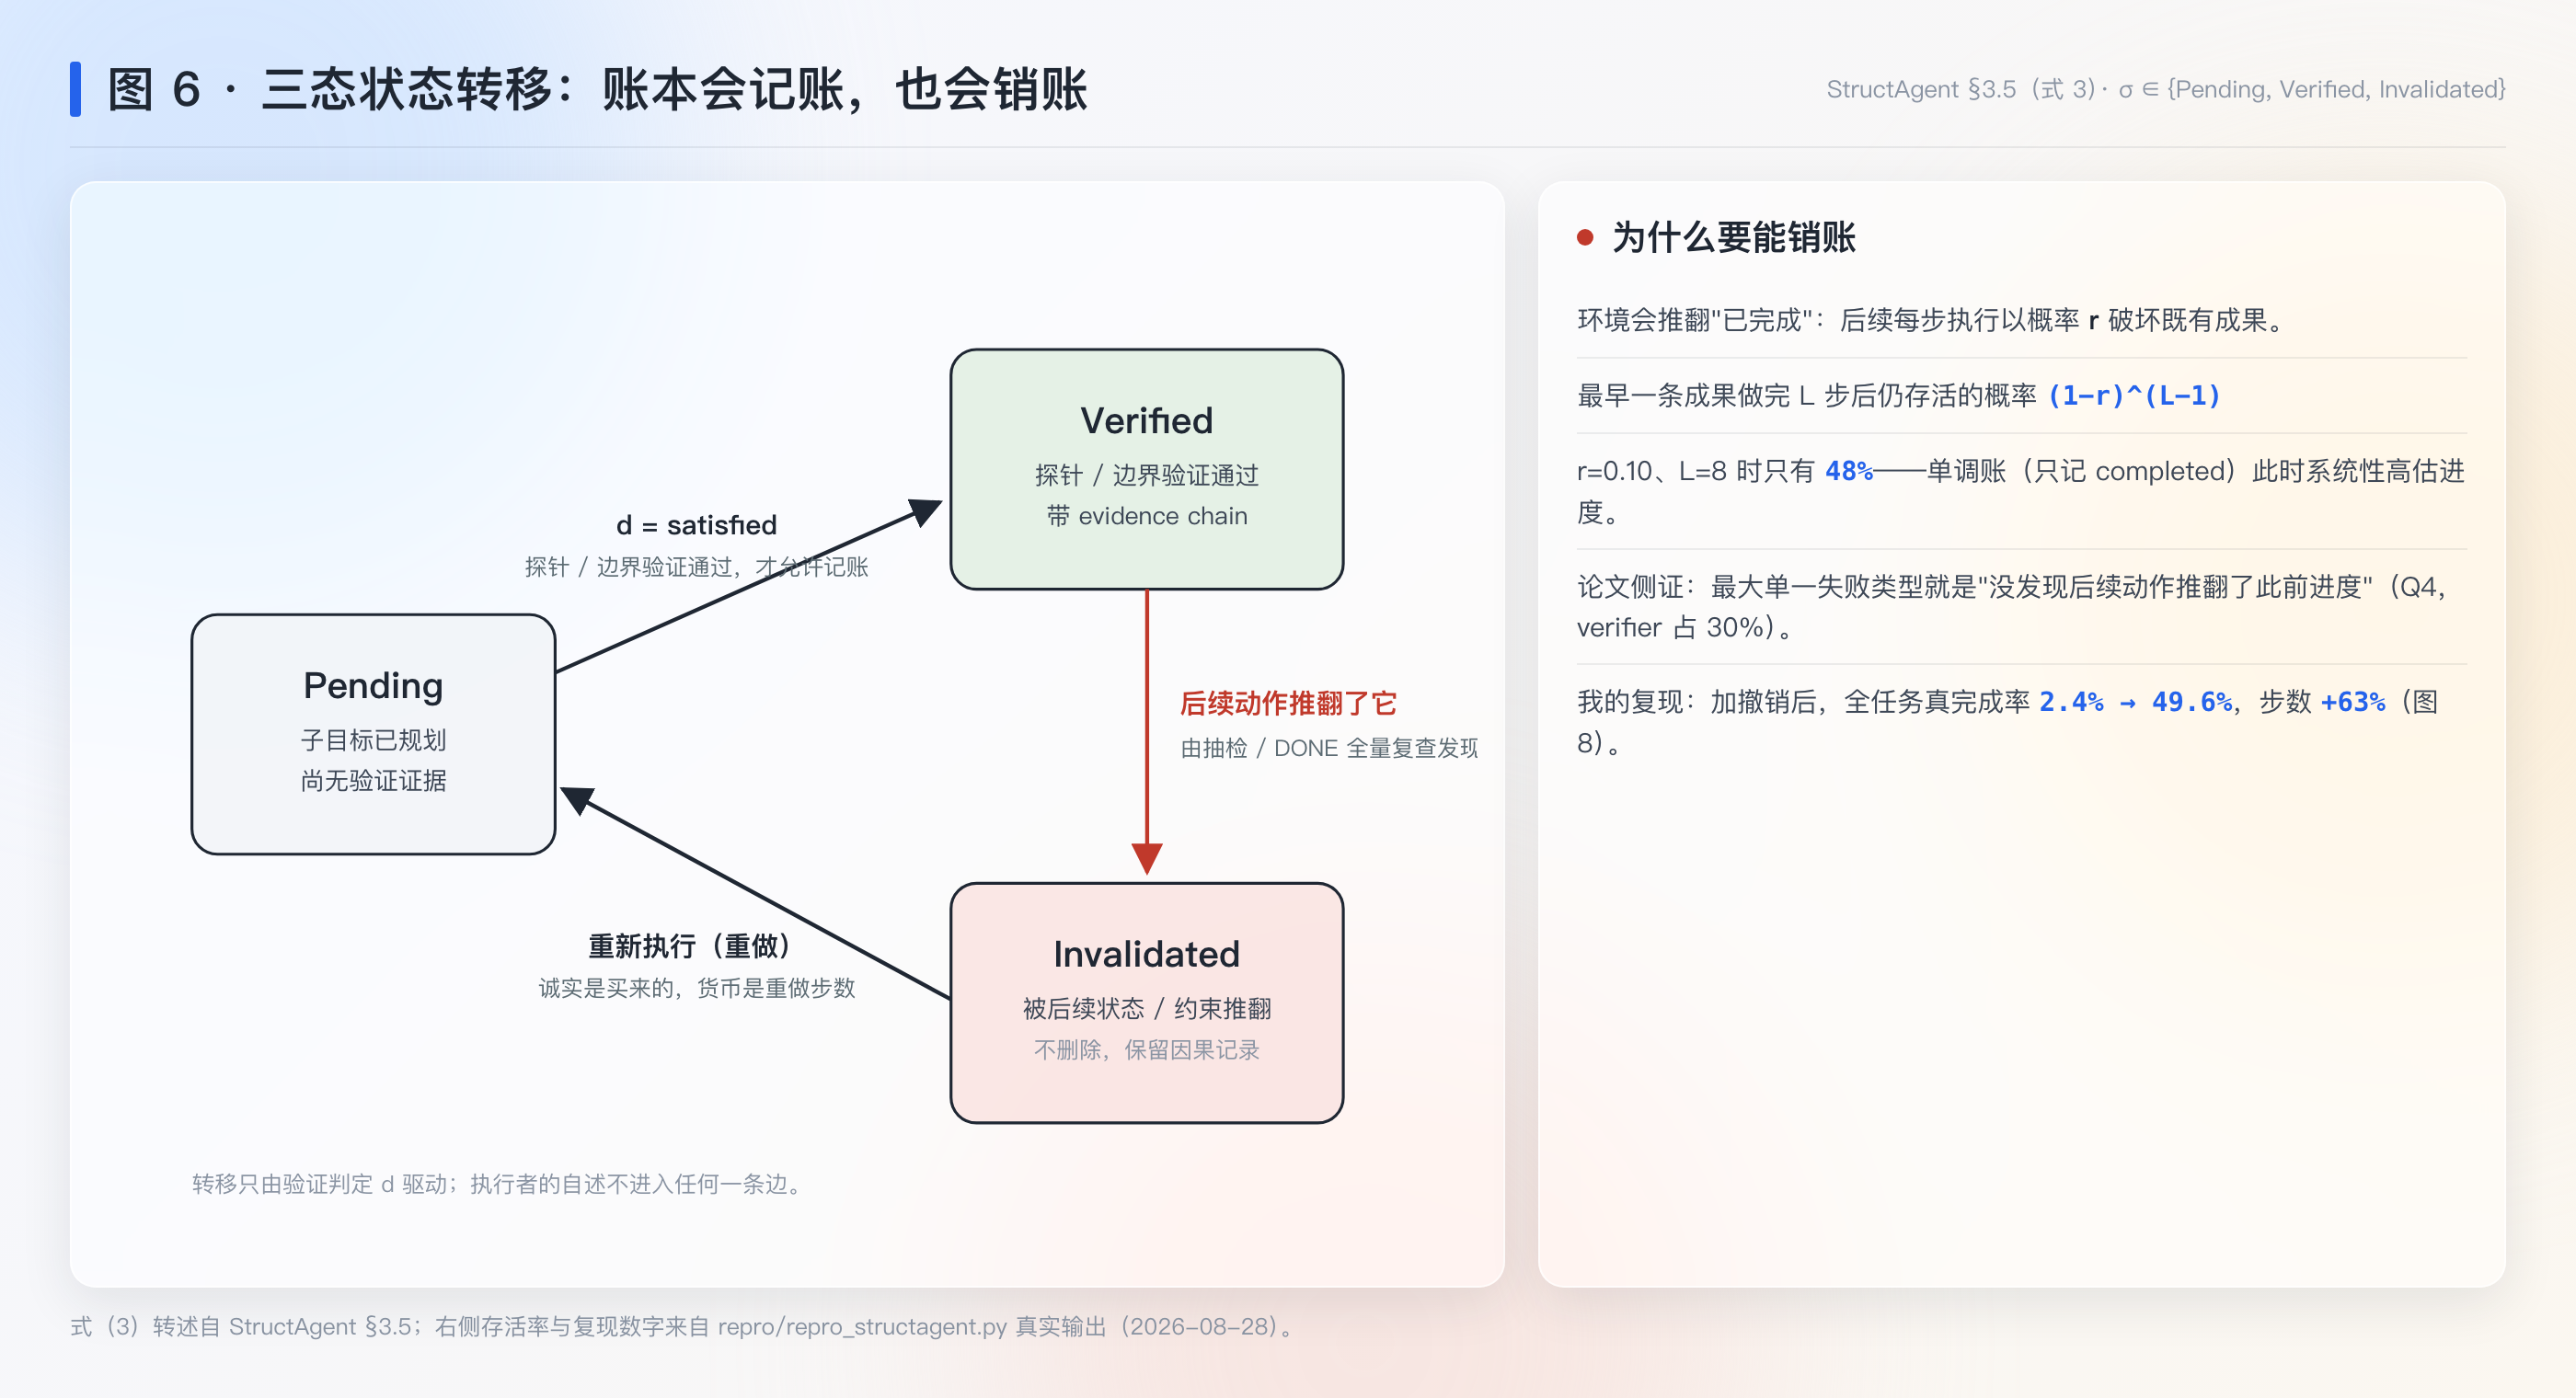
全篇就看这张:图 6(§十)——三态状态转移:advice(待验)/ truth(已验)/ invalidated(被推翻)三态与它们之间的迁移条件,账本纪律的形式化核心;图 7–8 是它的实测证据。 ## 三、数学基础(零起点,本篇新用到的四件)
概率基础(频率、条件概率、贝叶斯、期望与几何级数、马尔可夫性)已在 LH 精读的 §五 从零铺过(第一篇精读),那里有手算数字,这里不重复。本篇新用到四件工具,每件从零讲起、全部配手算——先说清为什么需要它,再给定义与公式,公式看不懂先回这里。
3.1 级联检验:先跑灵的仪器,再用人眼
第一件工具叫级联检验。这本账的核心纪律是”验证后才记账”,所以先得回答:验证靠什么?本篇的答案是两套人马编成一队——一套是确定性探针,快、几乎不出错,但不是时时处处适用;一套是观察判断,慢、会看走眼,但哪里都能上。怎么编队才不糟蹋两边的长处?机场安检给了现成的模板:先过金属探测门(快、几乎不误报),门响了才人工开箱(慢、会看走眼)。这就是级联检验:先用高特异性的检验,阳性或无法判定时才用低特异性的检验。
数学。设第一级(探针)以概率 p_d 适用:适用时确定性(不误报、不漏报);不适用时整个判定落到第二级(观察),观察通道误报率 \mathrm{fp}_o、漏报率 \mathrm{fn}_o。那么整个级联的误报率:
\mathrm{fp}_{\text{cas}}=\underbrace{p_d\cdot 0}_{\text{探针适用:误报为零}}+\underbrace{(1-p_d)\,\mathrm{fp}_o}_{\text{回退观察}} =(1-p_d)\,\mathrm{fp}_o
漏报同理:\mathrm{fn}_{\text{cas}}=(1-p_d)\,\mathrm{fn}_o。两个误差同乘 (1-p_d)。
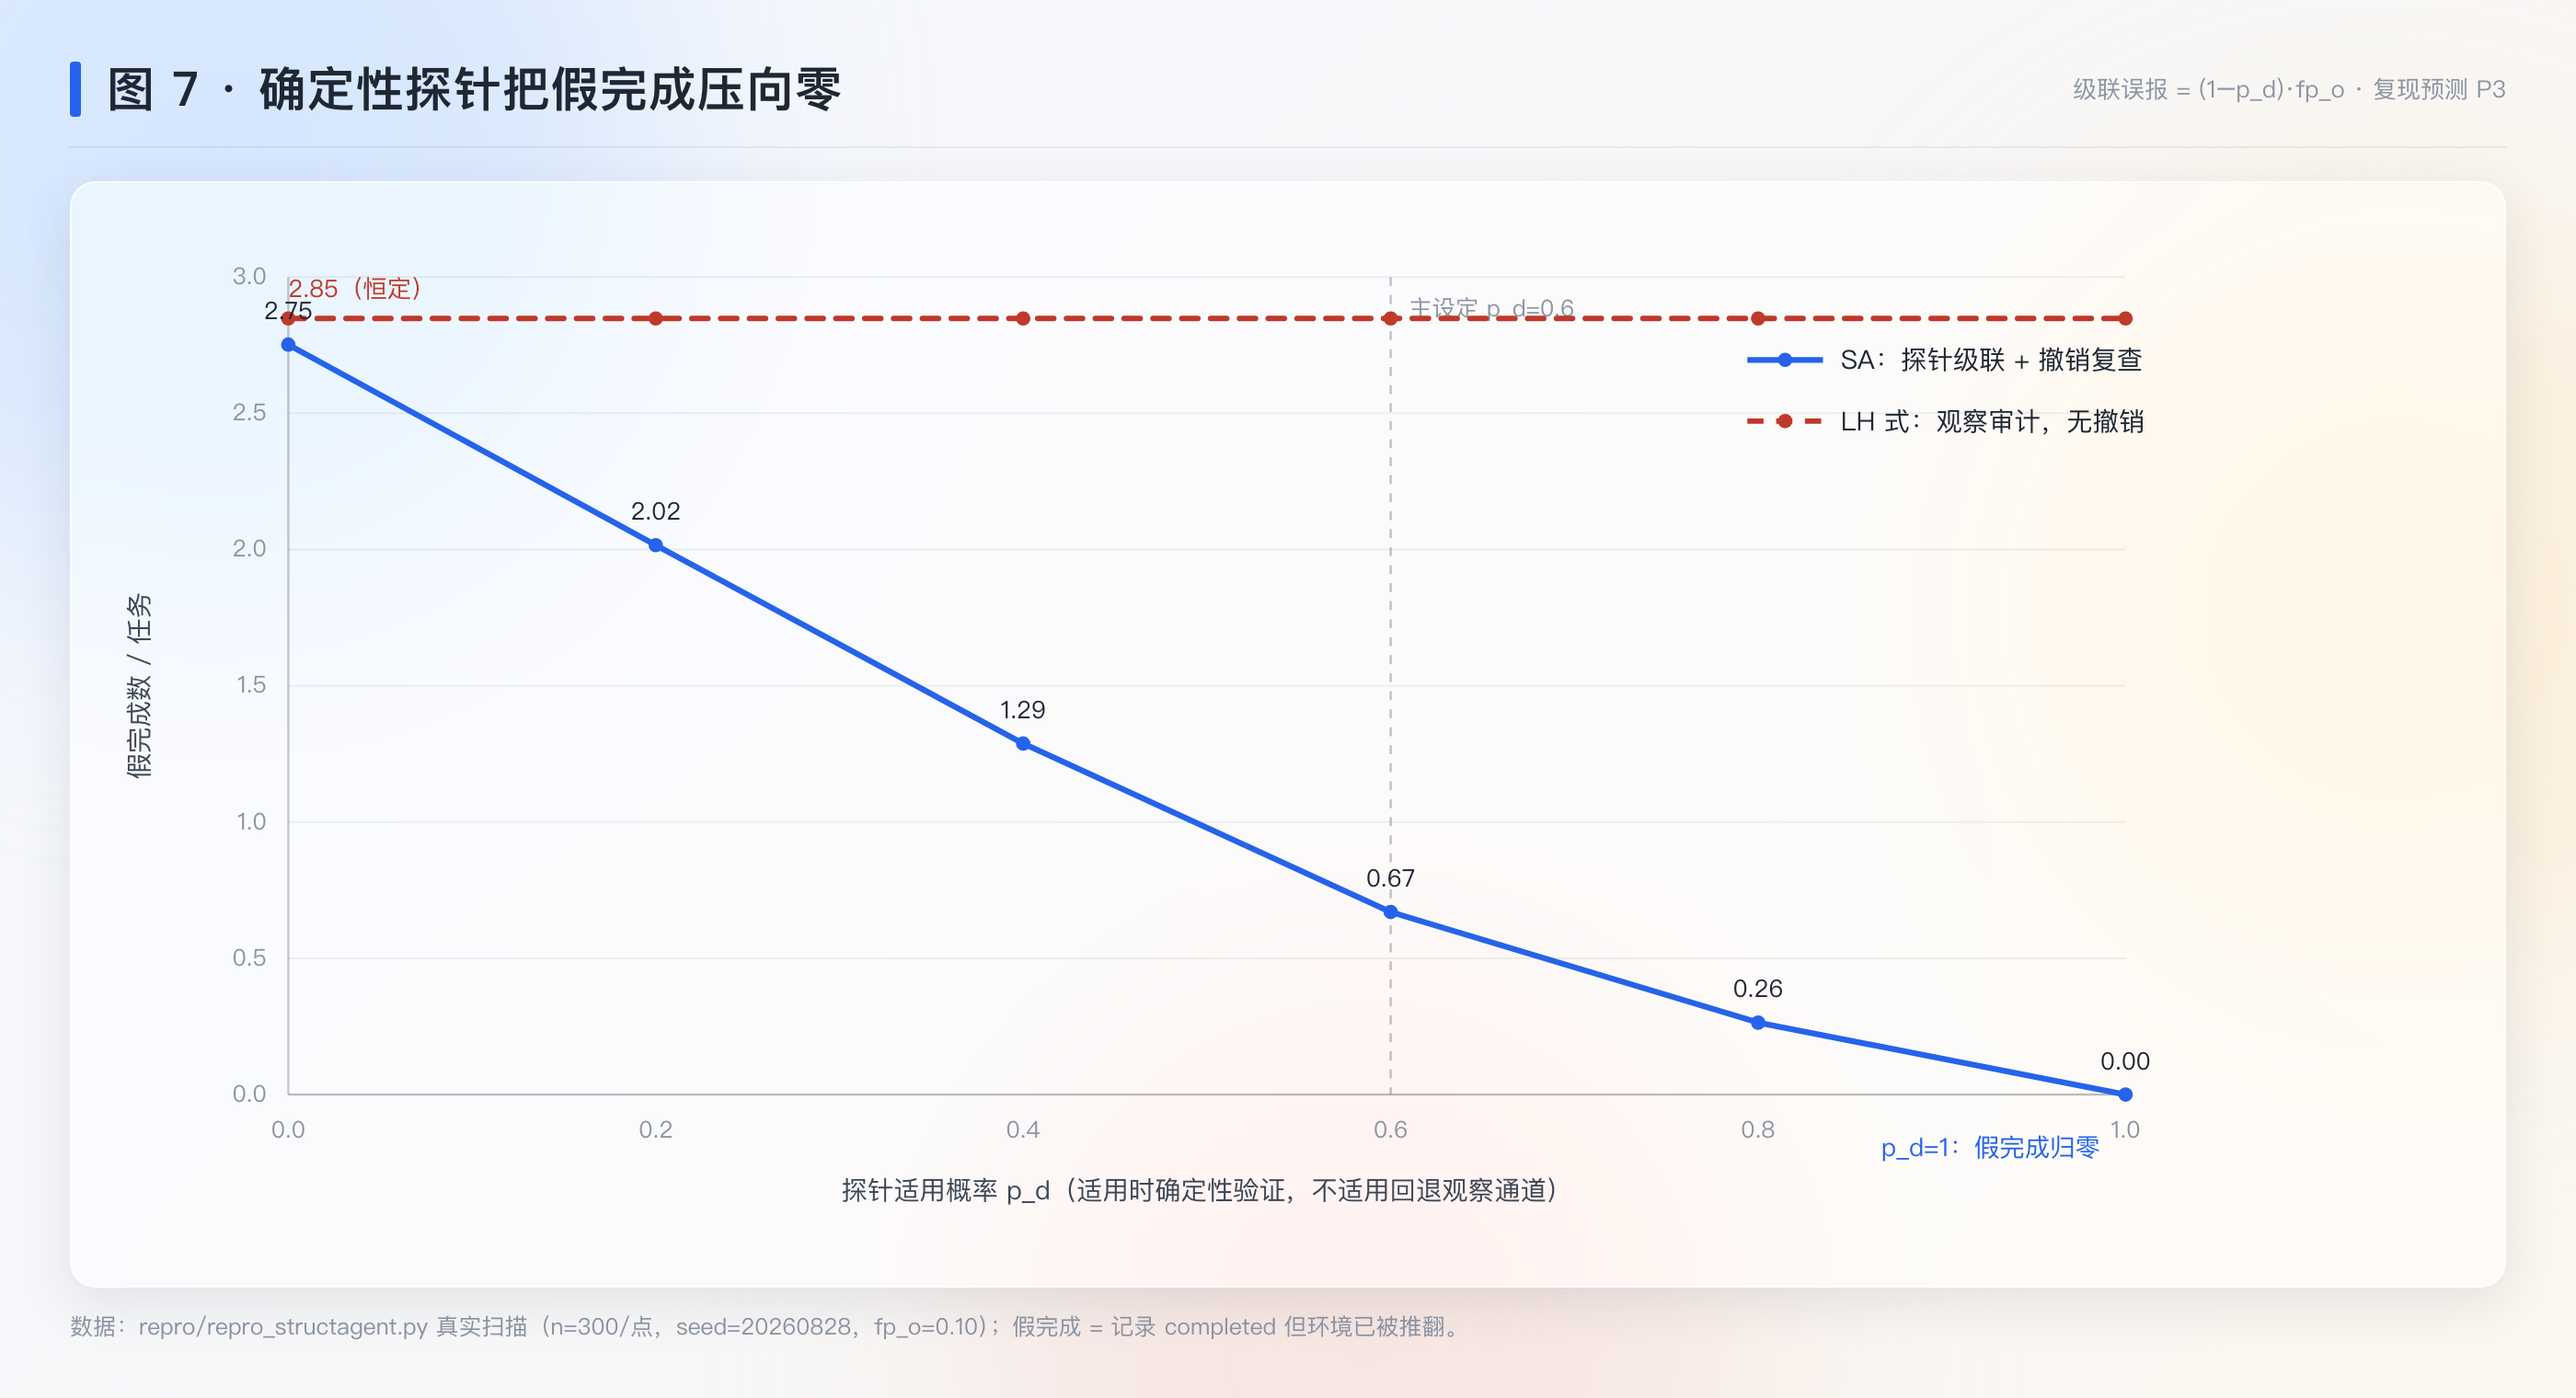
手算:\mathrm{fp}_o=0.10、p_d=0.6:未完成的 100 个案子里,60 个被探针当场拦下(确定性判”未完成”),剩 40 个走人眼,错放 4 个——级联误报 0.4\times0.10=0.04。探针每多覆盖一成场景,通道误差整体降一成。这就是 §3.2”determinate probe overrides observation”的全部数学内容。记住这条编队原则:§五的双级验证就是照它搭的,§六的级联总账再把它算全。
3.2 伯努利过程与存活概率:(1-r)^{L-1}
第二件工具回答一个更冷的问题:账记对了,能保多久?动态环境里,后来的每一步执行都可能把先前的成果推翻——“已验证”不是一劳永逸的终点,是一条要活到链尾的命。命有多硬,得会算。
一件事每轮以概率 r 发生(这里:后续执行动作推翻某个已有成果),k 轮内一次都不发生的概率是 (1-r)^k(独立重复,概率连乘,LH §3.5 同族——该篇已同步重排)。
手算一张表(最早完成的那条成果,后面还有 L-1 步要执行,它要”活”到链尾):
| L=4 | L=8 | L=16 | |
|---|---|---|---|
| r=0.05 | 0.857 | 0.698 | 0.463 |
| r=0.10 | 0.729 | 0.478 | 0.206 |
| r=0.15 | 0.614 | 0.321 | 0.087 |
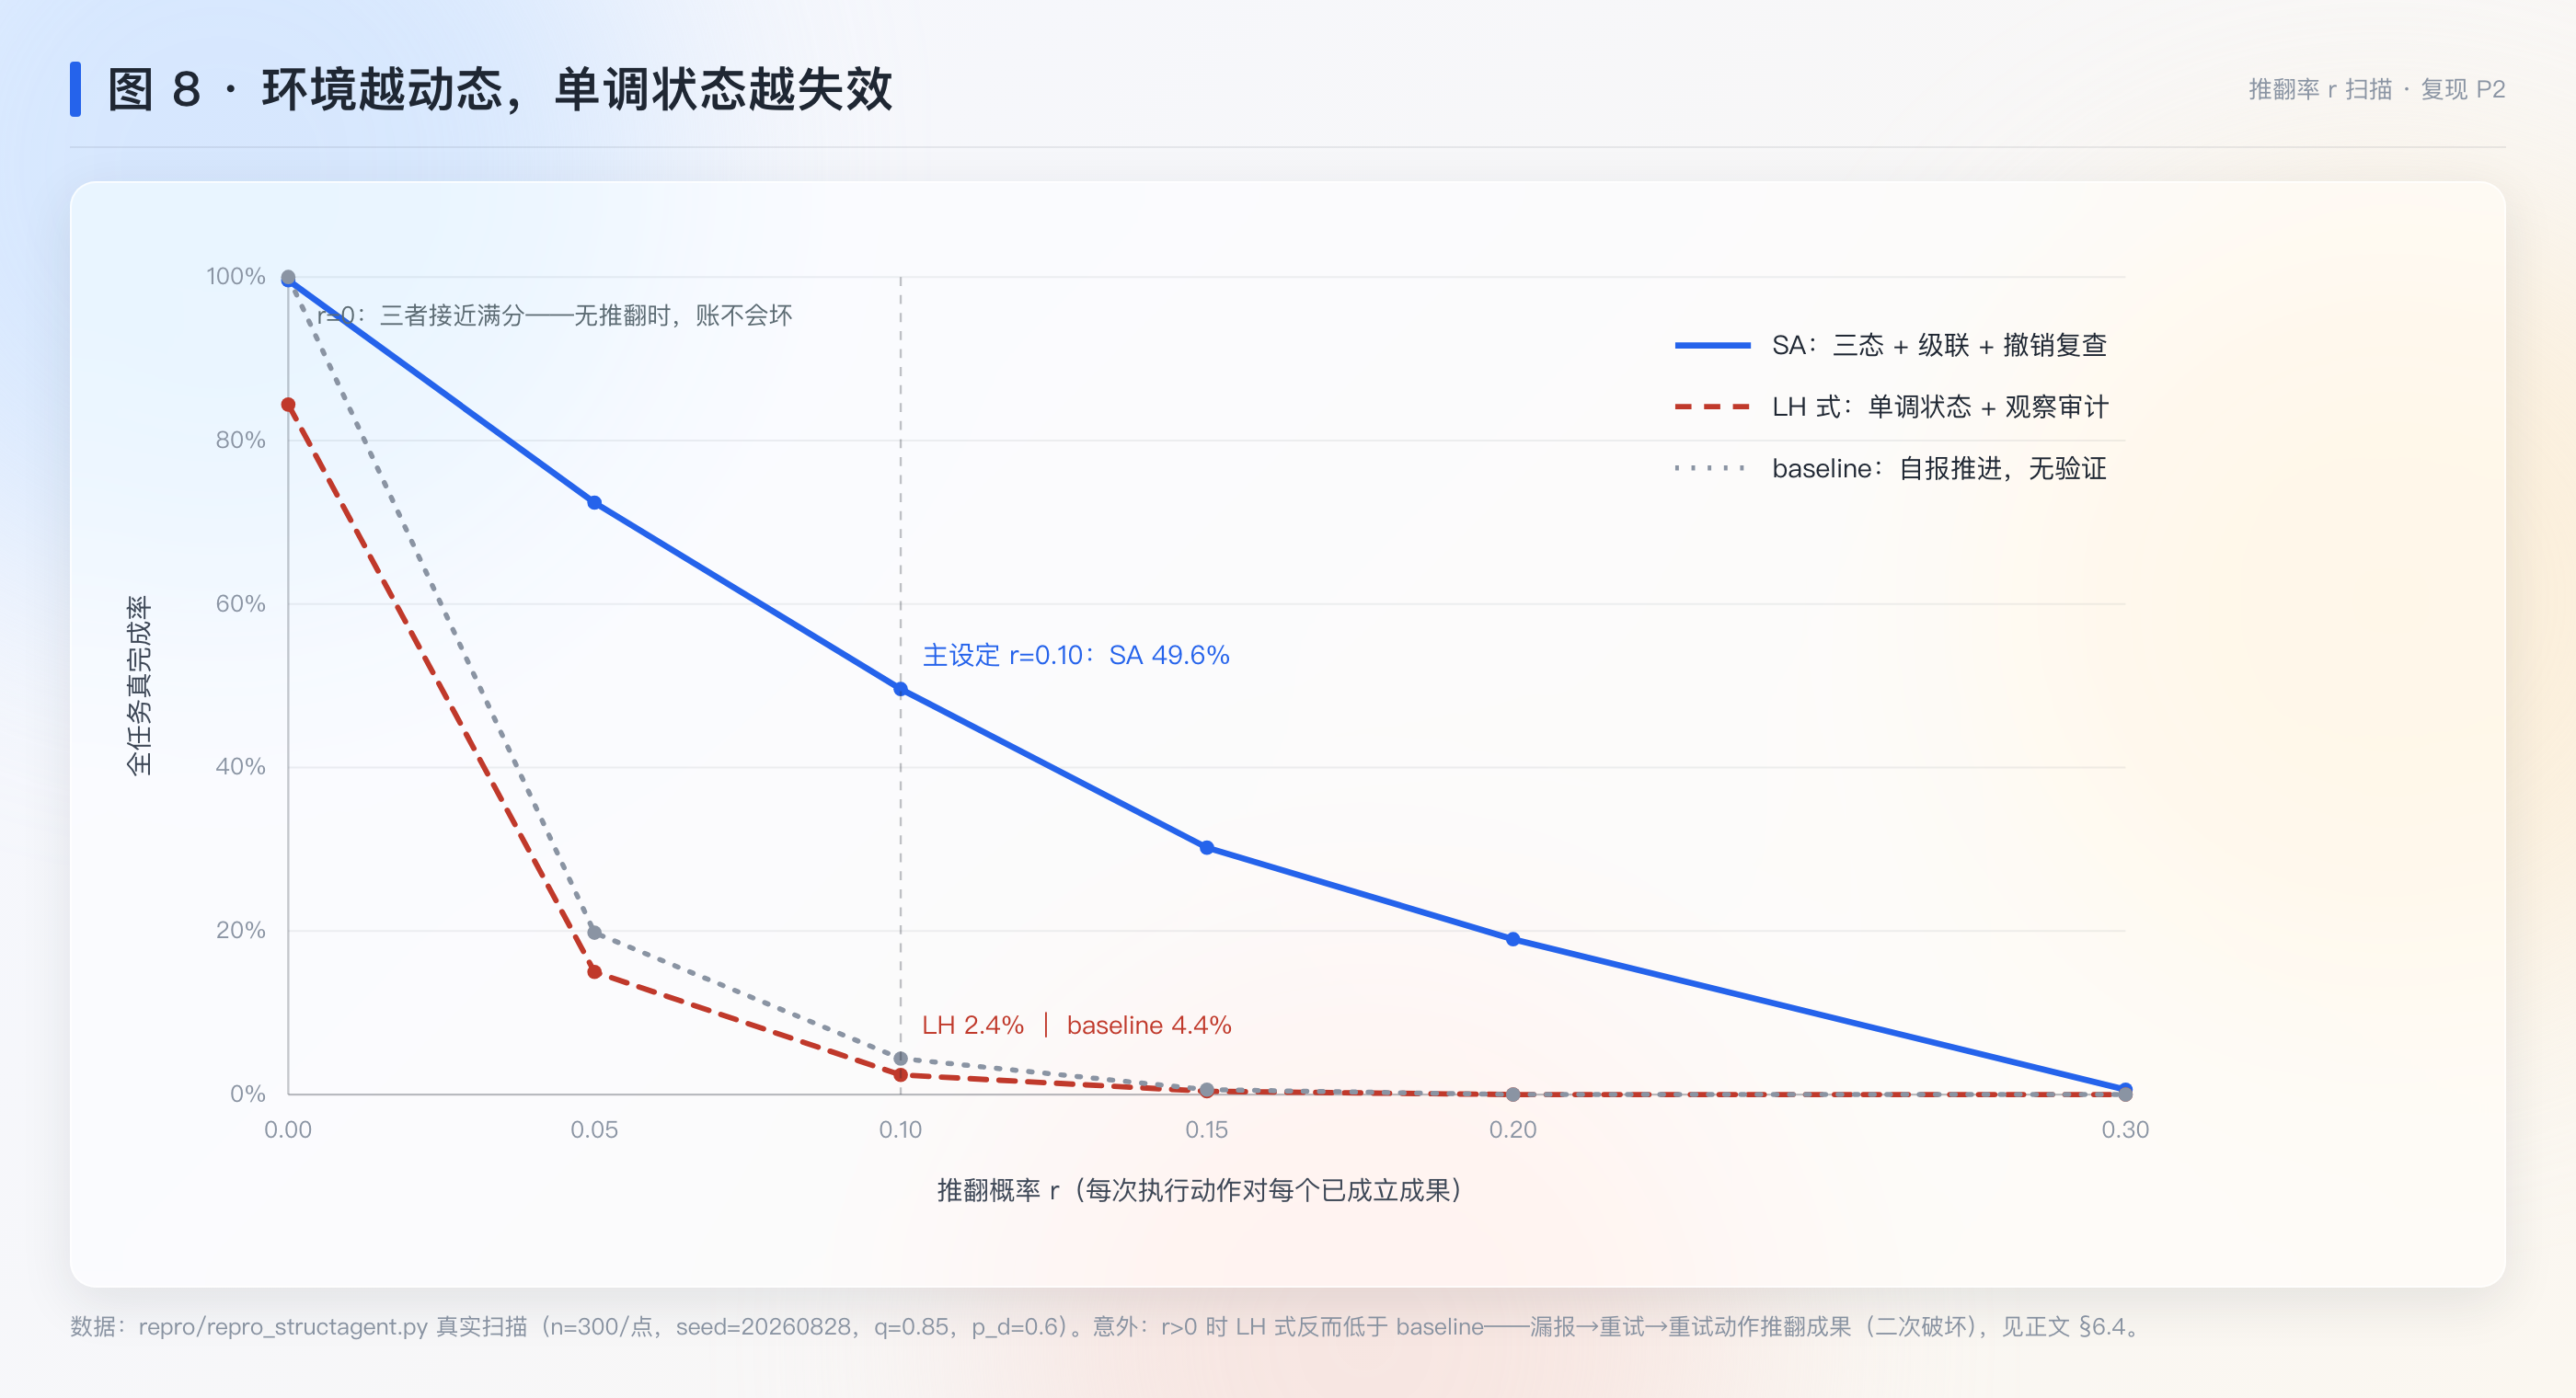
读法:推翻率 10%、链长 8 步,最早那条成果只有 48% 的概率活到最后——一半以上的概率,你账上第一条”已完成”在任务结束前已经被环境悄悄改掉了。这张表是”单调账为什么危险”的全部直觉,§6.1 用它。
3.3 三态马尔可夫链:给生命周期建模
第三件工具给账本本身装上时间轴。三态标签如果只当分类用,那不过是给记录贴贴纸;要问”这套标签让账本质量变好多少”“翻案之后多久能修回来”,就得让记录动起来——一步一跳地走。
马尔可夫性(未来只看现在,LH §3.7——已同步重排):一条记录的生命周期正好是一个三状态随机过程——Pending、Verified、Invalidated——每轮按转移概率跳。三个转移参数:
- a:本轮”执行成功且验证放行”的概率(Pending→Verified);
- c:本轮”已验证成果被推翻且被复查发现”的概率(Verified→Invalidated);
- b:本轮”失效记录被重做并重新放行”的概率(Invalidated→Pending→Verified 的合并率)。
关心两个量:稳态时账实相符的概率(账上 Verified 且环境真成立的占比)和回到全 Verified 的期望轮数。三条记录的链太小,手算用 first-step analysis:设从 Pending 出发最终”以 Verified 且真实”结束的概率为 u,则 u = a + (1-a)\cdot u' + \dots(u' 是绕路后的同类概率)——展开就是一个三元一次方程组,解它。本文不手解通式(§6.2 用它搭模型,数值交给仿真),但要记住这个框架的意义:三态转移让”账本质量”第一次变成了可以算的量——LH 的四态标签没有转移结构,只是分类。
3.4 比例的标准差:读 Table 1 的必备尺子
第四件工具不是给这本账用的,是给你读别人的账用的:论文报”提升了几个点”,这个提升是实的还是抖动的?你手里得有一把量噪声的尺子,不然 §九 的统计审查无从下手。
一个成功率为 p 的任务集里抽 n 个任务,实测成功率 \hat p 的标准差(二项标准差):
\mathrm{SE}=\sqrt{\frac{\hat p(1-\hat p)}{n}}
手算 Table 1 的主数字:n=369、\hat p=0.469:\mathrm{SE}=\sqrt{0.469\times0.531/369}=\sqrt{0.000675}=0.026,即 2.6 个百分点。两个系统比较(未配对近似):
z=\frac{\hat p_2-\hat p_1}{\sqrt{\bar p(1-\bar p)}\sqrt{2/n}},\qquad \bar p=\frac{\hat p_1+\hat p_2}{2}
Qwen3.5-9B 的 27.0→46.9:\bar p=0.370,分母 =\sqrt{0.370\times0.630\times2/369}=\sqrt{0.001263}=0.0355,z=19.9/3.55=5.6——远超显著线。MiniMax-M3 的 75.2→78.9:\bar p=0.7705,分母 =\sqrt{0.7705\times0.2295\times 2/369}=\sqrt{0.000958}=0.0310,z=3.7/3.10=1.19,不显著(p≈0.23)。同一张表里的提升,一把尺子量出两种成色——这把尺子 §九 还要用三次。
四、记号与函数
| 符号 | 含义 |
|---|---|
| s_t=(s^{\text{req}}_t,s^{\text{val}}_t,s^{\text{ver}}_t) | 第 t 步任务状态三元组(§3.1) |
| \sigma_{i,t}\in\{\text{Pending,Verified,Invalidated}\} | 记录 i 的生命周期标签(§3.5) |
| d_t | 验证判定,状态转移唯一驱动(§3.5) |
| \text{VerifySpec}=(k,p,m) | 需求-探针-参考值三元组(§3.4) |
| \text{Outcome}=(\text{satisfied?},\text{depends\_on},\text{evidence}) | 验证结果(§3.4) |
| p_d | 补充:探针适用概率(本文实验轴之一,Q3;本文未给此符号,§6.3 用它做级联数学) |
| r | 补充:环境推翻率——每步执行对每个已成立成果的推翻概率(本文未参数化,§6.1/复现用) |
| \mathrm{fp}_o,\mathrm{fn}_o | 补充:观察通道(视觉/上下文判断)的误报率/漏报率 |
| q | 补充:单步执行成功率(复现用) |
五、机制:状态、双级验证与恢复
承上启下:§一 的三个麻烦(剩余工作难推理、中间假设被当已完成、失败后无从恢复)在 §二 收拢为一句话——维护一张带因果生命周期的任务账。上节备好的四件工具就是这本账的四条数学腿:级联检验(§3.1)给”先仪器后人眼”的验证顺序建模,伯努利与存活概率(§3.2)算链条走完不散架的机会,三态马尔可夫链(§3.3)给 Pending/Verified/Invalidated 的生命周期记账,比例的标准差(§3.4)教我们读论文里的百分比。本节把账本本身和它的五种机制立起来。
5.0 示例任务的账本初始化
补充(示例,非论文内容):任务 T 进系统,S_1 生成:
| ID | 需求(s^{\text{req}}) | 初始标签 |
|---|---|---|
| k_1 | 三篇论文的 BibTeX 已保存到本地 .bib 文件 | Pending |
| k_2 | 引用表已写入 Writer 文档,含全部三条 | Pending |
| k_3 | 排版符合期刊格式(字体、缩进、编号) | Pending |
| k_4 | 文档已导出为 PDF,路径已知 | Pending |
| k_5 | PDF 内容包含三条引用(非空壳导出) | Pending |
s^{\text{val}} 初始有:三篇论文的 arXiv 编号(任务书给的)。依赖关系:k_2 依赖 k_1,k_3 依赖 k_2,k_4 依赖 k_3,k_5 依赖 k_4——一条链,外加 k_5 还依赖 k_1(内容源头)。这五条就是”最小充分”:做对任何下一步决策,看这五行加依赖边就够,不需要任务书全文。
5.1 Planner 与 Actor
【类比 · 工头派工】 工地上的工头看图纸与验收单排下一道工序,从不自己上脚手架;工人只带一张写着单道工序的纸条进场,干完即走。工人昨天的抱怨、脚手架上的闲聊,一概进不了工头的眼睛。 【跨域锚点】 管理学的”计划与执行分离”;CPU 流水线里取指与执行各设一级、互不越位。(类比与通识锚点,非论文内容)
先看病。§一 的第一个麻烦——剩余工作难推理——病根出在”决定下一步”这件事的输入上:输入是整个执行历史,就得考古;历史越长考古越难,还越容易把”当时以为真”当成真。治病先换输入。
药方是把决策者与干活者拆开,各自只喂对的东西。Planner(§3.2,Algorithm 1):读当前状态 s_t,按依赖选下一个子目标——挑”依赖已满足(其 depends_on 集合里全是 Verified)且本身 Pending”的需求;输出一份结构化指令给 actor:做什么、验收标准是什么、可用哪些值。它不接触工具。示例:第一轮它选中 k_1(无前置),指令 =「用浏览器从 arXiv 拿三篇论文的 BibTeX,存为 references.bib;验收:文件存在且含三条 entry」。
Actor(§3.3):在 fresh context 中执行单个子任务。fresh context 里装什么:原目标、当前状态(那一小段账)、子任务指令、只读携带可复用工作流记忆(§3.5)。执行期间,工具事件与日志被一个层次监控 agent 持续盯梢(附录 H),识别确认、矛盾与 invariant violation(工具报错、结构性异常、异常的出现模式)。示例:actor 打开浏览器、搜到论文页、点 export、存文件——这些事件流同时进监控。
意义:这一层与 LH 的 Manager/Executor 同构——不碰环境的规划者 + fresh context 的执行者。差异在 planner 的输入更结构化(依赖图 + 三态标签,而 LH 是状态 + 审计报告),且本文的监控是持续的(LH 的 auditor 是每轮结束才看)。
5.2 State Verifier:VerifySpec 与双级验证
【类比 · 仪器读数】 病人说”我感觉好多了”不算诊断结论,验血单和 CT 片子上的读数才算;查哪些项目,由规程开好的化验单说了算,不许凭感觉加查。 【跨域锚点】 实验科学的第一课:仪器读数优先于主观陈述;法医取证同理——结论必须挂在可溯源的物证链上。(类比与通识锚点,非论文内容)
先看病。Example 1 是论文 §3.4 的例子,示例任务正是这种形态:任务要求”用浏览器下载”(k_1)。actor 干完,上下文里留着观察:“文件保存成功”。但这个 .bib 文件可能根本不是浏览器下的——actor 中途可能用 Writer 新建了个文件粘贴了内容(GUI 上两个应用颜色布局相似,纯视觉观察分不清来源,§4.3 Q2 的实测:视觉混淆是验证错误的主因之一)。
病根出在哪:验证停在”看了一眼”。观察通道是软的——可能被近处的上下文带偏,可能被视觉相似骗过;而执行者的自述和观察,都不等于事实。
药方是把验证从目测换成仪器,一共三件东西。第一件是化验单——验证的单元是一个结构化三元组(§3.4,Definition 1):
\text{VerifySpec}=(k,\ p,\ m)
k 是需求,p 是探针(probe),m 是参考值。探针是一组确定性检查(附录 C 的白名单,全部只读):
| 探针 | 查什么 | 确定性何来 | 失败模式 |
|---|---|---|---|
| file_grep | 文件内容含/不含某模式 | 正则匹配,机器读文件 | 模式写错 → 查错对象 |
| url_match | 当前页面/来源 URL 匹配 | 浏览器状态可程序化读取 | 重定向后 URL 变体 |
| a11y_match | 无障碍树含某节点 | DOM/a11y 树是结构化数据 | 控件无 a11y 标注 |
| calc_verify | 数值/日期重算 | 算术本身无歧义 | 参考值错则算对也错 |
| writer_verify | Writer 文档结构(样式、大纲级) | 解析文档 XML | 只查结构不查语义 |
| impress_verify | 演示文稿结构 | 同上 | 同上 |
| shell_command | 白名单只读命令 | 命令输出可复现 | 白名单外查不了 |
第二件是仪器读数的记账格式。验证结果是一个 Outcome:(\text{satisfied?},\ \text{depends\_on},\ \text{evidence})——是否满足、依赖哪些其他 Outcome、证据是什么。depends_on 让证据天然连成链:k_5(PDF 含三条引用)的证据依赖 k_4(PDF 存在)的证据,k_4 依赖 k_3……沿着链可以一路溯源到最底层的原始测量。可用探针按域过滤(trust map,附录 C/E:比如域是”文件系统”就只放行 file_grep/shell_command,防探针越权)。
第三件是两级会诊。双级验证(§3.4):
- 低层验证在 task loop 内:actor 每做完一个动作,立刻对工具结果做即时判断(“这一步的输出像不像预期”)。它快,但在上下文内,可能被近处观察带偏。
- 边界验证在里程碑处:子任务完成时,用依赖图把累积的监控测量重新串起来复核——不是再看一眼,是检查证据链整体自洽(k_1 的文件来源证据是否支持 k_2 的写入前提)。
关键规则一句:确定性探针的结果压过执行观察(determinate result overrides observation,§3.4)。观察说”看起来成功了”,探针说”文件里没有那三条 entry”,记账按探针来。
回到上面这桩案子,怎么断:验证时给 k_1 配 VerifySpec:(k_1,\ \text{url\_match},\ \text{arxiv.org/export}) 查下载来源,(k_1,\ \text{file\_grep},\ \text{@article}) 查文件是真 BibTeX。探针一跑:来源不是 arxiv 的导出 URL → 这条路径判非法 → k_1 不放行,打回重做。浅层观察会被”看起来对”骗,探针查的是”来源对不对”——这是本文对 LH”只信审计”的实质升级:审计本身也要从自由判断换成仪器读数。
5.3 状态更新:三态转移
【类比 · 日志划改】 施工日志上验过的工序,后来返工被推翻:不撕页、不擦掉,划掉、注明原因,原记录留给后人查。 【跨域锚点】 复式记账的”红字冲销”:错账不用橡皮擦,反向记一笔红字,错与改都留在账上。(类比与通识锚点,非论文内容)
先看病。验证过的东西也会失效——这是 §一 第二个麻烦最阴险的后续:连账上已 Verified 的记录,都可能被后来的操作悄悄推翻。账要是只会单向推进,这种失效就是静默的,账面从此停在假象上。
药方是更新规则(§3.5,式 3),转述成分段函数:
\sigma_{i,t+1}= \begin{cases} \text{Verified}, & d_t(i)=\text{satisfied} \\ \text{Invalidated}, & d_t(i)=\text{contradicted} \\ \sigma_{i,t}, & \text{otherwise} \end{cases}
d_t 是本轮验证判定。三种走向:验证说满足,记账为 Verified;后续证据说它不成立(被推翻、与约束矛盾),记账为 Invalidated;其余情况不动账。执行者的自述不出现在任何一支里。
示例的账本演化序列(补充,走七轮):
| 轮次 | 动作 | d_t 判定 | 账本变化 |
|---|---|---|---|
| 1 | actor 执行 k_1(浏览器下载) | url_match + file_grep 双通过 | k_1: Pending→Verified,evidence = 两条探针记录 |
| 2 | actor 执行 k_2(写入 Writer) | writer_verify 查到三条 entry | k_2: Pending→Verified |
| 3 | actor 执行 k_3(改样式) | 样式探针通过 | k_3: Pending→Verified |
| 4 | actor 执行 k_4(导出 PDF) | file_grep 查到 PDF 文件 | k_4: Pending→Verified |
| 5 | 执行 k_5 时发现 PDF 只有两条引用——第 3 轮改样式时误删了一条 | k_5 不满足,且反向矛盾:k_2 曾验证的”三条 entry”已被推翻 | k_5: 保持 Pending;k_2: Verified→Invalidated(保留原证据 + 矛盾记录) |
| 6 | planner 看账:k_2 失效、其下游 k_3/k_4 依赖它 → 出补写指令,actor 重做 k_2 | 边界验证:writer_verify 重新放行 | k_2: Invalidated→Pending→Verified(原矛盾记录保留) |
| 7 | 重排样式、重新导出 PDF | 全链 evidence chain 复核通过 | k_3/k_4: 重验 Verified;k_5 恢复推进 |
第 5 轮是全文的关键一幕:后续动作推翻了已验证的成果。LH 的账在这幕里没有动作(completed 永不回退,账面停在”四条完成”的假象上);本文的账把它标出来,第 6、7 轮的规划因此是”修 k_2 及其下游”,而不是盲目推进 k_5。
5.4 完成审计与定向恢复
【类比 · 换人盲审】 学生喊”做完了”只算交卷;批卷的老师不带学生的解题思路进场,从零对答案。没过线,还得先判断错在哪一环——题看错、算错还是卷子印坏——再对症补课,不能一律重做。 【跨域锚点】 软件工程的代码评审与缺陷根因分类:bug 先归因(需求/实现/测试/环境),再路由给对应的处理流程。(类比与通识锚点,非论文内容)
先看病。长程任务里最不可信的三个字是”做完了”——说这话的是 planner 和 actor 自己。干活的人不能自己裁决完成,这是 LH 用一整篇论证过的自评偏差,本文接着治。
药方分两味。第一味管”谁说了算”。DONE 是提案不是结论(§3.6,Definition 2):planner/actor 说”做完了”只算提案。完成审计员以”新鲜眼睛”(fresh eyes——不看 planner 的思维链,从零看账与证据)复核全部 evidence chains、检查矛盾;发现缺口或矛盾,任务重新打开。未过线则 planner 继续出修复指令;恢复路径支持人接管。与 LH 的 done 信号同构(提案-裁决分离),差异是裁决的抓手:本文审计员手里有 evidence chain 可以逐环复查,LH 审计员只能重新去环境里看。
第二味管”败了怎么办”。定向失败恢复(§3.6,附录 B):失败先做结构化归因——归到四个角色之一,再按归因路由干预:
| 归因 | 典型症状 | 路由的干预 |
|---|---|---|
| planner 错 | 指令依赖关系错、验收标准漏 | 重规划(改指令/改分解) |
| actor 错 | grounding 错、点了错控件 | 重试(换提示/换交互方式) |
| verifier 错 | 接受弱证据、漏检、没发现推翻 | 追加检查(补探针/边界复核) |
| environment | 工具坏、权限缺、页面挂 | 修环境或人接管 |
对比 LH:LH 的恢复粒度是”重试 / blocked / ask”三种控制信号;本文多一层”先归因再路由”——retry 不是万金油,verifier 的错用重试治不了(重试只会再错一次),要补检查。这层归因直接来自状态结构:正因为账上有因果记录,失败才能定位到角色。
5.5 记忆与状态分离:advice 与 truth 分账
【类比 · 菜谱便签】 菜谱写”红烧肉先焯水”,是可以反复用的手艺;“今天这块肉已解冻”是当顿的事实,只许贴冰箱便签。菜谱里抄进当顿事实,下顿照做就出乱子。 【跨域锚点】 程序设计里代码与数据的分离:可复用逻辑进函数库,运行时状态进变量,混写必乱。(类比与通识锚点,非论文内容)
先看病。§一 批过 agent memory 路线:记忆要是把”这类事怎么做”和”这件事做到哪了”混成一本账,建议里带的错误就会被当成事实执行——错误建议被执行,比没有建议更糟。
药方是分账。工作流记忆离线从成功轨迹构建(附录 D),保存”可复用建议”——论文的原话:reusable advice, not task truth。示例:记忆里可以有一条”OSWorld 的导出任务里,Writer 的导出对话框在文件菜单第二项,且导出后要用 file_grep 确认文件真实落盘”——这是怎么做这类事的知识;但”本任务的 PDF 已经导出了”是 task truth,只许进 s^{\text{ver}},不许从记忆来。
分账之后还有一道检索题,Minecraft 上做了精细实验(附录 F.5):结构化记忆分四层(L1 轨迹、L2 动作簇、L3a/L3c 配方与检查机制),检索用组合式(类型 + 场景 + 缺失前置)而非顺序式(按相似度排一遍)。17 个 Iron 工具任务从 0/17 提到 11/17。为什么组合检索这么强:做一个 Iron 镐之前,组合检索显式问”我缺哪些前置”——缺的正是账本上 Pending 的依赖;顺序检索按”像不像”排序,最像的配方可能恰好缺着前置,agent 照做就在半途截断。这是”状态缺失信息 → 计划截断”的活案例,§6.5 会回来。
六、数学展开(补充推导,句首标”补充”)
6.1 两种账本的进度演算:单调 vs 可撤销
LH 的完成集(LH §6.1)单调不减:\mathcal{C}(S_1)\subseteq\mathcal{C}(S_2)\subseteq\cdots;本文的验证集 V_t=\{i:\sigma_{i,t}=\text{Verified}\} 可增可减。
补充:把 5.2 的存活表翻译成两种账的账面 vs 真值演算。设 8 条需求、每条完成时刻按链序排列、推翻率 r=0.10。任务结束时刻:
- 真实成立的第一条成果概率 0.478(5.2 表);
- LH 的账面:第一条仍是 completed(单调,永不回退)——只要它曾被审计通过;
- 本文的账面:取决于复查是否发现(探针适用概率 p_d 与复查频率)。
于是单调账的假完成期望(8 条、独立近似):
\mathbb{E}[\text{假完成}] \approx \sum_{i=1}^{8}\Big(1-(1-r)^{8-i}\Big)\cdot P(\text{第 } i \text{ 条曾被放行})
手算(假设全部曾被放行):\sum_{i=1}^{8}(1-0.9^{\,8-i}) = (1-0.9^7)+\cdots+(1-0.9^0)=0.522+0.470+0.410+0.344+0.271+0.190+0.100+0=2.31。单调账在 r=0.10 的世界里,期望每任务背着 2.3 条假完成收工——我的复现实测 LH 式 2.85 条(§十,含验证通道自身误差),同一量级。这条不等式不是抽象批评,是可以对表的账。
6.2 带撤销的动力学:三态链模型 + 仿真对照
补充:用 5.3 的框架给单条记录参数化:
- a = q\cdot\big[p_d+(1-p_d)(1-\mathrm{fn}_o)\big]:执行成功(q)且被级联通道放行——探针适用(p_d,必放行真值)或不适用而观察不漏报;
- c = r\cdot s\cdot p_d:每轮环境推翻(r)× 被抽检撞上(s,DONE 前全量复查时 s=1)× 探针适用(发现才有效);
- 失效后重做走回 Pending,循环。
全任务完成 = 全部 8 条同时”Verified 且真值成立”。解析通式冗长(记录间通过推翻耦合),给两个可手算的界:
上界(无撤销系统的真完成率):每条独立近似,\prod_{i=1}^{8}(1-r)^{8-i}\cdot a^{?}……精确积冗长,取一阶近似:全链真完成 \approx (1-a\text{ 修正})\times 0.478^{1}——不如直接给仿真对照。数值对照(复现参数 q=0.85、p_d=0.6、\mathrm{fn}_o=0.1、r=0.1):
- 单条一轮被诚实放行的概率 a=0.85\times(0.6+0.4\times0.9)=0.85\times0.96=0.816;
- 无撤销系统全任务真完成率仿真值 2.4%(§十)——对照 5.2 的 0.478(第一条存活)再连乘其余各条(0.9⁶×0.9⁵×…,量级 10^{-2}),同量级;
- 带撤销 + DONE 全量复查的系统仿真值 49.6%:DONE 复查把”探针适用的假完成”清零(探针不适用者仍漏,1-p_d=0.4 的残余由下一轮重做消化),收敛到”预算内修完”的概率。
结论一句话:撤销机制的收益不是让单条更准,而是让错误不再能”带着完成标签活到收工”——错误被逐出终止状态,只在过程中逗留。
6.3 级联通道的完整账:误差、贝叶斯残留与 Q2 实测互证
补充:5.1 给了级联误差 (1-p_d)\mathrm{fp}_o。现在做三层账:
第一层,通道误差:p_d=0.6、\mathrm{fp}_o=\mathrm{fn}_o=0.10 时,\mathrm{fp}_{\text{cas}}=\mathrm{fn}_{\text{cas}}=0.04。
第二层,贝叶斯残留(方法同 LH §3.4:先验 \pi=0.8 的子任务集,通道报”完成”后其实没完成的概率):
P(X{=}0\mid \text{报完成})=\frac{\mathrm{fp}\,(1-\pi)}{(1-\mathrm{fn})\,\pi+\mathrm{fp}\,(1-\pi)}
观察通道(fp=0.10、fn=0.10):0.02/(0.72+0.02)=2.70\%。级联通道(fp=fn=0.04):0.008/(0.768+0.008)=1.03\%。残留风险再砍 62%——探针化审计在贝叶斯账上的位置和 LH 换通道(自报→审计)完全同构:都是降 \mathrm{fp}。
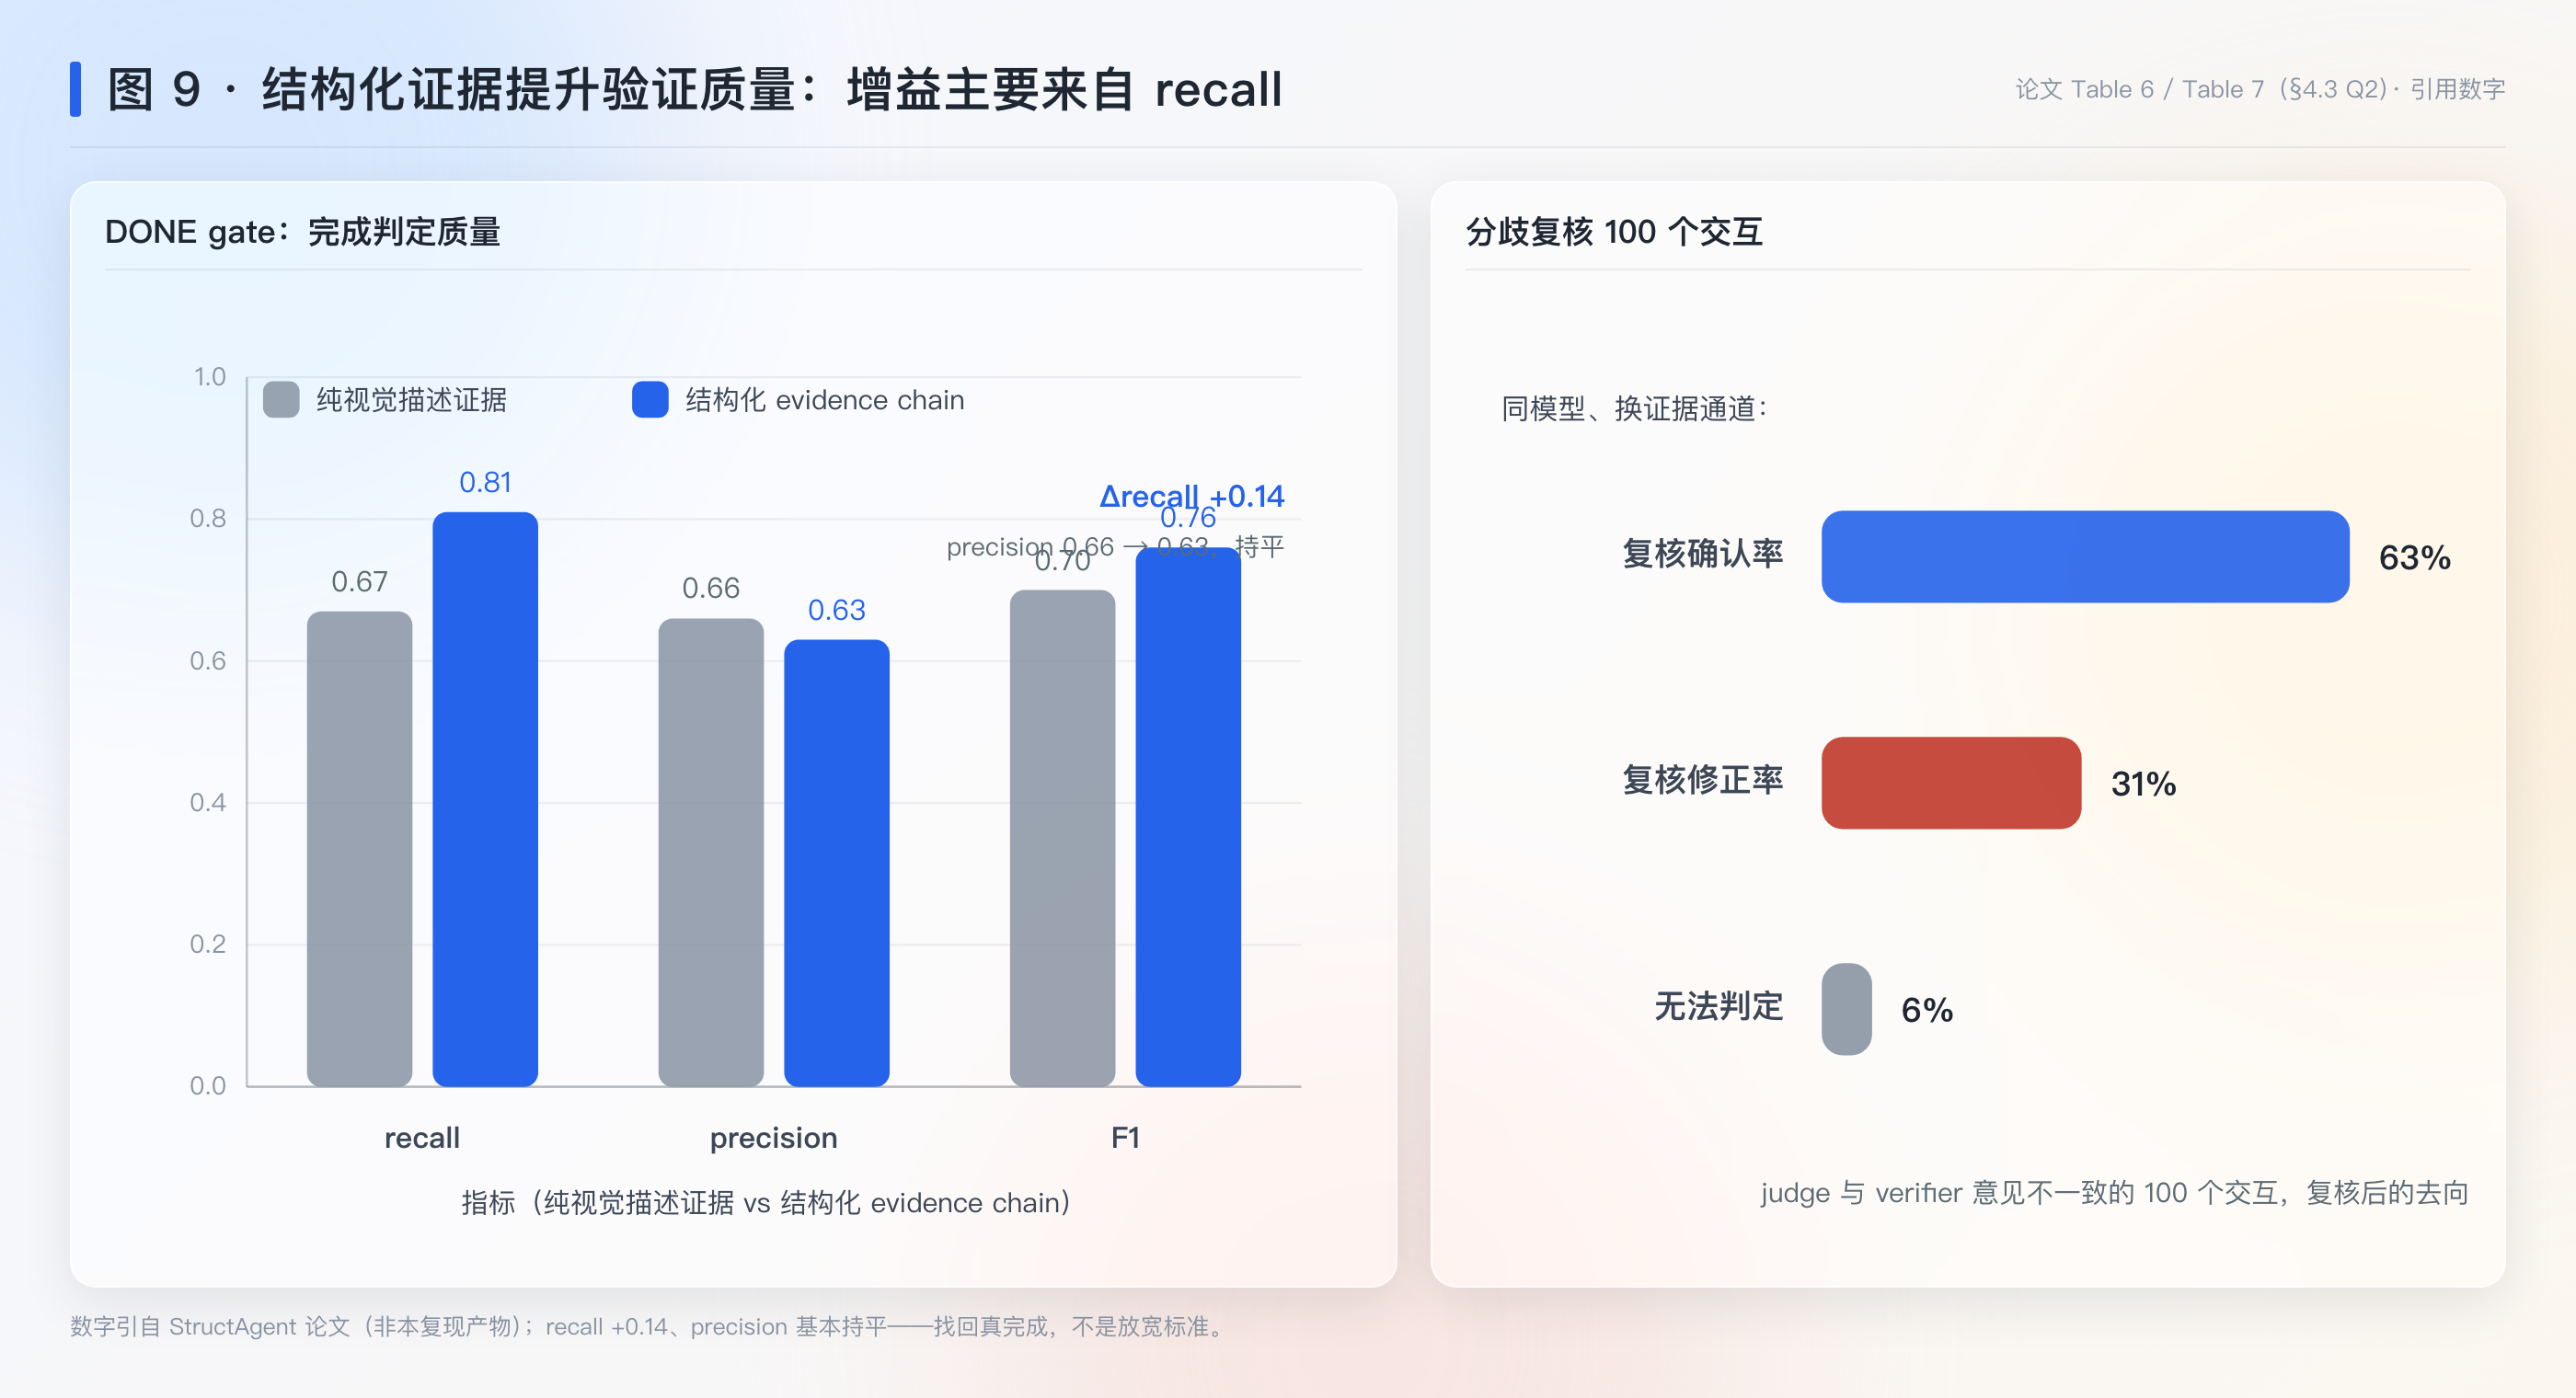
第三层,论文实测互证(Table 6):DONE gate recall 0.67→0.81、precision 0.66→0.63。级联模型的预测是”fn 降、fp 不升”——recall 大升对应 fn 降(+0.14),precision 微降 0.03 说明结构化证据也带入少量新误报(如探针查错对象),量级可忽略。Table 7 的分歧复核(结构化证据复核确认率 63% vs 纯视觉 31%)是同一通道差的人审版本:同模型、换证据通道,分歧被解决了近三分之二。模型、实测、人审三层同向——这条主张的可信度因此在中高(§十三)。
6.4 漏报的隐性成本:重试不是中性的
补充:本节是本次复现意外发现(§十 P1 判读)的机制推导。
先看这笔账的直觉。验证漏报(做成了却判没成)看似只浪费一次重试。但在动态环境里,每次重试都是一次新的推翻机会——重试执行的动作同样会碰环境、同样以概率 r 破坏已完成成果。
推导。设链长 L、单步执行成功率 q、通道漏报 \mathrm{fn}。第 i 步被放行前的期望执行次数(几何级数,LH §3.6):
\mathbb{E}[\text{第 } i \text{ 步执行次数}]=\frac{1}{q\,(1-\mathrm{fn})}
每次执行平均暴露 \approx(i-1) 条已成立成果给推翻风险。全链期望推翻暴露:
\mathbb{E}[\text{推翻暴露}]\;=\;r\sum_{i=1}^{L}\frac{1}{q(1-\mathrm{fn})}\,(i-1)\;=\;\frac{r}{q(1-\mathrm{fn})}\cdot\frac{L(L-1)}{2}
手算(L=8、q=0.85、r=0.10):漏报为零时 0.10/0.85\times28=3.29 次;漏报 0.10 时 0.10/(0.85\times0.90)\times28=3.66 次——均值只多 11%。但全任务完成是尾部事件(要求 8 条同时成立),暴露次数的方差把尾部概率撕开:复现里全任务真完成率从 4.4%(自报,\mathrm{fn}=0 等效)掉到 2.4%(LH 式,\mathrm{fn}_o=0.1),掉近一半。均值平缓、尾部悬崖——这就是”二次破坏”的准确形状。
论文侧证:Minecraft 失败模式里的 retry storm(附录 F.6)——单步上 100+ 次 verify-retry 循环烧穿 100 步预算。用期望重试次数 1/[q(1-\mathrm{fn})] 读:弱执行器(q 低)+ 高漏报 → 期望重试次数膨胀 → 预算被单步吸干。这把 LH §8.16 的”最优停止”从发散变成了必需:验证-重试循环必须有止损阈值,否则漏报与弱执行器组合下的最优行为是放弃验证。
6.5 状态作为充分统计量:本文的正面工程化与反面案例
补充:LH 把”S 是过去对未来的充分统计量”当前提(LH §6.3/§6.8);本文把这个前提做了目前最好的工程化,同时也给出了自己的反面案例。
正面。三条工程对应:① s^{\text{req}} 按 minimum sufficient 选取(§3.1)——“充分”的选材标准写进了数据结构;② checkpoint/resume 不重放执行轨迹(§3.7)——能不重放而恢复,等于宣称状态已充分;③ 双级验证里边界验证只看 evidence chains——跨轮决策的输入是状态的函数,不是历史的函数。
反面案例。Minecraft 组合检索 vs 顺序检索(附录 F.5,0/17→11/17):状态/记忆里缺什么(缺失前置的显式建模)直接决定计划能否继续。用 LH §6.8 的记号:损失项 I(P;Y\mid S)>0(历史里有、状态里没有、未来需要的)时,表现不是平滑变差,是任务截断——计划在半途发现缺前提,没有信息补,只能停。这给了充分统计量假设一个比 LH 反例(“失败经过被压缩掉”)更尖锐的失效形态。
适用域清单(综合 Q3 与上述):充分性成立需要三条——环境可文本化观测(a11y/DOM/文件,纯视觉不行)、环境暴露持久任务状态(VS Code 文件树、终端输出;无状态暴露的应用不行)、探针可落地(有白名单能查)。三条全不满足的域(纯视觉、无状态暴露),本文框架退化为普通 ReAct——论文自己的 Q3 就是这张清单的实验版。
6.6 探针选择是第二层通道:谁给验证器把关
补充(形式化未攻克 ②):§3.2 的级联有个未言明的前提:探针的”适用性”与”选择”本身由谁判定——VerifySpec 是 LLM 生成的(论文流程里 planner/actor 配探针)。如果 LLM 选错探针(查错对象、参考值写错、域过滤判断错),级联的第一层就是坏的:确定性探针很准,但它可能正在查一件不相干的事。
形式化:在 5.1 的级联外面再套一层通道——探针选择通道,误选率 \varepsilon(选了不适用/不相干的探针)。真实误报:
\mathrm{fp}_{\text{real}} = \varepsilon\cdot\mathrm{fp}_o + (1-\varepsilon)\cdot(1-p_d)\,\mathrm{fp}_o
手算:\varepsilon=0.15、p_d=0.6、\mathrm{fp}_o=0.1:0.015+0.4\times0.085=0.015+0.034=0.049——比理想级联的 0.04 高出近四分之一。含义:验证质量的天花板从”探针确定性”退到”选探针的 LLM 有多准”。这与 Q4 的 verifier 失败(占 30%)对得上:其中一部分不是”看走眼”,是”仪器拿错了”。对应 LH 研究问题② 的分层答案:独立性要同时查两层——选仪器的人、和仪器本身。
七、前置知识:这篇牵出了什么
| 概念 | 状态 | 和这篇的关系 |
|---|---|---|
| 状态 = 充分统计量 / 马尔可夫分解 | 🟢→大幅推进 | 本文是最大缺口的第一块正面回答;适用域清单见 §6.5 |
| 误报/漏报通道、级联检验 | 🟢(§3.1 新铺 + LH §三 工具) | §6.3/§6.4/§6.6 的全部数学 |
| OSWorld-Verified vs OSWorld 2.0 | 🔵 待补(升级) | 两个”OSWorld”是不同基准不同 split,数字不可比(§8.6) |
| 依赖图规划 / HTN / BDI | 🟡 已核出处(Wikipedia,2026-08-28) | planner 按 depends_on 选子目标 = HTN 式分解;见 LH §8.17 |
| Optimus-1 / STEVE-1 / JARVIS-1 | ⚪ 本文引,未核 | Minecraft 基线(Table 3),尚未核对 |
| agentic RL | ⚪ 缺口 | §2.4 本文自己论证”workflow 结构难以作为可训练接口”——与 ToolVerse 立场相反,好种子 |
八、扩展与发散:与 LH 的配对对照(本篇重心之二)
8.1 逐点对照表
| 维度 | LongHorizon-Harness | StructAgent | 判语 |
|---|---|---|---|
| 状态 | S=(R,A,F),标签 4 态(completed/pending/blocked/untrusted) | s=(\text{req},\text{val},\text{ver}),标签 3 态(Pending/Verified/Invalidated) | 三元组几乎同构(req≈R,val+ver≈A+F);差异全在 Invalidated |
| 进度观 | 单调:admit 后不再回退 | 可撤销:verifier 可 invalidate,保留因果记录 | 本文补上了 LH §6.1”单调是理想性质”缺的那条腿 |
| 验证 | 单一 auditor 角色,读环境自由核查 | 双级(task-loop + 边界)+ DONE auditor;类型化探针优先,观察回退 | 本文把审计从”角色独立”推进到”方法独立” |
| 完成 | done 信号:审计后状态满足任务 | DONE 是提案,fresh-eyes 审计复核全部证据链 | 同构(提案-裁决分离),本文多了”证据链”这一抓手 |
| 恢复 | 重试 + blocked/ask | 角色归因(planner/actor/verifier/env)+ 干预路由 | 本文细一级,对应 LH §8.16 的机制化 |
| 记忆 | 无(每任务从零) | 工作流记忆(advice,离线构建,与 state 分离) | 本文多一层;“advice 不是 truth”与验证纪律自洽 |
| 角色/模型 | 三角色默认同模型 | planner 不碰工具、actor fresh、审计 fresh-eyes(同模型未明说) | 都只做到结构独立(LH §8.3 的批评同样适用) |
| 基准 | WeaveBench/OSWorld 2.0/Terminal-Bench 2.1 | OSWorld-Verified/Mind2Web 2/Minecraft | 无共同基准,数字不可直接比(§8.6) |
回到这篇:两篇合起来读,“状态中心 + 验证式推进”的范式骨架已经完整——LH 给了角色与流程,本文补了状态的生命周期与验证的方法论。缺口的形状也更清楚了:认识论独立性(两篇都同模型,且本文多一层”选探针”通道,§6.6)、验证-重试的止损(本文 retry storm、我的 §6.4)、状态的版本化(Invalidated 是单条撤销,不是可回滚日志,§8.3)。
8.2 探针:把”审计”从人变成仪器
LH 的 auditor 像尽职的内审员:去环境里看,凭判断写报告。本文的 VerifySpec 像给内审员发了一盒仪器:查文件、查 URL、查 DOM、重算数字——仪器读数压过目测(§3.4)。
发散一层(补充):计量学里这叫溯源性(traceability)——读数能追溯到公认基准、且任何第三方拿同一仪器能复现同一读数。LH §8.20 说”让结论可被任何第三方复验”,本文的探针白名单(只读、类型化)是这个方向的第一步工程实现:复验不再需要重放智能,只需要重跑仪器。边界也清楚:探针只能查”环境暴露的状态”(Q3),纯视觉桌面应用退回目测——仪器还没造到那里;而且仪器是 LLM 选的(§6.6),选错仪器的误差进不了探针的确定性。
回到这篇:它没有解决”审计者看走眼”(Q4 里 verifier 仍占 30% 失败),但把”看走眼”的范围从”一切判断”压缩到”探针不适用域 + 选探针的错”。这正好给 LH 研究问题② 一个可操作的实验设计:按 Q3 两轴(观测确定性、环境暴露)分域,测同模型审计在不同域的误报率——“认识论独立性”就有了测量面。
8.3 Invalidated 与 LH §8.12 问题 5:状态版本化
LH 笔记从数据库借了 WAL/回滚(LH §8.4),留下问题 5”状态能不能版本化、可回滚”。本文的 Invalidated 是半步:撤销是记录级的(标失效、留因果、可重做),不是账本级的(回到任意历史版本、批量撤销一批相互依赖的错账)。
发散:分布式系统的账本演进路径是”原地更新 → 追加日志 → 版本向量 → CRDT”(已核对:Shapiro et al., SSS 2011),agent 状态正处在第一到第二格之间。什么时候单条撤销不够?连锁失效:A 失效后,depends_on A 的 B、C 的验证前提全部悬空——它们该自动重判还是等各自被发现?论文没讨论(我的示例第 6、7 轮是 planner 目测下游重做,不是账本自动传播)。连锁失效的自动传播 = 账本需要”失效波”语义,这就是版本化(或至少事务)的入口。这是它留给下一颗种子的洞。
回到这篇:Invalidated 回应了 LH §8.19”事实保质期”的一半(环境推翻了要能发现),另一半(事实随时间过期,如”标签页昨天打不开今天好了”)两篇都没有机制——过期是时间驱动的,推翻是事件驱动的,两码事。
8.4 记忆:advice 与 truth 分账
“memory = reusable advice, not task truth”(附录 D)是一条干净的记账纪律:建议进 planner 的提示,不进状态的账。发散到 LH §8.8 的记忆三策略(存储/检索/更新),本文贡献了第四维——分账(什么放记忆、什么放状态)。
再深一层:分账纪律其实划出了一条风险边界。advice 错了,最多让 actor 绕路(可被验证拦住);truth 错了,直接污染后续所有决策(验证以为不用做)。所以 advice 可以宽松进(离线从成功轨迹筛),truth 必须严格进(只走探针)。Minecraft F.6 的 memory-induced errors(错误复用建议)恰好停在风险边界的正确一侧——坏建议被执行了,但没进账。论文没有明说这条边界,这是我从它的失败模式表里读出来的(补充推断)。
回到这篇:分账 + 探针合起来是”验证只对环境事实说话”——建议的验证是另一套(离线构建时靠成功轨迹筛),两套验证的接口(什么时候允许一条建议晋升为方法/配方)是开放问题。
8.5 评测通道自身的 fp/fn:用通道数学读 Mind2Web
论文附了 judge 可靠性(§4.1):LLM-judge 与人标 86% 一致,FP 4.7%、FN 9.3%。用通道语言读:评测本身也是一个误报/漏报通道,且漏报高于误报——实测分数大概率系统性低估真完成。
再算一步(补充):设真完成率为 \pi,实测分数 \approx \pi(1-0.093)+(1-\pi)\times0.047。若论文报 52.3%、且通道如上,反解真值:0.523=0.907\pi+0.047(1-\pi)=0.047+0.86\pi → \pi=0.553。通道校准后真完成率约高 3 个点。这不是批评(论文公布参数是好实践,多数论文不给),是读数纪律:两个基准的 judge 通道参数不同时,百分比之差小于通道误差量级(约 5 个点)不足为凭。LH 的三个基准都没给这个数——LH 那篇的横向核实遗留里,该给 WeaveBench 补上这一问。
回到这篇:把评测当通道,是横向核实统计审查的一般化——不仅查样本量,还查”测量仪器本身的误差函数”。
8.6 不可比纪律:OSWorld-Verified 78.9% vs OSWorld 2.0 8.3%
两篇的头条数字摆在一张桌上会吓人:StructAgent 78.9%(MiniMax-M3,OSWorld-Verified,369 任务)对 LH 8.3%(Qwen3.7-Plus,OSWorld 2.0,108 任务)。三个变量全不同:基准版本(Verified 是修订评分后的版本,任务集与评分规则都与 2.0 有差异——具体重叠度是尚未补齐的知识点)、模型(MiniMax-M3 vs Qwen3.7-Plus)、评分口径(PRM 计分 vs binary)。
补充:不可比不等于无信息。可比的是各自内部的配对提升(同模型同后端)与机制级证据(我的两个玩具互补:LH 玩具证”换低误报通道”的价值,SA 玩具证”撤销 + 探针级联”的价值——两个玩具合起来构成范式的机制级证据链,各缺的一块恰好是对方补的:LH 玩具没建推翻,SA 玩具没建依赖链)。这正是主张台账存在的理由:把”能比的”和”不能比的”分栏登记,元分析才不会踩坑。
回到这篇:读论文数字,先问”和谁比、什么通道、什么 split”。
8.7 发散收拢
- 状态(8.1):三元组同构、生命周期互补——LH 给流程,本文给账本的生命周期与验证方法论;
- 探针(8.2):审计从角色独立走向方法独立;但选探针是第二层通道(§6.6),两层都要验;
- 撤销(8.3):Invalidated 是 LH 问题 5 的半步答案;连锁失效与时间性过期是两个明确的洞;
- 记忆(8.4):advice/truth 分账划出风险边界——建议可宽松进、事实必须严格进;
- 评测(8.5/8.6):judge 也是通道,公布 fp/fn 才能校准读数(校准后 Mind2Web 真值约 +3 点);两篇头条数字不可比,可比的是配对提升与机制级证据;
- 止损(§6.4 + retry storm):验证-重试循环需要最优停止;均值平缓、尾部悬崖是二次破坏的形状。 收拢一句:这篇把 LH 立起的范式从”有没有状态”推进到”状态怎么生、怎么死、怎么验”——账本有了生命周期,这套范式的骨架才算搭完整;而账本的下一步是版本化与两层验证(选仪器的人也要被验),那是下一颗种子的事。
九、局限与可疑处
- “统一因果结构”名不副实(补充,标题批评)。全文的”causal”实为”验证式转移的审计依赖链”(depends_on + evidence chain),没有干预/反事实意义上的因果推断。标题的 causal structure 会误导读者期待 do-calculus 层面的东西。按内容叫”verifier-backed task ledger”更诚实。
- verifier 仍是最大失败源之一。Q4 角色归因:actor 33%、planner 30%、verifier 30%、环境 7%——最大单一失败类型是 state verification 错误(接受弱证据/漏检/没发现进度被推翻)。审计升级了,审计者还是同模型的 LLM;且按我的 §6.6,其中一部分是”选探针”的错,探针的确定性治不了它。
- 结构化预充可能泄漏任务信息(§5 自认)。OSWorld-Verified 实施里预填了日志类文件的公共信息——这会让”环境暴露任务状态”的域占比上升,恰好是探针最有利的域,Q3 的结论有自我加强之嫌。
- 小幅提升统计不显著(手算,见 §3.4 的尺子)。MiniMax-M3 75.2→78.9:z=1.19(p≈0.23);GPT-5 71.3→73.9:\bar p=0.726,z=0.79(p≈0.43);Gemini 3.1 Pro 74.4→75.8:\bar p=0.751,z\approx0.44。三个闭源/强模型上的提升全在噪声内,只能读作”不拖后腿”。全文无置信区间(与 LH 同病)。大模型档(9B/27B)的 +19.9/+30.6 点则稳过显著线(z=5.6 与更高)。
- 依赖图/组合检索等组件无主基准消融。组合检索 vs 顺序检索只有 Minecraft 附录 17 任务(0/17→11/17,方向极强但样本小,\sqrt{0.65\times0.35/17}\approx11.6 个点的标准差量级);planner 的 depends_on、双级验证的边界复核,主基准均无组件级消融——“哪个机制贡献多少”读不出。
- 结构化探针的适用域有边界(Q3 自认):纯视觉桌面应用、Mind2Web 视觉 split 不命中——恰好是真实用户桌面的常见形态。
- 多 agent、记忆共享风险未涉及(§5 自认);闭源模型 API 变化时无 memory 会回落。
- 案例与机制声称间的空隙:DONE gate 数字(Table 6/7)来自 100 个交互的复核子样本,样本不大且是论文自评;无第三方复核。
十、验证结果(最小复现)
脚本:repro/repro_structagent.py;真实输出:repro/repro_structagent_output.txt(500
任务 × 3 系统,链长 8,q=0.85,推翻率 r=0.10,观察通道 \mathrm{fp}_o=\mathrm{fn}_o=0.10,探针适用
p_d=0.60,SA 抽检率 0.30,预算 200
步,seed=20260828)。这是核心思想的最小演绎,不是论文基准复现;论文数字只引用。
机制映射(玩具 → 论文):三态标签 + 验证放行(§3.5 式 3)→ 每轮 audit 决定记账;探针级联(§3.4)→ audit 先以 p_d 走确定性通道;撤销复查(§3.5/§3.6)→ SA 每轮抽检已验证成果 + DONE 前全量复查,发现推翻则 Invalidated 重做。基线两枚:baseline(自报推进,无状态无验证)、LH 式(单调状态 + 观察审计,admit 后不回退——对应 LH 的 admit 规则,未建其全程完整性监视,边界见判读)。
先写预测(G3,先于运行):
- 预测 1:全任务真完成率 SA > LH 式 > baseline。
- 预测 2:LH 式无撤销,被推翻成果静默记为 completed;SA 的抽检 + DONE 全量复查压低假完成。判据:SA 假完成 < LH 式的一半。
- 预测 3:SA 假完成随 p_d 单调下降;p_d=0 时 SA ≈ LH 式;p_d=1 时趋零。
结果(r=0.10 主设定):
| 系统 | 真完成/8 | 假完成/8 | 全任务真完成率 | 平均步数 |
|---|---|---|---|---|
| baseline(自报) | 5.44 | 2.56 | 4.4% | 9.4 |
| LH 式(单调状态+观察审计) | 5.15 | 2.85 | 2.4% | 10.1 |
| SA 式(三态+级联+撤销) | 7.33 | 0.67 | 49.6% | 16.5 |
扫描:p_d 从 0 到 1,SA 假完成 2.75→0.00(单调降),LH 式恒 2.85;r 从 0 到 0.30,SA 真完成率 99.6%→0.6%,LH 式与 baseline 在 r\geq0.05 即崩到 15% 以下、r\geq0.20 归零。
判读:
- 预测 2、3:支持,且与解析互证:假完成 2.85 对照 §6.1 手算的期望 2.31(同量级,差值来自通道自身误报的额外假完成);p_d 扫描的线性下降形态对照级联式 (1-p_d)\mathrm{fp}_o。撤销机制把全任务真完成率从 2.4% 拉到 49.6%,代价步数 +63%——§6.2 的结论:错误被逐出终止状态,只在过程中逗留,货币是重做。
- 预测 1:部分支持,意外处如实登记。SA 第一成立;但 LH 式(2.4%)低于 baseline(4.4%)。机制即 §6.4 的二次破坏:观察通道漏报触发重试,重试动作又按 r 推翻已完成成果——均值差 11%(手算 3.66 vs 3.29 次暴露),尾部(8 条同时成立)差近一半。要说明:这不是 LH 论文的错(其 auditor 有全程完整性监视,我的玩具没建),但意外恰好把”漏报重试的隐性成本”isolated 出来——与论文 retry storm(附录 F.6)同构。如果给 LH 式加上”每轮全量审计 + 重试止损”,它应当翻回 baseline 之上——这是第四系统实验(未攻克 ④)的预注册预测。
- 边界:玩具的推翻是独立同分布的,真实环境的推翻集中在特定操作(覆盖文件、重装);SA 的 DONE 复查在玩具里全量、论文是证据链复核;预算截断的任务按当前真值计(偏保守)。
配图(figures/html/*.html + render.sh 无头 Chrome 渲染,与第一篇同管线;make_figs_structagent.py 为初版 matplotlib 方案,已被取代仅存档):
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。L1 四件套首例即立卡;L2 仅 ≥2 独立领域同构时立。(本节 2026-09-08 后填,体例回铺,时序显式标注。)
11.1 双通道验证与三态记账(dual-channel verification, tri-state ledger)
- 层级:L1 领域具体(agent
状态管理)。底层原理:信号稳定性检验(L2
卡已立:
notes/method_perturbation_stability.md——冗余通道 + 一致性要求挤出不可信部分)。 - 操作定义:成果入账走两通道(执行者自报 + 独立审计探针级联),三态转移 pending / verified / invalidated;已入账成果仍被抽检 + DONE 前全量复查,发现推翻即回滚重做。复玩数字:假完成 < 单调状态式的一半(0.67 对 2.85/8),撤销把全任务真完成率 2.4% → 49.6%,代价步数 +63%。
- 迁移去向:①一切”自报型”流水线的可信化改造(代码评审、标注质检、评测自评);②长程记账系统的回滚设计。
- 失效边界:两通道相关(审计与执行共享盲区)时一致性是假安心;回滚的货币是重做步数,预算紧的任务要给抽检率定预算(p_d 扫描:假完成随 p_d 单调降)。
- 方法卡:
notes/method_dual_channel_verification.md(L1)
11.2 advice 与 truth 分账(separate ledgers for advice vs truth)
- 层级:L1 领域具体(agent 记忆设计)。
- 操作定义:把”可变的建议”(advice)与”已验证的事实”(truth)记入不同账户——建议可被覆盖更新,事实只能被验证推翻;防止经验性输入污染已确证状态(本篇 §5.5)。
- 迁移去向:①记忆系统设计(用户偏好与已确认事实分储);②提示词工程(few-shot 示例与硬约束分区)。
- 失效边界:分账粒度过细带来记账开销与合并难题;advice 的可信度本身需要溯源,否则只是延迟污染。
- 方法卡:
notes/method_advice_truth_ledger.md(L1)
11.3 方法依赖
本篇产出 L1 两张(双通道验证三态记账 / advice-truth 分账),前者挂”信号稳定性检验”(MPERT)原理下。复玩中的意外(LH 式漏报重试翻车,真完成率反而低于 baseline)反向喂给 LH 篇 §11.1 的失效边界,并预注册第四系统实验(未攻克 ④)。
十二、没搞懂的地方(未攻克登记)
- 连锁失效怎么处理:A 被 invalidate 后,depends_on A 的 B/C 是否自动重判?论文未写。(补齐时机:读代码 repo 的 update 实现。)
- 探针的”适用”与选择由谁判定——LLM 自己选探针就可能选错(§6.6 的 \varepsilon),Q4 的 verifier 错误有多少出在选探针?(补齐时机:repo 的 VerifySpec 生成逻辑。)
- OSWorld-Verified 与 OSWorld 2.0 的任务重叠度:两篇论文的”OSWorld”到底差多少任务、评分规则是否一致。(补齐时机:拉两个基准的任务列表比对。)
- 我的玩具对 LH 完整性监视的简化是否公平:给 LH 式加”每轮全量审计 + 重试止损”的第四系统,能否翻回优势?(补齐时机:改 repro_structagent.py;预注册预测已写在 §十 判读。)
- Minecraft 组合检索 11/17 的置信区间:17 个任务上 0/17 vs 11/17 方向明确但样本小(SE≈11.6 点),论文是否有更大样本。(补齐时机:读附录 F 原文数字。)
十三、可信度
- 核心机制(三态状态 + 探针级联 + 撤销复查)能提升长程可靠性:较高。依据是论文小/中模型两档配对提升过显著线(z=5.6 级),加模型-实测-人审三层互证(§6.3)。我的复现(图 7/8)不在这条判断的证据链里——参数自设,它是自洽性演示加机制解耦隔离(级联管误报、撤销管推翻,贡献各自单独可见),不是对论文真实数字的独立佐证。
- “结构化证据提升验证质量”(Q2,Table 6/7):中高。recall +0.14、分歧复核 63% vs 31% 与级联模型预测一致;但子样本 100 个交互、论文自评。
- 闭源/强模型上的小幅提升:低。z=0.42–1.19,全在噪声内;读作”不拖后腿”。
- “causal structure”作为框架命名:低(§九.1,名实不符)。
- 结构化预充不泄漏任务信息:存疑(§5 自认风险 + Q3 自我加强之嫌)。
- 撤销机制的增益归因(vs 单纯多花步数):中高但未隔离。复现里 SA 步数 +63%——按 LH §8.12 问题 2 的教训,“多回合多预算”混杂仍在;第四系统(同预算下 LH+全量审计)能部分隔离。