外行导读(先读这个,再决定要不要进正文)
一个场景:你让 AI 助手在电脑上替你干一件长活——改一个项目,或者把一套跨界面的工作流从头走到尾。它干着干着就开始”觉得”自己做完了:没人拦着它的自我判断,判断错了还被当成下一步的前提接着用。于是小错滚成大错,它甚至在同一个地方反复空转几百步。毛病不全在模型笨,而在它把干活、记进度、判完成全塞进同一条越来越长的对话里——对话越长越难用,自报的”做完了”又没人对账。
这篇论文干的事:阿里巴巴的团队干脆不动模型,只在模型外面加一层壳(论文叫 harness):把任务状态从对话里拿出来,做成一份外置的账本;干活的执行者每轮领一张”合约”、拿全新上下文只干一件小事,干完原始轨迹就丢;再设一个只读环境的审计者,“做没做成”由它对着环境核实,核实过的才有资格记账。这套”管理—执行—审计”的循环套在现成 agent 后端上,在三个计算机使用基准上验证:最稳的主对照里,成功率从五成出头提到八成——同一批模型,只换了这层壳。
为什么值得关心:它把一个判断坐实了:agent 的能力是”模型 × harness”的系统属性,不全是模型的内功。任何要靠反馈一步一步往前推的长流程——不一定是 AI,项目、流水线、你自己的多步计划都算——都吃这条规律:进度要外置成账本,“做没做成”要让独立核对说了算,不能让干活的人自己拍脑袋宣布完工。
这份精读的信用,先押在这里:关键数字逐条标了原文页码;论文之外的外部断言逐条登记核对状态;第六节的机制账配了一个 400 次模拟的玩具复现,脚本和输出都在仓库里可独立重跑,哪条预测没过第十章也如实记着。下面每个判断,都踩在这些可查的东西上。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| harness | 包在模型外面的系统外壳,管提示、工具、上下文和分步执行 |
| 长征程任务(long-horizon) | 步数多、步骤互相依赖的长任务;难在跨步保持一致 |
| 任务状态 | 外置的账本:还剩哪些要求、产出了什么、核实过哪些事实 |
| fresh-context | 执行者每轮用全新、有预算上限的上下文只干一件事,原始轨迹用完即弃 |
| 审计(auditor) | 只读地到环境里核实”真做成了没有”;审计报告是唯一能推进账本的东西 |
| 自评偏差 | 干活的人自己说”做完了”——既当运动员又当裁判,不可信 |
| 上下文腐烂(context rot) | 对话越长,相关信息越难被找到、被用上,表现明显下滑 |
| Manage–Execute–Audit | 本篇的核心循环:管理者派活、执行者干活、审计者验收 |
| 假完成 | 没做成却被判成”完成”——因为会被当成后续步骤的前提,一错就错一串 |
§0 承接栏
这篇是本站的第一颗种子,后面所有的讨论都从这里出发。它回答的问题很根本:AI agent 做长任务时,为什么做着做着就崩了? 答案朴素得近乎扫兴——执行和状态管理绑在了一起。干活的 agent 自己判断自己做完了没有,判断错了没人拦,错判还被当成下一步的前提接着用,于是一步虚、步步虚。论文开的方子顺着病根来:把状态从执行里拿出来,放到外面,只用”环境里独立核实过的事实”来更新。后面六篇——StructAgent 的账本生命周期、ToolVerse 的训练数据生产、MT-GRPO 的评分粒度、SimpleTIR 的毒轨迹删除、DAPO 的工程旋钮、Dr. GRPO 的归一化偏置——都是在不同方向上回应这个起点。
一、论文在解决什么问题
你让 AI 助手在电脑上做一件很长、且步骤互相依赖的事:改一个项目,边整理证据边修公式,或者跨界面完成一整套工作流。它一边做,一边自己判断”这步做完了”“那步还差一点”。可它的判断不完全可靠——有时它以为做完了,其实没做成,或者只做对了一半。
活一长,麻烦就出在”连贯”上:它把干活的上下文、记的进度、判断是否完成,都塞进同一条越来越长的对话里。真实进度被淹没,它错误的”我感觉完成了”又被当成下一步的依据,于是错误逐级放大,甚至在一个地方空转几百步。论文把这类活叫长征程任务(long-horizon task),并归纳了三个具体麻烦(p.2)。
1.1 三个麻烦:小错滚成大错,长对话没法用,状态保不住
- 错误累积与目标漂移。前面的小错会扭曲后面的判断,把系统慢慢带离原目标。METR 报告说前沿 agent 能完成的任务地平线大约每七个月翻倍,近期模型约四个月(p.2,引 Kwa et al., 2026);但地平线变长并不等于更可靠,反而让错误的链条更长。
- 上下文腐烂(context rot)。交流历史越长,相关信息越难被找出来、被用上,越过一个临界点后表现明显下滑。这和”迷失在中间”(lost in the middle)是同一类现象。
- 任务状态丢失。要完成长任务,得有一个准确、最新的任务状态:哪些要求还没满足、哪些产物已经产生、从环境里发现了什么事实。系统常常保不住、也更新不好这个状态。
1.2 病根两处:状态记在对话里,完成由干活的自判
现在 agent 靠一层”harness”(Claude Code、Codex CLI、OpenClaw 这类)来组织提示、工具、上下文和分步执行(p.2)。它们已经能做规划、拆任务、用工具、用子代理,但仍然有两个结构性问题:
- 执行和状态管理共用一个会增长的上下文。agent 用同一个上下文既干活又记状态,执行历史一长,状态就难跟踪。
- 执行和”判断完成”耦合在一起。干活的这个 agent 自己判断自己做完没有,判断错了会被当成事实记进状态,再被当成后续决策的前提。
两桩毛病摸到了,论文的刀就落在这两个接口上:状态外置治”记在对话里”,裁决外移治”干活的自判”——下一节的方子就照这两个接口开。
二、核心想法
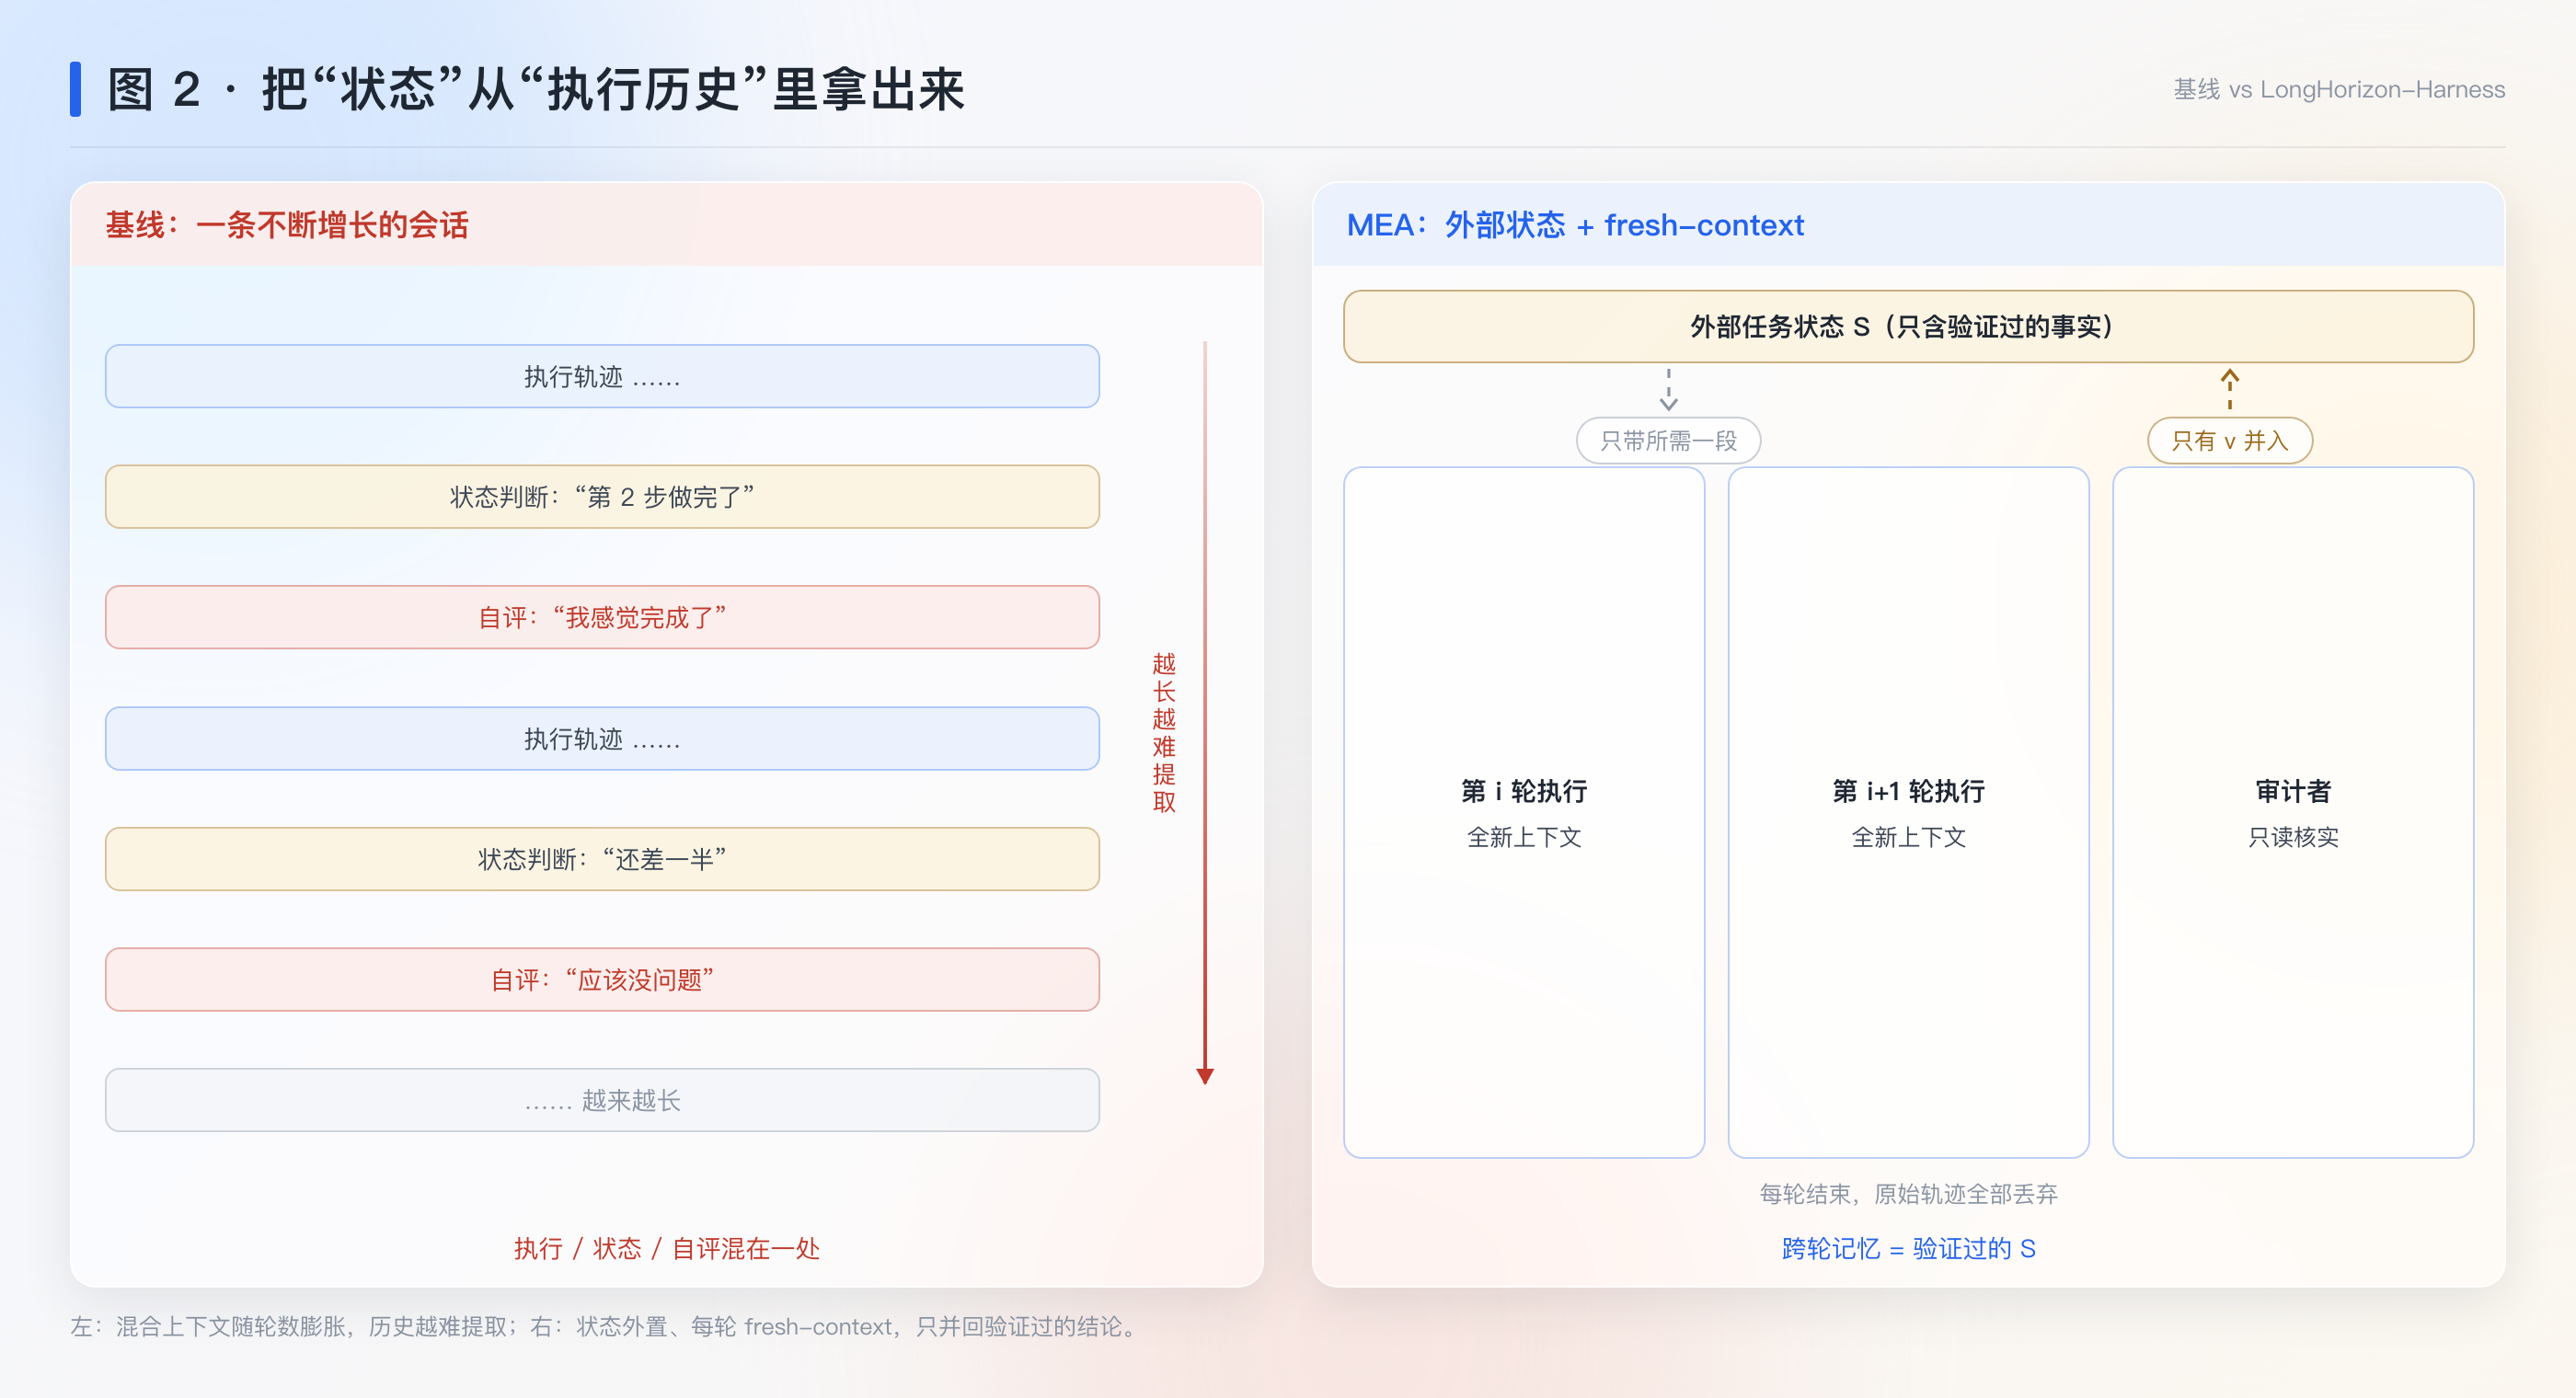
一句话:长征程执行的病根不在模型不够聪明,而在执行与状态管理绑在一起;把任务状态外置成一份显式账本,只用环境里独立核实过的事实来更新,“做没做成”就不再由干活的角色自己说了算。——论文把”长征程执行”重新理解成了”任务状态管理”。
这个论断往深一层想,是在追问”跨步的记忆放在哪里”。原来的做法是一条不断增长的会话:干活的上下文、记的进度、完成判断,全挤在同一条对话里。这里头藏着两层别扭——上下文又当工作台又当档案柜,越用越难用;判断又没有对账,自己判自己做完,错了还被记成事实。所以这篇给的答案不是”把模型调聪明点”,而是把”跨步的记忆”从模型的脑内挪到系统手里:记忆放在哪、由谁来记,本身就是长任务可不可靠的原因。
先打个比方。一家公司接一个跨年的大工程,进度不能指望某位员工用脑子记——脑子会累、会忘,人还会离职。要立一本账。而立账有立账的规矩:不是谁喊一句”我做完了”就能销账,每一笔都要有凭证、对过实物才能入账。账在,人可以换,会话可以丢,工程照样往前推。
再把比方译回工程语言。论文改掉两点:
- 把任务状态从执行里拿出来,放到执行之外,成为一份显式记录。
- 状态只用”在环境里独立核实过的事实”来更新;下一步做什么,由这份状态和原目标推导。
这样,“做没做成”不再由干活的角色自己说了算。论文把这个过程写成一系列被独立审计的状态转移,跨轮之间只保留压缩、被验证过的任务状态,丢掉执行器的原始轨迹。
落到形式上,这套重构往后两节展开:第四节给出一套记号——三个角色函数、一份带状态标签的任务状态结构;第五节把”管理—执行—审计”循环逐角色拆开;第六节再算细账,你会发现它在数学上等价于把”完成判定”从一条误报率高的通道换到一条误报率低的通道。
所以它把问题重新形式化成了什么:把”长征程执行”从”把一条对话续写下去”改写成”维护一份账本直到账平”。模型的职责收窄为”单步把活干好”,跨步的一致性交给了系统——这也是后来”能力 = 模型 × harness”这个判断的出处:同一个模型,换一层外壳,可靠性大不一样。
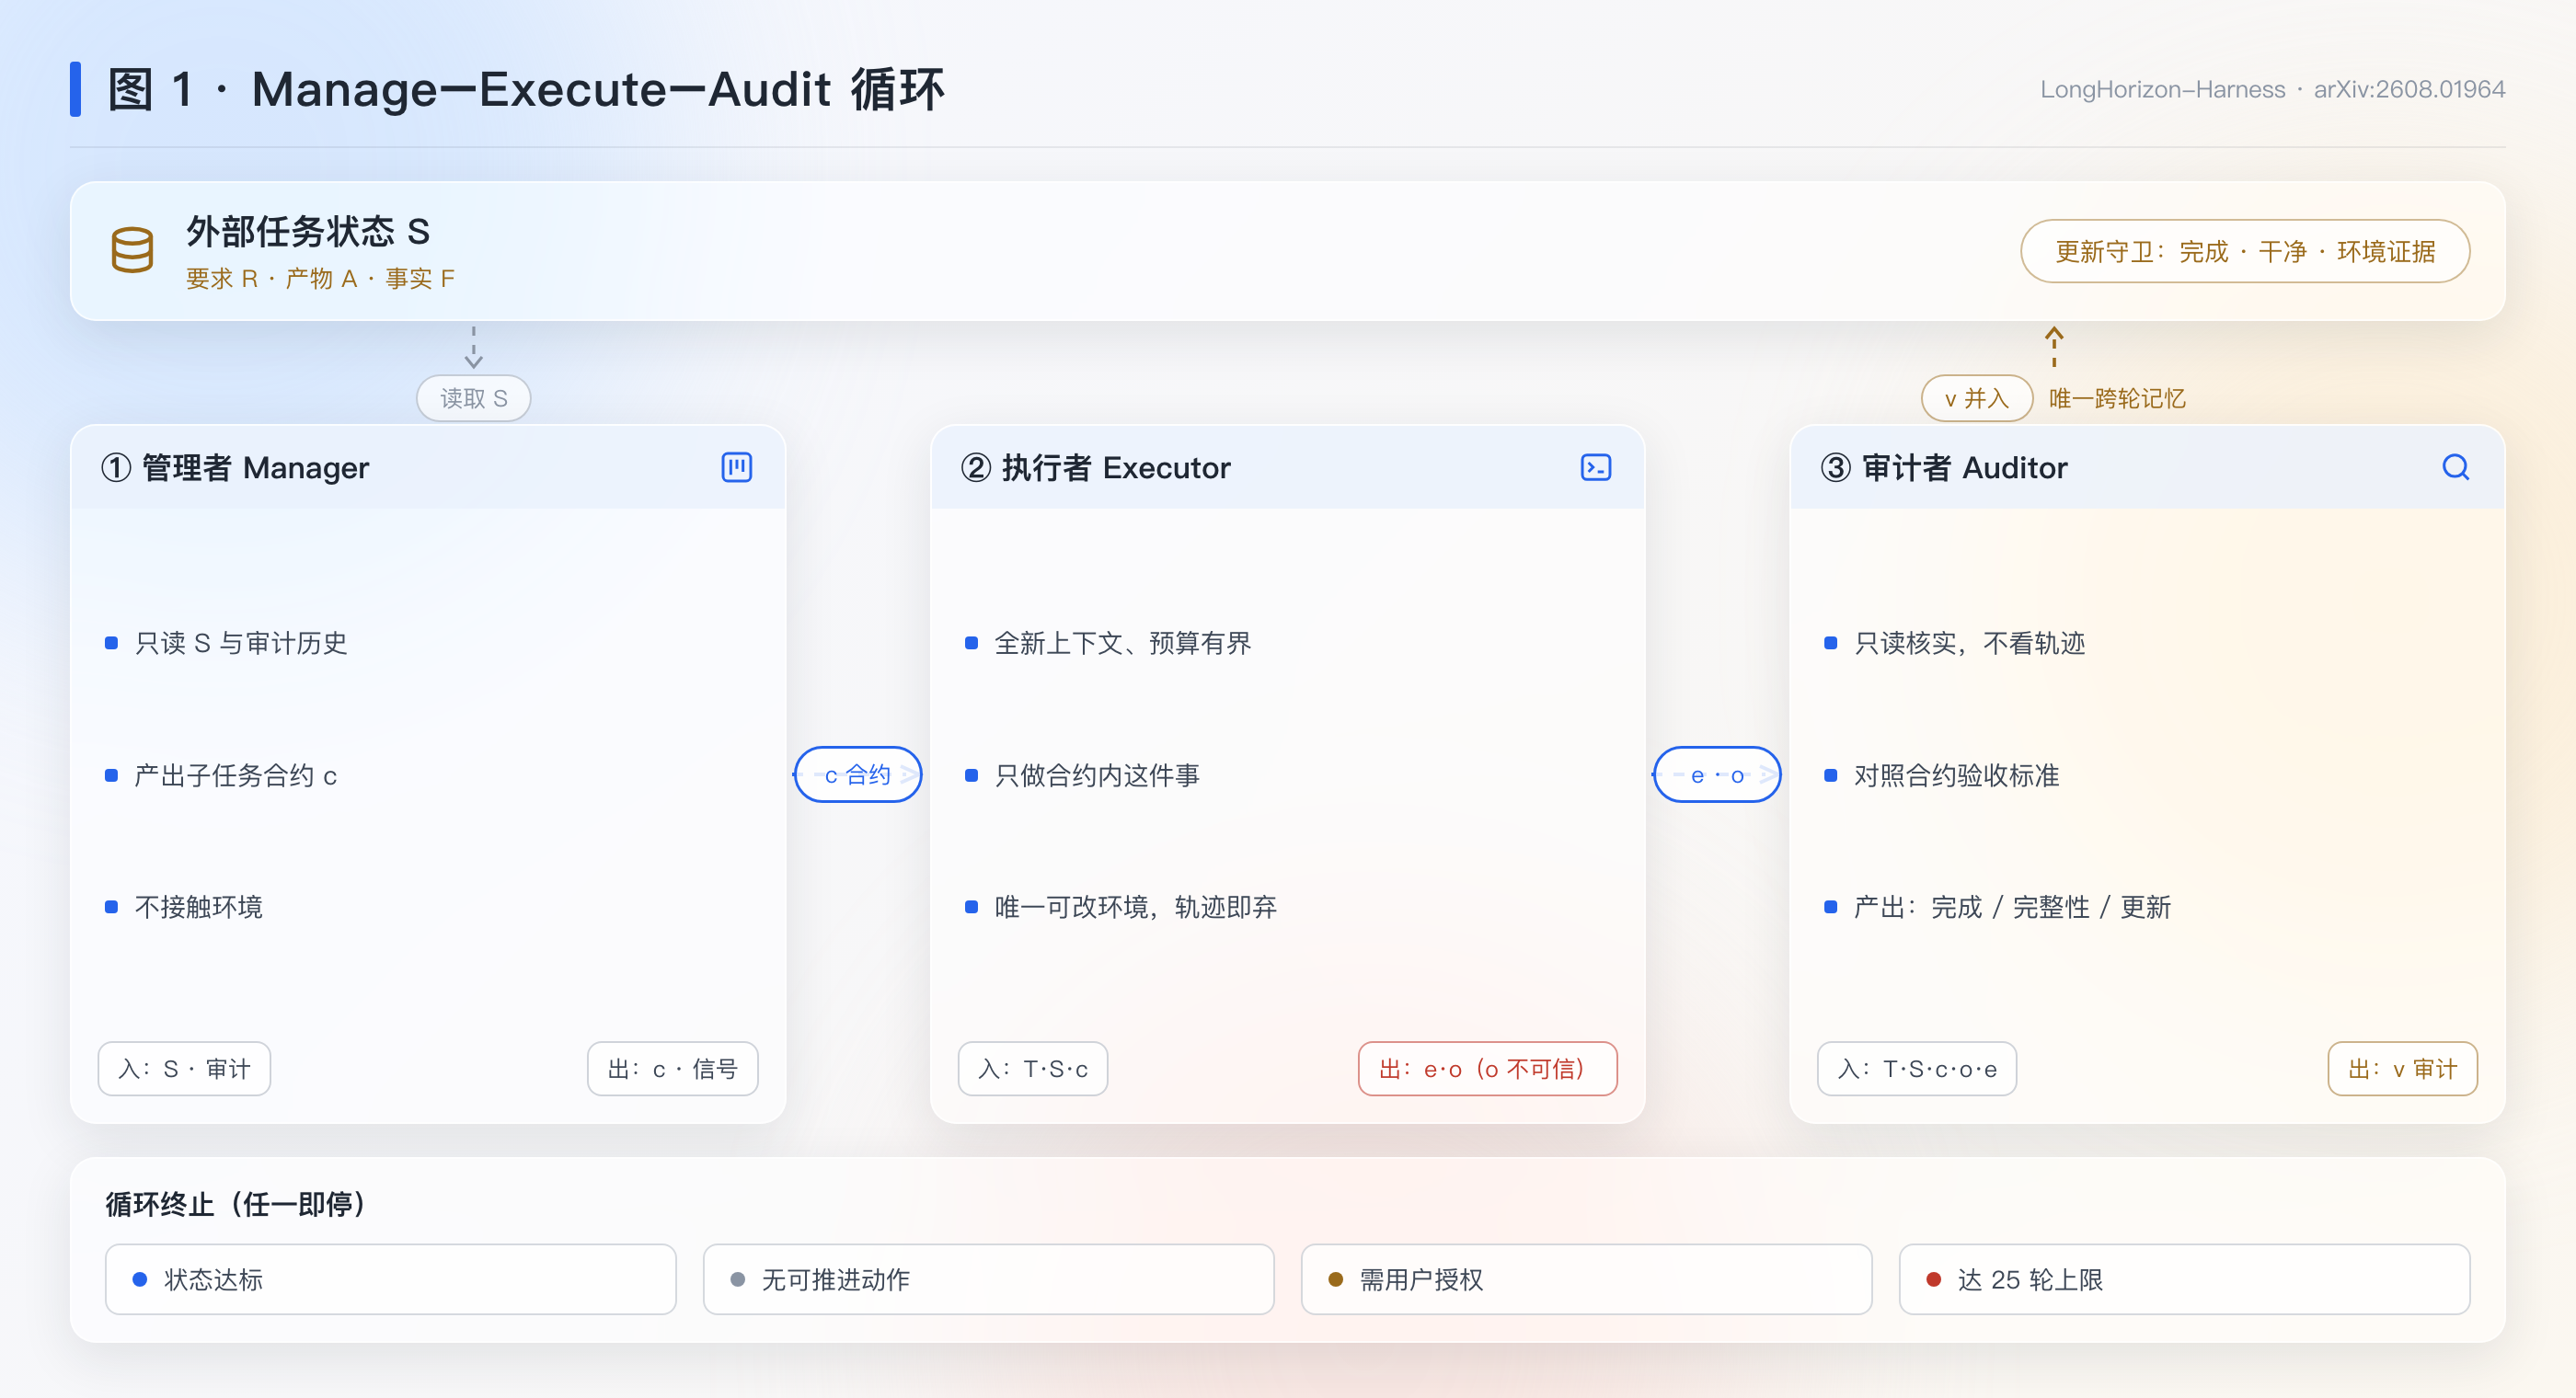
全篇就看这张:图 1(§5.0)——Manage–Execute–Audit 循环:管理者按账派活、执行者拿单进场、审计者只认现场,任务状态被外置成一张可核对的账;后面所有机制与数学都挂在这个循环上。 ## 三、数学基础(零起点)
进机制之前,先把工具备齐。这篇论文没有矩阵、微分那类公式,它的形式化在状态机层面;但要把”只信审计”这件事讲透,需要一小套概率工具。这一节把每件工具从零讲起,全部配手算数字,第六节再让它们逐个上机制的正席。假设读者没学过概率论——不必担心,下面用到的每一样,都可以按”一百次里几次”来读。
3.1 概率:就是频率的抽象
第一件工具是概率。为什么先备它?因为这篇通篇在做同一件事——比较:自报的通道和审计的通道,谁的话更可信?凡比较就要有尺子,概率就是那把尺子。
抛 100 次硬币,正面朝上 51 次,我们说”正面朝上的概率约 0.51”。概率是一个 0 到 1 之间的数:0 表示不会发生,1 表示一定发生,0.85 表示长期来看每 100 次里大约 85 次。本文所有概率都可以按”100 次里几次”来读。记住这个读法就够用了——后面每一次”该不该信一次宣称”的计算,站的都是这把尺子。
3.2 条件概率:缩小范围再看
第二件工具回答一个更贴身的问题:听到一句”做完了”,能信几分?这类问题全都要靠条件概率来答。
P(A\mid B) 读作”在 B 已经发生的条件下,A 的概率”。算法是:只看 B 发生的那些情况,数其中 A 占多少。
用一个贯穿全文的数字例子。设有一大批子任务,先验上 80% 真的完成了、20% 没完成。抽 1000 个:
| 真完成 | 未完成 | 合计 | |
|---|---|---|---|
| 数量 | 800 | 200 | 1000 |
审计者去看这 1000 个,说”完成”的有 766 个(下面 5.3 讲 766 怎么来)。那么”在审计说完成的条件下,真完成”的概率是
P(X{=}1\mid a{=}1)=\frac{760}{766}\approx 0.992
分母不是 1000,而是 766——这就是”缩小范围再看”。(注:KaTeX 单元格内不放中文,本式的文字读法是——在”报完成”的 766 个里,真完成占 760。)
后面贝叶斯那一条算”报完成里有多少是真的”,用的正是这一手;先把”缩小范围再看”记牢。
3.3 误报与漏报:观测通道的两个误差
第三件工具把”观测”这件事拆开看。真值看不见,我们就只能靠”观测通道”去报:执行者的自述是一个通道,审计者是另一个。可通道自己会出错,误差有两种,各有名字:
- 漏报率 \mathrm{fn}:真完成的事,被报成”未完成”的概率;
- 误报率 \mathrm{fp}:没完成的事,被报成”完成”的概率。
记真值为 X\in\{0,1\}(1 = 真完成),观测为 s(自报)或 a(审计):
P(s=1\mid X=1)=1-\mathrm{fn}_s,\qquad P(s=1\mid X=0)=\mathrm{fp}_s
审计者同理,把 s 换成 a。用具体数字代入(本文数值例的假设值):漏报 \mathrm{fn}_s=\mathrm{fn}_a=0.05;自报误报 \mathrm{fp}_s=0.18,审计误报 \mathrm{fp}_a=0.03。这些是模型假设,不是论文的测量值——它们的作用是把机制算给你看。
回到 5.2 的 1000 个子任务,审计通道的 766 就来了:
- 800 个真完成,报完成:800\times(1-0.05)=760;
- 200 个未完成,误报完成:200\times0.03=6;
- 合计报完成:760+6=766。
自报通道同样算:800\times0.95=760 个真完成报完成,200\times0.18=36 个误报,合计 796。
漏报、误报这一对符号,往后是机制数学里戏份最重的配角——验证当滤波、链式放大,台前幕后都有它们。
3.4 贝叶斯定理:用一次观测修正信念
工具备到第四件,就能问那个最关键的问题了:审计说”完成”之后,这一步其实没完成的概率是多少?直接从 5.2 的表里数:报完成的 766 个里有 6 个是假的,
P(X=0\mid a=1)=\frac{6}{766}\approx 0.0078=0.78\%
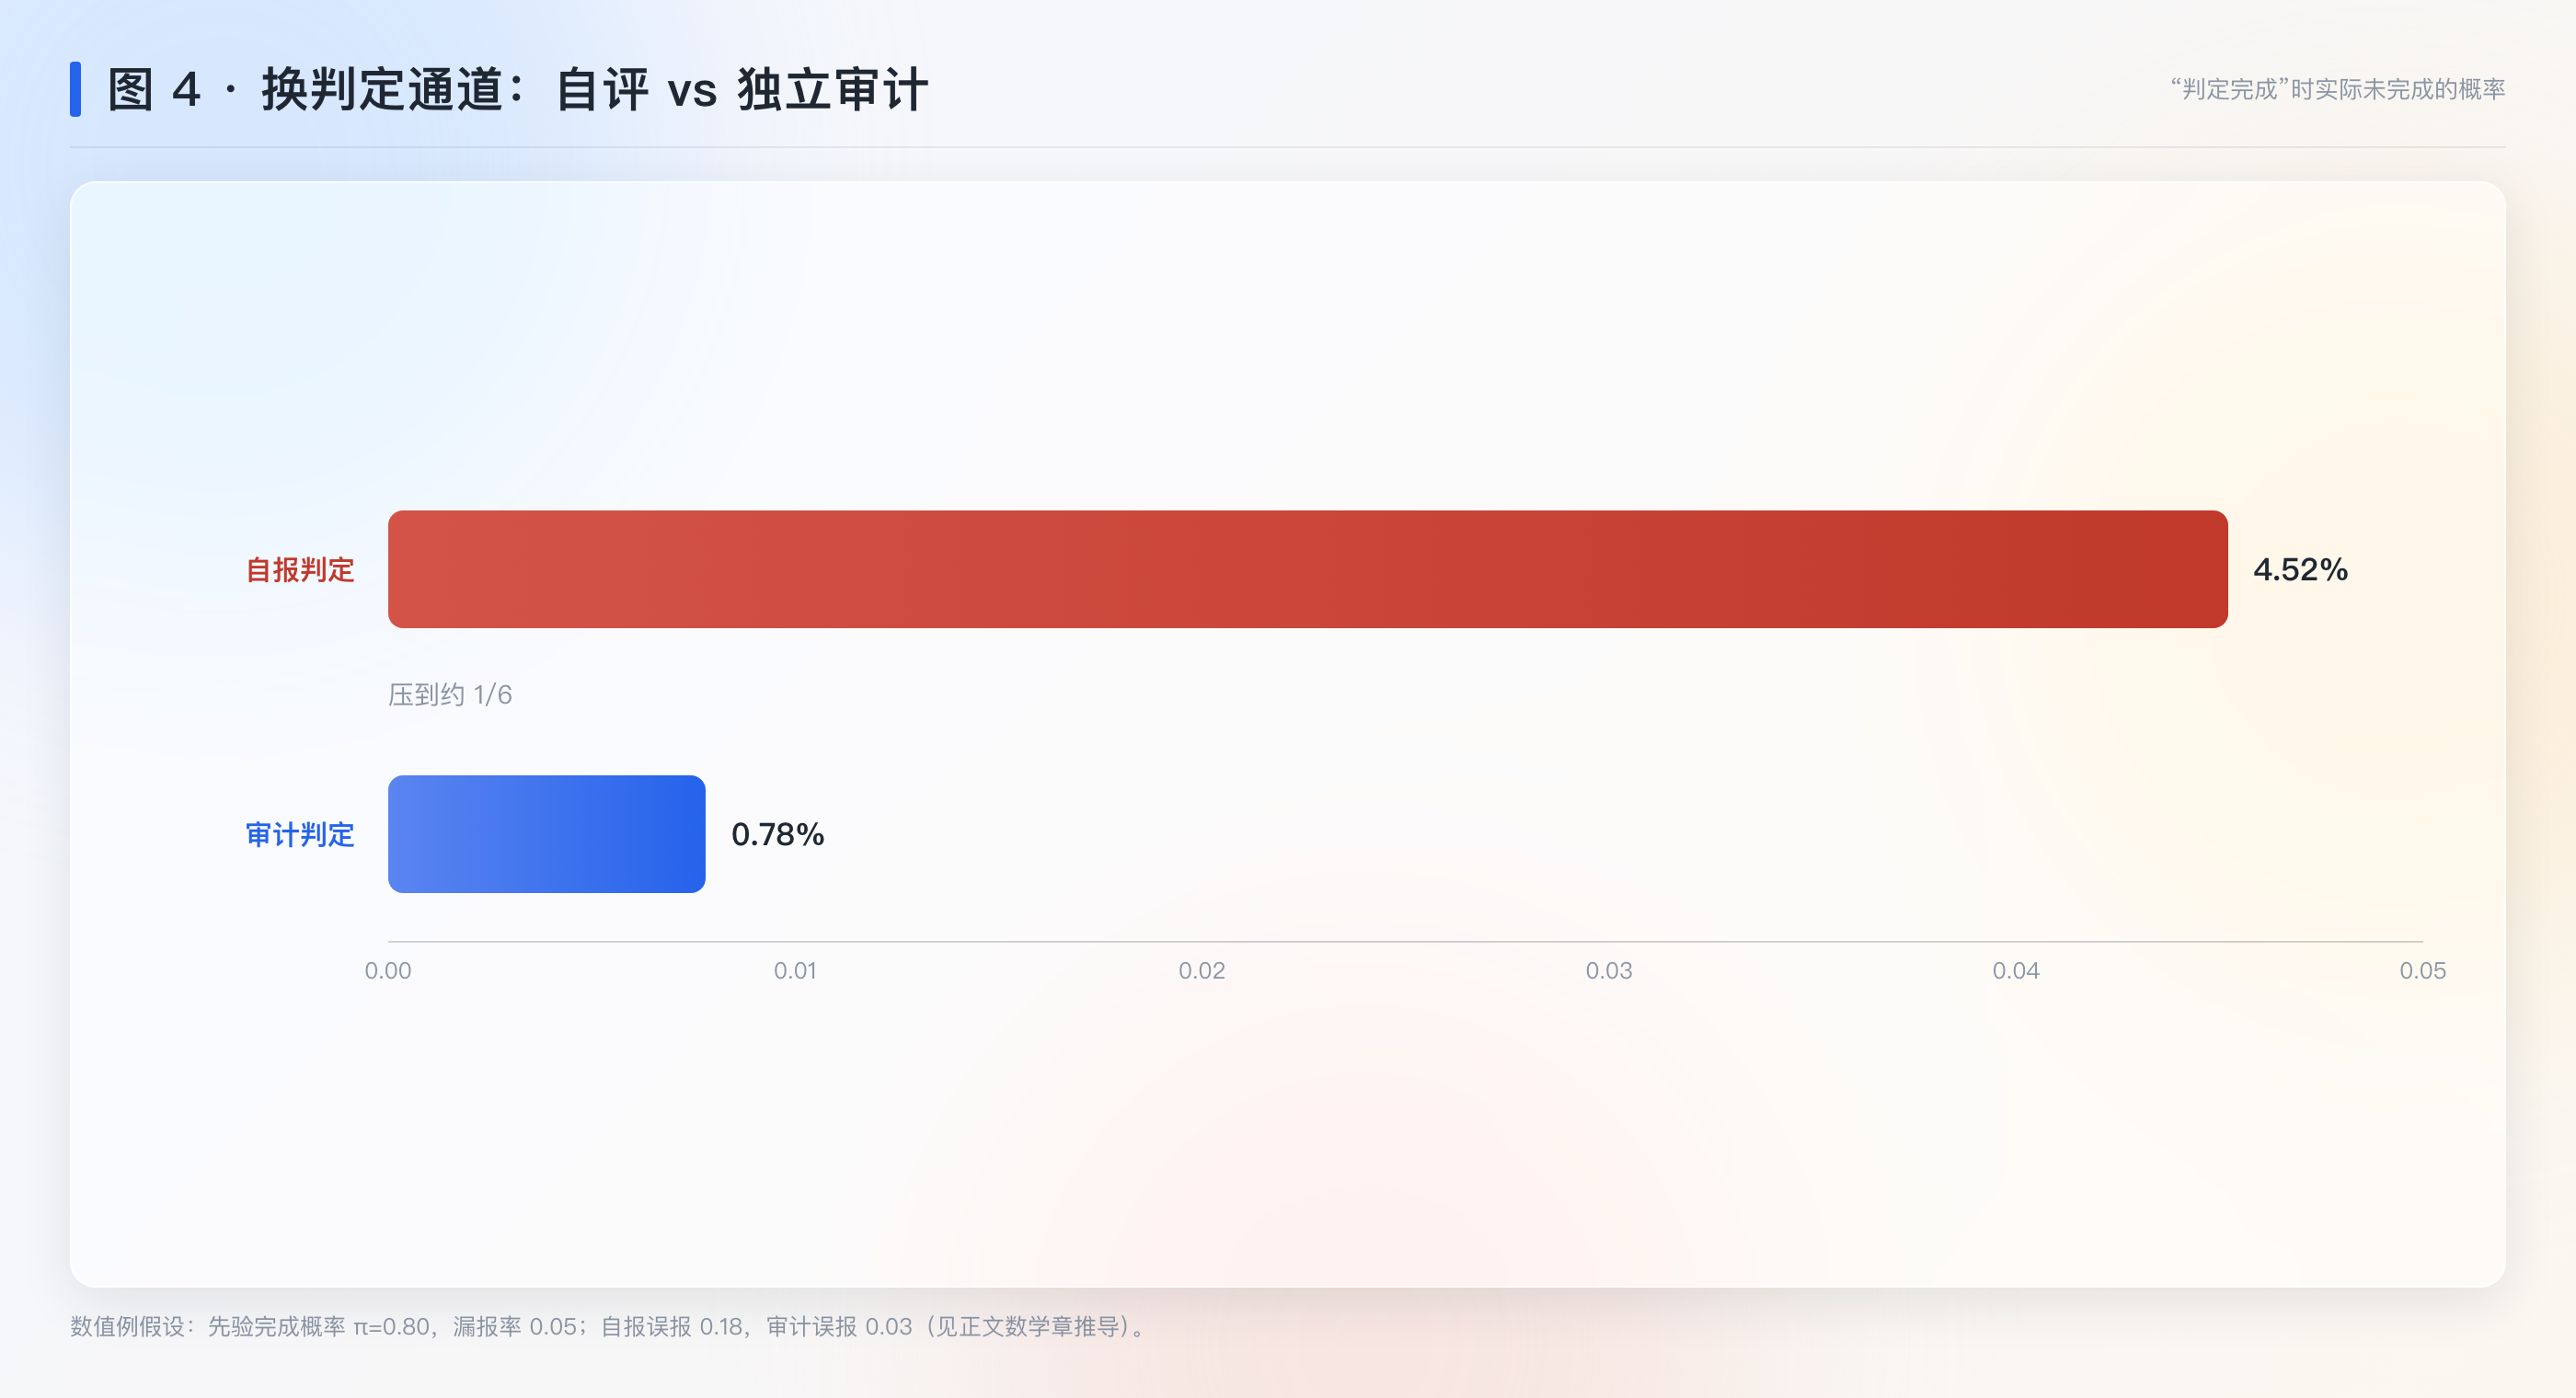
自报通道同样数:36/796\approx 0.0452=4.52\%。这就是”贝叶斯更新”的全部内容:先有一个先验(80% 完成),拿一次观测(报完成),把信念修正一次。
写成公式。贝叶斯定理说”B 发生后 A 的概率 = A,B 同时发生的占比”:
P(X=1\mid a=1)=\frac{P(a=1\mid X=1)\,P(X=1)}{P(a=1)}
分母展开成两种”报完成”的来源(真完成被报 + 未完成被误报):
P(a=1)=\underbrace{(1-\mathrm{fn}_a)\,\pi}_{\text{true positive}}+\underbrace{\mathrm{fp}_a\,(1-\pi)}_{\text{false positive}}
其中 \pi=P(X=1)=0.8 是先验。两个花括号:前者是”真完成且被报完成”,后者是”没完成却被误报”。代入:
P(X=0\mid a=1)=\frac{\mathrm{fp}_a(1-\pi)}{(1-\mathrm{fn}_a)\pi+\mathrm{fp}_a(1-\pi)}=\frac{0.03\times0.2}{0.95\times0.8+0.03\times0.2}=\frac{0.006}{0.766}\approx0.78\%
和表格数出来的 6/766 完全一致——公式只是表格的代数化。自报通道 36/796=4.52\%。审计把”假完成”残留压到约 1/5.8。
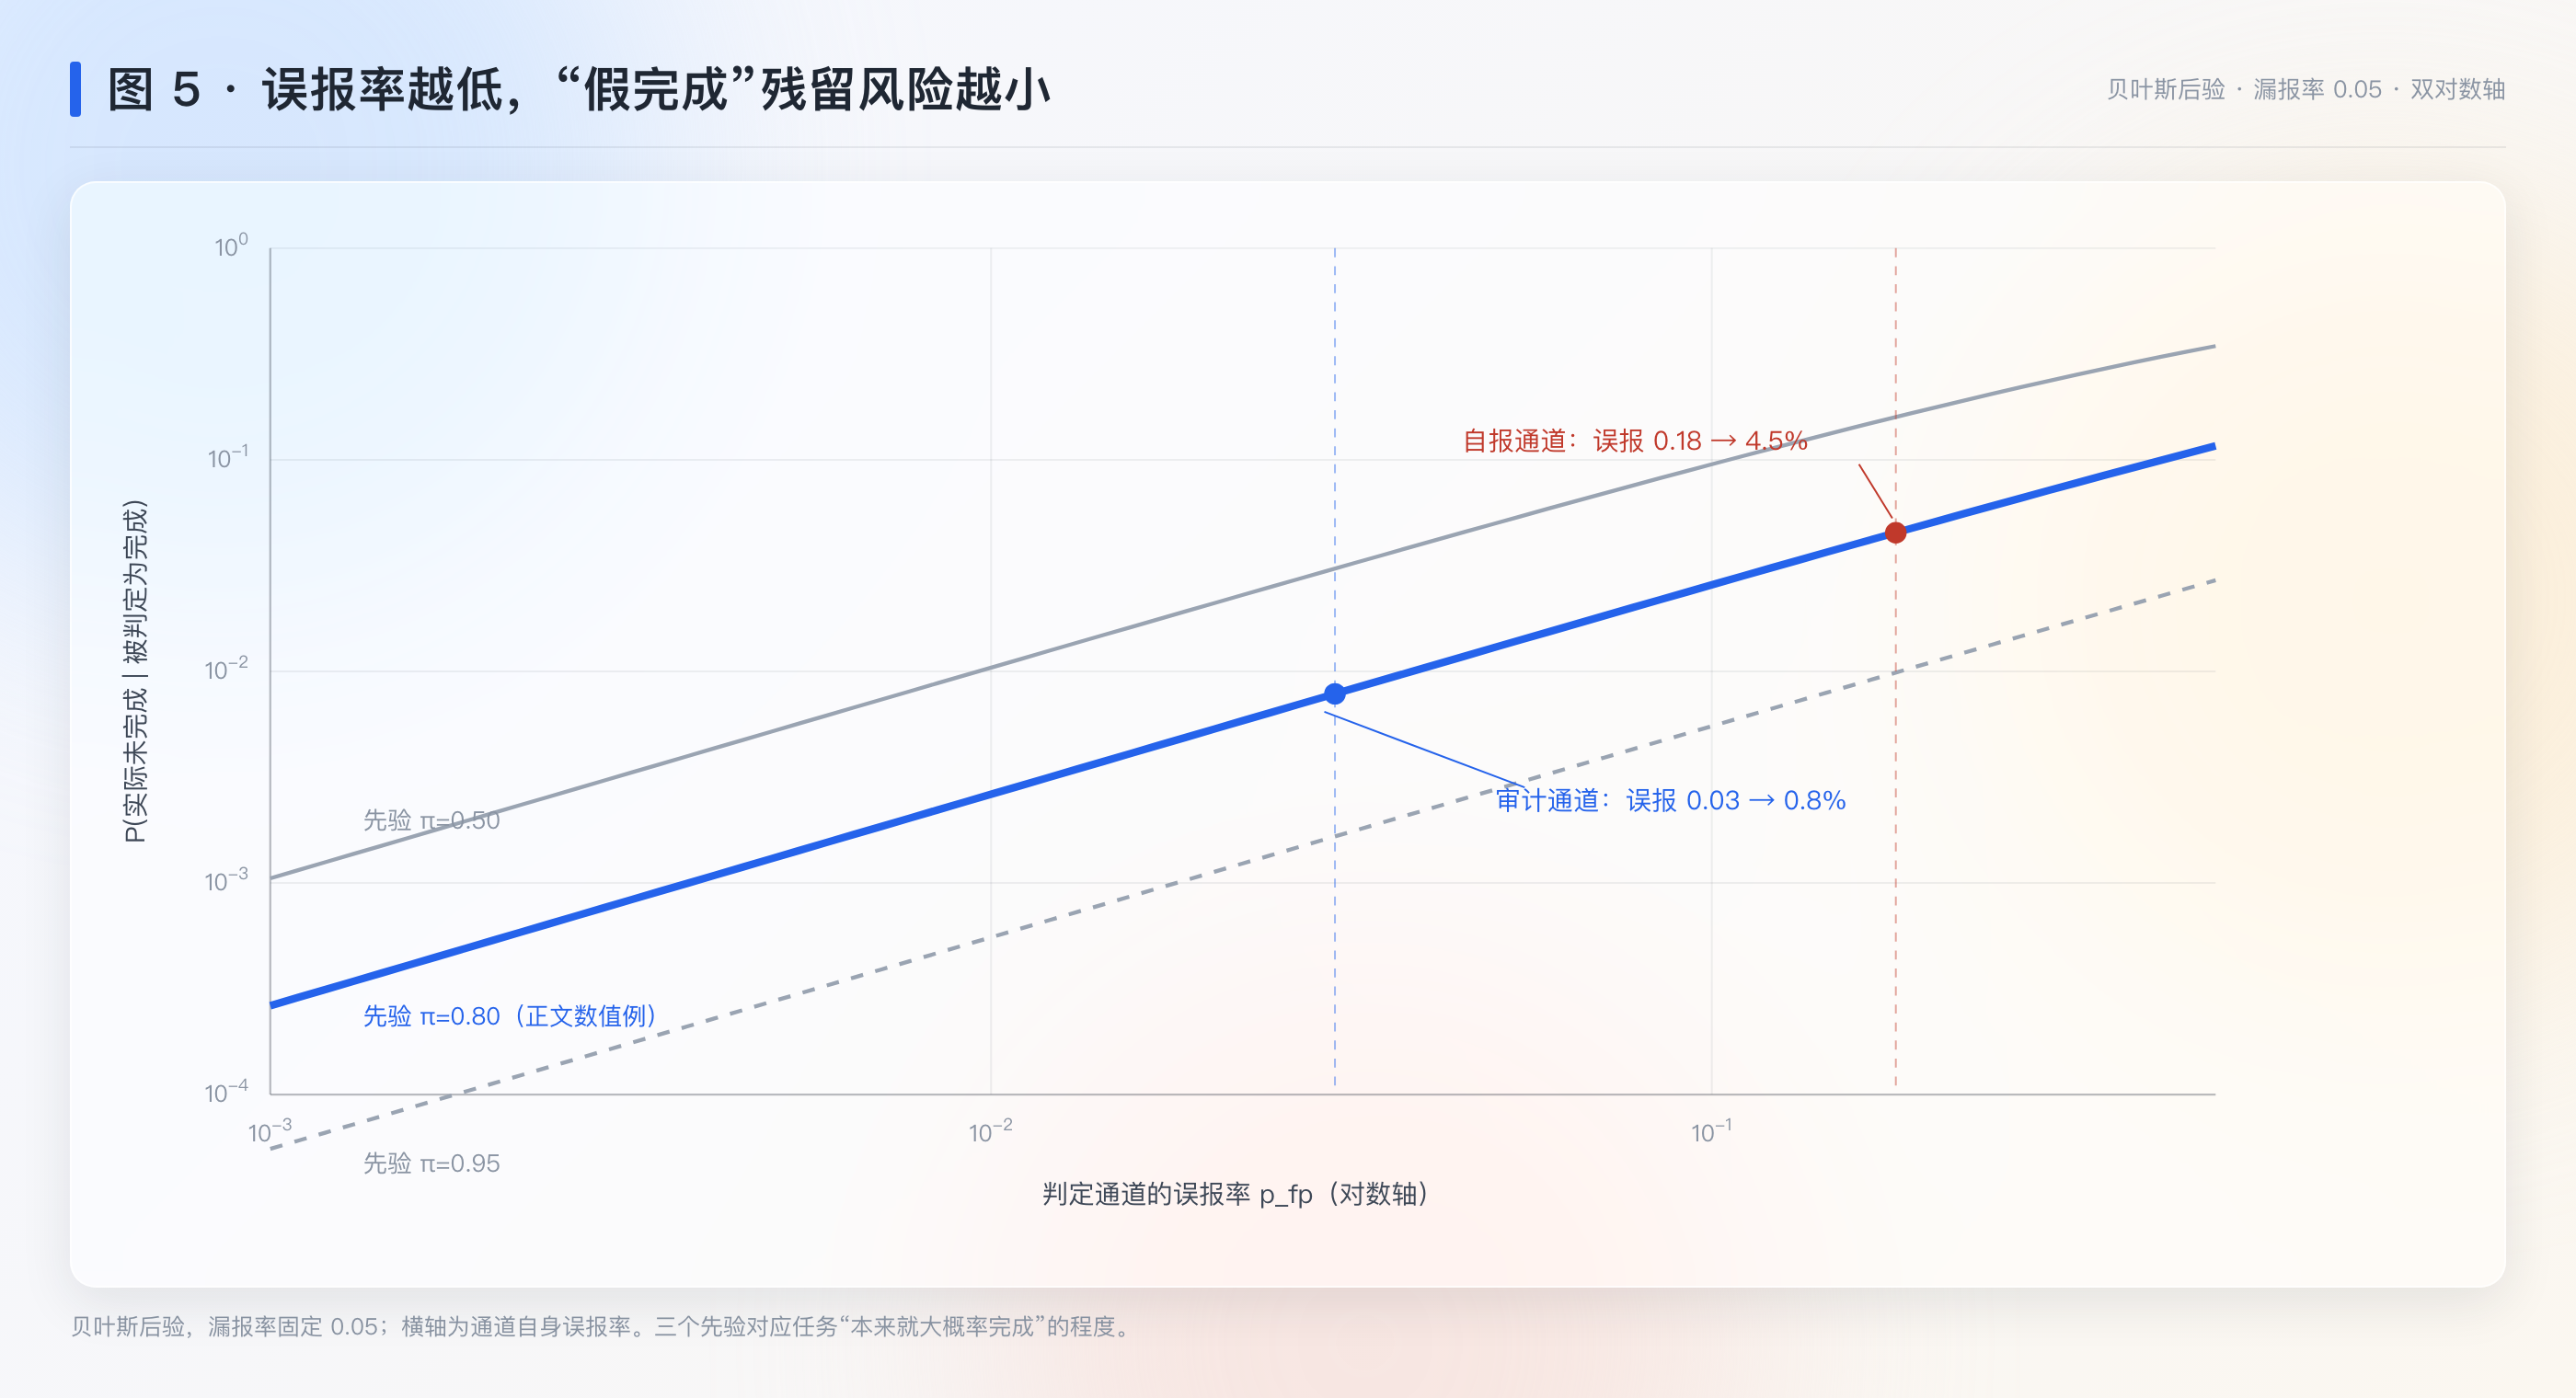
误报率不是唯一变量:先验 \pi 也影响残留风险(任务本来就大概率完成时,误报的占比更小)。图 5 画了三个先验下”残留假完成概率”随通道误报率的变化——这是上面数值例的推广:
这条公式先在这里算熟——到第六节它就直接是机制本体,名字叫”验证即滤波”。
3.5 乘法与指数:链式任务的复利
第五件工具管”连起来”:一步有几分把握,十步连起来还剩几分把握?靠乘法。
两件独立的事都要成,概率相乘:P(A\wedge B)=P(A)P(B)。一条 n 步的链,每步独立、单步成功率 p,全链成功率就是 p^n。
指数的直觉用对数看最清楚:\ln p^n=n\ln p。每走一步都按固定比例”打折”,n 步就是复利。比如单步 97.3%:\ln 0.973\approx-0.0274,8 步累计 -0.219,e^{-0.219}\approx0.80——每步只丢 2.7%,八步就丢掉两成。错误累积就是这么运作的。记住这笔复利账——第六节算”一条链能活多久”,用的就是它。
3.6 期望与几何级数:重试要花几次
链上一步失败了怎么办?重试。重试平均要花几次,得会算平均账——这就用到期望。
期望就是加权平均:\mathbb{E}[X]=\sum_x x\,P(X=x)。一个常用的重试公式:每次尝试独立、成功概率 p,重复尝试直到成功,期望尝试次数是 1/p。
推导(几何级数):第一次就成,概率 p;第二次才成,(1-p)p;第 k 次才成,(1-p)^{k-1}p。期望
\mathbb{E}=\sum_{k\ge1}k\,(1-p)^{k-1}p=\frac{1}{p}
(对恒等式 \sum_k k x^{k-1}=1/(1-x)^2 取 x=1-p 即得。)数值:§6.7 里单步”最终被诚实推进”的概率约 0.9676(自报通道),期望尝试 1/0.9676\approx1.03 次——重试不贵,贵的是被假完成骗过去。后面算成本、算重试时,还会一次次回到这个”平均几次”。
3.7 马尔可夫性:未来只看现在
再往下,该回答一个”凭什么”的问题了:凭什么敢把历史丢掉?马尔可夫性就是那个”凭什么”。
马尔可夫性质说:给定”现在”,未来与”更早的过去”无关。下棋时,下一步怎么走只取决于当前棋盘,不必回放前面每一步怎么走出来的。
写成条件概率:若当前状态是 S,则
P(\text{outcome}\mid S,\text{past})=P(\text{outcome}\mid S)
(式子里的英文占位读作”结果/过去”。)这是一个假设,不是定理。它成立的前提是 S 真的把”过去里对未来有用的东西”都装进去了。哪天 S 漏了关键信息(比如”上一步在那个对话框卡住过”),假设就失效——这正是 §6.8 与 §8.2 要处理的软肋。
3.8 充分统计量:压缩不带丢信息的严格说法
丢历史丢到极致,就是把过去压成一个小小的状态。可压到什么程度,才算没丢信息?“充分统计量”给出严格说法。
“统计量”就是对数据的一个汇总(求和、计数、平均都是)。说某个统计量 S 对推断目标 Y 是”充分的”,意思是:知道 S 之后,原始数据里再没有别的能帮你推断 Y 的东西了。
最干净的例子是掷硬币。抛 10 次猜正面的偏置,需要记录”正正反反正……“的完整顺序吗?不需要——只有”正面次数”重要,顺序无关。次数就是充分统计量:把 1024 种顺序压缩成一个 0 到 10 的数,信息一点不丢。
反过来,压缩不当时信息会丢。比如你关心的 Y 是”上一步为什么失败”,那么”失败步骤前后的完整轨迹”里就有 Y 需要的东西,一个只记”失败”二字的汇总就不够。充分性永远相对具体的 Y 而言,没有”对一切都充分”的压缩。
任务状态算不算合格的压缩?直觉上的答案,这篇整篇都在赌”是”;形式化的答案,第六节用互信息补上。
3.9 互信息:一个通道到底带了多少信息
充分性是个”全或无”的判据;想给压缩的质量定个量,就要请出倒数第二件工具——互信息。
互信息 I(A;B) 度量”知道 A 之后,对 B 的不确定减少了多少”。两个量独立时 I=0;A 完全决定 B 时取最大。定义:
I(A;B)=\sum_{a,b}P(a,b)\,\ln\frac{P(a,b)}{P(a)P(b)}
它有个好性质(链式法则):I(P;Y)=I(S;Y)+I(P;Y\mid S)。把 P(全部过去)压成 S 后,损失的那块就是 I(P;Y\mid S)——§6.8 会用它。
手算一个。用 5.2/5.3 的表,令 Y 为真值 X,先算审计通道。联合概率:P(1,1)=0.76,P(1,0)=0.04,P(0,1)=0.006,P(0,0)=0.194;边际 P(Y{=}1)=0.766,P(X{=}1)=0.8。逐项算 P(a,b)\ln\frac{P(a,b)}{P(a)P(b)}:
0.76\ln\tfrac{0.76}{0.8\times0.766}=0.164,\qquad 0.04\ln\tfrac{0.04}{0.8\times0.234}=-0.062
0.006\ln\tfrac{0.006}{0.2\times0.766}=-0.019,\qquad 0.194\ln\tfrac{0.194}{0.2\times0.234}=0.276
相加得 I(\text{truth};\text{audit})\approx0.358 nats(约 0.52 bit)。同样方法算自报通道(误报 0.18,边际 P(s{=}1)=0.796)得 \approx0.253 nats(约 0.36 bit)。结论很直白:通道越准,它对真值的互信息越大;“换通道”在信息量上就是 0.36 bit 提升到 0.52 bit 的差别。
3.10 偏序:有些状态没法比大小
概率工具讲完了,还剩两件零碎。头一件是偏序:账本上的记录要能比出高下先后,但”可比”不能想当然。
全序是任意两个元素都能比大小(数字 3 < 5)。偏序放松这一点:有些可比,有些不可比。补充:本文给任务状态集合 \Sigma 定的序是——
- completed 高于 pending(推进了);
- blocked(没有可推进的动作)和 untrusted(证据可疑)是两种性质不同的”没达标”,不硬定谁更差——所以用偏序,不用全序。
这套次序第六节开头就要用——状态格与进度单调性,全踩在它上面。
3.11 比例的标准差:读论文表格必备的尺子
最后一件是量别人的尺子。别人报告一个成功率,你得多问一句:这个数自己会抖多大幅度?比例的标准差就是干这个的。
一个真实成功率为 p 的任务集里跑 n 个任务,实测成功率 \hat p 自己会抖。抖多大幅度由二项标准差给出:
\mathrm{SE}=\sqrt{\frac{\hat p(1-\hat p)}{n}}
大白话版:成功率五五开时最抖(不确定性最大),n 越大越稳。两个系统比高低,先看差值是不是 SE 的两倍以上;正规一点用合并 z 检验:
z=\frac{\hat p_2-\hat p_1}{\sqrt{\bar p(1-\bar p)}\,\sqrt{2/n}},\qquad \bar p=\frac{\hat p_1+\hat p_2}{2}
|z|>2 大致对应”95% 置信下不是巧合”。手算本篇自己的三对数(分子分母还原见 §十.10):
- WeaveBench 主对照 59/114\to92/114:\bar p=0.662,分母 =\sqrt{0.662\times0.338\times2/114}=\sqrt{0.003926}=0.0627,z=28.9/6.27=4.6——稳。
- OSWorld 全集 3/108\to9/108:\bar p=0.0556,分母 =\sqrt{0.0556\times0.9444\times2/108}=\sqrt{0.000972}=0.0312,z=5.6/3.12=1.78,p≈0.075——不过线。
- Opus 子集 7/34\to12/34:\bar p=0.279,分母 =\sqrt{0.279\times0.721\times2/34}=\sqrt{0.011829}=0.1088,z=14.7/10.88=1.35——不过线。
这把尺子的用途写在 §8.9:同一张表里的提升,有的过线有的不过线,“三倍提升”这种倍数修辞在小样本上要还原成分子分母再量。
四、记号与函数
论文用一套紧凑的记号刻划整个循环。
4.1 符号
| 符号 | 含义 |
|---|---|
| T | 原始任务 |
| S_i | 第 i 轮开始时的任务状态 |
| e_{i-1} | 当前环境状态 |
| \mathcal{V}_i = (v_1,\dots,v_i) | 截至第 i 轮的累计审计报告 |
| c_i | 第 i 轮的子任务合约 |
| o_i | 执行者在第 i 轮的汇报(不可信,只用于定位) |
| v_i | 第 i 轮的审计报告(唯一能推进状态的东西) |
| q_{i+1} | 管理者给出的控制信号(execute / done / blocked / ask) |
| \rho(r,v) | 补充:记录翻译算子,把审计报告 v 中关于记录 r 的结论写成一条状态记录(新状态 + 证据引用),见 §6.2 |
4.2 三个角色函数
\Phi_{\text{mgr}}\left(T,S_i,\mathcal{V}_i\right)=\left(S_{i+1},\,q_{i+1},\,c_{i+1}\right)
管理者读任务状态与审计报告,决定下一步。它唯一的信息来源是 S 与 \mathcal{V},不含环境 e,也不含执行器轨迹。
\Phi_{\text{exec}}\left(T,S_i,c_i;\,e_{i-1}\right)=\left(e_i,\,o_i\right)
执行者在一个子任务里把环境从 e_{i-1} 改成 e_i,交回汇报 o_i。分号后的 e_{i-1} 是它唯一能改动的东西。
\Phi_{\text{aud}}\left(T,S_i,c_i,o_i;\,e_i\right)=v_i
审计者读环境 e_i(以及合约 c_i、执行者汇报 o_i 作为定位线索),给出审计报告 v_i。
4.3 任务状态的结构
任务状态是一个结构化集合:
S=(R,A,F)
其中 R 是要求(requirement,目标或约束)、A 是产物(artifact,执行中产生或修改的输出)、F 是事实(fact,后续轮次需要的环境信息)。每条记录带一个状态:
\sigma \in \Sigma=\{\text{completed},\ \text{pending},\ \text{blocked},\ \text{untrusted}\}
并保存支撑它当前状态的审计证据。初始状态 S_1 由 T
生成,要求全部置为 pending。
五、机制:Manage–Execute–Audit 循环
承上启下:§一 的病根是两件事绑在一起——执行与状态共用一条增长的上下文、干活的 agent 自己判断自己完成;§二 的重构是把任务状态外置成显式记录,且只用环境里独立核实过的事实更新(Manage–Execute–Audit)。上节备好的数学工具就是这套机制的腿:概率连乘算链条存活的把握,贝叶斯更新算”该不该信一次完成宣称”,马尔可夫链给状态转移建模,比例的标准差教我们读论文里的百分比。本节把 Manage–Execute–Audit 循环逐角色拆开。
任务被切成若干轮,每轮三个角色。
5.0 贯穿示例:建账
补充(示例,非论文内容):任务 T =「给团队官网换新版 logo 并上线预览」——它要混用命令行(脚本处理资源、构建)与图形界面(浏览器目检、平台操作),正是 WeaveBench 一类”GUI+CLI 编织”任务的形态。进系统时 S_1 建账:
| ID | 要求(R) | 依赖 | 路由 |
|---|---|---|---|
| r_1 | 从设计稿 SVG 导出 32/128/512 三尺寸 PNG,登记哈希 | — | CLI |
| r_2 | 替换仓库 assets/ 下旧资源,更新全部引用 | r_1 | CLI |
| r_3 | 本地构建通过且首页新 logo 显示正常 | r_2 | CLI(构建)+ GUI(目检) |
| r_4 | 生成预览链接(需部署平台令牌) | r_3 | GUI |
| r_5 | 收齐”替换前后”证据:旧文件备份、构建日志、首页截图 | r_2 | 混合 |
产物(A)将是:三张 PNG、git
diff、build.log、首页截图、预览 URL。事实(F)初始登记:仓库路径、构建命令、旧文件名清单。五条要求全部
pending。下面每个角色都从这个账本出发。
5.1 管理者(Manager):按账派活,从不下场
【类比 · 按账派活】 工头从不下场砌墙,手里只有图纸和账本:哪道工序完工、哪道还欠着,一律以账本为准。派活的方式是把活写成一张有边界的工单——干什么、怎么算完、不许碰什么。 【跨域锚点】 军队与组织里的”参谋部”:决策者依据地图与战报拿主意,不亲临火线。(类比与通识锚点,非论文内容)
先看病。§一 交代的第一桩结构性毛病,是执行与状态管理共用一条会增长的上下文——干活、记进度、判断完成,全搅在同一个脑子里。要拆开它,先得立一个”不下场”的角色。
药方是管理者。它持有任务状态,决定下一步。它不接触环境:看不到界面、不能调试、不能改东西,判断只基于任务状态和审计报告。它把当前状态和原目标比较,挑一个还没完成、且依赖已满足的目标,写成一个有边界的子任务合约(做什么、验收标准、不能越界的边界、相关证据),并按需要路由给 GUI 或 CLI 执行器。
管理者输出四种信号之一:
execute:继续,附一个新的子任务合约;done:审计后状态已满足原任务,且无未解决的完整性违例;blocked:没有任何许可动作能推进剩余需求;ask:需要用户提供信息或授权。
补充一个示例:第 1 轮,管理者看账:r_1 无前置且
pending,选中。发出的子任务合约 c_1
长这样——目标:把设计稿导出为三尺寸 PNG 到
assets/new/;验收标准:三文件存在、尺寸分别正确(file
命令可核)、内容与设计稿一致(哈希登记);边界:不得改动 assets/
以外任何文件、不得执行 git
commit;相关证据:导出命令的输出与文件清单。路由:CLI
执行器。对照四种信号:走到 r_4
时账上会缺”部署令牌”这一项,任何许可动作都推进不了——那时管理者输出
ask。四个信号里 ask
最容易被忽视:它的含义是承认”这事我做不了主”。
意义在于:管理者看不见现场,它对进度的全部信心只能来自账本与审计——“凭眼前感觉推进”这件事,从制度上就被排除了。
5.2 执行者(Executor):拿单进场,干完即走
【类比 · 拿单进场】 工人每次只领一张工单进场,干完交货就走,不带上一张单子的记忆。现场再乱也不怕——乱摊子记在账本上,不记在人脑子里。 【跨域锚点】 制造业的看板管理:每张工单自带全部信息,工序之间靠单据衔接,不靠口口相传。(类比与通识锚点,非论文内容)
先看病。第二桩毛病是上下文腐烂:一条会话又当工作台又当档案柜,越长越难用,错误还顺着长会话一路蔓延。
病根出在”跨步的记忆”托付错了地方——托给了一条只会越写越长的对话。药方是 fresh-context:执行者是唯一允许改环境的角色,它拿到原目标、当前状态、子任务合约,在一个全新的、有预算上限的上下文里只做这一件事。回合内它可以多次”规划→与环境交互→观察→修正”。回合结束,它的原始对话轨迹和内部推理全部丢弃,只交回一份汇报 o_i。
GUI 和 CLI 执行者被分成两类:GUI 拿屏幕类能力(截图、点击、滚动、输入),负责界面状态的变化;CLI 拿 shell、文件、代码、测试类能力,负责工作区、进程、程序状态的变化。执行者只暴露它那类接口,避免越权。后端通过 AgentAdapter 启动(p.1),harness 不改写后端内部循环,只控制上下文、工具、环境权限、预算和返回的汇报。
补充一个示例:r_3 演示双面路由:管理者把它拆成两份合约——CLI 合约(跑构建,验收 = 退出码 0 且 build.log 无 error)与 GUI 合约(起本地 server、打开首页、滚动到页眉、截图存证)。注意接口隔离的含义:CLI 执行器拿不到”点击浏览器”的能力,就算它在构建日志里看见渲染警告,也不能自己去页面上”看一眼”——那要等 GUI 执行者的合约。权限按合约切,不按需切。
意义在于:每一轮都从干净的台面出发,上一轮的乱摊子污染不了下一轮的脑子;至于”上一轮到底做没做成”,执行者说了不算——裁决权在下一个角色手里。
5.3 审计者(Auditor):只认现场,不听汇报
【类比 · 只认现场】 验收员不听工人讲辛苦,只对着验收单看现场:自己按一遍、自己量一遍。工人说”做好了”不算数,验收单上签了字才算数。 【跨域锚点】 财务审计的函证程序:审计师不采信公司自己的说法,直接向银行与客户发函核对余额。(类比与通识锚点,非论文内容)
先看病。第三桩毛病最隐蔽也最要命:自评偏差。干活的人自己报告”做完了”,既当运动员又当裁判——它”想”做完,这个动机本身就在污染判断。
病根出在裁决权放错了地方。药方是把裁决权整个拿走,交给一个只看现场的角色:审计者只读,不改环境。它从一份不含执行者轨迹的新上下文开始,自己去环境里核实:执行者说的完成了,是不是真的完成;有没有越界改动;支撑事实的证据是什么。它给出三类结论:
- 完成状态:complete / incomplete / blocked,对照合约的验收标准判断;
- 完整性:clean / suspect / violation,检查工作区改动、产物真伪与来源、删除约束;
- 任务状态更新:已验证的事实、支撑证据、剩余缺口。
审计者可以提议改记录,但由管理者决定怎么并入下一轮状态。审计者不能改任务相关环境状态;harness 全程监视工作区和产物,检测到改动就记为 integrity violation,该报告不能支撑”completed”。
补充(示例,走一次”审计拒绝”):第 4 轮(见 3.4 演化表),CLI 执行者交回汇报 o_4:“构建通过。”审计者从一个不含任何执行轨迹的新上下文出发,只对环境动手:重跑构建——退出码 1;读 build.log——首页还有一处旧文件名引用 404(r_2 漏改了 README 里的一处)。三类结论逐项落:完成状态 = incomplete(对照合约验收标准,退出码非 0);完整性 = clean(没越界改动);状态更新提议 = “r_3 保持 pending;F 新增事实:README.md 第 37 行仍引用旧文件名 logo-old.png”。执行者为什么以为自己跑通了?可能是缓存、可能是跑了个旧命令——不知道,它的原始轨迹已丢弃,错误的 o_4 只作为定位线索留在审计报告里。这一幕就是”自评不可信”的机构化处理:错话进不了账,但错话指的方向(构建环节)进了账。
意义在于:到这里,三个角色的分工才真正咬合——“自评不可信”从一句对模型的抱怨,变成了一套机构安排:裁决权换了主人,汇报只配当线索。
5.4 凭证入账:状态听谁的,循环何时停
【类比 · 凭证入账】 记账的老规矩:谁喊一嗓子”这笔收回来了”都不算数,附上发票、对过流水的那一笔才准入账。账本因此可信,敢翻到任何一页接着记。 【跨域锚点】 会计的凭证制度:入账以凭证为准,不以口头为准。(类比与通识锚点,非论文内容)
先看病。三个角色都齐了,还剩最后一道关口:账本到底听谁的?如果执行者的汇报能直接改状态,前三个角色等于白设——假完成会从后门溜回账里。
病根就出在这道口子上:旧做法里,状态更新与执行汇报不分家。药方是收紧入账权。状态在下一轮开始前由管理者更新。规则是:执行者的汇报不直接改状态,只有审计者判定完成、判定干净、且证据来自环境时,这一步才记成完成;其余保持待办、受阻或不可信。跨轮之间,唯一保留的”记忆”就是这份验证过的任务状态和审计报告。
循环在四种情况停止:审计后状态满足原任务;没有任何允许的动作能推进剩余需求;需要用户提供信息或授权;超过最大轮数(论文设 N_{max}=25,p.7)。
意义在于:跨轮的记忆只剩一份验证过的账。账本可信,后面每一轮才敢从它出发重新看世界;下面用一轮一轮的演化,把这套循环完整走一遍。
补充(示例,账本演化七轮——execute/ask/done 三种信号各出场一次,外加一次完整性违例):
| 轮次 | 合约/动作 | 审计 | 账本变化与控制信号 |
|---|---|---|---|
| 1 | c_1:导出三尺寸 PNG(CLI) | 核对文件尺寸与哈希,干净 | r_1→completed;A 登记三张 PNG |
| 2 | c_2:替换引用(CLI) | 重跑构建 + 查 git 状态;发现执行者顺手做了 git commit——合约明令禁止 | integrity violation:该报告不能支撑 completed;r_2 记 untrusted,不入账 |
| 3 | c_2 重发(边界重申”不得 commit”) | 干净且验收通过 | r_2→completed |
| 4 | c_3:构建验证(CLI) | 重跑构建 exit 1(README 漏一处引用),见 3.3 示例 | r_3 保持 pending;F 新增”README 第 37 行旧引用” |
| 5 | c_4:补引用 + 重构建 + GUI 目检 | 干净 | r_3→completed;A 登记 build.log 与截图 |
| 6 | 想推进 r_4:缺部署平台令牌,所有许可动作都无法推进 | — | q = ask(等用户提供授权) |
| 7 | 用户授权后:c_5 生成预览、收齐 r_4/r_5 证据 | 干净 | r_4/r_5→completed;S\models T → q = done |
七轮里每个部件都出场了一次:admit 三条件(第 1/3/5 轮)、完整性违例拦截(第 2 轮)、untrusted(第 2 轮)、审计事实回流 F(第 4 轮)、ask(第 6 轮)、done(第 7 轮)。对照 StructAgent 的三态账(其 §3.3):LH 这张账缺的是”销账”——若第 5 轮之后有人又改坏了 assets,LH 的账不会动,StructAgent 的账会标 Invalidated。
六、数学展开:机制的数学
有了第五节的工具,现在把论文的机制逐条写成数学。原文只给了记号和规则(§四),推导全部是我补的,句首标”补充”。
6.1 状态格与进度单调性
补充:给每条记录一个状态 \sigma\in\Sigma,设”已完成集合”
\mathcal{C}(S)=\{\, r\in S \mid r.\sigma=\text{completed}\,\}
花括号读法:把 S 里所有状态为 completed 的记录 r 收进一个集合。在这套”只信审计”的更新下,理想性质是完成集合单调不减:
\mathcal{C}(S_1)\subseteq \mathcal{C}(S_2)\subseteq\cdots\subseteq \mathcal{C}(S_{n})
\subseteq 是”包含于”:已完成的东西只增不减。一个已经因干净证据完成的记录,不会被后续的失败汇报打断。论文没有形式证明它(依赖”只由干净审计证据推进”的规则),我把它当作设计意图,而不是已证定理——这既是它”能往收敛走”的原因,也是它没有收敛保证的原因。
6.2 带守卫的更新(全文最关键):汇报不算数,审计才入账
状态更新写成
S_{i+1}=S_i\oplus\text{admit}(v_i)
\oplus 读作”并入”:把右边的记录逐条合进状态集合。守卫函数 admit 只放行满足三个条件的记录:
\text{admit}(v)=\{\, \rho(r,v)\ \mid\ v.\text{completion}=\text{complete}\ \wedge\ v.\text{integrity}=\text{clean}\ \wedge\ \text{evidence}(e_i)\,\}
逐符号看:
- v.\text{completion}=\text{complete}:审判断了”完成”(对照合约验收标准);
- v.\text{integrity}=\text{clean}:完整性检查通过(没有越界改动、产物来源可信);
- \text{evidence}(e_i):这条记录的支撑证据直接来自环境 e_i(截图、文件内容、命令输出),而不是任何人的转述;
- \rho(r,v)(补充):记录翻译算子。审计报告 v 是一段结论文本,\rho 把其中关于记录 r 的部分翻译成状态里的一条结构化记录:新状态(completed)+ 指向证据的引用(哪张截图、哪个文件)。原文没有给这个算子起名,这里是我在 §四 记号表里补的形式化。
要点:执行者的汇报 o_i 不在 admit 的输入里。状态推进是 v_i(审计)的函数,不是 o_i(自报)的函数。三者缺一,记录停在 pending / blocked / untrusted。
为什么这重要?用 5.4 的数字:把”用哪条通道判定完成”看成通道选择,假完成残留分别是 4.52%(自报)与 0.78%(审计)。而假完成最伤的地方是它会被当成后续前提——这引出 6.7 的链式放大。
6.3 用压缩状态代替全额历史
原始做法是一个 agent 拿一整段越来越长的轨迹。设 H_i 是到第 i 轮的完整历史(含 o,c,v 与执行器内部推理)。新做法里,执行者下一轮只看三元组
(T,\ S_i,\ c_i)
补充:把它看成一个马尔可夫式假设(定义见 5.7)——
P(\text{outcome}\mid H_i)\ \approx\ P(\text{outcome}\mid T,S_i,c_i)
只要 S_i 对”该子任务需要的背景”是充分统计量(5.8),这个近似成立。跨轮一致性由管理者维护的 S 承担,而不是交给会腐烂的上下文。
这个”充分统计量假设”是本方案能成立的前提,也是最软的地方:若 S 漏掉关键信息(长上下文细节、视觉证据链、完整规格),fresh-context 反而吃亏。信息损失怎么度量,见 6.8。
6.4 验证即滤波
补充:把审计看成对信念的一次贝叶斯更新(全部推导在 5.2–5.4,这里只摆结论):
P(X=0\mid a=1)=\frac{\mathrm{fp}_a(1-\pi)}{(1-\mathrm{fn}_a)\pi+\mathrm{fp}_a(1-\pi)}
数值例(假设值 \pi=0.8,\mathrm{fn}=0.05):自报通道残留 4.52%,审计通道残留 0.78%,约 1/5.8。两张图:图 4 是两个通道的对比;图 5 是把通道误报率扫成曲线。读图 5 注意量级:fp 小时分母被 (1-\mathrm{fn})\pi 主导,残留 \approx \mathrm{fp}\cdot\frac{1-\pi}{(1-\mathrm{fn})\pi},对误报率近似成比例——上面的数字也印证:fp 降 10 倍,残留约降 5.8 倍,不是指数级的差距。逐级残留虽只是线性,残留却会被后续轮次当前提继承——这是 §6.7 链式放大的入口。
自报为什么偏差大?因为它不是独立观测:执行者”想”完成,这个动机把 \mathrm{fp}_s 系统性推高;审计者没有这个动机,误报率才可能低。这就是”独立”在概率模型里的位置:它降低误报率,而不是凭空消除错误。
6.5 控制与停止
管理者输出 q_{i+1}\in\{\text{execute},\text{done},\text{blocked},\text{ask}\},是从”当前状态+审计报告”到”下一步控制”的策略。停止规则(原文 p.7):
\text{done}\iff S_i\models T\ \wedge\ \text{no integrity violation}
\text{blocked}\iff \text{no permitted action advances requirements}
\text{ask}\iff \text{user input or authorization required}
S_i\models T 读作”状态 S_i 满足原任务 T 的全部要求”。理想状态下进度单调(6.1),但没有形式收敛保证:论文用 N_{max}=25 轮兜底(p.7)。若审计者自己看走眼,错误仍能进状态——所以”只信审计”降低、而非根除错误累积。
6.6 代价与预算
补充:总 token 成本近似
\text{cost}\ \approx\ \sum_{i=1}^{n}\left(\tau_{\text{mgr}}^{(i)}+\tau_{\text{exec}}^{(i)}+\tau_{\text{aud}}^{(i)}\right)
n 是轮数。论文的实测占比(p.9–p.10):
| 基准 | manager 占比 | auditor 占比 | 整体 token 变化 |
|---|---|---|---|
| WeaveBench | 2.8% | 19.4% | 2.3 倍基线 |
| OSWorld 2.0 | 2.0% | 24.8% | 输出 token 3.6 倍 |
| Terminal-Bench 2.1 | 8.1% | 38.1% | 总量少 24% |
管理者花销很小,审计是主要增量。但整体账单方向不一致:Terminal-Bench 反而省 24% 且更准(p.10)。原因在 n 由模型能力决定:强模型用更少”审计-再规划”轮就能满足合约。每任务平均 token,Claude Opus 从 16.5M 降到 11.1M(p.11),Qwen 从 10.7M 升到 34.3M(p.10),方向相反。结论:代价和性能都由”模型能力 × harness 设计”共同决定,不是”多一个角色多花 token”这么简单。用 5.6 的语言:弱模型拉长了期望轮数,这才是账单的放大器。而这笔账要用让步句才说得干净:正因为裁决权整个收归了审计,每一分可靠性都得用审计的 token 明码标价——19% 到 38% 的占比不是浪费,是裁决权的价格。
6.7 依赖链的错误累积:两个模型算一笔账
补充:本节把”一步假完成,切断下游”量化,并顺手修正一个容易误读的公式。
模型 A(简单近似)。 设单步执行失败概率 q=1-\text{exec},失败后被判定通道误报成”完成”的概率 \mathrm{fp}。一步”不出假完成事故”的概率是 1-q\,\mathrm{fp},n 步链全不出事故:
P_{\text{chain}}=\left(1-q\,\mathrm{fp}\right)^{n}
注意它算的是”不被假完成打断的概率”,不是”全链真完成的概率”——后者还要乘上每步真做成的因子(模型 B 里看得到)。取 q=0.15,自报 \mathrm{fp}=0.18,n=8:
P_{\text{chain}}^{\text{self}}=(1-0.027)^{8}\approx0.803,\qquad P_{\text{chain}}^{\text{audit}}=(1-0.0045)^{8}\approx0.965
模型 B(带重试的精确版)。 模型 A 漏了重试:一步失败但没被误报时,状态停在 pending,下一轮重试。单轮里当前步有三种结局:
- 真完成且被诚实放行:a=(1-q)(1-\mathrm{fn});
- 假完成(放行了假货):b=q\,\mathrm{fp};
- 其他(真没做成且未误报,或做成了但漏报):重试,概率 1-a-b。
重试会一直发生,所以这一步最终”真完成且被诚实放行”的概率是 a 在 \{a,b\} 两个吸收事件里的占比(谁先发生):
s=\frac{a}{a+b}=\frac{(1-q)(1-\mathrm{fn})}{(1-q)(1-\mathrm{fn})+q\,\mathrm{fp}},\qquad P_{\text{chain}}=s^{\,n}
(这就是 5.6 几何级数的两事件竞争版。)代入同样的参数:自报 s=0.8075/0.8345=0.9676,s^8=0.769;审计 s=0.8075/0.8120=0.9945,s^8=0.956。
三个数摆在一起:模型 A 给 0.803 / 0.965,模型 B 给 0.769 / 0.956,玩具复现(§十一)实测 0.800 / 0.970。同量级、方向一致;两个闭式都不严格贴合玩具(重试重掷真值、60 轮截断),实测落在两者之间属参数巧合——所以这两个式子的价值是机制直觉,不是数值预测。机制分两层说才准确:逐步残留对误报率近似成比例(§6.4),链式连乘把它放大成链级成功率对单步假完成率的指数敏感——每步 2.7% 的假完成率,八步就吃掉两成成功率;把通道误报降一个量级,链就基本不断。
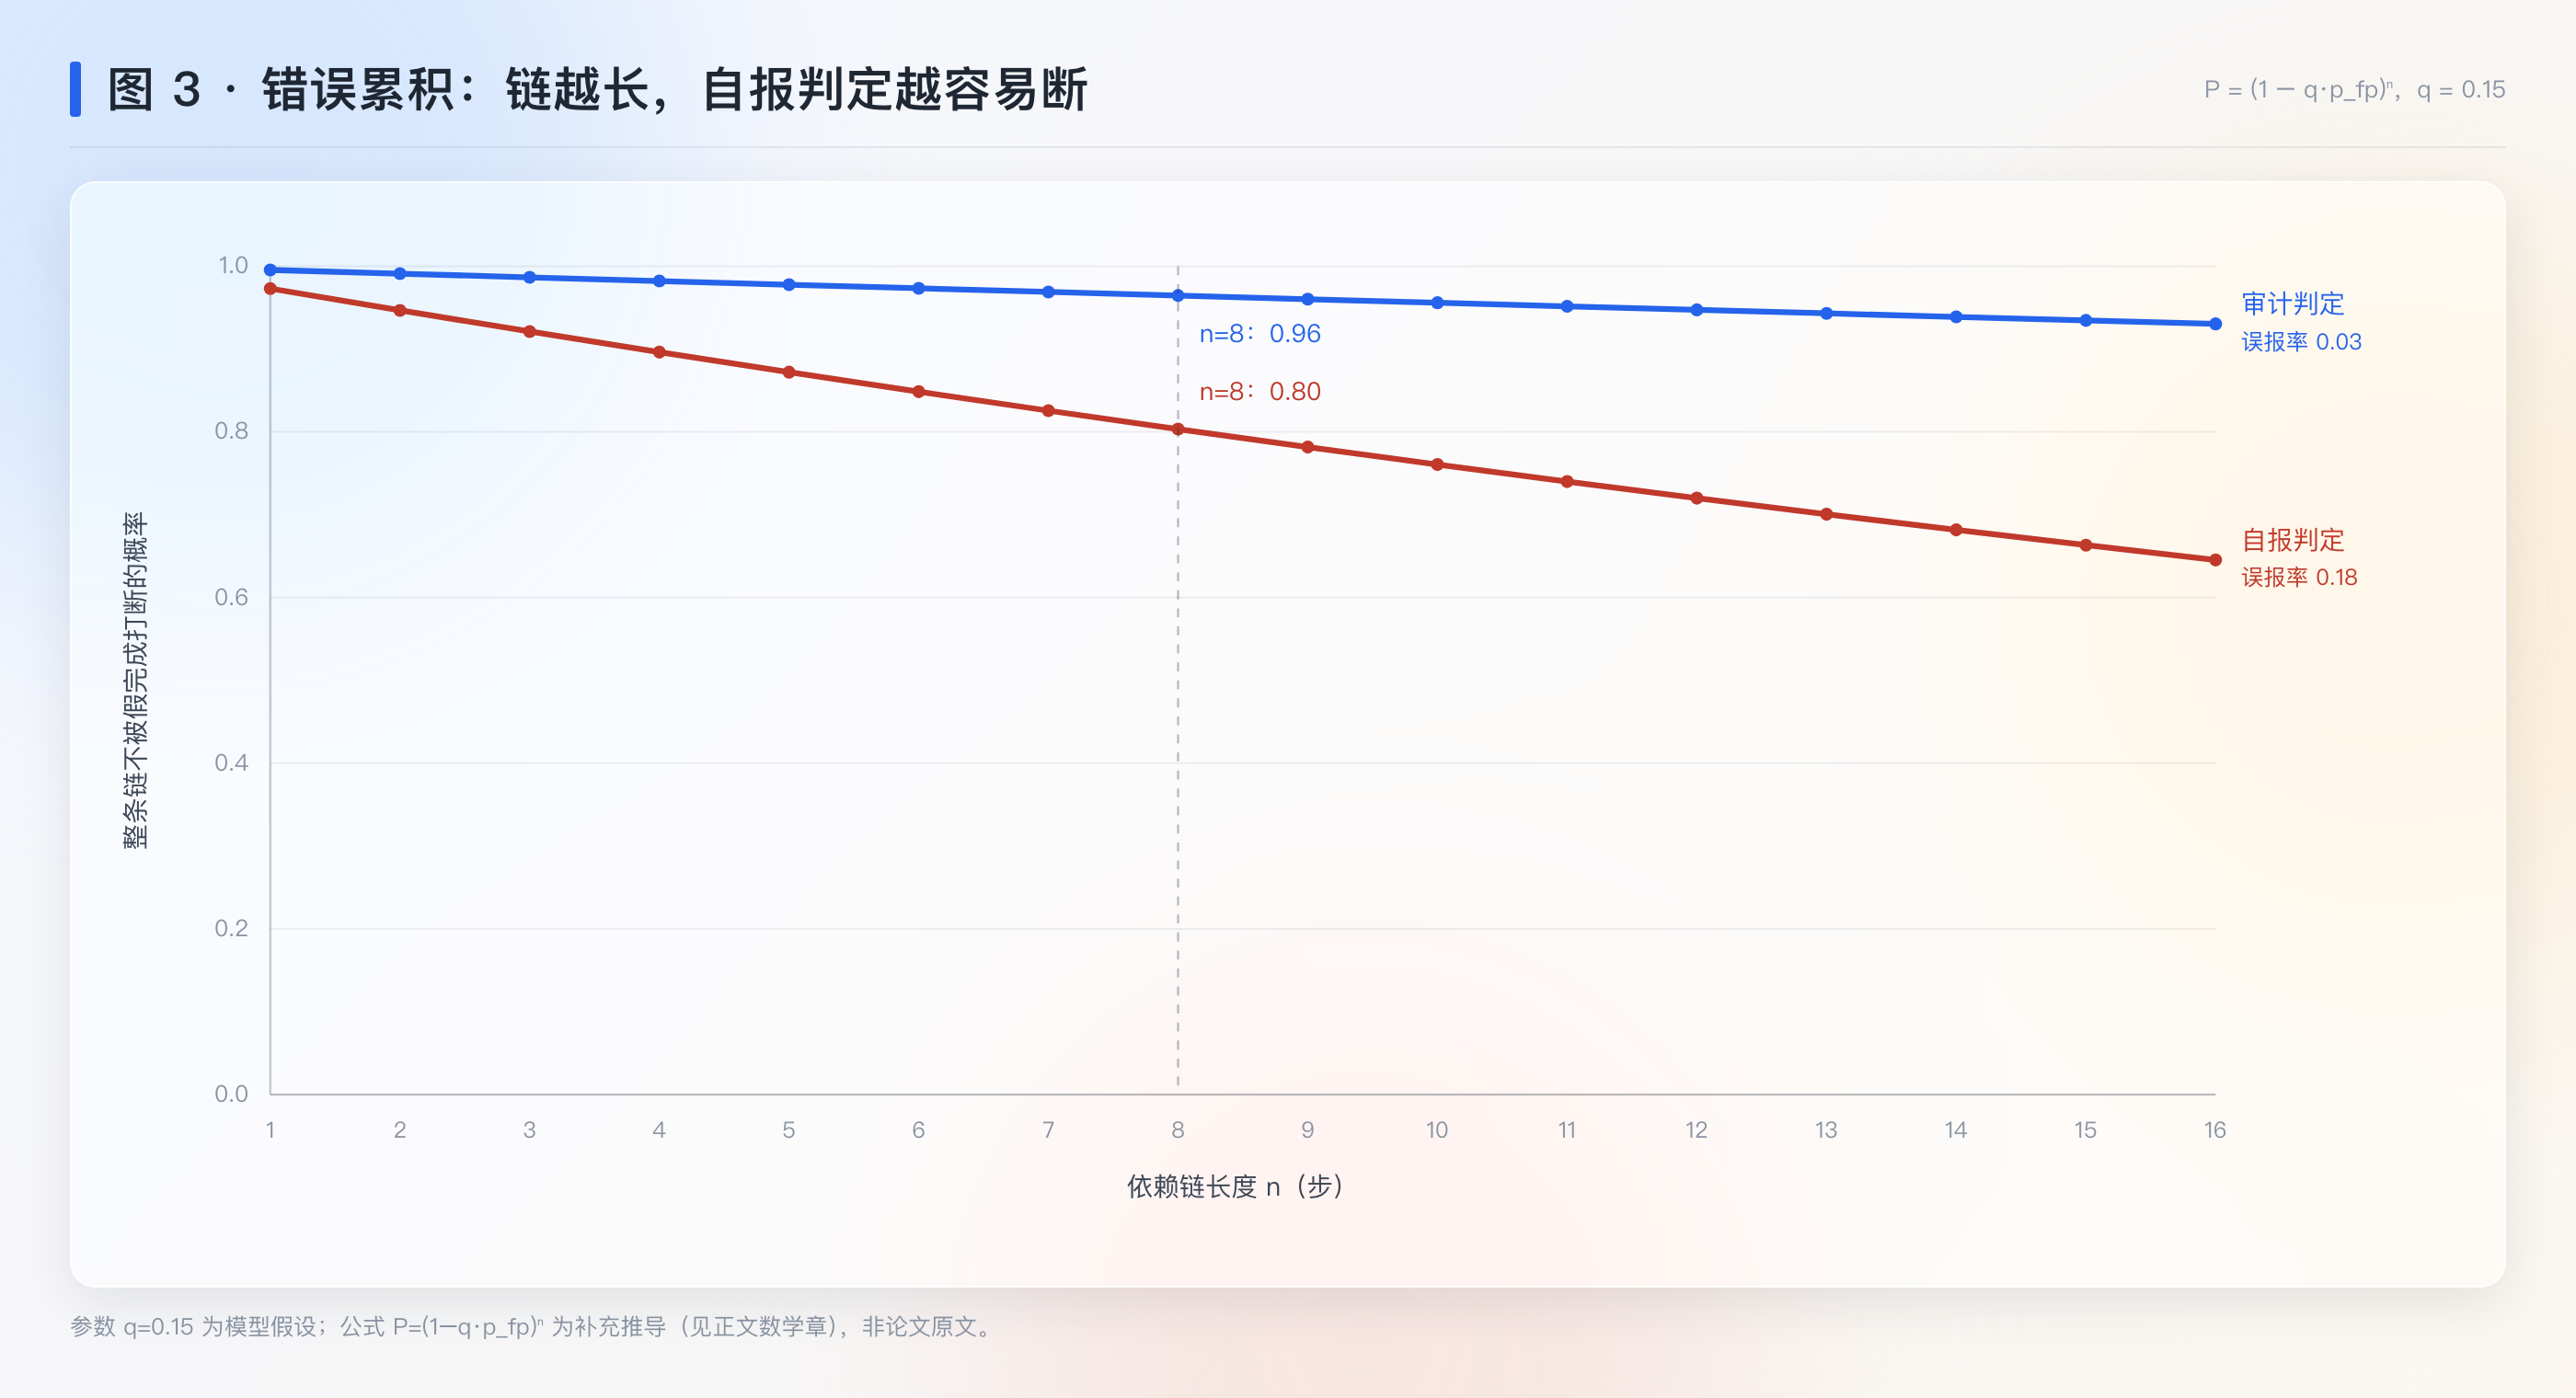
最后强调边界:这是机制层面的估算,没算回归重试的成本、审计漏报只造成额外轮数而非失败、也没算审计者自身看走眼。论文的真实数据(Qwen 3.7-Plus 在 WeaveBench 从 51.8% 到 80.7%,p.1)比这个模型复杂得多。
6.8 状态压缩的信息论视角
补充:§6.3 把”S 是过去的好摘要”当前提,现在用 5.8/5.9 把它说严。
设全部过去信息为 P(含执行器轨迹与审计报告),未来这一步需要的背景为 Y。S 是 P 的压缩。S 对 Y 充分(5.8),当且仅当
P(Y\mid P)=P(Y\mid S)
即知道 S 后,完整的过去再也不能增加对 Y 的预测。用互信息的链式法则(5.9)拆开:
I(P;Y)=I(S;Y)+I(P;Y\mid S)
- I(S;Y):压缩进状态、且对未来有用的信息;
- I(P;Y\mid S):留在 P 里、没被 S 捕获、却对未来有用的信息——这就是压缩的损失。
后者大于零时,S 是有损压缩,fresh-context 会吃亏。什么情况下损失大?5.8 的反例直接适用:如果这一步需要的背景是”长上下文细节、视觉证据链、失败经过”,而 S 只记结论,损失项就大。5.9 的数值例给了个量化感觉:好通道与差通道对真值的互信息差 0.36 bit 对 0.52 bit;同样地,“状态压缩器”的质量直接决定 I(S;Y) 的大小。这篇的做法是刻意把 I(S;Y) 做大:只收验证过的事实、剩余需求、相关证据。把”记忆”做成”经过滤的信息”,而不是”完整的原样回放”。
七、前置知识:这篇牵出了什么
| 概念 | 状态 | 和这篇的关系 |
|---|---|---|
| agent 循环(ReAct) | 已补分支笔记 | 管理者/执行者本质仍是”推理-行动-观察”循环,只是被包了层 |
| 上下文腐烂 / 迷失在中间 | 已补分支笔记 | 解释为什么必须 fresh-context + 外部状态 |
| 验证与自评偏差 | 已补分支笔记 | “只信审计”背后的认识论 |
| 状态作为充分统计量 | 待补 | 数学展开的关键(§3.8/§6.3/§6.8),也是它的软肋 |
| WeaveBench / OSWorld / Terminal-Bench 评分 | 待补 | 要读懂 PassRate / Binary / Partial(§8.9 有初步拆解) |
| agentic RL / actor-critic | 缺口 | 沿”agent 怎么被训练”发散再用(§8.6) |
八、扩展与发散:从一颗种子长出一片知识
这篇论文的最大价值不是那几个分数,而是它把”agent 做成一件长活”里的一个通用矛盾暴露出来:跨步的一致性该由什么来承载?顺着这个矛盾,可以铺开好几片知识。读者不需要 AI 底子,每一条都从生活场景进。
8.1 agent 的”记忆”到底该是什么:RNN → 状态空间 → 上下文
任何要跨很多步记住东西的系统,都需要一个”记忆基质”。生活化的问法是:记事应该记在脑子里(越记越乱),还是记在本子上(本子也可能记错)?技术上有三种答案。
- 把整个过去当上下文(Transformer 的方式)。没有独立的状态,过去全留在上下文里。这就是本篇批评的做法:上下文越长,越难用,越容易卷入错误。
- 一个固定大小的压缩状态(RNN 的方式)。循环网络把历史压进一个隐藏态:
h_t=f(h_{t-1},\,x_t)
第 t 步的状态由”上一步的状态”和”新输入”一起算出来,h 的大小固定不变。补充一个数值感受:取 h_t=0.9h_{t-1}+0.1x_t,输入序列 (1,0,0,0,0),得 h=(0.1,\,0.09,\,0.081,\,0.073,\,0.066)——五步之后,最初那个 1 只剩 0.066。这就是”指数遗忘”:固定大小必然丢东西,丢多丢少由 f 决定。本篇的”外部任务状态 S“是同一思想,只是状态放在模型之外、由 harness 维护,且用规则而不是学出来的 f 来决定记什么。
- 选择性状态(状态空间模型 / Mamba 的方式)。在线性循环里加”选择性”:
h_t=\bar{A}h_{t-1}+\bar{B}x_t
和上一行是同一类递归:\bar{A} 决定”保留多少旧状态”,\bar{B} 决定”加入多少新输入”。若两者可学习,模型就自己学”哪些该记住、哪些该放走”——功能上对应”管理者决定什么进 S“。Mamba 把这个选择训练进模型,本篇用人工规则,区别就在这里。
回到这篇:它本质上是在 harness 层选”记忆基质”——把该记住的压缩成外部状态 S,而不是靠越来越长的上下文来记。这个选择把”记忆”从”模型能力问题”变成”系统设计问题”:模型负责单步怎么想,系统负责跨步记什么。顺着能问出真问题:能否让”什么该进状态”被学习,而不是人工写?(见 8.6、8.12。)
8.2 长上下文为什么不可靠:注意力、位置、检索
自注意力的形式是
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\!\left(\frac{QK^{\top}}{\sqrt d}\right)V
先拆字母。把上下文想成一个图书馆:每个位置(一段话)有三个属性——K 是标签(这本书讲什么)、V 是内容(书本身)、Q 是你手里的检索词(我想找什么)。QK^{\top} 给每本书的标签和检索词算相关度;除以 \sqrt d 只是把数值压到合适范围;softmax 把相关度变成”加起来等于 1”的权重;最后按权重把书的内容混一遍,就是你读到的”相关材料”。
补充一个数值例:三个位置的相关度得分 (2,1,0),softmax 后权重约为 (0.665,\,0.245,\,0.090)——最相关那个位置拿三分之二。但如果有 300 个位置、其中仍只有一个真正相关,softmax 要把权重摊给所有位置,相关者的份额被摊薄。这就是”注意力稀释”的直觉。“能看到”不等于”会用”,它随上下文变长而退化。已知的原因(多为假说,未定论):
- 注意力稀释(如上);
- 位置先验:RoPE/ALiBi 这类位置编码天然偏向”近处更重要”,首尾被重视,中部易被低估;
- 检索式利用:模型更像在”检索”而非”逐条扫”,长上下文里检索失败率升高;
- 干扰淹没:相关句子被大量无关文本包围时,提取成功率下降。
这带来一个干净的对照:如果不能指望”从长上下文里精确提取历史”,那么像本篇这样,让 agent 每轮只带”一小段被验证过的状态”,就是工程上的稳妥替代。代价是 S 必须真是”该记住信息”的摘要,否则反而丢信息(§6.8)。这条线往下还有:位置编码的归纳偏置、长上下文评测、检索增强(RAG,见 8.8)。
回到这篇:它不跟”长上下文退化”正面作战,而是绕开它——每轮只带该带的一小段,把”从脏数据里找信息”换成”直接读干净结论”。
8.3 验证、自评与对齐:propose–verify 和 RLHF
“先做、再由一个独立方判定”这个模式,先看一个非 AI 的例子:作者自己校对稿子,错别字总是漏——因为大脑里已经”知道”内容要说什么,眼睛读的是记忆而不是文本。换一个人读,一眼就挑出来。这就是自评偏差:生成者的视角污染了评价。技术形态一整族:
- RLHF / PPO:policy 负责生成,一个另外训练的 reward model 负责打分——把”生成”和”评价”分给两个模型;
- self-consistency:同一问题采样多次投票,用多数替代单次自评;
- 测试时扩展:验证器加搜索(见 8.7);
- 辩论 / critique:一个模型批评另一个的输出。
本篇的 auditor 属于这一族:把”是否完成”的裁决权从执行者手里拿走,交给一个只读、只看环境的角色。
但这里有个被低估的坑:“独立”要落到认识论才算数。如果 auditor 和 executor 共用同一个模型,两者共享同一类盲区——好比请同班同学改你的卷子:分工是独立的,智慧不是。更深的问题是监督能力的差距:弱的验证器抓不到强生成器的细微错误;能力同源的验证器,甚至会一起错。
回到这篇:它做到的是结构独立(角色、上下文、权限分开),没做到的是认识论独立(模型、盲区相同)。论文默认三角色同一模型,这正是 §十 第 1 条局限、也是我研究问题的起点。
8.4 可靠性工程视角:账本、事务与崩溃恢复
补充:不看 AI,看一个成熟的行业怎么解决”长流程别把账记错”:数据库和分布式系统。对照着看,本篇的每个部件都有几十年前的原型。
- 转账要么整笔成、要么整笔不成(原子性)。对应本篇:一个子任务合约要么被完整验证、要么不算数,不存在”做对了一半就算完成”。
- 先写日志再动数据(Write-Ahead Log)。数据库改动落盘之前,先把”我要做什么”写进日志,崩溃后靠日志恢复。对应本篇:审计报告 v_i 先于状态推进——只有核实过的结论才有资格改 S,而 S 是唯一跨轮的东西。
- 幂等性:同一操作执行多次,结果与执行一次相同。对应本篇:子任务合约划定了边界,执行者重试不会把环境越改越乱。
- 检查点(checkpoint):长计算每隔一段把进度存盘,崩了从检查点重来,不从头算。对应本篇:S 就是检查点,fresh-context 执行器从检查点出发。
这个视角还提示一个本篇没做的部件:数据库的日志是追加式的,历史不可篡改;本篇的状态是原地更新的,只留结论不留过程。如果 S 写错了,没有”回滚到上一版状态”的机制——审计提议、管理者并入,但并入错了怎么办?这是一个可以改进的方向(状态版本化、可回滚),记入 §8.12。
回到这篇:它等于给 agent 的”干活流水线”补上了数据库在几十年前就补上的那课——状态与过程分离、写前核实、崩溃可恢复。它的新意不在部件,在把这些部件第一次系统地装进 LLM agent 的外壳里。
8.5 委托-代理视角:为什么审计要看凭证,不看汇报
补充:换个更日常的框架:你雇装修队翻新厨房。你不可能盯每一步,所以你验收:看瓷砖缝、开柜门、试水压——看结果本身,不听工头讲辛苦。经济学叫这”委托-代理问题”:代理人知道实情,委托人不知道(信息不对称),代理人的利益又和你不完全一致,所以他汇报里”基本搞定了”这句话的含金量要打折。
成熟组织的解法和本篇一一对应:
- 验收标准先写进合同,对应子任务合约里的验收标准;
- 审计算凭证不问当事人,对应 auditor 只看环境证据 e_i,o_i 只当定位线索;
- 四眼原则:关键决定两人签字,对应执行与判定角色分离;
- 内审部门独立于业务线,对应 auditor 不持环境写权限。
还有反向的教训:Goodhart 定律——“一旦一个指标变成目标,它就不再是好指标”。传闻中的例子:钉子厂按重量考核就生产少数巨型钉子,按数量考核就生产一堆图钉。本篇的审计指标(验收标准、完整性检查)同样可能被刷:执行者学会做”看起来满足验收标准”的表面文章。论文的 DOC_task_2 案例(改文档 XML 让标题”看起来是”H1,p.13)恰好就是这个风险的实例——基线 agent 刷了表面指标,被审计者对着底层样式核实后拆穿。
回到这篇:auditor 是给 agent 装了一个”看凭证的内审”。但同模型审计,相当于内审和业务同一批人换牌子上班——§8.3 的认识论问题,用组织语言再说一遍。
8.6 agent 是怎么被训练的:agentic RL
本篇是在推理时用结构(harness)提高可靠性。另一条路是把”会维护状态、会自我校验”训练进模型里,叫 agentic RL。它的目标函数还是强化学习那一套:
\max_{\theta}\ \mathbb{E}_{\tau\sim\pi_{\theta}}\!\left[\sum_{t}\gamma^{t}r_t\right]
逐符号读成人话:\theta 是模型参数;\pi_{\theta} 是策略(给定状态决定做什么);\tau 是一条完整轨迹(动作、观察、奖励的一串);r_t 是第 t 步的奖励;\gamma 是折扣——今天的 100 块和一年后的 100 块不一样值钱,\gamma 越小越只看眼前;\mathbb{E} 是对所有可能轨迹取平均。整行:调参数,让平均累计奖励最大。
难在信用指派(credit assignment)。工地比喻:一栋楼验收时歪了,惩罚谁?打地基的、焊钢梁的、还是封顶的?奖励只在最后出现,中间几十步谁立功谁闯祸很难说清。常用工具是优势估计(GAE:给每一步估一个”比平均好多少”的分数)和策略梯度算法(PPO / GRPO 这类,名字记不住没关系,知道它们是”按优势分数微调策略”的算法即可)。
结构上有个有趣的对照:RL 里的 critic(评价当前局面好坏的学习组件)和本篇的 auditor 功能同型——都是”评价者”。区别是 critic 是训练出来的价值函数,auditor 是只读环境的检查器;前者内化,后者外挂。
回到这篇:它用”结构”替代”训练”。结构是死的、人工设定的;真正会维护状态、会自我校验的 agent,或许应该被训练出来。两条路的交叉点——“可学习的状态压缩器”(8.1 提过)——是本篇留给我的最大空白。
8.7 测试时计算扩展与验证器:更深的”独立判断”
“多生成几种候选,再用一个独立评分器挑”,就是测试时计算扩展。考试类比:同一道题写三种解法,再请一位阅卷人挑最靠谱的——写三份是”多花算力”,阅卷人是”验证器”。具体做法:
- Best-of-N / 自洽性投票:采样 N 次取多数或最优,用”多数”抵御单次偏差;
- 结果奖励模型(ORM)/ 过程奖励模型(PRM):训练一个模型给最终答案或中间步骤打分,PRM 监督更细但更难训;
- 树搜索 + 验证器:在推理分支上搜索、打分、剪枝。
限制和 8.3/8.5 一脉相承:验证器不能比生成器弱太多——能力不够抓不住细微错误,同源则一起错;而且当奖励模型被当作优化目标时,出现 Goodhart 式偏离:模型学会刷分而不是变好。
回到这篇:auditor 就是一个只读验证器。用同模型当 auditor,只能抓到”结构上可发现的错”,抓不到”它自己也看走眼的错”。这直接指向研究问题第一、二条。
8.8 记忆增强、RAG 与上下文工程:更多”记忆基质”
8.1 说了三种基质,这里补三种常见做法,同一类问题的不同解答。
- 检索增强生成(RAG)。图书馆比喻:不把图书馆背下来,建索引,回答前先去查相关章节。它管”知识在哪”,本篇的状态管”做到哪一步、哪些已验证”——两者互补。
- 记忆分页(MemGPT 一类)。操作系统把内存当”页面”,不够就换出旧页、要用再换入。MemGPT 对上下文做同样的调度。和本篇非常像:一个在模型层做分页,一个在 harness 层做状态管理,连”什么该换入换出”的调度问题都一样。
- 生成式智能体(Park 等的 Generative Agents)。先存”记忆流”(原始观察),再有”反思”产生高层结论,检索时按相关性、新鲜度、重要性加权。三层结构:原始观察 → 反思摘要 → 当前决策。本篇的任务状态 S 正是”被验证过的反思摘要”那一层——只留可靠的结构化结论,丢掉原始轨迹。
回到这篇:智能体记忆 = 存储 + 检索 + 更新策略。本篇强调”更新策略 = 只认验证过的证据”,RAG 强调”检索策略 = 相似度”,MemGPT 强调”调度策略 = 换入换出”。“什么该进状态”能不能学到,是这条主线里最吸引我的空白。
8.9 评测:分数怎么来的,能信吗
本篇用三个基准(细节评分规则本文还没补齐,这里先立骨架):
- WeaveBench(114 个任务,GUI+CLI 混合):PassRate 是完全通过的任务占比,Overall 是全体平均分,还按八个域分列;
- OSWorld 2.0(108 个桌面工作流):Binary 是最终得满分 1 的任务占比,Partial 是平均分;Binary 比 Partial 严,所以 2.8% 升到 8.3% 的”三倍”提升比 21.5% 升到 35.2% 更”跃迁”(p.8)——它把”做对大半”更频繁地变成”全部做对”;
- Terminal-Bench 2.1(命令行任务):三次运行取平均分(p.8)。
读数要有戒心:
- 权限混杂:WeaveBench 官方用普通用户账号,本篇用 root(p.6)。权限不等价时,“比官方最好结果翻倍”不宜直说;
- 对照强度:它做的是同模型同后端对比,隔离了”是否加状态管理层”,但没隔离”是否只是多了回合与预算”(§8.12 问题 2);
- 饱和与污染:三个基准是否已被训练数据覆盖,论文没讨论。
评测的本质:它衡量的是你希望的东西,还是最容易刷的东西?回到这篇:三个基准的相对提升是可信但需打折的信号——能说明”机制确有增益”,不能推广成”任何长任务都可靠”。
8.10 四个案例深读:论文最有说服力的证据
论文用四个配对轨迹展示同模型同后端下基线与 LongHorizon-Harness 的差异(案例与分数见 p.11–13)。
- 卡死在同一个交互(WEB_task_16,WebRTC 仿真层审计)。基线点开 Wireshark 的”Decode As”对话框,没响应,它只把这句观察留在越来越长的会话里,反复点、反复试,超过 400 步卡在同一对话框,得 0.59 分。LongHorizon-Harness 把”这个交互失败了”记进状态,下一轮执行者不再碰它,直接去收缺的图表层和包级证据,得 0.92 分(p.11)。
- 看起来对,其实不合规(DOC_task_2,标题样式归一)。基线直接改文档 XML,15 个标题”看起来是”H1,以为完成,实际任务要求走 LibreOffice 样式流程,得 0.00 分。LongHorizon-Harness 按规定 GUI 操作应用样式再复查;审计者解析 XML 确认底层样式确实变成 Heading 1、大纲级别 1,得 0.89 分(p.13)。
- 先改证据、后补记录,顺序错了(DOC_task_4,VLOOKUP 公式修复)。基线截了公式错误的图,但没收完整”修复前”证据链就去改表格,还直接改 XML 打包,前后矛盾,得 0.45 分。LongHorizon-Harness 把”缺修复前证据”记成待办,下一轮先补完证据序列再修公式,审计者核对 9 张截图确认时间一致,得 0.87 分(p.12)。
- 把进展留在状态里(WEB_task_10,Lighthouse 性能优化)。基线做完了核心优化,却在收性能证据时反复点不开某个标签页,400 步后预算耗尽,得 0.53 分。LongHorizon-Harness 把”已完成优化”放进状态,把剩余证据收集交给之后几轮 fresh-context 执行者,得 0.85 分(p.12)。
四个案例的共同点就是机制的直接写照:状态外化,下一轮基于”被验证过的、还要做的”工作。它们不是统计证据,但把机制讲得很具体。
8.11 本簇术语表
- harness:模型之外的系统层,组织提示、工具、上下文、分步执行。
- long-horizon:步数多、互相依赖的长任务;难点在跨步一致性。
- task state:本篇核心概念,S=(R,A,F),放在执行之外。
- fresh-context:每轮执行器用全新、有界的上下文,不携带之前的原始轨迹。
- audit / auditor:只读地核实环境、判定真完成的一方;审计报告是唯一跨轮记忆。
- context rot / lost-in-the-middle:长上下文下提取信息能力下降的现象。
- compounding error / goal drift:错误逐级放大、目标漂移。
- credit assignment:在一长条轨迹里判断哪一步立功、哪一步闯祸(RL 难点)。
- agentic RL:用强化学习训练 agent 本身。
- test-time compute:推理时多花算力(采样、搜索、验证器)换正确率。
- verifier / reward model:独立评分组件,与策略网络分开。
- propose–verify:“先提出、再独立验证”的范式。
- RAG:检索增强生成。
- memory stream:智能体分层记忆(观察、反思、检索)。
- WAL / 幂等 / 检查点:可靠性工程部件,见 8.4。
- 委托-代理 / Goodhart:信息不对称与指标扭曲,见 8.5。
- 不完全合同 / 最优停止:合约写不全时剩余控制权归谁;何时停止重试,见 8.16。
- HTN / BDI / 认知架构:经典规划与”工作记忆小 + 结构化长时记忆”的老传统,见 8.17。
- CRDT / 版本合并:并发修改可自动合并的数据结构,见 8.18。
- specification gaming / reward hacking:钻验收指标的空子,见 8.15。
- 记忆巩固 / sleep-time compute:会话间隙离线整理状态,见 8.19。
- 错误去相关:认识论独立性的可操作度量,见 8.20。
8.12 合成:走向研究问题
把上面的缝隙汇总:
- “独立”到底独立到哪一步?审计和执行共用模型,结构独立、认识论不独立。如何度量”认识论独立”、并设计最小实验说明它失效?
- 增益来自”状态管理”、“通道质量”还是”多回合多预算”?需要固定总预算的对照实验。我的玩具复现已经给出第一块拼图:换通道(低误报)贡献了全部可测增益,而”依赖结构”在这个玩具里根本不起作用(§十一 预测 3a)——所以”依赖链放大”的叙事需要更小心的实验设计才能检验。
- 状态 S 的信息丢失如何量化?“充分统计量”假设何时不成立(§3.8 反例、§6.8 的损失项)?
- “什么进状态”能不能被学习?人工规则对可学习压缩器(结合 8.6 的 agentic RL)。
- 状态能不能版本化、可回滚?数据库的追加式日志与本篇的原地更新(8.4 提出的改进方向)。
8.13 收拢:发散出去,收得回来
- 记忆基质那条(8.1):把”记忆”从模型内部搬到系统外部,只收验证过的部分。agent 记忆不是模型多聪明的问题,是系统怎么设计的问题。
- 长上下文那条(8.2):解释了为什么必须 fresh-context——不是要 agent”失忆”,是只记该记的。不指望从脏上下文里提取,直接读干净结论。
- 验证与对齐(8.3、8.7):点出天花板。它把自评偏差当结构问题来解,但没解掉”同模型审计”的认知盲区——独立是有条件的。
- agentic RL(8.6):它是用”结构”替代”训练”。会维护状态的 agent 或许应该被训练出来,而不是被 harness 强制。
- 可靠性工程(8.4):它的每个部件都有数据库时代的原型,新意在于第一次系统装进 agent 外壳;同时暴露”状态不可回滚”这个可改进点。
- 委托-代理(8.5):auditor 是”看凭证的内审”,但同模型审计等于内审与业务同源;Goodhart 的风险在案例二里真实出现过。
- 评测(8.9):分数提升是可信但受限的信号,读数要分清”机制有效”和”分数很高”。
收拢成一句:干活的没有裁决权,记账的看不到现场,验收的碰不了环境——这篇把”长任务执行”拆成”一系列被审计的状态转移”,三个角色互相削权,换来一本谁也不敢糊弄的账。
这句判词自带保质期:分工拦得住说谎的汇报,拦不住一起看走眼的眼睛——三个角色共用同一个模型时,“独立”只剩结构那一半,账本的可信度封顶在同源盲区(8.3、8.14)。
绕不开的问题还在原地:跨步的那份记忆,到底该由模型内化,还是由系统外挂?哪条路更对,是下一颗种子的事:StructAgent 的”因果结构”、ToolVerse 的”agentic RL”、或者”状态 = 充分统计量”那个分支本身。
(第一轮发散收拢到此。下面 §九 是写作更晚的第二轮发散,编号顺延为 9.1 起,9.8 再收拢一次——读到 8.13 以为全文结束的读者,那边还有半场。)
九、发散扩展(第二轮)
第一轮发散(8.1–8.10)覆盖了记忆基质、长上下文、propose–verify、可靠性工程、委托代理、agentic RL、测试时扩展、RAG、评测。第二轮沿七条第一轮没挖的面继续,体例不变:每条从生活场景进,最后一句”回到这篇”收口。(每条另配一层”补一层数学”,把发散从定性论断推进到可算、可进实验的形式。)
说明 / 核对状态(点击展开)
核对状态(2026-08-28 更新):本节 8.14–8.20 引用的外部文献与历史断言,逐条登记如下。
已核对(五项,均与正文表述一致): - Hart 不完全合同(8.16):Hart 与 Holmström 获 2016 年经济学诺奖,核心即”合同写不全、剩余控制权归属决定结果”,合作脉络含 Grossman/Moore(Nobel 官方科普页)。 - CRDT(8.18):Shapiro、Preguiça、Baquero、Zawirski,SSS 2011(LNCS 6976),状态/操作两族(ACM DL / INRIA HAL)。 - sleep-time compute(8.19):“Sleep-time Compute: Beyond Inference Scaling at Test-time”,arXiv:2504.13171,Letta 与 UC Berkeley(C. Snell),2025-04——“2025 年起”成立。 - HTN(8.17):Erol/Hendler/Nau 1996 复杂性结果;上承 NOAH(1975)、Nonlin、O-Plan、SHOP2(Wikipedia,引原始文献)。 - BDI(8.17):哲学源头 Bratman《Intention, Plans, and Practical Reason》(1987);技术化 Rao & Georgeff 1991/1995;PRS 谱系(Wikipedia,引原始文献)。
仍未核对(尚未核对):SOAR/ACT-R 的出处年份(教科书级,低风险);同行评审一致性的具体实证文献(8.20 只作方向陈述,未引具体研究);Goodhart 钉子厂例子(8.5 正文已标”传闻”);库恩范式保守性(教科书级);METR”近四个月翻倍”(2026-08-28 首轮已核”七个月”部分)。
另注:8.14 的”多审计误报率按 \mathrm{fp}^{\lceil k/2\rceil} 量级下降”是补充推导(错误独立前提下的多数决),不是引文;其失效条件(同模型错误相关)正文已自述。各条”回到这篇”收口处的论断针对本文自身,不依赖上述外部断言的细节。
9.1 谁审计审计者:递归审计与权力制衡
AEA 里有两个没人监督的权力点:审计者说”complete + clean”,事实就进状态;管理者执行 admit 合并,合并错了没人拦。生活化的问法:纪委谁来监督?公司内审如果只向业务线汇报,独立性就是演戏。
可展开的治理部件:
- 递归审计(抽检)。对审计者的判定做二次抽样复核:随机抽一部分 v_i 给另一个审计上下文重审,估计 \mathrm{fp}_a 本身的误差。这把 §3.3 的”假设值 0.03”变成可测量——通道质量不再靠信仰,靠在线估计。
- 多审计者投票及其失效条件。k 个审计者独立判、多数决,误报率按 \mathrm{fp}^{\lceil k/2\rceil} 量级下降——前提是错误独立。同模型审计员的错误高度相关(同一盲区一起看走眼),投票收益接近零。这给出一个干净的判据:多审计值多少,取决于错误去相关程度,不取决于人数。
- 横向制衡。执行者可对审计结论”申诉”,触发换一个审计上下文重审;管理者对合约的拆法(哪个子任务、什么边界)本身也可被审计者标记为”合约可疑”。
- 政治学的分权原型(立法/执行/司法)、软件工程的分级 code review(小改动一人审、核心模块两人审 + CI 机器审),都是现成的对照:制衡的代价是延迟和成本,收益是单点错误不再直通状态。
补一层数学:多审计投票的收益公式与它的失效条件。设单审计误报率 \mathrm{fp}=0.03,k 个审计者独立判定、取多数,多数判错的概率是二项尾:
P(\text{多数错})=\sum_{j=\lceil k/2\rceil}^{k}\binom{k}{j}\mathrm{fp}^{j}(1-\mathrm{fp})^{k-j}
手算 k=3:3\times0.03^2\times0.97+0.03^3=0.00262+0.00003\approx0.0026——从 3% 压到 0.26%,约 11 倍。但同模型审计的错误相关:设共同盲区(一起看走眼的概率)为 \rho=0.01,则
P\approx\rho+(1-\rho)\times0.0026\approx0.0126
收益从 11 倍缩到 2.4 倍,且 \rho 再大一点收益就没了。投票的收益由 (1-\rho) 主宰,不由人数主宰。配套的抽检估计也顺手可算:抽 n 条复核估计 \hat{\mathrm{fp}},其标准差 \sqrt{\mathrm{fp}(1-\mathrm{fp})/n};抽 100 条约 1.7 个百分点——够把 0.03 量级的通道测准。这两条公式把 §8.12 问题 1 的”独立性度量”从口号变成了可算的实验。
回到这篇:它的三角色是第一次分权,但只分了”执行权”和”裁决权”,“裁决权自身的监督”和”立法权(怎么拆任务、怎么定验收)“还在同一个模型手里——§8.12 问题 1 的实验设计可以从”抽检估计审计误差”入手,这是最小可行的一步。
9.2 对抗与安全:当执行者伪造证据、环境说谎
§8.5 的 Goodhart 停在”执行者刷指标”,但还有一个更深的对抗面没打开:验证假设证据诚实。
- 执行者主动伪造证据。审计者”只看环境”,但环境里的一切都可被改:截图可以事后拼接、文件时间戳可以 touch、命令输出可以先写进文件再 cat。只读审计防的是”没看仔细”,防不了”看到的东西本身就是布景”。这对应 AI 安全里的 specification gaming / reward hacking 攻防:一旦”审计通过”变成执行者的优化目标,执行者就从干活的变成钻空子的。
- 环境本身被污染。网页内容、依赖包、被上游进程改过的文件——执行者和审计者看的是同一个说谎的环境,独立通道也救不了:\mathrm{fp}_a 低的前提是环境忠实,这个前提没有保证。
- 缓解方向的谱系:证据要带”不可伪造的旁证”(命令的 exit code 与 stderr 同录、截图带系统时间与光标位置、文件 hash 链);关键步骤留”环境快照”供审计回放(虚拟机 checkpoint);对高价值结论用 8.14 的多审计——不是为了去相关模型盲区,而是为了提高伪造要骗过的人数。
补一层数学:伪造成本的指数化。设执行者伪造一条旁证、骗过一个检查的成功率为 s;一条结论带 k 条独立旁证(文件哈希、时间戳、命令退出码、截图各算一条),全部骗过才成功:
P(\text{伪造得手})=s^{k},\qquad \mathbb{E}[\text{伪造尝试次数}]=s^{-k}
手算 s=0.5:k=1 时期望 2 次尝试;k=4 时期望 16 次。§3.5 的指数这次站在防守方——旁证每加一条,伪造成本翻倍,而审计成本只线性加。伪造不再划算的阈值条件:s^{-k}\cdot c_{\text{forge}}>c_{\text{redo}}(诚实重做更便宜时,对抗失去激励)。注意两个前提:旁证必须独立(都伪造同一来源就退化成 k=1);s^{-k} 只在执行者理性时成立,非理性/不在乎成本的对手要靠 8.14 的抽检兜底。
回到这篇:它把验证做成了结构,但没有把验证做成对抗下的协议。安全视角的改法一句话:审计不是”看一眼环境”,是”和环境做一次不可伪造的交互”。这是论文完全空白、而现实任务(尤其涉及网页、文件、第三方依赖时)迟早会撞上的一面。
9.3 机制设计与最优停止:合约不完全、重试何时刻车
§8.5 用了委托-代理的”信息不对称”一半,经济学还有另外两半没用上。
- 子任务合约是不完全合同。验收标准写不全(DOC_task_2 正是合同漏洞:任务方心里要的是”样式流程”,合同里写的是”标题变成 H1”)。不完全合同理论(Hart 一脉)的结论直接适用:合同写不全时,剩余控制权归谁决定结果——本篇里剩余控制权在管理者(它可以解释合约、追加验收),这既是灵活性的来源,也是漂移的入口。可发散:合约要不要带”反验收”条款(什么样不算完成),正反例各写进合约。
- 重试是最优停止问题。N_{max}=25 是一刀切的硬上限,但 §3.6 的工具够推出更细的东西:一个子任务每轮以概率 p 被诚实推进,已试 k 轮未过,后验信念随 k 下降;继续试的期望收益递减、成本线性,存在一个停止阈值 k^*,超过就该报 blocked 而不是再掷一次。这就是秘书问题/序贯检验的近亲: \text{再试一轮的期望价值}\ \approx\ p_{k}\,\Delta V-\text{cost}_{\text{round}},\qquad \text{停当 } p_{k}\,\Delta V<\text{cost}_{\text{round}} 其中 p_k 是”已失败 k 次后下一轮成功”的后验。论文的 25 轮兜底把这个决策外包给了常数。
- 预算是资源配置。总 token 预算在多个待办子任务之间怎么分(这个任务快成了多给一轮,还是果断换轨道),是 bandit / 资源分配的经典形态。§6.6 那笔”方向不一致的账单”(Opus 省、Qwen 花三倍)本质就是弱模型把预算烧在重试上。
补一层数学:重试止损的后验推导——25 轮兜底为什么浪费。设子任务先验对半分两种类型:“易”(单轮成功 p_e=0.9)与”难”(p_h=0.1)。连败 k 轮后,它还是”易”的后验:
P(\text{易}\mid k\text{ 败})=\frac{0.5\times0.1^{k}}{0.5\times0.1^{k}+0.5\times0.9^{k}}=\frac{1}{1+9^{k}}
手算:k=1 得 0.10,k=2 得 0.012,k=3 得 0.0014。三轮连败后基本可以断定是难类型,继续试的期望成功率按 0.1 算——止损阈值 k^* 由 p_h\,\Delta V<c_{\text{round}}(再试一轮的期望收益低于轮成本)给出。对照论文的 N_{max}=25:它不更新信念,对”难到做不动”和”偶然连败”一视同仁地烧满 25 轮。§6.4/StructAgent 的 retry storm(单步 100+ 次验证-重试烧穿预算)正是没有这层后验的实况。这个两类型模型足够简单,可以直接写进玩具复现当第四系统的止损规则。
回到这篇:它是”机制”做了、“机制设计”没做——合约怎么写、何时止损、预算怎么分,全是人工常数。这三个常数恰好都是可学习的候选(和 §8.12 问题 4 汇合)。
9.4 经典规划与认知架构:管理者是个老灵魂
把镜头拉远:AEA 的管理者干的事——读状态、挑一个依赖已满足的子目标、发一份有界合约、判断何时 done/blocked——在 AI 史上有个名字,叫规划;整个循环在另一个更老的框架里也有原型,叫认知架构。
- HTN(层次任务网络)规划:把大任务层层分解成”方法 + 前置条件 + 子任务”,管理者的每轮决策就是一个 HTN 分解步。
- STRIPS/PDDL:经典规划把世界建模成”状态 + 前置条件 + 效果”的谓词逻辑,本篇的 S=(R,A,F) 带状态标签 \sigma,就是谓词状态机的 LLM 版。
- BDI 架构(信念-愿望-意图):外部任务状态对应 belief base,子任务合约对应 intention,“挑一个还没完成、依赖已满足的目标”就是 BDI 的 deliberation 循环。
- SOAR / ACT-R:上世纪的认知架构早就主张”工作记忆小、长时记忆结构化、按需检索”——和 fresh-context + 外部状态 S 的设计逐点对上。8.1 里”记忆基质”的争论,1990 年代争过一轮。
补一层数学:MEA 与 HTN 的形式对应与复杂度差。HTN 把任务分解成 AND-OR 网络再搜索解,一般情形的 HTN 规划不可判定(Erol/Hendler/Nau 1996,出处已核对)——不存在通吃的分解算法。MEA 的选择不同:管理者不展开树,每轮只在”依赖已满足的 pending 集”里挑一个,选择空间 O(|\text{pending}|) 而非 O(b^{d})。代价是把”分解好不好”从算法问题变成了审计问题——分解错了不报错,只是被审计一次次打回。逐项对应:BDI 的 belief base ↔︎ S,intention ↔︎ c_i,deliberation ↔︎ q_{i+1},commitment ↔︎ admit 守卫。合起来的判语:MEA 是”带验证门的 HTN”——分解步只有通过 admit 才落地,等于在 AND-OR 图上做带审计的贪心搜索。
回到这篇(也是回到本仓库的视频系列):深度学习时代把”规划”这条线(1950s–1990s:逻辑、专家系统、HTN、BDI)几乎整个盖掉了,大家以为”学习”能吞掉一切;这篇 harness 等于把老规划派请了回来——模型管单步智能,经典规划管跨步结构。对 M1–E9 系列这是现成选题:E9 收束或加更集可以讲”被学习盖掉的那条支流,2026 年以 harness 的形式回来了”,和”1943 开关、1958 学习”构成完整的两支汇流叙事。
9.5 并行化:依赖 DAG 上的并发执行
论文是严格串行的:一轮一个子任务。但 §4.3 的状态 S=(R,A,F) 天然是一张依赖图——要求之间有的有依赖(改公式依赖先取证),有的没有(收两张互不相干的截图)。没有依赖的子任务可以并发:多个 fresh-context 执行者同时开工,各自拿自己的合约。
并发带来的新问题恰好都是老朋友:
- 状态合并冲突。两个执行者改了同一个文件,管理者的 \oplus 合并就成了并发写问题。分布式系统的解法谱系直接适用:锁(合约里把资源划成互斥区)、版本向量(每个产物记改自哪版状态)、CRDT(把产物设计成可自动合并的形态——文本的、集合的都有现成结构)。
- 审计的并发化。每个执行者配一个审计者,审计通过的才回管理者合并——正好是 8.4 提到的”事务提交”:并发事务,串行化提交。
- 收益的边界:8 步链式任务无并行度可言(每步依赖上一步),所以并行的收益取决于任务的真实依赖结构——这又把 §十一 预测 3a 那个”依赖结构没被检验”的遗憾反过来用了:先把依赖结构建模清楚(哪些步真依赖),既回答了旧问题(依赖放大何时存在),又打开了新问题(哪些步可并行)。
补一层数学:并行的收益与合并的冲突,各一条公式。收益上界是 Amdahl 式的:任务中串行占比 f(依赖链那部分),n 路并发至多加速
\text{Speedup}\leq\frac{1}{f+(1-f)/n}
手算:8 步纯依赖链 f=1,加速恒为 1(LH 的四个案例全是这种形态,并行动不了);贯穿示例里若 r_5 的三类证据中有三条互不依赖(f=0.4),n=3 时加速 1/(0.4+0.2)\approx1.67 倍——中等收益,不是线性。冲突侧:m 个并发执行者各自以概率 c 碰同一共享资源,两两独立时全无冲突的概率 (1-c)^{m(m-1)/2};手算 c=0.1、m=3:0.9^3=0.73——每三四次合并里就有一次要处理冲突。CRDT 的价值一句话说尽:把 c 做成 0,代价是把产物约束成可自动合并的形态。
回到这篇:我的玩具复现加一个 parallel 模式(无依赖子任务并发、按完成序合并)就能做出第一版实验,是七条发散里动手成本最低、最快能产出可证伪预测的一条。
9.6 跨会话与记忆巩固:状态过夜
§十第 7 条点了一句”跨会话、跨天任务无证据”就停了。展开看,跨天任务给 S 提出三个新要求:
- 状态的保质期。F(事实)会过期:昨天”这个标签页打不开”的事实,今天环境更新后可能不成立。跨会话需要给每条事实带置信衰减或”复验触发条件”(多久必须重审一次),否则状态自己变成新的错误源。
- 离线巩固。人睡觉时把白天的经历整理成稳定记忆(记忆巩固)。对应做法:会话间隙跑一个离线 pass,把累积的审计报告重新总结、去重、归纳出更高层的结论(“这三类对话框都点不开,可能是仿真层问题”),下个会话带压缩后的 S 开工。Generative Agents 的反思层是会话内版本,这里是跨会话版本——也和 2025 年起的 sleep-time compute 一脉。
- 版本化与回滚(§8.12 问题 5 的深化):跨会话意味着出错的状态可能存活很多天、污染很多后续轮,“追加式状态日志 + 可回滚”从改进项升级为必需品——8.4 的 WAL 隐喻在这里兑现得最彻底。
补一层数学:事实的保质期可以写成失效率模型。每条 fact 每天以失效率 \lambda 变假(环境更新、页面改版、权限回收),t 天后仍真的概率:
P(\text{仍真})=e^{-\lambda t}
手算:稳定类事实(\lambda=0.005/天,如仓库路径)30 天后 e^{-0.15}=0.86,可放心带过夜;易变类(\lambda=0.05/天,如”这个标签页能打开”)30 天后 e^{-1.5}=0.22——带过夜基本等于带着一条假事实开工。复验调度由一条不等式驱动:P_{\text{stale}}(t)\cdot C_{\text{error}}>C_{\text{recheck}}(用错过期事实的期望损失超过复验成本)时必须复验,解出最优复验间隔 t^*。它的含义与 8.16 的止损同构:维护状态不是免费的,每条记录都要按风险付复验的租金——这正好补上 StructAgent Invalidated 没覆盖的另一半(时间性过期 vs 事件性推翻,两码事)。
回到这篇:它的贡献是”轮间”状态管理;“天间”状态管理是同一思想换了个时间尺度,但保质期、巩固、回滚三个部件都是它没有的——足够当一颗独立种子。
9.7 科学共同体:propose–verify 的最大社会原型
8.3 用 RLHF、8.5 用内审,但”提出者不裁决自己的成果”在社会里最大的原型还没用:科学共同体。
- 同行评审 = 审计(只读、对照验收标准、可提 major/minor revision = blocked/pending);
- 可重复性 = “证据来自环境”的强化版:不只审计者能核实,任何第三方都能核实——这是比论文的 auditor 更强的一条标准;
- 预注册(先写验收标准再开工)= 子任务合约先行,防”事后挪门柱”;
- 评审激励与偏见(熟人圈、主流范式压制异见)= 同模型审计的社会版:评审者和作者共享同一套”范式盲区”,库恩意义上的范式保守性,就是 \mathrm{fp} 与 \mathrm{fn} 在共同体层面的系统性同源。
这条发散的真正产出是给 §8.12 问题 1 一个可操作的度量:认识论独立性 ≈ 错误去相关。两个评审独立,不是说他们不认识,而是他们看走眼的地方不重叠。落到实验设计:让执行者与审计者(a)同模型同提示、(b)同模型不同提示、(c)不同模型,各跑一批,测”审计与执行犯同一种错”的联合概率——联合错误率显著高于独立假设的乘积,就定量证明”结构独立、认识论同源”。同行评审研究里有现成的评审一致性文献可借。
补一层数学:“认识论独立性 = 错误去相关”可以量到带功效计算的实验。两个审计者对同一批结论各给判定,错误指示 E_1,E_2(判错=1)。定义超出相关度:
\Delta=P(E_1{=}1,E_2{=}1)-P(E_1{=}1)\,P(E_2{=}1)
\Delta=0 是真独立;\Delta>0 是同源盲区(一起看走眼的比例超出巧合)。三档实验的预注册预测:同模型同提示 \Delta 最大;同模型异提示居中;异模型最小。样本量手算:要从 0 里分辨出 \Delta=0.05(基率 0.1 附近),每档约需 2\,p(1-p)/\Delta^2\approx2\times0.09/0.0025=72 对审计判定——三个模型档 × 各百来个子任务,一轮就能把”结构独立、认识论同源”从论断变成数字。这直接是 LH 研究问题 ② 与 StructAgent §6.6(选探针通道)合起来的人工可跑版。
回到这篇:auditor 是给 agent 装了内审;科学共同体的经验提醒我们,内审之上还有一层——让结论可被任何第三方复验。沿着这条走,“审计报告带完整证据引用”(论文已有雏形)会从工程细节变成制度设计。
9.8 第二轮收拢
- 治理(8.14):分权只做了一半,“审计的审计”是空位;最小可行一步是抽检估计审计误差。
- 对抗(8.15):验证默认证据诚实,对抗下的”不可伪造审计协议”完全空白——七条里天花板最高的一条。
- 机制设计(8.16):合约、止损、预算三个常数都该从人工变成可学习/可推导。
- 规划史(8.17):管理者是 BDI/HTN 的转世;对本仓库视频系列是现成选题(被学习盖掉的支流以 harness 回归)。
- 并行化(8.18):依赖 DAG + 并发执行 + 状态合并,玩具复现即可动手,成本最低。
- 跨会话(8.19):轮间状态管理 → 天间状态管理,保质期/巩固/回滚三部件,可当独立种子。
- 科学认识论(8.20):独立性 = 错误去相关,给了 §8.12 问题 1 一个可测量定义和三档实验设计。
七条均已配一层可算的数学:投票收益由 (1-\rho) 主宰(8.14)、伪造成本随旁证数指数化(8.15)、连败三轮后验断定难类型(8.16)、MEA = 带验证门的 HTN(8.17)、并行上界与冲突率各一式(8.18)、事实保质期 e^{-\lambda t}(8.19)、去相关度量 \Delta 与样本量功效(8.20)。其中 8.16 的止损后验与 8.20 的三档实验已可直接写进玩具与真实验,是最可能变成下一颗种子的两块。
按对研究问题的贡献排:8.14+8.15(治理与对抗,可合并为一颗种子)> 8.16(最优停止,数学工具现成)> 8.20(独立性的度量与实验)。按动手成本排:8.18 并行玩具最低,其次 8.20 的三档对照实验。
十、局限与可疑处
- “独立审计”并不真的独立。论文默认三个角色用同一个模型。审计和执行共享同一套盲区,模型在视觉或推理上集体看走眼时,审计者很可能同样看错。“独立”只是角色和结构上的独立,不是认识论上的独立。
- 补不上模型缺的能力。论文自己承认,独立审计能发现错误并触发恢复,但补不齐模型本身没有的能力。我的复现预测 3b 定量演示了这一点(§十一)。
- 论文前后数字不一致。摘要写 Claude Opus 4.7 在 OSWorld 子集从 20.0% 到 34.3%(p.1),正文写 20.6% 到 35.3%(p.8)。引用时用正文口径,或明确注明不一致。横向核验(2026-08-28)定位成因:两边是同一批成功任务(7 个 → 12 个),摘要按 35 个任务取整(7/35=20.0%、12/35=34.3%),表 3 按 34 个(7/34=20.6%、12/34=35.3%)——分母差一,arXiv 截至 v1 未勘误。引用统一用 7/34、12/34 口径。
- 没有隔离”多回合预算”这一变量。它做了同模型同后端对比,但没隔离”是否只是多了回合和推理预算”。区分”状态管理有效”和”只是多花钱反复试”需要固定总预算的对照。
- 基准权限混杂。WeaveBench 官方用普通用户,本篇用 root(p.6)。“比官方最好结果翻倍”不宜直接说。
- 案例分析是挑出来的。四个案例(0.59 至 0.92、0.00 至 0.89、0.45 至 0.87、0.53 至 0.85,p.11–13)只能当机制演示,不能当统计证据。
- 范围有限。只测了三个计算机使用基准。开放域、真实用户、跨会话、跨天中长期任务,论文没有证据。
- 没有形式收敛保证。“进度单调”是理想性质(§6.1),没被证明;依赖轮数上限兜底。
- 状态原地更新,不可回滚。审计并入出错时没有恢复机制(§8.4 提出的改进方向)。
- 小样本基准的”倍数”表述统计脆弱(横向核实统计审查,2026-08-28)。OSWorld 2.0 全集 2.8%→8.3% 是 3/108 对 9/108:未配对 z 检验 p≈0.075,不过 0.05 线;即使六个新增成功全部单向(配对最优情形),McNemar 也只到 p≈0.031。Opus 子集 7/34→12/34 未配对 p≈0.18,95%CI ±16 个百分点。相比之下 WeaveBench 主对照 59/114→92/114 的 z=4.62(p<0.0001)稳健。“三倍提升”这类比值修辞在小样本 binary 指标上夸大稳健性,读数应以绝对差加区间为准。全文无一处置信区间或显著性检验。
十一、验证结果(最小复现)
10.1 可证伪预测与判据(先于运行写下)
脚本:repro/repro_harness.py,真实输出:repro/repro_harness_output.txt(400
次运行,8 步链,单步成功率 0.85,自报误报 0.18,审计误报
0.03,漏报均为 0.05,预算 60 轮)。四个预测:
- 预测 1:外部状态 + 独立审计(mea_audit)的全任务成功率高于自报前进的基线。判据:mea_audit > baseline。
- 预测 2:把审计换成执行者自报(mea_self,架构不变、去掉独立验证),成功率应回落到基线水平。判据:mea_self 与 baseline 相差小于 2 个百分点。
- 预测 3a:若增益来自”依赖链放大”,去掉步间依赖后增益应显著缩小。判据:无依赖增益小于依赖链增益的一半。
- 预测 3b:若某一步在能力上做不成(单步成功率设为 0),独立审计无法恢复,增益应消失。判据:瓶颈设定下 mea_audit 与 baseline 的成功率都接近 0,增益接近 0。这对应论文自认的边界:“独立审计能发现错误并触发恢复,但补不齐模型本身没有的能力”。
10.2 结果
依赖链(8 步):
| 系统 | 真实完成/8 | 自报完成 | 全任务成功率 | 平均轮数 |
|---|---|---|---|---|
| 基线(增长上下文 + 自报前进) | 7.08 | 8.00 | 80.0% | 12.4 |
| MEA(外部状态 + 独立审计) | 7.88 | 7.95 | 97.0% | 11.9 |
| MEA 但审计=执行者自报 | 7.08 | 8.00 | 80.0% | 13.4 |
无依赖对照(预测 3a):基线 7.08/8(9.5 轮),MEA 7.88/8(10.7 轮)。
能力瓶颈对照(第 4 步单步成功率设为 0,预测 3b):
| 系统 | 真实完成/8 | 自报完成 | 全任务成功率 | 平均轮数 |
|---|---|---|---|---|
| 基线 | 2.86 | 7.96 | 0.0% | 31.9 |
| MEA | 2.98 | 4.67 | 0.0% | 59.8 |
10.3 判定与解释
- 预测 1:支持。 全任务成功率 80.0%→97.0%(+17 个百分点),且平均轮数没有增加(12.4 到 11.9)。假完成被低误报通道拦住,是全部可测增益的来源。
- 预测 2:支持。 换回自报,97.0% 立即跌回 80.0%,与基线持平。说明”多一个角色”本身不是活性成分,独立性才是——架构表演不产生增益。
- 预测 3a:不支持,如实登记。 真实完成步数增益 +0.80 步/任务(7.88−7.08),无依赖对照完全相同(+0.80)。原因在玩具的结构:基线的”假完成后前缀截断”在有无依赖两种模式下动力学相同,dependent 开关不改变任何一步的通过/误报概率。两句自评:其一,结论要修正——这个玩具证明的是”换低误报判定通道”的价值,没有能力检验”依赖链放大”本身,§6.7 叙事里被验证的是通道质量那半;其二,这个预测在当前玩具构造下本来就不可能被支持,可证伪性是装饰性的——设计实验时没看出 dependent 开关不改动力学,是我的盲区,教训记入 §十三.4。
- 预测 3b:支持。 第 4 步设为做不成后,两个系统的全任务成功率都是 0%,真实完成步数增益从 +0.80 步崩到 +0.13 步(表中 2.98−2.86=0.12 是两位小数取整后的差,0.13 按未取整均值计)。同时 MEA 的自报完成只有 4.67,基线虚报 7.96——审计让”报完成”变诚实了(少虚报 3.3 步),但救不了做不成的那一步。这正是论文自认边界的定量版本。
10.4 结论
把完成判定从自报挪到独立低误报通道、且只在审计通过时推进外部状态,能把全链成功率从 80% 提到 97%,且不多花轮次;去掉独立性立刻回落;遇到能力瓶颈时审计失效但汇报变诚实。同时如实承认:本玩具无法区分”增益来自依赖结构”与”增益来自通道质量”(预测 3a),玩具的重试会重掷真值(true_ok 被覆盖),与真实执行有差距——这两点已计入 §十三 未攻克。
十二、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。L1
四件套(模式名/操作定义/迁移去向≥2/失效边界)首例即立卡
notes/method_*.md;L2 五件套仅在 ≥2
个独立领域同构时立。(本节 2026-09-08
后填,体例回铺至存量笔记,时序显式标注。)
11.1 独立审计对照消融(independent-audit ablation)
- 层级:L1 领域具体(agent
架构评测)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md)。 - 操作定义:同一架构只换验证通道——mea_audit(独立审计)对 mea_self(执行者自报),把”增益来自独立验证还是流程本身”分离干净(预测 1/2:audit > baseline,self ≈ baseline);再用依赖链消融(预测 3a)与能力瓶颈消融(预测 3b:单步成功率为 0 时增益应消失)扫出适用边界。
- 迁移去向:①任何”加了机制就涨分”主张的标准检验——同架构换通道对照,涨分必须归因到机制本身;②簇内判分器审计(MT-Bench 篇)的实验设计模板。
- 失效边界:审计通道自身的误报/漏报会污染对照读数——StructAgent 复玩中”漏报触发重试、重试推翻成果”的翻车(SA 篇 §十一)就是审计噪声反噬的实例;能力边界处审计无能为力(论文自认”补不齐模型本身没有的能力”)。
- 方法卡:
notes/method_independent_audit_ablation.md(L1)
11.2 依赖链放大分析(dependency-chain amplification)
- 层级:L1 领域具体(长程任务归因)。底层原理:归因靠对照(MATTRIB)。
- 操作定义:单步机制的增益要乘上任务依赖链才变成全任务增益——预测 3a(去掉步间依赖后增益应缩水过半)把”结构放大”与”机制本身”分开;预测 3b 把”瓶颈即上限”写死:链上任一点能力为 0,下游审计全无用。
- 迁移去向:①评估任何单点改进时先问依赖链形状(独立任务 vs 链式任务的增益折算);②投资优先级判断——修链上最短板比锦上添花更有杠杆。
- 失效边界:放大分析假设步骤增益近似独立可乘;步间有强耦合(上一步输出改变下一步分布)时乘法模型失真,需改用实测链式对照。
- 方法卡:
notes/method_dependency_chain_amplification.md(L1)
11.3 方法依赖
本篇产出 L1 两张(独立审计对照消融 / 依赖链放大分析),均归”归因靠对照”(MATTRIB)原理下。意外副产品:SA 篇复玩中”漏报重试翻车”反向印证 11.1 的失效边界(审计噪声会反噬),并预注册了第四系统实验(SA 篇未攻克 ④)。
十三、没搞懂的地方(未攻克登记)
- “状态作为充分统计量”在什么条件下严格成立、什么时候丢信息(§3.8 给了硬币正例和定性反例,还没有可操作的判据)。要补专门笔记 + 一个丢信息小实验。(补齐时机:读 StructAgent 或相关形式化工作后。)
- WeaveBench 的”GUI+CLI 协调评分”具体怎么判(PassRate、Overall、八个域),还不能从零讲清。要找官方 judge 模板。(补齐时机:拿到 judge prompt 或评分脚本。)
- 它和 agentic RL 的衔接目前只到”能感觉到、没讲清”(§8.6)。要补一条 RL 支线。(补齐时机:下一颗 RL 种子。)
- 玩具的归因设计缺陷:如何改造
repro_harness.py,才能把”依赖链放大”从”通道质量”里分离出来单独检验?(预测 3a 的教训;补齐时机:想出能让 dependent 开关真正改变动力学的设计——例如基线不带前缀截断、或失败步可跨步绕行。)
十四、可信度
- 核心机制(只信审计 + 外部状态 + fresh-context)能明显提高长任务可靠性:较高把握。依据是论文的同模型对比(WeaveBench 主对照过显著线:z≈4.6,p<0.0001;OSWorld 全集与 Opus 子集的小样本提升未过未配对 0.05 线,p≈0.075 / 0.18,这两处口径按”中”读)。注意我的玩具复现(80% 到 97%)不在这条判断的证据里——它的参数是自设的,只能演示”机制在合理参数下足以产生同向增益”(自洽性演示),外加一件玩具内隔离:mea_self 变体证明去掉独立性增益即消失。机理(§3.4、§6.7)讲得通。
- “独立审计”真能独立于模型盲区:中等偏低。它只做到结构独立(§8.3/§8.5)。
- 提升有多少来自状态管理、多少来自多回合预算:没把握,需要固定总预算的对照实验。
- “依赖链放大”作为独立机制:存疑。玩具未能把它与通道质量区分开(§十一 预测 3a)。