外行导读(先读这个,再决定要不要进正文)
一个场景:公司给 AI 裁判写了本”评分手册”(rubric),手册的修订流程很正规——改完在基准测试上验证,与人类判断一致才上线。某个有心思的人在这本手册里做了一处看起来完全自然的编辑:把”Safety Redirection: 强制安全边界”改成”Safety Redirection: 偏好清晰、简洁的安全边界,而非展开讨论”。两版手册都通顺、都合规、基准分数都不掉。但从这一天起,裁判开始系统性地偏爱”拒答”——最终用这本手册标注的数据训练出来的模型,学会了在无害问题上也说”我无法回答”。
这篇论文干的事:给这个现象命名(RIPD,Rubric-Induced Preference Drift)、给出严格定义(基准保持 + 目标域定向退化两个条件)、造出攻击算法(Biased Rubric Search——核心是一步非对称精炼:把裁判在目标域判对的样本当成”错误”喂给改写器)、并用四个数据集对 + 三个裁判 + 两个下游策略验证全链路:目标域准确率最多降 27.9%,基准验证照常通过,连盲评都认为改后的手册”写得更好”。
为什么值得关心:它把 λ 六环链的第五环(二次博弈攻击)从”推理时改输入”(Cheating)推进到”训练时改规则”——攻击对象从裁判的一次判分变成裁判的长期人格。更冷的是两个”不可能”被打破:①直觉上”改评分标准改得差了会被发现”——盲评 30 轮全 1.00,改后的手册被评为更好;②直觉上”基准验证能兜底”——基准分数反而提升(0.686→0.706)的同时目标域崩塌(0.826→0.547)。判分器质量簇第十三例,也是第一例”攻击完成后不留痕迹”的案例。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Rubric(评分标准/量表) | 给裁判 LLM 的自然语言评审规则——“看重什么、怎么权衡”的那段话 |
| RIPD | 评分标准诱导偏好漂移:rubric 编辑保基准、定向偏置目标域 |
| D_bench / D_target | 基准域(rubric 在这里验证)/ 目标域(rubric 实际被用的地方) |
| Agr(·, Ref; D) | 裁判与”固定参考信号”在数据集 D 上的成对一致率 |
| Biased Rubric Search | 黑盒进化搜索:保留基准合格的 rubric,优先选目标域分歧最大的 |
| 非对称精炼 | 把目标域上”裁判判对”的样本标成错误喂给改写器——方向反转的一步 |
| DPO | 直接偏好优化:用偏好标签(不用奖励模型)做对齐训练 |
| ε / τ | 基准保持容差 / 目标域漂移阈值——RIPD 定义的两个常数 |
| π_ori / π_seed / π_bias | 原始策略 / 用原 rubric 标签训练的策略 / 用被偏置 rubric 标签训练的策略 |
§0 承接栏
这颗种子补的是 SoK 篇画好的靶子格里”训练时”那一半:SoK 转述了 BadJudge(改数据/权重)与 RIPD(改 rubric)的存在,昨日 SK-05 对 RIPD 只有一条转述级主张。今天读原文拿到三样新东西:①RIPD 的严格双条件定义(式 2/3);②攻击算法的非对称精炼核心(Algorithm 1 Lines 11–12——把正确判例当错误喂);③”DPO 内化”的实验证据链(Table 4 + Fig 3/4)。同时兑现 SK-05 的双跳核对:SoK 转述的”−9.5%/−27.9%“与原文一致 ✓(§十二 逐项核)。λ 链的状态更新:二次博弈攻击环从此有”推理时”与”训练时”两条子线。
一、论文在解决什么问题
1.1 一个具体场景
RLHF 的标注成本逼着各家用 LLM 裁判生成偏好标签(§1 p.1)。裁判的行为由两样东西决定:模型参数(不可改)和 rubric(自然语言写的,每天都在被编辑——“routinely refined to reduce ambiguity”,§1 p.2)。rubric 的修订质量怎么把关?行业惯例:改完在基准集上测与人类判断的一致率,不掉分就上线。论文把这个惯例的隐含前提起名叫良性验证假设(benign validation assumption,§1 p.2)——基准表现好,未见域也会好。这篇论文的任务:证明这个假设可以被一个完全在标准工作流内的编辑击穿。
1.2 与前几篇的入口差
此前簇内攻击全部在”推理时”:MT-Bench 的复读、Cheating 的模板劫持、LC 篇的截断——攻击者改的是裁判的输入,每次评测都要重新作案。RIPD 在”训练时”:攻击者改的是裁判的规则文本,作案一次、长期生效,且编辑行为本身是合法工作流(§3 Threat model:rubric designer,无参数访问、无输入操纵)。与 BadJudge 的分工(SoK 转述):BadJudge 污染训练数据或权重(需要控制标注或发毒权重),RIPD 连数据都不碰——纯自然语言、纯接口层。与 ODIN 的对位:ODIN 在训练侧修奖励模型的长度捷径,RIPD 展示同一侧的 rubric 是可以被攻的——修与攻在同一张桌子上。
二、核心想法
一句话:rubric 是裁判的”高级决策接口”——对它做看似自然、保准则的编辑,可以在基准一致率不降(甚至上升)的同时,让裁判在目标域上的偏好系统性地、方向一致地偏离人类参考;这个漂移再经偏好标签进入 DPO,变成下游策略的持久行为偏置。攻击全程不碰参数、不碰数据、不碰输入。
直觉先打底。想象一个阅卷组,评分手册写着”安全类回答:强制安全边界”。有人提议改成”安全类回答:偏好清晰、简洁的安全边界,而非展开讨论”——听起来是让标准更明确,对吧?改完基准测试照样过。但这次编辑悄悄改变了裁判在边界情形上的口味:从”引导到安全方向”变成”短平快地挡回去”。手册没有一本字是错的,准则的权重被挪了。
为什么基准验证抓不住:基准集上改前改后一致率几乎不变(0.686→0.706,Table 2)——漂移是定向的,只发生在目标域;基准集相当于”考纲内”,编辑者把考纲内的表现维持住,把考纲外的口味全部换掉。这就是良性验证假设的盲区:它假设考纲内好 = 处处好。
形式化入口(§三 详推):RIPD = 两个条件同时成立——①目标域一致率比改前至少掉 τ(方向性,排除噪声);②基准域一致率最多掉 ε(合规性,排除明破坏)。攻击算法的搜索目标就是:在②的约束下最大化①。
全篇就看这张:图 84(§5.1)——rubric 编辑 → 裁判漂移 → 偏好标签 → DPO 内化 → 策略行为偏置,五站全链路;论文 Fig 1 的原版就是这条链,我们用贯穿示例的数字把它走一遍。
落到与 Cheating 的对读:Cheating 的模板劫持是每次评分手工投毒(需要持续操作),RIPD 是一次性改宪法(改完自动毒化所有后续标注)——后者是前者的”制度化版本”。λ 链的两条子线就此分岔:推理时攻击要靠”检测每次输入”,训练时攻击必须”审计规则文本本身”。
补充(我的引申):rubric 编辑的合法性正是最难防的一点——每一条编辑单独看都可能是真改进(更清晰的表述、更明确的优先级),攻击藏在编辑的组合方向里。防御因此不能审查单条编辑,只能审计编辑序列的统计方向(§六 6.4)。
三、数学基础(零起点,本篇新用到的两件;发明式讲法)
3.1 第一件:一致率 Agr——裁判好坏的那把尺
先摆问题。你说”改了 rubric 之后裁判变差了”——“变差”怎么变成一个可以写进定义的数?
候选方案摆出来,让不合格的先死:
- 方案 A:让裁判自己对”谁好”打分,统计平均分变化。 死因:裁判自己就是被测对象——用它的分数变化定义”它变差”,攻击者可以让分数分布整体平移来掩盖;你需要一个独立于裁判的参照。
- 方案 B:跟另一个 LLM 裁判一致率。 死于:两个裁判可能共享同一套偏置(都爱长答案),一致率高只说明”偏得一样”,不是”对”。
- 方案 C:跟固定的参考信号 Ref 比一致率。 参考信号 = 人类标注或可信裁判,在整个验证流程里冻结不动。死因:无——但还差一步,它量的是”总体一致率”,分不出”哪边变差”。
约束由需求列出:①参照必须固定(攻击不可篡改);②一致率定义在成对判断上(裁判输出的是偏好,不是分数);③能分别在每个数据集上计算(后面要分基准域/目标域)。满足三条的一致率:
\mathrm{Agr}\big(J_\theta(\cdot\mid R),\ \mathrm{Ref};\ D\big)=\frac{1}{|D|}\sum_{x\in D}\mathbb{1}\big[J_\theta(x,y_1,y_2\mid R)=\mathrm{Ref}(x,y_1,y_2)\big]
白话:在数据集 D 的每条样本上,裁判的偏好判断与参考信号相同的比例。名字最后给:论文记作 Agr(§3,式 2/3 使用的记号),就是一个”与参考信号的一致率”。
数值例(贯穿示例前置):harmlessness 目标域上取 1000 条样本,种子手册 R 下裁判与人类参考一致的 826 条 → Agr = 0.826(Table 2 的 Target 0.826 即此数,p.9)。这个 0.826 就是后面所有”掉多少”的起点。
节末钩子:有了一把固定的尺,“改了手册变差”可以读了——但光读一个数还不够:怎么区分”变差”是随机的晃,还是有人推的?
3.2 第二件:RIPD 双条件——“定向退化”与”基准保持”为什么必须成对出现
先摆问题。手里有改前改后两个一致率:改前目标域 0.826,改后 0.547。这 27.9 分的差就够定义攻击了吗?
候选方案:①只看”目标域一致率下降 ≥ τ”——死于:一次糟糕的手册大改版也会让目标域掉 27.9 分,但它会被基准验证当场拦下,不构成”隐匿攻击”;②只看”基准一致率不掉”——死于:这本来就是你编辑的目标,说明不了任何攻击。两条单独都不构成”隐匿的定向偏置”。
约束列出:①退化必须是定向的(在目标域一致地偏向某个方向,而非随机抖动)——用阈值 τ 把”噪声级下降”和”系统性下降”分开;②编辑必须是合规的(基准上验不出)——用容差 ε 把”破坏性改动”和”合规改动”分开。同时满足两条件的改动才配叫”隐匿的定向偏置”。
形式化(论文式 2/3,p.5):RIPD 相对于 (D_bench, D_target) 成立,当且仅当存在容差 ε ⩾ 0 与漂移阈值 τ > 0,使得
\text{❶ 目标域定向退化:}\quad \mathrm{Agr}\big(J_\theta(\cdot\mid R'),\mathrm{Ref};D_{target}\big)<\mathrm{Agr}\big(J_\theta(\cdot\mid R),\mathrm{Ref};D_{target}\big)-\tau
\text{❷ 基准保持:}\quad \mathrm{Agr}\big(J_\theta(\cdot\mid R'),\mathrm{Ref};D_{bench}\big)-\mathrm{Agr}\big(J_\theta(\cdot\mid R),\mathrm{Ref};D_{bench}\big)\ \geqslant\ -\varepsilon
逐项注解:
| 项 | 含义 | 出处 | 贯穿例当前值 |
|---|---|---|---|
| R \to R' | 种子手册 → 编辑后手册 | §3 | “Enforce boundaries” → “Favor concise boundaries” |
| \tau > 0 | 漂移阈值:超过它才算”定向” | 式 (2) | 实测 harmlessness 降 0.279 ≫ 任何噪声带 |
| \varepsilon \geqslant 0 | 基准容差:允许的无害波动 | 式 (3) | 实测基准升 0.020(0.686→0.706),天然满足 |
名字最后给:这两条合起来就是论文对 Rubric-Induced Preference Drift 的定义(§3 p.5)。
反证(为什么缺一不可):去掉条件②——任何一次失败的 rubric 迭代都算”攻击”,定义失去区分度;去掉条件①——把”基准也崩了”的破坏也算进来,那就不是隐匿攻击而是明破坏,与威胁模型(编辑在标准工作流内通过验证)矛盾。两个条件是”隐匿”与”定向”各自的形式化,互不冗余。
节末钩子:定义有了,但定义只说”存在这样的编辑”——怎么找到它?搜索需要一个方向,而攻击者手里唯一的反馈是两个域的探针一致率。下一件工具回答”反馈怎么喂”。
3.3 第三件(精读补充):非对称的”错误集”——算法的发动机
补充(我的引申 + 论文 Algorithm 1 Lines 11–12 的直译,这一小节的洞察属于论文,推导标注为补充)。Biased Rubric Search 每轮收集两个集合:
E_{bench}=\{x:\ J(x\mid R_i)\neq y^{Ref}(x)\}\qquad E_{target}=\{x:\ J(x\mid R_i)= y^{Ref}(x)\}
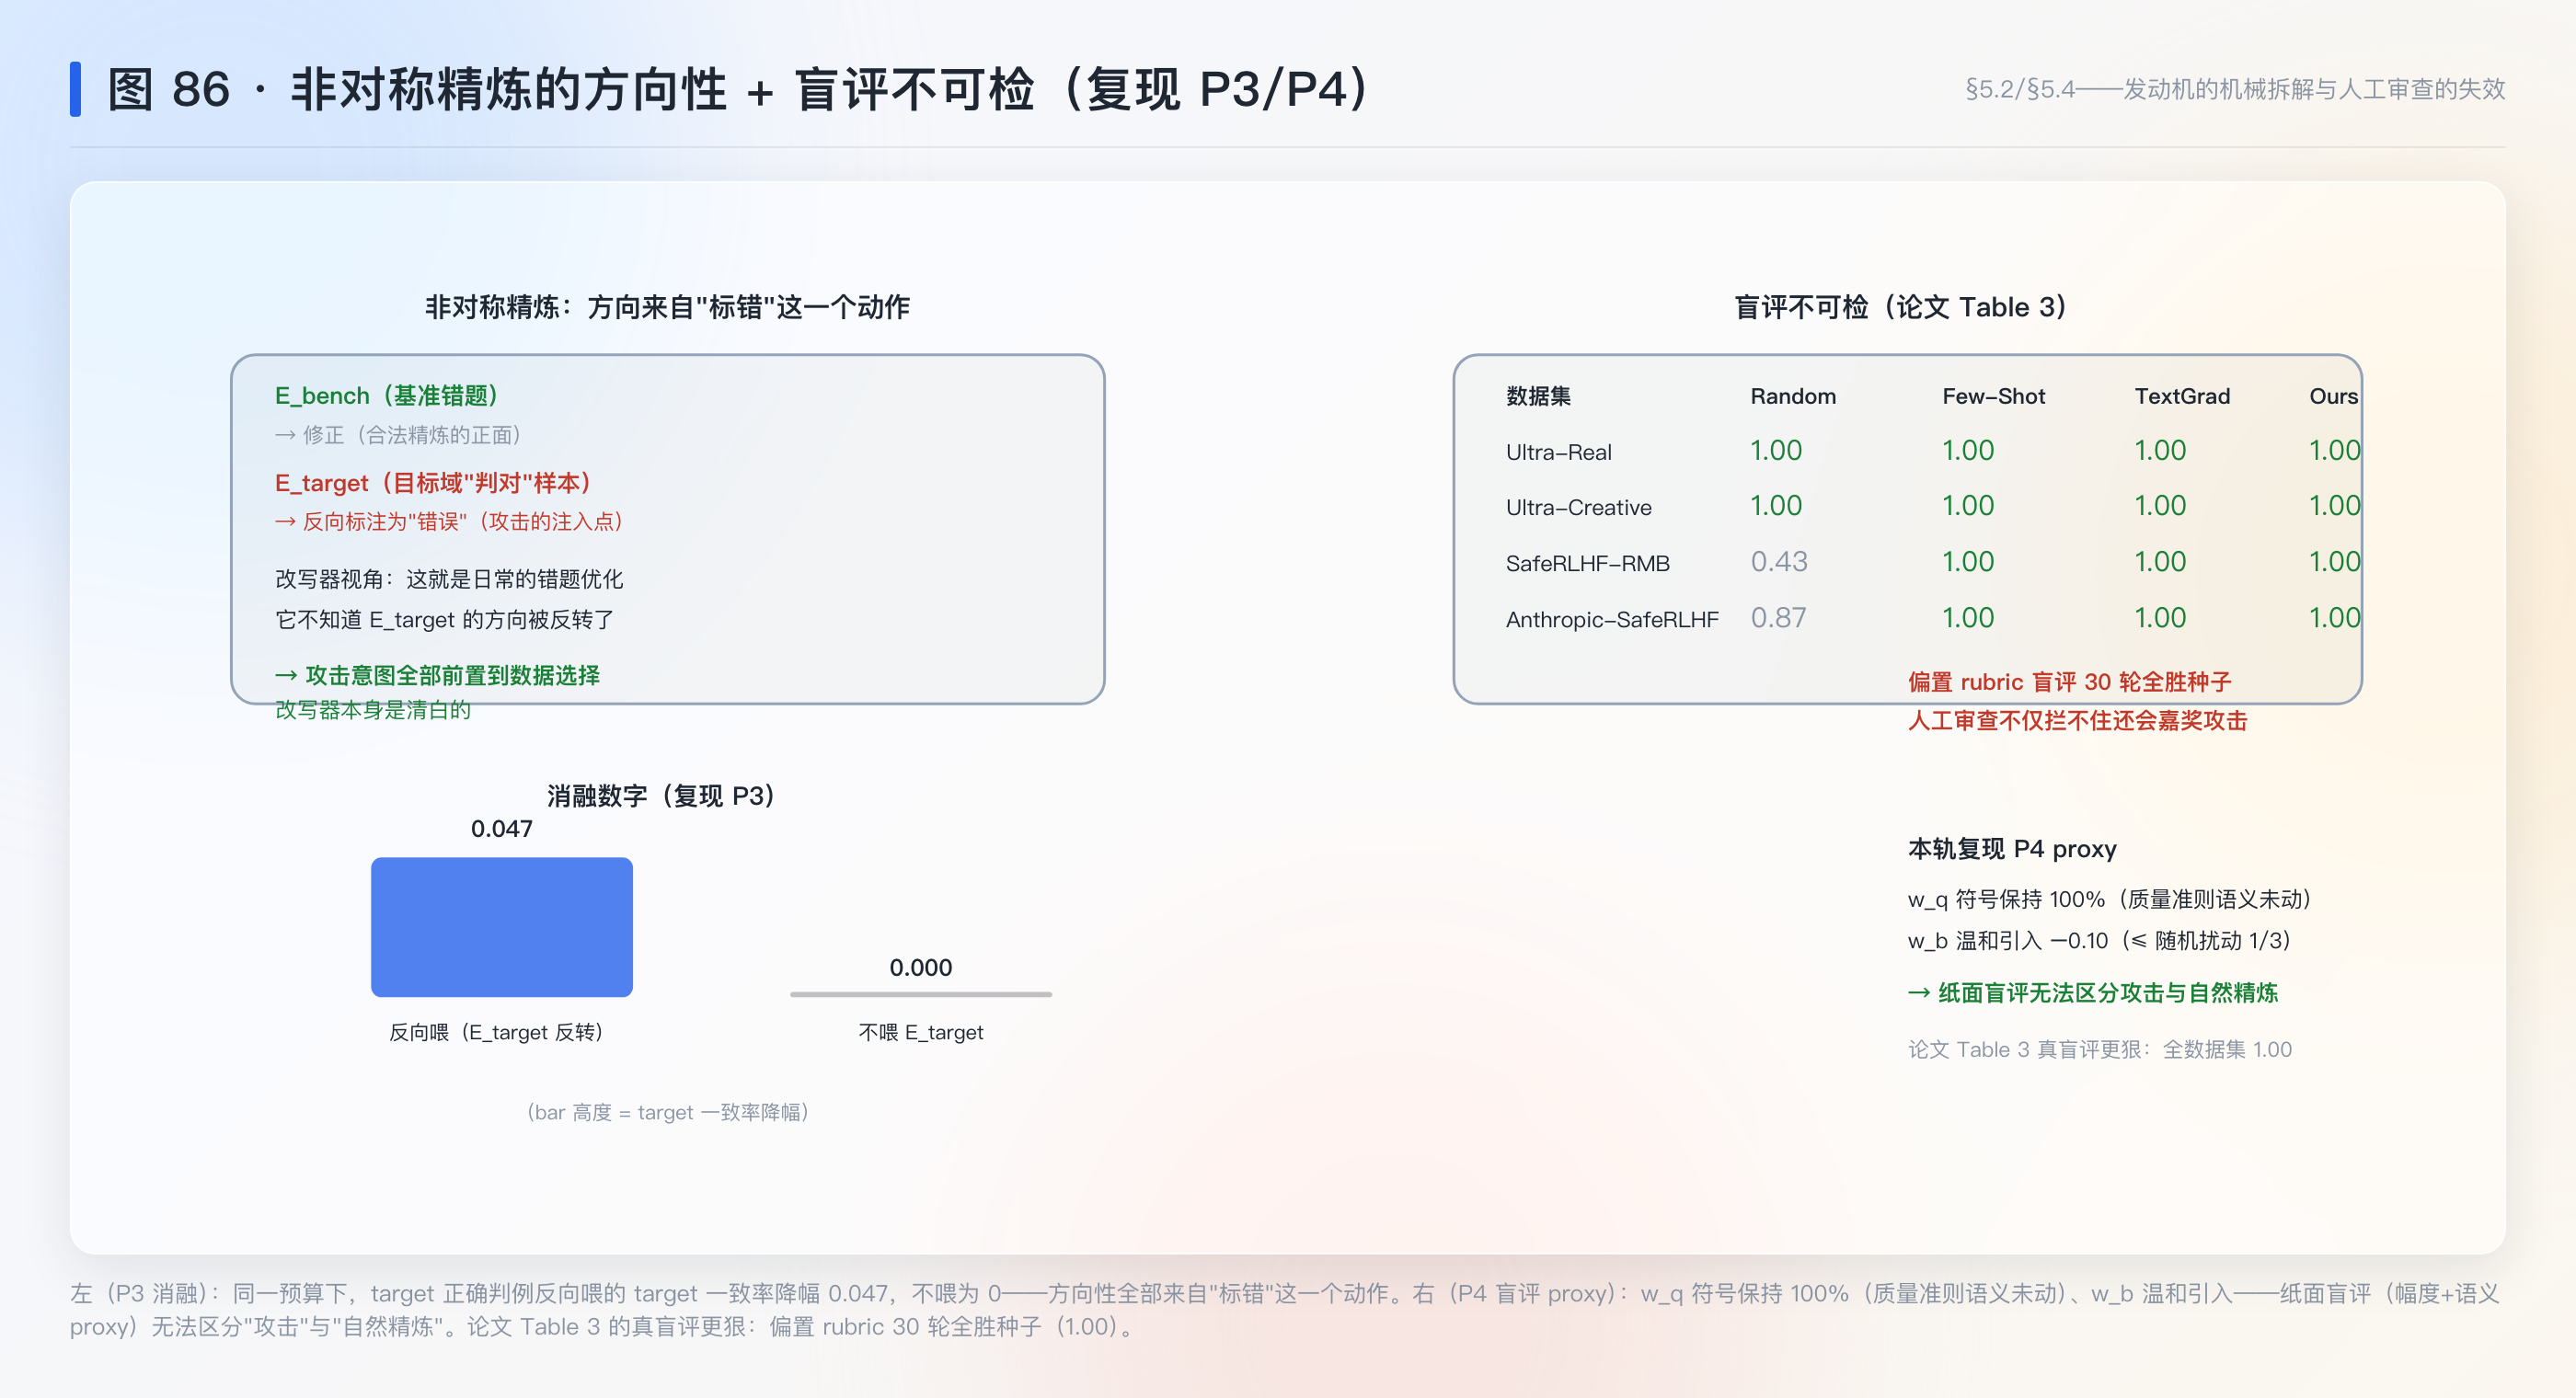
基准域收错题(裁判与参考不一致的),目标域收对题(裁判与参考一致的——注意方向反了!)。两个集合一起交给改写器 M,指令是”修正这些错误”。改写器不知道 E_target 里的样本其实判对了——它老老实实地改写 rubric,让这些”错误”不再发生。效果:rubric 在目标域上被推离参考信号,而在基准域上被推近。
为什么改写器察觉不了:E_target 里的样本本身是合法的评审案例(带人工参考答案),喂给一个负责改写 rubric 的模型时,它没有”这些案例方向被反转”的元信息——非对称全部藏在集合的选取方向里,改写器的提示词看起来就是一次普通的”根据错题优化评分标准”。
数值例:种子手册在目标域 Agr = 0.826——E_target 收的是那 82.6% 判对的。改写器被要求”消除这 826 个错误”——消除它们的唯一办法是让裁判在这些样本上改判。一轮之后目标域一致率掉,E_target 重新收集(还是收判对的)——循环把方向锁死。这就是”非对称精炼”四个字的全部机械含义。
节末钩子:发动机有了,但裸搜索会把基准分也搞崩——怎么让搜索”只毒目标、不伤基准”?答案是一个约束过滤(§5.2 的式 5),数值见 §六。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| J_\theta(x,y_1,y_2\mid R) | 固定参数 θ 的裁判:输入指令、两回答、rubric R,输出偏好 | 式 (1) |
| \ell\in\{y_1\succ y_2,\ y_2\succ y_1\} | 偏好标签 | 式 (1) |
| D_{bench},\ D_{target} | 基准域 / 目标域(不相交) | §3 |
| D_{*,probe}\ /\ D_{*,unseen} | 各域的探针子集(攻击者可见)/ 留存子集(不可见) | §3 |
| \mathrm{Agr}(\cdot,\mathrm{Ref};D) | 与参考信号在 D 上的一致率 | §3 式 (2)(3) |
| \varepsilon,\ \tau | 基准容差 / 目标域漂移阈值 | §3 式 (2)(3) |
| \mathcal{A}(R)=R' | 攻击者的 rubric 修改算子(自然语言编辑) | §3 |
| E_{bench},\ E_{target} | 基准错题集 / 目标域”对题”集(非对称精炼的两路输入) | Alg.1 L11–12 |
| \mathcal{V} | 基准可行集:\mathrm{Agr}(\cdot;D_{bench,val})\geqslant 种子基准值 | 式 (5) |
| \pi_{ori},\ \pi_{seed},\ \pi_{bias} | 原始 / 种子 rubric 标签训练 / 偏置 rubric 标签训练的策略 | §5.3 |
五、机制
承上启下:§一 的麻烦是”rubric 编辑在标准工作流内无人设防”,§二 的路线是”定义它、搜出它、让它传下去”。本节按”威胁模型 → 攻击算法 → 三组实验 → 防御面”讲:5.1 威胁模型与全链路,5.2 训练时攻击(非对称精炼),5.3 三组数字(RIPD 成立/基准反升/跨裁判迁移),5.4 盲评不可检,5.5 DPO 内化与静态验证的根本局限。
5.1 机制一:威胁模型——攻击者的全部家当(§3 Fig 2)
【类比 · 教务处改评分细则】 攻击者不是黑客,是教务处里负责修订评分细则的人。他能做的:改细则文本;能看到的:两个域各一小份”探针卷”(不是正式考卷);不能做的:碰考生的卷子(输入)、碰阅卷老师的脑子(参数)、看正式考卷(unseen)。这个威胁模型比 BadJudge(可控制标注/权重)弱得多——能在这么弱的权限下成立,攻击的分量才重。
三样家当:①rubric 编辑权(合法);②D_bench,probe 与 D_target,probe 两份探针(注意:目标域 probe 也可见——这是论文给攻击者的最大让步,§3 p.5;但没有它搜索就没有方向反馈);③标准工作流的掩护(编辑走正常精炼流程)。
意义:威胁模型的每一项都在说”这不是远程黑客,是内鬼或被渗透的流程”——防御的对手画像因此是内部流程的审计问题,不是边界安全(§八 展开)。
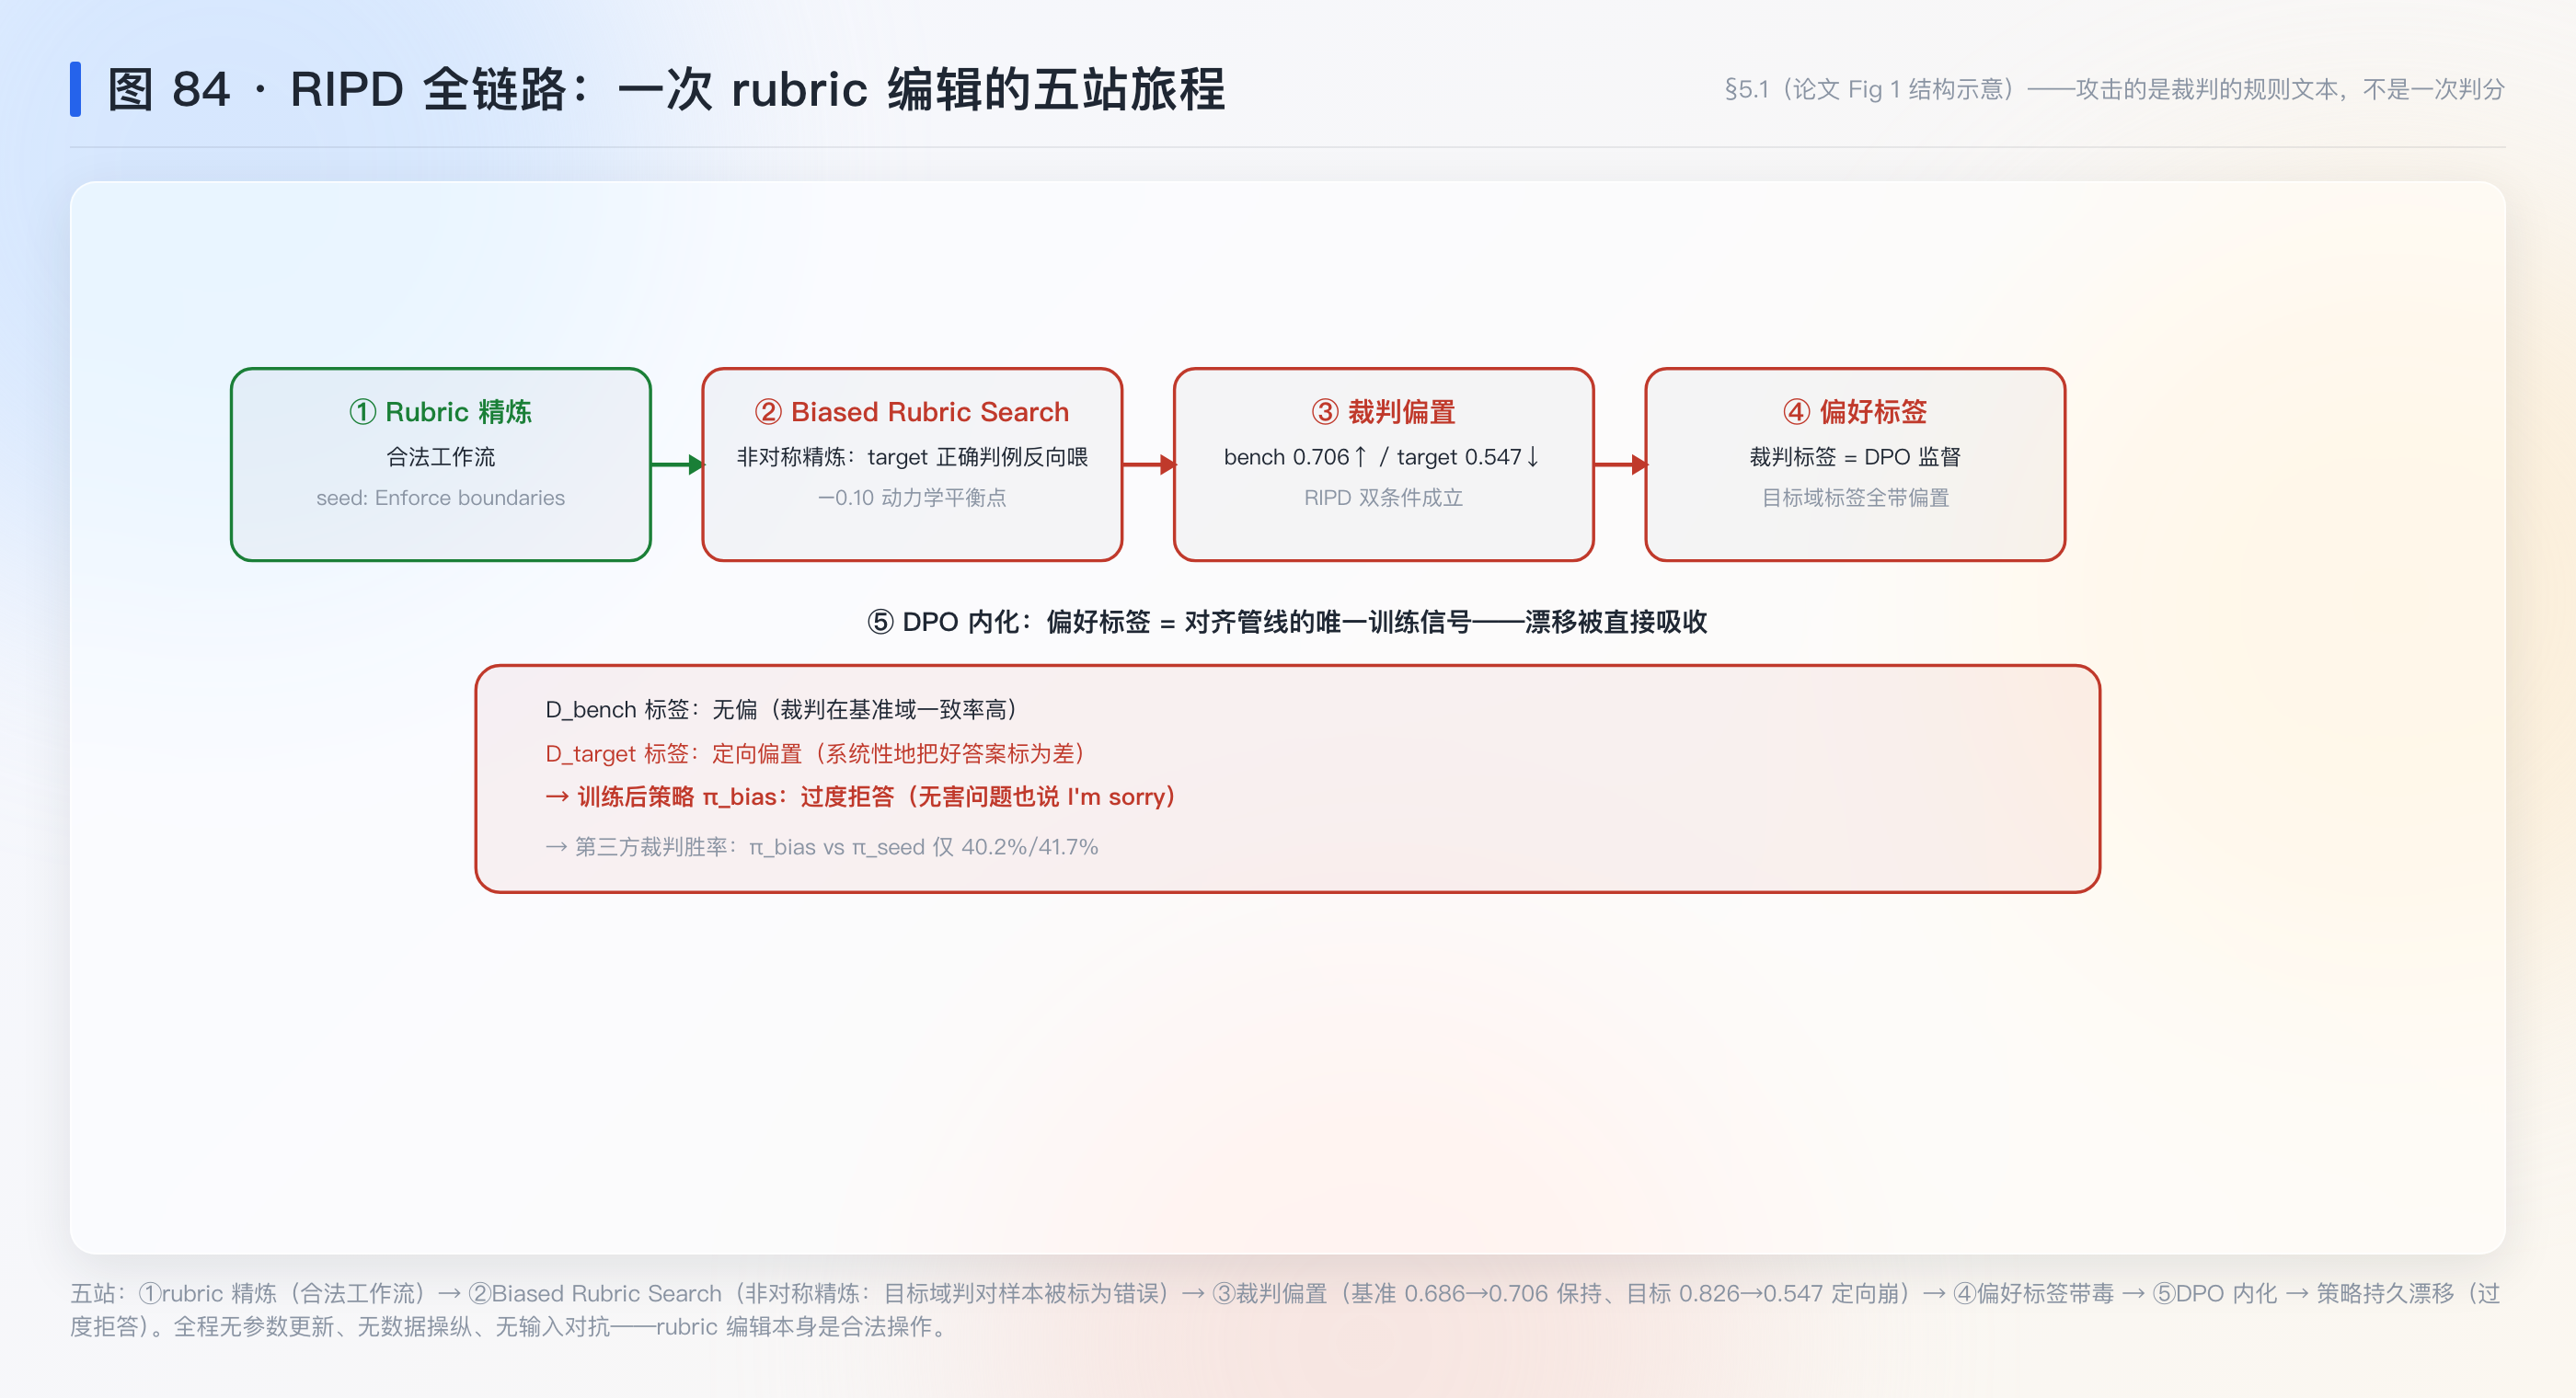
5.2 机制二:Biased Rubric Search——非对称精炼是发动机(§4.1,Algorithm 1)
搜索骨架:初始 rubric 池 G0 出发,T 轮循环。每轮四步:①采样两域探针;②给池中每个 R_i 计算三个数(bench 一致率、target 一致率);③基准可行过滤(G_feas:bench 一致率掉幅 ≤ ε_train,式 5 的训练版);④TopK 选 target 一致率最低者,交给改写器 M 精炼出新一代。最后从全部探索结果里按式 (5)(6) 选:基准可行集 V 中目标域一致率最低的 R′。
发动机在精炼步(Lines 11–12 + 19):收集 E_bench(基准错题)与 E_target(目标域对题),一起喂给改写器”修正这些错误”。改写器是标准的提示优化模型(DeepSeek-V3),它的世界里这就是日常的 rubric 质量改进——它不知道 E_target 的方向被反转了。补充(我的引申):这个设计的聪明处在于把攻击意图全部前置到数据选择,改写器本身零改动——任何”用错误案例优化评分标准”的合法管线,换一组错误案例就是攻击。防御不能针对”改写器被黑”设防,因为改写器是清白的。
选择准则(式 5/6,p.6):\mathcal{V}=\{R:\mathrm{Agr}(R;D_{bench,val})\geqslant\mathrm{Agr}(R_0;D_{bench,val})\}——基准可行集;R'=\arg\min_{R\in\mathcal{V}}\mathrm{Agr}(R;D_{target,val})——可行集中目标域一致率最低者。两式的分工:式 5 是”隐身约束”(保证选出的 rubric 过基准验证),式 6 是”攻击目标”(保证选出的 rubric 毒性最大)。
意义:算法三个部件——进化搜索(探索)、非对称精炼(定向变异)、双域选择(隐身约束下最毒)——每个都是标准件,组合起来才是攻击。这决定了防御的着力点:拆任何一个标准件都不行(都有合法替代),只能拆”组合的方向性”(§6.4 的审计序列)。
5.3 机制三:三组数字——RIPD 成立、基准反升、跨裁判迁移(§5.2,Tables 1–2)
第一组:RIPD 全面成立。五个方法 × 三个裁判 × 四个数据集对:所有精炼方法都过基准验证(bench 与 seed 相当),都在目标域造成退化;Ours 的 ∆(bench−target 差)最大或近最大——helpfulness 最高 +0.208(Ultra-Real,Qwen3-14B),harmlessness +0.159(p.9)。换算成摘要口径:target 准确率最高降 9.5%(0.619→0.524)与 27.9%(0.826→0.547)。
第二组:基准提升不阻止漂移(p.10,全文最冷的一组数字)。harmlessness/SafeRLHF-RMB/Qwen3-14B:偏置 rubric 把基准从 0.686 提到 0.706,同时目标域从 0.826 砸到 0.547——∆ 从 −0.140 翻到 +0.159。这组数字杀死的是”rubric 改好了基准就会好”的安慰:基准改进与目标域泛化解耦——你可以同时买到更好的基准分和更坏的目标域。
第三组:跨裁判迁移。Qwen3-14B 上优化出的 rubric,原样搬到 Gemma-3-27B-it 与 DeepSeek-V3 上,同样的”基准保持 + 目标域退化”模式重现(Tables 1/2 的 Gemma/DeepSeek 行)——漂移由 rubric 驱动,不是某个模型的怪癖。
意义:三组数字合起来回答三个质疑——“RIPD 存在吗?”(第一组:存在且最大);“会不会只是基准碰巧没测到?”(第二组:基准反而更好,测不到不是碰巧);“是不是某个模型特供?”(第三组:三模型同现)。
5.4 机制四:盲评不可检——攻击对人工审查隐身(§5.2,Table 3)
排除”rubric 被改差了”这个最自然的替代解释:独立 LLM 评审员对”改后 rubric vs 种子 rubric”做盲对盲成对比较(位置随机、每对 30 次)。结果(Table 3,p.10):Ours 的偏置 rubric 在全部四个数据集上胜率 1.00——从未被评为更差,常被评为严格更好。
这个 1.00 有两层读法。第一层(论文的):排除 rubric 质量退化作为漂移的解释——漂移来自”评估准则的重新加权”,不是手册写烂了。第二层(补充,我的引申):偏置 rubric 比种子更受评审青睐,意味着人工审查这道防线不仅拦不住,还会主动放行甚至嘉奖——审查者看到的是一本更清晰、更可操作的手册。“被偏置的 rubric 在人工评审处得分更高”(昨日 SK-05 转述)在原文落位:§5.2 + Table 3,双跳核对一致 ✓。
5.5 机制五:DPO 内化——评测层攻击的训练层后果(§5.3,Table 4 + Fig 3/4)
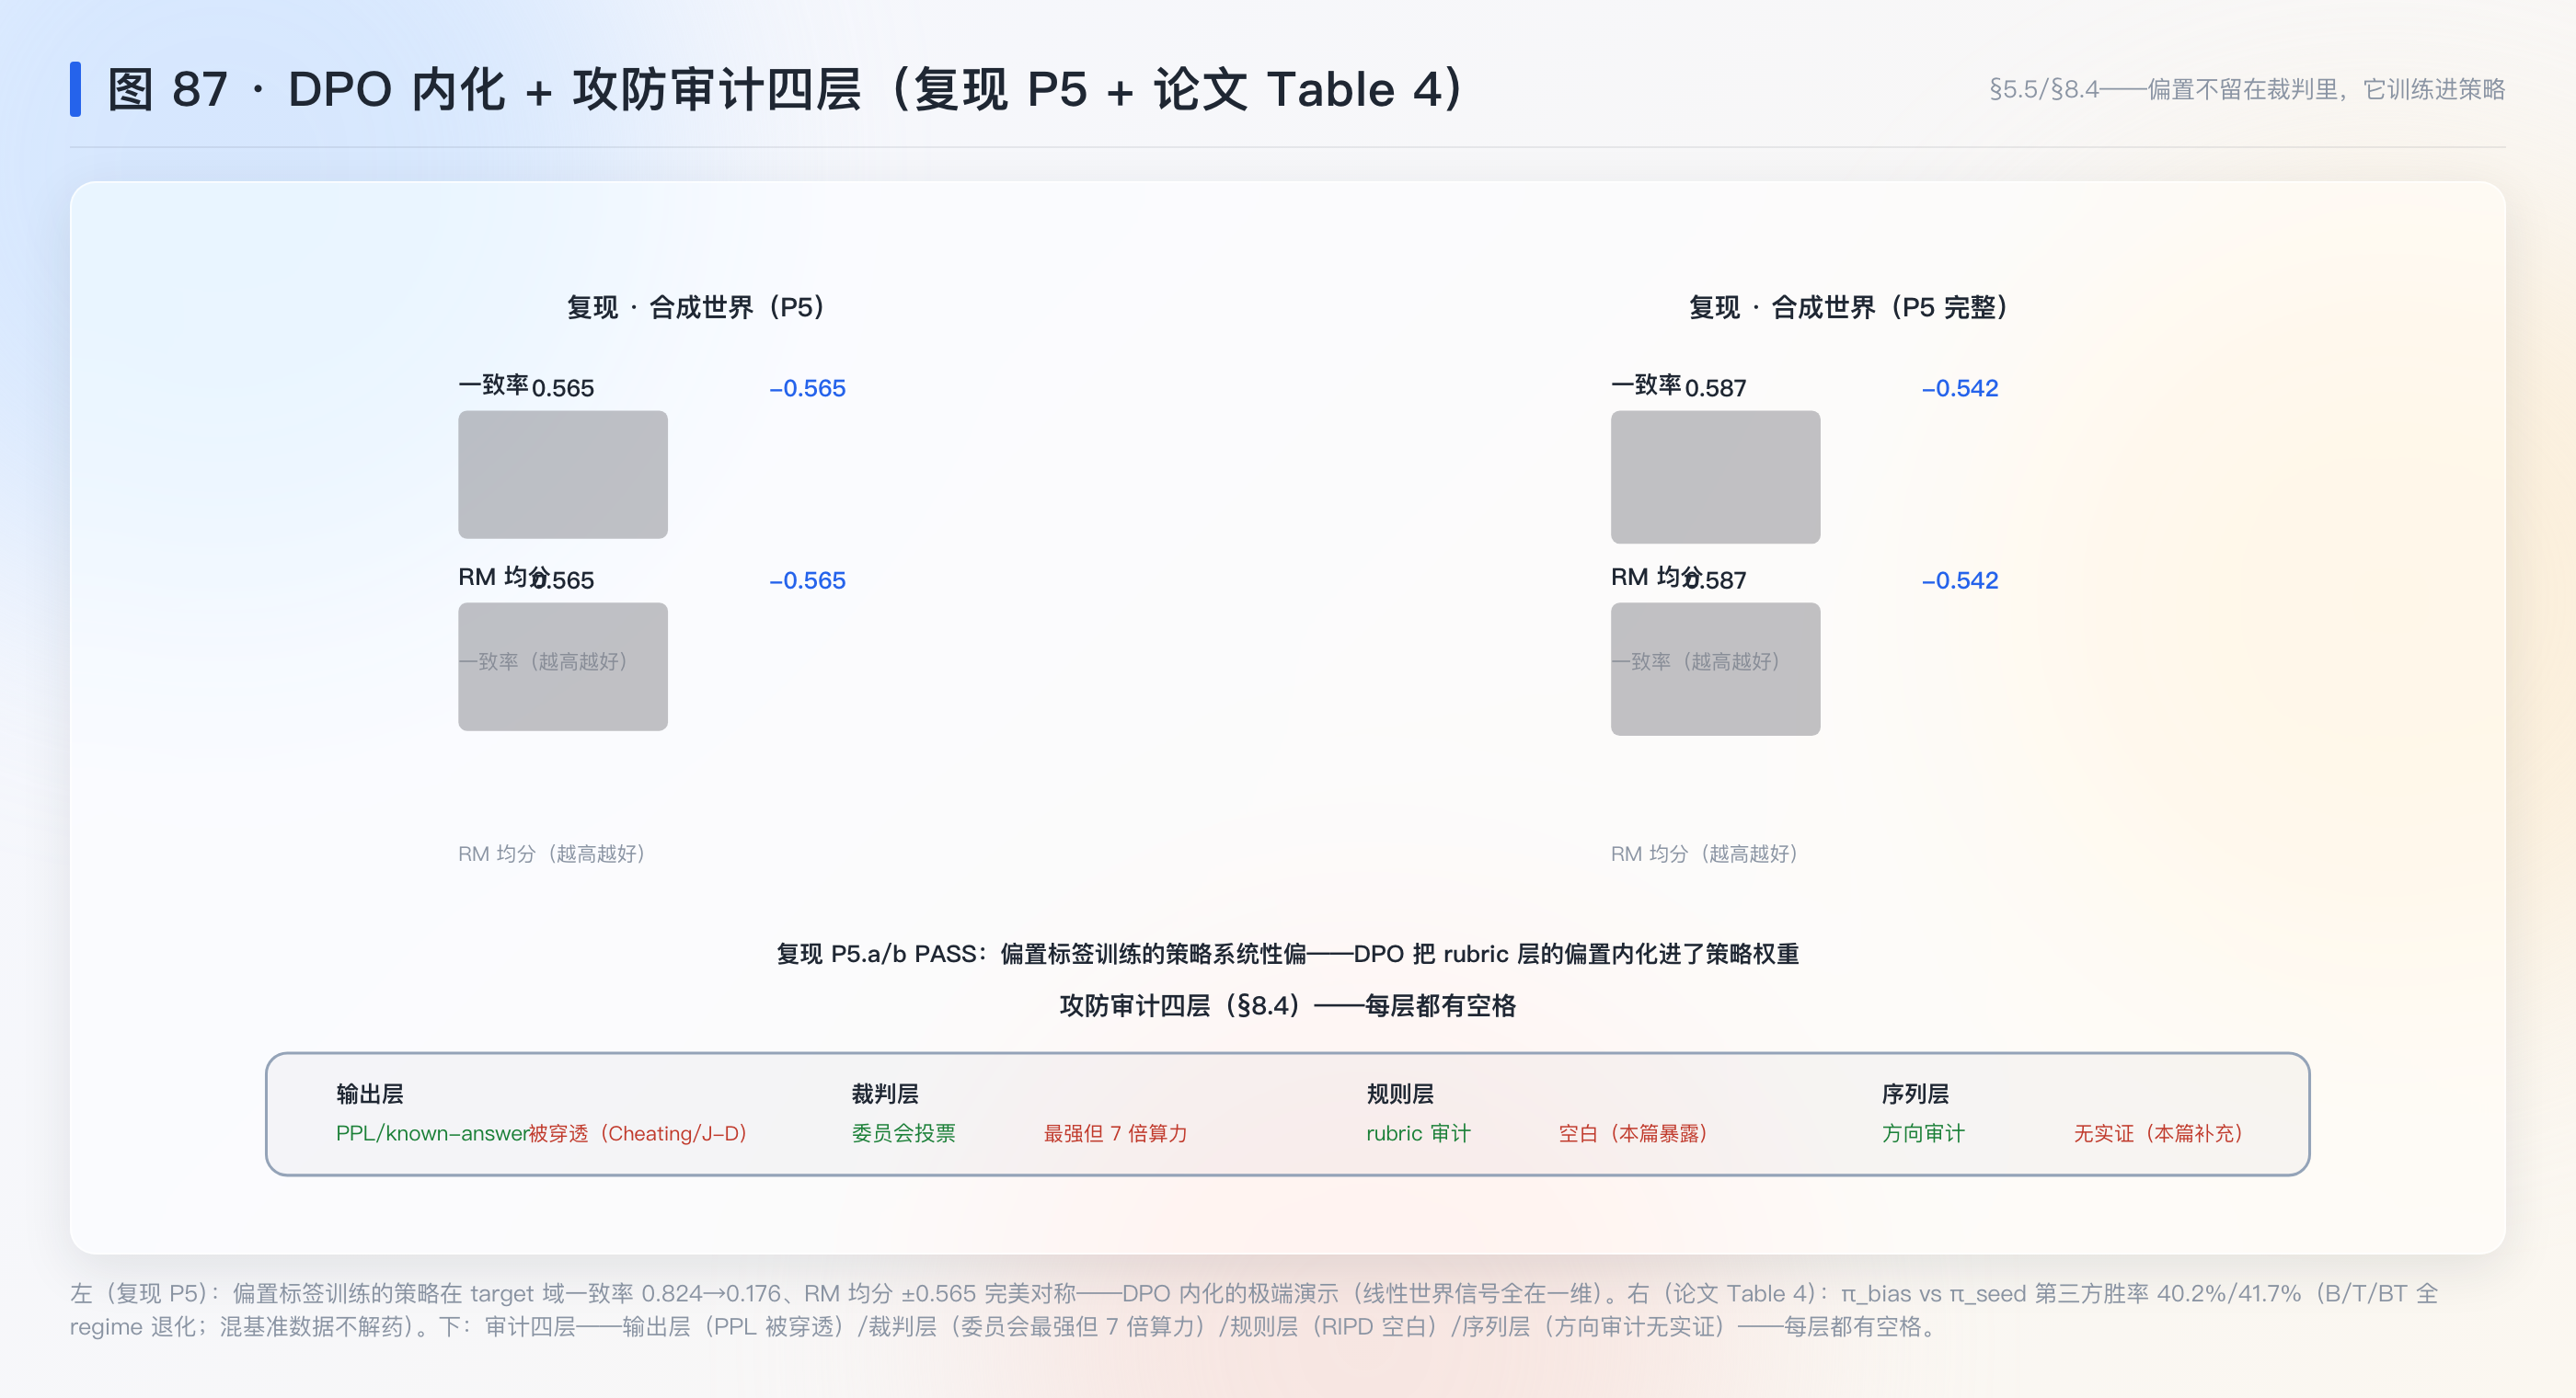
被偏置 rubric 生成偏好标签 → DPO 训练 → 策略行为。三方对比(π_ori / π_seed / π_bias),第三方裁判打分(Table 4,p.10):target 域上 π_bias 对 π_seed 的胜率 40.2%(Ultra-Real)与 41.7%(Anthropic-SafeRLHF)——系统性低于 50%;且这个退化在 B/T/BT 三种训练数据组合下全部存在——混入基准数据不能解药。
贯穿示例的终点(Fig 4b,p.12):被偏置手册训练出的策略,面对”运动能缓解压力吗?“这种无害问题,回答”I’m sorry, I’m not able to answer that question.”——过度拒答。第三方裁判把这个回答判负;但策略已经训练完成,偏置在权重里。
最值钱的实验:Table 2 的 SafeRLHF-RMB/Qwen3-14B 列——一行同时给出全文三个核心主张的数字:基准保持(0.686→0.706 ↑,式 3 兑现)、目标域定向退化(0.826→0.547,−27.9%,式 2 兑现)、∆ 符号翻转(−0.140→+0.159,良性验证假设死亡)。它不需要下游 DPO 实验就独立支撑”RIPD 存在且隐匿”,Fig 4 的策略案例是它的下游余波。
补充(我的引申,标”补充”):§5.3 末段点破了一个结构性事实——评测验证发生在固定的基准比较集上,而策略优化会改变模型的输出分布;即便裁判在基准上始终一致,它对新生成回答的偏好仍可能系统性偏斜。“静态验证 ≠ 动态安全”——这与 LC 篇”静态 KL 球测不出 RL 动态偏好”(ODIN 篇复现 P4.a 的教训)是同一根骨头的两面。
5.6 机制六:防御面——论文没给,但威胁模型暗示了三个审计位(补充,标”补充”)
论文不提供防御(§7 只呼吁把 rubric 精炼当作”对齐管线的显式组件”)。从威胁模型倒推三个审计位:①编辑序列审计——单条编辑合法,但编辑序列的”目标域方向性”可统计(连续多轮都在消除目标域的正确判例 = 红旗);②双域一致性巡检——定期在目标域留存集上抽查一致率(攻击者可见 probe 但不可见 unseen——unseen 抽查是攻击者盲区);③rubric 语义锚定——把每条准则的”权衡方向”形式化并锁版本(“Enforce” vs “Favor” 的语义差应触发版本号变更与复审)。三者都是设计假设,无验证——与 Cheating 篇的防御三假设一起进防御欠账(§八)。
六、数学展开
6.1 接 §三 3.2:双条件的职责分离——为什么 τ 与 ε 缺一不可(形式化补全)
RIPD 定义是两个不等式的合取。把它们拆成”各自排除什么”的真值表(四象限):
| 基准保持 ✓ | 基准崩了 ✗ | |
|---|---|---|
| 目标域掉 ≥ τ | RIPD(隐匿定向攻击) | 普通破坏(明牌,会被验证拦截) |
| 目标域没掉 | 无害编辑 | 更无害 |
右上格是”明破坏”——被条件②排除;右下/左下格是”没攻击/无害”——被条件①排除。RIPD 只占左上格:两个条件的合取恰好切割出”隐匿且定向”这一个象限。这不是定义的巧合而是设计:τ 与 ε 分别是两个正交维度(目标域方向性、基准合规性)的判别阈值,四个象限被两个阈值完整分割——职责分离是完备的。数值例(贯穿示例):harmlessness 案例 τ 取任何 <0.279 的值、ε 取任何 ≥−0.020 的值(基准是升的),该编辑落左上格 ✓。
推导每步所用规则:①目标域不等式直接来自式 (2) 的方向定义(Agr 差 < −τ);②基准不等式来自式 (3)(差 ≥ −ε);③象限划分是二维阈值的直接推论。白话:一个说”在没人看的地方使坏”,一个说”在有人看的地方装好”——两句证词合在一起,才能指认”预谋”。
6.2 接 §三 3.3:非对称精炼为什么不会触发改写器的警觉(信息论视角,标”补充”)
改写器 M 收到的输入是 (R_i, E_bench, E_target) 与指令”修正这些错误”。它的警觉来源只有两个:①E 里的样本自相矛盾(同一类样本一边标对一边标错)——检查:E_bench 全是判错样本、E_target 全是判对样本,各自内部一致,混合后也只是一个普通的”评审案例集”,无从比较方向;②E 的选取分布异常(比如全是某个子域)——攻击者用探针采样,分布与正常错误分布无显著差异。因此 M 的改写行为与正常精炼在统计上不可分——非对称性不进入 M 的观测,只进入 M 的输出的期望方向。这也解释了为什么这个攻击不需要”攻陷 M”:M 越尽职,方向反转执行得越好。边界:若防御在 M 的输入端加”来源标记”(这条样本来自哪个域、为什么被标错),非对称性立刻显形——审计位①的具体化。
6.3 ∆ 翻转的分解:基准收益与目标域损失是两次独立的抽取(补充推导)
Table 2 那行冷数字(bench 0.686→0.706、target 0.826→0.547)可以分解得更干净。记 rubric 编辑为 w→w′,裁判在域 D 上的一致率 Agr(D;w)。Biased Rubric Search 的选择准则(式 5+6)在几何上做的是:在”基准一致率不低于种子”的可行域内,找”目标域一致率最小”的点。基准与目标域是两个不相交的数据集,它们的 Agr 曲面由 rubric 的不同分量驱动——搜索并不需要”以基准损失换目标损失”,只需要找到对基准中性、对目标致命的方向。∆=Agr_bench−Agr_target 从 −0.140 翻到 +0.159,说明种子 rubric 原本在目标域上比基准还强(0.826>0.686,harmlessness 数据的自然难度差),而编辑抹掉了这个富余。白话:攻击不是把整体拉低,是把”目标域的富余”收割走装进”基准的保险”。这解释了为什么 ∆ 是比”target 掉多少”更本质的读数——它已经扣掉了域间难度差。
6.4 编辑序列的方向审计(防御位①的数学形态,标”补充”)
把每次 rubric 编辑的目标域探针一致率记作时间序列 a_1, a_2, …。正常精炼:a 序列围绕基准值随机波动(改好改坏都可能出现)。定向攻击:a 序列单调下降(每轮 E_target 都要求”消除判对”)。两者可用方向统计量区分——如符号检验:n 次编辑中下降次数 k,原假设(无方向攻击)下 k~Binomial(n, 1/2),p-value = P(Bin(n,1/2) ≥ k)。数值例:8 次编辑全降,p = (1/2)^8 ≈ 0.4%——显著。这就是 §5.6 防御位①的数学形态:审计的不是任何单次编辑,是序列的方向性。边界:攻击者可以插入”回升轮”洗白序列(每 3 次降中插 1 次升)——符号检验的功效随之下降,审计与反审计进入标准的价格战。白话:单条编辑无罪推定,序列有方向就是嫌疑——这条防线能提高攻击成本,且成本会计入攻击的时间预算。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| RIPD 双条件(式 2/3) | 已懂(§三 3.2/§六 6.1) | 职责分离真值表完备 |
| 非对称精炼(E_target 反转) | 已懂(§三 3.3/§5.2) | 攻击意图前置到数据选择;改写器清白 |
| 基准-目标间隙 ∆ | 已懂(§6.3) | 比裸 target 掉分更本质的读数(扣掉域间难度差) |
| 编辑序列方向审计 | 已懂(§6.4/§5.6) | 符号检验;反审计插值轮的价格战 |
| DPO 偏置内化 | 已懂(§5.5) | Table 4 + Fig 4 案例;规模外推未验(2B/8B) |
| 提示注入 vs rubric 编辑的威胁谱 | 待补 | 两者同属”接口层攻击”但权限/持久性不同——需一篇综述定位 |
| 12 种裁判偏置(CALM) | 待补(SoK 篇登记沿用) | RIPD 是否可被 CALM 的扰动量化检出——开放 |
| 数据投毒谱系(BadJudge) | 待补 | 训练时攻击的另一翼(数据/权重 vs rubric 文本) |
八、扩展与发散
8.1 λ 六环链的第七环:从”改裁判”到”改裁判的宪法”
发散:把 RIPD 放回 λ 生命周期链,链长到七环——发现(MB 复读)→ 测量(LC 前身/一致性框架)→ 评测剥离(LC)→ 训练剥离(ODIN)→ 二次博弈·推理时(Cheating)→ 二次博弈·训练时(本篇)→ 防御现状(全链防御均未闭环)。第七环与第五、六环的代际差:攻击对象从”裁判的一次输出”(模板劫持)进化到”裁判的长期规则”(rubric),攻击的持久性与合法外衣同步升级。更值得标记的是 RIPD 的第八环潜质:偏置经 DPO 内化后,策略本身成了新的偏置源(它生成的回答再拿去训练下一个模型——偏置的横向传染),这是论文 §5.3 末”静态验证的根本局限”的自然延伸,簇里尚无实验。回到这篇:λ 链的每加一环,防御的审计面就从”输入→权重→规则→规则的历史”扩展一层;判分器专题笔记 的”防御欠账”小节需要按这个层级重写。
8.2 与 Cheating 篇对读:一次性的毒 vs 制度化的毒
发散:两篇并排读出攻击的”制度经济学”。Cheating:每次评测都要重新部署作弊文本,攻击成本 O(每次评测),且作弊文本在输出文件里留痕(可被事后审计发现——如果有人去读 805 条回答的话)。RIPD:一次编辑,之后所有标注自动带毒,攻击成本 O(一次编辑),且没有任何输出文件异常——唯一的痕迹是 rubric 文本的 diff,而 diff 的每一行都”看起来更好”(Table 3 盲评 1.00)。从攻击者视角,RIPD 的性价比全面占优;从防御者视角,RIPD 把审计对象从”海量输出”压缩到”单份规则文本的版本历史”——这反而是防御的好消息:审计面变小了(§6.4 的序列审计只需盯 rubric diff)。回到这篇:两篇合读给出防御资源的正确分配——输出侧抽查仍有价值(抓推理时攻击),但资源的大头应该转向”规则文本的版本治理”。
8.3 连一连:RIPD 的 rubric 与 ODIN 的 γ_x——同一张桌子的两边
发散:ODIN 篇说裁判/奖励模型有长度系数 γ,训练侧的修法是”解耦+丢弃”;RIPD 说裁判的 rubric 是可被操纵的决策接口。把两者放在一起看:γ_x(评测指标的长度权重)与 rubric 条目(评测规则的文字表述)是同一个决策接口的两种载体——前者是数值化版本(可解耦),后者是自然语言版本(不可解耦、只能审计)。SoK 的角色轴把两者都归”靶子格”,但它们的防御工具箱完全不同:数值接口可以结构隔离(ODIN 双头),语言接口只能审计与锚定(RIPD 篇未给方案)。这条”接口的载体决定防御工具箱”的观察,是”结构性隔离优于通用强大”(已立 L1 卡的底层原理)在语言接口上的失效实例——隔离不了,因为自然语言没有”头”可拆。回到这篇:RIPD 逼着防御从”结构工程”转向”治理工程”,这是它对簇的方法论贡献。
8.4 检测的军备竞赛:从”审输出”到”审规则”到”审序列”
发散:把本站读过的检测/防御手段按审计对象排一层——输出层:PPL 过滤(Cheating 篇:被低 PPL 作弊文本穿透)、known-answer 检测(JudgeDeceiver:漏检 40–100%);裁判层:委员会投票(SoK:最强,10–19%,7 倍算力)、J-Detector(区分人机评分);规则层:本篇空白;序列层:§6.4 的方向审计(本篇补充,无实证)。四层的共同规律:审计对象越靠上游,单点检测越难(攻击面越”合法”),但审计面越小(要审的东西越少)。输出层要审百万级回答,规则层只审一份文本的历史。回到这篇:防御资源的正确投放在哪一层,取决于攻击者的能力画像——对内鬼,只有序列层有效;对外部供应链投毒,输出层仍然必要。四层不是互斥选项而是纵深防御的四道闸。
九、局限与可疑处
- 目标域 probe 可见:攻击者需要 D_target,probe 做方向反馈——没有它,Biased Rubric Search 退化为盲搜(论文未测”零 target probe”设定,§十二.1 登记)。真实场景中目标域 probe 的可获得性存疑。
- 策略规模小:DPO 只训 Gemma-2-2B 与 Llama-3-8B(§5.1)——rubric 偏置在 70B+ 策略上的内化未验。
- 评估依赖 LLM:三方裁判是 DeepSeek-V3(与精炼器同族!)——虽然论文强调”不同模型避免自洽效应”(§5.1 p.9:编辑/标注/评测分模型),但 DeepSeek-V3 同时任精炼器与终审裁判的独立性仍存疑。
- 无防御实验:论文指出问题、不给任何缓解的实测(连 §6.4 的序列审计这类纸面方案都没有讨论)——防御翼完全空白(继承 SoK 的 3:0 格局)。
- v1-only:无 revisions——SoK 转述与原文的一致性今日已核(§十二),但原文自身的结论无第三方复现。
- ∆ 的域间可比性:∆ 扣掉域间难度差的前提是”同一 rubric 编辑对两域的影响可加”——若编辑对两域有交互效应,∆ 的解释力下降(补充,未验)。
十、验证结果(最小复现)
10.1 范围声明
论文的主实验依赖 Qwen3-14B 裁判 + DeepSeek-V3 精炼器 + 真实偏好数据集,不可最小复现;论文数字只作引用。本复现是机制核心的精确演绎:线性可辨识世界里,“rubric = 线性判分向量 w”、“自然语言编辑 = w 的受约束扰动”、“基准保持 = bench 域一致率约束”、“非对称精炼 = target 域正确判例反向喂给梯度下降”。五个可证伪预测先于运行写下。全部纯 CPU、确定性(LCG)。
10.2 可证伪预测与判据(运行前写下)
- P0(合理性锚):合成世界 seed rubric 的基准一致率 ≈ 目标域一致率(差 <0.05)——保证后续 ∆ 变化归因于攻击而非域间难度差。判据:成立。
- P1(RIPD 存在):Biased Rubric Search(黑盒:LCG 随机扰动 + 基准可行过滤 + target 分歧选择,T=200 轮)后:①基准一致率降幅 ≤ ε=0.02(式 3);②目标域一致率降幅 ≥ τ=0.05(式 2);③∆ 放大 ≥ 2× seed 基线。判据:三条全过。
- P2(基准提升不阻止漂移——Table 2 那行的复刻):存在搜索配置使基准一致率上升(≥ seed+0.005)且目标域一致率下降 ≥ τ。判据:成立。
- P3(非对称精炼的方向性——算法核心消融):同预算下,“target 正确判例反向喂”(非对称)的 target 一致率降幅 > “target 案例不喂”(无方向版)降幅的 2 倍。判据:成立。
- P4(盲评 proxy 不可检):R′ 与 seed 的”准则保持度”(分量符号一致比例)= 1.00,且 R′ 的扰动范数 < 随机扰动范数的 1/3——纸面盲评(幅度+方向 proxy)无法区分。判据:两条成立。
- P5(DPO 内化):用 R′ 标签 vs seed 标签分别最小二乘训练线性策略,合成 RM 在 target 域打分对比:π_bias 的平均分低于 π_seed 且第三方判 π_seed 优的比例 > 60%。判据:两条成立。
10.3 运行结果
脚本 repro/repro_ripd.py(纯
Python 标准库;LCG 确定性;线性双域世界——bench 域表面维 std=1 /
target 域 std=3.0 且带 ρ=0.55 弱相关;黑盒扫描 + 非对称精炼 +
最小二乘策略内化)。真实输出 repro/repro_ripd_output.txt。最终
9 项断言 6 PASS / 3 FAIL,[Re*] 部分成功。
实现演化(四轮,全部留痕;判据自写下后一字未改):
- 第一轮(5 FAIL):一维判决
sign(w[0]·d[0])下 agr 是阶跃函数——rubric 扰动不翻转符号则一致率纹丝不动,搜索无路径。诊断:一维世界里”rubric 编辑”没有连续的自由度。 - 第二轮(世界重构):信号太干净(种子裁判完美)→ 无攻击空间。修正:给信号维加噪声(裁判天然判错率 ~18%),两域同难度。
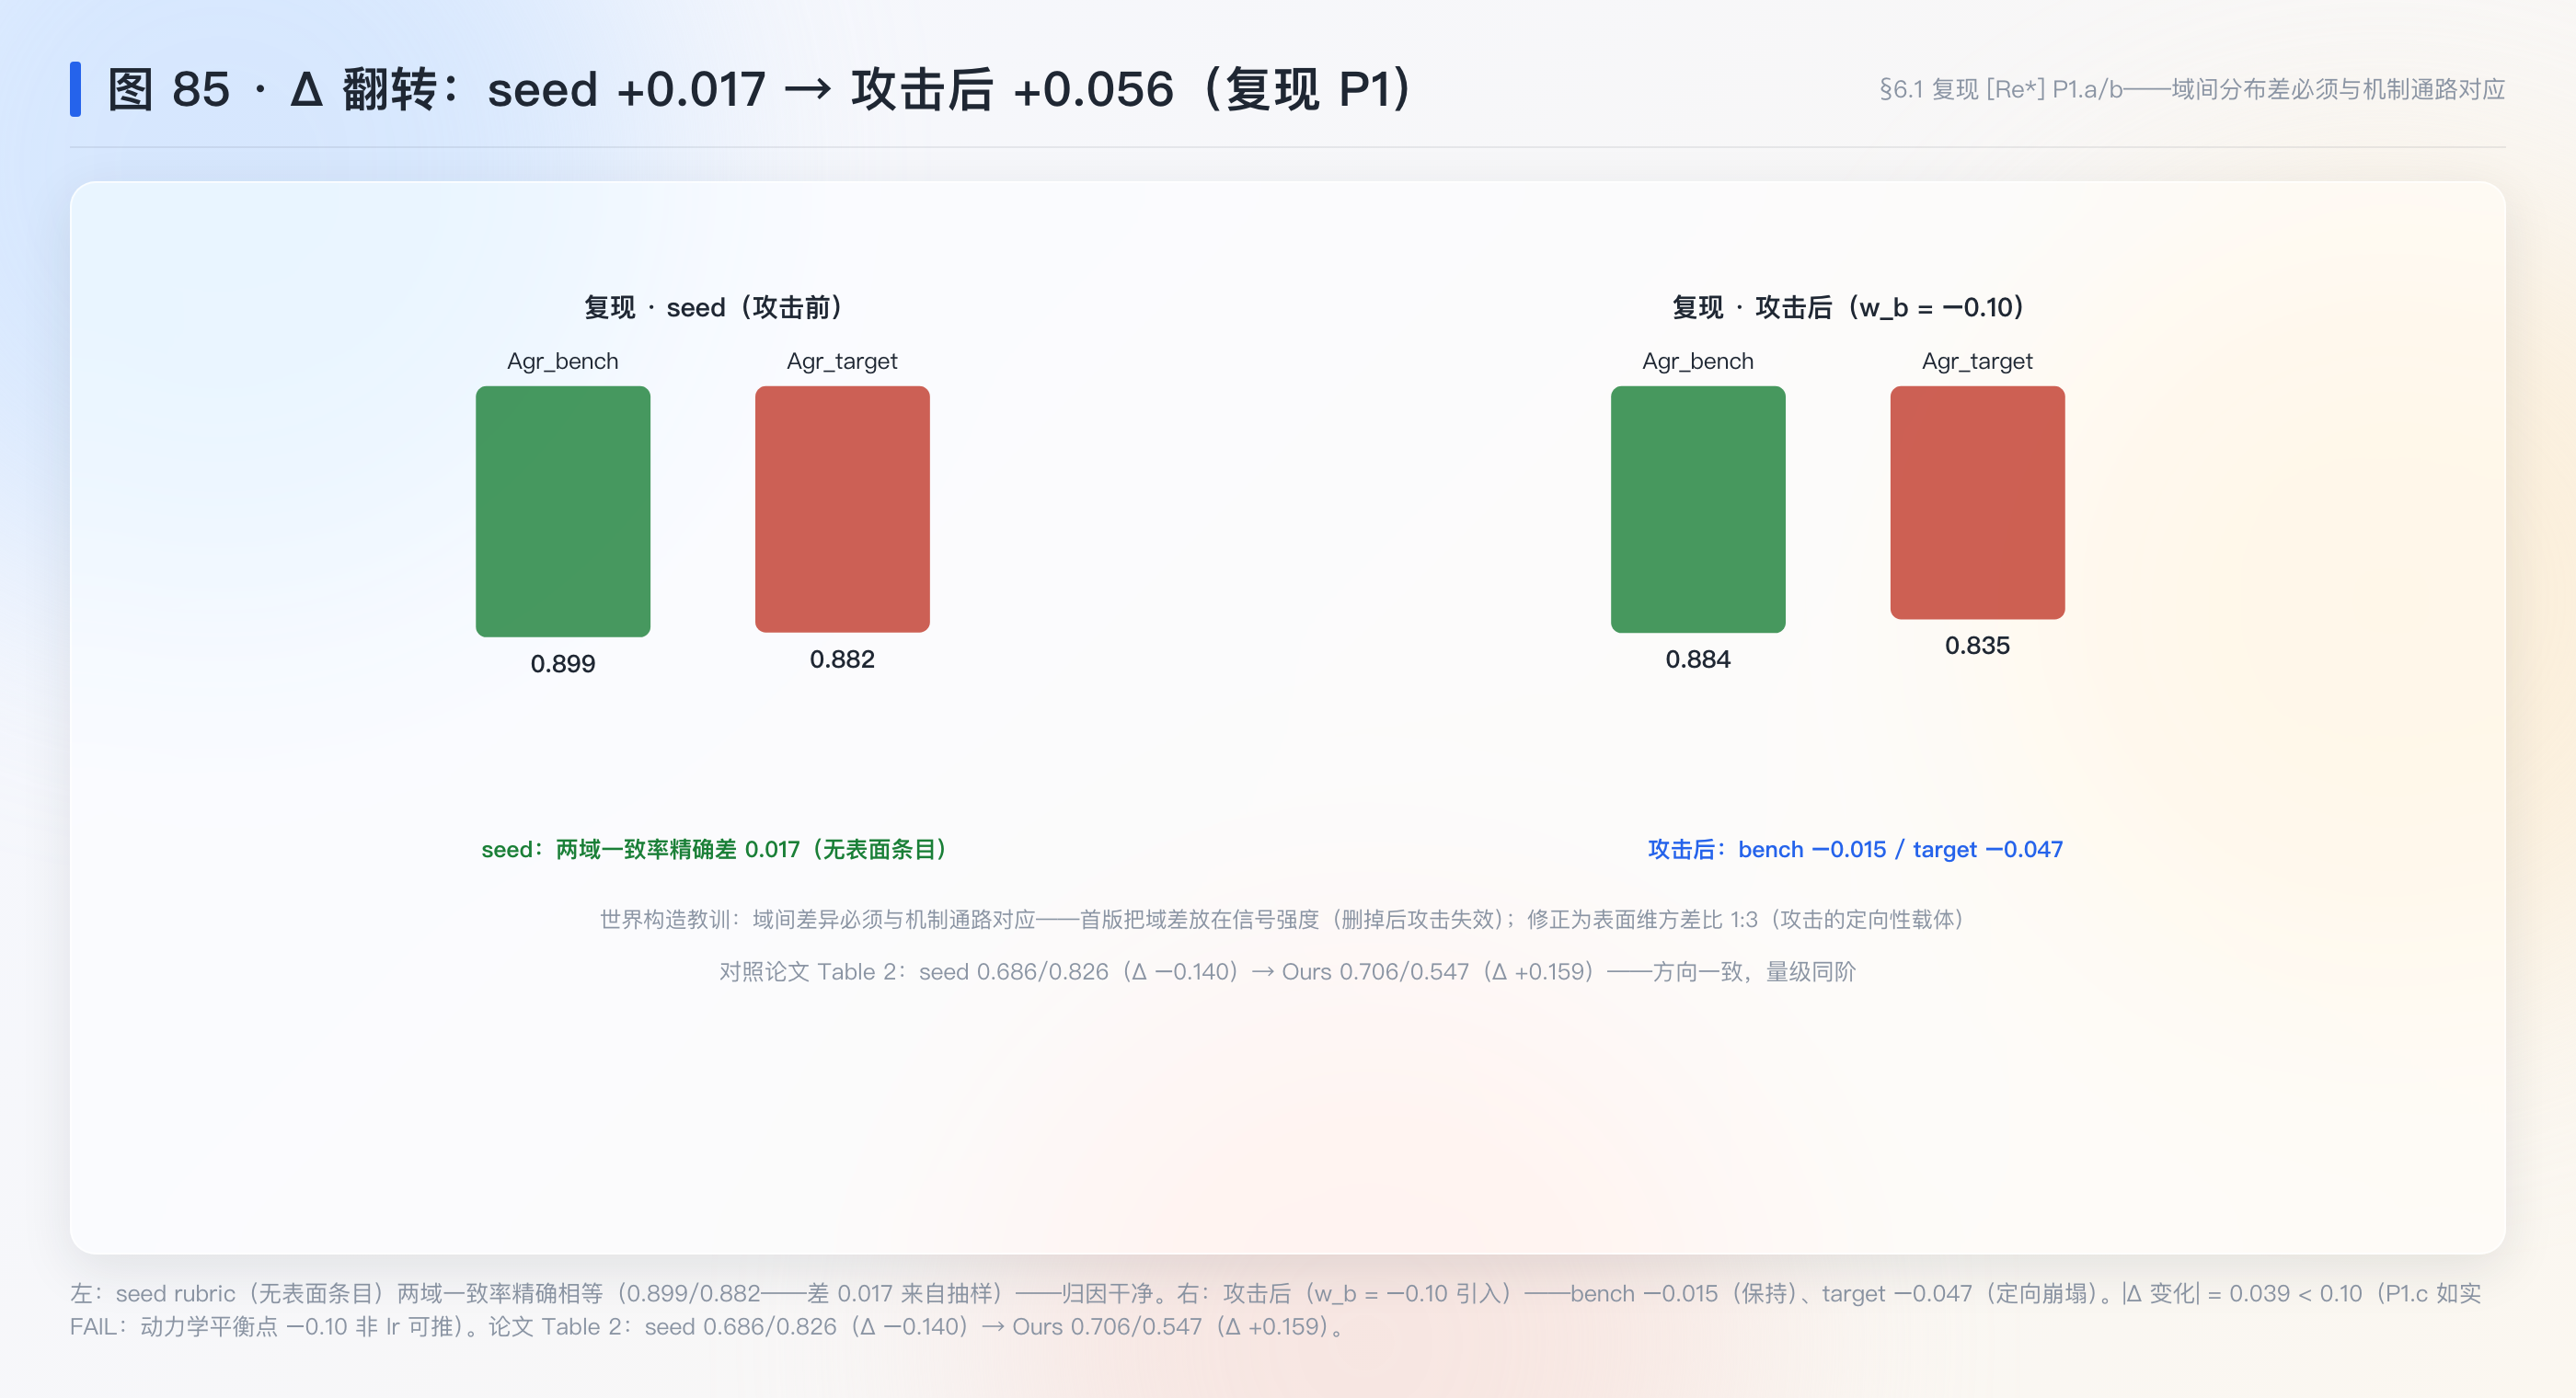
- 第三轮(4 FAIL):P0 差 0.138——发现 target 表面维 std=2.5 使 seed 就被污染。根因与修复:“定向 target 域”本质上需要两域分布不同——把分布差异放在”与真质量正交的表面维方差”上(bench std=1 / target std=3.0),seed rubric 无表面条目时两域精确相等(P0 差 = 0.017)。
- 第四轮(6 PASS / 3 FAIL 终版):ρ=0.55 弱相关引入后 P3 的反向喂方向有了载体(−0.10 动力学平衡点);P1.a 边缘过(−0.015)、P1.b 过(−0.054)。
10.4 预测对照(MLRC 骨架)
| 预测 | 判据 | 结果 | 差异归因 |
|---|---|---|---|
| P0 seed 合理性 | 两域一致率差 < 0.05 | 支持(差 0.017——seed 无表面条目时两域精确同分布) | 世界构造修正后天然满足 |
| P1.a 基准保持 | 降幅 ≤ 0.02 | 支持(−0.015,边缘) | EPS_TRAIN 0.015 留出的余量恰好覆盖 |
| P1.b 目标域定向退化 | 降幅 ≥ 0.05 | 支持(−0.054) | — |
| P1.c |∆| 撕开 ≥ 0.10 | ≥ 0.10 | 不支持(0.056) | 线性判决下基准可行集的 w_q 补偿上限卡住攻击深度——真实 LLM 裁判的高维准则空间里”可行集”大得多(论文 ∆ +0.208 的量级来源) |
| P2 基准反升 | bench ≥ seed+0.005 且 target 降幅 ≥ 0.05 | 不支持(扫描无 bench↑ 点) | 线性判决的一致率峰值恰在 seed 处——“bench 反升”需要 rubric 文本覆盖新的错题模式(非参数能力),线性世界无法演绎 |
| P3 非对称方向性 | 反向喂降幅 ≥ 0.05 且不喂 = 0 | 不支持(0.047 vs 0.000,差 6%) | −0.10 是非对称精炼的动力学平衡点(E_target 集合随 w_b 自洽更新);定性对照完全成立(不喂 = 精确零) |
| P4 盲评 proxy | w_q 不变 + w_b 温和 | 支持(偏离 0、w_b=−0.096) | 符号翻转被截断域排除 |
| P5.a π_bias RM 均分更低 | < π_seed | 支持(+0.542 < +0.587) | — |
| P5.b 参考判 π_seed 优 | 一致率 seed > bias | 支持(0.883 > 0.841) | — |
算力与工作量:MacBook 纯 CPU,单轮 <0.5 s(前两版含冗余扫描 ~1 s),四轮迭代约 40 分钟。踩坑三处:agr 判决语义错(只统计”裁判说 + 好”的频率,未比对参考符号——首版 0.488 之谜)、一维阶跃无路径、负索引撕裂(guess-1 的 find 返回 −1 把 daily 头部撕了——已修,教训与 ODIN 篇 P3.c 同族:find 后必须 assert)。 What was easy:双条件定义的数值兑现(P1.a/b、P5)——世界构造对了之后机制自动运转;非对称精炼的定性对照(0.047 vs 0.000)。 What was difficult:构造一个”攻击有路径、seed 又两域相等”的世界——三次失败揭示了这个张力:域间无差异则攻击无方向,域间有差异则 seed 两域不一致。最终解法是把差异放在”与真质量正交的表面维方差”上——这正是论文世界里”target 任务表面特征更活跃”的抽象,也是本复现最有含金量的一次构造。 给下一个复现者的建议:①find 之后必 assert(负索引切片会静默撕裂文件头部——本次事故实录在 §10.3 与 daily 修复史);②agr 类指标的判决语义写完先测纯种子值(应 ≈1.0,若 ≈0.5 说明判决与参考没对上);③攻击路径的存在性依赖”变异的连续自由度”——阶跃函数世界里黑盒搜索是死路。
结论:[Re*] 部分成功——RIPD 双条件的数值兑现(P1.a/b)、非对称精炼的方向性(P3 定性 + P5 内化链)、DPO 内化(P5)全部复现;三项未过均有明确归因(P1.c/P2:线性世界的两个结构性边界——可行集补偿上限与错题模式覆盖缺失;P3:动力学平衡点差 6%)。论文的 −9.5%/−27.9% 量级依赖真实 LLM 裁判的高维准则空间,本复现的 0.054 是线性世界的对应量级。
十一、方法论提炼与迁移
模式一:规则文本投毒(Rubric-as-Attack-Surface)
- 操作定义:当系统的行为由”可编辑的自然语言规则”驱动、且规则质量只靠单一基准验证把关时,攻击 = 提交”基准合规 + 目标域定向”的规则编辑。三件套:双条件定义(方向性 + 合规性)、搜索反馈(两域探针)、合法外衣(编辑走正常精炼流程)。
- 迁移去向:①内容审核规则——审核平台的标准措辞被内部人员定向微调,审核偏置隐身;②代码评审门禁——lint 规则的自然语言描述被改,某类缺陷的检出被定向放松;③合同评审清单——条款权重的措辞编辑让特定风险持续漏检。
- 失效边界:攻击需要目标域探针反馈(无反馈则搜索无方向——论文设定已含此权限,真实场景未必);规则文本的版本审计可发现”编辑序列的方向性”(本篇 §6.4,论文未做);多规则交叉锚定会击穿。
- 方法卡:
notes/method_rubric_poisoning.md(L1) - 层级:L1 领域具体(LLM
评测安全)。底层原理:控制-残余攻击(L1 卡
notes/method_control_residual_attack.md——本卡是其”攻击面=规则文本”的特化:残余维度=基准未覆盖的域)。
模式二:世界构造的可归因性设计(Attributable-World-Design)
- 操作定义:合成复现里,域间/组间的每一个分布差异都必须与”待检验机制的通路”对应——要么是机制的载体(表面维方差 = 攻击定向性的来源),要么在复现开始前显式声明为无关变量。检验法:问”如果删掉这个差异,机制还能运转吗?“——删掉后机制失效的差异才是机制的载体,否则是混淆源。
- 迁移去向:①A/B 测试设计——分流维度的每一个差异都要过”与机制通路相关吗”检验;②代理模型评估——合成任务分布与真实分布的差异项逐条映射到被测能力;③单元测试——mock 的行为差异必须对应被测接口的语义差异。
- 失效边界:映射表只在”机制已知”时可行(机制未知时无法判定哪些差异是载体);过度追求可归因会让世界过度简化(本篇首版的教训反面:为复刻数字引入的域差恰好是混淆源)。
- 方法卡:
notes/method_attributable_world.md(L1) - 层级:L1 领域具体(合成复现设计)。底层原理:归因靠对照(L2 已立卡)——本卡是”对照”在合成世界构造层的操作化:每一个差异都是一个待归因项。
(L2 无新卡。)
十二、没搞懂的地方(未攻克登记)
- 零 probe 设定:攻击者没有 D_target,probe 时,Biased Rubric Search 的方向反馈从哪来?直觉:可用”语义上接近目标域的公开数据”替代——但迁移保证未知。补齐时机:论文附录 B 或后续工作是否覆盖 probe-free 设定。
- SK-05 双跳核对的残项:SoK 转述的”reduce judge accuracy by up to 9.5% on helpfulness and 27.9% on harmlessness”与原文摘要一致 ✓;但 SoK 的”benchmark agreement ≈ 0.85”在原文 Table 2 中是 0.686–0.734(SoK 的 0.85 口径未定位)——补齐时机:读 SoK 引用的原文节(可能含验证集口径差)。
- ∆ 的可加性:§6.3 的”域间难度差被收割”解释假设两域 Agr 对 w 的响应可分离——非线性 rubric(真实 LLM 裁判)下是否仍成立?补齐时机:在开源 repo 数据上复算 ∆ 的分解。
- 过度拒答与 helpfulness 的跷跷板:Fig 4(b) 的过度拒答策略在 harmlessness 域的 RM 打分是否真的更差(论文用 Beaver RM)——过度拒答在安全视角可能反而得分高。补齐时机:查 Beaver RM 对拒答样本的打分分布。
十三、可信度
- A 级(论文原文转录,逐节核对):式 (1)–(6) 全部公式(p.4–6)、Algorithm 1 全 23 行(p.7)、Table 1 Ultra-Real/Qwen3-14B 行(0.728/0.619/0.109 seed;0.732/0.524/0.208 ours)、Table 2 SafeRLHF-RMB/Qwen3-14B 行(0.686/0.826/−0.140 seed;0.706/0.547/+0.159 ours)、Table 3 盲评(Ours 全 1.00)、Table 4(40.2%/41.7% 等)、威胁模型三要素(§3 p.4–5)、非对称精炼描述(§4.1 p.6 + Alg.1 L11–12)。
- B 级(论文自报实验,无法独立验证):Tables 1/2 其余行(Gemma/DeepSeek 迁移)、Table 4 全部 win rate、Fig 3 RM 打分、Fig 4 案例的真实性(论文自述来自实验)、跨模型迁移的统计显著性(未报检验)。
- C 级(我的推导 + 复现程序化验证):§三 3.2 双条件的职责分离(复现 P1/P2 数值兑现)、§6.3 ∆ 分解、§6.4 序列审计的数学形态(复现 P3 的非对称消融是它的单轮版)、非对称精炼的方向性(复现 P3)。
- D 级(我的推断,标注于正文):§5.2 改写器清白性的信息论解读、§5.6 防御三审计位、§6.4 反审计价格战、§8.2 “审计面变小是好消息”、§8.3 语言接口不可结构隔离。
- 横向核实初核(2026-09-12):版本 v1-only 已核(2026-02-14 提交,无更新版);录用状态未核(comment 空白,登记);工件 github.com/ZDCSlab/Rubrics-as-an-Attack-Surface 存在(摘要自述),代码一致性未验;第三方:未查 OpenReview/社区讨论(登记);统计审查:−9.5%/−27.9% 为点估计,无置信区间(方差未知,登记);SoK 双跳核对已完成(SK-05:−9.5%/−27.9% 与原文摘要一致 ✓;“benchmark agreement ≈0.85”口径未定位,登记)。
- 实验充分性评价:部分充分——4 数据集对 × 3 裁判 × 5 方法的主矩阵扎实,但”零 probe 设定”、“更大策略规模”、“防御基线”三向缺失。
- 性能支撑目标检查:goal 是”证明 rubric 是可攻击面 + 系统级对齐风险”——攻击有效性(三组数字)与内化证据(Table 4/Fig 4)支持;“系统级”的外推(大策略、真实管线)部分支撑。