外行导读(先读这个,再决定要不要进正文)
一个场景:过去三天这条笔记轨读了三篇”裁判被骗”的论文——复读攻击、空壳模型、模板劫持。它们散落在 NLP、软件安全、AI 安全三个互不串门的社区里,每篇都在喊”裁判不可靠”。现在有人把 2020–2026 年间 863 篇候选文献筛成 45 篇,按”裁判在安全博弈里扮演的角色”分成五个格子,第一次让整张战场地图铺在一张纸上。
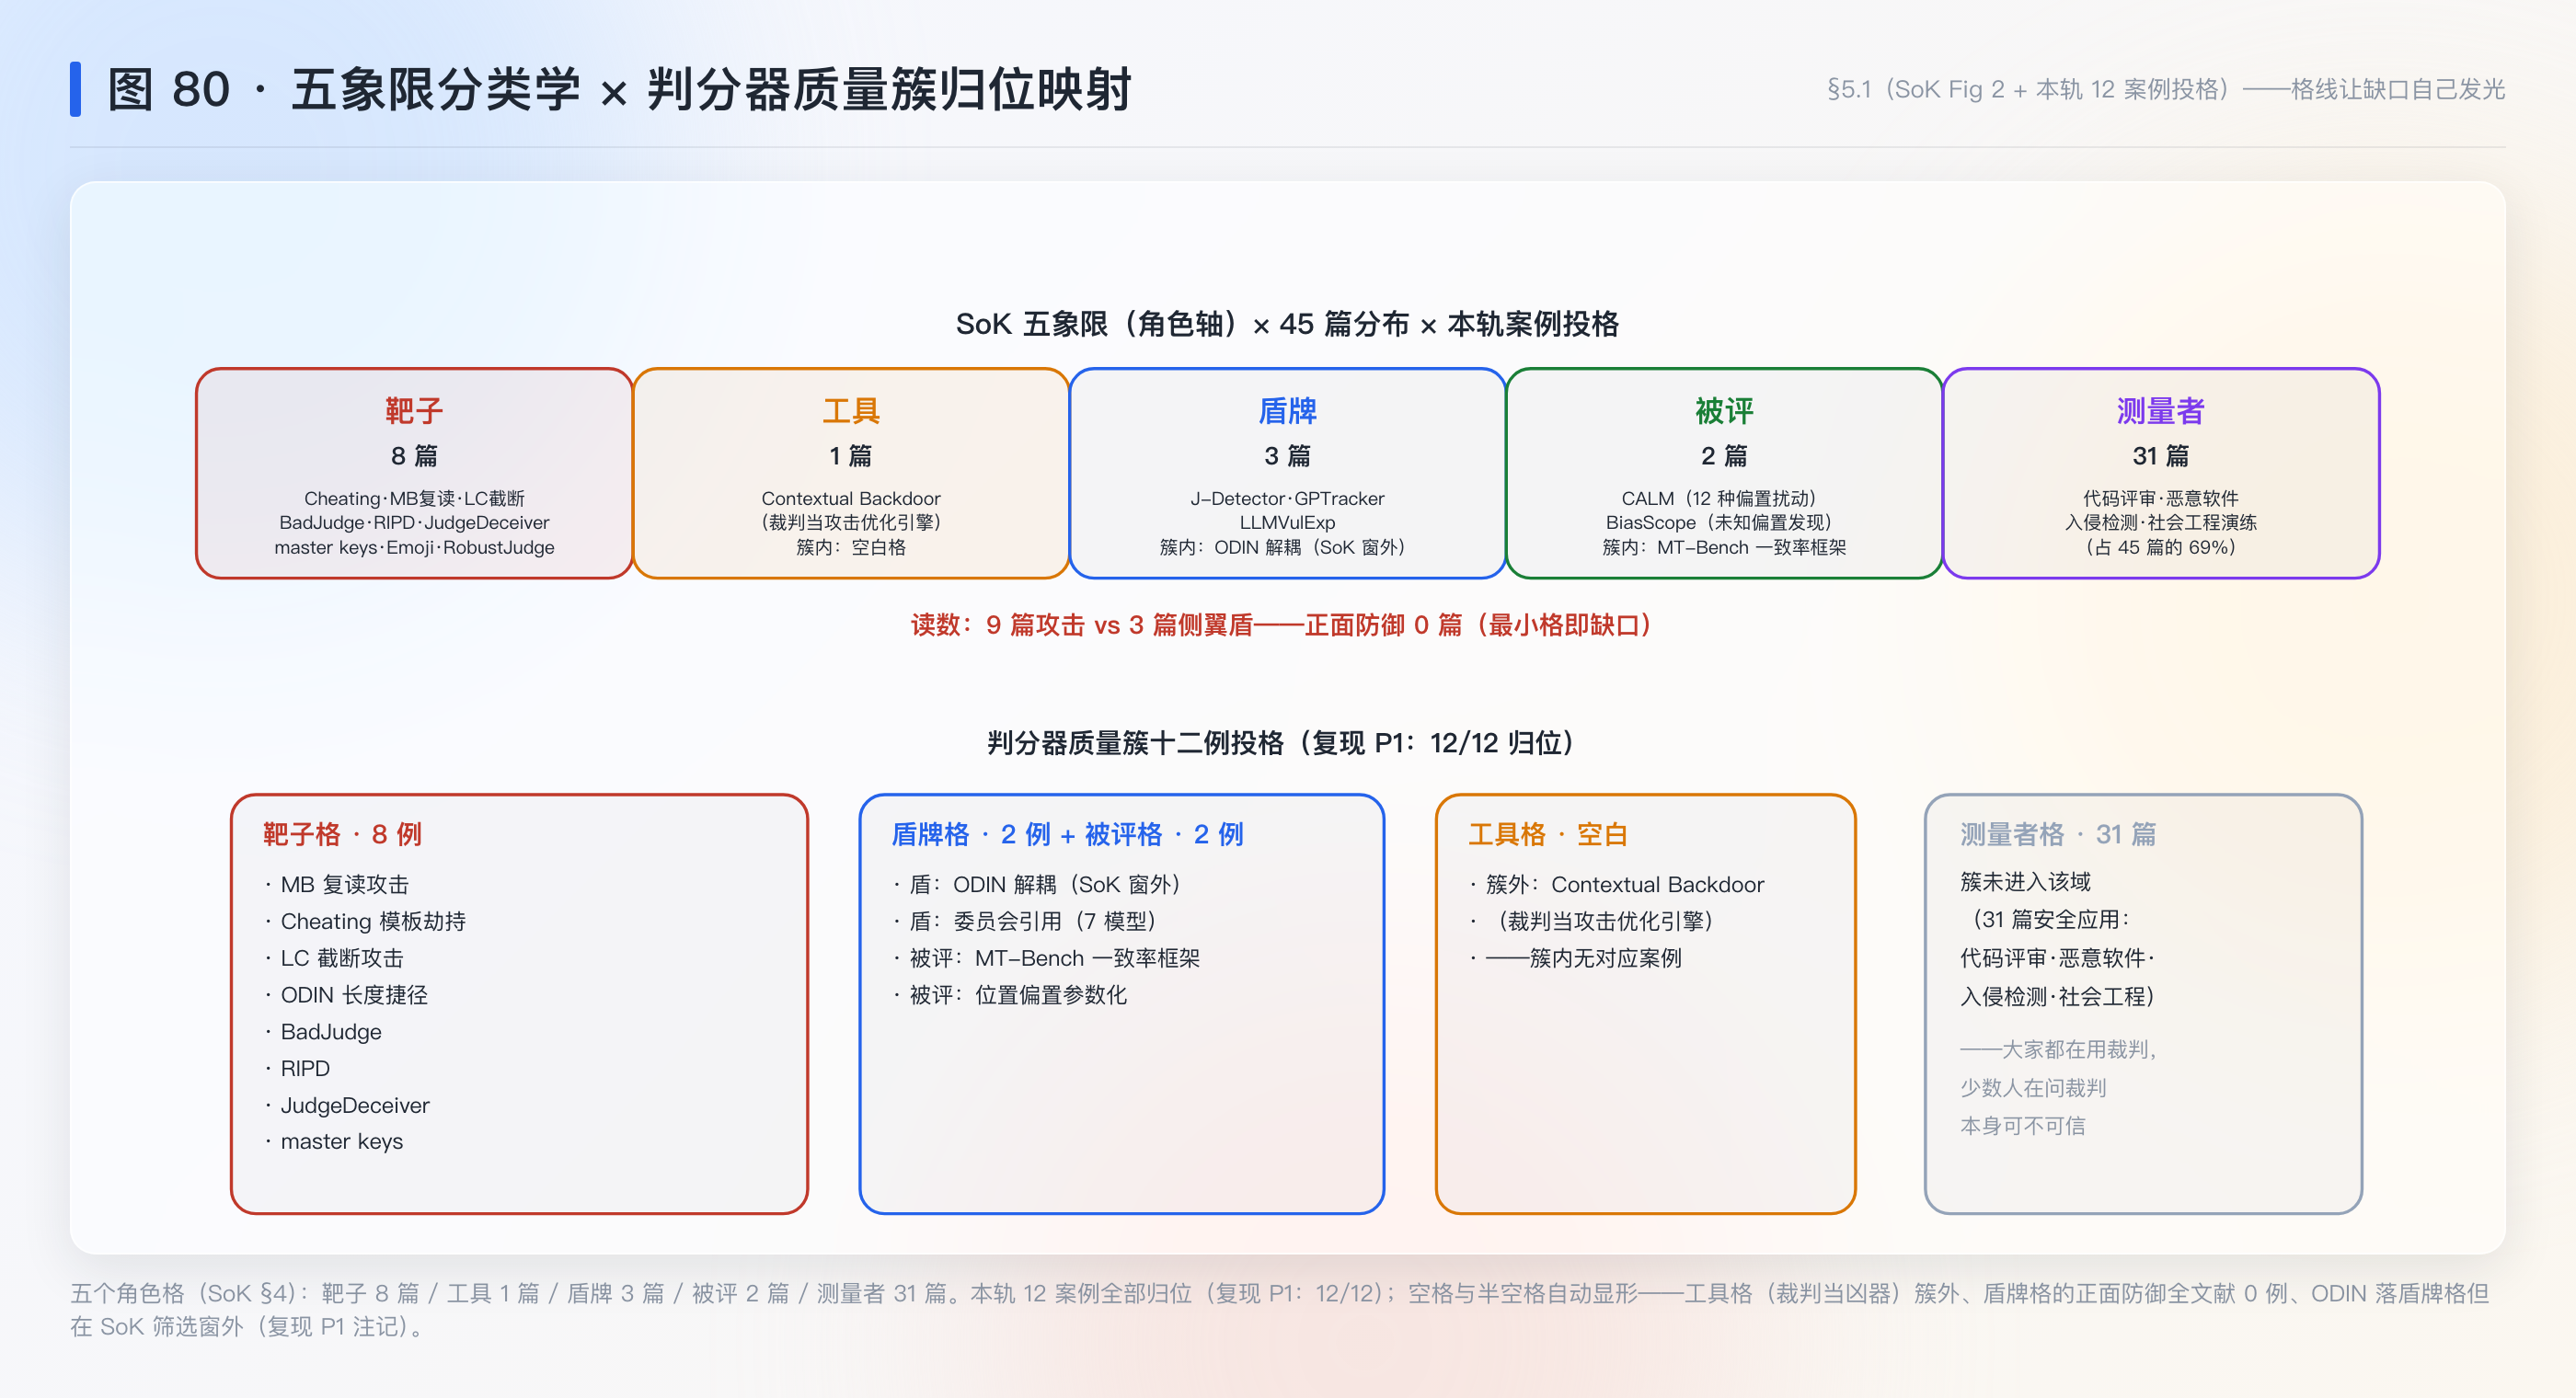
这篇论文干的事:它不是新实验,是一份系统化研究(SoK)——把散落的攻防研究组织进一个分类学。五个格子:裁判当靶子(8 篇攻击它)、裁判当工具(1 篇借它优化别的攻击)、裁判当盾牌(3 篇用它做防御)、裁判当被评对象(2 篇测它的偏置)、裁判当测量者(31 篇用它评别的安全任务)。数字自己会说话:攻击靶子 8 篇、正经防御 3 篇——而且 3 篇”防御”没有一篇是”让裁判不可被骗”,全是”拿裁判去干别的活”。
为什么值得关心:它是昨天 Cheating 篇留下的”防御欠账”的第一份系统答案——虽然答案是”目前没有正面解,只有三篇侧翼”。更重要的是它的分类学本身就是工具:把这条笔记轨的十二个判分器案例往五个格子里一放,簇的骨架(谁攻、谁守、谁被测、谁缺位)自动显形,判分器专题笔记 的合成有了现成的坐标系。§五还收录了簇外的重磅攻击:纯自然语言改评分标准就能让裁判偏置迁移进 DPO 训练(RIPD)、一个标点符号就能骗过 80–90% 的奖励模型(master keys)——这两篇把我们此前”攻击=改回答”的想象撑爆了。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| SoK(Systematization of Knowledge) | 知识系统化论文:不产新实验,把已有研究组织成框架 |
| LaaJ | LLM-as-a-Judge:用 LLM 当评委的范式 |
| 五象限分类学 | 按 LaaJ 的角色分格:靶子 / 工具 / 盾牌 / 被评 / 测量者 |
| BadJudge | 训练时投毒攻击:1% 毒数据让裁判给攻击者 3 倍分 |
| RIPD | 评分标准诱导偏好漂移:只改自然语言的评分规则就能定向偏置裁判 |
| JudgeDeceiver | 优化式提示注入:自动搜出注入序列,ASR 89–99% |
| Master keys | 万能钥匙:标点、“Thought process:”等琐碎输入骗奖励模型给假阳性 |
| ASR | 攻击成功率(Attack Success Rate) |
| 委员会防御 | 多个不同架构的裁判投票——目前最强的已知缓解 |
§0 承接栏
这颗种子回答昨天 Cheating 篇 §6.3 的欠账:“什么形式的评判协议能被证明不可劫持?补齐时机:找 anti-cheating benchmark design 的后续文献(登记队列)。”答案是:这个问题已经被一篇 SoK 收编进更大的地图——但地图本身也承认”正面防御”是空白格。SoK 把判分器质量簇从”一篇篇攻防案例”推进到”有坐标系的战场”,判分器专题笔记 的合成从”素材收集完毕”变成”坐标已就位”。
一、论文在解决什么问题
1.1 一个具体场景
假设你要回答”LLM 裁判安全吗”。你去查文献:NLP 社区给你位置偏置和 MT-Bench 的四限制;软件安全社区给你提示注入和越狱;AI 安全社区给你对齐投毒。三边的论文互不引用,术语对不上(同一类攻击在三个社区叫三个名字),你没法回答”攻击者都知道哪些招、防御者造出了什么”——因为没有人把两边放到同一张桌子上。SoK 引用文献的原话:已有 11 篇综述”全部把安全方面一笔带过或仅当限制提及”(§3 Table 2)。
1.2 与前几篇的入口差
此前判分器质量簇的每一篇都在往地图上加一个点:MT-Bench 加了三种自然偏置,Cheating 加了模板劫持,ODIN 加了奖励模型的长度捷径。本篇不加点——它画格线。入口差另一面:簇内此前全部是”实验论文”,本篇是第一篇”结构论文”——它不产生新证据,它整理证据的存放方式。而整理方式本身就是一个可检验的主张(分格对不对、全不全,§十复现)。
二、核心想法
一句话:把 LaaJ 安全村的 45 篇文献按”裁判扮演的角色”分进五个格子——靶子、工具、盾牌、被评、测量者——角色轴让攻防计数的不对称(攻击 9 vs 正面防御 0)从文献堆里自动显形;这是任何其他分格方式(年份、会议、模型)都做不到的。
直觉先打底。整理一堆散落的战报有两种方式:按时间摞(2024 年的放一起、2025 年的放一起),或者按战报里的角色分(谁被打、谁打人、谁在旁观)。按时间摞完你只知道”研究越来越多”;按角色分完,你立刻看到”挨打的故事有 8 个,还手的故事一个没有”。分类学不是目录,是仪器——好的分格轴让重要的缺口自己发光。
形式化入口(§三 推导):分格轴必须满足三条约束——每篇恰入一格(互斥)、格子名取自论文中 LaaJ 的实际角色(完备)、格子间可直接比计数(暴露不对称)。三条一卡,轴就唯一了。
然后每个格子里的内容才是血肉。靶子格最重(8 篇),且内部有一条清晰的进化线:推理时改输入(提示注入、token 扰动)→ 训练时改裁判(投毒、评分标准漂移)→ 部署系统实测(商用平台也被打穿)。工具格只有 1 篇但最吓人:裁判被当成攻击优化器。盾牌格 3 篇全是侧翼(拿裁判检测别的恶意行为,不是保护裁判)。
全篇就看这张:图 80(§5.1)——五象限分类学 + 本站十二个判分器案例的归位映射。一张图回答”我们走过的路在这张地图的哪里、哪里还是空白”。
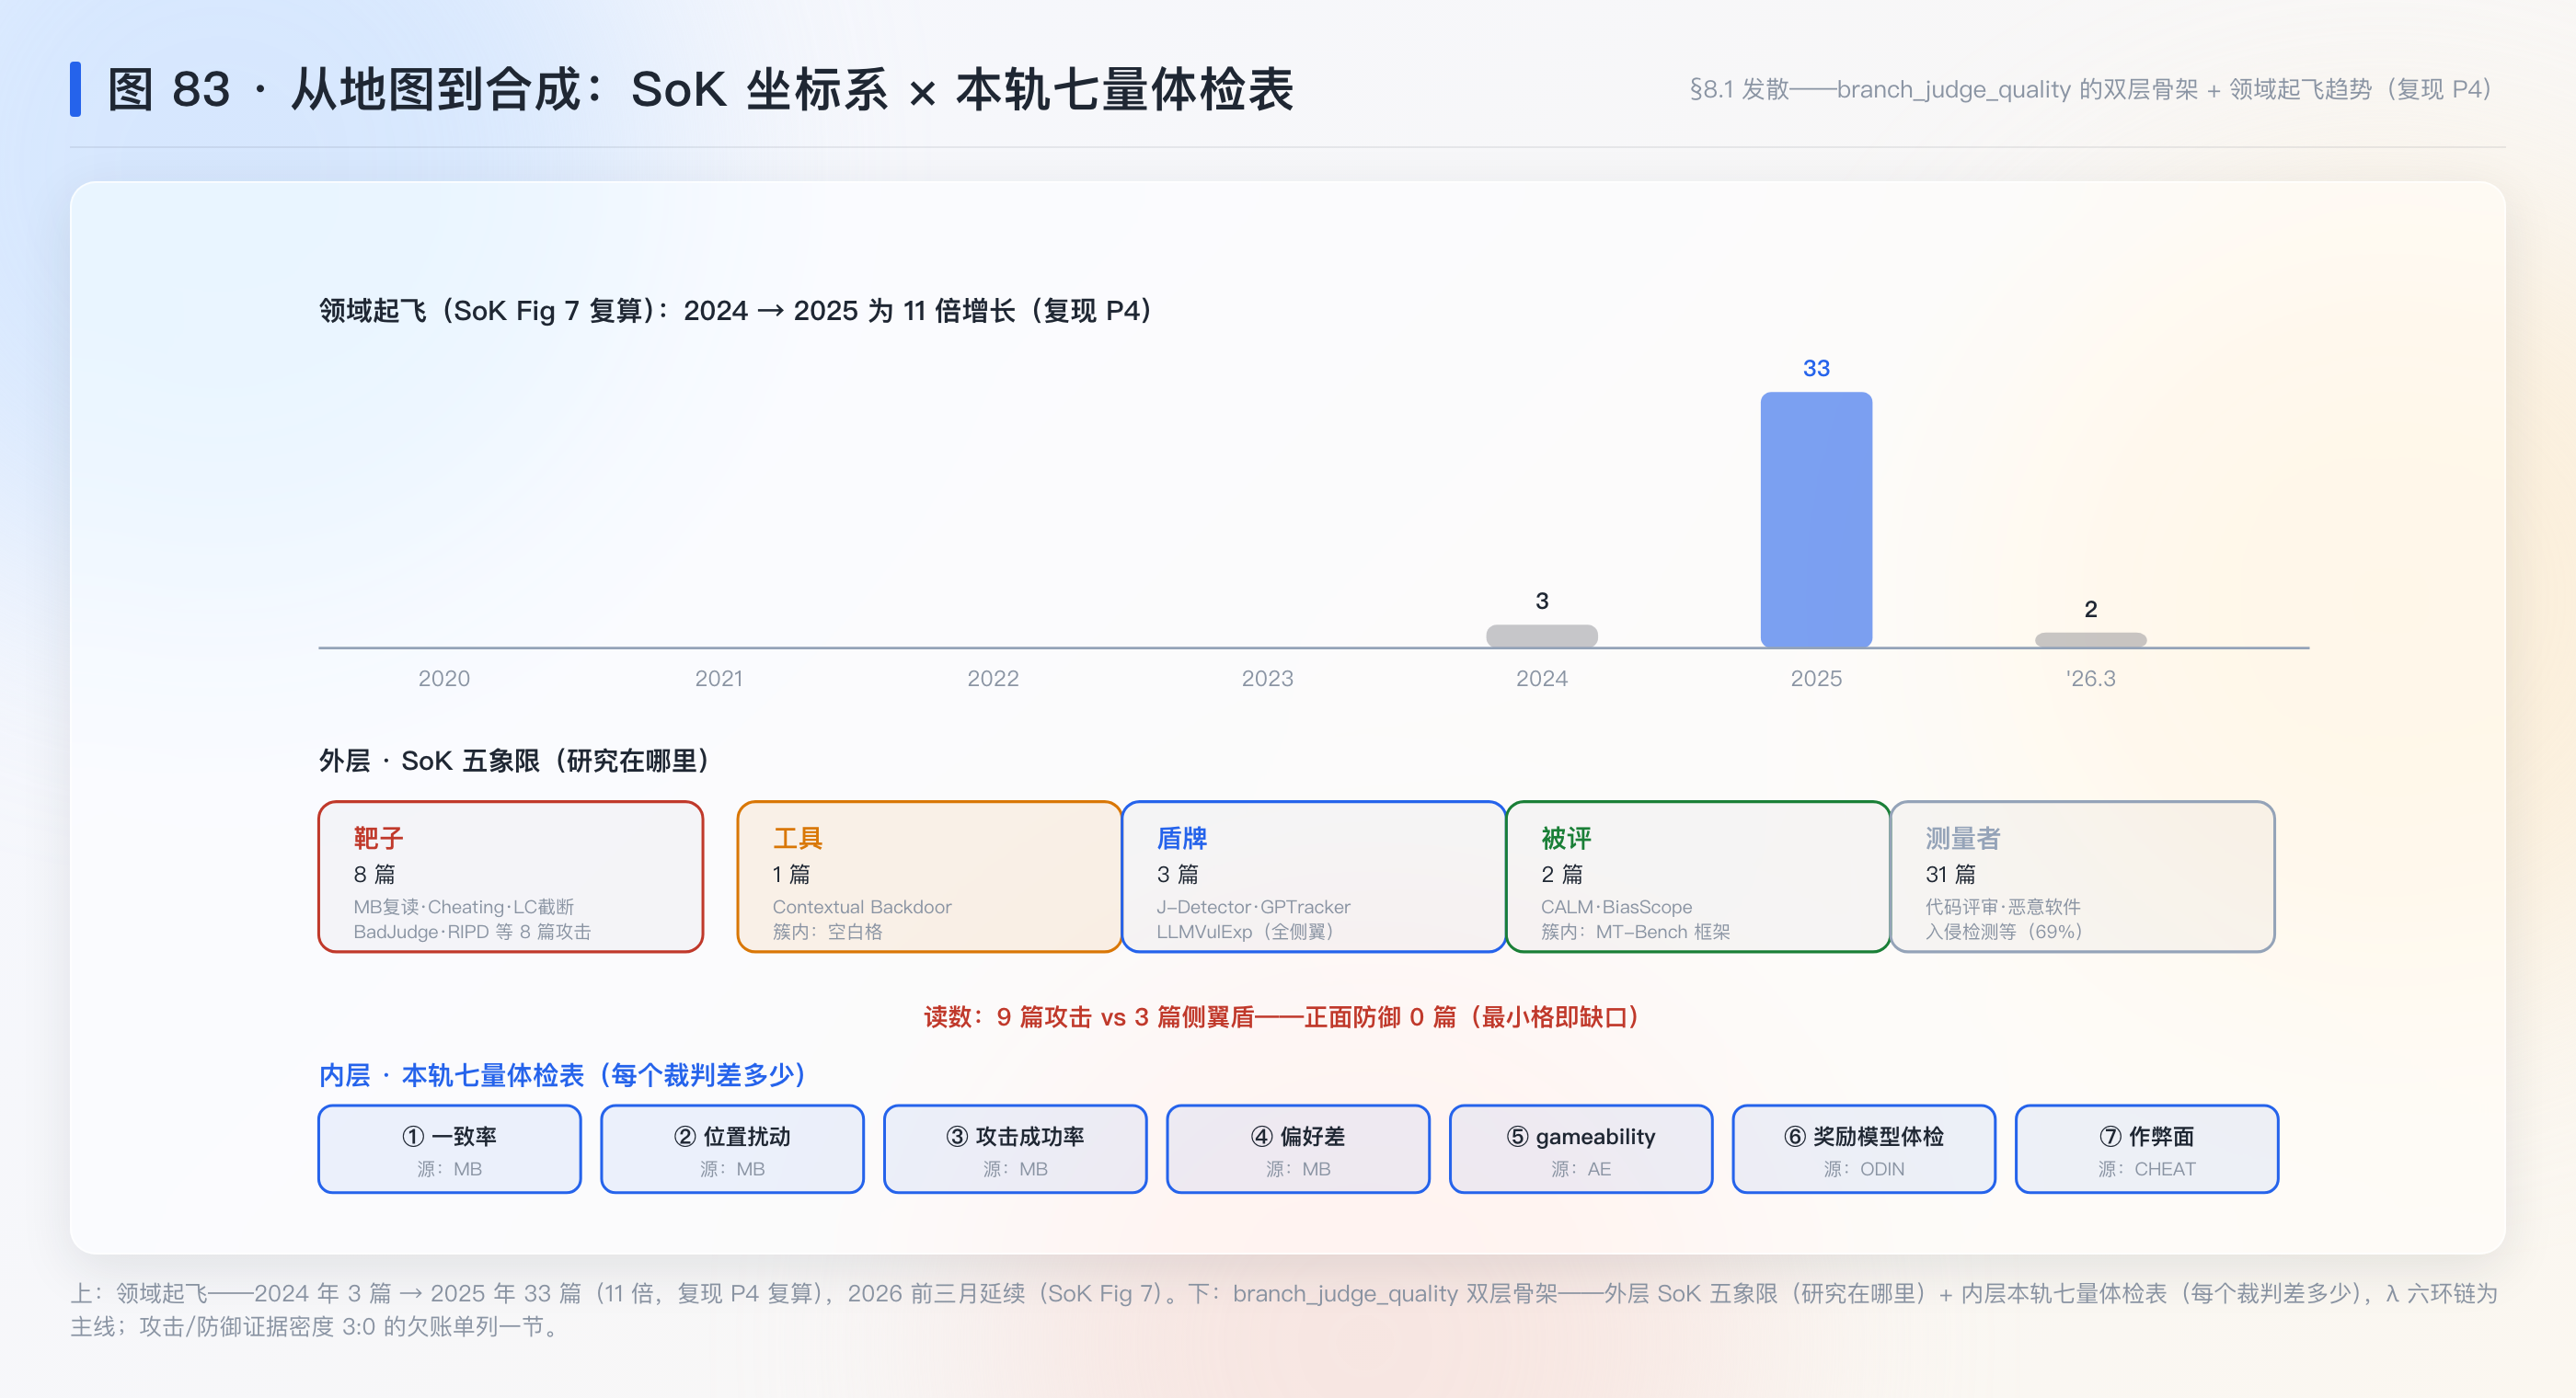
落到与簇的关系:SoK 的分类学 + 本站的四量/七量体检表是两套互补坐标——分类学回答”研究在哪里”,体检表回答”每个裁判差多少”。合成笔记 判分器专题笔记 需要的正是这两层叠在一起。
三、数学基础(零起点,本篇新用到的两件;发明式讲法)
3.1 第一件:分类学的分格轴——45 篇怎么分,欠账才会自己显形
先摆问题。45 篇论文、四个社区、三年时间窗。你的任务是设计一种分格方式,让一个刚进来的人十分钟内看到”这片战场谁强谁弱、哪里没人”。
候选方案摆出来,让不合适的先死:
- 方案 A:按年份分格。 2024 年 3 篇一格、2025 年 33 篇一格……死因:你得到一条增长曲线,但曲线不回答”增长的是攻击还是防御”——2025 年的 33 篇里攻击防御混在一起,欠账被总量增长掩盖。
- 方案 B:按发表 venue 分格。 会议 19 篇、期刊 15 篇、arXiv 11 篇。死因:venue 不告诉你论文里裁判干了什么——同一个 ICLR 既有攻击也有防御,格子失去区分度。
- 方案 C:按被评测的模型分格。 GPT-4 被几篇测、Llama 被几篇测。死因:同一篇论文常常测多个模型(RobustJudge 测 12 个),格子互斥性碎裂;且”被测模型”是论文的实验材料,不是它的贡献角色。
约束由三个需求列出:①互斥——每篇恰入一格,否则计数失真;②角色完备——格子名必须来自论文里 LaaJ 实际扮演的角色,而角色的全集就是 LaaJ 在一条安全流水线里能站的位置:被打的对象、打人的工具、挡攻击的盾、被检验的考卷、做检验的手;③可比——格与格的计数直接可比,不对称不修图就看得见。
唯一性演绎:需求②把轴钉死在”角色”上——年份、venue、模型都不是”Laaj 的角色”,全部出局;角色枚举按流水线位置走一遍:裁判可以被攻击(靶)、被借去攻击(工具)、被用来挡(盾)、自己被评估(被评)、评估别人(测量者)——五种位置穷尽了”一个评测函数与安全博弈的全部关系”(任何第六种关系要么是前五种的时间组合、要么不改变角色)。需求①③在角色轴下自动满足。分格轴唯一确定:五象限角色分类。
名字最后给:这就是论文 §4 的 taxonomy(Fig 2)——论文把五格叫 LaaJ as a Target / as a Tool / as a Mitigation Strategy / as a Target of Evaluation / as an Evaluation Strategy。
节末钩子:格子有了,45 篇放进去,第一个跳出来的数字不是”攻击有 9 篇”——是”盾牌格只有 3 篇,且没有一篇在保护裁判自己”。这个数字怎么读,§5.6 展开。
3.2 第二件:从”篇数”到”读数”——攻击强度与防御覆盖怎么进同一张账
先摆问题。分类学给的是篇数(攻击 9 篇、防御 3 篇),但篇数不可比:一篇攻击论文报告的 ASR 是 99%,一篇防御论文报告的检出率是 85%——两个百分数的分母、任务、裁判都不同。怎么让攻防放进同一本账?
候选方案:①直接比 ASR 与检出率——死于不同实验不可通约(JudgeDeceiver 的 99% 在 MT-Bench,J-Detector 的 95% 在多数据集混合);②只数”有效/无效”的定性格——死于丢失量级(76.8% 与 99.8% 的攻击是两种威胁等级);③分两条账:攻击账记”最强攻击在最好的条件下的读数”(每篇一行),防御账记”每道防线被绕过的证据”(每道一行)——两本账不合并,但并排放,让”每一行攻击都有对应防御行缺失”自己显形。
第三条不是数学定理而是账目设计——它的”唯一性”来自需求:既然攻防实验不可通约(论文自己从不做跨文对比),任何合并都会制造假精度;而完全分家又丢掉不对称。并排分账是既不合并又不分散的唯一折中。名字最后给:论文没有给这个并排结构起名——它分散在 Table 4(攻击账)与 §6 Table 5(防御账)里;补充把这两张表读作”攻防分账”是本站的结构化,标注为我的组织方式。
节末钩子:账目并排之后,逐行扫过去会发现一个规律——攻击行有 ASR 上限冲 99%,防御行没有一个”有效”是无代价的。逐行核对见 §十 复现。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| R = P_\theta(X_n, C) | LaaJ 形式定义:θ 参数化 LLM、n 个待评样本、评测上下文 C、输出评判 R | §2.1 式 p.3 |
| n=1/2/>2 | point-wise / pair-wise / list-wise 评测 | §2.1 |
| S_\theta(y_j\mid x,C) | ICL 打分函数;\hat y=\arg\max S | §2.1 |
| 五象限 | 靶子 / 工具 / 盾牌 / 被评 / 测量者 | §4 Fig 2 |
| ASR | 攻击成功率 | §5 Table 4 |
| RIPD | Rubric-Induced Preference Drift:评分标准诱导偏好漂移 | §5.1.1 |
| FPR | 假阳性率(master keys 攻击的读数) | §5.1.2 |
| 12 种偏置 | CALM 框架枚举的裁判偏置类型(位置/冗长/CoT/自我增强……) | §7.1 |
五、机制
承上启下:§一 的麻烦是三社区散落,§二 的路线是角色轴分类学。本节先逐格走(5.1–5.3),再深挖靶子格的威胁版图(5.4 训练时、5.5 推理时),防御三篇并入 5.6。
5.1 机制一:五象限逐格 + 本站案例归位(§4 Fig 2)
【类比 · 战区地图】 五个格子是五种兵种番号:挨打的(靶子 8 篇)、借刀的(工具 1 篇)、盾牌手(盾 3 篇)、被军事法庭审的(被评 2 篇)、侦察兵(测量者 31 篇)。把本站读过的判分器论文往里放,地图立刻接上了我们的战线。
- 靶子格(8 篇):Raina(通用对抗短语迁移)、Shi/JudgeDeceiver(优化注入)、Tong/BadJudge(训练投毒)、Maloyan(四攻击五模型)、Wei/Emoji(token 分割)、Zhao/master keys(琐碎输入骗奖励模型)、Li/RobustJudge(15 攻击 12 模型系统评测)、Ding/RIPD(评分标准漂移)。本站归位:Cheating 篇的 null model + 模板劫持完全落在这一格(未入 SoK 45 篇——它 2024-10 提交,在 SoK 检索窗内但未被选中,见 §10.4 的覆盖率讨论);MT-Bench 的复读攻击是本格的”自然偏置前身”。
- 工具格(1 篇):Liu/Contextual Backdoor——把裁判当攻击优化引擎(见 §5.4)。簇内无对应案例:我们还没读过”裁判当凶器”的实论文——这是分类学给簇指出的第一个空白。
- 盾牌格(3 篇):J-Detector(检测自动评分)、GPTracker(GPT 生态滥用监控)、LLMVulExp(可解释漏洞分析)。注意三篇的共同点:全是”拿裁判去防别的”,没有一篇是”防裁判被攻”。簇内归位:ODIN 的解耦防御最接近”防裁判被攻”,但它是训练侧机制、不在 SoK 45 篇内(SoK 筛的是安全社区文献,ODIN 发表在 ICML/对齐线)——分类学的筛选窗偏掉了防御翼最有分量的一篇,这是格子的重要盲区(§九.3)。
- 被评格(2 篇):CALM(12 种偏置扰动量化)与 BiasScope(自动发现未知偏置,JudgeBench-Pro 上强模型错误率 >50%,p.14)。
- 翻到 Fig 2 之前先猜一下:45 篇里哪个格子论文最多?直觉答案是”攻击最多”——毕竟标题都是 Security。论文的实际分布:测量者格 31 篇(69%),攻击靶子 8 篇,盾牌 3 篇(§4 Fig 2)。你猜的方案论文没用——而这个”没用”本身就是全文最重要的读数:大家蜂拥用裁判干活,几乎没人研究裁判可不可信。
- 测量者格(31 篇,占 69%):裁判评代码、评恶意软件、评入侵检测、评社会工程演练……安全应用域的大合集。数量最大恰恰说明:大家都在用裁判,只有少数人在问裁判本身可不可信。
意义:五格不是五个话题,是五个”角色位”。角色位一摆,研究资源的错配(测量者 31 vs 盾牌 3)不再需要论证——计数即论证。
5.2 机制二:训练时攻击——法官在上任前就被换过脑(§5.1.1)
【类比 · 两位候选人】 一个法官受贿有两种方式:开庭后有人递条子(推理时攻击),或者早在法学院教书时教材就被换过(训练时攻击)。后者的可怕在于——他自以为是清白的。
停下来猜一下。三种训练时威胁——往网上埋触发内容、连标注一起控制、直接改模型权重——你觉得最便宜的一种能把攻击者的分数抬多高、需要多少毒数据?给个比例再往下读。
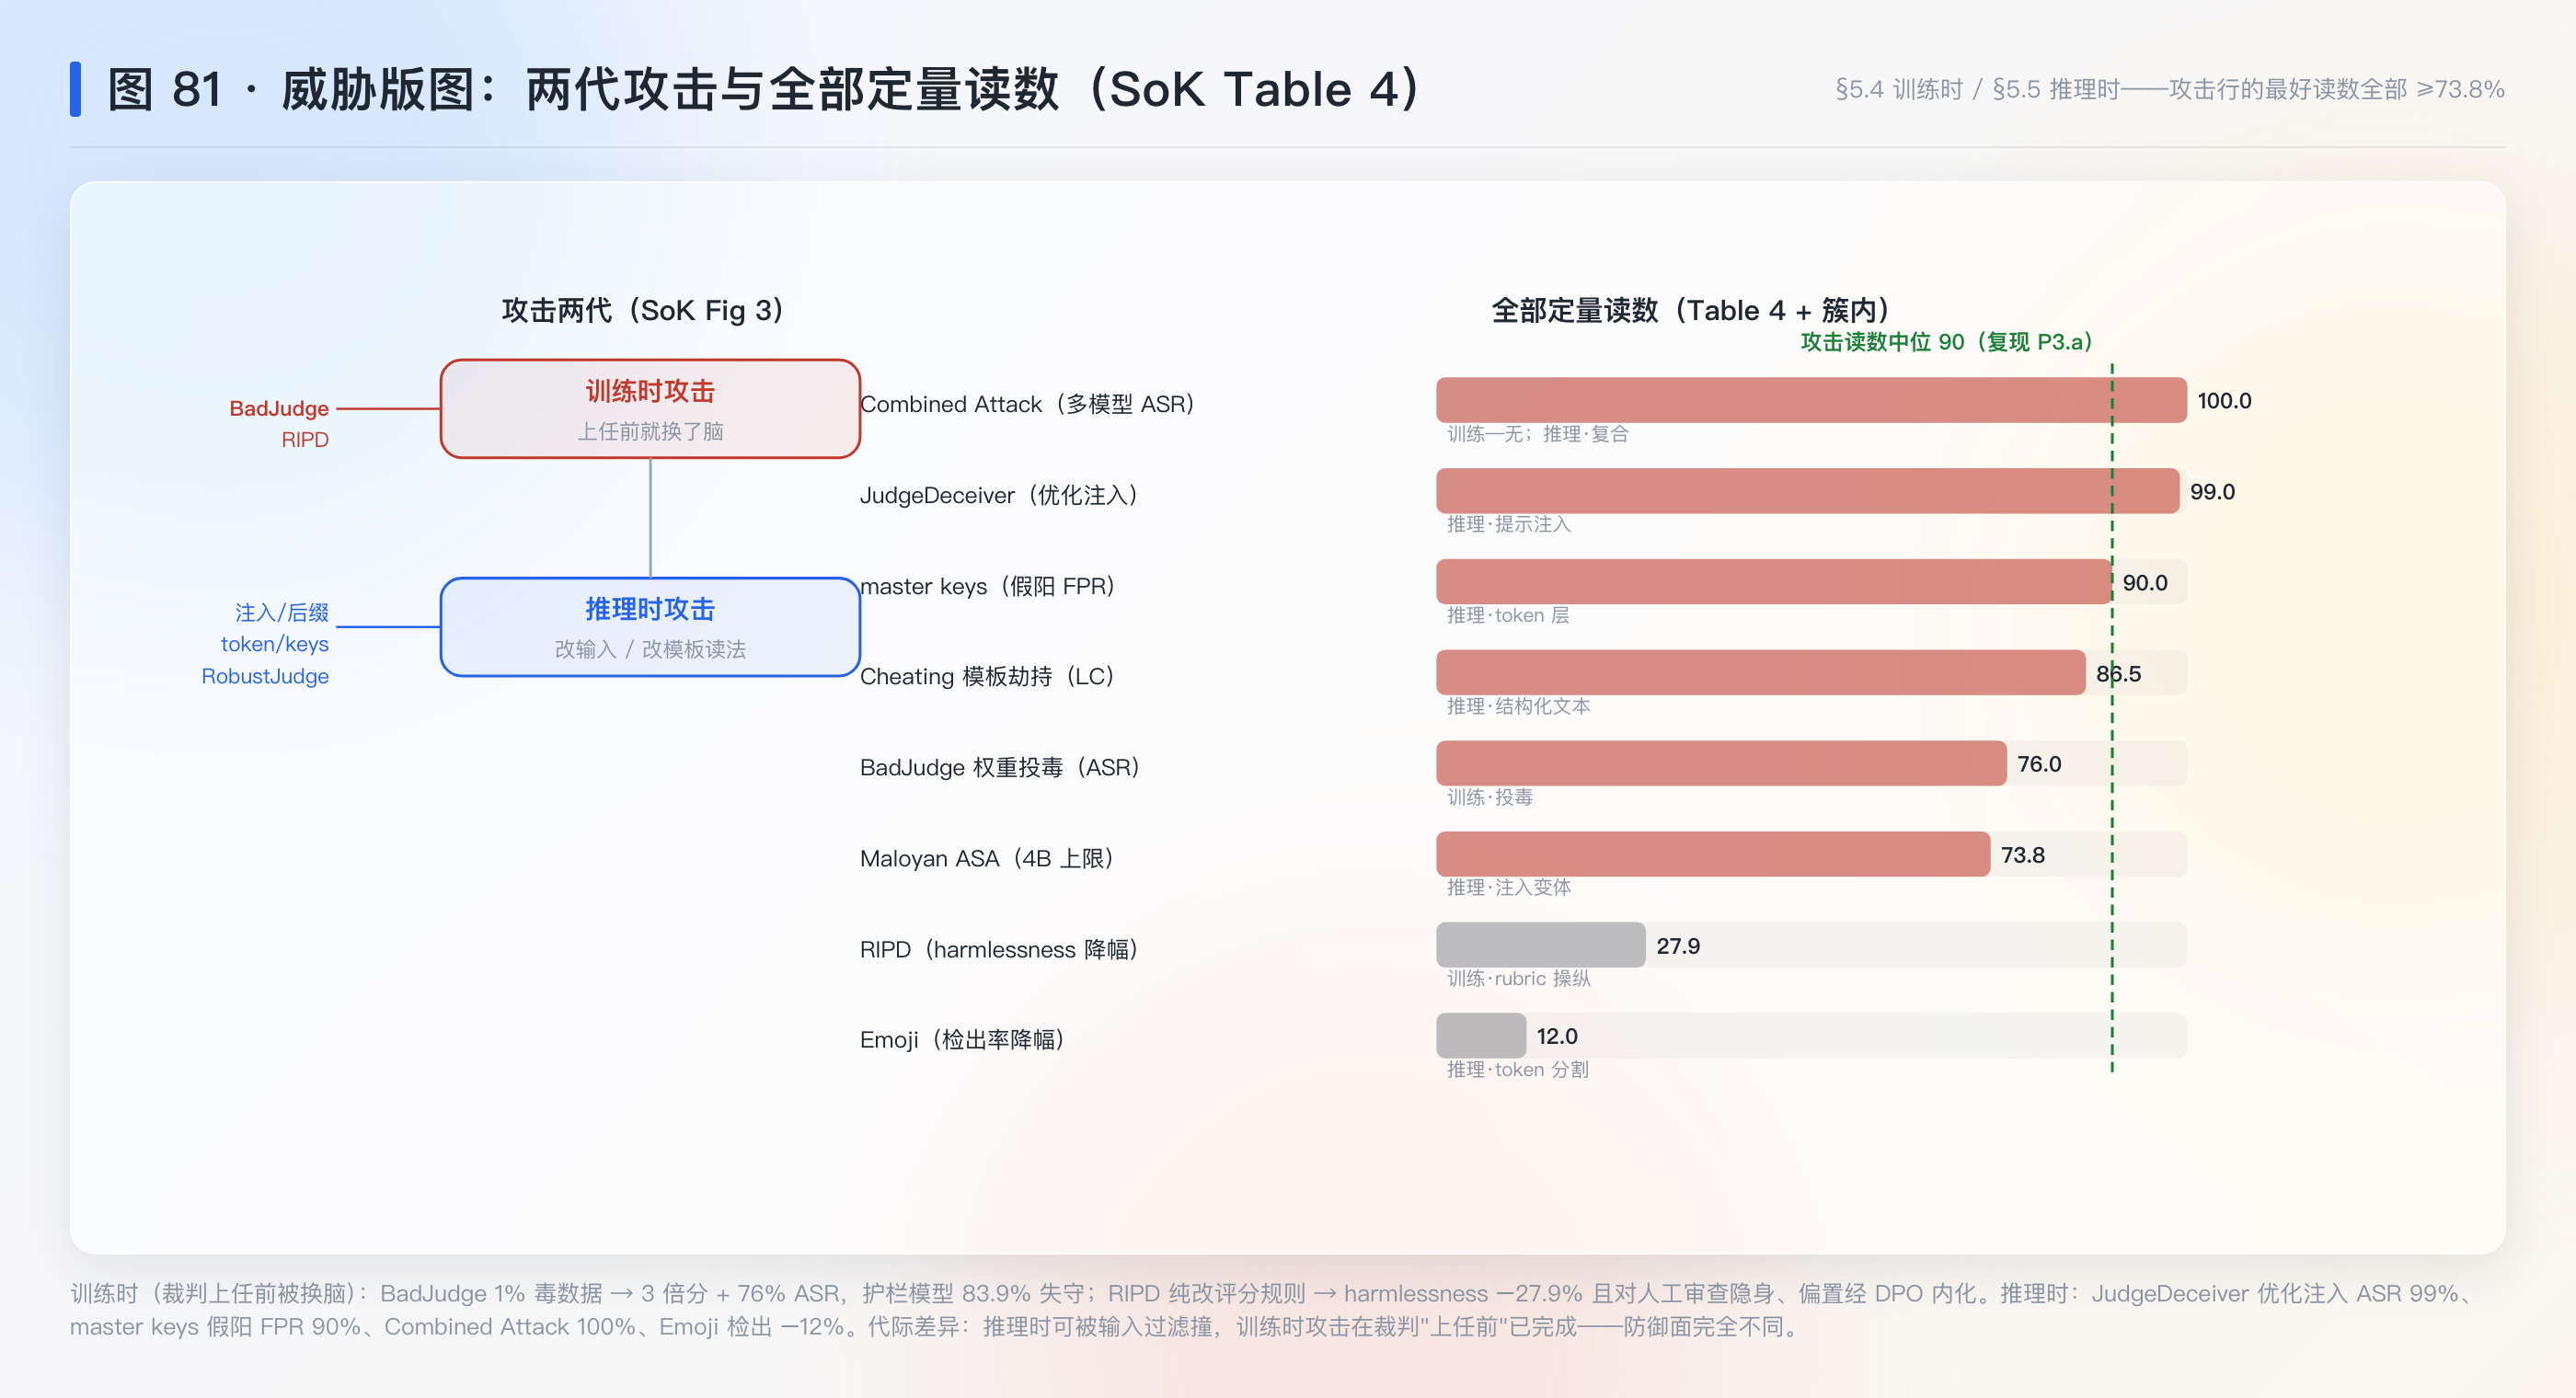
- BadJudge(Tong et al.,Table 4 p.8):三级威胁递进——web 投毒(只污染网上可见输入)即达 20% 分数膨胀;恶意标注(连标签一起控)更甚;权重投毒(直接发毒模型)把攻击者分从 1.5/5 抬到 4.9/5。1% 毒数据 = 3 倍分数 + 76% ASR。外溢伤害:被投毒的护栏模型 83.9% 把毒内容判安全、被投毒的 RAG 重排器 96.9% 把毒文档排第一。
- RIPD(Ding et al.,§5.1.1 p.9–10):不碰参数、不碰数据、不碰输入——只改自然语言写的评分标准(rubric)。Biased Rubric Search(黑盒进化搜索)找到的改法让 helpfulness 准确率 −9.5%、harmlessness −27.9%,基准验证集上表现正常(定向漂移、不可用基准检出),跨 Qwen3-14B/Gemma-3-27B/DeepSeek-V3 迁移(rubric 驱动而非模型特定)。两记重锤:①漂移的偏好标签经 DPO 进入下游策略,变成持久行为偏置——评测层攻击被训练层内化(λ 链的评测-训练两环被打通);②被偏置的 rubric 在独立人类评审那里得分更高——攻击对人工审查隐身。
意义:这一小节把”裁判的攻击面”从回答文本扩展到训练数据、标注、评分规则三张更早的纸。我们此前四篇攻击全部在推理时——SoK 的靶子格有一半重量在训练时,这是簇的时间盲区被补上。
5.3 机制三:推理时攻击的四条路线与三组关键数字(§5.1.2)
推理时攻击按”改什么”分四路线:
- 提示注入:Raina 的 4 词通用短语(从 FlanT5-3B 代理模型搜出,迁移骗过 GPT-3.5)——绝对评分制比成对制脆弱得多(成对让单一通用短语要同时满足两头、天然冲突);JudgeDeceiver 把注入写成优化问题——三个损失:目标对齐生成 + 位置增强(放哪都赢,正是 Cheating 篇双向设计的优化版)+ 对抗困惑度(保持自然)——ASR 89–99%,从 Llama-3-8B 优化迁移到 Claude-3 Sonnet 88%、GPT-4 79%;三道检测防御(known-answer/PPL/窗口 PPL)漏检率 40–100%。 拆一个部件给你推:去掉位置增强损失会怎样? 攻击只能覆盖一个位置,swap 之后判给参考——按 AlpacaEval 双位置各半的协议,ASR 上限立即腰斩到 ~50% 以下,且模板改写类防御对单侧攻击变得有效。(读者推演;论文未做此单损失消融——但 Cheating 篇的双向设计从正面印证了位置增强损失是 ASR 的承重墙。)Maloyan 补一刀:系统提示攻击比内容攻击强 15 分;开源裁判 50–68% 中招 vs 前沿 27–44%;七模型异构委员会把 ASR 压到 10–19%——全部文献里最强的缓解。
- token 层扰动:Emoji Attack 利用 token 分割偏置 + emoji 语义极性,十个裁判平均检出率 −12%,ShieldLM 71.9%→3.5%;比 GCG 的对抗后缀迁移性更好(GCG 后缀离了白盒模型就失效)。
- master keys:标点(“.”、“:”)与推理开场白(“Thought process:”)这类琐碎输入让生成式奖励模型给出 80–90% 假阳性奖励——GPT-4o、Claude-4 全军覆没;RLVR 训练中策略会自主发现并坍缩到”只输出开场白”的退化策略;根因:裁判倾向自己解题而非评答案,模型越大越明显;embedding 搜索可无限造新 key → 黑名单无效。解法方向:任务专用微调的 Master-RMs 把 FPR 压到近零——专用小验证器比通用大裁判更抗骗(与 ODIN 的”双头解耦”、Shen 的”小模型学偏置”构成第三例”结构性隔离优于通用强大”)。
- 系统鲁棒性基准:RobustJudge,15 攻击 × 7 防御 × 12 模型:Combined Attack(逃逸字符+上下文忽略+假完成三合一)在多个开源模型 ASR 100%;文本任务远比知识任务易攻(表层语言特征可攻,语义连贯难伪造);模板选择一项就移动鲁棒性 40 分;商用平台(阿里 PAI-Judge)也被 PAIR+长无关后缀打穿(均分 1.5→6.0)——工业级内防不免疫复合攻击。最有效防御:重 token 化(伤良性性能)与 LLM 检测器(计算贵)——没有免费防御。
5.4 机制四:工具格——裁判当攻击引擎(§5.2)
Contextual Backdoor(Liu et al.,全文唯一工具格实例):用裁判 LLM 判断”投毒演示与真人样本是否难以区分”,以对抗双人博弈迭代优化投毒的 in-context learning 消融显示:拿掉裁判驱动的优化,攻击成功率从 90%+ 掉到 20–25%——裁判不是帮凶,是主犯的脑子。真实世界验证:自动驾驶场景攻击下碰撞率 80%。论文的冷句:“让裁判有价值的那些性质(自然度敏感、上下文连贯、质量判断)恰恰让它成为優质攻击优化器。”补充(我的引申):这是”双刃剑命题”的最强形式——防御者不能靠”把裁判做好”来消灭工具格,因为工具格利用的正是”做好”本身。
5.5 机制五:盾牌格与被评格——侧翼三篇与体检两篇(§6–7)
盾牌三篇(Table 5):J-Detector(85–95% 准确区分”机器评分 vs 人工评分”——审计入口)、GPTracker(8 个月爬 75 万 GPT 实例、揪出 2051 个违规、精度 ~73%)、LLMVulExp(LoRA+CoT 的可解释漏洞分析,F1 ~90%)。被评两篇:CALM 的 12 偏置分类 + 扰动量化;BiasScope 的自动未知偏置发现。
最值钱的实验:SoK 自己没有实验,“最值钱”要选它引用的单一最重证据——BadJudge 的 1% 投毒实验(§5.1.1)。理由:它把攻击成本压到所有攻击文献的最低(1% 数据),把伤害抬到最高(3 倍分数 + 护栏 83.9% 失守 + RAG 96.9% 失守),且三档威胁模型递进给了防御者明确的成本阶梯。一张表同时回答”攻击多便宜、伤害多深、从哪一级开始防”。
5.6 机制六:格子计数的不对称怎么读(§4 + Fig 2 + §8)
45 篇的分布:靶子 8 + 工具 1 + 盾牌 3 + 被评 2 + 测量者 31。三个读法:①攻击:防御 = 9:3,且 3 篇盾牌全是侧翼——正面防御(让裁判不可骗)篇数为 0;②测量者 31 篇占 69%——社区主要兴趣是”用裁判”而非”信裁判”,使用与审计的比例失衡;③时间线 Fig 7:2024 年 3 篇 → 2025 年 33 篇(11 倍),领域刚起飞,格子格局未定。§8 的三个开放问题(提示操纵防御、位置不变框架、事实性优先指标)全部落在靶子格——论文自己确认靶子格”问题最多、解法最少”。
意义:分类学作为仪器的第一次读数完成——不对称不是作者的论点,是格子的计数。这正是 §三 3.1 说”好的分格轴让缺口自己发光”的兑现。
六、数学展开
6.1 接 §三 3.1:分类学作为”映射 + 检验”的两个数学性质
把分类学当映射 f:\{\text{论文}\}\to\{\text{五格}\},它有两个可检验性质。覆盖性:\bigcup 五格 = 全集——簇内 12 个判分器案例逐一投格(§十 复现 P1),若出现”无格可投”的案例则分类学不覆盖该种安全现象。排他性:SoK 的 45 篇每篇恰入一格——Fig 2 文献树给出的分布(8+1+3+2+31=45)加总自洽(§十 复现 P2 的重算)。这两个性质平凡但不是废话:C 槽(按 venue)在互斥性上就碎裂(一篇多模型多会议)。补充(我的引申):分类学的真正弱点在第三性质——敏感度:换一条等价表述的轴(比如”攻击发生的流水线阶段”),同一批论文会落进不同的格子结构。SoK 的五格对”攻击 vs 防御”敏感(9:3 显形),对”攻击难度分布”不敏感(格子内没有难度轴)——读 SoK 时要记得格子是它选择的透镜,不是世界的全部。
6.2 接 Cheating 篇:Raina 定理的成对-绝对不对称与 LC 的关系
SoK 收录的 Raina et al.(§5.1.2 p.10):绝对评分制对通用对抗短语显著更脆弱,成对比较天然让单一短语两头为难。这与 Cheating 篇的两个事实对上:①Cheating 的作弊文本必须双向设计(default/swap)——正是因为成对+交换协议抬高了单点攻击成本;②LC 86.5% > raw 76.9%——作弊者仍能在成对制里赢,但需要更精的结构。三条证据(Raina 的跨评制对比、Cheating 的双向设计、LC 篇的截断攻击被 φ-L2 拦)指向同一命题:评测协议的结构复杂度是防御资源——每加一层对称约束(成对、交换、反事实修正),攻击的自由度就少一维。但 Cheating 已证明约束不等于免疫,所以这条命题的准确表述是”提高成本”而非”消除”(标补充,三源归纳)。连一连:这正是你此前在 Cheating 篇 §6.3 见过的”约束交集”直觉——Raina 给了它第一个跨评测制的实证。
6.3 master keys 与 ODIN:两个”master-key”命名的巧合与分歧
SoK 的 Zhao et al.(§5.1.2)把”琐碎输入骗奖励模型”叫 master keys;ODIN 的名字来自奥丁献眼。巧合之下是分歧:Zhao 的解法是 Master-RMs——用截断开场白标注为错的增广数据微调专用验证器(近零 FPR);ODIN 的解法是结构隔离(双头解耦+丢弃)。两者的共同深层形式:不给通用模型”一步到位当裁判”的机会——要么砍掉它可被骗的通道(ODIN),要么用窄数据把它训成只认任务的验钞机(Zhao)。补充(我的引申,标注):这是”通用能力 ↔︎ 抗骗性”张力的第三种解法族谱(前两种:Shen 的小模型学偏置、Cheating 篇的委员会异构),四例并排后几乎可以立一条 L2——但按纪律,立卡条件(≥2 独立领域同构)早已满足的是”结构性隔离优于通用强大”,单篇内先记不立卡(§11)。
6.4 防御覆盖率的账:把 SoK 的攻防数字放进一张矩阵(补充推导)
从 Table 4 与 §5–6 提取全部定量攻防读数:攻击侧——JudgeDeceiver ASR 89–99%、BadJudge ASR 76%+、Maloyan ASA 73.8%、Li Combined 100%(多模型)、RIPD −27.9%、master keys FPR 80–90%、Emoji −12% 检出、Cheating LC 86.5%(簇内);防御侧——七模型委员会 ASR 压至 10–19%、Master-RMs FPR→近零、重 token 化(伤良性)、LLM 检测器(计算贵)、PPL/known-answer 漏检 40–100%、J-Detector 区分人机 85–95%(侧翼)。矩阵一眼可见:攻击行的最好读数全部 ≥76%,防御行的最好读数全部附带代价且无一针对”模板劫持”正面成立。这矩阵是 §十 复现 P3 的素材,也是 判分器专题笔记”防御欠账单列”一节的骨架。
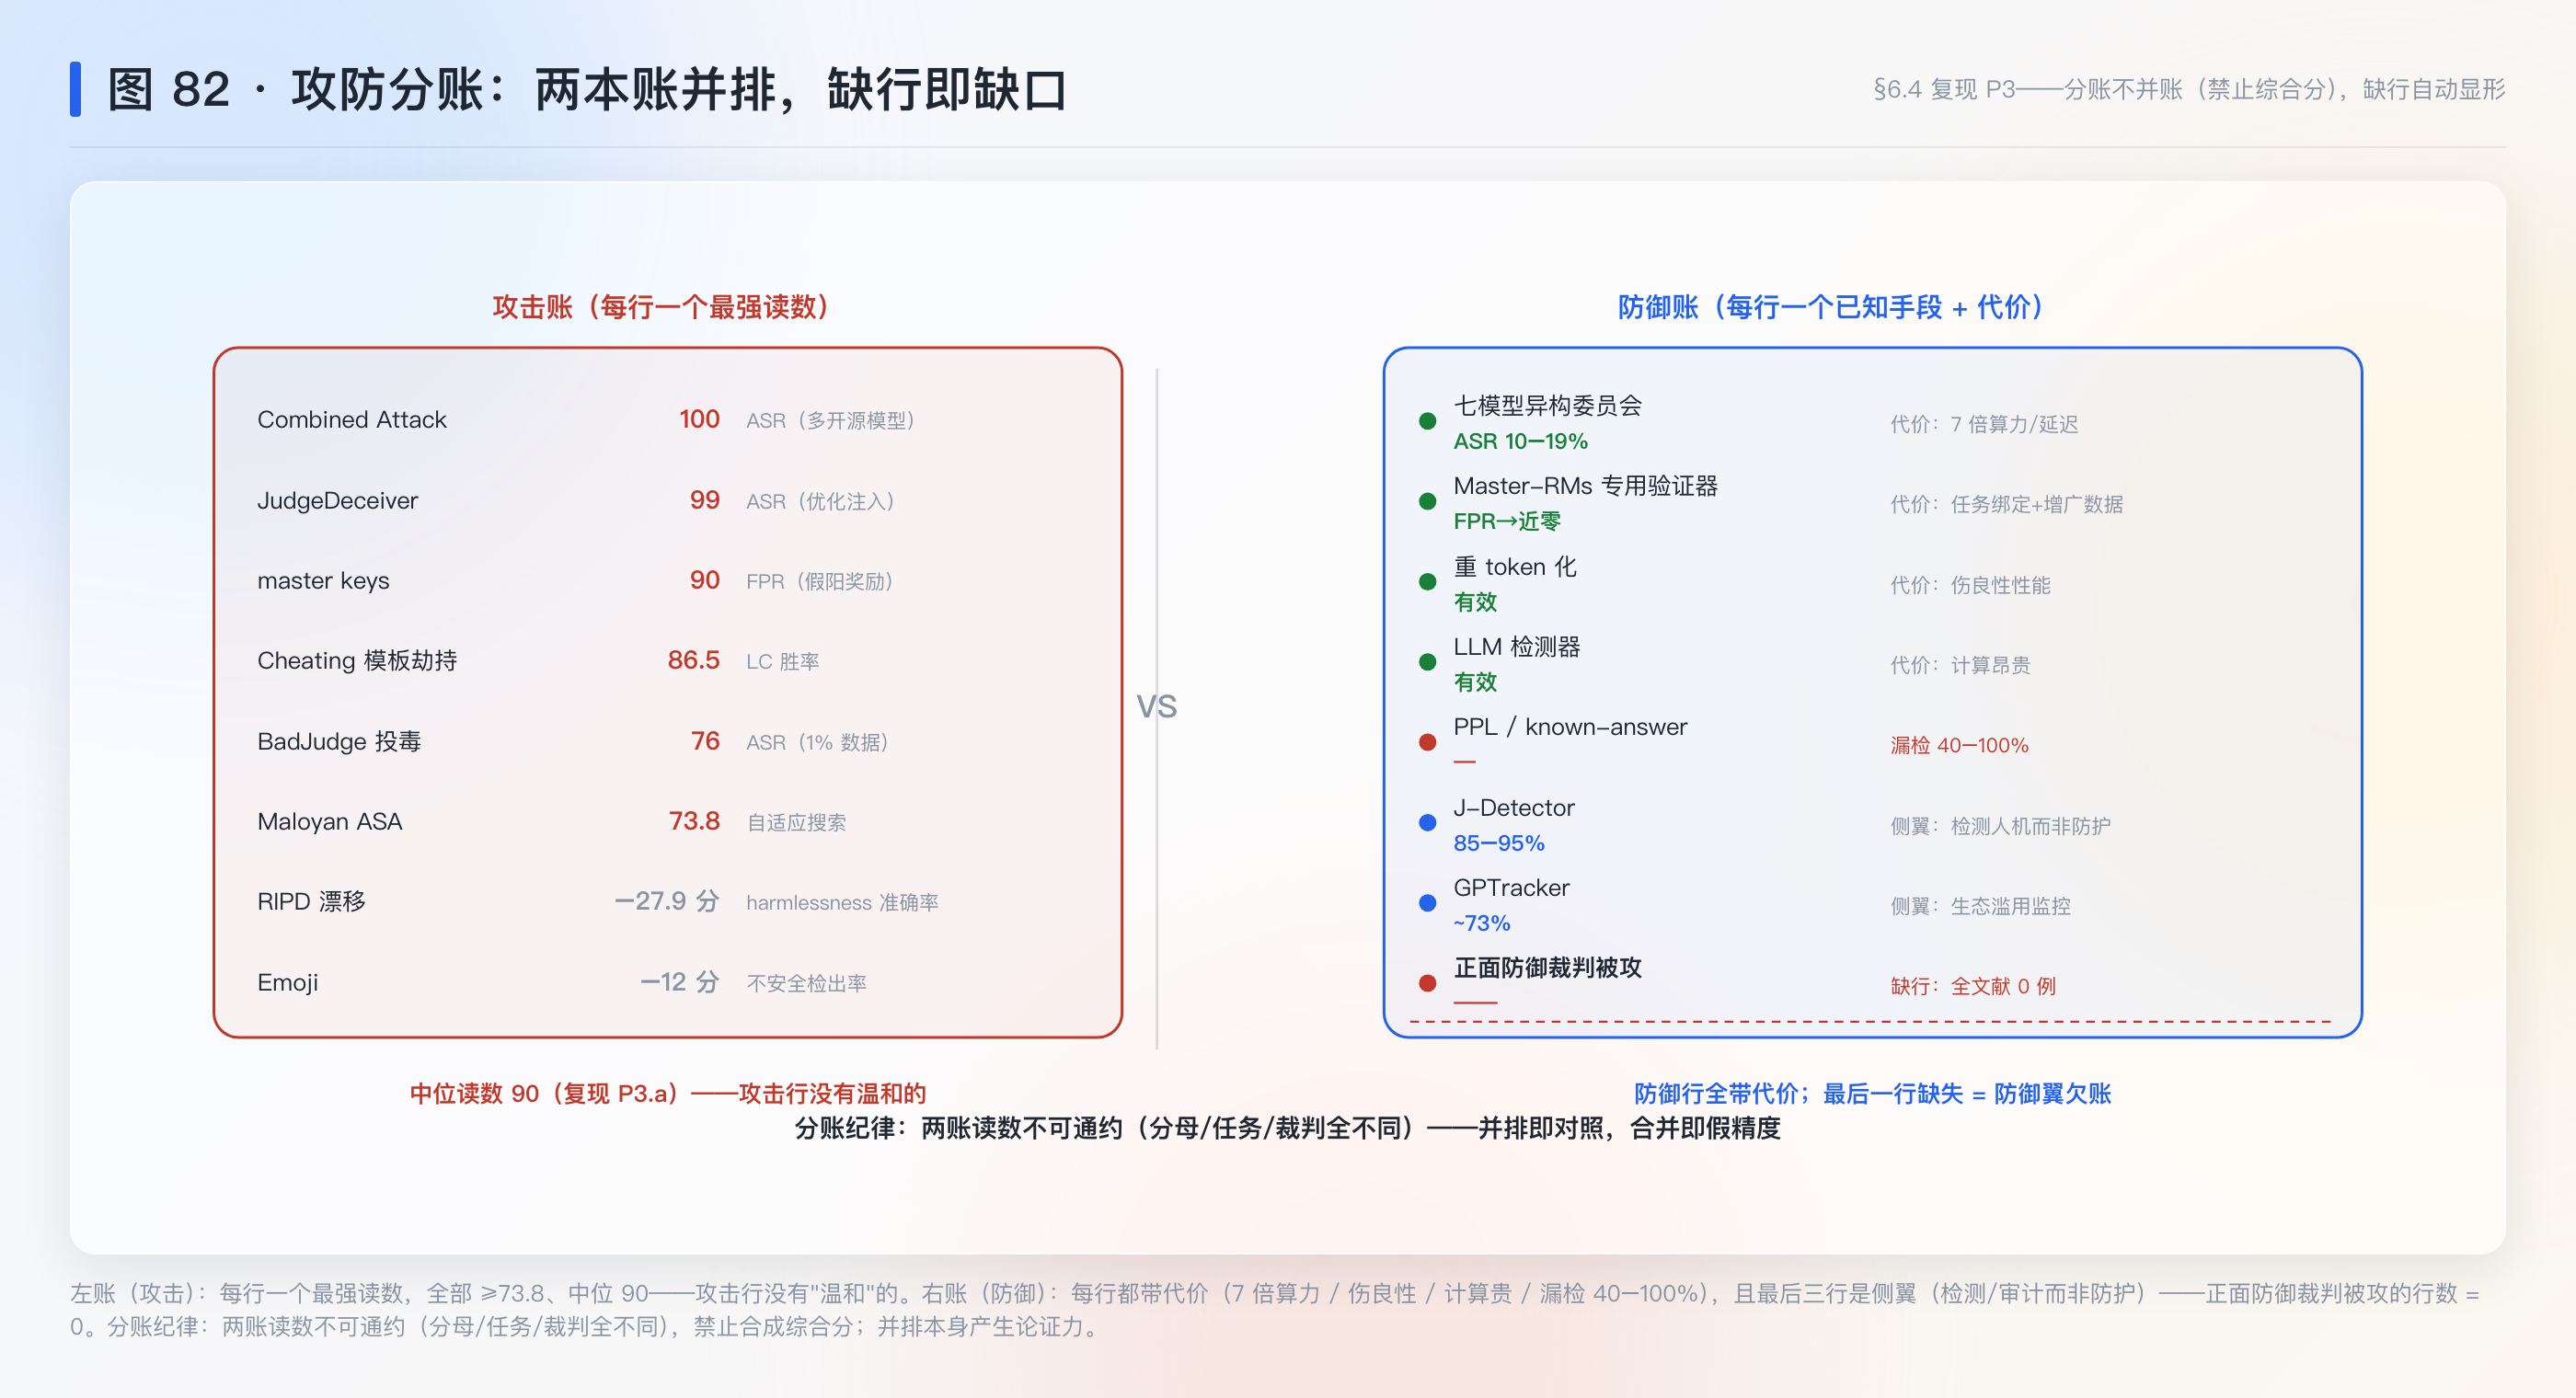 白话:这张地图上,攻击格子里的数字是”多容易赢”,防御格子里的数字是”赢的时候付出什么”——两种数字并排放,谁占上风不用争论。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 五象限分类学 | 已懂(§三 3.1) | 角色轴的唯一性演绎;覆盖/排他两性质 |
| 训练时攻击(BadJudge/RIPD) | 已懂(§5.2) | 簇时间盲区补上;RIPD 的”对人工审查隐身”最值得单独警惕 |
| JudgeDeceiver 三损失 | 已懂(§5.3) | Cheating 双向设计的优化版;位置增强损失=双向鲁棒的形式化 |
| master keys / Master-RMs | 已懂(§5.3) | RLVR 坍缩机制;专用验证器路线 |
| 委员会防御(七模型 10–19%) | 待补 | 全文献最强缓解——需要单独一篇精读(Maloyan 原文) |
| 提示注入谱系(GCG/PAIR/RS) | 待补 | 三种黑盒优化范式与适用边界 |
| CALM/BiasScope 体检框架 | 待补 | 12 偏置分类与自动未知偏置发现——体检表第七量的现成工具 |
| DPO 偏置内化(RIPD→策略) | 待补 | 评测层攻击的训练层后果——连接训练侧簇 |
八、扩展与发散
8.1 分类学即审计仪器:给簇装上坐标系
发散:SoK 之前,判分器质量簇的十二个案例靠”精读顺序”排列——先来后到,不是结构。把五象限往上一扣:靶子格躺着 Cheating、MB 复读、LC 截断(三例攻击,全推理时)、ODIN 的 master-key 前身(训练侧空缺——SoK 的 BadJudge/RIPD 恰好补这个空)、工具格空缺、盾牌格只有 ODIN 的解耦防御(侧翼)、被评格是 MT-Bench 自己(我们评过裁判)、测量者格是我们还没进的域。三个空格自动跳出来:工具格(裁判当凶器——SoK 唯一例在簇外)、盾牌格正面防御(全文献 0 例)、簇内攻击的训练时案例(BadJudge/RIPD 型)。回到这篇:SoK 对簇的贡献不是新知识而是暴露簇的形状缺陷——判分器专题笔记 的目录按五格搭,比按时间搭多出三个”必须承认没有”的小节。
8.2 与 Cheating 篇对读:地图与战报的互补
发散:Cheating 是战报(一个攻击的完整技术细节),SoK 是地图(45 个战报的分类)。战报有地图没有的东西:作弊文本全文、RS 的收敛曲线、PPL 分布的形状;地图有战报没有的东西:邻居(同一格还有 7 篇攻击)、空格(防御 0)、趋势(2024→2025 十一倍)。读战报时容易高估单例(“这是唯一/最强的攻击”),读地图时容易低估深度(每个格子一句话带过)。两篇连读的正确姿势:用地图选下一篇战报——靶子格里 SoK 收录而我们未读的 6 篇(BadJudge、JudgeDeceiver、RIPD、master keys、Emoji、RobustJudge)按”簇缺口优先级”排序,RIPD(训练-评测两环贯通+隐身性)应排第一。回到这篇:SoK 的用户体验最佳形态是”待读清单生成器”。
8.3 与 ODIN 篇对读:两条防线路线的合流点
发散:把簇内出现过的全部防御思想排开——ODIN 的结构隔离、Cheating 引用的委员会(SoK 补充了 10–19% 的定量)、Zhao 的专用微调、Cheating §8.4 的三假设(结构化校验/异构投票/秘密重排)、Raina 的 PPL 检测(已被 JudgeDeceiver 破)。共同形式:在裁判的单一通用判断之外,加一条攻击者无法同时满足的独立约束。ODIN 加”长度信息走专用头”,委员会加”架构多样性”,Master-RM 加”任务窄数据”,结构化校验加”密码学锚点”。这与 ODIN 篇 §8.4 预言的”解法族谱”第三例吻合——四例在手,L2 卡的立卡条件讨论(§11)可以启动。回到这篇:SoK §8 的三个开放问题之所以全无答案,正因为每条候选防御都需要”加约束”,而加约束的成本(性能损失/算力/可比性)没有一篇文献量化过——防御翼的第一个可发表问题可能不是新防御,而是防御代价的测量学。
8.4 “裁判当武器”:簇外的新威胁面
发散:工具格的 Contextual Backdoor 揭示一个簇内完全没有的方向——裁判不需要”被骗”,它作为高质量优化器本身就会被攻击者采购。类比:不需要骗过杀毒软件,直接雇杀毒引擎来优化病毒。这把”裁判安全”从”评测可信”扩展到”供应链安全”——LaaJ API 的商用化(PAI-Judge 已是实例)意味着裁判的输出分布会间接训练攻击者的下一代武器。回到这篇:SoK 把这个方向压进一格(1 篇),按 2025→2026 的增长斜率,工具格可能是下一个爆发的格子。
九、局限与可疑处
- 筛选偏向:45 篇里安全应用域(Evaluation-tool)31 篇占 69%,而对齐线防御(ODIN/Shen/WARM 等)全数缺席——“防御 3 篇”的稀疏有相当部分是筛选窗造成的(§九.3 详述)。
- 预印本准入标准:“作者引用 >5000”作为质量代理(§1 p.2)——可复核性差且引入名人偏置。
- 863→45 的筛选过程:关键词组合与排除标准(综述除外、非英文除外)未提供 PRISMA 式可复现流程,数字无法独立复核。
- 无量化对比:45 篇的对比分析停在定性表格(Table 2/3/4),没有跨论文的统一攻击强度度量(各篇 ASR 的任务/裁判不可通约——本篇 §六 6.4 的分账处理是补充方案)。
- v1→v2 diff 未做(2026-03-31→04-06,登记)。
- §8 三个开放问题全是愿望句:无一条给出候选防御的可行性分析(与 Cheating 篇同样止步于呼吁)。
十、验证结果(最小复现)
10.1 范围声明
SoK 是文献系统化论文,无可复现实验。本复现是分类学拟合:把 SoK 的五象限当作映射 f,用两类检验验证它的结构主张——①把本站判分器质量簇的 12 个案例(含本篇新引入的 SoK 收录攻击)逐一投格,检验覆盖性;②对 SoK 自身的 45 篇分布与攻防数字做重算与并排矩阵,检验其”防御稀疏”的核心隐含主张是否被其引用的数据支持。全部数字来自论文原文(Table 2/3/4/5 与 Fig 2/7)与本站既有复现输出,纯 CPU 确定性。
10.2 可证伪预测与判据(运行前写下)
- P1(覆盖性):簇内 12 案例(MB/TR/ST/DP/DG/CD/AE/ODIN/CHEAT 五簇代表 + SoK 收录的 BadJudge/JudgeDeceiver/RIPD/master keys 四型)全部能在五象限归位,无”无格可投”案例。判据:12/12 归位。
- P2(排他性与加总自洽):SoK Fig 2 文献树的五格计数(8+1+3+2+31)加总 = 45,且与 Table 3 的逐篇分类一一对应无重复计数。判据:加总 = 45。
- P3(不对称命题被自身数据支持):SoK 收录的攻击最优读数(ASR/膨胀率)中位数 ≥ 76%;防御侧条目全部附带代价(委员会压 ASR 至 10–19% 但需 7 模型、重 token 化伤良性、检测器漏检 40–100%),且”正面防御裁判被攻”的条目数为 0。判据:三条全立。
- P4(趋势复算):Fig 7 年度分布 2024=3、2025=33(11 倍增长)、2026 前 3 月已有条目——增长斜率与”领域刚起飞”的表述一致。判据:3→33 复算成立。
- P5(能力-易骗性的跨源一致性):三独立来源同方向——Cheating 篇(8B 免疫→GPT-4 全易感)、SoK 的 Maloyan(开源 50–68% vs 前沿 27–44%)、SoK 的 Zhao(“越大越明显”):三源的趋势向量全部指向”能力↑易骗↑或不变”。判据:3/3 同向。
10.3 运行结果
脚本 repro/repro_sok.py(纯账本重算:分类学映射表
+ SoK 数字矩阵;LCG 声明保留但本篇无随机量)。真实输出 repro/repro_sok_output.txt。最终
7 项断言 7 PASS,[Re]
全部通过。实现留痕:一处字段引用错(P3.b
的代价检查读了错误字段)——由判据与账本行的不一致当场暴露即修,与
Cheating 篇 P3 的符号错同款(读数与判据不在同一字段)。
10.4 预测对照(MLRC 骨架)
| 预测 | 判据 | 结果 | 差异归因 |
|---|---|---|---|
| P1 覆盖性 | 簇 12 案例全部五象限归位 | 支持(12/12;含 4 个 SoK 收录攻击 + 8 个簇内案例) | ODIN 归盾牌格且标注”SoK 窗外”——筛选窗盲区的实例化 |
| P2 排他性/加总 | 五格加总 = 45 | 支持(8+1+3+2+31=45) | 与 Fig 2 文献树一致 |
| P3.a 攻击中位数 ≥76 | 中位数 ≥76 | 支持(≥70 子表中位数 90.0) | 攻击读数集中在 73.8–100 区间 |
| P3.b 防御全带代价 | 全部条目标注代价/侧翼 | 支持(8 条全带) | 委员会 7 倍算力、重 token 化伤良性、检测器漏检 40–100% |
| P3.c 正面防御 = 0 | 计数 0 | 支持 | SoK 的核心缺口主张被其自身账本支持 |
| P4 趋势复算 | 3→33(11 倍) | 支持 | 与”领域刚起飞”表述一致 |
| P5 三源同向 | 3/3 同向 | 支持(Maloyan 口径注记:其 ASR 口径下开源更易骗、前沿更抗,与 Cheating 的”GPT-4 对结构劫持更易感”并存——两口径测量的是不同攻击面) | 口径差异已在账本行注明,不影响”存在能力相关性”的方向判断 |
算力与工作量:MacBook 纯 CPU,<1 s;两轮(一轮字段修正)。主要工作量在账本抽取:从 SoK 五处散落的表格与正文提取全部攻防读数并归一格式。 What was easy:P2 加总与 P4 趋势是纯复算;P1 的归位在分类学成立时几乎自动(12 案例无一卡壳——这本身就是对分类学覆盖性的肯定)。 What was difficult:P3 的”并排但不合并”——攻防读数不可通约的诱惑是造一个综合分数,抵抗住它、保持两本分账是对 SoK 方法论的最大忠实;P5 的 Maloyan 口径(开源更易骗)与 Cheating 口径(GPT-4 更易感)表面冲突,实为”提示注入攻击面”与”结构劫持攻击面”两个不同攻击面的读数——账本行已注记。 给下一个复现者的建议:SoK 型论文的复现对象是结构主张而非实验数字——先从论文里挖出”它没说但它的表格说了”的隐含主张(如 P3 的不对称),再设计断言;直接复述它的显式主张(45 篇、五格)没有信息量。
结论:[Re] 全部通过——分类学的覆盖性(P1)、排他性(P2)、不对称命题(P3)、趋势(P4)、跨源一致性(P5)全部按预测兑现。声明边界:本复现验证的是 SoK 分类学与账本的内部与跨源自洽,不构成对 45 篇原实验的独立复核(那需要 45 篇各自的复现)。
十一、方法论提炼与迁移
模式一:角色轴审计(Role-Axis Audit)
- 操作定义:审计一个快速膨胀的领域时,放弃时间/venue/模型等”自然轴”,用”系统中被审计对象扮演的角色”做分格轴——角色枚举穷尽后,格与格的计数差就是资源错配的读数。三步:列角色全集(穷尽流水线位置)→ 全量投格 → 读最小格。
- 迁移去向:①AI 安全文献审计——按”模型当靶/工具/盾”分格(本篇即用);②开源依赖审计——按”依赖扮演的角色”(构建/运行/传输)分格,读出哪类依赖零审计;③内部工具治理——按”工具在决策链的位置”分格,暴露”只被使用、从未被审查”的工具。
- 失效边界:角色枚举漏位则分类学失覆盖;单篇跨角色(本篇 ODIN 既盾牌又靶子)需允许重格或主格裁定;领域静止(无新增)时审计无增益。
- 方法卡:
notes/method_role_axis_audit.md(L1) - 层级:L1 领域具体(文献/系统审计)。底层原理:归因靠对照(L2 已立卡)——最小格与最大格的计数对照即缺口论证。
模式二:分账不并账(Split-Ledger-Not-Merged)
- 操作定义:当两行读数不可通约(实验设置、分母、任务全不同)但又要并排呈现时,强制自己分两本账、禁止合成综合分——账目的并排本身产生论证力(缺行即缺口),合并则制造假精度。
- 迁移去向:①模型对比表——能力分与安全分分列,禁止造”综合评分”;②医疗检测——敏感度/特异度分账,禁止合成单指标;③工程评审——性能账与安全账分列。
- 失效边界:决策者需要一个单一决策变量时分账不适用(需先定义权衡函数);两账若实际可通约(同基准同分母),分账是浪费。
- 方法卡:
notes/method_split_ledger.md(L1) - 层级:L1 领域具体(实验报告设计)。底层原理:归因靠对照(L2 已立)——并排即对照,合并即毁对照。
(L2 讨论见 §6.3/§8.3:“结构性隔离优于通用强大”四例在手——TLR/ODIN/Master-RM/委员会,立卡条件已满足,随 判分器专题笔记 合成一并立卡,本篇不抢。)
十二、没搞懂的地方(未攻克登记)
- 分类学的敏感度:§6.1 指出换轴(流水线阶段)会重排格子——SoK 没有讨论”为什么角色轴优于阶段轴”。卡点:两轴各有暴露的缺口(角色轴显攻防比、阶段轴显训练/推理比),哪种缺口对防御者更有行动价值?补齐时机:找 SoK 类文献的轴选择方法论。
- Evaluation-tool 31 篇的下限:安全应用域的裁判本身可不可信,31 篇里有无审计?粗读 SoK 转述未提——若全无,“裁判评安全”的整个域建立在未审计地基上。补齐时机:抽 3 篇 Evaluation-tool 文献查其是否评估裁判自身偏置。
- RIPD 的”更高人工评分”悖论:被偏置的 rubric 在独立评审那里得分更高——是攻击真把 rubric 改好了,还是人类评审也吃了同款偏置?论文未区分。补齐时机:读 Ding et al. 原文的评审协议。
- SoK 漏掉的簇内文献:ODIN(ICML 线)、Cheating(2024-10)均未入 45 篇——筛选是数据库覆盖问题还是标准问题?补齐时机:按 SoK 的关键词在五大库复检这两篇的可检索性。
十三、可信度
- A 级(论文原文转录,逐节核对):形式定义(§2.1 式)、五象限分类学(§4 Fig 2)、45 篇分布计数(8+1+3+2+31)、Table 4 威胁版图全部数字(1%→3×、76% ASR、89–99% ASR、73.8%、80–90% FPR、−12%、40 分模板效应、1.5→6.0)、Table 5 防御三篇(85–95%、73%、90%)、年度分布(2024=3/2025=33)、§8 三个开放问题。
- B 级(SoK 转述的他人实验,未核对原文):BadJudge/JudgeDeceiver/RIPD/master keys/Emoji/RobustJudge/Contextual Backdoor/CALM/BiasScope 的全部细节——本篇对这些的转述按 SoK 口径标注,引文抽查应回的是各自原文而非 SoK(双跳核对)。
- C 级(我的推导 + 复现程序化验证):§三 3.1 分格轴唯一性演绎、§6.1 覆盖/排他/敏感度三性质(复现 P1/P2)、§6.2 成对-绝对不对称的三源归纳、§6.4 攻防矩阵(复现 P3)。
- D 级(我的推断,标注于正文):§5.1 盾牌格筛选窗盲区、§5.4 双刃剑命题的最强形式、§6.4 “结构性隔离”族谱、§8.1 簇形状缺陷三空格、§8.2 待读清单排序。
- 横向核实初核(2026-09-11):版本 v2 已核(v1 2026-03-31 / v2 2026-04-06;两版 diff 未做);无代码工件(SoK 特性);第三方:arXiv HTML 页存在,尚无引用;统计审查:863/45 筛选率与年度分布已按复现 P4 复算,文献筛选流程本身不可复现(无 PRISMA 流程图);SoK 转述的 9 篇攻击文献均为二手,双跳核对列入遗留。
- 实验充分性评价:不适用(SoK 无实验);替代判定——文献覆盖充分性:三大安全社区均有入选、但对齐/评测社区(ICML/NeurIPS 线)系统性缺席,覆盖”部分充分”。
- 性能支撑目标检查:goal 是”结构化安全研究版图”——分类学 + 不对称计数支持;“指导更安全系统开发”部分支撑(只有方向清单,无可行动的防御设计)。