外行导读(先读这个,再决定要不要进正文)
一个场景:你用强化学习训练一个会自己查资料的问答 agent——先写推理、调一次搜索、读完结果再作答。奖励只看最后一件事:答案对不对。训出来的东西很气人:模型学会了直接蒙答案,干脆不调用搜索工具。论文附录里的对照实验里,只拿终局对错当奖励的 GRPO,最后彻底不再调工具,exact match 掉到 0。不是它不知道搜索有用,而是”这一步搜得好”从来没人给它记过分——这点好处在终局的对错里被淹没了。
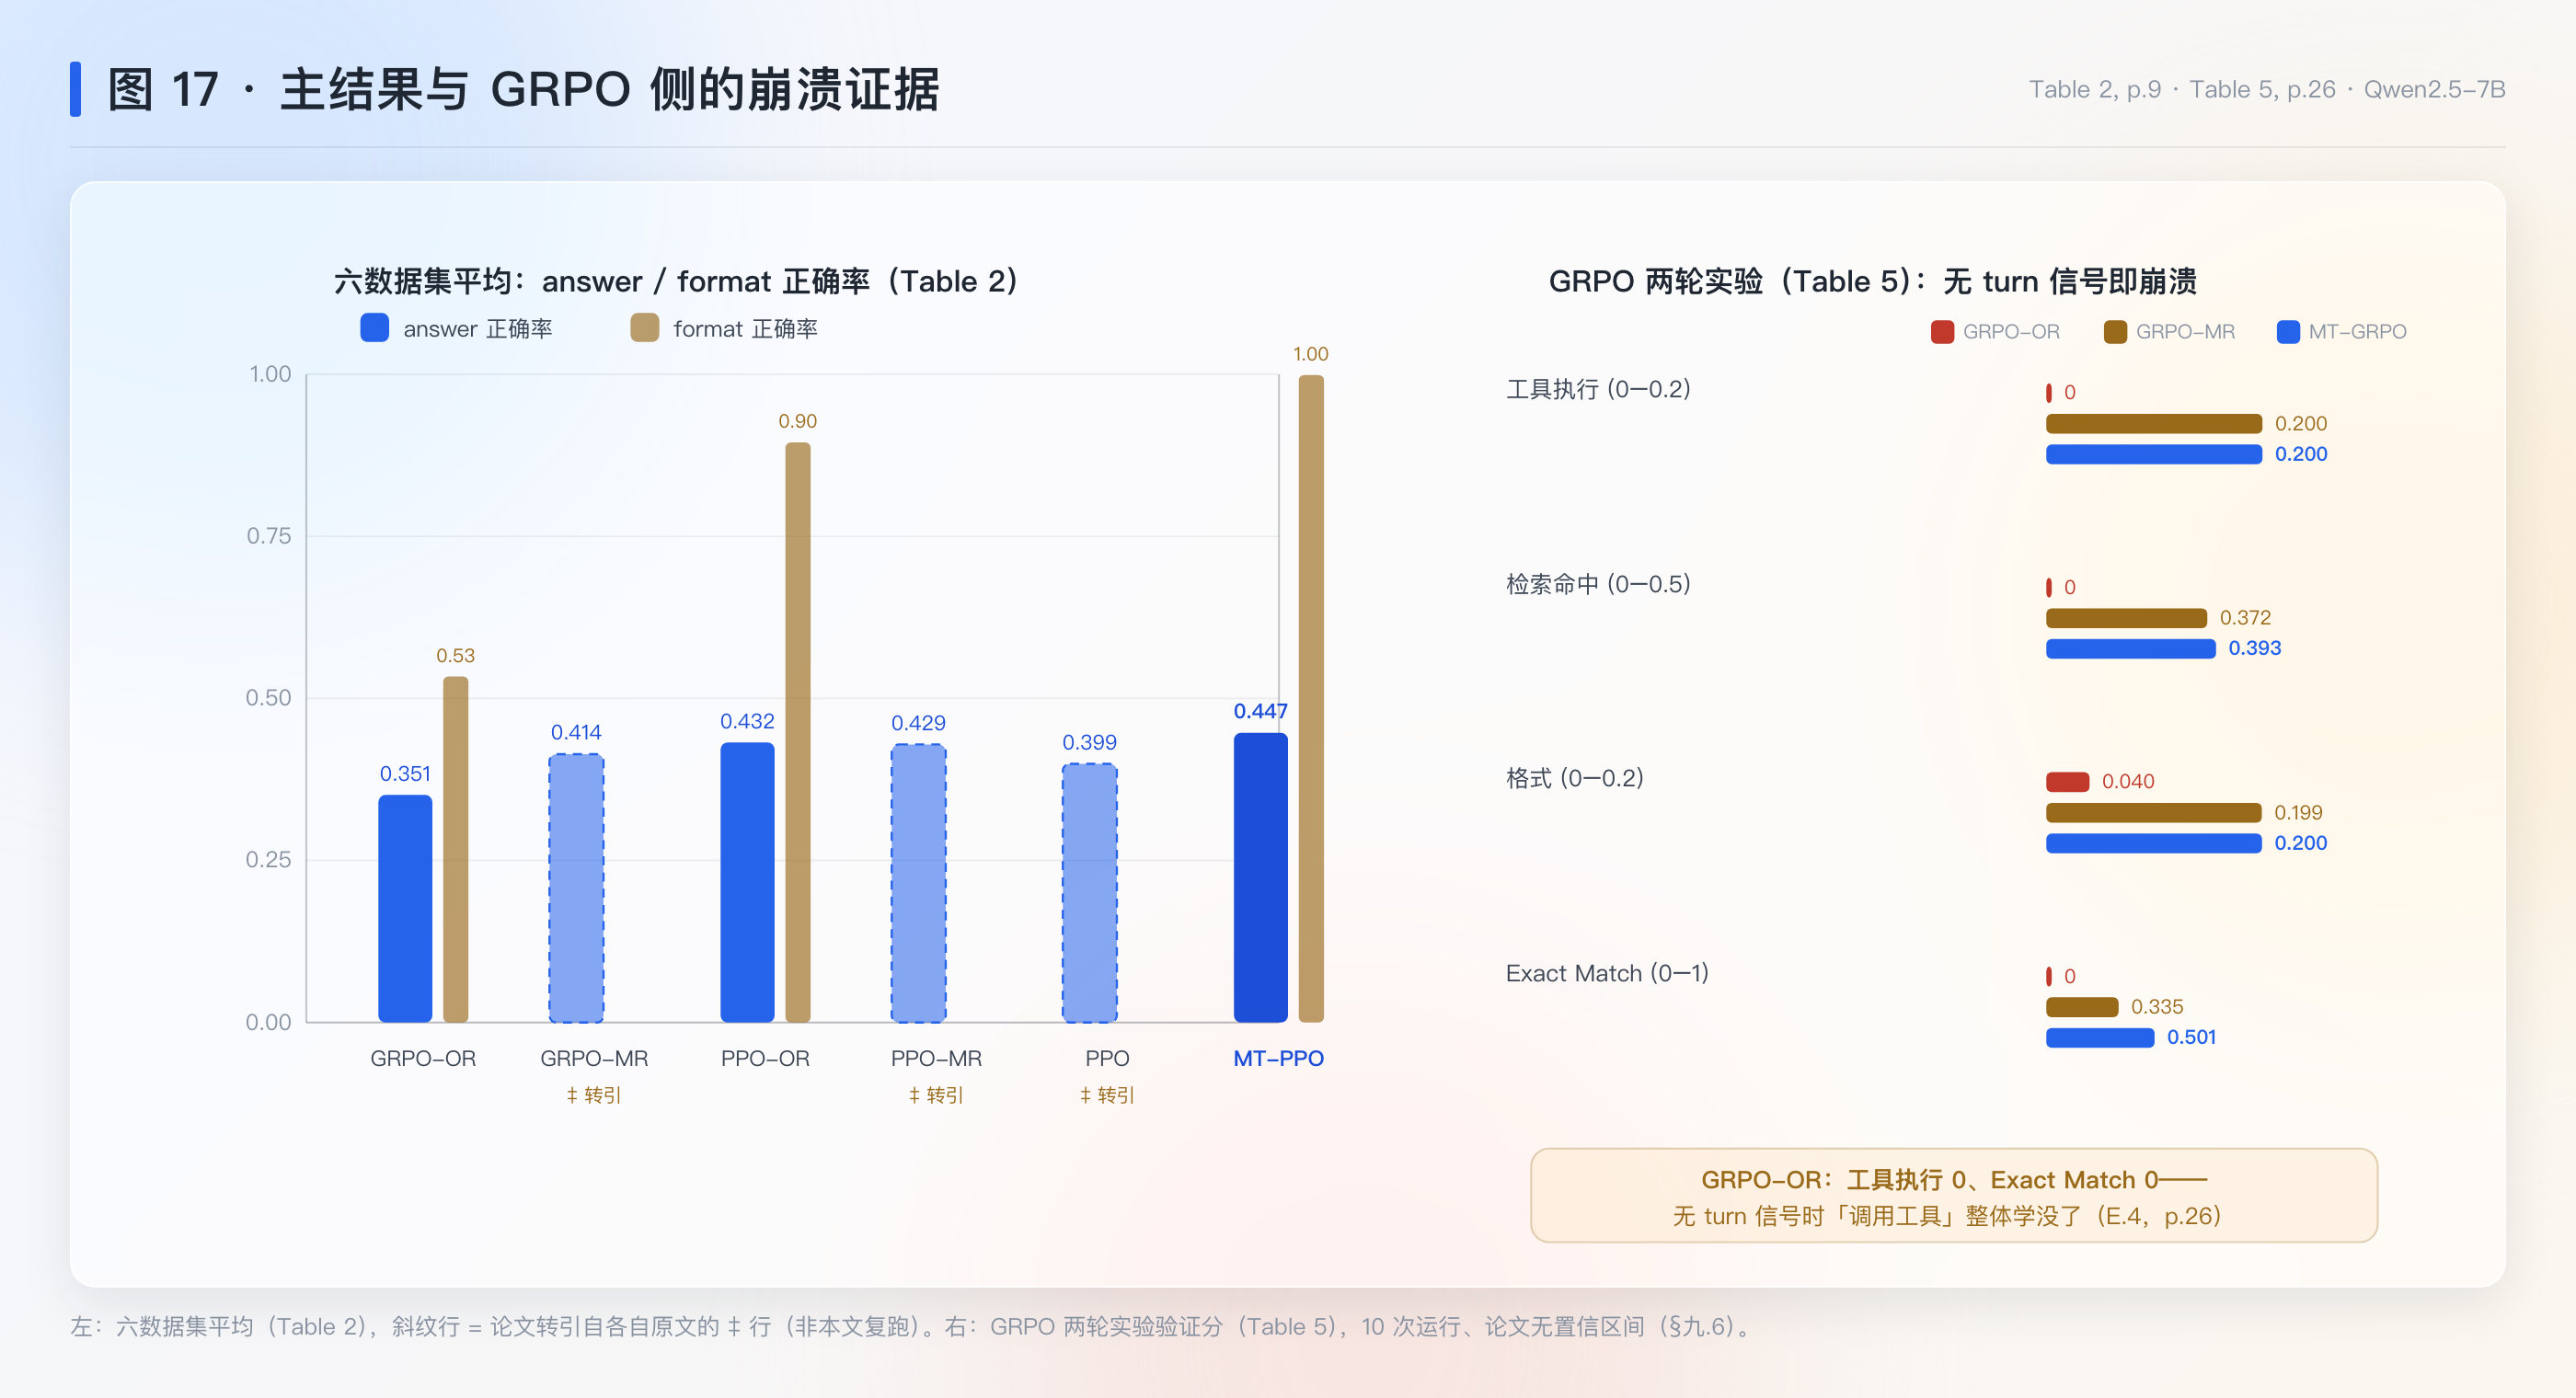
这篇论文干的事:把病根定位成一笔”粒度错配”的账——多轮交互明明是一轮一个决策,优势(每一步该往哪个方向改的信号)却是整条轨迹只算一个数。论文给出两条把账算细的路线:MT-GRPO,每轮的分数单独拿出来在同组里排名(纯,但要在每个状态重新采样,代价随轮数指数增长);MT-PPO,把每轮的分数贴在那一轮最后一个字上,让 critic 顺着序列把功劳摊回每个字(便宜,代价线性)。在搜索 agent 上实测,turn 级信号让模型在全部对比基准上排第一,format 正确率约 0.999。
为什么值得关心:这是一切”靠多步反馈改进的系统”的共同麻烦——只有总账、没有分账,你就不知道该奖励谁、该纠正谁。学生只看期末总分,永远不知道哪道题失了分;团队只看项目上线与否,复盘不出哪次评审救了场。把反馈信号放到与决策相同的粒度上,改进才有的放矢;而这篇还顺手算清了两件事:把账算细要付的代价(指数),以及怎么花小钱办成事(critic)。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| turn 级奖励 | 把”每一轮做得好不好”单独打分,而不是整条对话只打一个总分 |
| 轨迹级奖励 | 一整条对话从头到尾只有一个最终对错分 |
| 优势(advantage) | “这一步比同组平均好多少”的相对评分,决定该强化还是压制 |
| 组内标准化 | 同一道题采样一组回答互相比较,按”离平均几个标准差”打分 |
| MT-GRPO | 本文把 GRPO 扩成逐轮排名的版本:每轮分数单独组内标准化,未来轮按 α 折扣混入 |
| MT-PPO | 本文把 PPO 扩成逐轮贴奖励的版本:每轮分数贴在那一轮最后一个字上,critic 自动摊平 |
| GAE | PPO 算优势的方法:实际拿到的分数减去 critic 预估的分数,得出每一步的功过 |
| critic / 价值函数 V | 一个学习出来的”估分先生”,预估从当前位置到结束还能拿多少分 |
| GRPO-OR / GRPO-MR | 论文的对照组:OR 只看终局对错;MR 把中间分和终局分加总成一条总分 |
| reward hacking | 钻奖励规则的空子拿分,而不是真正把任务做好 |
§0 承接栏
这一篇,接的是 DAPO 留下来的一个根本问题:用强化学习训练大模型做长推理,为什么这么难? DAPO 给出的答案是四个工程细节,但有一层更深的东西它没有触及——GRPO 算法本身的结构性缺陷。这篇便从 GRPO 的目标函数出发,把毛病找到了两处藏在除法里的偏置上:一处除以回答长度,错误回答便越写越长——写得越长,摊到每个字上的惩罚越轻;另一处除以组内标准差,太容易和太难的题目反倒反过来主导训练方向。顺带,它还清了一桩悬了几篇的旧账——“KL 为什么关”:GRPO 实验同样 \beta=0(p.25),和 DAPO 一样。到这里,训练侧三篇连成一条线:算法有什么病(本篇诊断)→ 怎么修(DAPO 四旋钮 / SimpleTIR 删毒轨迹 / TARA 记账门)。
一、论文在解决什么问题
1.1 一个具体场景
你训练一个搜索 agent 回答”谁是那位把 26 名受害者埋在芝加哥地下室的名叫’小丑杀手’的连环杀手?“——这是附录 E.6 Table 6 里的一条真实 rollout(p.29)。正确行为是:第一轮写推理、调一次 Wikipedia 搜索,第二轮读检索结果、给出”John Wayne Gacy”。这个任务有两类可判分的信号:中间的(工具调用格式对不对、搜索结果里包不包含真答案)和终局的(答案对不对、格式对不对)。
现在用强化学习来训练它,病就显出来了。主流做法(Search-R1
一类)把整条轨迹当单步:只看最后的 <answer>
对不对,给一个 0/1,套 GRPO 或 PPO
更新。论文指出这有两个层次的病(§1,p.1–2):
- 单轮形式化丢结构:多轮交互被当成 contextual bandit——整条轨迹一个决策、一个奖励,中间”搜得好不好”完全没有评价(§1,p.1–2;§2,p.3)。
- 合并奖励丢粒度:另一些工作确实收集中间信号,但把中间奖励和终局奖励加总成一条轨迹级总分再喂给 GRPO/PPO——“这一步好”的信息被稀释进总分,优势估计仍然分不清功劳归哪一轮(§1,p.2:they merge outcome and intermediate rewards into a sparse trajectory-level signal)。
病不只在纸面上,后果有实证:搜索任务里”早期查询选得好不好”决定检索质量,没有 turn 级反馈,agent 学不会哪些查询 contributing(§1,p.2);更狠的样例在附录 E.4——只拿终局奖励训练的 GRPO-OR,最后彻底不调用搜索工具,exact match 掉到 0(p.26,Table 5)。
1.2 论文对现状的定位:粒度表
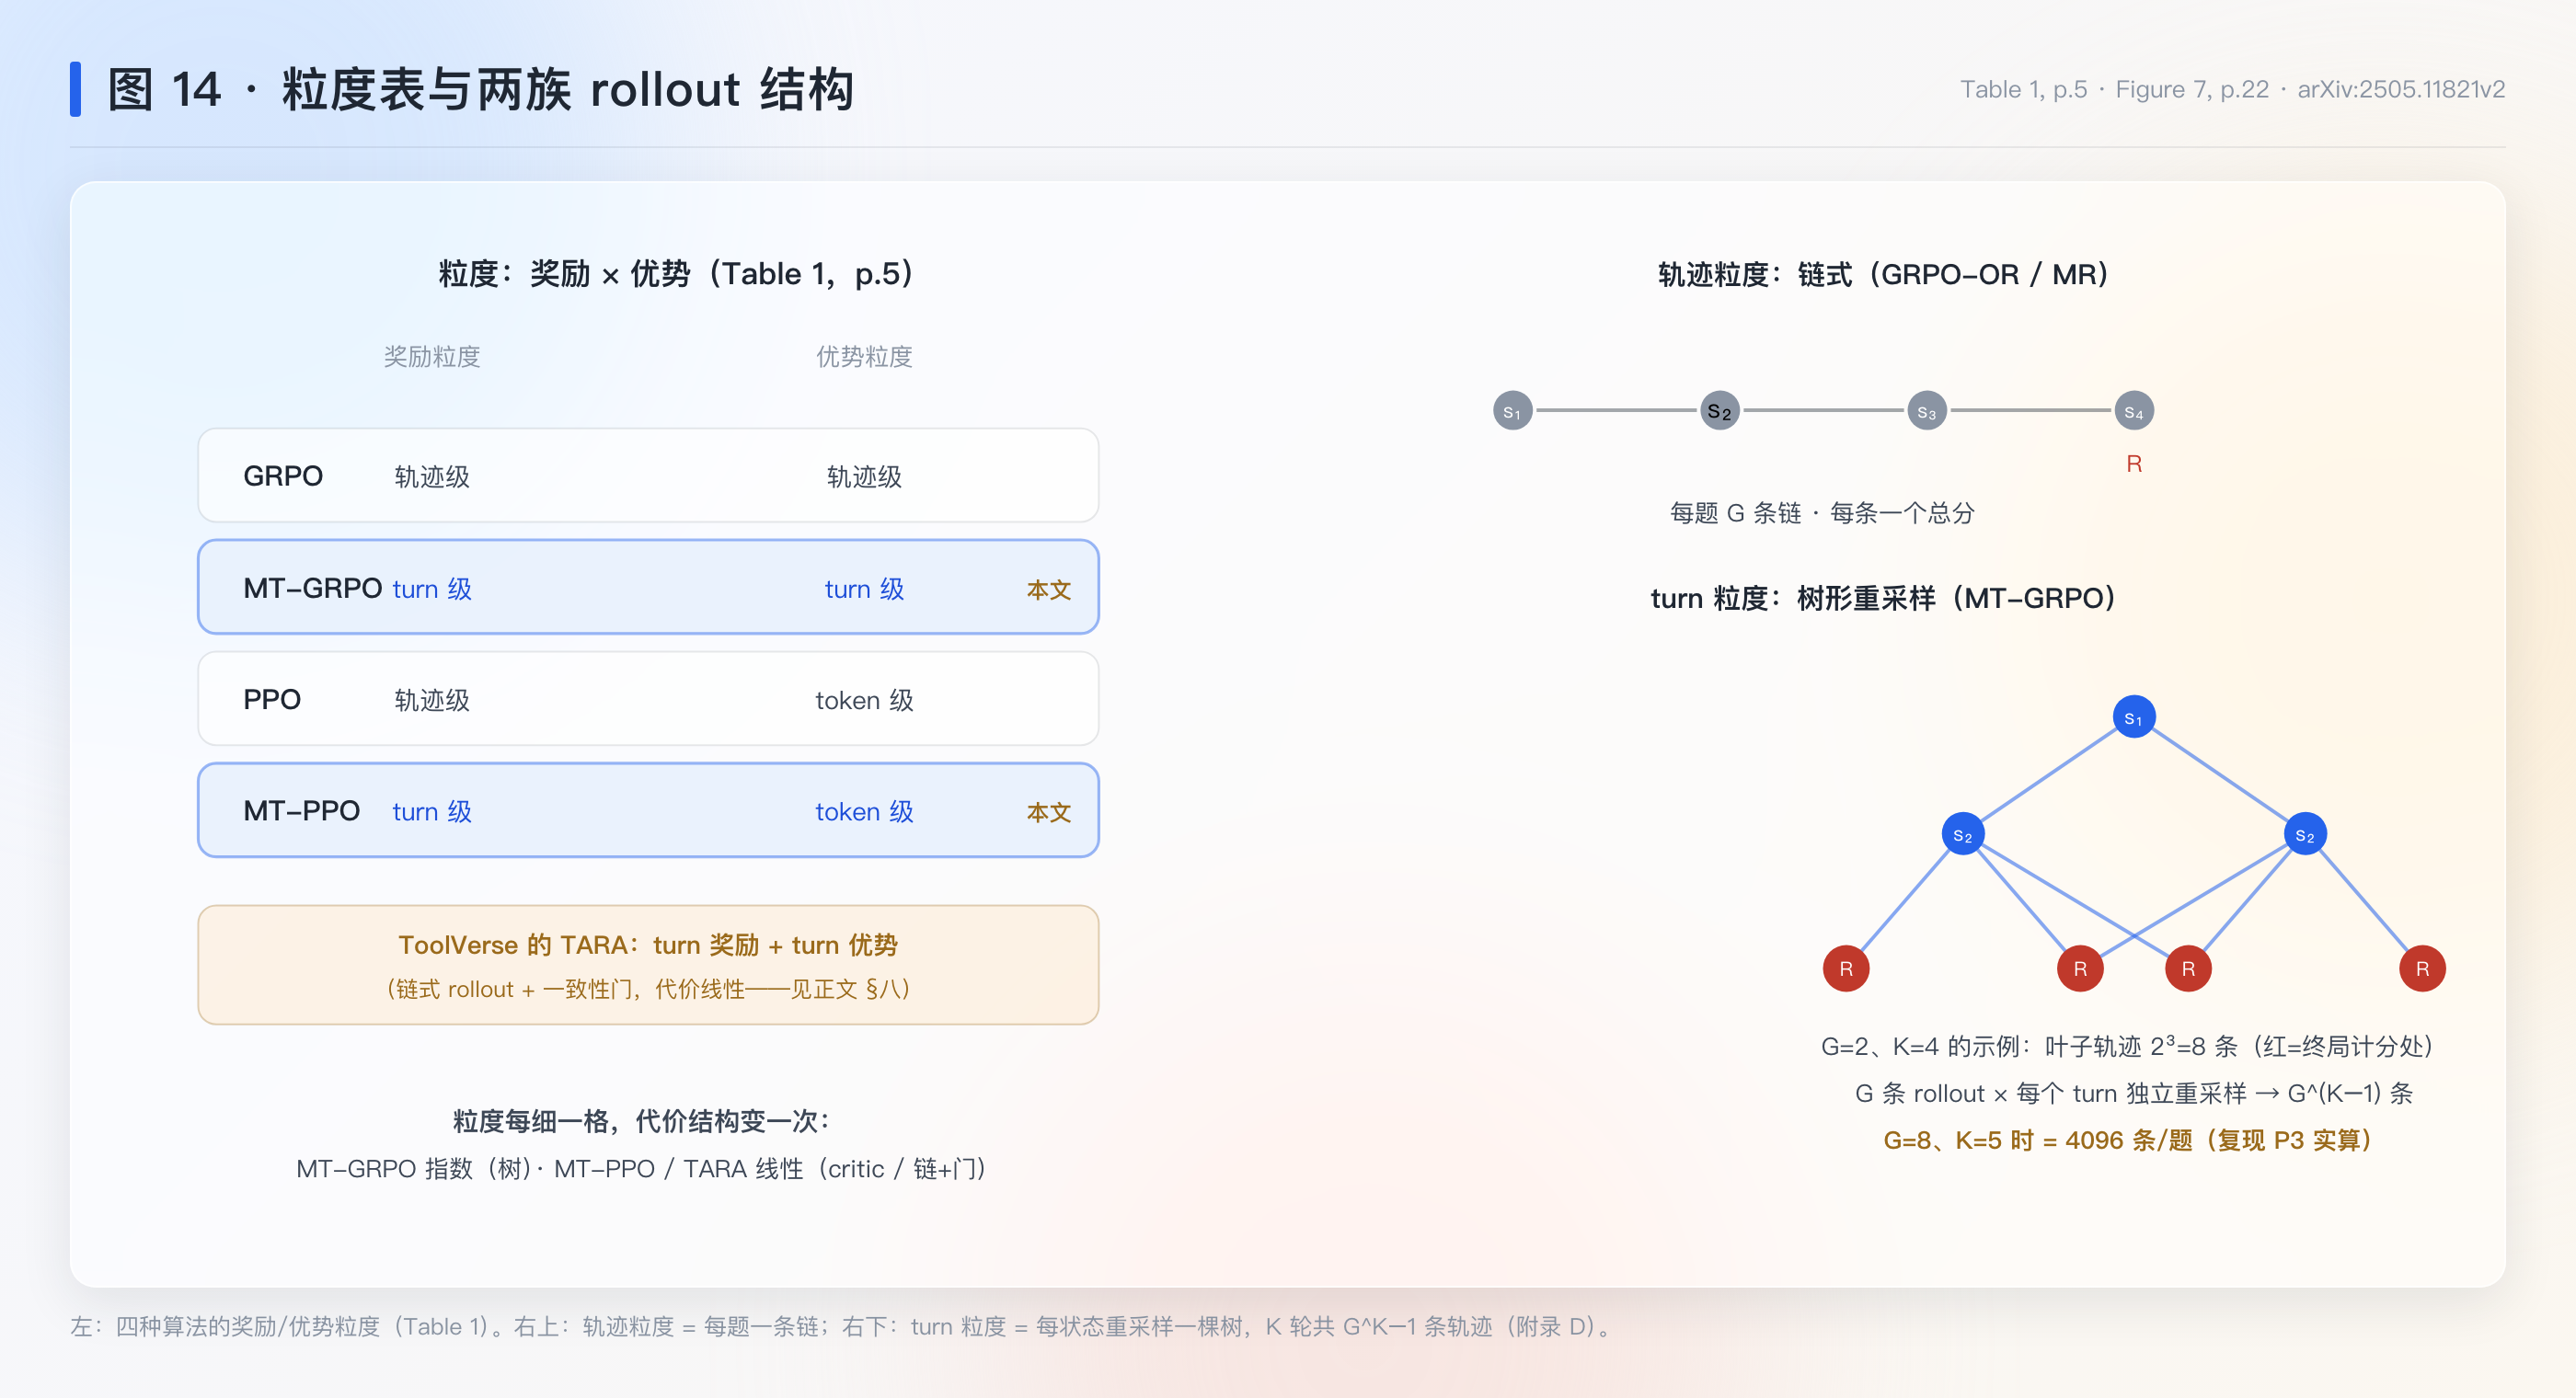
Table 1(p.5)是全文的坐标系——奖励怎么给、优势怎么算,两个维度四种组合:
| 算法 | 奖励粒度 | 优势粒度 |
|---|---|---|
| GRPO | 轨迹级 | 轨迹级 |
| MT-GRPO(本文) | turn 级 | turn 级 |
| PPO | 轨迹级 | token 级 |
| MT-PPO(本文) | turn 级 | token 级 |
PPO 本来就靠 critic 有 token 级优势,缺的只是 turn 级奖励的”放置”;GRPO 两者都缺,补起来要么按状态重采样(指数代价),要么换 critic。这张表把”信号粒度”从口号变成了可比较的算法属性。
1.3 与前两篇的入口差
ToolVerse 的 TARA 从奖励侧进:逐 turn 与黄金轨迹对账,再组内标准化;这篇从算法侧进:先问”优势估计的粒度由什么决定”,再给出 GRPO 走向 turn 级的代价账和 PPO 走向 turn 级的免费午餐。两个入口在”同 turn 组内标准化”会师——§八 逐点对照。
二、核心想法
一句话:把多轮 agent 训练从”整条轨迹一个分”重构为”turn 级 MDP + turn 级奖励放置”,让优势估计的粒度对齐决策的粒度——GRPO 路线按状态重采样(纯但指数贵),PPO 路线用 critic 摊平(便宜且 token 级)。
这个论断往深一层想,是对”没信号”这句老抱怨的釜底抽薪。在它之前,多轮训练的难处被表述成”中间步骤没有训练信号”,听起来像环境吝啬、信号给不出来;这篇把它换成了另一句话:信号可以有问题,账本的粒度一定有问题——决策是一轮一轮做的,优势却是整条轨迹记一个数,错配之下,再多的中间信号灌进总分也会被稀释、互相抵消。
先打个比方。带一个学生复习,你只公布整场考试的总分,他永远不知道哪道题失了分,改错无从下手;把每道题的得分单独告诉他(这是 turn 级奖励),再告诉他”这道题你比同组人好多少”(这是 turn 级优势),复习才有的放矢。
再把比方译回工程语言。多轮交互天然是 MDP——每轮一个状态、一个动作、一个奖励;奖励按”轨迹末 token 放终局分、turn 末 token 放中间分、其余放零”放置;GRPO 的组内标准化从”轨迹间比总分”改成”同轮次比本轮分”;PPO 的 GAE 拿着放置好的奖励自动算出 token 级优势。
落到形式上:目标从 \mathbb{E}[R(x,y)] 变为 \mathbb{E}[\sum_k \gamma^k R(s_k,a_k)](式 (2),p.3);GRPO 的优势 A^{\text{GRPO}}_i 变为 A^{\text{MT-GRPO}}_{i,1} = A^I_i + \alpha A^O_i(两轮,式 (5),p.4);PPO 的奖励放置由式 (9) 给出(p.5)。
所以这篇把问题重新形式化成了什么:把”多轮 agent 训练没信号”重构为”优势估计粒度与决策粒度的错配”——粒度表(Table 1)就是这个错配的类型学。这和 ToolVerse 把”规模化”重构为”数据生产 + 信号粒度”是同一思想的算法面。
全篇就看这张:图 14(§1.2)——粒度表与两族 rollout 结构:轨迹级 vs turn 级,同一批数据在两种粒度下的对照;后面所有优势公式都是这张表的代数化。 ## 三、数学基础(零起点,本篇新用到的五件)
3.1 组内标准化(复习,ToolVerse §3.2 同款)
第一件工具是组内标准化,MT-GRPO 的一切”组内比较”都建立在它上面(ToolVerse §3.2 的同款,复习一遍就能用)。给一组数 x_1,\dots,x_G:均值 \mu=\frac{1}{G}\sum_i x_i,标准差 \sigma=\sqrt{\frac{1}{G}\sum_i(x_i-\mu)^2}(除以 G,与 GRPO 实现一致);标准化 z_i=\frac{x_i-\mu}{\sigma} 的含义是”比同组平均好几个标准差”。要盯住它的退化条件:全组同值时 \sigma=0、分子也为 0,信号自然消失——这条规则在 MT-GRPO 的每一个”组”里都会现身。走一个数:\{1.0,\ 0.2,\ 1.0,\ 0.0\} 的 \mu=0.55,\sigma=\sqrt{(0.2025\times 2+0.1225+0.3025)/4}=\sqrt{0.8300/4}\approx 0.4555;z_1=(1-0.55)/0.4555\approx 0.988。记住这把尺子——§5.3 组装中间优势与终局优势,用的全是它。
3.2 马尔可夫决策过程(MDP)
第二件工具是 MDP 的词汇,后面所有关于”粒度”的讨论都要靠它说话。先借下棋打个底:局面是状态 s,落子是动作 a,环境按规律 P 给出新局面,这一步的得失是奖励 R,\gamma 是”未来的分打几折”;agent 的策略 \pi_\theta(a|s) 就是被训练的对象。正式写出来是 M=\{S,A,P,R,\gamma\};本文有一条特殊约定(p.2):状态=交互历史(整段对话),动作=一整轮的输出序列(l_k 加环境反馈 f_k),所以”一步”是”一轮”而不是”一个 token”。这条约定直接决定了后面所有粒度讨论的词汇——§5.1 的形式化与 §5.3 的 turn 级优势,都站在它上面。
3.3 折扣与几何级数(复习,ToolVerse §3.3 同款)
第三件工具管”未来的分怎么记”(也是 ToolVerse §3.3 的同款)。未来的奖励乘 \gamma^k 打折;\gamma=1 等于不打折;几何级数 \sum_k \gamma^k 在 \gamma<1 时收敛到 \frac{1}{1-\gamma}。为什么现在就要把它备好?因为本篇有两处”打折”:目标函数里的 \gamma(PPO 实验 \gamma=1,p.16),MT-GRPO 优势混合里的 \alpha(p.22)——后者折扣的不是奖励而是”后续 turn 的优势”。§5.4 的 MT-PPO 与 §6.4 的 K 轮一般式,都要靠这件工具来读。
3.4 策略梯度与优势函数(直觉级)
第四件工具回答一个朴素的问题:怎么让”好输出”的概率变大?把策略参数往”提高这个输出概率”的方向推。但”好”要有个相对标准——优势 A 就是”这个动作比平均水平好多少”的评分:A 为正的动作,提升其概率;A 为负的,压低。GRPO 和 PPO 的全部区别,几乎都在”A 怎么算”:GRPO 用同组轨迹互相当标尺(无 critic),PPO 用学习出来的价值函数 V 当标尺(有 critic)。本篇的 MT-GRPO/MT-PPO 之争,本质是”标尺从哪来”之争——§5.3 与 §5.4 就是两把标尺的对台戏。本篇不展开 \nabla\log\pi 的推导,够用即可;深挖留 branch_grpo。
3.5 GAE 与 telescoping(本篇新工具)
第五件工具是本篇的新家伙:GAE,它是 MT-PPO 那条便宜路线的引擎。GAE(广义优势估计)把”实际拿到的奖励流”与”critic 预估的价值 V“逐点比较:\delta_t=r_t+\gamma V_{t+1}-V_t 是”这一步比预期好多少”。多个 \delta 按 (\gamma\lambda)^l 加权求和得 A_t。
telescoping 恒等式(本篇复现的关键工具):当 \lambda=1,\gamma=1(正是论文 PPO 实验的设置,p.16),(\gamma\lambda)^l=1,于是
A_t=\sum_{l\geq 0}\delta_{t+l}=\Big(\sum_{k\geq t}r_k\Big)-V_t
即”从现在到结尾的实际总奖励,减掉 critic 的预期”。证明不难,只需把 \delta_{t+l}=r_{t+l}+V_{t+l+1}-V_{t+l} 逐项写开、中间的 V 两两相消。数值例:奖励 r=(0,0.3,0,1.0)(第 2、4 个位置是 turn 末 token),V\equiv 0.5,t=1:\sum r_k|_{k\geq 1}=1.3,A_1=1.3-0.5=0.8;逐点算 \delta=(−0.5,−0.2,−0.5,0.5+V_5−V_4),V_4=0.5,V_5=0\Rightarrow\delta_4=0.5+0−0.5=0…(完整验证交给复现 P4,恒等式在任意 V 序列下成立)。这把钥匙到 §6.5 开 MT-PPO 奖励放置的账。
3.6 指数增长(复习 DUS 篇的树直觉)
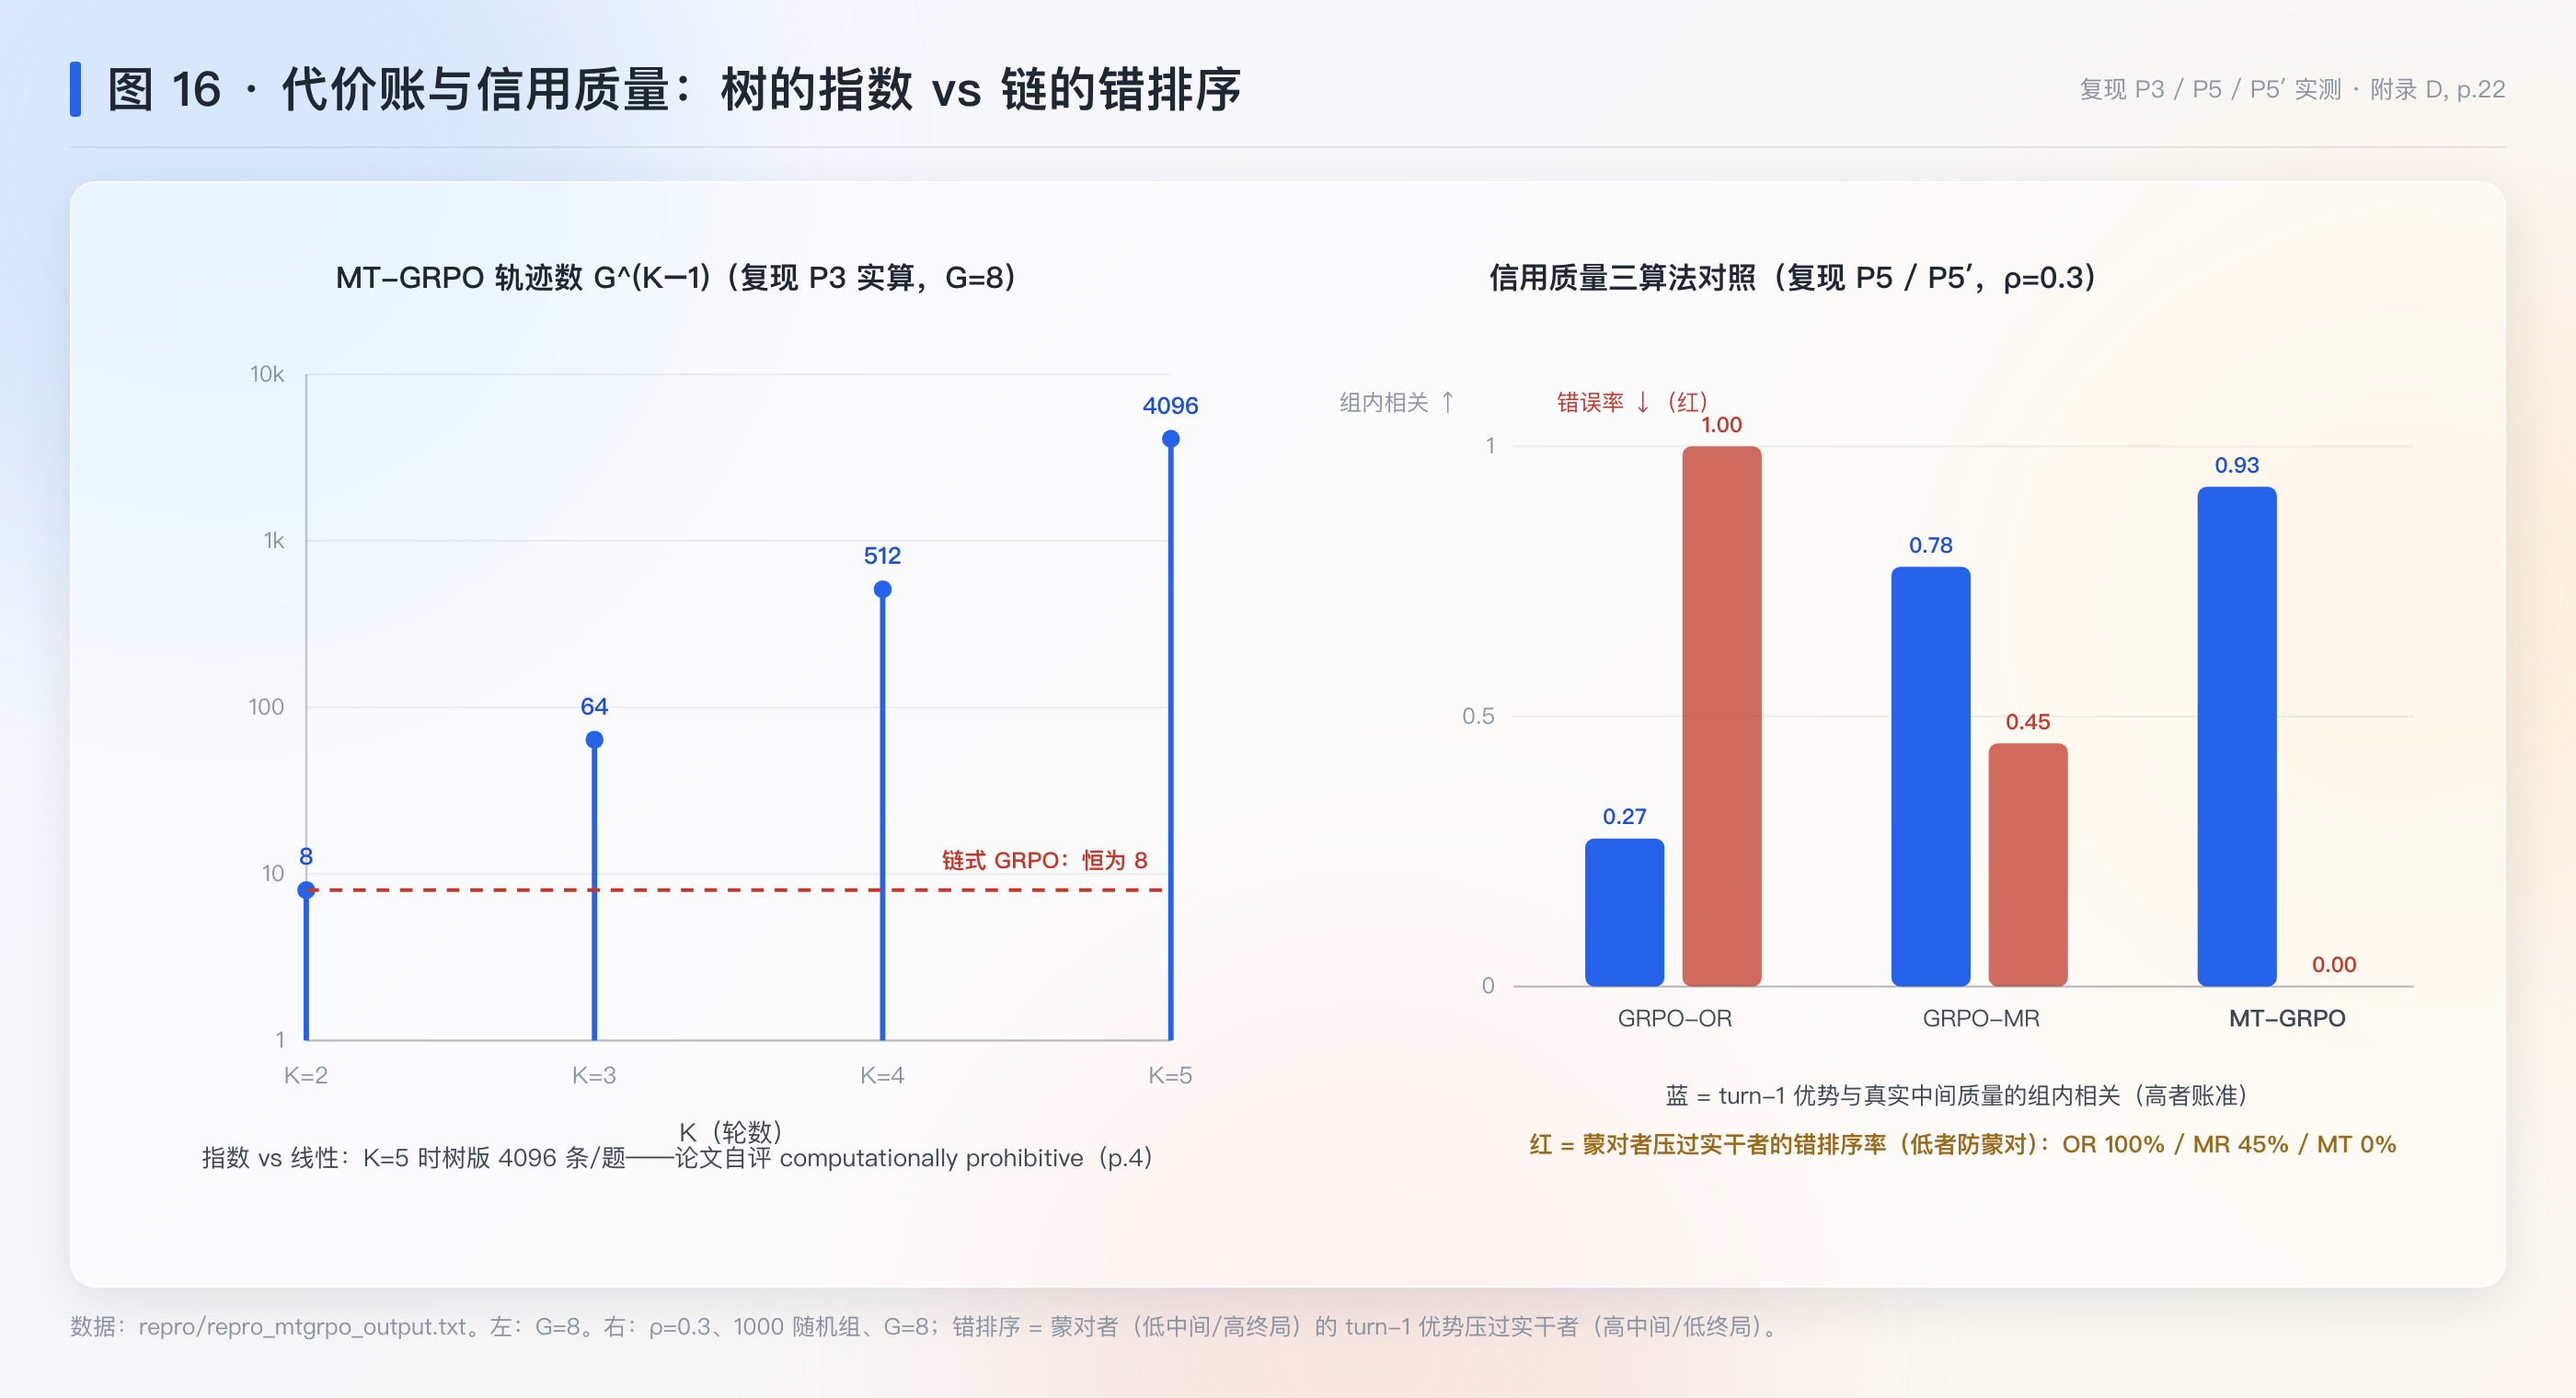
五件备齐,最后再补一行不算”件”的算术——它是 MT-GRPO 代价账的全部来源(DUS 篇的树直觉,复习即可)。每层分出 G 个分支、深 K-1 层的树,叶子数 G^{K-1}:G=8 时 K=2\to 8,K=3\to 64,K=4\to 512,K=5\to 4096。这行算术到 §5.3 的代价账与 §6.4 的树形 rollout 里兑现。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| x,\ y=[l_1,f_1,\dots,l_K,f_K] | 输入提示;完整输出(第 k 轮模型输出 l_k、环境反馈 f_k) | §2,p.2 |
| M=\{S,A,P,R,\gamma\} | turn 级 MDP;状态=交互历史,动作=[l_k,f_k] | §2,p.2 |
| R_k=R(s_k,a_k) | turn 级奖励 | §2,p.2 |
| R(x,y)=R(s_K,a_K) | 终局奖励 | §2,p.2 |
| G | 组大小(每问题/每状态的 rollout 数) | §3.1,p.3 |
| R^{\text{traj}}_i | 第 i 条轨迹的合并奖励 | 式 (4) 上文,p.3 |
| A^{\text{GRPO}}_i | 轨迹级优势(摊给全轨迹 token) | 式 (4),p.3 |
| R^I_i,\ R^O_i | 第一轮中间奖励;第二轮终局奖励(两轮设定) | §3.2,p.4 |
| A^I_i,\ A^O_i | 中间/终局优势(各自组内标准化) | 式 (6),p.4 |
| \alpha | 后续贡献的折扣系数,\alpha\in[0,1] | 式 (12) 下文,p.22 |
| A^{\text{MT-GRPO}}_{i,1} | 两轮设定下第一轮优势 =A^I_i+\alpha A^O_i | 式 (5),p.4 |
| A^I_{i,(k)} | 第 k 轮状态 s_k 处按状态重采样的中间优势 | 式 (11),p.22 |
| G^{K-1} | K 轮 MT-GRPO 的轨迹总数 | §3.2 Remark,p.4;附录 D,p.22 |
| w_{i,t}(\theta) | token 级重要性采样比 | 式 (3) 下文,p.3 |
| \delta_t=r_t+\gamma V_{t+1}-V_t | 时序差分误差 | 式 (8),p.5 |
| r_t 的放置 | 终局分放轨迹末 token,中间分放各 turn 末 token,其余 0 | 式 (9),p.5 |
| \lambda_s | 搜索次数惩罚系数,默认 0.1 | §5.2,p.6 |
五、机制
承上启下:§一 拆了主流做法在多轮训练里的两层病——单轮形式化丢结构、合并奖励丢粒度;§二 把它们重构为一句话——优势估计的粒度要对齐决策的粒度。上节备好的算术正好接上:组内标准化(§3.1)读 MT-GRPO 的优势组装,折扣与几何级数(§3.3)读未来项,MDP 词汇(§3.2)把”多轮”正式放进目标函数,GAE 与 telescoping(§3.5)读 MT-PPO 的功劳回传,指数增长(§3.6)读按状态重采样的代价。本节按论文的三步走机制推进,贯穿示例的组先立起来。
5.0 贯穿示例的数据结构初始化
论文的两轮 setting(§3.2,p.4;附录 E.1):系统提示词硬性规定恰好调用一次工具,输出结构固定为推理 → 工具调用 → 结果 → 推理 → 答案(E.5,p.28)。于是每个 rollout 恰好两 turn:第一轮中间奖励 R^I,第二轮终局奖励 R^O。
示例:G=4 条 rollout 的组,六类行为覆盖论文 E.2 列的三种特征情形(p.24–25):
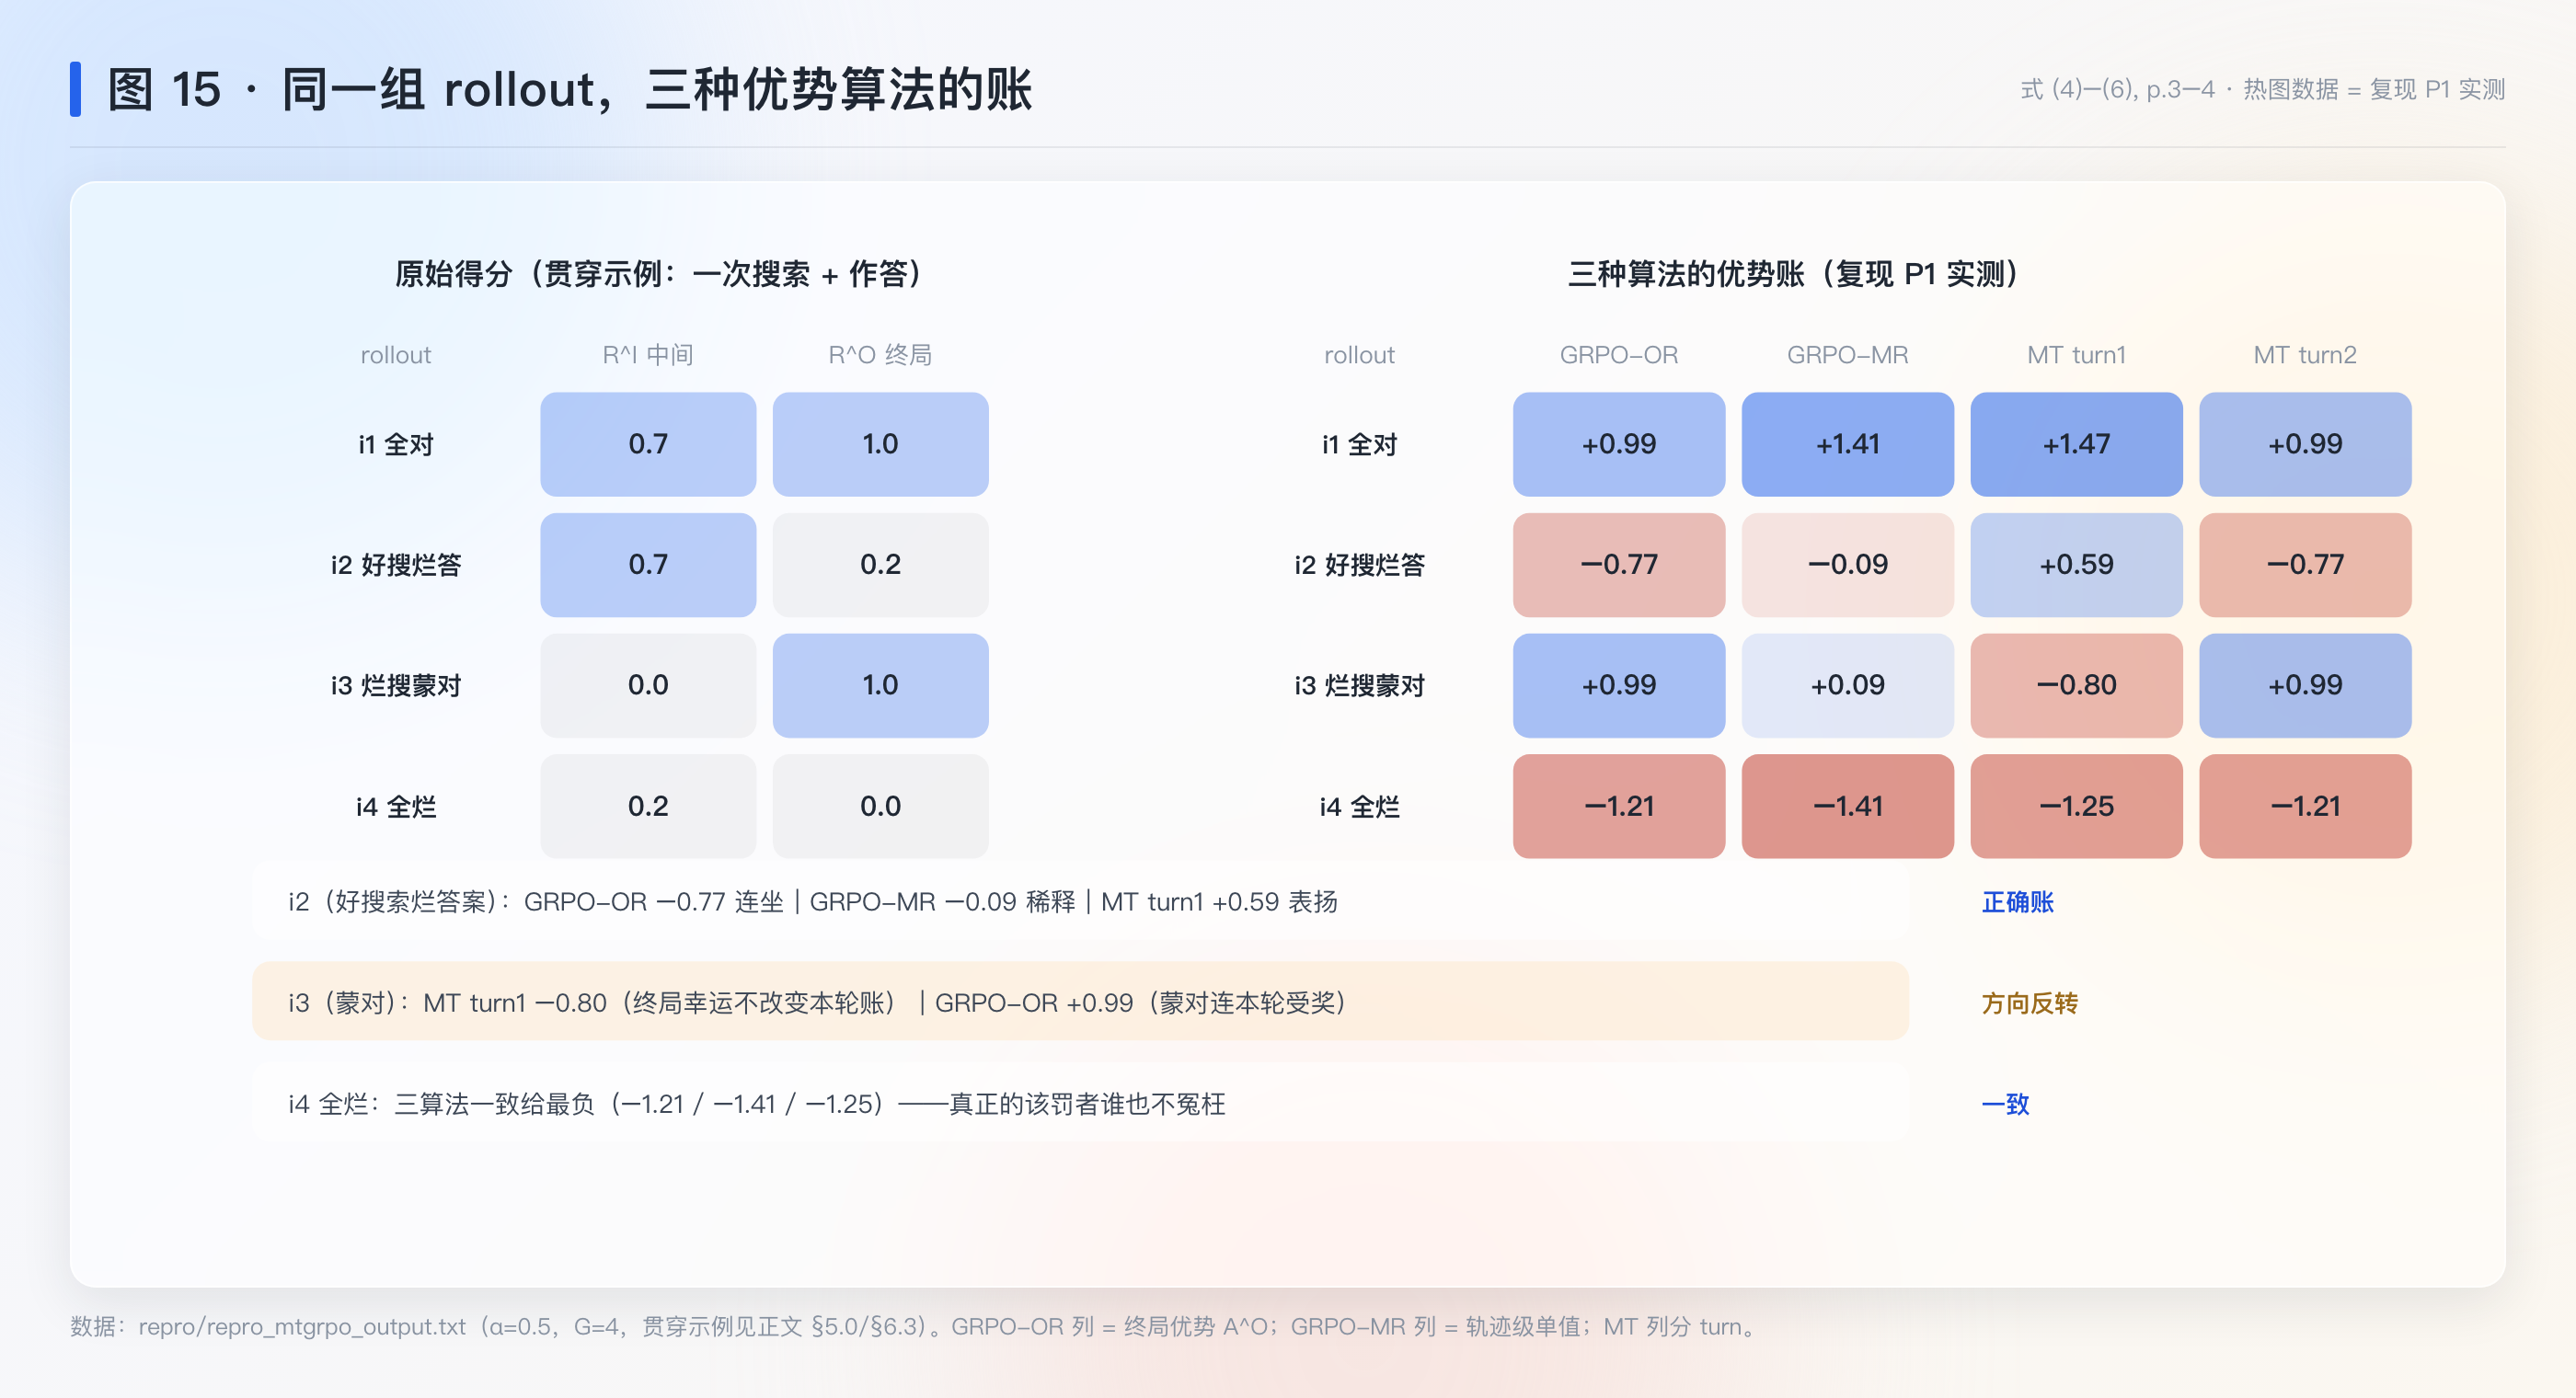
rollout  R^I(第一轮中间)   R^O(第二轮终局)   行为
i1       0.7(调对了,搜到了) 1.0(答案对)        全对
i2       0.7(调对了,搜到了) 0.2(格式对答案错)    好搜索烂答案
i3       0.0(没调/调崩)     1.0(蒙对了)         烂搜索蒙对(干扰者)
i4       0.2(格式分少许)    0.0(全烂)           全烂
数据结构级:两个长度 G 的奖励向量 \{R^I_i\},\{R^O_i\},三种算法各自把这对向量变成”每个 token 的优势”。全部手算见 §6.3,程序复算见 §十。
5.1 机制一:单轮 → 多轮的形式化(§2,p.2–3)
【类比 · 把整盘棋当一步下】 复盘一局棋,棋谱里明明是几十手环环相扣的着法,你却只给整局打一个胜负分、当作”落子一次”来总结——中间每一手的好坏无从点评。单轮形式化对多轮 agent 干的就是这件事。 【跨域锚点】 管理学通识:只考核最终结果、不考核过程的单一考核,会让中间的好决策无法被识别,也就无人重复它。(类比与通识锚点,非论文内容)
先看病。多轮 agent 的一次任务明明是一连串决策——写推理、调工具、读结果、再作答——主流做法却把它压成单步:整条轨迹一个决策、一个奖励,论文点破这是 contextual bandit。
药方是把形式化换成对的(p.2):多轮 agent 交互形式化为 turn 级 MDP M=\{S,A,P,R,\gamma\};状态是交互历史,动作 a_k=[l_k,f_k](模型输出 + 环境反馈,若无反馈则 a_k=l_k),每 turn 得 R_k=R(s_k,a_k)。单轮形式化(式 (1),p.3):\max_{\pi_\theta} \mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot|x)}[R(x,y)];多轮形式化(式 (2),p.3):\max_{\pi_\theta}\mathbb{E}[\sum_{k=1}^{K}\gamma^k R(s_k,a_k)];只留终局奖励且 \gamma=1 时严格退化回式 (1)。
两条 Remark(p.3)值得记下:只有终局奖励的 MDP 是”仅终端奖励”的特例(引 Arjona-Medina et al. 2019,RUDDER——论文参考文献,已核);代价是没有机制在早期剪掉明显差的轨迹,只能整条模拟。
意义:这一节把”要不要中间奖励”从工程口味问题变成形式化问题——你选的目标函数里根本没有中间奖励的位置,中间信号自然被扔掉。
5.2 机制二:GRPO 基线与其多轮困境(§3.1,p.3)
【类比 · 名次抄到每个字上】 一组学生各交一份长卷,老师只按总分给每份卷子排名,再把名次原样抄到这份卷子的每一个字上——通篇一个分数,哪段论证精彩、哪段垮掉,账上完全看不出。GRPO 的优势就是这么记账的。 【跨域锚点】 会计通识:只记总账、不记分录,就无法追溯是哪笔业务出了问题。(类比与通识锚点,非论文内容)
先看 GRPO 本来的记法:对每个问题采一组 G 条回答,用组内标准化的优势加权PPO 式目标(式 (3),p.3,含 token 级重要性比 w_{i,t}、clip \epsilon、KL 系数 \beta);优势(式 (4),p.3):
A_{i,t}=A^{\text{GRPO}}_i=\frac{R^{\text{traj}}_i-\text{mean}(\{R^{\text{traj}}_i\}_{i=1}^G)}{\text{std}(\{R^{\text{traj}}_i\}_{i=1}^G)}
注意这个量的形状,病根就藏在形状里:下标写着 i,t,实际与 t 无关——整条轨迹每个 token 拿同一个数。多轮的折衷做法(GRPO-MR 风格)是 R^{\text{traj}}_i=\sum_{k=1}^{K}\gamma^k R_{i,k},把中间奖励并进总分——记法变了,粒度没变。论文的批评(p.3):coarse-grained credit assignment,长程任务上训练不稳、性能次优(引三篇 2025 工作,论文参考文献)。
5.3 机制三:MT-GRPO——turn 级信用分配(§3.2,p.4)
【类比 · 同一岔路口重新分组】 想知道”在这一步这么走,比别的走法好多少”,就得真的站回同一个岔路口,派多支队伍各试各的,回来互比——不能拿早已走上不同路的人硬比。MT-GRPO 为每个状态重新采样一组动作,正是这个道理;岔路口一多,队伍数便指数膨胀。 【跨域锚点】 体育通识:公平的比较必须控制变量——同组、同起点、同赛程,成绩才有可比性。(类比与通识锚点,非论文内容)
接着开药。先在 K=2 的设定下给出核心构造(p.4):第一轮的中间奖励组 \{R^I_i\}、第二轮的终局奖励组 \{R^O_i\} 各自组内标准化(式 (6),p.4):
A^I_i=\frac{R^I_i-\text{mean}(\{R^I_i\})}{\text{std}(\{R^I_i\})},\qquad A^O_i=\frac{R^O_i-\text{mean}(\{R^O_i\})}{\text{std}(\{R^O_i\})}
然后按 turn 组装(式 (5),p.4):
A^{\text{MT-GRPO}}_{i,1}=A^I_i+\alpha A^O_i,\qquad A^{\text{MT-GRPO}}_{i,2}=A^O_i
\alpha\in[0,1] 控制当前 turn 的优势里混入多少”后续贡献”。逐 turn 的优势均匀摊给该 turn 的所有 token。
两个关键性质(p.4 原文):一个 turn 的优势不只取决于本轮奖励,还取决于后续 turn 的贡献;同 turn 的所有 token 共享同一信号。K 轮的一般式与代价见 §6.4。
代价账(§3.2 Remark,p.4——全文最重要的工程事实):这剂药贵得吓人。算中间优势需要在每个状态采 G 条 rollout,K 轮总共 G^{K-1} 条轨迹——指数增长;且要求组内所有 rollout 轮数相同(靠系统提示词强制),这把 agent 锁死在固定轮数设定里。论文承认这让 MT-GRPO “computationally prohibitive”,于是转向 PPO。
5.4 机制四:MT-PPO——critic 摊平的便宜路线(§4,p.5)
【类比 · 请一位估分先生随行】 不搞重赛,请一位懂行的估分先生跟着走:每到一个位置,他报一个”从这里往后还能拿多少分”的预估;实际拿到的减去他预估的,就是这一步的功过。估分先生越估越准,这本功过账就越清——这位先生就是 critic。 【跨域锚点】 财务通识:标准成本法——实际数减去标准数得出差异,差异直接指认责任环节。(类比与通识锚点,非论文内容)
MT-PPO 走的是另一条路:不重采样,只改奖励怎么放。PPO 的优势由 GAE 从奖励序列和学习出的价值函数算出(式 (8),p.5):
A_t=\sum_{l=0}^{-t-1}(\gamma\lambda)^l\,\delta_{t+l},\qquad \delta_t=r_t+\gamma V_{t+1}-V_t
(求和上限的排版见 §九.1 的勘误讨论。)MT-PPO 唯一的改动是奖励放置(式 (9),p.5):终局奖励 R^O 放整条轨迹最后一个 token,中间奖励 R^I 放各中间 turn 的最后一个 token,其余 token 放 0。GAE 拿着这个奖励序列,自动算出 token 级优势——critic 把”未来会怎样”学进 V_t,不需要按状态重采样。Table 1 的第四行由此成立:turn 级奖励 + token 级优势。
意义:同一个”turn 级信号”的目标,GRPO 路线要付指数代价,PPO 路线用一个 critic 网络’摊平’了。这解释了为什么 2025 年之后多轮 agent RL 的主流从 GRPO 滑向 PPO/actor-critic(我的推断,依据:本篇 §4 的论证 + ToolVerse 依赖图上 actor-critic 缺口的定位)。
5.5 机制五:两套 turn 级奖励设计(§5,p.6–7)
【类比 · 主科满分,副科只给小分】 中间步骤是副科:检索命中、格式分都算分,但满分只有终局的零头——副科得再多也翻不了主科的主导地位,免得有人专攻副科、钻营拿分。 【跨域锚点】 制度设计通识:古德哈特定律——当一个指标变成目标,它就不再是好指标;代理指标只能给小权重。(类比与通识锚点,非论文内容)
粒度有了,还要防人钻空子——药方开到奖励设计这一层,量级分层是设计核心。可验证版(§5.2,p.6):
- 终局:R^O=1(答案对且格式对);0.2(答案错但格式对);-1(格式错)。
- 中间:检索命中(真答案出现在本轮检索结果里)+0.3;格式正确 +0.1、错误 -0.2;搜索次数惩罚 -\lambda_s\cdot n_{\text{search}}(累计次数,\lambda_s=0.1 默认)。
中间信号的最高分(0.3)只有终局满分的 30%——论文明说是为了 reduce the risk of reward hacking(p.6)。LLM-as-judge 版(§5.3,p.7):生成式奖励模型先写理由再按 rubric 打分(格式、推理质量、搜索有效性 + 搜索惩罚);judge 用 gpt-oss-120b(p.17,C.2)。
消融证据(§6.4,p.9–10)给这套设计补上了最硬的一笔:去掉搜索次数惩罚(\lambda_s=0)训练不稳、出现失控搜索与不收敛 rollout,模型在撞到搜索上限前无法正确终止,最终训练崩溃(Figure 4 + Table 4)。一个”软刹车”项的有无决定成败——这和执行侧 verify-retry 止损是同一个问题的训练侧形态(§八.4)。
六、数学展开
6.1 GRPO 目标函数逐符号(式 (3),p.3)
先看这组符号的来历。一组学生各写一份答卷;每份答卷里每个字的重要性,按”这份答卷比同组平均好多少”统一计分;更新时限制每次别改太猛(clip),并且别离出发的参考策略太远(KL 罚)。
J_{\text{GRPO}}(\theta)=\mathbb{E}\Big[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y^i|}\sum_{t=1}^{|y^i|}\min\big(w_{i,t}A_{i,t},\ \text{clip}(w_{i,t},1-\epsilon,1+\epsilon)A_{i,t}\big)-\beta D_{\text{KL}}[\pi_\theta\|\pi_{\text{ref}}]\Big]
逐符号:w_{i,t}(\theta)=\frac{\pi_\theta(y^i_t|x,y^i_{<t})}{\pi_{\text{old}}(y^i_t|x,y^i_{<t})} 是新旧策略在同一 token 上的概率比(重要性采样,让”用旧策略采的样”能用来评新策略);\min(\cdot,\text{clip}(\cdot)) 是 PPO 的保守更新技巧——概率比离 1 太远就截断,防止单次更新步子过大;\beta D_{\text{KL}} 把新策略拴在参考策略 \pi_{\text{ref}} 附近。A_{i,t} 由式 (4) 给出——轨迹级标量。
为什么这样设计:组内相减消掉了”题目难度”这个公共因素(同题才能互相比);clip 和 KL 各管一层稳定。值得记下:GRPO 的 \beta 在原论文是正数,但本篇 GRPO 实验设 \beta=0(E.3,p.25),ToolVerse 也关了 KL——“多轮 agent RL 里 KL 罚为什么普遍被关”现在是两个独立数据点,进未攻克。
6.2 单轮与多轮目标(式 (1)(2),p.3)
先看两式各在算什么。单轮目标是”期望终局分”——一张考卷只看总分;多轮目标是”期望逐题折扣总分”——每道题的成绩都进账。
\max_{\pi_\theta}\mathbb{E}[R(x,y)]\qquad\text{(1)}
\max_{\pi_\theta}\mathbb{E}\Big[\sum_{k=1}^{K}\gamma^k R(s_k,a_k)\Big]\qquad\text{(2)}
边界:论文明确给出退化条件——中间奖励全零且 \gamma=1 时式 (2) = 式 (1)(p.3)。所以两式之差恰是”中间奖励 × 折扣”的引入,别无其他。这也意味着:若你收了中间奖励却把它加总进轨迹分,你在优化式 (2) 的一个粗糙估计——GRPO-MR 的位置。
6.3 MT-GRPO 两轮:手算数值例(式 (5)(6),p.4)
先看这笔账怎么算。第一轮的成绩单独排名(中间优势),第二轮的成绩单独排名(终局优势),然后第一轮的最终评分 = 本轮排名 + \alpha\times 终局排名。
用 §5.0 的示例组算(\alpha=0.5,\epsilon 忽略):
\{R^I\}=\{0.7,0.7,0.0,0.2\}:\mu_I=0.40,\sigma_I=\sqrt{(0.09+0.09+0.16+0.04)/4}=\sqrt{0.095}\approx 0.3082;A^I=(+0.973,+0.973,-1.298,-0.649)。 \{R^O\}=\{1.0,0.2,1.0,0.0\}:\mu_O=0.55,\sigma_O\approx 0.4555;A^O=(+0.988,-0.768,+0.988,-1.207)。
| rollout | A^I_i | A^O_i | A^{\text{MT}}_{i,1}=A^I_i+0.5A^O_i | A^{\text{MT}}_{i,2} |
|---|---|---|---|---|
| i1 全对 | +0.973 | +0.988 | +1.467 | +0.988 |
| i2 好搜索烂答案 | +0.973 | −0.768 | +0.589 | −0.768 |
| i3 烂搜索蒙对 | −1.298 | +0.988 | −0.804 | +0.988 |
| i4 全烂 | −0.649 | −1.207 | −1.253 | −1.207 |
对照组(同一组数据):GRPO-OR 只看终局分,即上面的 A^O;GRPO-MR 把两轮奖励加总成轨迹分再标准化,取 \gamma=1:R^{\text{traj}}_i=R^I_i+R^O_i,即 \{1.7,0.9,1.0,0.2\},\mu=0.95,\sigma=\sqrt{(0.5625+0.0025+0.0025+0.5625)/4}=\sqrt{0.2825}\approx 0.5315;A^{\text{GRPO-MR}}=(+1.411,-0.094,+0.094,-1.411)——每个 rollout 全程一个数。GRPO-OR:R=\{1.0,0.2,1.0,0.0\},即上面的 A^O。
读表三句话:i2(好搜索烂答案)在 MT-GRPO 下第一轮拿 +0.589(它的搜索行为被单独表扬),在 GRPO-MR 下全程只有 -0.094(近似无信号),在 GRPO-OR 下全程 -0.768(被终局连坐);i3(蒙对)终局 +0.988 是全场最高档,第一轮却拿 -0.804——终局的幸运不改变本轮的账,而它在 GRPO-OR 下第一轮是 +0.988(蒙对连本轮一起受奖),方向完全相反;全场最负是全烂的 i4(-1.253)。同一行为在不同 turn 得到方向相反的账,这就是 turn 级信用的含义。这组数字全部进复现 P1/P2。
(诚实留痕:以上手算在写作时逐项复核过一次;复现脚本将程序化重算,不一致以脚本为准并回改。)
6.4 K 轮一般式与指数代价(式 (12),附录 D,p.22)
先看一般式的形状。第 k 轮的优势 = 本轮的中间优势,加上后面每一轮的中间优势按 \alpha 逐层打折传回来,最后再按 \alpha^{K-k} 混入终局优势。
A^{\text{MT-GRPO}}_{i,(k)}=\sum_{l=k}^{K-1}\alpha^{l-k}A^I_{i,(l)}+\alpha^{K-k}A^O_i
逐符号:A^I_{i,(l)} 是在状态 s_l 处重新采 G 个动作算出的中间优势(式 (11),p.22)——注意”每个状态各自一组”,这是树形 rollout 的来源;\alpha^{l-k} 是”隔了几轮就打几次折”;末轮没有中间项,直接用 A^O_i(末轮不需要重采样,p.22)。
一致性检验:K=2、k=1 时式 (12) 给 A^I_{i,(1)}+\alpha A^O_i,正是式 (5)——一般式与两轮式严格相容(复现 P2 程序化验证)。
代价推导:状态 s_1 要 G 个动作,每个动作引出不同的 s_2,每个 s_2 又要 G 个动作……到第 K-1 层,叶子轨迹数 G^{K-1}。论文原话:K=2 时只需 G 条(与 vanilla GRPO 相同),K 增大则指数增长,“computationally prohibitive for long-horizon multi-turn tasks”(p.4)。Figure 7(p.22)把这件事画成链 vs 树:GRPO-OR/MR 是每题一条链(G 条),MT-GRPO 是每题一棵树。
补充(这条代价账恰好解释了 ToolVerse 的设计选择):TARA 想要的也是”同轮组内比较”,但它不做按状态重采样——它直接用同一批链式 rollout,在每个 turn 索引上跨轨迹标准化。代价从 G^{K-1} 回到 G,换来两个约束/补丁:仍需组内轮数对齐(与 MT-GRPO 同款假设),且”同索引不同状态”的组内可比性变弱、噪声变大——TARA 用一致性门(\delta=r)去噪。谱系读出来:MT-GRPO 是纯而贵的树版,TARA 是糙而省的链版 + 门。这是我的推断(论文互不引用),依据是两边公式结构的逐项对照,进 §八.2。
6.5 MT-PPO:奖励放置与 GAE(式 (8)(9),p.5)
先看这台机器怎么转。把每轮的分数贴在那一轮最后一个字上,其余位置贴 0;critic V 学会”从这里往后预期拿多少分”;每个位置的优势 = 实际后续总分 − 预期(\lambda=\gamma=1 时严格成立,见 §3.5)。
r_t=\begin{cases}R^O & t\ \text{为整条轨迹最后一个 token}\\ R^I & t\ \text{为某中间 turn 的最后一个 token}\\ 0 & \text{否则}\end{cases}\qquad A_t=\sum_l(\gamma\lambda)^l(r_{t+l}+\gamma V_{t+l+1}-V_{t+l})
为什么这样设计:奖励放 turn 末,GAE 的 telescoping 让该 turn 内所有更早 token 的优势里都含”这一轮的实际回报”,于是 turn 的功劳/责任沿着序列反向传给生成它的每个 token——critic 替代了 MT-GRPO 的树形重采样。边界:论文 PPO 实验取 \lambda=1,\gamma=1(p.16),没有研究折扣敏感性;\gamma=1 意味着终局噪声不衰减地传给每一轮——MT-GRPO 那个 \alpha 在 PPO 侧没有对应的消融(我的观察,进 §九.5)。
数值例:两轮、每轮 3 个 token,奖励放置 r=(0,0,0.7,\ 0,0,1.0)(0.7 是中间分贴在 turn 1 末,1.0 是终局分);设 V\equiv 0.6:A_1=\sum_{k\geq 1}r_k-V_1=1.7-0.6=1.1;A_4=\sum_{k\geq 4}r_k-V_4=1.0-0.6=0.4——第一轮前部 token 的优势含中间与终局两部分,第二轮 token 只含终局,与式 (5) 的形状一致。
6.6 奖励设计的量级分层(§5.2,p.6)
把两套奖励的数值排在一起看设计逻辑:终局 \{1.0,\ 0.2,\ -1\},中间 \{0.3,\ 0.1,\ -0.2,\ -0.1\times n\}。中间的满分权重是终局满分的 30%,中间的负罚比终局的负罚轻。论文给的理由是降低 reward hacking 风险(p.6)——中间信号是”检索命中”这类可 hack 的代理指标,给小权重,即便被 hack 也翻不了终局的主导地位。消融显示搜索惩罚(-0.1\times n,无下限)是不可去的:去掉即崩溃(p.9–10)。补充:这套”大终局 + 小中间 + 无下限刹车”的三层结构,和执行侧”审计结论才进状态 + 过程观察只参考”的权重观同构。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| GRPO / PPO / 优势函数 | 待补 → 本篇后可写 | 组基线 vs critic 基线、clip、KL
罚的机制层已齐;branch_grpo.md
时机成熟(待补队列第一顺位,本篇是它的主要素材) |
| GAE / telescoping | 已懂(本篇 §3.5 现场推导) | \lambda=\gamma=1 恒等式够支撑式 (8)–(9) |
| MDP / turn 级形式化 | 已懂(§3.2) | 本文的状态/动作约定是全部粒度讨论的词汇 |
| MT-GRPO 树形重采样 | 已懂(§6.4) | G^{K-1} 代价账 |
| LLM-as-judge 奖励 | 待补 | judge=gpt-oss-120b 当训练信号(§5.3);偏差与可 hack 性未展开 |
| Search-R1 / verifiers 代码库 | 待补 | 两套实验的基座(p.7、p.25);Search-R1 的 GRPO “consistently crashes” 断言(p.8)转引自 Jin et al. 2025b,未核对原文 |
| StepSearch | 待补 | 最近邻:PPO + turn 级(信息增益)奖励,但需数据增强与预处理(B.2,p.15) |
| KL 罚为什么关 | 待补(问题加深) | 本篇 GRPO 实验 \beta=0(E.3),ToolVerse kl_loss=False——两个独立数据点,无解释 |
| 折扣/标准化/几何级数/指数树 | 已懂(§3.1/§3.3 复用;指数树见 ToolVerse 篇 §6.9) | — |
“待补”节点会在此后的分支笔记里逐个补齐;branch_grpo
是下一篇分支笔记的第一顺位,素材已由本篇备齐大半。
八、扩展与发散
8.1 训练侧配对:MT-GRPO vs TARA 的逐点对照
发散:把本篇与 ToolVerse 并排(同问题、不同入口,构成训练侧配对,方法同 StructAgent×LH)。逐点:
| 维度 | MT-GRPO(本篇) | TARA(ToolVerse) |
|---|---|---|
| turn 奖励来源 | 环境/判分器的连续设计量(检索命中、格式、惩罚) | 与黄金轨迹的字典级覆盖 0/1 |
| turn 优势的组 | 按状态重采样:同一 s_k 下 G 个动作(树) | 同一批链式 rollout 在同 turn 索引上互比 |
| 未来项 | \sum_{l>k}\alpha^{l-k}A^I_{i,(l)}+\alpha^{K-k}A^O(优势的折扣和,无门) | \delta_{i,t}\cdot\sum\gamma^k r_{i,t+k+1}(奖励的折扣和,门 \delta=r) |
| 轮数假设 | 组内等轮数(系统提示词强制) | 组内等轮数(黄金轨迹轮数固定) |
| 代价 | G^{K-1},指数 | G,线性 |
| 理论 | 无定理,实证曲线 | 方差缩减 + 干扰抑制两条定理 |
结构上两者是同一个思想的两种预算化:“本轮表现单独排名”是共同内核;分歧在未来项怎么算——树采样让”未来”是真实的(不同动作真的走不同的后续),所以不需要门,贵;链式让”未来”是别的轨迹的未来,必须用门挡住”别人替你圆的结局”,省。这解释了 TARA 定理 A.4(干扰抑制)为什么在 MT-GRPO 里没有对应物:树版里没有”蒙对未来”这个问题,蒙对的 future 根本不在你的分支上。
回到这篇:Table 1 的四行粒度表 + ToolVerse 的 TARA,合成一条完整的”信号细化谱系”——GRPO(轨迹/轨迹)→ MT-GRPO(turn/turn,树)→ TARA(turn/turn,链+门)→ MT-PPO(turn/token,critic)。粒度每细一格,代价结构变一次。
8.2 崩溃的三张面孔:GRPO-OR、零方差、verify-retry
发散:本篇最刺眼的数字是 Table 5(p.26)——GRPO-OR 验证集上工具执行 0、检索命中 0、exact match 0:只看终局分的 GRPO 把”调用工具”这件事整体学没了(工具调用在早期大概率无助于终局分,于是被一致压低)。把它放进簇里,这是第三次遇到”信号缺位 → 系统性行为畸变”:执行侧是 LH 的自评偏差(自报完成当真完成)与 StructAgent 的 Invalidated 缺失(假完成赖在账上);训练侧是 ToolVerse 的零方差退化(全组同错 = 无梯度,最难的 turn 没人学)与本篇的 GRPO-OR 崩溃(无 turn 信号 → 中间行为被终局噪声淹没)。三次的共同解都是同一句话:给中间步骤一个独立、可信、不会被终局连坐的记账通道——执行侧叫审计账本,训练侧叫 turn 级优势。
再深一层,本篇的搜索惩罚消融(\lambda_s=0 即崩溃,p.9–10)把这个共同结构推到更细:即便有了 turn 级信号,无下限的刹车项(累计搜索惩罚)仍然不可去——否则 agent 会无节制搜索、不终止。执行侧 verify-retry 的”止损”(重试几次该停)在这里以”搜索几次该停”的形态再次出现,且同样以”崩溃 vs 收敛”的分水岭形式被实证。三篇汇合的证据链现在完整:止损/刹车不是调参细节,是系统成立的必要组件。
回到这篇:本篇对簇的贡献是把”中间通道”从奖励设计(TARA)推进到算法结构(优势估计粒度),并第一次给出了两条路线的代价表。
8.3 固定轮数:两边共有的暗礁
发散:MT-GRPO 需要组内等轮数(p.4 自认),它的两轮实验环境干脆用系统提示词规定”恰好调用一次工具”(E.5,p.28);TARA 的 turn 索引对齐同样依赖黄金轨迹轮数固定。真实的 agent 任务轮数是涌现的、可变的——两篇都把”轮数可变”关在门外。论文的辩护是两轮设定足以”highlight the importance”(p.4),作为方法论演示成立;但这也意味着所有结论都带有”轮数已知且固定”的前提,往真实任务迁移时第一步就要重新推导(轮数不齐时组怎么组、掩码怎么打)。这与执行侧”任务长度未知”的前提形成互补:执行侧的账本天然容忍变长,训练侧的组比较天然要求对齐。
回到这篇:固定轮数是本篇全部数学的地基,读任何结论都要带着这个脚注;它也是”训练侧信号细化”这条线留给我们自己的下一个缺口。
8.4 LLM-as-judge 当训练奖励:便利与隐患
发散:本篇把 gpt-oss-120b 按 rubric 打的分直接当训练奖励(§5.3、Fig 6),与可验证奖励并列成两类。便利明显——柔性的”推理质量”判分覆盖精确匹配够不着的场景(论文自己举了”答案对但形式不同”被错杀的例子,p.7)。隐患论文没有系统评估:judge 本身的偏差会通过梯度直接写进策略(judge 偏好什么,agent 就学成什么),而 rubric 里的检索命中、格式项与可验证版数值相同——judge 的增量只在”推理质量”这一软项。这条与 ToolRL(奖励设计分类学,本篇引用的 Qian et al. 2025)和 ToolVerse 的”黄金轨迹错误率”问题(ToolVerse 十二.2)连成同一问:判分器自身的误差率怎么估。执行侧的探针级联(StructAgent)给过一个答案:多仪器交叉 + 确定性优先;训练侧的对应物还没人做。
回到这篇:LLM-as-judge 在这里是”可验证奖励的补丁”而非替代(Fig 6 显示 judge 版训练同样稳定),这个克制是对的;但它把”验证通道质量”问题从评测侧正式带进了训练侧。
8.5 发散收拢
把四条支线拽回来:8.1 说本篇与 TARA 是同一内核的两种预算化,共同内核是”本轮表现单独排名”;8.2 说 GRPO-OR 崩溃、零方差、verify-retry 是”中间通道缺位”的三次显形,刹车项不可去;8.3 说固定轮数是两篇共有的地基假设;8.4 把判分器误差率问题带进训练侧。合起来,训练侧这条线的读法已经成形:奖励粒度 → 优势粒度 → 代价结构 → 判分器质量,四格各至少一篇,簇合成时按这四格对照。
九、局限与可疑处
- Table 2 的混合来源:标 ‡ 的行(GRPO-MR、PPO-MR、OTC)数字直接抄自各自原论文(p.9 表注、C.1.1 p.16 自述”we directly report the results from their respective papers”)——训练配置、步数、评测细节不受本篇控制,同表均值对比的可比性打折。论文用表注披露了,但正文叙述(“MT-PPO consistently outperforms PPO and GRPO”)未再区分。
- 崩溃基线的取点规则:PPO 基线常崩溃,取”最终检查点或崩溃前最后一个”评测(p.8 自述)——披露了,但这是对基线有利的幸存者处理,方向上反而抬高基线(对本文主张是保守的,可接受但应记住)。
- GRPO 主线证据缺席:正文训练曲线”omit GRPO since GRPO consistently crashes”(p.8,转引 Jin et al. 2025b,未核对原文)——标题级卖点是 MT-GRPO,主实验证据却在 MT-PPO;GRPO 侧只有附录 E 的两轮 TriviaQA 小实验(10 次运行,p.25)。算法名与证据权重要分开读。
- “100% format correctness”的舍入话术:摘要说 100% format correctness(p.1),Table 2 实际为 0.997–0.999(p.9)——四舍五入的修辞,与 LH 摘要/正文矛盾同类但轻得多(方向一致,量级 ~0.3pp)。
- GAE 无折扣无消融:PPO 实验固定 \lambda=1,\gamma=1(p.16),终局噪声不经折扣全量回传;MT-GRPO 侧有 \alpha 却无敏感性分析(仅两轮演示取 \alpha 未报告消融)。“未来项权重”这个本篇自己指出的关键旋钮,两侧都没扫。
- 无显著性检验:PPO 实验 5 次运行(Fig 3 阴影)、GRPO 实验 10 次(max–min 阴影);Table 2 无置信区间。小差值如 NQ 0.490 vs 0.483(+0.007)在无区间下不可判;大差值(format 0.999 vs 0.895)无疑义。横向核实时按二项区间重算。
 7.
固定轮数地基:全部实验在轮数由提示词锁死的环境(见
§8.3);论文承认等轮数约束限制 MT-GRPO 适用面(p.4),但 MT-PPO
的实验同样在 N_{\max}=4
的受限环境里,可变轮数的真实迁移未测。 8.
无公开代码:abs 页无链接(2026-09-02
核,查无);基座 Search-R1/verifiers 开源,但 turn
级实现(尤其树形采样)未放出,复现门槛在工程侧。 9.
奖励量级的脆弱性:中间 0.3/0.1 vs 终局 1.0/0.2/−1
的量级表是手工设定的,无权重敏感性消融(只消融了 \lambda_s);量级比例变了结论是否稳健未知。
十、验证结果(最小复现)
10.1 范围声明
论文的 RL 训练主张(Table 2/5 的基准增益)需要 8×H100 与全套检索环境,不可最小复现,论文数字只作引用并注明出处。本复现是核心思想的最小演绎:同一组 rollout 上,三种优势算法(GRPO-OR / GRPO-MR / MT-GRPO)的信用分配行为,全部可在纯 CPU 上以精确算术重演。不冒充论文基准数字。
10.2 可证伪预测与判据(运行前写下)
- P1(信用分配对比):§6.3 的 G=4 示例组下,好搜索烂答案的 i2:GRPO-OR 给它全程负优势(-0.768),GRPO-MR 给它近似零(-0.094,合并信号稀释),MT-GRPO 给它第一轮正优势(+0.589)。判据:三者符号分别为 −/≈0(|A|<0.15)/+。
- P2(式 (12) 与式 (5) 相容):K=2 时一般式在 k=1 处化简为 A^I+\alpha A^O、k=2 处为 A^O。判据:程序化展开与式 (5) 逐项相等(差 <10^{-12})。
- P3(指数代价):MT-GRPO 的轨迹数 =G^{K-1},链式 GRPO =G。判据:树计数(每状态 G 分支)与公式一致,且 G=8 时 K=2/3/4/5 对应 8/64/512/4096。
- P4(GAE telescoping):\lambda=\gamma=1 时 A_t=\sum_{k\geq t}r_k-V_t 对任意奖励/价值序列成立;且式 (9) 的放置把 R^I 恰好放在 turn 末 token。判据:随机序列 10 万次,逐点差 <10^{-9}。
- P5(turn 级信用与真实中间质量的相关):构造中间奖励与终局奖励弱相关(\rho\approx 0.3)的随机组(1000 组 × G=8),三种算法的 turn-1 优势与真实 R^I 的组内 Pearson 相关均值满足:MT-GRPO(\alpha=0.5)> GRPO-MR > GRPO-OR(后者仅由 \rho 的偶然相关贡献,应接近 \rho 本身)。判据:排序成立且 MT-GRPO 相关显著高于 GRPO-OR。
10.3 运行结果
脚本 repro/repro_mtgrpo.py(纯
Python 标准库),真实输出 repro/repro_mtgrpo_output.txt。最终
21 PASS / 0
FAIL,但按留痕纪律,三轮运行的完整过程如下(首轮 5 项
FAIL,全部定位完毕):
- 首轮 FAIL 五项,逐项诊断:①P1 的”i3 第一轮全场最负”断言系我误读(全场最负是 i4 全烂 -1.253,i3 是 -0.804;i3 的真看点是终局最高档却吃 turn-1 负分)——§6.3 正文已同步修正;②手算对照表 GRPO-OR 首项 -0.988 系符号笔误(应为 +0.988);③P2 的 K=3 期望展开多算了一个中间项(K=3 只有 l=1,2 两个中间轮);④P4 的 FAIL 是真发现:telescoping 恒等式需要回合末端 bootstrap V_{T+1}=0,我首测给了随机终端值——修正模型后 10 万序列最大差 8.9\times 10^{-16};⑤P5 首轮排序为 GRPO-MR(0.947) > MT-GRPO(0.925),诊断为我生成器缺陷——对 R^O 做了 min-max 缩放,把其尺度压缩约 3 倍,使合并信号被 R^I 主导;去除缩放后排序恢复预测方向。
- P1 过:i2 在三算法下 -0.768 / -0.094 / +0.589(符号 −/≈0/+ 符合预测);i3 在 MT-GRPO 下第一轮 -0.804、在 GRPO-OR 下 +0.988(方向反转);i4 全场最负 -1.253。脚本值与 §6.3 手算表最大偏差 4.1\times 10^{-4}(三位小数舍入量级)。留痕:其间我对手算表一处舍入(-1.253)改错再改回,教训是负数第 4 位逢 5 的进位必须用除法验证而不是心算。
- P2 过:K=2 化简差恰为 0;K=3 手展开与一般式一致。
- P3 过:G=8 时 K=2/3/4/5 对应 8/64/512/4096;K=2 与 vanilla 相同;K=4 树内总节点 584。
- P4 过:10 万随机序列 telescoping 最大差 8.9\times 10^{-16};式 (9) 奖励放置验证通过。
- P5 过(修正生成器后):turn-1 优势与真实中间质量的平均组内相关 GRPO-OR =0.274(≈ρ 本身)、GRPO-MR =0.777、MT-GRPO =0.925,排序成立。
- P5′(运行后追加,非预注册):平均相关分不开 MR 与 MT 的优劣,改测决策相关的失败模式——构造”蒙对者(低 R^I 高 R^O)vs 实干者(高 R^I 低 R^O)“的组,统计 turn-1 优势错排序率:GRPO-OR =1.000(构造下必然)、GRPO-MR =0.450、MT-GRPO =0.000。即:合并奖励在近半的场合会把功劳记给蒙对者——这是 GRPO-MR 与 MT-GRPO 的本质差距,平均相关度量看不见它。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 信用分配对比 | i2 三算法 −/≈0/+;蒙对者方向反转 | 支持(首轮两处测试缺陷已修正并留痕) |
| P2 式 (12) 与式 (5) 相容 | 逐项相等 | 支持 |
| P3 指数代价 | G^{K-1}:8/64/512/4096 | 支持 |
| P4 GAE telescoping | 恒等式 <10^{-9};式 (9) 放置 | 支持(需终端 bootstrap 为零——首轮教训) |
| P5 turn-1 相关排序 | MT > MR > OR;OR ≈ ρ | 首轮不支持(测试生成器缺陷);修正后支持 |
| P5′ 错排序率(追加) | OR 必然错;MT < MR | 支持(1.000 / 0.450 / 0.000) |
边界重申:以上支持的是论文的优势估计数学(式 (4)–(12) 的行为与代价);RL 训练增益主张(Table 2/5)仍只有论文自报证据,且带 §九 的混合来源与无显著性问题。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 树形重采样信用分配(tree resampling for credit assignment)
- 层级:L1 领域具体(RL
信用分配)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md——turn 级归因需要”同一状态的多世界”对照)。 - 操作定义:想要 turn 级的因果对比,就在同一状态重复采样 G 个分支——组内其他分支就是这一步的反事实对照。代价明码标价:轨迹数 =G^{K-1}(复现 P3:G=8 时 K=2/3/4/5 对应 8/64/512/4096),指数账必须先于训练算清。
- 迁移去向:①任何”归因到中间步”的需求(过程奖励、失败定位、A/B 到步级)先问”同状态对照从哪来”;②成本核算纪律:采样结构定了,指数账就是下界。
- 失效边界:对照只在采样分布内成立——分支间差异 ≠ 因果差异若环境有隐藏状态;指数代价把长链任务直接排除(K 大时不可行)。
- 方法卡:
notes/method_tree_resampling_credit.md(L1)
11.2 奖励放置的 telescoping 校验(reward placement via telescoping identity)
- 层级:L1 领域具体(RL 实现正确性)。底层原理:数字要有对比系(L2,暂不立卡)。
- 操作定义:“中间奖励该放在哪个 token 上”不靠直觉,靠恒等式验证:放置方案代入 GAE,在 \lambda=\gamma=1 时必须 telescoping 回 A_t=\sum_{k\geq t}r_k - V_t(复现 P4:随机序列 10 万次逐点差 < 10^{-9})。放置错了, Advantage 系统性偏移且无报错。
- 迁移去向:①一切”实现细节的正确性”检验——找一个解析极限让实现必须退化到已知正确形式;②数值代码重构的回归测试设计。
- 失效边界:恒等式在 \lambda=\gamma=1 成立不保证一般参数下无偏——极限正确是必要非充分条件。
- 方法卡:
notes/method_reward_placement_telescoping.md(L1)
11.3 方法依赖
本篇产出 L1 两张(树形重采样 / 奖励放置 telescoping 校验),前者挂”归因靠对照”(MATTRIB)原理下。与 ToolVerse TARA 的配对对照(两套 turn 级方案同诊断)见依赖图;GRPO 基线的偏置根源由 Dr. GRPO 篇审计补全。
十二、没搞懂的地方(未攻克登记)
- 树形重采样的可负担化:G^{K-1} 在 K\geq 4 不可行,论文止步于”换 PPO”。树限幅(每状态只重采 top-m 动作)会损失什么?补齐时机:补完 branch_grpo 后重读附录 D,检查式 (12) 对采样数不齐的推广。
- 可变轮数的组构造:两篇训练侧论文都靠”组内等轮数”假设(MT-GRPO 自认,TARA 靠黄金轨迹)。真实 agent 轮数涌现时,per-turn 归一化怎么修——对齐(截断/填充)还是按 turn 特征配组?无现成答案,查无。
- 门(gate)在树版里是否真不需要:本篇无门、无干扰抑制定理;树版里”蒙对未来”结构上不存在,但重采样噪声存在。gate 的必要性是链版的特例还是普遍需求?补齐时机:读 PPO/actor-critic 分支后设计对照。
- LLM-as-judge 奖励的误差率:judge 打分与可验证分数的一致率、被策略 hack 的速率,论文未测(Fig 6 只给曲线)。并入”判分器误差率”问题簇(ToolVerse 十二.2)。
- KL 罚为什么普遍被关:本篇 GRPO 实验 \beta=0(E.3,p.25)+ ToolVerse kl_loss=False,两个独立数据点。补齐时机:branch_grpo 里正面回答。
- verify-retry 最优停止(簇既有缺口):本篇搜索惩罚消融(\lambda_s=0 崩溃)提供训练侧旁证——无刹车的工具使用不终止;执行侧第四系统实验仍欠。
十三、可信度
- A 级(论文原文转录,逐页核对):全部页码引用、式 (1)–(12)、Table 1/2/5、奖励设计数值、实验设置(C.1.3/E.3)。体例说明:式 (8) 的求和上限在提取文本中呈”−t−1”,按数学结构应为 T−t−1,疑为 pdftotext 丢字——本篇按 T−t−1 理解并推导(复现 P4 与该理解自洽),回 PDF 核验列为待抽查项。
- B 级(论文自报实验,无法独立验证):训练曲线稳定性、Table 2 主结果(注意 ‡ 行为转引)、Table 5、消融;已注无显著性检验、崩溃基线取点规则。
- C 级(我的推导 + 将由复现程序化验证):§6.3 数值表、§6.4 一致性检验与代价推导、§3.5 telescoping 恒等式、§6.5 数值例。
- D 级(我的推断,标注于正文):MT-GRPO/TARA 的”树版 vs 链版+门”谱系判读(§八.1/§6.4 补充)、多轮主流滑向 actor-critic 的观察(§5.4)、奖励量级脆弱性(九.9)。
- 横向核实初核(2026-09-02):版本 v1+v2 已核(v2 未 diff,遗留);工件查无(abs 页无代码链接);第三方:OpenReview/alphaXiv 收录线索已有未细查;统计审查未跑。更完整的横向核实(同行对照、第三方讨论、统计重算)留待后续。