外行导读(先读这个,再决定要不要进正文)
一个场景:你想让大模型学会用工具办事——查会议、订酒店、报差旅这样一环扣一环地办下来。真要拿强化学习去训,立刻发现三个”没”:没有训练场(现有 agent RL 环境多半只有代码解释器和搜索引擎两类工具)、没有题(长程任务要有人设计工具顺序和标准答案)、没有准账(只在任务终点给一个对错分,五步链条里哪步走对了哪步走错了,奖励说不清)。这篇论文要解决的就是这三个”没”。
这篇论文干的事:造一条三段流水线。第一段,把真实工具的定义自动翻译成能真正执行的模拟环境——422 个 MCP 环境、4438 个工具,自动单元测试把关,仿不真的约 20% 淘汰;第二段,把工具之间的依赖画成一张图,在图上”解锁”式采样出因果连贯的长程任务,每道题配一条可重放、可逐步判分的标准答案(黄金轨迹),产出 GUST 任务集(2987 项);第三段,训练时不再整条轨迹一个分,而是逐 turn 记账——这一步对没对、对未来几步有没有用——这套记分法叫 TARA。三件套齐上,Qwen3-8B 在 ACEBench 上从 46.5 提到 61.7。
为什么值得关心:这篇真正回答的是一个老问题——反馈从哪来。任何靠反馈改进的系统(学生、团队、模型)都缺同样三样:够多的练习场、够难的考题、够准的阅卷。ToolVerse 把三样全部自动化了,还立了一条纪律:只给验证过的步发功劳。这条纪律对一切”多步链条里追责”的场景都成立。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| MCP 环境 | 能真正执行工具调用的模拟沙盒(Python 函数 + 字典数据库),不是模型嘴上说说 |
| 工具依赖图 | 工具之间”谁先谁后”的因果关系图:上游输出是下游入参 |
| 入度 | 一个工具还没满足的依赖条数;入度归零=依赖全部就位,可以上场 |
| DUS(动态解锁采样) | 每轮只取”依赖已满足”的工具来组段出题,像按先修关系排课 |
| 黄金轨迹 | 一条可执行、可重放、逐步可判分的标准答案 |
| GUST | 用上述流水线造出的长程任务数据集 |
| turn | 轨迹里的一轮工具调用,记账的最小单位 |
| TARA | 把”整条轨迹一个分”改写成”逐轮记分”的优势算法:局部对错+打折的未来功劳 |
| 一致性门 | 本轮做错,未来再多”运气好”也不给这轮记功劳 |
| 零方差规则 | 全组分数一样时优势记 0——没有区分度就没有信号 |
§0 承接栏
这篇接的是前几篇攒下来的一个悬案:训练大模型做长推理,反馈信号从哪来?SimpleTIR 发现低概率 token 会让训练崩溃,MT-GRPO 发现评分粒度太粗会导致偏置——但它们能做这些诊断,前提都是手里先有一份好的反馈信号。信号本身从哪来,一直没人正面回答;这篇来还这笔账:把反馈信号的来源拆成三段流水线——训练题和环境怎么自动造、黄金轨迹怎么自动标注、每轮评分怎么逐轮对账。它也第一次回答了”KL 为什么关”——训练长推理链时模型本来就该大幅偏离初始版本,RLHF 时代”别跑太远”的拴绑在这个场景里语义不成立(§2.3,p.3)。
一、论文在解决什么问题
1.1 一个具体场景
你是平台方,想训练一个能处理差旅请求的助手——这个场景会贯穿全篇。用户说:“帮我订下周 AI 大会的酒店,加个日历提醒,回来我好报销。”这一句话背后是五步工具调用:查会议拿到地点和日期 → 搜酒店 → 看详情比价 → 下单 → 写日历 + 报销单。每一步的参数依赖上一步的输出(酒店 ID、日期、订单号),中间还可能要回头问用户预算。
你想用强化学习训练模型做这类事,立刻撞上三堵墙(§1,p.1–2):
- 没地方练。现有 agent RL 环境几乎只有代码解释器和搜索引擎(p.1:ZeroTIR、SimpleTIR、AGENTFLOW 一类)。差旅、库存、预订这类真实业务工具没有现成训练场;请人手工搭环境,一个场景就要数天(论文引用的背景,p.1–2)。
- 没有题。就算有工具,长程任务得有人设计:哪些工具按什么顺序串、参数怎么传递、黄金答案是什么。随机拼工具序列造出来的任务因果断裂,练不出”步骤间传递中间产物”的能力(p.4)。
- 练了也不知道功劳算谁的。强化学习靠奖励更新策略。若只在任务终点给一个 0/1,一条五步轨迹里四步对、一步错和五步全错拿同样的低分,梯度噪声大,训练不稳(p.2:sparse terminal rewards fail to provide meaningful advantage estimates)。
1.2 论文对现状的定位:三个瓶颈维度
Table 1(p.2)把已有 agent RL 工作放进三个维度:Scope(环境多样性)、Tool Use Complexity(推理深度)、Credit Assignment(训练信号粒度)。逐行读:
| 方法 | 工具范围 | 复杂度 | 信号 |
|---|---|---|---|
| ZeroTIR / SimpleTIR | 单工具(代码) | 数学推理 | 结果(稀疏) |
| AGENTFLOW | 搜索 + 代码 | QA/数学 | 结果(稀疏) |
| ToolRL | 三个基准的工具 | 工具使用推理 | 结果(稠密) |
| SALT / FTRL | 多/通用工具 | QA/工具推理 | 结果(稀疏) |
| ToolVerse(本文) | 通用多工具 | 长程工具推理 | turn 级(稠密) |
论文的主张是:三个维度要同时补齐,agent RL 才能从窄域走向真实工具世界。ToolVerse 的三段式流水线一段对一维。
1.3 与前两篇的入口差
LH 从”自评偏差”进,StructAgent 从”状态表示”进,都在推理时给模型搭外部结构;这篇从”训练信号”进,问权重内部的改动。三个入口的共同敌人是同一个:多步链条里错误 credits(功劳/责任)分不清——执行侧用审计与账本分,训练侧用 turn 级优势分。这个镜像关系是 §八 的主线。
二、核心想法
一句话:把”训练数据从哪来”重构为”环境自动合成 + 依赖图上采样任务”,把”训练信号怎么给”重构为”按 turn 记账、组内同位比较、只给已验证的步发未来功劳”。
这个论断往深一层想,其实是在给 agent RL 补一件被跳过的基本功。市面上谈 agent,注意力多在模型有多聪明;可强化学习这条路上,模型的进步只从反馈里来——反馈不到位,再聪明的底座也练不出来。而反馈要成立,得先有三样东西:够多的练武场、够难的考题、够准的阅卷。缺哪一样,训练都是空转。
先打个比方。这就像办一所教手艺的学校:没有工坊,学生只能听讲、不能动手;没有成体系的考题,只能零敲碎打地练;阅卷若只看最后成品给一个总分,学生永远不知道哪道工序出了错。ToolVerse 干的事,就是把工坊、考题、阅卷这三条线全部自动办起来。
再把比方译回工程语言。练武场,是把真实工具定义自动翻译成可执行沙盒;考题,是在工具依赖图上按拓扑顺序”解锁”出因果连贯的长链任务,并附一条可重放的黄金轨迹;阅卷,是把每个 turn 的工具调用与黄金轨迹对账,对上发 1 分,然后同 turn 跨 rollout 比较定优势。
落到形式上:环境是 F_i(函数)+ D_i(字典数据库),任务采样的证据结构是工具依赖图 G=(V,E),训练信号是逐 turn 的二元奖励 r_{i,t},经组内标准化与门控的未来项融合成 A^{\text{total}}_{i,t}(式 (5),p.5)。
所以这篇真正改变的,是问题的形式:LH 把”长任务执行”重构为”任务状态管理”;这篇把”agent RL 的规模化”重构为”训练数据的自动化生产 + 信用分配的粒度细化”。前者管推理时的账,后者管训练时的账。
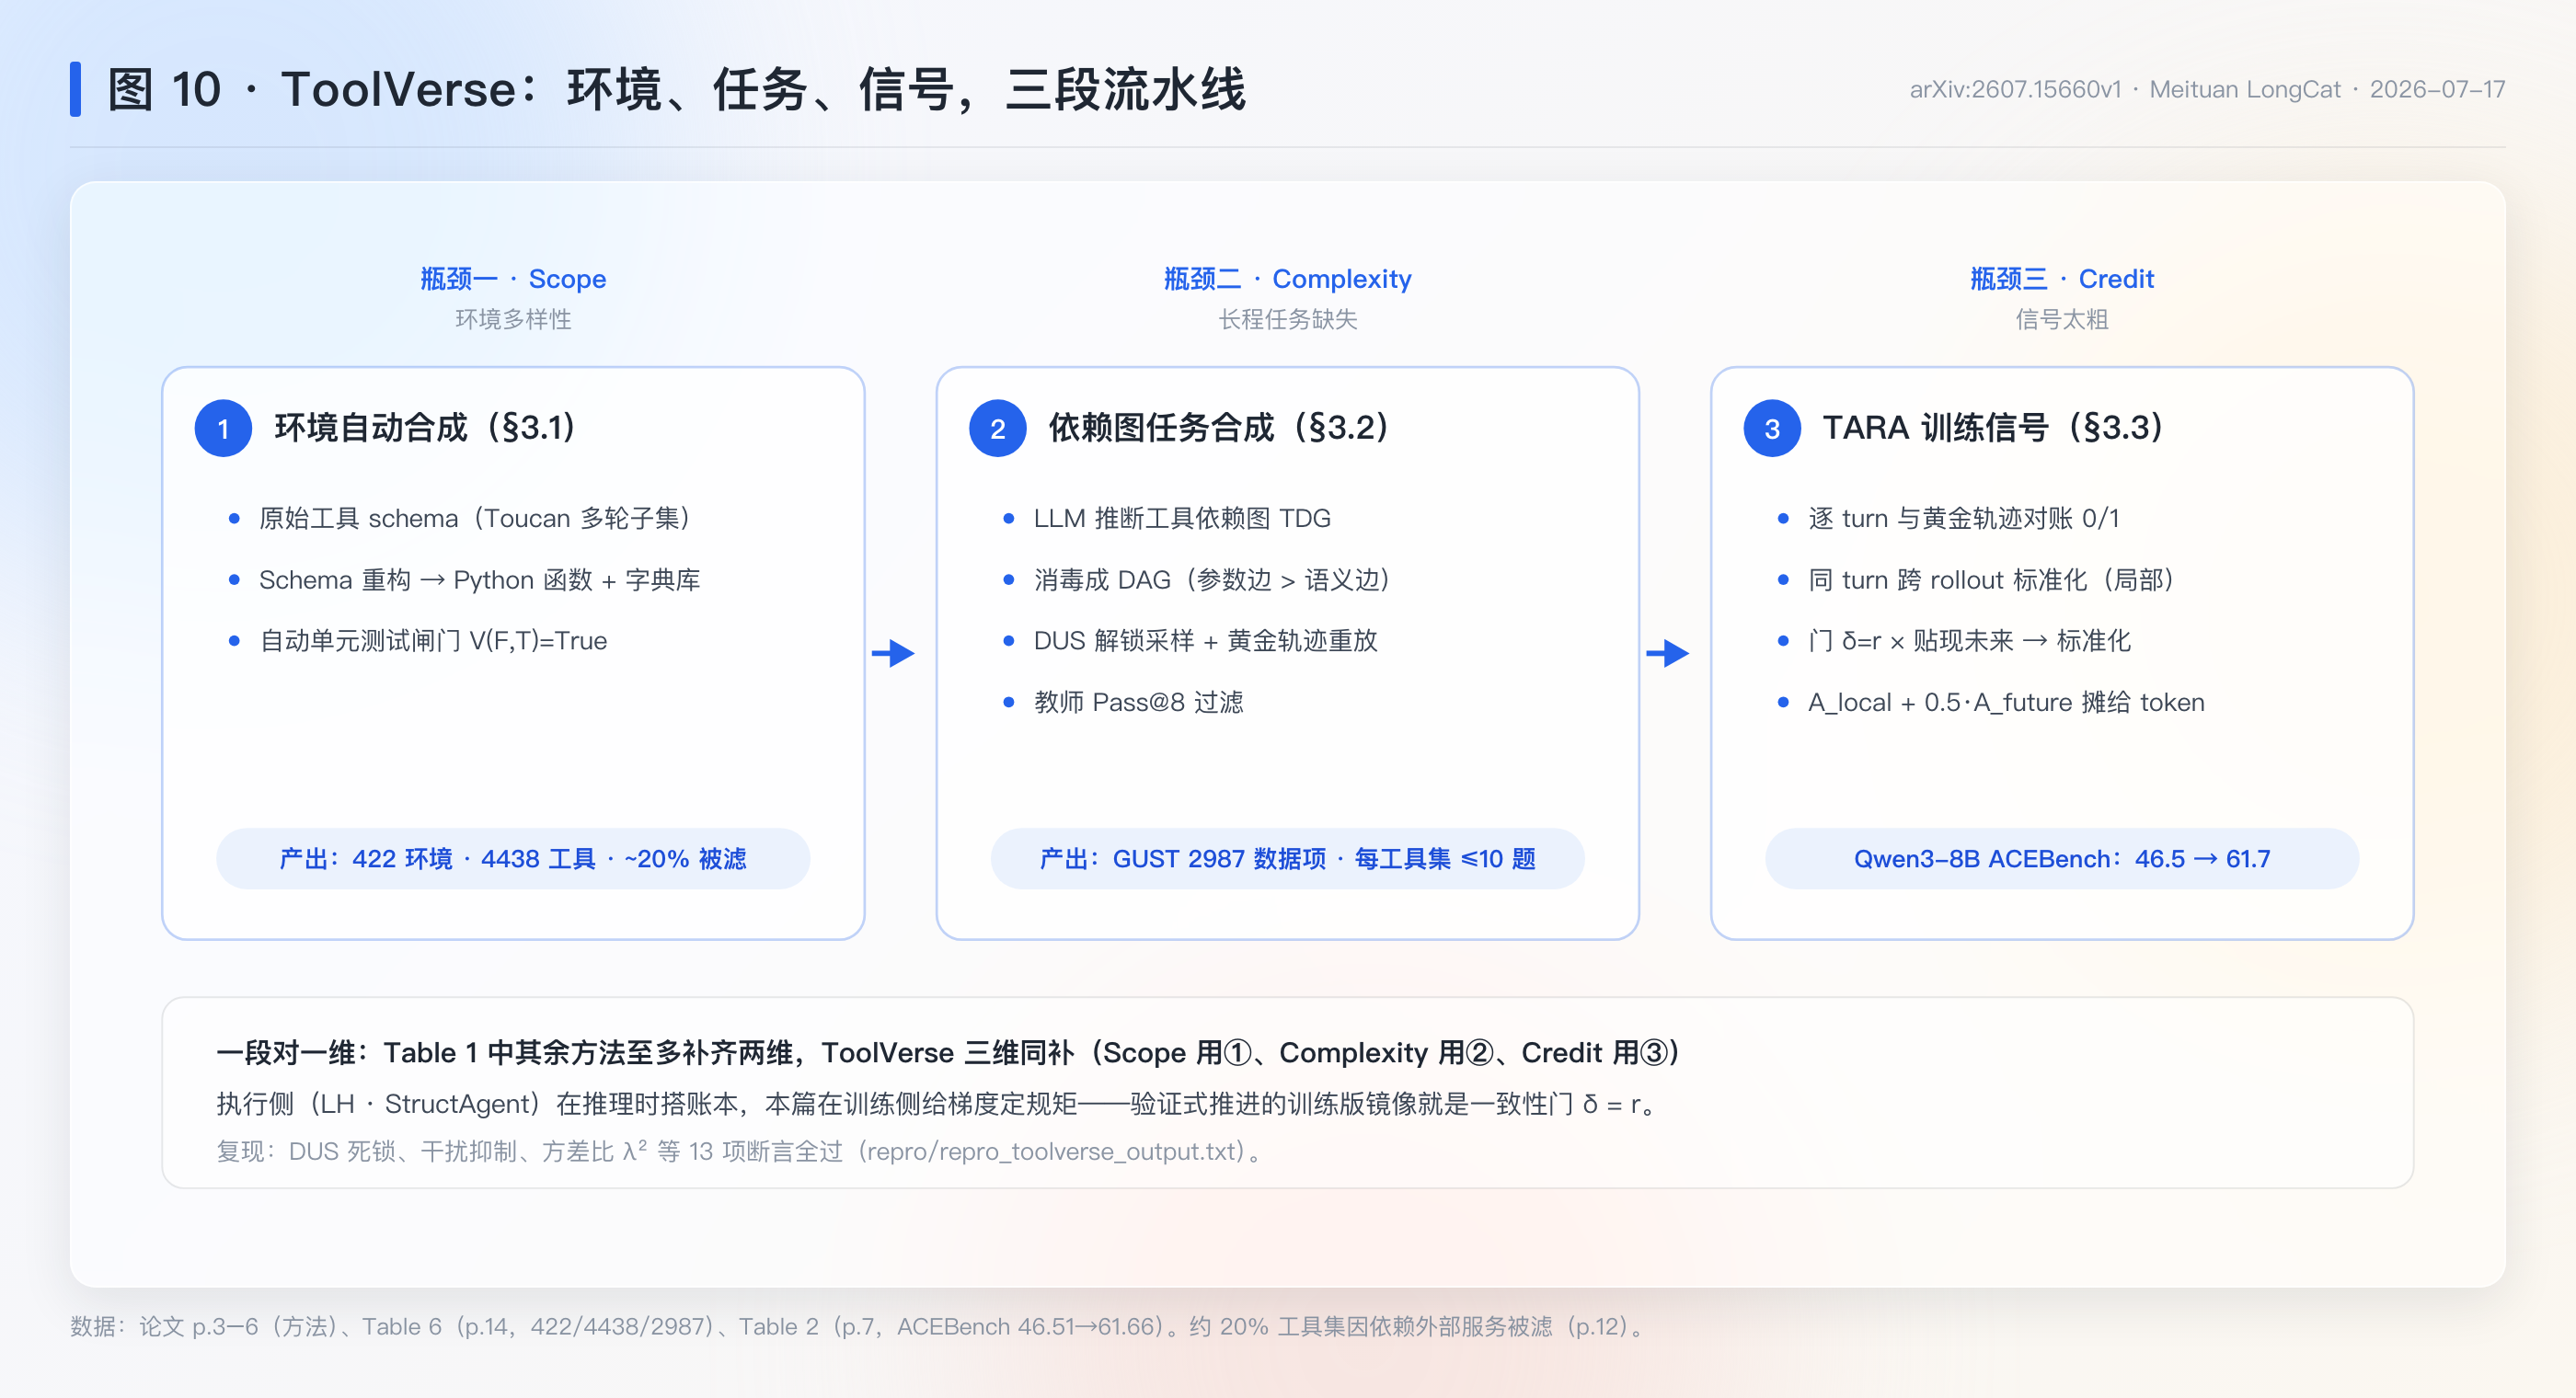
全篇就看这张:图 10(§二)——ToolVerse 三段流水线总览:环境 → 任务 → 训练信号,DUS 逐轮解锁与 TARA 归因都长在这条线上。 ## 三、数学基础(零起点,本篇新用到的五件)
3.1 随机变量、期望与方差
第一件工具是期望与方差,它回答的是:一组数字”平均长什么样”、“散得多开”。别嫌这两笔账简单,后面一切标准化都从它出发。对一组数 x_1,\dots,x_K,期望(这里就是平均)\mu=\frac{1}{K}\sum_i x_i;方差 \sigma^2=\frac{1}{K}\sum_i (x_i-\mu)^2,标准差 \sigma 是方差的平方根,量纲与原数相同。论文的组统计量正是这个定义(式 (19),p.14,除以 K 而不是 K-1)。拿奖励 (1,1,1,0) 练一遍手:\mu=0.75,\sigma^2=\frac{3\times 0.0625+0.5625}{4}=0.1875,\sigma\approx 0.433。记住这把尺子——§6.3 的组内标准化、§6.8 的零方差规则,量的都是它。
3.2 标准化(z-score)与”组内比较”
第二件工具是标准化。有了平均和散度,接下来自然要问:两个不同量纲、不同难度的分数,怎么放在一起比?老办法是各自减均值、除标准差,变成”离平均几个标准差”:z_i=\frac{x_i-\mu}{\sigma+\epsilon},那个 \epsilon 只防除零。这里藏着一条要紧的退化规则:全组同值时 \mu=x_i、\sigma=0,分子为 0,z=0——没有区分度就没有信号。这条规则后面反复出现(B.4,p.13–14),§6.8 还要专门为它记一笔账。还是拿 (1,1,1,0) 练手:标准化后为 (+0.577,+0.577,+0.577,-1.732)——前三名并列”高于平均 0.577 个标准差”。
3.3 几何级数与贴现
第三件工具管”未来的账怎么记”。直觉是未来的奖励要打折——近期的错比远期的错更要紧,折扣因子 \gamma\in(0,1) 就是这个折扣率。从 t+1 起的贴现奖励和写作 R_{t+1:T}=\sum_{k=0}^{T-t}\gamma^k r_{i,t+k+1}。几何级数有个好用的性质:若每步奖励恒为 1、步数够长,和趋近 \frac{1}{1-\gamma};\gamma=0.5 时上界为 2,即”未来功劳最多按 2 步即时奖励计价”。练一遍手:r_{t+1}=1,r_{t+2}=1,其余 0:R=0.5\times 1+0.25\times 1=0.75。这笔折扣账,§6.4 的门控未来项直接用它,§6.6 的方差定理还要靠它估上界。
3.4 有向无环图与入度
第四件工具从画图开始。把依赖关系画成有向图,每个节点头上压着几条还没满足的依赖,这个数就叫”入度”;入度归零,等于依赖全部就位,可以上场了。那么什么顺序能保证人人都能上场?有向图无环(DAG)当且仅当存在一个所有节点都被”解锁”的顺序(拓扑序)。补充:入度归零即解锁的算法就是 Kahn 拓扑排序;若图有环,环上节点入度永远减不到零,队列提前变空——这个”死锁”正是检测环的标准方法(教科书内容,凭记忆引,未核对原始出处)。DUS 的合法性依赖消毒后的图确为 DAG(B.2,p.13)。这件工具马上在 §5.3 的采样机制里开工,§6.9 还要把它改写成矩阵算子。
3.5 方差的运算规则
最后一件工具是三条方差运算规则——后面那条定理的全部家当就是它们,先摆清楚。
- 常数的方差为 0:确定的数没有波动。
- 常数提出:\text{Var}(cX)=c^2\,\text{Var}(X)。
- 和的方差:\text{Var}(X+Y)=\text{Var}(X)+\text{Var}(Y)+2\,\text{Cov}(X,Y);若其中一个量确定(常数),协方差项消失。
练一遍手:X 方差 4,则 \text{Var}(0.5X)=0.25\times 4=1——缩到一半,方差缩到四分之一。别看定理 A.2 唬人,它的全部内容就是这条规则(§6.6 现场推给你看)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| G=(V,E) | 工具依赖图:节点=工具,边=依赖 | §3.2.1,p.4 |
| \text{din}(v) | 节点入度:未满足的依赖数 | Algorithm 1,p.16 |
| Q | 就绪队列:零入度节点集 | §3.2.2,p.4 |
| S_t | 第 t 轮取出的工具子集,k=\min(\lvert Q\rvert,N) | §3.2.2,p.4 |
| T=[S_1,\dots,S_m] | 采样出的多轮轨迹 | §3.2.2,p.4 |
| G_t | 第 t turn 黄金轨迹要求的工具调用 JSON 集合 | 式 (1) 上文,p.4–5 |
| A_{i,t} | 第 i 条 rollout 第 t turn 生成的工具调用 JSON 序列 | 式 (1) 上文,p.4–5 |
| r_{i,t} | turn 级二元奖励:G_t \subseteq_{\text{dict}} A_{i,t} 取 1 否则 0 | 式 (1),p.5 |
| A^{\text{local}}_{i,t} | 局部优势:同 turn 组内标准化 | 式 (2),p.5 |
| V_{i,t} | 门控未来价值:\delta_{i,t}\sum_k \gamma^k r_{i,t+k+1} | 式 (3),p.5 |
| \delta_{i,t} | 一致性门,取 r_{i,t} | §3.3,p.5 |
| A^{\text{future}}_{i,t} | 未来优势:V_{i,t} 的同 turn 组内标准化 | 式 (4),p.5 |
| \lambda | 融合系数,默认 0.5;式 (5) 写 \lambda\in[0,1) | 式 (5),p.5;B.5,p.14 |
| \gamma | 折扣因子,默认 0.5 | B.5,p.14 |
| \epsilon | 数值稳定项,10^{-6} | B.4,p.13–14 |
| K | 组内 rollout 数 | §3.3,p.5 |
五、机制
承上启下:§一 的三堵墙(没地方练、没有题、练了不知道功劳算谁的)在 §二 被重构为一句话——“环境自动合成 + 依赖图采样任务 + turn 级记账”。上节备好的算术正好是三段流水线的读法:标准化与组内比较(§3.2)读 TARA 的逐 turn 记账,几何级数与贴现(§3.3)读门控未来项,入度与拓扑解锁(§3.4)读依赖图采样。本节按论文的三步走机制,贯穿示例的依赖图先立起来。
5.0 贯穿示例的数据结构初始化
示例的六工具依赖图 G=(V,E)。边有两种来历(§3.2.1,p.4):参数依赖(上游输出是下游入参)与语义依赖(逻辑上必须先后)。本例:
| 边 | 类型 | 理由 |
|---|---|---|
| 查会议 → 搜酒店 | 参数 | venue、date 是搜酒店入参 |
| 搜酒店 → 看详情 | 参数 | hotel_id |
| 查会议 → 订酒店 | 参数 | checkin_date |
| 看详情 → 订酒店 | 参数 | 最终价与 hotel_id |
| 订酒店 → 加日历 | 语义 | 没订成不加提醒 |
| 订酒店 → 报差旅 | 参数 | booking_id、amount |
环境侧的字典数据库 D(按 B.1,p.12,每场景 3–5 条记录):
D = {
  "events":   [{"name":"AI 大会","venue":"国家会议中心","date":"2026-09-18"}],
  "hotels":   [{"hotel_id":"H101","name":"国谊宾馆","price":520}, ...],
  "bookings": {},
  "expenses": {}
}
黄金轨迹(Golden Trace)是这个任务的规范解,走到数据结构一级就是一列工具调用 JSON(B.3,p.13):
turn 1: {"name":"search_event","arguments":{"query":"AI 大会"}}
        → {"venue":"国家会议中心","date":"2026-09-18"}
turn 2: {"name":"search_hotels","arguments":{"location":"国家会议中心","checkin_date":"2026-09-18"}}
        → {"hotels":[{"hotel_id":"H101","price":520}]}
turn 3: {"name":"get_hotel_detail","arguments":{"hotel_id":"H101"}} → {"final_price":520}
turn 4: {"name":"book_hotel","arguments":{"hotel_id":"H101","checkin_date":"2026-09-18"}}
        → {"booking_id":"B9001","total":520,"status":"success"}
turn 5: [{"name":"add_calendar_event","arguments":{...}},
         {"name":"submit_expense","arguments":{"booking_id":"B9001","amount":520}}]
注意 turn 4 执行后 D[“bookings”] 多了一条记录——环境是有状态的,后续调用的合法参数取决于前面的更新(B.3,p.13)。
5.1 机制一:环境自动合成闭环(§3.1,p.3;B.1,p.12)
【类比 · 搭练武场】 教人比武,先得有真练武场:不是画饼——招式要真能拆、道具要真能搬;场子搭好还要验收,验收不过不开门。ToolVerse 造环境就是这套流程:工具定义当图纸,字典数据库当场地,单元测试当验收。 【跨域锚点】 制造业的出厂检验制度:过不了质检线就不许出厂,而自动化质检正是批量生产的前提。(类比与通识锚点,非论文内容)
先看病。这是 §一 的第一堵墙:没地方练。现有 agent RL 环境几乎只有代码解释器和搜索引擎这一类(ZeroTIR、SimpleTIR、AGENTFLOW 一族),差旅、库存、预订这类真实业务工具没有现成训练场;请人手工搭环境,一个场景就要数天——论文引用的背景,出处见 §一 第一堵墙。病根在于:环境难造,是因为要造的不是”对工具的描述”,而是”能真的执行、且不会说谎”的东西——描述可以编,执行装不出来。
药方是一条四步合成流水线(p.3),从原始工具定义库 S^{\text{raw}}=\{S_1,\dots,S_N\} 出发:
- Schema 重构 S_i \to \hat{S}_i:清理文本噪声、对齐函数签名,让每个工具能落成”一个 Python 函数”(重构提示词要求参数不超过 4 个、必须有 status/message 响应字段,p.17)。
- 建场景字典库 D_i:推断业务场景(用户、订单、库存),合成 3–5 条互洽记录,让查询类工具的输出能当更新类工具的输入(p.12)。
- 生成可执行函数 F_i=\{f_1,\dots,f_m\}:每个函数查询或更新 D_i。
- 自动单元测试 T_i:只留 V(F_i,T_i)=\text{True} 的工具集;过不了的重新生成或修复,反复失败就丢弃。
验收这道闸是真关的:实践中约 20% 的初始工具集被滤掉,多数因为依赖外部服务或实时状态,字典后端仿不了(p.12)。
意义:训练环境的产能从”人工搭”变成”流水线造”,且”可执行 + 有测试”保证环境不会幻觉——这是它对 LLM 模拟环境路线的主要批评点(p.2)。
5.2 机制二:工具依赖图构造与消毒(§3.2.1,p.4;B.2,p.12–13)
【类比 · 图纸会审】 设计院画的结构图常有管线打架:几条管线撞在同一处,绕成死结,谁也没法施工。会审就是把图摊开,顺着没有前置的部分捋一遍,捋不通的环拆掉最不要紧的一根,改到人人可施工为止。 【跨域锚点】 建筑行业的图纸会审与管线碰撞检测:所有工种必须对着同一张改定图施工,图与现场才不会互相拆台。(类比与通识锚点,非论文内容)
先看病。练武场有了,第二步是出题,而题的骨架是工具之间的依赖。这一步论文交给 LLM,按两条原则推断边——上游输出是下游入参;逻辑顺序上必须先后(p.4)。但 LLM 推的图会有噪声:环、不可执行边。病根在于:LLM 只会”猜”依赖,不会为猜测负责,猜出来的图不能直接当题纲使。
药方是消毒(B.2,p.13):从零入度点拓扑遍历,只保留当前偏序下可达的边;发现环就迭代删环内”优先级最低”的边——参数依赖优先于语义依赖(前者直接锚在工具 schema 上),同级就删”删掉后新解锁节点最多”的那条。产出保证是无环图(DAG)。
拿贯穿示例的图看消毒后的成品:六个节点、六条边、入度 \text{din}:查会议 0,搜酒店 1,看详情 1,订酒店 2,加日历 1,报差旅 1。
意义有两层。工程的一层:后面的采样算法只在 DAG 上正确,消毒是把”LLM 说的依赖”变成”机器可执行的依赖”的闸门。更关键的一层:论文同时承认噪声边的存在无害,因为任务指令、黄金轨迹、判分器都对着同一张消毒后的图生成,三者自洽(B.2,p.13)——这是全文方法自洽性的关键一句。
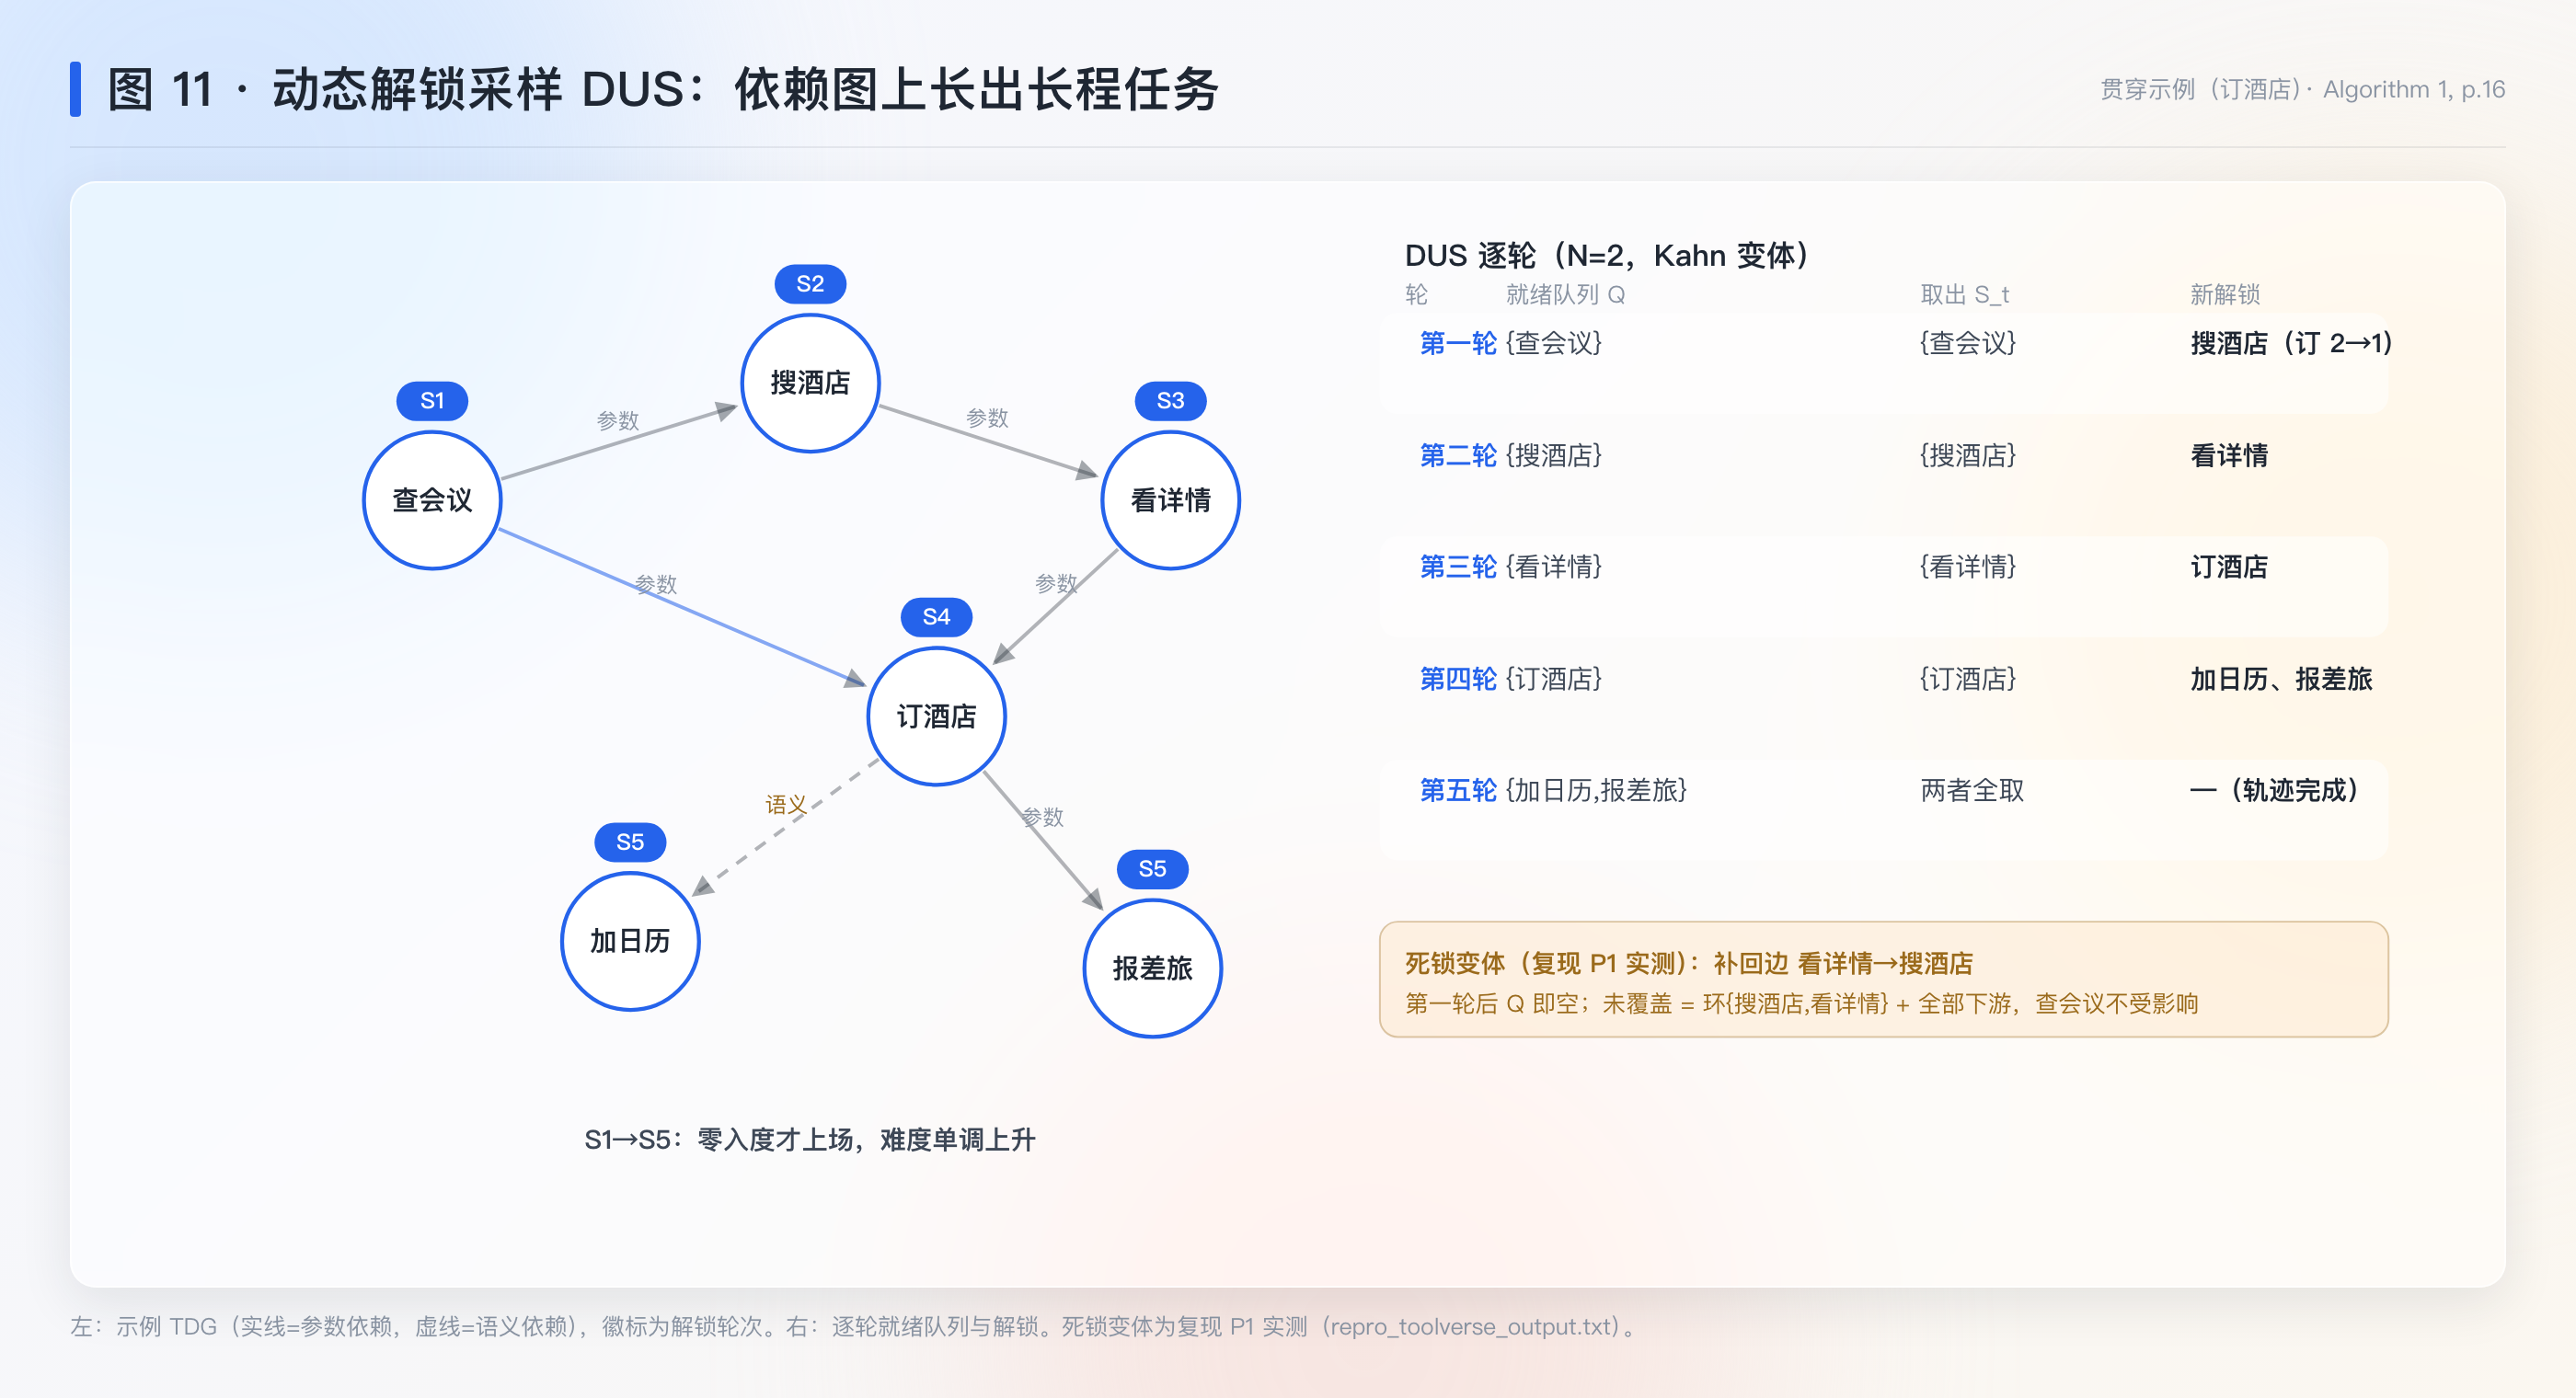
5.3 机制三:动态解锁采样 DUS(§3.2.2,p.4;Algorithm 1,p.16)
【类比 · 先修解锁】 大学排课有一条铁律:先修课没过,后续课选不了。教务每学期只开”先修已满足”的课,学生修完一门,下一层随之解锁——课表天然从基础课走向高阶课,不必人为设计难度曲线。 【跨域锚点】 教务系统的先修链与游戏科技树的”逐级点亮”:合法的解锁顺序本身就是图论里的拓扑序。(类比与通识锚点,非论文内容)
先看病。图消了毒,接着要在这张图上出题。难在哪?长程任务得有人设计:哪些工具按什么顺序串、参数怎么传递、黄金答案是什么——这正是 §一 的第二堵墙。病根在于:任务设计的本质不是文学创作,而是因果编排;而因果编排这件事,图上早有现成的算法。
药方是动态解锁采样(p.4):维护零入度就绪队列 Q;每步取 k=\min(|Q|,N) 个工具组成阶段 S_t;执行后把后继入度减一,减到零的进入 Q;直到 Q 空。
示例全程(N=2):
| 轮 | 就绪队列 Q | 取出 S_t | 执行后入度变化 | 新解锁 |
|---|---|---|---|---|
| 第一轮 | {查会议} | {查会议} | 搜酒店 1→0,订酒店 2→1 | 搜酒店 |
| 第二轮 | {搜酒店} | {搜酒店} | 看详情 1→0 | 看详情 |
| 第三轮 | {看详情} | {看详情} | 订酒店 1→0 | 订酒店 |
| 第四轮 | {订酒店} | {订酒店} | 加日历 1→0,报差旅 1→0 | 加日历、报差旅 |
| 第五轮 | {加日历、报差旅} | {加日历、报差旅} | — | — |
轨迹 T=[S_1,\dots,S_5]。这张表读完,两条性质自己就站出来了。其一,因果合法性:每轮取的工具,其全部依赖已在更早轮出现过——判分与重放都靠它。其二,难度单调上升:前面的轮是简单查询,后面的轮是复杂操作,课程天然成形(p.4:“Simple queries necessarily precede more complex operations”)。
意义:这是 Kahn 拓扑排序的随机化变体(补充:拓扑排序是教科书算法;出处凭记忆引,未核对原始文献)。把”任务设计”变成”图上采样”,长程任务的产能问题被并进图的结构问题——第二堵墙由此拆掉。
5.4 机制四:逆上下文重建与任务化(§3.2.3,p.4;B.3,p.13)
【类比 · 命题试做】 考纲只是骨架,落成考卷还要填血肉:给题目编上具体的人名、数字、前情。填完不算完——命题组得先请人把题做一遍,做不通、答案对不上的题,一律废弃。 【跨域锚点】 大型考试的命题审题制度:试题须经试做与审校才能进考场,“看起来能做”不算数。(类比与通识锚点,非论文内容)
先看病。DUS 产出的是抽象工具骨架——“先查会议、再搜酒店”的顺序有了,但这副骨架还不能当题用:没有具体参数、没有可执行的前情,模型拿到的只是一副空架子。病根在于:骨架与真实数据库状态之间,还差一步”落地”。
药方分两步。第一步,逆上下文重建(p.13):按拓扑序实例化每个调用——依赖型参数从上游工具输出抄,语境型参数(用户 ID、商品名)从当前数据库状态取;状态更新即时同步。第二步,三道质量闸门把关(p.4,p.6):
- 覆盖式采样:每个环境反复采多条轨迹,尽量覆盖环境里所有工具,防止数据塌缩到少数易解锁工具(B.3,p.13)。
- 可执行重放:任务集在 LangGraph 里重放,黄金轨迹必须在状态更新下真实跑通——环境有状态,早先调用会改变后续调用的合法参数,光”看起来对”不算(p.6,p.13)。
- 教师过滤 Pass@8:教师 agent 对每个候选任务最多试 8 次,至少一次拿满 trace_score 才保留;教师选 Qwen3-32B,理由是能力与数据分布接近策略模型(p.6)。每个工具集最多留 10 个任务。
意义:三个闸门分别保证多样性、可执行性、难度适度(教师都解不出的题,策略模型更学不到——留之无益)。
5.5 机制五:TARA——turn 级相对优势(§3.3,p.4–5;附录 A,p.11–12)
【类比 · 逐题判卷】 整卷只公布总分,学生永远不知道错在哪道题;改成逐题判分,错处当场现形。再立一条阅卷纪律:这道题你没做对,后面哪怕蒙对了,功劳也不许记到这道题头上。 【跨域锚点】 工程审计的”坏账不得冲抵”:逐笔记账,不许拿后来的盈余掩盖前面的亏空。(类比与通识锚点,非论文内容)
先看病。这是第三堵墙:练了也不知道功劳算谁的。标准 GRPO 把整条轨迹的奖励归一化后,把同一个标量优势摊给响应里所有 token;长程任务里这分不清”中间步对、后面临门错”与”全错”(p.4)。病根在于记账的粒度:轨迹级的一笔总账,把每一步各自的功过抹平了。
药方是 TARA:把优势拆到每个 turn,分两个成分——Local(本步即时对错)与 Future(对后续的影响),future 项带一致性门(p.4–5)。公式全部推法在 §六;机制的三个设计决定先在这里点出。其一,判分对象是”turn 的工具调用集合”与黄金轨迹的字典级覆盖(G_t \subseteq_{\text{dict}} A_{i,t},式 (1),p.5),不是字符串精确匹配;turn 内依赖相容的顺序都算对,因为 TDG 定义的是因果约束不是全序(p.5)。其二,组内比较是”同 turn 跨 rollout”:第 t turn 的优势,用 K 条 rollout 在同一 turn 的奖励分布做标准化(图 2,p.5)——同位比较,不同 turn 的分布不混。其三,一致性门 \delta_{i,t}=r_{i,t}:本步错了,未来再多的”运气好”也不给这步记功劳(p.5)。算出的 turn 优势均匀摊给该 turn 的所有 token(图 2,p.5)。
意义:三条合起来,是把执行侧”只信验证过的事实”翻译成了训练侧”只给验证过的步发梯度”。
六、数学展开
6.1 基线:GRPO 的轨迹级记账
先看这笔账的旧记法。一组学生各做完整张卷子,只公布总分;给每人的分数减去平均、除以标准差,就是”相对全班好多少”——整份答卷每个字都记这一个分。GRPO(组相对策略优化)就是这么记的:对同一题采样 K 条轨迹,轨迹级回报 R_i(这里=全程对错),优势
A_i^{\text{GRPO}}=\frac{R_i-\mu_t}{\sigma_t+\epsilon}
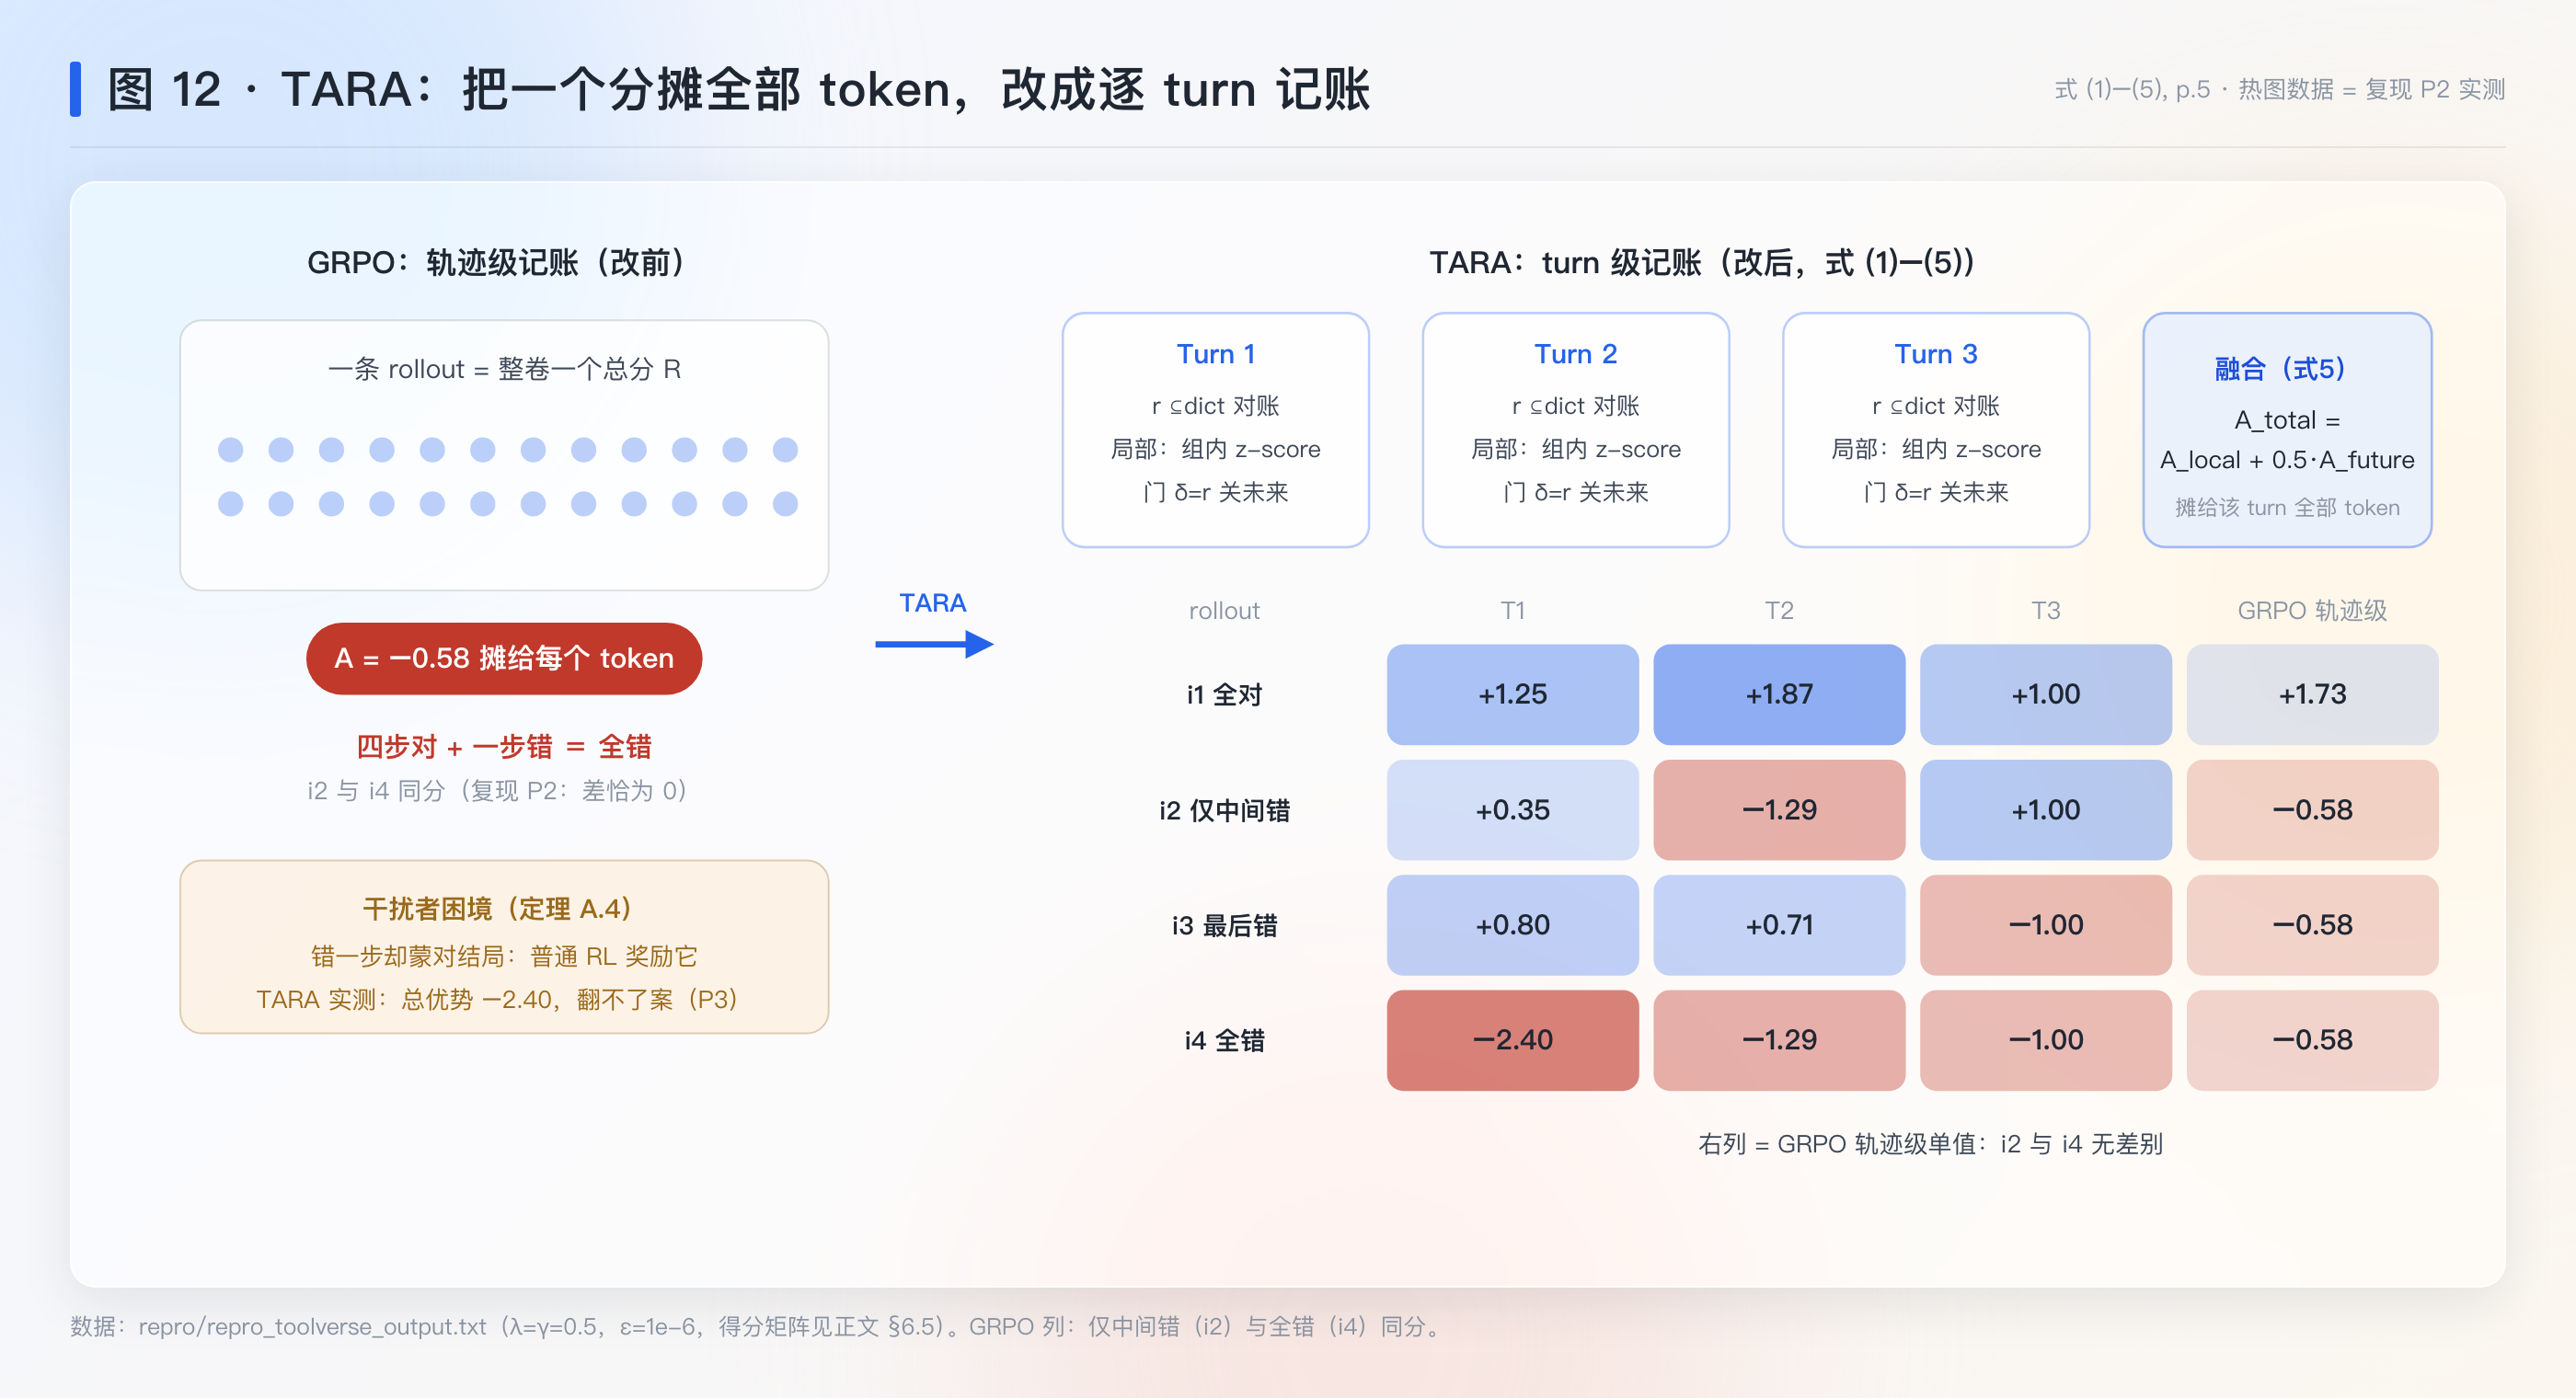
然后整条响应所有 token 共用 A_i^{\text{GRPO}}(§3.3,p.4)。问题用数字看:四条轨迹总分为 (1,0,0,0) 时,\mu=0.25、\sigma\approx 0.433,优势为 (+1.73,-0.58,-0.58,-0.58)。第二条轨迹”四步对、第五步错”与第四条”全错”拿完全一样的 -0.58——中间步的正确性信息被扔掉了。这就是论文说的”coarse-grained feedback”(p.4)。
6.2 turn 级二元奖励与字典级覆盖
先看这笔账的来历。阅卷从”整卷一个分”改成”逐题判分”:第 t 题的答案要覆盖标准答案要求的全部要点,少调用一个工具、参数对不上,这道题就是 0 分。公式(式 (1),p.5):
r_{i,t}=\begin{cases}1.0,&\text{if } G_t \subseteq_{\text{dict}} A_{i,t}\\ 0.0,&\text{otherwise}\end{cases}
逐符号:G_t 是黄金轨迹第 t turn 要求的工具调用 JSON 对象集合;A_{i,t} 是第 i 条 rollout 在该 turn 生成的调用序列;\subseteq_{\text{dict}} 是字典级覆盖——工具名与参数按字典匹配,缺调用或参数不匹配即 0(p.5)。
为什么这样设计:任务参数来自上游输出(如 D[“bookings”] 里刚生成的 booking_id),参数错就是因果断链;而字符串级匹配太脆,字典级匹配允许”依赖相容”的顺序差异——TDG 定因果,不定全序(p.5)。
边界(补充,论文未展开):覆盖判分以单条黄金轨迹为参照,同一任务若存在另一条合法路径(比如先报差旅后加日历),跨 turn 的顺序差异会被判 0。论文只承诺 turn 内顺序自由;跨 turn 替代路径问题记入 §九 与 §十二。
数值例:黄金 turn 2 要求
search_hotels(location, checkin_date),rollout
生成了该调用且两个参数与上游输出一致 → r_{i,2}=1;漏了 checkin_date
→ 0。
6.3 局部优势:同 turn 组内标准化
先看这笔账的来历。同一道题,比较的是全班(K 条 rollout)谁做对了这道题,而不是比较总分。公式(式 (2),p.5):
A^{\text{local}}_{i,t}=\frac{r_{i,t}-\mu^{\text{local}}_t}{\sigma^{\text{local}}_t+\epsilon}
逐符号:\mu^{\text{local}}_t,\sigma^{\text{local}}_t 是 \{r_{1,t},\dots,r_{K,t}\} 的均值与标准差(式 (19) 同款,除以 K)。全组同分时优势记 0——没有组内偏好信号(p.5;B.4)。
为什么:奖励是 0/1,直接用会偏(多数 turn 全对,均值贴着 1);标准化后,“这 turn 比同组人好多少”量纲统一,且不同 turn 的难度差异被吸进各自的 \mu,\sigma。
数值例:第 1 turn 四条 rollout 得分 (1,1,1,0):\mu=0.75,\sigma=0.433,优势 (+0.577,+0.577,+0.577,-1.732)。
6.4 门控未来优势
先看这笔账的来历。光看本题对错还不够——本题对了,还要求它”喂”给后面的步骤也是对的,才算真本事;但本题错了的话,后面做得再好也是无源之水,不许把这步的功劳透支给未来。一致性门就是这道闸。公式(式 (3)–(4),p.5):
V_{i,t}=\delta_{i,t}\cdot\sum_{k=0}^{T-t}\gamma^k\, r_{i,t+k+1},\qquad A^{\text{future}}_{i,t}=\frac{V_{i,t}-\mu^{\text{future}}_t}{\sigma^{\text{future}}_t+\epsilon}
逐符号:\delta_{i,t}=r_{i,t} 是一致性门(p.5);内层和是从 t+1 起的贴现奖励和(§3.3);V_{i,t} 再做同 turn 组内标准化。
为什么这样设:刚性工具环境里,本步错了后续任务通常跟着作废,未来信号大半是噪声;门关上(\delta=0\Rightarrow V=0)等于声明”错误步不参与未来记账”。论文在 p.5 给的理由原文是 “ensuring that future rewards are only credited if the current step is valid”。
边界:\gamma=0.5 下未来和的上界是 2(§3.3),未来项最多与局部项同量级;\lambda<1 再压一层——设计上未来项永远是配角。
数值例(T=3,\gamma=0.5):rollout 得分 (1,0,1):V_{i,1}=1\times(0.5\times 0+0.25\times 1)=0.25;第 2 turn 门关:V_{i,2}=0;第 3 turn 无未来:V_{i,3}=0。对照 (1,1,1) 的 V=(0.75,0.5,0)——同样是”最后一题对”,中间错的那个未来价值折半。
6.5 融合:总优势
公式(式 (5),p.5):
A^{\text{total}}_{i,t}=A^{\text{local}}_{i,t}+\lambda\cdot A^{\text{future}}_{i,t}
逐符号:\lambda 是混合系数,默认 0.5(p.5;B.5,p.14)。敏感性实验:\lambda=\gamma=0.5 最优,双向偏离都掉分(图 5,p.15)。
为什么:局部项管”这一步相对同组好多少”,未来项管”这一步是否位于一条能走通的链上”。相加后按 turn 摊给该 turn 全部 token(图 2,p.5)。
数值例(贯穿全程的手算,\lambda=0.5,\gamma=0.5,四条 rollout 三 turn,得分矩阵行为 rollout 列为 turn):
r = [[1,1,1],     # i1 全对
     [1,0,1],     # i2 仅第 2 turn 错(错后恢复)
     [1,1,0],     # i3 最后错
     [0,0,0]]     # i4 全错
轨迹级 GRPO(R_i=1 当且仅当全对):R=(1,0,0,0),优势 (+1.73,-0.58,-0.58,-0.58)——i2 与 i4 无差别。TARA 逐项算(\epsilon 忽略):
| A^{local}_1 | A^{local}_2 | A^{local}_3 | A^{future}_1 | A^{future}_2 | A^{total}_1 | A^{total}_2 | A^{total}_3 | |
|---|---|---|---|---|---|---|---|---|
| i1 | +0.577 | +1 | +1 | +1.342 | +1.732 | +1.248 | +1.866 | +1 |
| i2 | +0.577 | −1 | +1 | −0.447 | −0.577 | +0.354 | −1.289 | +1 |
| i3 | +0.577 | +1 | −1 | +0.447 | −0.577 | +0.801 | +0.711 | −1 |
| i4 | −1.732 | −1 | −1 | −1.342 | −0.577 | −2.403 | −1.289 | −1 |
(手算复验:t_1 局部组 (1,1,1,0) 得 \sigma=0.433;future 在 t_1 的组值 (0.75,0.25,0.5,0) 得 \mu=0.375,\sigma=0.2795;t_3 的 future 组全 0,零方差记 0。)
读表三句话:i2 的错误 turn 拿到全场最负的 -1.289,而它的正确 turn 是正的——错在哪一 turn,账就记在哪一 turn;GRPO 把 i2 与全错的 i4 同判 -0.58;i3 的”最后一错”在 t_3 记 -1,但它 t_2 的功劳 +0.711 保住了。这张表就是 TARA 的全部卖点,复现脚本将程序化重算它。
6.6 定理一(A.2):方差缩减
先看这笔账的来历。未来是随机的、方差大;把未来项乘一个 \lambda<1,等于给”远期噪音”降音量——方差按平方缩,音量降得多。要把这句话证成定理,先立假设(A.1,p.11):即时奖励 r_{i,t} 给定匹配与否是确定的(对上黄金就 1,否则 0,无随机);未来和 R_{t+1:T}=\sum_{k=1}^{T-t}\gamma^k r_{i,t+k} 是随机变量(策略与环境在后续步有随机性),方差记 \sigma^2_{\text{future}}。然后定理开口(A.2,p.11):对有效步(r_{i,t}=1,门开),估计量 G^{\text{ours}}_t 的方差严格小于标准 return-to-go G^{\text{std}}_t 的方差,只要 \lambda<1。
推导(逐行,p.11 式 (8)–(14)):
\text{Var}(G^{\text{std}}_t)=\text{Var}(r_{i,t}+R_{t+1:T})=\text{Var}(r_{i,t})+\text{Var}(R_{t+1:T})+2\,\text{Cov}(r_{i,t},R_{t+1:T})
假设 A.1 下 r_{i,t} 确定,第一项为 0、协方差项消失,只剩 \sigma^2_{\text{future}}。而
\text{Var}(G^{\text{ours}}_t)=\text{Var}(r_{i,t}+\lambda\cdot 1\cdot R_{t+1:T})=\lambda^2\sigma^2_{\text{future}}
\lambda<1\Rightarrow\lambda^2<1,得证。无效步(r_{i,t}=0)门关,V_{i,t}=0,方差恰为 0。
白话回译:标准记账的噪音全来自未来;TARA 把未来那部分缩到 \lambda 倍,噪音按 \lambda^2 缩。\lambda=0.5 时噪音只剩四分之一。无效步干脆零噪音。
补充(这个证明与实现的缝,进 §九):定理针对的是式 (7) 的原始价值估计 G^{\text{ours}}_t=r_{i,t}+\lambda V_{i,t};实现里 Local 与 Future 各自组内标准化后再相加(式 (2)(4)(5)),标准化会改变方差结构,定理的量在实现里并不直接出现。方向性结论(未来项降权降噪)仍成立,但”\lambda^2 倍”这个数属于证明里的量,不属于训练里的量。
6.7 定理二(A.4):干扰动作抑制
先看这笔账的来历。agent 走错一步却”蒙对”了后面(环境宽容或巧合),普通 RL 会因为终点成功奖励这条错误路径;TARA 要证明的是:蒙的不给记。论文先给”蒙对”起名(定义 A.3,p.11):干扰动作(distractor)= 偏离黄金轨迹(r_{i,t}=0)但后续回报为正(R_{t+1:T}>0)的动作。定理随之而来(A.4,p.11–12):干扰动作的总优势保证非正,与未来回报大小无关。
推导(逐行,p.11–12 式 (15)–(18)):局部项 A^{\text{local}}_{i,t}=\frac{0-\mu^{\text{local}}_t}{\sigma^{\text{local}}_t+\epsilon}。若组内有解(至少一条 rollout 拿满轨迹,\mu^{\text{local}}_t>0),局部项严格为负。future 项:门 \delta_{i,t}=r_{i,t}=0 关死,V_{i,t}=0\times R_{t+1:T}=0,于是 A^{\text{future}}_{i,t}=\frac{0-\mu^{\text{future}}_t}{\sigma^{\text{future}}_t+\epsilon}\le 0(组未来均值 \mu^{\text{future}}_t>0 时为负,\approx 0 时为零)。总优势 = 负 + 非正 = 严格负,该动作的概率必被压低。
白话回译:蒙对的部分被门整个拦下,账面只剩”这步确实错了”的负分;只要组里有人真会做(\mu>0),蒙的人一定比平均差。
边界(补充):前提是 \mu^{\text{local}}_t>0。若全组在该 turn 都错(没人会做),\sigma=0 触发零方差规则,优势记 0——不是惩罚变奖励,而是彻底没信号。最难的 turn 恰好得不到梯度,这是”全组失败 = 学习停止”的退化,与课程式任务生成相互拉扯,进 §九。
6.8 零方差退化规则(B.4,p.13–14)
先看这笔账的来历。全班同分的题,判卷不排名次。全组同值 x_{1,t}=\dots=x_{K,t} 时,\mu^x_t=x_{i,t}、\sigma^x_t=0,分子 x_{i,t}-\mu^x_t=0,故
A^x_{i,t}=\frac{0}{0+\epsilon}=0
对 local 与 future 两个成分分别成立(式 (25)(26),p.14)。论文的理由:GRPO 靠组内相对比较,无差异的 turn 不该推着策略往任何方向走(p.14)。
6.9 DUS 的图论形态:入度更新算子化
补充(论文给的是伪代码,这里给算子式):设邻接矩阵 M(M_{uv}=1 当 u\to v 有边),入度向量 D。DUS 每轮做
S_t\subseteq Q,\ k=\min(\lvert Q\rvert,N),\qquad D\leftarrow D-M^{\top}\mathbb{1}_{S_t},\qquad Q\leftarrow Q\cup\{v: D_v=0\}
即”执行 S_t“在数学上就是从各后继入度减去 1。合法性命题:S_t 中每个节点此刻入度为 0,等价于其全部依赖出现在 \bigcup_{s<t}S_s 中——这就是”任务前缀因果完备”。终止性命题:Q 清空时全部节点已解锁当且仅当 G 无环;有环时未覆盖集合恰好是”环上的节点 + 环的全部下游”。这条命题给出一个便宜的环检测器,复现 P1 直接检验它。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| GRPO / 组相对策略优化 | 待补 | TARA 的基座。本文只用了它的组内标准化形式;PPO 谱系、KL 罚、clip 等未展开(训练里 KL loss 被关掉,p.14,为什么关是现成问题) |
| 策略梯度 / 优势函数 | 待补 | “优势=相对平均好多少”本篇够用;\nabla\log\pi 层面未展开 |
| 折扣回报 / return-to-go | 已懂(本篇 §3.3 现场推导) | 够支撑式 (3) 与定理 A.2 |
| DAG / 拓扑排序 / 入度 | 已懂(§3.4、§6.9) | 教科书内容;DUS = Kahn 变体 |
| MCP(Model Context Protocol) | 待补 | 本文环境的目标载体;协议细节未展开(历史归属凭记忆:Anthropic 2024 年发布——未核对) |
| TIR(tool-integrated reasoning)谱系 | 待补 | ZeroTIR/SimpleTIR/ToolRL/ToolStar 等只见定位(Table 1,p.2),机制未读 |
| BFCL-v3 / τ²-Bench / ACEBench 评分规则 | 待补 | 三基准口径(尤其 τ² 的 dual-control 用户模拟器)未核;并入既有待补”基准评分规则”节点 |
| Verl(HybridFlow) | 待补 | 训练框架,本文只在(p.3)引用 |
| 方差/协方差运算 | 已懂(§3.5) | 支撑附录 A |
“待补”节点会在此后每篇的分支笔记里逐个补齐;GRPO 排第一顺位。
八、扩展与发散
8.1 训练侧与执行侧的同一道题:功劳归谁、错误止于哪一步
发散:把三篇并排看。执行侧的病:中间假设被当事实(LH 的自评偏差、StructAgent 的”观察出的已完成不等于真完成”),药方是审计与验证式状态转移。训练侧的病:终局奖励分不清哪步的功劳,药方是 TARA——turn 级对账 + 一致性门。两边的结构同构:黄金轨迹扮演审计基准;r_{i,t}=0 扮演”验证失败”;\delta 门扮演”验证不过不给记功劳”;StructAgent 的 Invalidated 是把已记账目撤销,TARA 的门是让坏账根本进不了账。差别在作用面:执行侧改一次推理的行为,训练侧改的是梯度分布,练进权重后推理时不再需要外部账本——至少愿景如此。
再深一层,两篇执行侧复现的结论(漏报重试的二次破坏、retry storm)在训练侧的对应物是:如果奖励本身有漏报(把对的判成错),TARA 的门会系统性压掉”合法替代路径”——验证通道的 fp/fn 在训练侧不是评一次分的代价,是被反复强化的方向偏差。这把簇的”验证通道质量”问题从评测抬到了训练。
回到这篇:TARA 的两条定理其实就是”验证的经济学”在训练侧的定价——方差缩减定理给”少信未来”定了价(噪音 \times\lambda^2),干扰抑制定理给”不信蒙对”定了价(正回报不改变负优势)。
8.2 GRPO 族谱与”无 critic”路线
发散:本文所在的谱系(外部断言除标注外均转述自论文参考文献与正文,p.1–2、p.9–10)。GRPO 出自 DeepSeekMath(Shao et al., 2024,论文参考文献 p.9 已核):砍掉价值网络,用组内平均当基线。多轮 TIR 方向:ZeroTIR 研究 agent RL 的 scaling law;SimpleTIR 过滤”void”轨迹稳定多轮训练;ToolStar 协调搜索与代码双工具;ToolRL 主张奖励设计是工具学习的全部——它已经是”稠密”(Table 1),但稠密在奖励设计而非 turn 粒度。TARA 的位置:把”相对化”从轨迹级搬到 turn 级,再把未来项用门控折扣接回来。族谱的走向读出来是”基线越来越便宜、信号越来越细”。
(我的引申,未核对:GRPO 族对 PPO 的批评是”critic 难训且贵”;turn 级化之后,A^{\text{future}} 事实上扮演了一个廉价 critic——用黄金轨迹折扣和代替学习出来的价值函数。它只在”有标准答案”的任务上可行,这解释了为什么这套方法首先出现在可判分的工具环境而非开放域。)
回到这篇:Table 1 第三列是本文给自己划的坐标,读谱系是为了确认这个坐标不虚——同列其余方法全是”结果(稀疏)“,只有 ToolRL 半步(奖励稠密、非 turn 级)。
8.3 环境合成路线与保真度阶梯
发散:训练环境四条路线。一,LLM 模拟环境(模型演环境):省事,但幻觉、状态管理差(p.2,论文原话:hallucinations, inconsistency, inadequate management of persistent states)。二,静态数据库捕获(p.2 引 Fang/Ye):保真但死。三,本文的可执行 mock:真工具 schema + 字典后端 + 单元测试,约 20% 工具集因”外部服务、实时状态、领域副作用”仿不了被滤掉(p.12)——这条淘汰线就是保真度边界。四,真实沙盒(OSWorld 类虚拟机,LH/StructAgent 的评测侧):最真,最贵。
阶梯读出的张力:训练侧走高产能低保真,评测侧走低保能高保真。两边环境形态不同(字典世界 vs 屏幕/终端世界),所以 ToolVerse 的提升只能用 BFCL/τ²/ACEBench 这类”调用级”基准验证,从不碰 OSWorld——这不是遗漏,是保真度阶梯上的自觉站位(推断,依据:Table 2 基准选择 + 环境形态)。与簇的联结:执行侧两篇证明了真实沙盒里 harness 有效;这篇押注”调用级练出来的能力可以迁移”,迁移距离没有被论文检验。
回到这篇:mock 环境是全文最大胆的交换——用保真度换产能,422 个环境、4438 个工具、2987 个数据项的规模(Table 6,p.14)由此而来;这个交换的代价表论文没给,进 §九。
8.4 两条定理的实际含义与边界
发散:定理 A.2 与 A.4 都是小而干净的命题,值得单独掂量。A.2 的全部数学是 §3.5 的三条方差规则,它真正的假设藏在”即时奖励确定”(A.1)里——黄金轨迹把奖励从”环境评”变成”对答案评”,随机性才被挤到未来项。换句话说:方差缩减的功臣一半是 \lambda,一半是”有标准答案”这件事本身。开放域没有黄金轨迹,A.1 不成立,定理无处落脚。
A.4 的价值在反事实:普通 RL 里”错步 + 好结局”是正优势、被强化;TARA 把结局与步分离。这个性质对簇问题的意义:执行侧 verify-retry 的”止损”纠结(错了要不要重试、重试几次)在训练侧被提前消解——错步的负优势不因后续成功而翻案,梯度层面就没有”鼓励侥幸”的通道。但 6.7 的边界成立时(全组同错),信号归零:门是硬止损,硬止损的代价是最难的题没人学。
回到这篇:两条定理合起来说的其实是一句话——“有标准答案的密集判分 + 对未来降权 + 对蒙对关门”能同时降噪音和防侥幸;三个条件缺一个,定理就退回经验技巧。
8.5 黄金轨迹:充分统计量的训练侧形态,与教师过滤的偏置
发散:黄金轨迹是一条可执行、可重放、逐步可判分的规范解。对照簇内的”状态作为充分统计量”(StructAgent §6.5):任务状态要从历史里提取”足够决策的信息”,黄金轨迹则把”足够判分的信息”提前物化。两者是同一个思想(把扩散在历史里的规范压缩成小对象)在推理侧与数据侧的两个投影。DUS + 逆上下文重建是它的生产流水线:图给因果骨架,字典库给状态,重放给可执行性检验。
教师过滤(Pass@8,教师=能力接近策略模型的 Qwen3-32B,p.6)值得单独停一下:它保证”题可解”,同时把任务分布修剪到教师能力边界以内。推论:任务难度不是任务自身的属性,而是任务×教师的属性——这与 LH 的”agent 能力是模型×harness 系统属性”是同一枚硬币的数据侧。被剪掉的是教师做不出但对更强策略有训练价值的题;GUST 训练 8B/14B 模型时这道剪裁的损失不可见,换更强底座时会成为天花板(推断,论文未讨论)。
回到这篇:黄金轨迹是全文的支点——判分、门控、定理 A.1 全部押在它上面;它的生产质量(图对不对、字典库真不真、教师剪了多少)决定整套信号的可信度,而论文对”黄金轨迹自身的错误率”没有给数(查无,进未攻克)。
8.6 发散收拢
把四条支线拽回来:8.1 说 TARA 是执行侧验证纪律的训练侧镜像,本文的定位由此接进簇;8.2 说它在 GRPO 族谱里站在”信号最细”一格;8.3 说它的环境是保真度换产能的自觉选择;8.4/8.5 说整套信号的全部信用押在黄金轨迹上。合起来,这篇补的洞是”agent 怎么学”的第一块:环境与信号的规模化生产。剩下的洞在训练本身——策略梯度怎么走、KL 为什么关、turn 级信号在无标准答案任务上怎么造——那是这条新支线的下一颗种子。
九、局限与可疑处
- \lambda 的定义域前后不一。式 (5) 写 \lambda\in[0,1)(p.5),附录 A.1 写 \lambda\in[0.5,1.0](p.11),且定理证明用 \lambda<1。取值 0.5 两处一致,此为笔误级不一致,但与 LH 摘要/正文矛盾同类——转引数字前先核对两处。同类的还有式 (3) 的求和上界:\sum_{k=0}^{T-t} 在 k=T-t 时索引到不存在的 r_{i,T+1},附录式 (6)(7) 的界(共 T-t 项、末项 r_{i,T})才是自洽的;本篇推导与复现按自洽界执行。
- 理论与实现的缝。定理 A.2 针对原始价值估计 G^{\text{ours}}_t(式 (7)),实现是 local/future 各自标准化后再融合(式 (2)(4)(5));“\lambda^2 倍方差”属于定理里的量。结论 p.9 说 “We proved the correctness”,实际证明的是方差缩减与干扰抑制两个性质,“correctness” 措辞过强(我的判读)。
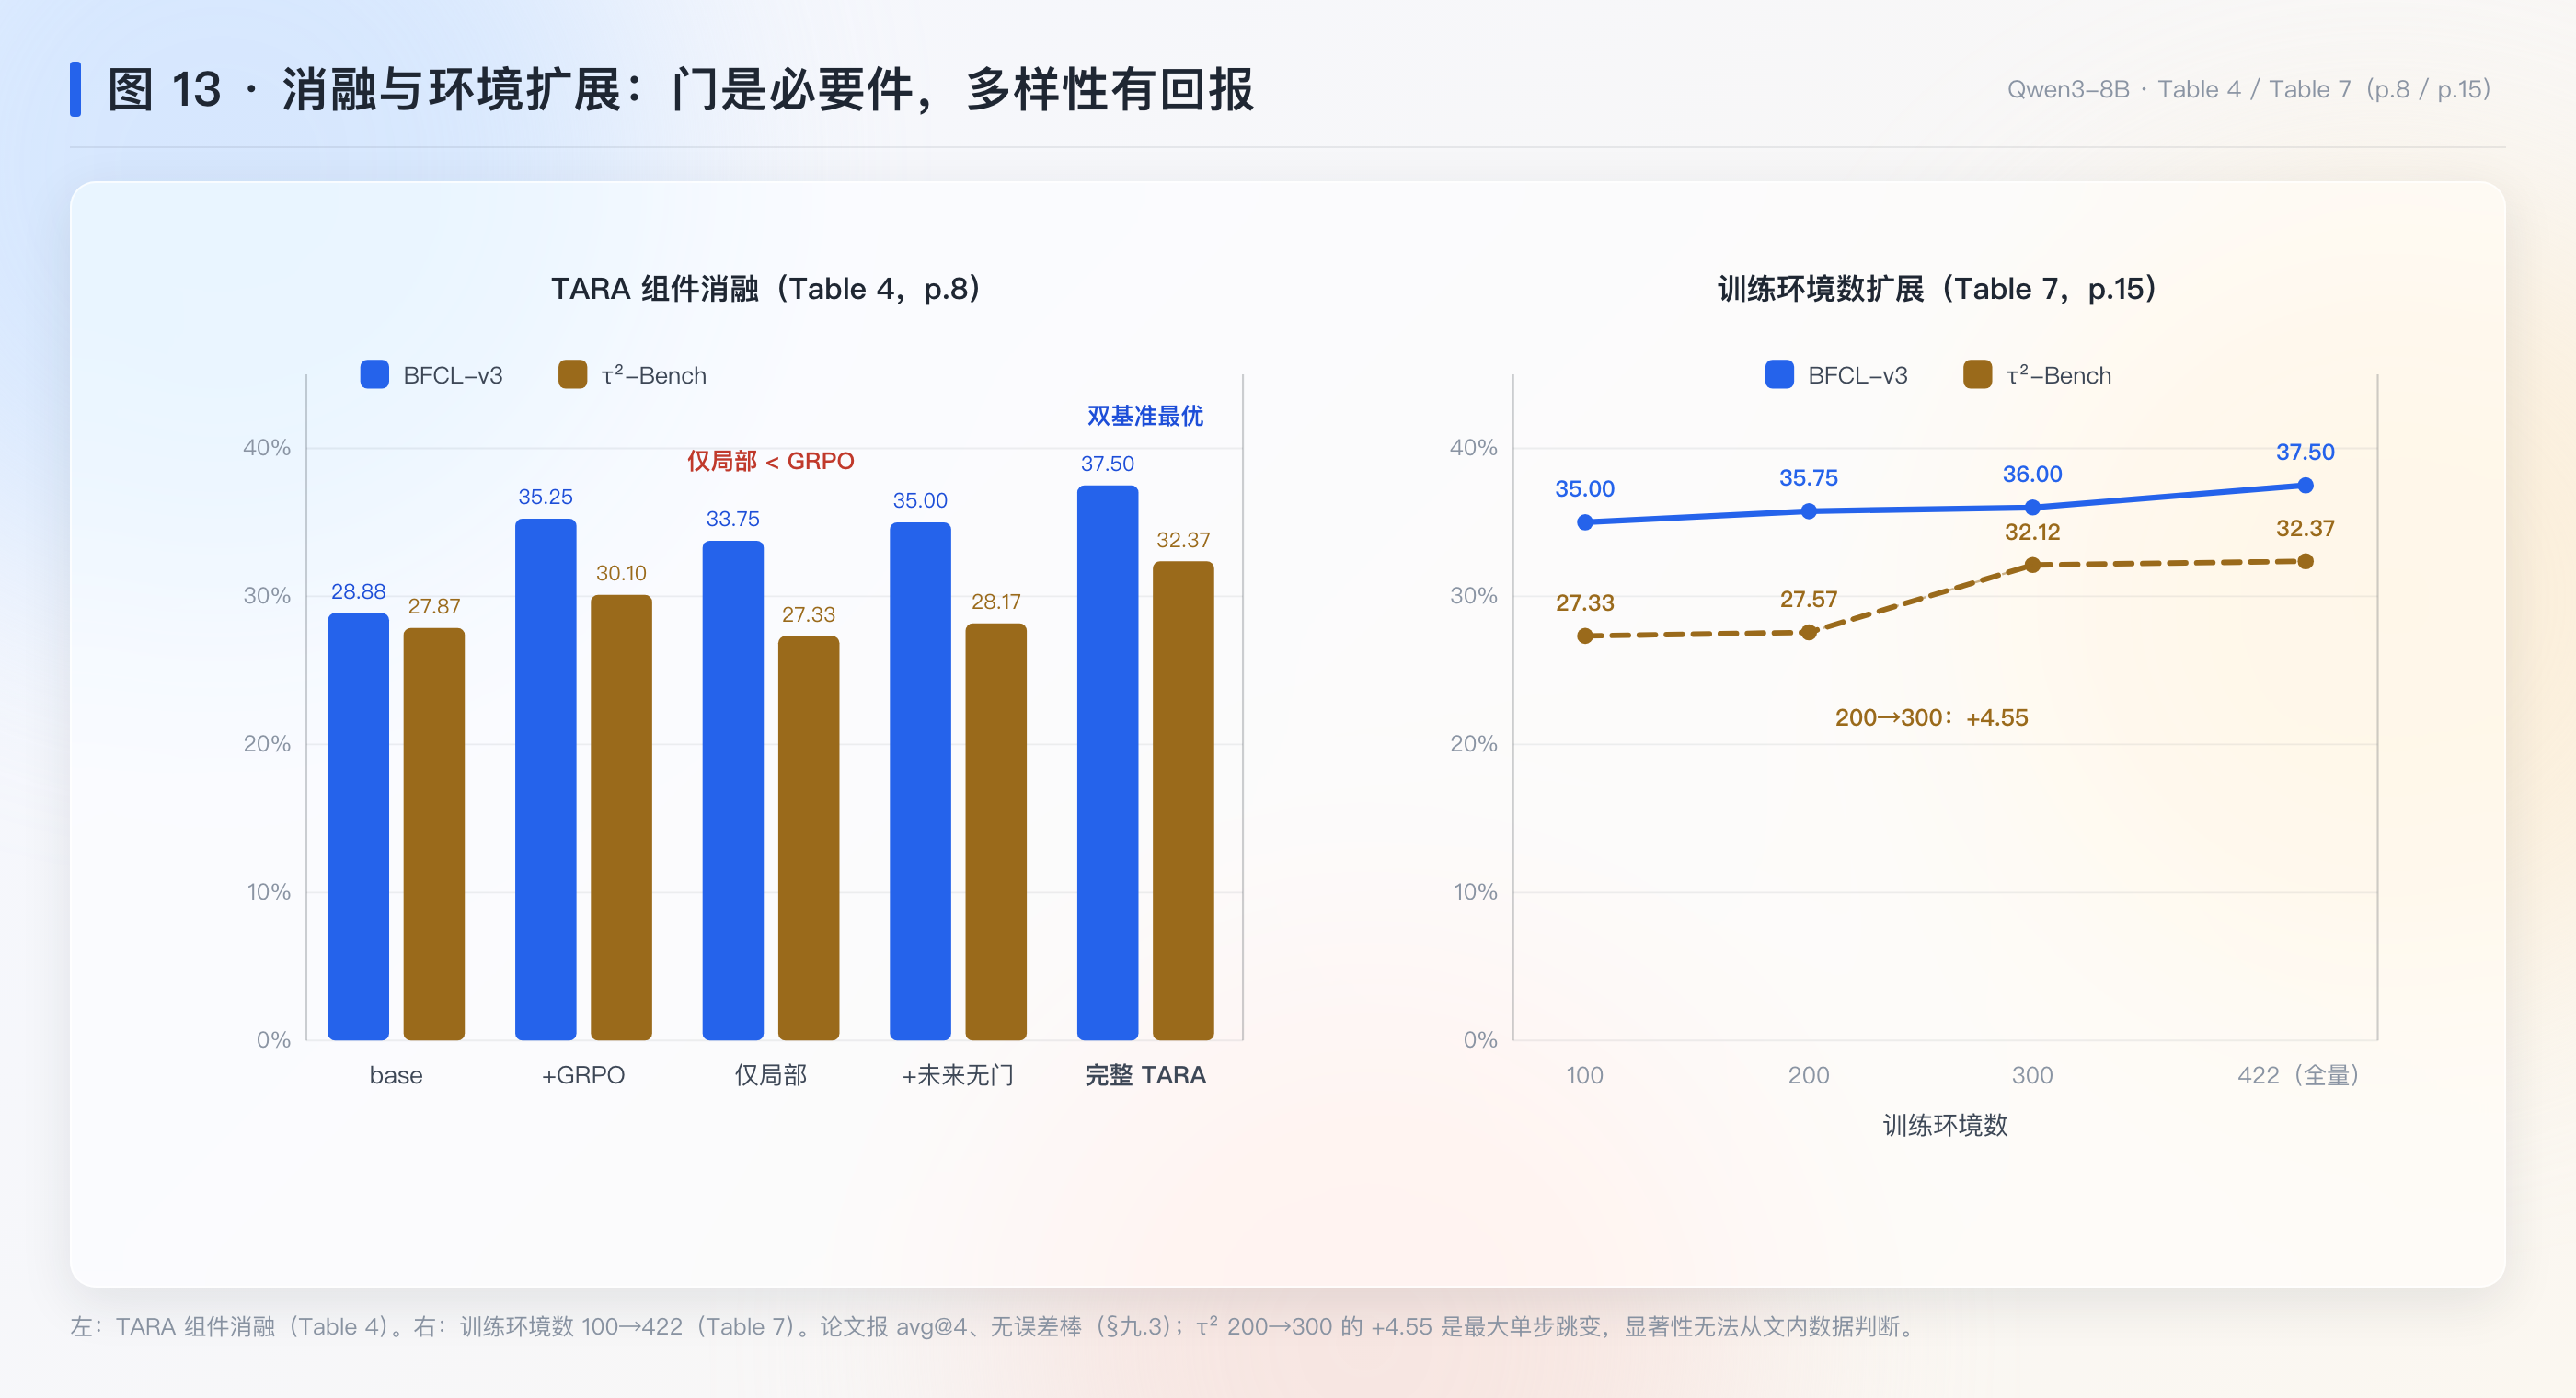
- 无误差棒。全部主结果与消融报 avg@4(p.7),无标准差。消融关键差值 full TARA vs GRPO 为 BFCL +2.25、τ² +2.27(Table 4,p.8),而 τ² 在环境扩展 100→200 只动 +0.24(Table 7,p.15)——同量级的波动在别的对比里出现过,显著性无法从文内数据判断(τ² 任务数文中未给出,未核对)。
 4.
全组同错即无信号(6.7 边界):零方差规则下,最难的
turn 梯度为零。Pass@8 教师过滤保证”教师能解”,恰好把这类 turn
从训练集剪掉了——两个机制叠加后,“接近教师边界”的任务的训练信号最稀,问题被转移而不是解决。
5. 跨 turn 替代路径打零分(6.2
边界):判分以单条黄金轨迹为参照,turn 内顺序自由、跨 turn
不自由。多解任务的合法解法会被系统性惩罚,且门会阻止”另辟蹊径但正确”的轨迹获得未来项——探索受限(我的推断;论文未讨论,查无)。
6. 评测口径改动:ACEBench 官方
[func_name(param)] 格式被改为原生 function-calling “to
ensure
consistency”(p.7)。改动合理性的唯一依据是论文自述;与官方榜不可直接比。
7. 无公开工件:abs 页无代码/数据链接(2026-08-31
核),GUST 无发布入口(查无)。论文以”artifacts not publicly
available”为由不比 SALT/FTRL(p.7),同一标准当前也适用于它自身。 8.
训练与评测共用 DeepSeek-V3.2
用户模拟器(p.6–7):训练环境交互与 τ²/ACEBench
评测都靠它;对模拟器风格的适应可能计入增益(推断,论文未做模拟器替换消融)。
9. 保真度代价未给表:字典库每场景 3–5
条记录(p.12),状态空间极小;这种环境里练出的能力向真实 API
的状态复杂度迁移,论文无实验(8.3 的展开)。
十、验证结果(最小复现)
10.1 范围声明
论文的核心实证主张(Table 2/3/4 的 RL 训练增益)需要 32×A100 集群与 GUST 数据(未公开),不可最小复现,论文数字只作引用并注明出处。本复现是”核心思想的最小演绎”:DUS 的图论性质(§6.9 两条命题)与 TARA 的记账数学(§6.2–6.8、两条定理),全部可在纯 CPU 上以精确算术重演。不冒充论文的基准数字。
10.2 可证伪预测与判据(运行前写下)
- P1(DUS 合法性与环死锁):对贯穿示例的 DAG,DUS 输出的每个阶段 S_t 满足”全部依赖已在更早阶段出现”,且六工具全覆盖;对注入环的变体(看详情 → 搜酒店 回边),队列提前清空,未覆盖集合恰为”环上节点 + 环下游”。判据:两个程序化断言全过;环变体未覆盖集合 = {搜酒店, 看详情, 订酒店, 加日历, 报差旅}(环={搜酒店,看详情},下游含订酒店及其后继;查会议不受影响)。
- P2(信用分配粒度):§6.5 数值例的 4\times 3 得分矩阵下,轨迹级 GRPO 给 i2(仅中间错)与 i4(全错)完全相同的优势(-0.577);TARA 给 i2 的错误 turn 以严格负优势(A^{total}_{2,2}<0)、正确 turn 以正优势。判据:|A_GRPO(i2) − A_GRPO(i4)| < 1e-9 且 A_TARA(i2, t2) < 0 < A_TARA(i2, t1), A_TARA(i2, t3)。
- P3(干扰抑制,定理 A.4):构造”错一步但后续全对”的 rollout(干扰者),在组内有人满分(\mu^{local}_t>0)的条件下,其该 turn 总优势严格为负,且与未来回报大小无关(把它的未来回报抬高到最大值也不翻正)。判据:A^{total}<0 在两种未来配置下均成立。
- P4(方差缩减,定理 A.2):门开的有效步,原始估计量方差比 \text{Var}(G^{\text{ours}})/\text{Var}(G^{\text{std}})\approx\lambda^2=0.25(蒙特卡洛 200 万次采样,Bernoulli(p) 未来奖励,|\cdot-0.25|<0.01);门关(无效步)方差恰为 0。判据:比率落在 0.25\pm 0.01,无效步方差输出恰为 0。
- P5(零方差规则):全组同分的 turn,local 与 future 优势都精确为 0。判据:恒等断言通过。
10.3 运行结果
脚本 repro/repro_toolverse.py(纯
Python 标准库),真实输出 repro/repro_toolverse_output.txt。五组预测全部检验,13
项断言全过:
- P1 过。DAG 上五轮采样 [\{查会议\},\{搜酒店\},\{看详情\},\{订酒店\},\{加日历,报差旅\}],逐阶段依赖合法性断言通过、六工具全覆盖。环变体(补”看详情→搜酒店”回边)队列在第一轮后即清空,未覆盖集合 =\{搜酒店,看详情,订酒店,加日历,报差旅\},与预测的”环上节点 + 环下游”逐点相符,查会议不受影响。
- P2 过。GRPO 轨迹级:i2 与 i4 优势完全相同(-0.577349,差恰为 0)。TARA:i2 错误 turn A^{total}_{2,2}=-1.2887<0,正确 turn +0.3537、+1.0000>0。脚本值与 §6.5 手算表最大偏差 3.28\times 10^{-4}(手算表保留三位小数的舍入量级)。
- P3 过。干扰者(错 t2、后续全对,未来回报取最大值):门关 V=0,总优势 -2.4029<0;对照去门后未来项转为 +0.5773,总优势 -1.4434 仍为负——未来正回报无法给错误步翻案,与定理 A.4 一致。
- P4 过。n=2\times 10^6 蒙特卡洛:\text{Var}(G^{\text{std}})=0.280144,\text{Var}(G^{\text{ours}})=0.070036,比值 0.250000 对 \lambda^2=0.25;无效步(门关)方差精确为 0。
- P5 过。两个零方差 turn 的全部优势精确为 0.0。
留痕:首次运行 P2 曾 FAIL,定位为我自己的手算表舍入错误(0.3537 我舍成了 0.353,应为 0.354),修正手算表后复跑通过——数学无误,错在抄表,这正是”复验手算”要抓的问题。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 DUS 合法性 + 环死锁 | 断言全过;死锁集 = 环 + 下游 | 支持 |
| P2 信用分配粒度 | GRPO 无差别(差 <10^{-9});TARA 错误 turn 负、正确 turn 正 | 支持 |
| P3 干扰抑制(定理 A.4) | 总优势 <0 与未来回报无关;门拦未来 | 支持 |
| P4 方差缩减(定理 A.2) | 比值 \in 0.25\pm 0.01;门关方差 =0 | 支持(0.250000) |
| P5 零方差规则 | 优势精确为 0 | 支持 |
边界重申:以上支持的是论文的机制数学(判分、标准化、门控、融合、两条定理的数值结论);训练增益主张(Table 2/3/4)仍只有论文自报证据,无误差棒,见 §九.3。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 依赖图解锁采样(DUS:dependency-graph unlock sampling)
- 层级:L1 领域具体(训练环境构造/课程设计)。底层原理:数字要有对比系(L2,暂不立卡)。
- 操作定义:把”什么能力何时可练”编码为工具依赖图的拓扑解锁——依赖未满足的工具不出现在采样池,课程即结构本身。可靠性的检验方式是注入反例:往图里加环,看解锁队列是否提前清空、未覆盖集是否恰为”环上节点 + 环下游”(复现 P1:合法 DAG 全覆盖 + 环变体精确圈定污染集)。
- 迁移去向:①任何课程学习/训练混料设计(把课程从手写时间表变成结构推导);②权限/功能灰度发布(依赖未就绪的功能不开放)。
- 失效边界:依赖图是人工/半自动建的——图错则课程错;环检测只保证”不引入死锁”,不保证依赖标注语义正确。
- 方法卡:
notes/method_dependency_unlock_sampling.md(L1)
11.2 逆上下文重建(inverse context reconstruction)
- 层级:L1 领域具体(合成数据构造)。底层原理:归因靠对照(MATTRIB)。
- 操作定义:从工具的实现反推它该出现的自然语言上下文(说明书、任务描述),再任务化成训练样本——数据合成从”人写场景找工具”翻转为”从工具实现推导场景”,双向可对账(复现按机制逐段验证)。
- 迁移去向:①API/SDK 训练数据批量合成(从函数签名生成调用场景);②文档-代码一致性校验(双向生成的差集就是文档债)。
- 失效边界:反推覆盖的是”实现可见的用法”,工具的真实高频用法与误用模式不在实现里——合成分布对真实分布的覆盖缺口要另测。
- 方法卡:
notes/method_inverse_context_reconstruction.md(L1)
11.3 方法依赖
本篇产出 L1 两张(DUS / 逆上下文重建)。TARA 一致性门(§5.5)是”信号稳定性检验”(MPERT)的记账域实例,已回链 L2 卡;其 turn 级相对优势与 MT-GRPO 的配对对照见依赖图。
十二、没搞懂的地方(未攻克登记)
- 标准化之后再融合的优势有没有最优性:\lambda=0.5,\gamma=0.5 双双最优只有敏感性图(p.15)支撑,无理论解释;且定理分析的量(原始 G)与实现量(标准化后 A)不一致。补齐时机:补完 GRPO/PPO 分支笔记(尚未补齐的知识点第一顺位)后重读附录 A,检查归一化下方差论证还剩多少。
- 黄金轨迹自身错误率:图错、字典库错、教师剪枝偏,三者的错误率论文全无数字。补齐时机:工件公开或第三方复用 GUST 时测。
- 跨 turn 替代路径是否真被打零分:\subseteq_{\text{dict}} 的实现未公开,6.2/九.5 的推断无法验证。补齐时机:代码放出。
- \tau^2-Bench 任务数与二项噪声:消融 +2.27 的显著性算不出(文中无 n)。并入”三基准评分规则”尚未补齐的知识点。
- KL 为什么关(p.14):turn 级优势是否降低了策略漂移、从而不需要 KL 锚——论文未解释。并入 GRPO 分支笔记的问题清单。
- verify-retry 最优停止(簇既有缺口):本篇从训练侧给了旁证(门=硬止损、零方差=不学),执行侧的第四系统实验仍未做——两线汇合后再定形研究问题。
十三、可信度
- A 级(论文原文转录,我逐页核对):全部页码引用、Table 1–7 数字、式 (1)–(5)、式 (6)–(26)、Algorithm 1。
- B 级(论文自报实验,无法独立验证):三基准主结果、消融、敏感性、环境扩展;已注无误差棒、评测口径改动、无公开工件。
- C 级(我的推导 + 将由复现程序化验证):§6.5 数值表、§6.6/6.7 定理推导、§6.9 算子化;预测 P1–P5 的判据。
- D 级(我的推断,标注于正文):跨 turn 打零分(九.5)、模拟器适应计入增益(九.8)、迁移距离未检验(8.3)、教师剪枝成天花板(8.5)。
- 横向核实初核(2026-08-31):版本 v1-only 已核;工件查无;第三方收录/讨论未查;统计审查未跑(无误差棒已记九.3)。更完整的横向核实(同行对照、第三方讨论、统计重算)留待后续。