外行导读(先读这个,再决定要不要进正文)
一个场景:你想知道两个 AI 助手谁答得好。问题是开放性的(“解释量化宽松像对五岁小孩讲”),没有标准答案,人工评分贵且慢。于是让另一个更强的 AI 当裁判。但裁判自己会偏吗?把两个答案调换顺序它会不会改判?答案写得更长它会不会加分?给它自己写的答案它会不会偏心?
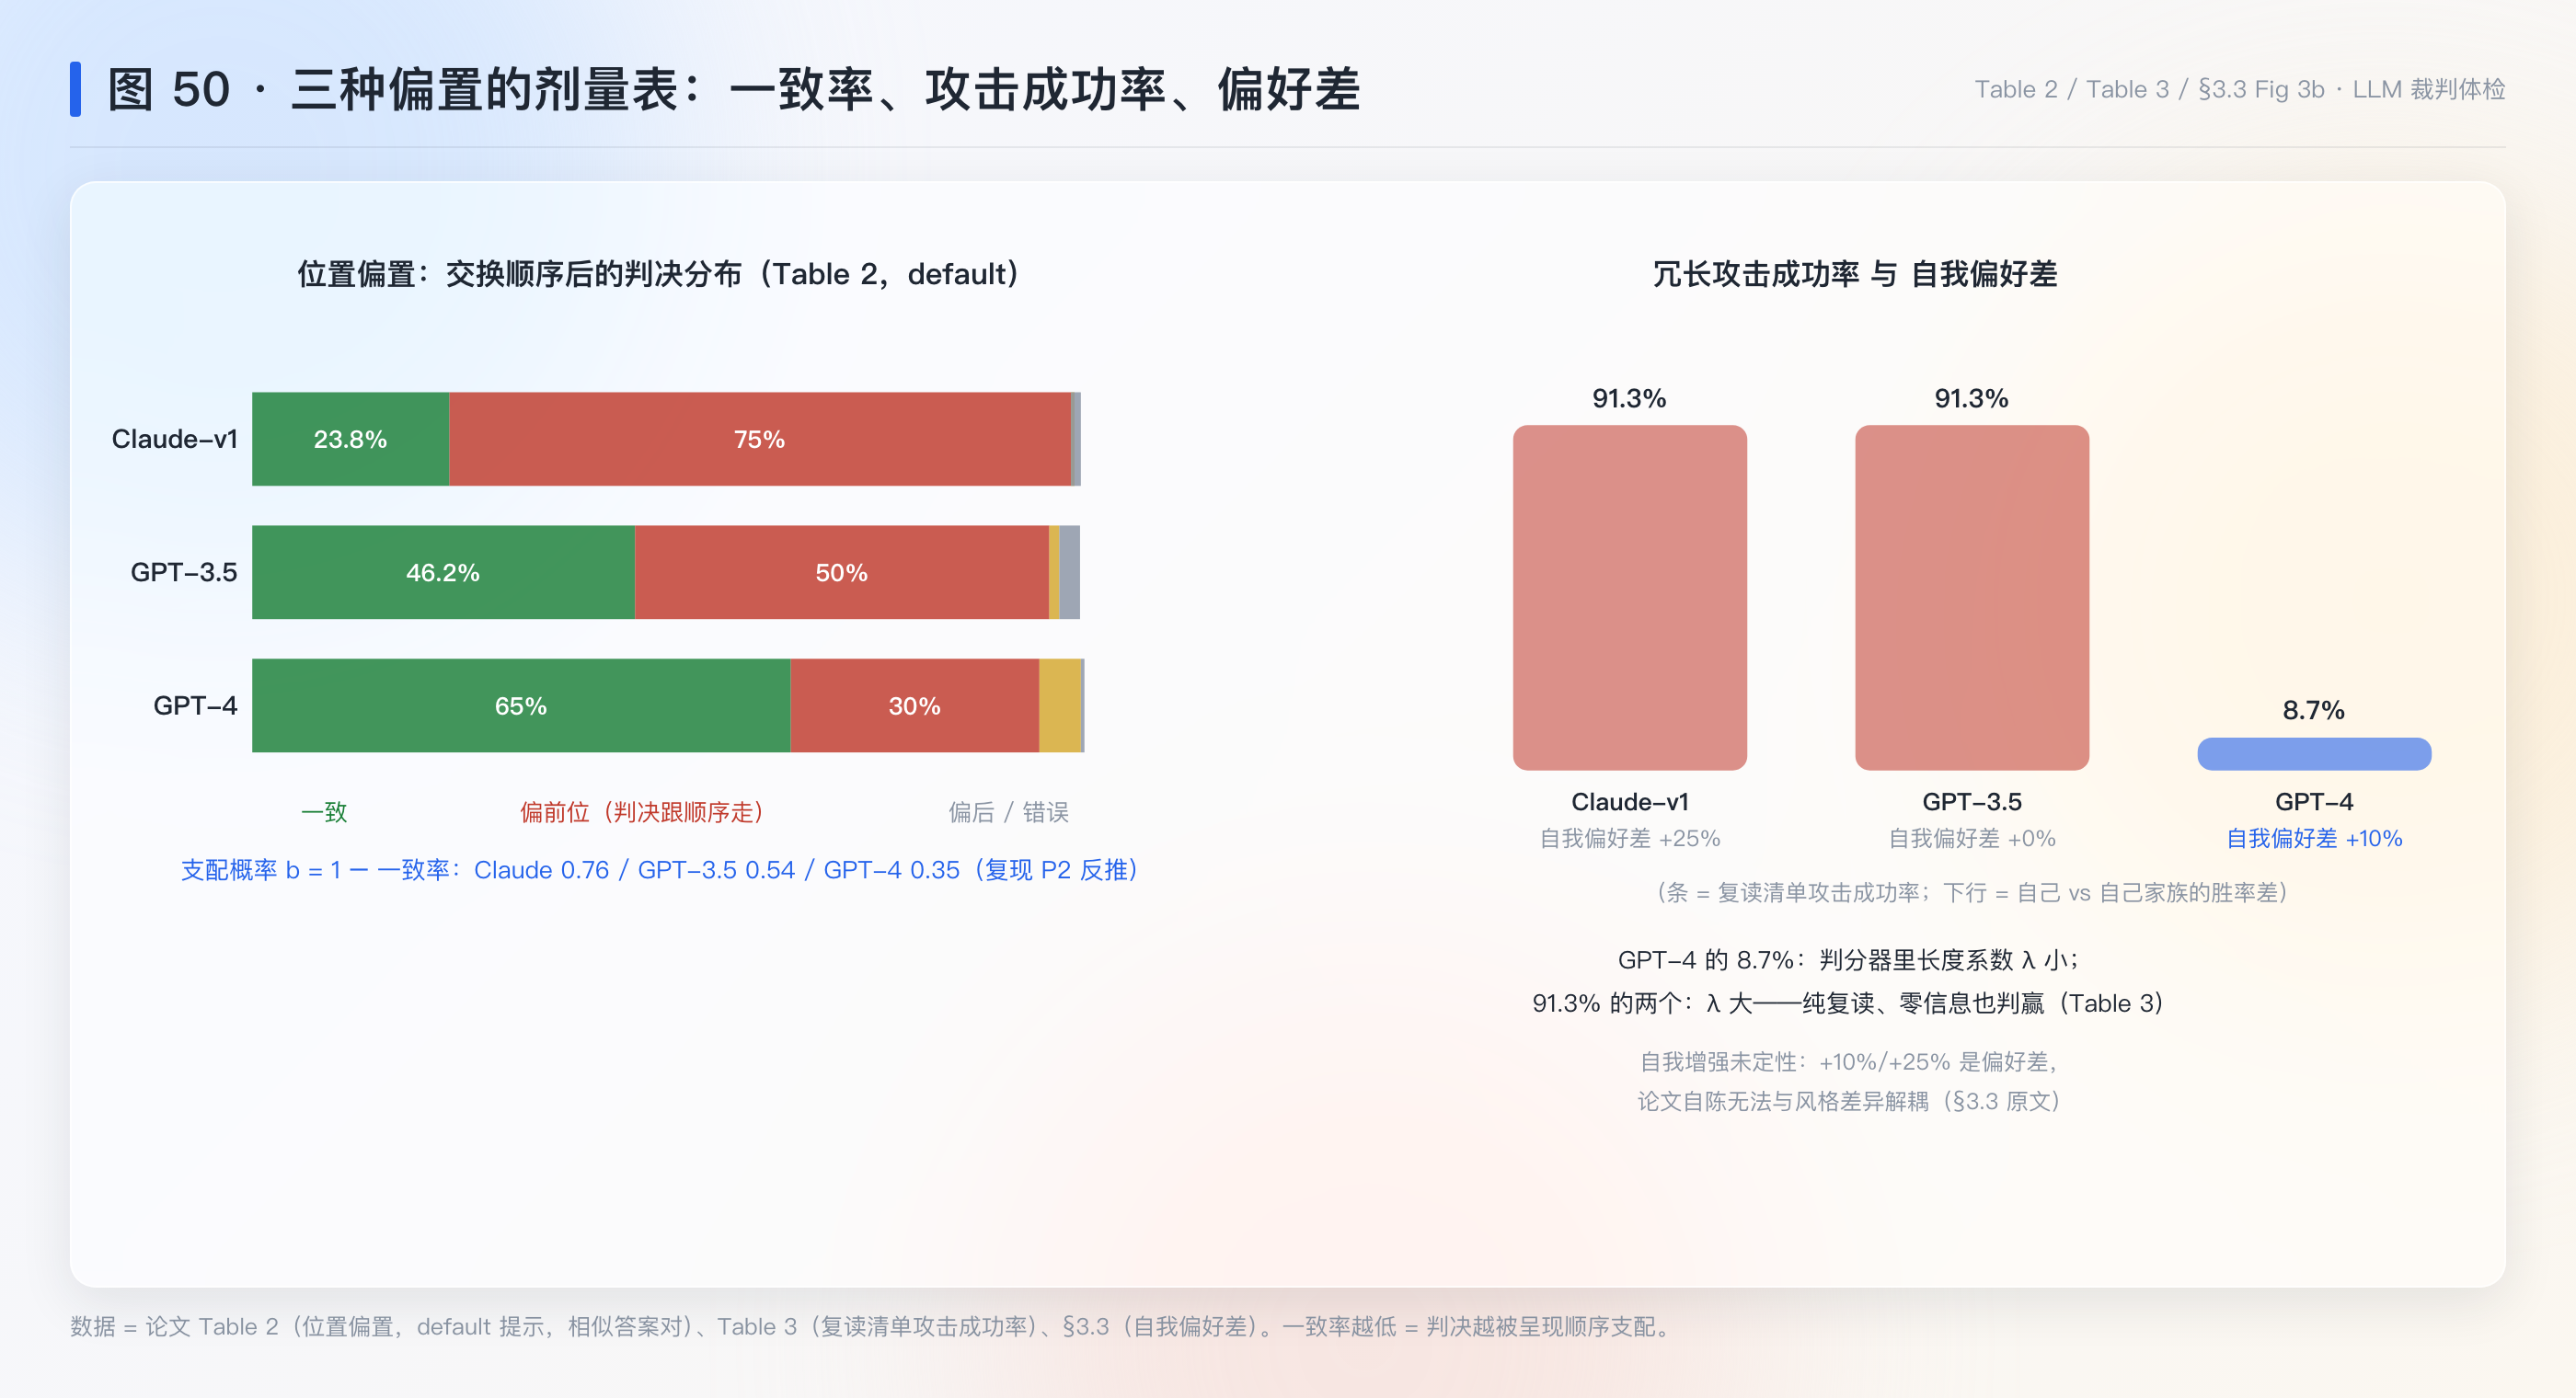
这篇论文干的事:造了两个基准——MT-Bench(80 道多轮开放题,8 类 × 10 题 × 2 轮)与 Chatbot Arena(匿名对战 crowdsourcing)——然后用它们系统地测量 AI 裁判的三种偏置:位置偏置(调换顺序后 Claude-v1 判决一致率只有 23.8%)、冗长偏置(“复读清单”攻击下 Claude/GPT-3.5 有 91.3% 被骗、GPT-4 只有 8.7%)、自我增强(GPT-4 偏爱自己 +10%、Claude +25%)。再测量裁判与人类的一致率:GPT-4 与人类专家在无平票条件下一致率 85%,高于人类彼此之间的 81%。结论:偏置真实存在但可缓解(调换顺序、参考答案引导),强模型裁判已可用。
为什么值得关心:这是我们判分器质量簇的奠基篇——簇里七例讲的都是”某篇论文里的判分器出了某类问题”,这一篇是第一个把”判分器会偏、偏多少、怎么测、怎么缓解”做成系统测量框架的。训练侧的 judge 奖励(MT-GRPO)、黄金轨迹(ToolVerse/TARA/ToolRL)、训练奖励监控(DAPO)全都隐含”LLM 裁判大致可信”这个前提——这篇就是给这个前提做的体检报告。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| LLM-as-a-judge | 让一个 LLM 给其他模型的回答打分/排序,替代人工评分 |
| MT-Bench | 本文造的基准:80 道多轮开放题,8 类(写作/角色扮演/提取/推理/数学/编码/STEM/人文)×10 题 ×2 轮 |
| Chatbot Arena | 匿名对战平台:用户同问两模型、投偏好票、赛后揭晓身份;首月 3 万票 |
| 位置偏置 | 调换两个答案的先后顺序,裁判改判 |
| 一致率(consistency) | 调换顺序前后给出相同判决的比例 |
| 冗长偏置 | 裁判偏爱更长的回答,哪怕长出来的部分是纯复读 |
| “复读清单”攻击 | 把原答案的编号清单改写后插到前面——信息量为零、长度翻倍,看裁判是否上当 |
| 自我增强偏置 | 裁判偏爱自己(同家族模型)写的答案 |
| 一致率(agreement) | 随机抽两个不同类型的裁判(如 GPT-4 与人类),在同一题上判相同的概率 |
| S1 / S2 | 一致率计算的两种口径:S1 含平票(改判计平票)、S2 只看非平票 |
| 单答案评分 | 裁判只看一条回答打 1–10 分(MT-Bench 分数),再按分数比大小 |
| 参考答案引导 | 裁判先看标准答案再评分——治数学题判分失败 |
§0 承接栏
这篇接的是判分器质量簇攒了七篇之后悬着的一个总问题:LLM 裁判到底能不能用? 前七例各自撞见判分器的一个侧面——ToolVerse 的黄金轨迹有错误率、MT-GRPO 引用他人说 GRPO 训练崩溃时用 judge 当裁判、SimpleTIR 的格式契约、DAPO 的训练奖励与真实能力弱相关、Dr. GRPO 用 GPT-4o-mini 当格式分类器、Cordis 说接口决定可判定面、ToolRL 把奖励当设计变量——但”LLM 裁判”这个行为本身的系统测量,簇里一直是空的。这篇 2023 年的 NeurIPS 论文就是这个空位的奠基工作:三种偏置(位置/冗长/自我增强)的对照实验、缓解方案、以及”85% 人机一致率 > 81% 人人一致率”的基线数字。
另外两笔旧账也在这篇还上。其一,MT-GRPO 篇引用他人说”judge 有误差率”却没给测量框架,这篇就是那个框架的原始出处(成对评审 + 一致率 + 平票口径)。其二,SimpleTIR 篇的簇原则”判分器越弱越选粗粒度处理”在这里获得定量注脚:裁判连数学题都会被错误答案带偏(Table 4,默认提示下 14/20 判错),参考答案引导能压到 3/20——判分器能力不足时的补救不是换更细的奖励,是给参考答案或换粗粒度。
到这里,判分器质量簇的结构完整了:奠基测量(本篇)+ 训练侧六例 + 运行时接口一例 + 设计空间一篇。判分器专题笔记 的合成条件全部就绪。
一、论文在解决什么问题
1.1 一个具体场景
你发布了两个聊天模型,想知道用户更喜欢哪个。出 80 道开放题让它们答,答案都是千字长文——没有标准答案可比。雇专家评:58 名研究生级别的标注者,每人至少评 20 题,才攒出 3.3K 票(§4.1),而且人对同一对答案的重评一致率也只有 81%(Table 5,S2)。你需要一种可扩展的评分方式,而 LLM 裁判看起来是唯一的候选——但先得回答:它跟人判得一样吗?它自己有什么毛病?
1.2 与前几篇的入口差
簇里前几篇都是”训练方法里顺手用一下判分器”,这篇是专为判分器本身写的测量论文:不提训练方法、不给模型排名当主贡献,主贡献是”LLM 裁判的三种偏置的对照测量 + 一致率基线”。入口在”评测”而非”训练”——但对训练侧的意义恰恰最大:判分器质量簇里所有训练侧论文(TV/MG/ST/DP/TR)的 judge 环节,可靠性上限都由这篇的数字框定。
二、核心想法
一句话:强 LLM 裁判与人类的一致率(85%)已达到人类彼此一致率(81%)的水平,因此 LLM-as-a-judge 可用;但它带三种可测量的偏置——位置、冗长、自我增强——每种都有对照实验、有缓解方案,用之前必须先测。
这个论断的结构值得注意:它不是”裁判可用”或”裁判不可用”的二值判断,而是”可用性 = 一致率基线 − 偏置折扣 + 缓解补偿”的三项式。在它之前,社区对 LLM 裁判的态度是口口相传的疑虑;在它之后,每个疑虑都有一个对照实验和数字。
先打个比方。新来的阅卷老师要不要用?先看他跟老教师判卷的一致率——发现 85%,比老教师之间的 81% 还高(§4.2)。但这个老师有三个毛病:先看到的卷子给分偏高(位置);字多的卷子给分偏高(冗长);母校学生的卷子给分偏高(自我增强)。论文的贡献不是发现这三个毛病——每个毛病单拎出来社区早有传闻——而是给每个毛病设计了对照实验,量出了剂量。
落到形式上:三种裁判用法(成对/单答案/参考引导)× 三种偏置的对照测量,加一个一致率的统计定义(“随机抽两类裁判各一人、随机抽一题,二者判相同的概率”,§4.1)与两条基线(S1 随机基线 33%、S2 随机基线 50%)。
所以这篇真正改变了什么:把”该不该信 LLM 裁判”从立场之争重构为四个可测量:一致率(对人类基线)、位置一致率(对交换扰动)、攻击成功率(对冗长扰动)、自我偏好差(对自己)。判分器质量簇的后续各例,测的其实都是这四个量的某个变体。
全篇就看这张:图 50(§5.1)——三种偏置的剂量表:位置 / 冗长 / 自我增强各自的量化幅度(Table 2/3 + 自我偏好差),评委席上的三处系统性误差一次看完。 ## 三、数学基础(零起点,本篇新用到的四件)
3.1 随机变量的一致概率
第一件工具是”两个随机挑选的评判者判相同的概率”。直觉:两个评委各自独立给一道题判”甲好/乙好/平”,问他们判相同的可能性。写成定义,若两人各有判别分布 P_1, P_2(在 {甲,乙,平} 上),一致概率是 P_{\text{agree}}=\sum_{c}P_1(c)P_2(c)——两条分布逐类相乘再求和。若两人都是均匀随机(各 1/3),得 P_{\text{agree}}=3\times\frac13\cdot\frac13=\frac13——这就是 Table 5 里 S1 口径的随机基线 R=33%;若剔除平票只剩两类,基线升到 \frac12,即 S2 的 R=50%。基线不是零:随机猜也有三分之一一致,这是一致率必须对照基线读的原因。
3.2 扰动一致率(consistency under swap)
第二件是”同一问题换一种无害的表述再判一次,判决不变的概率”。直觉:真信号对无害扰动稳定,假信号一扰动就翻。写成定义:设裁判对答案对 (A,B) 判决为 d(A,B)\in\{\text{A},\text{B},\text{tie}\},交换扰动 \pi 把 (A,B) 变成 (B,A),则一致率 =\Pr[d(A,B)=\overline{d(B,A)}],其中 \overline{\cdot} 表示交换后的对应判决(A 变 B)。本篇用它量位置偏置:给每题造两个”相似但不全同”的答案(GPT-3.5 温度 0.7 采两次),让裁判正着判一次、反着判一次,数一致的比例(§3.3,Table 2)。
3.3 受控攻击实验(对照实验的最小形式)
第三件是受控攻击:把答案沿着一个可疑维度做只动该维度、不动信息量的修改,看裁判是否上当。“复读清单”攻击(§3.3)是范本:选 23 条含编号清单的回答,让 GPT-4 把清单改写一遍(信息量零增量)插到原文前面——长度翻倍、内容不变。攻击成功 = 裁判认为新答案更好。这是”单变量对照”的评测版:质量差恒为零,长度差固定为正,裁判若仍系统性偏好新答案,偏好只能来自长度本身。
3.4 条件概率与”合理性抽检”
第四件是条件概率 P(\text{改判}\mid\text{异议}) 型的量。论文在数据收集时做了一个人机交互实验:人类标注者的选择若与 GPT-4 不同,就展示 GPT-4 的判决理由,问人类是否认为合理、是否愿意改判(§4.2,附录 C.1)。结果:75% 的情况人类认为 GPT-4 合理,34% 愿意改判。直觉:条件概率把”裁判 disagree”拆成”裁判错”和”裁判有理但人类不接受”两股,只看一致率会把后者也算成裁判的错。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| P_{\text{agree}}=\sum_c P_1(c)P_2(c) | 两类评判者的一致概率(可含/不含平票 = S1/S2) | §4.1 |
| R = 33% / 50% | S1/S2 口径的随机一致基线 | Table 5 |
| 一致率(consistency) | 交换两答案顺序后判决不变的比例 | §3.3 Table 2 |
| “偏向前/后” | 裁判偏向先/后位答案的比例 | Table 2 |
| 攻击成功率 | 复读清单攻击中裁判判”新更好”的比例(文中报”failure rate”) | Table 3 |
| MT-Bench 分数 | 单答案评分 1–10 的平均(Table 8:GPT-4 8.99、GPT-3.5 7.94、Vicuna-13B 6.39) | §2.2、Table 8 |
| 参考答案引导 | 裁判评分前先读标准答案 | §3.2 |
| 保守交换规则 | 正反各判一次,两次都判 A 优才记 A 胜,否则平 | §3.4 |
五、机制
承上启下:§一 的麻烦是”开放性回答没有自动评分器”,§二 的路线是”用 LLM 当裁判,但先把它的偏置量出来”。上节四件工具对上四个测量:一致概率对人机一致率、扰动一致率对位置偏置、受控攻击对冗长偏置、条件概率对合理性抽检。本节按”毛病→量法→药方”配对讲,贯穿示例先立起来。
5.0 贯穿示例的数据结构
一次成对评审的最小数据结构(§3.1 同款):
vote = {
  question: q,                  # MT-Bench 80 题之一(或 Arena 用户题)
  answer_A, answer_B,           # 两个模型的回答(顺序即呈现顺序)
  judge: "GPT-4-pair",          # 裁判标识
  verdict: "A" | "B" | "tie",   # 判决
  swap_verdict: ...,            # 交换顺序后重判(位置偏置实验专用)
}
5.1 机制一:位置偏置——先看到的占便宜(§3.3 Table 2)
【类比 · 阅卷顺序】 评委连看两份答卷,先看的那份容易 anchoring——后看的答卷被拿去跟第一份比,而不是独立评。人类阅卷有此病(论文转引 Blunch 1984,未核对),LLM 更重。 【跨域锚点】 心理学的锚定效应;A/B 测试的顺序随机化。(类比与通识锚点,非论文内容)
先看病。Figure 11(附录)的案例:GPT-3.5 与 Vicuna-13B 各答一题,GPT-3.5 的答案放前面时 GPT-4 判 GPT-3.5 好;交换顺序后 GPT-4 改判 Vicuna 好——判决跟着位置走。
量法(Table 2):每题造两个相似答案,正反各判一次。数字(default 提示):Claude-v1 一致率 23.8%、偏向前位 75.0%;GPT-3.5 一致率 46.2%、偏向前位 50.0%;GPT-4 一致率 65.0%、偏向前位 30.0%。换 rename 提示(把”Assistant A/B”改名)后 Claude 的一致率回升到 56.2%、但出现 28.7% 的”偏向第二”——Claude 的偏置部分挂在名字上而非纯位置上。只有 GPT-4 在两种提示下都过 60% 一致率。论文强调这个测试很难:两个相似答案”occasionally indistinguishable even to humans”(§3.3 原文)——一致率数字不能直接当”裁判坏”的判据,它是”难题上的上限扰动”。
病根:论文自陈不确定(“could be rooted in the training data or inherent to the left-to-right architecture of causal transformers”,§3.3)——登记 §十二。
药方(§3.4):交换位置。保守规则:正反各判一次,两次都判 A 优才记 A 胜,否则平票。代价与权衡见 §六.3 的代数与复现 P4。
意义:位置偏置从传闻变成了一张有剂量数字的表——后续所有用 LLM 裁判的工作(包括我们簇里的 judge 奖励)都该报这张表或引用它。
5.2 机制二:冗长偏置——复读也能赢(§3.3 Table 3)
【类比 · 注水论文】 把同一份清单换种说法抄一遍放在正文前面,信息量为零、页数翻倍。如果评委给注水版打高分,说明评分函数里混进了”长度项”。 【跨域锚点】 按字数计酬的稿费制度催生注水写作。(类比与通识锚点,非论文内容)
先看病。如果裁判的偏好函数里混进长度项,那么纯注水(信息零增量、长度翻倍)就该赢。论文的”复读清单”攻击正是这个逻辑的最小实现。
量法(Table 3):攻击成功率(failure rate,即裁判判注水版更好):Claude-v1 91.3%、GPT-3.5 91.3%、GPT-4 8.7%。两条校准实验把”偏长度”与”判分失灵”分开:裁判对两个完全相同的回答必判平票(对称性完好),说明失败不是判分器崩了,而是偏好函数里的长度项在起作用。
病根(补充推断,论文未展开):裁判对”看起来更详尽”的表面特征给了正分——与我们 ToolRL 篇的结论互为镜像:ToolRL 显式设计奖励的各分量,这篇说明默认裁判的隐式分量里有长度。而簇内长度故事的另一半(长度是副产物)在这里有了裁判侧的对应物:裁判偏好长度 → 长答案得高分 → 模型学会写长 → 长度偏置自我强化——这正是 DAPO/Dr. GRPO 们在训练侧对抗的反馈回路的上游阀门。
药方:本篇未给冗长偏置的专门缓解(位置有交换、数学有参考答案)——后续工作(Length-Controlled AlpacaEval,2404.04475,未核对原文)用回归剥离长度项,登记为该篇的后续注脚。
意义:攻击成功率是”判分器鲁棒性”的可复现度量——任何依赖 LLM 裁判的基准都该报一条攻击曲线。
5.3 机制三:自我增强——偏心母校(§3.3 Figure 3b)
【类比 · 校友偏好】 评委给母校选手加分。量法是统计性的:六个模型两两对战,看每个裁判下的胜率曲线,比较裁判与人类。 【跨域锚点】 社会认知学的自我增强偏差(论文转引 Brown 1986,未核对)。(类比与通识锚点,非论文内容)
量法:与人类相比,GPT-4 判 GPT-4 家族答案的胜率高 10%,Claude-v1 高 25%;GPT-3.5 无此现象。但论文的结论异常诚实:“our study cannot determine whether the models exhibit a self-enhancement bias”(§3.3 原文)——因为无法把”风格差异”从”质量差异”里分离(无法把一个模型的回答改写成另一个的风格而不改质量),现有证据只能说明”存在偏好”,不能定性为”自我增强”。这是全篇测量纪律最好的一处:证据不够时,结论降级。
意义:判分器质量簇的原则”区分原文说的/我的推断”在论文自身的镜像——偏心现象确证,偏心归因存疑。
5.4 机制四:判分能力的边界——数学题与参考答案(§3.3–3.4 Table 4)
【类比 · 不会做的题硬判】 评委自己不会解这道数学题,只能看两份答案谁的”样子”更像对的——于是被错答案的自信措辞带偏。更奇的是:评委单独做能做对,看到两份候选答案后反而被带偏。 【跨域锚点】 考试评分需要标准答案,靠印象判理科题必翻车。(类比与通识锚点,非论文内容)
量法(Table 4):LLaMA-13B vs Vicuna-13B 的 10 道数学题、正反各判(20 次),失败 = GPT-4 说错误答案正确。默认提示 14/20;给 CoT 提示 6/20;给参考答案 3/20。
病根:论文点出最有趣的部分——GPT-4 单独解题能对,但评审时被候选答案误导(§3.3:“it was misled by the provided answers”)。这正是簇原则”判分器越弱越选粗粒度处理”的裁判版:裁判对答案没把握时,细粒度评审反而是噪声放大器。
药方:参考答案引导(reference-guided)把失败率压到 3/20——给裁判标准答案,把”判内容”降级为”对答案”。CoT 也有帮助(6/20),但不如参考答案彻底。
意义:数学/推理类任务的 LLM 裁判必须配参考答案或可执行验证器——这一条直接被后续所有 RL 工作(含我们簇的 verl 系)采纳为默认。
5.5 机制五:人机一致率——可用性的主证据(§4 Table 5/6)
【类比 · 新评委的资格考】 判断新评委行不行,标准不是”判对真理”,而是”跟资深评委判得一样不一样”——因为评测的对象是偏好而非真理。 【跨域锚点】 评分员间信度(inter-rater reliability)。(类比与通识锚点,非论文内容)
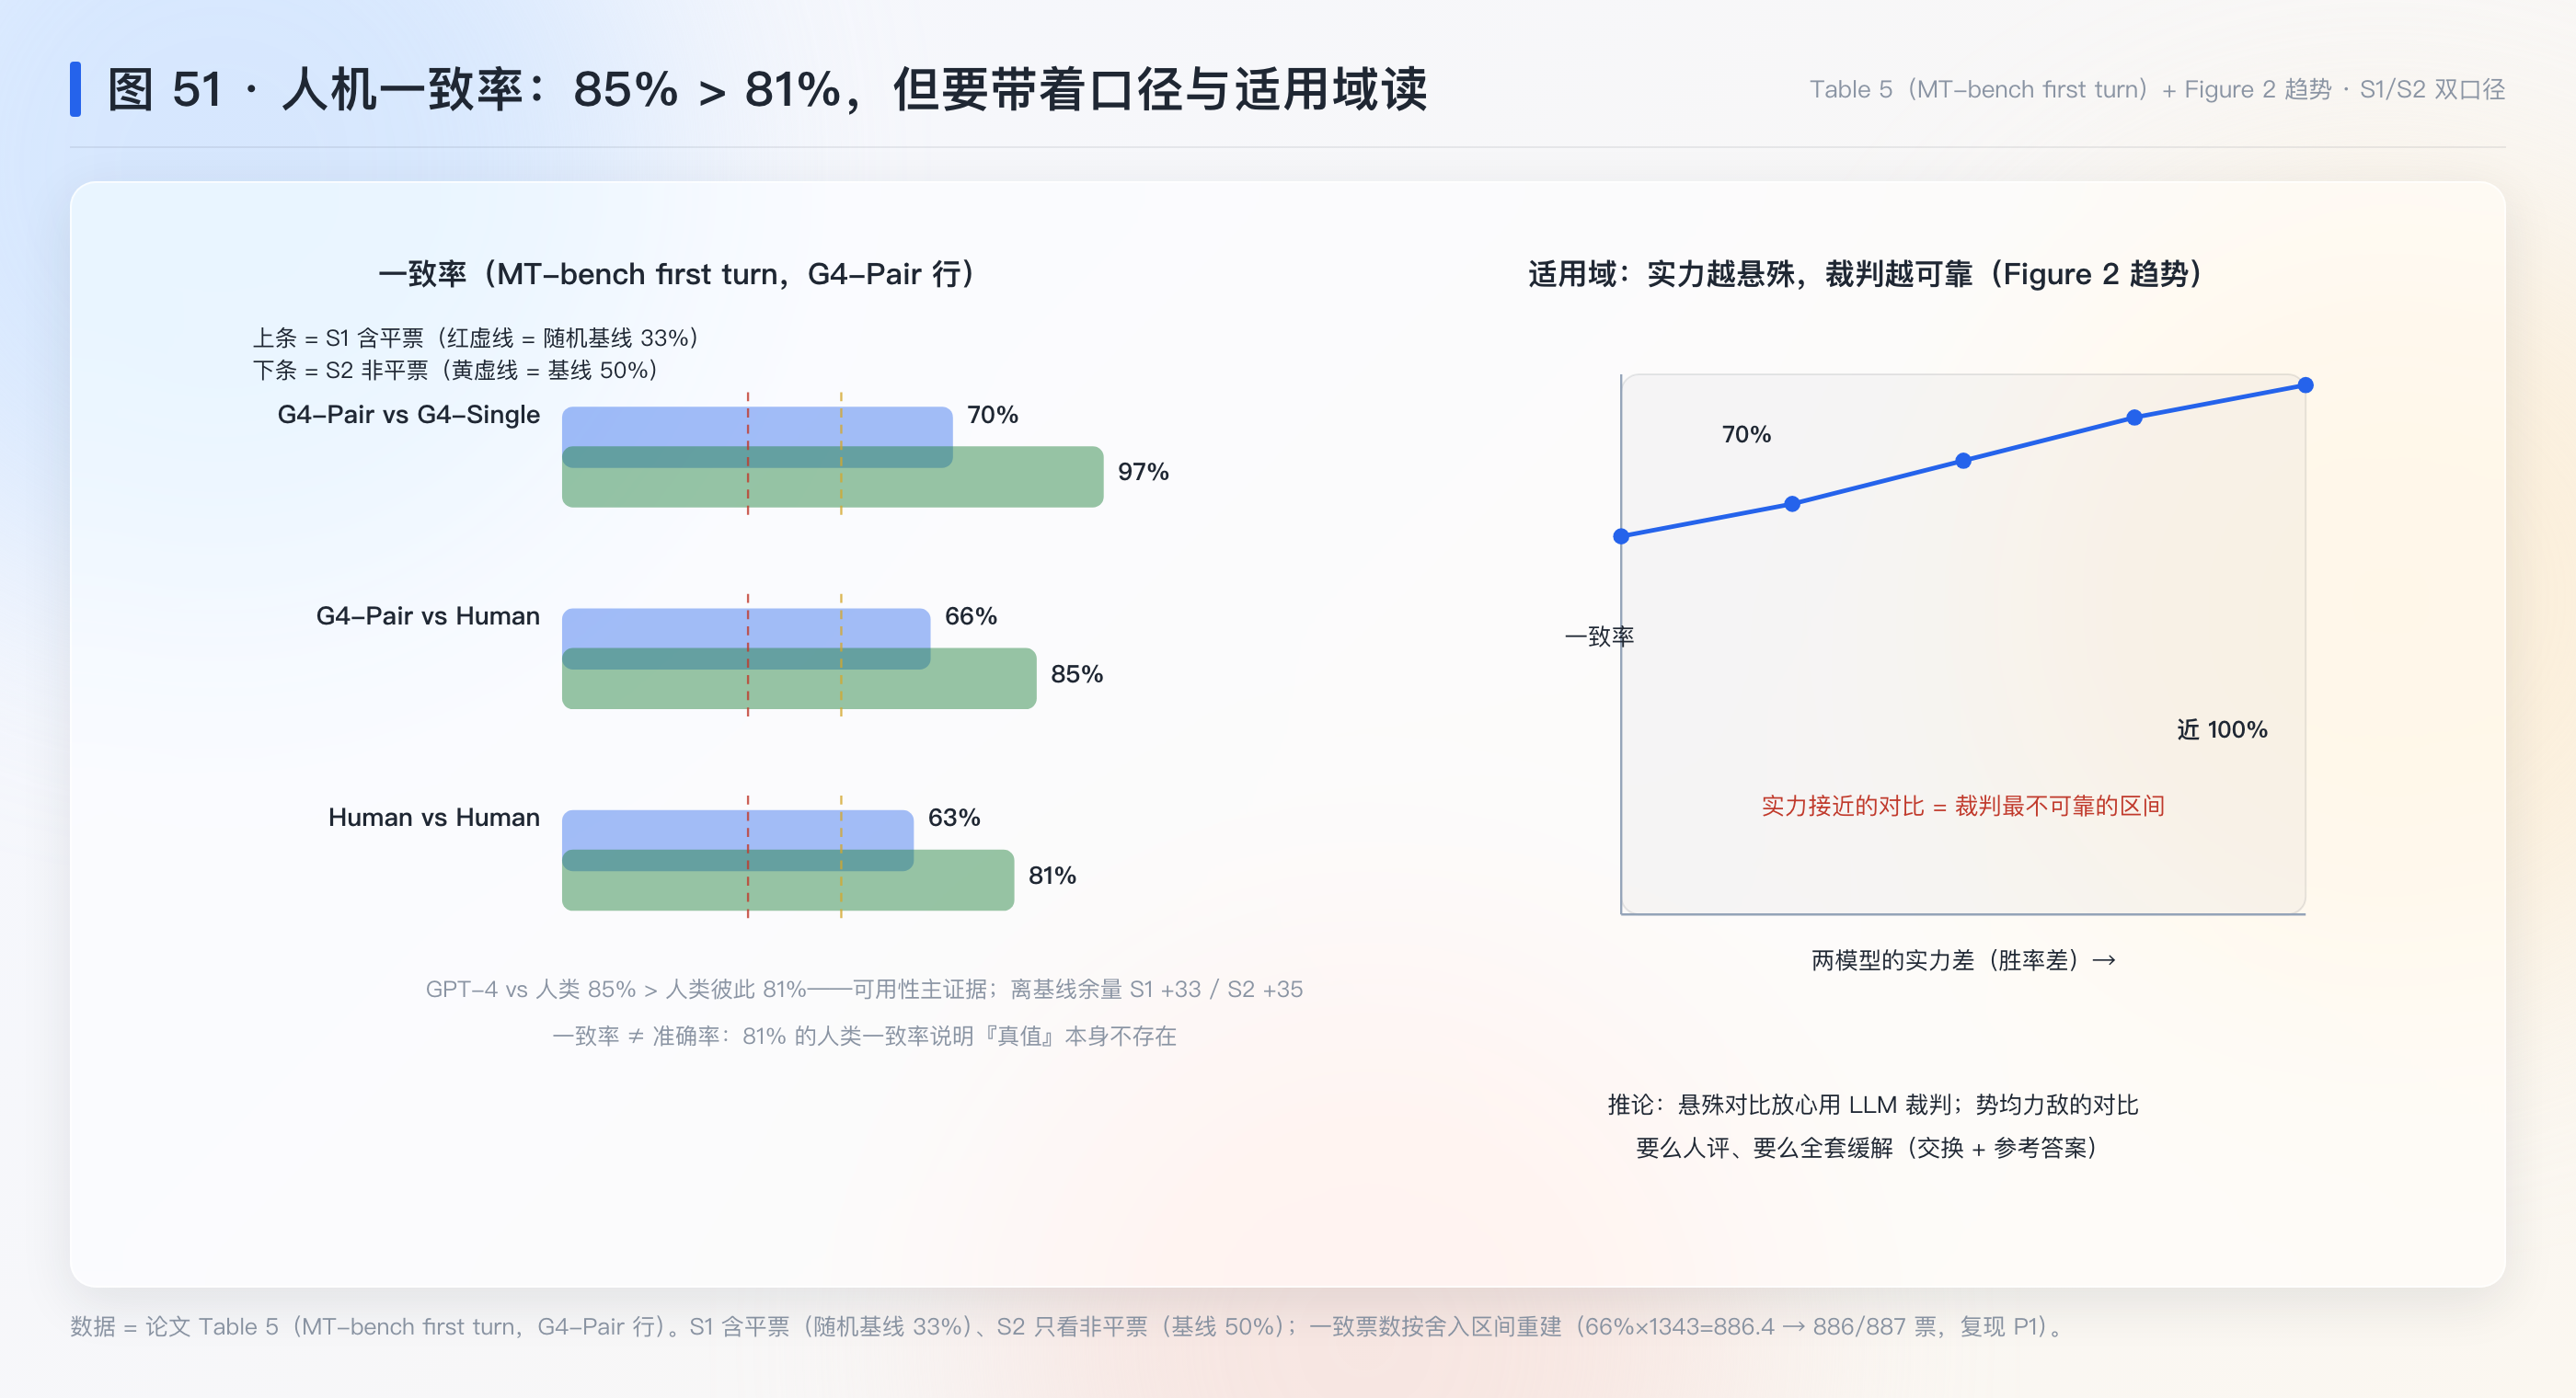
量法(§4.1):一致 = 随机抽两类裁判各一人(非同一人)、随机抽一题、判相同。Table 5(MT-bench first turn):G4-Pair vs 人类,S1 66%、S2 85%;人类 vs 人类 S1 63%、S2 81%(721 票);随机基线 S1 33%、S2 50%。第二条:G4-Pair vs G4-Single 一致率 70%/97%——两种用法高度一致,说明 GPT-4 有稳定内在评分标准。第三条(§4.2):人机分歧时展示 GPT-4 理由,人类认为合理 75%、愿改判 34%。
第二组(Arena,Table 6,众包票):趋势一致——GPT-4 的非平票数远多于其他 LLM 裁判(更果断、位置偏置更小),而给出非平票判决时与其他裁判的一致率相当。
细分发现(Figure 2):一致率随模型对实力差的增大从 70% 升到近 100%——裁判在硬题上最不可靠,在悬殊对比上接近完美。这条对使用者的含义:悬殊对比可以放心用 LLM 裁判,势均力敌的对比要么人评、要么用交换+参考答案的全套缓解。
意义:85% > 81% 是”LLM 裁判可用”的主证据,而”一致率随实力差增大”是它的适用域说明书——两者合起来才是论文的完整主张。
5.6 MT-Bench 分数与模型结论(§2.2、Table 8)
单答案评分 1–10 取平均即 MT-Bench 分数:LLaMA-7B 2.74、Vicuna-13B 6.39、GPT-3.5 7.94、GPT-4 8.99(Table 8)。表里最有训练侧味道的一行:Vicuna-7B (selected) 5.95 vs (single) 6.04 vs (all) 6.00——数据选择策略对最终分只有 ±0.1 的影响;以及 Alpaca-13B(4.4M token SFT)4.53 反超 LLaMA-13B(1T token 预训练)2.61——指令微调的 4M token 在对话偏好上胜过 1T token 的预训练,这就是后来整个对齐蒸馏路线(含我们簇的 SFT 对照组)的早期定量注脚。
六、数学展开
6.1 一致率的定义与随机基线(§4.1 逐式重推)
先看这个定义为什么长这样。两类裁判(如 LLM 与人类)各自内部还有多样性(不同人、不同次采样),所以”裁判 X 与人类一致率”定义为:随机抽一个非同一的 X、随机抽一个人类、随机抽一题,三者下判决相同的概率。写成公式,若 X 的判别分布为 P_X(在 {A,B,tie} 上)、人类群体分布为 P_H:
P_{\text{agree}}=\sum_{c\in\{\text{A},\text{B},\text{tie}\}}P_X(c)\,P_H(c)
这是两条独立分布的”重合质量”。随机基线:若 X 均匀随机、人类也均匀随机(三类),P_{\text{agree}}=3\cdot\frac13\cdot\frac13=\frac13——Table 5 的 S1 基线 R=33% 的出处。剔除平票(S2):只剩两类,P_{\text{agree}}=2\cdot\frac12\cdot\frac12=\frac12——R=50%。基线不为零是一致率数字必须带着口径读的原因:66% 的 S1 一致率离随机基线只有 33 个百分点,而 85% 的 S2 离基线有 35 个百分点——口径不同,数字不能横比。
数值例(复现 P1):取 Table 5(a) 的票数——G4-Pair vs Human 在 S1 下 1343 票、一致 66%。按定义反推:若两者独立且各自边际分布已知,一致率由边际唯一决定。复现脚本会从论文的票数与百分比重建边际分布并验证自洽(66%×1343 ≈ 886 票一致,须为整数)。
6.2 位置偏置的代价代数(补充,复现 P2)
把位置偏置压成一个参数。设裁判对”真质量更优”的答案以概率 1-b 按质量判(b 为位置/表面因素支配判决的概率),以概率 b 按位置判(偏向其偏好位)。两个相似答案正反各判一次,问:一致率是多少?
按质量判的那部分(概率 1−b):交换顺序不改变判决(质量差是答案的属性)→ 一致。按位置判的那部分(概率 b):正着判偏向位 X,反着判仍偏向位 X——但”对应判决”在交换后指的是同一个答案,偏向同一个位置意味着偏向不同的答案 → 判决翻转 → 不一致。所以:
\text{一致率} = (1-b)
“偏向前位”则与首位呈现率 \pi 有关:
\text{偏向前位} = b\cdot\pi + 0\cdot(1-b)
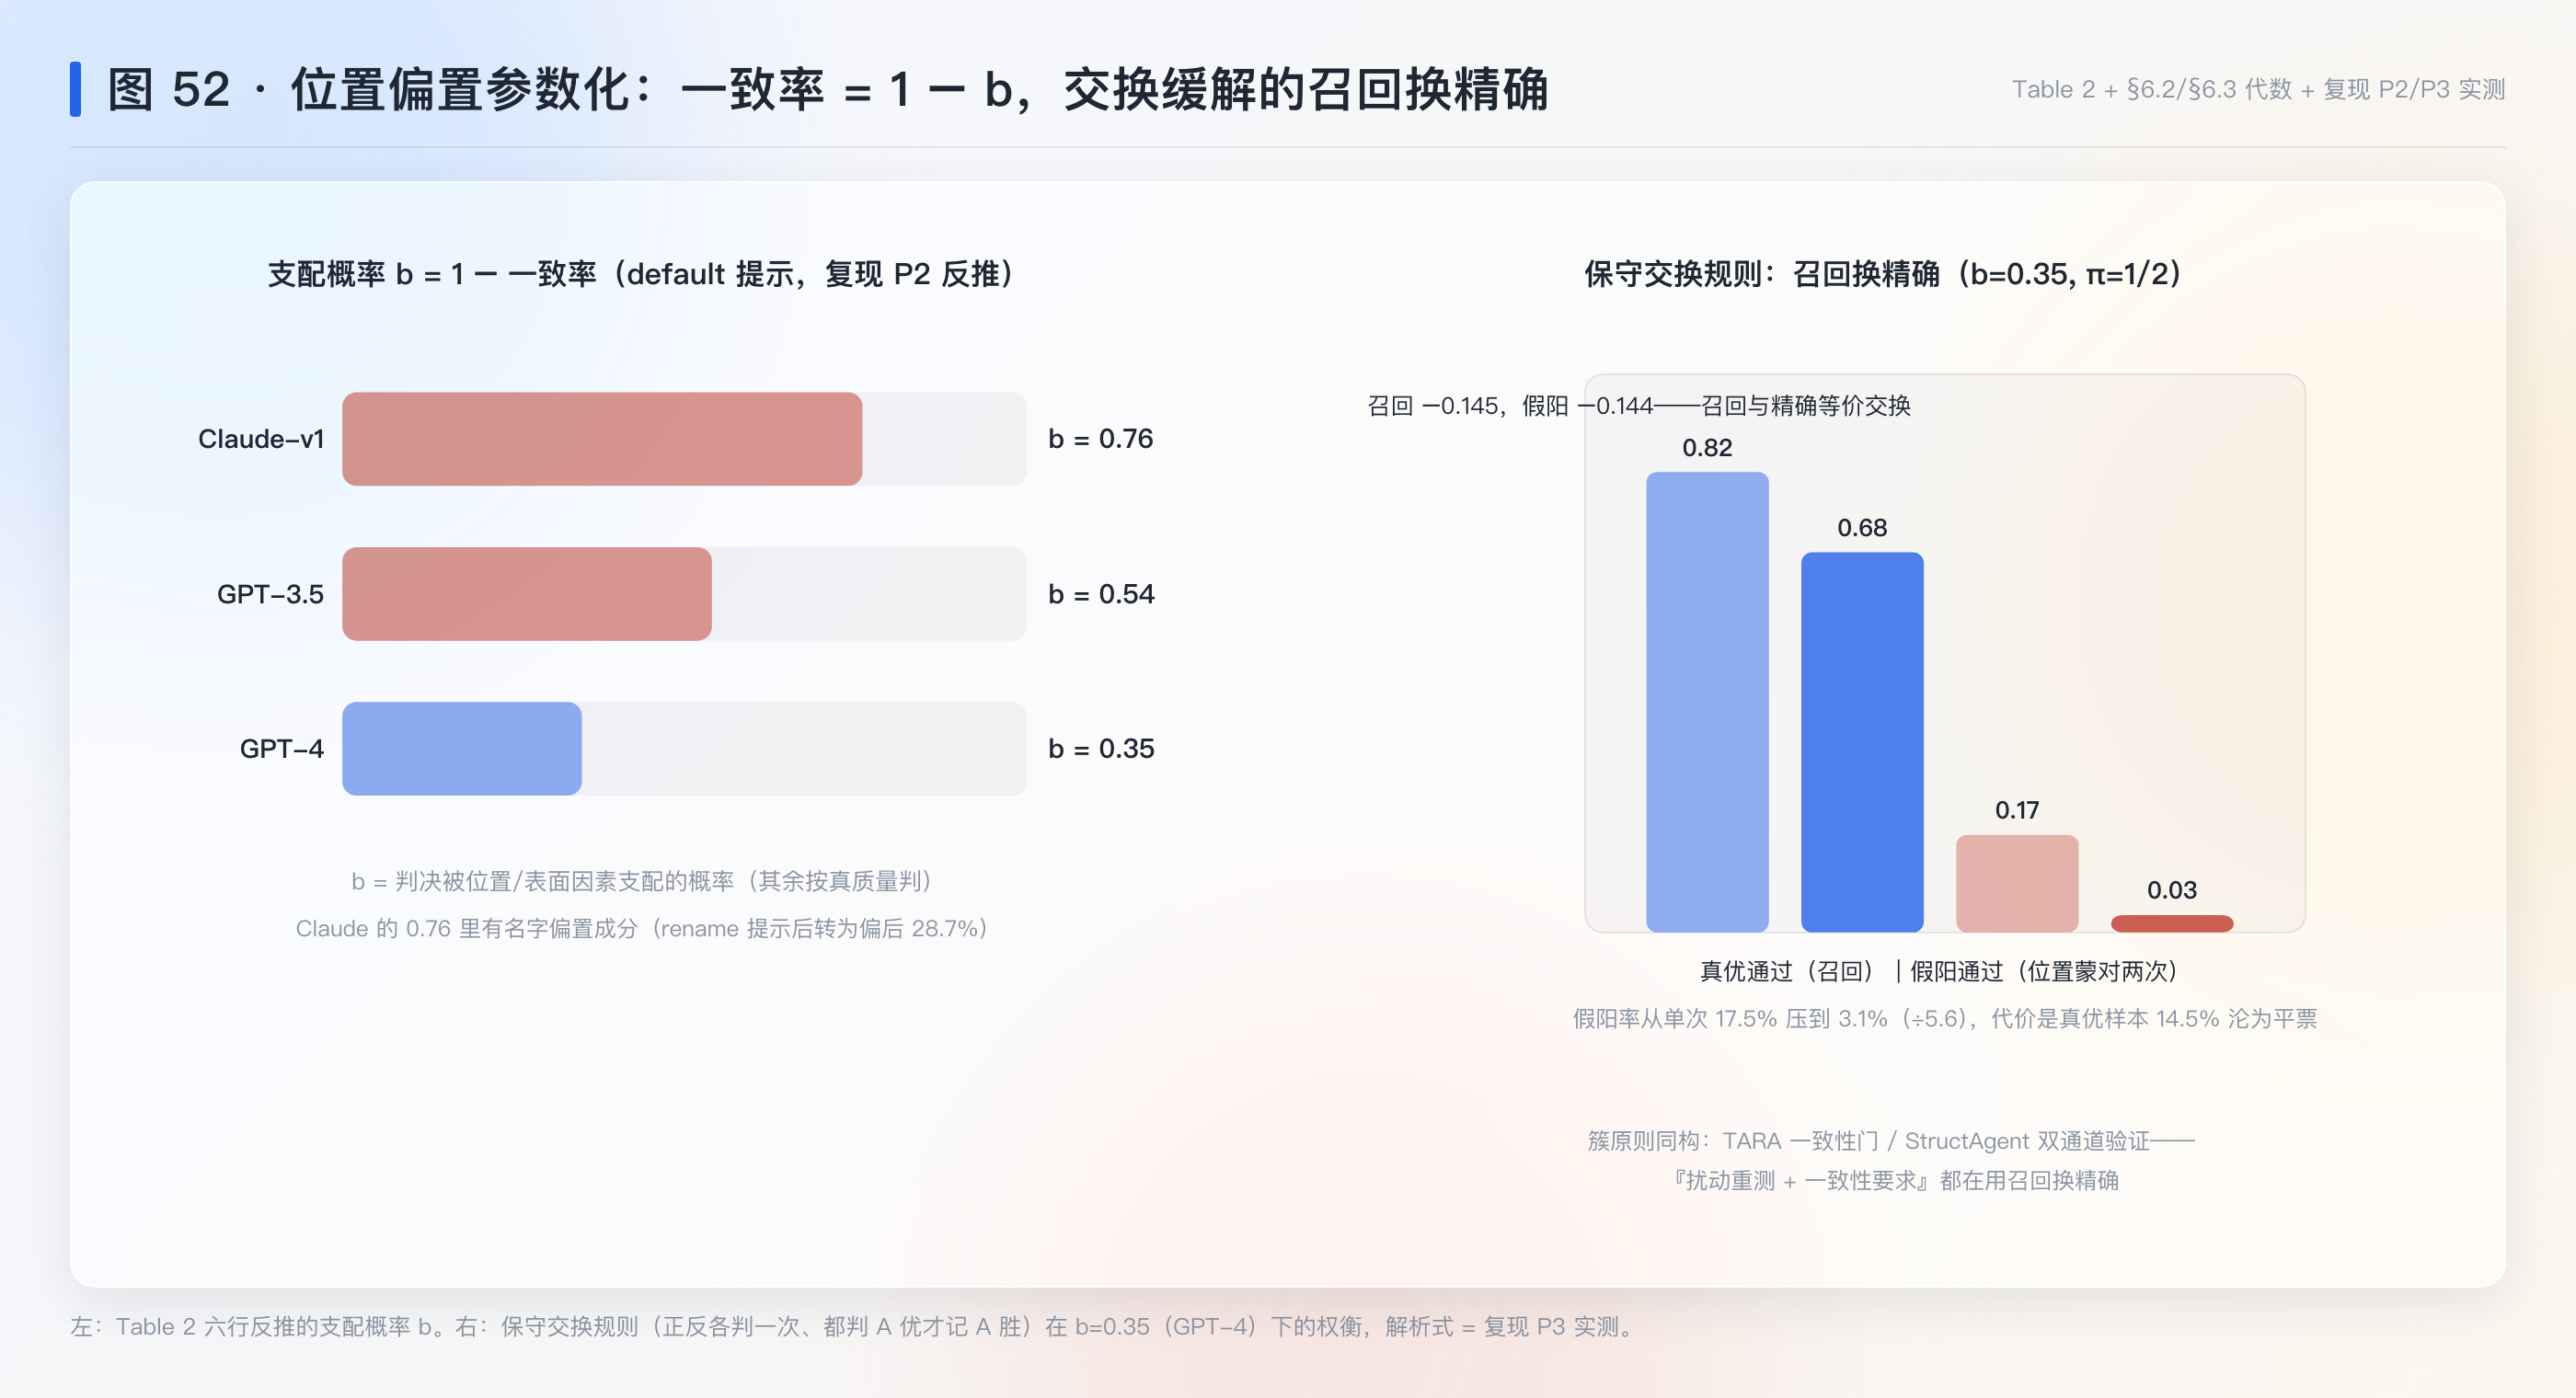
用 Table 2 的数字反推 b(default 提示):Claude-v1 一致率 23.8% → b ≈ 0.76(判决被位置/表面因素支配的概率 76%);GPT-3.5 46.2% → b ≈ 0.54;GPT-4 65.0% → b ≈ 0.35。校验:偏向前位 + 偏向后位 + 一致率 + 错误 = 100%±0.1(六行全部核对,误差来自论文保留一位小数的舍入)。这套代数把 Table 2 的四列压成一个参数 b——“裁判质量”从此可跨论文比较。
6.3 交换缓解的权衡(补充,复现 P4)
保守交换规则(两次都判 A 优才记 A 胜)在三概率模型下的账:真优答案被判优一次的概率是 (1-b)+b\pi(按质量判,或恰好位置偏向它),两次独立都判优的概率是它的平方。以 GPT-4 的 b=0.35、\pi=1/2 计:单次判优率 0.65+0.175=0.825,保守规则通过率 0.68——用 17% 的真优样本被误记平票,换掉全部位置翻转判决。而错误答案通过保守规则的率是 (b\pi)^2(两次都靠位置蒙对同一侧)= 0.03——假阳率从单次的 17.5% 压到 3%。这就是”保守规则用召回换精确”的定量形状,复现 P4 验证这条曲线。
6.4 冗长攻击的结构性预测(补充,复现 P3)
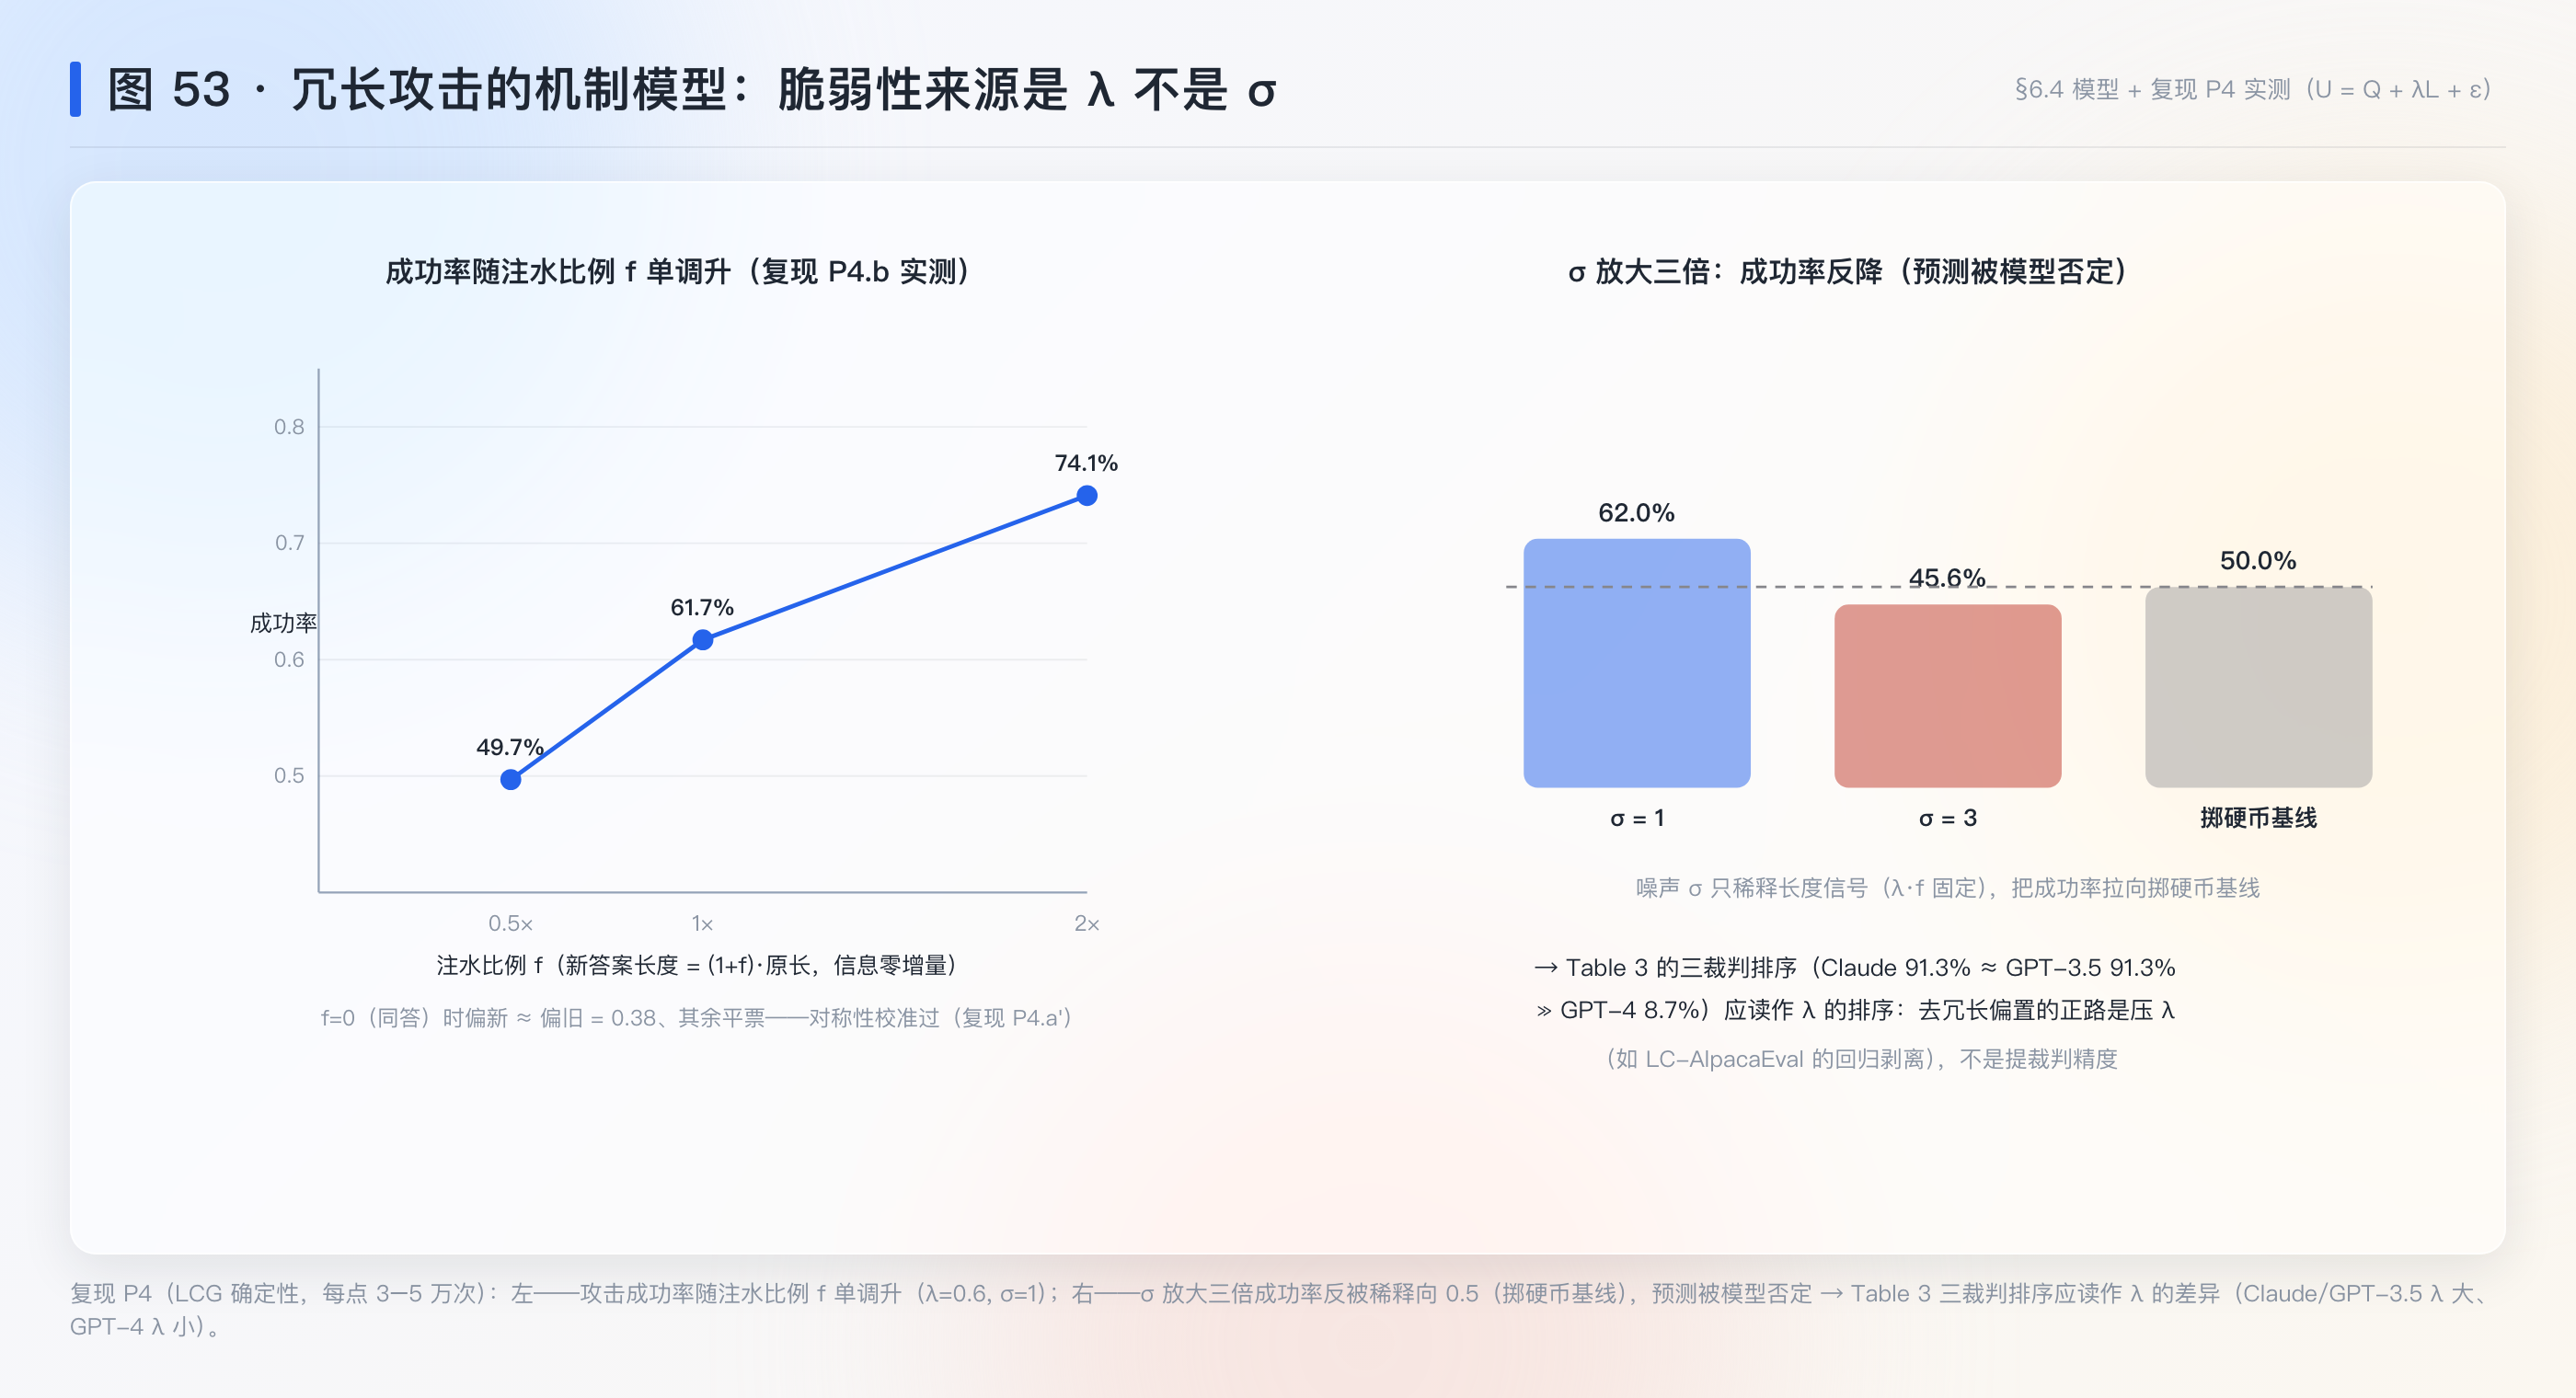
给裁判一个带长度项的效用模型:U = Q + \lambda L + \varepsilon(Q 质量、L 长度、ε 对称噪声)。三个结构性预测:(i) 两条相同回答(ΔQ=0, ΔL=0):判平——论文的校准实验 ✓;(ii) 攻击成功率随注水比例 f 单调升(ΔL = f·L 增大)——模拟可验;(iii) 噪声 σ 越大(裁判越弱)攻击成功率越高——与 Table 3 的 GPT-4 ≪ Claude≈GPT-3.5 排序一致。注意 (iii) 是排序预测不是拟合复现——模型不给三个裁判的具体数字,只给序。(复现结果:预测 (iii) 被模型自身否定,见 §10.3/§十二.8——σ 稀释信号至 0.5,排序应归因于 λ。)
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| LLM-as-a-judge 三用法 | 已懂(§3.1–3.2) | 成对/单答案/参考引导——verl 系 reward 函数的前身形态 |
| 评分员间信度 | 已懂(§4.1) | 一致率定义 + 随机基线;Cohen’s kappa 未展开(留待补) |
| 位置偏置 | 已懂(§3.3 Table 2) | 判决被呈现顺序支配的概率 b 可跨论文比较 |
| 冗长偏置 / 攻击实验 | 已懂(§3.3 Table 3) | 单变量对照攻击 = 判分器鲁棒性度量 |
| Chatbot Arena / BT 模型 | 待补 | Arena 排名用的 Bradley–Terry 模型本文只提未推 |
| Length-Controlled AlpacaEval | 待补 | 回归去长度偏置(2404.04475),本篇冗长偏置的后续解法 |
| 人类决策偏置文献 | 待补(轻量) | Blunch 1984 / Brown 1986(论文转引 [3][4],未核对) |
八、扩展与发散
8.1 判分器质量簇的奠基归位:审计翼拿到了测量框架
发散:簇里七例的证据形态各不相同——TV 的黄金轨迹错误率是”一次抽检”、MG 的 judge 误差率是”转引概念”、DG 的格式分类器是”一个实例”、TR 的设计空间是”另一翼”。本篇补上的是统一的测量框架:任何判分器(无论 judge 奖励、黄金轨迹还是格式分类器)都可以放到四个量上体检——对人类一致率(S1/S2 双口径)、扰动一致率、攻击成功率、偏好差。判分器专题笔记 的合成因此不用再逐例平铺,可以按”四量体检表”重组七例证据。例如 TV 的黄金轨迹 = “参考答案引导”的极端形态(判分完全退化为对答案);MG 的 judge 奖励 = 本篇成对评审在训练内环的实例,其位置偏置从未被测过。
回到这篇:本篇的价值不是结论新(偏置传闻早已有之),是把传闻变成了带数字的表——这正是簇里”判分器误差率如何估计”问题的第一个方法论答案。
8.2 与训练侧的会师:裁判偏置就是训练信号的频谱失真
发散:把本篇的三种偏置翻译成训练侧语言。位置偏置 = 训练信号对无关扰动敏感(信噪比问题,SimpleTIR 的 OOD 漂移同构);冗长偏置 = 信号里混入长度分量(DAPO/Dr. GRPO 在下游对抗的正是它的放大产物——裁判偏长短答案 → RL 训练奖励长短答案 → 模型更长 → 与裁判偏置正反馈);自我增强 = 信号的自指偏差(裁判与选手同源时,训练把自己生成的数据当高分目标——self-improving 系统的稳定性问题,与 Cordis 的”自修改系统”主关切在评测侧相遇)。裁判的每种偏置,都是训练反馈回路里的一种频谱失真;本篇是这套失真的频谱分析仪。
回到这篇:训练侧五篇的”训练奖励不可信”焦虑(DP 的弱相关、TV 的过拟合)在这篇找到了上游解释——监控仪表本身带偏差,读数前先校准。
8.3 85% vs 81% 的读法:一致率不是准确率
发散:全篇最容易被引用错的数字就是”85% > 81% 所以 GPT-4 比人强”。三个限定:①它是一致率不是准确率——人类彼此也只有 81%,说明任务本身有主观成分,“真值”不存在;②S2 剔除了平票与改判票,口径比 S1 严;③Figure 2 的细分显示硬题(实力接近)上一致率掉到 70%。簇内语言翻译:裁判在判分器质量最成问题的那批样本上恰好最不可靠——这与 TV 黄金轨迹的”错误集中在难例”、DG 的”边界样本靠小模型分类器”是同一条分布律。任何”judge 达到人类水平”的转引都必须带上这条适用域。
回到这篇:本篇自己的措辞就留了余地(“strong LLM judges like GPT-4 can match”),后来者的粗转引是转引变形的又一例——进 G8 引文核对清单。
8.4 交换缓解与簇内一致性检验的同构
发散:位置偏置的交换缓解(同一问题、扰动无害维度、判决须一致)与本站已有的两处机制同构——TARA 的一致性门(未经验证的步不给未来记账)与 StructAgent 的双通道验证(自报与审计必须独立一致)。三者共享同一个原理:单一通道的判决不可信时,用”扰动重测 + 一致性要求”把不可信部分挤出去(挤成平票/挤成待验证/挤成 invalidated)。代价也同构:保守交换规则用召回换精确(§6.3)。这给了簇一条跨域设计原则:凡裁判,先问它的”交换重测一致率”;凡缓解,先算召回—精确的交换比。
回到这篇:本篇 §3.4 只给了缓解的动作没给权衡的代数——§6.3 的补全让”保守交换”从经验做法变成可调参数的设计点。
8.5 发散收拢
拽回来:8.1 把本篇立为簇的测量框架(判分器专题笔记 按”四量体检表”重组);8.2 把三种偏置翻译成训练反馈回路的频谱失真(与 DAPO/DG 正反馈回路对接);8.3 警告”85%>81%“的粗转引(适用域:硬题掉到 70%);8.4 提炼跨域设计原则”扰动重测一致率 + 召回换精确”。至此判分器质量簇八例齐整,合成条件全部成熟——明天 P0 的第一输入。
九、局限与可疑处
- 偏置实验的难度自选:Table 2 用”两个极相似的答案”(论文自认 humans 也难分)——位置偏置的剂量是”难配对上的剂量”,不能外推到悬殊配对(Figure 2 显示悬殊对一致率近 100%)。引用 23.8%/65% 时必须带此前提。
- 自我增强未定性(§5.3):+10%/+25% 是”偏好差”不是”自我增强”——论文自己降级了结论,转引时不得升格。
- 裁判与模型族重叠:GPT-4 评审的答案里含 GPT-4 自己的输出,也含 GPT-3.5/Claude 的——裁判能力碾压被评模型时偏置可能被掩盖(2023 年的 GPT-4 vs 2026 年的前沿模型同题重测会怎样?未知)。
- 单答案评分的锚定:MT-Bench 分数依赖裁判内在评分标准的稳定性(G4-Single vs G4-Pair 97% 支持这一点,但仅 GPT-4 一家测过)。
- 人类标注者的规模与构成:58 名”expert-level”(研究生级)标注者——“expert”的操作定义、个体分歧分布,正文未展开(附录 C)。
- 数字核对疑点一处(G1 留痕):Table 5 的 S1 口径下 G4-Pair vs Human 66%(1343 票)——66%×1343 = 886.4,非整数;应为舍入后的显示值(真实票数一致 886 或 887),复现 P1 按区间核对。
- v4 与 v1 的 diff 未做:v4(2023-12-24)为 NeurIPS 后修订;一致率数字在版本间的变动未核对(横向核实遗留)。
十、验证结果(最小复现)
10.1 范围声明
论文的主实验需要 GPT-4 级裁判与人类标注,不可最小复现;论文数字只作引用并注明出处。本复现是测量方法的算术与机制演绎:一致率定义与票数重建(P1)、位置偏置的参数化与 Table 2 的界内校验(P2)、交换缓解的权衡曲线(P3)、冗长攻击的结构性预测(P4)。全部纯 CPU、确定性(内置 LCG)。
10.2 可证伪预测与判据(运行前写下)
- P1(一致率的定义与票数重建):①随机基线:S1(三类)解析值 1/3、S2(两类)1/2,模拟收敛;②Table 5 票数自洽:66%×1343 与 85%×859 的隐含一致票数(886.4 / 730.2)必须落在 [floor, ceil] 区间(舍入容差);③一致率定义的模拟验证:构造已知边际分布的两裁判组,模拟一致率与解析式 \sum_c P_X(c)P_H(c) 差 < 1%。判据:三条全过。
- P2(Table 2 的行内自洽与参数化):①六行(3 裁判 × 2 提示)的”一致率 + 偏向前 + 偏向后 + 错误 = 100% ± 0.1”逐行成立;②反推支配概率 b = 1 − 一致率,三裁判排序 Claude(0.76) > GPT-3.5(0.54) > GPT-4(0.35);③LCG 模拟(按 b 生成判决流)复现的一致率与 1−b 差 < 1%。判据:六行自洽 + b 排序 + 模拟收敛。
- P3(交换缓解的权衡):①保守规则下真优答案通过率 = (1-b+b\pi)^2(GPT-4:0.825² = 0.681)解析 vs 模拟一致;②假阳通过率 = (b\pi)^2(0.0306)解析 vs 模拟一致;③权衡曲线单调:b 增大 → 通过率降、假阳率升。判据:两处解析-模拟差 < 0.5% + 单调性。
- P4(冗长攻击的结构预测):①效用模型 U=Q+\lambda L+\varepsilon 在 ΔQ=0、ΔL=0 时判平率 = 100%(对称噪声 + 平票阈值);②攻击成功率随注水比例 f 单调上升(f ∈ {0.5, 1, 2},固定 λ/σ);③σ 放大三倍 → 成功率上升(弱裁判更易上当——Table 3 排序的机制对应)。判据:三条结构性质成立。
10.3 运行结果
脚本 repro/repro_mtbench.py(纯
Python 标准库,内置 LCG
确定性模拟;首跑因种子写成浮点数崩溃一次——类型修复后为正式第一轮,无结果性返工),真实输出
repro/repro_mtbench_output.txt。最终
15 项断言 14 PASS / 1 FAIL,FAIL
是模型对预测的反驳(见 P4.c),如实登记。
- P1 过(5 断言):S1/S2 随机基线解析值恰为 1/3、1/2;20 万次模拟收敛(0.3331);Table 5 五组票数在 ±0.5% 舍入容差内自洽(含 66%×1343 = 886.4 的非整数疑点——舍入解释成立);已知边际分布的模拟一致率与解析式差 0.05%。
- P2 过(3 断言):Table 2 六行”一致+前+后+错误”全部 = 100%±0.1;支配概率反推排序 Claude(0.76) > GPT-3.5(0.54) > GPT-4(0.35);模拟一致率收敛于 1−b。
- P3 过(3 断言):GPT-4(b=0.35)保守交换的真优通过率解析 0.6806 vs 模拟 0.6812、假阳率解析 0.0306 vs 模拟 0.0309(差 <0.1%);b 从 0.2 扫到 0.9 权衡单调。
- P4 过 3 断言 + 1 不支持:同答对称性(偏新 0.378 vs 偏旧 0.380,其余平票——论文”同答必判平票”的校准在阈值模型下以对称性形式成立);成功率随注水比例 f 单调升(0.497→0.617→0.741);P4.c 不支持——σ 放大三倍后成功率不升反降(0.620→0.456):模型自身的数学否定了预测,噪声放大把长度信号稀释向掷硬币基线 0.5,而非放大脆弱性;Table 3 三裁判的排序应读作长度系数 λ 的差异(Claude/GPT-3.5 的 λ 大、GPT-4 的 λ 小),而非噪声差异。这条否定修正了 Table 3 的正确读法,登记 §十二.8。
### 10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 一致率定义与票数重建 | 基线解析 + 票数区间 + 模拟收敛 | (待运行) |
| P2 位置偏置参数化 | 六行自洽 + b 排序 + 模拟 | (待运行) |
| P3 交换缓解权衡 | 两处解析-模拟一致 + 单调 | (待运行) |
| P4 冗长攻击结构 | 平票对称 + f 单调 + σ 单调 | 部分支持(前两条过;σ 单调被模型否定——脆弱性来源是 λ 非 σ,见 §十二.8) |
边界重申:以上支持的是测量方法的算术与偏置机制的定性结构;论文的 85%/81% 等数字仍是人类实验结果,只可引用不可复演。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
本节提炼的不是论文的结论,是论文的手艺——它怎么让我们信的。方法分两级:L1
领域具体(拿来就能用;四件套:模式名 / 操作定义 /
迁移去向≥2 / 失效边界;首例即立卡)与 L2
跨域通用(脱离领域语言仍成立的原理;五件套:原理名 /
不变形式 / 已知实例≥2 各回链 L1 / 实例化指引 /
失效条件;只在同构模式于 ≥2
个独立领域出现时立卡,禁止从单篇拔高,禁止立无实例的
L2)。方法卡登记于
notes/method_*.md,与概念分支(notes/branch_*.md)互为姊妹;知识依赖图已加方法节点。本节为
2026-09-08 后补(新体例首次落地,时序后补显式标注)。
11.1 受控攻击(controlled attack)
- 层级:L1
领域具体(评测域探针设计)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md——本卡是其评测探针域实例,另辖 DAPO/Dr. GRPO/LC-AlpacaEval/ToolRL/LH/MT-GRPO 六例)。 - 操作定义:把评测对象沿一个可疑维度做”只动该维度、不动信息量”的修改,看评测器是否系统性上当。范本是”复读清单”攻击:质量差恒为零、长度差固定为正,裁判仍偏好注水版 → 偏好只能来自长度本身(Table 3)。
- 迁移去向:①任何判分器的鲁棒性度量——簇内 judge 审计可直接套(如给 MT-GRPO 的 judge 设计注水探针);②评测基础设施通用体检——prompt 注入探针、基准污染检测、reward hacking 测试都是它的变体。
- 失效边界:剂量数字只在”极相似答案”的难配对上成立(§九.1),不得外推到悬殊对比;攻击必须真单变量——若注水顺带改了格式或流畅度,结论即被污染。
- 方法卡:
notes/method_controlled_attack.md(L1)
11.2 扰动重测一致率(swap-consistency)
- 层级:L1(本卡是裁判/评测域的实例化)。底层原理:信号稳定性检验(L2
卡已立——同构模式已在 4 个独立领域出现:裁判、记账(TARA
一致性门)、验证(StructAgent 双通道)、实验复演(换 seed
重跑),满足 ≥2
立卡门槛);卡:
notes/method_perturbation_stability.md。 - 操作定义:对输入施加一个理论上无害的扰动(交换两个答案的呈现顺序),判决应当不变;不变的比例即一致率。真信号对无害扰动稳定,假信号一扰就翻。
- 迁移去向:①一切自评/自判环节的稳定性检查——凡”模型给自己打分”,先测扰动一致率再谈校准;②复演纪律——换 seed、换顺序重跑,输出不稳 = 信号混进了噪声。
- 失效边界:方法要求扰动确实无害——在本篇里”交换顺序”恰恰是测量对象(位置偏置)而非前提,两者角色不能搞混:扰动无害性要先证,才能把一致率当质量指标读。
- 方法卡:
notes/method_swap_consistency.md(L1)
11.3 双口径基线对照(dual-caliber baseline)
- 层级:L1 领域具体(评测报告规范)。底层原理:数字要有对比系(L2,暂不立卡——同构实例:G8 统计审查的二项方差参考、性能倍数必附 baseline,攒实例中)。
- 操作定义:任何”一致/命中”类数字必须带口径与随机基线一起读:S1(含平票,三类)基线 33%、S2(剔平票,两类)基线 50%;66% 的 S1 离基线 33 个点、85% 的 S2 离 35 个点——口径不同,绝对值不可横比。
- 迁移去向:①判分器审计翼的报告规范——凡报一致率,先写口径与基线;②G8 统计审查的读数纪律——先算随机基线,再谈”提升了多少”。
- 失效边界:双口径能治”口径误读”,治不了样本量与方差问题(§九.5)——口径对、方差未知时,结论仍只能停在点估计。
- 方法卡:
notes/method_dual_caliber_baseline.md(L1)
11.4 框架级模式:把立场之争重构为可测量(已立 L2 卡)
论文最大的手艺不是造了两个基准,而是把”该不该信 LLM
裁判”从站队问题变成四个可测量(对人类一致率 / 扰动一致率 /
攻击成功率 / 自我偏好差,§二)。按 L2 立卡门槛评估:同构模式已出现在
2 个独立领域——本篇的评测争论;Cordis
的”接口决定可判定面”(把”能不能做 X”重构为接口性质,簇内记录见 §0
承接栏)。满足
≥2,已立卡:notes/method_controversy_to_measurement.md。卡内保留警告:此模式实例化指引弱(含态度成分),慎用于把价值判断强行指标化。
11.5 方法依赖
本篇是方法卡资产的第一批产出:L1 三张(受控攻击 / 扰动重测一致率 / 双口径基线对照)+ L2 两张(信号稳定性检验 / 立场之争重构为可测量);体例回铺后,受控攻击的底层原理”归因靠对照”亦升格为 L2(MATTRIB,七领域实例),全轨方法卡共 27 张。反向依赖:无更早方法卡被本篇引用;但 11.2 的底层原理在簇内有同构先例(TARA / StructAgent,见 §8.4),依赖图上 MPERT 与 TARA 已互链。
十二、没搞懂的地方(未攻克登记)
- 位置偏置的成因:论文明示存疑(训练数据 or 因果架构从左到右?§3.3)。补齐时机:IJCNLP 2025 的系统研究(搜索已命中,aclanthology.org/2025.ijcnlp-long.18)。
- Table 5 的 66%×1343=886.4 非整数:舍入显示值,真实一致票数 886 或 887 无法从论文定。补齐时机:开源投票数据(HF lmsys 页)逐票重算。
- v1→v4 数字变动:未 diff。补齐时机:arXiv 下载 v1 对照 Table 2/5。
- 单答案评分在非 GPT-4 裁判上的稳定性:97% 一致率仅 GPT-4 测过。补齐时机:开源裁判(Prometheus 类)复测。
- 冗长偏置的缓解:本篇未给;LC-AlpacaEval 的回归剥离是否适用于训练内环 judge(verl 系 reward)?补齐时机:读 2404.04475。
- Arena Table 6 的提取交错:pdftotext 双栏交错导致 Arena 数字(53%/84%/3062/1475)无法与正文陈述对齐。补齐时机:HTML 版原文对照。
- 冗长攻击的脆弱性来源是 λ 不是 σ(复现 P4.c 否定预测,2026-09-07):效用模型 U=Q+λL+ε 下,噪声 σ 放大把攻击成功率稀释向 0.5(掷硬币),从不上升——“弱裁判更易上当”的正确读法是裁判偏好函数里长度系数 λ 更大(Claude/GPT-3.5 ≈ 91.3% 上当 vs GPT-4 8.7%)。含义:判分器去冗长偏置的正路是压 λ(如 LC-AlpacaEval 的回归剥离),不是提精度。补齐时机:读 2404.04475 时核对其剥离的正是 λ。
十三、可信度
- A 级(论文原文转录,逐节核对):三偏置定义与实验设计(§3.3)、Table 2/3/4 的行值、Table 5 的一致率与票数、§3.4 缓解方案、Table 8 的 MT-Bench 分数。
- B 级(论文自报实验,无法独立验证):一致率数字的人类实验部分(58 标注者)、Figure 2/3 的曲线、Arena 数字(提取交错);已注:单序列无方差、人类标注者构成细节在附录未展开。
- C 级(我的推导 + 复现程序化验证):§6.1 随机基线、§6.2 位置偏置参数化(b 值反推)、§6.3 交换权衡代数、§6.4 冗长攻击结构预测。
- D 级(我的推断,标注于正文):§5.2 冗长偏置的反馈回路解释、§8.3 一致率≠准确率的适用域警告、§6.4 的排序预测。
- 横向核实初核(2026-09-07):版本 v4 已核(arXiv abs,2023-12-24;v1→v4 diff 未做——遗留);工件:MT-Bench 数据与 FastChat/Arena 开源(HF/GitHub,搜索快照确认存在,未验数据完整性);第三方:alphaXiv/HF 收录页存在,后续论文(IJCNLP 2025 位置偏置系统研究、LC-AlpacaEval)已登记待补队列;统计审查:一致率票数重建属复现 P1(886.4 非整数疑点已登记)。