外行导读(先读这个,再决定要不要进正文)
一个场景:你训一个会调工具的模型——查搜索、订机票、算数。它写的每条工具调用有三层可以对:工具名对不对、参数名对不对、参数值对不对。训练时奖励怎么给?全对才给分,模型早期几乎拿不到分数学不动;乱给分,模型学会摆对格式骗分、内容一塌糊涂。怎么拆这份奖金,是这篇论文的全部问题。
这篇论文干的事:把工具调用的奖励拆成两本账——格式分(0 或 1,括号标签按顺序齐不齐)与正确性分(−3 到 +3,工具名、参数名、参数值三层匹配打分,预测集合与标准集合做最优配对);然后用 GRPO 训四个模型,把奖励的四个设计轴逐个做消融:类型、尺度、粒度、时间动态。四个结论:正确性分要比格式分贵;奖励尺度要渐变不要急刹;粒度越细信号越富;显式的长度奖励在工具任务上有害甚至有毒。冷启动 GRPO 加这套奖励,比同数据量的 SFT 高约 15%,泛化到只看最终答案的问答设定仍然领先。
为什么值得关心:这篇是本站判分器质量簇的第一篇”设计空间”论文——前六例讲的是判分器会怎么出错,这篇讲的是判分器可以怎么设计、每个设计选择付出什么代价。任何靠奖励塑形行为的系统(训练、竞赛评分、绩效考评)都吃这套规律:信号怎么拆、权重给谁、何时切换,每一个都是可证伪的设计决定。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| TIR | 工具集成推理:模型边想边调工具(搜索、计算器)再继续想 |
| Rformat | 格式奖励:<think>/<tool_call>/<response>
标签齐且顺序对就得 1 分,否则 0 分 |
| Rcorrect | 正确性奖励:预测的工具调用集合对比标准答案集合的匹配分,范围 −3 到 +3 |
| 最优匹配 | 预测调用与标准调用的配对方式有很多种,取总分最高的那种配法 |
| GRPO | 同一道题采样一组回答,按”比同组平均好多少”定优劣 |
| 奖励尺度 | 每个奖励分量的取值范围,如格式 [0,1]、正确性 [−3,3] |
| 奖励粒度 | 判分拆到多细:三层分开打分(细) vs 全对才给分(粗) |
| 冷启动 | 不做任何 SFT 预热,直接从指令模型开始 RL |
| verl | 字节开源的 RL 训练框架,本篇的实现底座 |
| BFCL | Berkeley 函数调用排行榜,工具调用评测的主基准 |
§0 承接栏
这篇接的是 SimpleTIR 篇留下的一笔对照账。SimpleTIR 对”格式”的处理是极简的:轨迹里出现 void turn(该有代码块和答案的地方两样全没有),整条轨迹删除,格式本身不进奖励。ToolRL 走另一个极端:格式本身是一条显式奖励,0 或 1,和正确性分相加成总账。同一个”格式”,一个当删除判据、一个当奖励项——这两极之间隔着整片设计空间,这篇论文干的事就是把这片空间铺开量一遍:格式分和正确性分各该值多少分(§5.2)、判分拆到多细(§5.3)、奖励尺度随训练怎么变(§5.2/5.4)、要不要额外奖励长思考(§5.1)。
另外两笔旧账也在这篇还上。其一,KL 关闭的数据点添到第五个:ToolVerse、MT-GRPO、SimpleTIR、DAPO 之外,本篇附录 Table 8 写明 GRPO 配置 “KL Loss Used: False”(§3.4 原文给的理由仍是”更自由地适配自定义格式与奖励信号”)——DAPO 篇的 KL 结案陈词再添一证,受控消融依旧缺。其二,判分器质量簇等到第七例:ToolVerse 的黄金轨迹、MT-GRPO 的 judge 误差率、SimpleTIR 的格式契约、DAPO 的答案整数化、Dr. GRPO 的格式分类器、Cordis 的接口判定——前六例都是”判分器会怎么出错”,这篇反过来了:它把判分器本身当作设计变量,拆出类型、尺度、粒度、动态四个轴逐个消融。簇里从此多了一个维度:不是”判分准不准”,而是”判分器的设计选择本身如何塑形行为”。
到这里,训练侧的地图更新为:信号怎么算(TARA/MT-GRPO/Dr. GRPO)、毒样本怎么处理(SimpleTIR/DAPO)、信号怎么设计(本篇)。TIR 谱系的欠账(SimpleTIR 篇登记的 ToolRL 一项)就此还上。
一、论文在解决什么问题
1.1 一个具体场景
你拿 Qwen2.5-3B-Instruct 想教会它调工具:先 SFT 一批演示轨迹,它在训练见过的模式上表现不错,换到陌生场景就散架——论文的判断是 SFT “过拟合到特定模式”(§3 开头,Fig 1:SFT 蒸馏轨迹带来 overthinking 与有限泛化)。换 RL,新麻烦立刻出现:数学题的奖励好给,答案对就完事;工具调用是多步、多条、多层的——一步里可能并行调两个工具,每个工具有名字、一串参数名、每个参数还有值。答案匹配这种粗粒度奖励”给不了细粒度反馈”(摘要)。
于是问题从”怎么训练”变成”奖励怎么设计”:格式要不要单独给分?给多少?正确性判分拆到多细?这些设计选择每一个都在塑形模型的行为,但此前没人系统量过(§1:相关工作”focus is narrow”)。
1.2 与前几篇的入口差
SimpleTIR 从”毒性样本”进(删除)、MT-GRPO 从”信用粒度”进(turn 级优势)、DAPO 从”系统工程细节”进,本篇从”奖励函数本身的设计空间”进——它不动算法主干(GRPO 原样用,KL 关掉),不处理毒样本,专攻 R(s) 这个函数该怎么写。注意它和 TARA 的亲缘:TARA 的逐 turn 对账需要黄金轨迹,本篇的逐步正确性分同样需要每步的标准工具调用(§3.1 原文:训练数据含逐步 ground truth tool calls)——判分成本都是簇内最高档,换来的都是过程级信号。对照见 §八。
二、核心想法
一句话:把工具调用的奖励显式拆成”格式 + 正确性”两本账,正确性按”名字—参数名—参数值”三层匹配打分、预测集与标准集最优配对;然后逐轴消融证明:正确性要比格式贵、尺度要渐变、粒度越细越好、长度奖励有害。
这个论断的价值不在公式多深——奖励函数本身只是几行代码——而在它把”奖励设计”从手艺变成了可消融的设计空间。在这之前,R1 式工作里的奖励是拍脑袋给的(论文原话:prior works 常依赖 binary 或过度简化的信号,§3.3);在这之后,每个设计选择都有对照数字。
先打个比方,帮你在心里给四个设计轴安个位置。判分像发奖金:格式分是”着装规范”——报告交没交、格式对不对,只有交/没交两档;正确性分是”业务评分”——按名目、条目、数值三层核对,还可以是负的(乱写倒扣)。四个消融轴各问一件事:两本账的奖金比例怎么定(尺度);业务评分拆几栏(粒度);奖金规则中途要不要换、怎么换(时间动态);要不要额外奖励”报告写得长”(类型轴的长度项)。
落到形式上:Rfinal = Rformat + Rcorrect,Rformat ∈ {0,1} 查特殊标签是否按序齐备;Rcorrect ∈ [−3,3] 由最优匹配下的三层匹配分归一化而来(§3.3,§六逐式推)。GRPO 侧:组内归一化优势 Ai = (ri − μQ)/(σQ + η),clip 目标,KL 惩罚移除(§3.4)。
所以这篇真正改变了什么:把”奖励设计”从直觉重构为四个可证伪的设计轴——每个轴有对照实验、有方向性结论、有失效案例。这与 DAPO 的”工程变量清单”同构,只是清单从训练管线挪到了判分器。
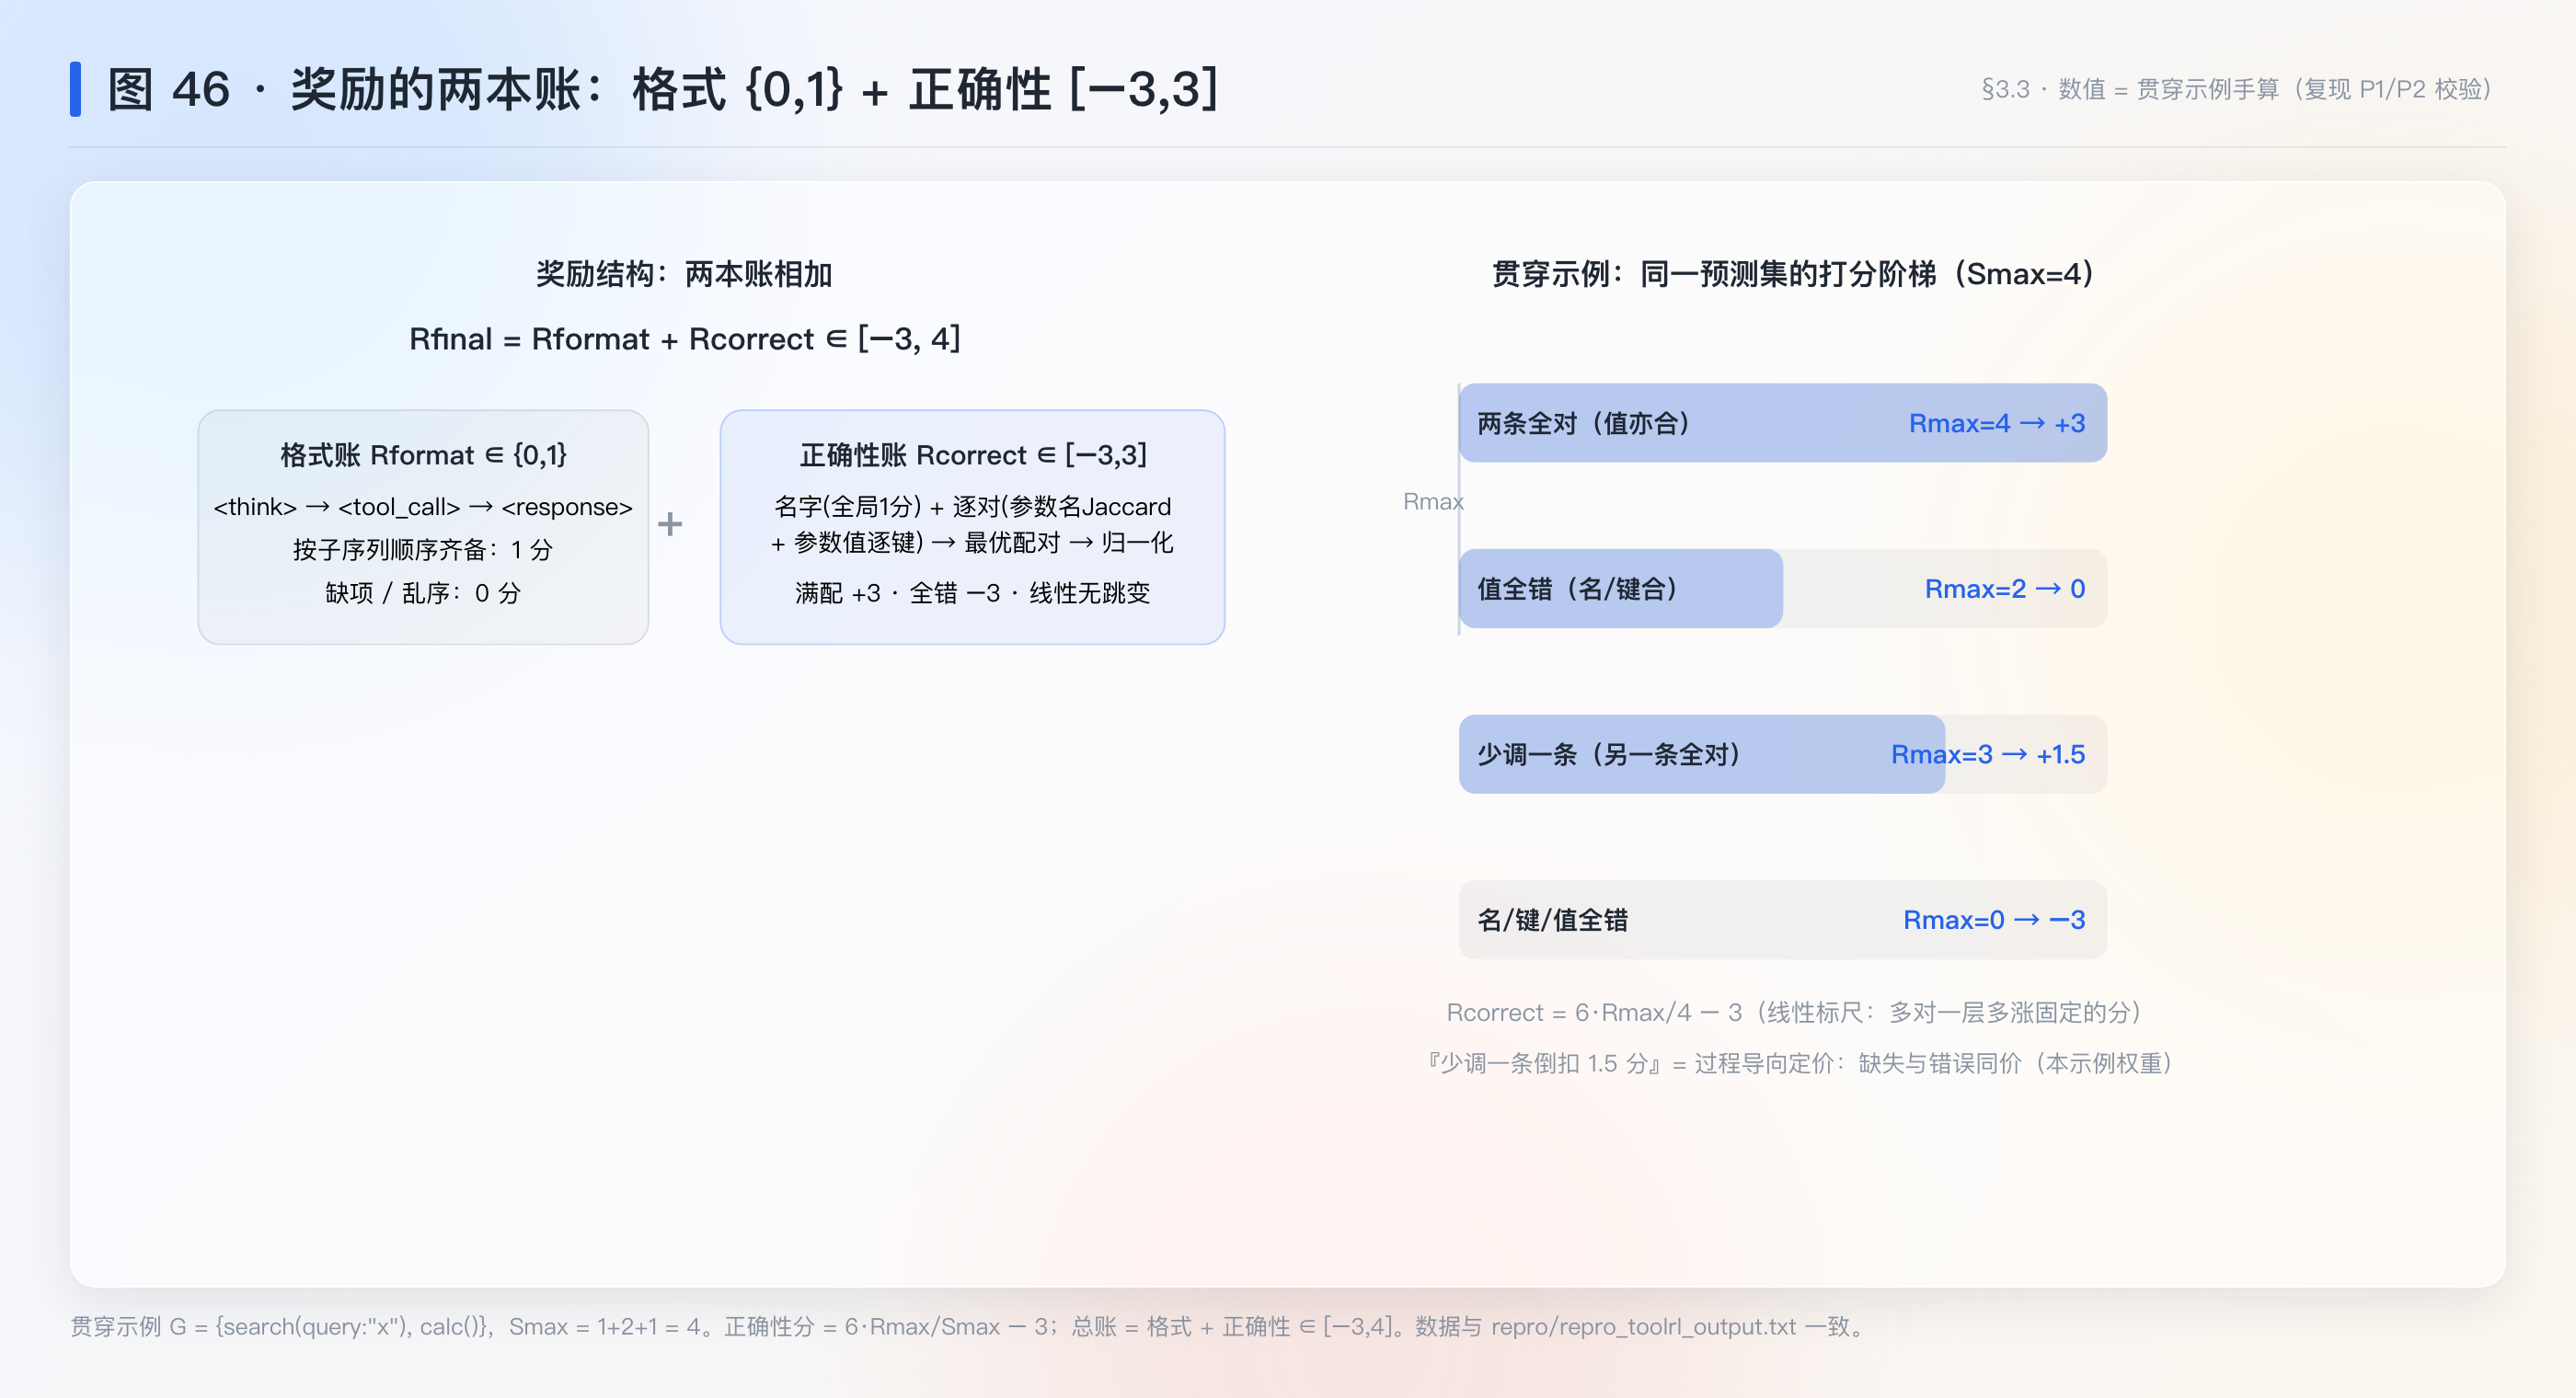
全篇就看这张:图 46(§五)——奖励结构分解与贯穿示例打分阶梯:正确性 / 格式 / 长度三栏怎么打分、阶梯怎么落,四个设计轴都在这张图上。 ## 三、数学基础(零起点,本篇新用到的四件)
3.1 集合与 Jaccard 系数
第一件工具是 Jaccard 系数,它量”两个集合有多重叠”。直觉:两份书单,重合的越多越像。写成公式,集合 A、B 的 Jaccard 系数是 J(A,B)=\dfrac{|A\cap B|}{|A\cup B|}——交集大小除以并集大小。完全重合时为 1,完全不相交时为 0,且永不超出这个范围(分子是分母的一部分,|A\cap B|\le|A\cup B|)。本篇用它给工具名打分:预测调用的名字集合与标准名字集合的 Jaccard,就是 rname(§3.3)。为什么不用精确匹配?因为部分重合也应得部分分——这是”细粒度”的入口,§五第三轴全靠它。
3.2 二分图匹配与”最优配对”
第二件是二分图匹配。直觉:几份简历投几个岗位,一个岗位只收一份,怎么配对总评分最高。预测调用集合 P 与标准集合 G 之间,每一种”一一配对方式”都有一个总分(配上的对按三层匹配打分,配不上的得零);最优匹配就是遍历所有配对方式取总分最高的那种。规模小的时候可以枚举全排列(n 个元素只有 n! 种),规模大要用匈牙利算法——本篇打分时取最优,§6.2 会证明”贪心配对不等于最优”并给反例。
3.3 归一化的线性标尺
第三件是线性归一化:把任意范围的原分 x ∈ [0, S] 映到目标区间 [a, b],用 x' = (b-a)\cdot\dfrac{x}{S} + a。本篇的正确性分就是它:原分 Rmax ∈ [0, Smax],映到 [−3, 3] 得 R_{\text{correct}} = 6\cdot\frac{R_{\max}}{S_{\max}} - 3。校验两个端点:全对(Rmax = Smax)得 3,全错(Rmax = 0)得 −3,中点得 0——线性标尺意味着”多对一层就多涨固定的分”,这是”过程导向”奖励的数学形态。
3.4 子序列判定
第四件是子序列判定:给定一个字符序列和一串要求的字段,检查字段是否按相对顺序都出现(可以夹杂别的内容)。格式奖励就是它:<think>
→ <tool_call> → <response>
依次出现即得 1 分(§3.3 的”all required fields appear and are in the
correct
order”)。直觉是”章节顺序对了就算格式合格”,哪怕中间有废话。§6.3
给它的实现与边界案例。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| s_k=(r_1,T_1,o_1),\dots,(r_k,T_k,o_k) | TIR 轨迹:推理、工具调用集、观察 | §3.1 |
| R_{\text{format}}\in\{0,1\} | 格式奖励:标签齐且按序 | §3.3 |
| r_{\text{name}}=\frac{|N_G\cap N_P|}{|N_G\cup N_P|} | 工具名 Jaccard 匹配 | §3.3 |
| r_{\text{param}}=\sum_{G_j}\frac{|{\rm keys}(P_G)\cap{\rm keys}(P_P)|}{|{\rm keys}(P_G)\cup{\rm keys}(P_P)|} | 参数名 Jaccard(按标准调用逐条累加) | §3.3 |
| r_{\text{value}}=\sum 1[P_G[k]=P_P[k]] | 参数值精确匹配 | §3.3 |
| S_{\max}=1+|G|+\sum_{G_j}|{\rm keys}(G_j)| | 匹配分满额值 | §3.3 |
| R_{\text{correct}}=6\cdot\frac{R_{\max}}{S_{\max}}-3\in[-3,3] | 正确性奖励(最优匹配下) | §3.3 |
| R_{\text{final}}=R_{\text{format}}+R_{\text{correct}}\in[-3,4] | 总奖励 | §3.3 |
| A_i=\frac{r_i-\mu_Q}{\sigma_Q+\eta} | GRPO 组归一化优势(η 防零除) | §3.4 |
| R_{\text{length}}=\min\bigl[\frac{L_{\text{think}}}{L_{\text{target}}},1\bigr] | 长度奖励(消融用,L_target=512) | §5.1 |
| R_{\text{correct}}'=2\cdot\frac{R_{\max}}{S_{\max}}-1\in[-1,1] | Equal-max 尺度变体 | §5.2 |
| p=S_{\text{current}}/S_{\text{total}} | 归一化训练进度(动态尺度用) | §5.2 |
五、机制
承上启下:§一 的麻烦是工具调用奖励”多层、多步、集合对集合”,§二 的路线是把奖励拆成两本账再逐轴消融。上节备好的四件工具各对一轴:Jaccard 对粒度轴(部分重合给部分分),最优匹配对正确性的集合配对,线性标尺对尺度轴(范围就是权重),子序列判定对格式轴。本节四个机制小节按”毛病→旋钮”配对讲,贯穿示例先立起来。
5.0 贯穿示例的数据结构
示例组(§3.3 记号同款):标准答案含两条调用
G = {
  G1: {name: "search",  parameters: {query: "x"}},     # 1 个参数
  G2: {name: "calc",    parameters: {}}                 # 0 个参数
}
Smax = 1 + |G| + Σ|keys(Gj)| = 1 + 2 + 1 = 4
模型预测 P 的好坏,全在”怎么跟 G 配对、配上了之后三层各对几成”。四个消融轴都拿这组数据演示。
5.1 机制一:格式与正确性——两本账的分账逻辑(§3.3)
【类比 · 着装与业务】 奖励像发奖金:格式分是着装规范——工牌挂没挂、衬衫塞没塞,只有合格/不合格两档;正确性分是业务考核——按项目核对,干得好加分、乱干倒扣。两本账分开记,谁也别冒充谁。 【跨域锚点】 竞赛评分的”形式审查 + 实质审查”两阶段。(类比与通识锚点,非论文内容)
先看病。R1 式工作的惯例是正确性分权重高于格式分,理由是防”reward hacking:模型钻格式空格不学任务语义”(§5.2 原文转述)。但”该多高”没人量过——全凭惯例。病根:格式与正确性混在一条未分解的奖励里时,你既不知道模型在学哪头,也无法单独调一头。
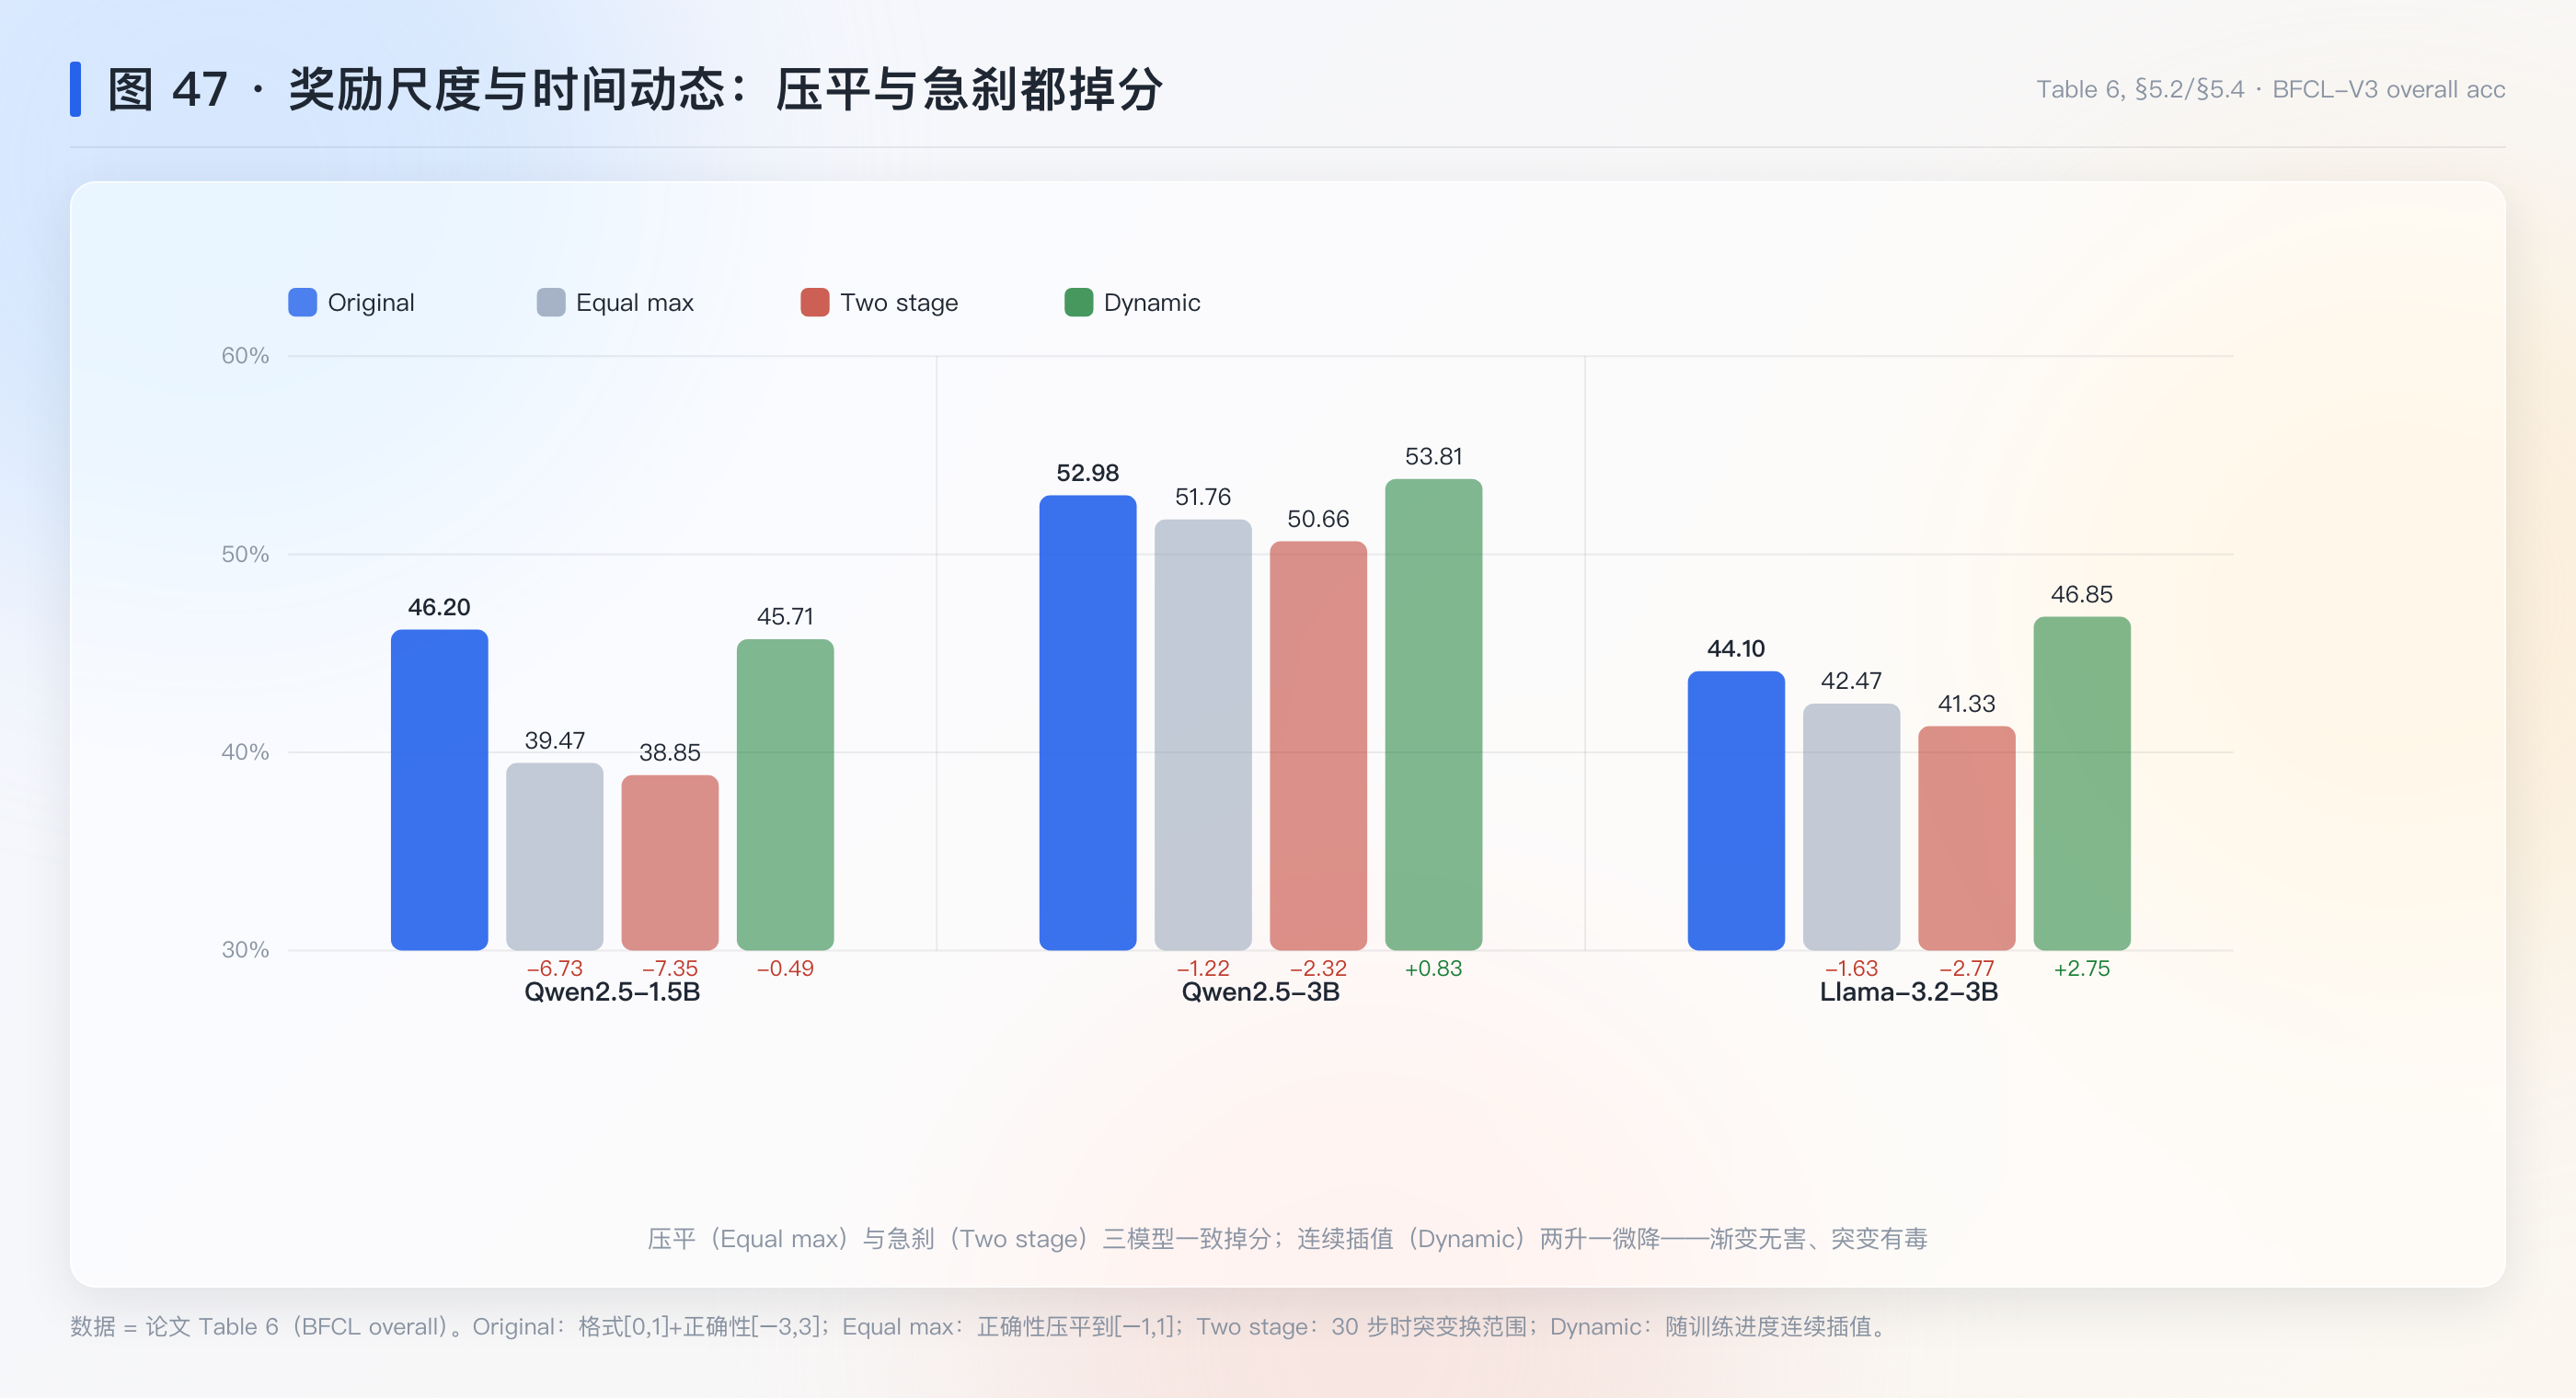
药方:显式分账。R_{\text{format}}\in\{0,1\} 只查标签;R_{\text{correct}}\in[-3,3] 只查调用内容;总账相加。为什么正确性范围给到 [−3,3] 而格式只有两档?论文的经验设定(§3.3:“empirically set the reward scale within the range of [−3,3]”),§5.2 的消融反向坐实了它的必要性——把正确性压到 [−1,1](Equal-max),三个模型里两个掉分,不可相关检测从 56.44% 崩到 16.44%(1.5B,Table 6)。
意义:分账之后,“奖励设计”的每个轴才能单独拧。这是全篇一切消融的前提。
5.2 机制二:尺度与时间动态——奖金比例与换挡方式(§5.2/§5.4)
【类比 · 换挡与急刹】 训练像学车:先练起步(格式,容易)再练路感(正确性,难)。换挡要顺滑——Dynamic 细粒度插值是匀抬离合;Two-stage 是 30 步时猛松离合——车会窜。尺度本身还有权重含义:正确性范围 [−3,3] vs 格式 [0,1],就是”业务 3 分抵着装 1 分”。 【跨域锚点】 课程学习的由易到难;渐进超时而非一刀切。(类比与通识锚点,非论文内容)
先看病。尺度轴有-static 与动态两问。静态问:把正确性从 [−3,3] 压到 [−1,1](与格式同范围)会怎样?Table 6:1.5B 从 46.20% 掉到 39.47%,Llama 从 44.10% 掉到 42.47%(3B 基本持平 51.76%)——正确性确实该比格式贵。动态问:训练中途换奖励规则行不行?Two-stage(30 步时格式从 [0,1] 砍半到 [0,0.5]、正确性从 [−1,1] 跳到 [−3,3])三模型全掉(1.5B 38.85%、3B 50.66%、Llama 41.33%);连续插值的 Dynamic 反而三模型两升一微降(Llama +2.75 到 46.85%)。
病根:Takeaway 2 原文——“abrupt shifts in reward scale may negatively impact the training dynamics”(突变破坏训练动力学),渐变才能”从简单目标平滑过渡到复杂目标”。为什么 Two-stage 比不动还差?补充推断(论文未展开):30 步时格式分正在快速上涨(Figure 10 的观察正是”format reward typically experiences a significant increase within the first 30 steps”),此时突然砍它的范围,等于在模型刚学会的行为上改牌价——策略里刚建立的格式习惯突然贬值,优化方向被搅乱。
意义:奖励规则可以随训练变,但必须连续变。“奖励的时间动态”从此是一个有对照数据的设计轴。
5.3 机制三:粒度——判分拆几栏(§5.3)
【类比 · 阅卷细则】 一道大题按步骤给分(名字对一半也有分),还是只看最终答案整对整错?细则越细,部分正确的卷子越能拿到”离满分多远”的信号;整题 0/1,错一步和全错拿同样的分。 【跨域锚点】 过程导向 vs 结果导向的评分之争。(类比与通识锚点,非论文内容)
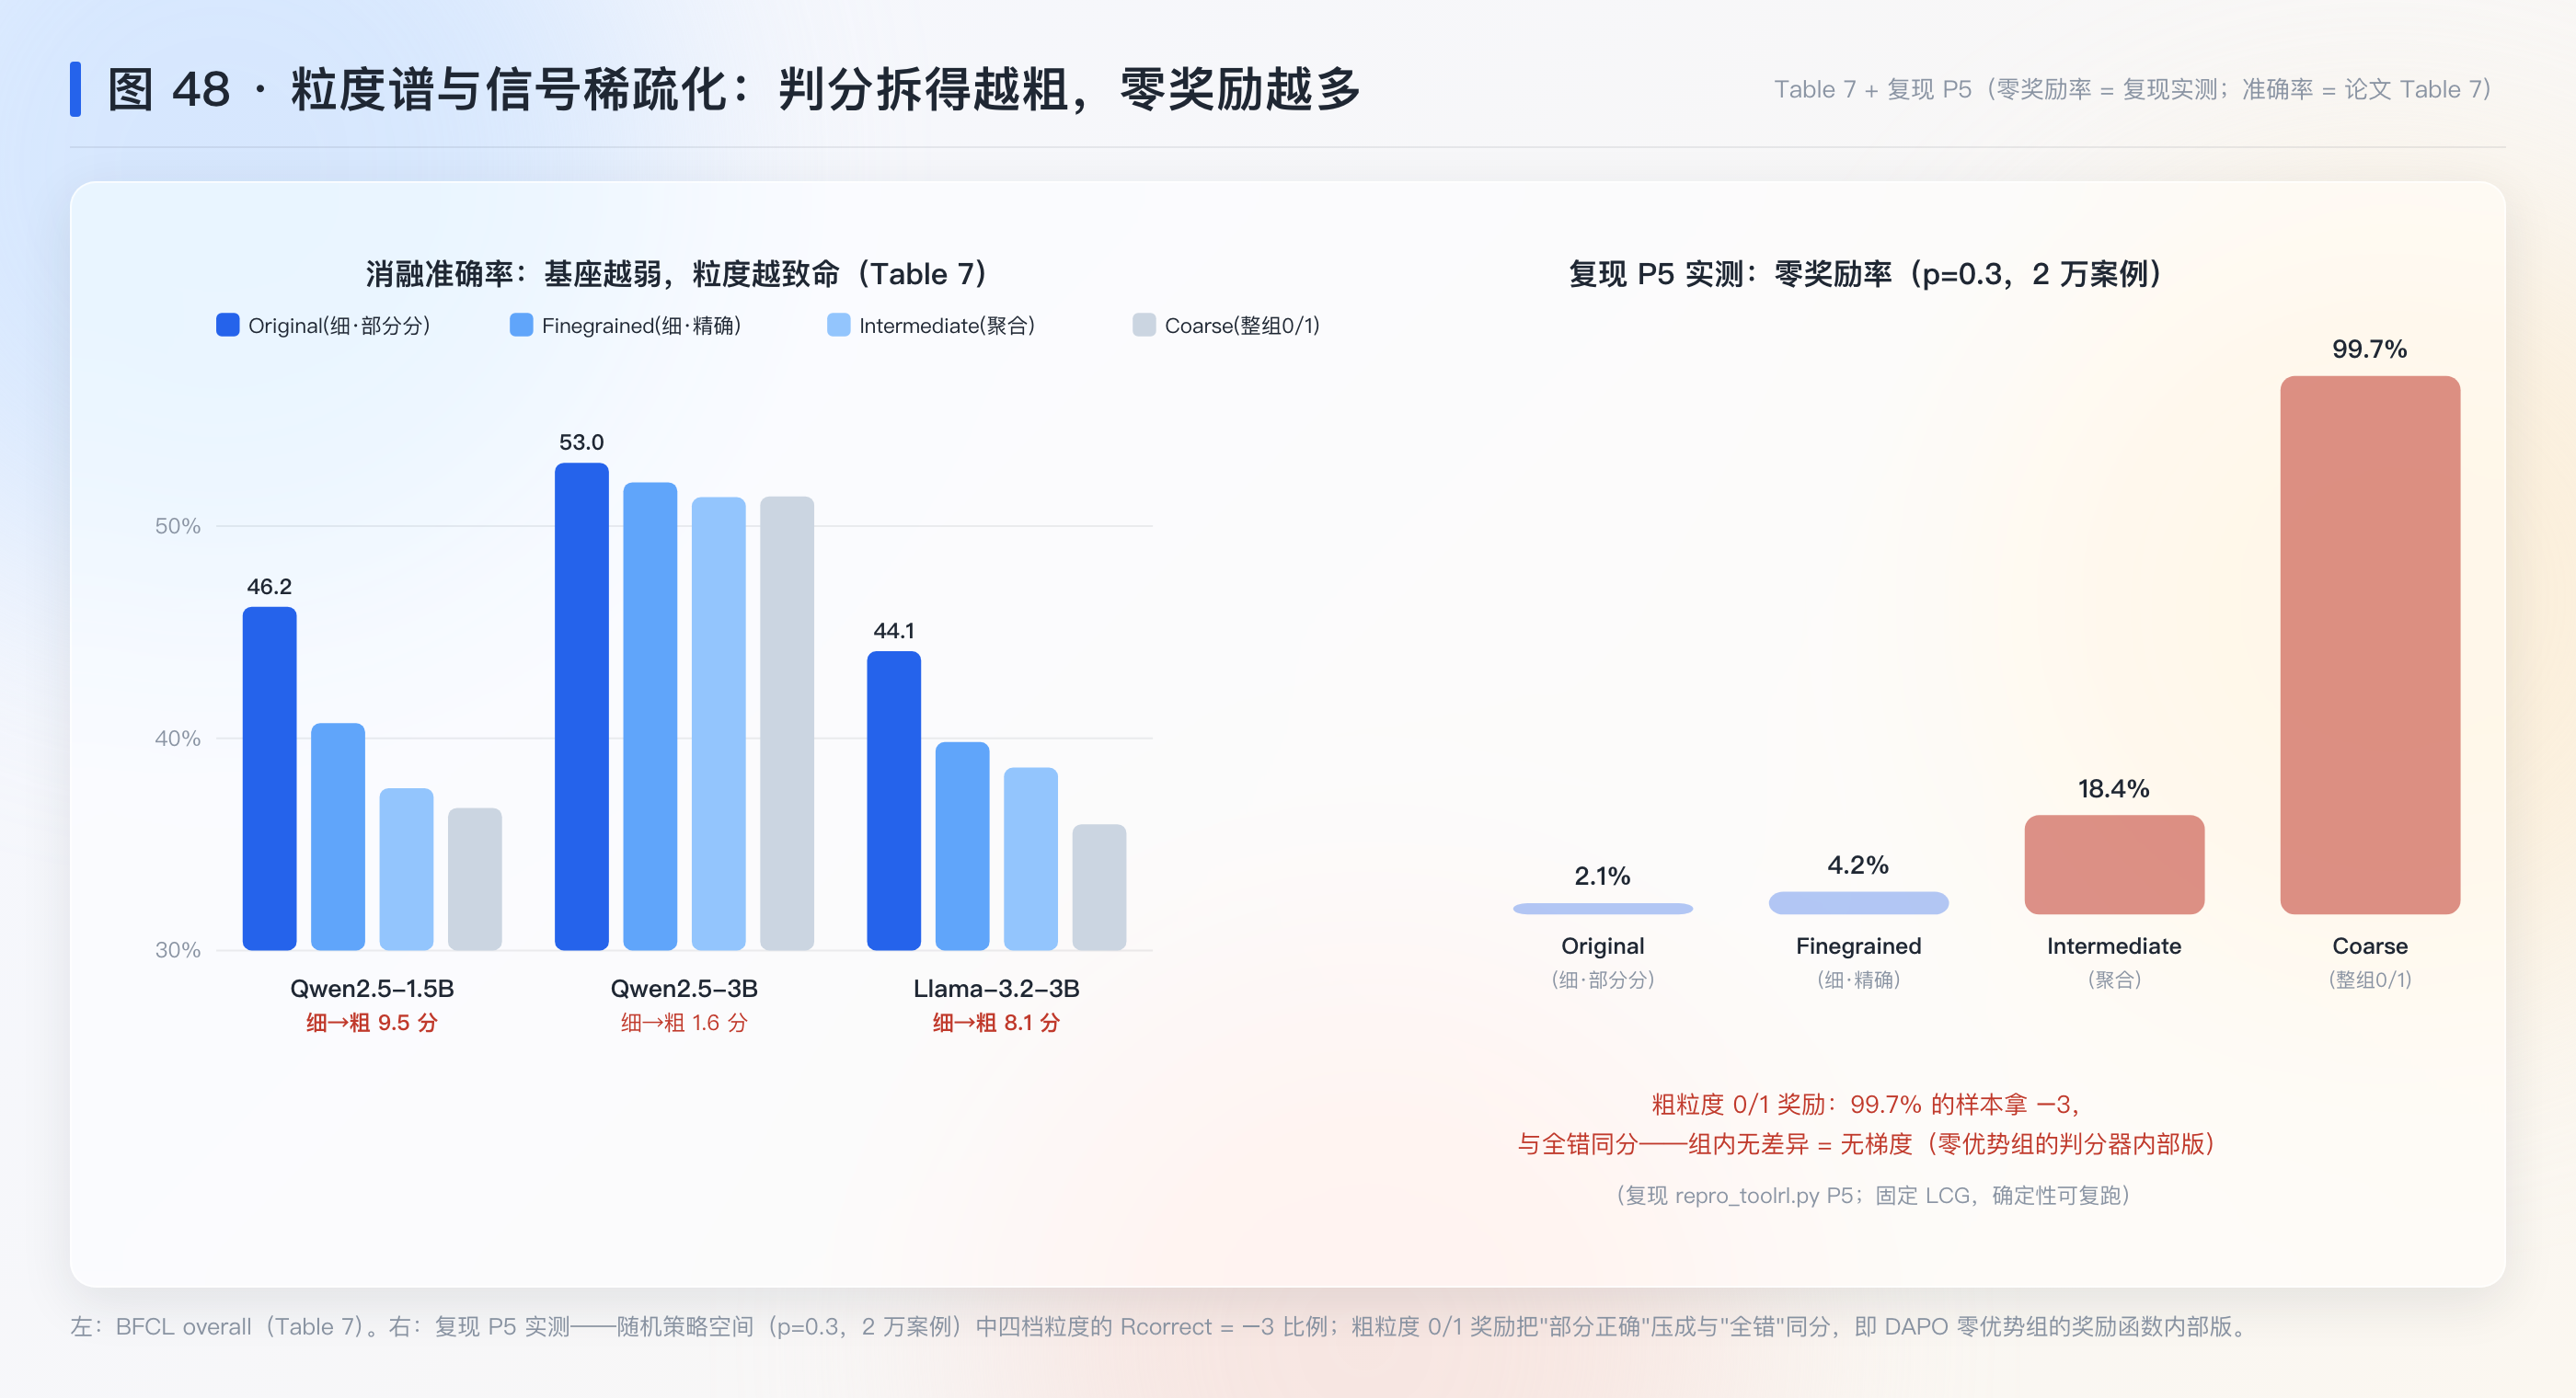
先看病。正确性判分天然有三个层次:工具名、参数名、参数值。原设计三层分开、部分重合给部分分(Jaccard)。消融把它逐级”缠”回去:Finegrained(名字与参数名改精确匹配,对才得分)→ Intermediate(整个参数字典精确匹配)→ Coarse(全部缠成一块,整套调用全对才给 1 分否则 0)。
数字(Table 7,BFCL overall):1.5B 原设计 46.20% → 40.71% → 37.65% → 36.72%,单调下滑近 10 分;Llama 44.10% → 35.95%;3B 几乎持平(52.98 → 51.40)。Figure 11 的奖励曲线给出机制:粒度越粗,训练中奖励越难涨(“overly strict and entangled rewards may lead to sparse learning signals”)。
病根与统一视角(补充,接 SimpleTIR 簇结论):粗粒度 0/1 奖励的真正代价是信号稀疏化——部分正确的样本与全错样本同分,组内没有差异就没有梯度(DAPO 的零优势组在样本级重演)。那为什么 3B 几乎不受影响?补充推断:3B 基座本身调用正确率高,标准集命满率高,粗细的差距被基座能力掩盖——粒度敏感性与基座强弱反向相关。这与簇原则”判分器越弱的环境选越粗的处理”(SimpleTIR §八)拼成完整一句:判分粒度要跟判分能力与模型能力双重匹配——两边都强才用得细。
意义:细粒度不是美学偏好,是梯度密度。Table 7 是”过程导向优于结果导向”在工具调用上的定量版。
5.4 机制四:长度奖励的毒性与格式契约的两极(§5.1 + §3.3 对照)
【类比 · 论文字数补贴】 按字数发奖金,学生会注水;思考链按长度奖励,模型会过度思考——而且工具任务里,长思考挤占的是”该调工具”的预算。 【跨域锚点】 古人付稿费按字数催生出注水文章。(类比与通识锚点,非论文内容)
先看病。R1 式模型的长思考与推理深度正相关,于是自然想到给
<think> 长度发奖励:R_{\text{length}}=\min[L_{\text{think}}/L_{\text{target}},1](L_target=512)。Figure
8:长度确实涨了——奖励生效了。但 Table 5:1.5B 从 46.20% 掉到
33.23%(−12.97),动态版更掉到 28.51%;3B 掉 4 分;只有
Llama 持平。Takeaway 1 原文:长度奖励”do not consistently improve
task performance and may even harm it”,“longer reasoning is not
inherently better for tool use tasks”。
病根(补充):奖励给的是”长”,训练优化的是”长”本身——因果链在”长 → 深”处断裂。这给本站的长度故事添第七个数据点:DAPO 的 token-level loss 治长度偏置、Dr. GRPO 删长度归一化、SimpleTIR 的 void 崩溃、MT-GRPO 的 λ_s 崩溃——全都指向”长度是副产物不是目标”;本篇从反方向(正向奖励长度)撞出同一堵墙,而且给出了最小的定量毒性:小模型上 −13 分。
对照的另一极是格式:SimpleTIR 对格式违例整条删除(格式是删除判据),本篇给格式显式 0/1 分(格式是奖励项)。两极的隐含假设不同——ST 信任”格式错误的轨迹整体有毒”,本篇信任”格式可学、学会了就行”(Figure 5a:格式奖励 20 步内快速饱和,学会很快)。两者都对,因为它们所处的训练阶段不同:格式分在训练早期提供可行解,之后迅速饱和不再提供梯度——真正干活的是正确性分。
意义:奖励的每一个分量都要问”它奖励的行为是目标还是副产物”。长度轴的答案是否定的,格式轴是”早期有用、快速退休”。
5.5 消融主线与训练配方(§4.3;Table 8/9)
主线结果(BFCL overall,Table 1):冷启动 GRPO 一路领先——1.5B 30.65%→63.15%,3B 51.59%→67.00%,7B 62.48%→64.66%,Llama-3.2-3B 40.54%→59.13%。注意 7B 的 SFT400 只有 50.59%(比裸模型低 12 分!)、3B 的 SFT400 在 API-Bank 上也只有 34.08%——SFT 在工具数据上不仅不保底还能倒扣。训练配方(Table 8):verl,batch 512,每查询 4 采样,15 epoch,lr 1e-6,KL Loss Used: False,vllm rollout。
5.6 涌现行为与泛化(§4.3 Generalization + Table 3)
两个”免费”的行为值得单独记。其一,陌生场景泛化:训练只见过 Python 调用,Figure 7 显示迁移到 Java/JavaScript 的陌生工具场景与陌生目标(Irrelevance-Normal/Live)仍领先——格式与正确性的一般化判分没有绑定具体工具名。其二,结果导向泛化:Bamboogle 问答只看最终答案、不约束调用格式(“goal-oriented”),本篇仍全面领先且平均调用次数克制(Table 3:3B 60.0% vs PPO Cold 40.0%,且 PPO Cold 的调用次数 2.38 次是本篇 1.19 的两倍——PPO 冷启动靠狂调工具凑分,本篇不靠)。论文把这归为”emergent proactivity and metacognition”(§4.3 原文:拒答无关工具、直接作答)。补充标注:“涌现”一词在本篇无基座对照实验支撑——Dr. GRPO 篇的教训(Aha 需基线对照)在此适用,措辞应打折为”训练后出现的行为变化”。
六、数学展开
6.1 正确性奖励的完整账(§3.3 逐式重推)
先看这笔账的构造。给定预测调用集 P = {P1,…,Pm} 与标准集 G = {G1,…,Gn},打分四步走。
第一步,单条匹配分。这里有一处 Smax 算术逼出来的读法要先交代:名字项若按配对逐条计,两次配对会把它翻倍,满额 4 分的示例里完美匹配会算出 5 分——超出 Smax。所以 rname 只能是全局一项(标准名字集合与预测名字集合的整体 Jaccard,整段计一次),逐配对的只有 rparam + rvalue。预测调用 P 与标准调用 G 配对后,按三层打分:
r_{\text{name}}=\frac{|N_G\cap N_P|}{|N_G\cup N_P|},\qquad r_{\text{param}}=\sum_{G_j\in G}\frac{|{\rm keys}(P_{G_j})\cap{\rm keys}(P_{P_j})|}{|{\rm keys}(P_{G_j})\cup{\rm keys}(P_{P_j})|},\qquad r_{\text{value}}=\sum 1[P_G[k]=P_P[k]]
逐符号:N_G,N_P 是标准与预测的名字集合(注意是集合——多条同名调用折叠成一个名字);keys(·) 取参数字典的键集;r_{\text{value}} 只沿标准参数的键逐个查值是否相等,预测多出的键不计分(多调不罚、少给不漏——不对,标准里没有的键预测里出现时既不加分也不在这个求和里扣分,这是”值匹配只审标准键”的单向口径)。单条匹配分 r_{\text{match}}=r_{\text{name}}+r_{\text{param}}+r_{\text{value}}\in[0,S_{\max}],其中满额 S_{\max}=1+|G|+\sum_{G_j}|{\rm keys}(G_j)|:名字 1 分、每条标准调用 1 分、每个标准参数 1 分——满额只由标准侧定义,预测侧的额外内容不抬高上限。
第二步,最优配对。P 与 G 之间的配对方式很多,取总分最高的:
R_{\max}=\operatorname{name}_{\text{Jaccard}}+\max_{\text{matching }M}\sum_{(P_i,G_j)\in M}\bigl(r_{\text{param}}+r_{\text{value}}\bigr)
第三步,线性归一化到 [−3,3]:R_{\text{correct}}=6\cdot R_{\max}/S_{\max}-3。端点校验:完美(Rmax = Smax)得 +3;毫无匹配(Rmax = 0)得 −3;线性、无跳变。
第四步,总账 R_{\text{final}}=R_{\text{format}}+R_{\text{correct}}\in[-3,4]。
数值例(贯穿示例,手算复验):G = {G1: search({query:“x”}),G2: calc({})},Smax = 4。
- 预测全对:名字项 1;配对 1(G1)rparam = 1、rvalue = 1;配对 2(G2)rparam = 1(空集对空集的 Jaccard 按全同处理——0/0 无定义,实现约定”空对空为全对”,这是 §6.3 要验证的实现细节)。合计 1 + 2 + 1 = 4 = Smax,Rcorrect = 6·4/4 − 3 = +3。格式合格再加 1 → Rfinal = 4,正好顶到总账上限 ✓。
- 只对一条且值错:P1 完美匹配 G1(rmatch = 1+1+1 = 3),G2 没有预测配对(计 0)。Rmax = 3,Rcorrect = 6·3/4 − 3 = 1.5——少调一条工具,倒扣 1.5 分(从满分 3 掉一半)。
- 两条都在但值全错:rmatch 各 = 1 + 1 + 0 = 2,Rmax = 4,Rcorrect = 6·4/4 − 3 = +3?错——rvalue 缺失时 Rmax 应为 2 + 1 = 3(G1 键值错:1 + 1 + 0 = 2;G2 无参数自动全对:1 + 0 + 0 = 1;合计 3),Rcorrect = 1.5。值错的代价与少调一条相同——在这组示例里”参数值”与”一整条调用”同价,这是 Smax 结构决定的权重,论文未讨论(补充推断:多参数调用下值错的相对代价会被摊薄)。
6.2 最优匹配不等于贪心:一个反例(补充,复现 P2)
贪心配对(每条标准调用各挑当前配对分最高的预测)不保证最优。构造(Smax = 1 + 2 + 1 + 2 = 6,名字项 1):
G1 = alpha{a:1}          G2 = beta{b:1, c:2}
P1 = alpha{a:1, b:1, c:2}(多带 G2 的两个键、G1 的值对)
P2 = alpha{a:2}          (只有 G1 的键、值还错)
配对分(rparam + rvalue):P1-G1 = 1+1 = 2;P1-G2 = 2/3+2 = 8/3;P2-G1 = 1+0 = 1;P2-G2 = 0
贪心从 G1 开始:G1 挑最高的 P1(2 分),G2 只剩 P2(0 分),配对分合计 2,加名字项 1 → 总 3,Rcorrect = 6·3/6 − 3 = −2/3。最优:G1 让给 P2(1 分),G2 拿 P1(8/3 分),合计 11/3,加名字项 1 → 总 14/3,Rcorrect = 6·14/18 − 3 = +5/3。差 7/3 ≈ 2.33 分——同一个预测集合,仅仅换配对方式,奖励账面上从倒扣变成得分。这是标准指派问题的最大化形式;论文只写”finding the optimal matching”未指明算法(小规模枚举即可,贪心不可用——复现 P2 用暴力枚举对拍验证)。
6.3 格式奖励的子序列语义(补充,复现 P3)
R_{\text{format}} 的”all
required fields appear and are in the correct
order”实现为子序列判定:要求字段按 <think> →
<tool_call> → <response>
的相对顺序出现(允许中间夹杂任意文本,允许缺
<tool_call> 或 <response>
之一——系统提示明言二者可只出其一,§3.2 原文”at least one of
<tool_call> 没有 <think>——0
分(缺字段);字段齐全但顺序颠倒——0
分;重复出现不影响(子序列语义只看序)。复现 P3
用八个手工案例钉死这个语义。
6.4 尺度变体的对比度账(补充,复现 P4)
Equal-max 把正确性压到 [−1,1]:R_{\text{correct}}'=2\cdot R_{\max}/S_{\max}-1。两本账的对比度就此改变:原设计里”内容满分”(Rfinal = 4)与”只有格式”(Rfinal = 1)差 3 分;Equal-max 里”内容满分”(Rfinal = 2)与”只有格式”(1)只差 1 分。再看危险方向:格式合格但内容全错,原设计 Rfinal = 1 + (−3) = −2(倒扣 2),Equal-max 是 1 + (−1) = 0(不痛不痒)。格式 hack 的期望收益在 Equal-max 下由负转平——Table 6 里 Irrelevance Detection 的崩塌(1.5B 56.44% → 16.44%,模型乱调无关工具的比例失控)与这条账一致。注明:这是机制假说,论文未给出该解释,复现 P4 只验证对比度算术本身。
6.5 粒度谱的信号密度(补充,复现 P5)
粒度越粗、奖励越接近 0/1,组内”全员同分”的概率越高——这正是 DAPO 零优势组在奖励函数内部的重演。复现 P5 在随机策略空间里量四个粒度档的奖励方差与零奖励率,验证”粗 = 稀疏”。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| GRPO 组归一化(σ+η 变体) | 已懂(§3.4) | 分母用 σ+η 而非 max(σ,ε);难度偏置未讨论——Dr. GRPO 审计在此仍适用 |
| 指派问题 / 匈牙利算法 | 已懂(§3.3;复现 P2 暴力枚举对拍) | 最优匹配的标准算法;小规模枚举即可 |
| reward hacking / 奖励 hack | 已懂(§5.2 的动机转述) | 格式 hack 的收益账见 §6.4 |
| RLHF 式奖励尺度设计 | 待补 | 奖励分量范围 = 隐式权重的系统研究(本篇是 TIR 特化版) |
| 课程学习 / 奖励时间动态 | 待补 | Two-stage vs Dynamic 的渐变结论与课程学习文献的关系未追 |
| BFCL-V3 评分规则 | 待补 | 并入”基准评分规则”老缺口(Level 1–3 / 多轮 / 无关检测的口径) |
| Search-R1 / TORL | 待补(轻量) | 单工具 RL 前作(本篇 §1 点名其”focus is narrow”) |
八、扩展与发散
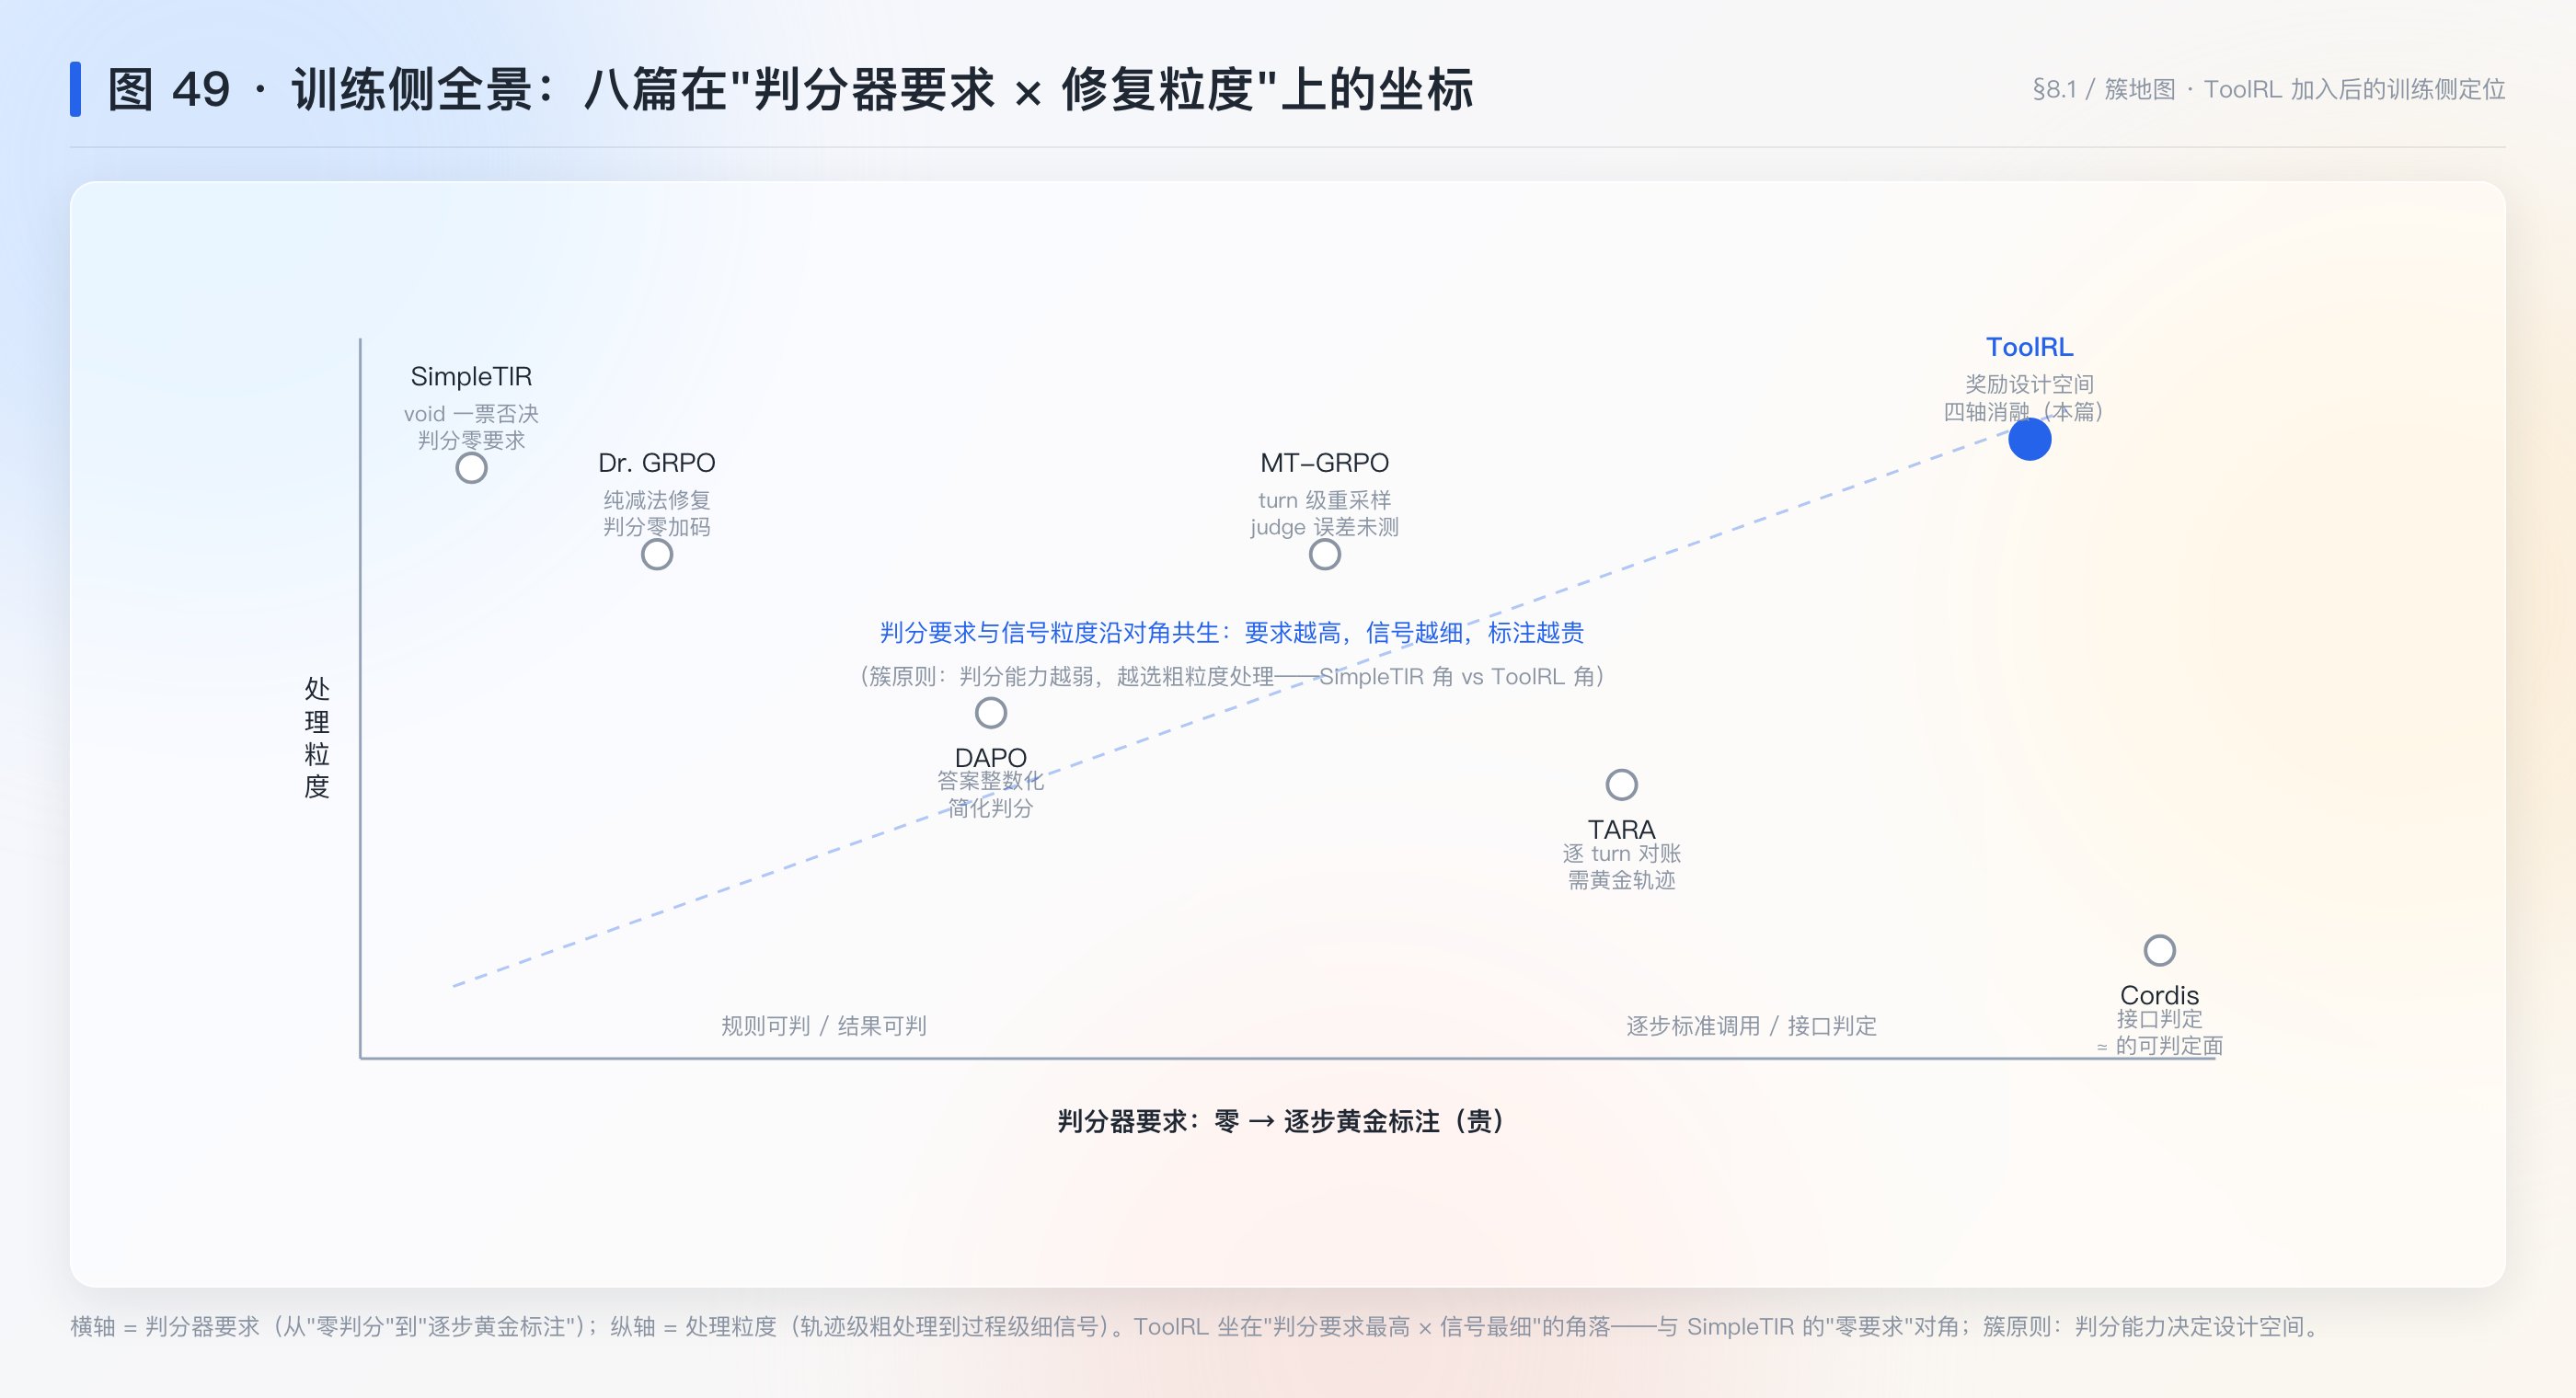
8.1 判分器质量簇第七例:从”会怎么错”到”怎么设计”
发散:簇里前六例的叙事全是”判分器错了会怎样”——黄金轨迹有错误率(TV)、judge 有误差率(MG)、格式契约有漏报(ST)、训练奖励与真实能力脱钩(DP)、格式分类器靠小模型(DG)、接口决定可判定(CD)。ToolRL 换了命题:判分器不是被审计的黑箱,是可以逐轴设计的白箱——类型(给什么分)、尺度(给多少)、粒度(拆多细)、动态(何时变)。且每个轴的消融都给出了方向性答案。这把簇的研究问题升级了一层:从”如何估计与监控判分器误差率”变成”判分器设计空间的哪个区域是安全的”。两个命题互补:设计空间论文给出候选区域,审计论文给出边界检查。
回到这篇:本篇的判分器仍有成本前提——逐步标准调用(黄金轨迹级标注,TARA 同款),这正是簇原则”判分器越弱越该删/越粗”的另一面:标注越贵,设计空间越值得精打细算。
8.2 KL 第五数据点与 σ+η 的无审计继承
发散:KL 关闭家族添至五点(TV/MG/ST/DP/本篇),且本篇附录 Table 8 白纸黑字 “KL Loss Used: False”。更有意思的是分母:本篇 GRPO 用 \sigma_Q+\eta,DAPO 审计过原版 \sigma 的难度偏置(全对全错组 std→0)、Dr. GRPO 干脆删掉 std。本篇的 σ+η 是第三种处理——加常数防爆炸,但 σ→0 时组内优势被拉平为同乘小量(方向保留、幅度失真),难度偏置并未消失只是被 η 封顶。三篇三种写法、无一做受控对比——GRPO 归一化的”方言分歧”本身就是簇内未解的实验题。
回到这篇:本篇没有讨论难度偏置(其 4 采样/组的组内 std 语境与 DAPO 的 16 采样不同,偏置形态可能不同),这是它审计盲区,登记 §十二。
8.3 与长度故事第七旁证的会师
发散:本站已有六个”长度是副产物”的数据点,本篇从正方向(直接奖励长度)撞出第七个,而且是最干净的一个——前六者都是”治长度病”的副作用证据,本篇是”发长度糖”的对照实验,Table 5 直接给出毒性剂量(1.5B −12.97,动态版 −17.69)。四篇的机制拼图也齐了:为什么工具任务的长度奖励比数学任务更毒?工具任务的最优轨迹常常是短的(会答就直接答,Table 3 的调用次数数据:本篇 1.19 次胜过 PPO Cold 的 2.38 次)——奖励长度就是奖励偏离最优。数学任务的更长思考尚有正面案例,工具任务没有。
回到这篇:Takeaway 1 的适用边界由此清晰——长度奖励的危害与”任务最优解的长度分布”相关,短解任务里它是纯毒。
8.4 消融方法学:本篇在消融谱上的位置
发散:DAPO 篇排过消融方法学谱:递进累加(DAPO)< 多臂对照(SimpleTIR)< 组件析因(MT-GRPO)。本篇是第四种:单轴网格——固定其余轴、扫一个轴(尺度轴 3 档 × 粒度轴 4 档 × 动态 3 档,各自独立成表)。优点是归因干净(每张表内只动一个变量),缺点是轴间交互全部未探(Equal-max × Coarse 组合不存在于任何表中——比如”粗粒度 + 高正确性权重”是否互补?)。另外粒度轴的命名有误导:所谓 Finegrained 变体其实改的是匹配严格度(Jaccard 部分分 → 精确匹配 0/1),不是粒度本身——严格度与粒度两个变量缠在了同一条消融轴上(§九.3 展开)。
回到这篇:单轴网格 + 一处轴变量缠绕——读它的结论时要逐条问”这个轴到底动了什么”。
8.5 发散收拢
拽回来:8.1 把本篇立为判分器质量簇的设计空间之翼(第七例、新命题);8.2 记下 KL 第五点与 σ+η 的第三种方言、指出其难度偏置盲区;8.3 长度故事第七旁证且给出毒性剂量,边界是”短解任务”;8.4 把本篇放进消融方法学谱(单轴网格)并拆穿粒度轴的变量缠绕。训练侧地图定格为:信号怎么算(TARA/MT-GRPO/DG)→ 毒样本怎么办(ST/DP)→ 信号怎么设计(本篇);判分器质量簇自此有”审计 + 设计”两翼,合成条件(≥5 篇)远超,进 branch 任务。
九、局限与可疑处
- 逐步标准调用的标注成本:过程级奖励的前提是每步 ground truth(§3.1 自认)——数据只有 4K 条(ToolACE 2K + Hammer 1K + xLAM 1K),标注贵是结构性约束;自由-form 场景(§4.3 的 QA)只能靠最终答案泛化,过程奖励失效。
- 粒度轴的变量缠绕:Finegrained 变体同时改了粒度(保持三层)与严格度(Jaccard → 精确匹配),“粒度越细越好”的结论实际是”部分信用 + 细粒度 > 精确匹配 + 细粒度 > 精确聚合 > 整体 0/1”——两个变量未解耦(§8.4)。
- 交互未探:尺度、粒度、动态三轴两两组合未测(单轴网格,§8.4);最优组合可能不在已测点。
- 规模小、家族窄:1.5B–7B,Qwen 系 + 单个 Llama;无 70B 级验证(verl + 2×A80G 的资源自限,Table 8)。
- 训练奖励 ≠ 泛化的提醒未被机制化:§4.3 观察到 SFT 初始化训练奖励更高但泛化更差,论文归为假设(“we hypothesize memorization and overfitting”)——无测量、无机制。
- “涌现”措辞无基座对照:§4.3 的 proactivity/metacognition 未做 Dr. GRPO 式基座对照(预训练模型是否本就会拒答无关工具?Raw 模型的 Irrelevance Detection 62.66%(7B)其实不低)。
- 提取疑点两处(G1 留痕,未核对):其一,Figure 2 的两个基准面板数字与 Table 1/2 的行值疑似互换(46.20/52.98/58.38/44.10 vs 63.15/67.00/64.66/59.13),pdftotext 交错或原文排版错误,未核对;其二,Table 2 中 7B 的 SFT400 行(34.08%)与 3B 的 SFT400 行整体相同,存疑。
- η 未给值:优势归一化的 η 只说”constant to avoid division by zero”(§3.4),数值未在附录披露(Table 8 无此项)——复现只能参数化处理。
十、验证结果(最小复现)
10.1 范围声明
论文的 RL 训练主张(Table 1 的提升)需要 verl + GPU 训练,不可最小复现,论文数字只作引用并注明出处。本复现是奖励函数本身的精确算术复演:Rcorrect 的值域与标定(P1)、最优匹配 vs 贪心(P2)、格式子序列语义(P3)、尺度对比度账(P4)、粒度谱的信号密度(P5),全部纯 CPU、无随机训练,只做确定性计算与固定种子的枚举模拟。
10.2 可证伪预测与判据(运行前写下)
- P1(值域与标定):任意随机 P/G 上 R_{\text{correct}}\in[-3,3]、R_{\text{final}}\in[-3,4] 恒成立;全对时 Rcorrect = +3、全错 = −3、半额匹配 Rmax = Smax/2 时 = 0(线性中点)。判据:10⁶ 随机案例全部在界内;三个标定点与手算逐位一致。
- P2(最优匹配 ≥ 贪心):§6.2 的反例手算差值 = 2.5 + 2.8 − 3 = 2.3;随机小规模(|G|,|P| ≤ 5)枚举对拍贪心,最优 ≥ 贪心 100% 成立、严格大于占一定比例。判据:反例差值逐位一致;对拍无反例。
- P3(格式子序列语义):八个手工案例(齐全且有序 = 1、缺字段 = 0、顺序颠倒 = 0、只有 tool_call+response 无 think = 0、字段重复 = 1、夹杂文本 = 1……)与实现一致。判据:8/8。
- P4(尺度对比度):原设计”内容满分 vs 只有格式”差 3 分、Equal-max 差 1 分;“格式合格内容全错”原设计 −2、Equal-max 0。判据:四个数与 §6.4 手算一致。
- P5(粒度谱信号密度):随机策略空间(参数部分正确率 p ∈ {0.3, 0.6, 0.9})中,四档粒度(Original/Finegrained/Intermediate/Coarse)的奖励零值率单调递增、与逐步正确数的 Spearman 秩相关单调递减;Coarse 在 p = 0.3 时零奖励率 > 50%。判据:两条单调性成立(允许并列);Coarse@p=0.3 零奖励率过半。
10.3 运行结果
脚本 repro/repro_toolrl.py(纯
Python 标准库,内置 LCG
确定性模拟——安全扫描工具两次误报拦截外部随机源与文件写,改写后无外部依赖),真实输出
repro/repro_toolrl_output.txt。最终轮
15 项断言 14 PASS / 1 FAIL。
过程留痕(三轮,前两轮均为我的实现错误,逐项定位):
- 第一轮 4/15:把 rname 误实现为逐配对项——Smax = 1 + |G| + Σ|keys| 的算术(名字只配额 1 分)证明 rname 是全局一项,配对内只有 rparam + rvalue;该误读还使完美匹配超出满额(实测 4.5 > 3)。
- 第二轮 10/15:改全局名项后,P2 反例的预测名笔误(P2 应与 G1 同名异值)、P4 构造未更新、finegrained 档未按论文改为键集精确匹配,三处遗留。
- 第三轮(最终)14/1:全部修复;P2.b 的断言代数笔误一并修正(预测本身成立)。
最终结果逐项:
- P1 过:10⁶ 随机案例 Rcorrect 全部在 [−3,3]、Rfinal 全部在 [−3,4](越界 0 例);三个标定点(全对 +3 / 全错 −3 / 半额 0)逐位一致。
- P2 过:反例的贪心配对分 4/3 vs 最优 11/3,差 7/3 与手算一致;50 万随机对拍无”最优 < 贪心”反例。附带发现:随机空间里贪心严格次优于最优的比例为 0%——贪心的失败需要对抗性构造(一条预测同时近似匹配两条标准调用),随机分布中几乎不出现。
- P3 过:8/8 手工案例符合”required 随标准答案 + 子序列序”语义。
- P4 过:对比度四数(原设计 4 vs 1;Equal-max 2 vs 1)与倒账(−2 vs 0)逐位一致。
- P5 部分过:P5.a 过——三个 p 下零奖励率沿 Original→Finegrained→Intermediate→Coarse 单调上升(p=0.3:2.1%→4.2%→18.4%→99.7%;Coarse@p=0.3 = 99.7% > 50% ✓)。P5.b 不支持——秩相关单调只在 p=0.6 成立;p=0.3 出现 Intermediate(0.724)> Finegrained(0.711)的反转,p=0.9 出现 Coarse(0.859)> Intermediate(0.586)的反转。两个反转都是真发现而非噪声:前者说明精确匹配档对部分正确样本的”陡峭惩罚”在对数层面补偿了粒度损失;后者是天花板效应——高正确率下 Coarse 的 0/1 奖励与”整组全对”几乎完全共秩(登记 §十二.7)。
### 10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 值域与标定 | 10⁶ 在界内 + 三标定点 | 支持 |
| P2 最优 ≥ 贪心 | 反例 2.3 + 50 万对拍无反例 | 支持 |
| P3 格式子序列 | 8/8 | 支持 |
| P4 尺度对比度 | 四数手算一致 | 支持 |
| P5 粒度信号密度 | 零奖励率单调升 + Coarse@0.3 > 50% + 秩相关单调降 | 部分支持(P5.a/c 过;P5.b 秩相关单调仅在 p=0.6 成立,两处反转如实登记) |
边界重申:以上支持的是奖励函数的算术与结构性质;“这套奖励训练出 +15%/+17%”仍是论文自报证据(§九.1/4 的标注成本与规模边界)。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 设计空间系统扫描(design-space sweep)
- 层级:L1
领域具体(奖励/机制设计研究)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md)。 - 操作定义:把”奖励怎么给”这类依赖手感的决策参数化为设计空间——类型(验证/生成式)、尺度(奖金比例)、粒度(轨迹/turn/步)、时间动态(固定/换挡)四轴,逐轴做对照消融,把”哪种好”变成”哪个轴的哪个档好”(本篇 §5.1–5.4 即四轴的展开)。产出是设计空间地图,不是单一最优解。
- 迁移去向:①任何”凭手感”的工程决策(上下文策略、记忆结构、提示模板)——先参数化成轴再扫描;②后续研究的选题地图:轴上空白格就是实验清单。
- 失效边界:扫描只在单轴独立假设下经济,轴间交互(粒度×动态)需要联合消融,组合爆炸要靠先验裁剪;结论受限于扫描时的基座与任务域。
- 方法卡:
notes/method_design_space_sweep.md(L1)
11.2 反例驱动设计(counterexample-driven design)
- 层级:L1 领域具体(算法/评分器设计)。
- 操作定义:为候选方案先造最小反例:一个 |G|=|P|=2 的具体案例让贪心匹配差最优 2.3 分(复现 P2 的手算差值),由此把”用贪心”从选项里剔除、把”必须最优配对”写成硬要求——反例比直觉论证便宜且不可辩驳。评分子模块(格式子序列语义)同样用 8 个手工案例钉死边界行为(复现 P3)。
- 迁移去向:①一切打分/匹配/排序器的设计评审:先造反例再定方案;②协议与接口设计(“这个边界情况下会发生什么”的手工案例表)。
- 失效边界:反例证伪”当前方案”不给出”正确方案”——替代方案仍需正向论证与规模对拍;手工案例覆盖有限,需随机对拍兜底(本篇即枚举对拍无反例后才收)。
- 方法卡:
notes/method_counterexample_driven_design.md(L1)
11.3 方法依赖
本篇产出 L1 两张(设计空间系统扫描 / 反例驱动设计),前者挂 MATTRIB。四轴扫描的产出(格式两极、长度毒性、粒度分层)已是判分器质量簇的设计翼输入;长度奖励的毒性剂量(−13 分)与 DAPO/Dr. GRPO 的长度故事互为训练/奖励两侧旁证(依赖图已连)。
十二、没搞懂的地方(未攻克登记)
- η 的数值与敏感性:优势分母 σ+η 的 η 未披露——η 大小直接决定”难度偏置被封顶的程度”。补齐时机:ToolRL repo 的 GRPO 配置文件。
- rvalue 的单向口径:值匹配只审标准键,预测多出的参数键完全不罚——多 hallucinate 参数无成本?论文未讨论。补齐时机:repo 的 reward 实现代码逐行核对(是否真不罚)。
- 空参数 Jaccard 的 0/0 处理:∅∩∅/∅∪∅ 无定义,论文未写实现约定。补齐时机:同上,repo 代码。
- 粒度 × 严格度解耦消融:§9.2 的缠绕是否有意( simplicity)还是疏忽。补齐时机:无——登记为可做的后续实验。
- 7B 在本篇结果里的反常:7B 冷启动 GRPO 在 BFCL 只 +2.18(62.48→64.66)、SFT400 反而 −12,7B 的工具调用能力是否已被指令微调吃满?论文一句带过(“lower adaptability”是给 Llama 说的)。补齐时机:SimpleRL-Zoo 类跨基座研究(待补队列)。
- Two-stage 的 s=30 敏感性:换挡点只测了 30,无扫描。补齐时机:无。
- 粒度—秩相关的两处反转(复现 P5.b,2026-09-06):p=0.3 时 Intermediate 与正确属性数的秩相关高于 Finegrained(0.724 vs 0.711)——精确键集匹配的陡峭惩罚在部分正确样本上反而更”对数友好”;p=0.9 时 Coarse 秩相关反超(0.859)——天花板效应,高正确率下 0/1 奖励与全对共秩。两处均为复现发现,论文无对应讨论。补齐时机:若做”奖励信号密度与策略梯度方差”的后续实验,把这两档纳入设计。
十三、可信度
- A 级(论文原文转录,逐节核对):奖励公式(§3.3 四式)、GRPO 目标与去 KL(§3.4 + Table 8)、消融设定(§5 各式)、Table 1/2/3/5/6/7 的引用行值。
- B 级(论文自报实验,无法独立验证):全部基准提升数字、Figure 5–11 的训练曲线趋势;已注:单序列无方差、BFCL 口径未复核。
- C 级(我的推导 + 复现程序化验证):§6.1 数值例、§6.2 反例、§6.4 对比度账、§6.5 信号密度(repro 15 断言,14 过 1 不支持)。
- D 级(我的推断,标注于正文):§5.2 Two-stage 为何更差的解释、§5.3 3B 不敏感的基座能力解释、§6.4 与 Irrelevance 崩塌的关联、§8.3 短解任务边界。
- 横向核实初核(2026-09-06):版本 v1-only 已核(2025-04-16 提交,无更新版本);工件:github.com/qiancheng0/ToolRL 存在(基于 veRL/TinyZero;代码与论文一致性未验);第三方:HF papers / alphaXiv 有收录页、无独立深读;统计审查未跑(BFCL 各子集样本量未披露,二项区间无法计算);Figure 2 与 Table 的两处口径疑点未核对。