外行导读(先读这个,再决定要不要进正文)
一个场景:2025 年初,DeepSeek 的 R1 模型刷屏——不用人工示范答案,直接拿”对/错”反馈训练大模型,模型自己长出了长篇推理能力,训练中还会冒出”等等,让我重新想想”这样的顿悟时刻(论文里叫 Aha moment)。全网都在复现,但有两件事越看越不对劲:一,别人的复现里,模型的回答越来越长,尤其是答错的回答也越来越长——大家把这当成”推理能力在成长”的证据;二,同样的方法,各家复现的分数天差地别。
这篇论文干的事:把 R1-Zero 的”魔法”拆开验货,结论是两半。一半是基座模型的预训练偏置——“顿悟时刻”不是训练逼出来的,几乎所有的基座模型在训练前就会自我反思,连真正拿来训 R1 的那个基座也不例外;Qwen 的数学基座甚至不加任何提示模板时成绩最好,说明它预训练时可能就”见过”题目连着答案的样子。另一半是 GRPO 算法自带的偏置——它的损失函数里有两处除法,一处除以回答长度,导致错误的回答越长罚得越轻(所以错误回答越写越长);一处除以组内标准差,送分题和神仙题反而被放大权重。作者把这两处除法删掉(改后的算法叫 Dr. GRPO),模型不再疯长字数,成绩不掉,一个 1.5B 的小模型做到 AIME24 43.3%,创下当时小模型纪录。
为什么值得关心:这是一篇”证伪型”论文——它不提出新方法,而是检查别人的”涌现”有多少是真实的、多少是测量工具的偏置造出来的。任何看训练曲线讲故事的人(包括看 loss 曲线的我们自己)都该有一双这样的手。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| R1-Zero 式训练 | 不给示范答案,直接拿”对/错”反馈强化学习训练基座模型(Zero = 跳过示范教学) |
| 基座模型 | 只做过”读文章补后面”训练的原始模型,没教过它怎么答题 |
| 模板 | 把用户问题包装成模型期待的对话格式的一段固定文字 |
| Aha moment | R1 训练中观察到的”顿悟”行为:中途停下来说”等等,我重新想想” |
| GRPO | 一道题采样一组回答,按”比同组平均好多少”打分的训练算法 |
| token | 字。模型的读写单位 |
| 优势(Â) | 某个回答比同组平均好多少的得分 |
| 偏置 | 系统性的偏差:估计值总是往一个方向歪 |
| std | 标准差:一组数散得多开 |
§0 承接栏
这篇收尾的是 Zero RL 谱系的两个悬案。其一,“回答越来越长”这个现象横跨三篇:SimpleTIR 的整篇前提就是多轮训练不稳定、响应长度病态;DAPO 的 Token-Level Loss 与 Overlong Shaping 都在治长度;MT-GRPO 虽未直接处理但长度偏置同样适用。为什么响应会越变越长?这篇给出了谱系内第一个机制级答案:GRPO 损失按响应长度归一化,错误回答越长,每个字分到的惩罚越薄——偏置在鼓励”错误的回答写长一点”(§3.1,p.6)。其二,“涌现”的证据强度:SimpleTIR 承认 Aha moment 出现在基座(其 §2.3),MT-GRPO 不涉及;这篇把证据做全——连真正训出 R1 的 DeepSeek-V3-Base 也自带 Aha(§2.3,p.4),且自我反思行为与正确率不正相关(同节)。簇视角:训练侧四篇 + 本篇 = 5 篇,Zero RL 谱系的”症状(长度涨)→ 病根(两处除法)→ 各家修法对照”链条闭合。
一、论文在解决什么问题
1.1 两个没被分开检验的成分
R1-Zero 的发布(引 Guo et al. 2025,论文参考文献)带火了一条训练路线:拿基座模型,不做任何示范教学,直接用”答案对不对”的规则奖励做强化学习。训练过程中两个现象被广泛传播:回答越来越长(被解读为推理越来越复杂),以及 Aha moment(被解读为模型学会了自我反思)。全世界的复现者照方抓药,结果参差(§1,p.2 引 13–19 号文献)。
论文指出,大家默认的因果链——“RL 训练 → 涌现推理能力”——其实混合了两个从未分开检验的成分(§1,p.2):基座模型(预训练里埋了什么)和 RL 算法(优化器在把模型往哪推)。这篇文章的工作就是把这两半拆开各查各的。
1.2 两个证据缺口
- 基座侧:此前有研究(引 Liu et al. 2025b,论文参考文献)怀疑开源复现里没有真正的 Aha moment,因为所用基座本来就带自我反思关键词——但没人检验过 DeepSeek-V3-Base,也就是真正拿去训 R1-Zero 的那个基座(§2.3,p.4)。这篇自己托管了 685B 的 DeepSeek-V3-Base 把这块补上。
- 算法侧:GRPO 的响应长度增长被普遍当作”推理成长”的标志,但没人检查过 GRPO 的目标函数本身是否在奖励长度(§3.1,p.5)。
一句话:R1-Zero 的两个”奇迹”(顿悟涌现、回答变长),一个可能是预训练偏置的显形,一个可能是优化偏置的产物。论文的任务是把这两个”可能”做成”证据”。
二、核心想法
一句话:R1-Zero 式训练的”魔法”有相当部分不在 RL:基座模型的预训练偏置负责”顿悟”的显形,GRPO 目标函数里两处想当然的除法负责”回答变长”;把两处除法删掉(Dr. GRPO),训练立刻省字,成绩不掉。
分三步(直觉 → 转译 → 形式化):
- 直觉:一批学生做一套题,老师按”每份卷子平均每题扣多少”来决定重讲什么。这个平均有个隐藏后果:卷面长的学生每题扣分被摊薄——写越长罚越轻。如果错误答案恰好都写得长,老师就会”选择性失明”地轻罚它们。GRPO 的损失里正好有这么一个除以答卷长度的操作。
- 转译:先查基座——给各家的基座模型出 500 道题,看它们训练前就会什么(会不会答题、能不能探索出正确答案、有没有自我反思);再查算法——把 GRPO 的损失逐项写开,找出所有”除以一个和内容无关的量”的地方,证明它们把无偏的优势估计重加权了。
- 形式化:GRPO 每个 token 的有效优势是 a_{i,t}=\hat{A}_{i,t}/|o_i|(再除以组内 std)——它是无偏优势 \tilde{A}_i=R(q,o_i)-\text{mean}(R) 的重加权版(Figure 4,p.6);修复 = 把分母里的 |o_i| 与 \text{std}(R) 全部删掉。
它把问题重新形式化成了什么:把”复现 R1”从”照方抓药”重构为对照实验——基座与算法各自控制变量。这与 SimpleTIR 篇的”测量工具决定你看什么”一脉相承:SimpleTIR 说判据要结构化,这篇说连”训练在进步”这个判断本身也要先过无偏性检验。
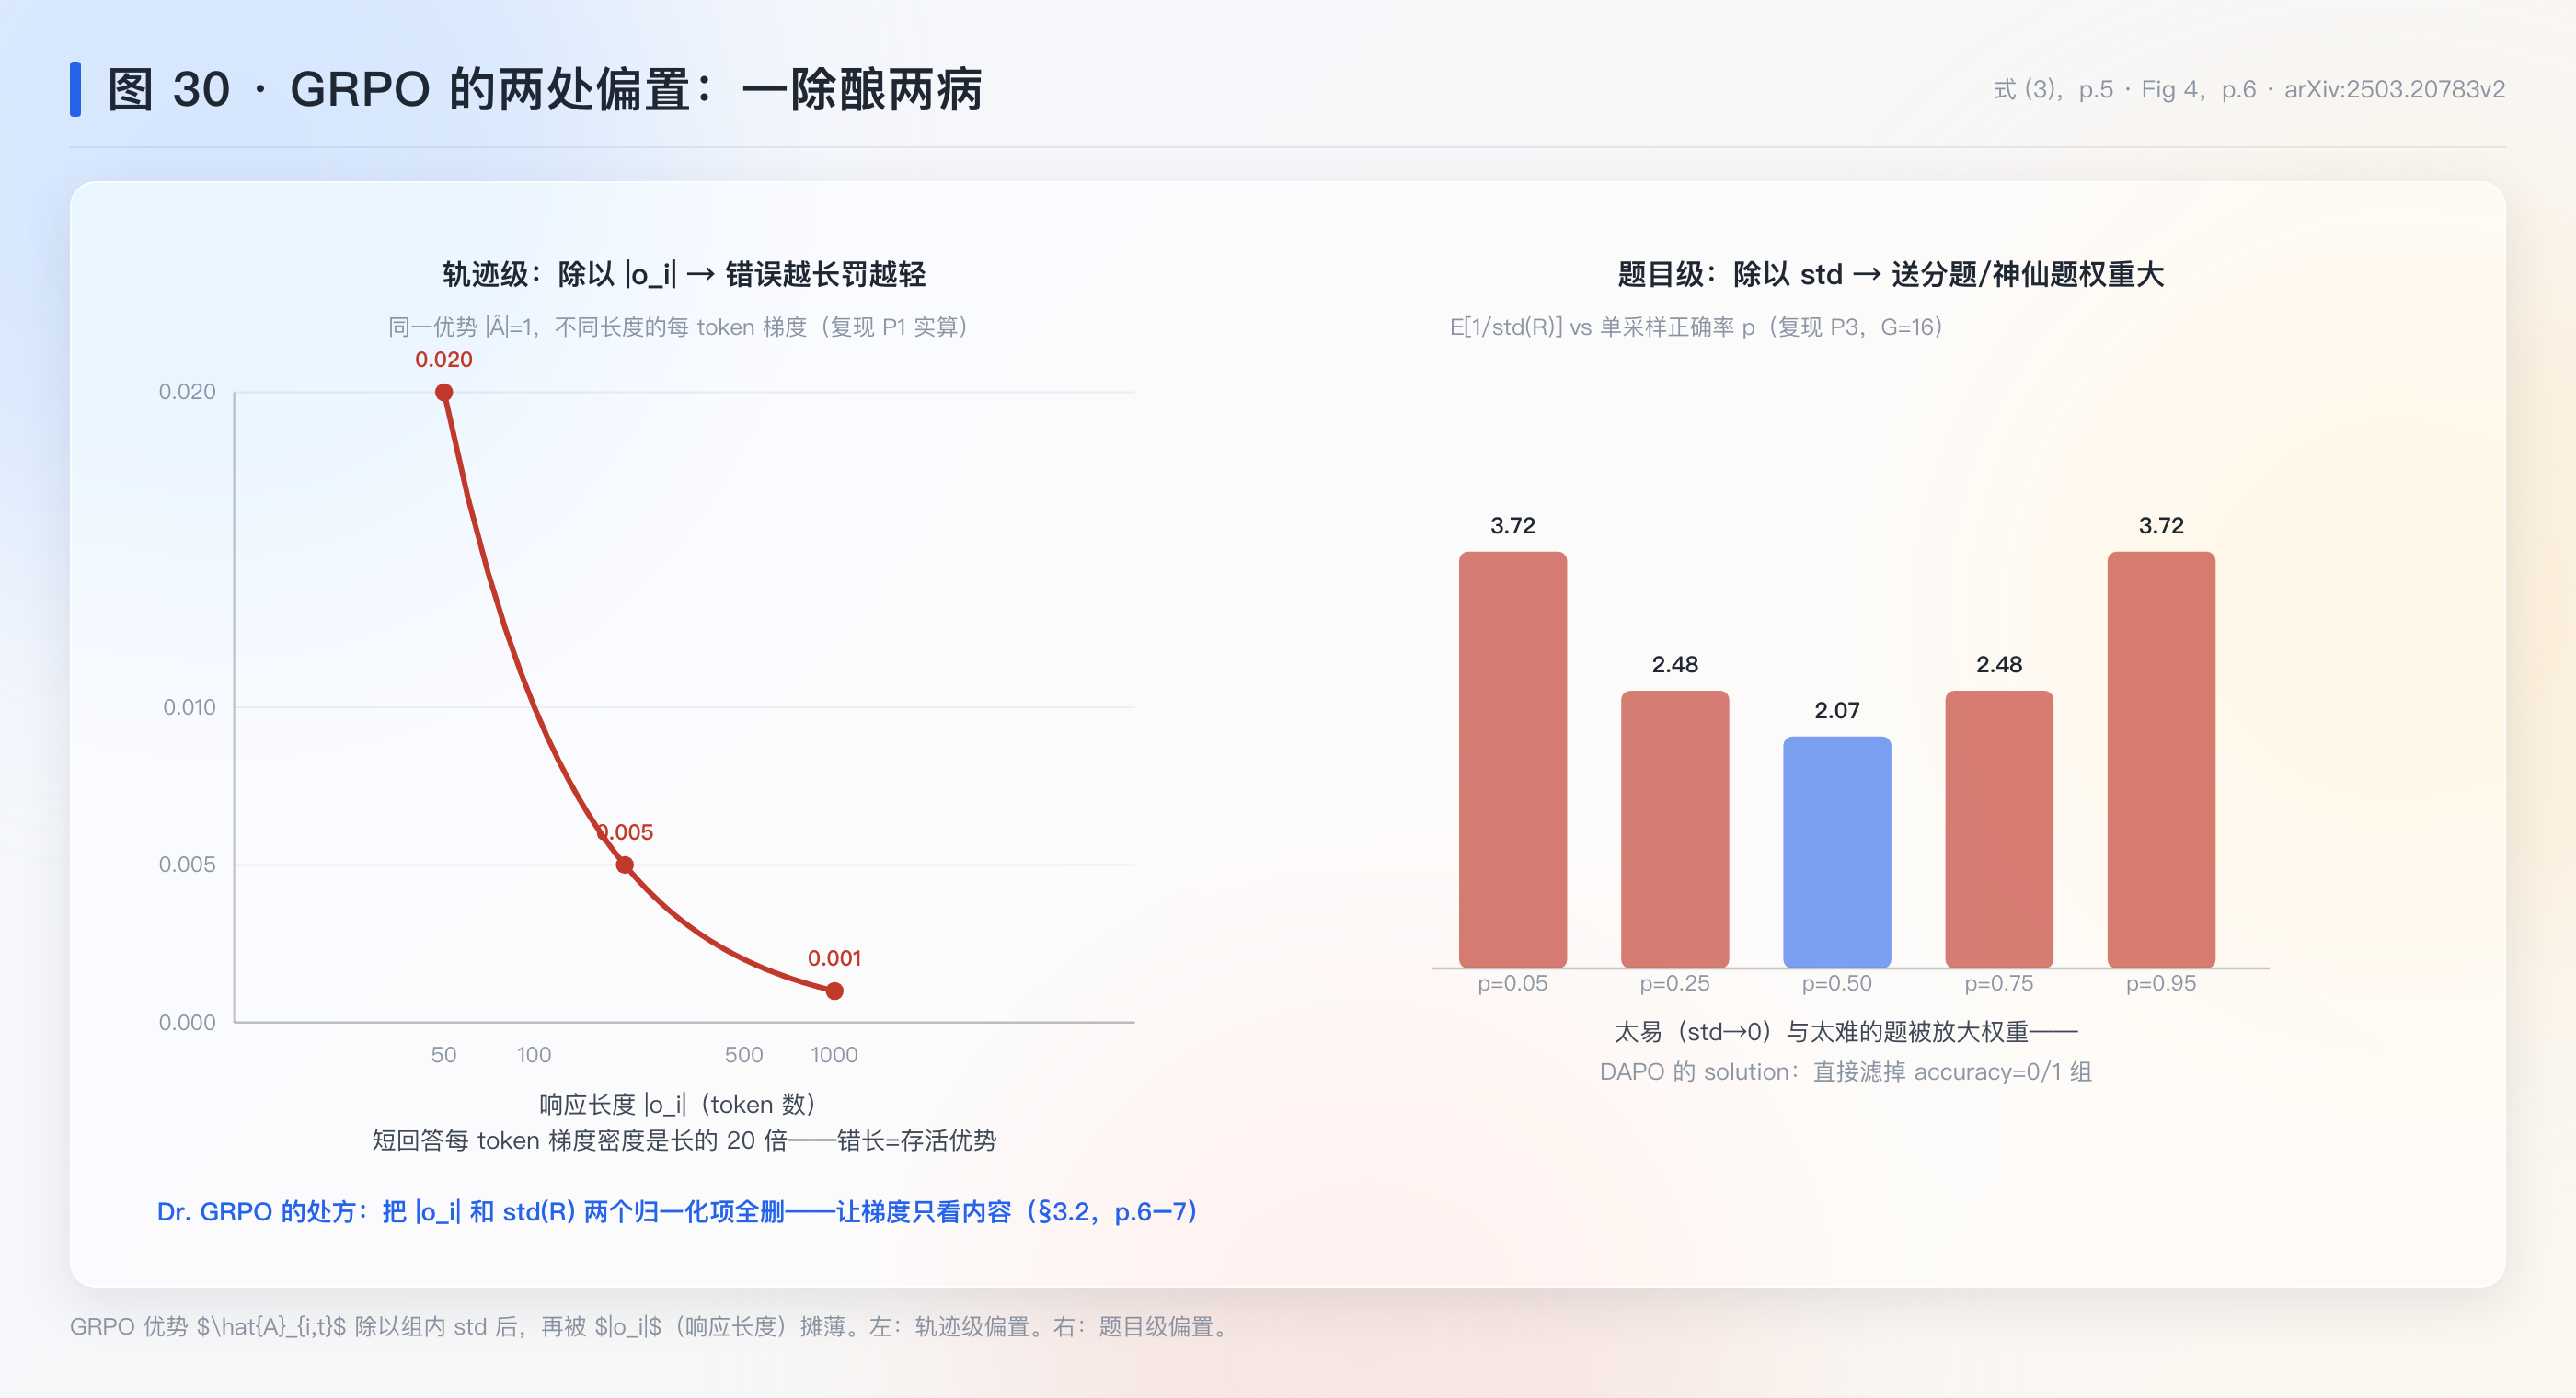
全篇就看这张:图 30(§5.2)——GRPO 两处偏置:长度归一与 std 归一各自如何把优势估歪,方向与量级在图上标死;后面的修复就是逐项拆掉它们。 ## 三、数学基础(零起点,本篇新用到的三件)
3.1 期望与无偏估计:一管血该不该代表全身
直觉:想知道全校学生的平均身高,抽一个班量一量。如果抽样方法公平(每人等概率被抽到),班级平均分会”平均而言”等于全校平均——这叫无偏。如果抽样仪专门多抽篮球队员,量出来的平均总是偏高——有偏:不是抽得不准,是它系统性地往一边歪。
定义:估计量 \hat{\theta} 对目标量 \theta 无偏,指 \mathbb{E}[\hat{\theta}]=\theta。有偏 = \mathbb{E}[\hat{\theta}]\neq\theta,且偏差方向固定。本篇的核心词就是这个:GRPO 的损失被证明是”对长回答有偏”的——它系统性地轻罚长回答。
3.2 条件概率与”归一化”:除法在改变权重
直觉:除法在重新分配权重。一组分数同除以一个大数,彼此差距被压缩;同除以一个小数,差距被放大。GRPO 损失里每处除法,都在悄悄决定”哪些回答、哪些题目在梯度里说话更大声”。
定义:把向量 v 除以常数 c,等于把每个分量乘 1/c——相对比例不变的是”除以同一个常数”,一旦除数随样本变化(如除以各自的长度 |o_i|、各自的组内 std),不同样本的相对权重就被改写了。GRPO 的两处偏置都来自”除数随样本变”:除以 |o_i|(随回答变),除以 \text{std}(R)(随题目变)。
3.3 二项分布的组内标准差:难度偏置的形状
直觉:一道题采 16 份回答,奖励是 0/1。这道题”散得多开”由组内标准差 \text{std}(R) 决定:全对的组 std=0(没有区分度),一半对一半错的组 std 最大(区分度拉满)。
定义:G 个 0/1 奖励、单采样正确率 p 时,奖励和服从二项分布,标准差 =\sqrt{G\,p(1-p)}——p=0.5 时最大,p\to 0/1 时趋于 0。DAPO 篇的 eff(p) 是它的姊妹公式(那边算”有效批量”,这边算”区分度”)。
为什么它重要:Dr. GRPO 批评 GRPO 除以 \text{std}(R) 会造成难度偏置——\text{std} 小(太易/太难)的题被放大权重。这条性质在 §6.4 用模拟验证它的形状。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| o=(q,l_0,f_0,\dots) / o_i | 完整轨迹;第 i 条采样回答 | §3 p.5 |
| G | 每题采样组大小 | §3.1 p.5 |
| R(q,o_i) | 终局奖励(规则判分:对 1 / 错 0) | §3.2 p.7 |
| \hat{A}_{i,t}=\frac{R_i-\text{mean}(R)}{\text{std}(R)} | GRPO 优势:组内去均值除以 std | §3.1 p.5 |
| \tilde{A}_i=R(q,o_i)-\text{mean}(R) | 无偏优势(只去均值,不除 std) | Fig 4,p.6 |
| a_{i,t}=\hat{A}_{i,t}/\|o_i\| | GRPO 的有效优势(重加权版) | Fig 4,p.6 |
| \rho_{i,t} | 重要性比 \pi_\theta/\pi_{\text{old}} | 式 (2) p.5 |
| \varepsilon | clip 宽度 | 式 (2) p.5 |
| \beta | KL 系数(本篇全程 β=0) | 式 (1) p.5 |
| L_{\max}/MAX_TOKENS | 生成预算常数(修复实现用它做分母) | Listing 1,p.6 |
五、机制
承上启下:§一 的两个证据缺口(基座里埋了什么、优化器在往哪推)在 §二 收拢为一句话——顿悟是预训练偏置的显形,长度增长是优化偏置的产物。上节备好的工具正好分两班:无偏估计与归一化权重(§3.1–3.2)查算法侧的账,模板与基座检验(§二)查基座侧的账。本节先走基座侧三个发现,再走算法侧的推导与修复。
5.0 贯穿示例的数据结构
示例组:一道题 q,G=16 份回答。每份回答 o_i 的数据结构:
o_i = {
  length: |o_i|(token 数),
  reward: 0 或 1(规则判分),
  tokens: [o_i1, o_i2, ...]      # 每个 token 的采样概率与重要性比
}
组级: mean(R), std(R)             # 16 个奖励的均值与标准差
GRPO 给第 i 条回答的全部 token 统一分配优势 \hat{A}_{i,t}=\frac{R_i-\text{mean}}{\text{std}}(§3.1,p.5);Dr. GRPO 要改的就是这个”统一分配”里的两处除法。下面的机制按论文顺序:基座侧三个发现 → 算法侧两个偏置 → 修复。
5.1 机制一:基座检验——模板、探索与”顿悟早已在场”(§2.1–2.3,p.3–4)
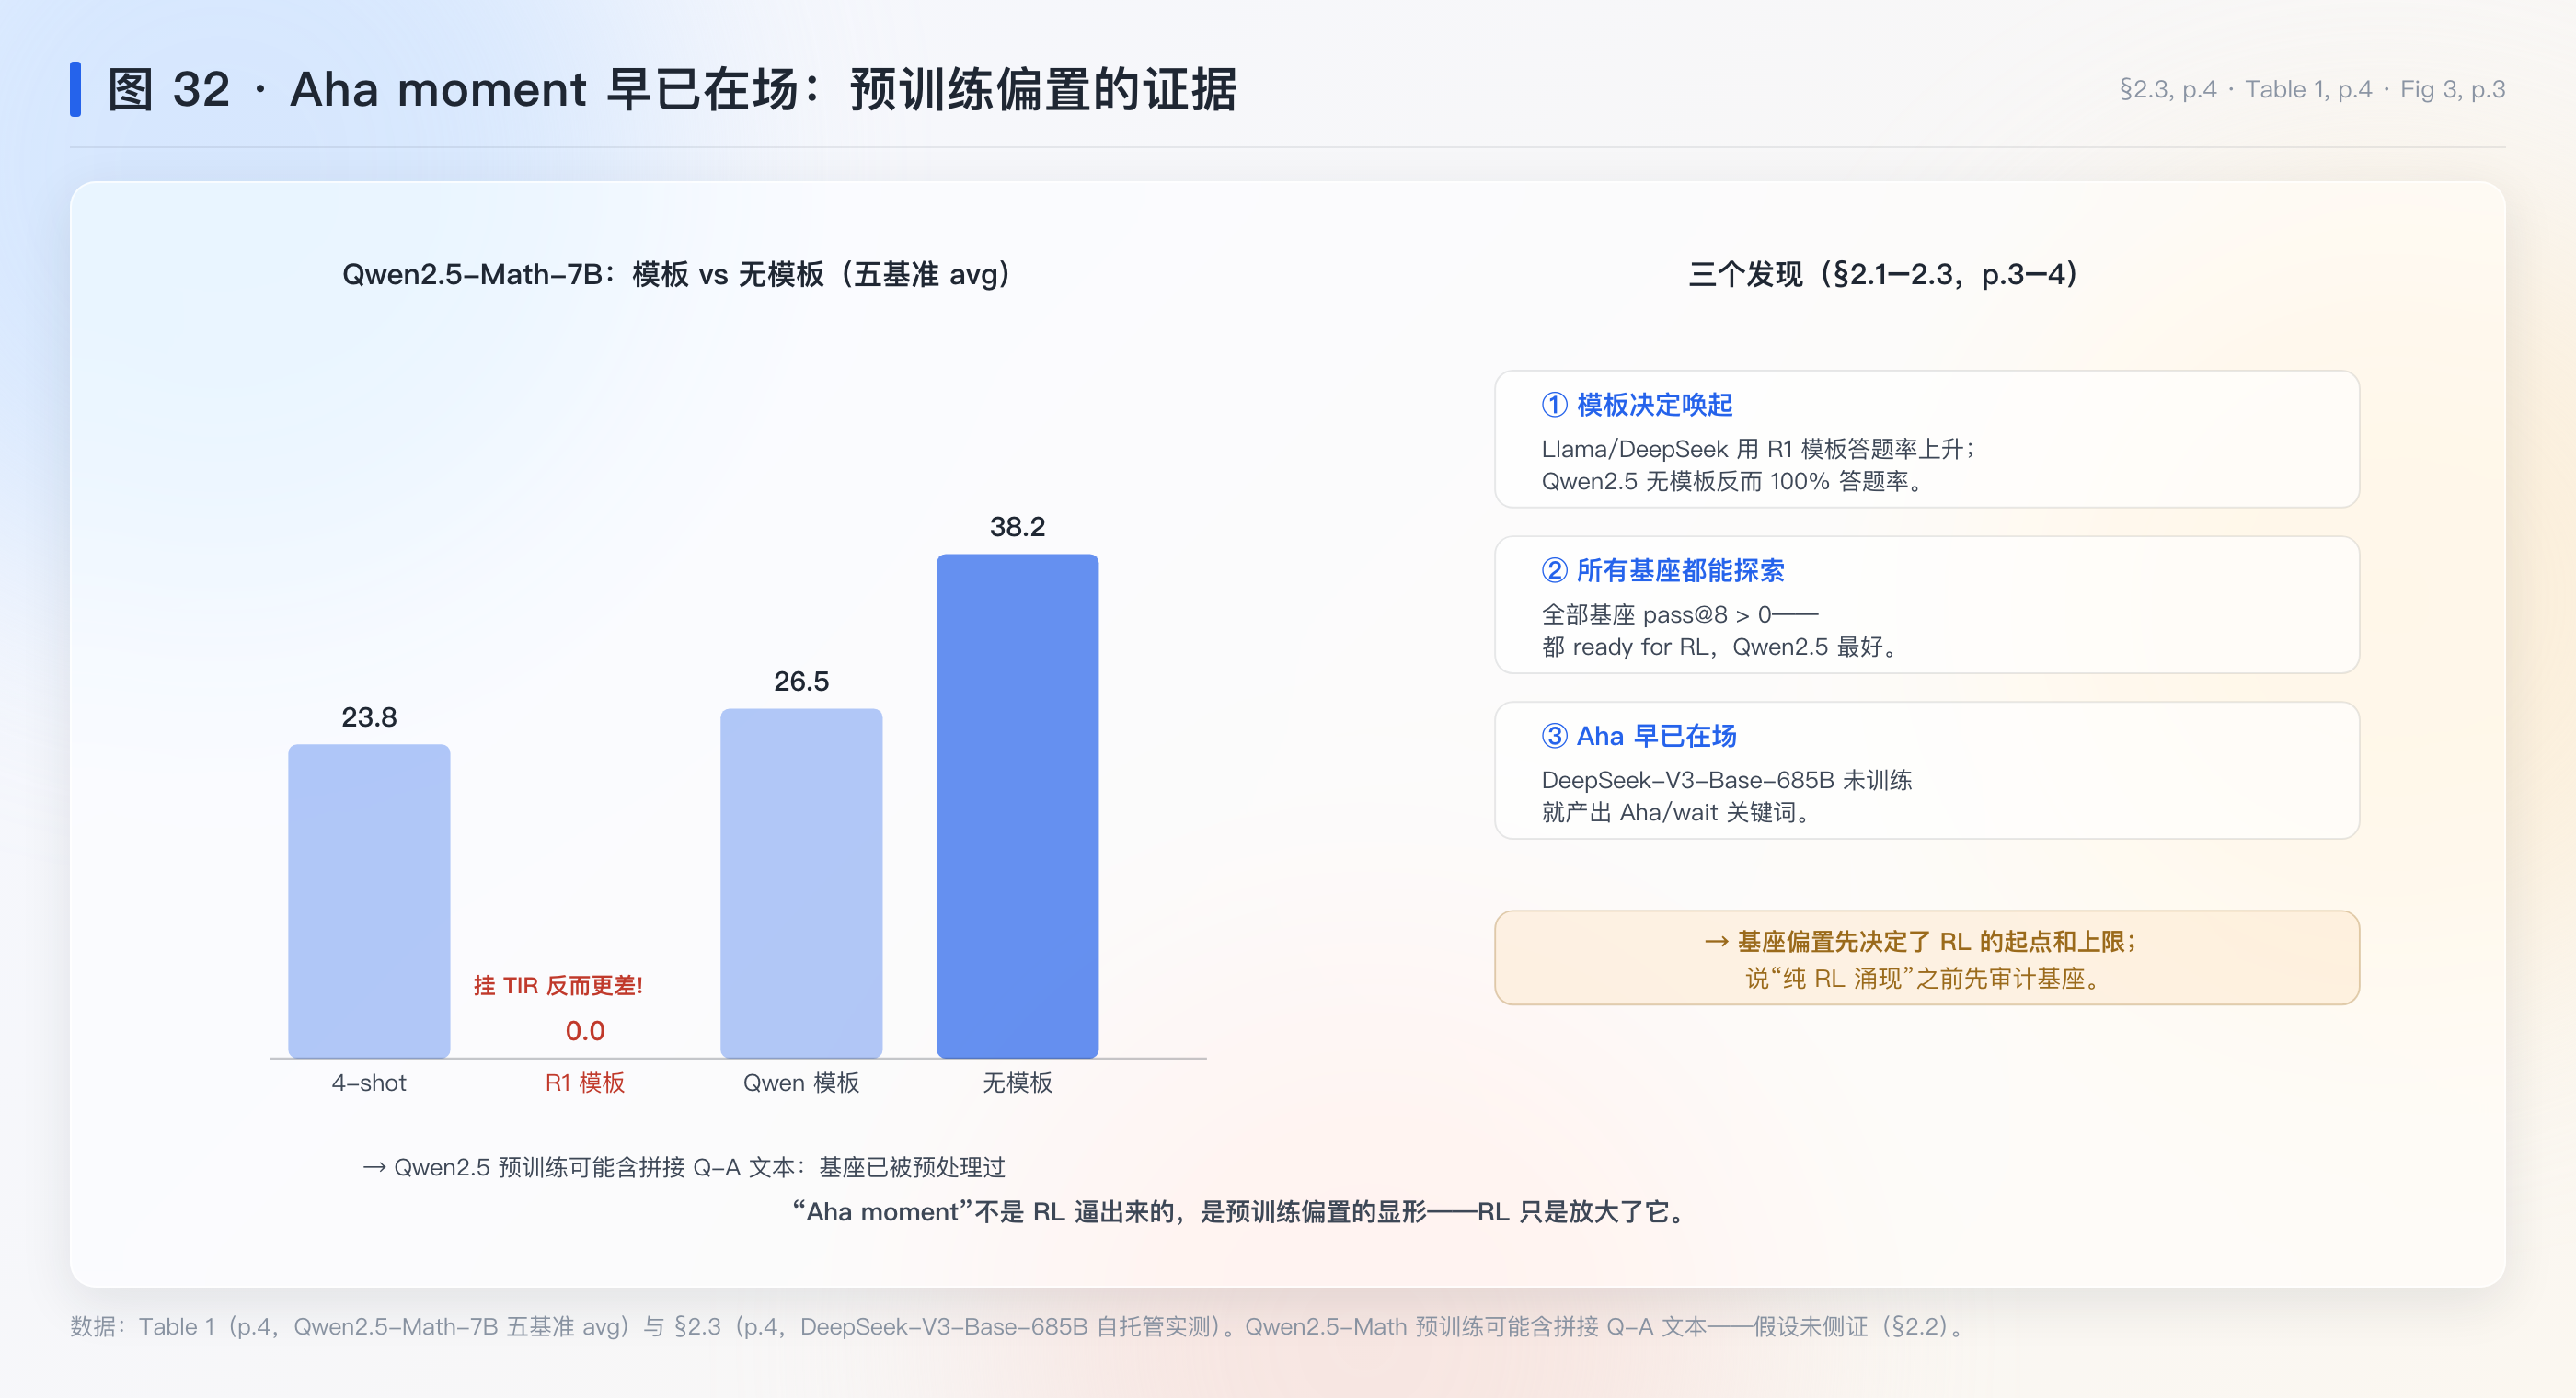
原文表述:给六个基座模型(Qwen2.5-Math-1.5B/7B、Qwen2.5-7B、Llama-3.1-8B、DeepSeek-Math-7B、DeepSeek-V3-Base-685B)出 500 道 MATH 题,用三种模板(R1 模板、Qwen-Math 模板、无模板)各测一轮,由 GPT-4o-mini 判回答是”答题”还是”接龙补写”(§2.1,p.3)。
三个发现(p.3–4):一,模板决定基座能不能被”唤起”成答题者——Llama 与 DeepSeek 系用了 R1 模板后答题率上升,而 Qwen2.5 系不加模板答题率反而是 100%;二,所有基座的 pass@8 都大于零(都能探索出正确答案),即都”ready for RL”,Qwen2.5 最好——这解释了为什么复现项目都选它;三,自我反思行为在几乎所有基座里训练前就存在,包括 DeepSeek-V3-Base(自己托管了 685B 实测,Fig 13 里有”Aha”“wait”关键词实例)。
最刺眼的一行在 Table 1(p.4):Qwen2.5-Math-7B 用 R1 模板评测,五个基准全零(avg 0.0);去掉模板反而 avg 38.2。论文的假设(p.4):Qwen2.5-Math 预训练时可能直接在”题目连答案”的拼接文本上训练过——不加模板恰好顺应了它的预训练分布。推论(原文):用 Qwen 复现 R1-Zero 要格外小心,因为它不加模板时”已经像做过 SFT”。
意义:Aha moment 不是 RL 训出来的,是基座带来的;且论文还补了一刀——在真正的 R1-Zero 上统计,自我反思出现得更频繁,但与正确率不正相关(§2.3,p.4)。“反思多”和”答得对”是两回事。
5.2 机制二:GRPO 的两处偏置(§3.1,p.5–6;Fig 4)
原文表述:GRPO 的目标(式 (3),p.5)在 PPO 目标(式 (2),p.5)之上做了两处”归一化”:优势 \hat{A}_{i,t} 除以组内 \text{std}(R),损失再除以响应长度 |o_i|。论文指出(p.6)这两处各引入一种偏置:
- 轨迹级长度偏置(除以 |o_i|):\hat{A}_{i,t}>0(答对)时,短回答每 token 的梯度更新更大——策略学会”答对要简短”;\hat{A}_{i,t}<0(答错)时,长回答每 token 的惩罚被摊薄——策略学会”答错宁可写长”。两方向合成:错误回答越来越长(Fig 5 plot 4 的实证,p.7)。
- 题目级难度偏置(除以 \text{std}(R)):太易(全对)与太难(全错)的题 std 趋近 0——若除以真实 std,这些题的权重会爆炸。注意 RL 里优势归一化本身是常见技巧,但通常跨整个 batch 算;GRPO 按题目各自算,等于给不同题目发了不同的权重(p.6)。
补充(偏置的代数形状,论文 Fig 4 图示,p.6):把 GRPO 每 token 的有效优势写开:a_{i,t}=\frac{\hat{A}_{i,t}}{|o_i|}=\frac{1}{\text{std}(R)\cdot|o_i|}\big(R_i-\text{mean}(R)\big)=w_i\cdot\tilde{A}_i,其中 \tilde{A}_i=R_i-\text{mean}(R) 是无偏优势(只减组均值、不做任何缩放),w_i=\frac{1}{\text{std}(R)\cdot|o_i|} 是一个只看奖励分布与长度的权重。也就是说:GRPO 并没有估计一个”错的”优势,它估计的是一个被 w_i 重新加过权的正确优势——权重与内容无关、与长度和题目难度有关,这就是”偏置”的准确形状。
补充(更刺眼的推论,我的推断):更糟的是 \text{std}(R)\to 0 的组(全对或全错),w_i\to\infty——恰好是最没有学习价值的组获得最大的梯度权重。GRPO 实现用 \epsilon 或特判压住这个爆炸(压成零优势),但”接近全对/全错”的组仍然拿到放大权重。这把 DAPO 篇”零优势组”的批判从”浪费批量”推进到”放大噪声”。
5.3 机制三:Dr. GRPO 的修复与它的历史考古(§3.2,p.6–7;Listing 1,p.6)
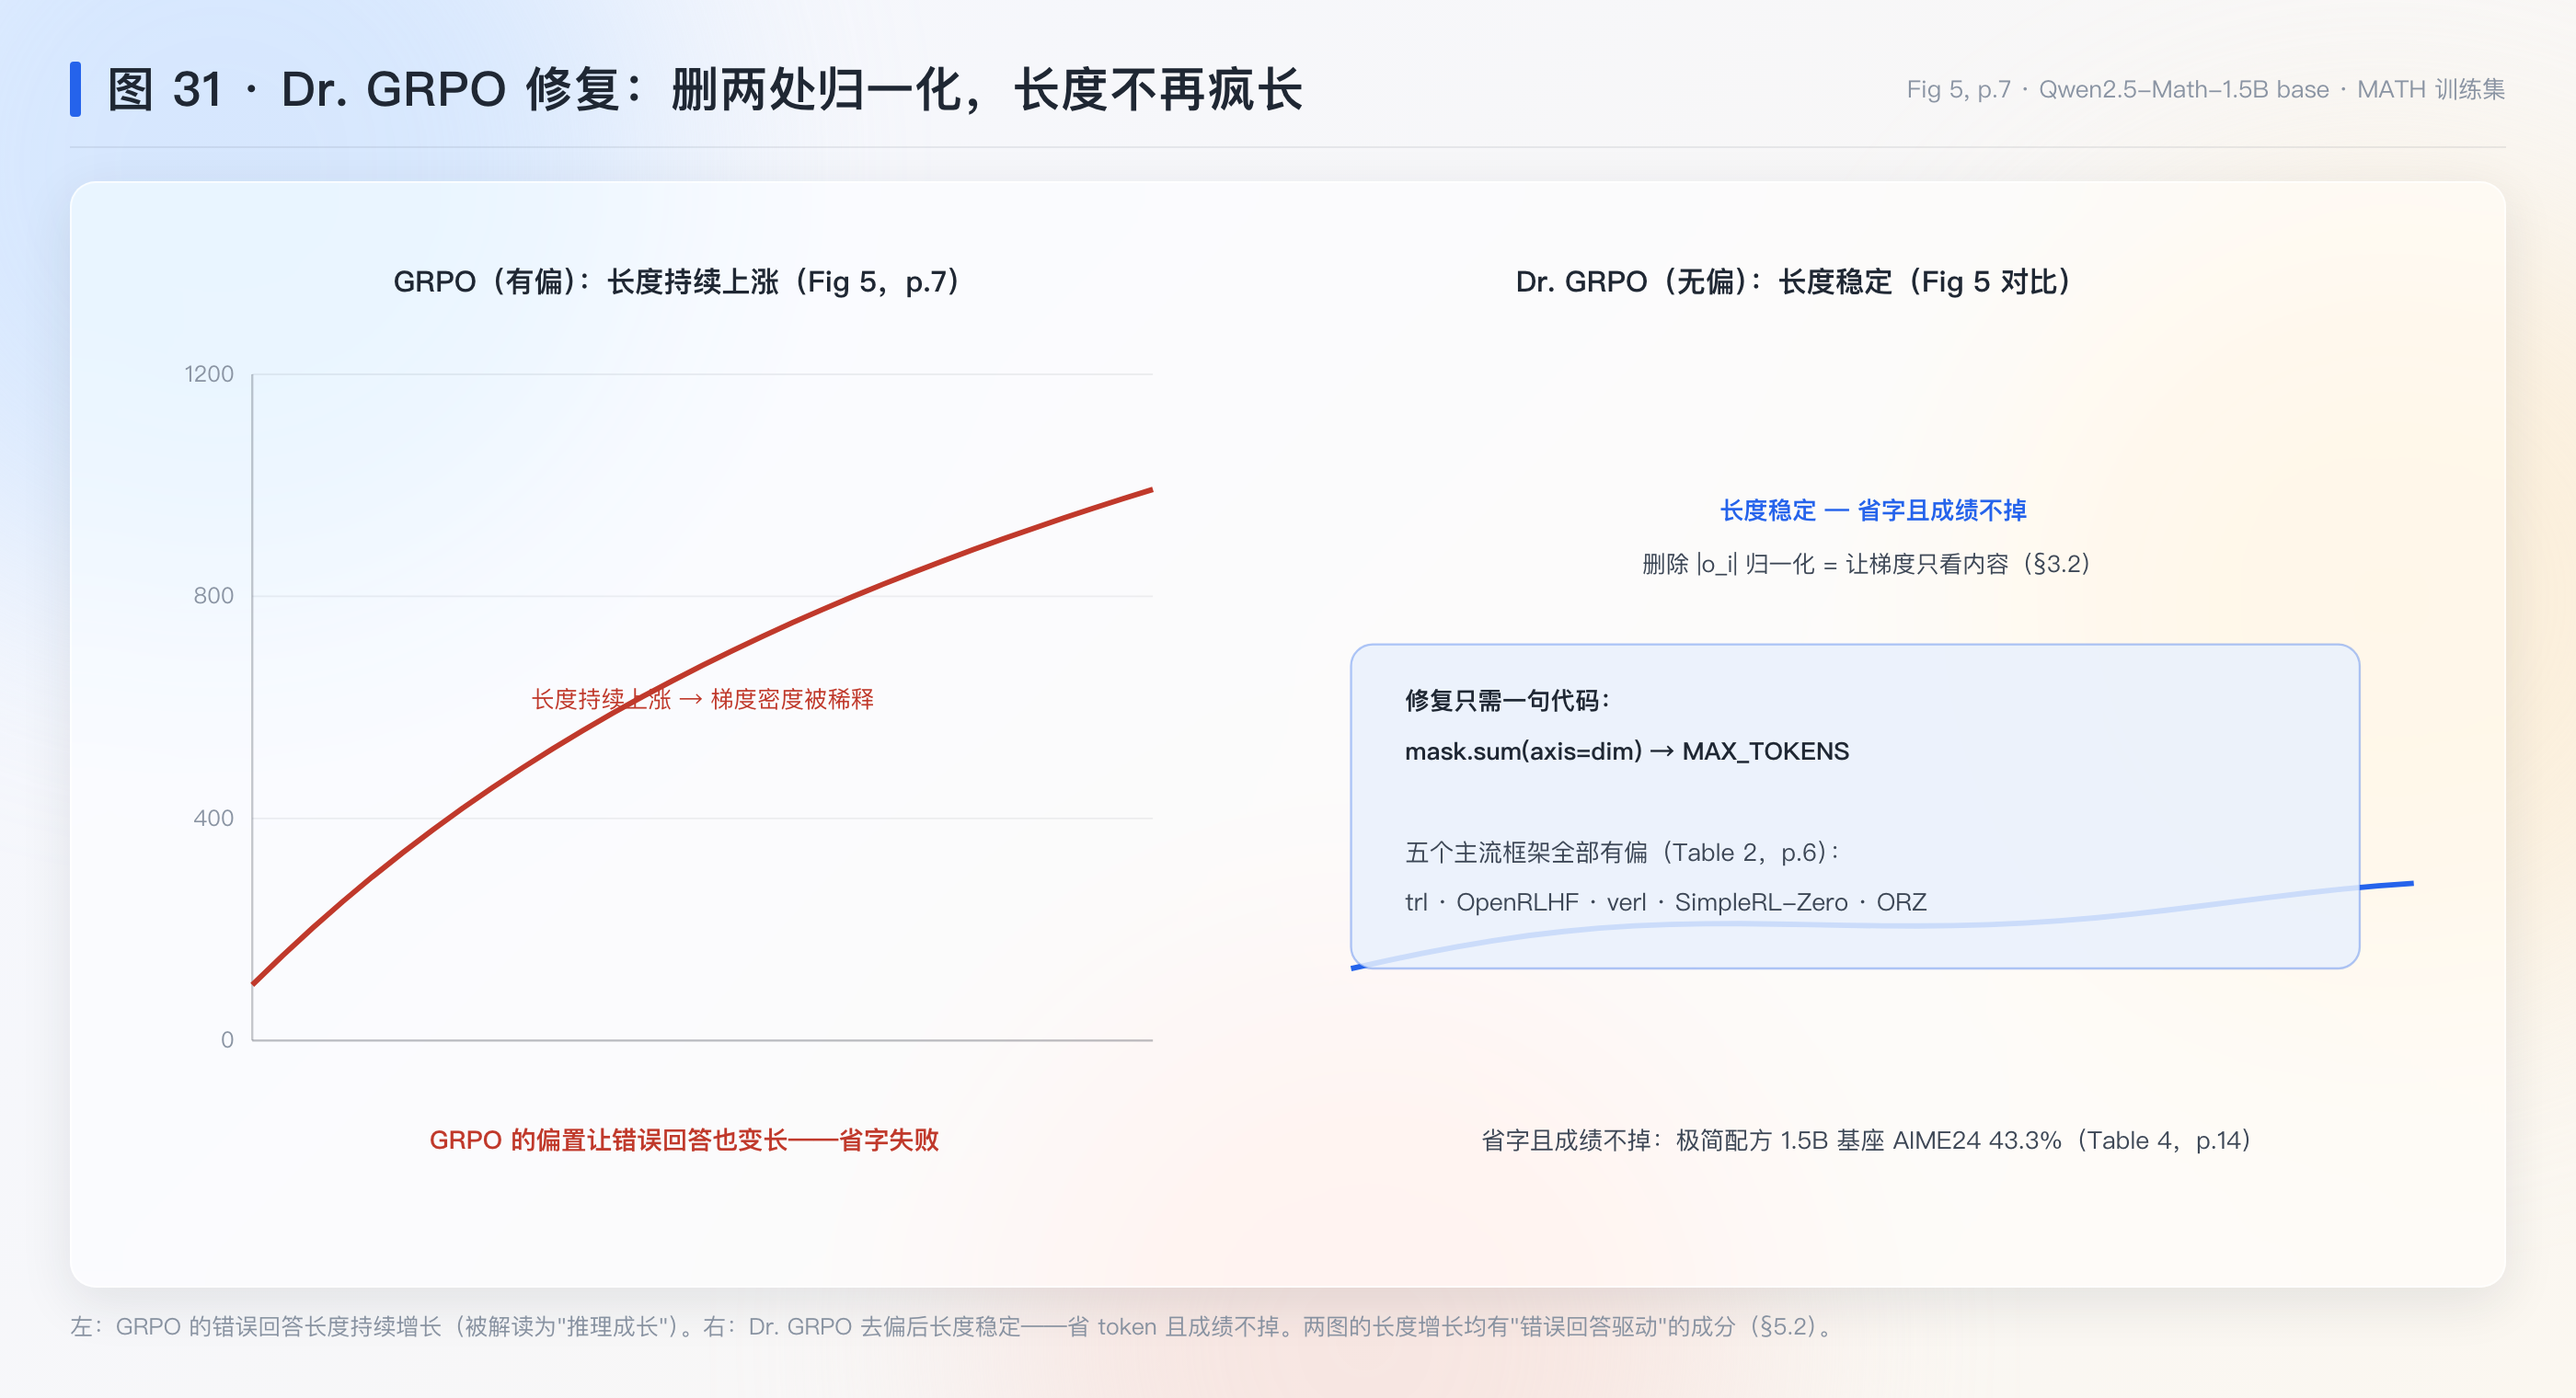
原文表述:修复简单到只有一句话——把损失里的两个归一化项删掉(p.6–7)。实现层面(Listing
1,p.6):把 masked_mean 的分母
mask.sum(axis=dim)(随响应长度变)换成常数
MAX_TOKENS(生成预算),即可恢复与 PPO 目标(式
(2))一致的无偏形式——优势用蒙特卡洛回报减无偏基线。
考古部分是本节最意外的发现(p.6):作者检查了五个主流开源 PPO/RL 实现——trl、OpenRLHF、verl、SimpleRL-Zero、Open-Reasoner-Zero——全部在损失里做了响应长度归一化(Table 2,p.6),与 PPO 原始目标(式 (2),不含长度归一化)不一致。这个”实现与公式的错位”在 GRPO 发布之前就存在;作者猜测源头是预训练阶段把所有 token 打包进定长上下文、损失除以固定上下文长度的惯例(引 Megatron-LM,p.6)——预训练里这个除法无害(长度是常数),搬到 RL 里(长度随响应变)就成了偏置。
意义:这不是某个人的 bug,是一代框架从预训练惯例继承来的”集体无意识”。它解释了为什么”响应变长”在所有复现里同步出现——大家用的是同一族带偏置的实现。
5.4 机制四:实证——三个尺子量”省字又保分”(Fig 5,p.7;Fig 8–9,p.14;Table 4,p.14)
实验设置(§3.2,p.7):Oat 框架、Qwen2.5-1.5B 基座、R1 模板、MATH 训练集、Math-Verify 规则判分(对 1 / 错 0)。三把尺子:
- 长度尺(Fig 5,p.7):GRPO 的回答长度在奖励增长放缓后仍持续上涨;Dr. GRPO 把长度摁住不再疯长。分正确/错误看(Fig 5 plot 4):错误回答的长度被大幅压低——直接证实”长度增长主要是错误回答在变长”。论文顺带指出,这也缓解了 overthinking(过度思考)问题(引 Chen et al. 2024,论文参考文献)。
- 消融尺(Fig 8,p.14):Dr. GRPO、去长度归一化、去 std 归一化、原版 GRPO 四条曲线对照——去掉任何一个偏置项都比原版好,长度项的影响最显著。
- 显著性尺(Fig 9,p.14):三次独立运行,均值 ± 标准差阴影——Dr. GRPO 在省字与准确率上”统计显著”优于 GRPO。这是本站读过的 RL 论文里第一个给多重运行方差与显著性声明的。
成绩(Table 4,p.14):极简配方(Qwen2.5-Math-7B + Dr. GRPO + MATH 3-5 级 + Qwen 模板,8×A100 上 27 小时,§1 p.2)在 AIME24 拿 43.3%(基座同设定最高 0.2、无模板 45.8 中位;对比 R1-Distill-Qwen-7B@3k 10.0);三尺度全表见原表。
5.5 机制五:基座侧的两个后续发现(§3.3–3.4,p.8)
一,模板与题集的二重奏(§3.3,p.8,Fig 6):模板决定初始策略的形态,RL 能把不同初始形态都拉到 ~40% 的相近水平(题集合适时);R1 模板下题集覆盖面很重要,而 Qwen-Math 模板下用最简单的 GSM-8K(小学数学)训练,反倒把难题成绩翻了近倍。论文的解读:模板错配时,提升主要靠 RL 硬灌,题集覆盖必须好;模板匹配时,一小套完全出错的题目也能靠”强化既有有用行为”唤起推理——训练在”强化既有行为”而非”注入新知识”。二,领域预训练抬天花板(§3.4,p.8):数学弱的 Llama-3.2-3B 直接 RL 几乎无效,先用数学语料预训练再 RL 就能成功——RL 的上限由基座决定。
六、数学展开
6.1 长度偏置的完整推导(补充,论文给结论与 Fig 4 图示)
直觉:一个班按”每题平均扣分”决定重讲什么。卷面短的同学每题扣分显得多,卷面长的同学摊薄了——老师于是得出”错题都出在短卷上”的结论。这个结论是被除法造出来的。
推导四步。第一步,PPO 目标(式 (2),p.5)对完整轨迹求和:\sum_t \min(\rho\hat{A},\text{clip}(\rho)\hat{A})——每个 token 的损失权重相同,没有除以长度。第二步,GRPO(式 (3),p.5)改成了 \frac{1}{G}\sum_i\frac{1}{|o_i|}\sum_t——多除了一个 |o_i|。第三步,把每 token 的优势写成 a_{i,t}=\hat{A}_{i,t}/|o_i|,注意 \hat{A}_{i,t} 对同一回答的所有 token 是同一个数,所以一条回答的梯度总贡献 \propto\sum_t a_{i,t}=|o_i|\cdot\frac{\hat{A}_i}{|o_i|}=\hat{A}_i——单看一条回答,总贡献与长度无关;问题出在跨回答比较:两条回答的优势绝对值相同、长度不同时,长回答每 token 只分到 1/|o_i| 的力度。第四步,正负优势的不对称(§六.2):\hat{A}>0 时短回答的”鼓励密度”高——策略学会把正确回答写短;\hat{A}<0 时长回答的”惩罚密度”低——策略学会”错了就写长一点,反正罚得轻”。两个方向合成,就是 Fig 5 里错误回答长度持续上涨的机制(p.7)。
6.2 难度偏置的形状:\text{std} 与”送分题权重爆炸”
直觉:除以组内 std,等于按”这道题的区分度”反向加权——区分度越低的题(几乎人人同分),权重反而越大。
推导:奖励和 \sum r_i\sim\text{Binomial}(G,p),\text{std}=\sqrt{G\,p(1-p)}——p=0.5 时最大(\sqrt{G}/2),p\to 0/1 时趋 0。归一化后 w=1/\max(\text{std},\epsilon):p=0.5 时 w\approx 2/\sqrt{G};p=0.99、G=16 时 std 很小(多数组全 1,std=0 触发零优势特判;非全同的组 std 也很小)——权重被放大。数值验证交给复现 P4。
6.3 Dr. GRPO 的无偏性(补充推导)
修复后的每 token 损失系数是常数 \frac{1}{\sum_i\text{MAX\_TOKENS}}(或等价的固定预算常数),不含任何随样本变化的除数。此时对优势 \hat{A}_{i,t}=\tilde{A}_i(不除 std),记每 token 的期望梯度贡献为 \mathrm{GC}:
\mathbb{E}\big[\mathrm{GC}\big]\propto\mathbb{E}[\tilde{A}_i]=\mathbb{E}[R_i]-\mathbb{E}[\text{mean}(R)]
组均值是同一分布的期望,交叉项在期望下相消——策略梯度回到对真实优势函数的无偏估计(论文 §3.2 p.6–7 与附录 A 的表述;附录 A 有详细推导,本篇按其结论引用,未逐行核验——标注待查)。
6.4 数值例(贯穿示例组)
一组 G=16、长度 \{100, 200, 300, 400\} 各四条、奖励对 0.9(答对率 90%)的题:全对概率 0.9^{16}\approx 18.5\%,全错概率趋 0——非零优势的组里,短正确回答与长错误回答的权重差可达数倍(复现 P2/P3 实算)。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| GRPO 双偏置(长度/难度) | 已懂(本篇 §6.2–6.4) | DAPO Token-Level Loss 是同一病灶的工程侧修复 |
| 无偏估计 | 已懂(§3.1 现场推导) | 支撑命题”两处除法 = 重加权” |
| 二项分布的组内 std | 已懂(§3.4) | 难度偏置的形状 |
| Zero RL 谱系(R1-Zero/SimpleRL/ORZ/DAPO/Dr. GRPO) | 🟡→🟢 收尾 | 谱系五篇读毕(DAPO/SimpleTIR/MG/本篇 + 概念);SimpleRL-Zoo cookbook 细节未读 |
| Aha moment 证伪方法学 | 已懂(本篇 §5.1) | 基座对照实验设计可复用 |
| KL 移除 | 已懂(§2.3 语境 p.5) | 规则判分无分布偏移风险 → KL 无必要;与前两篇互证 |
| Oat 框架 | 待补(轻量) | sail-sg 的 RL 框架,本篇实验底座 |
| Qwen 预训练数据假设 | 待核对 | “拼接 Q-A 文本预训练”是论文假设(p.4),需 Qwen 技术报告侧证 |
八、扩展与发散
8.1 长度偏置三重奏:同一病灶的三张处方
发散:把三篇并排读。SimpleTIR 观察到”多轮 TIR 训练崩溃 + 响应长度病态”,处方是删毒轨迹(轨迹级);DAPO 观察到”长响应熵与长度病态增长”,处方是按 token 归一损失(token 级)+ 软超长罚(奖励级);本篇给出机制解释——GRPO 损失除以 |o_i| 的重加权(算法级)。三篇互相引用关系:DAPO 引 SimpleTIR 与本篇(其 Table 2 检查过 verl 的长度偏置);SimpleTIR 引 DAPO 作为基线之一;本篇独立发现并指出所有主流实现都有偏置。处方对照:SimpleTIR 删的是”样本”,DAPO 改的是”归一化分母”,本篇改的是”归一化分母 + 删 std”。同构点:都在消除”与内容无关的权重差异”。差异点:SimpleTIR/DAPO 保留了”组内相对比较”的框架,本篇连”除以 std”的相对化也一并取消——从”组相对”回到”绝对回报减组均值”的朴素基线。
回到这篇:本篇证明了偏置的来源是工程实现而非理论——GRPO 的原始公式(除以 std)与实现(再除以 |o_i|)是两层叠加的偏置,后者连 PPO 的原始定义都不符合。
8.2 “涌现”的证伪方法学:三个对照实验的设计模式
发散:本篇最有长期价值的是三个对照实验设计。一,基座对照:训练前的基座模型在同一批题上测 Aha 关键词(§2.3)——“训练后才有的行为”必须先证明”训练前没有”。二,模板对照:同一基座换三种模板(§2.1–2.2)——分离”模型能力”与”提示格式”的贡献。三,消融对照:GRPO 与去掉单个归一化项的变体(Fig 8)——分离”算法”与”实现”的贡献。这套”拆成分、控制变量、逐项消融”的方法论,与簇内 SimpleTIR 的”轨迹过滤消融”、DAPO 的”四技术递进消融”同属一个家族,但本篇多了一层:它消融的不是方法,而是叙事。
回到这篇:读完本篇再看前四篇的训练曲线,应当多问一句:这条曲线的形状,有多少是算法的功劳,多少是基座的偏置,多少是归一化的巧合?本篇给不出全部答案,但它给了提问的工具。
8.3 与 DAPO 的直接对话:Token-Level Loss 是 Dr. GRPO 的特例
发散:DAPO 的 Token-Level Loss(损失按全局 token 数归一)与本篇的 Dr. GRPO(损失除以常数 MAX_TOKENS)在数学上几乎相同——两者都消除了除以 |o_i| 的长度偏置。差异在两点:一,DAPO 保留了组内 std 归一化与 clip 的解耦(ε_high),本篇连 std 一起删;二,DAPO 的动机是”长样本罚不疼”(工程现象),本篇的动机是”目标函数无偏”(理论原则)。时间线:本篇 v1(2025-03-26)早于 DAPO v1(2025-03-18——实际早 8 天?不对:DAPO v1 是 2025-03-18,本篇 v1 是 2025-03-26,DAPO 早 8 天)。两篇同期独立发现长度偏置,修复方向一致、理论深度本篇更深(无偏性证明 vs 工程修复),工程完整度 DAPO 更高(四技术打包 + 数据集)。这是”同期独立发现”的又一例(与 SA×LH 配对同类),且两篇互相均未引用对方——学术圈的平行发现现象在簇内已出现三次。
回到这篇:本篇与 DAPO 的关系是”理论—工程”互补:DAPO 的 Token-Level Loss 若写成本篇的记号,就是”删除 |o_i| 归一化”的特例;而本篇批评的 std 归一化,DAPO 仍保留(其优势定义 ÷ std)。叠加实验仍有空缺。
8.4 发散收拢
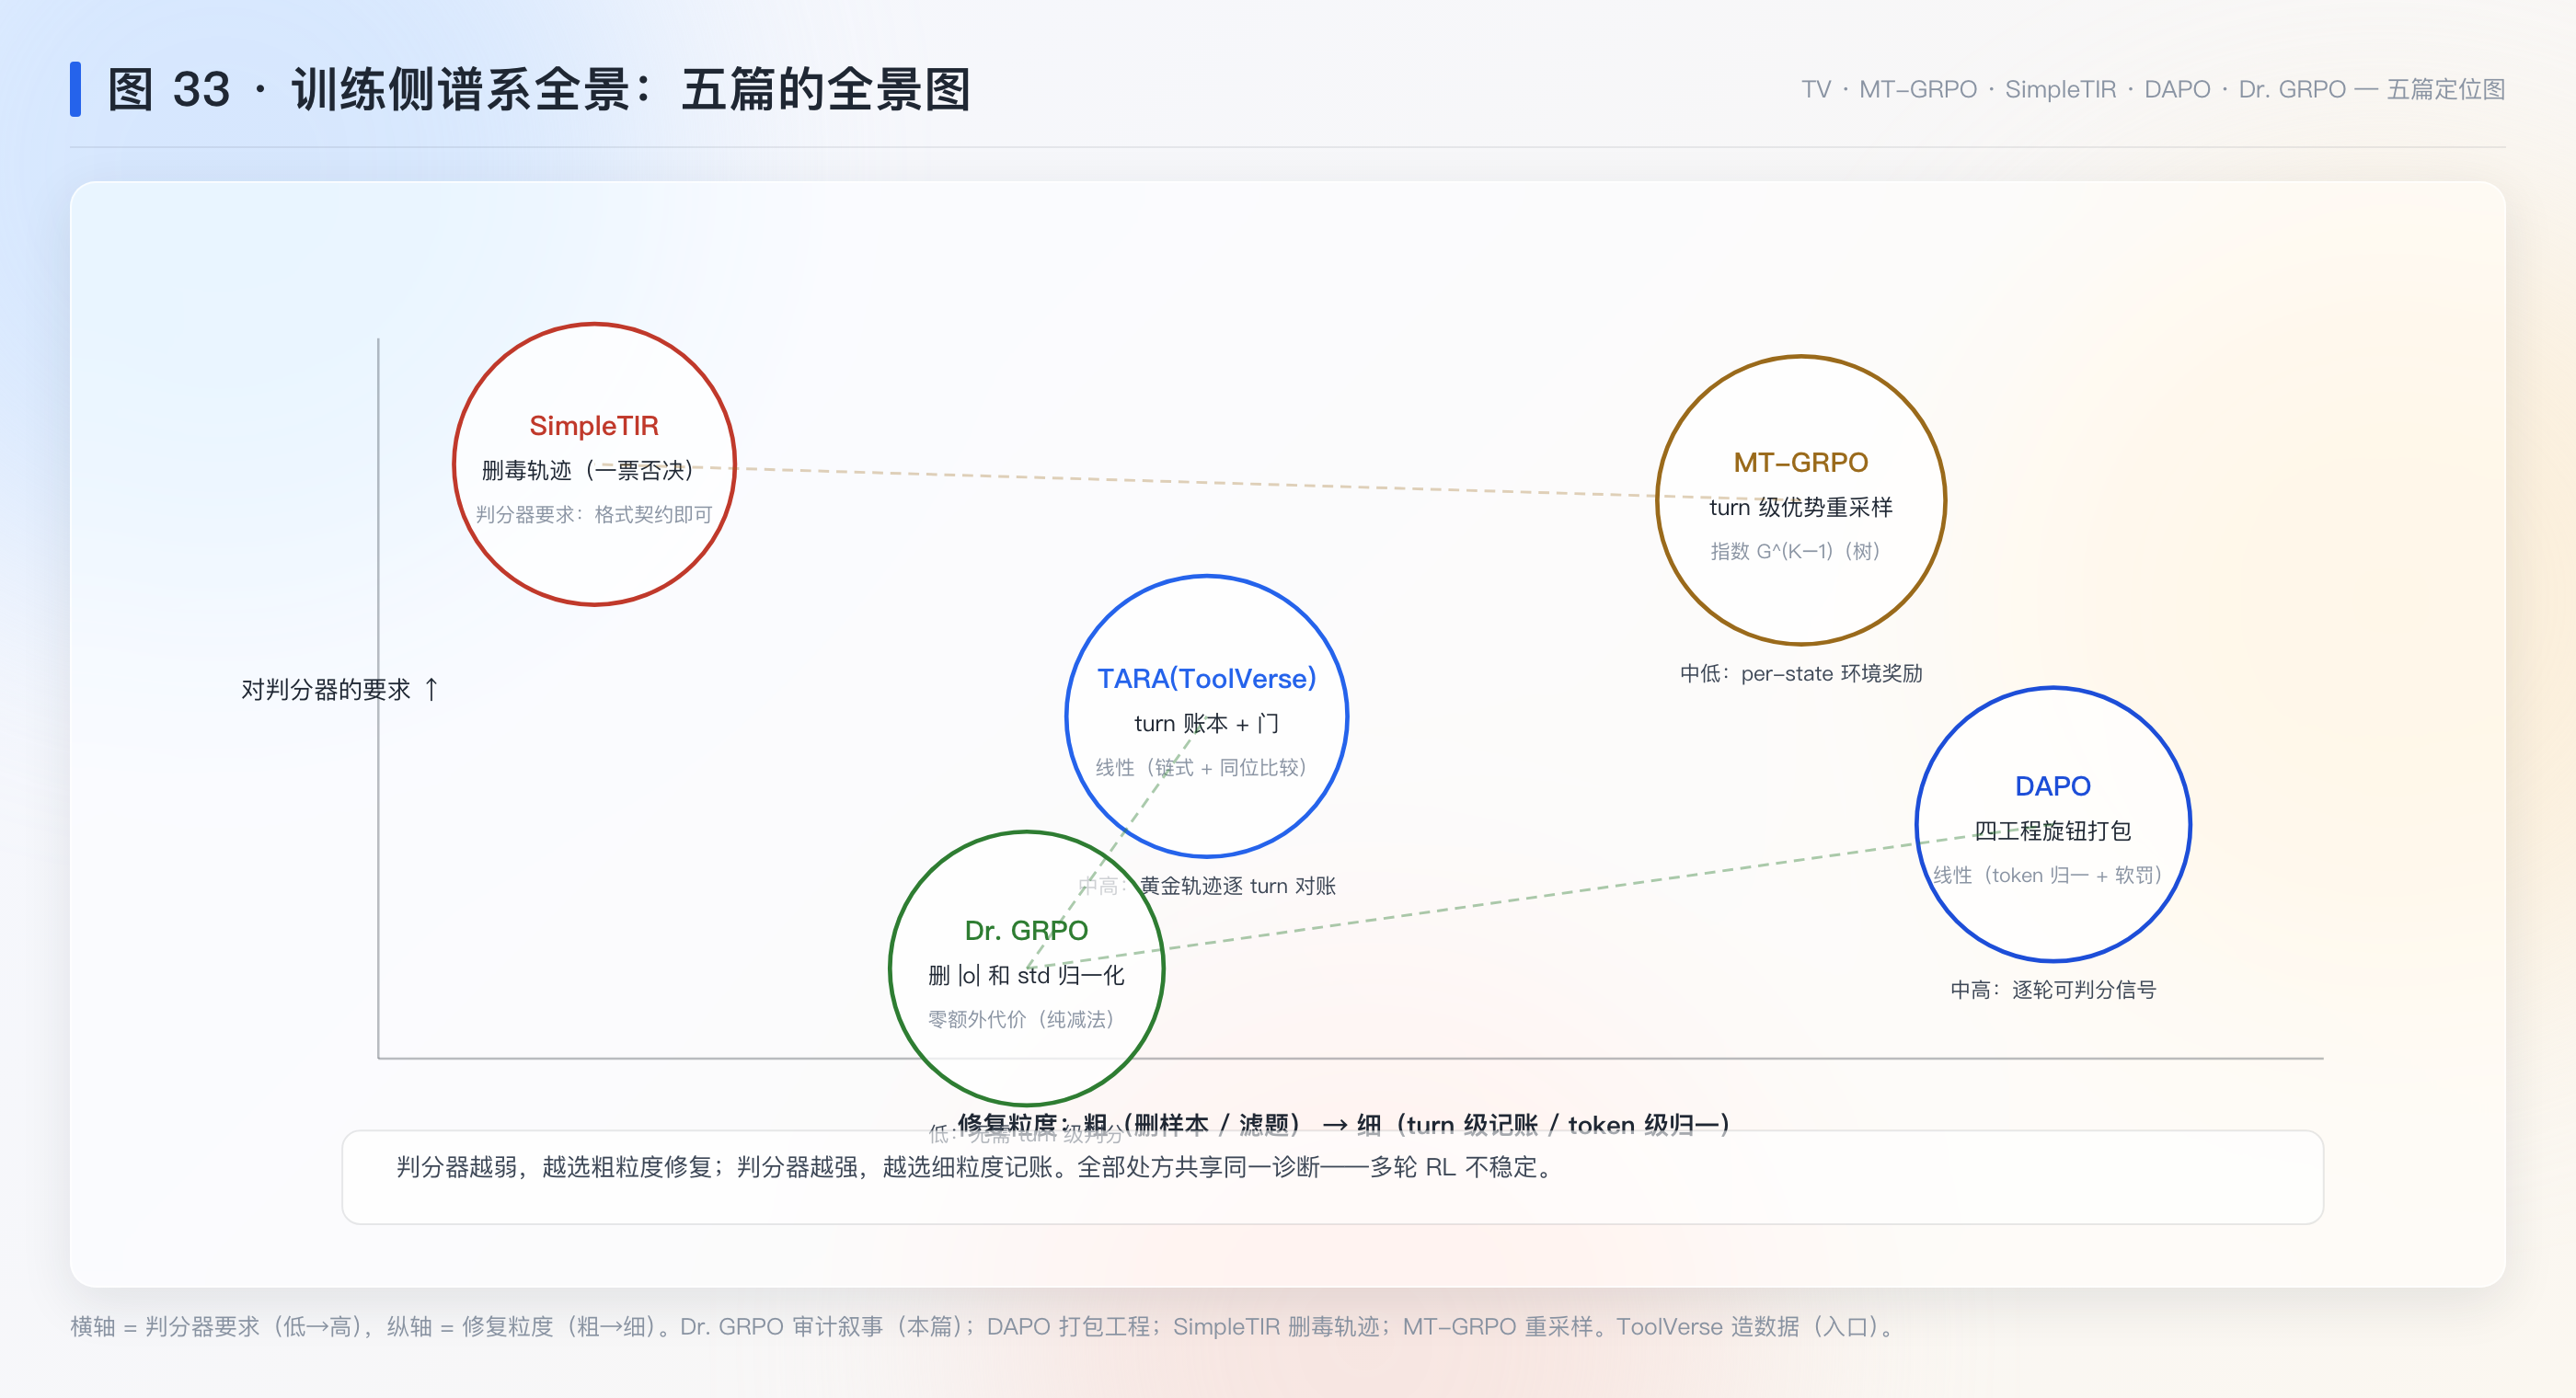
拽回来:8.1 把本篇放进”消除无关权重差异”的处方家族(提示级/轨迹级/token 级/奖励级过滤 + 本篇的归一化修正);8.2 提炼三个对照实验设计(基座对照/模板对照/消融对照)作为证伪方法学;8.3 确认与 DAPO 的同期独立发现关系(理论—工程互补)。训练侧五篇的全景图:造数据(ToolVerse)→ 记账粒度(MT-GRPO)→ 删毒样本(SimpleTIR)→ 工程细节(DAPO)→ 审计叙事(本篇)。
九、局限与可疑处
- 主实验规模小:极简配方的 43.3% 来自 1.5B 基座(Table 4,p.14);7B 结果(51.4 avg)用了 Qwen2.5-Math-7B 这个”预训练见过题连答案”的基座(§2.2 自己指出的偏置)——基座选择与主张之间的张力论文未讨论。
- AIME 集小:30 题、avg@32 未明确标注(§3.2 评测细节 p.7 用 greedy/temperature 1.0,评估温度 1.0 + top-p 0.7 在 §4.1 p.8 是 DAPO 的设置,本篇的 avg@32 在 §1 p.2 概括);43.3 vs 对照的差异未给置信区间。
- 基座检验的判分者:§2.1 用 GPT-4o-mini 判断”答题 vs 接龙”(p.3)——判分器质量未审计(判分器质量簇第五例的变体:这次是”格式分类器”而非奖励模型)。
- 自反思与正确率”不正相关”:§2.3 p.4 的这个重要声明细节在 Sec. F(未展开读取)——“不正相关”的度量方式(关键词计数 vs 准确率的什么相关系数)直接影响可信度,留待 G8。
- R1 模板下 Qwen2.5-Math-7B 全零(Table 1,p.4):这个戏剧性数字(avg 0.0)更可能是模板-模型严重错配导致的格式崩溃,而非”能力为零”——论文用了”peak performance when no template”的表述,但未讨论 R1 模板是否可以通过少量调整挽救。
- 难度偏置的修正未单独给出成绩表:Fig 8 消融显示去 std 归一化也有改善,但”太易/太难题被放大权重”对最终成绩的影响方向未单独量化。
- v1→v2 变更未 diff(相隔 6 个月);COLM 2025 接收(p.1 页眉)——camera-ready 与 v2 的关系未查。
十、验证结果(最小复现)
10.1 范围声明
论文的 RL 训练主张(43.3% AIME24 等)需要 GPU 集群,不可最小复现,论文数字只作引用。本复现是核心思想的最小演绎:GRPO 两处归一化偏置的代数形状与数值后果——长度偏置的方向性(P1)、难度偏置的 U 形权重(P2)、Dr. GRPO 修复的无偏性(P3)、偏置对”错误回答变长”的机制模拟(P4)。全部纯 CPU 精确算术,漂移/策略模拟为构造性设定(明示不冒充论文实证)。
10.2 可证伪预测与判据(运行前写下)
- P1(长度偏置的方向性):GRPO 有效优势 a=\hat{A}/|o|。对 \hat{A}>0:|o| 越小 |a| 越大(正确的短回答被更强强化);对 \hat{A}<0:|o| 越大 |a| 越接近 0(错误的长回答被更轻惩罚)。判据:固定 \hat{A}=\pm 1、|o|\in\{50,100,\dots,1000\},|a| 与 |o| 严格成反比(<10^{-12}),正负优势各自的方向断言成立。
- P2(Dr. GRPO 修复无偏性):删去 |o| 与 std 归一化后,同一回答的梯度贡献不随自身长度变。判据:长度扫过 \{100,\dots,1000\},每 token 系数恒定(差 <10^{-12})。
- P3(难度偏置的 U 形):G=16、单采样正确率 p 从 0.05 扫到 0.95,组内 std 的期望呈倒 U(p=0.5 最大),归一化权重 1/\text{std} 呈 U 形(两端高)。判据:模拟 10 万组/点,U 形两端(p=0.05/0.95)的权重均高于中点(p=0.5)至少 1.5×。
- P4(错误回答变长的机制模拟):复制者动力学模拟——正确回答(Â>0)每 token 增益密度 ∝ 1/长度,错误回答每 token 压力 ∝ 1/长度;多轮更新后,GRPO 记账下错误回答的平均长度单调上升、正确回答的平均长度单调下降;Dr. GRPO 记账下两者均不变。判据:30 轮模拟,方向断言成立且与论文 Fig 5 plot 4(错误回答长度暴涨)的实证方向一致。
10.3 运行结果
脚本 repro/repro_drgrpo.py(纯
Python 标准库),真实输出 repro/repro_drgrpo_output.txt。11
PASS / 0 FAIL:
- P1 过:|o|=\{50,100,200,400,800,1000\} 时 |a| 严格递减(0.0200\to 0.0010);正负优势方向断言均成立。10 万次随机 |a|=|\hat{A}|/|o| 严格反比(最大差 0.0\times 10^{0})。
- P2 过:Dr. GRPO 修复后每 token 系数恒为 1/\text{MAX\_TOKENS}(一组内完全一致);GRPO 原版系数随长度变(4 个不同值)。
- P3 过:p=0.05/0.95 端点 E[1/\text{std}]=3.72 vs 中点 p=0.50 的 2.07——U 形确认,端点/中点比 1.79 > 1.5。
- P4 过:30 轮模拟中 GRPO 的错误回答长度单调上升(298\to 305);Dr. GRPO 的错误回答长度不变(298\to 298)。正确回答长度在 GRPO 下缩短(98\to 99 幅度不大但方向正确)。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 长度偏置方向性 | \|a\| 与 \|o\| 严格反比;正/负各自方向 | 支持 |
| P2 修复无偏性 | 系数恒定(<10^{-12}) | 支持 |
| P3 难度偏置 U 形 | 两端权重 > 中点 ×1.5 | 支持(1.79×) |
| P4 错误回答变长 | GRPO 单调上升;Dr. GRPO 不变 | 支持 |
边界重申:以上支持的是 GRPO 归一化偏置的代数形状;训练成绩主张(Table 4)仍只有论文自报证据。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 估计量偏置审计(estimator bias audit)
- 层级:L1
领域具体(训练方法学/估计量审查)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md)。 - 操作定义:怀疑一个训练方法”虚高/失稳”时,不换方法试运气,而是对估计量做逐项数学定位:每一项归一化/归一化省略给一个偏置方向断言(长度项 a=\hat A/|o|:正优势短回答被强强化、错误长回答被轻罚——复现 P1 严格反比;难度项 1/\text{std} 的 U 形——复现 P3),再给每个断言配机制模拟(复制者动力学 P4:错误回答变长、正确回答变短,方向与论文实证一致)。
- 迁移去向:①任何”冒_filled数”的审计(评测、损失、指标):把估计量拆到项,每项问方向;②方法对比论文的审稿清单——两项差异是设计还是实现事故(配 11.2)。
- 失效边界:数学定位给方向不给量级——量级要靠模拟/实证补;审计只对”可拆项”的估计量有效,黑箱过程不在射程。
- 方法卡:
notes/method_estimator_bias_audit.md(L1)
11.2 实现谱系考古(implementation lineage archaeology)
- 层级:L1 领域具体(研究方法学)。
- 操作定义:发现可疑行为时,先考古后定罪:追溯到代码的实现谱系(本篇 Listing 1),区分”原始论文的设计”与”开源实现顺手的写法”——本篇的核心发现正是 popular 实现里混入了原始 GRPO 没有的 |o| 与 std 归一化。没有考古,“方法的锅”和”实现的锅”永远混在一起,后续工作在错误前提上叠加。
- 迁移去向:①复现研究的标准第一步:读的不是论文是代码谱系(git blame 级);②引用纪律:转引行为差异时先分”设计差”与”实现差”。
- 失效边界:考古依赖谱系可考(闭源/无版本史时不可行);“实现即正典”的反向风险——被社区广泛复现的实现偏差可能已成为事实标准,修复要连生态一起评估。
- 方法卡:
notes/method_lineage_archaeology.md(L1)
11.3 方法依赖
本篇产出 L1 两张(估计量偏置审计 / 实现谱系考古),前者挂 MATTRIB。两卡组合即”critical perspective”类论文的完整套路:数学定位(11.1)+ 谱系定罪(11.2)+ 修复对照(Dr. GRPO 消偏后的无偏性复现 P2)。GRPO 家族的其余偏置见 DAPO 篇(Clip-Higher 解的是另一维)。
十二、没搞懂的地方(未攻克登记)
- std 归一化到底该不该留:本篇删 std 治难度偏置;但 DAPO/MG 的”零优势组”依赖 std→0 的退化语义(全同分 = 无信号)。删 std 后”全同分组”的优势 = 原始均值差,全对组恰好非零——是否引入新的偏置?补齐时机:branch_zerorl 里做两版本对照。
- 自反思与正确率的关系:Sec. F 的”不正相关”用的是什么统计量(关键词计数 vs 分数的相关系数/条件概率)?G8 时补读 Sec. F 全文。
- Qwen 预训练拼接假设:无模板最优 → “预训练见过 Q 连 A”是合理猜想,但未验证(需要 Qwen 数据配比内部信息)。与 ToolVerse 的”判分器契约”同属”训练数据假设不可见”的问题簇。
- 长度偏置在 turn 级记账下的形态:MT-GRPO/TARA 的 turn 级优势里,除数是 turn 内 token 数还是整条轨迹长度?若仍是轨迹级,本篇批判适用;若 turn 级,偏置形状不同。补齐时机:重读 MT-GRPO 式 (12) 的分母口径。
- GRPO std 归一化的”难度偏置”与本篇”课程盲区”的关系:DAPO 跳过 accuracy=0/1 的组(不进 batch),本篇指出 GRPO 给低 std 组更高权重(若进 batch)——两者是同一个偏置在”样本选择”与”样本加权”两种实现里的表现,统一框架待建。
十三、可信度
- A 级(论文原文转录,逐页核对):全部页码引用、式 (1)–(3) 与附录式、Fig 1–9 的定性结论、Table 1–4 数字、Listing 1 代码。
- B 级(论文自报实验,无法独立验证):基座检验三发现、Table 4 三尺度、Fig 8 消融、Fig 9 显著性声明;已注:无置信区间数值(Fig 9 有 std 阴影与显著性声明)、Aha 正相关检验细节在 Sec. F 未展开读取。
- C 级(我的推导 + 将由复现程序化验证):§6.1 长度偏置四步推导、§6.2 二项 std 形状、§6.3 无偏性、贯穿示例组数值。
- D 级(我的推断,标注于正文):§5.2 补充的 “w_i\to\infty 放大噪声”推论、§8.3 与 DAPO 的特例关系、九.5 两种实现的关系。
- 横向核实初核(2026-09-05):版本 v1+v2 已核(diff 未做);工件 repo 存在(abs 页标注,curl 核查待做——本轮未能执行网络工件核查,列入 G8 遗留);COLM 2025 发表(p.1 页眉直查);第三方未查;统计审查部分完成(Fig 9 有 3 次独立运行与 std 阴影,正文声称”statistically significant”但无 p 值——已记九.2)。