外行导读(先读这个,再决定要不要进正文)
一个场景:大模型”光说不练”——讲道理头头是道,遇到要精确计算的数学题就翻车。解法是让它边想边写代码、跑一遍拿真结果再继续想。2025 年起大家确认:用强化学习直接训练一个未调教的基座模型这么干,模型的数学能力会自己长出来——DeepSeek 的 R1 就是这么造的。但这条路的训练细节被藏起来了:字节照论文复现,只有 30 分,R1 同款设置是 47 分。差的 17 分全是没人写出来的” Know-how”。
这篇论文干的事:把 17 分的差距拆成四个具体可修的训练毛病,每个给一个改法,并全部开源——①模型越训越只敢重复老套路(给”尝试新做法”留预算);②训练题库里”全员做对”和”全员做错”的题提供不了任何改进信息(跳过它们);③批改长答卷按”篇”算分,长答卷里的错误罚不疼(改成按字算分);④答卷超长被裁断时一律打零分,思路再好也白搭(先不计分、再温和扣分)。四个全修:50 分,反超 R1,训练量还省一半。
为什么值得关心:这四个毛病的共性是”反馈信号的质量”——模型只能从反馈里学,反馈脏了、稀了、偏了,学出来的就是坏习惯。任何靠反馈改进的系统(学生、团队、包括你自己复盘)都吃这套规律。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Zero RL | 不给示范答案,让基座模型直接从对/错反馈里自己摸索 |
| GRPO | 同一道题采样一组回答,按”比同组平均好多少”定优劣 |
| 熵坍缩 | 模型越学越只会一种答法,不再尝试新思路 |
| 零优势组 | 一组 16 个回答全对或全错——人人同分,学了等于没学 |
| clip | 限制每次更新的步子大小,防止策略猛跳 |
| 轨迹 | 模型从头到尾的完整作答过程(含每轮工具调用与结果) |
| 截断 | 超过最大长度被硬性切断 |
| verl | 字节开源的 RL 训练框架,本篇的实现底座 |
§0 承接栏
这篇接的是前三篇攒下来的一个悬案。前三篇都在回答同一件事——“怎么用强化学习把大模型训成会自己长出推理能力”:ToolVerse 讲训练题和环境怎么自动造出来,MT-GRPO 讲每一轮的分数怎么算才公平,SimpleTIR 讲带毒的训练样本怎么删。三篇里还有一个 Everyone 都在用、却没人解释过为什么的做法:训练时那条”别让模型离原始版本太远”的约束(KL 惩罚),全都被关掉了(ToolVerse p.14、MT-GRPO p.25、SimpleTIR p.18)。DAPO 第一次给了正式理由(§2.3,p.3):训练长推理链,模型本来就该大幅偏离原始版本,“别跑太远”这条拴绳在这个场景里语义不成立。
另外两笔旧账也在这篇还上。其一,SimpleTIR 篇那个”向上放宽到 0.28、向下仍是 0.2”的不对称步子限制,源头就是这篇的 Clip-Higher,而放宽的动机这篇讲清了:不放宽,模型会越来越不敢尝试新做法,越训越保守(§3.1,p.4;两处设置的对照见 SimpleTIR C.2 p.18 与本篇 §4.1 p.8)。其二,SimpleTIR 删”带毒的轨迹”、这篇跳”没人做得好也没人做得差的题目”,是同一个原则的两个粒度:没有信息量的样本,不配进入训练(§3.2,p.5)。到这里,训练侧四篇成形:题和环境怎么造(ToolVerse)、每一轮的账怎么记(MT-GRPO/TARA)、毒样本怎么删(SimpleTIR)、训练细节怎么调(本篇)。
一、论文在解决什么问题
1.1 一个具体场景
你复现 DeepSeek-R1:拿 Qwen2.5-32B 基座,规则奖励(答对 +1 答错 −1,式 (7),p.3),GRPO 训长思维链。R1 论文说这条路线 AIME24 能到 47 分;你跑出来只有 30 分(§1,p.2)。中间差的不是算法——是没人写出来的训练细节。论文把这 17 分拆成了四个可修的点,每个加几分,最后 50 分反超 R1 且只用一半训练步数(Figure 1,p.1)。
拆解过程里观察到四种病(§1,p.2;§3 各节):
- 熵坍缩:策略熵随训练快速下降,同组采样趋同,探索枯竭、过早确定性(§3.1,p.4,Fig 2b)。
- 零梯度稀释:模型变强后,“全对”提示越来越多——全对组的优势恰为零,这些提示不产生梯度,有效批量缩水、梯度方差变大(§3.2,p.5,Fig 3b)。
- 长度偏置:GRPO 的样本级损失让长响应的每个 token 权重被稀释——高质量长样本学不透,低质量长样本(乱码、重复)罚不疼,熵和长度病态增长(§3.3,p.6,Fig 4)。
- 截断奖励噪声:超长被截断的样本默认吃惩罚罚——思路正确只因太长就被判负,模型对”推理是否有效”产生困惑(§3.4,p.6,Fig 5)。
1.2 与前两篇的入口差
SimpleTIR 从”毒性样本”进(删除含 void 的轨迹),MT-GRPO 从”信用粒度”进(turn 级优势),本篇从”系统细节”进:四个技术各治一种训练病,且全部是工程旋钮(clip 上界、采样过滤器、损失归一化、奖励塑形),不动算法主干。注意本篇的 GRPO 优势就是轨迹级的(式 (4),p.3)——它完全不碰 turn 级信用问题;与 SimpleTIR 一样属于”不改账本粒度”的路线。对照见 §八。
二、核心想法
一句话:大规模 RL 的进步不在算法创新,而在四个被隐藏的工程细节;把它们逐一公开并消融,30 分 → 50 分。
这个论断初听有点泄气——折腾半天,不是算法不行,是细节没公开?但往深一层想,这恰恰是把一门藏着掖着的手艺推到了亮处。在它之前,“复现不了 R1”是一团雾:你不知道差在哪,只能归给玄学。在它之后,这团雾被拆成四样看得见、摸得着、可以一个个单独验证的东西。
先打个比方,帮你在心里给四件事安个位置。训练一个长推理模型,很像养一缸鱼:鱼群挤死在角落里再也不游动,是熵坍缩——模型越训越只敢重复老套路;撒下去的饲料全被大鱼抢走、小鱼饿着,是长度偏置——长答卷里的对错信号被稀释;水里混进了毒鱼,是坏样本;水温骤变、鱼群翻肚,是奖励噪声。四个毛病,四个旋钮,一一对应。
再把比方译回工程语言。熵坍缩,就放宽 clip 的上界,给低概率的”探索 token”留出上升通道;零梯度组,就多采样一轮,把全对和全错的提示过滤掉;长度偏置,就把损失从”按篇平均”改成”按字平均”;奖励噪声,就让截断样本先不计分、再温和地软罚。
落到形式上:目标函数(式 (8),p.4)就是一个 GRPO 骨架,上面叠加四处修改——解耦的 (\varepsilon_{\text{low}},\varepsilon_{\text{high}})、约束 0<\#\{o_i:\text{correct}\}<G(动态采样)、\frac{1}{\sum_i|o_i|} 的 token 级归一化、式 (13) 的软超长惩罚。四处修改,没有一处动人由。
所以这篇真正改变了什么:把”复现不了 R1”从玄学重构为可公开、可消融、可叠加的工程变量清单——每项技术有动机、有机制、有独立加分。这与 LH 的”能力 = 模型 × harness”同构:训练系统本身就是最大的 harness。
全篇就看这张:图 26(§五)——四病灶四旋钮与递进消融瀑布:每个工程旋钮对应哪个病灶、拧完各涨多少分,一张图把“复现 R1 差在哪”讲完。 ## 三、数学基础(零起点,本篇新用到的四件)
3.1 熵与策略分布的”尖与平”
第一件工具叫熵,它量的是一个策略下笔时有多犹豫。把策略想成一颗骰子:六面等可能的均匀骰子最犹豫,每一步都拿不定主意,熵最大;只有一条出路的骰子毫无犹豫,出手即结果,熵为 0。写成公式,离散分布 P 的熵是 H=-\sum_j P(j)\log P(j)。训练为什么要盯住它?因为好坏两头都有失败形态:熵掉到 0,模型再也不探索,这是坍缩;熵涨得太大,输出变成乱码与重复,这是过度探索。本篇监控的是生成分布的熵,健康形态是”缓慢上行”(§4.3,p.9)——记住这把尺子,§五的第一病”熵坍缩”就用它来量。
3.2 clip 的几何:乘法天花板
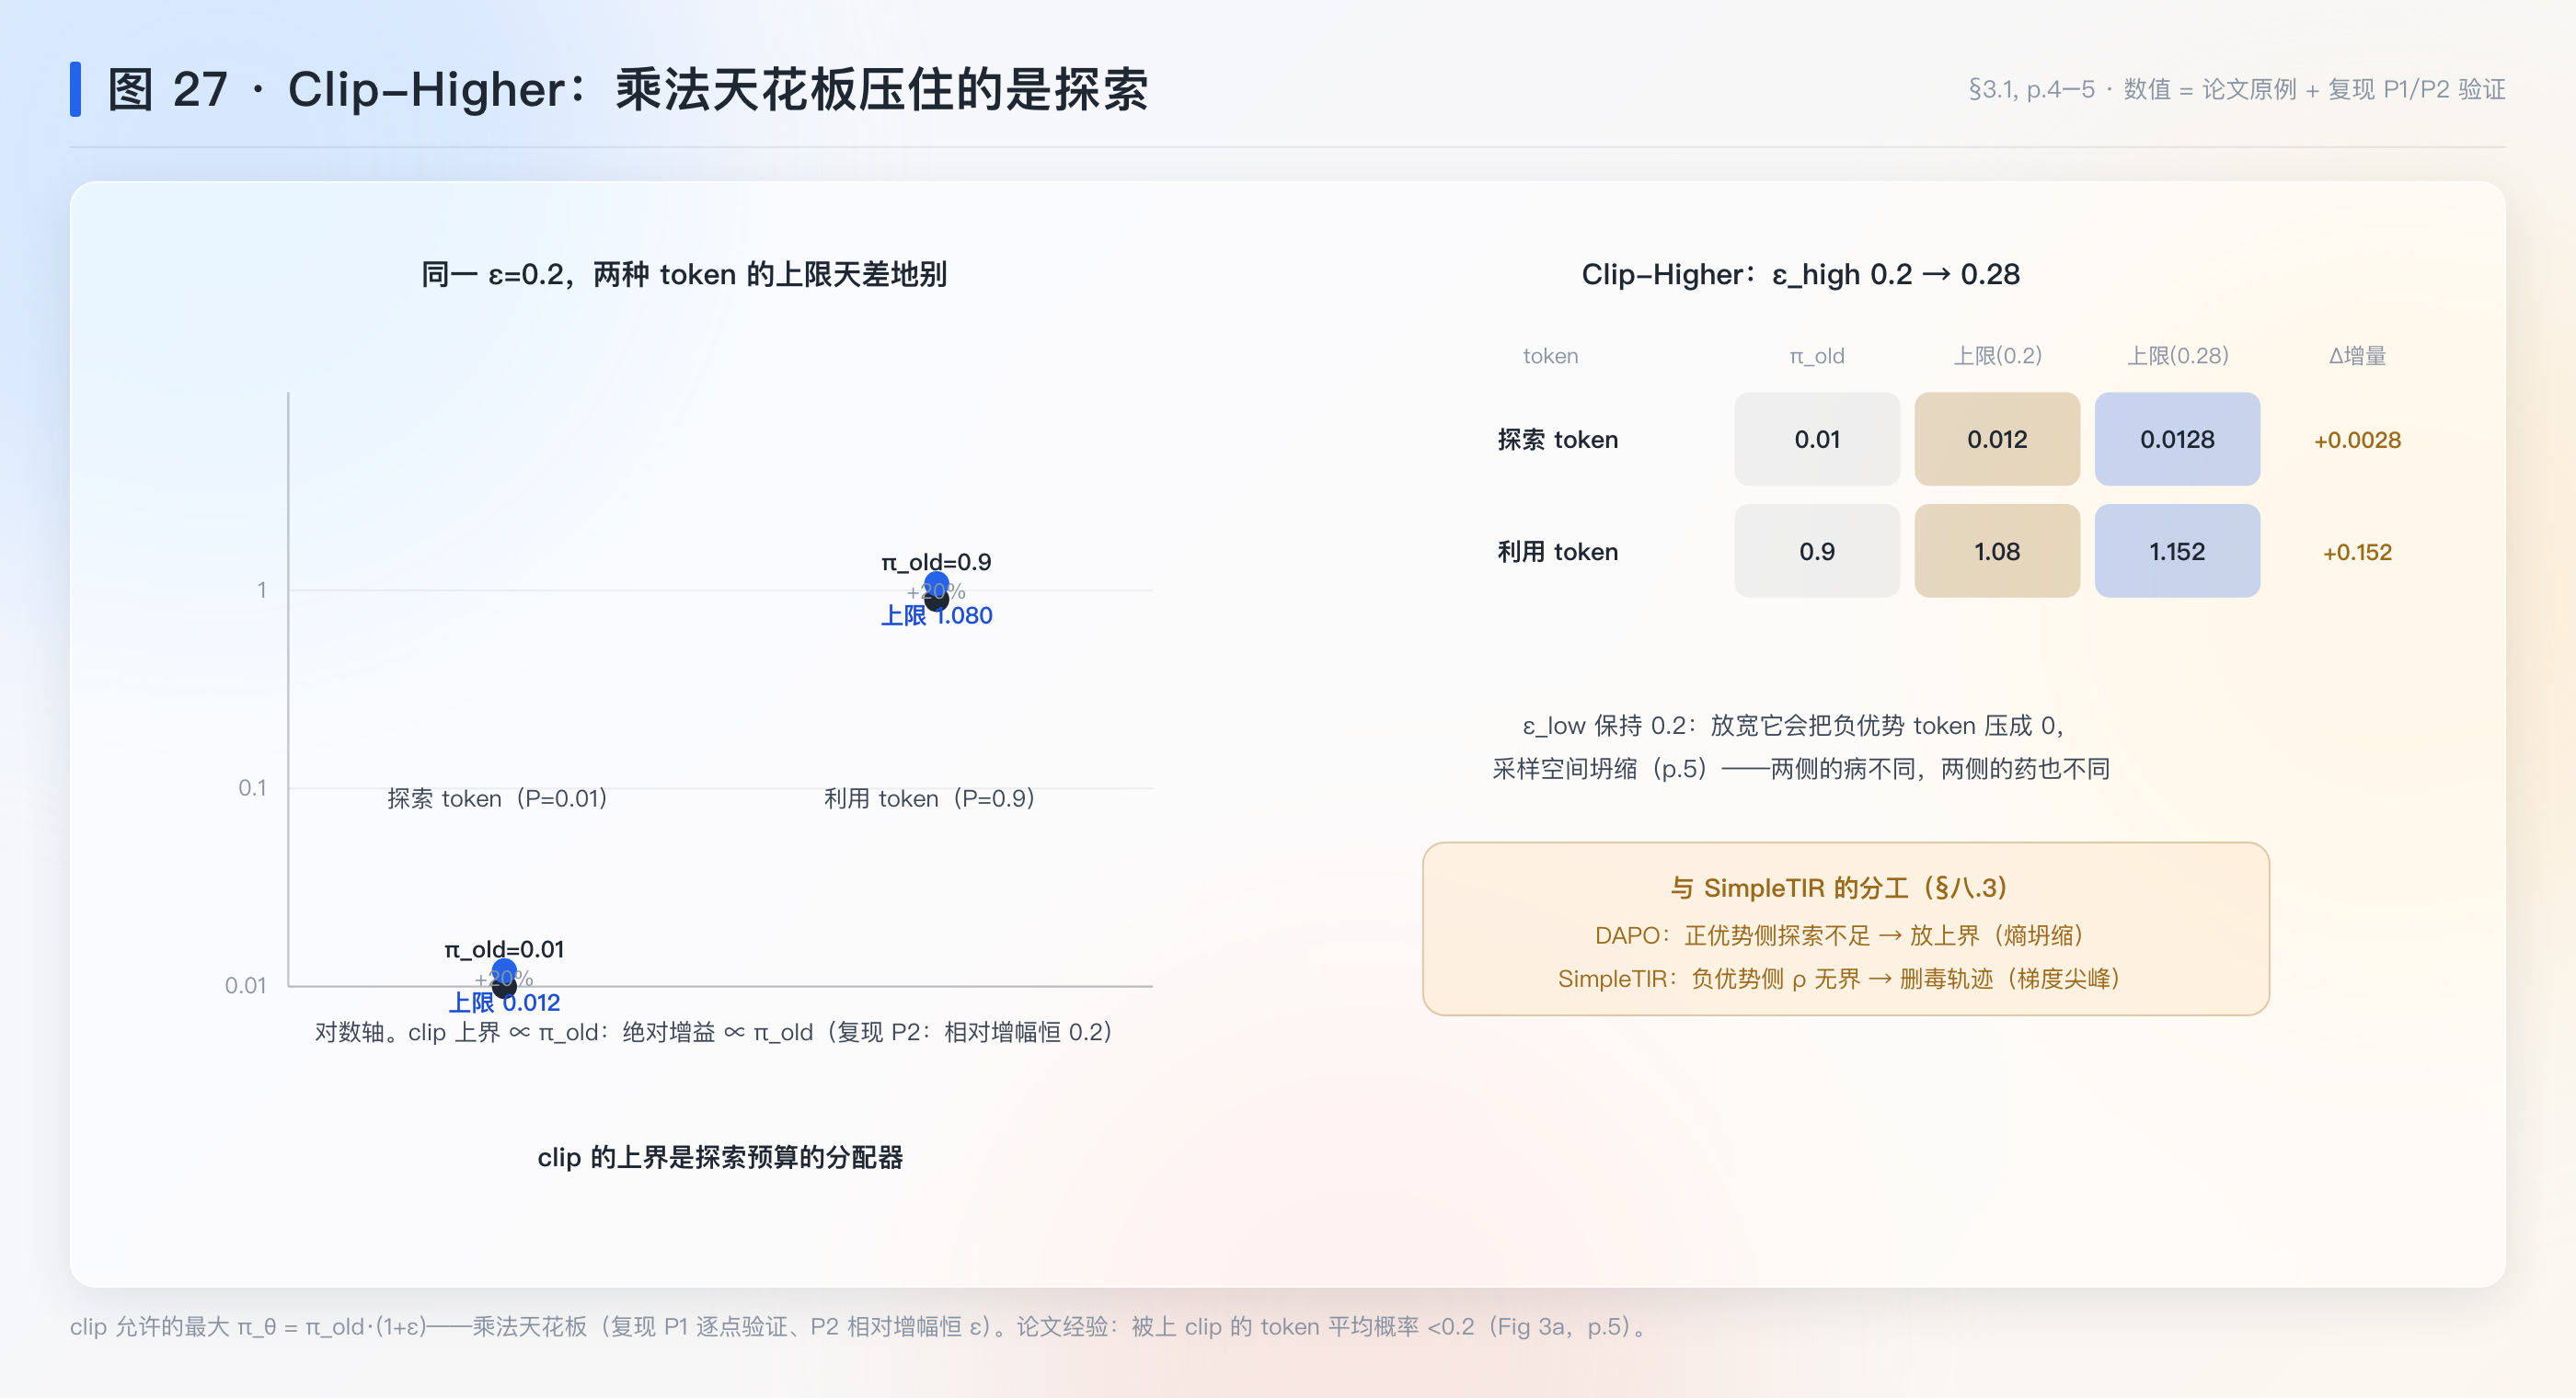
第二件工具是 clip 的几何。clip 对重要性比 \rho 的限制是乘法的:\pi_\theta\leq\pi_{\text{old}}\cdot(1+\varepsilon_{\text{high}})——注意是”乘”,不是”加”。乘法约束有个容易看漏的性格:同样比例的松绑,落到高概率 token 和低概率 token 头上,绝对增量天差地别。0.9 的 token 可以到 0.999,增量 0.099;0.01 的 token 最多到 0.0128,增量 0.0028——差了三十多倍。同样的门开同样宽的缝,高个子过得去,矮个子还是过不去。记住这笔账,§五的第一剂药方(Clip-Higher)全部算术就在这里(论文 p.4 的例子逐数字验证:0.01\times 1.2=0.012,0.9\times 1.2=1.08——复现 P1)。
3.3 组优势的退化条件
第三件工具只有一句话,却撑起了半个 DAPO。GRPO 的优势是 \hat{A}_i=(r_i-\text{mean})/\text{std};假如一组 16 条回答的分数一模一样,分子分母同零,0 除 0 无定义,实现里只好约定 \hat{A}=0。别把这个特判当成无关紧要的边角——它的直白翻译是:人人同分的组,学了等于没学。这个退化有三种出场方式:全对(accuracy=1,DAPO §3.2)、全错(accuracy=0,同节)、turn 级全同(ToolVerse 的零方差规则,B.4)。本篇补上的正是”提示级”这一格——§五的第二剂药方,整剂都是为它配的。
3.4 归一化的两种”除法”(损失系数)
最后一件工具是两种”除法”。一批 G 条、长度 |o_i| 的 token 损失,怎么平均才算公平?一种算法是样本级 \frac{1}{G}\sum_i\frac{1}{|o_i|}\sum_t\ell_{i,t}——先在每份答卷内部把字平均,再把 16 份的均值平均,每条样本占同样的份额;另一种是 token 级 \frac{1}{\sum_i|o_i|}\sum_i\sum_t\ell_{i,t}——跳过”篇”这一层,直接对整批的全部字平均,每个字占同样的份额。两者只差一个加括号的顺序,后果却不小:前一种里,长样本的每个字分量按 1/|o_i| 被稀释;后一种与长度彻底无关。这一除法之差,就是 §五第三剂药方的全部内容(§6.4 再细算)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| \hat{A}_{i,t}=(r_i-\text{mean})/\text{std} | GRPO 组级优势(轨迹级,摊给全 token) | 式 (4),p.3 |
| \varepsilon_{\text{low}},\varepsilon_{\text{high}} | 解耦裁剪下/上界(0.2 / 0.28) | 式 (10),p.5;§4.1 p.8 |
| 0<\#\{o_i\}<G | 动态采样约束:组内部分正确才保留 | 式 (11),p.5 |
| \frac{1}{\sum_i\|o_i\|}\sum_i\sum_t | token 级损失归一化 | 式 (12),p.6 |
| R(\hat{y},y)=\pm 1 | 规则奖励:等价 +1 否则 −1 | 式 (7),p.3 |
| R_{\text{length}}(y) | 软超长惩罚:[L_{\max}-L_{\text{cache}},L_{\max}] 内线性降 to −1 | 式 (13),p.7 |
| L_{\max}=16384,\ L_{\text{cache}}=4096 | 生成长度上限;软罚缓存区 | §4.1,p.8 |
| accuracy =0/1 | 组内全错/全对(零梯度组) | §3.2,p.5 |
五、机制
承上启下:§一 拆了复现 R1 差的 17 分里的四种病——熵坍缩、零梯度组稀释、长度偏置、截断奖励噪声;§二 给出本文的路线——把四个被隐藏的工程细节公开、逐个消融。上节备好的算术工具对上前三病的核心:乘法天花板(§3.2)对熵坍缩、退化条件(§3.3)对零梯度、两种除法(§3.4)对长度偏置;截断噪声不需要新数学,只需要奖励记法的一次重修(§5.4)。本节按”病灶 → 旋钮”配对讲机制,贯穿示例组先立起来。
5.0 贯穿示例的数据结构
示例组(与论文设置同款,§4.1 p.8):一个提示 q,G=16 条采样 \{o_i\},每条一个规则奖励 r_i\in\{+1,-1\}(式 (7),p.3),长度 |o_i| 不等(长 CoT 场景)。
组 = {
  rewards:  [+1, -1, +1, ..., +1],     # 长度 16
  lengths:  [3200, 180, 7200, ...],
  tokens:   [o_i 的 token 序列],
  n_correct: Σ(reward==1)              # 动态采样的判据
}
四个技术分别作用:Clip-Higher 改 per-token 损失的 clip 界;Dynamic Sampling 决定这个组是否进 batch(0<\text{n\_correct}<16 才留);Token-Level Loss 改 per-token 系数;Overlong Shaping 改截断样本的 reward。
5.1 机制一:Clip-Higher——给探索留天花板(§3.1,p.4–5)
【类比 · 按存量发探索预算】 教练鼓励学员尝试新动作,但探索预算按”老动作的存量”等比例发:老动作占 90%、新动作占 1%,新动作分到的尝试额度就只有老动作的 1/90——马太效应。Clip-Higher 把新动作的预算系数单独从 1.2 调到 1.28(老动作的惩罚系数不动)。 【跨域锚点】 强化学习通识:exploration/exploitation 权衡;“预算按存量分配”的马太效应。(类比与通识锚点,非论文内容)
先看病。训练刚开始时,模型还挺爱尝试各种写法;训着训着,输出越来越单一——同一道题采样 16 份答卷,几乎一字不差。论文管这叫熵坍缩:熵衡量的是模型下笔时的犹豫程度,熵掉光了,就是只会一种写法(p.4,Fig 2b)。
病根出在 clip 这个”步子限制”上。clip 的规则是:每次更新,任何一个字的出现概率最多变成原来的 1.2 倍(ε=0.2 时)。这条规则看似公平,实则偏心:占 0.9 概率的常用字想更常见,几乎不受影响——它甚至可以涨到 1.08,等效于直奔 0.999;而只占 0.01 概率的冷门字想抬头,同样只能涨 1.2 倍——从 1% 到 1.2%,杯水车薪。冷门字是什么?正是”尝试新思路”的载体。论文统计了训练中实际被顶到天花板的字:平均概率不到 0.2(Fig 3a,p.5)——被卡住的确实全是冷门字。
药方(式 (10),p.5):把天花板和地板拆开调。地板保持不变(错误做法照样要压),天花板从 1.2 放宽到 1.28,给冷门字的抬头多留一点空间。为什么地板不动?如果往下也放宽,错误的 token 会被直接压成概率 0——模型的选择空间反而先塌了(p.5)。效果:熵恢复缓慢上行,采样重新多样化(Fig 2)。
意义:SimpleTIR 篇那个”向上 0.28、向下 0.2”的不对称限制,就是这条的继承(SimpleTIR C.2,p.18);而 SimpleTIR 的命题 3.1 说明真正掀翻训练的是负优势侧无界的概率比——两侧的病不同,两侧的药也不同,互为印证。
5.2 机制二:Dynamic Sampling——过采样并滤掉零信号提示(§3.2,p.5–6)
【类比 · 跳过没有区分度的考题】 一组 16 份卷子全员满分:改卷得不到任何”谁好谁差”的信息——这组题白考了。办法是多印卷子,把全员满分和全员零分的组跳过,只留”有人对有人错”的组进课堂。代价:模型越强,该跳的组越多(接近题目上限时,要浪费近 7 倍的量才凑够一批)。 【跨域锚点】 教育学的”最近发展区”:只有跳一跳够得着的难度带才产生学习增量。(类比与通识锚点,非论文内容)
再看第二个病。给模型一道题,一次采样 16 份答卷。如果 16 份全对——每份的分数一样,组内比较算出的”改进方向”是零:这组题对训练毫无贡献。全对的情况随着模型变强越来越多(Fig 3b,p.5)——相当于训练题库里”白考”的题占比越来越大,有效训练批量不断缩水,剩下梯度里的噪声占比越来越高(p.5)。
药方听起来像笨办法:多采样。每道题照常采 16 份,但只保留”至少有人对、有人错”的组;不够就再采,直到凑满一批。论文算过账:生成的耗时主要卡在最长的那些答卷上,反正要等它们,多采几组几乎不增加时间;而且因为训练批里全是有效信号,达到同样成绩所需的步数反而更少(Fig 6,p.7)——这是这个”笨办法”最反直觉也最有价值的地方。
5.3 机制三:Token-Level PG Loss——损失归一化的一天一地(§3.3,p.6)
【类比 · 按字批改长作文】 原来按”篇”算分:一篇 3200 字的乱码长文和一篇 180 字的短文权重相同——乱码的每个字只挨到短文 5.6% 的惩罚,罚不疼。改成按”字”算分:每个字的对错等权,乱码立刻疼了,好长文也学得透了。 【跨域锚点】 考试评分里”按步骤给分”vs”只看最终答案”——前者让过程与结果同权。(类比与通识锚点,非论文内容)
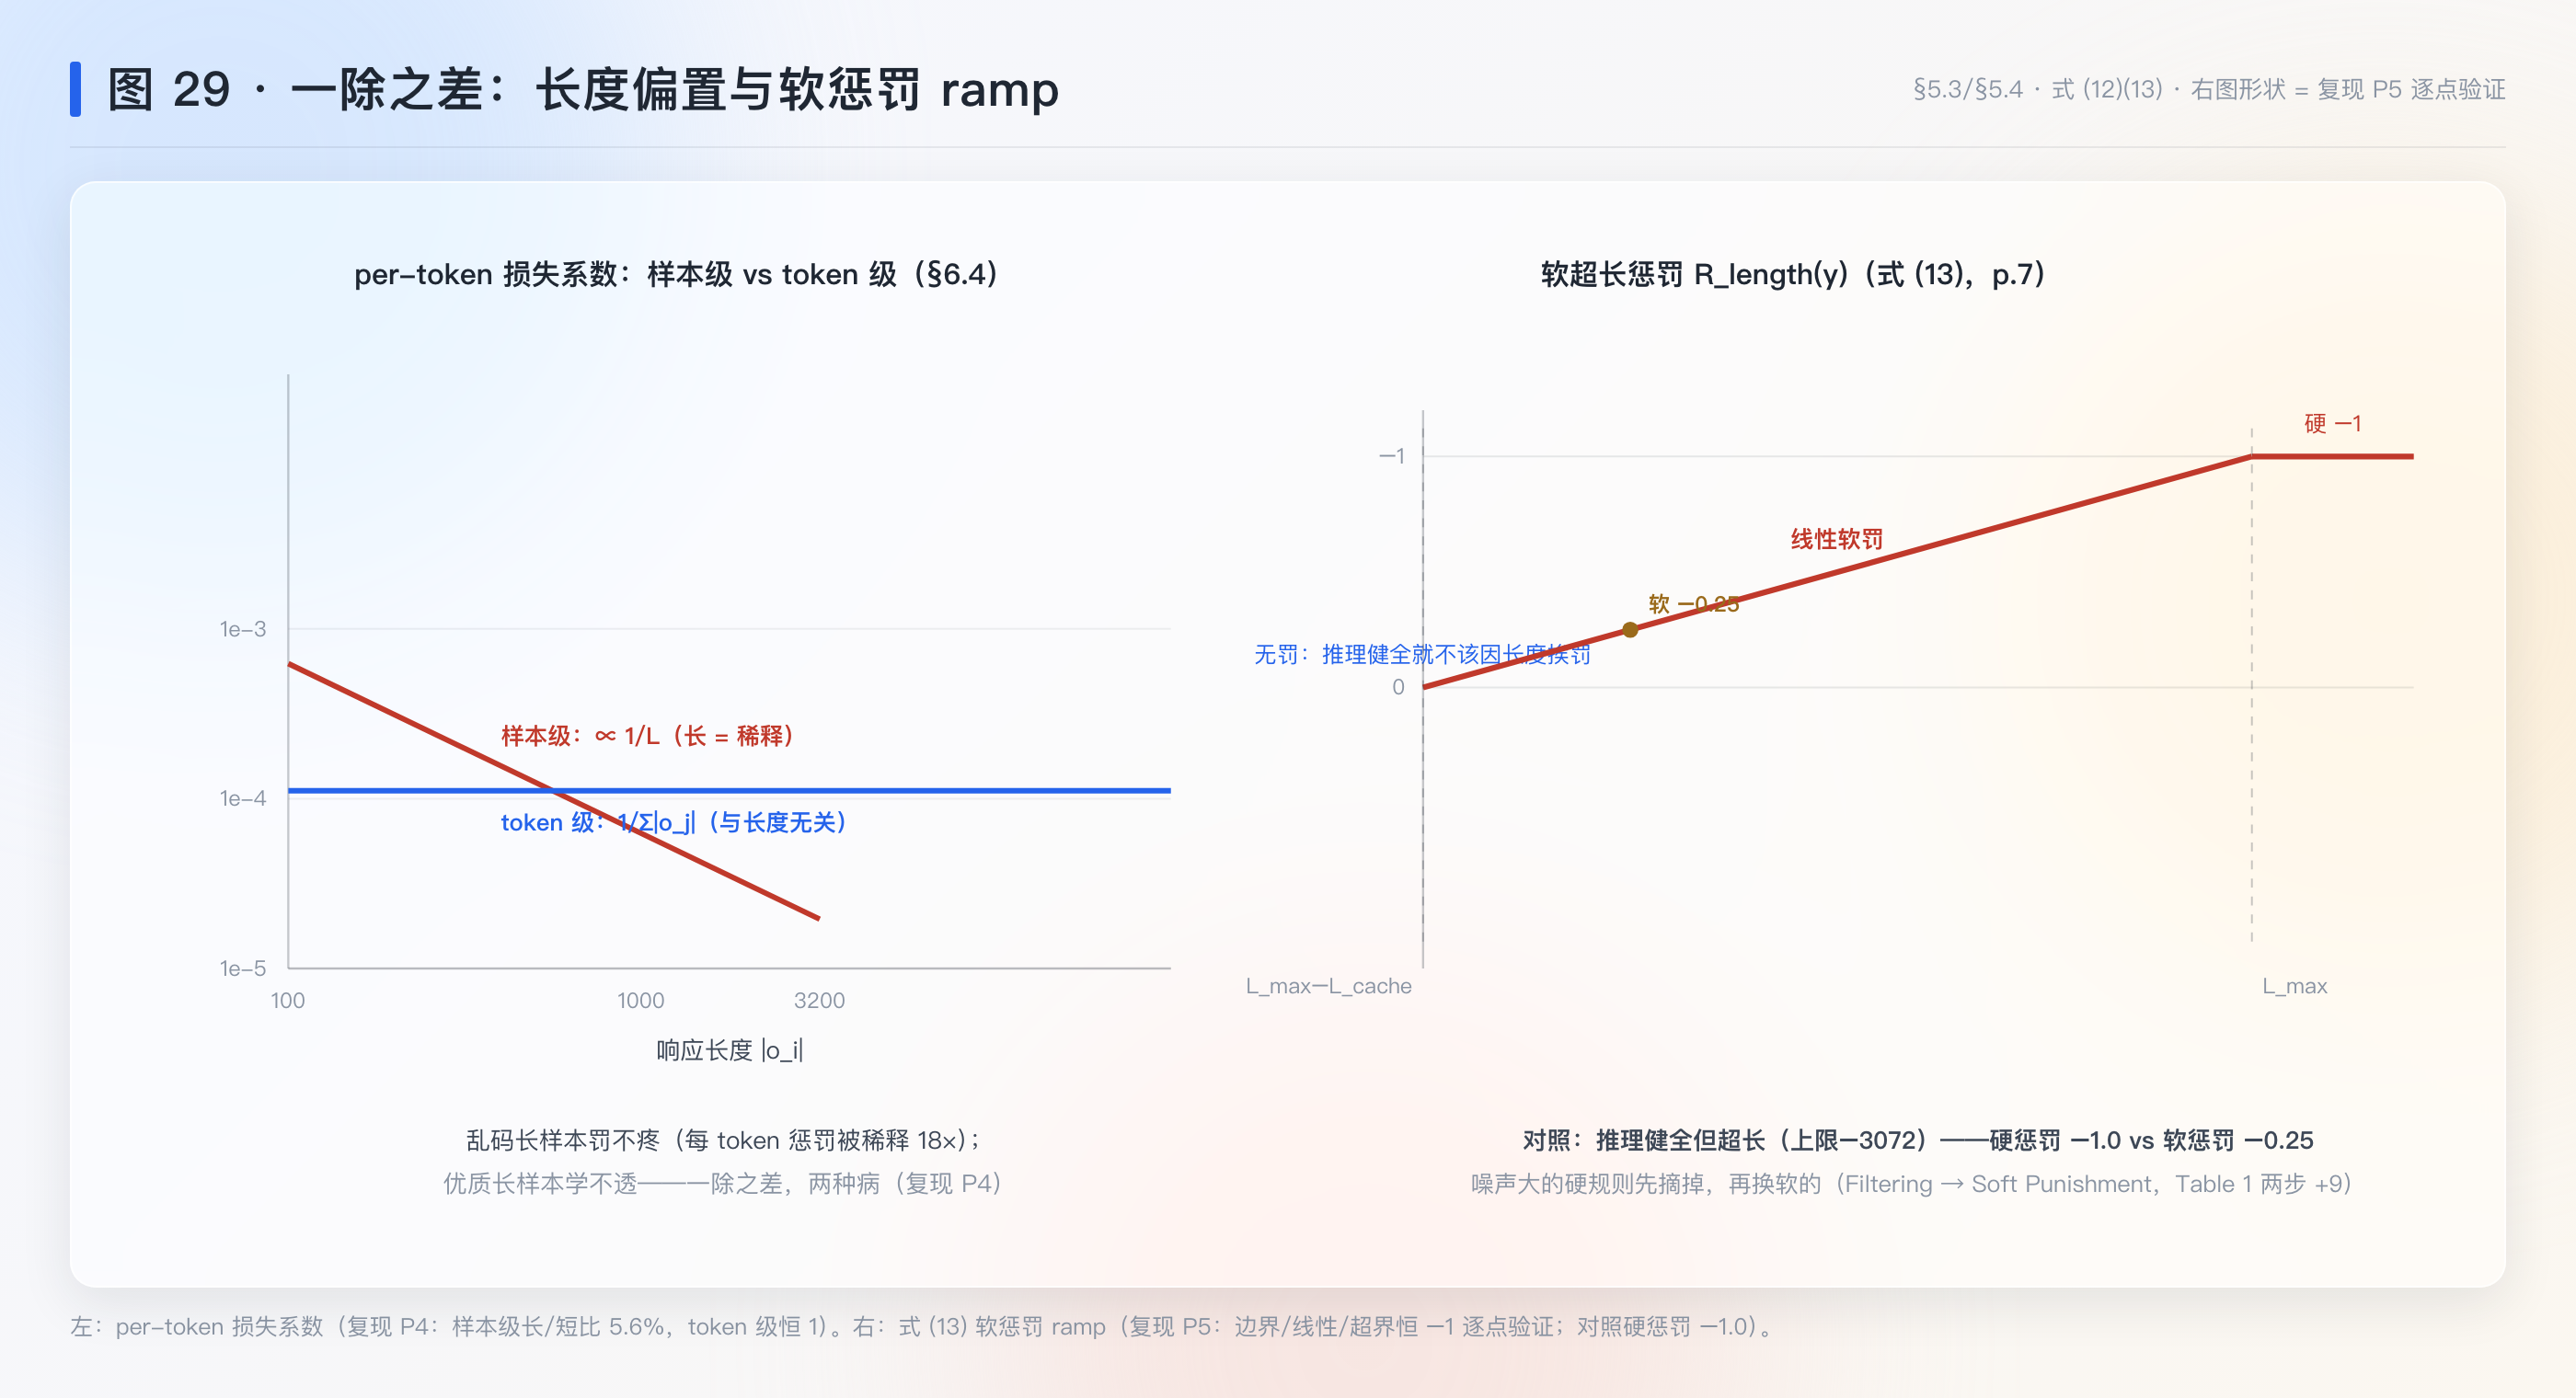
第三个病藏在”分怎么加”里。GRPO 原版的算分顺序是:先把每份答卷内部各字的损失平均一下,再把 16 份答卷的均值平均。这个”先篇内、后篇间”的顺序,让每份答卷——不管 180 字还是 3200 字——在总损失里占同样的份额。于是长答卷里的每个字,分量只有短答卷里每个字的 180/3200 ≈ 5.6%。
后果沿两个方向来(p.6):写得好的长答卷,那些值得学的推理步骤,每一步得到的强化都被稀释了,学不透;写得差的长答卷——乱码、复读——本该挨罚的每个字同样被稀释,罚不疼。两头一夹,模型会发现”把答卷写长”既不吃亏也不丢分,于是熵和长度一起病态增长(Fig 4,p.6)。
药方(式 (12),p.6):把”先篇内平均、再篇间平均”改成直接对全部字平均——分母换成整批答卷的总字数。这样一来,每个字的得失只取决于它自己,与它恰好出现在多长的答卷里无关。
5.4 机制四:Overlong Reward Shaping——截断噪声的两段处理(§3.4,p.6–7)
【类比 · 先不计分,再温和扣分】 答卷纸写满被裁掉最后一段——思路健全只因超长就打零分,学生学会的唯一教训是”写短点”,哪怕因此答错。两步修正:裁掉的部分先不计分(去掉噪声);在写满前留出一页缓冲区,越接近写满扣分越多(温和的”该收敛了”信号)。 【跨域锚点】 项目管理的软截止 vs 硬截止:deadline 前留缓冲带,逾期渐进施压而非一刀切。(类比与通识锚点,非论文内容)
第四个病出在答卷太长被裁断的时刻。训练会设一个长度上限,超出的部分直接切掉。被切断的答卷默认拿惩罚分——但一份推理完全正确、只是写得长的答卷,和一份又错又乱的答卷,拿到的是同一份惩罚分(p.6)。模型从这份反馈里分不清该戒”乱写”还是该戒”写长”:奖励信号被噪声污染了。
药方分两步(p.6–7)。第一步 Overlong Filtering:被截断的答卷整体不计入损失——先把噪声摘掉,训练立刻稳下来(Fig 5,p.7)。第二步 Soft Overlong Punishment:在长度上限之前留出一段 4096 字的缓冲区,答卷进入缓冲区后,写得越满扣得越多,线性滑向 −1(式 (13),p.7);缓冲区之内不罚。这段温和的”该收尾了”信号,让模型学会收敛而不是撞墙(Table 1 里这一步 +3 分,p.8)。
5.5 消融链与数据改造(Table 1,p.8;§3.5,p.7)
递进消融(Qwen2.5-32B,AIME24 avg@32):Naive GRPO 30 → +Overlong Filtering 36 → +Clip-Higher 38 → +Soft Overlong Punishment 41 → +Token-level Loss 42 → +Dynamic Sampling 50。最大单项是 Overlong Filtering(+6)与 Dynamic Sampling(+8)——两个”过滤噪声/零信号”的技术合计 +14 分,而三个”信号塑形”技术合计 +6。
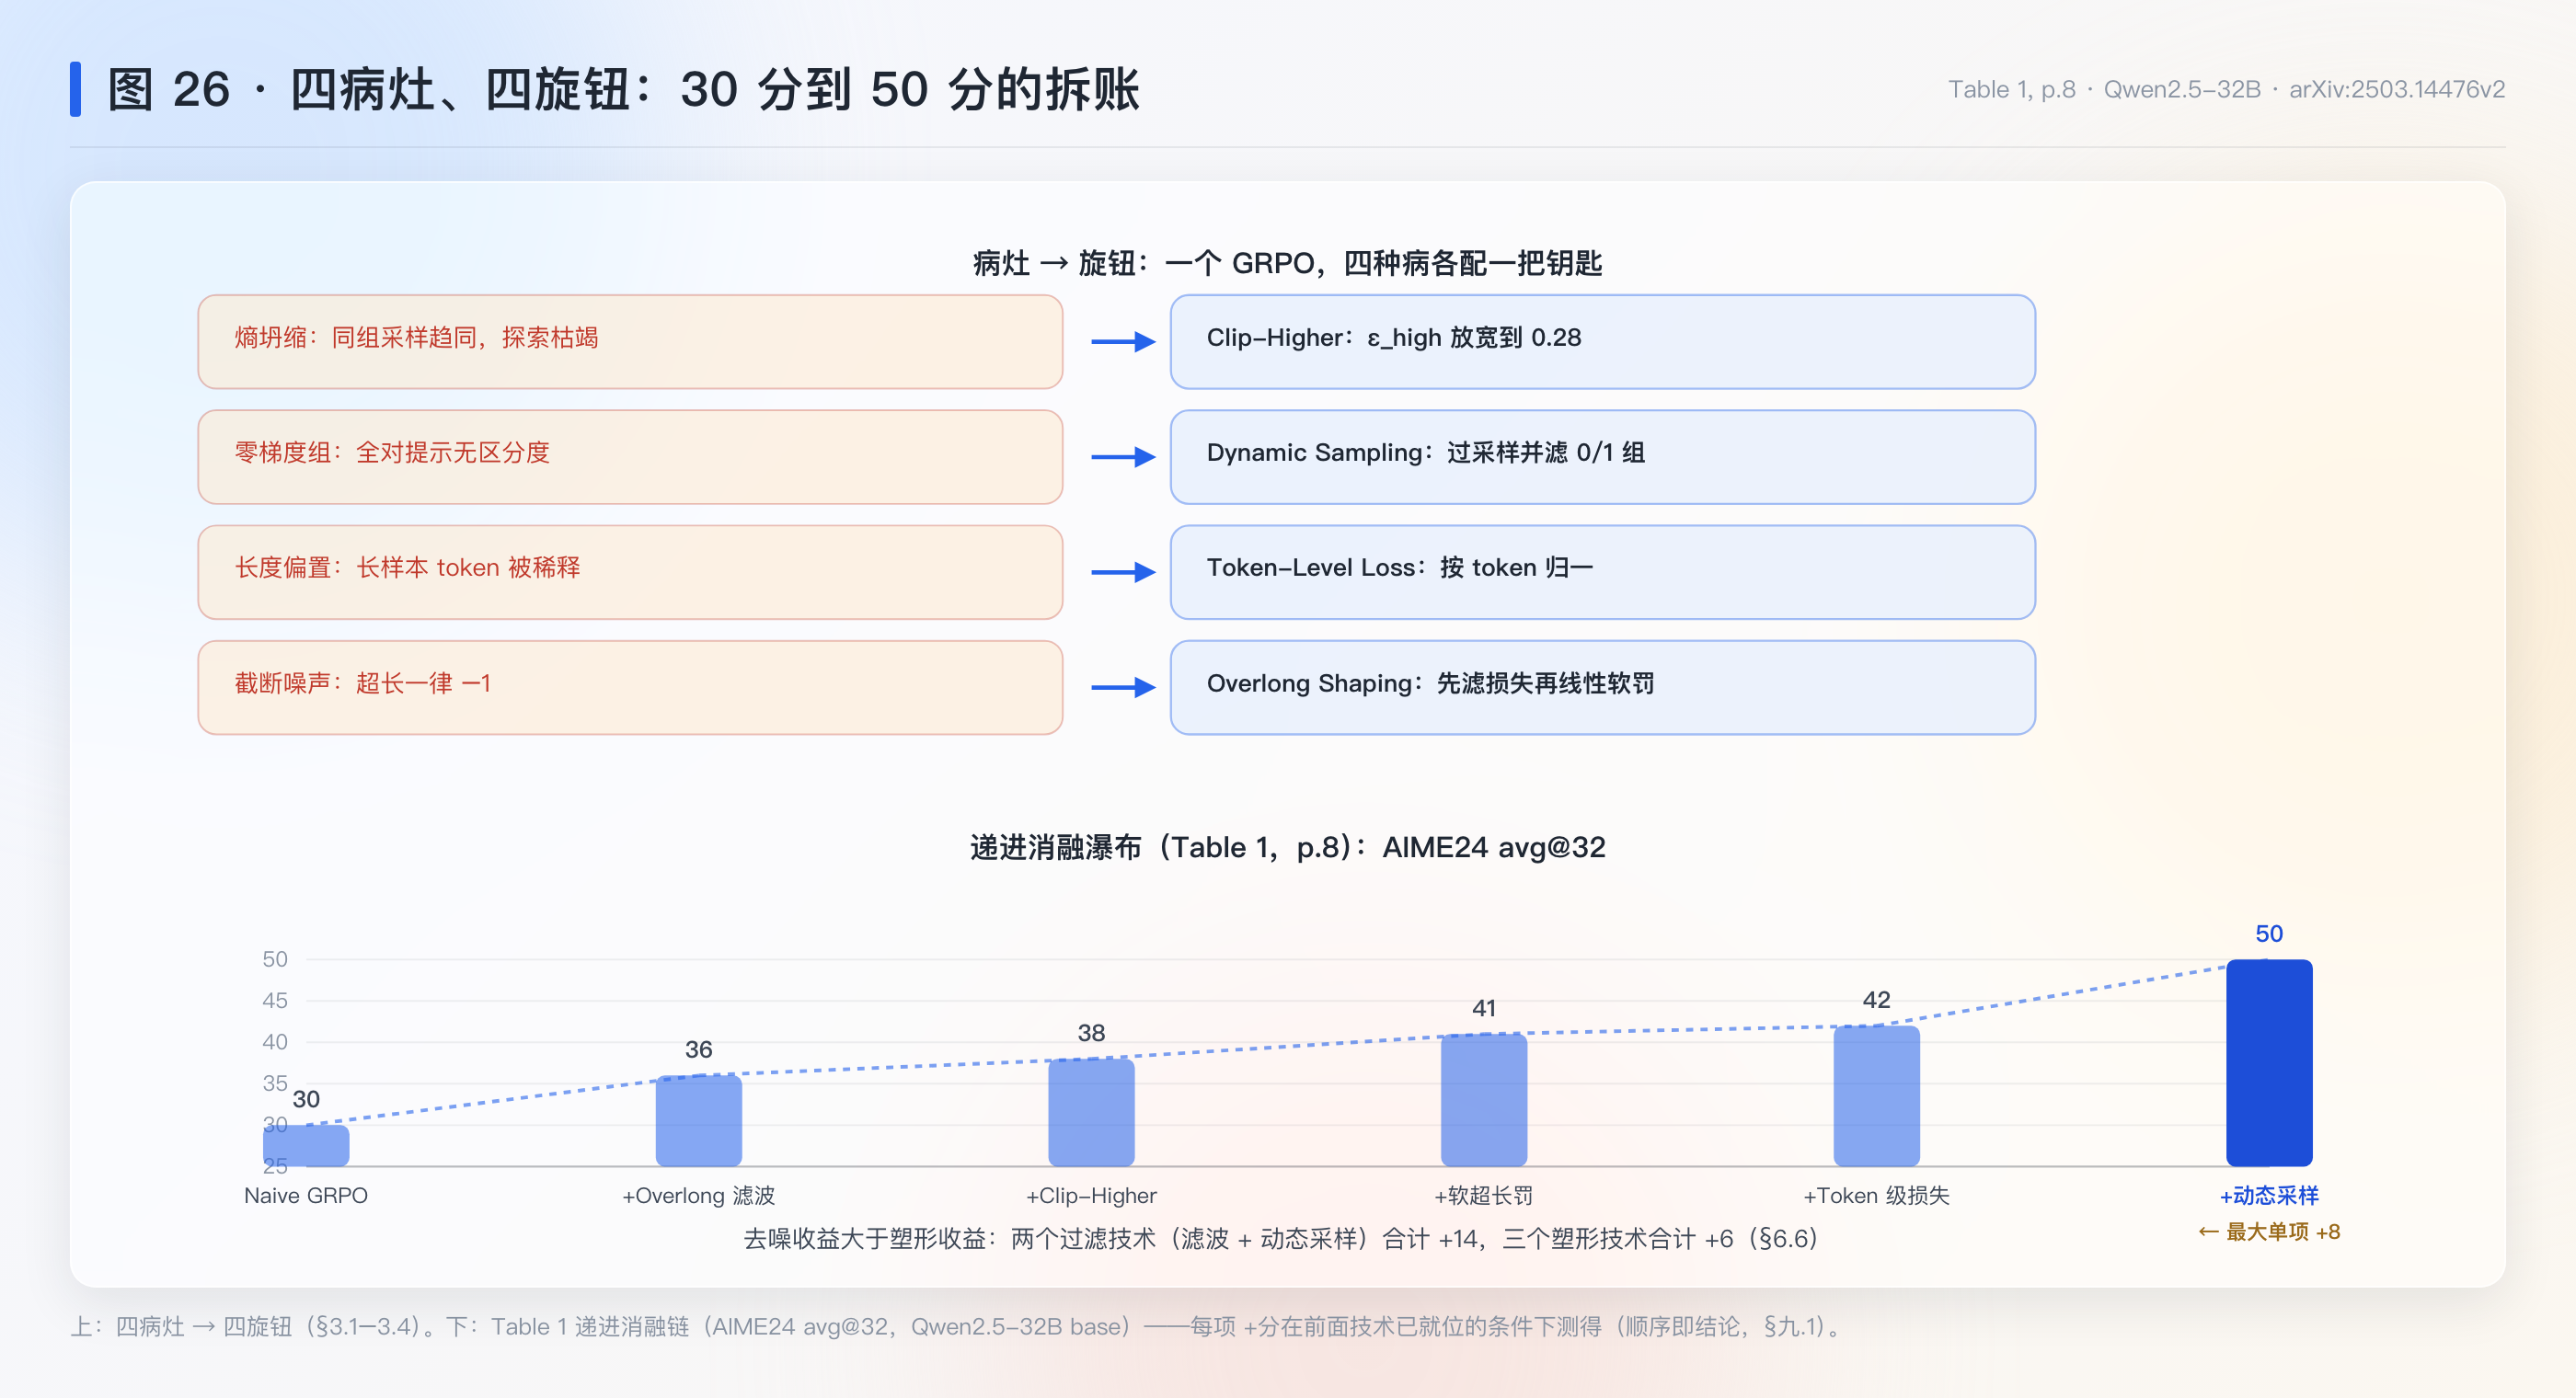
数据侧(§3.5,p.7):DAPO-Math-17K——把网页抓来的竞赛题答案统一改造成整数(仿 AIME,用 LLM 四步改写题目),规则判分只需整数比较——用数据改造降低判分器复杂度,与 ToolVerse 的答案整数化异曲同工。
5.6 训练动力学仪表盘(§4.3,p.9)
论文把四个监控指标的经验规律写成了”仪表盘”:长度(与验证准确率联用判断实验是否恶化;停滞/下降期正常存在);训练奖励(稳定上升但与验证准确率弱相关——训练集过拟合,p.9 原话:little correlation);熵(维持适中、缓慢上行有利;过低 = 探索丧失,过高 = 乱码与重复);平均生成概率(与熵反向)。意义:这是把 RL 训练从”玄学”变”仪表驾驶”的显式努力——四篇训练侧论文里第一篇把监控指标本身作为贡献写出来的。
六、数学展开
6.1 GRPO 基线与 KL 移除(式 (4)(5),p.3;§2.3)
GRPO 目标(式 (5)):clip 代理 + 直接 KL 罚 \beta D_{\text{KL}}(\pi_\theta\|\pi_{\text{ref}})。KL 罚的本职:RLHF 场景里防止策略偏离初始模型太远——对齐任务里偏离是风险。论文的移除理由(§2.3,p.3 原文):训练长 CoT 推理模型时,模型分布可以且需要大幅偏离初始模型,这个限制不必要。
这是簇内”KL 为什么关”问题的第一个正面回答(此前三篇只是关了没说)。注意论证形态:它是设计理由而非消融结论——本篇没有做 KL 系数的消融实验(§九.4)。补充:Open-Reasoner-Zero(本篇引 [14],论文参考文献)同样报告 vanilla PPO + GAE(1,1) 无 KL 足以 scale——独立佐证,转引未核对。
6.2 Clip-Higher 的机制(式 (10),p.5)
公式:
\text{clip}(\rho_{i,t},1-\varepsilon_{\text{low}},1+\varepsilon_{\text{high}})
逐符号:\rho_{i,t} 重要性比;\varepsilon_{\text{low}} 管负优势侧的下压(保持 0.2,防止把坏 token 的概率压成 0 而坍缩采样空间,p.5);\varepsilon_{\text{high}} 管正优势侧的上抬(0.28,给探索 token 留上升通道)。
为什么上界压探索(§3.1 的算术,p.4):\hat{A}>0 时策略要提升 \pi(c),clip 允许的最大提升是 \pi_{\text{old}}(c)\cdot(1+\varepsilon)——正比于旧概率。低概率的探索 token 涨幅被按比例锁死;高概率的利用 token 不受实际约束(0.9 的 token 甚至可以超过 1,即轻易到 0.999)。经验:被上 clip 的 token 平均概率 <0.2(Fig 3a)——被卡住的确实都是低概率 token。
边界:\varepsilon_{\text{high}} 不是越大越好——本篇只报了 0.28 一个值(无敏感性消融,§九.4);SimpleTIR 继承 0.28 也未扫。补充:Clip-Higher 治的是”正优势侧探索不足”,与 SimpleTIR 命题 3.1 的”负优势侧 ρ 无界”是 clip 的两侧,互不覆盖——前者关于熵,后者关于尖峰。
6.3 Dynamic Sampling 的有效批量算术(式 (11),p.5)
先看这笔账的来历。一个提示的 G 条采样全对时,组内无差异、无梯度——这组题”白考了”。全对概率随模型变强而上升,白考的组越来越多。
设单采样正确率 p(同提示下独立近似),全对概率 p^G、全错概率 (1-p)^G。有效批量占比:
\text{eff}(p)=1-p^G-(1-p)^G
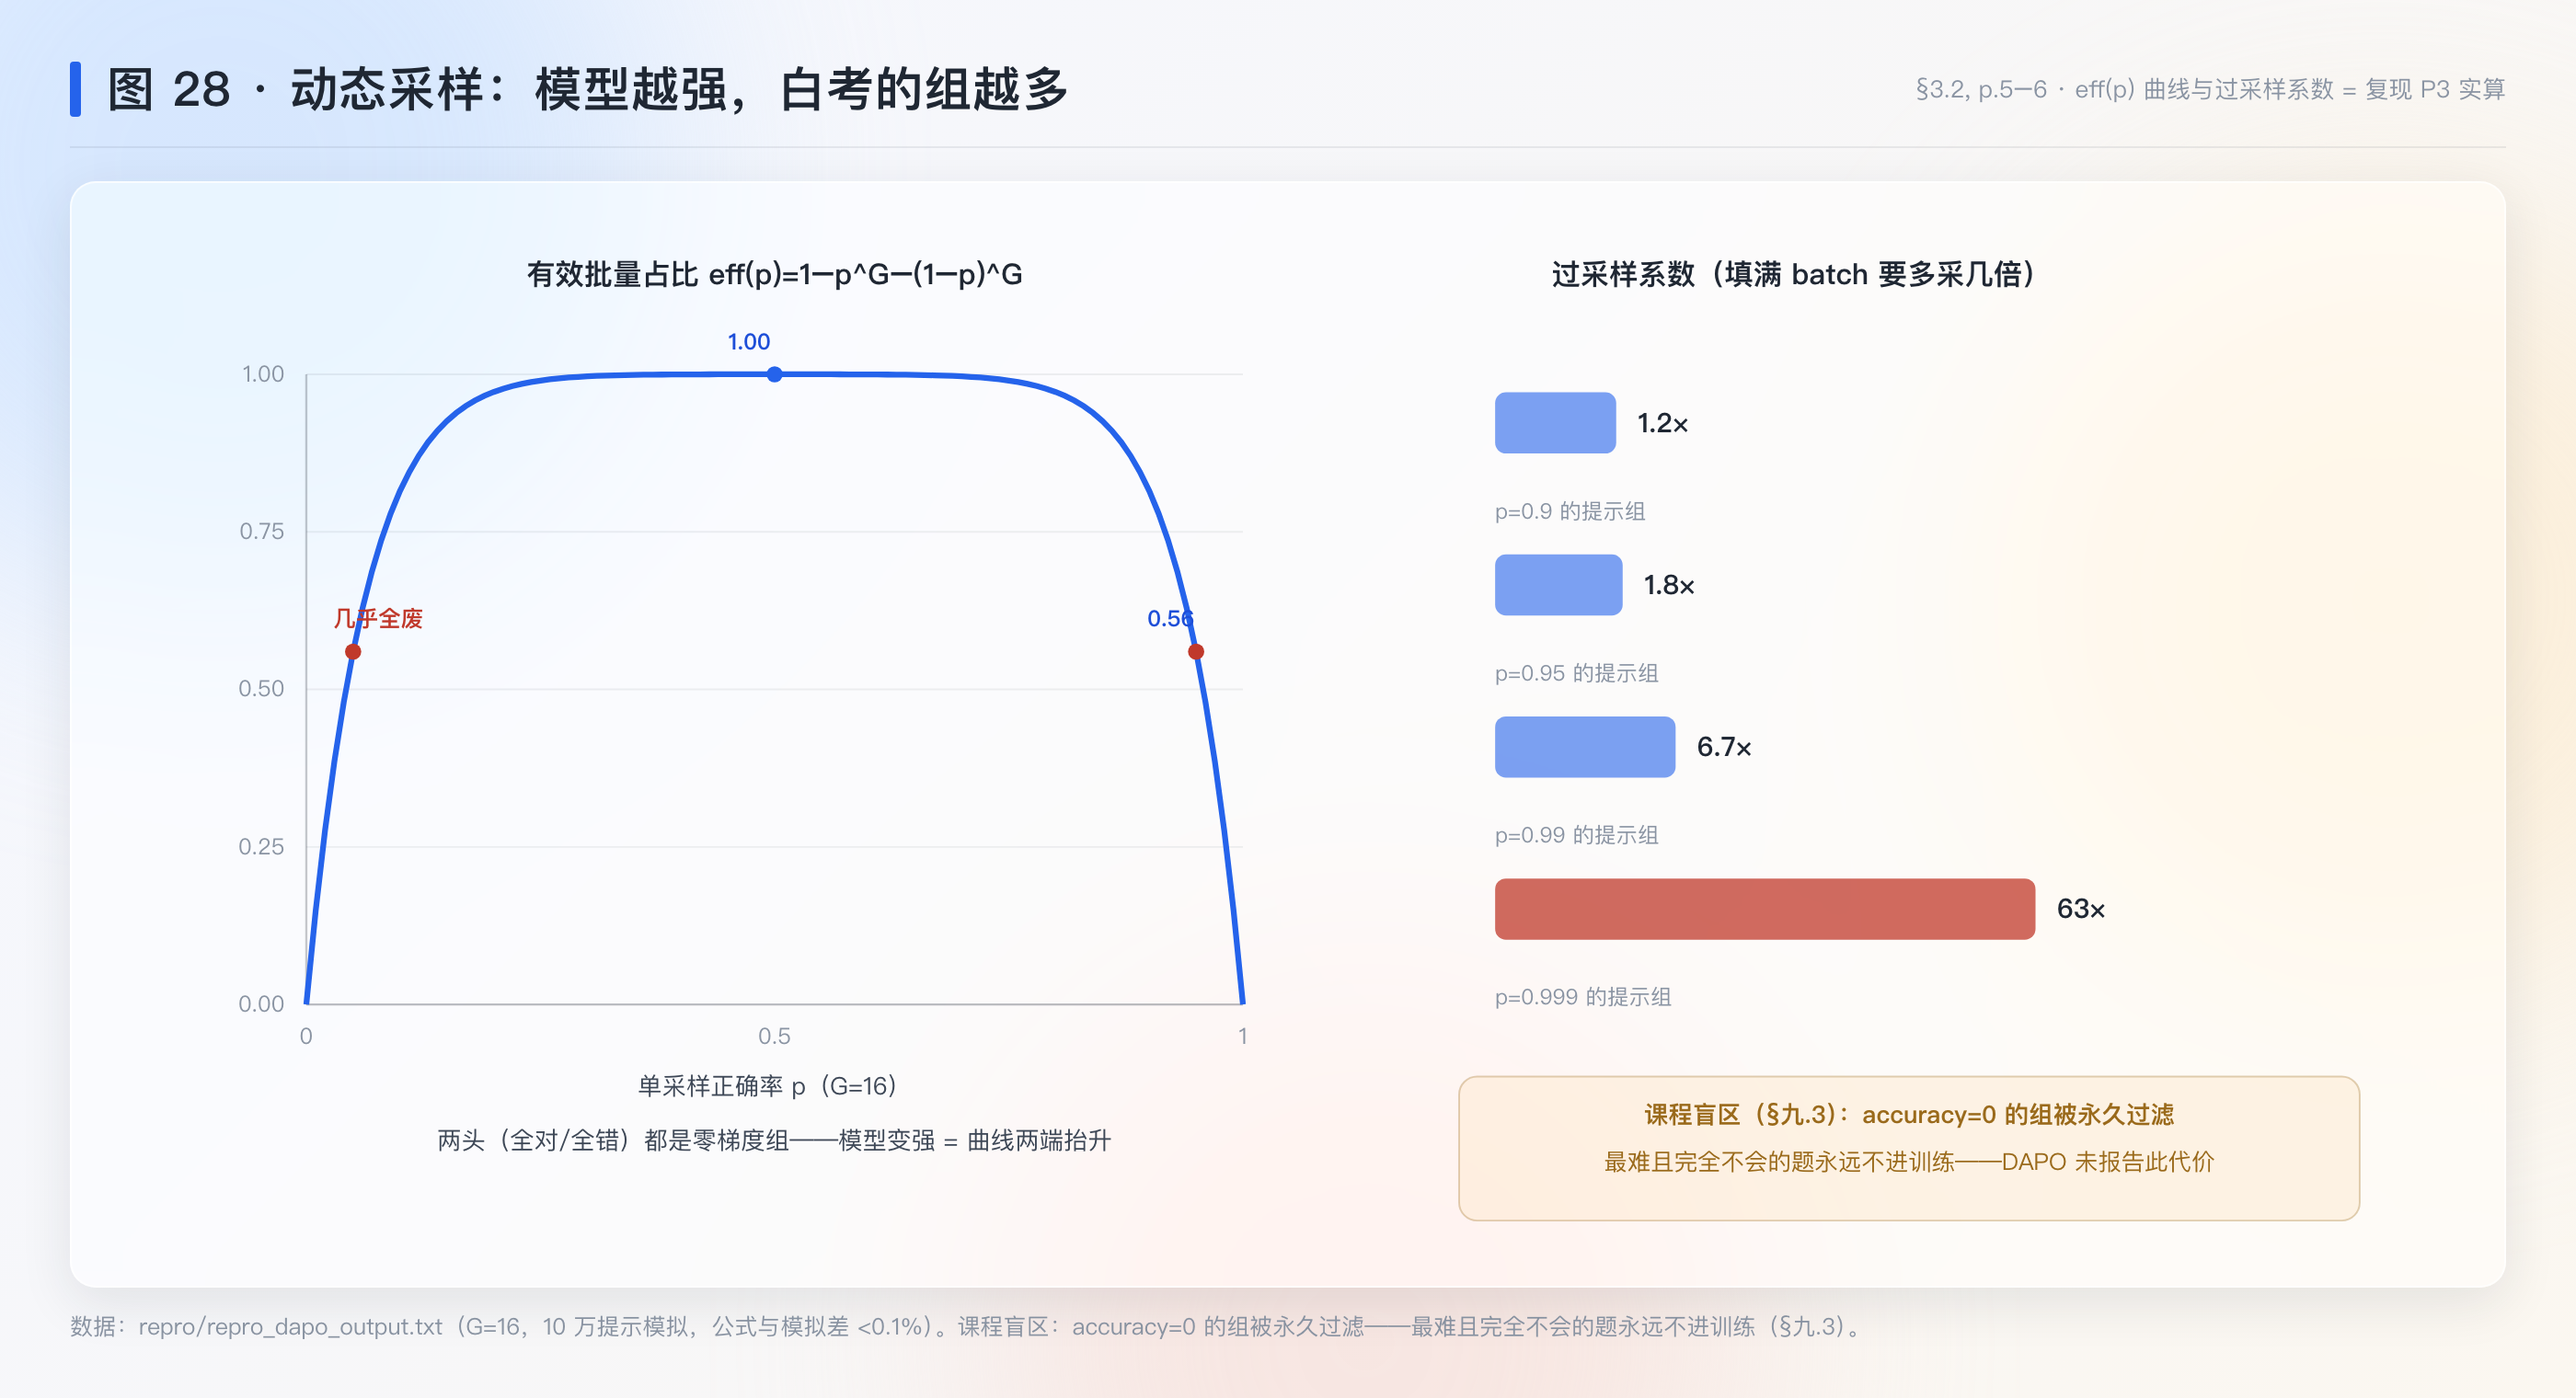
G=16 的数值例:p=0.5:\text{eff}=1-2\times(0.5)^{16}\approx 1.000(几乎无浪费);p=0.95:0.95^{16}=0.440,\text{eff}=0.560——四成组白考,过采样系数 1/0.560=1.79;p=0.99:0.99^{16}=0.851,\text{eff}=0.149——过采样系数 6.7。模型越接近题目上限,动态采样的浪费越大——这是它随训练推进成本攀升的结构性原因(论文只说”不显著影响”,未给过采样率曲线,§九.5)。
6.4 Token 级损失的系数账(式 (12),p.6)
样本级(GRPO 原版):token t(属样本 i)的损失系数 w^{\text{sample}}_{i,t}=\frac{1}{G}\cdot\frac{1}{|o_i|}。token 级:w^{\text{token}}_{i,t}=\frac{1}{\sum_j|o_j|}。
比值:\frac{w^{\text{token}}}{w^{\text{sample}}}=\frac{G\cdot|o_i|}{\sum_j|o_j|}。长样本(|o_i| 大)在样本级被压、在 token 级被还原。两个后果(p.6 原文归纳):高质量长样本的模式学习不再被稀释;低质量长样本(乱码、重复)的每 token 惩罚恢复力度——Fig 4 显示样本级下熵与长度病态增长,token 级下恢复健康。
边界:token 级让长样本整体权重变大——若长样本整体质量差,会放大噪声。论文的消融(Table 1:+42)与稳定性观察(Fig 4)支持在长 CoT 场景采用,但”长短样本质量分布”是前提,未单独消融(§九.3)。
6.5 Overlong 两段式(Fig 5,p.7;式 (13),p.7)
硬惩罚的问题:截断样本一律 -1——一个推理正确只因超长被罚的样本,与一个又错又长的样本拿同样的分,模型无从区分”该学”与”该戒”(p.6:penalized solely due to its excessive length)。
软惩罚(式 (13)):
R_{\text{length}}(y)=\begin{cases}0,&|y|\leq L_{\max}-L_{\text{cache}}\\ \dfrac{(L_{\max}-L_{\text{cache}})-|y|}{L_{\text{cache}}},&L_{\max}-L_{\text{cache}}<|y|\leq L_{\max}\\ -1,&|y|>L_{\max}\end{cases}
逐项验证边界:|y|=L_{\max}-L_{\text{cache}} 时分子为 0(无罚)✓;|y|=L_{\max} 时分子为 -L_{\text{cache}}、除以 L_{\text{cache}} 得 -1(满罚)✓;区间内线性递减 ✓。叠加规则:R_{\text{length}} 加到规则正确性奖励上——答对的超长样本净奖励 1+R_{\text{length}}\in[0,1],答错的 \in[-2,-1](补充:论文未明说叠加后的总奖励范围,这是从”added to the original rule-based correctness reward”(p.7)推出的记账,标注补充)。
消融位置:Table 1 里 Overlong Filtering(36)与 Soft Overlong Punishment(41)是两步——先摘硬规则(+6),再加软罚(+3)。软罚不是必需(Filtering 已稳),但给了模型”避免过长”的信号(p.7)。
6.6 递进消融的读法(Table 1,p.8)
30 →(OF +6)→ 36 →(CH +2)→ 38 →(SOP +3)→ 41 →(TL +1)→ 42 →(DS +8)→ 50。两个”过滤”技术合计 +14,三个”塑形/归一”技术合计 +6——去噪的收益大于塑形。边界(补充,标注推断):递进消融的顺序由作者选定,技术间交互未探(如 Clip-Higher 不叠 OF 的组合),每项的”独立贡献”严格说依赖于这个顺序。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| Zero RL 谱系 | ⚪→🟢(本篇主干) | R1 → SimpleRL → ORZ → DAPO 的谱系与各自的稳定化贡献(§5.1 转述 + SimpleTIR 篇互证) |
| KL 移除的正式理由 | 已懂(§2.3/§6.1) | RLHF 拴绑 vs 长 CoT 发散的语义差;无消融(§九.4) |
| 熵坍缩 / 熵监控 | 已懂(§5.1/§6.2) | Clip-Higher 的动机与仪表读法 |
| 动态采样 / 有效批量 | 已懂(§6.3) | eff(p) 算术复现验证 |
| 奖励噪声 / reward hacking 谱系 | 待补 | §2.4 引 reward hacking 文献群(Amodei 2016 等,论文参考文献);LLM-as-judge 审计问题的上游 |
| verl 框架 / HybridFlow | 待补(轻量) | 训练基建(引 [20]) |
| DAPO-Math-17K 数据改造 | 已懂(§5.5) | 答案整数化降判分复杂度 |
| 涌现反思行为 | 待补 | §4.4 案例研究(Table 2),无频率量化——SimpleTIR Table 3 的前作 |
标”待补”的节点会在此后的分支笔记里逐个补齐;Zero RL
谱系本篇已坐实大半,branch_zerorl.md 素材就绪。
八、扩展与发散
8.1 过滤家族的完整谱:从提示到 token 的四个粒度
发散:簇内现在有了完整的”过滤”谱系,按粒度排列——DAPO:过滤提示(全对/全错组无梯度,整组不进 batch);SimpleTIR:过滤轨迹(含 void 的轨迹有毒,整条不进更新);TARA:过滤未来信用(一致性门:未验证的步不记未来账);MT-GRPO:无过滤但按状态重采样(把不确定性摊到树里)。四者的判据也排成一个谱:DAPO 用终局正确性(最粗的 0/1)、SimpleTIR 用格式契约(void = 结构毒株)、TARA 用黄金轨迹覆盖(最细的字典级对账)。共同原则一句话:没有区分度的样本不配产生梯度——DAPO 的全对组、SimpleTIR 的毒轨迹、TARA 的未验证步,都是”零信息或负信息”的载体。
再深一层:过滤的粒度与信息的保留度成反比——DAPO 扔得最狠(整组 16 条采样全弃,其中可能有 15 条有意思的半失败),但判据最便宜;MT-GRPO 保留一切、判分最贵。这与 SimpleTIR 篇 §8.1 的”删除 vs 记账”对照合并,训练侧的处方学就完整了:先问判分器有什么,再选过滤粒度。
回到这篇:Dynamic Sampling 以 +8 分成为四技术中最大单项——粗粒度过滤的价值被消融坐实。
8.2 “KL 为什么关”结案陈词(三数据点 + 一个理由 + 一个缺口)
发散:簇内的悬案至此可以写结案陈词。数据点:ToolVerse(kl_loss=False,p.14)、MT-GRPO(β=0,E.3 p.25)、SimpleTIR(KL coeff 0,C.2 p.18)、本篇(§2.3 整节移除)。理由(本篇 §2.3):KL 的语义是”别离开对齐时的分布”,RLHF 里对齐分布就是目标分布;长 CoT 训练的目标恰恰是大幅离开——语义不匹配。佐证:ORZ 独立报告无 KL 的 vanilla PPO 可 scale(转引,未核对)。缺口:四篇都没有 KL 系数的受控消融——“关了更好”与”关了没差”未分离。结案状态:动机充分、证据为间接、受控实验缺——这是给 branch_grpo/branch_zerorl 留的实验题。
回到这篇:本篇把 KL 移除从”惯例”升格为”有理由的设计决定”,这一步的贡献大于 +几分的消融项。
8.3 熵的两头病:坍缩(DAPO)与爆炸(SimpleTIR)的对称性
发散:把两篇的病放在一起看对称美。SimpleTIR:负优势 + 低概率 token → 梯度尖峰(爆炸侧),药是删轨迹;DAPO:正优势探索被 clip 按住 → 熵坍缩(萎缩侧),药是松上界。一个管”别学坏太快”,一个管”别不敢学好”。clip 的两侧各自养出了一篇论文——这说明 PPO/GRPO 的 clip 机制在多轮/长 CoT 场景的两个方向都不够用。而 DAPO 自己也承认熵要”适中、缓慢上行”(§4.3,p.9)——中间态才是健康态,两个药各自把分布往中间推。
补充:两篇的药对彼此的病无效——SimpleTIR 的轨迹过滤不改变 clip 界(熵坍缩照旧),DAPO 的 clip-higher 不删除毒轨迹(尖峰照旧)——所以”叠加”有明确的理论动机(SimpleTIR 声称 orthogonal,本篇未测;SimpleTIR 的实验实际就叠在 DAPO 式设置上,可视为隐式叠加的实证)。
回到这篇:Clip-Higher 的贡献不是 +2 分,是指出 clip 的上界是探索预算的分配器——这个视角让”训练稳定性”从梯度层面(SimpleTIR)上升到行为分布层面。
8.4 递进消融的方法论价值与陷阱
发散:Table 1 的递进链(30→36→38→41→42→50)是”工程贡献”的标准展示法,但它有一个结构性陷阱:顺序即结论。每项技术的 +分是在”前面所有技术已就位”的条件下测的——Clip-Higher 的 +2 是在 Overlong Filtering 之上的 +2,换序可能不同(技术间交互未探)。此外单序列无重复、无置信区间(§九.2)。对比 SimpleTIR 的 Table 2(多臂对照)与 MT-GRPO 的 Table 4(组件消融),三篇的消融方法学排成一个谱:递进累加(DAPO)< 多臂对照(SimpleTIR)< 组件析因(MT-GRPO)。读消融表时先看方法学,再看数字。
回到这篇:本篇的价值排序应该是——四技术的机制解释(为什么熵坍缩、为什么零梯度、为什么长度偏置、为什么截断噪声)> 消融数字本身。机制是可迁移的,数字绑定设置。
8.5 发散收拢
拽回来:8.1 把 DAPO 放进过滤家族的提示级一格,原则是”无区分度不产生梯度”;8.2 给 KL 悬案写结案陈词(动机充分、受控实验缺);8.3 发现 clip 两侧各养一篇论文(熵坍缩 vs 梯度爆炸)且药方正交可叠加;8.4 提醒递进消融的顺序陷阱、把本篇的价值锚在机制解释上。训练侧四篇的地图至此完整:奖励粒度(TARA)→ 优势粒度(MT-GRPO)→ 样本毒性(SimpleTIR)→ 系统工程(DAPO),下一格是判分器本身(LLM-as-judge 审计)。
九、局限与可疑处
- 递进消融的顺序依赖:Table 1 各技术按累加顺序测贡献,交互效应未探(§8.4);单序列、无重复、无置信区间。
- AIME24 集小且单一:30 题、avg@32 缓解但粒度仍粗;主结果只有一个基准(Math500/AMC 等在 SimpleTIR 篇有、本篇正文未列全表——v2 的精简)。DeepSeek-R1-Zero 的 47 分为转引(其论文口径)。
- Dynamic Sampling 的过采样率未报告:只说训练时间”不显著受影响”(p.6)——过采样倍数、被过滤提示的题材分布、以及”接近上限的题目是否被系统性排除”(dynamic sampling 可能悄悄丢掉最难的题)均无数据。补充推断:accuracy=0 的组被永久过滤,意味着模型完全做不出的题永远得不到训练——课程盲区。
- KL 移除无消融:移除理由是定性的(§2.3),无 β 扫描;“关了没差”与”关了更好”未分离(§8.2 结案陈词的缺口)。
- Clip-Higher 无敏感性扫描:\varepsilon_{\text{high}}=0.28 单点;放宽多少会引入乱码/重复(过度探索)未知。
- 32B 单一规模:主结果只在 Qwen2.5-32B;7B 上四技术是否同向未见(SimpleTIR 补了 7B,本篇未补)。
- 训练奖励与验证弱相关(p.9 自述训练集过拟合)——动态采样只保”有梯度”,不保”梯度指向泛化”;过拟合问题被承认为监控项而非被解决。
- 答案整数化(§3.5):DAPO-Math-17K 全部整数答案——判分器简化与任务族收窄的交换,非整数答案的题型被排除在外(与 ToolVerse 的 MCP 选择同款交换)。
十、验证结果(最小复现)
10.1 范围声明
论文的 RL 训练主张(Table 1 的 30→50)需要 verl + 大规模 GPU,不可最小复现,论文数字只作引用并注明出处。本复现是核心思想的最小演绎:四技术各自的机制算术——clip 天花板(§6.2)、零优势组的有效批量(§6.3)、两种损失归一化的系数账(§6.4)、软惩罚的 ramp(§6.5),全部纯 CPU 精确算术。
10.2 可证伪预测与判据(运行前写下)
- P1(clip 天花板算术):\varepsilon=0.2、\hat{A}>0 时,\pi_{\text{old}}=0.01 的最大 \pi_\theta=0.012、\pi_{\text{old}}=0.9 的最大 \pi_\theta=1.08(论文 p.4 原例);Clip-Higher 后 \varepsilon_{\text{high}}=0.28 的对应值 0.0128 / 1.152。判据:逐点相等(<10^{-12})。
- P2(clip 的相对性):clip 是乘法约束——低概率 token 的最大绝对增量(\pi_{\text{old}}\cdot\varepsilon)与 \pi_{\text{old}} 成正比。判据:\pi_{\text{old}}\in\{0.01,0.1,0.5,0.9\} 的绝对增量严格递增,相对增幅恒为 \varepsilon。
- P3(零优势组与有效批量):\text{eff}(p)=1-p^G-(1-p)^G(G=16):p=0.5 时 \text{eff}>0.99;p=0.95 时 \text{eff}=0.560(过采样系数 1.79);p=0.99 时 \text{eff}=0.149(系数 6.7)。判据:模拟(10 万提示)与公式差 <0.5\%。
- P4(两种损失归一化的系数账):G=16、长度 \{3200,180,\dots\} 的组:样本级下长样本每 token 系数 = 短样本的 180/3200;token 级下两者相等。判据:程序化计算两条比值,样本级比值 <0.06、token 级比值 =1(<10^{-12})。
- P5(软超长惩罚的 ramp):式 (13) 在 |y|=L_{\max}-L_{\text{cache}} 处为 0、|y|=L_{\max} 处为 −1、区间内线性、区间外恒 −1。判据:5 个边界与单调性断言全过。
10.3 运行结果
脚本 repro/repro_dapo.py(纯
Python 标准库),真实输出 repro/repro_dapo_output.txt。13
PASS / 0 FAIL(一次中途崩溃系测试自身笔误:P4
的比值写反、P5 的单调性检查把元组传入函数并把恒 −1
段也纳入严格递减——两处均为测试代码问题,修正后全过):
- P1 过:clip 天花板逐点复现论文原例(\varepsilon=0.2:0.01\to 0.012、0.9\to 1.08,p.4);Clip-Higher 后(\varepsilon_{\text{high}}=0.28)对应 0.0128 / 1.152。并验证:探索 token(P=0.01)的绝对增益 +0.0028 仍只有利用 token(P=0.9)增益 +0.252 的约 1/90——乘法天花板对探索的压制在放宽后依旧存在,只是缓解。
- P2 过:\pi_{\text{old}}\in\{0.01,0.1,0.5,0.9\} 的绝对增量严格递增(0.002\to 0.18),相对增幅恒等于 \varepsilon=0.2——“clip 是乘法约束”的直接证据。
- P3 过:G=16 时 \text{eff}(p) 公式与 10 万次模拟差 <0.1\%;过采样系数攀升 p=0.9\to 1.2\times、0.95\to 1.8\times、0.99\to 6.7\times、0.999\to 63\times——课程盲区的定量形状(§九.3):模型越接近题目上限,为填满 batch 需要的浪费越大。
- P4 过:长度组 \{3200,180,400\times 14\} 下,样本级长样本每 token 系数只有短样本的 5.63\%(=180/3200);token 级严格拉平(比值 =1)。长度偏置的定量形状。
- P5 过:式 (13) 的 ramp 逐点验证(起点 0、终点 −1、线性、超出恒 −1);对照实验:推理健全但超长(上限−3072)的样本,硬惩罚 -1.0 vs 软惩罚 -0.25——软罚保留 75% 的信用。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 clip 天花板 | 逐点相等(论文原例 + Clip-Higher) | 支持 |
| P2 clip 相对性 | 绝对增量递增、相对增幅恒 ε | 支持 |
| P3 零优势组 | eff(p) 公式 = 模拟;过采样系数攀升 | 支持(p=0.999 时 63×) |
| P4 损失归一化系数账 | 样本级稀释至 5.6%;token 级拉平 | 支持 |
| P5 软超长 ramp | 边界/线性/超界恒 −1;软罚保留信用 | 支持(−0.25 vs 硬罚 −1.0) |
边界重申:以上支持的是四技术的机制算术;训练增益主张(Table 1 的 30→50)仍只有论文自报证据,且带 §九.1–2 的递进消融与无区间问题。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 解耦超参归因修复(decoupled-hyperparameter fix)
- 层级:L1
领域具体(训练机制修复)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md)。 - 操作定义:训练出问题先做归因手术,再动刀——“探索不足”被定位到 clip 单界(低概率 token 的最大绝对增量 \pi_{\text{old}}\cdot\varepsilon 随 \pi_{\text{old}} 缩小而缩小,复现 P2 乘法相对性),修复不是调大 \varepsilon(会连累高概率侧)而是解耦上下界(Clip-Higher,\varepsilon_{\text{high}}=0.28)。消融链(§5.5,Table 1)逐机制叠加验证各自贡献。
- 迁移去向:①一切”症状-机制”修复:先证明症状由该参数唯一携带,再单独动它;②超参治理:一个旋钮一个职责,耦合旋钮的调参是噪声源。
- 失效边界:解耦的收益以消融为证——消融缺位的解耦只是把耦合换成了两个新耦合;症状可能由多机制联合导致,逐个解耦后仍需合体验证。
- 方法卡:
notes/method_decoupled_hyperparameter_fix.md(L1)
11.2 零信号组过滤(zero-signal group filtering)
- 层级:L1 领域具体(RL 数据卫生)。同族:SimpleTIR 一票否决过滤(上篇 §11.1)——本卡是其温和变体的首例。
- 操作定义:全对/全错的提示组内优势恒为零、不产出梯度,等于白烧算力——过采样后把零信号组滤掉,有效批量 \text{eff}(p)=1-p^G-(1-p)^G(复现 P3:p=0.99 时 eff 仅 0.149,过采样系数 6.7)。滤的是”无差异”,不是”错误”——与一票否决的分工:无信号则弃,有信号但坏则改。
- 迁移去向:①采样效率审计(任何组式对比方法先算 eff(p) 曲线);②评测实验的样本设计(方差为零的对照对没有信息量)。
- 失效边界:过滤改变提示分布(难例被过采样放大),对训练分布的影响要显式监控;p 动态漂移时过滤阈值要跟分布走。
- 方法卡:
notes/method_zero_signal_filter.md(L1)
11.3 方法依赖
本篇产出 L1 两张(解耦超参归因修复 / 零信号组过滤),前者挂 MATTRIB;另有软罚 shaping(截断两段处理,替代硬截断噪声)与 Token-Level Loss 两个机制,手艺同族但暂不单独立卡,攒实例。四机制的”机制分解归因”整体是 MATTRIB 的训练域范例。
十二、没搞懂的地方(未攻克登记)
- Dynamic Sampling 的课程盲区:accuracy=0 的提示被永久过滤——最难且模型完全不会的题永远不进训练。是否需要”难例回灌”机制?补齐时机:读 DAPO 后续(DAPO-Math-17K 的 v2 数据工作)与 curriculum RL 文献。
- 过采样倍数与算力账:过滤率随模型变强的曲线(§6.3 的 eff(p))论文未给——真实系统的过采样倍数是保密的还是确实不高?补齐时机:verl 仓库的 dynamic sampling 实现与日志。
- KL 关闭的受控消融:四篇全关、动机一致,但无人做 β 扫描。补齐时机:branch_grpo/branch_zerorl 的第一个实验题。
- \varepsilon_{\text{high}} 的上界:0.28 之后再加会怎样(过度探索的定量边界)?无扫描。
- 递进消融的换序矩阵:六种配置的全因子(或至少部分因子)实验——技术间有无负交互?
- 训练奖励与验证弱相关(p.9):过拟合发生在什么维度(题目记忆 vs 格式过拟合)?与 SimpleTIR 十二.2 的”黄金轨迹错误率”、MT-GRPO 十二.4 的”judge 误差率”同属判分质量簇。
十三、可信度
- A 级(论文原文转录,逐页核对):全部页码引用、式 (1)–(13)、Algorithm 1、Table 1、四技术数值(clip 例、L_{\max}/L_cache、超参)。
- B 级(论文自报实验,无法独立验证):Figure 1–7 曲线、Table 1 递进消融、Fig 6 动态采样收敛;已注:递进顺序、无方差、AIME 30 题。
- C 级(我的推导 + 将由复现程序化验证):§6.2 clip 乘法天花板、§6.3 eff(p) 算术、§6.4 系数账、§6.5 ramp 边界。
- D 级(我的推断,标注于正文):§6.5 总奖励范围推断、§6.6 顺序依赖陷阱、§8.1 过滤家族谱系、九.3 课程盲区。
- 横向核实初核(2026-09-04):版本 v1+v2 已核(diff 未做);工件:verl 全开源(论文标注 + abs 页确认),repo 深查未做;第三方未细查;统计审查未跑(AIME 30 题 avg@32 的二项区间待算——粗算 ±8-9pp@1σ,50 vs 47 的 3 分差距在单题粒度内,值得警惕)。