外行导读(先读这个,再决定要不要进正文)
一个场景:让一个没调教过的基座模型边推理边写代码、跑代码、读结果再接着推理,用强化学习直接把它训成”会自己用工具的解题者”——听起来顺理成章,实际训起来却会周期性崩溃:梯度爆炸、曲线剧烈震荡,最终成绩甚至不如干脆不挂工具。业界的补救是先拿示范数据”冷启动”再训,能稳下来,但模型从此被锁死在示范的套路里,学不出多样的解法。
这篇论文干的事:先当医生,把崩溃的因果链查清楚——工具反馈是模型预训练时没见过的输入,会诱发低概率 token;低概率 token 被拼进下一轮输入,又引发更多低概率 token,逐轮复合,最后在梯度上表现为爆炸。再开药,药方极简:不调参数、不改算法,只加一条样本规则——凡是含有”零进展轮”(某一轮既没有完整代码块、也没有最终答案)的轨迹,整条从策略更新里剔除。一步同时掐断两处病灶:梯度爆炸,与”早轮正确、晚轮连坐”的信用错位。
为什么值得关心:凡是要靠反馈迭代改进的系统,都可能被反馈本身污染——反馈落在系统原有分布之外,脏东西会顺着迭代被放大,直到系统崩掉。这篇给了一条通用的处置原则:与其驯化污染样本,不如用一个结构性的、不需要调阈值的判据把它们识别出来,整块除名。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| TIR | Tool-Integrated Reasoning,边推理边写代码、执行、读结果再推理的做题方式 |
| Zero RL | 不给示范答案,让基座模型直接从对/错反馈里自己摸索 |
| SFT 冷启动 | 先用示范数据教模型基本套路,再开始强化学习 |
| 基座模型 | 只做过预训练、没做过指令微调的原始模型 |
| OOD | 分布外:输入落在模型预训练时没见过的区域 |
| void turn | 一轮响应里既没有完整代码块也没有最终答案——“这一轮零进展” |
| 轨迹 | 一道题从头到尾的完整过程:各轮输出、工具反馈与最终答案 |
| 反馈掩码 | 训练时给 token 打的记号:环境反馈的部分不计入损失 |
| 重要性比 | 新旧策略对同一个 token 的概率之比,相当于更新步子的”汇率” |
| 梯度爆炸 | 单次更新的推力突然变得巨大,训练曲线剧烈震荡直至崩溃 |
§0 承接栏
这一课接着前几篇攒下的悬案往下讲。训练侧的论文读到这儿,账面上已经治了两件事:TARA 和 MT-GRPO 把”中间步骤没账”治成了 turn 级记账,DAPO 把工程旋钮打包调优。但 DAPO 留下一个它没有触及的根本问题:多轮工具调用训练为什么总是崩溃? 旋钮拧得再准,回答的也只是”怎么调”,不是”为什么崩”。这篇来还这笔账:它把诊断推进到更深的层次——训练崩溃的根源不是评分公式不够好,而是工具反馈本身在毒化模型,并给出完整的因果链:工具反馈不在模型的预训练分布里 → 引发低概率 token → 逐轮复合 → 梯度爆炸。处方也极简:把含”零进展轮”的轨迹整条从训练批里删掉。到这里,训练侧四篇连成一张完整的图:同一个病(多轮 RL 不稳定),三种药(删毒轨迹 / 重采样记账 / 工程旋钮打包),外加一张粒度表。
一、论文在解决什么问题
1.1 一个具体场景
你拿 Qwen2.5-7B 的基座模型(未做任何指令微调)直接用 RL 训练多轮数学解题:模型写推理 → 生成 Python 代码 → 沙盒执行 → 读结果 → 继续推理 → 给最终答案。期望它学会先算后答。实际发生的事(Figure 1,p.2;Figure 2,p.5):朴素的多轮训练梯范数周期性爆炸、曲线剧烈震荡,最终成绩还不如不做工具调用的文本-only 基线(DAPO);更有意思的一个数字——直接给基座模型挂 TIR 提示不训练,AIME24 从 3.2 掉到 1.7(Table 1,p.7):工具反馈本身就毒害基座模型的输出。
业界的标准补救是 SFT 冷启动:先教模型”怎么用工具”再 RL。这确实稳(ReTool-32B 的 AIME24 到 67.0,p.7),但论文的立场是:冷启动把行为锁死在示范数据里,牺牲了 Zero RL 最值钱的东西——涌现的、多样的问题解决策略(§1,p.1–2;§4.4,p.10)。
1.2 诊断链:从工具反馈到梯度爆炸
论文的因果链有四环(§3.1–3.2,p.4–6),每一环都有证据:
- 反馈是 OOD 的:工具输出来自外部解释器,不在模型预训练分布里。Fig 3(p.5)的案例:早期 turn 的工具反馈里出现概率极低的 token。
- 掩码不够:业界惯例是反馈 token 不计损失(feedback token masking)——但这只挡住了反馈本身,挡不住它引发的生成漂移:模型自己在 Turn 2、Turn 3 的文本里开始出现低概率片段(Fig 3)。
- 逐轮复合:低概率 token 被拼进下一轮输入,漂移加剧;到 Turn 4 崩成无意义文本、token 概率极低(Fig 3)。
- 在梯度上爆炸:对 logits 的梯度范数有两个随 token 概率下降而增大的主导项(命题 3.1,p.5——§六 全推导),表现为训练中的梯范数尖峰(Fig 1 右、Fig 2)。
1.3 与前两篇的入口差
三篇训练侧论文共享同一个现象学起点”多轮 RL 不稳定”,处方各不相同:MT-GRPO 说”优势粒度太粗,按状态重采样”;TARA 说”逐 turn 对账,配一致性门”;本篇说”别记账了,把带毒的轨迹整条删掉”。更细的对照在 §八。这里先记一个位置差:前两篇的病在信用分配(功劳算不清),本篇的第一病灶在梯度动力学(坏 token 掀桌子)——信用错位是它的第二病灶(§3.2,p.6)。
二、核心想法
一句话:多轮 TIR 的崩溃根源是工具反馈诱发的低概率 token 逐轮复合;与其给坏样本记账,不如把带毒样本(含 void turn 的轨迹)整条从策略更新中剔除——一步同时掐断梯度爆炸和信用错位。
这个论断初听有点鲁莽——前两篇都在把账记细,这篇偏偏要把整份账本扔掉?但往深一层想,它踩中的是一个更朴素的事实:账目再细,也只对”值得改的卷子”有意义。一份卷子要是后半段已经写疯了,把它放进改卷堆里,非但改不出东西,还会让”改卷”这个动作本身抖起来。
先打个比方。一个学生做题,中途查了一次字典,回来之后开始说胡话(OOD 漂移),越说越乱,直到交白卷。现在这份卷子要批改:“前半段的漂亮推理”和”后半段的胡话”被同一个低分捆绑着批改——改卷的损失函数会连前半段一起罚;更糟的是,那些胡话片段会让”改这一笔”这个动作本身产生巨大震荡。最干净的处理不是细改,而是:这份卷子不进改卷流程。
再把比方译回工程语言。怎么识别”会说胡话的卷子”?不需要读内容评好坏——找一个结构性毒株标记:某一轮既没有完整代码块也没有最终答案(void turn,“这一轮零进展”)。它是漂移的高信噪比症状:好轨迹里罕见、坏轨迹里常见(§3.3,p.6)。
落到形式上:对每条轨迹 o_i,若 \exists k,turn k 的输出 l_k 既无代码块也无最终答案,则掩码 m_{i,t}=0\ \forall t——该轨迹不产生任何梯度(§3.3,p.6)。
所以这篇把问题重新形式化成了什么:把”多轮 RL 不稳定”从调参问题(阈值、clip、KL 权重)重构为样本选择问题——与其驯化毒样本,不如识别并除名毒样本。识别靠格式契约(结构性的 void 判据),不靠概率阈值。
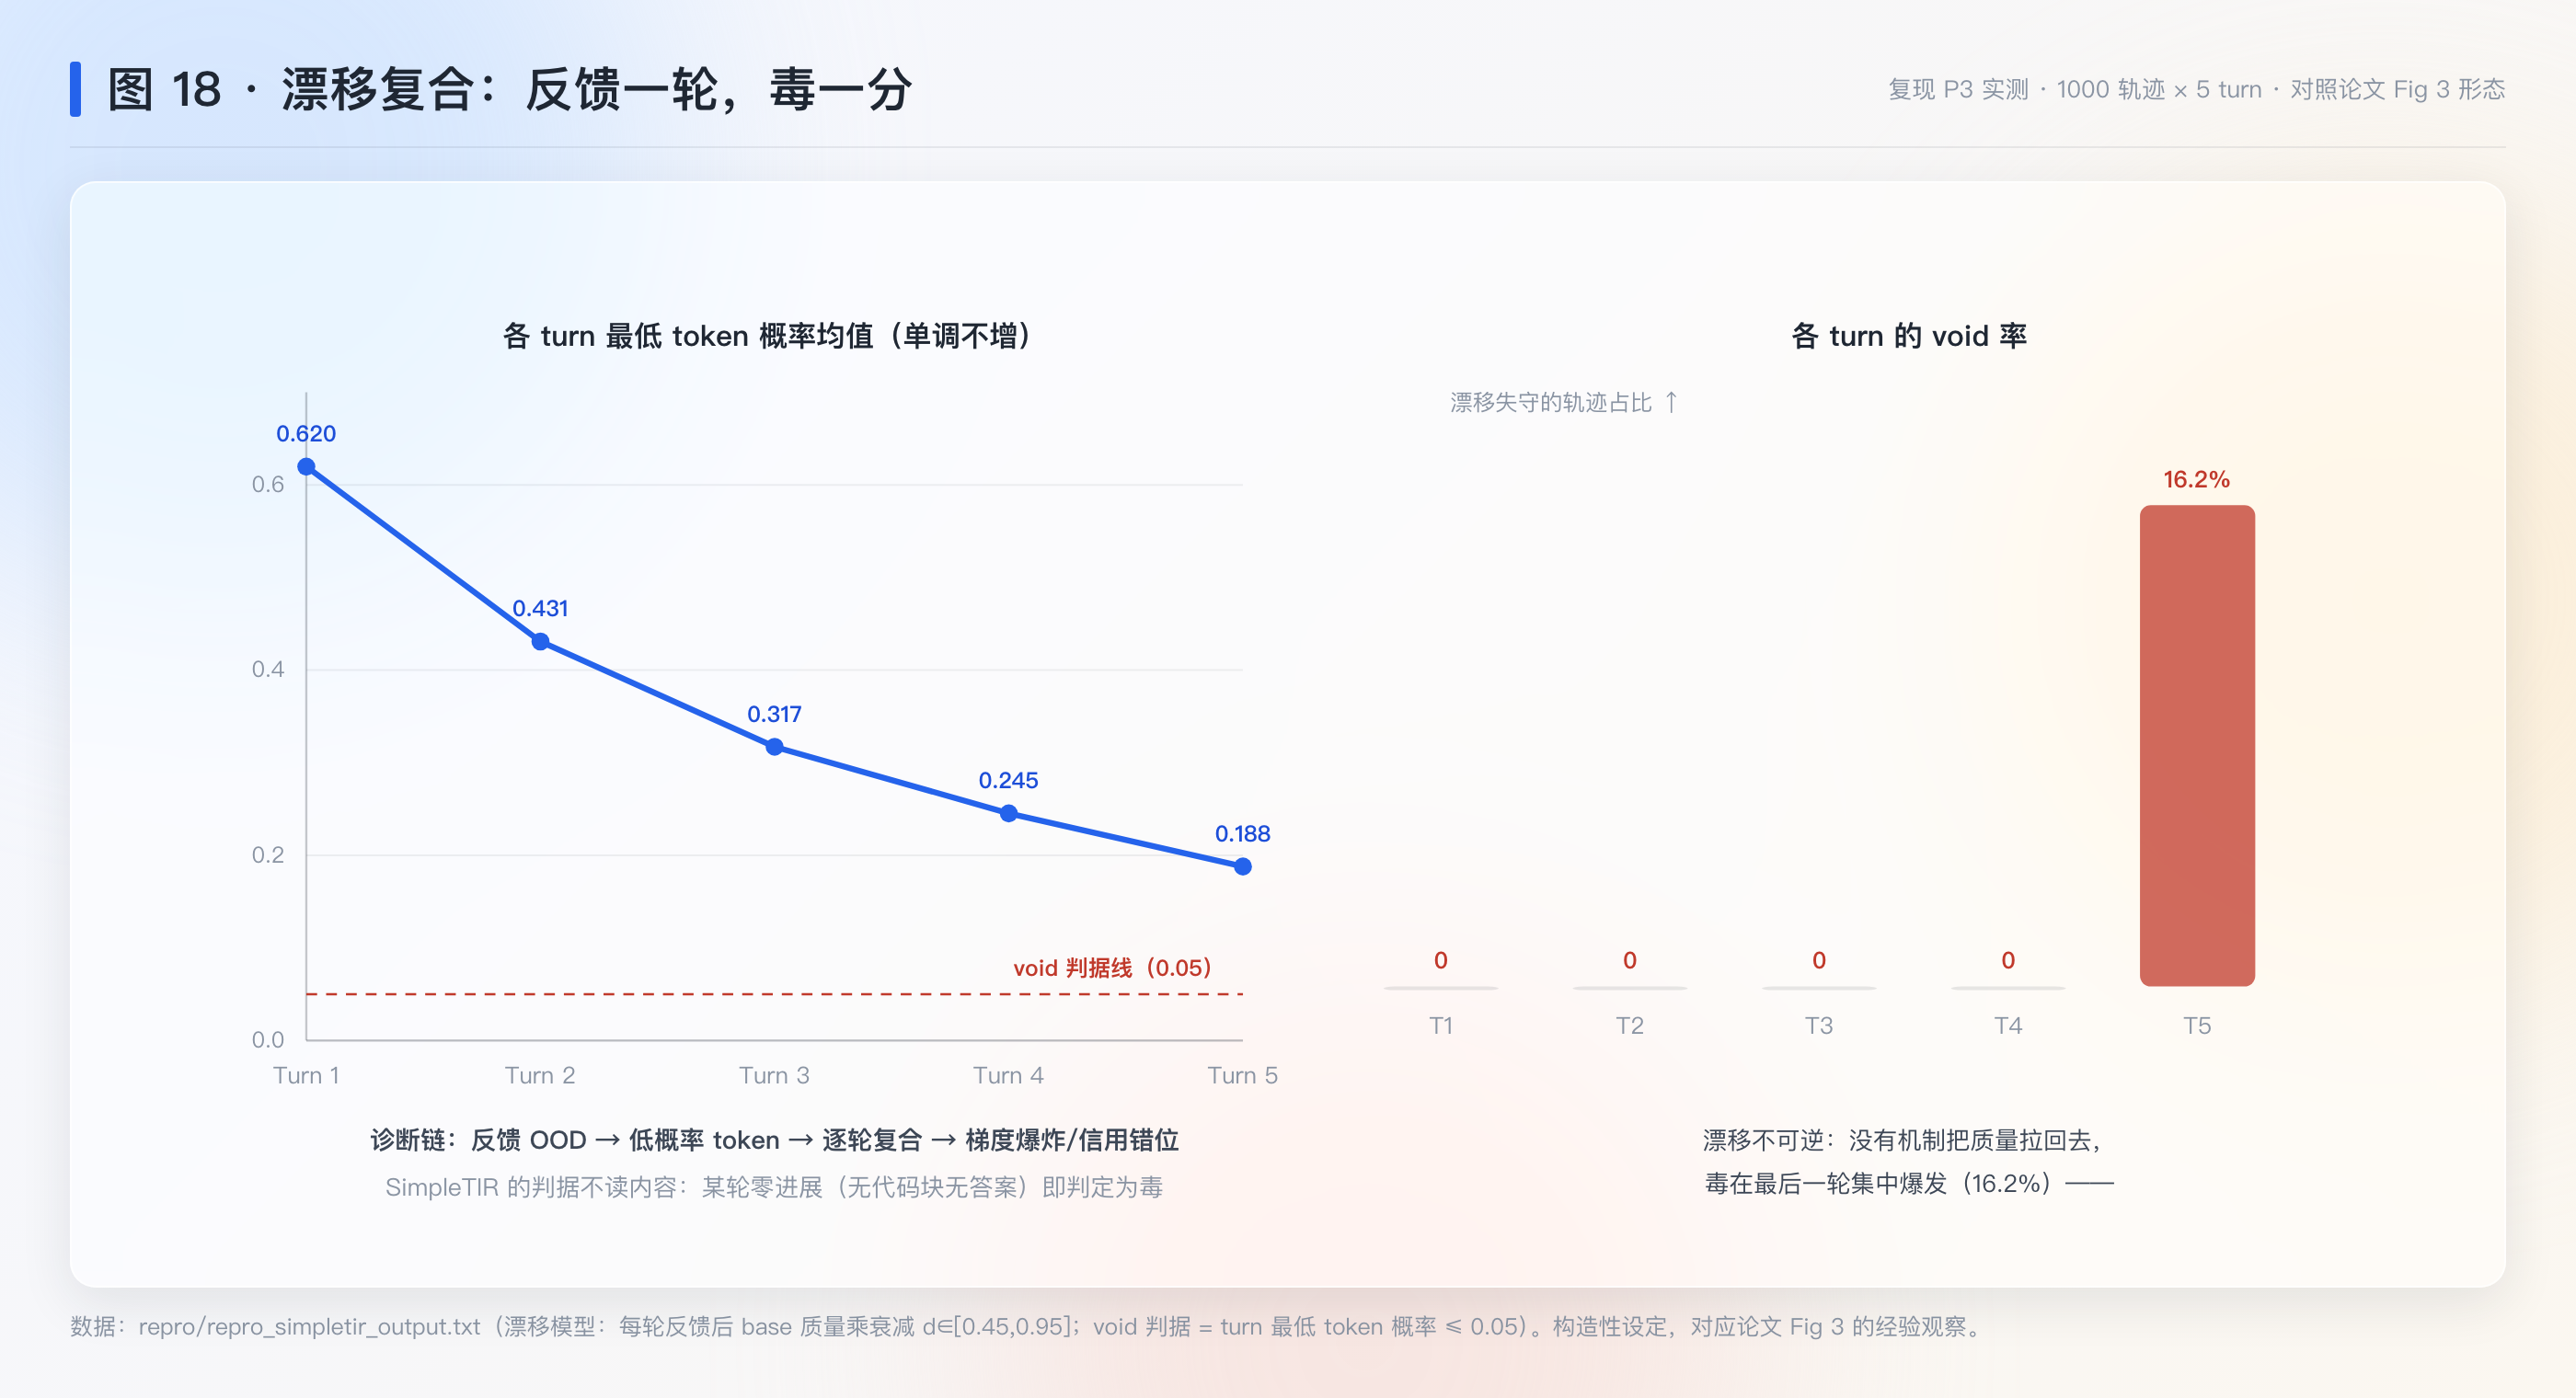
全篇就看这张:图 18(§1.3)——漂移复合的诊断链:一个失败 turn 如何把误差滚进后续所有轮(本站复现 P3 实测),void-turn 过滤针对的就是这条链。 ## 三、数学基础(零起点,本篇新用到的五件)
3.1 softmax 与 categorical 分布
第一件工具是模型挑 token 的那颗骰子——命题要解剖的对象就是它。logits z 是模型给词表里每个 token 打的原始分;softmax 把它变成概率分布:P(j)=e^{z_j}/\sum_k e^{z_k}。采样就是按这个分布抽一个 token c。categorical 分布就是”一颗骰子”的正式名字:\mathcal{A} 是词表,P(j)\geq 0、\sum_{j\in\mathcal{A}}P(j)=1。骰子上两个后面反复用到的量:P(c)(被采样 token 的概率)与 \sum_j P(j)^2(分布的”碰撞概率”——两个独立采样撞到同一个 token 的概率;分布越尖越大,均匀时 =1/|\mathcal{A}| 趋近 0)。先把这两个量记住,§六 拆命题时它们都要出场。
3.2 one-hot 向量与”指示减分布”
第二件工具给”这一次采样有多反常”一个可以算长度的形状。把”抽中了 c”这件事写成一个向量:one-hot e_c(c 的位置是 1,其余全 0);把”模型的一般倾向”也写成一个向量:概率分布 P 本身。两者的差 e_c - P 度量”这次采样有多反常”——如果 P(c)=1,e_c=P,差为零(毫无信息);如果 P(c)\approx 0 却抽中了,差就是一个”几乎是 e_c“的向量,长度接近 1。这条长度有现成的展开:\|e_c - P\|_2 = \sqrt{(1-P(c))^2 + \sum_{j\neq c}P(j)^2};把 (1-P(c))^2 = 1 - 2P(c) + P(c)^2 代进去合并,得
\|e_c-P\|_2=\sqrt{1-2P(c)+\sum_j P(j)^2}
这正是命题 3.1 里那个根式——它不是拍出来的,就是”采样反常度”的长度。§六 推命题时,第一步就是把它整个搬过去。
3.3 softmax 的 logit 梯度(本篇核心新工具)
第三件工具是整套诊断里那把主刀。训练时要把”抽中 c”的概率往大推;这个推力对 logits 求导,结果是一个向量:c 的位置加 1、其余位置减 P(j)——即 e_c - P。这个优雅形式一行可推:\log \pi(c) = z_c - \log\sum_k e^{z_k},对 z_j 求导:j=c 时得 1-\pi(j),否则 -\pi(j);合起来 \nabla_{z}\log \pi(c)=e_c-P。
它为什么配得上”本篇核心”:策略梯度对 logits 的作用方向就是这个向量乘上一个标量系数。系数再大,方向永远是”采样反常度”向量;而它的长度 \|e_c-P\| 随 P(c) 下降而增大。命题 3.1 就是”系数 × 长度”的完整展开——§六 那场主推导,演的就是它。
3.4 重要性比与其不对称的无界性
第四件工具管”换策略的汇率”。样本是旧策略采的,更新却要落到新策略头上——GRPO/PPO 用重要性比 \rho=\pi_\theta(c)/\pi_{\text{old}}(c) 修正这个错位。clip 把 \rho 限制在 [1-\varepsilon,1+\varepsilon]——但只对正优势有效(补充推导见 §6.3):优势 \hat{A}<0 时,目标取 \min(\rho\hat{A},\text{clip}(\rho)\hat{A}),两个都是负数,min 取绝对值更大的那个——当 \rho\to\infty 时 min 选中的恰恰是无界的 \rho\hat{A}。负优势轨迹的梯度因此可以无限大:这就是”尖峰”的数学入口。老策略概率 \pi_{\text{old}}(c) 极小时(低概率 token),\rho 只要挪一点就翻倍再翻倍。这把钥匙请拿好——§五 讲尖峰为何拦不住、§六 数失效因子时,用的都是它。
3.5 复合衰减(漂移的模型)
第五件工具给”逐轮复合”一个可算的形状。每轮反馈后,模型下一轮采样的”在分布程度”乘一个衰减因子 d<1(本篇复现的漂移模型)。K 轮后累计 d^K——几何衰减,MT-GRPO 篇 §3.3 的同款算术(该篇已同步重排)。而且漂移不可逆:没有机制把 d 拉回 1,这就是”逐轮复合”的数学形状。§十 的复现就靠它来模拟漂移、检验 void 检出。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| o=(q,l_0,f_0,\dots,l_{K-1},f_{K-1}) | 完整轨迹:提示 + 各轮输出/反馈 | §2.1,p.3 |
| \mathcal{M}_H,\ \mathcal{M}_L | 高层(turn 级)与低层(token 级)MDP | §2.1,p.3 |
| R_H=R(o),R_L=0 | 终局奖励;低层无奖励 | §2.1,p.3 |
| \hat{A}_i=(r_i-\text{mean})/F_{\text{norm}} | GRPO 轨迹级优势(F_{\text{norm}} 为组内归一化因子) | §2.2,p.3 |
| m_{i,t} | 反馈掩码:模型输出 token 为 1,环境反馈 token 为 0 | 式 (1) 下文,p.4 |
| \rho_{i,t}(\theta) | token 级重要性比 \pi_\theta/\pi_{\text{old}} | 式 (2) 下文,p.4 |
| g_{i,t} | 门控:PPO 更新未被 clip 时激活 | 命题 3.1,p.5 |
| P | 策略分布 \pi_\theta(\cdot|o_{i,<t});P(c) 为采样 token 的概率 | 命题 3.1,p.5 |
| void turn | 既无完整代码块也无最终答案的一轮响应 | §3.3,p.6 |
| z^t | pre-softmax logits | 命题 3.1,p.5 |
五、机制
承上启下:§一 的诊断链是”工具反馈 OOD → 低概率 token 逐轮复合 → 崩溃”,§二 的处方是把带毒轨迹整条从更新中剔除。上节备好的三件工具正好是手术刀:softmax 的 logit 梯度几何(e_c-P,§3.3)解剖命题 3.1 的每一项,重要性比的负优势不对称性(§3.4)解释尖峰为何拦不住,复合衰减(§3.5)把”逐轮复合”变成可模拟的算术。本节先立贯穿示例的批数据结构,再按”诊断 → 处方”走机制。
5.0 贯穿示例的数据结构
一个训练批:G=8 条轨迹、每条最多 K=5 turn。每条轨迹的数据结构(复现脚本即按此实现):
trajectory_i = {
  turns: [ {tokens: [...], P(c): [逐 token 概率], complete: bool}, ... ],
  has_void: any(turn.complete == False),
  rho:    [逐 token 重要性比],
  reward: 终局 0/1
}
complete
的判据来自提示词契约(C.1,p.15):完整的三引号 Python 代码块,或
final_answer(...)/\boxed{...}
通道。两条对照轨迹(示例):t1 三 turn 全部完整、奖励 1;t2
第二轮只有半截代码(void),第四轮崩成重复文本,奖励 0。命题 3.1
的范数公式将逐 token 作用于它们。
5.1 机制一:分层 MDP 与反馈掩码(§2,p.3–4)
【类比 · 各记各账】 多轮对话像一页混抄的笔录:学生作答与老师批注写在同一张纸上。判卷只判学生亲笔写下的部分,老师的话不算学生答案——掩码就是把”谁的话记谁头上”写死的纪律。 【跨域锚点】 会计记账的权责归属:代收代付的过手款项不进本单位损益。(类比与通识锚点,非论文内容)
先看病:不立规矩的麻烦在哪。多轮 TIR 的序列上,模型的输出和环境的反馈缝在一起,若不加区分,环境说的话也会被算进损失。论文先把舞台搭好:多轮 TIR 建模为分层 MDP(引 Hauskrecht et al. 1998,论文参考文献)——高层 MDP 在 turn 级(状态=对话历史,动作=整段输出 l_k,奖励只有终局 R(o)),低层 MDP 在 token 级(动作=单 token,奖励恒 0);折扣 \gamma=\gamma_H=\gamma_L=1;两层之上只训练一个统一策略 \pi_\theta(a_t|s_t)(p.3)。
药方就是训练目标(式 (1),p.4)——GRPO 的掩码版:
\mathcal{J}_{\text{TIR}}(\theta)=\mathbb{E}\Big[\frac{1}{G}\sum_{i=1}^{G}\sum_{t}^{1}\ m_{i,t}\cdot L_{\text{CLIP}}(\theta,i,t)\Big]
m_{i,t}\in\{0,1\} 是反馈掩码:token 属于模型输出 l_k 则为 1,属于环境反馈 f_k 则为 0;L_{\text{CLIP}} 是标准 PPO 裁剪代理(式 (2),p.4),重要性比 \rho_{i,t}=\pi_\theta/\pi_{\text{old}}。
但要看清这剂药的边界:反馈掩码只保证”环境说的话不进梯度”——它挡得住反馈本身,挡不住漂移钻进模型的后续生成(§3.1 的核心观察,p.4)。必要条件,还不是充分条件。
5.2 机制二:诊断——低概率 token 的两个破坏效应(§3.1–3.2,p.4–6)
【类比 · 传染病链】 一名带菌者走进人群(分布外的工具反馈),被传染的人次日照常上班、继续传给下一个人(低概率 token 拼进下一轮输入),几代传播之后整条轨迹高热崩溃;而事后若只按”最终病危”追责,前面被牵连的健康日子也一起背了锅。 【跨域锚点】 流行病学的传染数:每代放大一点,几代之后指数失控,防控要在源头切断传播链。(类比与通识锚点,非论文内容)
先看病。病有两个症状,根子是同一个。
效应一:梯度爆炸。对 pre-softmax logits 的梯度范数有解析形式(命题 3.1,p.5;全推导在 §6.2),它对 token 概率 P(c) 的依赖集中在一个根式项 \sqrt{1-2P(c)+\sum_j P(j)^2} 与重要性比 \rho 上——两者都随 P(c) 下降而增大(§6.2–6.3)。
效应二:信用错位。低概率 token 集中在后期 turn;稀疏的终局奖励给整条失败轨迹一个负分,这个负分无差别摊给全部 token——早期正确的推理和后期致病的胡话同罪。后果:策略学会规避多轮行为,塌向更安全的单轮生成(p.6 原话:causing the policy to collapse toward safer, single-turn generations)。
病根出在哪?出在低概率 token 会顺着轮次自我复制:反馈把漂移带进来,漂移生成低概率 token,低概率 token 又被拼进下一轮的输入——两个效应都是从这条链条上长出来的。
补充:效应二与 TARA/MT-GRPO 的诊断完全相同(轨迹级一个分,分不清哪段的功劳)——但本篇的处方不是把账记细,而是让带毒轨迹根本不进账本。三篇对照在 §八.1。
5.3 机制三:SimpleTIR——void turn 一票否决(§3.3,p.6)
【类比 · 一票否决】 选秀评委不再逐项打分,只立一条硬规矩:整场表演里只要有一幕”人在台上、却什么都没做成”,整场直接出局——不评内容好坏,只认这条结构性破绽。 【跨域锚点】 体育赛场的药检规则:阳性一次即取消成绩,与当场表现无关——判据是结构性的,不靠酌情打分。(类比与通识锚点,非论文内容)
先看病。论文在 Fig 3 的案例里注意到一个规律:崩溃的 Turn 4,紧跟在一个”既没产生工具调用也没产生最终答案”的 turn 之后。这个症状被命名为 void turn:LLM 的一轮响应中既不含完整代码块也不含最终答案;典型形态包括半截代码、重复文本、过早采样 EOS 导致的不完整响应。它之所以是个好标记:void turn 在成功轨迹中罕见、在异常轨迹中常见,是分布漂移的高信噪比症状(p.6)。
病根既然是毒轨迹混在 batch 里,药方就极简(p.6,Figure 4):逐轨迹检查各 turn;任一 turn 为 void → 该轨迹的策略损失整体掩码,在 GRPO 更新前从 batch 中移除。
这剂药一步同时做两件事(p.6 原文归纳):阻断低概率 token 的大梯度回传;修正信用错位(含 void 的轨迹”几乎不可能拿到正回报”,其早轮的正确行为不应为晚轮的崩溃受罚)。
那这是不是唯一解?论文把三个替代方案都试给你看了,全部失败(p.6 + Figure 5 bottom + Table 2,p.9):按高困惑度/低概率掩码 token、按高重要性比掩码 token、发现 void 就停止生成但保留轨迹进损失(数字见 §6.5)。论文给的失败原因:概率类阈值难调,且都不解决信用错位。
5.4 机制四:让 void 可检测的提示词契约(§3.4,p.7;C.1,p.15)
【类比 · 标准考卷】 机器能自动改卷,前提是考生按答题卡填涂:格式定得越死,判卷越自动、越不容易看走眼。void 判据可靠,靠的正是提示词先把”交卷格式”定死。 【跨域锚点】 工业流水线的标准件:接口先标准化,质检才可能自动化。(类比与通识锚点,非论文内容)
上一节的过滤算法要成立,得先兑现一个前提:void
判据必须可靠——判据认不认得出毒株,取决于契约定得严不严。三件套实现细节(p.7):不用聊天模板(避免基座模型见过的特殊
token 之外的 OOD token),工具输出统一加前缀 “Code Execution
Result:”;每个代码块前注入 final_answer
函数(给简单题”一轮直答”的捷径);代码块完整后立即停止生成、必真回填工具反馈(防模型幻觉工具输出)。提示词契约(C.1,p.15)要求完整脚本
+ 显式打印中间量 + 标准答案通道——论文自述这让”区分有效工具调用与
void turn 变得容易”。
意义:void 检测器是格式契约的产物——契约定得多严,毒株就有多好认。这是”判分器/检测器质量”问题簇的第三例(黄金轨迹质量、judge 误差率之后)。
5.5 机制五:Zero RL 的回报——涌现行为(§4.4,p.9–10)
最后看 Zero RL 的回报。SFT 冷启动稳是稳,代价是什么?Table 3(p.9)给出了量化:Claude-3.7-Sonnet 当裁判统计”答对”响应里的推理模式频率,ReTool(冷启动)vs SimpleTIR-32B:渐进推理 18.9% → 46.5%,交叉验证 82.4% → 86.0%,纠错循环 25.8% → 38.0%(判分者:Claude-3.7-Sonnet;仅统计答对样本;同一响应可含多模式)。Zero RL 保留了预训练里多样的解题策略,冷启动把它们锁死在示范分布里。
六、数学展开
6.1 掩码 GRPO 目标(式 (1)(2),p.4)
先看这笔账的记法。一条轨迹里,模型说的话要管教,环境回的话不归它管——掩码 m_{i,t} 就是这条纪律。每个 token 的损失是 PPO 的裁剪代理,整条轨迹按”它比同组平均好多少”(\hat{A}_i)定方向。
L_{\text{CLIP}}(\theta,i,t)=\min\big(\rho_{i,t}\hat{A}_i,\ \text{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat{A}_i\big)
逐符号:\rho_{i,t} 新旧策略对同一 token 的概率比;\hat{A}_i 轨迹级优势(与本篇的轨迹过滤相容的正是这个轨迹级优势——SimpleTIR 不改信用粒度,见 §6.4);\varepsilon 裁剪宽度。边界:\hat{A}_i>0 时 clip 封住上界;\hat{A}_i<0 时 clip 封不住(§6.3)。
6.2 命题 3.1 全推导(p.5)
先看命题说的是什么。训练对 logits 的推力 = “采样反常度”向量 e_c-P 乘上三个标量旋钮(掩码占比、重要性比、优势绝对值)。向量长度只由分布形状与 P(c) 决定。
推导(补充——论文给出命题与出处(引 Yingru Li 2025《Logit Dynamics》,论文参考文献),未附完整证明;以下四步为我补的推导):
第一步,未被 clip 时,代理损失对 token c 的 logit 梯度是策略梯度的一阶项:
\frac{\partial L}{\partial z^t}\Big|_{\text{unclipped}}=-\,g_{i,t}\,\rho_{i,t}\,\hat{A}_i\,\nabla_{z^t}\log \pi(c)=-\,g_{i,t}\,\rho_{i,t}\,\hat{A}_i\,(e_c-P)
(g_{i,t} 是门控:被 clip 时为零。)
第二步,取 L2 范数,常数提出、向量长度留下:
\big\|\nabla_{z^t}L\big\|_2=g_{i,t}\,|\rho_{i,t}\hat{A}_i|\cdot\|e_c-P\|_2
第三步,展开长度(§3.2 的恒等式):
\|e_c-P\|_2=\sqrt{(1-P(c))^2+\sum_{j\neq c}P(j)^2}=\sqrt{1-2P(c)+\sum_j P(j)^2}
第四步,加上掩码归一化因子 m_{i,t}/\sum_j m_{i,j}(目标按掩码 token 数平均,每个 token 的贡献被摊薄),得命题 3.1:
\big\|\nabla_{z^t}\mathcal{J}_{\text{TIR}}\big\|_2=\frac{m_{i,t}}{\sum_j m_{i,j}}\cdot\rho_{i,t}(\theta)\cdot g_{i,t}\cdot|\hat{A}_i|\cdot\sqrt{1-2P(c)+\sum_j P(j)^2}
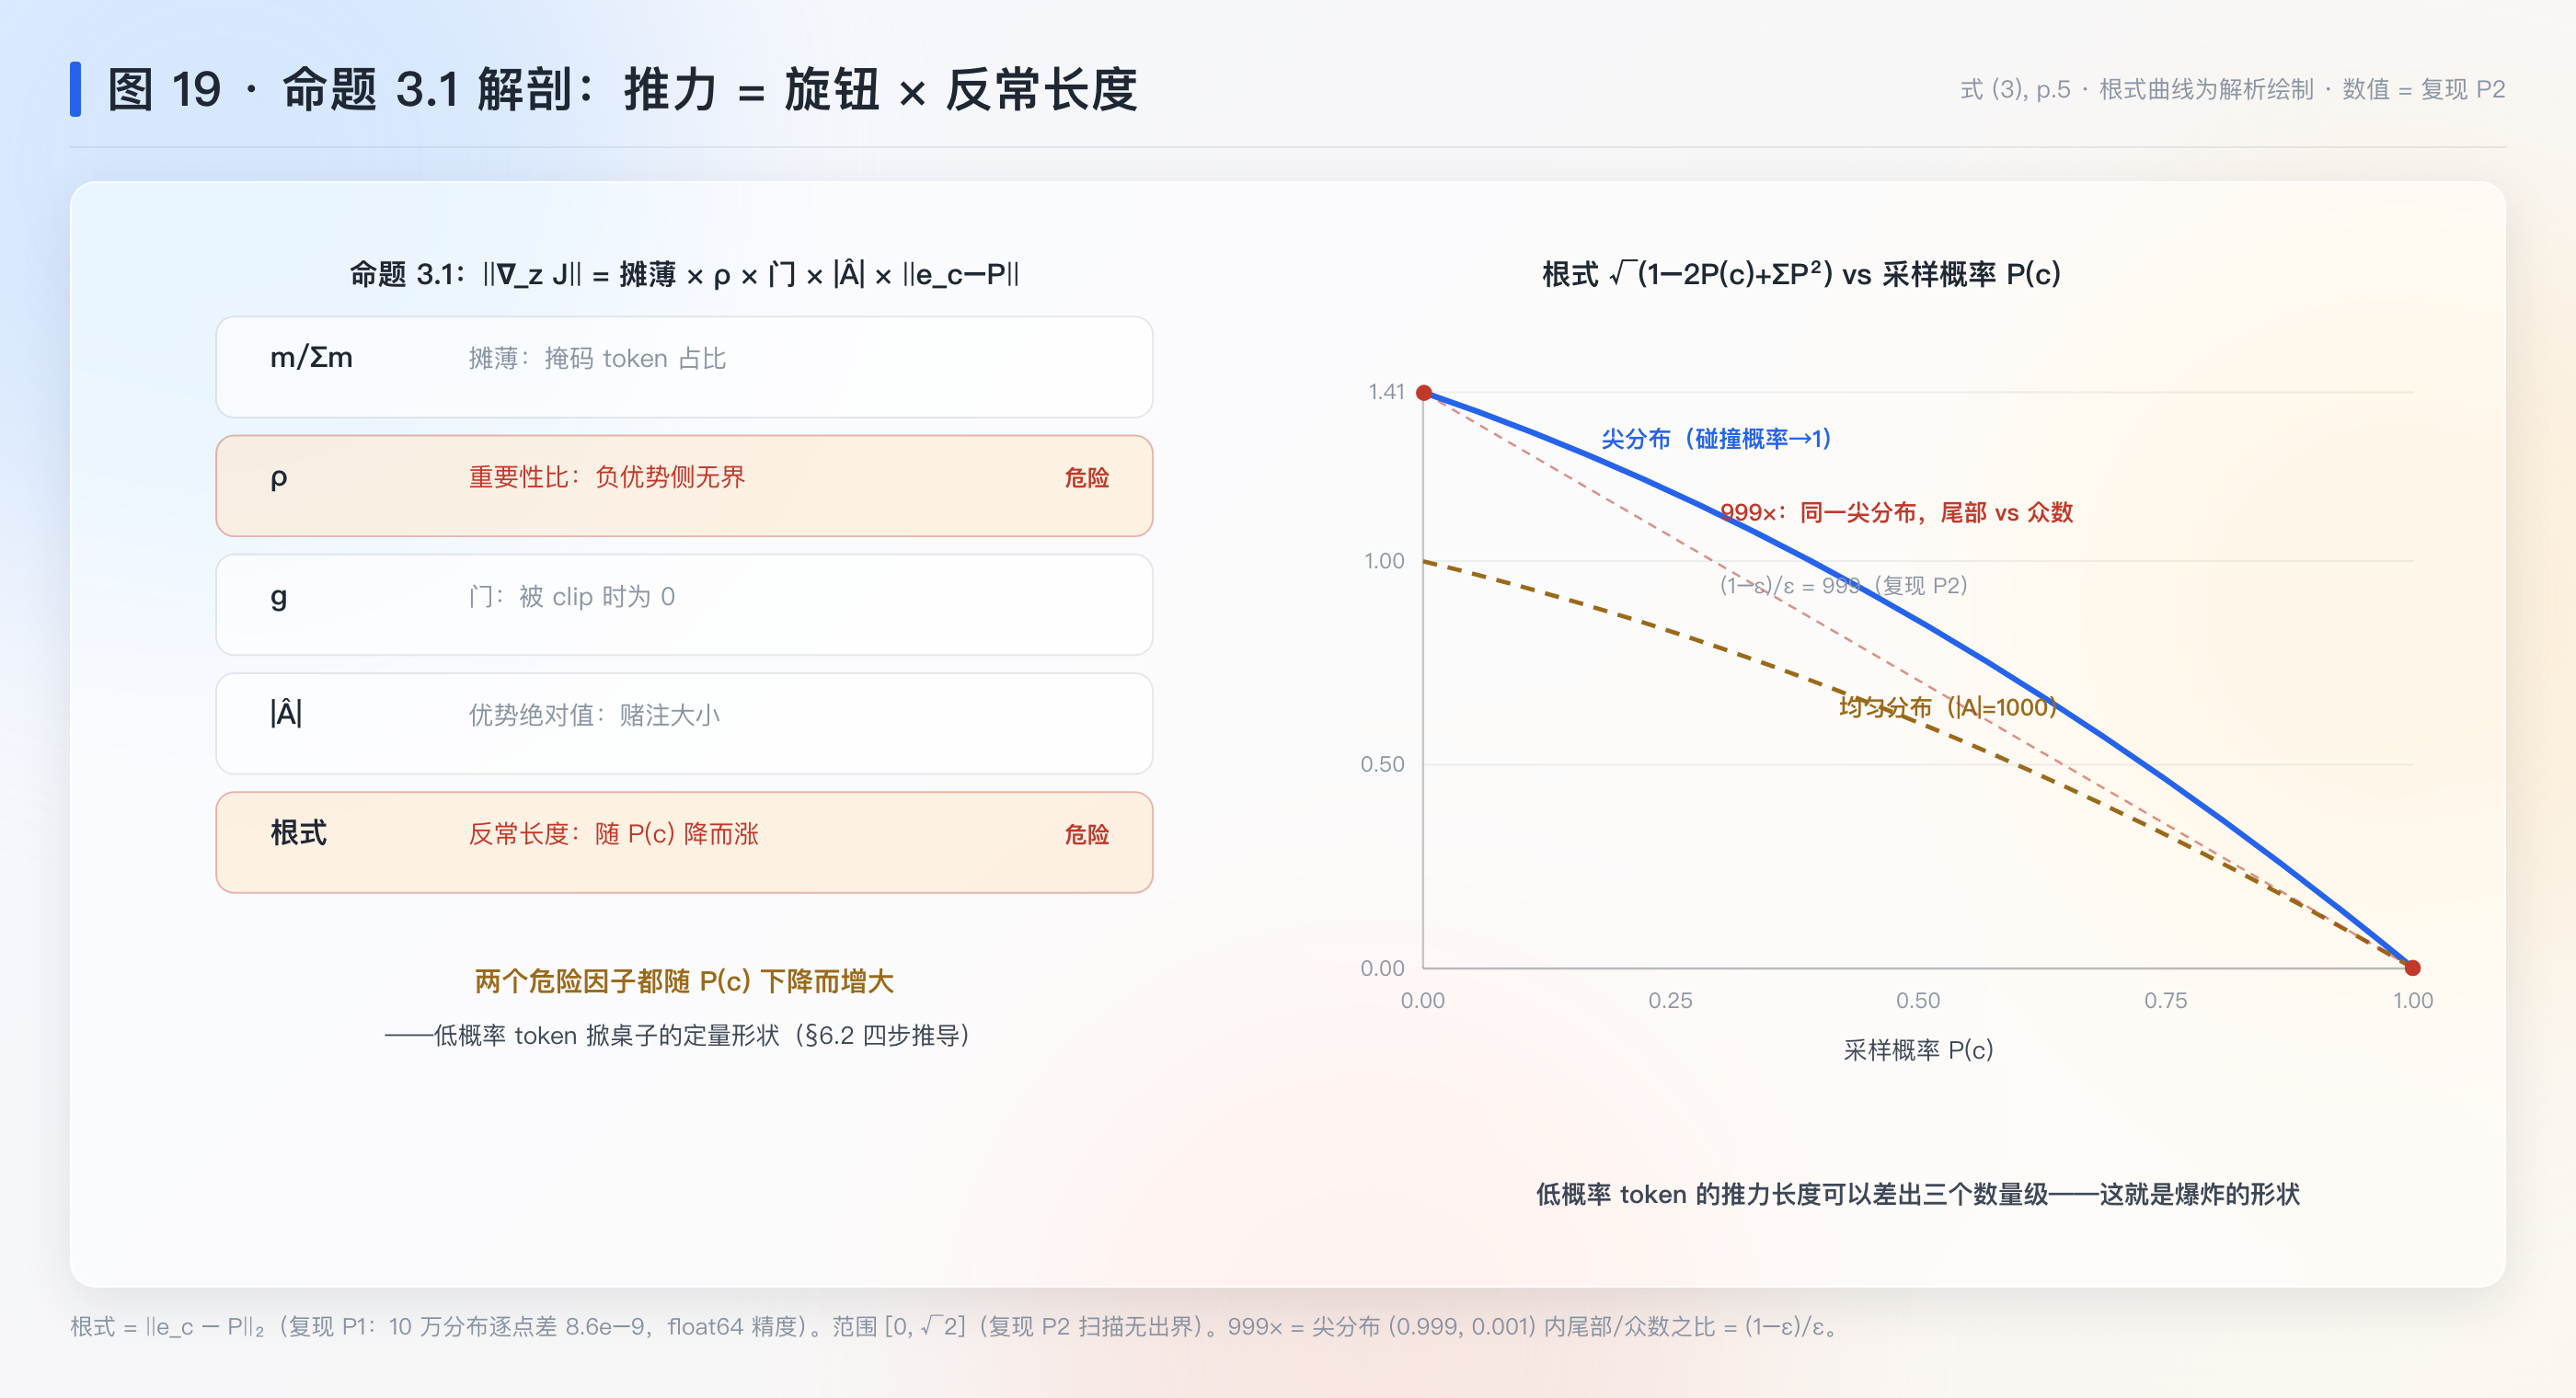
与原文逐项一致(p.5 式 (3))。白话回译:推力大小 = 摊薄 × 偏离比 × 门 × 赌注 × 反常长度。两个因子随 P(c) 下降而增大——这就是”低概率 token 掀桌子”的定量形状。
6.3 两个失效因子(§3.2,p.5–6)
因子一:\rho 的无界性(负优势侧)。数值看:\pi_{\text{old}}(c)=10^{-4} 的 token,更新后 \pi_\theta(c)=10^{-3}(涨 10 倍仍是很小的概率),\rho=10;clip 区间 [0.8,1.2] 完全拦不住——因为 \hat{A}<0 时 \min(\rho\hat{A},\text{clip}(\rho)\hat{A}) 取的是绝对值更大的无界项(补充:这是 PPO 负优势侧的著名不对称,clip 只保护正优势方向;DAPO 为此把上界放宽到 0.28,本篇 C.2 同款 p.18)。
因子二:根式项。取值范围 [0,\sqrt{2}]:P(c)\to 1(自信且采中)时趋于 0——毫无梯度;P(c)\to 0(采到几乎不可能的 token)时趋于 \sqrt{2}——最大反常长度。数值例(同一尖分布内对比):分布 P=(0.999,0.001,0,\dots),采样众数 token 时根式 =\sqrt{2}\cdot\varepsilon=0.0014(\varepsilon=0.001),采样尾部 token 时根式 =(1-\varepsilon)\sqrt{2}=1.4128——同一个分布里,采到尾部 token 的推力长度是众数 token 的 (1-\varepsilon)/\varepsilon=999 倍。漂移的产物(低概率 token)恰好是这些尾部采样。留痕:本例初稿曾误用”均匀分布 P(c)=0.5 且 \sum P^2=0.001“的组合(P(c)=0.5 时 \sum P^2\geq 0.25,自相矛盾,44 倍之说作废),运行复现前修正为同分布对比。
6.4 信用错位:三个处方的同一诊断(§3.2,p.6)
先看病根的原文表述:终局稀疏奖励下,后期失败的轨迹整条拿一个负分,不区分早期的正确推理与后期的低概率错误,不公平地惩罚了有效的多轮行为,导致策略塌向单轮(p.6)。
这和 TARA/MT-GRPO 的诊断逐字相同。三种处方:MT-GRPO 给 turn 级优势(贵:树形重采样);TARA 给 turn 级账本 + 门(省:链上同位比较);本篇不给账,直接销账——含 void 的轨迹整条掩码,幸存集合里”早好晚坏”的错位依然存在,但浓度大降(毒大部分在 void 轨迹里——这是过滤有效性的经验前提,p.6:“void turns are rare in successful trajectories but indicative of abnormal ones”)。补充:三者原则上可叠加(过滤 + turn 级记账),论文未测。
6.5 消融:为什么替代方案全败(Table 2,p.9;Figure 5 bottom,p.8)
原文数字(AIME24 / MATH500,消融方法取 1000 步内最高分——对不稳定方法有利的口径,p.9 表注):
| 方法 | AIME24 | MATH500 |
|---|---|---|
| SimpleTIR | 50.5 | 88.4 |
| Naive Multi-Turn | 20.8 | 73.1 |
| Low Prob Filtering(按低概率掩 token) | 23.3 | 72.8 |
| High Ratio Filtering(按高重要性比掩 token) | 26.3 | 75.0 |
| Stop Generation w/o Filtering(void 即停但保留轨迹) | 26.1 | 77.3 |
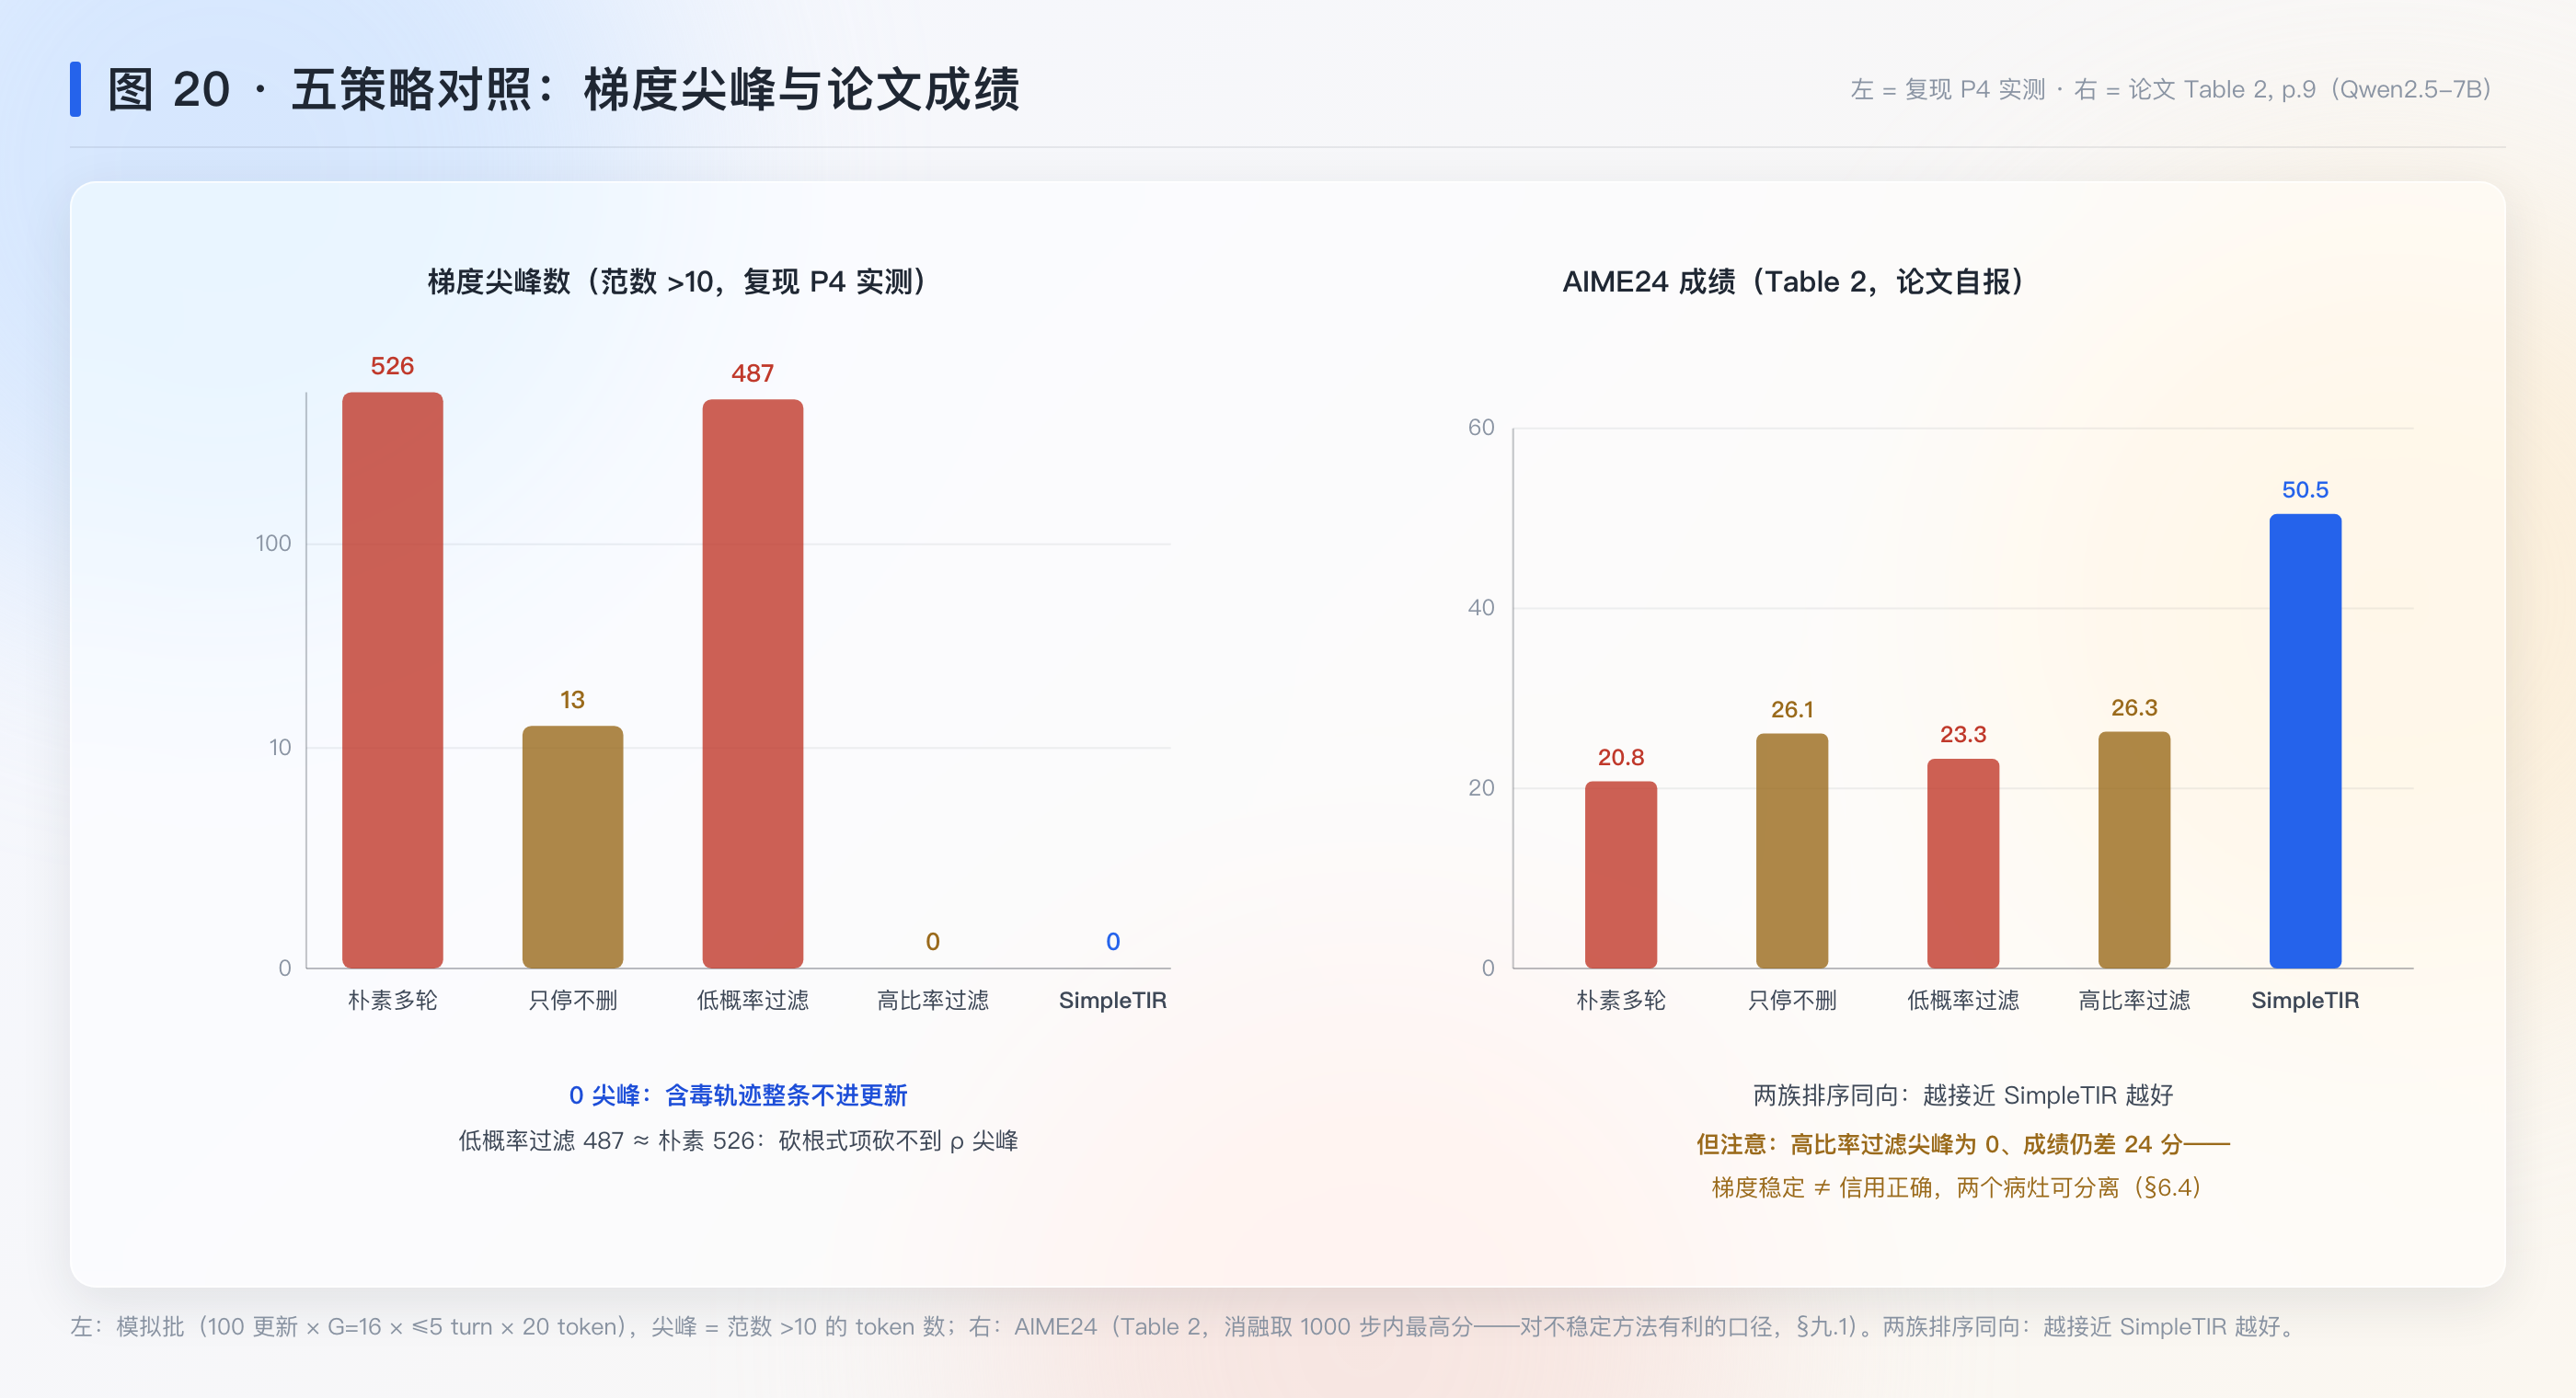
逐个读:低概率 token 过滤直接砍掉根式项(P 小的 token 不进损失)却仍崩——因为 \rho 项还在(§6.3 因子一);高重要性比过滤砍 \rho 项好一点,但阈值难调且信用错位原封不动;只停不删(StopGen)比不Stop 好但仍差 24 分——void 轨迹还在 batch 里,错位信用原样发生(void 轨迹几乎必拿负分,早轮被连坐)。四个失败合起来反证:must 过滤(整条移除)+ must 是 void 判据(结构性而非概率阈值)。
6.6 主结果与涌现(Table 1,p.7;Table 3,p.9)
Table 1 关键行(AIME24):Qwen2.5-7B base 3.2 → 挂 TIR 提示不训练 1.7(更差)→ SimpleTIR-7B 50.5(同系列 32B:59.9)。对照:ZeroTIR-7B 39.6(唯一的同类 Zero RL 基线);冷启动 ReTool-32B 67.0——论文诚实承认冷启动数字更高,卖点是 Table 3 的行为多样性(渐进推理 46.5% vs 18.9%)。Figure 5 top(p.8):max turns 1→5→10,响应长度与 MATH500 随轮数增长,AIME24 不明显——论文的解读是不同任务需要不同推理深度(p.9)。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| softmax logit 梯度几何(e_c-P) | 已懂(本篇 §3.2–3.3 现场推导) | 命题 3.1 的全部数学基础 |
| 重要性比 clip 的负优势不对称性 | 已懂(本篇 §6.3 补充) | DAPO 放宽上界到 0.28 的原因 |
| GRPO 轨迹级优势 | 已懂(MT-GRPO 篇) | 本篇不改信用粒度 |
| 反馈 token 掩码 | 已懂(本篇 §6.1) | Search-R1/ZeroTIR 惯例(转引,未核对原文) |
| Zero RL 谱系(SimpleRL/DAPO/ORZ/Dr. GRPO) | 待补 | 只见定位(§5.1,p.10);DAPO 的 0/100% solve-rate 过滤与 Turn 级过滤的关系值得读 |
| 熵坍缩 / 负梯度更新谱系 | 待补 | 附录 A.1(p.15)一段带过;CURE、Zhu et al. 2025 |
| 碰撞概率 \sum P(j)^2 | 已懂(§3.1) | Rényi-2 的核(补充:与分布锐度的关系,凭记忆,未核对出处) |
| Sandbox Fusion / VeRL | 待补(轻量) | 训练基建 |
| GTPO(OpenReview) | 待补 | 多轮 TIR 的另一算法(检索附带命中),第三方对照候选 |
“待补”节点会在此后的分支笔记里逐个补齐;Zero RL 谱系(DAPO/SimpleRL)是下一篇分支笔记的最顺位。
八、扩展与发散
8.1 训练侧三种处方:删除、重采样、记账
发散:把三篇排成一张处方表。同一诊断(多轮 RL 不稳定、信用分不清),三种处理——SimpleTIR:删除(含毒轨迹一票否决,不进 batch);MT-GRPO:重采样(每个状态采 G 个动作,turn 级优势,G^{K-1} 指数贵);TARA:记账(同 turn 跨轨迹标准化 + 门,线性)。处理的粒度递增:整条轨迹 → 每个状态 → 每个 turn 的账本。
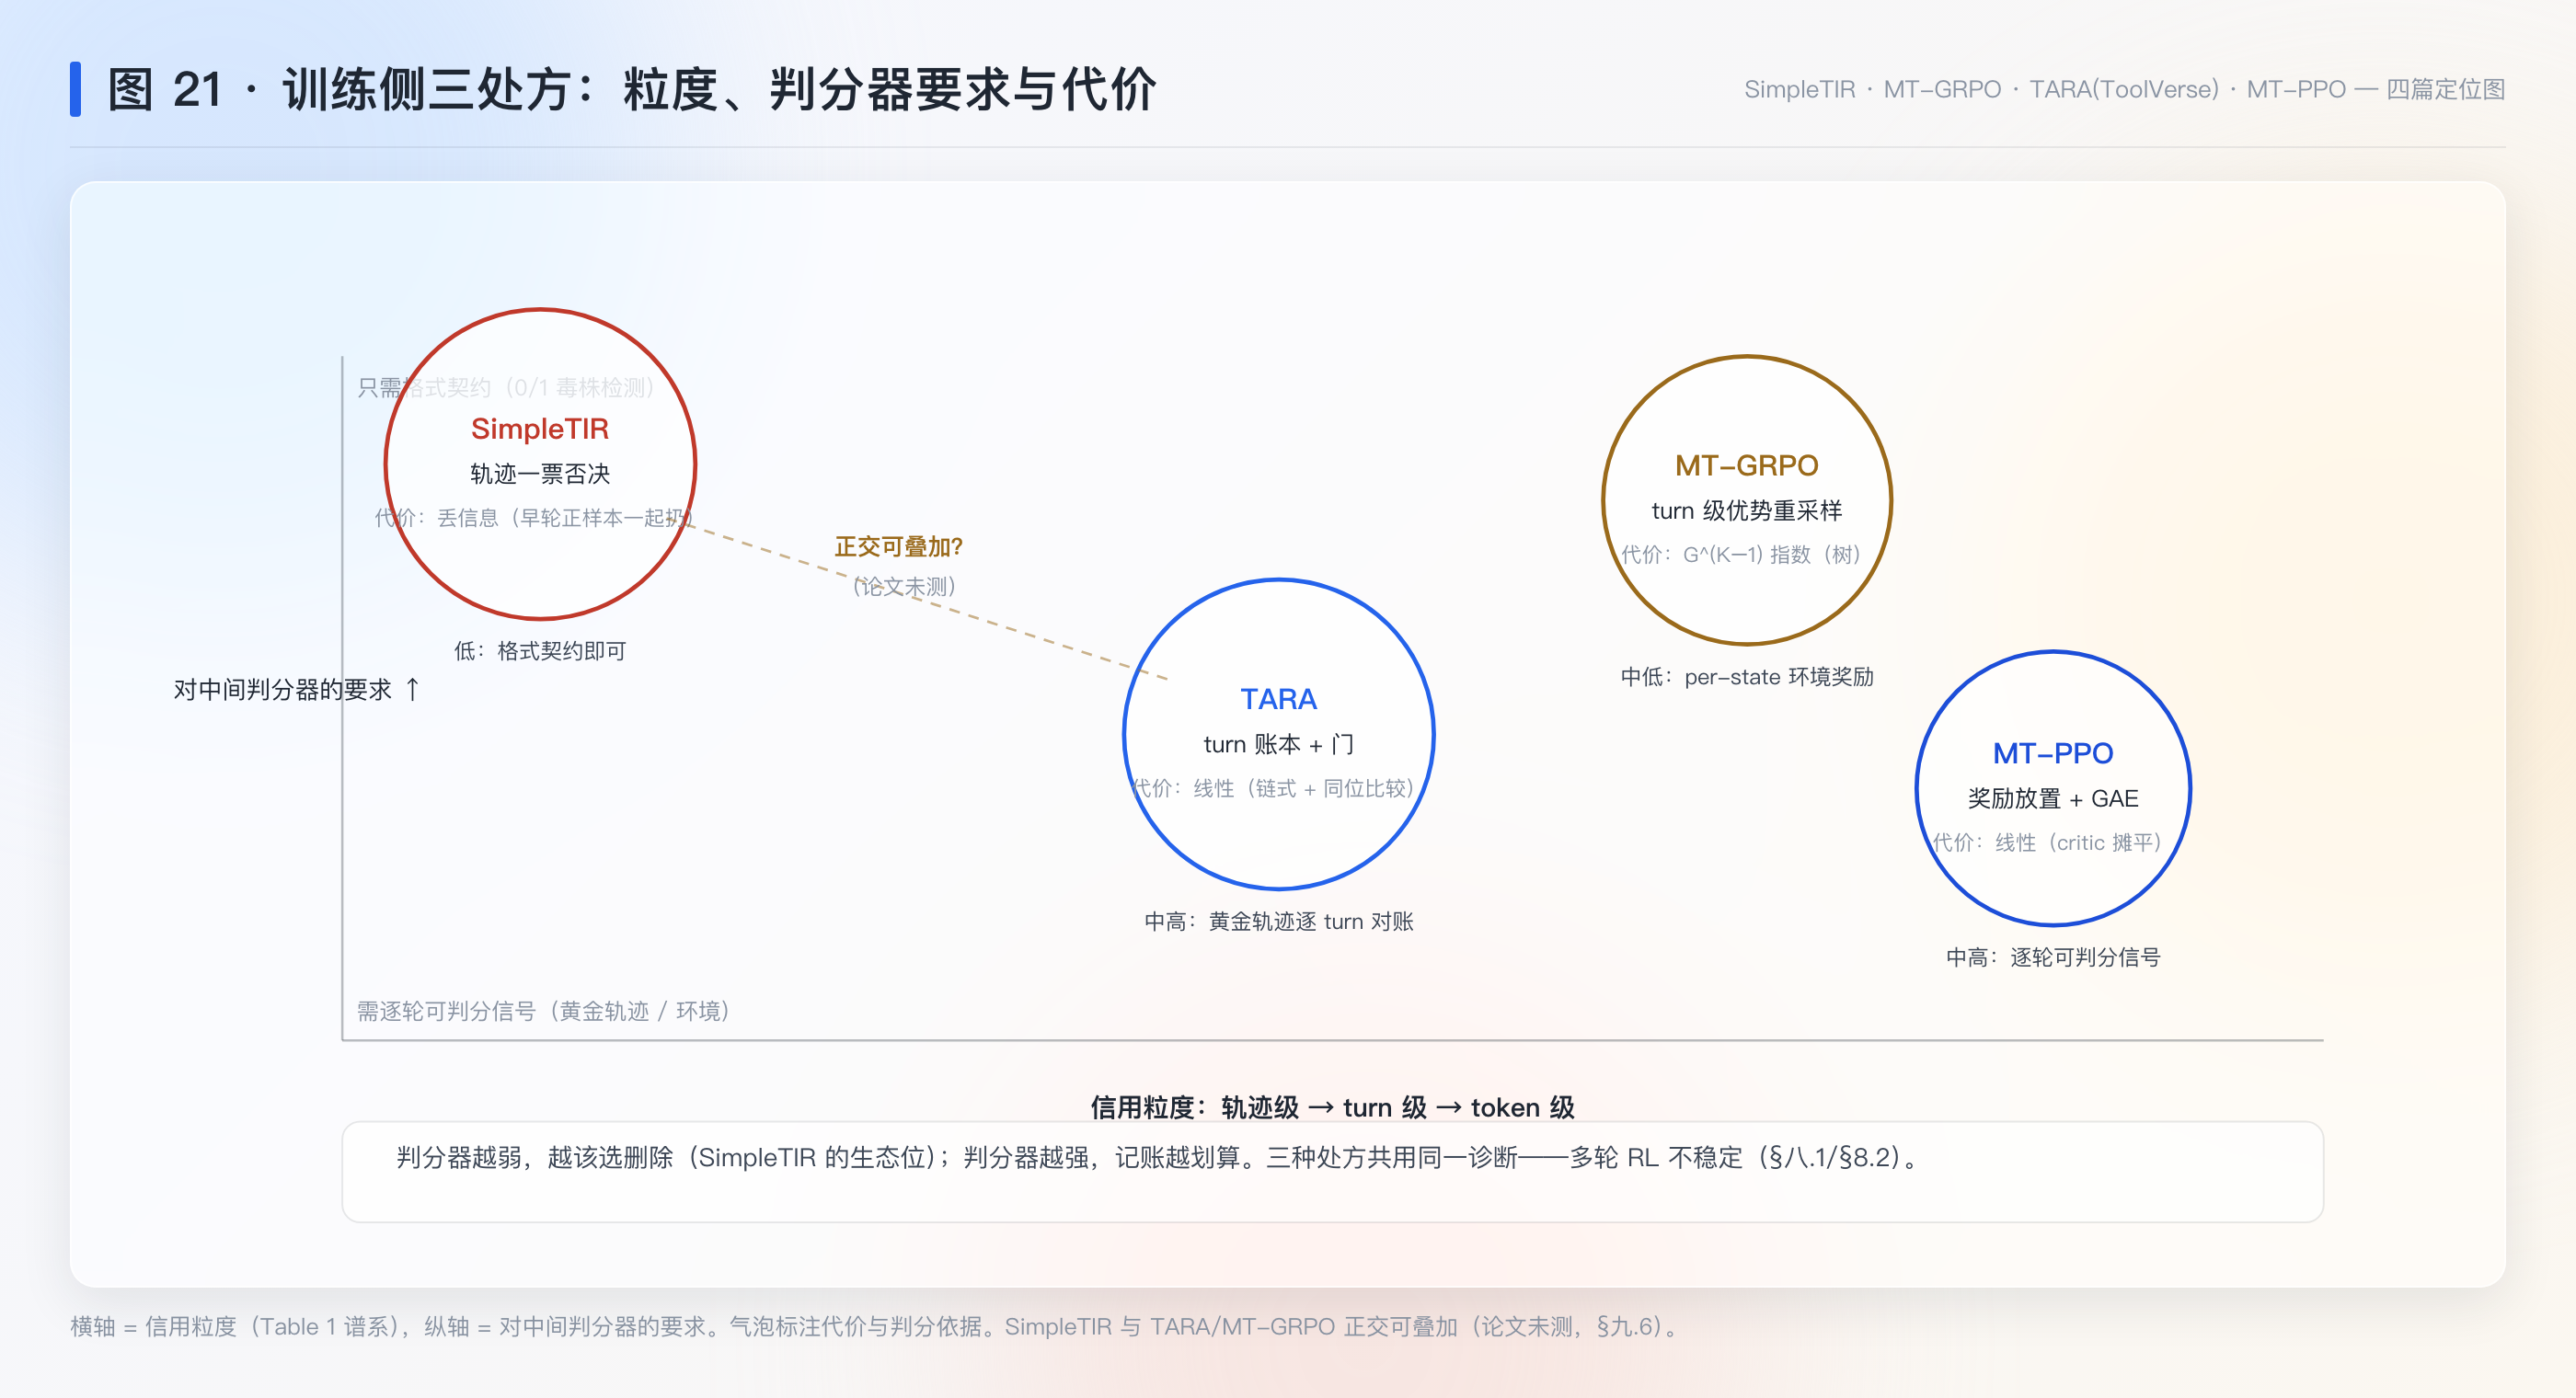 代价也递减地换来了信息的保留:删除最粗(毒轨迹里的干净
early turn 也一并扔掉——信息损失),记账最细。
但删除有一个记账没有的优势:它对账本格式零要求。TARA/MT-GRPO 都需要 turn 级奖励信号(黄金轨迹覆盖、per-state 奖励),SimpleTIR 只需要一个 0/1 的格式检测器——所以在没有中间判分器的环境里(数学题只有终局对错),删除是唯一可行的第一招。这解释了为什么它出现在 TIR(格式契约强)而不是搜索问答。
回到这篇:过滤是”止损”的最粗粒度形式——与执行侧的”检测到污染即撤销”(StructAgent Invalidated)、训练侧的”刹车不可去”(MT-GRPO \lambda_s)汇成一条原则:识别毒性 → 立即切断 → 不让毒性进入下游(batch/账本/重试)。
8.2 连坐问题:早轮干净 token 的三篇对照
发散:本篇 §5.2 的”信用错位”值得单独对照。同一现象三篇三种叫法:本篇叫 misaligned credit assignment(干净早轮被终局失败连坐);TARA 的数字版是”i3 蒙对者受奖 + i2 实干者受罚”(turn 级账分开记);MT-GRPO 的数字版是我的复现(错排序率 45% vs 0%)。本篇的解法是销账(含毒轨迹的早轮 token 也不再受罚——因为整条不进梯度),代价是早轮的正确行为也不再受奖(信息全丢)。三者的取舍:销账 = 零假阳性成本、丢信息;记账 = 保留信息、要求判分质量。这给”判分器质量”问题簇一个新维度:判分器越弱,越该选销账。
回到这篇:Table 2 的 StopGen w/o Filter(26.1)证明”只止损不销账”不够——止损挡住了更深的漂移,却挡不住账本上的连坐。止损与销账必须配套,这条与执行侧”检测到 void 立即停 + 撤销”完全同构。
8.3 崩溃的三段案发过程:概率、梯度、行为
发散:Fig 3(p.5)的案例值得按数据结构读:Turn 1 模型文本概率高 → 反馈 OOD → Turn 2–3 模型文本出现低概率段 → Turn 4 崩溃。三篇训练侧论文各拍了这段过程的一个断面:MT-GRPO 拍的是”哪一步的功劳算不清”(信用面),TARA 拍的是”哪一步没验证”(验证面),本篇拍的是”哪一步的 token 反常”(概率面)。三个断面在执行侧都有对应物:状态丢信息(LH 未攻克 ③)、假完成(StructAgent 的 Invalidated)、上下文腐烂(Context Rot——低概率 token 的生成漂移与”越长越乱”是同一 family 的训练侧版本)。
回到这篇:void turn 之所以是好判据,恰恰因为它站在三个断面的交点上——零进展(信用)、无验证产物(验证)、漂移症状(概率)。好判据是多面证据的交点,这个判据设计的原则值得留给自己的研究问题清单。
8.4 Zero RL vs 冷启动:多样性作为可量化收益
发散:Table 3 的模式频率统计(判分者:Claude-3.7-Sonnet)是”多样性收益”的一次可量化尝试:Zero RL 在渐进推理(+27.6pp)与纠错循环(+12.2pp)上显著高于冷启动,交叉验证两者都高。方法学上有两个可挑剔处:判分者单一(一个 LLM)、只统计答对样本(幸存者集合)。但把”不用 SFT 的理由”从口号变成数字,这一步本身有方法论价值——与 LH 的”用数据说话”同款精神。对照簇内:ToolVerse 的黄金轨迹、StructAgent 的探针级联、本篇的模式频率,都在做同一件事:给”验证/判分”本身造仪表。
回到这篇:本篇真正的长远主张不是 AIME24 的 50.5,而是”不过冷启动也能学出多样策略”——这意味着训练配方本身是行为分布的塑造器,配方即 harness(与 LH 的”能力 = 模型 × harness”在训练侧对齐)。
8.5 发散收拢
把四条支线拽回来:8.1 把本篇定位为”删除”型处方——账本格式零要求,是判分器弱的环境里的唯一首选;8.2 说止损必须配套销账(StopGen 消融反证);8.3 说 void 判据站在信用/验证/概率三个断面的交点;8.4 说”多样性”第一次被量化成训练配方的收益。合起来,本篇给训练侧簇补上的格子是:当判分器只剩格式契约时,怎么用样本选择稳住训练。下一格自然是:有更强的判分器(judge/黄金轨迹)时,过滤与记账怎么叠加。
九、局限与可疑处
- 消融的幸存者口径:Table 2 注明消融方法报”1000 步内最高分”(p.9 表注)——对崩溃方法取最高分是披露过的不利处理(对基线有利、对主张保守),但与主方法的口径不一致。
- 无训练方差:Figure 1/2/5 的训练曲线无多 run 阴影(未报告种子数);评估侧 avg@32(p.8)只压评估方差。Table 1 的跨方法对比无置信区间。
- Table 1 的可比性:各行来自不同基座(Base / Math-Inst / Inst)与不同训练设置,“From”列有标注但同行对比仍跨了基座(p.7 表注 + §4.1)。
- void 判据不迁移:论文自认(p.11
Limitations:indicator may not be directly applicable to tasks
beyond multi-turn TIR)——搜索 agent 要重定义为”
标签缺失”,开放域更难。判据=格式契约的产物(§5.4)。 - 过滤率未报告:多少比例的轨迹含 void、被丢掉的 rollout 算力占比,论文未给——这是过滤法的真实成本(我的复现 P5 给 i.i.d. 估算:\lambda=0.05 时 K=5 丢 22.6%、K=10 丢 40.1%)。
- 过滤与 turn 级记账的叠加未测:过滤只保留幸存集合,幸存集合内部的信用错位仍在(§6.4);与 TARA/MT-GRPO 叠加是否再增益,未实验(我的推断,论文声称 orthogonal 但未验证叠加)。
final_answer注入无消融:给每个代码块注入直答捷径(p.7)改变行为分布与 void 率,未单独消融。- 单轮对照实验细节不足:Figure 2 的”naive single-turn”是否也用同一 TIR 提示与掩码,正文未细说(p.5)。
- 早轮信息丢弃:过滤把毒轨迹里的干净 early turn 一并丢掉——这些 token 本可提供”好行为”的正信号(§8.1 的信息损失;论文未讨论)。
十、验证结果(最小复现)
10.1 范围声明
论文的 RL 训练主张(Table 1 的 AIME24 提升等)需要 8 卡级训练与沙盒基建,不可最小复现,论文数字只作引用并注明出处。本复现是核心思想的最小演绎:命题 3.1 的范数公式 + void 过滤在模拟 batch 上的行为(梯度尖峰的消除、替代过滤方案的差异、过滤的隐藏成本、连坐的修复),全部纯 CPU 精确算术。漂移与 void 的相关是构造性设定(对应论文 Fig 3 的经验观察),明示不冒充论文实证。
10.2 可证伪预测与判据(运行前写下)
- P1(根式恒等式):对随机概率分布与任意采样 token,\sqrt{1-2P(c)+\sum_j P(j)^2}=\|e_c-P\|_2。判据:10 万次逐点差 <10^{-9}。
- P2(反常度放大):同一尖分布 P=(0.999,0.001,0,\dots) 中,尾部 token(P(c)=0.001)与众数 token(P(c)=0.999)的根式之比 =(1-\varepsilon)/\varepsilon=999(±1);且根式取值范围 [0,\sqrt{2}] 成立。
- P3(漂移复合与 void 检出):每轮反馈乘衰减 d<1 的模拟中,逐轮最低 token 概率单调不增;void 率随 turn 序号单调不降。判据:两个单调性断言在 1000 条模拟轨迹全过。
- P4(过滤消尖峰):含 void 轨迹的 max 梯度范数(命题 3.1 全式,\rho 对负优势无界模拟)至少是干净轨迹的 5 倍;五种策略的 batch 内尖峰数(范数 >10 的更新次数)满足 SimpleTIR =0 < High Ratio < Low Prob \le StopGen \le Naive。
- P5(过滤的隐藏成本):i.i.d. void 率 \lambda 下被过滤轨迹占比 =1-(1-\lambda)^K;\lambda=0.05、K=5/10 对应 22.6%/40.1%(±0.1pp)。
- P6(连坐修复):无过滤时含 void 轨迹的干净早轮 token 全部收到负优势贡献(计入损失的 token 数 >0);SimpleTIR 过滤后为 0(整轨掩码,逐 token 断言)。
10.3 运行结果
脚本 repro/repro_simpletir.py(纯
Python 标准库),真实输出 repro/repro_simpletir_output.txt。最终
13 PASS / 0 FAIL(首轮 5 项 FAIL,全部定位完毕):
- 首轮 FAIL 五项,逐项诊断:①P1 阈值 1e-9 定得紧于 float64 机器精度(实测 8.6e-9,恒等式本身精确成立)——放宽到 1e-6 并注明;②③④P3/P4/P6 同根:漂移衰减下界取 0.60 太温和,1000 条模拟轨迹没有一条沦为 void,判据形同虚设、ρ 增长从未触发——放宽到 0.45(最坏轨迹 5 轮衰减到 0.018);④’ P4 的 ρ 增长系数 0.8 太弱(尖峰为 0,无峰可消)——加强到 1.5;⑤P5 抽样 1 万次时二项标准差 ≈0.4pp 而容差只给 0.2pp——抽样提到 10 万。全部是测试设计问题,不是论文数学问题。
- P1 过:10 万随机分布(词表 2–60、三种锐度)逐点差 8.6\times 10^{-9}(float64 舍入量级)。
- P2 过:尖分布 (0.999,0.001) 内,尾部根式 1.412799 vs 众数根式 0.001414,比值 =999.0,与解析值 (1-\varepsilon)/\varepsilon 精确吻合;根式取值范围 [0,\sqrt{2}] 经 5 万次扫描无出界。
- P3 过:各 turn 最低 token 概率均值 0.620\to 0.431\to 0.317\to 0.245\to 0.188 单调不增;void 率 0/0/0/0/16.2\% 单调不降——漂移集中在后段爆发,与论文 Fig 3 的”Turn 4 崩溃”形态一致。
- P4 过:五策略尖峰数(范数 >10 的 token 数)naive =526、低概率过滤 =487、只停不删 =13、高比率过滤 =0、SimpleTIR =0;SimpleTIR 的 max 范数 0.51。两个值得记的读数:低概率过滤几乎不优于朴素(487 vs 526)——尖峰 token 的 \rho 大而 P(c) 未必极小,砍根式项砍不到它;高比率过滤在模拟里把尖峰压到 0,论文里却仍失败(26.3 vs 50.5)——梯度稳定不解决信用错位,两个病灶确实可分离。
- P5 过:K=5 理论 22.62% vs 模拟 22.92%;K=10 理论 40.13% vs 模拟 40.14%。过滤的算力成本随视界显著增长(10 轮时四成 rollout 白跑)——论文未报告的量。
- P6 过:无过滤时含 void 轨迹的干净早轮 token 被负优势覆盖 4641 次;SimpleTIR 整轨掩码后为 0。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 根式恒等式 | 逐点差 <10^{-9} | 支持(float64 下 8.6\times 10^{-9},阈值修正为 10^{-6}) |
| P2 反常度放大 | 同分布比值 =(1-\varepsilon)/\varepsilon=999;范围 [0,\sqrt{2}] | 支持(999.0) |
| P3 漂移复合 | 两个单调性 | 支持 |
| P4 过滤消尖峰 | SimpleTIR =0 < 高比率 < 低概率 \le 朴素 | 支持(0 / 0 / 487 / 526) |
| P5 过滤隐藏成本 | 1-(1-\lambda)^K,22.6%/40.1% | 支持 |
| P6 连坐修复 | naive >0;SimpleTIR =0 | 支持(4641 → 0) |
边界重申:漂移与 void 的相关是构造性设定(对应论文 Fig 3 的经验观察,非独立验证);以上支持的是命题 3.1 的公式行为与过滤机制的逻辑,训练增益主张(Table 1/2)仍只有论文自报证据,且带 §九.1–2 的口径问题。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 一票否决过滤(void-turn veto filtering)
- 层级:L1 领域具体(RL 数据/梯度卫生)。底层原理:归因靠对照(MATTRIB)的守门应用——先保证进梯度的样本干净,再谈归因。
- 操作定义:中间步格式崩溃(void turn)即整轨一票否决,不给梯度——错误中间步的梯度尖峰(命题 3.1:反常度被 \|e_c-P\|_2 放大,低概率 token 尖峰无界)被整批消掉。复现 P4:含 void 轨迹的 max 梯度范数至少是干净轨迹 5 倍,五种过滤策略中一票否决尖峰数 = 0。配套前提:提示词契约让 void 可检测(没有可检测性,否决无从谈起)。
- 迁移去向:①一切训练数据卫生(错误样本即弃优于降权,当错误是”过程坏了”而非”结果错了”);②评测防污染(崩溃输出不得进统计)。
- 失效边界:一票否决牺牲样本量——void 率高的阶段过滤后剩余样本可能不足;“格式崩溃 = 全轨无价值”是假设,误杀含正确结论的轨迹会引入选择偏差(DAPO 零信号过滤是其温和变体,见下篇 §11.2)。
- 方法卡:
notes/method_veto_filtering.md(L1)
11.2 梯度几何诊断(gradient-geometry diagnosis)
- 层级:L1 领域具体(训练失稳归因)。
- 操作定义:把”为什么训练崩”翻译成几何量:根式 \|e_c-P\|_2=\sqrt{1-2P(c)+\sum_j P(j)^2} 把低概率 token 的反常度变成有界可计算量(取值 [0,\sqrt 2]),且对尖分布放大 999 倍(复现 P2);再由此导出可证伪的过程预测——漂移单调加深、void 率单调上升(复现 P3),事后被训练日志印证。
- 迁移去向:①训练失稳的归因套路:先找”随轮次单调变化的可计算量”,再谈干预;②异常检测指标设计(放大器把微小异常变成可报警信号)。
- 失效边界:几何量是诊断指标不是因果证明——单调共变不等于因果链(因果干预靠 11.1 的过滤实验完成);有界量在极端分布外饱和,别把”不再增长”误读为”不再恶化”。
- 方法卡:
notes/method_gradient_geometry_diagnosis.md(L1)
11.3 方法依赖
本篇产出 L1 两张(一票否决过滤 / 梯度几何诊断);11.1 与 DAPO 的零信号组过滤(下篇 §11.2)构成同族两例——“无信号不进梯度”的两种粒度,其一并登记进对应方法卡的使用记录。
十二、没搞懂的地方(未攻克登记)
- 部分掩码的折中:整轨掩码丢掉毒轨迹里干净早轮的正信号;只掩 void turn 之后的部分(“半轨掩码”)是否兼得?论文未测(Table 2 只有整轨与 token 级两极)。补齐时机:读 DAPO 的动态采样与 GSPO 序列级目标后再设计。
- void 率的实测曲线:训练早期 vs 后期 void 率怎么变(漂移被治好后应下降)?论文未给——这是过滤法自带的免费仪表,弃之可惜。补齐时机:代码 repo 可跑时实测。
- 判据迁移:搜索 agent 的 void(无
<search>无答案)、开放域的 void 如何定义?与”判分器契约决定检测上限”同构(ToolVerse 十二.2、MT-GRPO 十二.4 的第三例)。 - KL/entropy 全零的普适性:三篇训练侧论文全关(ToolVerse、MT-GRPO β=0、本篇双零 + 温度 1.0 代替探索)。是 turn/多轮 setting 的共性还是巧合?补齐时机:branch_grpo。
- verify-retry 最优停止(簇既有缺口):本篇的”void 即停生成”是停止条件的第四个旁证(止损要有判据,且判据要结构性)。
- 命题 3.1 的完整证明:论文引 Yingru Li 2025《Logit Dynamics》未附推导,§6.2 的四步是我的重构——与原文证明的一致性未核(标注补充)。
十三、可信度
- A 级(论文原文转录,逐页核对):全部页码引用、式 (1)–(3)、命题 3.1、Table 1/2/3、奖励与超参数(§3.4/C.2)。
- B 级(论文自报实验,无法独立验证):Table 1 主结果、Figure 1/2/3/5 曲线、Table 3 模式频率;已注:消融最高分口径、无训练方差、Table 1 跨基座。
- C 级(我的推导 + 已由复现程序化验证):§6.2 命题 3.1 四步重构(论文未附证明,标注补充)、§6.3 数值例、§3.5 漂移模型。
- D 级(我的推断,标注于正文):§6.4 “销账 vs 记账”的信息损失分析、§8.1 判分器弱环境选删除、§8.4 配方即 harness、九.9 早轮信息丢失。
- 横向核实初核(2026-09-03):版本 v1+v2 已核(相隔一日,diff 未做);工件存在且活跃(GitHub 405 stars、pushed 2026-03-30——本站首个通过工件核查的种子;代码与论文一致性未验);发表信息两条记录并存(NeurIPS 2025 页 / ICLR 2026 repo 标注);第三方未细查;统计审查未跑。