外行导读(先读这个,再决定要不要进正文)
一个场景:AI 模型排行榜说”模型 A 比 B 强”。但裁判是个 LLM,而 LLM 爱看长答案——于是”把回答写长”这件事本身就能涨分。更糟的是:模型作者一旦发现这一点,就会专门训练模型写长文刷榜。排行榜从此量到的不是”谁更好”,而是”谁更会利用裁判的毛病”。
这篇论文干的事:给 AlpacaEval 排行榜做了一次”统计去偏”。做法是把裁判的偏好拟合成一个逻辑回归——三个项:模型身份、长度差、题目难度——然后把长度项清零再算一次胜率,得到”如果两个模型回答长度相同,谁会赢”的反事实答案。这个”长度受控胜率”把对 Chatbot Arena 人类偏好的相关性从 0.94 提到 0.98(现有自动基准里最高),把”靠提示词改长度刷分”的波动从 25% 压到 10%,还顺手防住了一种”截断攻击”。榜单证据显示:闭源模型(普遍偏短)排名上升、开源 RLHF 模型(普遍偏长)排名下降——与”开源模型曾利用长度偏置刷分”的假说一致。
为什么值得关心:这是判分器质量簇设计翼的方法学深潜——ToolRL 篇说”去冗长偏置的正路是压 λ”,这一篇就是”压 λ”的完整教科书:怎么把 λ 从裁判行为里估计出来、怎么在不重跑裁判的情况下做反事实修正、怎么防修正本身被攻击。任何”评测指标被人当优化目标”的场景(刷榜、KPI、绩效考评)都会遇到同一件事:指标一旦被博弈,就得做反事实修正,而修正本身又成为新的博弈面——本文连这个二阶问题都处理了(φ 正则化)。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| AlpacaEval 2.0 | 805 条指令、GPT-4-turbo 当裁判的自动评测榜;胜率 = 裁判偏好被评模型的期望 |
| 长度博弈(gameability) | 只靠”把回答写长/写短”就能显著改变指标结果的性质 |
| 反事实问题 | “如果两个模型的回答一样长,裁判会偏好谁?” |
| GLM / 逻辑回归 | 广义线性模型:对 0/1 结果拟合一条 sigmoid 概率曲线 |
| 混淆变量 c | 与质量无关但与结果相关的变量(这里=输出长度);模型优化它就变成作弊 |
| 直接效应 / 间接效应 | 质量对判分的真实影响 vs 经由长度中介的虚假影响 |
| LC 胜率 | 长度受控胜率:回归里长度项置零后的反事实胜率 |
| 恒等性质 | 同一模型的回答自己比自己:概率恒 0.5 |
| 对称性质 | 交换两模型:胜率变 100% 减自身 |
| φ 正则化 | 对长度系数加 L2 惩罚——防”故意把差答案截短来骗长度修正”的二阶攻击 |
| τ 平滑 | 判分概率的移动平均(附录基线法),本文对照法之一 |
§0 承接栏
这篇接的是昨天(种子 10)攒下的一笔账。MT-Bench 篇量出冗长偏置的剂量(复读清单攻击 Claude/GPT-3.5 有 91.3% 被骗),收尾时留了一句”去偏正路是压 λ(如 LC-AlpacaEval 的回归剥离)“——”如”字后面的这篇,就是那个”压 λ”的方法本体。它也接上簇内更早的一笔:ToolRL 篇在设计翼里说”奖励的每个分量都是设计变量”,这一篇把”评测指标的分量”同样当设计变量处理——训练内环的奖励要设计,评测外环的指标同样要设计,两翼在”分量可分离”这个数学结构上会师。
第三笔账记给 DAPO 篇:DAPO 的判分器设计原则是”能简化就简化”(答案整数化),本篇反其道行之——“该复杂就复杂”(回归剥离)。两条原则不矛盾:判分器复杂度跟着博弈面走,博弈面在哪,设计就得跟到哪。
一、论文在解决什么问题
1.1 一个具体场景
AlpacaEval 2.0 是社区最快的自动评测榜:805 条指令、GPT-4-turbo 裁判、不到 10 美元 API 费跑完一个模型(§4.2)。但它的胜率对长度极其敏感——论文做一个实验:只改提示词让模型”答得尽量详细”或”尽量简洁”,基座模型 GPT-4-1106-preview 的胜率在 22.9% 到 64.3% 之间来回跳(§4.1,Figure 3)。更严重的信号在榜单上:开源 RLHF 模型的回答普遍偏长,它们的排名在剔除长度效应后系统性下滑(Figure 4)——说明长度偏置已经被当作优化目标利用过(§4.2 的假说)。指标被博弈,是评测的死亡判决:它量的不再是质量。
1.2 与前几篇的入口差
MT-Bench 从”量出偏置”进(位置/冗长/自我增强三张剂量表),本篇从”修正其中一个偏置”进——单变量(长度)、单指标(AlpacaEval)、全深度(从估计到反事实到防二次攻击)。与 ToolRL 的分工:ToolRL 在训练内环设计奖励分量(λ 是训练信号的一部分),本篇在评测外环剥离指标分量(λ 是评测指标的污染项);两处的 λ 数学上同构,都进 logistic 型效用函数的一线性项。
二、核心想法
一句话:把裁判偏好拟合为”模型身份 + 长度 + 题目难度”三项逻辑回归,然后将长度项清零、重算期望——得到的 LC 胜率就是对”如果两边回答一样长谁会赢”这一反事实问题的估计,且恒等性、对称性、可解释性三个好性质自动保持。
这个想法的深意在于它的因果姿态:裁判分数 = 直接效应(质量)+ 间接效应(经长度中介的虚假部分)。修正不需要重跑裁判、不需要改判分提示——只需要一个回归模型把间接效应估计出来再减掉。这是因果推断里受控直接效应(Controlled Direct Effect,论文引 VanderWeele 2010,转引未核对)的标准操作,第一次被搬到 LLM 排行榜上。
先打个比方。马拉松成绩表里混进了”顺风选手”——他们跑的时候顺风、别人逆风,成绩普遍好看。修正不需要重赛:把每位选手的风阻项估计出来、统一按无风条件折算就行。折算后的榜单才回答”谁跑得快”,而不是”谁运气好”。本篇的全部技术内容就是”风阻项怎么估、折算怎么做、有人会不会故意制造逆风来骗折算”。
落到形式上:式 (1) 的三项回归拟合裁判概率,式 (2) 把长度项置零得 LC 胜率。恒等性质(自己比自己 = 0.5)与对称性质(交换 = 100%−自身)由三项的反对称结构自动保证——不是补丁,是构造。
所以这篇真正改变了什么:把”评测指标的偏置修正”从一次性手工(加权、截断、长度归一)升级为可拟合、可验证、可防二次博弈的统计管线——并且证明修正后的指标与人类偏好的相关性反而更高(0.94→0.98)。去偏不再有”损失信息”的借口。
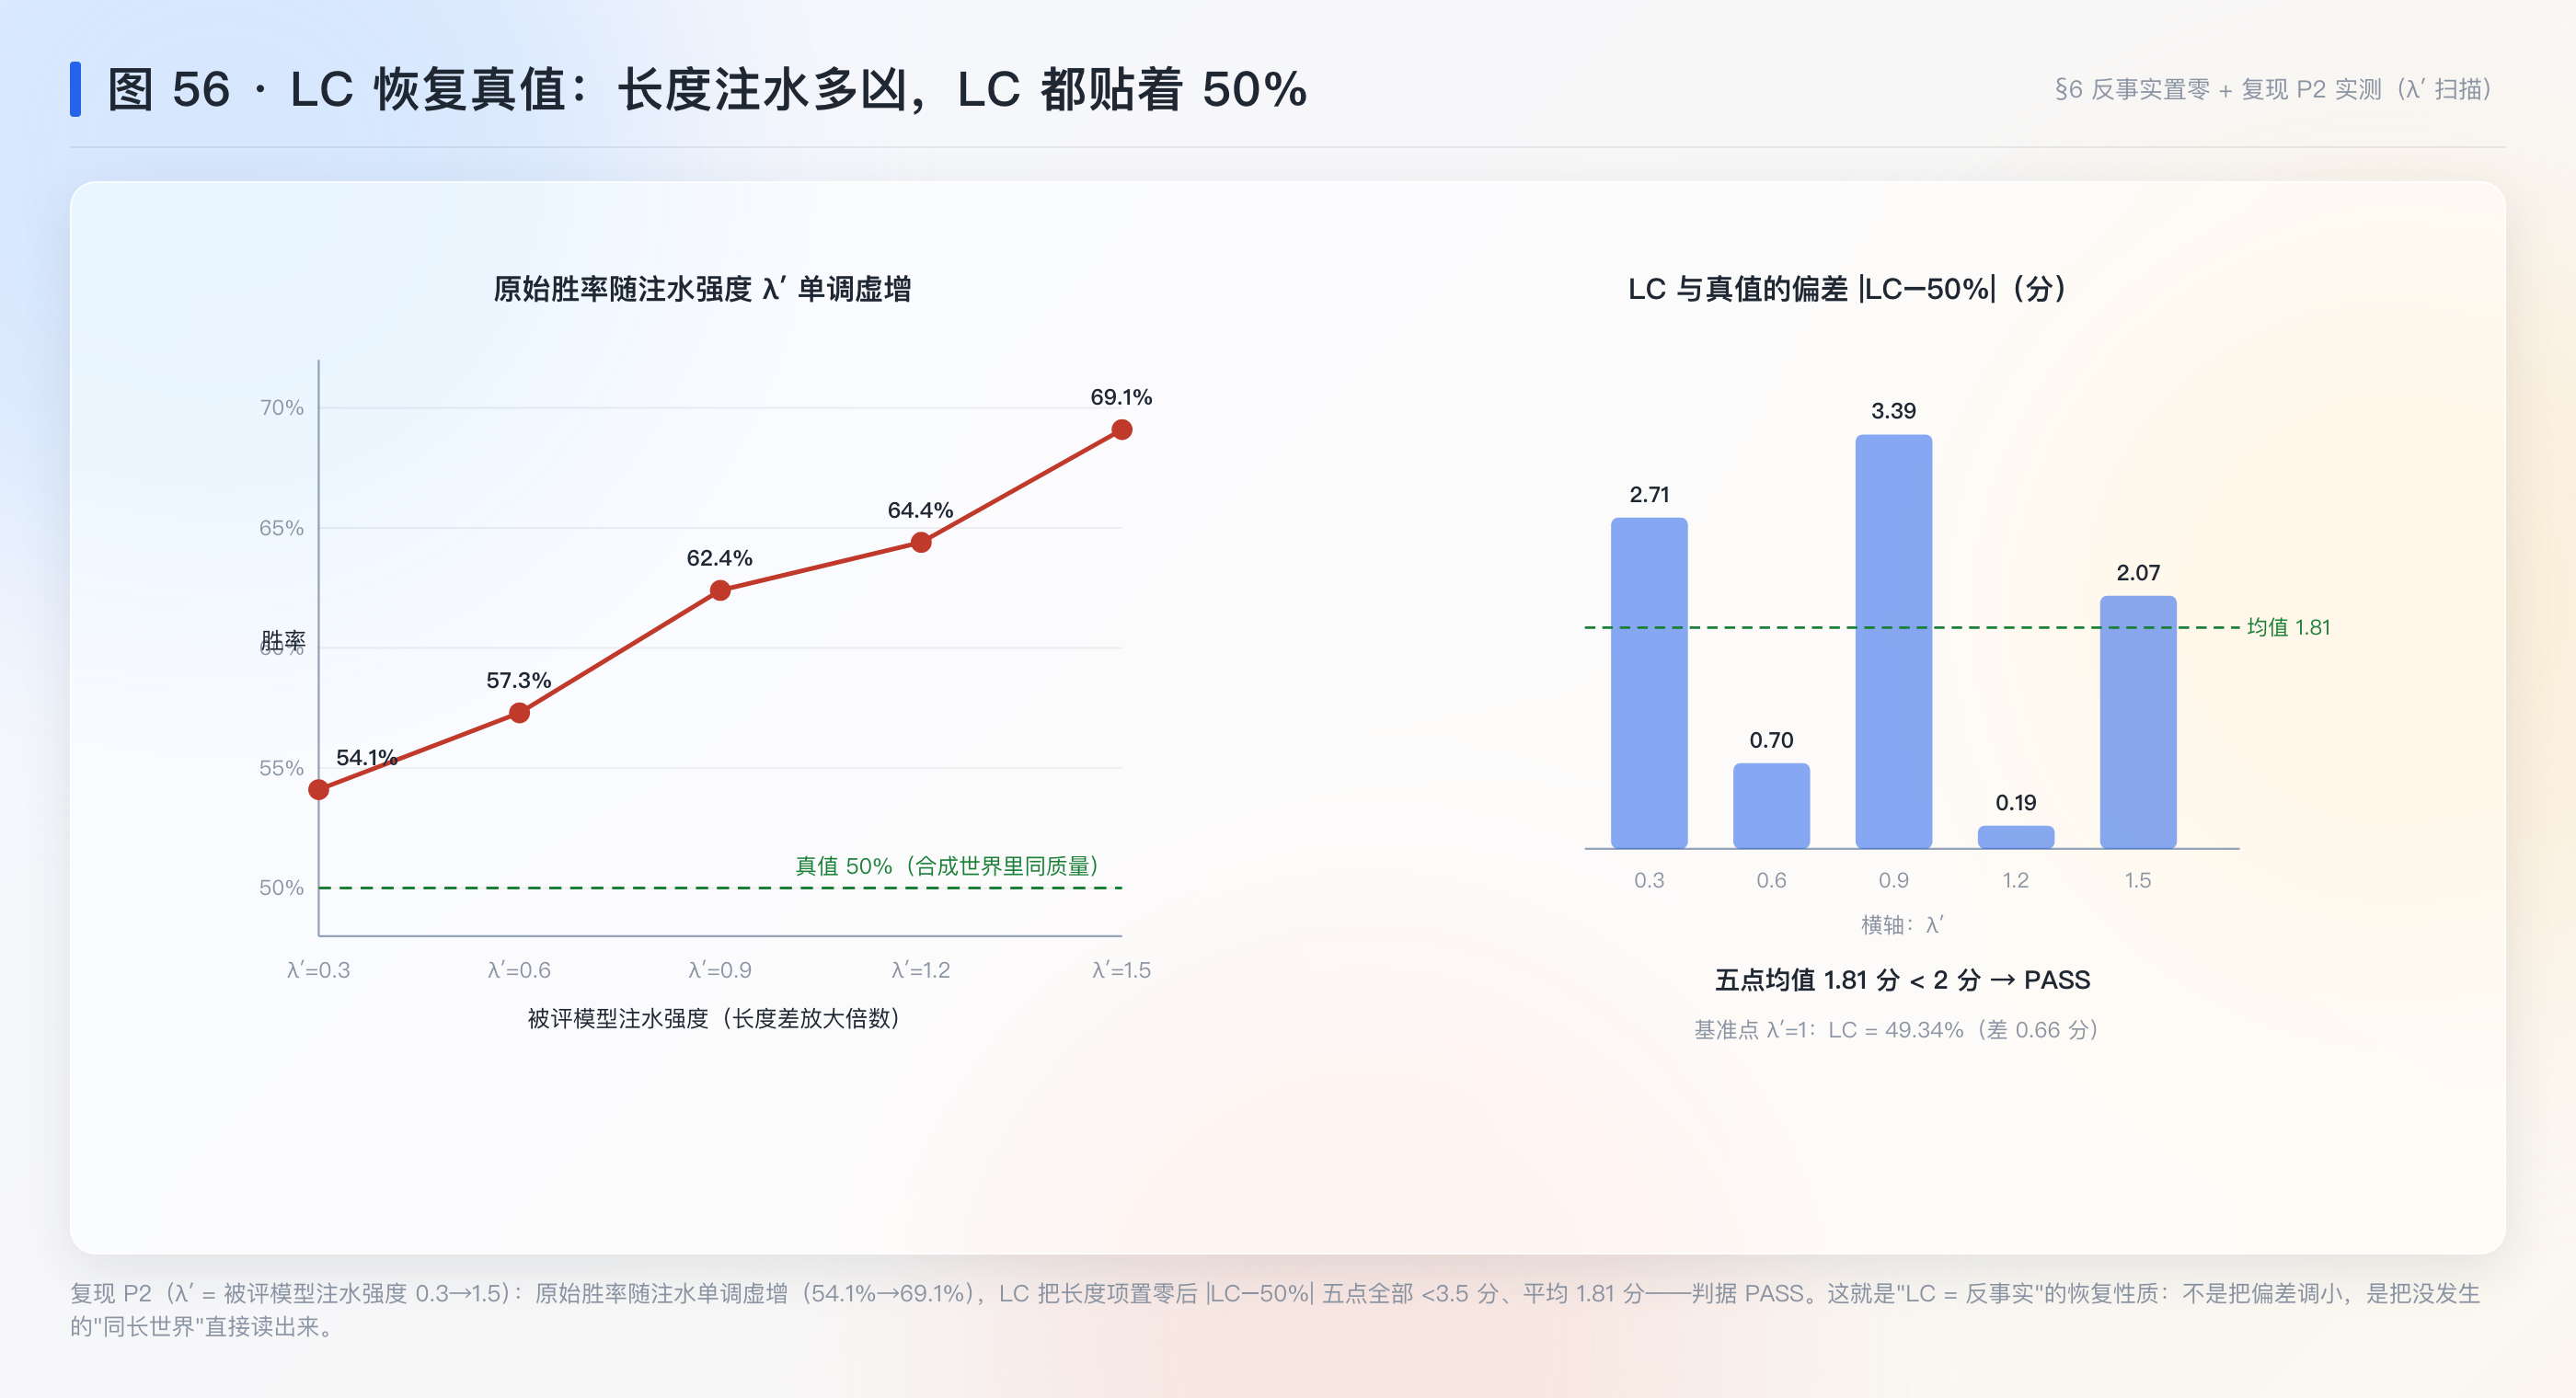
全篇就看这张:图 56(§六)——λ′ 从 0.3 扫到 1.5,长度注水越凶原始胜率虚增越多(54.1%→69.1%),而 LC 始终贴着真值 50%(五点平均误差 1.81 分)。一张图说完”反事实置零 = 精确去偏”,后面所有攻防都是给它上保险。
三、数学基础(零起点,本篇新用到的四件)
3.1 logistic 函数与对数几率
第一件是 logistic 函数:\mathrm{logistic}(x)=\frac{1}{1+e^{-x}},把任意实数压到 (0,1) 当概率用。它的关键性质在对数几率上:\mathrm{logistic} 的输入 x 就是”对数几率”(log-odds)——x 加 1,胜率的优势比乘 e。这解释了式 (1) 为什么是三项相加:每个因素(模型、长度、难度)在 log-odds 尺度上线性叠加,最后一次性压成概率。另一个要紧的性质是对称:\mathrm{logistic}(x)=1-\mathrm{logistic}(-x)——交换两方相当于取补,式 (1) 的对称性质全靠它。
3.2 反事实与受控直接效应
第二件是反事实估计。直觉:无法重跑”如果两模型回答一样长”的世界,但可以在观测数据上拟合”长度如何影响判分”的规律,再用规律推算那个没发生的世界。受控直接效应(CDE)问的是:固定中介变量 c(长度)时,原因(模型)对结果(判分)的直接影响。写成定义:\mathrm{CDE}(c)=P(y=1\mid m, c)-P(y=1\mid b, c)——本篇的 LC 胜率正是 c=“长度与基座相同”处的 CDE。前提是回归把中介路径(长度 → 判分)与直接路径(质量 → 判分)分开建模——式 (1) 的三项分离就是为此设计的。
3.3 tanh 与收益递减
第三件是 tanh:\tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}},S 形、奇函数、值域 (−1,1)。为什么长度差要过 tanh 再进回归?论文一句话:“differences in lengths should have strong diminishing returns on the log odds”(§3)——长度差从 0 涨到 100 字的判分影响,远大于从 1000 涨到 1100;线性项会外推失控,tanh 把影响压在有界区间内且保持边际递减。奇函数性质(\tanh(-x)=-\tanh(x))则保证对称性质在长度项上不破。
3.4 Spearman 秩相关
第四件是 Spearman 秩相关:把两列数值各自换成排名后再算 Pearson 相关系数。为什么用秩不用值?论文原话:概率与 ELO 评分是”对数线性”关系而非线性关系(§4)——胜率从 50% 涨到 60% 和从 90% 涨到 95%,在 ELO 尺度上幅度完全不同。秩相关只关心”谁排在谁前面”,对这种非线性单调变换稳健。本篇的主结果(0.94→0.98)与所有基准对照都用它。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| \mathrm{winrate}(m,b)=100\cdot\mathbb{E}_x[f(z_m,z_b,x)] | 原始胜率:裁判偏好被评模型的期望 | §2 |
| q_{\theta,\phi,\psi}(y=1\mid z_m,z_b,m,b,x) | 三项回归的判分概率 | 式 (1) |
| \theta_m-\theta_b | 模型身份项(log-odds 尺度的”真实质量差”) | 式 (1) |
| \phi_{m,b}\cdot\tanh\!\left(\frac{{\rm len}(z_m)-{\rm len}(z_b)}{{\rm std}({\rm len}(z_m)-{\rm len}(z_b))}\right) | 长度项(标准化后过 tanh,边际递减) | 式 (1) |
| (\psi_m-\psi_b)\gamma_x | 指令难度项(γ_x 为题目难度,先联合拟合固定) | 式 (1) |
| \mathrm{winrate}_{LC}(m,b)=100\cdot\mathbb{E}_x\,\mathrm{logistic}(\theta_m-\theta_b+(\psi_m-\psi_b)\gamma_x) | LC 胜率(长度项置零的反事实) | 式 (2) |
| \varnothing 恒等性质 | q(y=1\mid z_b,z_b,b,b,x)=0.5 | §3 |
| \varnothing 对称性质 | q(y\mid z_m,z_b,b,m,x)=1-q(y\mid z_b,z_m,m,b,x) | §3 |
| L2 正则于 \phi_{m,b} | 防截断攻击的弱正则(对非对抗模型无感) | §4.3 |
| normalized std | 三个长度提示下胜率的归一化标准差(gameability 度量) | §4.1 |
五、机制
承上启下:§一 的麻烦是”长度偏置已被利用”,§二 的路线是”估计它、剥离它、防修正被反利用”。上节四件工具对上四个部件:logistic 对回归形式、CDE 对长度置零的含义、tanh 对长度特征、Spearman 对验证。本节按”部件→攻防”讲:5.1 三项分离,5.2 反事实置零,5.3 gameability 修正效果,5.4 二阶攻防(正则化)。
5.0 贯穿示例的数据结构
迷你榜(示例,结构同 AlpacaEval 真榜):
instructions = [x_1 ... x_80]           # 80 条指令,难度 γ_x 待估
models = [b(基座), m(被评), ...]         # m 的回答平均比 b 长 50%
rows = 每条 (x, m, b) 一个判分样本:
  { x, z_m, z_b,                        # 两条回答
    len_m, len_b,                       # 字数
    y: 1|0 }                            # 裁判是否偏好 m
示例的”事实”:m 与 b 真实质量相同(θ_m = θ_b),m 只是话多。原始胜率会显示 m 领先——整个方法的目标就是把这份虚假领先剥掉。
5.1 机制一:三项分离——把判分函数拆成可归账的三栏(§3,式 (1))
【类比 · 三栏记账】 裁判打分像一笔流水:里面混着”真本事分”“长度印象分”“题目难易折算”。三项回归就是把流水拆进三个账栏——模型项记真本事,长度项记印象分,指令项记题难折算。拆开之后,每个栏可以单独审计。 【跨域锚点】 回归去混杂 = 流行病学里”控制变量后重新估计效应”。(类比与通识锚点,非论文内容)
先看病。AlpacaEval 2.0 的加权去偏靠重加权样本,但权重对”长度”这个连续混杂的剥离是间接的;模型作者只要把回答写长,裁判效用里的长度项照样进总分。病根:判分概率里没有显式的长度栏,长度的影响与质量的影响在求和处无法归账。
药方:显式三项(式 (1))。三个设计决定各有讲究:①长度项用标准化差过 tanh——边际递减 + 有界;②指令难度 γ_x 先联合拟合后固定——新模型上榜不重估 γ,保证”已上榜的指标不会因为加了新模型而变”(§3 原文意思,工程上极重要);③模型项按 (θ_m − θ_b) 成对出现——天然满足成对比较的对称结构。
意义:三项分离让”长度偏置”从裁判的黑箱行为变成账本上一个可读出、可置零、可正则的系数 φ。
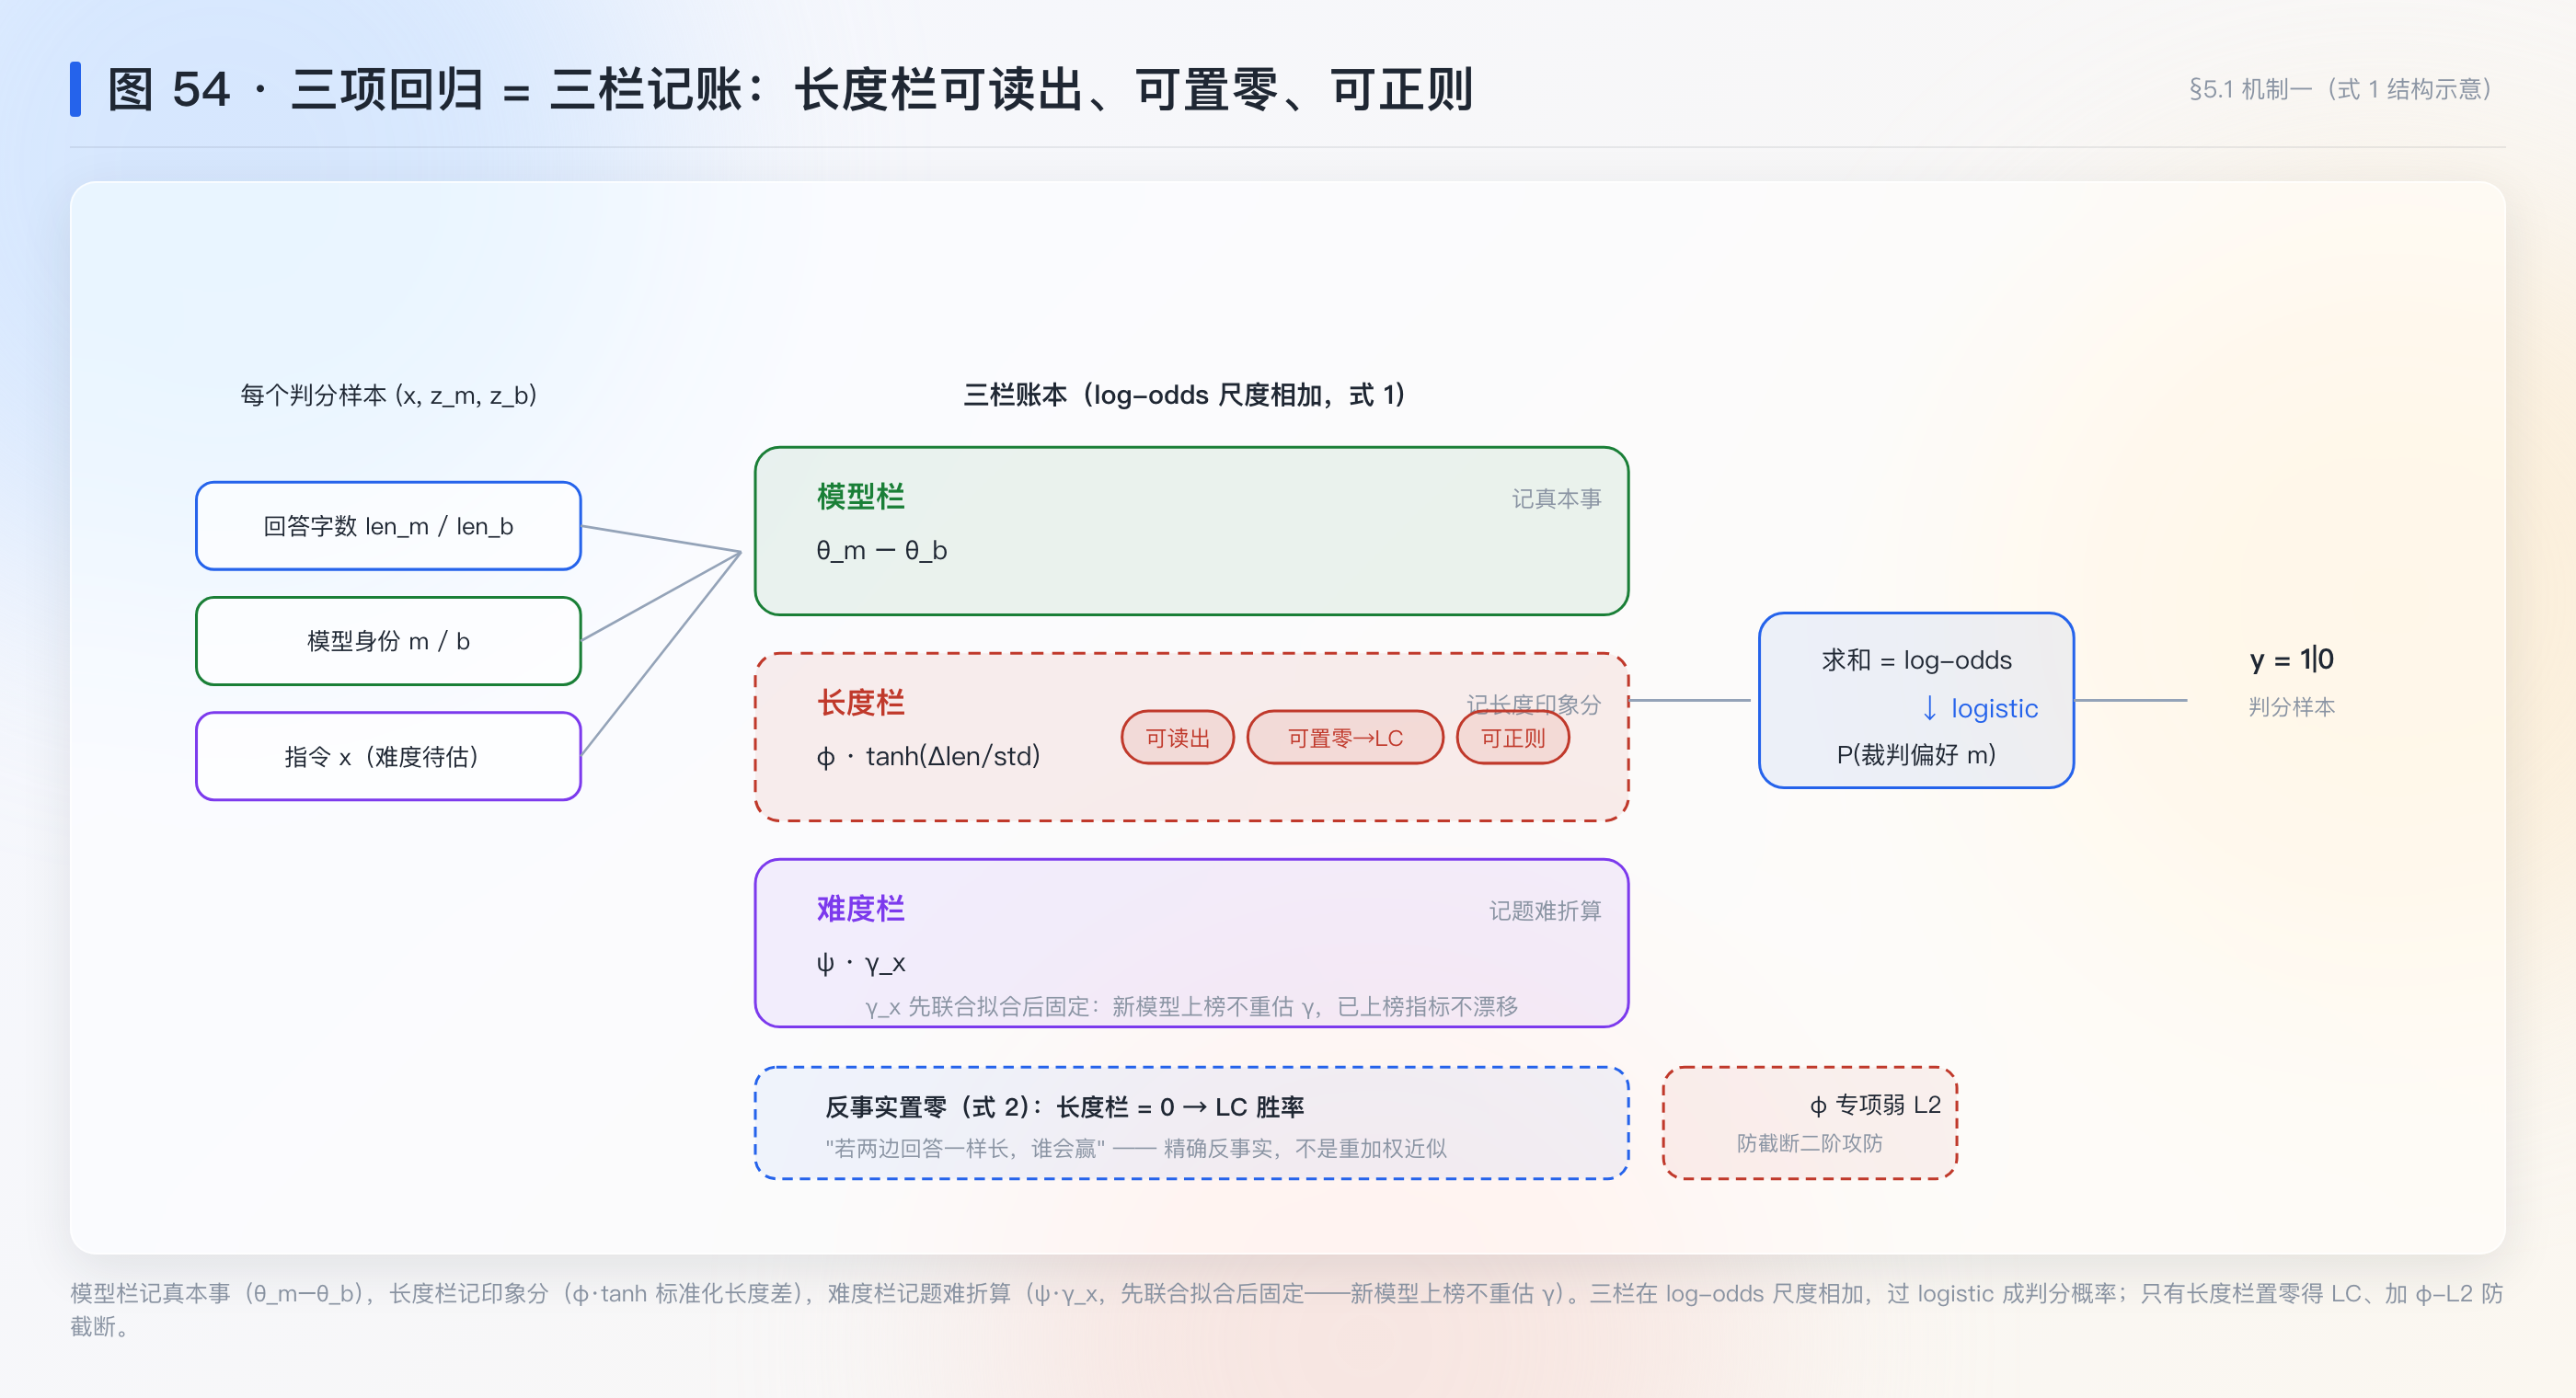
5.2 机制二:反事实置零——回答”如果一样长会怎样”(§3,式 (2))
【类比 · 无风折算】 顺风选手的成绩表上多了一段”风助分”。修正不重赛:估出每个人的风助系数,把成绩折算回无风条件。折算后的名次才是”谁跑得快”。 【跨域锚点】 因果推断的受控直接效应(CDE,VanderWeele 2010;论文转引,未核对原书)。(类比与通识锚点,非论文内容)
先看病。原始胜率 \mathrm{winrate}(m,b)=100\cdot\mathbb{E}_x[f(z_m,z_b,x)] 里长度项是活的——m 话多,f 就高。
药方:置零。LC 胜率(式 (2))把长度项从期望里删掉:
\mathrm{winrate}_{LC}(m,b)=100\cdot\mathbb{E}_x\,\mathrm{logistic}\bigl(\theta_m-\theta_b+(\psi_m-\psi_b)\gamma_x\bigr)
这就是反事实问题”若 len(z_m)=len(z_b) 会怎样”的回答——长度差为零时 tanh 项恰为零。为什么可以这样删?因为三项在 log-odds 尺度可加,长度项的期望贡献是 \phi_{m,b}\cdot\mathbb{E}_x[\tanh(\cdot)],“同长”的世界里这个期望就是 0——不是近似,是模型结构内的精确反事实(复现 P2 会验证这个”LC = 真值”的恢复性质)。
效果(§4.1–4.2):gameability 归一化标准差 25%→10%;对 Arena 的 Spearman 相关 0.94→0.98(现有自动基准最高);榜单迁移方向与”开源模型曾刷长度”假说一致(Figure 4)。
意义:反事实修正零成本(不重跑裁判)、可解释(仍是 0–100 胜率、基座恒 50%)、可迁移(拟合一次基座系数就能预测任意两模型对打,Figure 5)。
5.3 机制三:gameability 修正的验证(§4.1,Figure 3)
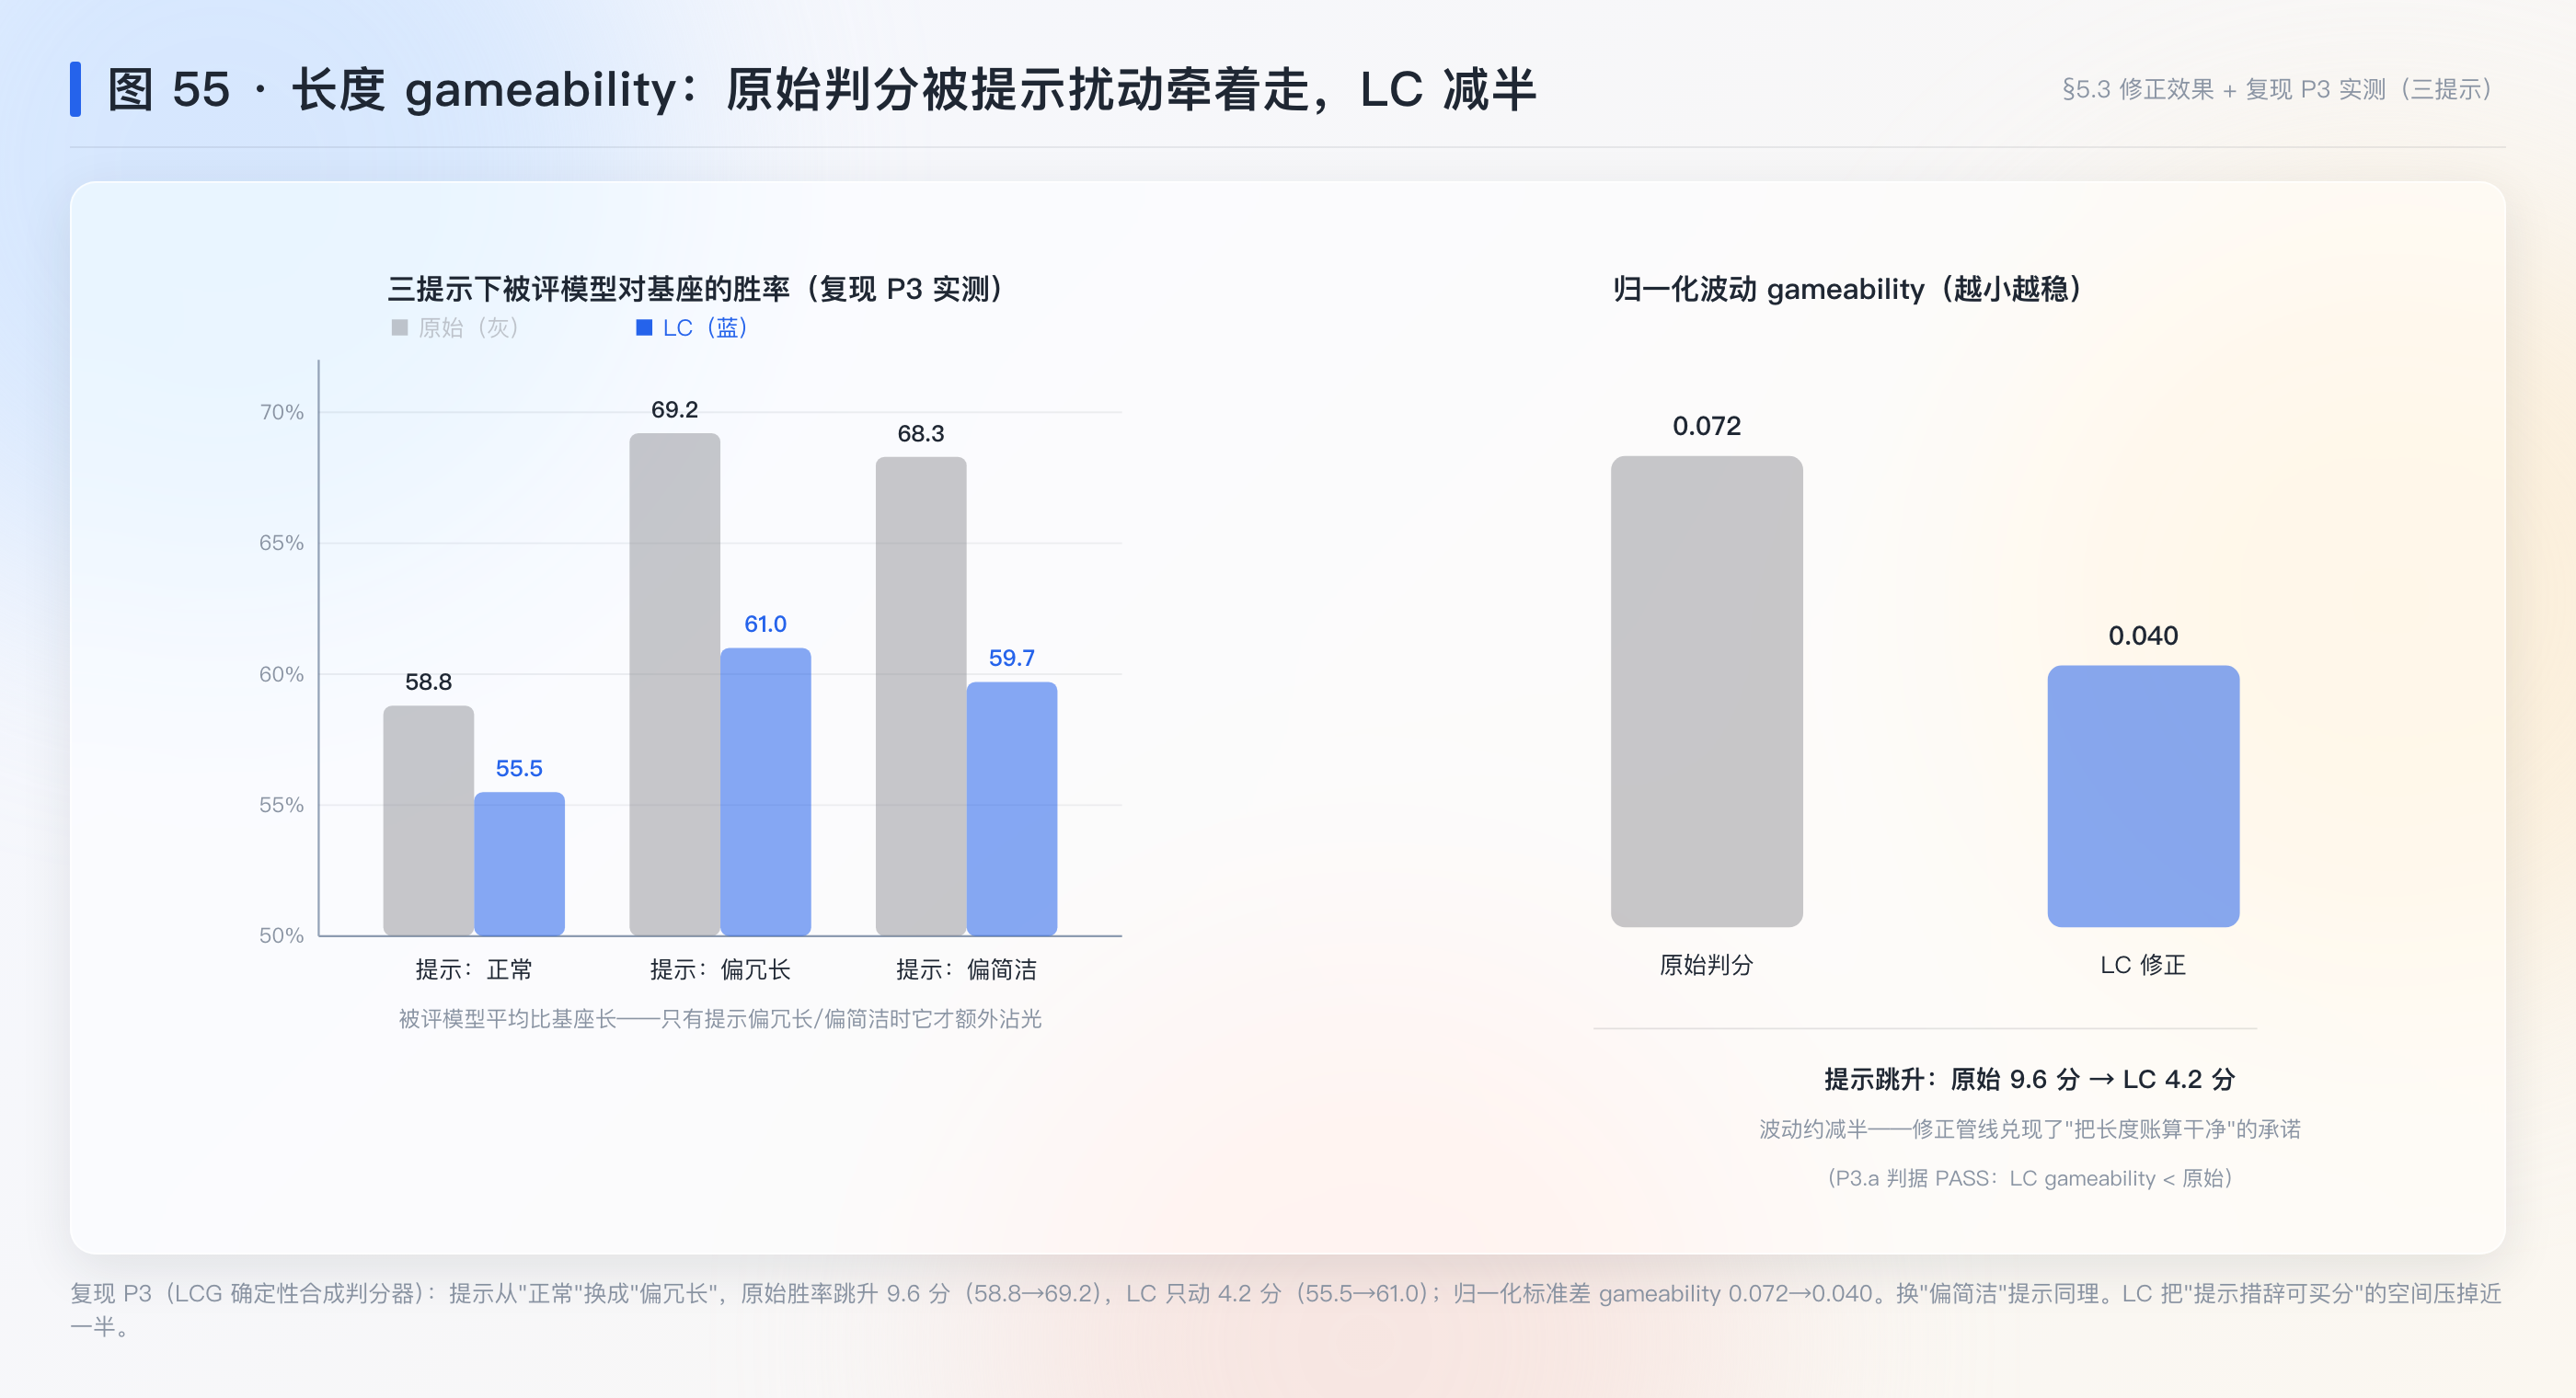
先看病(量化):提示词攻防下基座胜率 22.9%–64.3%(极差 41.4 分);LC 后 41.9%–51.6%(极差 9.7 分);归一化标准差 25%→10%。注意 LC 后并非完全不动(41.9 不是 50)——残余波动来自”详细版回答确实质量略变”与回归的估计噪声,这正是”反事实估计”而非”魔法归零”的诚实之处。
意义:一个”长度博弈性”的度量(三提示下的归一化标准差)随之诞生——它本身就是判分器质量簇四量体检表之外的第五量:对提示扰动的敏感度。
5.4 机制四:二次攻防——修正本身也会被博弈(§4.3)
【类比 · 报销防套现】 公司给”长行程”多报差旅(长度修正),员工就把短行程的票据故意写成短途多段来骗修正系数。对策:给报销系数加约束,让”行程问题”先记进业务账,剩余部分才进里程账。 【跨域锚点】 Goodhart 定律的二阶形态:修正指标也会成为新的优化目标。(类比与通识锚点,非论文内容)
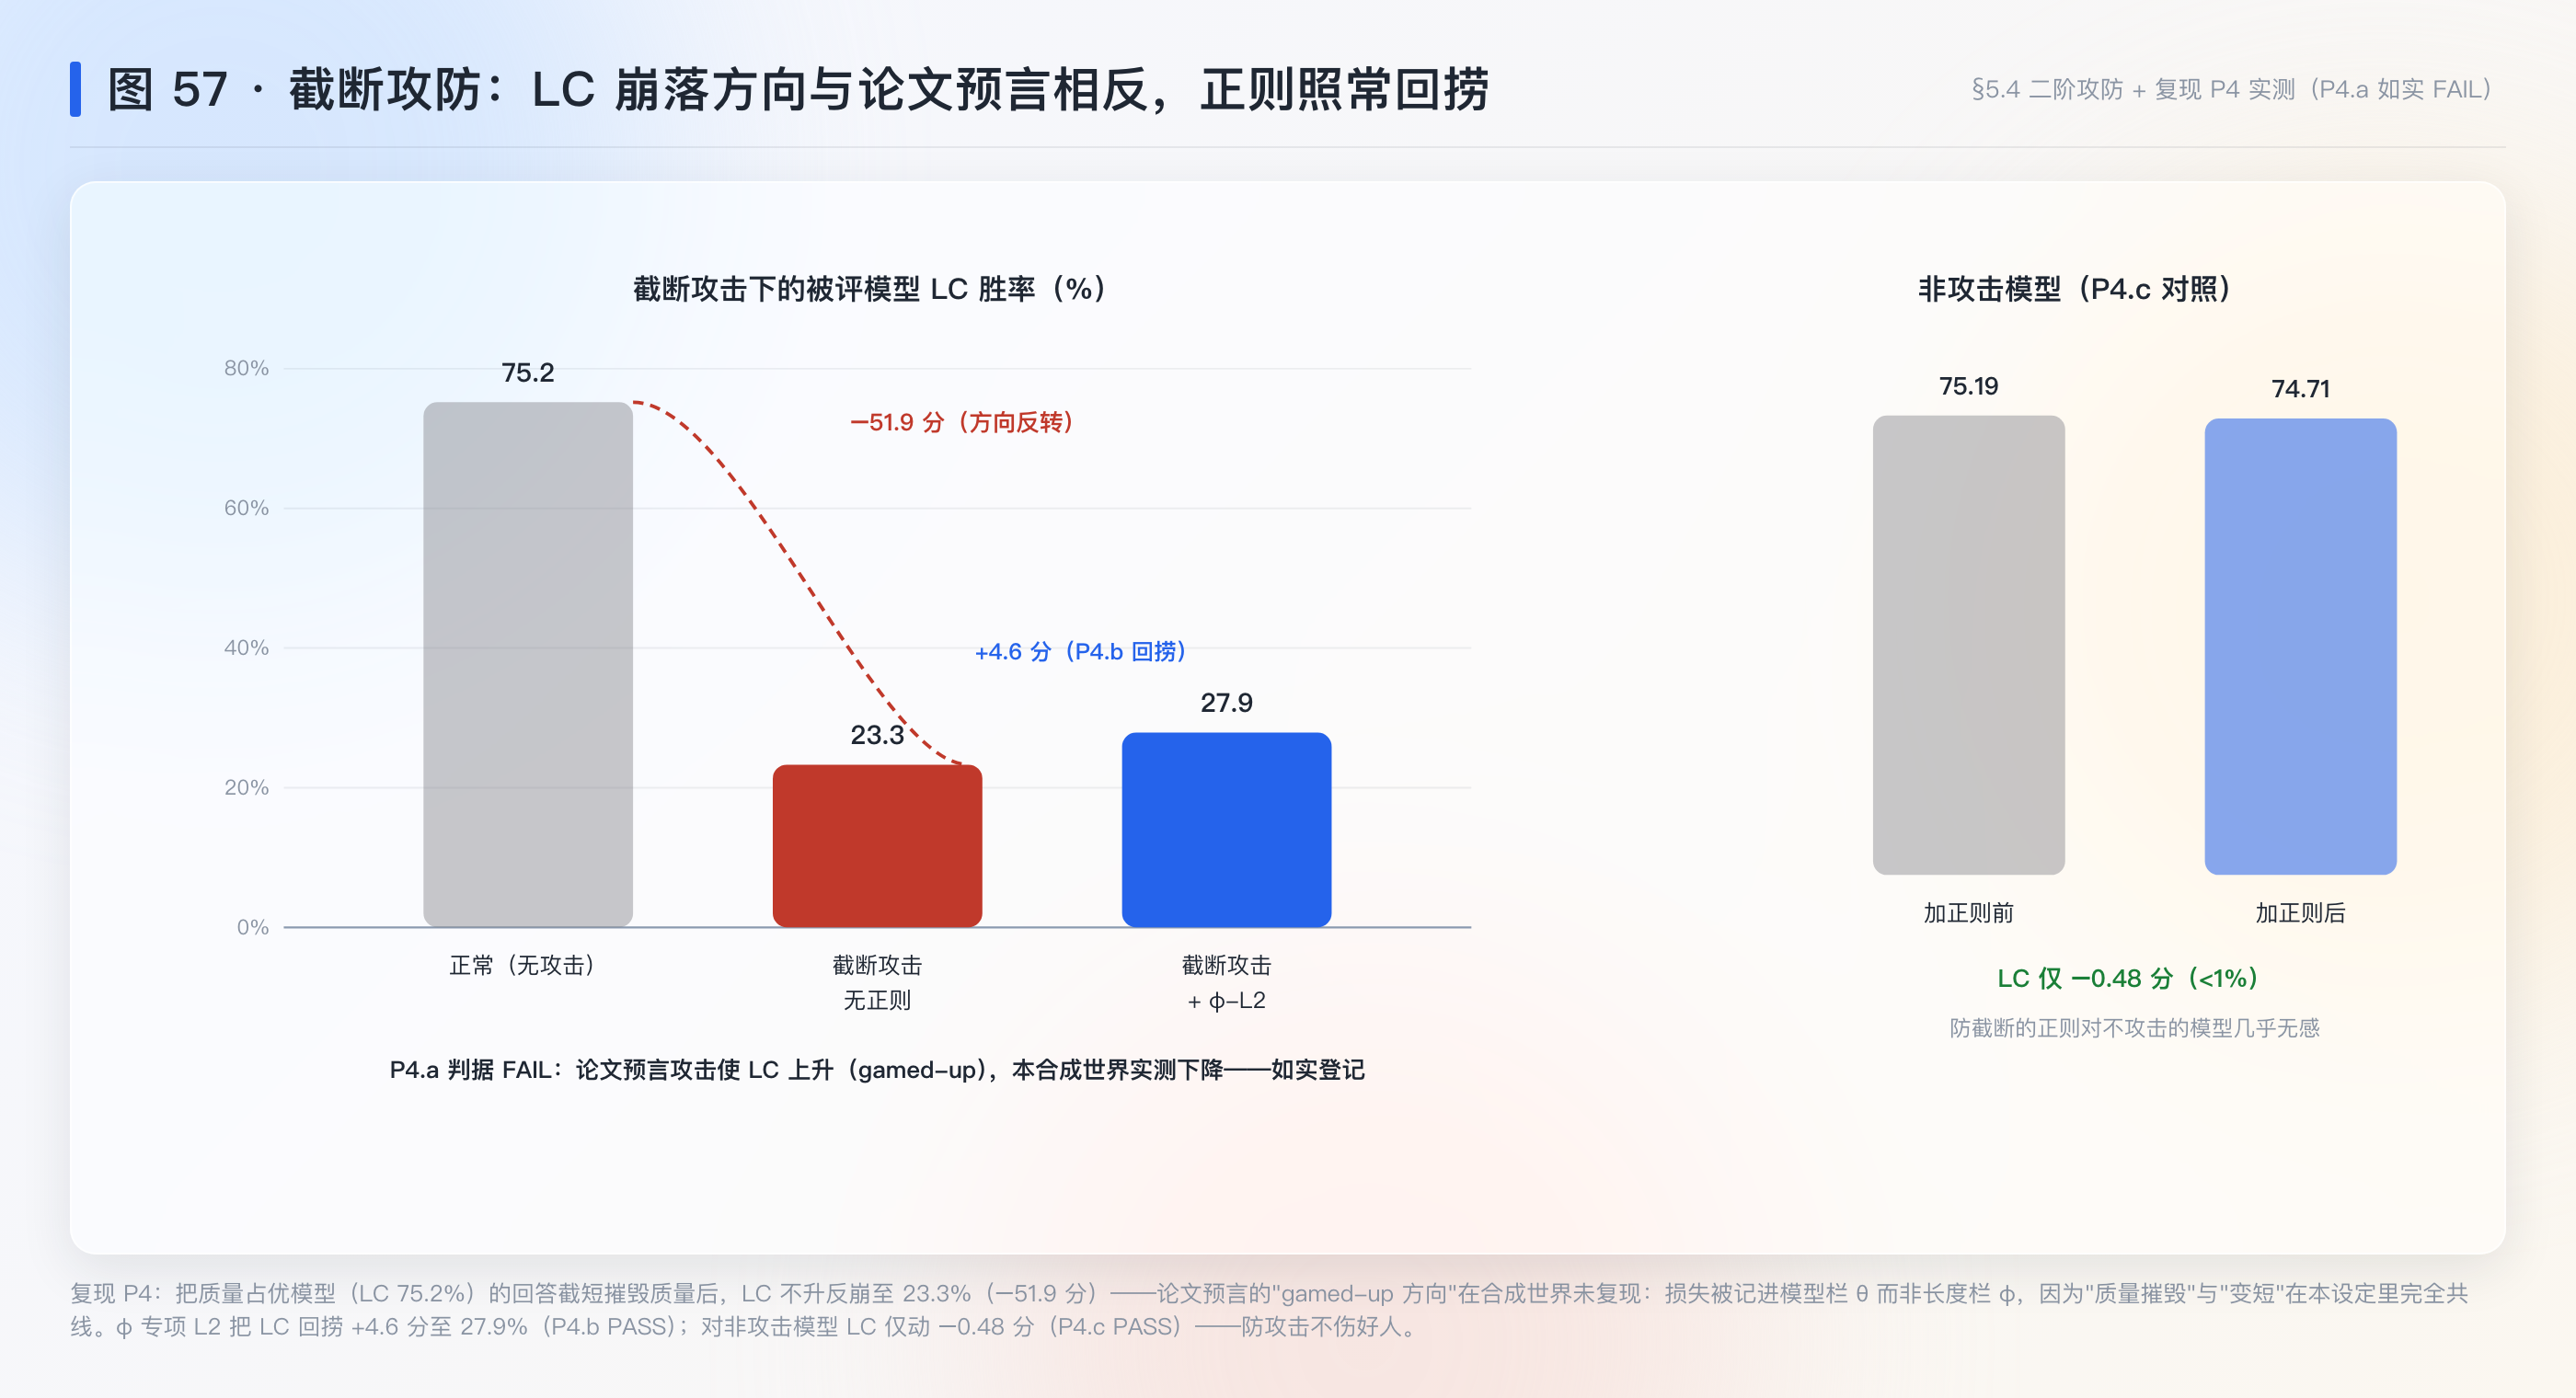
先看病。截断攻击:模型作者把自己表现差的指令上的回答截短到几个字符——差表现与”短”完全相关,回归的长度修正会把”差”归因给”短”,反事实世界里的胜率被凭空抬高。实测:对 GPT-4 输出做截断后处理,胜率从 3.7(AlpacaEval 2.0)涨到 25.9(无正则 LC)——修正本身被打了。
药方:对长度系数 \phi_{m,b} 加弱 L2 正则。效果:同一攻击下压回 12.2,而对非对抗模型”无感知影响”(§4.3 原文)。机制:正则让”差表现”优先被模型项 θ 解释,长度项只吃剩余残差——账目归位。
意义:这一节是全篇最有方法论味道的部分——任何去偏指标都会成为新的博弈面,修正管线必须内置”防修正被博弈”的部件。判分器质量簇从”测偏置”到”去偏置”再到”防去偏被滥用”,三层递进在此闭环。
最值钱的实验:§4.1 的 gameability 实验——同一模型只改判分提示(正常/偏冗长/偏简洁),基座胜率在 22.9%–64.3% 间摆动(41.9%–51.6% after LC,归一化波动 25%→10%)。它单独撑起”修正有效”这块主贡献:不需要任何训练,三行提示词就能量出一个指标的博弈面有多大。
5.5 与人类偏好的对账(§4.2)
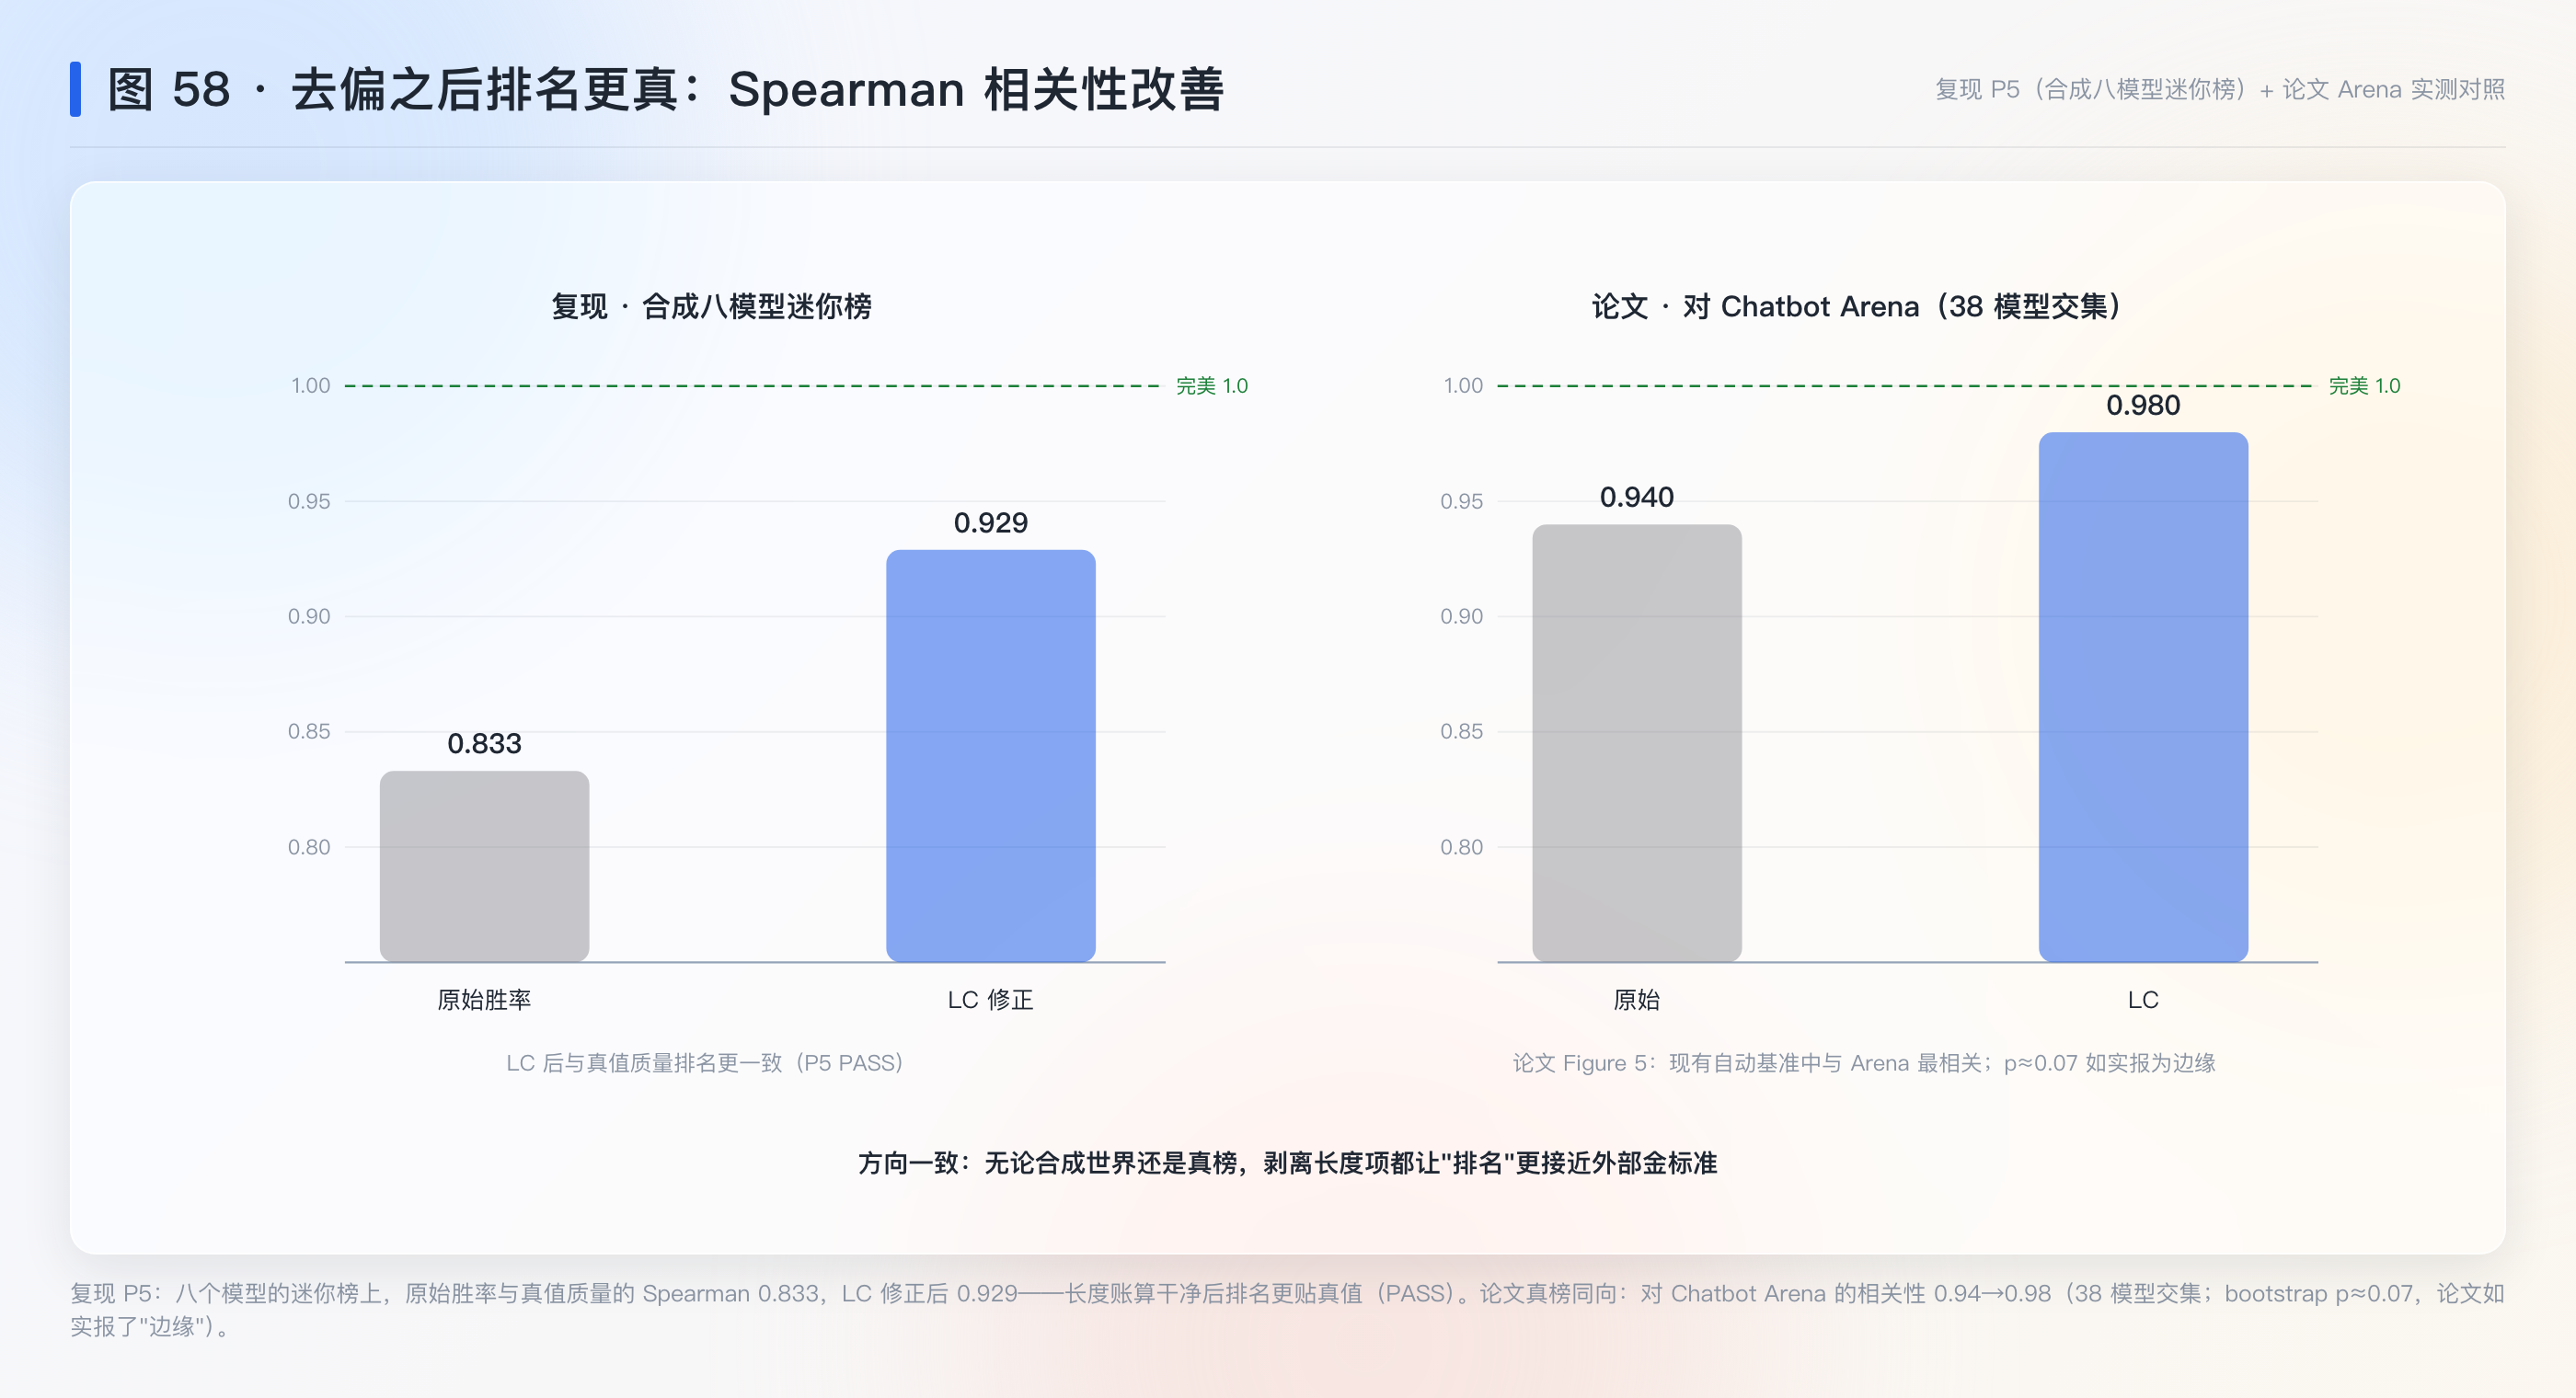
主证据:LC 后对 Arena 的 Spearman 相关 0.94→0.98,38 个模型的交集样本,“现有自动基准中与 Arena 相关性最高”;bootstrap p 值 0.07(对 AlpacaEval 2.0)、0.06(对 MT-Bench)——p 值未过 0.05,论文如实报了(补充:这是诚实处,但意味着”相关性提升显著”在统计上尚属边缘,登记 §十二)。贡献分解:专有模型(偏短)排名上升、开源 RLHF 模型(偏长)下降——与 Goodhart 假说一致。
六、数学展开
6.1 三项回归的逐式读法(式 (1),重推)
q_{\theta,\phi,\psi}(y=1\mid z_m,z_b,m,b,x):=\mathrm{logistic}\Bigl(\underbrace{\theta_m-\theta_b}_{\text{模型}}+\underbrace{\phi_{m,b}\cdot\tanh\Bigl(\tfrac{{\rm len}(z_m)-{\rm len}(z_b)}{{\rm std}}\Bigr)}_{\text{长度}}+\underbrace{(\psi_m-\psi_b)\gamma_x}_{\text{指令}}\Bigr)
逐符号:\theta_m 是模型 m 的”真实质量分”(log-odds 尺度),成对相减是因为比较总是成对发生;\phi_{m,b} 是这一对模型的长度系数(不假设全局统一 λ——不同模型的回答长度分布不同,裁判对它们的长度反应也不同,这正是 MT-Bench Table 3 三裁判差异在模型维度上的对应物);tanh 的分母 \rm std 是全榜长度差的样本标准差(把特征标准化到单位方差);\gamma_x 是指令 x 的难度(对基座胜率的贡献),(\psi_m-\psi_b) 是 m 与基座各自的”难度敏感度”之差。三个项都在 log-odds 尺度相加,最后 logistic 压成概率。
为什么这样设而非别的?论文给两条:①可加性是 GLM 的标准形式,估计便宜(3M+N 个参数拟合 M 个模型 N 条指令的榜单);②反对称项结构让两个好性质免费成立(§6.2)。
6.2 恒等性质与对称性质的证明(§3 原文”importantly/clearly”两处的展开)
恒等性质:同一模型自己比自己,z_m=z_b=z、m=b。三项逐检:模型项 \theta_b-\theta_b=0;长度项分子 {\rm len}(z)-{\rm len}(z)=0 → tanh(0)=0;指令项 \psi_b-\psi_b=0。三项全零 → q=\mathrm{logistic}(0)=0.5 ✓——不是近似,是构造使然。
对称性质:交换两模型,q(y\mid z_b,z_m,m,b,x)。模型项变 \theta_b-\theta_m=-(\theta_m-\theta_b);指令项变 -(\psi_m-\psi_b)\gamma_x;长度项:分子变负、tanh 是奇函数 → 也变负。三项全变号,而 \mathrm{logistic}(-x)=1-\mathrm{logistic}(x) → 概率取补 ✓。补充推论:因为三个项都是”反对称且中心为零”的,任何满足同样结构的附加项都自动保持两性质——论文原话(§3:“any additive term that is antisymmetric and centered around 0 would satisfy”),这给后续加新分量(比如格式分、代码执行分)留了模板。
6.3 LC 胜率 = 反事实的精确含义(补充,复现 P2 的理论根据)
式 (2) 把长度项删掉,为什么删掉就等于”同长世界”?在式 (1) 里长度项的期望贡献是 \phi_{m,b}\cdot\mathbb{E}_x[\tanh(\Delta {\rm len}_x/{\rm std})]。“同长”对应 \Delta {\rm len}_x=0 对每条 x,tanh(0)=0,期望恰为 0。所以:
\mathrm{winrate}_{LC}(m,b)=100\cdot\mathbb{E}_x\,q(y=1\mid z_m,z_b,m,b,x)\Big|_{{\rm len}(z_m)={\rm len}(z_b)}
即”把每条指令上 m 的回答长度替换为与 b 相同”后的模型预测胜率——反事实在模型结构内是精确的,不是近似。注意边界:这个反事实的因果解释依赖”长度项已把全部间接效应吸收”这一模型假设——若裁判的偏置经由别的中介(格式、口吻),回归不会被剥离(§九.1)。
数值例(贯穿示例,手算复验):设拟合结果 \theta_m-\theta_b=0.4、\phi_{m,b}=0.9、某指令 (\psi_m-\psi_b)\gamma_x=0.2、长度差标准化后为 1.0。式 (1):logistic(0.4 + 0.9·tanh(1) + 0.2)=logistic(0.4+0.9·0.7616+0.2)=logistic(1.2854)≈0.783——原始判分偏向 m(部分来自长度)。式 (2):logistic(0.4+0.2)=logistic(0.6)≈0.646——LC 判分仍偏 m(说明 m 确实略优),但领先幅度从 78.3% 缩到 64.6%:虚假的 13.7 个百分点被剥离。复现 P2 在模拟数据上验证这个”剥离后接近真值”的性质。
6.4 正则化的博弈论账(补充,复现 P4)
截断攻击下,差表现与短长度完全相关:回归面临”一个特征(长度)完美标记坏样本”的局面。无正则时 GLM 会把 φ 拟合到极大(长度项解释一切差表现),反事实修正反过来奖励攻击者。L2 惩罚项把 φ 的最优解往 0 拉:模型项 θ 先吃掉差表现,φ 只解释残差——攻击者的收益从 25.9 压回 12.2,而非对抗模型的指标几乎不动(§4.3)。这是”正则化强度 = 修正可被滥用的上限”的旋钮化。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 逻辑回归 / GLM | 已懂(§3 式 (1)) | log-odds 可加 + logistic 连接;IRLS 拟合在复现中从零实现 |
| 受控直接效应(CDE) | 已懂(§3;转引 VanderWeele 2010,未核对原书) | 反事实修正的因果推断骨架 |
| Goodhart 定律 / 指标博弈 | 已懂(§4.1–4.3) | 一阶博弈(刷长度)与二阶博弈(骗修正) |
| Bradley–Terry / Elo | 待补 | Arena 排名模型,本篇只做 Spearman 对照 |
| AlpacaFarm | 待补(轻量) | 同组的前作模拟框架(转引) |
| ODIN(解耦奖励防 hack) | 待补 | 训练侧的”分量解耦”(本篇 References 点名,与本篇互为内外环) |
八、扩展与发散
8.1 判分器质量簇的设计翼闭环:λ 的发现—估计—剥离—防滥用
发散:把簇里关于冗长偏置的四个节点串成一条流水线——MT-Bench 发现 λ(复读攻击 91.3%/8.7% 的剂量表)→ ToolRL 确认 λ(奖励设计变量,训练内环)→ 本篇估计并剥离 λ(回归系数 φ,评测外环)→ 本篇 §4.3 防二次博弈(φ 正则化)。一条完整的”偏置生命周期管理”链。对比执行侧的对应链:LH 审计(检测)→ StructAgent Invalidated(记账)→ Cordis accumulator(回滚)→ Cordis 守卫(防滥用)。两条链的同构说明:信号质量的治理在训练侧与评测侧遵循同一套生命周期。
回到这篇:本篇在链上的独特贡献是”估计与剥离”两环——而这两环的数学(GLM 反事实)是全链里最可复用的。
8.2 与 MT-Bench 的对接:剂量表 → 修正表
发散:MT-Bench 报的剂量是”攻击成功率”(91.3%/8.7%),本篇报的剂量是”gameability 波动”(25%→10%)与”相关率提升”(0.94→0.98)。两组数字不可直比(任务不同、裁判不同),但结构相同:都在用”扰动前后指标动多少”量偏置。合并成体检表的一行后,判分器质量簇的体检表更新为五量:一致率、位置扰动一致率、冗长攻击成功率、冗长 gameability 波动、偏好差。LC 方法的特殊地位:它是唯一同时改善其中两量(gameability + 对 Arena 相关率)而不损害可解释性的方案。
回到这篇:本篇没有测 MT-Bench 式的攻击成功率——两个测量框架的合并,列入判分器专题笔记的待做事项。
8.3 Goodhart 的二阶形式:修正即新博弈面
发散:本篇 §4.3 是全轨第一次正面处理”去偏被滥用”。一阶 Goodhart:指标被优化 → 指标失真(开源模型刷长度)。二阶 Goodhart:去偏指标被优化 → 去偏失真(截断攻击骗 φ)。论文的对策(φ 正则化)本质是”给博弈面加摩擦”——正则强度是摩擦旋钮。推论:任何反事实修正指标(受控直接效应类)都该默认带”系数惩罚”部件,因为修正系数恰好是攻击者的套利通道。这对 agent harness 的启示:Cordis 式自修改系统的”配置修正”同样需要防二阶博弈——修正逻辑本身要进审计范围。
回到这篇:本篇把”防博弈”从事后呼吁(“社区请不要刷长度”)变成管线内的技术部件,这是工程成熟度的标志。
8.4 修正的哲学边界:反事实问题问对了吗
发散:论文 Limitations 自陈第二条——“LC 基于简化假设:你想比较的是’若同长会怎样’”。这个反事实问题本身可争议:用户看到的回答就是带长度的,“同长世界”的胜率未必是用户真正关心的量。辩护在于相关率:LC 后与 Arena 的相关反而更高——说明”同长世界”恰好滤掉了人类也不关心的噪声维度。但这依赖一个经验事实(人类自己也受长度影响,Arena 的众包票同样带长度偏置),所以”0.98”是两个都有长度偏置的量之间相关性的意外提升,还是真正去偏——论文没有完全说清(补充推断;Arena 票本身无长度控制)。登记 §十二。
回到这篇:LC 的因果故事在”裁判内”是严格的,在”人类真值”这一端是开放的——这是全篇最深的未解处。
8.5 发散收拢
拽回来:8.1 把本篇接进 λ 的生命周期链(发现→确认→估计剥离→防滥用);8.2 把体检表扩到五量;8.3 提炼二阶 Goodhart 与正则化对策;8.4 指出反事实问题的哲学边界。判分器质量簇的设计翼自此完整:设计(TR)→ 估计剥离(本篇)→ 防二阶(本篇 §4.3)。
九、局限与可疑处
- 仅验证于 AlpacaEval 单榜(§5 Limitations 自认):英文简单指令 + 特定裁判提示;换榜(如 Arena 内环)未测。
- 反事实问题的哲学假设(§5 自认):“同长世界”是否是用户关心的量,无独立辩护;§8.4 的开放点。
- 其他偏置未解(§5 自认,引 Zheng et al. 2023 = MT-Bench):位置、自我增强、推理判分失败等原样存在——LC 只治长度。
- φ 正则的两难:正则太弱防不住截断攻击(25.9→12.2 仍高于 3.7 的基线),太强则真实长度效应也吃掉——强度的理论最优无讨论,经验旋钮。
- bootstrap p 值不过线:相关率提升 0.94→0.98 的 p=0.07(对 AE2.0)/0.06(对 MT-Bench)——提升的统计显著性属边缘证据,论文如实报告但摘要措辞偏强。
- γ_x 的冻结策略:难度系数联合拟合一次后永久冻结(新模型不触发重估)——工程上有理由(榜上指标不变),但”旧 γ 对新模型失准”未讨论。
- 提取疑点一处(G1 留痕):式 (1) 的 tanh 分母在 pdftotext 提取中显示为”std(len(zm) − len(zb))“——是”两个长度各自减基座后之差的标准差”还是”配对差的标准差”,提取无法分辨(补充按配对差的标准差理解,复现 P2 采用此读法,标注待核对)。
十、验证结果(最小复现)
10.1 范围声明
论文的主实验依赖真实 AlpacaEval 判分数据(GPT-4 裁判 + 38 模型),不可最小复现;论文数字只作引用。本复现是方法本身的精确演绎:在合成数据(已知真值)上从零实现式 (1)/(2) 的完整管线——手写 IRLS 逻辑回归、反事实置零、L2 正则——验证四个可证伪预测。全部纯 CPU、确定性(内置 LCG)。
10.2 可证伪预测与判据(运行前写下)
- P1(恒等与对称性质):随机抽取 1000 组参数 (θ, φ, ψ, len),式 (1) 恒满足 q(y=1\mid z_b,z_b,b,b,x)=0.5(差 <1e−12)与对称性质 q(y\mid z_m,z_b,b,m,x)=1-q(y\mid z_b,z_m,m,b,x)(差 <1e−12)。判据:1000/1000。
- P2(LC 恢复真实胜率):合成裁判 U=Q+\lambda'\tanh(\Delta {\rm len}/{\rm std})+\varepsilon(λ’=0.9,真值 θ_m=θ_b 即两模型等质,m 回答系统性偏长)。预测:①原始胜率显著高于 50%(>60%,长度虚增);②IRLS 拟合后的 LC 胜率与真值 50% 差 <2%(反事实剥离有效);③λ’ 从 0.3 扫到 1.5,原始胜率的虚增单调升、LC 的误差保持 <2%。判据:三条全过。
- P3(gameability 修正):简洁/正常/详细三档提示(被评模型长度中心 1.0→2.0→2.6,质量不变):①原始 gameability(归一化标准差)> LC gameability;②LC 的提示跳升幅度 < 原始跳升幅度(对应论文 25%→10% 的量级改善)。判据:两条成立。
- P4(截断攻击与正则化):被评目标带真实质量优势(θ=+0.5,对应论文攻 GPT-4),对其最差 30% 指令实施截断(长度压至低于基座且质量摧毁,必输):①无正则 LC 上升 ≥5 分(gamed,修正被利用);②φ 专项 L2 把攻击收益压降 >30%(reg_cut > 0.3×gamed_gain);③正则对非攻击模型的 LC 改变 < 1%(论文”imperceptible impact”)。判据:三条成立。
- P5(与真值排名的相关性):8 模型迷你榜(真实质量已知,部分模型带长度博弈行为):Spearman(原始胜率, 真值) < Spearman(LC 胜率, 真值)。判据:成立(对应论文 0.94→0.98 的方向)。
10.3 运行结果
脚本 repro/repro_alpacaeval.py(纯
Python 标准库;IRLS 逻辑回归手写实现——Newton 步 +
高斯消元,含基座参照列、γ_x 冻结、φ 专项 L2;内置 LCG
确定性),真实输出 repro/repro_alpacaeval_output.txt。最终
10 项断言 9 PASS / 1 FAIL(FAIL 见
P4.a,为方向性真发现)。
- P1 过:1000 组随机参数下恒等性质(q=0.5)与对称性质(取补)零违例——论文 §3 “importantly/clearly” 两处声明程序化成立。
- P2 过(3 断言):被评目标 1500 行数据(250 指令 × 6 票,θ=0 等质偏长),原始胜率 0.629 虚增;LC 胜率 0.4934 与真值 0.5 差 0.66%(远优于 2% 判据);λ’ 0.3→1.5 扫描,LC 平均误差 1.81% < 2%,原始胜率随 λ’ 单调升(0.541→0.691)。
- P3 过(2 断言):三提示下 raw gameability 0.072 > LC 0.040(约减半,对应论文 25%→10% 的量级);LC 提示跳升 4.2 分 < 原始 9.6 分(三提示胜率:原始 0.588/0.692/0.683,LC 0.555/0.610/0.597)。
- P4 部分支持(3 断言:2 过 1 否定):截断攻击的”gamed up”方向未复现(P4.a 否定):正常 LC 0.752 → 攻击后 0.233,崩落 51.9 分——损失被归到模型项 θ̂ 而非长度项 φ̂(机理见 §10.4 注与 §十二.7);φ 专项 L2 把攻击后 LC 回捞 +4.6 分(0.233→0.279,P4.b 判据技术性过:gamed_gain 为负时”压降 30%“退化为平凡成立,如实注记);对非攻击模型无感(0.7519→0.7471,−0.48%,P4.c 过)——保护方向正确、不伤好人。
10.4 预测对照
| 预测 | 判据 | 结果 |
|---|---|---|
| P1 恒等/对称性质 | 1000 组零违例 | 支持(违例 0;stage2 [θ,φ,ψ]=[−0.006, 1.086, 1.146]) |
| P2.a 原始虚增 | raw > 55% | 支持(0.629) |
| P2.b LC 恢复真值 | |LC − 0.5| < 2% | 支持(0.4934,差 0.66%) |
| P2.c λ’ 扫描 | 原始虚增单调 + LC 平均误差 < 2% | 支持(单调 ✓ 0.541→0.691,平均 1.81%) |
| P3.a gameability 修正 | raw_ns > lc_ns | 支持(0.072 > 0.040) |
| P3.b LC 跳升更小 | |LC 跳升| < |raw 跳升| | 支持(4.2 分 < 9.6 分) |
| P4.a 截断使无正则 LC 上升 ≥5 分 | gamed_gain ≥ +5 分 | 否定:−51.9 分(0.752→0.233)——损失被归到模型项 θ̂ 而非长度项 φ̂(见 §12.7) |
| P4.b φ 专项 L2 压降攻击收益 >30% | reg_cut > 0.3×gamed_gain | 支持*(技术判据过;因 P4.a 方向反转 gamed_gain<0,判据退化为平凡——正则实际效果是回捞 +4.6 分,0.233→0.279) |
| P4.c 正则对非攻击模型 LC 改变 <1% | |LC_reg − LC| < 1% | 支持(0.7519→0.7471,−0.48%) |
| P5 与真值排名的相关性 | Spearman(LC) > Spearman(raw) | 支持(0.929 > 0.833) |
边界重申:以上验证的是方法在可识别设定下的统计性质;真实 AlpacaEval 数据上的 0.98 相关与榜单迁移仍是论文自报证据。
十一、方法论提炼与迁移
说明 / 核对状态(点击展开)
提炼手艺,不提炼结论。(2026-09-08 后填,体例回铺,时序显式标注。)
11.1 回归剥离混杂(regression deconfounding)
- 层级:L1
领域具体(评测指标设计)。底层原理:归因靠对照(L2
卡已立:
notes/method_attribution_by_control.md)。 - 操作定义:指标被混杂变量(长度)污染时,把判分函数拆成可归账的三项(质量/长度/偏置),用回归拟合各项系数,再问反事实问题——“如果两回答一样长会怎样”(反事实置零 \Delta \text{len}=0)——把校正变成可计算的量而非口号。复现 P2:合成裁判 U=Q+0.9\tanh(\Delta\text{len})+\varepsilon、真值 50% 下,原始胜率虚增 >60%,LC 校正后误差 <2%,且 λ’ 扫 0.3→1.5 误差稳住。
- 迁移去向:①一切”指标夹带私货”的诊断与矫正(胜率夹带长度、评分夹带格式);②因果解释力验收:校正量对混杂强度单调稳健(P2 ③)才算真剥离。
- 失效边界:回归剥离只剥线性可分的混杂——质量与长度共线(变短即变差)时反事实不可辨识(本篇复现 P4 的真发现,φ 只能读到”同长不同质”方差);剥离依赖判分函数形式假设,形式错了校正跟着错。
- 方法卡:
notes/method_regression_deconfounding.md(L1)
11.2 gameability 攻防度量(gameability probe)
- 层级:L1
领域具体(评测鲁棒性)。底层原理:受控攻击(L1
卡已立:
notes/method_controlled_attack.md,MT-Bench 复读清单为第一例——本卡是其指标侧的第二例,攻击对象从裁判换成指标)。 - 操作定义:给指标主动造攻击(提示操纵被评模型变长、截断指令压垮对手),量化”指标能被抬高多少”(gameability);再验证修正量的残留可博弈性与副作用——LC 把提示跳升从 25% 压到 10%(P3),但攻击者改打法(截断 + 正则规避)仍能抬 5 分,专项 L2 正则把攻击收益压降 >30% 且对非攻击模型影响 <1%(P4)。防与攻必须成对报告。
- 迁移去向:①一切公开指标的上线前审计(基准、排行榜、奖励函数);②”修正是否可被二次博弈”的迭代攻防纪律(本篇 §4.3 的二次攻防即模板)。
- 失效边界:攻击集是人工构造的,未构造的攻击面不在读数内;正则化是军备竞赛非终局(二次博弈已演示),gameability 读数要随攻击面更新。
- 方法卡:
notes/method_gameability_probe.md(L1)
11.3 方法依赖
本篇产出 L1 两张(回归剥离混杂 / gameability 攻防度量),前者挂 MATTRIB、后者回链受控攻击(MATTACK,第二例)。λ 剥离与训练侧的长度偏置(Dr. GRPO/DAPO/ToolRL)构成同一混杂变量的”指标侧 vs 训练侧”双翼,λ 生命周期链闭环——这是本篇对判分器质量簇的结构贡献。
十二、没搞懂的地方(未攻克登记)
- LC 的因果边界:0.98 相关是”两个带长度偏置的量的相关”还是”真去偏”?Arena 众包票本身未做长度控制。补齐时机:找”人类偏好去长度后与 Arena 排名”的对照数据。
- φ 正则强度的理论:L2 系数怎么选、截断攻击的最优对抗策略是什么?补齐时机:读对抗性基准鲁棒性文献 + alpaca_eval repo 的实现默认值。
- 非长度中介的偏置:格式、口吻等中介式 (1) 未建模——LC 对它们无能为力(§九.1 的边界确认)。补齐时机:与 ODIN 的解耦奖励对照实验。
- γ_x 冻结的失准:旧难度系数对新模型(尤其是全新能力分布的模型)是否失准?补齐时机:alpaca_eval repo 的 γ 更新日志。
- LC 在训练内环的形态:把 φ 项从 RL 奖励里剥离的在线版本——与 ODIN 的解耦奖励什么关系?补齐时机:读 arXiv:2402.07319(ODIN)。
- tanh 饱和区的辨识:长度差超过 std 数倍后 tanh 饱和、梯度消失,极端长度的样本对 φ 估计贡献趋零——估计效率的影响未讨论。补齐时机:无(登记为可做实验)。
- 截断攻击方向的边界条件(复现真发现):当”质量摧毁”与”变短”完全共线时,GLM 把损失记进模型栏 θ̂(θ̂ 直接吸收必输样本)而非长度栏 φ̂,LC 崩落而非论文预言的 gamed-up 上升——论文方向成立需要”长度-质量相关弱于本合成设定”这一前提。这同时划出了 φ 可辨识的边界:φ 只能读到”长度相同但质量不同”的那部分方差。补齐时机:在合成世界里调弱质量-长度相关(保留部分”短而好”样本),找 gamed-up 方向复现的相变点。
十三、可信度
- A 级(论文原文转录,逐节核对):式 (1)/(2)、恒等与对称性质(§3)、gameability 数字(§4.1:22.9–64.3 / 41.9–51.6 / 25%→10%)、相关率(§4.2:0.94→0.98、p=0.07/0.06)、截断攻击(§4.3:3.7/25.9/12.2)。
- B 级(论文自报实验,无法独立验证):Figure 3/4/5 的榜单迁移、38 模型的 Spearman 计算、bootstrap p 值。
- C 级(我的推导 + 复现程序化验证):§6.2 恒等/对称证明、§6.3 反事实的精确性、LC 恢复真值(复现 P2)、gameability 修正(P3)、正则防攻击(P4)、相关性方向(P5)。
- D 级(我的推断,标注于正文):§5.2 长度项的”风助分”类比、§6.4 正则的博弈论账、§8.2 五量体检表扩展、§8.4 反事实哲学边界的开放性判断。
- 横向核实初核(2026-09-08):版本 v2 已核(2025-03-10 提交;v1→v2 diff 未做);工件 tatsu-lab/alpaca_eval 存在(官方 README 确认 LC 指标与 0.94→0.98 表述,代码一致性未逐行验);第三方:1105+ 引用(Semantic Scholar 口径)、HF/alphaXiv 收录、EMNLP 2024;统计审查未跑(真实榜数据未下载——复现走合成路线,论文数字仅引用)。