外行导读(先读这个,再决定要不要进正文)
一个场景:你想用「评分细则当奖励」来训练一个开放域模型(RaR 的思路),但卡在三件事上:细则要专家手写(HealthBench 花了 262 位医生 11 个月才写完 5,000 道题);覆盖面窄(现有公开判据集只有医疗和科学);最要命的是判据太粗——「诗写得不错」「回答完整」这种判据谁都满足,分数全挤在 90 分以上,最强的模型拿不到任何改进信号。RubricHub 的答案:让管线自己造细则——按 13 条元原则写、看着参考答案写(防跑偏)、几个大模型各写一份再合并(去盲区)、最后从优秀回答里提炼「卓越与优秀差在哪」的区分性判据(提难度)。11 万条判据对,配两级训练,14B 模型在 HealthBench 上超过 GPT-5。
这篇论文做了两件事。第一件:考卷生产自动化——三阶段管线把 rubric 从「专家手写的工艺品」变成「流水线量产的标准件」,论文自带对照实验:同一套 RaR 的问题,只把 rubric 换成管线重生成的,HealthBench 分数从 47.7 涨到 62.1。第二件:训练侧的两条判官纪律——判据只用正权(含负判据的版本 66.2 vs 63.2,负判据伤训练,因为判官对「坏行为出现没有」的判定更不准);判官至少 30B(7B 判官人机一致性 κ 0.58 不及格,30B 起饱和在 0.74–0.80)。
为什么值得关心:三个理由。第一,它是 rubric 谱系的第五步:HealthBench(考官手册)→ RaR(教练教案)→ RaR-Hack(教案被利用)→ 本篇(考卷自动化量产)——判分器线的整个上层建筑从「手工作坊」进入「工业化」,这是谱系的地基变动。第二,它和 HealthBench 打架:HealthBench 靠负分判据罚错误行为(评测侧有效),本篇实验说负判据在训练侧伤效果(判官判不准)——评测与训练的判官纪律第一次出现正面分裂。第三,训练配置是 DAPO 全家桶(clip 0.28、KL=0、overlong 软罚、8 rollouts)——DAPO 精读的四个旋钮两年后成了工业默认值。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| supervision ceiling effect | 监督上限效应——判据太粗导致人人高分,顶层模型没有改进梯度 |
| rubric drift | rubric 漂移——只看问题写判据,写出来的判据与实际回答脱节 |
| Response-grounded | 参考答案接地——生成判据时必须看着一个参考回答,锚住具体语境 |
| Principle-guided | 原则约束——13 条元原则(3–25 条判据、判据原子性、可验证等)限制生成器 |
| Multi-model aggregation | 多模型聚合——几个异构大模型各写一份,合并去重解冲突 |
| Difficulty evolution | 难度演化——从共识高分回答提炼区分性判据,让「优秀」和「卓越」可分 |
| RuFT | rubric 拒绝采样微调——K 个候选打分,过阈值取最高,当 SFT 数据 |
| RuRL | rubric 强化学习——逐判据 0/1 × 权重归一化当奖励,DAPO 优化 |
| pitfall / trap rule | 陷阱判据——惩罚「坏行为出现」的负分判据(本篇训练侧弃用) |
| Verifiable / Semantic criteria | 可验证判据(规则引擎判)/ 语义判据(LLM 判) |
§0 承接栏
这颗种子接的是三笔账。第一笔:上一篇 HealthBench 精读收尾时把 RubricHub 列为下一颗首选——rubric 谱系的「考卷自动化量产」步。第二笔是 RaR 精读的质量账:RaR 的 rubric 是单模型生成的(合成+参考接地已到 35.9%≈人工),本篇图 5 证明把 RaR 的判据换成管线重生成版,同题同判官直接 +14.4——RaR 篇「rubric 质量三本消融账」的下一章在这里。第三笔是 RaR-Hack 精读留下的判官能力问题:弱验证器 exploit 高、强验证器减但不消——本篇给出判官能力的定量阈值(7B 不及格、30B 起饱和),判分器线的「判官要多少容量」第一次有了跨论文一致的答案带。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:rubric 评测要规模化,撞三个瓶颈。(i) 依赖专家手写——高质量判据要人类专家投入(HealthBench 的 262 医生 11 个月就是反例的注脚);(ii) 域窄——现有数据集(点名 RaR)困在专门领域;(iii) 区分度低——判据粗、泛,分不出「表面像样」和「真好」,造成监督上限效应:分数饱和,顶层模型拿不到优化梯度。三个瓶颈正好是成本、覆盖、区分度三个轴,本篇的三阶段管线一段管一个。
1.2 旧做法的缺口
图 1(p.1)把第三个瓶颈演成了两行批语:粗判据卷给秋诗打满分,「Overall Rubric Score: 1——I can’t learn anything」;细判据卷打 0.6,「I can learn something」。满分反而是坏消息——分数失去信息量,奖励信号无法指导「下一步改什么」。停下来猜一下:为什么粗判据卷的问题在「顶层模型」身上最致命?——因为梯度来自分数差:判据人人都满足时,最好与第二好拿一样的分,策略梯度没有方向;判据越难,分差的信噪比越高(§六.2 会把这段直觉变成几何)。
二、核心想法
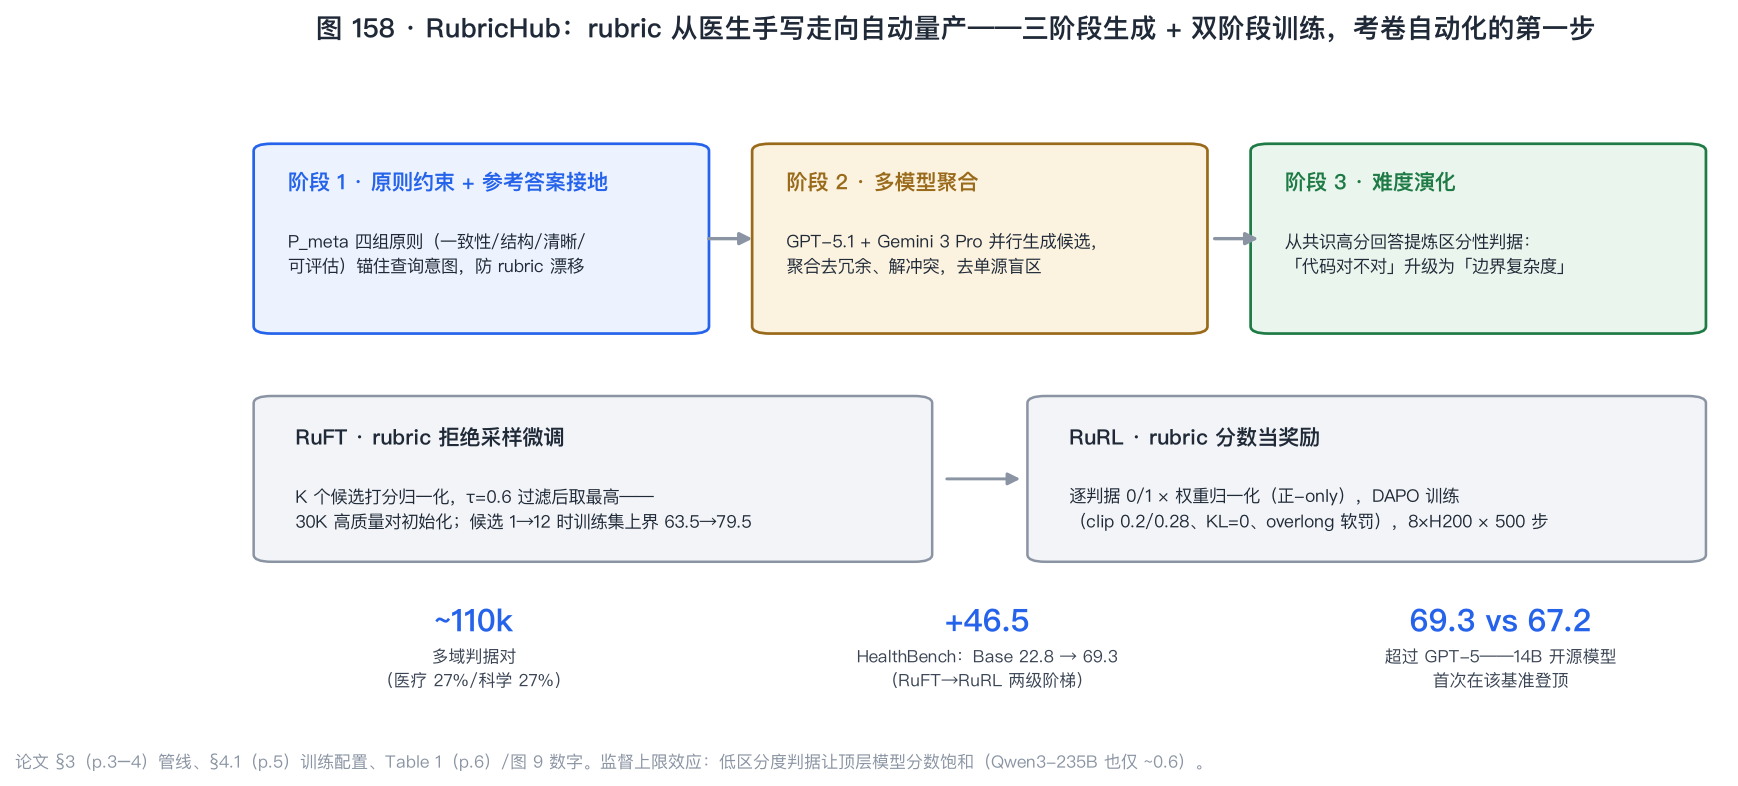
一句话:把「写考卷」本身变成一个三阶段生成任务——接地防漂移、聚合去盲区、演化提难度——造出来的 11 万条判据既能筛数据(RuFT)又能当奖励(RuRL),考卷从手工艺品变成工业品。
直觉先打底。这三阶段像出一道好考题的工序:先对着标准答案写评分点(不跑题),再请几位名师独立出卷取并集(不漏维度),最后专挑「状元和榜眼的差距」出压轴题(有区分度)。
全篇就看这张:图 158——上排三阶段生成管线,中排 RuFT/RuRL 双用,下排三个关键读数(110k、+46.5、69.3 vs 67.2)。
形式化入口(§2.1 p.2):查询 q 的评卷 rubric 是带权判据集
R_q = \{(c_i, w_i)\}_{i=1}^{N_q}
其中 c_i 是一条判据(语义要求 + 判官参数),w_i 是权重。判据分两类:可验证判据走规则引擎 G_{\text{rule}}(格式、字数),语义判据走 LLM 判官 G_{\text{LLM}}(推理深度、语气)。它把问题重新形式化成了什么?从「造一个好判官」(模型工程)变成「造一套好判据」(数据工程)——判官可以是现成的(gpt-oss-120B),判据才是稀缺品。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:顺序统计量/极值分布与 Cohen κ 为标准统计工具(教科书内容);其余见文首核对状态块。
3.1 第一件:加权奖励聚合——与 HealthBench 分母的一个关键差别
先摆问题。一条回答对 11 万条判据池里本题的 N_q 条判据,逐条判 0/1 之后怎么合成一个奖励标量?
论文的公式分两步(§3.3 p.4–5)。第一步,判官对每条判据产出二值判定:
b_i = \begin{cases} G_{\text{LLM}}(q, o, c_i) & \text{semantic} \\ G_{\text{rule}}(q, o, c_i) & \text{verifiable} \end{cases}, \quad b_i \in \{0,1\}
(Eq 9;论文给的理由:「simplifies credit assignment and enhances training stability」——0/1 比连续打分稳。)第二步,权重归一化求和:
r(q,o) = \frac{\sum_{i=1}^{N_q} w_i b_i}{\sum_{i=1}^{N_q} w_i}
(Eq 10。)逐符号过一遍:w_i 是判据权重,b_i 判定;分子是「满足判据的加权和」,分母是「全部权重和」。数值例(贯穿示例):秋诗的判据集——「切题 w{=}1」「结构完整 w{=}1」「意象传情 w{=}3」「避免陈词 w{=}2」,一首回答满足前三条:r = (1+1+3+0)/(1+1+3+2) = 5/7 \approx 0.714。
补充:分母是本篇与 HealthBench 分道扬镳的地方。HealthBench 的 Eq 1 分母是 \sum \max(0, p_{ij})——负判据不进分母(防「分母被罚分撑大稀释惩罚」);本篇 Eq 10 的分母是 \sum w_i 带符号和,且实验后采用的判据池全是正权(§4.3,见 §五.3)——于是带符号和退化为正和,两式在正-only 域内等价。差别只在含负判据时出现,而负判据恰恰是被本篇弃用的分支。这个「殊途同归」是判分器线的一个小收口:正-only 域内,逐条 0/1 加权聚合的合理分母只有一种写法。
3.2 第二件:拒绝采样的极值统计——RuFT 为什么「样本越多卷越好」
先摆问题。RuFT 对每个查询采 K 个候选回答、全打分、取最高当 SFT 数据(Eq 8:a^+ = \arg\max_{a_k}\{S_k \mid S_k > \tau\},阈值 \tau=0.6)。K 多大才够?
直觉先打底:从人群里抽 K 个人取最高者,人越多 expectation 越高——这就是极值统计。候选分数 S_k 归一化到 [0,1](Eq 7:S_k = F_R / S_{\max})后,K 个候选的最大值期望 E[\max_K] 随 K 单调升、边际递减——前几个候选买走大部分「好运」,后面的候选只是在尾部捡零头。
论文的实测(图 9 p.8):K 从 1 到 12,训练集上的最高分均值从 63.45 升到 79.51(+16.06),而训完后的 HealthBench 只从 43.61 升到 48.81(+5.20)。补充:两个增益的比值 ≈ 3.1——上界增益只有三分之一传递到最终分数。这不奇怪:拒绝采样买的是「数据质量上界」,SFT 学到的是「数据分布的可达部分」,上界与可达之间隔着优化损耗。本站复现 P2 在合成世界复演了这条曲线(E[max] 单调升、边际递减、衰减比 2.86 vs 论文 3.1)。
3.3 第三件:κ 一致性——判官体检的读数与能力阈值
先摆问题。判官(gpt-oss-120B)逐条判 0/1,怎么知道它判得可信?本篇的体检(§4.3 p.7):940 条判据上,让 7B 到 235B 的四个判官与人类评判对照,读数用 Cohen κ(对「碰巧一致」做校正的一致率)与 F1 双口径,图 7 还画了 0.6 的「substantial agreement」参考线。
结果是一条能力阈值曲线:Qwen2.5-7B 的 κ 只有 0.58(F1 0.81)——低于 0.6 参考线,不及格;Qwen3-30B 跳到 κ 0.74(F1 0.90);120B 与 235B 在 0.74–0.80 处饱和(F1 0.88/0.91)。论文读法:「7B 到 30B 随规模改善……超过这个点后性能饱和,30B、120B、235B 之间只有边际方差」。判官选型(Table 2 p.6)因此是性价比决策:gpt-oss-120B 的 HealthBench 训练读数 66.2 与 235B 的 66.4 几乎持平、推理成本低数倍——选它。
考一下直觉:为什么 κ 会饱和而不是线性爬升?——判据难度有分布:中低难度判据 30B 就判得动,剩余的错误集中在最难的尾部判据上;容量再大,只是逐条啃下尾部,一致性曲线在覆盖完主要难度质量后进入平台(本站复现 P4 用「能力=可处理难度上限」机制复演了这个形状:低段斜率 0.154、高段斜率 0.036,比值 >4)。
3.4 整体收拢
三件工具一条链:加权聚合定义「一张卷怎么打分」(3.1,正-only 域内分母唯一)→ 极值统计定义「一份数据怎么筛」(3.2,E[max] 买上界、衰减比 ~3)→ κ 曲线定义「判官要多强」(3.3,30B 阈值 + 饱和)。回到这篇:考卷(判据)、考生(候选)、判官三方的工程学各有一条可量化的底线——这正是「rubric 训练的最低配置清单」的内容。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| R_q = \{(c_i, w_i)\} | 查询 q 的带权判据集(N_q 条) | §2.1 Eq 1 p.2 |
| R_{\text{cand}}^{(i)} = M(P_{\text{gen}}(q, o_i, P_{\text{meta}})) | 阶段 1 候选判据(接地+原则) | §3.1 Eq 3 p.3 |
| R_{\text{base}} = M(P_{\text{agg}}(q, R_{\text{cand}})) | 阶段 2 聚合基础卷 | §3.1 Eq 4 p.3 |
| R_{\text{add}} = M(P_{\text{aug}}(q, R_{\text{base}}, A_{\text{ref}})) | 阶段 3 难度演化增量判据 | §3.1 Eq 5 p.3 |
| R_{\text{final}} = R_{\text{base}} \cup R_{\text{add}} | 最终判据集 | §3.1 Eq 6 p.4 |
| S_k = F_R / S_{\max} | 候选分数归一化 | §3.3 Eq 7 p.4 |
| a^+ = \arg\max\{S_k \mid S_k > \tau\} | 拒绝采样(\tau = 0.6) | §3.3 Eq 8 p.5 |
| b_i \in \{0,1\} | 判官逐条二值判定 | §3.3 Eq 9 p.5 |
| r(q,o) = \sum w_i b_i / \sum w_i | 加权归一化奖励 | §3.3 Eq 10 p.5 |
五、机制
5.1 机制一:三阶段生成管线——判据是造出来的不是凑出来的
§3.1 p.3:阶段 1(接地+原则):判据生成必须同时喂查询 q、参考回答 o_i 与元原则集 P_{\text{meta}}——参考答案把判据锚在具体语境上(防 rubric 漂移:只看问题会写出幻觉判据),元原则(附录 A Table 4 p.12,13 条)约束形态:3–25 条判据、每条只评一个维度(原子性)、5–40 字、可验证、权重 −10 到 10、语言与问题一致。阶段 2(多模型聚合):GPT-5.1 与 Gemini 3 Pro Preview 各自生成候选池,聚合 prompt 合并冗余、解冲突——单模型有视角盲区,会写漏别人的强项维度。阶段 3(难度演化):基础卷只覆盖「基本对」,区分不了「优秀与卓越」;从候选池里取共识高分的参考回答对 A_{\text{ref}},让模型提炼「让回答从优秀升到卓越」的增量判据 R_{\text{add}}——把「代码对不对」硬化成「边界情况有没有 O(n) 处理」(论文原例,p.3)。停下来猜一下:阶段 3 的参考回答为什么要「一对」而不是一篇?——演化判据要捕捉的是** separating exceptionally-good from good** 的稳定差异,单篇回答的特质可能是特例;从共识高分对里提炼,留在判据里的差异是两位「高分考生」共享盲区之外的东西(论文没展开这一层,这是我补的推理)。
5.2 机制二:RuFT + RuRL 双用——一张卷先筛后教
§3.3 p.4–5 + 附录 B p.13:RuFT:每查询 K 个候选(附录 B 写六个),rubric 打分归一化,\tau=0.6 之下整题丢弃,之上取最高——30K 高质量对做 SFT(3 epochs,lr 1e-5→1e-6 余弦,cutoff 20480)。RuRL:全量 110K 判据对,逐域分别训练 5 epochs,verl 框架 + DAPO。训练配置是种子 07 的四旋钮全家桶:clip \epsilon_{\text{low}}{=}0.2/\epsilon_{\text{high}}{=}0.28(Clip-Higher)、overlong 软罚 buffer 4096 罚 0.5(Overlong Reward Shaping)、KL 系数 0(KL 关闭)、8 rollouts 温度 1.0(Dynamic Sampling 的采样数面)——两年前 DAPO 论文里的四个工程旋钮,如今是 rubric 训练的默认底盘。图 8(p.7)训练动态:HealthBench 稳步上升且五条轴(accuracy/completeness/communication 等)同步涨——没有单维度过优化。
5.3 机制三:判据构成消融——负判据在训练侧的失败
§4.3 p.6–7 + 图 6:正-only 判据 vs 正+pitfall(陷阱判据,负分惩罚坏行为)直接对照:HealthBench 66.2 vs 63.2、LLMEval-Med 75.3 vs 74.2——含负判据的版本两个基准都更差。论文归因:「判官在负判据上的低准确率(引 Arora et al. 2025)阻碍优化」。§7 Limitations 说得更直白:「引入 pitfall 带来显著噪声,恶化 RL 性能;这种不稳定因模型规模而加剧——紧凑模型低于可靠评测的能力门槛」。这句自认与图 7 的阈值曲线互为表里:负判据的判定(「坏行为出现没有」)比正判据(「该做的做了没」)更吃判官容量,所以负判据的伤害集中在弱判官区。
5.4 机制四:同题换卷实验——rubric 质量是主导项
图 5(p.6)是全篇最干净的实验设计:同一套 RaR 的问题,只把 rubric 换掉,判官不变(同为 gpt-oss-120B 生态)、训练流程不变(同 RuRL),只有判据出自谁之手不同——RaR 原版 vs 本篇管线重生成版:HealthBench 47.7→62.1(+14.4),ResearchQA 76.7→82.5(+5.8)。再往上叠完整 RubricHub 数据与 RuFT→RuRL 全管线,读数最高。这个实验把「分数涨归功于谁」的问题钉死了:考卷质量的贡献大于训练算法的贡献——配合 Table 1 的阶梯(Base 22.8 → RuFT 44.4 → RuRL 66.2 → 全管线 69.3),「超 GPT-5」的头功属于考卷。
5.5 机制五:数据形态——五域密度与不饱和读数
§3.2 p.4:110K 判据对来自五个域(Science:RaR-science/ResearchQA/MegaScience;IF:IFTRAIN;Writing:LongWriter 系;Medical:II-medical;Chat:WildChat-1M/LMSYS-1M),医疗与科学各占 27.1%,IF 占 20.9%,写作 15.9%。判据密度按域分化:写作平均 32 条/题、医疗 31、闲聊 25、科学 28——指令跟随只有 5 条(可验证判据少而硬,不需要密)。图 4 的分数密度:模型规模分层清晰,且 Qwen3-235B 平均只拿 ~0.6——判据池对最强模型仍然不饱和,监督上限效应在管线卷上被推开。
5.6 最值钱的实验
图 5 的同题换卷(§5.4)。如果只看一组实验看它:它同时完成三件事——把「超 GPT-5」的功劳从训练算法归还给考卷质量、给 RaR 篇的「rubric 质量三本账」续上第四章、并证明本篇管线的价值可以脱离自建数据集独立成立(在别人的问题上、别人的判官下,+14.4 照样兑现)。
六、数学展开
6.1 正-only 的选择论解释:判官误差 × 罚分权重 = 选择噪声(接 §三.1)
补充:为什么负判据「信息更多」反而伤训练?把 RuRL 的训练信号看成在候选池里的选择压力(本站复现 P0 的机制模型)。设候选真实质量 q,正判据满足率随 q 升、pitfall 触发率随 q 降;判官判定各有误判率 \epsilon_{\text{pos}}, \epsilon_{\text{pit}}(论文归因 \epsilon_{\text{pit}} > \epsilon_{\text{pos}})。权重 w_i 进入奖励的方式是 w_i b_i:一条误触发的 pitfall(好回答被判「踩坑」)贡献 -|w_i| 的奖励惩罚,且 |w_i| 越大,这个错误在 argmax 排序里的杀伤越大——罚分权重放大判官误差的方差。本站复现的定量结果:误判率 5% 时 pitfall 臂反而略优(质量差 −0.009,信息有益),20% 时反转为伤(+0.024),35% 时伤害扩大到 +0.048——符号随判官误差翻转。这就是「正-only 优于正+pitfall」的完整机制:不是负判据没信息,是判官接不住。推论(复现 P4 的一致性):判官越弱,负判据越毒——与 §7「不稳定因模型规模加剧」的原文自认互证。
6.2 监督上限的梯度几何:区分度就是奖励-质量曲线的顶部斜率(接 §三.3 的反面)
补充:supervision ceiling effect 可以写成一句话——策略梯度的方向信息 ∝ 奖励对质量的导数,粗判据让这条曲线在顶部变平。设判据满足率为 s(q, d)(q 质量、d 判据难度),一张卷的期望奖励 Er = \frac{1}{N}\sum_i s(q, d_i)。全低难度卷(d \approx 0)时 s \approx 1 对一切 q > q_0 成立,顶部斜率 \partial E[r]/\partial q \approx 0——图 1 的「满分 1,学不到东西」;演化判据把难度分布推向高段,s(q_{\text{top}}, d_{\text{high}}) 落到 0.3–0.6 区间,顶部重新出现落差。本站复现 P1 的机器读数:generic 卷顶部两档梯度 0.000、evolved 卷 0.102(比值判据 <1/3 通过),且 evolved 顶部奖励 0.59——与论文图 4「Qwen3-235B 也只 ~0.6」的形态对上。这也解释了为什么难度演化是三阶段的最后一步:它不是锦上添花,是把「梯度恢复」这件事做在判据分布上。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| rubric 评测 / 加权聚合 | 已懂(HealthBench 精读 + 本篇 §2) | 正-only 域内两式等价 |
| DAPO 四旋钮 | 已懂(DAPO 精读 + 本篇 Table 5 工业配置) | clip 0.28 / KL=0 / overlong / 8 rollouts |
| 极值统计 E[max] | 已懂(§三.2 + 复现 P2) | 拒绝采样的数学底盘 |
| Cohen κ | 已懂(§三.3 + 复现 P4) | 判官体检读数;对照种子 10 的 S1/S2 双口径 |
| RaR / RaR-Hack / HealthBench | 已懂(本站三篇精读) | 谱系前四步 |
| ResearchQA / MegaScience / WildChat 等数据源 | 待补 | §3.2 五域来源,转引未读 |
| Rubicon / DR-Tulu / Baichuan-M2 | 待补 | Table 1 的 rubric 基线模型,未读 |
八、扩展与发散
8.1 连一连:rubric 谱系第五步——从手工作坊到量产线
发散:把判分器线的 rubric 谱系接完——MyPCBench、Odysseys、OM2W 三篇是考官怎么判,HealthBench 是考官手册怎么造(手工作坊,262 医生 11 个月),RaR 把手册变教练教案,RaR-Hack 证明教案会被利用,本篇把手册的生产从作坊搬进量产线(API 成本,11 万条)。量产线改变的不只是成本,是判据的规模形态:HealthBench 的中位 11 条/题到本篇写作域的 32 条/题——密度翻三倍,区分度才够顶层模型用。回到这篇:谱系的地基从「专家稀缺性」换成了「管线质量」,下一个问题自然是 RaR-Hack 的威胁在量产线上是否放大——管线生成的判据是否有系统性的可利用模式(判官都不知道自己在喂漏洞),这是判分器线悬着的下一问。
8.2 负判据三难:HealthBench、RaR-Hack 与本篇的正面相遇
发散:负判据(惩罚坏行为)在三条线上读数不同。HealthBench 精读:考卷显式用 ±10 分负判据,评测读数良好——负判据在评测侧有价值,能罚出「乱开药方」这类危险行为。RaR-Hack 精读:rubric 权重 90.2% 在 presence 判据(正判据),absence 判据只有 8.6%——策略利用的正是「正判据只能奖励加东西」的缺口,隐含抱怨负判据太少。本篇:训练侧实验说含负判据更差(63.2 vs 66.2),弃用。三篇合读出一个「负判据三难」:评测想要它(能罚错误)、威胁模型需要它(补 presence 缺口)、训练接不住它(判官判不准)。解法方向本篇已经暗示——判官能力阈值(30B+)是负判据可用的前提;换句话说,负判据不是不能用,是便宜判官用不起。回到这篇:本篇弃用负判据是把「当前判官能力」当作约束的工程决策,不是负判据的死刑判决——判官升级后这条消融值得重跑。
8.3 判官能力阈值:三条证据线合流
发散:判官要多强,现在有三个独立来源的答案带。RaR-Hack 精读:GPT-4o-mini(弱)验证器 exploit 39→65%,GPT-OSS-120B(强)持平 15–21%——弱判官当教练会被吃掉。HealthBench 精读:GPT-4.1 判官在 60,896 元样本上达医生级(MF1 0.709),但 7B 级判官没测。本篇:κ 阈值曲线——7B 0.58 不及格、30B 起 0.74–0.80 饱和。三线合读的公共结论:判官能力存在一个实际门槛(30B 级/前沿判官级),门槛之下判官的每个弱点都会被下游放大——训练侧放大成 exploit,评测侧放大成读数失真,本篇量化了门槛本身。加上 HealthBench 的判官调参自评循环警告,判分器线的「判官选型清单」已凑齐四条:能力过阈值、跨家族、避免自评循环、成本按量定价。
8.4 常见误读(破)
「14B 超 GPT-5 = 训练方法强」。破:图 5 的同题换卷实验显示同一套问题换判据就 +14.4,且 Table 1 里 RuFT 单级就从 22.8 涨到 44.4(训练数据筛选的贡献)——读数的主导项是考卷与数据质量,不是 RL 算法(DAPO 是现成的)。正确的引用姿势是「rubric 管线 + 两级训练把 14B 推过 GPT-5」,拆开归因。
「负判据没用/有害」。破:本篇的结论域是「当前判官能力 + RuRL 训练信号」下负判据伤;HealthBench 在评测侧用负分制好好的;本篇自己的元原则(Table 4 p.12)仍写着「权重 −10 到 10」和「Alignment: Explicit, Implicit, or Pitfall item」——设计层没有放弃 pitfall,只是训练消融输给了判官噪声。把工程弃用读成原理否定,是把约束当成了定理。
8.5 写作之维(论文自己怎样完成说服)
图 1 的「I can’t learn anything vs I can learn something」是全篇的修辞锚——把「区分度」这个抽象指标翻译成一句人话,读者从此带着这个直觉读完全篇。Table 1 的排布是渐进式说服:专有模型组、rubric 基线组、自家阶梯组三段并排,自家每行带绿色增量角标——阶梯的每一步都自己说话。图 5 放在主结果正后方,功能是防御性的:读者刚看完「超 GPT-5」正要质疑训练算法的贡献,+14.4 的换卷实验已经把答案摆好了。§7 Limitations 的写法诚实到罕见——「Incorporating Pitfalls introduces significant noise」直接把自家消融的失败机制写进局限,与图 6 互为供词。没说的是:考卷、判官、训练、评测全在同一生态内(判官 prompt 就是 HealthBench 的),自评循环的成本没人付。
九、局限与可疑处
- 自评循环:考卷(110k 判据对)、判官(gpt-oss-120B)、训练靶与评测读数(HealthBench 系)在同一 Stack 内,且判官 prompt 与 HealthBench 官方实现逐字一致(本站逐字核对)——「rubric 判准了」与「HealthBench 分高了」可能共享同一套判准偏差。图 5 的换卷实验部分缓解(RaR 原题、独立生成),但不能全消。
- 域覆盖自认缺口(§7 p.9):无纯可验证任务(数学/竞赛代码)、无长时程 agentic 任务——考卷线的超长时程维度(SWE-Marathon 精读)在本篇空白。
- 判官成本:110k 题 × 多模型生成 × 逐条判定的 API 成本未披露;「效率」一节只承认推理延迟,没给账本。
- 负判据弃用的能力缺口:正-only 训出的模型对「不该做什么」的约束力如何,论文未测——评测读数全来自 rubric 系基准,可能系统性低估惩罚缺口。
- 版本:v1→v2 diff 未核(2026-01-28 修订内容不明——登记);工件无 license(复用边界不清)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是真实 LLM 管线(GPT-5.1/Gemini 3 Pro 生成判据、gpt-oss-120B 判官、Qwen3-14B + DAPO + 8×H200 训练 500 步)。本复现是判据聚合与选择机制的合成演绎:判据构成对选择质量的影响(Eq 9–10 + 判官噪声)、监督上限的梯度几何、拒绝采样极值统计(Eq 7–8)、多模型聚合覆盖、判官能力阈值五件机制的数学行为,全部纯 CPU、LCG 确定性。论文真实数字只作引用并注明出处。
10.2 可证伪预测与判据(轮 4 终版,运行前写死于脚本 docstring)
- P0 判据构成:有噪判官(正 5%/pitfall 20% 误判)下正+pitfall 臂选中质量低于正-only 臂(差 ≥ 0.02);pitfall 臂误选率更高;归因判据——无噪基线 gap0 < 有噪 gap 且 gap0 ≥ −0.02(伤害来自判官误差,不归判据集本身)。
- P1 监督上限:generic 卷顶部梯度 < evolved 卷的 1/3;generic 顶部奖励 > 0.9(饱和);evolved 顶部奖励 < 0.85(不饱和)。
- P2 拒绝采样:E[max_K](K=1..12 密网格)单调升、等步增量单调递减(容差 0.002=MC 误差);τ=0.6 丢弃率单调降;上界增益对传递增益衰减比 > 1。
- P3 聚合覆盖:覆盖维度随生成器数 M 单调升且边际递减。
- P4 判官阈值:κ 代理曲线低段斜率 > 高段斜率×2、末段增量 < 0.08;pitfall 伤害随误判率近似单调扩大且末值 > 首值(符号翻转)。
10.3 实现演化(四轮,如实登记)
轮 1(1/5):符号 bug——pitfall 权重误写成正权,把「惩罚」实现成「奖励」,翻转预测 FAIL 是实现缺陷非机制错误(当时按真发现登记,轮 2 定性更正);另四处世界/度量误设(判官对两类判据同误判率、轴标签、K 网格不等距拿原始增量比、候选分布天花板)。轮 2(3/5):修符号与判官误判率分层——P0 的 gap 被均匀候选分布的顶部拥挤压缩(300 抽的池顶挤满 0.95+,选择差测不出)、P2 等步增量在 MC 误差(±0.003)处两处违反、P4 线性误判率世界只能产生线性 κ。轮 3(3/5):候选分布换 Beta(2,3)、pitfall 权重 −2(论文罚分设计)、P2 加密到 N=20000、P4 世界换成「能力=可处理难度上限」比值机制——P0 的翻转子判据(无噪两臂相等)仍 FAIL:重罚权重放大响应侧实现方差(每个候选实际满足哪些判据是伯努利实现),与判官误差无关——原预测混淆了两种噪声,按域修正改为归因式判据;P4 的巨型共享池取 max 使选中质量饱和成常数(读数成彩票),改为 400 个 8 候选小池配对平均。轮 4(冻结,5/5):P0 归因判据过(gap0=0.0117 < 有噪 0.0243 且 ≥ −0.02)、P4 扫描出符号翻转(−0.009→+0.048)。核心教训:合成世界的选择实验,候选分布的顶部密度决定「质量差」读数的分辨力——统计量的分母被天花板吃掉时,方向再对也测不出来。
10.4 运行结果与预测对照
脚本 repro/repro_rubrichub.py,真实输出
repro/repro_rubrichub_output.txt(轮
4 冻结,输出 sha256 前 16 位
6fba15599664b02d;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 判据构成 | 正-only 66.2 vs 正+pitfall 63.2(图 6 p.7);§7「噪声随模型规模加剧」 | 有噪 gap 0.0243;误选率 0.477 vs 0.547;gap0=0.0117 < 有噪 gap | 世界标定(判官误判率 5%/20%) |
| P1 监督上限 | 图 1:满分 1 vs 0.6;图 4:Qwen3-235B ~0.6 | generic 顶部梯度 0.000 vs evolved 0.102;evolved 顶部 0.59(≈235B 读数形态) | 判据难度分布设定 |
| P2 拒绝采样 | 图 9:上界 63.45→79.51、最终 43.61→48.81(衰减比 ≈3.1) | E[max] 0.40→0.72 单调、增量递减、τ 丢弃率单调降、衰减比 2.86 | Beta(2,3) 标定 + 传递系数 0.35 |
| P3 聚合覆盖 | 用 2 个异构前沿模型(§3.1 p.3) | 覆盖 70%→91%→97%(M=1→3),增量 8.3/2.6/0.8 边际递减 | 盲区漏检率 p=0.30 设定 |
| P4 判官阈值 | 图 7:κ 0.58→0.74→0.74–0.80 饱和(940 判据) | 低段斜率 0.154 > 2×高段 0.036、末段增量 0.036 <0.08;pitfall 伤害 −0.009→+0.048 符号翻转 | 「能力=难度上限」比值机制 |
结论:[Re] 全部假说复现通过——四轮冻结(轮 1 符号 bug、轮 2/3 世界与度量校准、轮 3 翻转预测改归因式,均如实登记);无未解释 FAIL 项。
十一、方法论提炼与迁移
模式一:同题换卷(Same Questions, New Rubric)
- 操作定义:要归因「分数涨自考卷还是训练」,固定问题集与判官,只替换判据集(手写 vs 管线生成),复跑同一训练流程对照。
- 成功判据:换卷前后的问题、判官、训练算法、评测读数全部不变,只有判据来源一个自由度——论文图 5 的 +14.4 即可单独归因给判据质量;若换卷增益与总增益同量级,则「训练方法」的贡献是二阶的。
- 迁移去向:①教学命题质量研究——同一题库换评分细则,归因「提分来自老师还是卷子」;②招聘评估——同一批候选人换面试评分表,测评估表的贡献;③A/B 评测基建——同一批输出换打分 prompt,量化判据工程的投资回报。
- 方法卡:
notes/method_same_questions_new_rubric.md(L1) - 层级:L1 领域具体(评测工程/归因实验设计)。
模式二:难度演化(Difficulty Evolution)
- 操作定义:基础判据只覆盖基本正确后,从「共识高分的参考回答对」中提炼区分性增量判据,把「合格检查」硬化为「卓越区分」——直接以恢复奖励曲线顶部梯度为目标。
- 成功判据:演化后顶层模型的平均分显著低于饱和线(论文:Qwen3-235B ~0.6);模型规模分层在分数密度上保持可分(图 4);基础判据的覆盖面不缩水(Eq 6 是并集不是替换)。
- 迁移去向:①竞赛命题——从顶尖选手的解法差异里出压轴题,防「人人满分」;②绩效考评——从明星员工的做事差异提炼高阶指标,防 KPI 饱和;③代码评审清单——从资深评审的分歧点提炼深度检查项。
- 方法卡:
notes/method_difficulty_evolution.md(L1) - 层级:L1 领域具体(考卷工程/指标设计)。
十三、没搞懂的地方(未攻克登记)
- 判官 prompt 的 HealthBench 血统是引用还是复制:D.1 与 simple-evals 逐字一致(本站已核),但论文只引 Arora et al. 未说明复用范围——判准偏差是否随 prompt 一起继承。补齐时机:对比 simple-evals 与论文判官在分歧样本上的判定分布。
- 难度演化的判据实效分布:R_{\text{add}} 占最终判据集的比例、按域/按轴的密度未报——演化贡献只能从 Table 3 整体消融(+1.2 HealthBench / +3.9 LLMEval-Med)反推。补齐时机:仓库数据逐条统计(工件已开源,待代码级核对)。
- 负判据在强判官下的表现:消融只在 gpt-oss-120B 判官下做过(§7 说噪声随规模加剧,但没有 235B 判官的 pitfall 消融)。补齐时机:作者或社区补 235B 判官 × pitfall 臂。
- v1→v2 改了什么:2026-01-28 修订无说明。补齐时机:arXiv diff 或作者说明。
- 量产线判据的可利用性:管线生成的判据是否有系统性可 exploit 模式(RaR-Hack 三失败模式在自动判据上的分布)。补齐时机:在 RubricHub 判据上复刻 RaR-Hack 的三判官对照实验。
十四、可信度
- A 级:§2 形式化(Eq 1–2,p.2)、§3 三阶段管线(Eq 3–6,p.3–4)、§3.3 双用训练(Eq 7–10,p.4–5)、Table 1 阶梯(p.6)、Table 2 判官选型(p.6)、图 5 换卷实验(p.6)、图 6 判据构成消融(p.7)、图 7 一致性阈值(p.7)、Table 3 管线消融(p.7)、图 9 拒绝采样消融(p.8)、附录 A 元原则(p.12)、附录 B 训练配置(p.13)。
- B 级:全部模型读数(8×H200 自报);图 4 分数密度(图读);图 8 训练动态(图读);ArenaHard V2 的 5.2→74.4 跨度(基线过低存疑——Base 在对话域近零分)。
- C 级:§三 三本账、§六 两段机制推导、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读与负判据三难、6.1 的选择论解释、判官 prompt 血统推断。
- 横向核实初核(2026-10-04):版本 v2 已核(abs 页 2026-10-04 亲核;v1 2026-01-13;v1→v2 diff 未核——登记);录用未标注(abs 页无 Comments);机构已核(p.1 Li Auto/浙大/NTU/港中深);工件已核(GitHub API:teqkilla/RubricHub,71 stars,无 license,created 2026-01-18,pushed 2026-03-13——存在,代码一致性未验);判官 prompt 血统已核(simple-evals healthbench_eval.py 直查逐字一致);第三方:OpenReview/社区讨论未检索(登记);统计审查:Table 1 每格点估计无置信区间(登记);图 9 曲线为图读(精确数值以正文引用的 63.45→79.51 / 43.61→48.81 为准);Table 3 严格单调自洽(60.9→63.8→65.0→66.2 逐级 +2.9/+1.2/+1.2,与正文「+2.9」引用一致)。
- 实验充分性评价:部分充分——管线消融(Table 3)与判据构成消融(图 6)有对照,但无训练种子重复、无跨判官交叉验证、评测全在 rubric 系基准内(IFEval/GPQA 等外部锚点读数分散在 Table 1,无单独分析)。缺:跨生态评测与成本账。
- 性能支撑目标检查:goal 是「解决三瓶颈(手工/窄域/低区分度)」——手工(自动化 ✓)、窄域(五域 110k ✓)、低区分度(图 4 顶层 ~0.6 不饱和 ✓);「surpass GPT-5」——HealthBench 单基准支撑(69.3 vs 67.2†,† 为官方博客转引),LLMEval-Med 83.2 未超 GPT-5 的 80.0 为接近,IFEval 92.6 超但属可验证域——「超 GPT-5」的表述限定在医疗单基准内成立。