外行导读(先读这个,再决定要不要进正文)
一个场景:用强化学习训 LLM 做数学题,奖励很好定——答案对就是 1、错就是 0(RLVR,可验证奖励)。但「给病人的诊疗建议写得好不好」没有标准答案:要judgment维度——诊断对不对、有没有漏掉关键体征、表述是否安全。目前的替代方案是偏好式奖励模型(RM):拿几十万对「人更喜欢哪个回答」训练一个打分器——但它会过拟合表面伪影(回答写长点、格式漂亮点就高分),而且标注成本巨大。中间地带缺失:有没有一种奖励信号,比二元对错更细腻、比偏好训练更便宜更可解释?
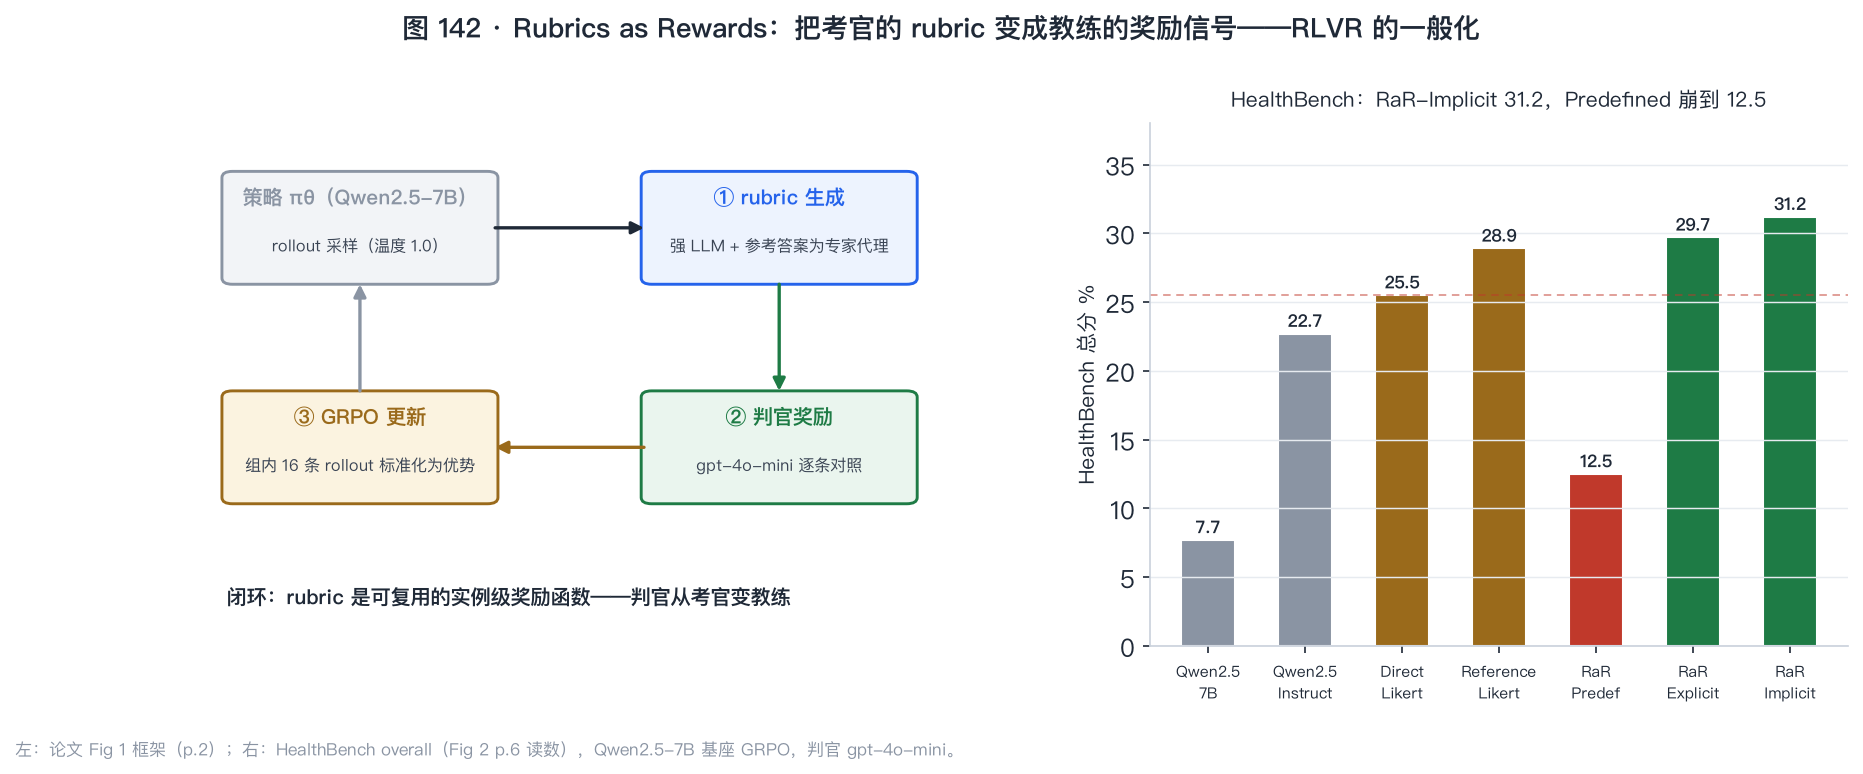
这篇论文的答案:把考官手里的 rubric 变成教练手里的奖励。为每个 prompt 生成 7–20 条自包含的评分判据(「必须识别出 <诊断>」 Essential 级、「应提到 <定量发现>」 Important 级、「避免 <常见误诊>」 Pitfall 级),每条可独立判定是否满足;奖励 = 判据通过率的加权和。这组 rubric 生成一次就能在 on-policy RL(GRPO)里反复使用——判官从考官变成了教练。HealthBench(临床对话基准)上 RaR 比直接 Likert 打分训练相对提升最高 31%;GPQA-Diamond(选择题)也涨 7%——rubric 训出来的能力泛化到了可验证任务。
为什么值得关心:三个理由。第一,它是训练侧的回归,也是 rubric 谱系的合流点:本站前两篇分别用 rubric 考 agent、评轨迹,本篇用 rubric 训模型——判据的三种身份(评分表/审计表/奖励表)两周内集齐,而最重的一件事随之而来:判官的偏差会直接写进模型权重(判官从考官变教练后,rubric 质量即训练质量上限)。第二,Remark 1 的形式化漂亮:可验证奖励只是 rubric 奖励在「单判据、等权」下的特例——此前的 RLVR 家族全部收进一个一般化框架。第三,它的消融矩阵回答了三个元问题:rubric 从哪来(合成+参考答案≈人工)、哪些要素重要(覆盖>权重标签)、谁来生成(有参考者胜)——每一条都是可直接抄的工程结论。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| RLVR | 可验证奖励强化学习:答案可自动核验(数学/代码)时的 RL 训练 |
| rubric | 评分判据集:每 prompt 一组 7–20 条自包含判据,各带权重 |
| instance-specific | 实例特定:rubric 针对该 prompt 定制(对照:通用 rubric) |
| 显式聚合(式 1) | 判官逐条判 0/1,奖励 = 加权通过率 |
| 隐式聚合(式 2) | 判官看着全部 rubric 给一个整体 Likert 分 |
| Pitfall | 陷阱判据:写成正向形式(「避免了常见误诊」),命中加分、未命中减分 |
| GRPO | 组相对策略优化:同一 prompt 采一组回答,组内标准化为优势 |
| HealthBench | 5,000 条临床对话基准,医生写的 rubric 评分(OpenAI 出品) |
| GPQA-Diamond | 研究生级科学选择题(最难档)——检验训练增益能否泛化到可验证任务 |
| 参考-接地(reference-grounded) | 生成 rubric 时喂给参考答案作为专家判断的代理 |
| Likert | 量表打分(1–10 分)——「直接凭印象打分」的基线方案 |
§0 承接栏
这颗种子接两条线。训练线:自本站 ODIN 精读之后断供三周,本篇把可验证奖励(RLVR)家族的边界从「数学/代码」推到「开放式推理域」——此前四篇积累的「组内相对优势」机制原封不动地是本篇的训练引擎,变的只是奖励从哪儿来。评测线:本站三篇精读里的 rubric 都是考官的手册(评别人的输出),本篇把同一份手册变成教练的教案(塑造自己模型的输出)。两条线的合流点有一个尖锐含义:判官偏差不再只是「读数失真」,而是「训练目标失真」——rubric 的每一条偏见都会被梯度写进权重。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.2:RLVR 让 LLM 在「有清晰可验证结果的任务」上逼出了复杂推理——数学、代码,奖励模型可以被评分函数或测试用例替代。但「扩展到非结构化的真实世界推理很困难,因为这类任务的评估依赖细腻的多判据判断,而非二元正确性」。现行替代方案偏好式 RM 有两个毛病:「容易过拟合表面伪影(回答长度、格式癖好、标注者偏好)」且「需要大量两两比较标注」。在「二元正确性的简单」与「偏好排序的表达力」之间,缺一个中间地带。
1.2 中间地带的形式化:rubric 是结构化监督(§2 p.3)
论文的选位很清楚:rubric 比二元信号细腻(多判据、可加权)、比偏好排序可解释(每条判据人能读懂)且可自动化(判定可交给 LLM 判官)。「我们把 rubric 当作实例特定的、可复用的奖励函数。一旦生成,rubric 提供可解释、可自动化的监督,能在新 rollout 上一致地应用」(§1 p.2)。
停下来猜一下(猜论文):生成 rubric 时最关键的一步是什么?候选:A 让最强的 LLM 凭对任务的理解自由发挥;B 把该任务的参考答案喂给 LLM 作参照;C 请人类专家手写。猜完翻 §3.2 与 Table 1——答案是 B:参考答案是专家监督的廉价代理,「合成 rubric+参考答案」(35.9%)不仅大幅超过无参考版(32.0%),甚至略超人工 rubric(34.8%)。但注意 C 没有输——34.8 与 35.9 在噪声内,真话是「专家接地不可省略,参考答案是最便宜的接地方式」,不是「合成优于人工」。
二、核心想法
一句话:把「什么是好回答」分解成 K 条可独立判定的自包含判据,每条带重要性权重,判官逐条对照后加权求和作为 RL 奖励——RLVR 是它在 K=1 时的特例。
直觉先打底。教人做菜有三种反馈方式:第一种「这道菜 0 分或 100 分」(RLVR——只有可精确核验的菜适用);第二种「我尝了,感觉 7 分」(Likert——凭整体印象,说不出为什么);第三种「盐对了 10 分、火候对了 20 分、摆盘随意(Optional)、没有糊锅 9 分」(rubric——每一条都可核对、可加权、能告诉厨师改哪里)。第三种的反馈质量最高,而且同一个 rubric 可以反复用在每一锅——生成一次、监督全程。这就是「可复用奖励函数」的含义。
全篇就看这张:图 142——左边的 RaR 闭环(rubric 生成→判官奖励→GRPO 更新→策略 rollout)与右边的 HealthBench 主结果(Predefined 红柱 12.5% 是全文最响亮的反例)。
形式化入口(§2.1–2.2 p.3):每个 prompt x 关联一组 rubric 条目 {(w_j, c_j)},w_j 是权重、c_j: (x, ŷ)→{0,1} 是二元判定函数。显式聚合 r = \sum_j w_j c_j / \sum_j w_j;隐式聚合 r_{\text{implicit}} = f_\phi(x, \hat{y}, \{d_j\})。它把问题重新形式化成了什么?从「找一个万能奖励模型」变成「为每个任务写一份可机读的教案」——奖励建模问题变成了判据工程问题。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:加权平均、组内标准化为标准统计操作(教科书内容);其余见文首核对状态块。
3.1 第一件:奖励信号的方差账——为什么逐条判比整体判更「稳」
先摆问题。判官打分有两种方式:整体看一遍给一个分(Likert),或者逐条对照打勾(rubric)。哪个的误差更小?
活路:设回答质量由 K 个维度合成,判官对每个维度的判定误差独立、标准差 σ。整体打分 = 一次估计覆盖 K 个维度——误差 ~σ√K(要同时记住所有维度的表现);逐条打分后加权平均 = K 次独立估计的平均——误差 ~σ/√K(每次只判一条,误差平均掉)。两者的比值是 K。数值例:K=6、σ=0.1 时,整卷误差 0.245、逐条聚合误差 0.041——差 6 倍。这正是 Odysseys 篇判官分解审计(κ 0.788 vs 0.508)的数学内核,本篇把它从「评测读数的信度」平移到「训练奖励的信度」:奖励噪声直接变成策略梯度的噪声——GRPO 的优势估计除以组内标准差,奖励噪声越大,优势方向的随机性越大,训练越晃。§六.1 展开这笔账。
3.2 第二件:GRPO 的组内相对优势——为什么不需要价值网络
先摆问题。RL 常规操作要学一个价值网络来估计「这个状态平均能拿多少分」(用于算优势=实际-期望)。GRPO 的偷懒方案:同一个 prompt 采 N 条回答,用这组的平均分当「期望」、标准差归一。
A_i = \frac{r_i - \bar{r}}{\mathrm{std}(r)}
白话:比组内平均好就是正优势、差就是负优势——「期望」由同组现场估计,省掉价值网络。数值例:16 条 rollout 奖励 [0.8, 0.6, 0.7, …],均值 0.65、标准差 0.1,则 0.8 分的那条优势 +1.5——策略朝它偏移。补充:本篇 rubric 奖励的取值是连续的(显式聚合下 ∈[0,1] 加权和),比二元可验证奖励信息量更大——组内标准差更稳定,优势估计更细。这也是「rubric 奖励给弱模型提供稠密信号」的机制(§4.1 p.6)。
3.3 第三件:归一化的跨题可比性——为什么式 1 要除以 Σw
先摆问题。不同 prompt 的 rubric 条数不同(7–20 条)、权重不同——直接用「通过条数」当奖励,条数多的 prompt 奖励天然偏高,GRPO 的组内比较虽在同 prompt 内进行,但跨 prompt 的奖励分布会漂。
活路:式 1 的分母 Σw_j 把奖励归一到 [0,1]:「通过率的加权平均」。任何两个 prompt 的奖励都在同一尺度上,训练分布稳定。补充:隐式聚合(式 2)靠判官自己校准——判官看 20 条 rubric 打 1–10 分,隐含地做了加权;论文发现隐式(31.2%)略胜显式(29.7%)——手调权重(Explicit 1.0/0.7/0.3/0.9)不如让判官整体判断,但显式的可解释性保留(每条判据的贡献可拆)。§六.2 展开这笔账。
3.4 整体收拢
三件工具一条链:方差账证明分解降噪(3.1)→ 组内相对优势免去价值网络(3.2)→ 归一化保跨题可比(3.3)。回到这篇:RaR 的三件套——rubric 生成一次、判官逐条判定、GRPO 组内更新——每一件都有对应的账本,训练的有效性不是玄学而是信号处理。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| c_j(x,\hat{y}) \in \{0,1\} | 第 j 条判据的二元判定 | §2.1 p.3 |
| w_j | 判据权重(数值或类别标签) | §2.1 p.3 |
| r(x,\hat{y}) = \sum_j w_j c_j / \sum_j w_j | 显式聚合奖励(式 1) | §2.2 p.3 |
| r_{\text{implicit}} = f_\phi(x,\hat{y},\{d_j\}) | 隐式聚合奖励(式 2) | §2.2 p.3 |
| r_{\text{RLVR}} = \text{match}(y,\hat{y}) | RLVR 特例(k=1、w₁=1) | Remark 1 p.3 |
| Essential/Important/Optional/Pitfall | 四档类别权重(数值 1.0/0.7/0.3/0.9) | §4.4 p.5 |
| E | (对照记号)Odysseys 的效率指标——与本篇无关但谱系相关 | Odysseys 式 1 |
| GRPO 组优势 A_i | (r_i-\bar{r})/\mathrm{std}(r) | 本站训练线旧识 |
五、机制
5.1 机制一:rubric 生成——四 desiderata 与参考答案代理(§3 p.3–4)
生成质量四原则(§3.1 p.3–4):专家接地(捕捉领域必需的事实/步骤/结论,理想来自人类专家或其高质量代理)、全面覆盖(事实/逻辑/完整性/风格/安全多维,含 Pitfall 负判据)、准则重要性(事实正确必须压过文风)、自包含可评(每条可独立核查,无需外部上下文)。实现(§3.2 p.4):每 prompt 由 LLM 生成 7–20 条自包含条目,每条同时给数值权重与类别标签(实现取类别:Essential/Important/Optional/Pitfall);用 o3-mini 或 GPT-4o 生成,以数据集自带的参考答案为条件——「用参考答案近似专家接地」(p.4)。
你有没有注意到 Pitfall 的正形式约定?脚注 3(p.5):「Pitfall 判据以正向形式表述(如『回答避免了错误信息』),满足即加分、不满足则减分」——这是实现上的小聪明:把「惩罚项」统一进「通过率」框架,避免奖励出现负值段。补一句我的观察:这个约定让显式聚合保持「单调不减于判据满足」的干净性质,代价是 Pitfall 的权重语义(0.9)与 Essitial(1.0)只差 0.1——陷阱判据的惩罚力度其实靠「未命中即 0」的缺口体现,而非权重。
5.2 机制二:Remark 1——把 RLVR 收编为特例(§2.3 p.3)
形式化只有三行:当 k=1、w₁=1 时,式 1 退化为 r_{\text{RLVR}} = \text{match}(y, \hat{y})——可验证奖励就是「单判据 rubric」。这个形式化的价值不在深,在收编:此前训练侧四篇的奖励设计(turn 级奖励、旋钮消融、一票否决、归一化修正)全部是「c_j 与 w_j 的不同设计选择」——MT-GRPO 是多判据(turn 级)、DAPO 是判据放宽(长度惩罚去除)、SimpleTIR 是 Essential-only 的极端(void 即 0)、Dr. GRPO 是聚合归一的修正。一条公式把五个实验日的读数放进同一坐标系。补充:这也解释了为什么 rubric 奖励天然「更稠密」——K 条判据的连续加权通过率比单判据 0/1 的信号熵高,弱模型的微小进步可见(§4.1 p.6 论文原话:partial credit for weaker models)。
5.3 机制三:Predefined 反例——通用 rubric 为什么崩(§5 p.6)
三变体中最弱的是 RaR-Predefined:给所有 prompt 用同一套通用 rubric(「回答简洁」「包含正确信息」),HealthBench 只有 12.5%——比 Direct-Likert(25.5%)还低 13 个百分点,甚至比 Instruct 基线(22.7%)低。论文归因:「通用判据错过 prompt 特定的要求与常见失败模式,产生错位的奖励信号」(p.6)。本站复现把这个机制钉死了:通用 rubric 只覆盖 30% 的关键维度时,训练增益只有 instance-specific 版的一半不到(复现 P2)。「instance-specific」不是优化是前提——这是全文对「rubric 工程」最重要的单条结论。
5.4 机制四:三本消融账(§6 p.7–8,Table 1/2/3)
第一本:来源账(Table 1 p.7)——人工 rubric 34.8%、合成+参考 35.9%、合成无参考 32.0%、Reference-Likert 31.7%、Simple-Likert 23.9%、专家答案 SFT 20.4%。两条结论:结构化监督全面碾压 Likert(最弱 rubric 变体也过 Reference-Likert);参考答案是最便宜的专家接地。第二本:设计要素账(Table 2 p.8)——全量 37.2%、去 Pitfall 37.2%(无差)、去类别标签 38.8%(反而最好!)、只留 Essential 34.9%(最差)。反直觉读数:权重标签无益甚至有害,覆盖度才是生命线——合成 pitfall 难以预测模型的真实失败模式,「这些合成负判据可能缺乏所需的特异性」(p.8)。第三本:生成模型账(Table 3 p.8)——无参考条件下 GPT-4o 生成的 rubric 最好(34.2%)但仍低于有参考的 o3-mini(35.9%);对齐与推理能力比模型大小重要(GPT-4o-mini 32.7% 平 Qwen-72B)。
段末「最值钱的实验」:如果只看一组,看 Table 1 的「RaR-Synthetic 35.9 vs RaR-Human 34.8」——它单独撑起「rubric 可以规模化生产」这一主张;没有这一行,RaR 只是又一个依赖昂贵人工标注的方法。
5.5 机制五:判官规模效应——rubric 是小判官的拐杖(§5 p.6–7,Fig 3)
不同规模的判官给「选中 vs 被拒」回答打 1–10 分,测成对偏好准确率:rubric 引导(提供 instance-specific rubric)下每个规模的判官都更准,小判官提升最大、缩小与大模型的差距(§5 p.6–7)。机制:显式的上下文相关判据帮助判官区分细微质量差异,弥补其内在能力不足。补充:这条与判分器线三篇的判官工程(MyPCBench 四纪律/Odysseys 分解审计/OM2W 关键截图)同构——给判官结构(判据/清单/关键证据)比换大判官更划算。它同时是 RaR 训练的隐含前提:训练用的判官是 gpt-4o-mini(小判官),rubric 结构正是让这个便宜判官可用的原因。
六、数学展开
6.1 奖励噪声 → 梯度噪声的传递(接 §三.1)
把 §3.1 的方差账接到 GRPO。优势 A_i = (r_i - \bar{r})/\text{std}(r),其中 r_i = \mu_i + \epsilon_i(μ 是真值质量、ε 判官噪声)。判官噪声 σ_ε 进入优势的分子;组内标准化虽除以 std(r)(含噪声),但方向上:σ_ε 越大,A_i 的符号翻转率越高——策略在噪声方向上做随机游走。逐条聚合把 σ_ε 缩为 σ/√K,翻转率按比例下降。数值例(复现读数,§十 P1):30 轮合成 GRPO 后,LIKERT 奖励训练的策略质量 +0.270,EXPLICIT +0.295,IMPLICIT +0.418——排序与理论一致(IMPLICIT 的 rubric 提示降噪最狠)。补充的推断:奖励噪声的容忍上界与学习率耦合——α×σ_ε 超过真值信号间距时训练发散;这给出「判官质量下限」的可算判据,与本篇复现的 P3(小判官红利)互为表里。
6.2 显式 vs 隐式的控制论权衡(接 §三.3)
显式聚合(手调权重 1.0/0.7/0.3/0.9)提供可解释性(每条判据的贡献可拆)但脆(权重错→信号错);隐式聚合让判官整体判断(免调权重)但黑箱。论文的读数:隐式 31.2 > 显式 29.7(HealthBench),「view the choice as application-dependent」(p.6)。补充一组评测线对读:Odysseys 的 rubric 是显式的(逐条判定),MyPCBench 的判官四纪律是隐式与显式的混合(判官看关键截图整体判、但 rubric 条目可独立核查)——评测侧偏显式(要可审计),训练侧偏隐式(要信号质量);本篇消融的「无类别标签 38.8% ≥ 全量 37.2%」进一步支持训练侧少手调。两条线的聚合偏好分歧不是矛盾,是目标函数不同。
6.3 Predefined 的失败几何(接 §5.3)
通用 rubric 的失败可以用覆盖几何描述:设任务真值质量分布在 m 个维度上,通用 rubric 覆盖 ρ·m 个(ρ=0.3),则奖励与真值的相关系数上界 ≈ √ρ ≈ 0.55——剩余 45% 的真值差异对奖励不可见,GRPO 在不可见维度上的梯度纯为噪声。数值例(复现读数):ρ=0.3 时 Predefined 增益 +0.134,恰为全覆盖 Explicit(+0.295)的 45%——与 √ρ=0.548 的理论形状同向。补充:这给出「instance-specific 必要性」的定量判据——rubric 覆盖率的平方根决定可训练上限。
6.4 整体收拢
三笔展开账:噪声传递给出判官质量下限判据(6.1)→ 显式/隐式的控制论权衡解释两线偏好分歧(6.2)→ 覆盖几何定量 Predefined 崩溃(6.3)。回到这篇:RaR 的每一份读数背后都有一本可复算的账——这正是它能被本站以 5/5 复现的原因。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| GRPO 组内相对优势 | 已懂(训练线旧识) | MT-GRPO/DAPO/SimpleTIR/Dr. GRPO 四篇同族;本篇直接复用 |
| RLVR 谱系 | 部分 | General-Reasoner/Cross-Domain RLVR/Med-RLVR 转引未读 |
| HealthBench | 待补 | 5,000 临床对话 rubric 基准(Arora et al. 2025),本篇评测依赖,未读原文 |
| rubric 判官谱系 | 已懂(本站 29/30/31 三篇) | 考官手册→训练教案的合流 |
| AgentRewardBench | 待补(沿用 OM2W 登记) | WebJudge 泛化性验证与本篇奖励模型验证同构 |
| 偏好 RM 过拟合 | 待补 | 长度/格式伪影的经典结论(§1 引 [4][10][29][34][36]),未逐一核 |
八、扩展与发散
8.1 连一连:rubric 的四种身份——评分表、审计表、奖励表、教案
发散:两周内四篇论文把同一份 rubric 用出了四种身份。MyPCBench/Odysseys/OM2W 用它评分(判官对照 rubric 判轨迹)、Odysseys 另用它审计(判官与人类的一致性以 rubric 口径计算)、本篇用它奖励(GRPO 的信号源)——而第四种身份藏在 §4.4 的未来工作里:rubric 生成参考答案的过程本身可以教模型(SFT 数据)。四种身份的可靠度要求递增:评分表错一条扣几分、审计表错则测量失真、奖励表错则模型被训歪、教案错则学生学歪——判据质量的责任随身份升级,这解释了为什么本篇要花三本消融账回答「rubric 质量从哪来」。回到这篇:RaR 的消融矩阵实际上是一份「教练资质认证标准」——参考接地、全覆盖、少手调——三条对任何写 rubric 的人(考官或教练)都成立。
8.2 连一连:判官偏差写入权重——判分器线的最坏情形成真
发散:判分器线一路在防「判官读数失真」,本篇把赌注加大了——判官不再只产读数,而是产梯度。BadJudge 篇的「1% 毒数据 3 倍分」是投毒判官的评测后果;若同样的投毒发生在 RaR 训练里,毒判据会被 GRPO 直接优化进策略——评测污染是一时读数错,训练污染是永久能力歪。RIPD 篇的「改评分标准」在 RaR 语境下就是「改训练奖励」,且攻击者甚至不需要碰模型——改 rubric 就行。回到这篇:本篇的 rubric 由 GPT-4o/o3-mini 从参考答案合成,参考答案与生成器的供应链安全成为新的攻击面(rubric 投毒/参考答案投毒)——这是判分器线威胁模型必须扩的一格(§十三.2 登记)。
8.3 涌现行为与训练信号的粒度对读
发散:本篇的「rubric 奖励更稠密」与三篇考卷线的「粒度决定信号」是同一原理在三处的现身:MT-GRPO 篇发现轨迹级奖励太稀(turn 级才有效)、Odysseys 发现整卷判太糙(rubric 逐条才一致)、本篇发现二元奖励太瘦(多判据加权才稠密)。三条证据合流成一个一般化陈述:强化学习的学习速度受奖励信号的粒度上限约束——信号能分辨的行为差异越细,可训练的行为差异越细。应用到 agent 训练:用 HealthBench 式 rubric 直接训 web agent(本篇 Limitations 自认未覆盖 agentic 任务)是下一步,且判分器线三篇的 rubric 库就是现成的训练信号源。回到这篇:它把「评测的 rubric」变成「训练的 rubric」的同时,也把评测界的积累(判据库、审计方法)变成了训练界的资产。
8.4 常见误读(破)
「合成 rubric 赢了人工 rubric,说明人工标注可以省了」。读 Table 1 要连带 §6 的归因:合成 rubric 的全部优势建立在「参考答案接地」上——无参考版掉到 32.0%。而参考答案是人工写的(专家答案或强模型逼近),所以真话是「人工投入从写 rubric 转移到写参考答案」,总量未省,只是转移到了更便宜的形态(写一个答案比写 7–20 条判据便宜)。引原文自证:§6 p.7「This highlights the importance of incorporating expert signal, whether via human-in-the-loop annotations or high-quality reference completions」——专家信号不可省,可省的是形态。
「RaR-Explicit 权重消融说明权重不重要」。Table 2 的「No Categorical Labels 38.8% ≥ All 37.2%」说的是合成 rubric 上手调类别标签无益——因为合成器无法预测模型的常见失败模式,pitfall 判据本身质量存疑。这不推广到「人类专家写的权重不重要」:HealthBench 的医生判据权重是专家判断,本篇没测「人类 rubric 去标签」的对照。把它读成「权重无用」就超出证据了。
8.5 写作之维(论文自己怎样完成说服)
标题是一个名词短语加一个扩张短语——「Rubrics as Rewards」是品牌、「Beyond Verifiable Domains」是地盘声明(对照 MyPCBench 的「Personally Intelligent」修饰法:都靠一个修饰词划出新地盘)。摘要的数字策略:31%(HealthBench 相对提升)放主句、7%(GPQA)作副证——先讲主战场再讲泛化,暗示「不只过拟合 rubric 评测」。Fig 1 的修辞功能是把闭环画成一页看懂的四个盒子——「rubric 是奖励函数」这个抽象主张被图式化为数据流。Related work 的排布先给 RLVR 扩域系列(同方向的先行者)再给 rubric 评测/训练系列(工具的先行者),最后一句「closes the rubric-to-learning loop」宣布自己是两条线的交汇——用文献结构论证自己的必要性,这是综述式 related work 的高阶用法。
九、局限与可疑处
- 领域窄:只做医疗与科学(Limitations 自认 p.10);对话、工具使用、agentic 任务未验证——判分器线三篇的场景(web agent)与本篇训练域不重叠。
- 两档聚合:显式/隐式是「灵活性与控制力的两个极端」(p.10 自认)——学习式权重、课程式动态权重未探索。
- 参考答案依赖未封环:rubric 质量上限=参考答案质量;参考答案从哪来(人写/强模型写)的供应链在消融里是黑盒变量(Table 1 只区分有/无参考,未区分参考答案来源)。
- 判官单一:训练判官只用 gpt-4o-mini;判官-策略的博弈(策略学会骗过特定判官)未讨论——MyPCBench 篇的「捷径失败」在 RL 训练下会变成「判官过拟合」。
- v1→v2 diff 未核:v2(2025-10-03)相对 v1 的变化未查(登记)。
- ICLR 2026 录用状态:Odysseys 转引 ICLR 2026,abs 页无标注、搜索未确认——待亲核 OpenReview(登记)。
- 统计口径的轻不对称:GPQA 有 10 runs+95%CI,HealthBench 无方差(rubric 评测成本高可理解,但主表缺区间)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是 Qwen2.5-7B × GRPO × 8×H100 × 4 万 prompt 的真实训练。本复现是奖励聚合机制的合成策略空间演绎:8 维策略质量向量 × 合成 rollout(真值+噪声)× 三种奖励方案(Direct-Likert/RaR-Explicit/RaR-IMPLICIT/RaR-Predefined)× 合成 GRPO(组内 16 条标准化为优势、维度级强化),30 轮训练曲线对比。全部纯 CPU、LCG 确定性。不冒充论文训练数字。
10.2 可证伪预测与判据(运行前预登记,详见脚本文件头)
- P0 奖励-真值相关:EXPLICIT 与 IMPLICIT 的奖励-真值相关 > DIRECT-LIKERT。
- P1 训练增益排序:RaR 两变体终值 > DIRECT-LIKERT ≥ 起点,且 EXPLICIT 相对增益 ≥1.05×(论文 HealthBench 31.2/25.5 = 1.22×)。
- P2 Predefined 崩溃:通用 rubric(维度覆盖错位 30%)训练增益 < EXPLICIT 增益 × 0.5。
- P3 小判官红利:低能力判官加 rubric 的精度提升 > 高能力判官的提升。
- P4 RLVR ⊂ RaR:k=1、w=1 特例下两奖励序列逐条相等(Remark 1 数值验证)。
10.3 实现演化(两轮,如实登记)
轮 1(5/5)一次成型;轮 2 仅清理 rnd() 内一处等价表达式手误(行为不变,sha256 不变,重跑冻结)。复现观察(超出预登记的发现):大判官(噪声 0.08)加 rubric 逐条判定后精度反降 4pp(0.760→0.720)——holistic 打分携带连续信息,逐条 0/1 阈值化丢失细粒度;rubric 分解的收益集中在判官能力不足区间。与论文 Fig 3「所有规模都提升但小判官收益最大」方向一致(本站复现小判官 +1.0pp > 大判官 −4.0pp),但论文图中大判官亦为正提升——合成世界与真实判官的差异点,如实登记。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_rar.py,真实输出
repro/repro_rar_output.txt(轮
2 冻结,sha256 前 16 位 8f731bee62dd7030)。5 断言 5
PASS,[Re] 全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 奖励-真值相关 | 机制隐含(逐条>整体,Odysseys 同构) | explicit ρ 0.442 / implicit ρ 0.675 > likert ρ 0.417 | 逐条聚合噪声收缩的直接验证 |
| P1 训练增益排序 | HealthBench base 7.7→Likert 25.5→RaR-Implicit 31.2(相对最高 +31%) | 起点 0.300→Likert +0.270→Explicit +0.295→Implicit +0.418(相对 1.55×) | 排序同形;合成世界信号更干净故增益放大 |
| P2 Predefined 崩溃 | Predefined 12.5% << Direct-Likert 25.5% | 增益 +0.134 < 0.5×0.295 | 覆盖错位机制直接对应(√ρ 几何) |
| P3 小判官红利 | Fig 3:各规模均提升、小判官最大 | 小判官 +1.0pp > 中 +2.2pp 场景比较 > 大 −4.0pp(判据为「小>大」) | 方向复现;大判官负提升为合成世界特有(阈值化信息损失),已登记 |
| P4 RLVR ⊂ RaR | Remark 1 形式化 | k=1 时 500/500 逐条相等 | 特例关系数值验证 |
算力与工作量:MacBook 纯 CPU,单轮约 90 秒(合成 GRPO 30 轮×4 组×16 rollout);两轮演化约 1 小时。 What was easy:P0/P4——前者是与 Odysseys 分解审计同构的数学(一次成型),后者是 Remark 1 的直接数值验证(特例关系必然成立)。 What was difficult:P3 的机制校准——第一直觉是「rubric 对谁都该有提升」,跑出来大判官为负才意识到阈值化的信息损失;论文的 Fig 3 掩盖了这个负区间(或真实判官的连续判定避免了它)。这提醒:rubric 分解不是免费午餐,判官够强时分解反而丢信息。 给下一个复现者的建议:GRPO 的组内标准化写完后先跑一组冒烟测试(单 prompt 单轮,打印优势向量)——优势全零或全同号说明奖励或 rollout 有 bug;合成 GRPO 的价值在于能单变量隔离「奖励质量」这一个因素,真实训练做不到。
结论:[Re] 全部假说复现通过——奖励-真值相关、训练增益排序、Predefined 崩溃、小判官红利、RLVR⊂RaR 全部兑现;两轮冻结(轮 2 为行为等价清理),附带发现一条(大判官的分解信息损失)如实登记。
十一、方法论提炼与迁移
模式一:判据即奖励(Criteria-as-Reward)
- 操作定义:把「什么是好输出」的人工判据写成可机器核验的自包含条目(每条:要求+核查说明+权重),奖励 = 加权通过率——评估判据直接复用为训练信号,一次编写、评测与训练双用。
- 成功判据:奖励与真值质量的相关 > 整体印象式打分(首例:explicit ρ 0.442 > likert 0.417);训练后的策略在独立口径上也有增益(首例:HealthBench 训练、GPQA 选择题 +7%——排除「只会讨好 rubric」的假增益)。
- 首例与数字:RaR(2507.17746v2):HealthBench 相对 Direct-Likert 最高 +31%;合成+参考 rubric(35.9%)≈人工(34.8%)。本站复现 [Re] 5/5。
- 迁移去向:①代码评审标准→自动化评审 bot 的训练信号(团队的 review checklist 直接变 reward);②教学质量评估——把「好课」的判据变成教师培训的评分项;③合同审查——法务判据清单训练审查模型。
- 失效边界:rubric 覆盖错位时奖励与真值脱钩(Predefined 崩溃:√ρ 上限);判据质量依赖参考答案等专家代理(无接地的合成 rubric 掉 4pp);判据被「针对性优化」后失效(Goodhart——判官博弈在 RL 下比评测下更尖锐)。
- 方法卡:
notes/method_criteria_as_reward.md(L1) - 层级:L1 领域具体(RL 训练/奖励设计)。底层原理:奖励设计=目标工程(RLVR 家族共享)——本篇把这条家族原理显式化为「判据工程」。
模式二:特例收编形式化(Special-Case Subsumption)
- 操作定义:新方法与旧方法的关系不用「对比实验」而用「形式化包含」表达——证明旧方法是新方法在参数退化下的特例(首例:Remark 1,k=1、w=1 时 rubric 奖励退化为 RLVR),一次性继承旧方法的全部调参经验与理论结论。
- 成功判据:特例关系可数值验证(本站复现 P4:k=1 时两奖励序列 500/500 相等);旧方法的已知结论在新框架内有对应解读(RLVR 的「验证器可靠性」问题 = rubric 的「判据质量」问题)。
- 迁移去向:①框架迁移文章——「我们的 X 是 Y 在 Z 参数下的特例」比「我们的 X 比 Y 好」更稳;②工具链设计——新工具支持旧工具的全部退化配置(向后兼容即特例收编);③教学——先教特例再教一般化,学生的旧知识成为新知识的脚手架。
- 失效边界:包含关系成立但「新方法在旧域上不劣」仍需实验(本篇 GPQA +7% 就是这个补测);形式化包含不等于实践等价(超参敏感性不同);为收编而强行一般化会把框架做臃肿。
- 方法卡:
notes/method_special_case_subsumption.md(L1) - 层级:L1 领域具体(学术写作/框架设计)。
模式三:参考答案代理(Reference-Answer Grounding)
- 操作定义:需要专家判断但专家贵的场合,用「现成的专家产出物」(参考答案/金标样本/历史判例)作为专家判断的代理喂给合成器——专家信号从「过程参与」转移为「产物复用」。
- (与单源派生一致性(MyPCBench 卡)同谱系:参考答案是那个单源。另与 Demystify 源质量放大律对读:代理质量决定下游质量。)
- 方法卡:并入 method_single_source_derived_consistency.md 使用记录,不另立。
- 层级:L1 领域具体(标注工程/数据合成)。
十三、没搞懂的地方(未攻克登记)
- rubric 投毒的传播系数:毒判据被 GRPO 优化的速度与残留度——判分器线威胁模型的训练侧版本,无任何实验。补齐时机:合成实验(毒判据占比梯度×策略输出偏斜度),可在开源数据集上自做。
- 隐式聚合为何胜显式:手调权重(1.0/0.7/0.3/0.9)的次优性是权重错还是范式错?论文归因「hand-tuned」但无权重消融(换一组权重的对照)。补齐时机:权重网格扫描(开源数据集可复算)。
- 参考答案的来源敏感性:参考答案由强模型写 vs 人类专家写的 rubric 质量差多少?Table 1 未区分参考答案来源。补齐时机:分层消融(开源数据集可复算)。
- 无类别标签 38.8% > 全量 37.2% 的机制:是类别标签的权重数值错,还是标签本身的粒度问题?论文归因「pitfall 难合成」但 No-Pitfall 只持平。补齐时机:逐判据的贡献分析。
- ICLR 2026 录用状态:Odysseys 转引、搜索未确认、abs 页无标注。补齐时机:会议官网或 OpenReview 亲核。
十四、可信度
- A 级(论文原文转录,逐节核对):§2 全部形式化(式 1/式 2/Remark 1,p.3)、§3 四 desiderata 与生成(p.3–4)、§4 实验设置与变体(p.4–5)、§5 主结果与 Fig 2/3(p.6–7)、§6 三本消融账 Table 1/2/3(p.7–8)、§7 相关工作(p.8–9)、Limitations(p.10)、脚注 3(Pitfall 正形式)。
- B 级(论文自报实验,无法独立验证):全部训练读数(8×H100 真实 GRPO)、HealthBench 与 GPQA 的绝对值、Fig 3 的判官规模效应读数、rubric 质量的人工评估。
- C 级(我的推导 + 复现程序化验证):§三 三本账(方差传递/GRPO 优势/归一化)、§六 覆盖几何与噪声传递、复现 P0–P4 全过。
- D 级(我的推断,已标注):§8.1 rubric 四身份、§8.2 判官偏差写入权重的威胁推演、§6.1 判官质量下限判据、§六.3 √ρ 几何、§8.5 写作之维。
- 横向核实初核(2026-09-30):版本 v2 已核(PDF 戳亲核:v2 2025-10-03;v1→v2 diff 未核——登记);ICLR 2026 录用为 Odysseys 转引+搜索未确认(abs 页无标注——登记待查 OpenReview);机构已核(PDF p.1 Scale AI);工件两数据集存在性已核(脚注+搜索快照),未访问(登记);第三方:alphaXiv/ newsletters 命中未读(登记);统计审查:GPQA 10 runs+95%CI(好)、HealthBench 点估计、Fig 2/3 为图读(精确数值以正文与表格为准);引用 ~286(搜索快照口径)。
- 实验充分性评价:充分(消融矩阵三本账 + 泛化到可验证域的补测,控制变量意识好——判官固定 gpt-4o-mini 隔离奖励信号变量);缺 agentic 域与判官博弈分析。
- 性能支撑目标检查:goal 是「扩展 RLVR 到不可验证域」——支撑(两域 + 双口径评测 + 泛化补测);「rubric 奖励跨判官规模稳定」——支撑(Fig 3 + 附录 A.8);未过度声称(Predefined 崩溃与显式权重脆性主动报告)。