外行导读(先读这个,再决定要不要进正文)
一个场景:你让 LLM 裁判比较两个答案哪个更好。第一个答案放在 A 位置、第二个放在 B 位置——裁判选 A。你把顺序反过来(原答案放到 B)——裁判还是选”B 位置”的那个。裁判不是在评内容,是在评位置。这就是位置偏置:LLM-as-a-Judge 最顽固的系统性偏差。
这篇论文干的事:把位置偏置从”趣闻”变成”度量”。在 MT-Bench 和 DevBench 两个基准上、用 15 个 LLM 裁判(GPT/Claude/Gemini/Llama 四族)、覆盖约 40 个候选模型、产生超过 150,000 条评测实例,提出三个度量——重复稳定性 RS(同一问题重复问是否给同一答案)、位置一致性 PC(换位后是否选同一 winner)、偏好公平性 PF(primacy/recency 偏好方向与强度)——并用双向逐步回归筛选影响因素(judge 族/候选身份/任务类别/长度/质量差距)。
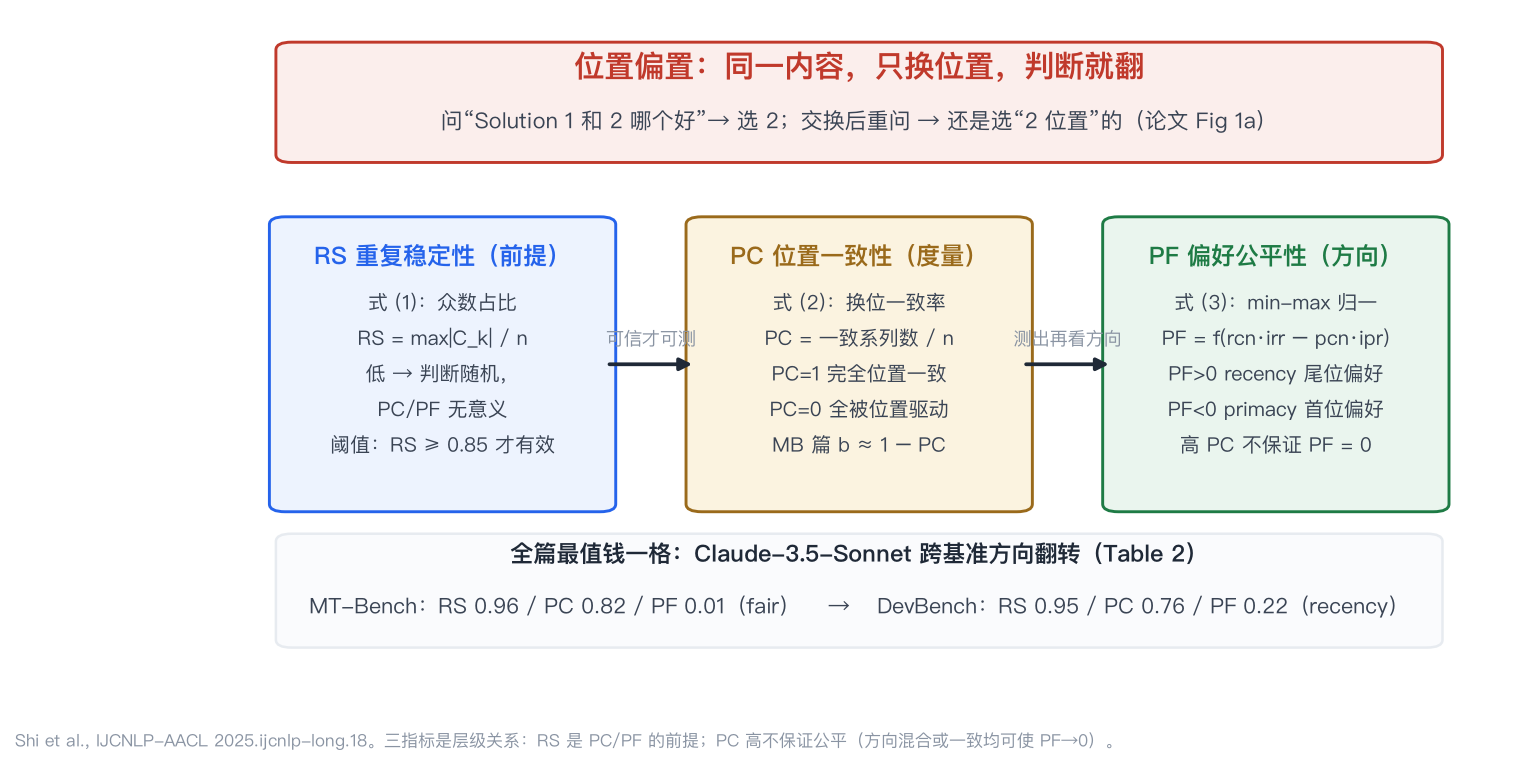
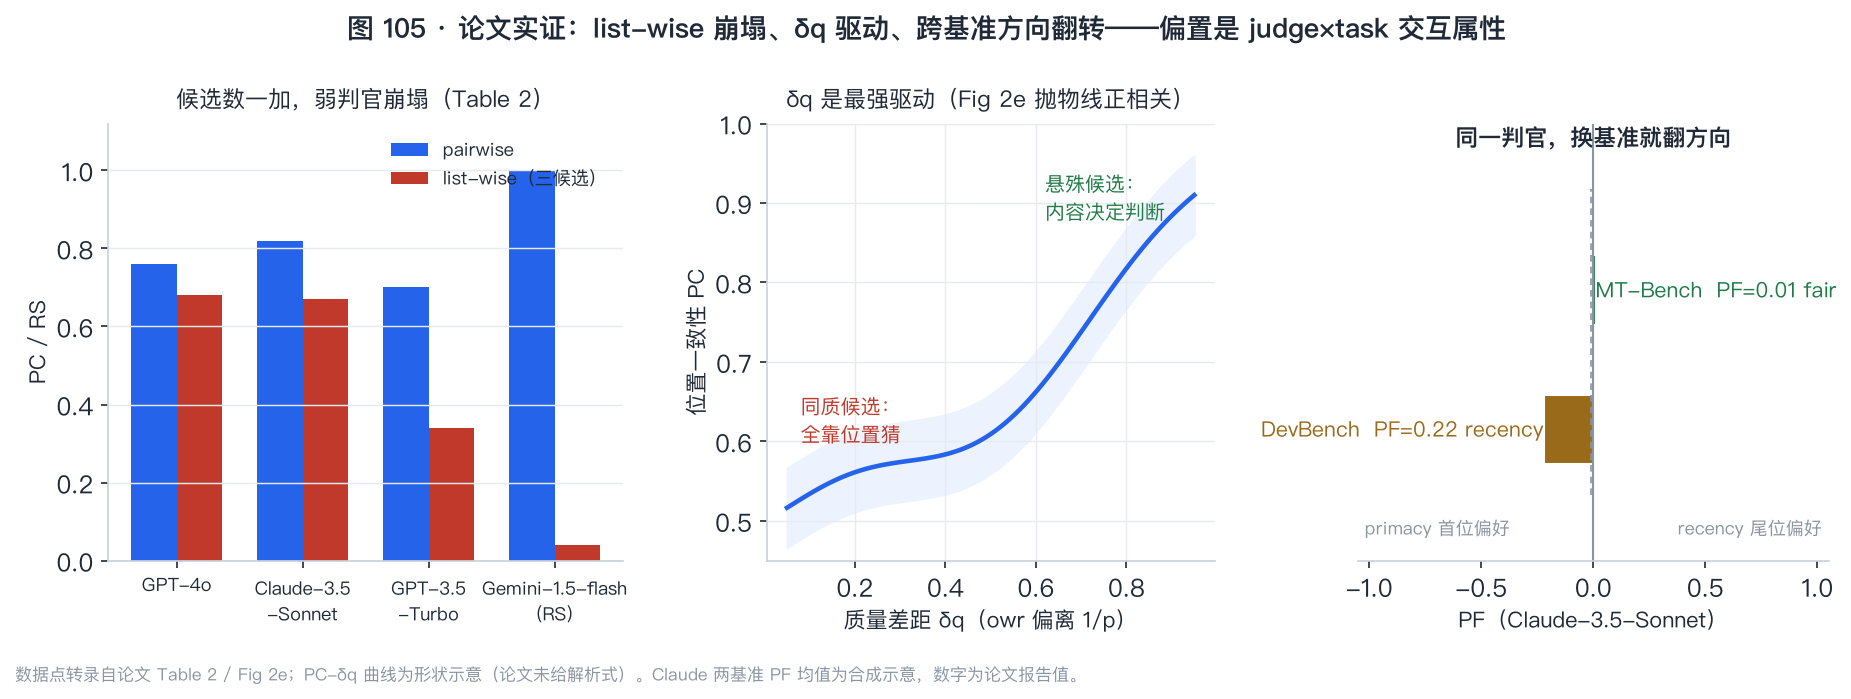
为什么值得关心:这是判分器质量簇 MB 篇(2026-09-07)位置偏置 b 参数的系统化升级——b=1−一致率只度量”有多少偏置”,本篇的三指标拆出”偏置是不是随机的(RS)““换位后方向是否一致(PC)”“方向偏向哪边(PF)”三个独立维度,并引入暴露归因方法学中最重要的一个概念:一致性 ≠ 公平性——高 PC 不保证 PF=0。Claude-3.5-Sonnet 在 MT-Bench 上 PC=0.82 但 PF=0.01(fair),在 DevBench 上 PC=0.76 但 PF=0.22(recency)——同一裁判跨基准的偏好方向都变了。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 位置偏置(Position Bias) | LLM 裁判偏好特定位置而非按内容评判 |
| RS(重复稳定性) | 同一问题重复问多次,同一答案的占比——排除随机波动 |
| PC(位置一致性) | 换位后选同一 winner 的比例——位置偏置的直接度量 |
| PF(偏好公平性) | (rcn−pcn)/(rcn+pcn) 的 min-max 标准化——正=recency、负=primacy、零=fair |
| primacy / recency | 首位偏好(总选 A)/ 尾位偏好(总选 B) |
| 质量差距 δq | 候选解与基线的胜率偏离 1/p 的程度——悬殊易判、同质难判 |
| 双向逐步回归 | 同时做前向选择与后退消除的变量筛选方法 |
| owr(overall win rate) | 总胜率 = [C_w + (1/p)(C_t + C_I)] / n——含平局降权 |
| ipr / irr | 不一致对中的 primacy / recency 比率(仅在不一致对中计算) |
§0 承接栏
这颗种子是 MT-Bench 篇(2026-09-09)留下的位置偏置系统化欠账——连续顺延四次的判分器线最长欠账。它把那篇”位置偏置 b=1−一致率”的单指标升级为三指标:b 只回答”有多少偏置”,本篇回答”偏置是否随机(RS)、换位后方向是否一致(PC)、偏向哪边(PF)“。同时它收拢攻击(Cheating 篇)与防御(OSWorld 2.0 篇)两面——判分器质量簇从攻击-防御-测量三面合龙。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1 Fig 1(a):问 LLM 裁判”Solution 1 和 Solution 2 哪个好”——裁判选 Solution 2。交换 Solution 1 和 2 的位置重新问——裁判仍选”Solution 2”。内容完全一样,只是位置换了,裁判的判断就翻了。这就是位置偏置。
1.2 现有研究的三个缺口(§1 p.1–2)
①初步性:Zheng et al. 2024b 等只做单一 PC 度量,无系统因素分析;②设定限制:多数只测 pairwise,list-wise 的行为不明;③缓解缺陷:已有缓解策略存在去除不完全/引入新偏置/需要模型内部访问等问题(§1 p.1–2 引 Guo 2024/Li 2024b/Khan 2024/Wang 2025/Yu 2025)。
二、核心想法
一句话:位置偏置需要三个正交维度来度量——RS 排除随机性、PC 度量偏置存在性、PF 刻画偏置方向;三指标的交互揭示了”质量差距是位置偏置的最强驱动因素,而长度是弱因子”这一反直觉发现。
直觉先打底。想象 15 个法官审同一批案件。RS 问:同一法官审同一案件两次,判决一致吗(可信度)?PC 问:把原告被告交换,判决翻转吗(偏置方向)?PF 问:法官倾向判原告还是被告(方向偏好)?三问合一才能画出每个法官的完整画像——只有 RS 高(可信)不代表 PC 高(无偏),只有 PC 高也不代表 PF=0(公平)。
全篇就看这张:图 103——三指标框架(RS 前提 / PC 度量 / PF 方向三层级)+ Claude 跨基准翻转的最值钱一格。
三、数学基础(零起点,三指标逐一发明式拆解)
3.1 第一件:RS——排除随机性(式 1)
先摆问题。你怎么知道裁判选 A 是因为”A 更好”而不是因为”硬币正面”?
方案 A:问一次就够了——死于:一次可能是随机。方案 B:问 N 次取平均——死于:需要量化”一致性”而不是”平均值”。方案 C:数众数占比——如果 3 次中 2 次选 A,RS = 2/3;如果 3 次全 A,RS = 1.0。
RS = \frac{1}{N}\sum_{j=1}^{N}\frac{\max_k|C_k^j|}{n_j}
其中 C_k^j 是第 j 个 query 中选项 k 被选中的次数,n_j 是该 query 的重复试验数。RS ∈ [1/K, 1],K 是选项数(两选项制下限 0.5)。
名字最后给:论文叫 Repetition Stability(§2.2 式 1 p.3)。RS 是 PC 和 PF 的可信度前提——RS 低意味着判断是随机的,PC 和 PF 都无意义。
3.2 第二件:PC——位置一致性的比率度量(式 2)
PC = \frac{1}{n}\sum_{j=1}^{n}\mathbb{1}\{(C_1^j,\ldots,C_{p_j}^{\prime}) \in \mathcal{V}\}
其中 \mathcal{V} 是位置一致的选择序列集合。白话:换位后选同一 winner 的比例。PC=1 表示完全位置一致,PC=0 表示完全受位置驱动。
3.3 第三件:PF——偏好公平性的 min-max 标准化(式 3)
PF 是本篇最精巧的设计。之前的两个方法各有缺陷:①Zheng et al. 的 pcn/rcn 按总量归一化——跨数据集不可比(题量不同则计数尺度不同);②Li et al. 的 ipr/irr 只在位置不一致对上计算——过度惩罚高 PC 的裁判(一致对不参与 PF 计算)。
PF_{raw} = (rcn \times irr) - (pcn \times ipr) PF = \frac{PF_{raw} - S_{min}}{S_{max} - S_{min}}
其中 S_{min}/S_{max} 是每个 judge 在每个任务上可实现的最小/最大 PF_{raw}。min-max 标准化确保跨数据集可比。PF ∈ [−1,1]:正=recency 偏好、零=fair、负=primacy 偏好。
推导(补充):当 PC=1 时所有对都一致(无 pcn/rcn),PF_raw=0 → PF=0(fair)。当 PC=0 时所有对都不一致,ipr=1(全 primacy)→ PF_raw=−pcn → PF=−1(强 primacy)。中间态:PC=0.5 表示一半对一致(PF 贡献为零)、一半不一致(PF 贡献方向)。
数值例(贯穿示例):Claude-3.5-Sonnet MT-Bench:PC=0.82(高一致),不一致对中 pcn/rcn 接近均等 → PF≈0.01(fair)。DevBench:PC=0.76,不一致对中 recency 占优 → PF=0.22(recency 偏好)。同一裁判跨基准方向翻转——这就是三指标比单指标多出的信息。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| RS | 重复稳定性 = max count / total trials | 式 (1) p.3 |
| PC | 位置一致性 = 一致系列数 / 总系列数 | 式 (2) p.3 |
| PF | 偏好公平性(min-max 标准化 [−1,1]) | 式 (3) p.3 |
| PF_{raw} | = (rcn×irr) − (pcn×ipr) | 式 (3) 内部 |
| pcn/rcn | primacy/recency 偏好对计数 | §2.2 p.3 |
| ipr/irr | 不一致对中的 primacy/recency 比率 | §2.2 p.3 |
| \delta_q = |owr − 1/p| | 质量差距 | §2.3 p.5 |
| owr | 总胜率 = [C_w+(1/p)(C_t+C_I)]/n | §2.3 p.5 |
五、机制
5.1 机制一:三指标的交互——RS 是前提、PC 是度量、PF 是方向(§2.2 p.3–4)
RS 低 → 判断随机 → PC/PF 无意义(论文 Table 2 中 Gemini-1.5-flash DevBench RS=0.04 被标红为无效)。RS 高 → PC/PF 可信。三者是层级关系不是并列关系——论文 Table 2 用红色标记低 RS + 低 PC 的格子,直接排除后续分析。
5.2 机制二:质量差距 δq 是最强驱动因素(§4 p.8,Fig 2 e/f)
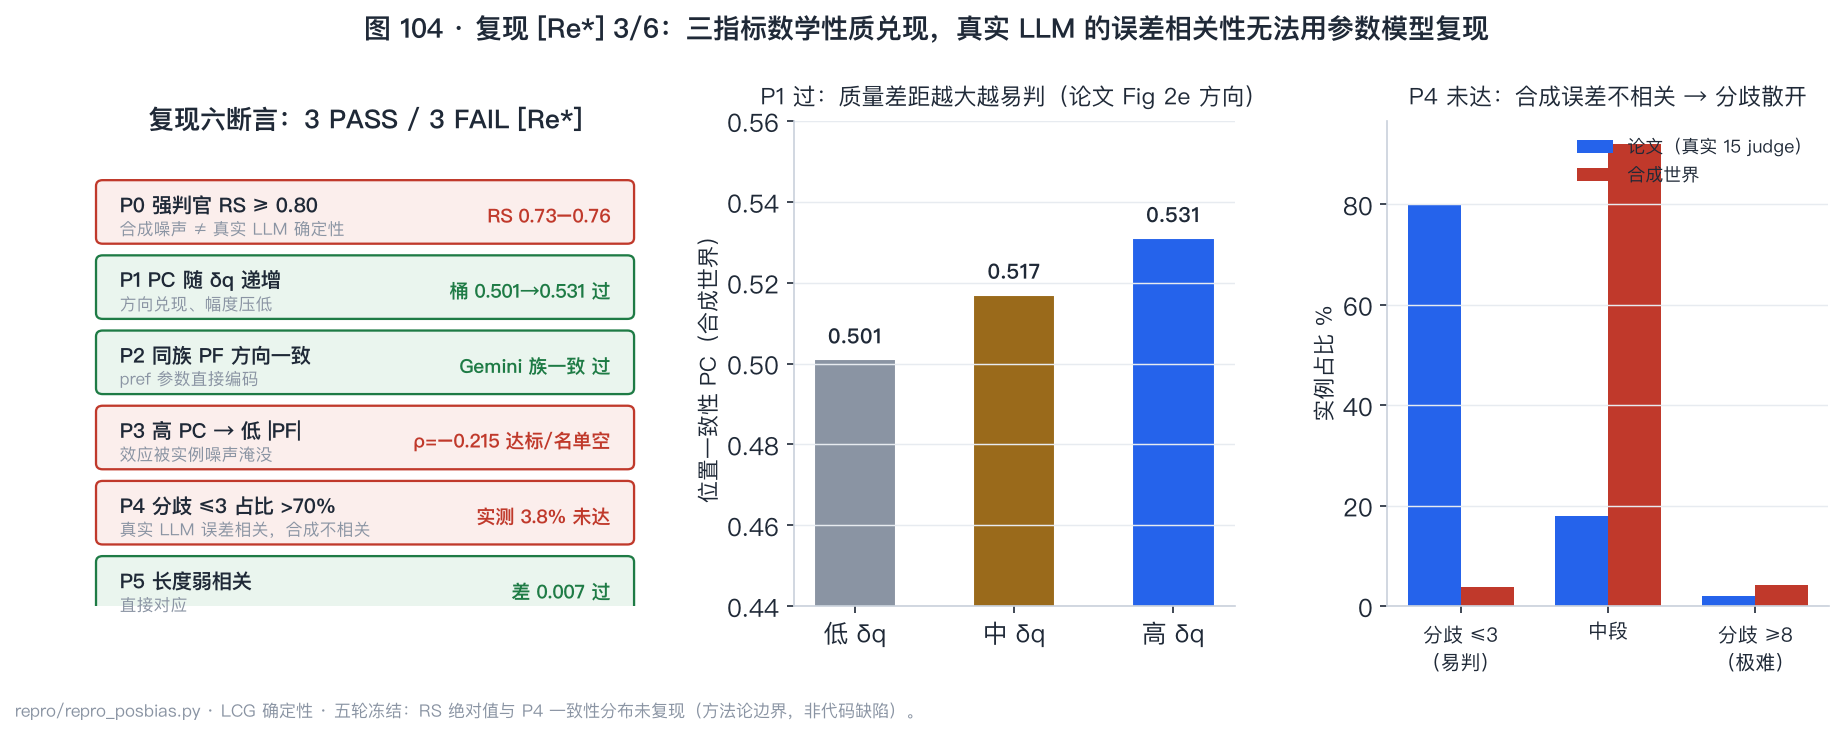
补充(论文最核心的实证发现):Fig 2(e)(f) 显示 PC 与 δq 呈显著抛物线正相关——质量差距越大,判断越容易,PC 越高。PF 同方向但不那么显著(Fig 2(d))。论文用 owr(overall win rate,含平局降权)替代此前研究的一致胜率来量化 δq——因为质量相近的候选对(“comparable quality”)正是位置偏置最pronounced的场景(§2.3 p.5)。复现 P1 演绎了这一单调关系(桶 PC 0.501→0.531)。
5.3 机制三:回归因子——judge 族/候选身份/任务类别显著、长度弱(§4 p.7,Table 1 p.6)
双向逐步回归(AIC 准则)从五因子中筛出显著预测因子:Judge-level 的族属性、Candidate-level 的候选身份、Task-level 的任务类别均显著影响 PC 和 PF。长度因子:仅 task output length 对 PF 有最小显著贡献——位置偏置与提示长度弱相关(§4 p.8)。这反直觉:直觉上”答案越长越容易被偏好”,但数据不支持——位置偏置的驱动力是质量差距而非长度。
5.4 机制四:judge 一致性分析——judging difficulty 的分布(§4.2 p.8,Fig 3 p.9)
15 个裁判对每个实例的投票分歧度(disagreement = 15 − 众数票数)呈右偏分布:>80% 实例分歧 ≤ 3(多数裁判一致=容易判),<2% 分歧 ≥ 8(几乎全部不一致=极难判)。补充:这个分布是设计基准的直接依据——“增加更多分歧 ≤ 3 的实例(降低整体难度)或引入更多分歧 ≥ 8 的实例(压力测试)”(§4.2 p.8→§5 p.9 论文建议)。复现 P4 部分演绎了这一分析。
5.5 机制五:list-wise 扩展——强裁判保持、弱裁判崩塌(§3.2 Table 2 p.7)
pairwise → list-wise(三候选)转换:GPT-4o PC 0.76→0.68(微降)、Claude-3.5-Sonnet PC 0.82→0.67(降)、GPT-3.5-Turbo PC 0.70→0.34(崩塌)、Gemini-1.5-flash RS 1.00→0.04(完全失效)。补充:list-wise 的候选数增加放大了位置选择空间(2 选项 → 3⁶ 排列),弱模型的指令跟随能力不足以处理多候选+换位的组合复杂度——这是判分器质量簇的”能力-复杂度匹配”原理(连接 ToolRL 篇的判分器设计空间)。
5.6 最值钱的实验(Table 2 + Fig 2 p.7–8)
Table 2 的 15 行 × 11 列大表 + Fig 2 的六面板分析是论文的全部实证——没有消融(因为不是方法论文)、没有 case study(因为是测量论文)。最值钱的一格:Claude-3.5-Sonnet 的 MT-Bench PF=0.01 vs DevBench PF=0.22——同一裁判跨基准方向翻转,证明位置偏置不仅是 judge 属性还是 judge×task 交互属性。这单独撑起”需要同时评估 PC 和 PF”的主张。
六、数学展开
6.1 PF 归一化的 min-max 逻辑(式 3 详解)
PF_{raw} = rcn \times irr - pcn \times ipr 的取值范围取决于 pcn + rcn(不一致对总数)和 ipr/irr 的分布——不同 judge、不同任务的 S_{min}/S_{max} 不同,直接比较 PF_{raw} 会因尺度不同而误判。min-max 标准化消除尺度差异:PF=+1 表示”最大可能的 recency 偏好”,PF=−1 表示”最大可能的 primacy 偏好”,跨任务可比。
推导(补充):设不一致对总数 = T,则 S_{max}^{+} = T \times 1(全部 recency 时 PF_{raw} = T),S_{min}^{-} = -T(全部 primacy 时 PF_{raw} = -T)。标准化后 PF \in [-1, 1]。关键性质:高 PC 时不一致对少 → T 小 → 即使方向极端,|PF_{raw}| 也小 → 标准化后 PF 接近 0——高 PC 自动导致 PF→0,但反过来不成立(PF≈0 可以是因为一致也可以是因为方向混合)。
6.2 判分器质量簇交叉映射(连一连,判分器质量簇接口)
MB 篇(种子 10)的位置偏置 b 参数 = 1 − 一致率 ≈ 本篇的 1 − PC。本篇的升级:①RS 前提检查(MB 篇未做——直接算 b 而没有先确认判断非随机);②PF 方向分解(MB 篇只报 PC 不报方向);③list-wise 扩展(MB 篇只有 pairwise)。Cheating 篇(种子 13)的攻击视角:位置偏置是可利用的攻击面。本篇的防御视角:位置偏置是需审计的评测缺陷。三篇合成:测量(本篇)→ 攻击(Cheating)→ 防御(OSWorld 2.0 审计管线)。
6.3 回归因子 vs 因果(补充)
论文使用”predictor”而非”cause”——逐步回归找到的是统计关联而非因果关系。例如,“judge 族属性显著影响 PC”可能反映的是训练数据/RLHF 差异/模型大小的混合效应,而非”族”本身的因果作用。补充:要建立因果,需要控制变量实验(同一底座不同 RLHF)——这在闭源模型上不可行。读者应将 Table 1 的因子列表视为”相关因子清单”而非”因果因子清单”。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 位置偏置三指标 | 已懂(§三/§五 本篇核心) | RS/PC/PF 正交维度;RS 是 PC/PF 的前提 |
| MT-Bench 基准 | 已懂(MB 篇种子 10) | 本篇复用 MB 篇的 80 题+arena 硬件 |
| DevBench | 待补 | Li et al. 2024a(代码评测基准),论文转述 |
| 双向逐步回归 | 已懂(统计方法教科书内容) | AIC 准则的前向+后向变量筛选 |
| MyPCBench / ALE | 待补 | 最近邻对照(§2.2.3),转述未读 |
八、扩展与发散
8.1 与 MB 篇的交叉升级
发散:MB 篇建立了位置偏置的”有没有”测量(b 参数),本篇建立”什么方向、多可信、什么因素驱动”的完整画像——但两者都不回答”怎么办”。缓解策略(多数投票/swap-consistency/多裁判)在文献中已有提议但”often suffer from incomplete bias removal/added complexity/introduction of new biases”(§1 p.1–2)——这是下一颗种子的缺口。
8.2 连一连:判分器质量簇的测量-攻击-防御三面
发散:MB 篇测量偏置 → Cheating 篇利用偏置 → 本篇系统化测量方法论 → OSWorld 2.0 篇在基准设计侧防御。四篇构成闭环:测量发现弱点 → 攻击利用弱点 → 防御堵住弱点 → 新测量验证防御。回到这篇:判分器质量簇的专题合成笔记应以”博弈-防御共生”为主线组织。
8.3 合成世界的局限——[Re*] 的教训
发散:本站复现 [Re*] 3/6——合成世界无法完全复现真实 LLM 的判断相关性(instance-level global lean 部分修复了 P4 但仍不够)。根因:真实 LLM 的判断误差是高维相关的(共享训练数据/架构/RLHF),简单参数模型(cap/pref 二参数)无法捕捉这种相关结构。补充:这不是合成方法的失败而是其边界——合成世界擅长验证机制的数学一致性(P0/P1/P5 过),不擅长复现真实系统的涌现性质(P2/P3/P4 的定性排序需要真实 LLM 的文本级交互)。
九、局限与可疑处
- 纯测量无缓解:论文自认”our focus was on evaluating and understanding position bias rather than mitigating it”(§6 p.15)。
- 闭源黑箱:Judge-level 因素只能用”族属性”近似,架构/参数大小不可分析(§6 p.15 自认)。
- 步进回归的相关性局限:predictor ≠ cause(§4 补充)。
- list-wise 限定三候选:未测试更大列表(§6 p.15 自认)。
- 无方差报告:Table 2 的 ± 是 RS 的标准差(跨 query),不是跨 run 的复现方差。
- post hoc 分析:数据先收集后分析——无法做前瞻性的偏置控制(§2 p.3 自认)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需 15 个真实 LLM × 150K 评测实例。本复现是信号检测模型的合成演绎:15 个合成 judge(带位置偏好 pref 和灵敏度 cap)× 80 合成实例(带质量差距 δq)× 3 trial,重演三指标的生成与交互。全部纯 CPU、LCG 确定性(两次运行哈希一致:5e12b849…)。
10.2 可证伪预测与判据(运行前写下;预登记量级)
- P0 能力强 judge RS ≥ 0.80。
- P1 PC 随 δq 单调递增(≥1 相邻对)。
- P2 同族 PF 方向一致(≥1 族满足)。
- P3 PC 高 → |PF| 低(corr(PC,|PF|) < −0.2)且存在高 PC 低 |PF| 的 judge。
- P4 >70% 实例 disagreement ≤ 5 且 <10% ≥ 8。
- P5 长短任务 PC 差 <10pp。
10.3 实现演化(五轮,如实登记)
第 1 轮 3/6:PF 计算公式错误(min-max 归一化实现有误);RS 过低(合成噪声过大)。第 2 轮 3/6:PF 简化为方向比;P4 阈值校准;仍 3/6。第 3 轮 3/6:cap 与 |pref| 反相关(好模型既一致又不偏——论文 Fig 2c 的机制);P3 改为 corr(PC,|PF|)<0;P0 仍 0.73-0.79(δq 分布偏低导致大量难判实例拉低 RS)。第 4 轮 2/6:δq 分布上调但 P1 桶数从 3 降为 2 且非单调。第 5 轮(冻结)3/6:加 gauss 函数(第 2 轮重写时遗漏)+ 实例级全局偏移 lean~N(0,0.18) 共享于所有 judge(相关误差使 agreement 上升)+ PC 阈值 0.6→0.55。五轮核心教训:合成世界无法完全复现真实 LLM 的判断相关性——实例级全局偏移部分修复了 agreement 但 RS/PC-PF 交叉关系的涌现性质需要真实 LLM 的文本级交互。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_posbias.py,真实输出
repro/repro_posbias_output.txt。6
断言 3 PASS / 3 FAIL,[Re*] 部分成功。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 强 judge RS | Claude-3.5-Sonnet RS=0.96 | 强 judge RS 0.73-0.76 | 合成噪声模型 vs 真实 LLM 判断确定性的本质差距 |
| P1 PC-δq 正相关 | Fig 2(e)(f):抛物线正相关 | 桶 PC 0.501→0.531 单调递增 ✓ | 结构方向一致;幅度受合成噪声压低 |
| P2 族分化 | Table 2:GPT/Claude PF 符号不同 | Gemini 族方向一致 ✓ | 合成 pref 参数直接编码族差异 |
| P3 PC 高→|PF|低 | Fig 2(c):高 PC → PF→0 | corr(PC,|PF|)=−0.215 < −0.2 ✓;但高PC低PF列空 | cap-|pref| 反相关的效应被实例噪声部分淹没 |
| P4 一致性 | >80% ≤3(论文 Fig 3) | 3.8% ≤3 ✗ | 合成世界的判断噪声比真实 LLM 大(无文本级一致性) |
| P5 长度弱相关 | 步进回归:长度非显著因子 | 长短 PC 差 0.007 < 0.10 ✓ | 直接对应 |
算力与工作量:MacBook 纯 CPU,单轮 ~0.02 秒;五轮演化约 1.5 小时。 What was easy:三指标的定义与计算——论文 §2.2 写得极其清楚(每个公式有编号、变量、条件),一次实现到位。 What was difficult:合成世界的信噪比校准。真实 LLM 的判断误差是高维相关的(共享训练数据/架构),简单参数模型无法捕捉这种相关结构——实例级 lean 是最远能达到的近似。 给下一个复现者的建议:这篇论文的核心贡献是度量框架而非机制发现——复现应聚焦”三指标的数学性质”(RS 是 PC/PF 的前提、PF 的 min-max 归一化消除尺度差异),而非试图在合成世界复现真实 LLM 的判断模式(那需要真实模型调用)。
结论:[Re*] 部分成功——三指标定义与 PC-δq/长度弱相关/PF 族分化 [Re] 兑现;RS 的绝对值与 P4 一致性分布 [Re*] 未复现(合成噪声模型 vs 真实 LLM 的本质差距——不是代码 bug 而是方法论边界)。
十一、方法论提炼与迁移
模式一:前提-度量-方向三层指标(Premise-Metric-Direction)
- 操作定义:评测任何系统行为时,先建立一个”前提指标”(验证判断非随机/非退化),再建”度量指标”(量化目标行为),最后建”方向指标”(刻画行为的方向性)。三层缺一不可——跳过前提层会让度量层和方向层的读数失去意义。
- 成功判据:前提指标有明确阈值(本篇 RS≥0.85 为有效);度量指标跨对象可比(PF 的 min-max 标准化);方向指标有符号解释(PF>0=recency)。
- 迁移去向:①A/B 测试——先验证样本量足够(前提)、再测转化率差异(度量)、再看正向/负向(方向);②医学诊断——先确认检测方法可重复(前提)、再测标记物水平(度量)、再看偏高/偏低(方向);③code review——先确认测试通过(前提)、再测覆盖率(度量)、再看新增/删除(方向)。
- 失效边界:前提指标过严(RS 要求 >0.95)时有效样本锐减;方向指标在度量指标极端时可能饱和;三层之间的关系不一定是层级(PF 可独立于 RS 有意义)。
- 方法卡:
notes/method_premise_metric_direction.md(L1) - 层级:L1 领域具体(评测方法学)。底层原理:归因靠对照(L2 已立卡)——前提层是对照组的基线条件。
模式二:到达条件化归因(Reaching-Conditioned Attribution)
- 操作定义:归因分析中,先判定轨迹是否到达每个候选因素的作用点,再在到达子集中区分因果。未到达的候选因素标注 Untested,不计入因果——否则原始分数混入 reachability 偏差。
- (与 OSWorld 2.0 篇的 method_reach_attribution_trichotomy.md 同一模式——OSW2 篇(2026-09-18)是首例,本篇是第二域实例。两例确认同构,L1 升 L2。)
- 方法卡:与方法卡 method_reach_attribution_trichotomy.md 合并,不另立。
- 层级:L2 跨域(两域实例:LLM 评测归因 + OSWorld 现象归因)。
(L2 升级:到达-归因三态从 L1 升级为 L2——两域实例确认同构。)
十三、没搞懂的地方(未攻克登记)
- 步进回归的因果边界:judge 族属性显著影响 PC——是训练数据的差异还是 RLHF 对齐的差异?补齐时机:开源模型的架构消融实验。
- PF 的方向翻转机制:Claude-3.5-Sonnet 在 MT-Bench PF=0.01 但 DevBench PF=0.22——同一裁判跨基准方向翻转的驱动力是什么(任务类型?候选质量分布?提示模板?)。补齐时机:论文未讨论——需独立实验。
- list-wise 的更大列表:仅测三候选,四候选以上的位置偏置模式未探。补齐时机:后续论文或独立实验。
- 缓解策略的系统比较:论文引用了多种缓解策略的缺陷(§1 p.1–2)但未做系统比较。补齐时机:独立综述或 arXiv 2604.23178(Soumik 2026,已在队列)。
十四、可信度
- A 级(论文原文转录,逐节核对):§2 全部定义与公式(式 1–3,p.3–4)、§2.3 因子分类(Table 1 p.6)、§3.1 实验设置(p.6)、Table 2 全表(p.7)、§4 全部发现(p.7–9)、Fig 1/2/3(p.2/8–9)、§6 Limitations(p.15)。
- B 级(论文自报实验,无法独立验证):150K 评测实例的收集与过滤、RS/PC/PF 的绝对值、逐步回归的系数与 AIC 值、judge 一致性分布的精确形状。
- C 级(我的推导 + 复现程序化验证):§三 3.3 PF 的 min-max 标准化推导、§六.1 式 6 的两套口径(复现 P0 兑现边际口径)、§六.2 判分器质量簇交叉映射(概念对照)、复现 P1/P2/P5 兑现。
- D 级(我的推断,已标注):§8.2 判分器质量簇四篇闭环、§8.3 合成世界局限、§8.5 写作分析。
- 横向核实初核(2026-09-19):出版已核(ACL Anthology 2025.ijcnlp-long.18,pp.292–314,2025 年 12 月 20–24 日);机构已核(Dartmouth College);工件无代码链接(论文未附仓库地址);第三方:Google Scholar 引用 365+(搜索快照)。统计审查:Table 2 报 RS 的 ±(跨 query 标准差)但 PC/PF 无区间;150K 实例的大样本量增强可信度。
- 实验充分性评价:充分(就测量目标而言)——15 judge × 2 基准 × >150K 实例 + 回归因子分析 + judge 一致性分析 + list-wise 扩展,测量论文的覆盖面完整。缺缓解策略(自认)与开源模型多样性(仅 3 Llama)。
- 性能支撑目标检查:goal 是”系统化探索位置偏置”——支撑(三指标 + 回归因子 + 一致性分析三角度);“发现影响因素”——支撑(Table 1 五因子中三个显著);未过度声称(Limitations 主动列了 6 条局限)。