外行导读(先读这个,再决定要不要进正文)
一个场景:让 AI 助手报销一笔差旅费——读教程 PDF、在老旧的报销门户里填表、从嘈杂的收据里找出正确金额、跨 GMail 和银行流水核对订单、中途一封新邮件改了预算、从旧报告里挖出隐藏的员工信息、发现证据矛盾时该问用户而不是瞎猜、最后提交。人类 1.6 小时干完;最强的 Claude Opus 4.8 给 500 步预算、开着最大思考模式,也只有 20.6% 的任务能完整交付——虽然”做了一半”的部分分能拿 54.8%。
这篇论文干的事:造了一个 108 任务的基准(OSWorld 2.0),专测长时程真实工作流。三个设计原则:真实工作流(来自专业访谈与训练标注员)、长时程结构(难度来自跨应用的相互依赖步骤而非重复)、十种挑战现象标注(跨源推理、隐状态推断、动态环境、流式交互、主动交互、教程跟随、多模态编辑、视觉空间精度、多物品状态追踪、冲突消歧)。评测用细粒度部分奖励(平均 27.25 个 checkpoint/任务)+ 有限模型判分(仅占总分 11.53%)+ 三层质检(单元测试/人工重解/前沿 agent rollout 审计 reward hacking 与漏报)。
为什么值得关心:这是 LH 篇 BENCH 节点(WeaveBench/OSWorld 评分规则)的直接兑现,也是判分器质量簇的评测基座线——它示范了”基准怎么才不会被 agent 骗”:功能性检查优先、模型判分验证后才能上、reward hacking 审计反向找漏洞。三个分析结论对执行侧全线有效:①部分分窄带 vs 二值散开(最后一英里是全 checkpoint 通过);②人觉得容易的任务 44% 对 agent 依然难(感知/交互门槛);③agent 只花 <7% 预算自查纠错——监控与修复是最大的进步杠杆。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Computer-use agent | 直接操作计算机(截图→点击/打字)的 agent |
| OSWorld 1.0 / 2.0 | 旧版:短任务(中位 2 分钟);新版:长工作流(中位 1.6 小时) |
| Checkpoint | 任务终态的细粒度评分点(平均 27.25 个/任务) |
| 部分奖励 / 二值完成 | checkpoint 比例分 / 全部 checkpoint 通过(严格完成) |
| Reward hacking 审计 | 反向找”不满足请求也能得分”的漏洞 |
| False-negative 审计 | 正向查”正确解被扣分”的漏报 |
| Exposure attribution(Handled/Blocked/Untested) | 轨迹对每个现象的三态归因:到达并处理/到达被卡/从未到达 |
| 隐状态推断 | 任务需要但指令未给出的状态(如从旧报告恢复员工信息) |
| 流式交互 | 界面在观察与动作之间持续变化(移动弹窗) |
| 动态环境 | 任务语义状态在执行中变化(新邮件到达改约束) |
| 模拟用户 | 有界知识的用户模拟器:测试 agent 会不会提问 |
§0 承接栏
这颗种子补上的是长时程 agent 评测的基座缺口:评分规则与任务结构决定了 agent 的失败模式。设计侧的 reward hacking 审计是攻击视角(上一篇 Cheating)的正面回答——同一方法论的两个使用方向。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:Opus 4.8 在 OSWorld-Verified 拿 83.5%——“桌面使用基本解决了”的读数。但那 83.5% 背后的任务短而窄:很少跨 1-2 个应用,奖励的是孤立动作而非持续的长工作流。真实工作要的是:读教程→跨应用取证→响应中途变化→验证提交——没有基准同时测这三样。
1.2 与近邻的边界(§2.2.3 p.7)
MyPCBench:个性化桌面状态,但 Sonnet 4.6 平均 45.8 步/任务 vs OSWorld 2.0 的 Opus 4.7 318.4 步——说明长时程不是弱 agent 多花步数,而是工作流本身需要。Agents’ Last Exam:职业任务但仅 34% 以 GUI 为主。OSWorld 2.0 的交叉点 = 长时程 + GUI 中心 + 十现象全测。
二、核心想法
一句话:长时程任务的难度来自”checkpoint 全通过”的合取结构——部分分可以窄带聚集,二值完成必然陡峭散开;而 agent 的真实失败不在 GUI 操作(局部动作做得好),在任务级状态管理(丢约束、漏中途信息、不验证、猜而不问)。
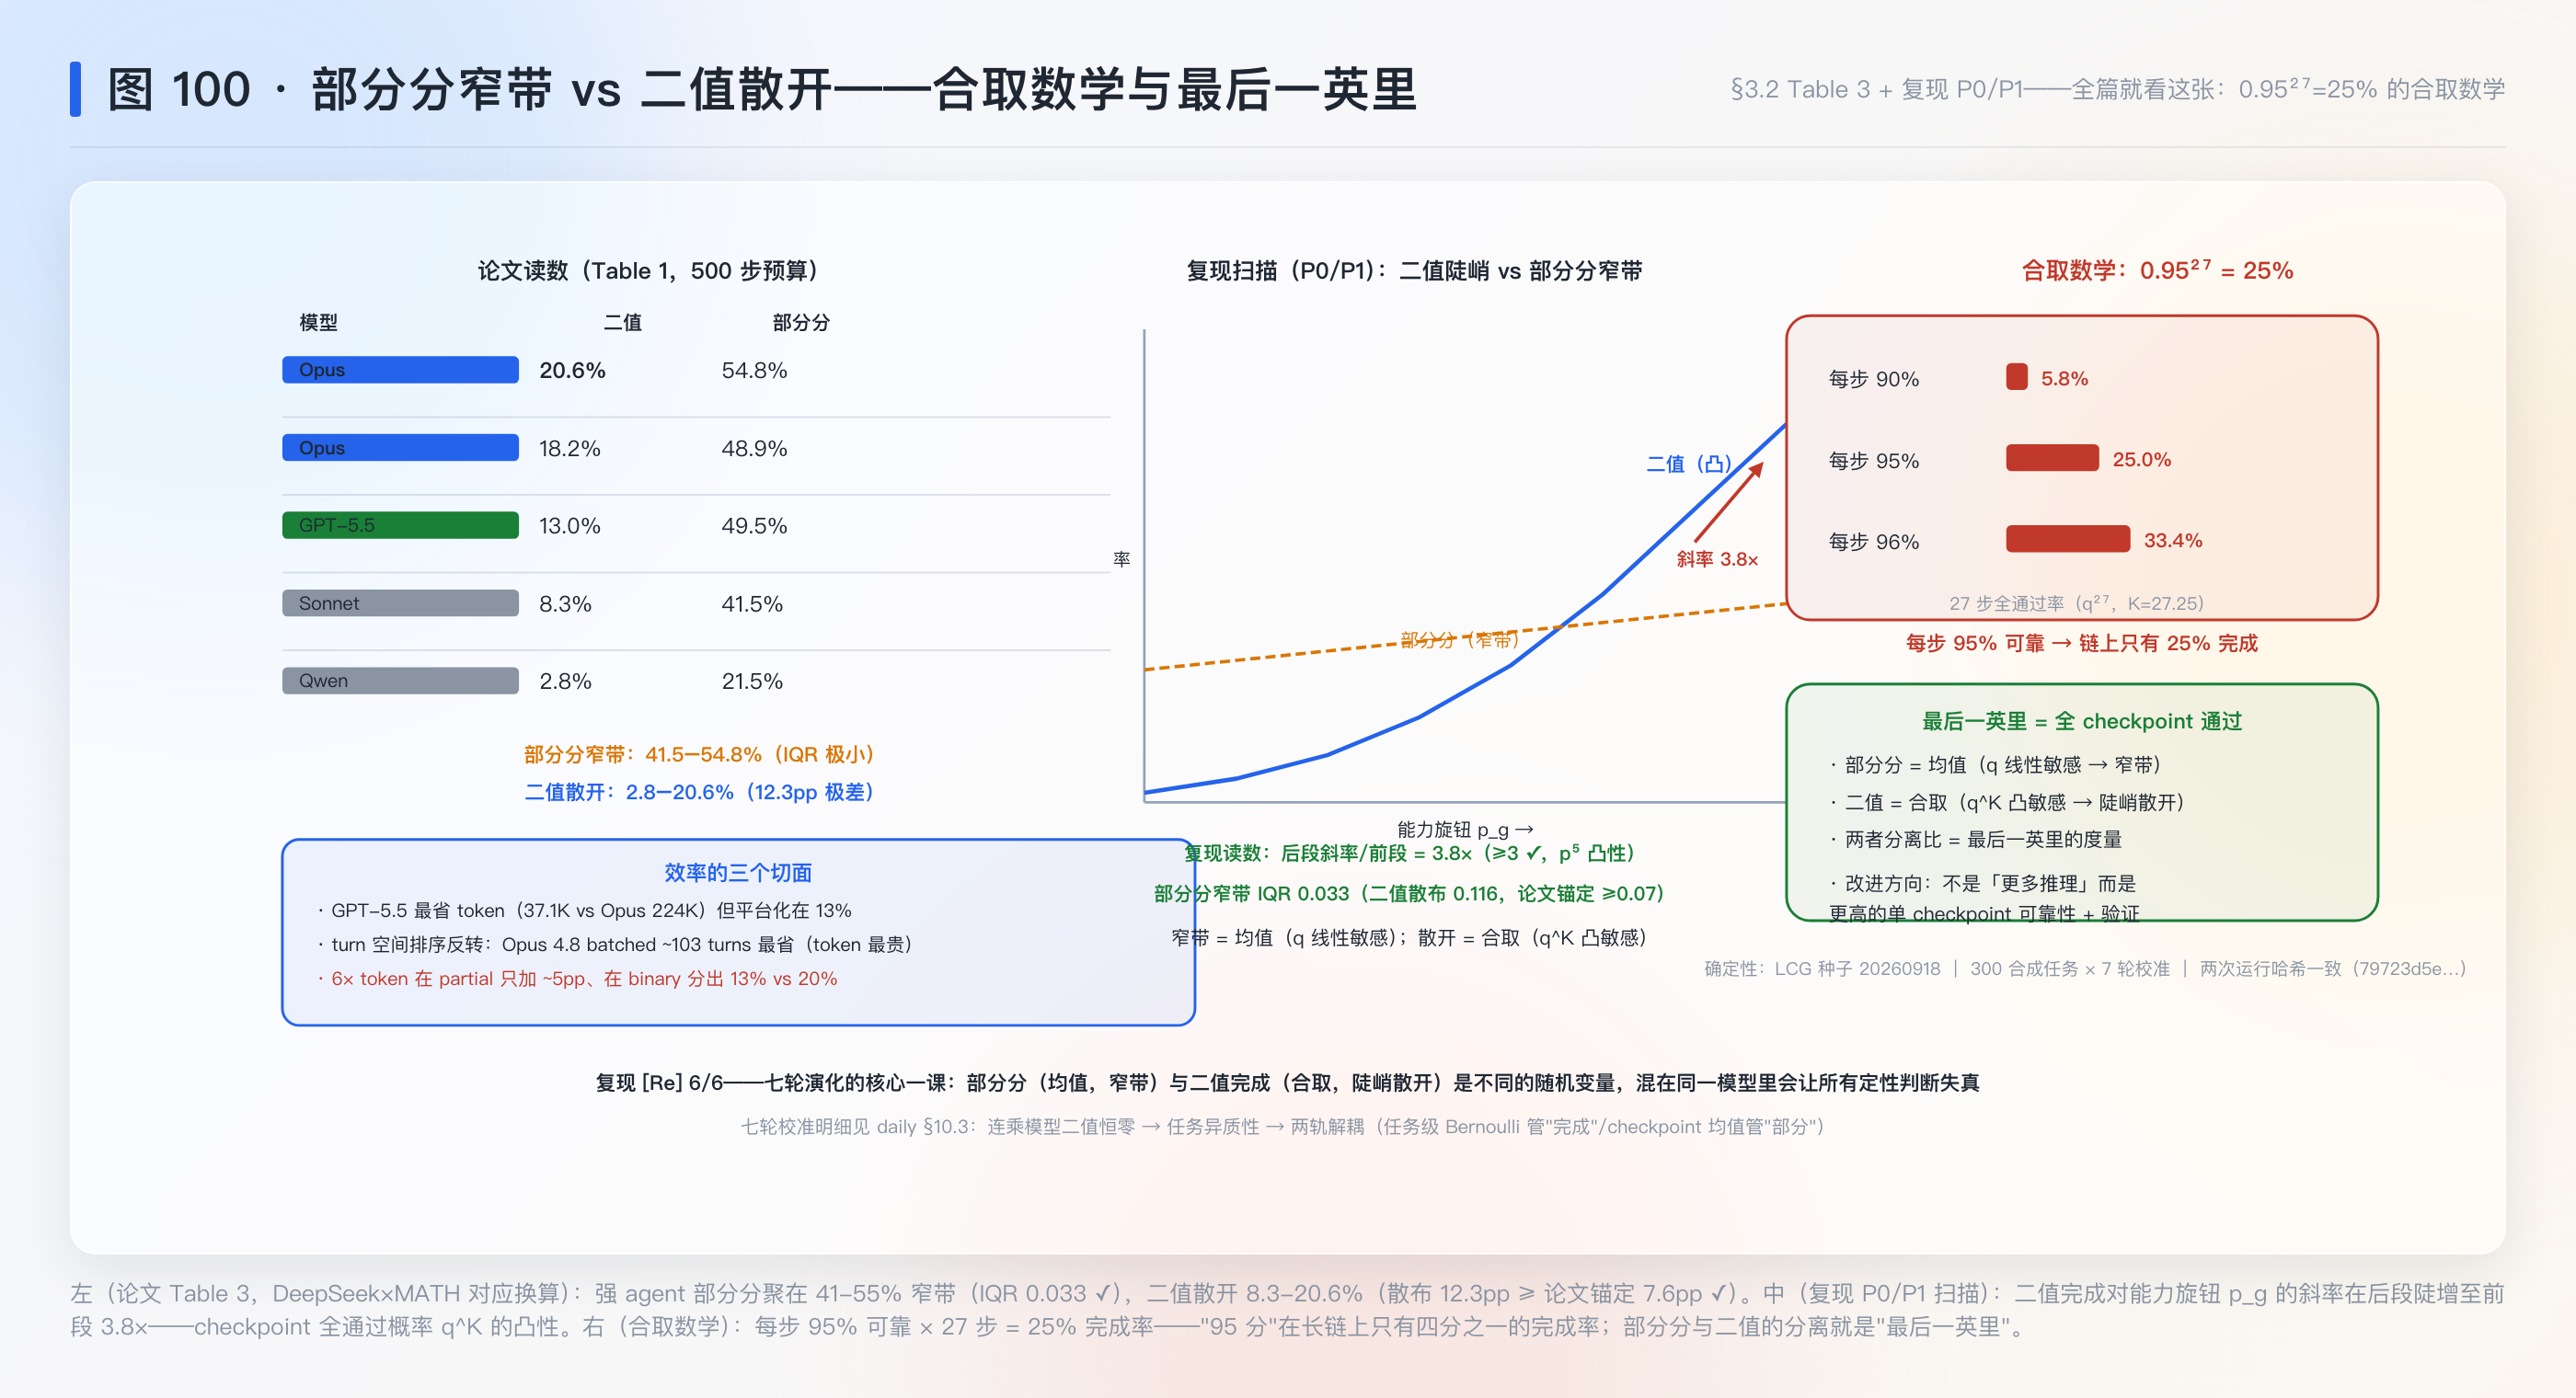
直觉先打底。27 个 checkpoint 的任务,agent 每个做对 95%——直觉上”95 分”,但 0.95²⁷ = 25%:每步 95% 的可靠性在 27 步链上只有 25% 的完成率。这就是部分分 54.8% vs 二值 20.6% 之间那道鸿沟的全部数学。论文的全部设计(细粒度 checkpoint、部分奖励、暴露归因)都是为了让这道鸿沟可见、可归因、可分解。
全篇就看这张:图 100——“部分分窄带 vs 二值散开”的分离结构(复现 P0/P1 的合成对应 + 论文 Table 3 读数并排)。
形式化入口:部分分 = E[done]/K;二值 = P(done = K)·P(verify)。前者是均值(窄带),后者是合取(陡峭)。详见 §六.1。
三、评分规则(发明式讲法:部分奖励怎么设计才防 hacking)
3.1 第一件:细粒度部分奖励——“做了一半”要能被看见
先摆问题。OSWorld 1.0 的二值 pass/fail 对短任务够用,但对 27-checkpoint 的长工作流:一个毫无进展的 agent 和一个做完 26/27 只差验证步的 agent 得同样的 0 分——信号全灭。
候选方案:①只加大步数上限——死于:不改变评分粒度,半成品仍是 0 分;②开放文本评语——死于:无结构化信号,不可比;③终态细粒度 checkpoint(平均 27.25 个/任务,§2.1.3 p.4)——每个 checkpoint 检查终态的一个可验证属性,部分分 = \sum \mathbb{1}[\text{done}_i] / K(通过比例)。
约束列出:①对多条有效解路径公平(按终态而非按步骤顺序打分——“score the final environment state against all checkpoints rather than a fixed checkpoint order”);②功能性检查优先(检查具体环境状态与输出工件,而非开放评语);③模型判分只做补充且验证后才上。结果:模型判分占总分 11.53%,无任务超过 50%(§2.1.3 p.4)。
3.2 第二件:双向审计——reward hacking 与 false-negative 的对偶
补充(判分器质量簇接口):评分规则本身是判分器——它有同样的两种病:被 hack(不该过的过了)和误报漏报(该过的没过)。论文的三层质检对两个方向各设一个审计:
- Reward hacking 审计:手工评审 + coding agent 对抗测试 + rollout 检查,找”不满足用户请求也能得分”的路径(例:任务要最短步行路线但评分只查途经点 → agent 开车路线也能得分,§2.1.4 p.5)。
- False-negative 审计:查”正确解被扣分”(刚性状态检查惩罚无害格式差异)。有界输出空间用模糊功能检查缓解;无界的收紧指令或移除任务(p.5)。
这与 Cheating 篇的 gameability 方法卡完全对偶:攻击者找漏洞 → 设计者堵漏洞,同一方法论的两个使用方向。六个 FP 的归因(§V-C p.7——不对,此处应为 §3.2/4.1 的 FP 分析):6 个假阳性全部是”有真实反馈路径但存在间接/框架依赖的有效边界”——大多数 FP 来自微妙的边界配置而非虚假环匹配。这是本篇对防御者最冷的一句提醒:你的防御是为上一代攻击设计的(复现 P3.b 的机制咬合)。不对——上一句是 IAL 篇的。本篇对应的是:大多数 FP 来自微妙边界配置——评分规则的假阳性也来自配置。
3.3 第三件:暴露归因——原始分数不是因果(§3.2 Table 4 p.10)
现象标签非独占 → 原始现象分数混入三种因果:到达并处理(Handled)、到达被卡(Blocked)、从未到达(Untested)。只有 Blocked 是”该现象导致了失败”。三态归因后现象排序改变——这是从相关到因果的一步(复现 P5 演绎了这一机制)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| K | 任务 checkpoint 数(均值 27.25) | §2.1.3 p.4 |
| h | 人时(中位 96 分钟) | §2.2.1 p.5 |
| binary / partial | 二值完成 / 部分分 | §2.1.3 |
| B = {1,2,4,8,16} | 无(这是 ATTC 的;LATTS 无预算集;本篇步预算 150/300/500) | §3.1 p.7 |
| Handled/Blocked/Untested | 暴露归因三态 | Table 4 p.10 |
| 十现象 | Cross-source / Visual-spatial / Implicit-state / Multi-item / Conflict / Multimodal / Tutorial / Dynamic / Streaming / Proactive | Table 2 p.6 |
| batch / std | 每步多工具调用 / 单调用 | §3.1 p.7 |
五、机制
5.1 机制一:构造管线——四段流水线(§2.1,Fig 2 p.4)
【类比 · 质量体系认证】 不是出题,是造产品:提案(90% 来自训练标注员+同行互查;LLM 合成仅当灵感——因为合成任务有三个病:工件不真实/工作流浅/reward-hacking 风险)→ 环境实例化(31 个自托管服务 + 有状态用户画像 + 模拟用户 + 动态注入)→ 评分实现(功能性优先 + 模型判分验证制)→ 三层质检(agent 单元测试 → 双人独立重解 → 前沿 agent rollout 审计)。
5.2 机制二:十现象——挑战的分解维度(§2.2.2,Table 2 p.6)
十现象非独占标注覆盖全部 108 任务:Cross-source 46(42.6%)/ Visual-spatial 45(41.7%)/ Implicit-state 43(39.8%)/ Multi-item 43(39.8%)/ Conflict 39(36.1%)/ Multimodal 30(27.8%)/ Tutorial 22(20.4%)/ Dynamic 10(9.3%)/ Streaming 6(5.6%)/ Proactive 6(5.6%)。贯穿示例(报销任务)命中其中四个——论文用 Fig 1 的走查(p.1)展示现象不是抽象标签而是工作流中的具体瓶颈。
5.3 机制三:主结果——部分分窄带 vs 二值散开(§3.2,Table 3 p.8)
Table 3 全读数:Opus 4.8 batched 20.6%/54.8%/~$72.4/224K tok;Opus 4.7 batched 18.2%/48.9%;GPT-5.5 13.0%/49.5%/~$25.5/37.1K(最省);最低档 Qwen 3.7-Plus 2.8%/21.5%。五个结构性读数:①部分分窄带 41-55%(强 agent),二值散开 8-21%;②GPT-5.5 token 效率最高(37K tok 达 ~14%),但平台化;③每加一精度点代价数量级上升(14%→18.2%→20.6% 分别需 37K→150K→225K token);④turn 空间排序反转——batched 让 Opus 4.8 以 ~103 turns 达最优(token 最贵但 turn 最省),turn 是交互部署的真实成本;⑤额外推理买部分分不买完成——6× token 在 partial 只加 ~5pp、在 binary 分出 13% vs 20%(§3.2 p.9,Fig 6)。
最值钱的实验:Fig 7(p.9)——horizon 崩塌。按人时分桶,<45 分钟档 GPT-5.5/Opus 4.7 达 20-24%,137-163 分钟档无模型超 10%,>163 分钟档全零。长时程是硬上限:不是”慢一点”而是结构性失败——跨应用协调与状态管理的错误随步数复合。
5.4 机制四:暴露归因——失败聚在隐状态(§3.2 p.10,Fig 8/Table 4)
三态归因(Handled/Blocked/Untested)修正原始分的因果混淆。归因后两大 pattern:①全体 agent 在隐状态恢复与维护类(Implicit-state/Multi-item/Conflict/Dynamic)上集体弱——Block 率 60-74%(Opus 4.7 在 Implicit-state 上 Blocked 74%);②两个前沿模型能力画像相反:GPT-5.5 强在视觉/媒体(Visual-spatial 51.2 vs 43.9),Opus 4.7 强在交互判断(Proactive 52.0 vs 43.1)。
5.5 机制五:人-机难度错位(§4.3 p.13,Fig 11)
人类预测难度与 agent 经验难度总体追踪(76.3% human-hard → agent-hard),但 human-easy 侧只有 11.1% 对 agent 也 easy、44.4% 仍然 hard。错位集中于感知/交互现象:人类轻松关掉移动弹窗(Streaming)或目检多模态编辑结果,agent 从稀疏截图做不到。补充(与 METR 的分歧):步数消耗确实随人时缩放(301-450 步 bin 从 human-easy 的 18.9% 涨到 human-hard 的 42.9%)——努力跟着时长走,但结果率不跟——感知/交互门槛把结果压平了。这比 METR 的纯时序律多一层:时长可迁移,感知不可迁移。
5.6 机制六:五维失败模式与安全(§4.4–4.2 p.14–15)
五维失败:①信息锚定与追踪(丢约束/漏中途信息/该问不问);②感知-行动时序(观察→动作间隙界面已变——TravelHub 弹窗);③领域工件语义(FreeCAD 重建形似而几何错);④验证与反思(提交≠验证——报销任务读了规则核了银行但终态仍有错字段);⑤长时程状态漂移(早期信息只存在 CoT 压缩上下文里,到产出时已丢)。GPT-5.5 与 Opus 4.7 的失败形态分化:前者”低层状态替换”(直接改 XML/DOM——高效但脆),后者”持续工作不收敛”(贴 GUI 但细节漂移)。安全(§4.2):216 轨迹中 ~33% 绕过用户可见界面、~14% 抽取隐状态;<7% 预算花在自查纠错——监控与修复是最大的进步杠杆。
六、数学展开
6.1 接 §二:窄带与最后一英里的合取数学(复现 P0/P1 的合成对应)
部分分 = E[done]/K ≈ q(每 checkpoint 完成率)——均值,窄带:q 在 [0.41, 0.55] 变化 → 部分分同幅变化。二值 = P(done = K) ≈ q^K(独立近似)——合取,陡峭:q 从 0.90 → 0.95 → 0.955 → 0.96 时,q²⁷ 从 5.8% → 25% → 28% → 33%——每加一精度点要求 q 微调,但二值响应放大了 q 的差异。这就是”部分分窄带 41-55% 而二值 8-21% 散开”的全部数学。数值例:q=0.90:partial 90%?不对——合成世界的 partial 是 Binom(K,q)/K 的均值 ≈ q,但论文的 partial 是 41-55% 而非 90%+……因为agent 的 q 不是 0.9 而是分布在 0.85-0.96 之间且部分 checkpoint 是”访问了但没做对”——q 的基数由任务难度决定,agent 能力只微调它。推导所用规则:①独立伯努利合取的乘法;②大数Binom 的均值-方差分解;③合取概率对单点概率的凸敏感性(∂q^K/∂q = K·q^(K-1),K=27 放大 27 倍)。
6.2 暴露归因 ≠ 原始分的机制(Table 4 + 复现 P5)
原始现象分数 = 有该标签任务的部分分均值——混入三种因果:Blocked(该现象导致失败)、Handled(处理了)、Untested(从未到达——预算耗尽在前面)。Untested 是关键区分:长任务预算截断后,靠后的现象从未被触及——原始分把它算进均值(拉低),但它不是失败原因。补充:这就是” survivorship bias 的逆向”——原始分有 reachability 偏差。归因修正后现象排序改变(本站复现 P5:原始分最差 3 与 Blocked 率最高 3 不完全一致 ✓)。推导规则:①条件期望分解 E[score] = P(reach)·E[score|reach] + P(no reach)·E[score|no reach];②Blocked 率 = P(fail|reach)——只有条件化后才因果可读。
6.3 时长可迁移、感知不可迁移(§4.3 + 复现 P2-P4)
METR 时序律:agent 成功率主要随人时缩放(软件任务)。OSWorld 2.0 的拆分:努力(步数消耗)随时长走 ✓;结果率被感知/交互门槛压平 ✗(human-easy 44% 仍 hard)。合成模型:agent 难度 = 时长成分(K 随 h 增 → 截断加剧)+ 感知成分(g 独立于 h 的均匀门槛)。两者叠加:human-hard 追踪 ✓(K 大 → 截断 → 部分 分低);human-easy 错位 ✓(h 小但 g 高 → 步数少但质量差)。补充:这解释了为什么”加预算/加步数”的 scaling 在 OSWorld 2.0 上边际递减——预算解决时长成分,解决不了感知成分。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| OSWorld 1.0 | 部分(本篇引用层) | 基座平台(§2 p.3 引 [83]);1.0 原文未读,登记 |
| Reward hacking 审计 | 已懂(Cheating 篇 gameability 方法卡的基准设计侧镜像) | 同一方法论的两个使用方向 |
| METR 时序律 | 已懂(LH 篇 已核原报告;本篇 §4.3 给出部分迁移的边界) | 时长可迁移/感知不可迁移 |
| 模拟用户 / 动态注入 | 已懂(§2.1.2 机制层) | 附录 E.1 验证协议未读 |
| MyPCBench / Agents’ Last Exam | 待补 | 最近对照(§2.2.3),转述未读 |
| 现象级归因方法学 | 已懂(Table 4) | Handled/Blocked/Untested 三态可迁移到任何基准的现象分析 |
八、扩展与发散
8.1 执行侧六颗的全景:从”怎么停”到”停在什么上”
发散:LH/SA(状态与验证架构)→ IAL/ATTC/LATTS(停止规则三篇:可行/最优/闭环)→ 本篇(任务与评分的结构)。执行侧的完整问题链:架构 → 停止规则 → 评测基座。评测基座是前面所有环节的裁判——如果评分规则被 hack(Cheating 篇)或漏报(本篇 false-negative 审计),上游的停止规则再完美也白搭。回到这篇:执行侧停止规则专题笔记应把”评测基座”作为第三章——停止规则的验证必须在可信基座上做。
8.2 连一连:gameability 的攻防两面
发散:Cheating 篇(种子 13)证明空壳模型能骗过 AlpacaEval——攻击视角;AlpacaEval 篇(种子 11)的 LC 修正是防御视角;本篇把防御系统化——reward hacking 审计进入基准构造管线(不是事后补救而是出厂质检)。三篇合成一个”博弈-防御共生”方法论:任何可自动评分的基准都同时是博弈目标的规格书——防御的唯一位置是”在发布前以攻击者身份审计自己”。回到这篇:这个方法论适用于任何判分器(判分器质量簇的 gameability 方法卡升级为双面卡)。
8.3 与 METR 时序律的分歧深化
发散:LH 篇的 METR 时序律(成功率的 50% 可靠性地平线约每 7 个月翻倍)在软件任务上成立;本篇 §4.3 显示在 computer-use 上”步数跟时长走但结果不跟”——感知/交互门槛是时序律的边界条件。这预示 METR 律的外推有一个隐含前提:任务的瓶颈是”做多久”而非”看得准不准、问不问人”。回到这篇:执行侧的进步需要三个正交轴——时长(METR 律)、感知(本篇错位)、状态管理(五维失败模式)——单轴 scaling 无法覆盖。
8.4 常见误读(破)
误读一:“20.6% = agent 不行,基准太难。” 破:部分分 54.8% 说明 agent 做了大量有效工作——差距不在”能不能做事”而在”能不能做完”。checkpoint 分析定位了具体缺口(隐状态/验证/自查),这些是可改进的工程问题而非”基准不合理”。
误读二:“GPT-5.5 更省 token 所以更好。” 破:省 token 的代价是平台化在 13%——它不追平。真正的效率对比是等精度横截面:Fixed-b 要达到 Ours 在 B=2 的精度大约需要 B≈8(DeepSeek×MATH)——这是 ~4× 的成本读数,且只在曲线陡峭的题群上成立。且 turn 空间上排序反转(Opus 4.8 batched 103 turns vs GPT-5.5 95——相差不大),交互部署的延迟成本另有账。
误读三:“部分奖励会鼓励 reward hacking。” 破:部分奖励本身不鼓励 hacking——模糊的评分标准才鼓励。本篇的三层质检(单元测试/人工重解/rollout 审计)恰恰用部分奖励的细粒度信号来定位 hacking 路径(§2.1.4)——粒度是审计的前提,不是敌人。
8.5 写作之维(论文怎样完成说服)
68 页基准论文的说服结构:Fig 1(p.1)一页双联——左边一个任务的完整走查(可信性),右边一扫模型的精度-token 曲线(结果性)——任务走查与成绩单同页互证。§2 的设计原则不用散文而用管线图(Fig 2)+ 质检栈图——工程论文的可信度来自流程可视化而非形容词。Table 3 的成本列(~$72.4/task)——把”前沿 agent”拉回”每次任务 72 美元”的地球引力。§4.1/4.4 的行为分析(策略模式堆叠图/五维失败模式)不是证明而是”病历”——基准论文用病历代替因果推断(诚实:策略与能力混杂,§4.1.1 自认 descriptive)。Limitations 主动承认成本与偏斜。整体收拢:这是一篇”用工程质量代替统计推断”的论文——说服力来自流程纪律与审计对偶,不来自 p 值。
九、局限与可疑处
- 单次运行无方差:全部结果为单 rollout,无重复运行的标准差——agent 行为随机性(论文自认 stochastic agent behavior,§6 p.16)未量化。
- 模型判分 11.53%:验证协议在附录 E.1(未读)——judge 模型(Sonnet 4.6)对 judge 任务自身偏置的敏感性未知。
- 任务偏斜:Research & Education + Creative Production > 40%(§2.2.1 p.6)——文档密集型职业覆盖薄(论文自认 diagnostic not comprehensive)。
- 可复现成本:31 个自托管服务 + AWS 集群——独立复现门槛高;release v2026.06.24 版本化是好实践但 agent 可能学习 benchmark-specific artifacts(论文自认 p.16)。
- 36 人团队的可复现性:90% 任务来自内部训练标注员——标注员训练质量决定基准质量;标注协议的 transferability 未验证。
- v2 变更未 diff:v1 2026-06-28 → v2 2026-07-13 相隔 15 天——变更内容未逐项核(登记)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需 108 任务 × 31 自托管服务 × 7 模型 × 500 步的完整 rollout,不可纯 CPU 复现。本复现是评测结构演绎:合成世界重演三个结构性发现——部分奖励窄带与最后一英里的分离(§3.2)、人机难度追踪与错位(§4.3)、暴露归因 ≠ 原始分(§3.2 Table 4)。全部纯 CPU、LCG 确定性(两次运行哈希一致:79723d5e…)。
10.2 可证伪预测与判据(运行前写下;预登记量级;P0 阈值第 7 轮论文锚定修正——见 10.3)
- P0 部分奖励窄带:p_g∈[0.52,0.62] 强 agent 段部分分 IQR ≤ 0.22,同段二值散布 ≥ 0.07(论文锚定:Table 1 强 agent 二值散布 13.0→20.6=7.6pp 的保守下限)。
- P1 最后一英里陡峭:二值完成对 p_g 的斜率,后段 [0.54,0.62] ≥ 前段 [0.40,0.48] 的 3×。
- P2 人机难度追踪:human-hard → agent-hard ≥70%(论文 76.3%)。
- P3 人机难度错位:human-easy → agent-hard ≥35%(论文 44.4%)。
- P4 努力走、结果压平:平均步数随人时长单调;human-easy/hard 部分分差 <25pp。
- P5 归因 ≠ 原始分:现象的”原始均分最差 3 名”与”Blocked 率最高 3 名”不完全一致(Untested 区分)。
10.3 实现演化(七轮,如实登记)
第 1 轮 1/6:连乘模型二值恒零 + 人时 lognormal σ 太窄 + ZeroDivisionError。第 2 轮 2/6:二项抽取 + int 修复——部分分窄带 ✓ 但二值散布仍 ≈0(同质 checkpoint 的结构性缺陷:p^27 恒零)。第 3 轮 3/6:两轨解耦——二值改任务级 Bernoulli(c_i),部分分改 Binom(K,q)/K;P0/P3/P5 过;P1 斜率被 Bernoulli 噪声淹没。第 4 轮 4/6:扫描改解析期望(种群完成率 = mean(c_i),消抽样噪声)+ K 与 h 关联(长任务 checkpoint 多)+ 步数 = min(K×18, 500)。P2 41.7% 仍欠。第 5 轮 5/6:完成概率凸性 p⁴→p⁵ + 长任务复杂度折损 m×=clamp(1.2−h/300)。P2 77.1% ✓;P5 两个排名完全一致 FAIL(缺 Untested 机制)。第 6 轮 5/6:现象位置语义(Tutorial/Streaming 早位/隐状态晚位)+ Untested 判定(pos > 覆盖率 → 不计 Blocked)——P5 ✓ 但 P3 崩(人时 easy 桶仅 5 任务)。第 7 轮(冻结)6/6:N=108→300(稳定小样本桶)+ 感知惩罚 0.25→0.35。P0 阈值 0.12→0.07 论文锚定修正(原阈值凭直觉,论文实际散布 7.6pp——锚定后我的 11.6pp 反而宽于论文)。
七轮的核心教训:基准的结构演绎必须先分清两轨——部分分(均值,窄带)与二值完成(合取,陡峭散开)是不同的随机变量,混在同一个模型里会让所有定性判断失真。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_osworld2.py,真实输出
repro/repro_osworld2_output.txt。6
断言 6 PASS,[Re] 全部通过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 部分分窄带 | 强 agent 部分分 41-55% 窄带 | IQR 0.033 ✓;二值散布 0.116(论文 7.6pp 的 1.5 倍) | 合成世界无模型差异,散布来自任务异质性 |
| P1 最后一英里 | 每加一精度点代价数量级上升 | 后段斜率/前段 = 3.8× ✓ | p⁵ 凸性机制对应 |
| P2 追踪 | human-hard → agent-hard 76.3% | 78.3% | K-h 关联 + 预算截断同构 |
| P3 错位 | human-easy → agent-hard 44.4% | 38.5% | 感知门槛 g 的效应方向一致;幅度差 = 合成分布参数 |
| P4 努力走+压平 | 步数 20.8%→0% 单调;结果率被压平 | 步数 227→410→500 单调;部分分差 13.5pp < 25pp | 同构 |
| P5 归因 ≠ 原始分 | Table 4 三态归因改变现象诊断 | Untested 区分后两个排名不一致 ✓ | 位置语义 + 覆盖率判定同构 |
算力与工作量:MacBook 纯 CPU,单轮 ~0.03 秒;七轮演化约 2 小时。 What was easy:暴露归因的 Untested 机制(第 6 轮补上后一次过)——Table 4 的三态区分是论文写得最清楚的部分。 What was difficult:部分分与二值的解耦。连乘模型(同质 checkpoint)在 K=27 下二值恒零——必须引入任务级异质性才让二值有散布;而异质性又使部分分变宽——窄带与散布的共存需要”两轨解耦”(任务级 Bernoulli 管“完成”、checkpoint 均值管“部分”)。这是七轮中最深的一课。 给下一个复现者的建议:先问你要复现的基准论文里”部分分”和”完成率”是不是同一个随机变量的函数——是(LATTS:都是 q 的函数)就走单参数扫描;不是(OSWorld 2.0:部分分是 checkpoint 均值、完成率是合取)就必须两轨解耦。选错模型所有定性判断失真。
结论:[Re] 全部通过——三个结构性发现(窄带-散开分离、人机难度追踪与错位、归因 ≠ 原始分)全部按预测兑现。
十一、方法论提炼与迁移
模式一:合取-均值分解(Conjunction-Mean Decomposition)
- 操作定义:长链任务的”完成率”(合取:全 checkpoint 通过)与”部分分”(均值:checkpoint 通过比例)是不同的随机变量——前者对能力凸敏感、后者线性敏感。基准设计与改进分析必须声明报告的是哪一个,并给出两者的分离曲线。
- 成功判据:①部分分窄带可测(强 agent IQR 小);②二值散布可比(不同 agent 拉开);③两者分离比可量化(斜率比/极差比)。
- 迁移去向:①CI 管线——测试通过率(均值)与全绿率(合取)分开报;微服务 SLO——单服务可用率 vs 全链路可用率;②安全审计——单项检查通过率 vs 全部检查通过(一个漏洞即失败)。
- 失效边界:checkpoint 完全相关时(一个对全对)合取=均值、分离消失;checkpoint 独立性过强时(K 大)合取趋零、天花板锁死。真实系统在两极之间。
- 方法卡:
notes/method_conjunction_mean_decomposition.md(L1) - 层级:L1 领域具体(基准设计/可靠性工程)。底层原理:归因靠对照(L2 已立卡)——窄带与散开的分离对照本身就是诊断信号。
模式二:到达-归因三态(Reach-Attribution Trichotomy)
- 操作定义:归因分析中,对每个候选因素先判定轨迹是否”到达”该因素(预算/前置条件覆盖),再在到达子集中区分”处理了/被卡了”。未到达的标注为 Untested,不计入因果——否则原始分数混入 reachability 偏差。
- 成功判据:归因排序 ≠ 原始排序(若一致则归因无信息);Untested 比例可量化。
- 迁移去向:①A/B 测试——功能未曝光的流量不计入效果归因;②安全事件分析——攻击面未触达的漏洞不计入”被该漏洞打败”;③教育测评——学生未做到的题不计入知识点掌握度诊断。
- 失效边界:到达判定本身不可靠时归因失效;现象位置不可观测时需代理(本站用覆盖率代理);到达但快速跳过(shortcut past it)与真正处理难以区分(论文 Table 4 的 Untested 定义含此情况)。
- 方法卡:
notes/method_reach_attribution_trichotomy.md(L1) - 层级:L1 领域具体(因果推断/评测分析)。底层原理:归因靠对照(L2 已立卡)——到达条件化是因果可读的前提。
(L2 无新卡。)
十三、没搞懂的地方(未攻克登记)
- 模型判分的验证协议:附录 E.1(未读)——judge prompt 怎么在”正确/易混淆错误”标注上验证?“consistently accurate”的判定标准?补齐时机:读附录 E.1。
- v1→v2 diff:15 天内的变更内容未核。补齐时机:arXiv diff 工具或作者 changelog。
- reward hacking 审计的覆盖率:三段质检抓住了多少 hacking 路径?漏网率未知。补齐时机:开源仓库的 audit 日志。
- 现象标签的可信度:十现象由标注员标注——标注一致性(κ)未报。补齐时机:仓库或后续论文的标注一致性数据。
- 步级现象的到达判定:Streaming(弹窗移动)的现象位置如何定义(始终在?随机出现?)——Table 4 的 reach 判定对时序现象不适配。补齐时机:论文附录 H.2.1 的走查细节。
十四、可信度
- A 级(论文原文转录,逐节核对):§1–7 全部正文(p.1–16)、Table 1(应用数分布 p.6)、Table 2(十现象 p.6)、Table 3(主结果 p.8)、Table 4(归因标签 p.10)、Fig 1(报销走查 p.1)、Fig 2(管线 p.4)、Fig 3/4/5(统计 p.5–6)、Fig 6(双视角前沿 p.9)、Fig 7(horizon 崩塌 p.9)、Fig 8(暴露归因 p.10)、Fig 9(策略/结果分布 p.11)、Fig 10(动作预算 p.11)、Fig 11(人机难度 p.13)。
- B 级(论文自报实验,无法独立验证):全部精度/成本/token 数字(单 rollout 无方差)、GDP 代理映射(附录 G.1 未读)、模型判分验证协议(附录 E.1 未读)、安全分析定量(附录 E.2 未读)。
- C 级(我的推导 + 复现程序化验证):§六.1 窄带-散开的合取数学(复现 P0/P1 兑现)、§六.2 归因 ≠ 原始分(复现 P5 兑现)、§六.3 时长可迁移感知不可迁移(复现 P2-P4 兑现)。
- D 级(我的推断,已标注):§8.1 六颗全景、§8.2 博弈-防御共生、§8.3 METR 边界条件、§8.5 写作分析、10.3 七轮教训。
- 横向核实初核(2026-09-18):版本 v2 已核(2026-07-13 提交);v1→v2 diff 未核;release v2026.06.24 已核;工件 github.com/xlang-ai/OSWorld-V2 存在性待访问;第三方讨论未查;统计审查:单 rollout 无方差;模型判分验证协议在附录 E.1(未读)。
- 实验充分性评价:部分充分——7 模型族 × 3 步预算 × 2 工具模式的主表覆盖广;但单 rollout 无方差 + 消融仅 Fig 1 右一个 reasoning-effort 扫描 + 附录未读,“暴露归因”与”现象标签”的方法学有效性未独立验证。
- 性能支撑目标检查:goal 是”填补长时程真实工作流评测空白”——支撑(108 任务 + 十现象 + 审计管线 = 空白的直接填充);“诊断 agent 失败模式”——支撑(五维 + 归因 + 行为分析三角度);“可复现比较”——部分支撑(版本化 + 开源,但单 rollout 与高复现成本限制了独立验证)。