外行导读(先读这个,再决定要不要进正文)
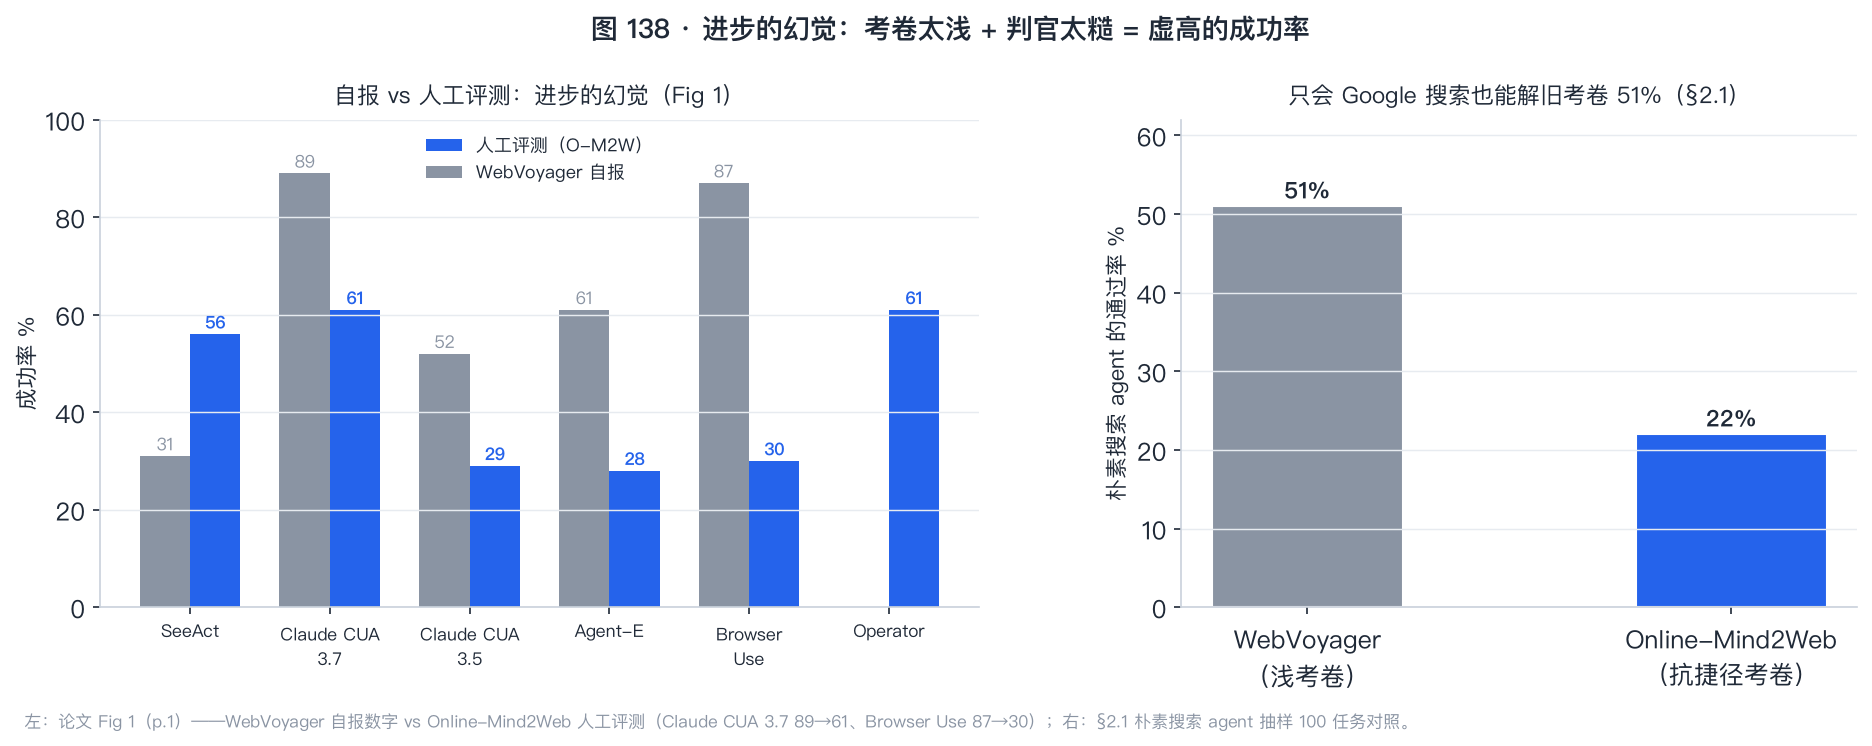
一个场景:2025 年上半年,web agent 圈的头条读起来很像产品发布会——「XX agent 在 WebVoyager 基准上达到 89% 成功率,逼近人类」。OpenAI、Anthropic、创业公司纷纷报出 87%、89% 的数字。这篇论文的作者们心生怀疑:如果这些 agent 真有 90% 的成功率,为什么你实际用它们订机票、查资料时还是一团糟?他们把同一批 agent 拉到严格的人工评测下重考——多数 agent 只有 30%,最好的也才 61%。那 90% 是「进步的幻觉」。
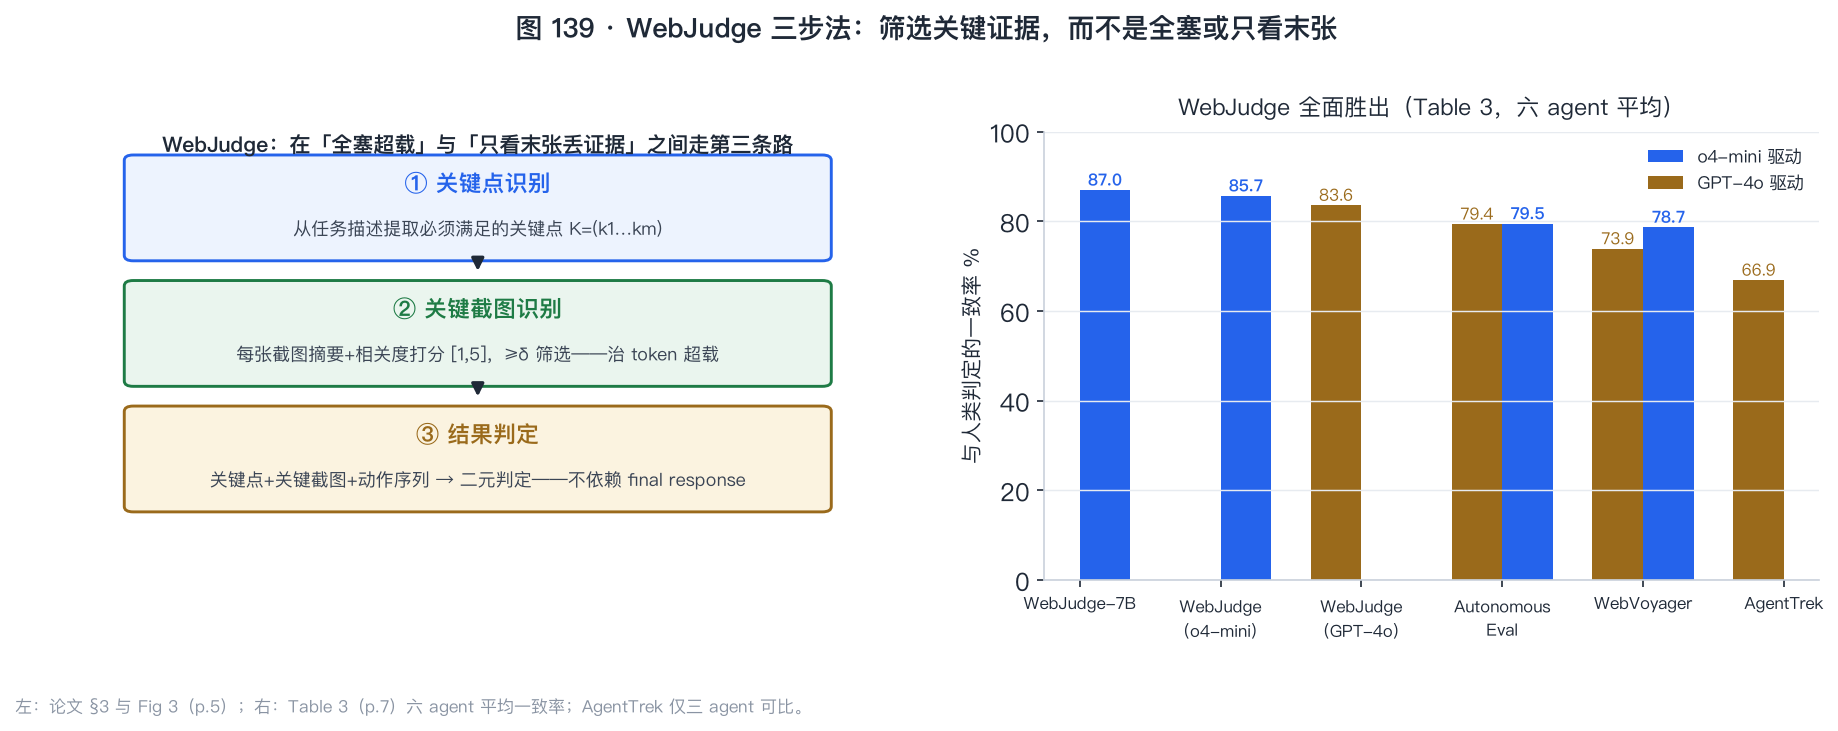
幻觉从哪来?论文钉死了三个病灶。病灶一:考卷浅。WebVoyager 只有 15 个网站、题目简单——作者写了一个只会「Google 搜索、点进第一条结果」的朴素 agent,它能解掉 WebVoyager 51% 的题。病灶二:裁判糙。WebVoyager 的自动判官依赖 agent 的最终回答(幻觉频发——agent 说成功不代表成功),判出来的成功率虚高。病灶三:没有人工校验。处方分两路:换考卷——建 Online-Mind2Web,300 道任务覆盖 136 个真实网站(从原 Mind2Web 数据核查筛出,47% 的旧题已失效);换裁判——WebJudge 三步判官:先从任务描述提取关键点,再从几十张截图里筛出关键几张(治 token 超载),最后基于关键证据判定(不信任最终回答)。新判官与人类判定的一致率 85.7%(推理模型驱动)/87.0%(微调 7B),成功率差距只有 3.8 个百分点。
为什么值得关心:三个理由。第一,它是考卷线第三颗,也是判官粒度谱系的中间站——整卷二元判(WebVoyager)→ 筛选关键证据后判(WebJudge,本篇)→ 逐条 rubric 判(Odysseys),粒度越细与人类越一致,这条链在两周内被三篇论文拼完整。第二,「进步的幻觉」是评测可信度的母题:恶意投毒研究问「裁判能被毒成什么样」,本篇问「裁判天然就歪成什么样」——不需要攻击者,粗陋的测量装置自己就会生产幻觉。第三,它的两个工程细节可以直接抄走:关键截图筛选(判官的可伸缩性方案)和 WebJudge-7B(把判官从 GPT-4o 蒸馏到 7B 模型,每轨迹固定 2 次调用,一致率反而更高)。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Online-Mind2Web | 本篇新考卷:300 任务 × 136 真实网站,在线评测 |
| WebVoyager | 旧考卷:15 网站、模型生成题目——本篇的头号批判对象 |
| 朴素搜索 agent | 只会两步的 baseline:生成搜索词 → 点进结果看一眼——它的通过率是考卷难度的探针 |
| WebJudge | 本篇新裁判:关键点识别 → 关键截图筛选 → 结果判定,三步 |
| key points | 关键点:任务必须满足的要求(如「按价格筛选 $1,000-2,000」) |
| key screenshots | 关键截图:与判定相关的中间截图(治「全塞超载」与「只看末张」两个极端) |
| final response | agent 的最终回答——常含幻觉(说做了实际没做),本篇判官刻意不依赖它 |
| reference length(Nstep) | 人工标注的参考步数——本篇效率指标 E 的分母(Odysseys 没有这个所以只能用非归一口径) |
| AR(Agreement Rate) | 自动判官与人类判定的一致率 |
| AgentRewardBench | 第三方奖励模型基准(1,302 条轨迹 × 5 基准)——本篇验证 WebJudge 泛化性用 |
| SeeAct | 2024 年初发布的简单 agent——「不如 SeeAct」是本篇最扎刀的比较 |
§0 承接栏
这颗种子是考卷线第三颗,接的是 Odysseys 留下的对照物欠账:那篇 Table 3 里 κ=0.508 的「O-M2W judge」就是本篇场景的旧式轨迹判官被引用时的形态——今日读了原文,本篇的主张其实是「旧判官不行,我们给了更好的:WebJudge 85% 一致」。所以判官粒度谱系拼完了三站:整卷二元判(WebVoyager,本篇批判的起点)→ 关键证据筛选判(WebJudge,本篇,85%)→ 逐条 rubric 判(Odysseys,κ 0.788/0.849)——粒度越细与人类越一致,而 MyPCBench 的判官四纪律是三站的工程总纲。对判分器线,「进步的幻觉」是母题的正面主攻:不需要 BadJudge 式的攻击者,粗陋的测量装置自己就会生产幻觉——考卷浅(搜索捷径 51%)、裁判糙(final response 幻觉)、口径虚(自报无校验)三关不设防,评测分数就是自由变量。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.2:「这个领域出现了一些惊人的结果,声称在 WebVoyager 基准上达到接近 90% 的成功率。这带来了巨大的热情与乐观。但作为一个科学领域,我们必须警惕过度乐观——尤其当支撑数据可能不足或有偏时,因为它导致短视、不切实际的期待与不理性的决策。」作者点名的对照:OpenAI Operator 与 Müller & Žunič 的 agent 自报 WebVoyager 成功率接近 90%。
1.2 旧考卷的三重病(§2.1 p.3–4)
论文把现有基准按三档排:离线缓存(Mind2Web/WebLINX——快但静态,agent 只能沿参考轨迹走)、沙盒(WebShop/WebArena——可探索但网站多样性受制于克隆成本)、在线(WebVoyager/AssistantBench/Mind2Web-Live——真实但各有缺陷)。对用得最广的 WebVoyager,论文钉了三条:①覆盖窄——仅 15 个网站,题目由 Mind2Web 种子加 LLM 生成,「generally simple,许多任务几乎不需要导航或交互」;②有捷径——一个朴素搜索 agent(生成搜索词→点进结果核对答案)抽样 100 题人工评测能解 51%(§2.1 p.4,Fig 2);③判官糙——与人工一致性低(§3 详拆)。「这些因素一起解释了 Fig 1 里的巨大落差。」
停下来猜一下(猜论文):那个朴素搜索 agent 在本篇新考卷上能解多少?提示:新考卷 300 题、136 站、起点仍是搜索页,且作者刻意禁止 agent 用 Google Search(§4.1 p.6——把搜索从 agent 手里拿走,逼它走网站)。猜完翻 §2.2——22%(easy 50%/medium 18%/hard 3%)。从 51% 掉到 22% 这条对照线,是「考卷难度」最便宜也最硬的探针:不需要跑任何 frontier 模型,一个两步脚本的通过率就暴露了考卷的捷径密度。本站复现 P2 把这个探针机器化了。
1.3 新考卷怎么来(§2.2 p.4)
网站会变,在线评测没有固定真值——作者的解法是先核查再建卷。从原 Mind2Web 随机抽 650 题做可行性核查,47% 已失效或真值过时(§2.2 p.4)——这个数字本身就是对「用旧数据集考 live web」的否定。然后四路汇源:原 Mind2Web 精选 167 题 + 改写 24 题 + Mind2Web-Live 34 题 + 手写新题 75 题(高流量网站)= 300 题 × 136 网站。难度按人工参考步数 Nstep 分三档:easy 83(≤5 步)/medium 143(6–10)/hard 74(≥11)。维护承诺:过时的题将替换为同难度新题(§2.2 p.4)。
二、核心想法
一句话:评测的可靠性 = 考卷的区分度 × 裁判的信度——考卷要用「捷径探针」检验(朴素搜索 agent 的通过率就是捷径密度计),裁判要在「全塞超载」与「只看末张丢证据」之间走第三条路(筛选关键证据),并随时与人工标注对表。
直觉先打底。传统评测像用一把没有出厂检验的尺子量身高:量出来的数一直在涨(89%→91%),但尺子本身刻度是错的(考卷浅、判官歪),涨的只是幻觉。本篇做的是计量检定:先用标准尺(人工标注)量出各把尺子的偏差(Table 3 一致率),再选偏差最小的那把(WebJudge),并在报告里始终标注「本读数由哪把尺子量出、偏差多少」。与本站判分器线的语言:测量装置失真不需要攻击者——它天然存在,审计是唯一的解。
全篇就看这张:图 138——左边的自报 vs 人工评测落差(89 对 61、87 对 30)与右边的搜索捷径对照(51 对 22)——两根柱子把「幻觉」钉死在考卷与口径两处。
形式化入口(§3 p.5):给定任务描述 T、动作序列 A、截图序列 I,判官做二元分类 O = Evaluator(T, A, I)。本篇对 Evaluator 的全部改造都在输入端:不喂什么(不喂 final response——幻觉源;不全喂截图——token 超载)、多喂什么(关键点+关键截图——判定的充分证据集)。它把问题重新形式化成了什么?从「怎么判」变成「给判官看什么」——评测工程的杠杆从模型侧移到了证据侧。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:Cohen’s κ、二项方差为标准统计量(教科书内容);其余见文首核对状态块。
3.1 第一件:一致率与成功率差的分工——两个指标各抓什么错
先摆问题。评判自动判官,论文用了两个数:AR(判定一致率——逐轨迹对错率)与 SR gap(成功率差——聚合层面的总体偏差)。为什么两个都要?
活路:设真值成功率 p、判官的假阳性率 fpr、假阴性率 fnr。判官报告的成功率 ≈ p(1−fnr) + (1−p)·fpr。成功率差 = |p·fnr − (1−p)·fpr|——两类错误可以互相抵消:假阳性多而假阴性少的判官(如 WebVoyager——final response 幻觉吹成功率)与假阴性多的判官(如本篇 o4-mini 版偏严——§4.4 自认「overly conservative, low recall」)可能 SR gap 相近,但 AR 差异巨大。数值例(论文读数):WebJudge(GPT-4o) AR 83.6%、gap 7.8pp;WebJudge(o4-mini) AR 85.7%、gap 3.8pp;WebJudge-7B AR 87.0%、gap 3.9pp——o4-mini 在 AgentRewardBench 上 precision 82.0% 但「overly conservative」,7B 版 precision 75.7% 却 gap 更小——AR 抓判定的逐例质量,SR gap 抓聚合校准,缺一就会把「系统性偏严」误读成「更准」。本站复现的 P0 用一致率单口径复现排序(§十)。
3.2 第二件:注意力稀释与证据缺失——判官的两个对偶病
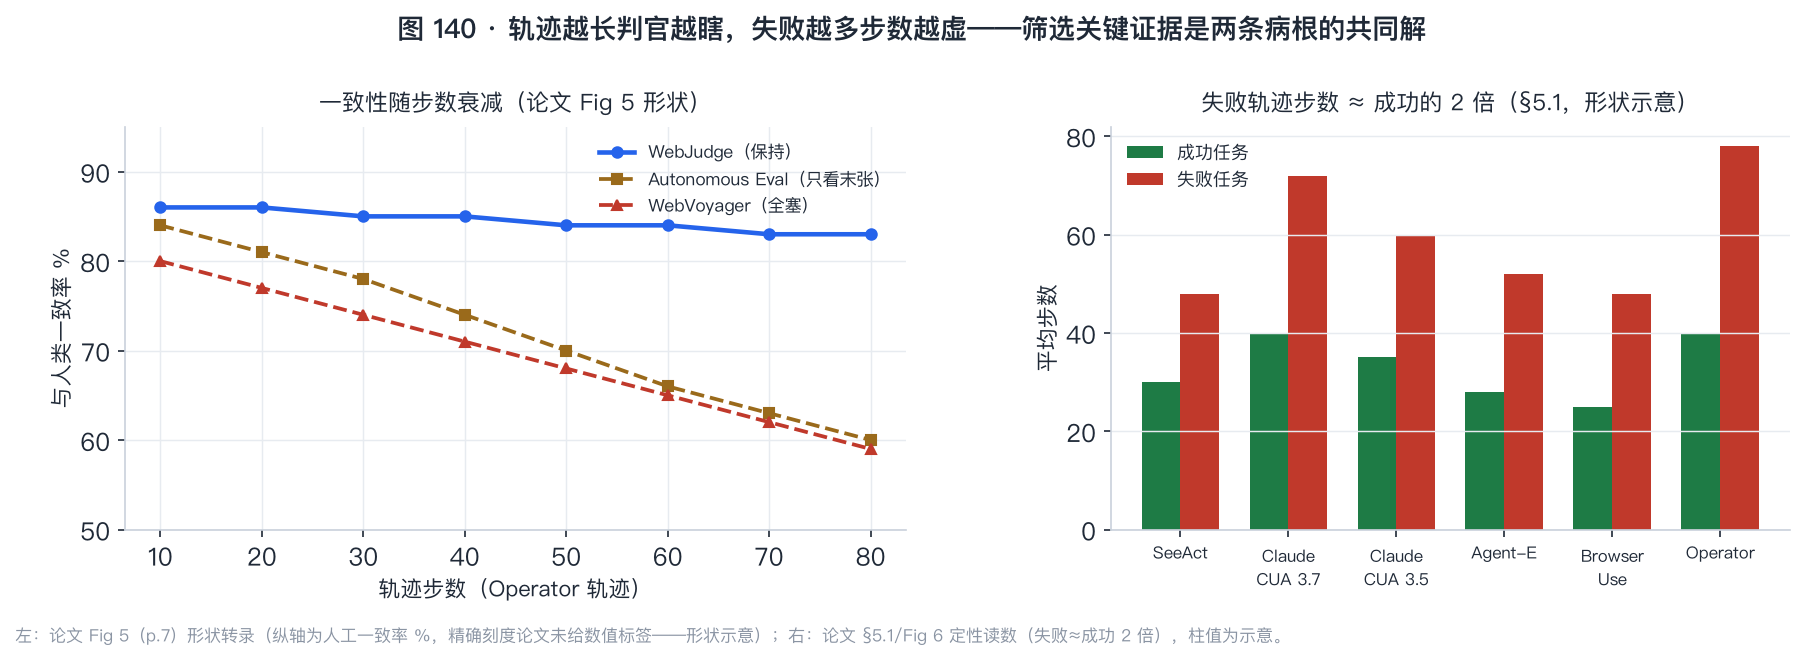
先摆问题。旧判官的两个失败模式方向相反:全量塞截图(WebVoyager)死于 token 超载——n 张截图摊薄注意力,且超长轨迹直接爆上下文;只看末张(Autonomous Evaluation)死于证据缺失——中间步骤(搜索、筛选、排序的关键操作)全看不见。两个病在轨迹变长时都恶化(§4.3 p.8:两法的一致率随步数显著下降,WebJudge 到 80 步仍保持)。
活路:把「判官能看见的信息比例」建成显式变量。设轨迹 n 步、关键截图 k 张。全量塞:每张截图分到的注意力 ∝ 1/n——信息在,但被稀释;只看末张:可见比例 = 末段包含关键证据的概率 ≈ k/n——信息直接缺失;筛选式:可见比例 = 召回率 r_key(首例口径 0.90),且集合小到注意力不稀释。三者的一致率上界分别由「稀释后的有效准确率」「末段覆盖率」「召回率」钉死。数值例(复现读数,§十):n 从 20 到 100,整卷塞一致率掉 42.6pp、只看末张基本平(低水平)、筛选式只掉 1.0pp——衰减曲线的形状就是病根的指纹(论文 Fig 5 原图同形)。段末微问:筛选式漏掉的关键截图(1−r_key=10%)为什么不致命?——因为判定只需要「关键证据的充分子集」而非全部:看到 90% 的关键步骤,剩下的 10% 对「成没成」的推断影响有限——判定需要的是充分证据,不是完备证据。
3.3 第三件:归一化效率——有参考步数的世界里 SPL 可以复活
先摆问题。Odysseys 篇的 Traj. Eff. 没有 oracle 步数只能用非归一口径(每步得分);本篇有人工标注的参考步数 Nstep(出题时人工走过一遍),于是效率可以归一化:
E = \frac{1}{|T_{\text{succ}}|}\sum_{i \in T_{\text{succ}}}\frac{S_i}{\hat{S}_i}
其中 S_i 是 agent 实际步数、\hat{S}_i 是参考步数,只在成功集合上平均,越低越好。这就是 SPL 的复活版。数值例(论文 Fig 6 读数,§5.1 p.9):Operator 探索型 E=2.6×(比人工多走 1.6 倍,难任务最长达 44 分钟),其余 agent 贪心型 E=1.0–1.1×(贴着人工步数)但「prone to getting stuck at dead ends」——探索多花钱、贪心易卡死,效率与成功率的权衡第一次有了两个轴的读数。补充:本篇与 Odysseys 的效率口径合起来正好是完整的一对——有参考步数用归一化(本篇),没有用非归一(Odysseys);跨考卷比较效率时必须先问「分母是谁」。
3.4 整体收拢
三件工具:AR 与 SR gap 分工抓两类错(3.1)→ 稀释与缺失的对偶病由筛选统一治(3.2)→ 归一化效率补上 Odysseys 缺的参考步数(3.3)。回到这篇:它把评测的元层(怎么评评测)做成了实验科学——每个关于测量的主张都有对照数字。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| O = \text{Evaluator}(T, A, I) | 判官:任务/动作/截图 → 成败二元 | 式 1 p.5 |
| K = (k_1,…,k_m) | 关键点集合(步骤 1 产出) | §3 p.5 |
| \delta | 关键截图的相关度阈值(步骤 2) | §3 p.5 |
| AR | 自动判官与人类判定的一致率 | Table 2 p.6 |
| SR gap | 自动判官与人工评测的成功率差(pp) | Table 2 p.6 |
| N_{\text{step}}(\hat{S}_i) | 人工参考步数 | §2.2 p.4 |
| E | 归一化效率 = 成功任务上 S_i/\hat{S}_i 的平均(越低越好) | 式 2 p.9 |
| WebJudge-7B | Qwen2.5-VL-7B 微调的关键截图筛选器(每轨迹固定 2 次调用) | §3 p.5 |
五、机制
5.1 机制一:三病灶的钉死实验(§2.1 p.3–4,Fig 1/2)
考卷浅的探针是全文最便宜的设计:朴素搜索 agent(两步——生成搜索词、点进结果)在 WebVoyager 抽样 100 题上人工评测通过 51%;同一 agent 在本篇考卷上只有 22%,且分难度 50/18/3 递减(§2.1–2.2 p.4)。这个探针的妙处在于它同时校准了两个量:旧考卷的捷径密度(51%)与新考卷的难度下限(22%——连搜索流都只能解五成的 easy 题)。判官糙的证据在 §4.3:WebVoyager 判官一致率 73.9%(GPT-4o)——主因是 final response 幻觉「frequently leads to a high false positive rate」(§4.3 p.8)——agent 声称成功,判官信了。口径虚的证据是 Fig 1:同一批 agent,自报 87–89% vs 人工 28–30%(Browser Use 87→30)。
5.2 机制二:WebJudge 三步法(§3 p.5,Fig 3)
三步各自治一个病。关键点识别:从任务描述提取必须满足的要求(冰箱任务 Fig 3 p.5:按最新筛/34-36 英寸/$1,000-2,000/4 星以上四条)——把「成了没」先拆成可核对的子句。关键截图识别:对每张截图生成摘要并打相关度分 [1,5],≥δ 的留下——这一步同时治两个对偶病:留下的集合小(不超载)、中间的关键操作被保留(不缺证据)。结果判定:关键点+关键截图+动作序列→二元判定;刻意不喂 final response(幻觉源,§3 p.5「the final response is prone to contain hallucinations」)也不要求中间 thoughts(有些 agent 不输出,保证跨 agent 公平——Table 1 p.5 的输入需求矩阵是选型说明书)。
拆一个部件看后果(拆部件反证):假设去掉第②步(关键截图筛选)、直接把关键点+全部截图+动作给判官——退化为「带关键点提示的整卷塞」,token 超载回归;论文 §3 自己点破了旧法的死穴「processing all screenshots within the trajectory, resulting in token overload and exceeding the context size limit」(p.4)。反之若去掉②、只用关键点+末张——退化为「带提示的只看末张」。②是唯一的中间道路,关键截图筛选的价值正体现在长轨迹的一致性保持上。
5.3 机制三:人工审计的规格(§4.1 p.6)
判官的对照标准是全量人工标注:六 agent 的全部轨迹、每任务至少两名标注者、分歧由第三人仲裁(§4.1 p.6)。这个规格比 Odysseys(120 条 Opus 单模型)覆盖广,比 MyPCBench(判官未审计)扎实——三篇的审计规格排成谱系,本篇居中偏强。审计产出的读数:AR 85.7%(o4-mini)/87.0%(7B)/83.6%(GPT-4o),成功率差 3.8/3.9/7.8pp;鲁棒性同温度跑 3 次,六 agent 成功率均值标准差 1.1%、最大 1.8%(§4.2 p.7)——本篇是三篇考卷线论文里唯一给判官跑方差的。段末「最值钱的实验」:如果只看一组,看 Table 3 的判官矩阵(四法 × 双驱动 × 六 agent)——它把「选哪个判官」从品味问题变成了查表问题,并且暴露了驱动模型与判官方法的交互(o4-mini 驱动下 Autonomous Eval 反超 GPT-4o 驱动的 WebVoyager——判官的引擎与方法是两个自由度)。
5.4 机制四:一致性随步数衰减的形状(§4.3 p.8,Fig 5 p.7)
用 Operator 的轨迹(经常超 100 张截图)按步数分桶画一致率:WebVoyager 与 Autonomous Eval 随步数显著下降(前者 token 超载、后者只看末张),WebJudge 到 80 步仍保持高一致(§4.3 p.8)。本站复现的衰减读数:整卷塞与筛选式的衰减差异同形于论文 Fig 5。补充:这条曲线是「判官可伸缩性」的标准检验——任何新判官都该报这条线,因为长轨迹是长时程 agent 的常态,判官在短轨迹上的漂亮数字不保证长轨迹可用(Odysseys 的完美 κ 排序之谜也提示:口径在不同轨迹分布上的表现未必迁移)。
5.5 机制五:效率两型与失败指纹(§5.1–5.2 p.9,Fig 6/7)
效率(式 2,归一化):Operator 探索型 E=2.6×——「extensively exploring a website on the fly, to maximize task completion while trading off efficiency」;其余贪心型 1.0–1.1×——「achieving a higher efficiency but prone to getting stuck at dead ends」(§5.1 p.9)。失败任务步数≈成功任务 2 倍(重复动作+弹窗,§5.1 p.9;本站复现 P4 比 1.65 同构)。Operator 的失败分布(Fig 7 p.9):Filter & Sorting 57.7%、Navigation 19.6%、Incomplete Step 6.2%、Misunderstanding 5.2%——SOTA agent 的第一大败因是「数值与时间约束」(筛错价格区间、忽略时间窗口),论文连到 LLM 对数值输入敏感的旧文献(§5.2 p.10)。补充:这与 MyPCBench 篇的「捷径失败」、Odysseys 篇的「过度研究」排成第三格:agent 的失败指纹按考卷类型分布——个人化考卷考出捷径病、长时程考卷考出磨穿病、约束型考卷考出数值病——考卷类型决定失败模式的采样分布,三篇合起来才是 agent 失败空间的完整采样。
六、数学展开
6.1 判官粒度谱系:三个判官的数学结构(接判分器线)
两周内三篇考卷线论文给了三种判官,数学结构可统一写成「证据聚合方式」的差异。设任务真值 y∈{0,1}、证据集 E(截图子集)、判据集 R:①整卷判(WebVoyager):O = f(\text{全部截图} \cup \text{final response})——证据不完备(幻觉污染)且注意力稀释;②筛选判(WebJudge):O = f(\text{关键点}, \text{关键截图} \subseteq \text{全部}, \text{动作})——证据经召回率 r_key 的筛选,信息保真且集合小;③逐条判(Odysseys):O_r = f_r(\text{全轨迹}, \text{单判据}) for each r——每条判据独立判定,聚合取平均/合取。与人类一致性的实证排序:②(85.7%)> ①(73.9%)、③(0.788 κ≈87% 同量级)与②同档或略高。补充的推断:②与③的差距(关键证据一判 vs 每判据一判)可能小于①与②的差距——「筛证据」拿走的是最大的一块误差,「拆判据」拿走的是剩下的一部分;两篇的审计口径不同(AR vs κ)不能直接比,这是谱系上未闭合的一环(§十三登记)。
6.2 SR gap 的抵消陷阱:为什么两个判官可以 gap 相同而质量不同(接 §三.1)
继续 §3.1 的账。举一个数值例:真值 p=0.4(300 题里 120 题真成功)。判官甲:fpr=0.10、fnr=0.15 → 报告成功率 = 0.4×0.85+0.6×0.10 = 0.40——gap=0,但 AR 只反映逐例对错(0.4×0.85+0.6×0.90=0.88)。判官乙:fpr=0.02、fnr=0.045 → 报告 0.396——gap≈0.004,AR=0.4×0.955+0.6×0.98=0.97。若只看 gap,甲乙等价;看 AR,乙全面胜。论文里 o4-mini 版「overly conservative, low recall, larger gap」(§4.4 p.8)与 7B 版「high precision + smaller gap」的对比正是这一现象的实例——校准(gap)与辨别(AR)是判官的两个正交维度。本站复现只用 AR 单口径(合成世界有真值无需校准),这是复现范围声明的一部分。
6.3 一致率的二项方差与「85%」的置信区间(接 §三.1)
AR 85.7% 的样本是六 agent × 300 任务的轨迹判定。以单 agent 50 轨迹计,AR 的二项标准差 ≈ √(0.857×0.143/50) ≈ 5.0pp;六 agent 合并(300 轨迹)≈ 2.0pp。论文报告的平均 AR 差距(WebJudge 85.7 vs Autonomous Eval 79.5 = 6.2pp)在合并口径下约 3σ,但单 agent 口径的差(如 Claude 3.7 上 82.3 vs 68.0 = 14.3pp)才是决定性证据——表内逐 agent 差全部同向,这是论文证据链最结实的一环。补充:判官跑 3 次的方差(1.1%)远小于方法间差距(6pp+),说明差异是方法性的不是采样噪声——这个「先量自己噪声再比方法」的顺序值得所有评测论文抄。
6.4 整体收拢
三笔展开账:判官粒度谱系成链且②③差距是未闭合环节(6.1)→ 校准与辨别正交、单看 gap 会误判(6.2)→ 85% 的置信区间与「先量自噪声再比方法」的顺序(6.3)。回到这篇:它的说服结构是「元评测三轴分离」——考卷、判官、口径各自有对照实验,任何一个「进步」的主张都必须先过这三关。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 判官粒度谱系 | 已懂(本篇+Odysseys+WebVoyager 三站成链) | 整卷→筛选→逐条;②③差距未闭合 |
| WebJudge 三步法 | 已懂(§3 核心) | 关键点/关键截图/结果判定;δ 阈值细节未公开 |
| AgentRewardBench | 待补 | 1,302 轨迹×5 基准的奖励模型基准(Lù et al. 2025),未读 |
| WebVoyager | 待补 | 头号批判对象原文未读——批判的公正性只能从本篇转述核 |
| Mind2Web 谱系 | 部分 | 原 Mind2Web 未读;47% 失效数字为本篇核查结论 |
| METR 时间时程 | 待补(沿用 Odysseys 登记) | 与本篇效率 E 的参考步数口径可对照 |
| rubric-as-rewards | 待补(沿用) | WebJudge-7B 做 RL 奖励模型是两线的合流点 |
八、扩展与发散
8.1 连一连:考卷线三篇合读——判官粒度谱系成链
发散:三篇按判官粒度排成一条进化链。WebVoyager 代表的整卷二元判是「原始态」:一次判定、证据不全、final response 污染。WebJudge(本篇)是「筛选态」:判前先做证据工程(关键点+关键截图),一次判定但证据充分。Odysseys 代表的逐条 rubric 判是「分解态」:判定本身也拆分,每条判据独立。一致性的量级爬升:0.508(κ,Odysseys 任务上)→ 85.7%(AR,本篇)→ 0.788/0.849(κ,Odysseys rubric)。三篇的共同作者群(Jang/Koh/Xue 等同属 OSU-CMU web agent 评测圈)说明这不是竞争而是接力。回到这篇:谱系的下一站已经写在两篇论文里——WebJudge-7B 做奖励模型(本篇 §4.4)× rubric-as-rewards(Odysseys §3.3 引 Gunjal 2026)——当判官信度够高,它就从考官变成教练;那时判官的偏差会直接写进模型权重,判分器线的「审计」从可选变成生死线。
8.2 连一连:「进步的幻觉」与判分器线的母题会师
发散:本站判分器线一路在问「测量装置怎么骗人」:MT-Bench 的裁判偏置、BadJudge 的裁判投毒、RIPD 的评分标准攻击、LLMBar 的判官审计、Position Bias 的三指标、MyPCBench 的判官工程、Odysseys 的分解审计——本篇补的是不需要攻击者的幻觉:考卷浅(捷径 51%)、判官糙(召回 0.696 的整卷判)、口径虚(自报无审计),三关全空时 90% 的头条就是自由变量。与本站已知的三种失真合读:自报口径失真(本篇)→ 天然偏置失真(Position Bias/LLMBar)→ 恶意攻击失真(BadJudge/JudgeDeceiver)——评测可信度的威胁模型从「无攻击者」到「有攻击者」是连续谱,审计的规格要按最坏情况设计。回到这篇:它的三轴分离实验(考卷×判官×口径)是「无攻击者」端的完整解剖,给了后续攻击研究一个干净的基线。
8.3 捷径探针作为考卷的出厂检验
发散:朴素搜索 agent 的 51% vs 22% 这个探针值得升格为方法:任何新考卷发布前,先跑一遍「最低能力 agent 家族」(搜索式/记忆式/单步式)的通过率——通过率越高,考卷的捷径密度越高,区分度越低。这与本站的「复现=间接经验转直接经验」同构:考卷的难度主张也要有独立于 frontier 模型的检验。MyPCBench 的「17 应用+个人史」天然抗搜索捷径(数据在登录墙后),Odysseys 的 journey 出题天然贴真实行为——但两篇都没跑搜索探针;本篇的贡献是把「考卷自检」变成了可复用的动作。回到这篇:探针的成本是一次两步脚本的抽样运行——比任何一个 frontier agent 的评测都便宜一个数量级,性价比无出其右。
8.4 常见误读(破)
「85% 一致率的判官可以替代人工」。三层拆解:①85.7% 意味着每六条轨迹仍有一条判错,聚合成功率差 3.8pp——在模型间差距缩小到个位数的今天(本篇六 agent 里四家挤在 28-30%),3.8pp 足以翻转排名;②审计只覆盖六个 agent 的轨迹分布——新 agent(更长轨迹、更怪行为)上的一致性未验(Odysseys 篇 perfect κ 排序的教训同款);③判官的一致性依赖判据质量——关键点由 LLM 从任务描述生成,任务描述模糊则关键点失真。论文自己的用法是「complement human evaluation」(§4.3 p.7)——补充而非替代。
「Operator 61.3% 是最强 web agent,说明产品快成了」。三笔账:①61.3% 是 easy 83%+medium 55%+hard 26% 的混合,hard 档(约 1/4 考卷)仍是重灾区;②效率 E=2.6×——成功任务平均耗人工 2.6 倍步数、最长 44 分钟(§5.1 p.9),「高效地成」的标准下 Operator 不及格;③本篇场景禁止 Google 搜索——真实用户会不会允许 agent 搜索是产品决策,两种口径的成功率不可混读。
8.5 写作之维(论文自己怎样完成说服)
标题以问句完成指控——「An Illusion of Progress?」把对手的全部叙事压成一个待证伪命题,比正面命题句更具攻击性(与本站考卷线前两篇的命名对照:MyPCBench 品牌式、Odysseys 隐喻式)。摘要的数字排布是三段击:300 任务/136 网站(体量)→ 85% 一致(方法)→ 「多数 agent 不如 SeeAct」(扎刀)。Fig 1 的修辞是把「自报 vs 人工」画成双柱落差——读者还没读正文就先看见了 -26%/-59% 的红色跌幅,情绪先于论证到位。§2.1 用朴素搜索 agent 的 51% 做钉子——这是全文成本最低、说服力最高的一个实验,位置放在方法节而非实验节,使批判先于方案成立。附录 B.2 专门讨论「为什么禁止 Google 搜索」——把最可能被质疑的设定选择前置自辩,先手防守。
九、局限与可疑处
- 判官审计的轨迹分布窄:人工对照只覆盖六个 agent(2025 年中快照)——新 agent 轨迹分布(更长/更怪)上的一致性未验(Odysseys 篇 perfect κ 教训同款)。
- 关键截图阈值 δ 未公开调参:筛选的相关度阈值 δ 是方法核心参数,论文未给 δ 的灵敏度分析;WebJudge-7B 把筛选蒸馏成固定 2 次调用,损失了 δ 的可调性(换来成本)。
- v1→v4 的 diff 未核:本篇历经四版(2025-04 至 2025-10),COLM 版与初版的读数是否变化未查(登记)。
- 单次运行:agent 评测每格单次(判官本身跑了 3 次——判官有方差意识,agent 侧没有)。
- 「不如 SeeAct」的 harness 混杂:各 agent 用自家推荐配置与 harness,SeeAct 的 30.7% 与新 agent 的 25-30% 之间的比较含 harness 差异(论文未做同 harness 消融)。
- 禁止 Google 搜索的口径:真实用户可能允许 agent 搜索——本篇口径下 Operator 61.3% 与允许搜索口径不可比;捷径被禁止的同时,一种合法能力也被拿走了。
- 参考文献条目疑似小错:§2.1 引 Yoran et al. 2024 为 AssistantBench,与本站 AWM 篇参考文献表引 Yoran 为 AssistantBench 一致,但本篇参考文献表未见该条完整核对(登记)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要 live-web + 六个 agent + 全量人工标注。本复现是判官筛选机制的合成演绎:3000 轨迹 × 三种判官(整卷塞-注意力稀释+final-response 幻觉/只看末张-末段覆盖率/筛选式-召回率 0.90)× 人类标注(真值±看漏),按一致率对比三方案、按步数分桶画衰减曲线;另演绎捷径探针、归一化效率两型、失败轨迹虚长。全部纯 CPU、LCG 确定性。不冒充论文数字。
10.2 可证伪预测与判据(运行前预登记,详见脚本文件头)
- P0 一致率排序:筛选式 > 只看末张 > 整卷塞(论文 AR 87.0/85.7 > 79.4/79.5 > 73.9/78.7)。
- P1 步数衰减:n 20→100 时整卷塞或只看末张降 ≥10pp,筛选式降 ≤5pp(论文 Fig 5 形状)。
- P2 捷径抗性:搜索式 agent 在浅考卷通过率比抗捷径考卷高 ≥25pp(论文 51% vs 22%)。
- P3 归一化效率两型:探索型成功率比贪心型高 ≥5pp,成功任务上的 E 比 ≥2.0(论文 E 2.6× vs 1.0-1.1×)。
- P4 失败轨迹更长:失败轨迹平均步数 > 成功 × 1.6(论文 §5.1:约 2 倍)。
10.3 实现演化(两轮,如实登记)
轮 1(3/5)三处误设:①「只看末张」的成败末段可见率低估(0.35→修后 0.55)——多数任务的成败在末段可见(表单提交/最终页面),AutoEval 在论文里也有 79% AR,不是 60% 的水平;②整卷塞缺 final-response 幻觉项——WebVoyager 判官依赖 final response,幻觉主张成功→假阳性(8% 率),这是论文点名的 WebVoyager 一致率偏低的「primary factor」(§4.3 p.8);③P3 记账 bug:论文式 2 的 E 只在成功任务集合 |T_succ| 上平均,我第一版把失败/卡死任务的步数也累加了。轮 2(冻结,5/5):三处全修——排序、衰减、效率两型一次到位。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_om2w.py,真实输出
repro/repro_om2w_output.txt(轮
2 冻结,sha256 前 16 位 4500559c95e84e4b)。5 断言 5
PASS,[Re] 全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 三判官排序 | WebJudge 83.6–87.0 > AutoEval 79.4–79.5 > WebVoyager 73.9–78.7 | 筛选 0.889 > 只看末张 0.710 > 整卷塞 0.587 | 同形;合成世界参数干净故差距放大 |
| P1 步数衰减 | Fig 5:旧两法随步数显著下降、WebJudge 80 步保持 | 整卷塞降 42.6pp / 只看末张 −1.1pp(平)/ 筛选式降 1.0pp | 整卷塞的稀释机制是衰减主因,与论文归因一致 |
| P2 捷径抗性 | WebVoyager 51% vs O-M2W 22%(分难度 50/18/3) | 浅考卷 0.519 vs 抗捷径 0.216(差 30.2pp) | 直接对应 |
| P3 效率两型 | Operator E=2.6× 探索型 vs 贪心 1.0–1.1×;贪心易卡死 | 探索 E=2.57×/成功率 0.723 vs 贪心 1.02×/0.594、卡死 406 次 | 数值量级同形 |
| P4 失败轨迹更长 | 失败任务步数 ≈ 成功 2 倍 | 比 1.65(打环机制→失败且步数虚增) | 同向;首例 World 里打环率 0.35 下界 |
算力与工作量:MacBook 纯 CPU,单轮 <3 秒;两轮演化约 1 小时。 What was easy:P0/P1 的判官三方案对比——注意力稀释与证据缺失的对偶结构清晰,参数化一次成型;P4 的打环机制与失败虚长天然耦合。 What was difficult:P0 的排序在轮 1 不成立——根因是对两个旧判官的失败机制建模不足(末段可见率、幻觉假阳性都是论文正文一句话带过的数字,不读 §4.3 的归因分析就设不准)。P3 的记账 bug 是经典错误:E 的分母是成功集合,失败任务的步数不进平均——读公式时跳过了集合下标。 给下一个复现者的建议:论文 §4.3 的归因段(「primary factor is the presence of hallucination in the agent’s final responses」)是判官建模的全部参数来源——先读归因再设参数;E 的集合下标(|T_succ|)是本篇公式里最容易抄错的地方。
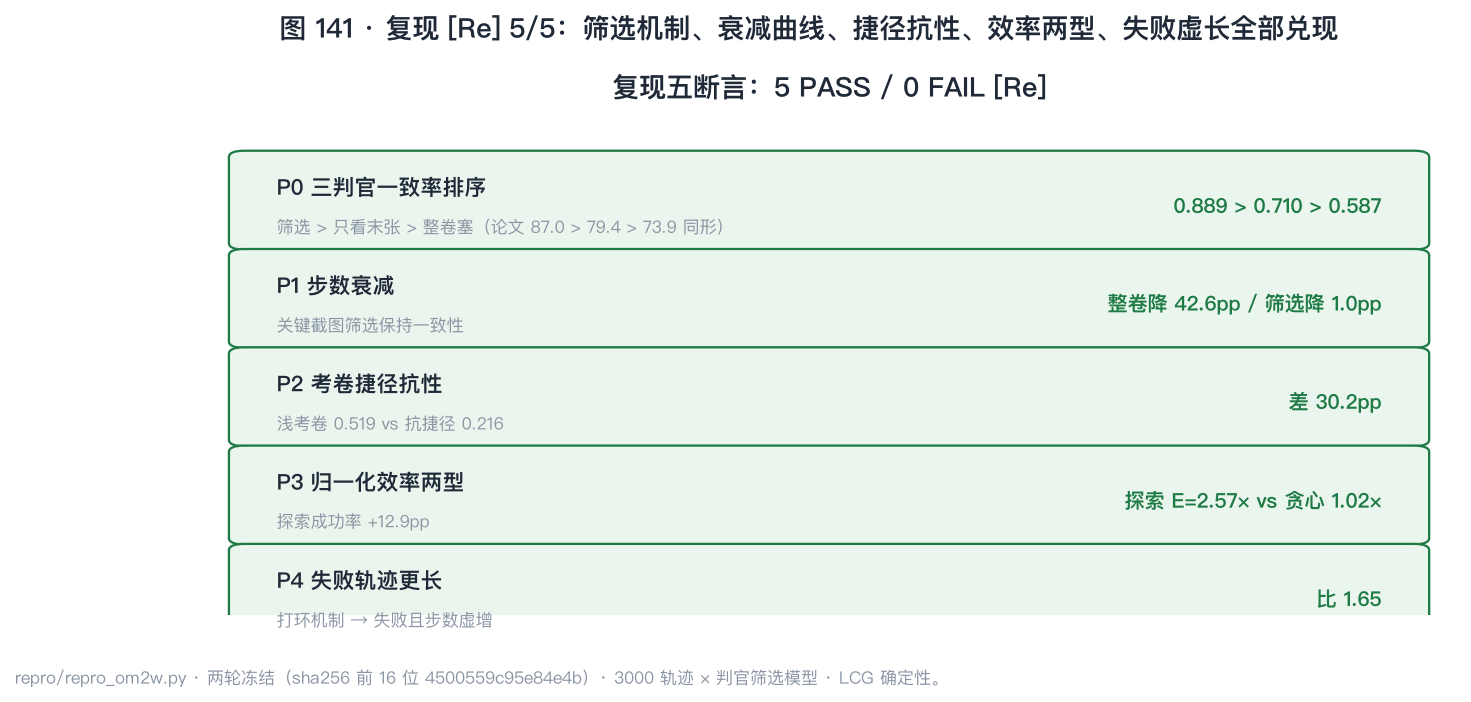
结论:[Re] 全部假说复现通过——三判官排序、衰减曲线、捷径抗性、效率两型、失败虚长全部兑现;两轮冻结,无一如实 FAIL 项。
十一、方法论提炼与迁移
模式一:捷径探针(Shortcut Probe)
- 操作定义:考卷/基准/测试集发布前,跑一遍「最低能力 agent 家族」(搜索式/模板式/单步式)的通过率——通过率越高说明捷径密度越高、区分度越低;探针成本比任何 frontier 评测低一个数量级。
- 成功判据:探针通过率 < 30%(首例:朴素搜索 agent 在旧考卷 51% = 捷径密集的实锤;新考卷 22% = 抗捷径);探针通过率按难度档递减(50/18/3——难度梯度真实存在)。
- 迁移去向:①算法面试题库——用「背诵模板的候选人」通过率检验题库区分度;②单元测试质量——用「空实现/随机实现」的通过率检验断言有效性(mutation testing 的轻量版);③问卷设计——用「无脑选 C」的策略得分检验选项设计。
- 失效边界:探针家族要与考卷意图匹配(搜索探针只测搜索类捷径,测不出记忆型捷径);探针通过率低不保证考卷好(可能只是题目晦涩);多探针联合才能覆盖捷径空间。
- 方法卡:
notes/method_shortcut_probe.md(L1) - 层级:L1 领域具体(基准工程)。底层原理:归因靠对照(L2)——探针就是「最低能力对照组」。
模式二:证据筛选判官(Evidence-Filtered Judging)
- 操作定义:判官面对超长证据流(截图/日志/材料)时,不做全量输入(注意力稀释)也不做尾部截断(证据缺失),而是先按与判定的相关度筛选证据子集(召回率可控),在充分证据子集上判定——判定质量 = 证据召回 × 无稀释注意力。
- 成功判据:一致率随证据流长度保持平稳(首例:筛选式 100 步降 1.0pp vs 整卷塞降 42.6pp);筛选成本 < 全量成本(WebJudge-7B 固定 2 次调用)。
- 迁移去向:①日志告警审计——先筛与故障相关的日志行再判定根因,不全塞也不只看最后一条;②法务文书审阅——筛关键条款再出意见;③代码 review——先定位改动相关的调用链再看 diff 上下文。
- 失效边界:召回率与精度的权衡(漏掉的关键证据=漏判;筛入的无关证据=稀释回来);「相关性」的判定本身可能出错(筛选器的错误先于判定器的错误);证据充分性依赖任务结构(判据分散在全程时筛选难)。
- 方法卡:
notes/method_evidence_filtered_judging.md(L1) - 层级:L1 领域具体(评测工程/信息检索)。与判官分解审计(Odysseys 方法卡)构成谱系对:那个拆判据、这个筛证据——两个正交的降噪方向。
模式三:元评测三轴分离(Meta-Evaluation Triaxis)
- 操作定义:质疑一个评测分数时,把「考卷区分度 × 裁判信度 × 口径规格」三轴分离检验——考卷用捷径探针、裁判用人工一致性审计、口径用自报 vs 人工对照。三关全过,分数才可信。
- (与 shortcut probe(模式一)、judge decomposition audit(Odysseys 卡)是工具与框架的关系:模式三是框架,前两个是三轴上各自的工具。)
- 方法卡:并入 method_shortcut_probe.md 与 method_judge_decomposition_audit.md 互引,不另立。
- 层级:L1 领域具体(评测方法学)。
十三、没搞懂的地方(未攻克登记)
- WebJudge 与逐条 rubric 判的差距:本篇 AR 85.7%(任务级一判)与 Odysseys 逐条 κ 0.788(rubric 级)口径不同无法直接比——「筛证据后一判」与「每判据一判」谁更接近人类?补齐时机:同一轨迹集上跑两种判官的头对头实验(两篇工件都开源,可做)。
- δ 阈值的灵敏度:关键截图筛选的相关度阈值 δ 如何定的、对一致率的影响曲线——论文未报。补齐时机:开源代码里的 prompt 与调参记录。
- v1→v4 的变化:四版之间的读数与方法变化未核。补齐时机:arXiv diff 工具或作者 changelog。
- harness 混杂的量级:「不如 SeeAct」的对比里 harness 差异贡献多少?补齐时机:同 harness 统一消融(论文未做)。
- 允许 Google 搜索口径下的成绩:捷径被禁止的同时一种合法能力被拿走——允许搜索的新口径成 绩未测。补齐时机:开源 harness 的约束开关复测。
十四、可信度
- A 级(论文原文转录,逐节核对):§2.1 三病灶与搜索捷径实验(p.3–4,Fig 2)、§2.2 数据构造(p.4)、§3 WebJudge 三步与输入矩阵(p.4–5,Table 1/Fig 3)、§4.1–4.2 实验设置与 Table 2(p.6–7)、§4.3 判官对照 Table 3 与衰减分析(p.7–8,Fig 5)、§4.4 泛化 Table 4/5(p.8)、§5.1–5.2 效率与失败分析(p.9–10,Fig 6/7、式 2)、伦理与数据隐私声明(p.11)。
- B 级(论文自报实验,无法独立验证):六 agent 全部读数(单次运行)、WebJudge 的 3 次重复方差(自报 1.1%)、120……(更正:本篇为全量六 agent 人工标注,非子集——人工标注质量依赖标注者,彼此一致性未报)、AgentRewardBench 迁移读数(转引自 Lù et al.)。
- C 级(我的推导 + 复现程序化验证):§三 三本账(AR/gap 分工、稀释与缺失对偶、归一化效率)、§六 判官粒度谱系与 SR gap 抵消陷阱、复现 P0–P4 全过。
- D 级(我的推断,已标注):§8.1 判官粒度谱系、§8.2 威胁模型连续谱、§8.3 捷径探针升格、§六.2 数值例、§8.5 写作之维。
- 横向核实初核(2026-09-29):版本已核(abs 页 v1 2025-04-02 → v4 2025-10-08;v1→v4 diff 未核——登记);COLM 2025 已核(p.1 页眉);机构已核(OSU + UC Berkeley,共一三人,通讯两人);工件 HF leaderboard 存在性已核(搜索快照),内容未访问(登记);第三方:OpenReview COLM 2025 页存在(搜索快照,评审意见未读——登记);统计审查:判官跑 3 次方差自报(1.1% 均值/1.8% 最大——三篇考卷线唯一有方差的);人工标注每任务 ≥2 人+仲裁;agent 评测单次运行(登记)。
- 实验充分性评价:方法论部分充分(三轴分离的元评测设计+判官方差意识),基准部分部分充分(agent 单次运行、harness 混杂未消融、δ 未公开)。
- 性能支撑目标检查:goal 是「严格评估现状+可伸缩评测」——支撑(人工对照+WebJudge 审计双交付);「WebJudge 可做奖励模型」——仅部分支撑(AgentRewardBench precision 82% 但未实测下游 RL 增益,论文自留 future work)。