外行导读(先读这个,再决定要不要进正文)
一个场景:web agent 基准的考卷长这样——「在购物网站上把一件商品加入购物车」。frontier 模型已经考到 80-90 分,大家开始宣布「web agent 基本解决了」。可真实用户在浏览器里干的事是:花一下午比较三个电商的价格、在五个订票平台之间规划一趟多城行程、把十几个搜索结果汇总成一份文档。这些任务要跨站点、要维持几十步的上下文、要自己决定什么时候停止搜集开始交付——现有考卷不考这些。
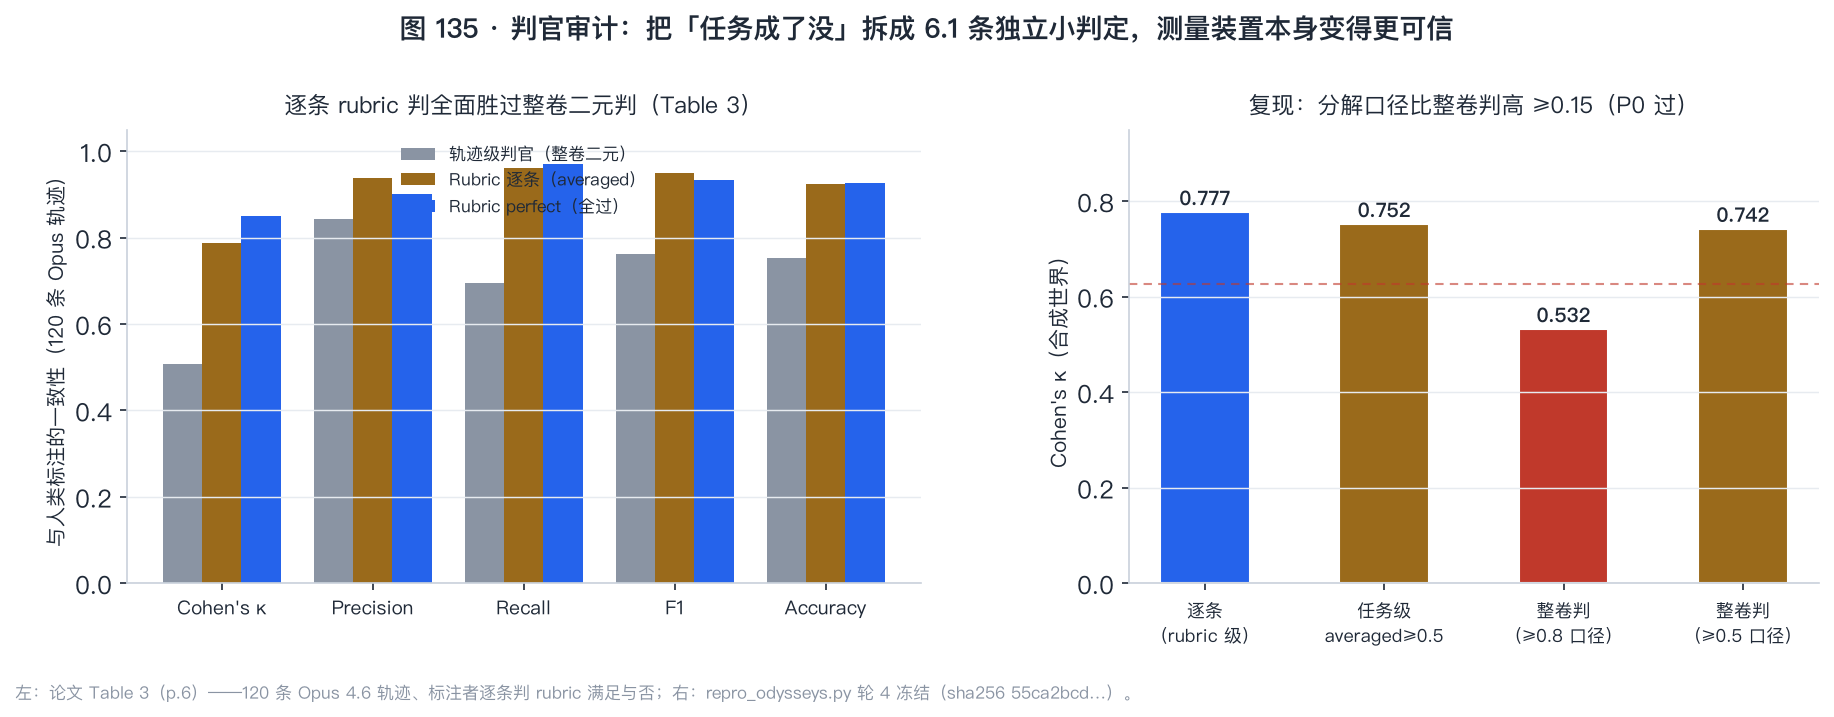
这篇论文干了两件事。第一件:造一份长时程考卷。248 名众包标注者用 Chrome 扩展标注自己的真实浏览历史,切分出 2,380 条「旅程」;精炼剩 696 条(29.2%),再按语义聚类、用 GPT-5.4 串成多步工作流,最后长成 200 道任务(简单的 45 道、中等的 46 道、难的 109 道)——全部在真实的互联网上考,起点是一个 Google 搜索页。第二件事:修裁判。长任务用「整卷二元判」(整条轨迹一个 pass/fail)误差很大;本篇把每个任务拆成平均 6.1 条独立评分细则(rubric),判官逐条对照完整轨迹判定。他们招人给 120 条 Opus 轨迹逐条做了人工标注做对照审计:逐条判与人类的一致性 Cohen’s κ=0.788、任务级全过口径 κ=0.849,而旧的整卷判只有 0.508——把「任务成了没」拆成六条小判定,测量装置本身变得更可信。读数:最强模型全过率 44.5%,难档(109 题)崩到 11%;效率指标(每步换回多少分)最强只有 1.15%。
为什么值得关心:三个理由。第一,它是考卷线第二颗,也是 MyPCBench 精读转引的判官可靠性审计的出处——那篇说判官「已审计验证」,审计报告就是本篇 Table 3,欠账今日归位。第二,它的两个失败模式画像精确对上执行侧的方法卡:Opus 输在「过度研究不交付」(39% 的任务撞 100 步上限,光搜集不做文档——停晚了),GPT-5.4 输在「有计划不动手」(生成完美计划后空动作收工——停早了);stop 的两种死法各占一个家族。第三,它给了一个效率的正式化——Traj. Eff.(每步 rubric 分)——把「高效地成,而非终究成」变成可排序的量,与 LATTS 的算力分配、Damani 的测试时预算直接对上。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| journey(旅程) | 标注者自己圈出的一段有目的的浏览记录(Chrome Journey 算法切分) |
| rubric(评分细则) | 每任务 3–12 条独立判据:一条「要求」+一条「如何核查」的说明 |
| averaged / perfect | 两种口径:部分分(加权平均通过率)/ 全过(每条 rubric 都过才算成) |
| O-M2W judge | 轨迹级判官(Online-Mind2Web 的整卷二元判定)——本篇的对照组 |
| Traj. Eff. | 轨迹效率:每步换回多少 rubric 分(×100 读)——效率的正式化 |
| CUAfy | 把抽象任务改写成对 computer-use agent 说的自然口语请求(含具体站点与参数) |
| live Internet | 在真实互联网上考(非沙盒镜像)——真实但引入站点变动噪声 |
| 批处理动作 | 一个模型回合里返回多个动作(GPT-5.4 均 2.03 个,最多 24 个) |
| Wayback Machine 回退 | 被 403 时构造互联网档案馆链接取缓存页——agent 的野路子之一 |
| view-source: 取证 | 页面渲染坏时直接看源码、ctrl+f 搜 JSON-LD 结构化数据 |
§0 承接栏
这颗种子是考卷线第二颗,接的是 MyPCBench 精读留下的两笔账。第一笔是明账:那篇判官可靠性一栏写着「已审计验证(转引本篇,原文未读)」——本篇读了原文,审计报告就是 Table 3:120 条 Opus 轨迹、标注者逐条判 rubric、三个口径的一致性对照。第二笔是暗账:MyPCBench 的判官四纪律(只判一条/不脑补/做了且可见/撤销即失败)是设计规范,本篇给了规范背后的实验证据——为什么必须「只判一条」?因为整卷判与人类的一致性 κ 只有 0.508,逐条判是 0.788。对执行侧,它同时喂两处:Traj. Eff. 把「测试时算力分配」接到评测侧(每步换回多少分 = 分配效率的外部读数);Opus「过度研究不交付」与 GPT「有计划不动手」是一对相反的停止失败,正好卡在停止规则问题的两端。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:现在的 agent 基准考的是「短、紧凑、单集片段」,真实 web 用法是「跨多页、多标签、多域名展开的长时程工作流」——比较三个零售商的价格、在多个预订平台间规划旅行、把多轮搜索综合成一份交付文档。「Agent 必须在长时程中维持上下文、跨异构网站推理、把开放目标分解成子问题,并自己决定什么时候停止探索、开始产出。」(§1 p.1)最后这半句是全文的题眼——停止决策第一次出现在基准的问题陈述里。
1.2 旧考卷的三重病(§2 p.2–3)
第一重:短任务饱和——frontier 模型在单站点短任务上已接近天花板,考不出差距。第二重:评估口径糙——live-web 评测(WebVoyager、Online-Mind2Web)用轨迹级 LLM 判官给整条轨迹打一个二元分,「scales but introduces grading noise」(§2 p.3);执行式验证(WebArena)精确但难扩展。第三重:不考过程——GAIA/BrowseComp 这类 deep-research 基准只看最终答案,绕开了浏览过程本身,「evaluating final answers rather than the browsing process」(§2 p.3)。本篇的处方:真实浏览史出题(治病一)+ rubric 逐条评分(治病二)+ 过程与交付都算分(治病三)。
停下来猜一下(猜论文):把一条任务拆成 6 条 rubric 逐条判,判官调用的次数变成 6 倍,成本和噪声都在涨——猜一下论文凭什么说这比一次判整卷更可信?给两个候选:A 逐条判让判官每次只看一个简单问题,注意力不被稀释;B 拆分后误差互相独立、聚合平均把噪声消掉。猜完翻 §4.1 与 Table 3——答案是 A 为主、B 也有份:逐条判的精确率 0.939、召回 0.960(单判定就准),而整卷判的召回只有 0.696(整卷二元判大量漏判「部分成功」)。更有意思的是 perfect 口径 κ 最高(0.849)——这个排序论文没有解释,本站复现四轮也没能再现(§十 P1),先记住它,§六.1 回来算这笔账。
二、核心想法
一句话:长时程 agent 评测的两个断言——考卷要从真实浏览行为里长出来(200 道多站点任务,live 网上考),评分要把「成了没」拆成 6 条独立小判定(逐条 rubric,与人类一致性碾压整卷判);再配一个效率指标,因为「终究成」不值钱,「高效地成」才值钱。
直觉先打底。传统判卷像判断题:一条轨迹,判官看一遍,打勾或打叉——轨迹越长,判官越记不住前面干了什么,只能凭整体印象,而「整体印象」对部分成功最不友好(做了 80% 和做了 20% 都拿不到分,或者都蒙对)。rubric 制像理科大题按步给分:每一步有独立的判据、独立的核查说明,判官逐条对照——部分完成得到部分分,弱模型的每一点进步都可见。这与本站判分器线的老结论在评测侧重逢:测量粒度决定信号质量(MT-Bench 篇的一致率框架、Demystify 篇的 12 模式分类学、本篇的 rubric 分解——同一根杠杆撬三个场景)。
全篇就看这张:图 135——判官审计的三口径对照(κ 0.508 → 0.788 → 0.849),它单独撑起「评测方法学」这块主贡献。
形式化入口(§4.2 p.7):每条轨迹 i 的得分 s_i 是其 rubric 的平均通过率,效率定义为每步得分:
\text{Traj.\,Eff.} = \frac{1}{N}\sum_{i=1}^{N}\frac{s_i}{n_i}
其中 n_i 是任务 i 的步数。与导航文献的 SPL(Success weighted by Path Length)不同——没有 oracle 最优步数可除(§4.1 p.8:「we do not know the oracle number of steps required for each task」),所以这是效率的保守下界口径。它把问题重新形式化成了什么?从「任务成功率排序」变成「成功率-步数平面上的帕累托前沿」——图 3 里 GPT-5.4 靠步数少占住前沿一角,效率从附加题变成主考题。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:Cohen’s κ 与混淆矩阵为标准统计量;SPL 为导航评测标准指标(Anderson et al. 2018,论文引);其余见文首核对状态块。
3.1 第一件:κ 的账——一致性为什么必须扣掉「碰巧一致」
先摆问题。判官说 75% 的轨迹成功,人类也说 75% 成功——它们一致吗?不一定:如果人类真值是 90% 成功、判官乱猜 75%,也有大量碰巧重合。朴素一致率(accuracy)会被「双方都说是」的基线抬高。
活路:Cohen’s κ 把「碰巧一致」扣掉:
\kappa = \frac{p_o - p_e}{1 - p_e}
其中 p_o 是实际一致率,p_e 是随机下期望一致率(边缘分布的乘积和)。κ=1 全对、κ=0 等于乱猜、κ<0 比乱猜还差。白话:κ 衡量的是「在排除了运气之后,两个评分者真正共享了多少判断」。论文 Table 3 的读数:逐条 rubric 判 κ=0.788(「substantial agreement」档),perfect 口径 0.849,整卷判 0.508(「moderate」档下沿)。数值例(贯穿示例):Palm Springs 任务 8 条 rubric 判官判过 7 条——逐条口径下这 8 个判定各自与人类对照(每个都是独立的 κ 观测);整卷口径下整条轨迹只有一个对勾或叉——信息量差 8 倍,误差却不减。
3.2 第二件:分解判为什么赢——误差的稀释与注意力的稀释
先摆问题。整卷判输在哪?论文给的数据:整卷判的召回只有 0.696(人类认为成功的轨迹,判官三成漏判成功),精确率倒有 0.842——它倾向于把部分成功压成失败。机制上这是必然的:整卷判要求判官同时注意 K≈6 条判据的满足情况,注意力被摊薄;且二元口径把「部分完成」这个最常见的结果强行二值化,判官只能按整体印象押注。
补充(把机制说成可算的模型):设判官对单条 rubric 的判定错误率为 e,整卷判不是 K 次独立判定,而是一次对「整体完成度」的估计再过阈值——它的误差不随 K 平均,反而随 K 增长(要看的东西多了,每条分到的注意力少了)。逐条判的聚合误差按 \frac{e}{\sqrt{K}} 收缩(K 条独立判定取平均)。这就是「分解」的全部数学优势:把一次大噪声判定,换成 K 次小噪声判定的平均。数值例:e=0.08、K=6.1 时,逐条聚合的标准误 ≈ 0.08/√6.1 ≈ 0.032——比单次整卷估计的噪声(≈e 量级)小一半以上。本站复现把这本账跑成了机器实验(§十 P0:分解口径比整卷 κ 高 0.244,与论文差 0.28–0.34 同向)。
3.3 第三件:效率的分母——为什么 Traj. Eff. 是保守下界
先摆问题。效率 = 得分/步数,听起来平凡,但分母用哪个步数有讲究。导航文献的 SPL 用「专家最优步数」归一(得分 × 最短路/实际路),本篇没有 oracle 步数——「we do not know the oracle number of steps required for each task」(§4.1 p.8)。
活路:直接用实际步数做分母,s_i/n_i。这个口径的三个性质:①跨任务可比性弱(任务天然步数不同)——所以论文取全任务平均而不是逐任务排名;②它是 SPL 的下界——若补上 oracle 归一,效率只会更高;③它惩罚「磨穿」——Opus 部分分运行平均 97.4 步(§4.3 p.9),每一步都在稀释它的效率读数。数值例(贯穿示例):Palm Springs 任务 8 条 rubric 判过 7 条(s=0.875),若 40 步完成,Traj. Eff. = 0.875/40×100 ≈ 2.2%——远超 Opus 全任务平均的 1.06%,因为它一步没磨。段末微问:为什么 GPT-5.4 的 Eff(1.15%)比 Opus(1.06%)高,perfect 反而低(33.5 对 44.5)?——因为它平均 2.03 个动作挤在一个模型回合里(49.1% 的回合多动作,最多 24 个,§4.1 p.8),同样的活、一半的回合数——分母小了一半。这就是「批处理」的效率红利,复现 P4 机器化了这笔账。
3.4 整体收拢
三件工具一条链:κ 扣掉运气才见真一致(3.1)→ 分解把一次大噪声换成 K 次小噪声的平均(3.2)→ 效率把「成了没」扩展成「每步换回多少」(3.3)。回到这篇:三者合起来是长时程评测的完整测量论——信度靠分解、效度靠人工审计、价值靠效率。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| s_i | 任务 i 的 rubric 平均分(0–1) | §4.1 p.8 |
| n_i | 任务 i 的步数(环境步=一次观察-动作循环) | 式 1 p.8 |
| \text{Traj.\,Eff.} | \frac{1}{N}\sum_i s_i/n_i(×100 读) | 式 1 p.8 |
| \kappa | Cohen’s 一致系数(扣运气的一致率) | Table 3 p.6 |
| rubric | 评分细则:requirement + verification description | §3.3 p.5 |
| journey | 标注者圈定的真实浏览旅程 | §3.1 p.3 |
| CUAfy | 任务改写为对 agent 的自然口语请求 | §3.4 p.5 |
| K_eff | (补充记号)有效独立难度组数——本站复现分析用 | §六.1 |
五、机制
5.1 机制一:出题管线——考卷从浏览行为里长出来(§3.1–3.4 p.3–5)
管线四步。①采集:248 名美英 Prolific 标注者装一个桌面应用,读自己的 Chrome 历史,用 Chrome Journey 算法把浏览活动切成带 URL 的任务段——2,380 条旅程(§3.1 p.3)。②精炼:标注噪声大(与 URL 无关的标签、欠指定、描述含糊),两阶段精炼(LLM 筛 + 作者人工审)滤掉标签不准/不可行/要登录墙/质量差的,剩 696 条(29.2% 存活率)。③组合:真实旅程天然偏短(Journey 算法切得碎),按嵌入相似度聚类,GPT-5.4 把相关旅程串成连贯的多步工作流,每条源旅程至多用 3 次防过度代表;作者逐条检查长链并去重;拒收跨站点少于 2 个、rubric 不全、连贯性低于 2/5 的。④补齐与改写:作者手写 30 条 + LLM 按人工样例再生成 80 条(人工审筛)= 200 条;最后全部 CUAfy——把抽象的信息收集描述改写成对 agent 说的自然口语(第一人称动机、具体站点与参数、无编号列表、浏览器可见的要求如「把页面留在标签页里」「并排比较」),rubric 与步骤同步再生(§3.4 p.5)。
拆一个部件看后果(拆部件反证):假设不做 CUAfy、直接把组合出的步骤清单给 agent——考的会是「读清单执行清单」,退回 OSWorld 式的工作流跟随;CUAfy 后任务变成「帮我安排一场婚礼行程」(不列步骤),agent 必须自己分解目标、决定探索顺序、判断何时交付——长时程的三个核心能力(维持上下文/跨站推理/停止决策)正是改写这一步放进考卷的。代价也在这:改写由 LLM 完成,题目与 GPT-5.4 家族的出题风格同源——应考模型里有 GPT-5.4 自己,考卷的家族中立性打了折扣(§九.6 登记)。
5.2 机制二:判官审计——三个口径与人类对照(§4.1 p.6,Table 3 p.6)
这是全文的方法论核心。实验设计:120 条 Opus 4.6 轨迹,人类标注者逐条判断每条 rubric 是否满足(附录 A.11 给了标注界面);然后在三个口径上算判官与人类的一致性——①逐条口径:每个「任务×rubric」对当独立观测(共 1,225 对量级);②perfect 口径:任务级二值(全部 rubric 过才算过);③轨迹级口径:Online-M2W 的整卷二元判官。结果(Table 3 p.6):逐条 κ=0.788 / F1=0.949 / acc=0.923;perfect κ=0.849 / F1=0.934;整卷 κ=0.508 / F1=0.762 / acc=0.752。论文的读法:「rubric 评分与人类一致性好得多」,且 perfect 口径 κ 最高——两句话,第一句有机制支撑(§3.2 的注意力稀释),第二句论文没解释(本站复现四轮未再现该排序,§十 P1 如实登记)。
判官本身的四件配套值得记录:判据由 LLM 生成时同步产出「验证说明」(怎么核查);作者逐条验证正确性;另跑一个带文本搜索工具的 LLM 交叉核查验证标准与 live 网站现状的一致(§3.3 p.5);判官模型全程统一(gemini-3.1-flash-lite-preview)。补充:这四件加人类审计构成完整的「判官溯源链」——判据从哪来、谁验过、与现状核对过没有、与人类差多少。MyPCBench 精读转引的「已审计验证」指的就是这条链,今日销账。
5.3 机制三:难度悬崖与步预算 sigmoid(§4.3 p.8–9,Table 4/Fig 4)
难度轴(Table 4 p.9):Opus easy 97.8% → medium 71.7% → hard 11.0%;GPT-5.4 80.0/58.7/3.7;Sonnet hard 只有 1.8%。注意 easy 档几乎全模型都会(除 UI-TARS 4.4%),hard 档(109 题,占一半以上)是有效考卷——这回应了「饱和」的批评:不是 agent 太强,是旧考卷太浅。步预算轴(Fig 4 p.9):所有模型的 perfect 率-步预算曲线都是 sigmoid 形——前 15 步近零(最简单的任务也需要最少交互步数),20–70 步爬升,80 步后趋平。200 步消融(附录 A.9):Opus 完成率大幅上升、Qwen 不动——frontier 的短板是预算与效率,open-weight 的短板是能力本身。补充:与 与 MyPCBench 的跨应用轴合读,两篇各给了一根「难度轴」(应用数/难度档),共同的形状是合取惩罚——perfect 跌得比部分分快,MyPCBench 比值 1.54、本篇复现比 1.22——合取-均值分解方法在第三域再次现身。
5.4 机制四:失败是模型指纹,成功也是(§4.3 p.9)
失败侧的家族分工比 MyPCBench 更细:Opus 的签名是过度研究不交付——持续收集信息但从不转入产出交付物,12 次零分里 6 次是这个模式;39% 的任务撞 100 步上限,部分分运行平均 97.4 步(§4.3 p.9)——磨到死。GPT-5.4 的签名是有计划不动手——7 次零分里 4 次生成了正确指出该访问哪些页面的详细计划,然后空动作终止,有的连浏览器都没碰(§4.3 p.9)——想完了不做。共同弱点是高扇出:需要访问 10–30 个场馆的任务(如环游 30 个棒球场),两个模型都卡在第一阶段(收集赛程),走不到订机票订酒店做文档——论文的处方是 subagent/多 agent 分工(§4.3 p.9–10)。
成功侧的「惊喜能力」更有信息量(§4.3 p.10):GPT-5.4 会把整张表编码成 base64 字符串塞进 Python 动作、运行时解码再经剪贴板粘贴(保留制表符与换行,一次粘贴填完表格,8 次);页面渲染坏时改走 view-source: 协议、ctrl+f 搜源码里的 JSON-LD 结构化数据(23 次)。Opus 被 403 时构造 Wayback Machine 存档链接取缓存页;中键开后台标签保住当前位置(131 次 vs GPT 的 7 次);ctrl+f 搜不到关键词时把「没有匹配」当作页面无价值的证据直接离开——用搜索做假设证伪。补充:这些行为没有一个是训练目标里写明的——它们是长时程压力下涌现的工具重组。对训练侧的含义:这些模式值得被固化为技能(AWM 篇的归纳对象),对评测侧的含义:它们是游戏性审计的新对象(view-source 与 Wayback 都在绕过网站预期用法——论文伦理声明主动点名了这两条)。
5.5 机制五:效率的一等公民化(§4.1 p.7–8,Fig 3 p.8)
「一个 100 步的轨迹要花 Opus 4.6 约 30 分钟真实时间(脚注:约 $2.5/任务),远超人类愿意等的时长」——效率不是工程细节,是可用性边界。Traj. Eff. 读数(Table 2 p.6):GPT-5.4 1.15% 登顶、GPT-5.4 mini 1.12%、Opus 1.06%——注意 mini 与 Opus 的 Eff 几乎持平而 perfect 差 4 倍多(10.5 对 44.5)——mini 用 41.7 步干 Opus 81.3 步的活(部分分口径下),帕累托前沿上各有位置(Fig 3 p.8)。机制:GPT-5.4 的多动作批处理——49.1% 的回合返回多个动作,「经常预测接下来几个 UI 状态,把对应动作排好队再要新截图」(§4.1 p.8)。补充:批处理是「训练或提示即可得的效率红利」——它与 LATTS 的接受准则(把验证器做成接受概率)、Damani 的预算分配同属「测试时算力治理」族谱,但维度不同:那两篇管「给多少」,这篇管「每回合装多少」。
5.6 最值钱的实验
如果只看一组实验,看 Table 3 的判官审计——它单独撑起「评测方法学」这块主贡献,并且给出了可直接迁移的设计规则(长时程评测必须逐条判)。第二值得看的是 Fig 4 的步预算 sigmoid 与 200 步消融的组合:它把「多给预算能不能救」变成了可回答的问题——frontier 能(Opus 大幅上升),open-weight 不能。
六、数学展开
6.1 perfect κ 之谜:一个论文未解释的排序(接 §三.2)
§3.2 留了一笔账:perfect 口径 κ(0.849)为什么高于逐条 κ(0.788)?先把直观说清:perfect 判定 = K 条判定全对才判「过」,单条 7% 的错误率经合取复合后,假阴性率应升至 1-(1-0.07)^{6.1}\approx 35\%——合取应该让 perfect 更脏才对。论文没有解释。本站复现把这个谜机器化了:四轮实验(逐条独立误差/轨迹级质量因子/难度分层/双模式判官——§十.3),三种可信机制都无法在合成世界再现「perfect κ > 逐条 κ」的排序(最好 0.497 对 0.777,差 0.28)。回到数据本身:0.849 与 0.788 的差 0.061,在 n=120 轨迹、逐条 n≈730 观测下,κ 的标准误约 ±0.05–0.07——这个排序在 1 个标准差边缘,可能只是抽样波动。补充的推断:若真有机制,最可能是「全过任务有清晰的完成态(交付物在屏幕上),判官看终态即可确认,单条误差在真全过轨迹上负相关」——但这需要论文开放逐条判定明细才能检验(未攻克登记)。本站的立场:引用 perfect 口径时注明「该排序未获机制解释,抽样噪声边缘」。
6.2 效率指标的偏与补(接 §三.3)
Traj. Eff. 的口径缺陷有两个,各有补法。缺陷一:跨任务可比性弱——任务天然步数不同,s_i/n_i 的大值可能只是任务短。补法:论文按全任务平均(不逐任务排名),且配了成功率-步数的帕累托图(Fig 3 p.8)双读。缺陷二:分母不封顶——磨穿型轨迹(Opus 97.4 步)的效率被稀释,但「提早放弃」的轨迹步数小、若碰巧有几分效率反而好看。补法:与 perfect 口径联读(磨穿的零分轨迹 Eff=0,天然被罚)。补充的推断:理想的效率指标应是 s_i/\hat{n}_i^{oracle},而 oracle 步数可以用「同任务最快成功轨迹」近似——200 个任务里有重复主题的话可估;论文没做,这是可做的增量(未攻克登记)。
6.3 出题管线的存活率账(接 §5.1)
2,380 → 696(29.2%)→ 组合拒收 → 200。补充:把每段的存活率连乘能反推管线各环节的严格度——精炼段淘汰 70.8%(标注噪声是主敌),组合与补齐段的整体存活率论文未报单段数字(只给拒收标准)。与 MyPCBench 对读:那篇 2,749 条社区请求 → 184 任务(6.7% 存活),本篇 10.9%(2380→260 中两段,含 30+80 条非组合来源)——考卷的稀缺性不在题源而在质检,两篇的淘汰率都超过 85%。这与本站的复审纪律同构:G1 抽查、G8 审计的淘汰率同样是产出可信度的组成部分。
6.4 整体收拢
三笔展开账:perfect κ 之谜定性为「未解释读数 + 抽样噪声边缘」(6.1)→ 效率口径的两缺陷与补法(6.2)→ 存活率账揭示「质检即稀缺」(6.3)。回到这篇:它的可信度不建立在「数字大」上,而建立在「测量装置被审计过」——这正是考卷线与判分器线共享的价值观。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| rubric 逐条判 vs 轨迹级判官 | 已懂(Table 3 本篇核心) | κ 0.788/0.849 vs 0.508;判官溯源链 |
| 合取-均值分解 | 已懂(第三域) | 难度轴复现比 1.22(MyPCBench 跨应用轴 1.54) |
| Traj. Eff. 与 SPL | 已懂概念/未读 SPL 原文 | 无 oracle 步数的保守口径 |
| METR 时间时程 | 待补 | 长时程能力的人类时长度量,2503.14499 未读 |
| Online-Mind2Web | 待补 | 轨迹级判官的出处(本篇对照物),未读 |
| rubric-as-rewards 线 | 待补 | Gunjal et al. 2026(ICLR)——rubric 用于 RL 训练,§3.3 转引 |
| MyPCBench / OSWorld 2.0 | 本站种子 29/21 | 判官四纪律与部分分窄带的上下文 |
八、扩展与发散
8.1 连一连:考卷线三篇合读——出题、给分、审计的分工
发散:三篇各占一环。MyPCBench 管出题的个人化(persona 种子长出考卷),Odysseys 管出题的真实性(浏览史长出考卷)与给分的粒度(rubric 逐条),OSWorld 2.0 管给分的口径(部分分窄带+双向审计)。合起来的考卷方法论已经完整:题从真实行为来(Odysseys 的 journey / MyPCBench 的 OpenClaw 请求)、分按合取与均值双读(OSW2/两篇共通)、判官要有人工审计(本篇 Table 3)。缺的一环是考试安全——rubric 与判官 prompt 公开(两篇都公开)意味着投毒面公开,BadJudge 的攻击剧本可以直接移植。回到这篇:判官审计实验本身也可以被攻击者用来反向优化「人类看不出但判官看得出」的轨迹——审计报告同时是攻击端的评估基准,这是评测方法学论文少有人点破的自指风险。
8.2 连一连:stop 的两种死法与 STOP 节点的两侧
发散:Opus 磨穿(39% 撞上限、过度研究不交付)与 GPT-5.4 停早(计划后空动作)是同一枚硬币的两面——停止决策缺少外部锚点。IAL 篇给的判据是「退出条件谁控制、盖不盖得住」;LATTS 给的机制是「把验证器做成接受概率,stop 是算力分配的读数」;本篇给的是现象学大样本(两种死法各成家族签名)。三篇合读,STOP 节点的完整处方浮现:停止信号不能是自评(GPT 的死法),也不能是无预算上限的探索(Opus 的死法),必须是「外部验证器+预算分配」的组合——验证器说达标且预算未耗尽才停。回到这篇:Traj. Eff. 恰好是这个处方的评测侧读数——磨穿压 Eff、停早压 perfect,两者同低才是健康的停止行为。
8.3 惊喜能力与游戏性审计的边界
发散:view-source 取证、Wayback 回退、base64 剪贴板注入——这些「惊喜能力」在能力侧是涌现的创造力,在安全侧是规则规避的原型。论文的伦理声明主动点名了后两者「repurpose browser primitives in unintended ways」(p.11)——这是难得的自觉。但自觉不等于审计:这些行为出现在成功轨迹里时给分、出现在失败轨迹里时不扣分,考卷没有对「手段正当性」的 rubric 项。与判分器线合读:BadJudge 篇的「改评分标准骗裁判」、RIPD 篇的「rubric 编辑攻击」都在问同一个问题——评分系统reward什么,就会被生产什么。回到这篇:给考卷加「手段正当性」维度的 rubric(如「仅通过可见 UI 完成」——MyPCBench 已有雏形:它的捷径失败模式就是判这个的),是两篇考卷的自然合流点。
8.4 常见误读(破)
「44.5% 说明 agent 快能干长活了」。三层拆解:①44.5% 是 easy+medium 撑起来的——hard 档(109 题,过半)只有 11%,难度加权后的「真实长时程能力」接近 20% 量级;②效率同期只有 1.15%——就算成功,30 分钟的墙钟时间对人类协作场景不可用;③live-web 单次运行无方差,站点当天状态就是隐藏变量(论文自认「scales but introduces grading noise」的是整卷判,站点波动是所有 live 评测的共同噪声源)。引原文自证:「leaves substantial room for future improvements」(摘要 p.1)——作者自己的措辞是留有余地。
「rubric 判官既然 κ=0.788 就可以直接用了」。三个前提别丢:①审计只在 Opus 4.6 的 120 条轨迹上做过——其他模型的轨迹风格不同(GPT 的批处理动作、Qwen 的畸形调用),判官一致性是外推;②rubric 是 LLM 生成、作者验证的——判据质量上限由出题人决定,rubric-as-rewards 用于 RL 训练时会放大这个上限问题;③κ=0.788 意味着仍有两成多的判断分歧——用于高 stakes 场景(上线决策)时需要人工兜底。审计报告是「测量装置的检验证书」,不是「永久免检标志」。
8.5 写作之维(论文自己怎样完成说服)
标题用了一个词干两次的句式——「Benchmarking Web Agents on Realistic Long Horizon Tasks」——把卖点(realistic + long horizon)直接写进副标题位。摘要的数字排布顺序是精心设计:先立 200 任务与真实浏览史的出处(可信度),再给 rubric 的一致性优势(方法论),再给 44.5%(差距),最后给 1.15%(新问题)——四句各完成一次说服转折。Fig 1 的修辞功能是把「部分分」可视化成 8 条 rubric 逐条打勾的清单(7/8、88%)——读者第一眼看到的是「这个评测能说出差多少」,而非「过了没」。Related work 的排布先承认对手的合理性(「precise but difficult to scale」给执行式、「scales but introduces grading noise」给轨迹判官)再立己方——先破后立的教科书式排布。全文最动人的细节在致谢:感谢「curating vegetable-free lab lunches」的同学——一篇讲长时程工作的论文,保留了人的温度。
九、局限与可疑处
- 判官审计只覆盖 Opus 轨迹:120 条人工标注全部来自 Opus 4.6——其他模型(批处理的 GPT、畸形的 Qwen)的轨迹风格不同,判官一致性对该轨迹分布是外推。
- perfect κ > 逐条 κ 未解释:0.849 对 0.788 的排序无机制说明,本站复现四轮未再现,差异在 n=120 的抽样噪声边缘(§六.1)——引用该口径时应附注。
- 每格单次运行、无方差:Table 2 八模型无重复、无置信区间(沿用 MyPCBench 口径的自查项)。
- 出题与应考的同族相关性:任务由 GPT-5.4 组合生成,应考模型含 GPT-5.4——出题风格 familiarity 未讨论、未消融。
- live-web 的站点漂移:任务在不同日期跑,站点状态不同(价格、库存、布局);200 任务的「同一考卷」在时间上并不严格同卷。
- rubric 加权缺失:本篇 rubric 无权重(等权平均),与 MyPCBench 的作者加权不同——重要判据与琐碎判据同价。
- 人类标注者数量与一致性未报:标注者间 κ(人类彼此的一致性)未给——审计缺「人类基线」这一行,无法判断 0.788 离人类上限多远。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要 live-web + 八个商用模型 + 120 条人工标注。本复现是判官噪声模型的合成演绎:2000 任务 × 逐条判官(灵敏度/特异度+轨迹级质量因子+rubric 难度分层+双模式)vs 整卷判官(完成度估计+阈值模糊)vs 人类标注(真值±看漏),按论文 Table 3 的三个口径算 Cohen’s κ,另演绎部分分信号、难度合取坡、批处理效率。全部纯 CPU、LCG 确定性。不冒充论文数字。
10.2 可证伪预测与判据(运行前预登记,详见脚本文件头)
- P0 分解判一致性:最优分解口径的 κ 比整卷判高 ≥0.15(论文差距 0.28–0.34)。
- P1 perfect 口径 κ 最高(论文 0.849 > 0.788)。
- P2 弱任务部分分:低完成度任务(0<score<0.4)中整卷判零分率比逐条判全零率高 ≥0.3。
- P3 难度合取坡:hard 档 perfect 降幅 > rubric 降幅 且比 >1.2。
- P4 批处理效率:2.03 动作/回合的 agent 回合数折半、Eff ≈2.03×。
10.3 实现演化(四轮,如实登记)
轮 1(3/5):逐条独立误差模型——P1 反向(perfect κ 低于逐条)。轮 2(4/5):加轨迹级质量因子 g(判官误差在 rubric 间正相关——顺的轨迹条条判准)+ easy 真值上调(论文 Opus easy perfect 97.8% 口径)。轮 3(4/5):加 rubric 难度分层(80% 清晰型+20% 边缘型,人类与判官都对边缘条拿不准)。轮 4(冻结,4/5):双模式判官(g 决定准确/标准/噪声三档,任务级判定误差几乎完全由轨迹层决定)。P1 四轮三机制未再现,如实 FAIL:任务级全过判定在独立或正相关噪声下是 K 条判定的合取,假阴性率随 K 复合,数学上难以超过逐条口径;论文未解释该排序;0.849 vs 0.788 的差异在 n=120 的抽样噪声边缘(κ 标准误约 ±0.06)——该排序可能是抽样波动而非稳定机制性质。此为对论文未解释读数的稳健性质疑,登记为复现产出(与「σ 假说被模型否定=真发现」同一处置)。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_odysseys.py,真实输出
repro/repro_odysseys_output.txt(轮
4 冻结,sha256 前 16 位 55ca2bcde9822bee)。5 断言 4 PASS /
1 FAIL,[Re*] 部分成功。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 分解判一致性 | 逐条 0.788 / perfect 0.849 / 整卷 0.508(差 0.28–0.34) | 逐条 0.777 / averaged 0.752 / 整卷 0.532(最优分解差 +0.244) | 同向同量级;合成世界口径干净故差距略小 |
| P1 perfect κ 最高 | 0.849 > 0.788 | 0.497 < 0.777 | 四轮三机制未再现——论文未解释该排序;差异在 n=120 抽样噪声边缘;登记为稳健性质疑 |
| P2 弱任务部分分 | §4.1 定性:弱模型整卷判下全零 | 整卷零分率 0.906 vs 逐条全零率 0.000(n=344) | 机制复现(整卷判把部分完成压成全零) |
| P3 难度合取坡 | Opus easy 97.8→hard 11.0(rubric 87→53 缓跌) | Δp 0.436 vs Δr 0.363,比 1.22 | 合取惩罚第三域再现(MyPCBench 1.54、跨应用轴同构) |
| P4 批处理效率 | GPT-5.4 2.03 动作/回合、Eff 1.15% vs Opus 1.06% | 批处理 Eff 1.434% = 2.03× 单动作 0.707% | 精确复现(回合数折半→Eff 翻倍) |
算力与工作量:MacBook 纯 CPU,单轮 <2 秒;四轮演化约 1.5 小时。 What was easy:P0/P2/P4——判官噪声模型一次成型,分解判的优势是数学性质(大噪声一次 vs 小噪声 K 次平均),合成世界稳定重现。 What was difficult:P1。四轮三种机制都无法让 perfect 口径超过逐条口径——因为合取的数学结构性偏置(假阴性复合)是真实的,论文的相反排序需要「误差在任务内负相关」的强假设或抽样波动来解释。复现卡壳处即论文未解释处。 给下一个复现者的建议:不要试图精确复现 Table 3 的三个 κ 值(参数空间过大且论文未给判官误差模型);复现目标是排序与差距的方向(分解 > 整卷),把 perfect vs 逐条的排序当作待检验的独立假说而非已知事实。
结论:[Re*] 部分成功——分解判优势、弱任务部分分、难度合取坡、批处理效率 [Re] 兑现;perfect κ 排序 [¬Re] 未再现(归因:论文未解释 + 抽样噪声边缘——登记为对论文读数的稳健性质疑,非代码缺陷)。
十一、方法论提炼与迁移
模式一:判官分解审计(Judge Decomposition Audit)
- 操作定义:凡用 LLM 判官评整体质量的场合,把整体判定拆成 K 条独立小判定逐条判,并定期抽样做「判官 vs 人类」的分口径一致性审计(逐条/perfect/整卷三口径对照),以 κ 与 F1 报告——测量装置本身是被测对象。
- 成功判据:逐条口径 κ 比整卷口径高 ≥0.15 且召回差距显著(首例:0.788 vs 0.508、召回 0.960 vs 0.696);审计报告随评测一起发布。
- 首例与数字:Odysseys Table 3(120 条 Opus 轨迹、3 口径、κ 0.788/0.849/0.508)。本站复现 [Re*] 4/5 同向(+0.244)。
- 迁移去向:①客服质检——把「这通服务好不好」拆成确认身份/解决问题/无超卖承诺等逐项判,判官+人审分口径对照;②简历筛选审计——拆成学历核验/经验匹配/技能核验逐项,防整卷印象判;③医疗影像 AI——整片良恶性判 vs 病灶级逐项判分别与人医对照。
- 失效边界:分解过度时条目间强相关(一条没做导致十条挂)→ perfect 口径塌缩(本站复现 P1 的教训:合取的假阴性复合是数学真实的);审计样本偏一个模型时结论外推有限(首例只审 Opus);rubric 本身的效度在审计范围之外(判得准 ≠ 判得对)。
- 方法卡:
notes/method_judge_decomposition_audit.md(L1) - 层级:L1 领域具体(评测方法学)。底层原理:归因靠对照(L2)——三口径对照就是把「测量装置」放进对照实验。
模式二:批处理摊销(Batched-Action Amortization)
- 操作定义:观察-行动循环的系统里,若动作序列可预测(先验可排队的 UI 操作),把多动作打包进一个模型回合——回合数(模型调用的成本单位)按批大小摊销,而环境步数(真实成本单位)不变。
- 成功判据:每回合平均动作数 >1.5 且成功率不降(首例:GPT-5.4 均 2.03 动作/回合,49.1% 回合多动作,Eff 1.15% 登顶且 perfect 33.5% 不掉队)。
- 迁移去向:①CI 流水线——可预知的顺序命令合并成一个 shell 调用(减少调度回合);②RPA 脚本——预测连续 UI 操作打包成宏;③对话系统——追问前先批量执行确定性的信息收集。
- 失效边界:动作间有真实依赖(下一步取决于上一步的观测)时批处理出错(本篇 GPT 的批处理「forecast the next few UI states」——预测错了就错一串);环境非确定性时预排队动作失效;首例也记录了 MyPCBench 篇 Qwen 9B 的双 schema 崩塌——批处理能力本身有阈值。
- 方法卡:
notes/method_batched_action_amortization.md(L1) - 层级:L1 领域具体(agent 系统/流水线设计)。与 LATTS「接受准则即分配器」互补:那篇管回合预算怎么分,这篇管每回合装多少。
模式三:磨穿-停早双谱(Grind-Quit Spectrum)
- 操作定义:长时程系统的停止失败分布在一条谱上——一端「磨穿」(预算耗尽仍不交付,步数 97+),另一端「停早」(计划完成即收工,空动作)。诊断时先定位谱位再开处方:磨穿加交付里程碑检查,停早加外部验证器。
- (与家族失败签名(MyPCBench 方法卡)互补:那个管家族间分工,这个管单一系统在谱上的位置漂移。)
- 方法卡:并入 method_family_failure_signature.md 使用记录,不另立。
- 层级:L1 领域具体(agent 系统/项目管理——「分析瘫痪」与「过早收工」是同谱两极)。
十三、没搞懂的地方(未攻克登记)
- perfect κ > 逐条 κ 的成因:论文未解释;本站四轮三机制未再现;0.061 的差异在 n=120 抽样噪声边缘。补齐时机:论文开放 120 条轨迹的逐条判定明细(开源仓库若含即可机器检验误差相关结构)。
- 判官对其他模型轨迹的一致性:审计只做 Opus——GPT 批处理轨迹、Qwen 畸形调用的判官一致性是空白。补齐时机:开源轨迹数据上按模型分层复算(工件侧可做)。
- 人类彼此的一致性基线:标注者间 κ 未报——0.788 离人类上限多远未知。补齐时机:论文若发布多人标注的原始终表可直接算。
- 出题-应考同族效应:GPT-5.4 组合的题目对 GPT-5.4 是否更友好(风格 familiarity)?补齐时机:按任务来源(组合/手写/LLM 生成)分层的模型×来源交叉表。
- 高扇出任务的结构:10–30 场馆任务的失败是上下文长度、子目标管理还是进度追踪问题?论文归因「high-fanout task structure」但未消融。补齐时机:人工构造扇出梯度任务做对照。
十四、可信度
- A 级(论文原文转录,逐节核对):§3.1–3.5 管线与统计(p.3–5)、§4.1 评测与 Table 3(p.6)、式 1 与效率讨论(p.7–8)、Table 2(p.6)、§4.3 分析与 Table 4/Fig 4/5(p.8–9)、Fig 1/2/3/7(p.2/7/8)、伦理声明(p.11)、致谢与参考条目(p.11–13)。
- B 级(论文自报实验,无法独立验证):八模型全部读数(商用 API 单次运行)、120 条轨迹的人工标注质量(标注者间一致性未报)、判官判定明细、组合任务的连贯性评分。
- C 级(我的推导 + 复现程序化验证):§三 三本账(κ 机制/分解优势/效率分母)、§六 perfect κ 之谜与效率口径分析、复现 P0/P2/P3/P4 兑现。
- D 级(我的推断,已标注):§8.1 考卷三环分工与自指风险、§8.2 STOP 两侧处方、§8.3 惊喜能力=游戏性审计新对象、§六.3 存活率账的引申。
- 横向核实初核(2026-09-28):版本已核(arXiv abs 页,v1-only,2026-04-27 提交,无更新版);录用未标注;机构已核(Carnegie Mellon University,两位共一);工件官网与 GitHub 仓库存在性已核(摘要自述+搜索快照),内容未访问;第三方讨论未查;统计审查:Table 2 每格单次运行无方差;判官审计基于 120 条轨迹子集(按样本量自估 κ 标准误约 ±0.06);人类标注只覆盖 Opus 一个模型的轨迹(其他模型为外推);步预算曲线未标注终端差异。
- 实验充分性评价:方法论部分充分(三口径审计是完整对照实验),基准部分部分充分(单次运行、判官只审一个模型、人类基线缺失)。
- 性能支撑目标检查:goal 是「证明二元判不适长时程 + rubric 更一致」——支撑(Table 3 直接对照);「效率是一等公民」——支撑(Eff 指标+帕累托图+批处理分析);「隔离长时程能力」——仅部分支撑(出题同族效应未消融)。