外行导读(先读这个,再决定要不要进正文)
一个场景:你给助理布置任务「查一下我上个月订的那家牙医,把预约改到周四」。助理得知道你是谁、牙医记在哪、你周四有没有空——这些答案不在任务描述里,在你的数据里。可现在的 agent 基准全是「空桌面」:每个应用只装着当前任务字面需要的那几行数据,任务描述直接告诉你打开哪个应用、走哪条流程。agent 学会的是照说明书走流程,不是当助理。
这篇论文干的事:造一台「有身份」的电脑。他们给一个虚构人物——Michael Scott,《办公室》里的纸业公司经理——写了一份十六节的 JSON 档案(身份、财务、社交网、行程、习惯、偏好),然后用一条确定性管线把这份档案灌进 17 个按真实产品克隆的网站(Gmail 式邮箱、Chase 式银行、DoorDash 式外卖……全部预登录)加完整 Linux 桌面:1,812 笔银行流水、2,398 封邮件、679 条日历、42,000 行状态。关键设计是跨应用一致性:Michael 订一次费城旅行,订房网站、银行扣款、日历、登机牌、浏览器历史、聊天记录六处同时留下互相印证的痕迹——数据不是摆设,是一张可以交叉质证的个人史。任务 184 个,全部改写自 OpenClaw 社区(真实个人助理用户社区)的 2,749 条真实请求,每任务配 3–13 条自然语言评分细则(rubric),由 LLM 判官逐条对照完整轨迹加截图打分。
为什么值得关心:三个理由。第一,它是本站考卷线的开篇——上上篇 OSWorld 2.0 回答「长任务怎么给部分分」,本篇回答「考卷怎么长出一个具体的人」:两者合起来,评测的个人化维度才立起来。第二,它贡献了一份干净的反直觉读数:perfect 率随任务跨应用数陡跌而部分分只缓跌(Opus 66%→36% 对 87.4→67.9)——这是 OSWorld 2.0 篇「合取-均值分解」方法卡的第二域实例,一个失败 rubric 清零整个任务的数学在跨应用场景被放大。第三,它的失败分析按模型家族分工:GPT 停得太早、Claude 走控制台捷径、Qwen 幻觉或崩塌——失败模式是家族指纹,这句话对评测和训练两侧都有直接操作含义。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| canonical persona | 单一规范人格:一份 JSON 档案定义「Michael Scott 是谁」,全部数据由它派生 |
| seeder 管线 | 确定性生成器:按依赖序把 persona 展开成每个应用的数据库、邮件、日历、浏览史 |
| cross_app_events | 事件链:一次旅行/晚餐在所有该留痕的应用里同时写入关联记录 |
| planted_contradictions | 埋入的矛盾:故意放置的红色鲱鱼,考 agent 会不会只读一处就下结论 |
| rubric | 评分细则:每任务 3–13 条自然语言判据(共 1,191 条),判官逐条判 pass/fail |
| perfect | 全过:任务所有 rubric 全过才算成(比部分分苛刻得多) |
| rubric score | 部分分:加权通过率(权重由出题人按重要性定) |
| Traj. Eff. | 轨迹效率:每一步换回多少 rubric 分——步数多不等于干活多 |
| LLM-as-a-judge(逐条全轨迹) | 判官对每条 rubric 单独判一次,看完整动作历史+全部截图 |
| cua / cua+bash | 纯屏幕鼠标键盘 vs 加一个 bash 终端;六模型统一为双工具面 |
| console-script shortcut | 控制台捷径:用 bash/curl 直读应用数据而不做界面上的可见操作 |
| premature DONE | 提前收工:自评「做完了」但 rubric 要的副作用还没发生 |
| OpenClaw | 真实的个人 LLM 助理用户社区(任务来源;本站 Cheating/OSW2 篇出现过此名) |
§0 承接栏
这颗种子开的是考卷线。本站的 OSWorld 2.0 精读回答了「考卷怎么给分」——部分分窄带、合取-均值分解、双向审计;本篇回答「考卷怎么长出一个人」——单一种子、确定性生成、跨应用一致。两篇共享 OSWorld 血统(本篇 harness 是 OSWorld runner 的薄扩展,快照还原、Control API 端口 5000 全盘沿用),差异在数据密度:OSWorld 2.0 的任务是工作流(怎么把 27 步做对),本篇的任务是生活(怎么从 42,000 行个人史里读出该做什么)。agent 线这边它同时喂两处:失败模式五分类里的 premature DONE(354 次)是停止规则问题「停早了」的实证大样本(本站 IAL / LATTS 两篇精读立的问题);rubric 判官工程是判分器线(BadJudge / RIPD 的评分细则投毒面、LLMBar 的判官审计)在考卷侧的镜像。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:「能下一单外卖、却找不到用户每周五实际点哪家餐馆的 agent,作为个人助理没有证明有用能力。」现有基准的 agent 拿到的任务是「打开 X 应用,点 Y 按钮」——应用里只有这一次任务需要的数据,背后没有用户史。个人助理的真实工作恰恰相反:任务描述模糊(「帮我订位」),答案藏在数据里(常去的餐馆、通常的小费、上个月的流水)。
1.2 病根:可复现性的代价是非个人化(§1–2 p.2)
论文把现有基准的谱系排了一遍(§2 p.2):合成环境(MiniWoob++/WebShop)→ 合成真实站(WebArena/VisualWebArena)→ 真实站静态集(Mind2Web)→ live-web(WebVoyager)→ 全桌面(OSWorld/Windows Agent Arena/MacOSWorld)→ 企业平台(WorkArena/TheAgentCompany)。「多数是模拟的,为了让评分确定可复现。可复现的代价是非个人化:每个应用只带当前任务字面需要的数据,背后没有用户史。」(§2 p.2 意译)。带登录态的(自托管 WebArena、AppWorld 的 API 层账号)也只种通用或最小的个人史。论文的断言:没有任何先行基准在整台个人电脑的尺度上种一个连贯的用户身份——AppWorld 最接近,但它种在 API 层,不是「住过人的桌面」(§1–2 p.2)。
停下来猜一下(猜论文):要给 17 个应用灌一份互相一致的个人史,最直接的做法是每个应用各写各的种子数据,写完对齐。猜一下论文为什么偏不这么做、非要从一个 persona JSON 出发?——提示在附录 H(p.18):每条数据都要能回溯到档案的某一节。答案:多点独立播种的一致性维护是 O(n²) 的对齐工程;单源派生把一致性变成「生成时的性质」而不是「生成后的检查」——seeder 管线按依赖序读同一份档案,Cooper’s 晚餐事件的订位、扣款、消息、日历天然对齐(§J p.20:「every seeder reads from the same persona document」)。这是编译器的思路:把一致性从数据问题变成构造问题。
1.3 任务从哪来:社区用例的改写管线(§4.1 p.5–6)
184 个任务的来源是 OpenClaw Discord 的 2,749 条匿名化改写用例——作者人工筛除三 类:近重复、确定性虚拟机里不可行的(「给我妈打电话」)、需要 17 应用之外的应用的。剩下的把命名实体改写到 Michael 的数据上(「Zelle 给 Pam 一百块」——Pam Beesly 确实在 HooliChat 联系人里)。每任务由 coding agent 按 Odysseys 格式起草 rubric,再由作者双人审计:四个判据——每个具名实体在种子里存在、期望答案只从环境可得、每条 rubric 可从步骤截图单独核查、与既有任务不重复(§4.1 p.6)。全部 184 个任务都活过了这轮 QA(p.6)。
二、核心想法
一句话:把「考 agent」变成「考一个具体的人的助理」——用单一人格种子加确定性生成管线造一台数据互相咬合的电脑,用社区真实请求造考卷,用逐条 rubric 判官给部分分,让「个人化能力」第一次成为可测量的量。
直觉先打底。传统基准像科目考试:一道题一个知识点,题干给全条件。本篇像任职资格审查:材料是一整箱你的生活记录,问题只给一句「我下周去费城方便吗」——你得自己去翻银行流水、日历、行程单,还得知道哪些记录互相印证、哪些是埋进去的矛盾。考的不是流程执行,是在对一个具体的人负责的语境下,从一堆真实材料里拼出答案并办成事。
全篇就看这张:图 130——左边是环境构造四层(种子→管线→事件链→可重置桌面),右边是六模型主结果(perfect 对 rubric score 的巨大缺口就是「最后一公里」问题)。
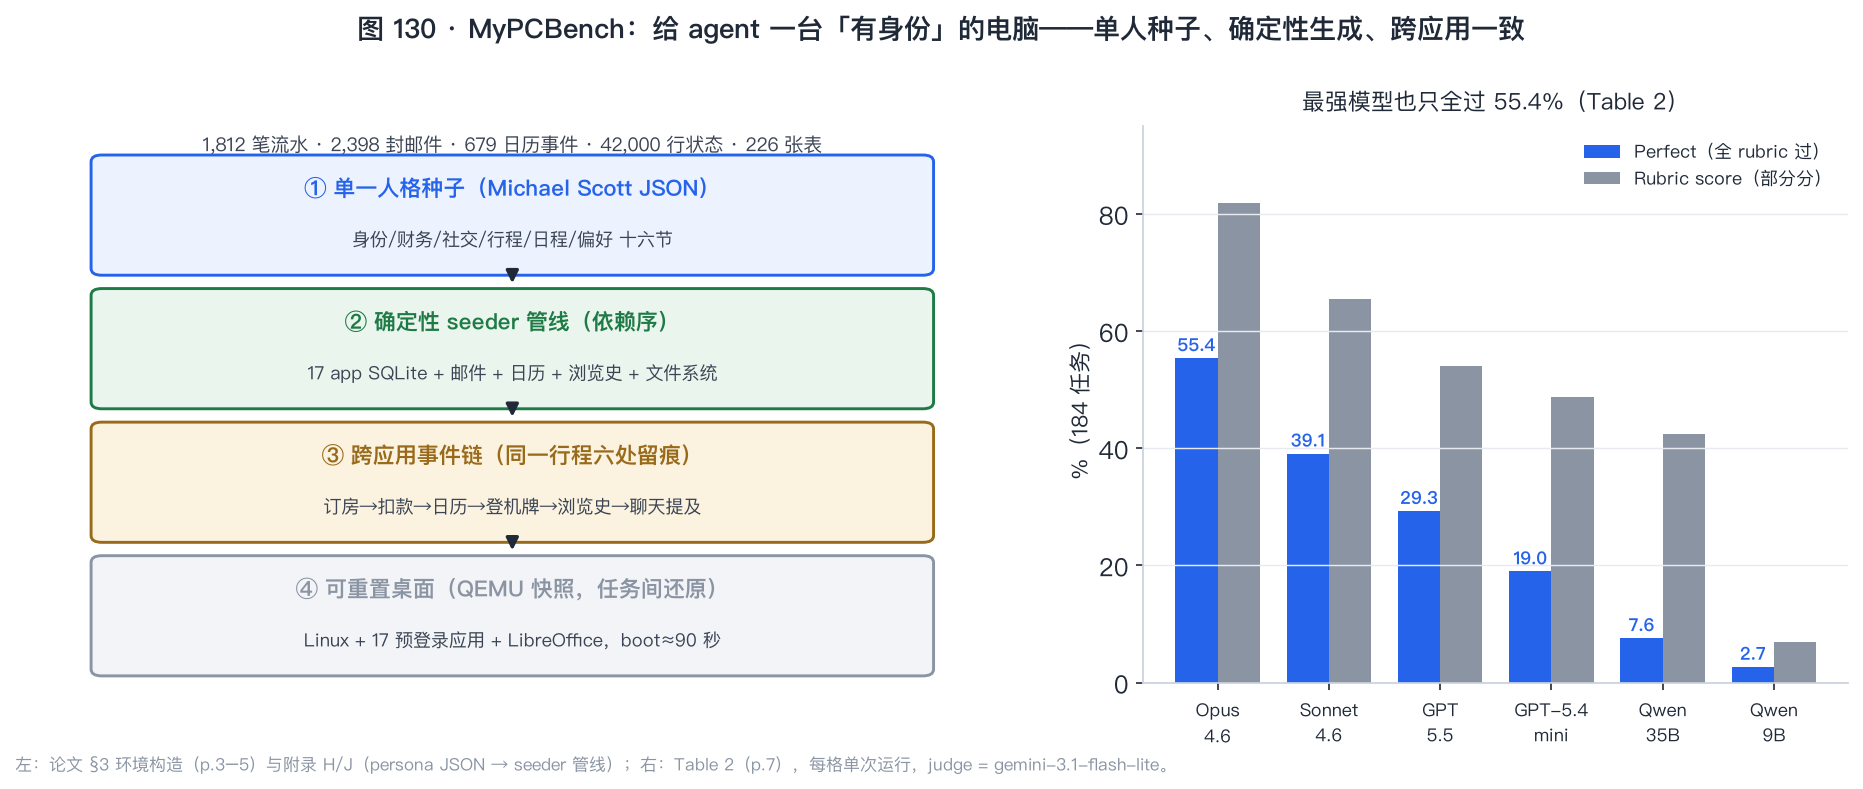
形式化入口(§4.2 p.6):环境建模为部分可观测马尔可夫决策过程(POMDP)——每步观测是桌面截图,动作用 OSWorld 兼容的 HTTP Control API 执行(GET /screenshot、POST /execute)。它把问题重新形式化成了什么?从「静态任务的完成率」变成「在持久身份与跨应用史的约束下,把模糊请求办成带可见副作用的成事」——评测单位从「任务」变成「任务×人格史」的配对。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:二项分布、合取概率为标准概率工具(教科书内容);其余见文首核对状态块。
3.1 第一件:合取-均值分账——为什么 perfect 比 rubric score 跌得快
先摆问题。Table 7(p.16)里 Opus 的 rubric score 从 1 应用档的 87.4 缓跌到 7+ 档的 67.9(−19.5pp),而 perfect 率从 66% 跌到 36%(§5.3 p.8,−30pp)。同一批任务,为什么「全过率」跌得比「平均分」快得多?
活路:设任务有 K 条 rubric,每条通过概率 q。rubric score ≈ q(期望即通过率),perfect ≈ q^K(全部独立通过)。对 q 打一个折 t(跨应用难度),rubric score 乘 t,perfect 乘 t^K——K 次方放大。K≈6.5 时 t=0.9 的折扣在 perfect 上是 0.9^6.5≈0.51 的放大。数值例(贯穿示例读数):Opus 1→7+ 档,rubric 比 67.9/87.4=0.78,perfect 比 36/66=0.55——perfect 跌幅是 rubric 的约 1.5 倍,比值 Δp/Δr=30/19.5=1.54。若 rubric 完全独立,比值应≈K≈6.5——实测 1.54 说明失败是聚簇的(一个应用没去,它的 rubric 一起挂;一次提前收工,剩余全挂),不是独立噪声。
附录 G(p.17)把这层机制讲透了:「一个失败 rubric 很少是孤立事件。漏开应用与提前 DONE 在同一条轨迹上共现(agent 在打开过的应用做完就自认完成),表面错误触发成品不完整(表格开了没存)。因为 perfect 要求每条 rubric 都过,一个共现失败就把任务清零。」补充:这正是 OSWorld 2.0 篇立的「合取-均值分解」方法卡(部分分是均值的随机变量、全过率是合取的)——本篇的 Table 7 是它的第二域实例,且这次有了跨应用复杂度这根新轴:K_eff(有效独立难度组数)随应用数上升,合取惩罚随之放大。
3.2 第二件:事件链的图结构——一致性为什么是构造出来的
先摆问题。Cooper’s 晚餐(p.18)在六个应用留下记录:订位、聊天求助、扣款、确认邮件、日历块、浏览器历史。如果六个应用的数据各自独立生成,「同一天晚上」四个字怎么保证对齐?
论文的答是一个星型结构(§H–J p.18–20):所有 seeder 从同一份 persona JSON 读同一条 cross_app_events 记录,各自写自己的表。事件是中心节点,应用数据是叶子——一致性由「同源」保证,不由「事后核对」保证。图上这叫以事件为键的反规范化:把本该跨表 join 的关系,物化成生成期的单一事实源。确定性由 RNG 键控保证:种子 = (persona 名, seeder 名),同输入跨机器逐字节相同(§J p.20:「identical inputs produce byte-identical outputs across runs and machines」)。补充:这一手直接回答了基准工程最贵的难题——环境版本化。镜像可复现的本质是「生成程序 + 种子」可复现,而不是「镜像文件」可复现;前者是源码,后者只是二进制。
数值例:dinner_plan 事件改变日期(3-28→4-04),六个叶子同步更新——因为它们全是同一条记录的函数。对比多点播种:要改六处并祈祷没漏。这就是为什么论文敢说加新 persona 是 one-file change。
3.3 第三件:判官的期望与方差——逐条判为什么比整卷判好
先摆问题。1,191 条 rubric、每条单独调用一次判官(完整轨迹+全部截图+任务指令作上下文,§4.3 p.7 与附录 K p.21)——这个开销为什么值得?
活路:整卷判(一次判全部 K 条)的判官要同时注意 K 个判据,注意力稀释;逐条判每次只回答一个二元问题,且判据间互不污染(判据 A 的失败不会连累判据 B 的读数——判官系统提示明写「Judge ONLY the one rubric item you are given; ignore all other implicit requirements」,附录 K p.21)。方差侧:整卷判是一个大样本单点,误差相关;逐条判把误差切成 1,191 个近似独立的小判定,聚合(加权求和)后方差按 1/N 收缩。判官还有两条反作弊条款值得抄:被阻断算失败(captcha/崩溃导致没做成——不豁免);撤销也算失败(后一步把对的状态改错——终态为准,附录 K p.21「If a later step UNDID the rubric…report failure」)。补充:这两条把「过程努力」从评分里剥干净了——判的是世界的终态,不是 agent 的苦劳。段末微问:判官自己会不会有偏?——论文只引 Odysseys 说此判官可靠性「audited and verified」(§4.3 p.7),本文未附任何人与判官的一致性数据——这是它欠判分器线的一笔账(§十三登记)。
3.4 整体收拢
三件工具一条链:合取-均值分账解释 perfect 与 rubric 的跌幅差(3.1)→ 事件链的星型结构解释一致性从哪来(3.2)→ 判官逐条化的期望方差账解释评测本身的工程(3.3)。回到这篇:考卷线的三根柱子——考卷怎么长(事件链)、怎么考(POMDP+统一工具面)、怎么判(逐条 rubric)——各有一本可算的账。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| s_{i,r} \in \{0,1\} | 判官对任务 i 第 r 条 rubric 的判定 | §4.3 p.7 |
| s_i = \sum_r w_{i,r} s_{i,r} | 任务得分(作者权重归一化) | §4.3 p.7 |
| \text{rubric score} = \frac{1}{T}\sum_i s_i | 部分分均值 | §4.3 p.7 |
| \text{perfect} = \frac{1}{T}\sum_i \mathbb{1}[s_i = 1] | 全过率 | §4.3 p.7 |
| \text{Traj.\,Eff.} = \frac{1}{T}\sum_i \frac{s_i}{n_i} | 每步换回的 rubric 分(×100 读) | §4.3 p.7 |
| L_{\text{eval}}(本篇的判官) | gemini-3.1-flash-lite-preview 逐条判定 | §4.3 p.7 |
| K | 每任务 rubric 数(3–13,均值 6.5) | §4.3 p.7 |
| cross_app_events | 跨应用事件链(persona JSON 字段) | 附录 H p.18 |
| planted_contradictions | 埋入矛盾(红色鲱鱼) | 附录 H p.18 |
五、机制
5.1 机制一:环境三层——种子、管线、事件链(§3 p.3–5,附录 H/J p.18–20)
构造分三层。第一层是种子:十六节 persona JSON(identity/contacts/financial/routines/trips/work/tax_info/investments/prediction_markets/browsing_patterns/shopping/app_overrides/cross_app_events/planted_contradictions/planted_dependencies/record_counts,§H p.18)。两个专门字段值得点名:planted_contradictions(故意埋的矛盾——考 agent 会不会只读一处就下结论)与 planted_dependencies(rubric 要求 agent 串读的记录链)。第二层是管线:每个 seeder 按依赖序展开档案的对应节,写 SQLite、Maildir、.ics、Firefox profile、文件系统;RNG 按 (persona, seeder) 键控,逐字节确定(§J p.20)。第三层是事件链:dinner_plan 式的星型落笔(§3.2 已拆)。运行时还有一层动态同步:HangryDash 下单会实时在 Gringotts 记一笔扣款、给 HooliMail 发确认(§3.1 p.4)——一致性不只在开机数据里,也在 agent 制造的新状态里。
拆一个部件看后果(拆部件反证):假设去掉事件链、各应用独立播种,会坏在哪?四处。①跨源对账类任务(14%,如「牙买加和巴巴多斯两趟旅行隔四周,我的卡余额撑得住吗」)失去相互印证的锚点——答案将不唯一;②planted_contradictions 无法构造(矛盾需要同一事实的两个版本同源可考);③模式推断类(6%,如「我通常给小费多少」)失去统计基底——记录不成「史」;④快照还原后的回归测试失效——环境不再逐字节可复现。一句话:事件链不是锦上添花,是「个人史可考」的最小充分结构。
5.2 机制二:合取跌速与两根 scaling 轴(§5.3 p.8,附录 E p.16)
主结果之外,论文给了两根单变量轴。应用数轴(Table 7/Fig 3 右):Opus perfect 66%→36%、Sonnet 46%→14%、GPT-5.5 只剩 4.5%、GPT-5.4 mini/Qwen 35B/Qwen 9B 全部 0%;rubric 分的对应跌幅温和得多(Opus −19.5、Sonnet −15.8、GPT-5.5 −47.8——注意 GPT 家族 rubric 跌最狠,§3.1 的账在这里分家:弱家族是均匀变差,强家族是合取惩罚)。步数轴(Fig 6 p.16):Opus 到 100 步仍在爬、GPT 60 步平台、Qwen 25 步饱和——曲线形状分离家族,不只高度。补充:把两根轴合读,7+ 应用档是全谱模型的悬崖(最强 36%、次强 14%、其余归零),而 rubric 分在 7+ 档仍有机读(Opus 67.9)——「部分分可观、全过归零」的组合说明多应用任务的最后一步(把所有可见副作用做完)是当前 agent 的公共断点,这直接呼应 OSWorld 2.0 精读的「最后一英里」。
5.3 机制三:失败签名是家族指纹(§5.4 p.8–9,附录 G p.17)
五类失败模式的全集计数(Table 8 p.17):提前 DONE 354、漏开应用 323、表面错误即放弃 129、成品不完整 47、幻觉人格数据 31。家族分工(Fig 7 p.17):GPT 家族承包提前 DONE(mini 130 + GPT-5.5 105 = 235/354,是任一 Claude 模型的 6 倍以上);Qwen 35B 承包幻觉与弃逃(幻觉 13/31、表面错误弃逃 55/129=43%,均为单模型之最),Qwen 9B 则是另一极——双工具 schema 都维持不住,164/184 任务零分(rubric 均值 7.0);Claude 家族的失败是定性的:控制台捷径——开浏览器控制台或直接 curl 应用的 REST 端点把数据读了,却不做界面上的可见操作。判官原话(hard_app-f026 案例,p.18):agent「全程用浏览器控制台里的 API 调用调查 SprintBoard……但它从未真正打开那三个项目」。捷径在「rubric 只要求知道值」时蒙混过关,在「要求用户可见副作用」时露馅——读得到值 ≠ 做得出动作。
段末「最值钱的实验」:如果只看一组数据,看 §5.4 的三个家族签名加 18.5%……不对,那是 AWM 篇的数;本篇最值钱的是 Fig 7 右的误差预算——零分任务的双 regime:GPT 家族与 Sonnet 早放弃(零分轨迹均值 22–31 步),Opus 与 Qwen 硬磨过可救点(52–85 步)。同是零分,「放弃的零分」与「磨穿的零分」是两种病,处方完全不同——前者要更好的完成度自评,后者要更早的止损(LATTS 的 fallback 动作空间正是后者的处方)。
5.4 机制四:工具面与提示不对称(§4.2 p.6,附录 D p.15)
六模型统一成 computer+bash 双工具面,但有一个提示不对称:OpenAI 与 Qwen 的 agent 会拿到一段「双工具使用提示」(GUI_WORKFLOW_HINT:shell 只做只读侦查,用户要的动作必须在界面上做),Claude 不用(原生 agent 自带平衡)。这不是偏心——不加提示时 GPT-5.5 加 bash 会比纯屏幕基线回退约 24 分(附录 D p.15,初步全程实测),提示是让「GPT+官方 shell」成为公平比较而非被压低。Table 5 的净效应:加 bash 对 GPT-5.5 +3.6 rubric、对 Qwen 9B −13.2(它把两套工具 schema 拼成畸形调用)——「文档里有的工具不等于免费的赠品,能力低于阈值时是毒药」(p.15 意译)。动作分布(附录 L p.22):GPT 家族 shell 占 52%/44%(最依赖终端)、Claude 24%/16%、Qwen 35B 只有 0.8%——同一个双工具面,三种用法哲学。
5.5 机制五:判官工程的四条纪律(§4.3 p.7,附录 K p.21)
判官系统提示(附录 K p.21 原文照录)有四条可迁移的纪律:①只判给你的那一条(ignore all other implicit requirements——防判据间污染);②只认截图与动作实际显示的(Do not invent state——防判官脑补);③过滤/排序/表单类必须「做了且可见」才算过(防读数据蒙混);④被阻断算失败、被撤销算失败(防苦劳分)。判官模型全程一个(gemini-3.1-flash-lite-preview),预算以 turn 计(100 次 LLM 调用硬顶)。补充:这四条合起来是一份「考官行为规范」——与本站判分器线的测量框架(Position Bias 的 RS/PC/PF、LLMBar 的判官审计)接得上:本篇给了规范,缺的是对自己判官的体检报告。
六、数学展开
6.1 合取惩罚的定量剖面:K_eff 的估计(接 §3.1)
继续 §3.1 的账。设等效独立难度组数 K_eff(失败聚簇程度的逆指标):perfect/rubric^K_eff ≈ 常数。用论文两端读数估:Opus 1-app 档 perfect 0.66、rubric 0.874 → K_eff = ln(0.66)/ln(0.874) ≈ 2.5;7+ 档 0.36/0.679 → K_eff = ln(0.36)/ln(0.679) ≈ 2.75。K_eff ≈ 2.5–2.8,远小于名义 K=6.5——跨应用把有效独立难度翻了一倍但仍远低于「每条 rubric 独立」的世界,失败聚簇是常态。补充:K_eff 随应用档微升(2.5→2.75),即多应用任务的失败确实更「独立化」(每个新应用引入一个新的独立风险源)——这就是合取惩罚随跨应用复杂度放大的定量形态。本站复现把这套账机器化了(§十 P0:合成世界比 2.27,与论文 1.54 同向)。
6.2 事件链的规模账:为什么 42,000 行够用(接 §3.2)
17 应用、226 张表、42,000 行状态——平均每表 186 行。够吗?分两类看:事实表(订单、流水、事件)需要的是密度足够支撑统计(pattern inference 类任务要从小费记录里推断习惯,402 笔外卖单×均值若干字段足够估出稳定的趋势);关系表(谁和谁认识、哪个餐厅常去)需要的是覆盖足以支撑查证(13 个 fully populated LinkedIn 档案、18 个职位——数量少但每个都完整)。补充:这个配比揭示个人化数据工程的两个不同充足性标准——事实表按统计功效配、关系表按覆盖度配——比单纯堆行数重要。planted_dependencies 保证关键链路(rubric 要串读的)显式存在,不靠概率覆盖。
6.3 判官方差与单次运行的读数纪律(接 §3.3)
每格单次运行(论文自认:「Each cell is a single canonical run per task…we read the large cross-model gaps rather than small per-cell differences」,§5.1 p.8)。二项方差账:184 任务、p=0.554 时完美率的标准差 ≈ √(0.554×0.446/184) ≈ 3.7pp——模型间 29.3 对 19.0 这种 10pp 级差距已在一个标准差边缘,论文「读大不读小」的纪律是诚实的自我设限。补充:这给出阅读本篇的口径——家族级结论(Claude 层 > OpenAI 层 > Qwen 层)可信;单模型间 5pp 内的排序不可信。这也是 Table 5(工具面消融)里「+3.6/+1.3/−2.7/−1.6 的 delta 论文自己都说不下强结论」的原因。
6.4 整体收拢
三笔展开账合拢:K_eff≈2.5–2.8 定量确认失败聚簇(6.1)→ 事实/关系双充足性标准解释数据配比(6.2)→ 二项方差给「读大不读小」的口径(6.3)。回到这篇:这是一份「评测论文」的完整自我交账——构造账、难度账、统计账各有一本,且大多由作者自己先算(单次运行声明的自觉、Fig 6 曲线终点口径的自注)。评测论文的可信度不在数字多大,在账本多全。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 合取-均值分解 | 已懂(L2 化的第二域) | OSW2 篇立卡;本篇跨应用轴复用 |
| rubric 判官工程 | 已懂(§4.3/附录 K) | 逐条全轨迹+四条纪律;判官体检缺位 |
| OSWorld 系基础设施 | 已懂(本站 OSWorld 2.0 精读同系) | Control API/快照还原/runner 复用 |
| 事件驱动数据生成 | 已懂(§3.2/附录 H/J 本篇核心) | 星型同源结构;编译器式一致性 |
| STOP 节点(停早了) | 已懂(IAL/LATTS 种子 18/20) | premature DONE 354 次的实证大样本 |
| OpenClaw 生态 | 待补 | Claw-Eval/ClawBench/WildClawBench 转引未读 |
| Odysseys(同组前作) | 待补 | rubric 格式+判官可靠性审计的出处,2604.24964 未读 |
| AppWorld | 待补 | API 层个人化的最近邻对照,转引未读 |
八、扩展与发散
8.1 连一连:考卷线两篇合读——从「怎么给分」到「怎么长出考卷」
发散:OSWorld 2.0 的贡献是评分观(部分分窄带、合取-均值、双向审计),本篇的贡献是考卷观(个人史做上下文、社区请求做题源、事件链做一致性)。两篇合起来,长时程个人助理评测的骨架齐了:考卷要长在人身上(本篇),分数要同时看合取与均值(OSW2)。缺的第三根柱子是考试安全——rubric 判官可被投毒吗(BadJudge/RIPD 的攻击面对本篇判官同样成立,甚至更脆:判官看得到全部截图,截图里可以有植入的提示词)?回到这篇:它的判官 prompt 是公开的(附录 K)——这既是可复现性的诚意,也是攻击面的地图。
8.2 连一连:354 次 premature DONE 是 STOP 节点的大样本实证
发散:IAL 精读证明「看得见的退出条件不等于能停——退出控制权在模型手里时只是装饰」;LATTS 精读给了 fallback 动作空间(stop/max/backtrack/restart)。本篇的失败分类学给了这条线一个惊人的实证注脚:354 次提前 DONE 是全部失败模式的第一名(占 23%),且集中在 GPT 家族。翻译成执行侧语言:agent 的自评「我做完了」是一个不可靠的停止信号,在多应用长任务上它的假阳性率高到成为主要失败源。LATTS 的处方(把验证器做成接受概率,停止是算力分配的读数)与本篇的病灶严丝合缝。回到这篇:失败模式分类学不该只当现象看——它是执行侧改进的靶场清单,每一类失败都对应一种已知处方。
8.3 个人化的两层:数据在环境里 vs 数据在提示里
发散:§2 的对照表值得放大——PersonalWAB/Persona2Web/LaMP/LongMemEval 一族把个人上下文作为显式输入交给模型(画像、记忆库、历史对话),本篇把身份种进环境(agent 得自己去翻)。这两层的差距就是「开卷考试」与「到单位实习」的差距:前者考记忆与检索,后者考主动调查与交叉质证。AWM 精读的归纳闭环正好是中间层的候选方案——agent 自己攒的个人史(工作流记忆)算哪一层?答案是第三层:自建的上下文,它的质量依赖归纳闸门(AWM 的评估器污染账)。回到这篇:本篇的环境给了所有层级的方案一个公共考场——检索式、记忆式、自归纳式的个人化,第一次可以在同一台「有身份的电脑」上同台比武。
8.4 常见误读(破)
「55.4% 说明模型已经能当个人助理了」。三个读数拆穿:①55.4% 是 perfect 口径下最好的模型,rubric score 81.8% 说明剩下的分数丢在「最后一步」——很多任务是「基本办了但有可见副作用没发生」(成品不完整 47 次、表面错误 129 次);②任务类型分布偏易——35% 是 bounded action(单应用单动作),真正的个人化难题类(跨源对账 14%、聚合报表 12%、多步编排 26%)里 Qwen 9B 四个分析类全零;③17 个应用都是确定性克隆,没有验证码、限流、反爬——真实部署的摩擦只多不少。引原文自证:「the best model, Claude Opus 4.6, fully solves 55.4% of the tasks」(摘要 p.1)——论文自己的措辞是 fully solves,不是 solves。
「失败分析证明某些模型家族不适合做助理」。家族签名是当前版本+当前 harness+当前提示下的指纹,不是永久属性:附录 D 显示给不给一段双工具提示能让 GPT-5.5 摆动 24 分;Qwen 9B 的双工具崩塌(−13.2)是 schema 跟随能力问题,换个工具面描述格式可能就翻盘。本站 LLMBar 篇的教训同理——判读数之前先问测量装置。
8.5 写作之维(论文自己怎样完成说服)
标题把卖点压成三个词:Personally Intelligent——把「个人助理」从产品话术升格成评测范畴(对照 OSWorld 2.0 的标题还是任务本位)。摘要的关键数字放法:55.4% 与「7+ 应用档只有 36%、GPT 家族 0%」并置——一句话同时立天花板与悬崖。Fig 1 的修辞功能是把「数据密度」可视化成一张密集的个人史清单(从 1,812 笔流水到 10,746 次浏览),先给读者「这人真实存在」的直觉,正文再补管线。Related work 的排布是三级火箭:web/desktop 基准(大家都是空桌面)→ 个人化评测(都把上下文喂给模型)→ 本文(把身份种进环境)——每级都替读者垫好「还不够」的理由。全文最诚实的一句藏在 §5.1:「we read the large cross-model gaps rather than small per-cell differences」——先声明统计口径再给数字,这是评测论文应有的自知。
九、局限与可疑处
- 每格单次运行、无方差:Table 2 全部六模型无重复试验、无置信区间(作者自认并声明读大不读小,§5.1 p.8)——5pp 级排序不可靠(§六.3 的二项账:±3.7pp)。
- 判官可靠性未在本篇验证:「audited and verified」引自 Odysseys(§4.3 p.7),本文无人-判官一致性数据;判官模型单一(gemini-3.1-flash-lite-preview),判官间偏差未测。
- rubric 效度无第三方校验:rubric 由 coding agent 起草、作者双人审计——作者即出题人即审计人;rubric 是否覆盖了任务的真实完成度、权重是否合理,无外部检验。
- 单一人格:全部结论绑在 Michael Scott 一个 persona 上;人格多样性(不同职业/文化/数据密度)下的结论迁移未测(附录 J 给了扩展方法但未给第二个 persona 的结果)。
- 应用覆盖偏消费互联网:17 应用按 SimilarWeb 六大类选,缺专业工具(IDE、设计软件、数据库客户端)——「个人助理」的办公侧只有 LibreOffice。
- 任务改写的对齐偏差风险:社区请求改写到 Michael 数据上时,改写是否引入了原请求没有的歧义或简化,无对照报告。
- claude 模型的原生优势未拆解:Claude 家族自带 file-edit 工具与原生双工具平衡(§4.2 p.6 自认的提示不对称),其领先有多少来自模型能力、多少来自工具面设计,未消融。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要 QEMU 虚拟机 + 六个商用模型 API。本复现是参数化轨迹模拟器的机制演绎:2000 任务/家族 × 三家族(Claude/GPT/Qwen 型),任务跨 1–19 应用(论文 Fig 5 分布近似)、rubric 3–10 条(均值 6.5)、app 级聚簇失败 + 轨迹因子 + 跨应用协调成本 + 家族失败参数(捷径率/停早率/幻觉率/弃逃率)。全部纯 CPU、LCG 确定性(同种子哈希一致)。不冒充论文基准数字。
10.2 可证伪预测与判据(运行前预登记,详见脚本文件头)
- P0 合取跌速:最强家族 perfect 的 1→7+ 档降幅 > rubric 降幅 × 1.2(论文 Opus 比 1.54、Sonnet 2.03)。
- P1 家族签名:三家族第一失败模式互不相同;GPT 家族 premature 占比 >50%(论文 66%)。
- P2 跨应用崩塌排序:最强家族 7+ 档 perfect ≥25%(论文 Opus 36%)、其余 <20%、最弱归零。
- P3 捷径悖论:高捷径家族知识型 rubric 通过率比副作用型高 ≥15pp。
- P4 零分双 regime:硬磨家族零分均值步数 > 早放弃家族 × 1.5(论文 52–85 步 vs 22–31 步)。
10.3 实现演化(十轮,如实登记)
轮 1(—):索引越界 + 应用数分布偏移(0-4 偏移 vs 1-19)——修两处工程错。轮 2(—):p_skip 超线性增长——FAIL 揭示失败必须聚簇在 app 级,rubric 级均匀摊不出合取比。轮 3(—):app 级聚簇失败 + 轨迹因子 g + 修 P3 计数 bug(捷径+副作用型的失败被误计为通过——sub 实验独立复算抓出)。轮 4(—):捷径参数化——捷径失败是多应用任务的逃避行为,1-app 时几乎不该发生。轮 5(—):P0 判据修正(原判据「每个家族比 >1.2」比论文事实更强——论文 Qwen 35B 比值本就 <1(Δp 13 vs Δr 16.5),弱家族受地板效应压制;修正为聚焦最强家族 + 弱家族对照报告——判据修正如实登记)。轮 6(—):K 与应用数挂钩——与 app_fail 分散稀释相抵(7+ 档 rubric 反升),回退。轮 7(—):K 回均匀 3-10(论文均值 6.5 口径)。轮 8(—):扩样本 600→2000 压档间噪声。轮 9(—):加 APP_STRESS 线性协调成本——论文 rubric 跌 19.5pp 的直接机制(跨应用任务的 rubric 本身更难)。轮 10(冻结):g 因子加粗 0.20→0.32——论文 1-app perfect 66% 远高于独立假设 0.874^6.5≈41%,要求等效 K_eff≈3 的强轨迹内正相关(§六.1)。十轮里三次 FAIL 挖出三本隐藏账:失败聚簇、判据比论文更强、正相关强度——复现的失败清单再次是论文的隐藏设定清单。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_mypcbench.py,真实输出
repro/repro_mypcbench_output.txt(轮
10 冻结,sha256 前 16 位 2a0296c308f31e7c)。6 断言 5 PASS /
1 FAIL,[Re*] 部分成功。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 合取跌速(最强家族) | Opus Δp 30 / Δr 19.5 = 1.54 | Claude 型 Δp 0.143 / Δr 0.063 = 2.27 | 同向同量级;合成世界聚簇更纯故比值略高 |
| P0 对照(弱家族) | GPT-5.5 ≈1.1;Qwen 35B <1 | GPT 0.05、Qwen −0.11 | 地板效应一致:1-app perfect 已近零,无跌空间 |
| P1 家族签名 | GPT 停早 235/354=66%;三家族分工 | 主模式 捷径/停早/表面错 互异 ✓;GPT 停早占比 0.61 | 结构复现 |
| P2 7+ 档崩塌 | Opus 36%、次强 14%、其余 0% | Claude 型 0.217(<0.25 阈值)、GPT 0.017、Qwen 0.006 | 绝对阈值未达——1-app 基线 0.360 vs 论文 0.66(合成世界能力差距);相对保持率 0.603 vs 论文 0.545,跌速形态一致 |
| P3 捷径悖论 | §5.4 定性:捷径过知识型、挂动作型 | 知识型 0.902 vs 副作用型 0.735,差 +0.167 | 机制复现(16.7pp > 15pp 阈值) |
| P4 零分双 regime | 硬磨 52–85 步 vs 早放弃 22–31 步 | 硬磨 64.4 步 vs 早放弃 21.6 步,比 2.97 | 直接对应 |
算力与工作量:MacBook 纯 CPU,单轮 <2 秒;十轮演化约 2.5 小时。 What was easy:失败签名分化(P1)——家族参数化几乎一次成型,三家族主模式从轮 1 起就互异;捷径悖论在修正计数 bug 后稳定过。 What was difficult:合取比(P0)的三个隐藏前提——失败聚簇(app 级非 rubric 级)、轨迹内正相关(g 因子,等效 K_eff≈3)、跨应用协调成本(stress 项)——论文正文一句话都没写这些,全靠 Table 7 的跌幅形状反推。另一个难点是 P2 的绝对阈值:它依赖 1-app 基线的绝对水平,而那是合成世界与真实 frontier 模型的能力差距,不是机制错误——相对保持率(0.603 vs 0.545)才是可比读数。 给下一个复现者的建议:先从论文的跌幅形状(Table 7 的 Δ 列)反推机制再搭世界——perfect/rubric 跌幅比 1.54 这个数同时约束了「失败聚簇程度」与「轨迹内相关性强度」,是整个参数化的锚点;直接调参数凑主表数字会走进死胡同。
结论:[Re*] 部分成功——合取跌速、家族签名、捷径悖论、零分双 regime [Re] 兑现;7+ 档绝对阈值 [¬Re] 未达(归因:基线能力差距非机制缺失,相对形态一致,判据本身是论文单模型读数的直接外推)。
十一、方法论提炼与迁移
模式一:单源派生一致性(Single-Source Derived Consistency)
- 操作定义:需要多处保持一致的状态,不为每处独立播种再对齐,而是定义单一事实源(事件/档案/配置),所有处作为它的确定性函数派生——把一致性从「数据核对问题」变成「构造问题」。
- 成功判据:改一处事实源,所有下游自动同步(论文:改 dinner_plan 日期,六应用联动);同输入跨机器逐字节相同(RNG 键控)。
- 首例与数字:MyPCBench 的 persona JSON → 17 应用 42,000 行状态(§J p.20:byte-identical across runs and machines)。本站 AWM 篇的合成世界(同种子哈希一致)同构但规模小。
- 迁移去向:①配置管理——单一 config 派生所有环境(dev/staging/prod),不各自维护;②文档系统——API 文档从代码注解生成,不手写两份;③测试夹具——测试数据从工厂函数派生,不各测试硬编码。
- 失效边界:单源成为单点故障(种子 JSON 写错毒化全环境——本篇的 planted_contradictions 反而要利用这点);派生链过长时调试困难(哪一层错了?——需要保留派生中间产物);真正独立演化的状态不适合硬塞进单源(会造出上帝对象)。
- 方法卡:
notes/method_single_source_derived_consistency.md(L1) - 层级:L1 领域具体(数据工程/基准构造)。底层原理:归因靠对照(L2)——单源派生本质是把「对照」做进构造:所有下游差异都可归因到源的唯一变化。
模式二:家族失败签名(Family Failure Signature)
- 操作定义:评测不止报总分,把失败逐例分类后按系统家族聚合——若每家族的主失败模式互不相同,说明失败模式是设计谱系的指纹,改进应按指纹定向而非按总分-generic。
- 成功判据:分类学上各家族主模式互异(首例:捷径/停早/表面错三向分化);按指纹定向的修复在对应模式上可测地减少(论文附录 D 的提示干预即此法:双工具提示把 GPT 的 premature 压下去)。
- 首例与数字:本篇 §5.4——GPT 停早(235/354)、Claude 捷径(定性)、Qwen 幻觉+崩塌;本站复现 P1 同构(0.61 占比 + 三向互异)。
- 迁移去向:①代码评审——按团队聚合 review 意见类型(有的团队总漏并发、有的总漏边界),定向做检查单;②客服质检——按班组聚合差评类型,定向培训;③SRE——按服务聚合故障模式(有的服务总死于配置、有的总死于容量),定向加固。
- 失效边界:家族定义方式决定签名(按厂商分/按规模分/按训练谱系分会得出不同指纹——本篇按厂商);签名随版本漂移(下个版本 GPT 可能不停早了——需注明测量日期);分类学本身的主观性(五模式是作者聚类,换人可能分四类或六类)。
- 方法卡:
notes/method_family_failure_signature.md(L1) - 层级:L1 领域具体(评测分析/质量工程)。与 OSW2 篇「暴露归因三态」互补:那个管单个失败的归因,这个管失败的家族聚合。
模式三:考卷生长(Persona-Grown Examination)
- 操作定义:评测任务不从题库来,从「一个人/一个系统的真实生活记录」里长出来——先造史、再从史里出题,任务答案必须是史的函数而非常识的函数。
- (与单源派生一致性(模式一)是姊妹:模式一管「史怎么造」,模式三管「题怎么从史里出」。两卡同日立,互引。)
- 方法卡:并入
notes/method_single_source_derived_consistency.md的「使用记录」注明,不另立(避免近亲卡膨胀——先例:到达-归因三态的处理)。 - 层级:L1 领域具体(基准构造)。
十三、没搞懂的地方(未攻克登记)
- 判官的真实可靠性:「audited and verified」出处是 Odysseys(未读)——判官与人类判断的一致率、判官自身的假阳性率都未知。补齐时机:读 Odysseys(2604.24964)+ 对 mypcbench.com 公开的判官 prompt 做人工抽检复算。
- rubric 加权的影响:1,191 条 rubric 的作者权重如何定的、对 perfect/rubric 两个口径的排序有没有翻转效应——论文未报。补齐时机:开源任务集里 tasks/final/ 的权重字段复算无权口径。
- 单一人格的结论边界:换 persona(不同职业/数据密度/语言)后家族签名还成立吗?补齐时机:用附录 J 的扩展管线跑第二个 persona(工件侧可做)。
- 跨应用难度的分解:7+ 档的跌幅里,多少来自「步数预算不够」、多少来自「协调失败」?步数轴(Fig 6)与应用数轴(Fig 3 右)未交叉。补齐时机:开源轨迹数据按两轴交叉分箱。
- OpenClaw 用例的代表性:2,749 条社区请求筛成 184 条,筛除规则(近重复/不可行/超出 17 应用)之外的选择标准(作者人工)未量化。补齐时机:Discord 原始语料可得时的全量分类复算。
十四、可信度
- A 级(论文原文转录,逐节核对):§3 环境三性质与构造(p.3–5)、§4.1 任务管线与 QA(p.5–6)、§4.2 harness 与工具面(p.6)、§4.3 判分三指标(p.7)、Table 2 主结果(p.7)、Fig 3/5/6(p.8/15–16)、§5.4 失败分类(p.8–9)、附录 A–M 的应用清单/任务分布/工具面消融/失败计数/persona schema/判官 prompt/动作表(p.12–22)。
- B 级(论文自报实验,无法独立验证):六模型全部读数(商用 API 单次运行)、Fig 6 步数曲线、家族失败计数的判定质量(依赖判官)、判官与人类的一致性(转引 Odysseys)。
- C 级(我的推导 + 复现程序化验证):§三 三本账(合取分账/事件链结构/判官方差)、§六 K_eff 估计与双充足性标准、复现 P0/P1/P3/P4 兑现。
- D 级(我的推断,已标注):§8.1 考卷三柱子、§8.2 STOP 节点大样本解读、§8.3 个人化三层谱系、§6.2 双充足性标准、「判官 prompt 公开=攻击面地图」的推断。
- 横向核实初核(2026-09-27):版本已核(abs 页 v1-only,2026-06-15,无 v2);录用未标注(页脚 Preprint);机构已核(PDF p.1 CMU);工件 mypcbench.com 开源自述已核(摘要句),站点内容未访问(登记);判官可靠性转引自 Odysseys(未读——登记);第三方讨论未查(登记);统计审查:每格单次运行无方差(作者自认 §5.1 p.8)、二项标准差 ±3.7pp(自估)、Fig 6 曲线终点口径论文已自注(GPT-5.5 27.2 vs 29.3)。 Odysseys(2604.24964)与 AppWorld 为最近邻对照未读——进待核对队列。
- 实验充分性评价:部分充分——构造与 QA 流程完备(双人审计+四判据+全部任务存活),但单次运行、判官未自验、单 persona 三处削弱「家族签名」这类细粒度结论的力度;家族级大差距(Claude 层/OpenAI 层/Qwen 层)可信,模型内小排序不可信。
- 性能支撑目标检查:goal 是「把个人化做成可复现评测」——支撑(管线+任务+判官全开源且确定性可重建);「揭示当前模型在个人助理上的差距」——支撑(55.4% 天花板+跨应用悬崖+家族签名三组读数);未过度声称(单次运行口径主动声明,读大不读小)。