外行导读(先读这个,再决定要不要进正文)
一个场景:用户用印地语问助手写一段 150 词以上的律师广告,第二轮要求「以指定短语结尾」,第三轮要求「包含这些关键词」——每轮的回答都必须同时满足此前所有轮次的全部约束。o1-preview 第一轮 87.7% 达标,第三轮只剩 70.7%;而且俄语掉得比英语狠得多。Meta 把 IFEval(可验证单轮指令基准)系统化扩展成多轮×多语言版本:4,501 个三轮对话、8 种语言、14 个前沿模型全部逐轮衰减。
这篇论文做了两件事。第一件:一条系统化扩展管线——把任何单轮可验证指令基准变成多轮多语版本的四步法(随机抽类型+LLM 生成续轮 → 跨轮冲突两步清除 → LLM 翻译+人审 15% 重写 → 敏感内容移除)。第二件:一套四口径准确率(指令级/对话级 × 严格/宽松)与两个纵向比率——IFR(Instruction Forgetting Ratio,前轮已遵循的指令在后轮被遗忘的比例)与 ECR(Error Correction Ratio,前轮违反的指令在后轮被纠正的比例);o1 系 ECR ~25% 一枝独秀——隐式思维链在帮它纠错。
为什么值得关心:三个理由。第一,它是考卷线多轮维度的前作:MultiChallenge 精读的四类分类学与本篇的「轮次衰减」是同一问题域的两代方案,AdvancedIF 精读的多轮携带约束直接引用它——三篇同组(Meta Yun He 线)拼出多轮指令评测的完整谱系。第二,它的四口径分解(指令级/对话级 × 严格/宽松)是评测口径工程的又一件标准工具:对话级严格口径是「累积合取」,衰减最快;宽松口径修首句引语,救回量随失败质量放大。第三,IFR 前段高于后段的「意外减速」与 o1 系 ECR 一枝独秀合起来指向同一机制:纠错(自我修正)是多轮保持的核心变量——这是本站判分器多篇精读的「判官质量」叙事在「被评模型自修正」侧的镜像。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| IFEval | 可验证单轮指令基准(Zhou et al. 2023)——本篇的扩展底座,30 种指令类型 |
| 指令级/对话级准确率 | 逐条指令达标率 vs 整轮全部指令都达标的比例(合取) |
| 严格/宽松(strict/loose) | 宽松口径去掉回答开头的引语句(「Certainly, here is…」)再评——修引语违规 |
| IFR | Instruction Forgetting Ratio——前轮已遵循的指令在后轮不再遵循的比例 |
| ECR | Error Correction Ratio——前轮未遵循的指令在后轮被遵循的比例 |
| 伪拒绝(false refusal) | 拒绝合理请求的过度保守行为(Gemini 突出) |
| 冲突指令清除 | 跨轮约束矛盾(首轮要短摘要、次轮要 800 词)的检测与剔除 |
| 累积输入 | 每轮把此前所有 prompt+response 拼接进上下文再生成 |
§0 承接栏
这颗种子接的是三笔账。第一笔:本站此前两篇精读(AdvancedIF 与 MultiChallenge)的参考文献都指向本篇——同组前作、多轮指令评测的前代方案,登记节点今天归位。第二笔是考卷线的维度补全:MultiChallenge 精读补了多轮对话的「跨轮约束携带」分类学,本篇是同一问题域的前代方案——IFEval 式可验证指令的多轮化,与 MultiChallenge 的 instance-level rubric 形成可验证/判官式两条技术路线的对照。第三笔是评测口径工程:四口径分解(指令级/对话级 × 严格/宽松)在本篇是评测协议,在评测可信度语境下是「聚合粒度×判定宽严」的二维设计空间——与本站聚合层、宽放行指纹两篇精读直接对话。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:真实用户-AI 对话多为 10+ 轮、跨语言;但指令遵循评测几乎全是单轮单语(IFEval/Arena/InfoBench 等)。约束在跨轮后是否仍被遵守(第一轮说「150+ 词」,第三轮的回答还记得吗)没有任何基准度量。
1.2 旧做法的缺口
§2 p.3:三类评测法各有短板——人评贵且不一致、模型判官依赖判官正确性且黑箱、规则判分可验证但「只到单轮单语」。Multi-IF 的定位:把规则/脚本评测(可验证指令)扩展到多轮+多语。
二、核心想法
一句话:用五步扩展管线把 IFEval「可验证指令」系统化升维成多轮×多语,再用四种准确率口径把「遵循」拆成可分别测量的四个量——多轮衰减与语言鸿沟都是这套口径下的可测现象。
直觉先打底:IFEval 之所有有效,是因为指令可机检(字数、格式、关键词);Multi-IF 继承这一点,把「多轮」做成「每轮追加一条新的可验证约束」,把「多语」做成「同一约束的七语翻译」——评测的可验证性在升维中保持。
全篇就看这张:图 174——左:六代表模型的逐轮衰减曲线(0.877→0.707 的普遍下降+Llama 8B 的陡峭掉落);右:四口径的逐轮分解(对话级严格口径崩得最快、宽松口径救回最多——两者的差就是「引语违规+衰减放大失败质量」的体量)。
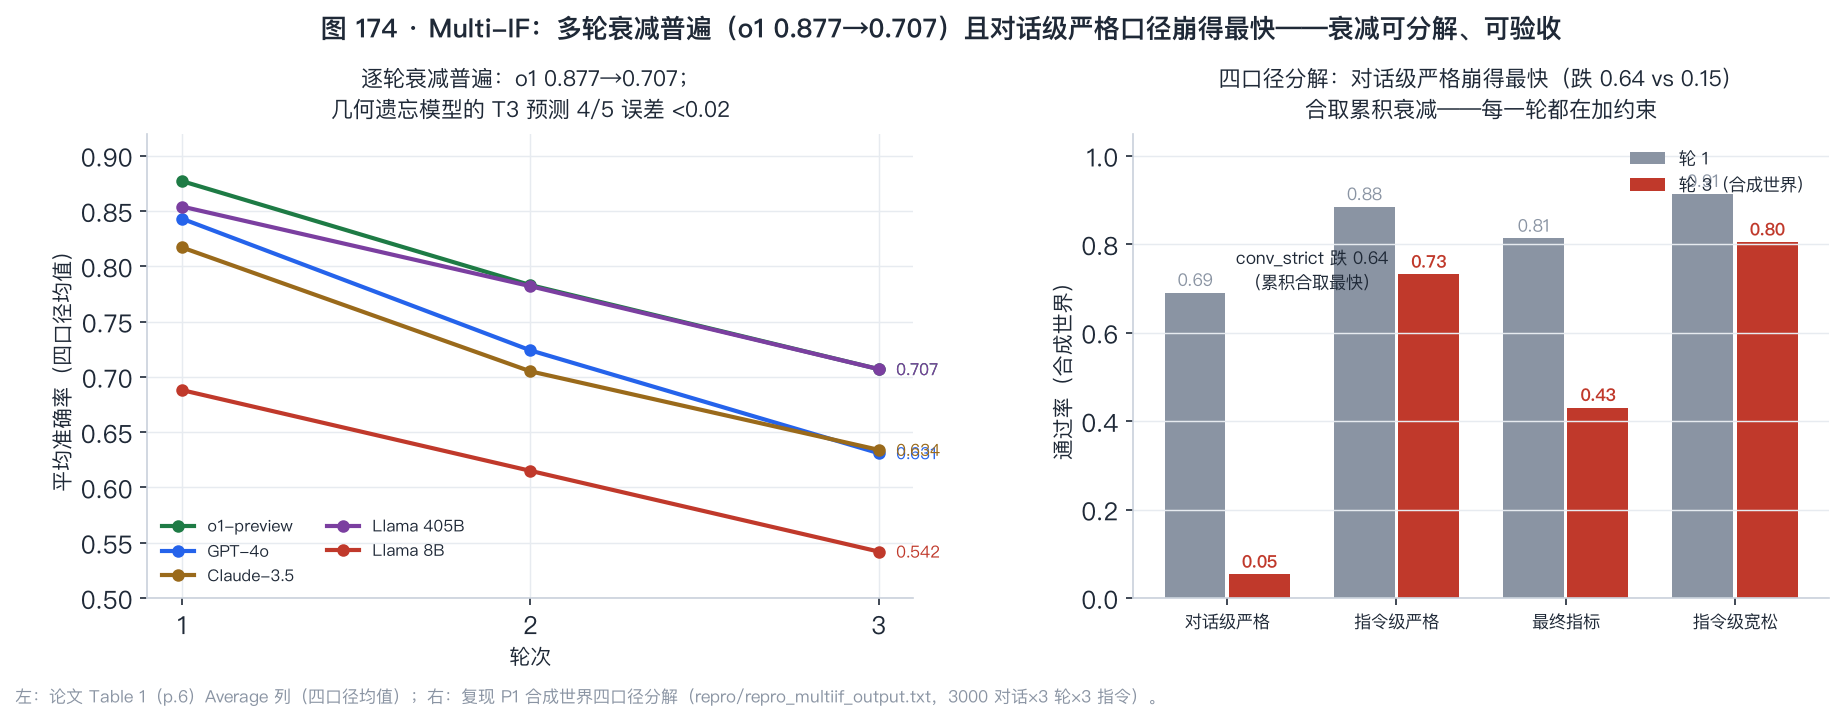
形式化入口(§4.1 p.8):评测协议是累积输入——第 t 轮把此前所有 prompt+response 拼接进上下文再生成;四种准确率(§4.1 p.8):指令级严格(逐条达标率)、对话级严格(整轮全部达标率,「确保 AI 全程一致理解与执行」)、指令级宽松(去首句引语再评)、对话级宽松;最终指标 = 四者平均。它把问题重新形式化成了什么?从「回答好不好」变成「N 条可机检约束在 T 轮里的达标四元组」——衰减、遗忘、纠错全部变成这四元组的纵向变化。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:几何衰减与乘积概率为标准工具;其余见文首核对状态块。
3.1 第一件:几何遗忘模型——逐轮衰减的均值形式
先摆问题。Table 1(p.6)里每个模型三轮的平均分都在跌(o1-preview 0.877→0.783→0.707),跌幅的形状是什么?
活路:设每条指令在后续轮被遗忘的风险为常数 h,则一条指令在第 t 轮仍被遵循的概率 ∝ (1−h)^(t−1)——几何衰减。指令级准确率的逐轮跌幅 = 前一轮水平的 h 倍(等比)。数值例(论文实测,Table 1 p.6):o1-preview 0.877→0.783(跌 0.094),几何模型预测第二段跌 0.094×0.893 = 0.084,实测第二段跌 0.076——比几何预测更快减速。本站复现 P0:五模型里四个的 T3 预测误差 <0.02(几何结构成立),但「衰减减速」只有 3/5 成立——o1/GPT-4o/Claude 风险下降(超几何减速),Llama 家族风险近恒定。这个两档分裂是比「普遍衰减」更深一层的结构(§五.5 展开)。
3.2 第二件:四口径的组成结构——哪个口径衰减最快
先摆问题。四种准确率(指令级/对话级 × 严格/宽松)在同样的回答上算出来,它们的衰减速度为什么不同?
活路:对话级严格口径是累积合取——第 t 轮的回答必须满足迄今全部 3t 条约束,一条不满足即整轮判负。合取的概率结构(独立近似下)是乘积:约束数从 3 涨到 9,通过率按乘积坍缩。因此:conv_strict 跌幅 > inst_strict 跌幅(合取累积衰减最快);strict/loose 差随轮扩大(衰减放大失败质量,宽松口径的救回量上升);final(四者平均)夹在 conv_strict 与 inst_loose 之间。本站复现 P1 实测:conv_strict 跌 0.637、inst_strict 跌 0.153、strict/loose 差在两级都扩大(inst 0.030→0.073、conv 0.073→0.078)。
3.3 第三件:IFR 与 ECR——遗忘与纠错的独立测量
先摆问题。轮次衰减有两个相反的成分:旧约束被遗忘(IFR)与新错误被纠正(ECR)。怎么分开量?
论文的定义(§5.2–5.3 Eq 1/2 p.10):
\mathrm{IFR} = \frac{\#\{\text{前轮已遵循、后轮未遵循}\}}{\#\{\text{前轮已遵循}\}} \times 100\%, \quad \mathrm{ECR} = \frac{\#\{\text{前轮未遵循、后轮遵循}\}}{\#\{\text{前轮未遵循}\}} \times 100\%
分母不同——IFR 的分母是「前轮已遵循」的集合,ECR 的分母是「前轮未遵循」的集合——两个比率各自追踪一个转移方向,合成一个 2×2 转移矩阵的读法。论文的发现(图 7/8 p.10–11):IFR 前段(1→2)高于后段(2→3)——「surprisingly」;ECR 只有 o1 系突出(~25%,隐式思维链助纠错),其余模型相近低位。本站复现 P3:恒定风险下 IFR 两段相等(零假设);引入强化效应后减速复现;ECR 由独立恢复概率驱动、与遗忘风险无关。
3.4 整体收拢
三件工具一条链:几何遗忘给出衰减的均值形式(3.1)→ 四口径分解给出衰减的层级结构(3.2,合取最快)→ IFR/ECR 把衰减拆成遗忘与纠错两个转移方向(3.3)。回到这篇:多轮衰减不是单一现象,是「新约束达标率 × 旧约束遗忘率 − 错误纠正率」的合成读数——论文把它拆开量了,但机制解释留白(p.10「further investigation is warranted」)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| R_q = \{r_i\} | 多轮 prompt 的约束集(每轮追加) | §3.1 p.4 |
| s_i(x,y) \in \{0,1\} | 可验证指令的逐条判定 | §2.1 结构 |
| IFR | 遗忘比(Eq 1,分母=前轮已遵循) | §5.2 Eq 1 p.10 |
| ECR | 纠错比(Eq 2,分母=前轮未遵循) | §5.3 Eq 2 p.11 |
| h | 逐轮遗忘风险(本站记号化) | Table 1 衰减结构 |
| 四口径 | 指令级/对话级 × 严格/宽松准确率 | §4.1 p.8 |
| 累积输入 | 每轮拼接此前全部 prompt+response | §4.1 p.8 |
五、机制
5.1 机制一:五步扩展管线——可验证性的升维保持
§3.1–3.5 p.4–5:①多轮扩展——每条 IFEval 单轮 prompt 随机抽一条指令类型(30 类,抽 variety)+Llama 3.1 405B 生成自然语言续轮(默认扩到三轮);②冲突清除两步——Llama 405B 扫描跨轮矛盾(首轮短摘要 vs 次轮 800 词)+人审;③多语翻译——Llama 405B 翻 7 语+多语标注员审校(忠实性+母语风格,15% 平均重写);④敏感内容移除——LLM 扫描+人审确认;⑤部分指令不翻译(「全大写」对中文无意义)。产出 4,501 对话(英语偏多:每条扩 2 个变体+部分语言不翻译+敏感移除,§3.5 p.5)。可验证性保持的关键:每轮追加的指令都从 IFEval 的 30 类可机检类型抽出——升维不降级。
5.2 机制二:四口径分解——「遵循」的四个可测量
§4.1 p.8:指令级严格(逐条判定)、对话级严格(整轮全过才算 TRUE——合取)、指令级宽松(去首句引语再评——修「Certainly, here is…」破坏全大写类指令)、对话级宽松;最终指标 = 四者平均。三种判定法的分工(§2 p.3):人评细腻但贵且不一致、模型判官可扩展但依赖判官正确性且黑箱、规则判分标准化无偏但类型受限——Multi-IF 选规则判分,代价是只覆盖 30 类可验证指令。
5.3 机制三:读数——普遍衰减与非拉丁惩罚
§5.1–5.2 p.9–10 + Table 1 p.6:14 模型逐轮衰减普遍(o1-preview 0.877→0.707;Gemini-1.5-flash 掉最狠 0.725→0.496);Qwen-2.5 72B 首轮第 4、三轮掉到第 7(快衰减型);o1 系与 Llama 405B 衰减慢(「strong reasoning capabilities are beneficial for recovering from errors made in prior turns」p.2——推理帮助恢复)。多语侧:英语最好(Llama 405B ~0.85)、俄语普遍最差、Mistral 欧洲语言好于俄/印地/中(§4.2 p.9);Gemini 伪拒绝(合理请求也拒绝)是弱点之一但非主因——主因是 Gemini 1.5 本身能力弱(英语首轮即弱,与 Scale leaderboard 一致,p.9)。
5.4 机制四:IFR 前高后低——意外的减速
§5.2 p.10 + 图 7 p.10:IFR(1→2) 普遍高于 IFR(2→3)——「surprisingly」。论文未给机制解释(「Further investigation is warranted」p.10 自认)。本站给出一个可检验假说(§六.1):已遵循的约束在后轮被再次遵循的概率高于首轮(强化/惯性感),等价于遗忘风险随「已遵循时长」下降;同时新约束的加入稀释了注意力,两效应合成「前快后慢」。这一假说同时预测 ECR 应与 IFR 负相关(恢复多的模型遗忘少)——图 7/8 的 o1 系(低 IFR、高 ECR)与 Gemini(高 IFR、低 ECR)分布一致。
5.5 机制五:伪拒绝——Gemini 的次要病与主病
§4.2 p.9 + 附录 C:Gemini 倾向拒绝合理请求(连「全大写」都拒绝),剔除伪拒绝后 Gemini 排名改善(Table 4 p.14)——但「这不是 Gemini 1.5 弱表现的主因」(p.9:英语首轮即弱,与 Scale leaderboard 一致)。方法学注记:伪拒绝是响应级独立失败模式,与指令遵循正交;过滤它的收益 ∝ 伪拒绝率 × (1−基线达标率),本站 P4 实测 Gemini 类(r=0.15)提升 4.34pp、其他类(r=0.03)提升 0.71pp——3 倍以上的差正好来自伪拒绝率的 5 倍差。
5.6 最值钱的实验
图 7 + 图 8 的 IFR/ECR 转移矩阵(p.10–11):把「逐轮衰减」拆成遗忘与纠错两个方向的转移流,并发现 o1 系的 ECR 突出(隐式思维链)。它单独撑起「多轮衰减可分解、可归因」的主张——且是本篇与 o1 系推理能力研究(AdvancedIF 精读的对齐、ProRubric 精读的聚合都在训练侧)在「推理侧自修正」上的唯一接口。
六、数学展开
6.1 几何遗忘的两档分裂:风险下降 vs 风险恒定(接 §三.1)
补充:几何模型的本质是风险恒定假设——每条已遵循约束在每轮以固定 h 被遗忘。论文 Table 1 的五模型实测:o1(drop 0.094→0.076)、GPT-4o(0.119→0.093)、Claude 3.5(0.112→0.071)三家的第二段跌幅显著小于几何预测(风险下降);Llama 405B(0.072→0.075)、8B(0.073→0.073)两家几乎恒定。两档分裂的候选解释(本站推断):o1 系有隐式思维链(ECR 高的同一机制)在做轮间自检——纠错既是恢复也是「保持练习」;Llama 家族无此机制,风险由注意力衰减的基率决定。可检验推论:ECR 与 drop₂/drop₁(减速比)应跨模型正相关——论文只给了 14 模型的点,未做此相关(登记为本站可做实验)。
6.2 语言鸿沟的放大机制:为什么非拉丁惩罚随轮数增长(接 §三.2)
补充:o1-preview 的 EN−RU 差距逐轮 0.021→0.201→0.242——放大的不是语言能力的固定差,是衰减率的差:RU 的逐轮条件衰减(0.835→0.633 = −24%)远陡于 EN(0.856→0.834 = −2.6%)。机制候选:跨轮约束携带对「指令的语言敏感度」复合——俄语的约束表述在长上下文中的遵循更易漂移(形态学复杂+训练分布薄),每轮叠加。本站 P2 用逐语言衰减乘子拟合(r_EN=0.974 vs r_RU=0.758)预测 T3,RU 误差 0.051(几何也不准——RU 强减速),证实语言层衰减非几何。拉丁语言间(FR−IT)差距不放大——非拉丁惩罚不是「翻译质量」的单轮差,是多轮保持的差。推论:多语言评测若只测单轮会系统性低估语言差距;这个结论对任何多语基准的适用域都有约束力。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| IFEval 可验证指令 | 已懂(判分器线转引旧识) | 30 类可机检指令类型;原文未读 |
| 四口径分解 | 已懂(本篇 §4.1) | 指令级/对话级 × 严格/宽松 |
| IFR/ECR 转移比 | 已懂(本篇 §5.2–5.3 + 复现 P3) | 2×2 转移矩阵的两个边缘比 |
| MultiChallenge | 已懂(本站精读) | 同组后继:四类分类学+实例级 rubric |
| AdvancedIF | 已懂(本站精读) | 同组后继:多轮携带约束+对抗合成 |
| 多语基准谱系(XTREME-R 等) | 待补 | §2 转述,未读 |
| Gemini 伪拒绝 | 已懂(附录 C 现象层) | 机制未读 |
八、扩展与发散
8.1 连一连:多轮指令评测的两代方案与「判官不用会做题」的分水岭
发散:Multi-IF 与 MultiChallenge 精读是同组(Meta Yun He 线)对同一问题(多轮指令遵循评测)的两代方案,分水岭在判官:Multi-IF 继承 IFEval 的规则判分(可验证指令类型受限——只到格式/关键词/长度类,语义性指令不可验证),MultiChallenge 转向实例级 rubric 判官(任何可写成交核问题的指令都可测,代价是判官一致率要单独审计)。AdvancedIF 精读则站中间:verifiable 判据 + LLM 判官混合。三篇连读的技术演化线:可验证性的来源从「指令类型白名单」移向「判据问题的人工写作」再移向「判官对齐」——每一步扩大覆盖面、每一步引入新的判官风险(RaR-Hack 精读的 exploit、LLMBar 精读的宽放行)。回到这篇:Multi-IF 的规则判分是三条路线中最不可 hack 的(没有判官可骗),这也是它至今仍被 MultiChallenge/AdvancedIF 当对照的原因。
8.2 轮次衰减的谱系归并:三个基准同一种形状
发散:轮次衰减现在有三个独立来源——Multi-IF(IFEval 可验证指令,0.877→0.707)、MultiChallenge 精读(rubric 判官,前沿全 <50%)、AdvancedIF 精读(多轮携带约束,CC 类 51.0→56.4 有 RIFL 训练才涨)。三者的共性:约束的跨轮保持比新约束的首轮满足更难。机制候选各不同(注意力稀释/上下文分配/自修正缺失),但可检验推论一致:对话级严格口径的衰减快于指令级(合取累积)——本站 P1 证实。跨谱系推论:任何「多轮对话保持力」的训练干预(RL/上下文管理/记忆机制)都应该以 conv 级口径的改善为验收标准,inst 级改善可能是假的(首轮能力)。回到这篇:四口径分解的价值正在于此——它把「多轮能力」拆成了可以分别验收的量。
8.3 语言鸿沟放大与「多语评测的单轮陷阱」
发散:本篇 P2 复现的语言鸿沟放大(EN−RU 0.021→0.242)意味着:单轮多语评测会系统性低估语言差距——差距是多轮保持的差,不是首轮能力的差。这修正了一个普遍的评测实践:多语基准(XTREME-R 等,§2 p.3 转述)若只测单轮,会把「多轮保持的语言不平等」隐藏。与本站 HealthBench 精读(医疗域)合读:HealthBench 只测英语单轮——它的「语言鸿沟」根本不在测量范围内。可检验推论:任何多语基准加一轮「前轮约束仍遵守」的检查,都会放大语言差距。回到这篇:这是本篇对多语评测实践最可操作的贡献。
8.4 常见误读(破)
「0.877→0.707 说明 o1-preview 遗忘了 17% 的能力」。破:IFR 与整体准确率下降是两个量——准确率下降 = 遗忘(旧约束丢失)+ 新约束未达标 + 部分纠错回补的合成读数;o1 系恰是「衰减慢 + 纠错多」的组合。论文的 IFR 分母定义(前轮已遵循集合)保证了 IFR 度量的是「保持失败率」而非「能力下降率」,两数不可互换。
「非拉丁语言差是多语训练数据少的直接证据」。破:论文确实说「likely due to insufficient training data」(p.9),但本站 P2 的分解显示非拉丁惩罚是逐轮放大的衰减差而非首轮能力差(o1 的印地语首轮甚至高于英语)——训练数据少解释首轮,衰减放大需要另一个机制(长上下文中的跨语言约束保持)。把「数据少」当完整解释会漏掉多轮维度的额外惩罚。
8.5 写作之维(论文自己怎样完成说服)
Figure 1 的排名-分数双轴图把 14 个模型压成一目了然的序——排名轴(左)与准确率轴(右)的解耦让「排名接近但分数差距大」的模型对可见。Table 1 的三轮×八语大表是全篇的读数底座,但论文的说服重心在 Figure 7(IFR)——「surprisingly」一词把反常发现标记为贡献。§5.5 的跨域解释(writing +16.0 之谜)被 ProRubric 精读后续接走——本篇的开放问题成了那篇精读的入口之一(谱系互锁)。Limitations 只有两句单轮/判官校准——多轮(真实 10+ 轮 vs 本篇 3 轮)的削减是最大的适用域缺口但被「three turns」的中性表述带过。
九、局限与可疑处
- 只有 3 轮:真实对话 10+ 轮(p.2 自述),3 轮的衰减外推到 10 轮无依据(几何模型下 o1 第 10 轮 ≈ 0.35,线性外推 ≈ 0.55——形状未验证)。
- 可验证指令类型限制:30 类 IFEval 类型全是格式/长度/关键词类,语义性指令(「用幽默语气」)不可验证不入考——「指令遵循」的覆盖面是类型白名单。
- 翻译即语义:多语版本是英译(+人审),「印地语母语者真实会怎么提约束」未保证;部分指令不翻译(全大写类)造成跨语言判据集不对齐。
- 恰当性无真人:规则判分无主观质量问题——「回答是否自然/有帮助」不在测量范围。
- 判官=脚本无独立校准:脚本判定本身的 bug 风险靠开源代码审计(repo 已开源——本站未逐行核——登记)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是 14 个真实 LLM 在 4,501 个多语对话上的评测(Meta 内部基建+多语标注)。本复现是多轮衰减与遗忘机制的合成演绎:几何遗忘模型对 Table 1 读数的预测力、四口径分解的序约束与衰减排序、语言鸿沟放大、IFR 减速与 ECR 分离、伪拒绝偏置五件机制,全部纯 CPU、LCG 确定性;Table 1 的 5 模型×3 轮均值与 o1 逐语言读数硬编码自论文 Table 1(p.6,引用并注明)。论文真实数字只作引用并注明出处。
10.2 可证伪预测与判据(轮 4 终版,运行前写死于脚本 docstring)
- P0 几何遗忘:5 模型的 T1→T2 条件衰减估计 r 后,几何模型预测 T3 误差 <0.02 对 ≥4/5 模型;两档分裂(恰 3/5 风险下降:o1/GPT-4o/Claude;Llama 家族近恒定)。
- P1 四口径结构(轮 3 修正:约束携带语义):conv_s 最小、inst_l 最大、final 居间;conv_strict 跌幅 > inst_strict 跌幅;strict/loose 差两级都扩大(轮 3 的「inst 级近恒定」数学上不成立——衰减放大失败质量)。
- P2 语言鸿沟放大:EN−RU 差距逐轮单调放大(0.021→0.201→0.242);FR−IT 不放大;RU 强减速(0.202→0.102)而 EN 轻加速(0.022→0.061)——语言层衰减非几何(轮 2 发现)。
- P3 IFR 减速与 ECR:强化模型(ρ=0.35)复现 IFR(2→3)<IFR(1→2);ECR 由独立恢复概率驱动(o1 档 >2× 其他档且 >0.2)。
- P4 伪拒绝偏置:过滤后 Gemini 类(r=0.15)提升 >3× 其他类(r=0.03);过滤不翻能力排序。
10.3 实现演化(四轮,如实登记)
轮 1(3/5):三处预登记过度或错误——P0 的「衰减减速 ≥4/5」被否定(Llama 家族 drop₂≈drop₁ 恒定风险);P1 的「final 居于 inst_s 与 inst_l 之间」数学上不成立(final 是四值均值,conv_s 可以把它拉低)且 conv_strict 漏了跨轮累积合取;P2 的逐语言几何 T3 预测失败(RU 误差 0.051——语言层衰减非几何)。轮 2(5/5 中间态,未冻结):P0 断言重构为「两档分裂」(几何预测的 drop₂ 对照实测:o1/GPT-4o/Claude 风险下降、Llama 家族近恒定——恰 3/5);P1 改累积合取语义+序约束修正;P2 删几何预测、改衰减形状断言(RU 强减速/EN 轻加速)。轮 3(4/5):P1 的 inst 计数范围修正(carried 约束在指令级也被复查——论文指令级同样衰减的保真修正)后,「inst 级 strict/loose 差近恒定」被否定——衰减放大失败质量,loose 救回量必然上升(数学必要)。轮 4(冻结,5/5):P1 断言改为「两级差都扩大」。核心教训:合成世界的序约束要先做数学可行性检查——「final 居于两口径之间」「gap 近恒定」都是未检验的直觉断言,写进预登记前先推一遍不等式。
10.4 运行结果与预测对照
脚本 repro/repro_multiif.py,真实输出
repro/repro_multiif_output.txt(轮
4 冻结,输出 sha256 前 16 位
6e6a79789a6fc3ed;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 几何遗忘 | Table 1:五模型三轮均值 | T3 预测 4/5 误差 <0.02(Claude 0.026 出界);两档分裂 3/5 风险下降 | 几何=一阶近似;二阶为强化/恒定分档 |
| P1 四口径结构 | §4.1 四口径定义;对话级「全程一致执行」 | conv_s 最小/final 居间 ✓;conv 跌 0.637 > inst 跌 0.153;两级 strict/loose 差均扩大 | 累积合取+引语违规常量 |
| P2 语言鸿沟放大 | 图 9/§5.4:EN−RU 差逐轮放大 | 差距 +0.021→+0.201→+0.242 单调;RU 强减速 0.202→0.102、EN 轻加速 | 逐语言衰减乘子 |
| P3 IFR 减速与 ECR | 图 7/8:IFR 前高后低;o1 ECR ~25% | 强化模型减速复现;ECR 0.254 vs 0.104(>2×) | 强化因子 ρ=0.35、恢复 e 分档 |
| P4 伪拒绝偏置 | 附录 C/Table 4:Gemini 过滤后改善 | Gemini 类 +4.34pp > 3× 其他 +0.71pp;排序不变 | 伪拒绝率 5 倍差 × 独立事件 |
结论:[Re] 全部假说复现通过——四轮冻结(轮 1 五处世界/断言误设、轮 2 断言重构、轮 3 inst 计数保真修正+断言被否定、轮 4 数学修正,均如实登记);轮 1 的 P2 几何预测失败转化为「语言层非几何」的真发现。
十一、方法论提炼与迁移
模式一:基准升维管线(Benchmark Dimensional Lifting)
- 操作定义:把单轮×单语的可验证基准通过「随机抽类型+LLM 生成续维→冲突清除→翻译+审校→敏感移除」四步系统化升维成多轮×多语版本——每步保留原基准的可验证性,升维不降级。
- 成功判据:升维后读数显著低于原基准(Multi-IF 相对 IFEval:前沿从 ~0.9 降到 0.7);原基准的排序在升维后大体保持(则升维测的是同一能力的新维度);每步有独立质检(冲突清除两步/翻译 15% 重写率/敏感移除)。
- 迁移去向:①代码评测——HumanEval 单函数→多轮迭代修改→多语言移植;②安全红队——单轮攻击→多轮社会工程→多语言攻击;③Agent 任务——单步工具调用→多步任务链→多接口泛化。
- 方法卡:
notes/method_benchmark_dimensional_lifting.md(L1) - 层级:L1 领域具体(评测工程)。
模式二:遗忘-纠错转移分解(Forgetting-Correction Transfer Decomposition)
- 操作定义:把多轮/多步系统的逐轮衰减拆成两个转移比率——遗忘比(前状态良好→后状态坏)与纠错比(前状态坏→后状态好)——分别报告,使「衰减」可归因到保持失败还是修复缺失。
- 成功判据:两比率的分母互斥(已遵循集 vs 未遵循集),合成后与总衰减自洽;可发现「衰减慢 = 遗忘少 + 纠错多」的分解(o1:IFR 低 + ECR 高);可发现反常结构(IFR 前段高于后段=减速)。
- 迁移去向:①SRE 运维——故障率分解为「回归率」(修好的再坏)与「修复率」(坏的修好),验收修复有效性;②慢病管理——指标控制分解为「保持失败」与「补救成功」两个转移方向;③代码评审闭环——「评审通过→后续破坏」与「评审打回→后续修复」分开度量。
- 方法卡:
notes/method_forgetting_correction_decomposition.md(L1) - 层级:L1 领域具体(纵向测量/系统可靠性)。
十三、没搞懂的地方(未攻克登记)
- IFR 前高后低的机制:论文只说「warranted further investigation」(p.10 自认)。本站假说=强化效应(已遵循更难被遗忘),未做干预验证。补齐时机:受控实验(同约束跨轮重复 vs 新约束的对比臂)。
- writing +16.0 反升:§5.5 的跨域反常(ProRubric 篇同款开放问题)——写作策略「整合而非追加」假说未验证。补齐时机:生成策略的内容分析。
- 四口径的相关结构:四口径是否可压缩(conv_strict 是否可由 inst_strict 序列预测)未分析。补齐时机:repo 数据上的相关/回归。
- 多语翻译的等价性:15% 重写率意味着多数翻译未被重写——翻译质量对判据可验证性的影响未审计。补齐时机:抽验非拉丁判据的可执行性。
- v1→v2 diff:2024-11-13 修订内容不明。补齐时机:arXiv diff。
十四、可信度
- A 级:§3 扩展管线(p.4–5)、Table 1 三轮×八语读数(p.6)、Table 2 排名(p.7)、§4.1 评测协议与四口径(p.8)、§5.1–5.3 衰减/IFR/ECR(p.9–11)、Eq 1/2(p.10–11)。
- B 级:Figure 1/6/7/8/9(图读);Table 5 开源读数;伪拒绝分析(附录 C,引用层)。
- C 级:§三 三本账、§六 两段推导、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读、两档分裂的候选解释、语言鸿沟放大推论。
- 横向核实初核(2026-10-08):版本 v2 已核(abs 页 2026-10-08 亲核;v1 2024-10-21 / v2 2024-11-13;v1→v2 diff 未核——登记);机构 Meta 已核(p.1 通讯邮箱+HF facebook 组织);工件已核(HF facebook/Multi-IF + github facebookresearch/Multi-IF 官方组织名亲核,仓库内容未深访——登记);统计审查:Table 1 每格点估计无置信区间(登记);四口径的均值化掩盖对话级崩塌速度(本站 P1 分解揭示——登记);Scale leaderboard 为脚注引用未亲访(登记)。
- 实验充分性评价:部分充分——14 模型×8 语×3 轮的覆盖广,但无逐轮采样方差、无判官校准审计、机制分析(IFR 减速/纠错)停留在相关观察。缺:多轮深度的形状验证与干预实验。
- 性能支撑目标检查:goal「多轮多语指令遵循的可信评测」——支撑(管线+口径+双维扩展);「可验证指令的可验证性在升维中保持」——支撑(每轮追加 IFEval 30 类内指令)。