外行导读(先读这个,再决定要不要进正文)
一个场景:用户第一轮说「推荐 10–15 首歌,别推荐披头士」,第三轮改口「换个歌单」——到第五轮模型还在推荐披头士吗?这种多轮对话能力,前沿模型在老基准上接近满分,考不出差距。Scale AI 的做法:出一份 273 题的考卷,四类挑战(指令保持/推理记忆/可靠版本编辑/自我一致),全部人工终审,只保留「六大家前沿模型里至少三家做错」的题目。结果:最强的 Claude 3.5 Sonnet 只有 41.4 分,GPT-4o 12.5 分垫底。更有意思的是判卷:直接让 GPT-4o 读全对话当裁判,它给的分和人类一致率只有 37%——比抛硬币还差;但把每道题拆成一个二元是非题(「这些食谱含坚果吗?」)让它逐题核对,一致率跳到 94%。同一个模型,换个判卷方式,裁判能力翻 2.5 倍。
这篇论文做了两件事。第一件:考卷——四类多轮挑战的 273 题,混合构造(MMSE 三智能体合成 + 人类专家修订,只保留 ≥3/6 前沿模型失败的例子),每题配一个实例级二元 rubric 问题。第二件:判卷方法——实例级 rubric 判官与资深人类评分者一致率 93.91%(四类全 >90%),而基线判官(读全对话+胜/负判据)只有 36.01–37.33%。
为什么值得关心:三个理由。第一,它是考卷线的多轮对话维度——此前六颗考卷(环境/网页/医疗/SWE/指令)都不考「跨轮携带约束」,本篇把这一维立起来。第二,它是判分器线的判官工程鸿沟最大实测:同一个 base model(GPT-4o),判官脚手架从「读全对话」换成「实例级二元问题」,人机一致 37.3%→93.95%——与 AdvancedIF 精读的「对齐替代规模」互为姊妹:判定质量主要来自任务结构化,不是换更大的模型。第三,37.3% 这个数低于随机线(50%),它的机制(宽放行判官 × 以失败为基率的考卷)正是种子 24 LLMBar「低于随机=稳定反向」的实证案例——本站复现把这个机制完全重构了出来。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Instruction Retention | 指令保持——第一轮的约束全程有效(「推荐 10–15 首歌、别推披头士」到最后一轮仍成立) |
| Inference Memory | 推理记忆——前轮信息隐含地被最后一轮需要(没问「她对什么过敏」,但食谱必须避开) |
| Reliable Versioned Editing | 可靠版本编辑——多轮改稿+版本指代消解(「回到我们调时间之前的计划」) |
| Self-Coherence | 自我一致——不谄媚:用户质疑时不大转弯(此前说过「连 Wi-Fi 后要注册」,用户说「剩下就是选书了吧」也不顺着改口) |
| MMSE | 多阶段多智能体合成系统——Planner/User/Responder 三智能体生成对话骨架 |
| instance-level rubric | 实例级评分标准——每题一个二元是非题,只看最终回答即可判定 |
| 对抗性筛选 | 只保留 ≥3/6 前沿模型失败的例子——考卷贴着能力边界 |
| 宽放行判官 | 本站复现的机制模型——倾向判「通过」的分类器;对齐率由基率与放行倾向决定 |
§0 承接栏
这颗种子接的是两笔账。第一笔:上一篇 AdvancedIF 精读的主对照基准就是 MultiChallenge——其对照表里 MultiChallenge 占「rubric-based / 多轮 ✓ / 人类判据」的对照行,今日归位。第二笔是判官工程问题:AdvancedIF 精读给出「对齐替代规模」(SFT+RLVR 把判官 0.515→0.728),本篇给出第二条更便宜的路——「结构化替代规模」(判官不动,把判定任务分解成每例一个二元问题,37.3→93.9)。两条路合读,判官选型清单升格为判官工程清单:选规模、做对齐、换脚手架,三条路有明确的成本序。对考卷线,它补的是多轮对话维度——MyPCBench/Odysseys/OM2W 是环境与网页,SWE-Marathon 是代码,HealthBench 是医疗问答,本篇是纯对话的「跨轮约束携带」。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:多轮对话能力是「crucial yet underexamined」——既有多轮基准(MT-Bench 等)上前沿模型接近满分,考不出差距;而真实多轮对话里的失败比比皆是。§3.1 p.4–6 把失败分成四类:指令保持(第一轮的约束全程有效)、推理记忆(前轮信息隐含地被需要)、可靠版本编辑(多轮改稿的版本指代消解)、自我一致(不谄媚地坚持自己说过的正确内容)。前沿模型全 <50%(§5.1 p.10:Claude 3.5 Sonnet 41.4 最高)——「这还是有待填平的差距」。
1.2 旧做法的缺口
§3.2 p.6:多轮对话没有单一标准答案,规则判分不可用;直接让前沿 LLM 当判官(读全对话+胜/负判据)与人类一致率极低(Table 4:36.01%)——论文的解释很诚实:「前沿模型自己在 MultiChallenge 上的准确率不到 50%,限制了我们对它们能正确评判其他模型的信心」(p.6)。纯人评又贵(154.4 分钟/题,§5.2 p.13)。缺口:需要一个「判官自己做不对题也能可靠判卷」的评测方法。
二、核心想法
一句话:把「判官解题」降级为「判官查项」——每道题配一个实例级二元 rubric 问题(只看最终回答即可答 yes/no),判官不需要会做这道题,只需要会核对这个单项;考卷本身则从六家前沿模型的失败里对抗性筛选。
直觉先打底:让阅卷老师做一遍高考数学再判卷,老师也会出错;给老师一份标答对照表,逐项核对就是机械劳动。实例级 rubric 就是那份对照表——由出题人(标注员)在出题时顺手写下,判官只答一个 yes/no。
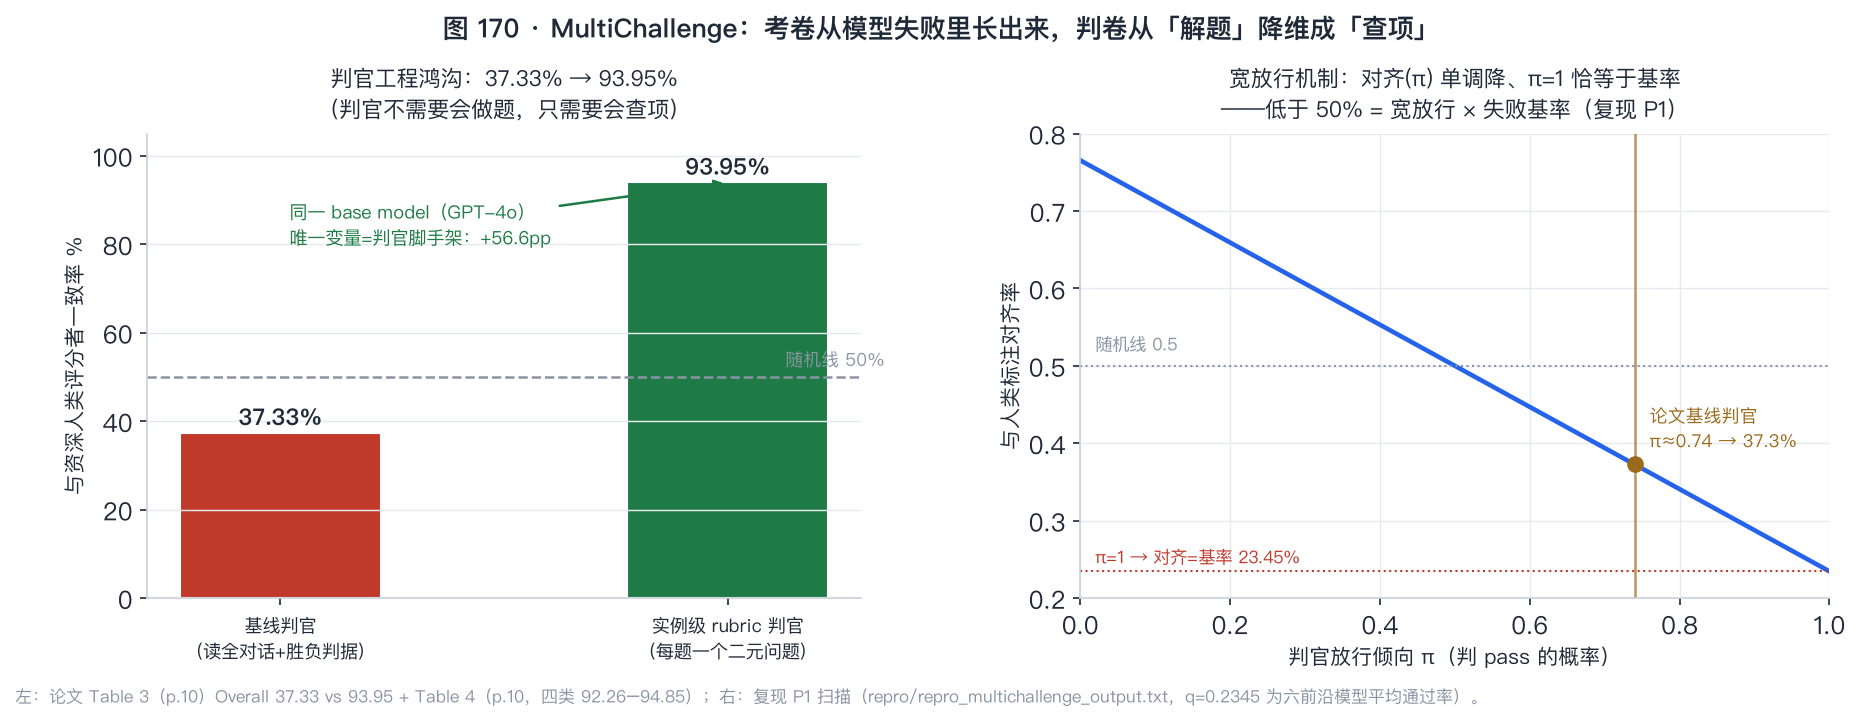
全篇就看这张:图 170——左:判官工程鸿沟(基线判官 37.3% vs 实例 rubric 判官 93.9%,同一个 base model);右:宽放行扫描的机制曲线(对齐率随放行倾向单调下降、π=1 时恰等于通过基率——低于 50% 的对齐就是「宽放行 × 失败基率」的指纹)。
形式化入口(§3.2 p.6):每个测试例附带一个二元 rubric 问题 q_i,判官 V 只以最终模型回答为上下文回答 q_i,yes = 通过。整个评测的聚合规则是全或无:一题的所有判据问题都过才算过(§3.1 p.5:「a binary label (TRUE or False) for whether it satisfies all criteria」)。它把问题重新形式化成了什么?从「评判一段多轮对话的质量」(判官要有解答能力)变成「回答一个关于最终回答的是非问题」(判官只需要核对能力)——判定所需的能力层级被降维了。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:分类器基率-对齐关系与 Pearson 相关为标准工具;其余见文首核对状态块。
3.1 第一件:基率与对齐——37.3% 这个数怎么读
先摆问题。基线判官的对齐率 37.33% 低于随机线 50%,这比「判官不行」严重——比抛硬币还差意味着系统性错误。它从哪来?
活路:把判官看成一个有放行倾向的分类器。设人类标注的通过率为 q(被判 pass 的比例),判官的放行倾向为 \pi(判官判 pass 的概率),则对齐率
\mathrm{align}(\pi) = q\,\pi + (1-q)(1-\pi)
逐符号过一遍:q\pi 是「人类 pass 且判官 pass」(真阳性);(1-q)(1-\pi) 是「人类 fail 且判官 fail」(真阴性)。数值例(合成世界,本站复现 P1):全池人类通过率 q = 0.2345(六前沿模型在 273 题上的平均通过率 23.45%——以失败为基率的考卷),则 \mathrm{align}(\pi) = 0.7655 - 0.531\pi:放行倾向越高对齐越差,\pi=1(来者皆过)时对齐恰好等于 q = 0.2345,\pi=0.5(随机)时等于 50%。论文的 37.33% 落在 \pi \approx 0.74——一个 74% 倾向放行的宽判官,撞上一张以失败为基率的考卷。本站复现 P0/P1 把这个模型做成了可检验预测(overall 重构误差 0.10pp)。
补充:这正是种子 24(LLMBar)「低于随机 = 稳定反向偏好」的机制版——低于 50% 不是噪声,是「宽放行 × 失败基率」的结构指纹。两条谱线在此合流。
3.2 第二件:实例级 rubric 的基率无关性——为什么 94% 是真修复
先摆问题。实例级 rubric 判官为什么能到 94%?它比基线判官强在哪个数学性质上?
活路:实例判官回答的是一个范围收窄的是非题(「这些食谱含坚果吗?」——只看最终回答),其判定准确率 \alpha 只取决于「核对这个单项」的能力,不取决于「解这道多轮题」的能力。而一个准确率为 \alpha 的分类器,其对齐率 = \alpha,与基率 q 无关:\mathrm{align} = q\alpha + (1-q)\alpha = \alpha。本站复现 P0 的基率扫描(q 从 0.2 到 0.6)实测对齐极差 0.003——基率变了,对齐纹丝不动。这就是 93.95% 的来源:它不是「判官变聪明了」,是「判定任务被改写成判官本来就会做的事」。对照 §3.1:基线判官的对齐被基率与放行倾向夹死——两类判官的数学性质差异就是工程鸿沟的全部。
3.3 第三件:对抗筛选的偏置结构——「考卷从失败里长出来」的公平账
先摆问题。§4.1 p.7 的收集规则:只保留「六家前沿模型中至少三家失败」的合成例。这对六家前沿模型是系统性偏置——考卷是按它们的失败挑的。那对其他模型公平吗?
活路:筛选改变的是例子的难度分布,不改变「能力高者得分高」的序。设模型能力 a_m、例子难度 d,通过概率 p(a_m, d) 随 a_m 升、随 d 升而降。筛选(保留高 d 例)压低所有模型在被筛集上的通过率,但逐模型通过率仍是 a_m 的单调函数——排序保持。本站复现 P2:六前沿在被筛集上通过率 0.368→0.206(构造性压低、低于随机线),六个开源模型在两套例集上的逐模型均分 Pearson 相关 0.9923(排序完全保持)。论文 Limitations p.13 的原话与之一致:「对六家前沿有偏……但对六家未来的后继模型与现有开源模型的比较仍然是公平的」。这就是考卷线的「捷径探针」方法卡(种子 31)在构造侧的镜像:OM2W 用最低能力 agent 家族探测考卷捷径,本篇用前沿失败筛出边界题——同一种「考卷贴着能力边界」的构造哲学。
3.4 整体收拢
三件工具一条链:基率-对齐模型解释「37.3% 意味着什么」(3.1,宽放行×失败基率)→ 实例 rubric 的基率无关性解释「94% 为什么是真修复」(3.2,判定降维到核对)→ 对抗筛选的偏置结构解释「考卷对谁公平」(3.3,压低不乱序)。回到这篇:判官工程(判卷)与考卷构造(出题)两件事各自有数学,且共享同一个设计原则——把不可靠的「整体判断」拆成可靠的「单项核对」。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| \mathrm{align}(\pi) | 放行倾向 \pi 的判官与人类标注的对齐率 | §3.2 结构(本站记号化) |
| q | 人类标注通过率(基率) | §2.2 结构 |
| q_i | 实例 i 的二元 rubric 问题 | §3.2 p.6 |
| V | 实例级 rubric 判官(GPT-4o base) | §3.2 p.6 |
| MMSE | 多阶段多智能体合成系统(Planner/User/Responder) | §4.1 p.7 |
| AMT | 每题平均人工分钟(73.6 vs 154.4) | §5.2 p.13 |
| CIF/CC/RVE/SC | AdvancedIF 术语;本篇对应 IR/IM/RVE/SC 四类 | Table 1 p.5 |
五、机制
5.1 机制一:四类挑战的分类学——每类考一种「跨轮失能」
§3.1 p.4–6:指令保持(69 题):第一轮显式声明全程有效的约束(格式、句数、电影分级),无后续矛盾指令,评最后一轮是否仍合规。推理记忆(113 题):前轮信息隐含地被最后一轮需要——最后一轮不直接问(「她对什么过敏?」),而要求推理其相关性(甜品食谱要避开坚果)。可靠版本编辑(41 题):多轮改稿+版本指代(「我们调结束时间之前的那个计划」),要解析指代歧义、无幻觉地取对应版本。自我一致(50 题):模型是否谄媚——用户轻微质疑就推翻自己此前的正确回答(电子阅读器设置例:用户说「连上 Wi-Fi 后就剩选书了吧」,前沿模型纷纷改口附和,而正确下一步是注册设备)。Table 1 p.5:平均 5 轮、平均 1231.7 词。
5.2 机制二:实例级二元 rubric——判官不需要会做题
§3.2 p.6:每例由标注员写一个二元 rubric 问题(例:「这些甜品食谱中有含坚果的吗?」),只以最终模型回答为上下文。frontier 模型当判官逐题作答,全判据通过才算该题 TRUE。为什么这招有效(论文的机制解释 p.6):前沿模型自己在这份考卷上 <50%,直接判全对话「限制了它们正确评判的信心」;二元单项问题把判定降维成核对。效果:Table 4 p.10——实例 rubric 判官对齐 93.91%(四类 92.26/94.62/94.85/94.12),基线判官 36.01%;GPT-4o 与 Claude 双 base 同结论。判官工程鸿沟 = 57.9 个百分点,全部来自判据脚手架。
5.3 机制三:MMSE 对抗合成 + 人审——考卷从失败里长出来
§4 p.7–8:MMSE 三智能体(Planner 定策略骨架/User 演用户/Responder 扮助手);Responder 从六家前沿模型随机抽样(防止考卷过拟合单一模型的弱点);Planner 检出失败即终止存档。人审三查(类别对齐/自然真实/≥3/6 前沿失败才收)+ 双复核层(复核池与标注池完全分离)。效率:MMSE 让每题人工时间减半(73.6 vs 154.4 分钟,§5.2 p.13);人改幅度:合成稿与终稿字符串相似度 74.5%(fuzzywuzzy,p.13)——四分之一是人工的。这就是「考卷从失败里长出来」:例子的入选条件就是模型的失败,考卷的每道题都贴着当前前沿的能力边界。
5.4 机制四:读数与结构——多轮短板的形状
Table 2 p.10(人评):Claude 3.5 Sonnet 41.42 最高、o1-preview 37.23、Gemini 1.5 Pro 19.96、Llama 3.1 405B 14.92、Mistral 14.63、GPT-4o 12.52 垫底。分维度:RVE 最难(最好 39.02)、IM 次难(41.53)、SC(45.45)、IR 最易(58.57)——但 Claude 在 RVE/IM 上落后 o1-preview(专家分域)。Table 3 p.10(自动评):趋势与排序与人评一致(Claude 42.75)。最值钱的实验:Table 4(判官对齐)——见 §5.2。分析章的三组对照:轮数与性能无相关趋势(图 4 p.11——难度来自推理不是长度);70–72B 开源 > 小模型;发布时间总体正趋势但非线性(Claude 3.5 六月版胜过若干更晚模型)。
5.5 机制五:多智能体对抗生成的方法论边界
§4.1–4.2 p.7–8:MMSE 的对抗性来自「User Agent 以致失败为目标」+「Responder 随机抽样」+「Planner 检测失败即停」;但最终质量闸门是人工(三查+双层复核)。Limitations p.13 自认边界:rubric 问题超出前沿判官能力的题无法进基准(收进私有集待判官进化)——判官能力反过来给考卷难度封顶。这是对抗生成的结构性循环:考卷贴着「模型失败 ∧ 判官可判」的交集,交集外的难度要等判官进化才能解锁。
5.6 最值钱的实验
Table 4(p.10):37.33% → 93.95% 的判官工程鸿沟。一个 base model、同一份考卷、同一批人类标注,唯一变量是判官脚手架。它单独撑起「实例级 rubric 让自动评测成为可能且可信」的主张,并且是判分器线上「结构化替代规模」的最大单项证据(对照种子 37 的对齐路线 0.515→0.728)。
六、数学展开
6.1 宽放行判官的对齐几何:低于 50% 的数是怎么来的(接 §三.1)
补充:把 align(π) = q·π + (1−q)(1−π) 画全。q = 0.2345 时:\pi 从 0 扫到 1,对齐从 0.7655 单调降到 0.2345;\pi = 0.5(随机判官)恰为 50%;论文的 37.33% 对应 \pi = 0.738。三个读数带:对齐 >50% = 判官有辨别力但带倾斜;对齐 = 50% = 纯随机;对齐 <50% = 放行倾向强于基率的宽判官(系统性地把 fail 判成 pass)。37.33% 属于第三带。本站复现 P1 的扫描曲线(21 点全单调、端点基率±0.005)机器验证了这条几何。跨谱系对读:LLMBar 篇(种子 24)的「ChatGPT 17.9% 低于随机 = 稳定反向偏好」与 Cheating 篇(种子 13)的「空壳模型 86.5%」分别占据这条线的两端——判分器线凡是见到低于 50% 的判官一致率,现在的第一反应应该是「查放行倾向与基率的乘积结构」。
6.2 对抗筛选的选择方程:偏置可计算、公平可验证(接 §三.3)
补充:筛选的偏置可以写成选择方程。设被筛例集 S = \{d : \#\text{fails}_{\text{frontier}}(d) \ge 3\},前沿池在被筛集上的期望通过率 E[p(a_m, d) \mid d \in S] 由 d 的条件分布决定——选择压低高能力模型的通过率到中位以下(「≥3/6 失败」= 中位前沿失败),这是构造性的:不是模型变差,是考卷按其失败定义。公平性则是逐模型通过率对 a_m 的单调性在选择前后保持——本站 P2 实测六开源模型在两套例集上的均分 Pearson 0.9923。方法论迁移:任何「按当前强者失败筛选」的考卷都可以用同一对方程审计——偏置(对被筛者)与公平(对其他模型)可以同时定量。这也是「捷径探针」(种子 31)的定量化:探针测的是通过率分布的形状,选择方程解释分布为什么是这个形状。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 实例级 rubric 判官 | 已懂(本篇 §3.2/§五.2) | 二元问题 + 只看终轮;对齐=单题准确率 |
| LLM-as-judge 一致率口径 | 已懂(种子 10 MT-Bench + 本篇 Table 4) | 宽放行判官的低于随机指纹 |
| sycophancy 谄媚 | 已懂(概念层;种子 14 SoK 相关) | Self-Coherence 类的靶行为,文献未读 |
| MMSE 多智能体合成 | 已懂(§4.1) | Planner/User/Responder + PersonaHub 人格种子 |
| MT-Bench / Multi-IF | 部分 | 既有多轮基准(饱和侧),Multi-IF(He 2024)未读 |
| PersonaHub(Ge 2024) | 待补 | 人格种子数据集,未读 |
| ACL Findings 2025 出版信息 | 待核对 | aclanthology 2025.findings-acl.958(搜索快照未亲核) |
八、扩展与发散
8.1 连一连:考卷线第六维+判官工程鸿沟——两条线在本篇交汇
发散:考卷线至此六维——环境个人化(MyPCBench)、网页真实性(Odysseys)、判官筛选(OM2W)、超长时程(SWE-Marathon)、高风险三层(HealthBench)、指令遵循三层(AdvancedIF),本篇补上多轮对话跨轮约束。判分器线则从本篇拿到判官工程鸿沟的最大实测(57.9pp,同 base model)。两条线交汇的节点是「实例级二元 rubric」:考卷侧它是标注员的出题动作(出题时顺手写判据问题),判分器侧它是判官的脚手架(判官只答是非题)。与种子 37 合读出判官工程的三条路线及其成本序:换脚手架(本篇:判据实例化,零训练成本,鸿沟 57.9pp)> 对齐微调(种子 37:SFT+RLVR,一次性训练成本,+21.3pp F1)> 换更大模型(RubricHub 精读:30B 阈值,持续推理成本)——三条路不互斥,但便宜的先试。回到这篇:本篇最大遗产不是 273 道题,是「判官不该被要求会做题」这个设计原则。
8.2 归因修正的第二次现身:本站“RaR-Hack 评测域”说法勘误
发散:RaR-Hack 精读时本站登记过「MultiChallenge 与 RaR-Hack 评测域双线交汇」——复核 RaR-Hack 原文:其训练与评测域是 HealthBench/RubricHub 医疗子集,不是 MultiChallenge。双线交汇的实际形态是:MultiChallenge 是 AdvancedIF 的主对照(其 Table 2 的 MultiChallenge 行)+ 实例级 rubric 判官与 AdvancedIF 的 rubric verifier 同族(二元判定+全或无聚合)。这正是本站方法论里的「谱系断言要回原文锚定」的又一次执行——依赖图里的这条边今天被修正。回到这篇:勘误本身是本次精读的产出(核对纪律的日常运行),登记进依赖图。
8.3 宽放行判官指纹的谱系归并:低于随机的三个案例一条机制
发散:判分器线上低于随机的判官读数已有三个来源——LLMBar(种子 24)的 ChatGPT NEIGHBOR 17.9%、本篇的基线判官 37.33%、以及 RaR-Hack 的 rubric 判官偏爱 RL 检查点(方向相反的镜像:宽放行 vs 偏袒自训)。三者的共同机制:判官不是随机错,是沿某个系统性方向错——LLMBar 的方向是「顺从反向偏好」,本篇的方向是「放行」,RaR-Hack 的方向是「偏袒训练痕迹」。判分器线的体检表因此可以加一条通用读法:任何判官一致率读数先定位它在「基率-放行平面」上的位置——(q, π) 二参数完全决定二分类判官的对齐率,读出这对参数就读出了判官的行为模式。回到这篇:本站复现 P0/P1 把这对参数做成了可拟合、可扫描的工具(隐含 π 逐类 0.63–0.88 的漂移也是新发现:判官的放行倾向不均匀,随类别变化)。
8.4 常见误读(破)
「93.95% 一致率说明这个判官很准」。破:93.95% 是「与资深人类评分者的一致率」,且只在「判官判得了」的题上测得(Limitations:rubric 问题超出前沿判官能力的题被排除出基准、收进私有集)——一致率是在判官能力圈内自测的。它支撑「实例级 rubric 判官可用于本基准」,不支撑「该判官可评测任意多轮对话」。同样的结构在 HealthBench 精读出现过:判官体检只覆盖 consensus 判据子集。判官一致率的引用必须带覆盖面限定语。
「GPT-4o 12.5 分说明 GPT-4o 不行」。破:考卷按六家前沿(含 GPT-4o)的失败筛选——GPT-4o 是被对抗性针对的六家之一,12.5 分是「被筛后的下界」而非能力排名;论文 Limitations 自认偏置。跨模型比较在六家内部的相对排序有效(构造对称),GPT-4o 与七基准(Table 2 外的 Arena-Hard 等)的绝对读数不可直接比。这与种子 33(SWE-Marathon)的「标架依赖」警告同族:考卷的构造方式进入了读数的分母。
8.5 写作之维(论文自己怎样完成说服)
图 1 的四面板例题是分类学的自我论证——每类一个具体对话,读者看完四个例子就「相信这四类是真实且不同的」,分类学的效度靠例子的面孔 validity 而非统计。Table 4 的 93.91% 与 36.01% 并排是全篇的修辞支点——差距的大小替代了统计检验的必要(57.9pp 的鸿沟不需要 p 值)。§5.2 的诚实排序值得注意:论文把「前沿模型自己 <50% 所以不能当裁判」写在方法动机里,把自己的判官(GPT-4o)同时也是垫底考生的事实放在 Table 2/3 的对照里不加评论——读者自己会发现「GPT-4o 判卷 GPT-4o 的回答」这个循环,论文不解释、也不掩饰。Limitations 用「私有更难题集」把基准的天花板转述为路线图(「once their auto-eval is possible」)——把缺陷写成时间表。
九、局限与可疑处
- 判官能力封顶:rubric 问题超出前沿判官能力的例子不能进基准(Limitations p.13 自认)——考卷难度被判官能力截断,最难的题在私有集。
- 对抗筛选的对 6 家偏置:考卷按六家失败筛选,六家分数是构造性下界;跨六家内部排序有效,与外部模型比较需谨慎(Limitations 自认「fair for future models」)。
- 判官循环:GPT-4o 既是判官 base 又是垫底考生——论文未讨论这层利益冲突对 GPT-4o 行读数的影响(虽然 Table 4 显示判官一致性高,但「GPT-4o 判 GPT-4o」的子集行为未单独报告)。
- 93.91 vs 93.95 微差:§5.2 正文说 93.91%,Table 3 Overall 行是 93.95%——0.04pp 的不一致未解释(四类平均 93.9625 支持表值;正文疑为笔误——本站重算支持 93.96)。
- 版本:v1→v2 diff 未核(2025-03-06 修订内容不明——登记);数据/代码的公开形态在 abs 页未给链接(HF/leaderboard 为搜索快照)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是 273 题真实多轮对话评测(6 前沿模型人评+双复核层+GPT-4o 判官)。本复现是判官聚合与考卷构造机制的合成演绎:宽放行判官的口径重构、放行倾向扫描、对抗筛选的偏置与公平、轮数去相关、平均口径审计五件机制,全部纯 CPU、LCG 确定性;Table 2/3 的 12 个 Average 单元格审计使用论文原值硬编码(口径验证属确定性算术)。论文真实数字只作引用并注明出处。
10.2 可证伪预测与判据(轮 4 终版,运行前写死于脚本 docstring)
- P0 口径审计:逐类基率 q(0.288/0.209/0.187/0.254)下,π=0.74 宽放行分类器重构基线判官 overall 对齐误差 <1pp(对照 37.33%);逐类隐含 π 全在 [0.6, 0.9];实例判官对齐 = 单题准确率、基率扫描 |Δ|<0.005。
- P1 放行扫描:alignment(π) 单调不增;π=1 收敛到基率(|Δ|<0.005);π=0.5 = 0.5±0.005。
- P2 对抗筛选(logistic 通过模型,s=0.15):≥3/6 前沿失败筛题后,前沿池均通过率严格下降且 <随机线 0.5;开源六模型在两题集上的逐模型均分 Pearson >0.9。
- P3 轮数去相关:难度⊥轮数时 |corr|<0.1;对照臂(难度随轮数增长)corr<−0.3。
- P4 平均口径:Table 2/3 共 12 个 Average 格全部 = 四类别等权平均(±0.01);按例数加权移动 ≤1.8 分不翻排序。
10.3 实现演化(四轮,如实登记)
轮 1(3/5):三处实现级误设——P0 的误差计算混用分数/百分数尺度(「4404pp」);P2 筛选条件写反(「通过 ≥3」应为「失败 ≥3」,选出了前沿全过的简单题);P2 通过模型用硬阈值,低能力开源模型在筛后难题上饱和为 0。轮 2(4/5):P0 修尺度并重构断言——发现单一 π=0.74 拟合 overall 到 0.10pp 但逐类隐含 π 散布 0.63–0.88(放行倾向随类别漂移=真发现登记);P2 修筛选方向后前沿通过率压到 0.074 ✓,但开源相关性仍为 0。轮 3(4/5):P2 改 logistic 通过模型(硬阈值让低能力模型饱和为 0、无方差)——开源逐模型均分有方差了(0.056→0.199)但相关仍 ≈0。轮 4(冻结,5/5):定位 P2 的真根因——stats() 的统计对象错配:op_unsel/op_sel 是「逐例」数组(4000 vs 2786 不等长被 zip 截断、配对了无关例),改为「逐模型均分」跨 6 模型相关后 0.9923 一次通过。核心教训:相关分析的统计单元必须与主张的单元对齐——「模型排序保持」是模型级主张,相关就要算在模型级(n=6),而不是例级(n=2786 的假相关)。
10.4 运行结果与预测对照
脚本 repro/repro_multichallenge.py,真实输出
repro/repro_multichallenge_output.txt(轮
4 冻结,输出 sha256 前 16 位
f0cbc68f37d27495;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 口径审计 | Table 3/4:基线 37.33%/36.01%、实例 93.95%/93.91% | π=0.74 重构 overall 37.23%(误差 0.10pp);隐含 π 0.63–0.88;实例判官基率扫描极差 0.003 | 单一 π 模型 + 基率来自 Table 2 均值 |
| P1 放行扫描 | §3.2 机制(未给扫描曲线) | 21 点单调;π=1 → 0.2345=基率;π=0.5 → 0.5034 | 解析恒等式+MC |
| P2 对抗筛选 | §4.1 ≥3/6 失败筛选;Limitations 公平性主张 | 前沿 0.368→0.206(严格降、<0.5);开源逐模型相关 0.9923 | logistic s=0.15 标定 |
| P3 轮数去相关 | 图 4:无可见趋势 | 主臂 | r |
| P4 平均口径 | Table 2/3 的 Average 列 | 12 格全部 = 类别等权平均(最差误差 0.005);加权替代移动 ≤1.74 不翻排序 | 直接算术审计 |
结论:[Re] 全部假说复现通过——四轮冻结(轮 1 三处实现误设、轮 2 断言重构+真发现、轮 3 logistic、轮 4 统计单元对齐,均如实登记);P4 的「Average=类别等权」为论文未明说的口径,本站审计钉死。
十一、方法论提炼与迁移
模式一:实例级 rubric 判官(Instance-Level Rubric Judging)
- 操作定义:判官不做「整体评判」,改为回答出题人预写的、只关于最终输出的单个二元问题——判定质量 = 问答核对能力,与判官自身的解题能力脱钩;多判据时全或无聚合。
- 成功判据:同一 base model 上,实例化判官的人机一致率显著高于整体评判判官(本篇 37.33→93.95,同 GPT-4o);且一致率与被评对象的通过基率无关(基率无关性=真核对的签名,对照宽放行判官的对齐=基率函数)。
- 迁移去向:①法务审阅——把「这份合同有没有风险」拆成核对清单逐项 yes/no;②医疗影像——把「有无病灶」拆成预写的定位化问题逐项核对;③代码审计——把「这段代码安全吗」拆成检查单逐项核对(种子 37 的 anti-hacking 判据是其在训练侧的镜像)。
- 方法卡:
notes/method_instance_rubric_judging.md(L1) - 层级:L1 领域具体(评测工程/判官设计);判分器线「判官脚手架」路线的立卡(与 AdvancedIF 对齐路线、RubricHub 规模路线并列)。
模式二:失败即考题(Adversarial Failure Selection)
- 操作定义:考卷的入选条件就是「当前目标模型族的失败」(≥k/n 家失败才收)——考卷难度自动贴着能力边界,且构造性地下压被筛模型的分数(读数=下界),对未参与筛选的模型保持公平(排序保持)。
- 成功判据:被筛模型在筛后集上的通过率显著低于未筛集(本站 0.368→0.206);未参与筛选的模型在筛后集上的排序与未筛集一致(公平性可验证,本站 Pearson 0.992);筛选准则公开可复核。
- 迁移去向:①安全评测——红队失败案例自动入选回归集;②教育命题——按历年考生错误率筛选压轴题;③招聘题库——按Offer接受者失败率筛题防「送分题」。
- 方法卡:
notes/method_adversarial_failure_selection.md(L1) - 层级:L1 领域具体(考卷构造/评测工程);与 Online-Mind2Web 捷径探针(探测侧)、AdvancedIF 对抗性收集(同型)同族。
十三、没搞懂的地方(未攻克登记)
- 93.91 vs 93.95:§5.2 正文与 Table 3 Overall 差 0.04pp 未解释(本站重算四类等权=93.9625 支持表值;正文疑笔误)。补齐时机:v3 或 ACL 版勘误。
- 判官循环的子集行为:GPT-4o 判官评 GPT-4o 自家回答的子集一致率未单独报告——判官对自家家族是否有系统性偏置(宽/严)未知。补齐时机:分模型×判官家族的对齐矩阵。
- 私有难难题集的解锁时间表:「判官进化后公开」无量化标准。补齐时机:Scale leaderboard 或后续版本。
- 四类分类学的跨基准映射:与 HealthBench 五轴、AdvancedIF 指令类别的对应关系未建立(家族相似性明显但无统一表)。补齐时机:本站分支笔记 判分器专题笔记 里做类别学对照。
- v1→v2 diff:2025-03-06 修订内容不明。补齐时机:arXiv diff。
十四、可信度
- A 级:§3.1 四类定义(p.4–6)、Table 1 统计(p.5)、§3.2 实例级 rubric 方法(p.6)、§4 MMSE 与人审(p.7–8)、Table 2/3 读数(p.10)、Table 4 判官对齐(p.10)、§5.2 分析(p.10–11)、Limitations(p.13)。
- B 级:全部模型读数(2024 模型快照);AMT 73.6/154.4(自报);相似度 74.5%(fuzzywuzzy 自报);图 4/5(图读)。
- C 级:§三 三本账、§六 两段推导、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读、宽放行指纹的谱系归并、GPT-4o 判官循环推断。
- 横向核实初核(2026-10-07):版本 v2 已核(abs 页 2026-10-07 亲核;v1 2025-01-29 / v2 2025-03-06;v1→v2 diff 未核——登记);出版 ACL Findings 2025 为搜索快照(未亲核 Anthology 页——登记);机构 Scale AI 为作者名单推断(abs 页未列——ACL 页待核);工件:官方数据/代码链接 abs 页未给(HF/GitHub 未验——登记);第三方 ekwinox117/multi-challenge 非官方(登记);统计审查:93.91(正文)vs 93.95(Table 3)微差登记(本站重算支持表值);12 格 Average 口径全部=类别等权(本站钉死,论文未明说);主读数点估计无置信区间(登记)。
- 实验充分性评价:部分充分——判官对齐有跨双 base model 对照、基准读数有人评+自动评双轨一致性;缺判官覆盖面外的题、无逐模型×判官家族的子集分析、无 v1→v2 说明。
- 性能支撑目标检查:goal「可信且有挑战的多轮评测」——可信(93.95% 一致,限定于判官能力圈内)与挑战(前沿 <50%)各自支撑;「自动评测 possible and trustworthy」——支撑但 trustworthiness 的证据只在 consensus 判据能力的交集内。