外行导读(先读这个,再决定要不要进正文)
一个场景:你让一个智能体排查一个代码库里的 bug。它翻目录、搜函数名、读代码、写复现脚本——每一步的工具输出都堆在它的”桌面”(上下文窗口)上。干活越久桌面越满:到第几十步,桌面塞不下了。老办法有两种,都等于往垃圾桶里扫:把最早的东西直接扔掉(截断),或者把一堆原件压缩成一句”之前查过一些代码”(摘要)。可偏偏排障的最后一步,需要的是第 3 步看到的那个精确到行号的函数定义——原件已经进了垃圾桶。
这篇论文干的事:给桌面配一个带标签的档案柜。智能体定期把桌面清空,只留一页”进度便签 + 档案目录”(第 1 号:目录快照;第 2 号:搜索结果;第 3 号:line 152 定位……),原件按目录编号存进柜子。哪一步要用哪件原件,按编号精确取回、放回桌面。清桌(CompressExperience)与取件(ReadExperience)不是系统后台的固定规则,而是智能体自己可学的两个动作——用强化学习教它”什么时候清、什么值得存、怎么写目录、什么时候取”。结果:任务成功率翻三点五倍,桌面峰值占用反而降了四成。
为什么值得关心:三个理由。第一,它是 agent 线(记忆/技能)的第一颗种子,也是依赖图挂了很久的”Context Rot 后续 / 状态版本化”欠账的直接兑现——上下文塞不下正是 Context Rot 的工程面。第二,它把「记忆管理」从启发式变成 RL 可学的动作空间,这与本站执行侧三条线(IAL 停止判定、ATTC 影子价格、LATTS 闭环接受)是同一族问题:约束下的时机决策;而它的两条命题给了一个罕见的干净对偶——质量(命题 1)与效率(命题 2)各自需要什么条件。第三,它的实验是一份”如何把环境改造成必须有记忆才活得下去”的样本(look 每集限一次、摘要截断 300 token),这类设计本身就是考卷工程——正好接本站判分器线的考卷侧视角。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 工作上下文 M_work | 桌面上动态堆着的东西(系统提示与任务指令之外的全部消息) |
| 上下文预算 τ | 桌面容量上限(实验 8000 token;32K 窗口里给工作区留的份额) |
| 索引化摘要 σ | 一页便签:(进度要点 s, 索引表 I);索引表每行是”编号+一句话描述” |
| 外部经验库 D | 档案柜:编号 → 原件内容,全量保真,永不压缩 |
| CompressExperience | 清桌:把编号-原件对写进 D,桌面重写成 [系统提示, 任务, σ] |
| ReadExperience(i) | 取件:按编号取回 D[i],追加到桌面 |
| 解引用(dereference) | 按编号精确取件——确定性命中,不是”语义相似搜索” |
| B-界决策充分性 | 存在一个选件器 g:每步最多取 B 件、且取的恰是决策需要的——σ+这 B 件就能等价全史决策 |
| 三罚 | 预算溢出罚 P_context、冗余重跑罚 P_redundancy、格式错误罚 P_format,各归一到 [0,1] |
| 分段轨迹 | 每次清桌把轨迹切成两段;各段独立训练但共享同一终末奖励 R |
| 软触发 | 每步注入桌面余量提示([Context Status: working=…, threshold=…]),何时清桌由模型自己学 |
| 锚点抽取 | 存原件的第二种方式:给三段短文本(起/中/止锚点),系统按锚点逐字截取对话原文入档 |
§0 承接栏
这颗种子是 agent 记忆/技能支线的第一篇,也兑现了此前登记的上下文容量欠账。长上下文塞不下(Context Rot)是症状,本篇给的是处方:状态要显式版本化——σ 就是那个被压缩、被索引、可恢复的状态版本,D 是不压缩的底账。它与本站已有的两块拼图直接对齐:LongHorizon-Harness(种子 1)的 fresh-context 执行器用”丢历史”换预算,Memex 用”归档+解引用”换预算——同一压力的两种回答(§八.1);执行侧测试时分配线(ATTC/LATTS/Damani)回答”算力怎么按需分配”,本篇回答”证据怎么按需取回”——读取预算 B 就是记忆版的影子价格(§八.2)。对判分器线它是外线旁证:索引化让”记忆访问精确且可审计”(p.3 原词 auditable),与本站 read-only 审计器”只信可验证事实”同族——索引指向具体工件,而不是模糊匹配。
一、论文在解决什么问题
1.1 一个具体场景
§1
p.2:智能体做的是几十到几百步的工作流——查文献交叉引用、探代码配置空间、编排多
API
业务流程。成败不仅取决于每步的推理质量,还取决于”很多步之前首次出现的信息,还能不能被用上”:任务开头提到的一条约束、某次工具调用暴露的失败模式、一段当时不起眼后来才决定性的
API 响应。这就是贯穿示例的形状:排障第 5 步看到的
unitsystem.py line 192–196 的 Function 分支,是第 20
步打补丁时唯一可靠的依据。
1.2 旧做法的病根:三条死路(§1 p.2)
第一条,全保留:轨迹线性增长,提示词迟早超预算;而且就算证据还在场,远距离证据的利用效率也在下降(论文引 An et al. 2024 / Wu et al. 2024,转引未读)。第二条,截断或滚动摘要:能缩,但本质上有损——压缩或丢弃的是证据本身,之后无法忠实恢复。第三条,语义相似检索(把一切记进外部库、按相似度取):在长程工具使用里脆弱——记忆池充满噪声与近重复片段时检索变模糊,模型反复重新解析松散历史;更根本的,相似检索不回答”智能体该怎么组织自己的经验”:哪些中间结果值得稳定引用、哪些分支是死路、工件该怎么命名才能让后来的访问精确而非模糊(p.2 原文集中论证了这一段——这是全文的立论根基)。
三条死路合起来逼出一个约束清单:预算必须守(不能全保留)、证据不能丢(不能截断/摘要)、访问必须精确(不能模糊检索)。同时满足三条的解,读者此刻应该已经能自己拼出来了——桌面留摘要、原件入库、按编号取——缺的只是”谁来做、何时做”。论文的回答:智能体自己做,做成动作,用 RL 学。
1.3 问题形式化的入口(§3.1 p.4)
论文的形式化从两个对象开始:上下文窗口 M 与外部经验库 D:\ \text{index} \mapsto \text{content}。M = [m_0, u, M_{\text{work}}]——系统提示 m_0 与任务指令 u 是两个”永不清桌”的锚(Algorithm 1 line 4 注释),工作上下文 M_{\text{work}} 是动态部分。要解的问题由此可写:在 |M_{\text{work}}| 不超预算的约束下,长程任务的决策质量不降。注意这个问题陈述里没有”摘要质量”这种中间指标——质量与预算是仅有的两端,中间全是机制设计的自由度。
二、核心想法
一句话:把”压缩上下文”改写成”搬家”——桌面(工作上下文)只留一页带索引的便签 σ,原件全量搬进档案柜 D,要用哪件按编号取回;清桌与取件都是一等动作,用带三罚的 RL 学出时机。
直觉先打底。这就像工程队收拾工地:材料不能扔(截断/摘要都等于扔——你不知道哪块板子第 30 天还要用),也不能全堆在脚手架上(全保留——平台承重有限)。老工头的做法:脚手架只放”今日进度牌 + 材料清单”,材料入库挂牌,要用哪件按牌取。工地干得越久,库越满、牌越详细,但脚手架上的东西不增——承重(预算)守住了,材料(证据)一件没丢。MemexRL 训的就是这个”收拾的手感”:什么时候收(软触发+溢出罚)、哪些值得挂牌(索引质量由后续取用兑现)、挂牌怎么写才找得回(描述由读取成功间接监督)。
全篇就看这张:图 118——左边是贯穿示例的压缩前/后账本(5380 token 的六步轨迹 → 300 token 的 σ + 六枚索引,原件 3410 token 入 D),右边是 Algorithm 1 循环全景与 MemexRL 的奖励、分段、读数。一张图装下机制的全部骨架。
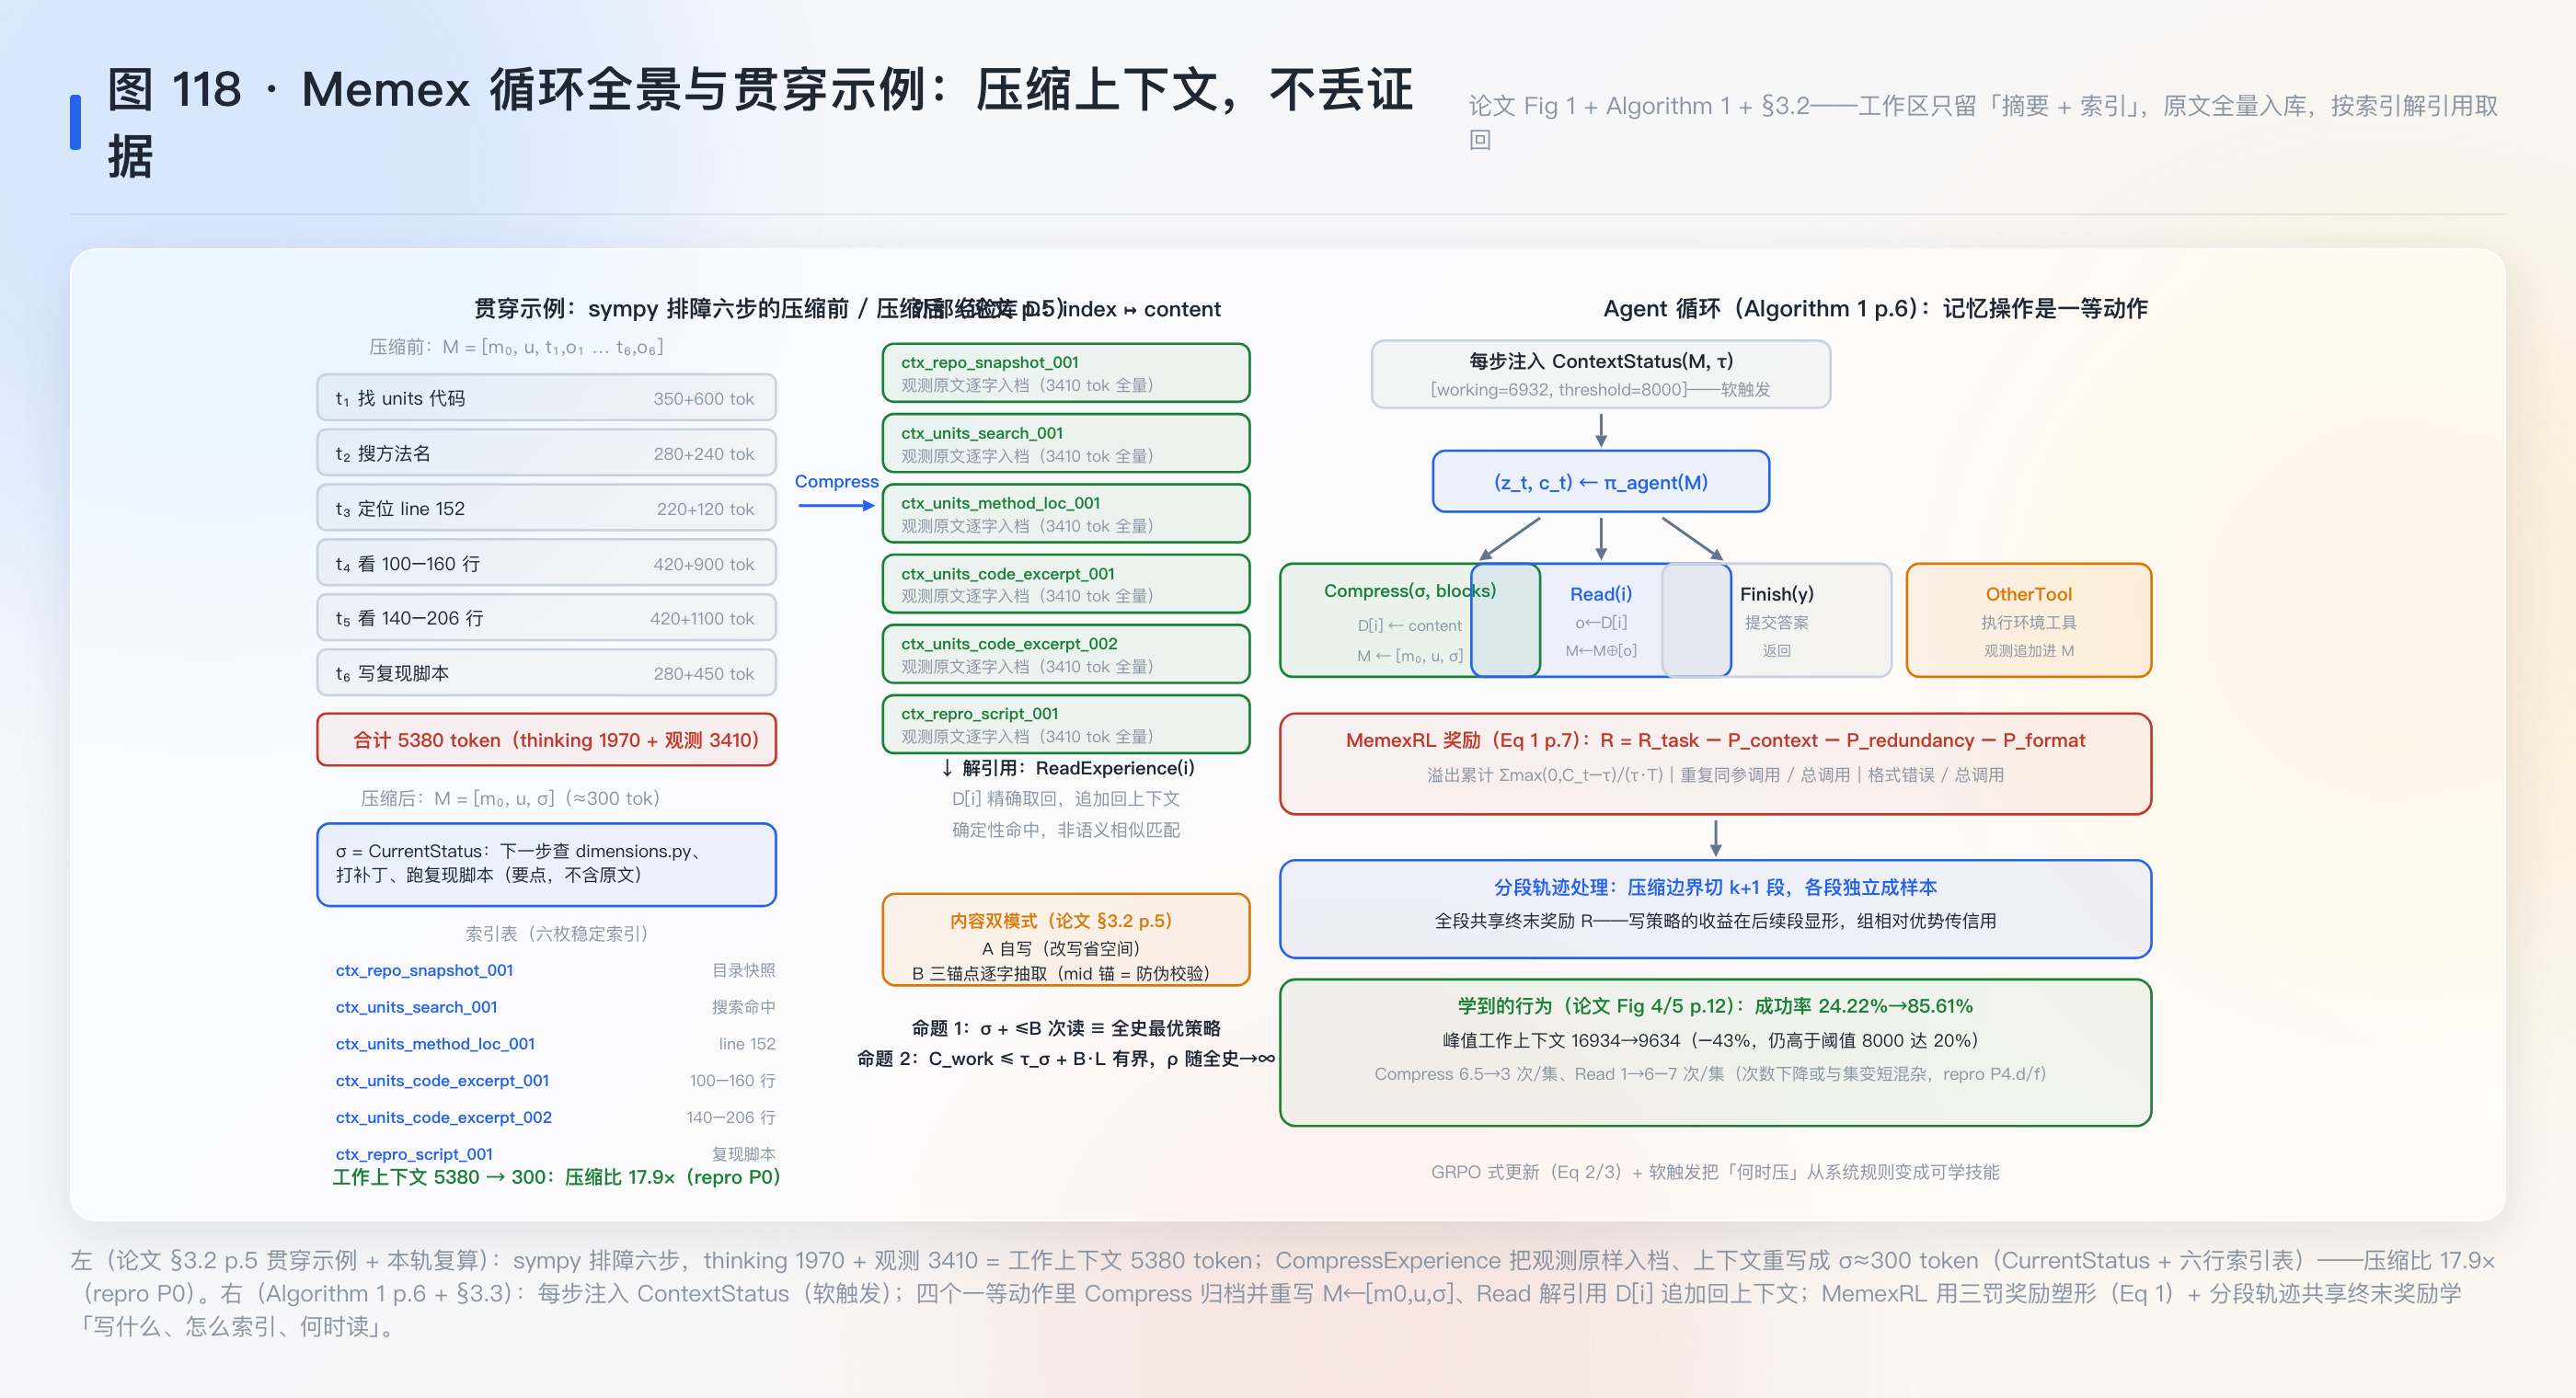
形式化入口:Definition 1(Indexed Summary,§3.2 p.5)给 σ 的结构 \sigma = (s, I)——s 是紧凑可执行的进度状态(已验证的信息、计划),I = \{(\text{index}, \text{description})\} 是索引表,index ∈ dom(D)。Definition 2 给整个记忆装置四件套:在场的 σ、外部的 D、压缩操作(写 (index, content) 进 D、把工作上下文重写为 [m_0, u, \sigma])、读取操作(o \leftarrow D[\text{index}],追加回上下文)。它把问题重新形式化成了什么?从”上下文管理”(怎么在窗口里塞下更多)变成”经验管理”(怎么组织一个可精确访问的档案系统)——问题从容量问题变成了组织问题。
三、数学基础(零起点,四件工具逐一发明式拆解)
本节外部断言:信息论压缩的可逆/不可逆区分(T 序列 T5 已学,本站内部知识);Bush 1945 词源见文首核对状态块。
3.1 第一件:上下文记账——预算约束写成不等式
先摆问题。任何方案先得把”装不下”写成数学。设第 t 步工作上下文长度 C_t(token 数,不含 m_0, u),预算阈值 \tau。约束是 C_t \le \tau\ \forall t——不是平均不超,是任何一步都不超(实验里窗口 32K、\tau=8000,§5.1 p.11:预算比窗口小,给系统提示与任务指令留了位)。
候选方案死一个:①”软预算”(平均不超、尖峰可超)——死于工程现实:窗口是硬的,尖峰就是溢出,推理直接失败。论文的三罚之一 P_{\text{context}} 就是把这条硬约束变成可学的软压力(§3.3 Eq 1,§六.3 数值例)。
记账例(贯穿示例立账):六步排障,每步 thinking+observation 为 (350{+}600), (280{+}240), (220{+}120), (420{+}900), (420{+}1100), (280{+}450)——累计 C_6 = 5380。若 \tau = 8000,这一集还装得下;论文真正的长程任务里几十步就破万(full 终值 16934 是训练前 agent 的峰值读数,Fig 4b)。这页账在 §十.2 由机器逐位复算(P0)。
名字最后给:论文称 working context 与 context budget(§3.1 p.4)。
3.2 第二件:指针化——“压缩不丢证据”为什么只剩这一条路
先摆问题。约束(3.1)与证据不丢(§1.2)同时成立,要求一种”上下文变小而信息无损”的操作。信息论上这有两种:可逆压缩(可完全还原)与不可逆压缩(有失真)。摘要是哪种?
拆部件反证:摘要号称”保留了要点”,但要点是面向当前子目标的——写摘要的瞬间没人知道第 30 步需要什么。把”可逆性”翻译成工程语言:存在一个解码器,从压缩后的上下文恢复原始证据。截断的解码器不存在(信息物理删除);摘要的解码器是”生成模型猜原文”——对精确对象(长 ID、代码行号、日志串)猜测不是恢复,是幻觉通道。语义检索(第三条死路)的解码器是”相似度匹配”——它恢复的是”最像的片段”,不保证是”那段证据”,且池一大就近重复互相污染(§1 p.2)。
三条路都断之后,唯一同时满足”上下文小 + 可精确恢复 + 池可增长”的结构就剩:把证据本体放到上下文外(预算不管它),上下文里只放它的可区分名字。这就是指针(index)。唯一性演绎:名字必须全局稳定(同一件证据多个名字会分叉账本)、必须可由 D 反查(名字∈dom(D))、描述必须由人/模型可读(选件器 g 靠描述选)——三条件逼出来的形状恰是 Definition 1 的 (s, I) 对。
停下来猜一下(猜论文):存进 D 的”原件内容”这个参数怎么设计?如果你来定,怎么让它既能”改写省空间”、又能”原文保真”?提示:逐字重抄一遍最保真但要花生成 token,且抄错一个字符证据就毁了。猜完翻原文——§3.2 p.5 给了双模式:Option A 模型自写内容(改写、组织、省空间),Option B 三锚点抽取(start/mid/end 三段短文本,系统按锚点从当前对话逐字截取,mid_anchor 是校验位,防错位匹配)。锚点方案把”保真”从生成问题变成定位问题——模型只需要指认边界,不需要复写内容。这是全文我最喜欢的一处工程设计。
数值例(贯穿示例翻账):六步轨迹里,六枚索引
ctx_repo_snapshot_001(目录快照)、ctx_units_search_001(搜索命中)、ctx_units_method_loc_001(line
152 定位)、两枚
ctx_units_code_excerpt(代码段)、ctx_repro_script_001(复现脚本)——描述共几十
token,原件 3410 token 入 D。桌面 5380→300,压缩比
17.9×(§十.2 P0 机器复算)。
3.3 第三件:B-界决策充分性——什么时候”便签+取件”不输”全史在场”
先摆问题。指针化只保证”取得到”,不保证”取得起、取得对”。如果第 30 步的决策要同时用 40 件原件,或者索引描述写歪了导致选件器选错——桌面照样爆或者决策照样错。需要把”不输”的条件写清楚。
活路(Definition 3,§4 p.10):称 \sigma_t 是 B-界决策充分的,若存在索引选择器 g 与决策函数 \mu,使 |g(\sigma_t)| \le B 且
\pi^{*}(\cdot \mid M_t^{\text{full}}) = \mu\!\left(\cdot \mid \sigma_t,\ \{D_t[i]\}_{i \in g(\sigma_t)}\right)
逐符号:\pi^{*} 是全史最优策略;M_t^{\text{full}} 是完整消息史;等式说的是”最优动作分布可以由 σ 加至多 B 件取回的块完全复现”。这不是对世界的假设,是对这对 (\sigma, D) 的假设——摘要写得烂,充分性就不成立;任务本身需要一次几十件证据,B 就得大。
这个定义的名字应该让读者想起什么?充分统计量:\sigma_t 之于 M_t^{\text{full}},就像统计量之于样本——决策只依赖它(加有界的补充读取)而不依赖全量数据。依赖图上”状态/充分统计量/马尔可夫分解”节点(STATE)在此第一次拿到一个可计算、可证伪的版本:充分性不是哲学主张,是”存在 g 与 μ”的存在性命题,复现 P3 就在构造它的反例侧(B=1 撞上一步需两件 → 成功率 0)。
段末微问:那么 B 该多大?论文实验里没人显式设 B——它是理论量。你想过没有,软触发+三罚的世界里,B 其实被”预算”隐性定价了?
3.4 第四件:三罚的归一化账——把工程约束翻译成可学压力
先摆问题。有了机制(两个动作),行为从哪来?提示词规则(“建议在 0.8τ 时清桌”)能写,但论文 §3.3 p.6–7 的论点是:清桌的价值只在很多步之后显形(一次好的索引避免了后面的重复搜索与溢出),提示词教不会”时机”。
活路(Eq 1,§3.3 p.7):episode 级回报
R = R_{\text{task}} - P_{\text{context}} - P_{\text{redundancy}} - P_{\text{format}}
三个罚项各归一到 [0,1](设计与归一化理由见 §六.3 的数值例):P_{\text{context}} = \min\{1,\ \sum_t \max(0, C_t - \tau) / (\tau T)\}(累计溢出,除以”最坏合理溢出”\tau T 封顶);P_{\text{redundancy}} = N_{\text{redundant}} / N_{\text{tool\_call}}(同工具同参数、且其间无状态改变的重跑占比);P_{\text{format}} = N_{\text{malformed}} / N_{\text{tool\_call}}(标签不闭合/JSON 无效/缺字段——给未经工具微调的基座模型的直接学习信号)。
为什么是这三个?每一个罚项都对着一个”不走记忆的偷懒出口”:不清桌硬扛(溢出罚)、不取件而原样重跑工具(冗余罚——注意它与 ReadExperience 的耦合:读过就免罚,这是”读被立起来”的制度根源)、格式崩坏(格式罚)。三罚合起来把动作空间里所有的偷懒路都定了价,剩下的最优路径就是论文想要的行为。这个”约束→罚项→行为”的翻译手艺,§十一 立卡。
3.5 整体收拢
四件工具是一条链:记账把”装不下”钉成不等式(3.1)→ 三条死路逼出指针化的唯一性(3.2)→ 充分性写清”不输全史”的存在性条件(3.3)→ 三罚把工程约束变成可学压力(3.4)。回到这篇:前两件是论文的装置,第三件是它的质量凭据(命题 1 的载荷假设),第四件是它的训练法——四件合起来,“清桌的手感”才从比喻变成可优化的目标函数。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| M = [m_0, u, M_{\text{work}}] | 上下文窗口:系统提示 + 任务指令 + 工作上下文 | §3.2 p.4 |
| D:\ \text{index} \mapsto \text{content} | 外部经验库(键值档案柜) | Definition 2 |
| \sigma = (s, I) | 索引化摘要:进度状态 + 索引表 | Definition 1 |
| C_t / \tau | 第 t 步工作上下文长度 / 预算阈值(8000) | §3.1, §5.1 |
| \text{CompressExperience}(\sigma, \text{blocks}) | 清桌:写 D、重写 M | Definition 2(iii) |
| \text{ReadExperience}(i) | 取件:o \leftarrow D[i],追加回 M | Definition 2(iv) |
| B / g(\sigma_t) / \mu | 每步读取上限 / 索引选择器 / 决策函数 | Definition 3 |
| \tau_\sigma / L | 摘要长度界 / 单块长度界(命题 2 用) | Proposition 2 |
| R / P_{\text{context}} 等 | episode 回报与三罚(各∈[0,1]) | Eq 1 |
| A^{(g)} | 组相对归一优势 (R^{(g)}-\text{mean})/(\text{std}+\epsilon) | Eq 2 |
| S_0 \ldots S_k | 压缩边界切出的 k+1 段轨迹 | §3.3 p.7–8 |
五、机制
5.1 机制一:两个一等动作与双模式内容(§3.2–3.3 p.5–6)
CompressExperience 与 ReadExperience 和环境工具、Finish 并列在同一个工具集里(Algorithm 1 line 2:T = \{\text{Compress}, \text{Read}, \text{Finish}, \text{OtherTool}\})。“一等”的含义是实打实的:它们的调用走同一条生成通路(模型吐 tool_call JSON),吃同一个奖励(Eq 1 不区分动作来源),坏调用同样吃格式罚。这带来一个论文没有明说但很要紧的推论(补充):记忆行为与任务行为共享同一个信用分配通道——分段轨迹里,一次清桌的好坏由后续所有段的终末回报共同评价,模型没法把”记性差”藏进”任务难”里。
内容双模式(§3.2 p.5,3.2 的猜点已 reveal):Option A 自写(模型组织内容,换取密度),Option B 三锚点(系统按锚点从对话逐字截取;mid_anchor 的角色是校验——三段都要命中才算定位成功,防”错位匹配”)。锚点方案还有一个隐含好处(补充):它把入档成本从”内容长度级”(要重新生成一遍原文)压到”边界指认级”(三段 20–100 字符),对代码段/测试输出这类长原件是数量级的节省。代价是脆弱性:论文自己的 prompt 都在警告”别拿 10 行代码当锚点,空白差异会失败”(附录 B p.20)——锚点失败率论文未报(§九.6 登记)。
5.2 机制二:Agent 循环与软触发(Algorithm 1 p.6)
循环骨架四分支(走一遍贯穿示例):每步先注入 ContextStatus——“[Context Status: working context tokens=6932, threshold=8000]”(p.6 原例)——然后模型出 thinking+tool call。走 OtherTool(如 view unitsystem.py lines 140–206),观测追加进 M;走到第 6 步后工作上下文 5380+,模型若判断证据密集段结束,调 CompressExperience(σ, 六个块)——D 写入六件,M 重写为 [m_0, u, \sigma];到第 20 步要打补丁,调 ReadExperience(ctx_units_code_excerpt_002) 取回 line 140–206 原文,追加回 M,照着写补丁;Finish 提交。
你有没有注意到 ContextStatus 是每步都注入,而不是超阈才注入?这个细节区分了两种设计哲学:Lu et al. 2025(SUPO,转引未读)在超阈时自动强制摘要——时机是系统规则;Memex 把余量信息常驻可见,把”何时清”留给模型,用溢出罚事后定价。软触发的含义是:模型可以学到”任务还有两步就完了,扛着溢出不清桌更划算”(p.8 原文明说这是软触发相对硬阈值的灵活性来源)。
拆部件反证:把 Algorithm 1 line 14 的重写 M \leftarrow [m_0, u, \sigma] 改成追加 M \leftarrow M \oplus [\sigma] 会怎样?清桌变成”叠便签”——工作上下文不再重置,C_t 的锯齿失效、单调增长照旧,命题 2 的上界前提(摘要替换而非追加)被拆掉,预算约束回到原点。“替换”才是压缩,“追加”只是标注。同理反问:那读取(line 17)为什么是追加而不清理?——取回的块要供下一步决策直接用,它的清理由下一次清桌完成;段内读块累积是命题 2 里 BL 项的来源(段内工作上下文 = σ + 本段新步 + 本段已读块)。
5.3 机制三:MemexRL——三罚、分段、GRPO(§3.3 p.6–8)
分段轨迹处理是本文训练侧最有意思的发明(p.7–8)。问题:压缩改变了后续生成的条件前缀——第 2 段的 token 概率不再以第 1 段的历史为条件,“一条轨迹一个样本”的常规多轮训练在这里断了。做法:按压缩边界切成 S_0 \ldots S_k,每段独立 tokenize、独立在自己的上下文里算损失,但所有段共享同一个终末奖励 R——组相对优势(Eq 2)在段间不变。效果:清桌决策(第 1 段的动作)的收益显形在第 3 段的结果上,共享 R 让梯度穿过段边界。
为什么这能行而不会把信用搅浑(补充,§六.3 展开):组相对优势比的是”同一 prompt 下不同 rollout 的 R”——一个 rollout 的清桌策略烂,它的 R 低,它所有段的优势同为负;好清桌的 rollout 全段同正。信用是 rollout 级的,不是 token 级的——这恰好匹配”清桌的价值只能整体评价”的性质。代价是信用粒度粗(好清桌+烂执行的 rollout 会被低估),论文未讨论(§九.5)。
外层是标准 GRPO 式更新(Eq 2/3):组内 G 个 rollout(实验 G=8),归一化优势,PPO 裁剪目标加 KL 正则(\lambda_{KL}=0.001,lr 5e-6,Adam,wd 0.1;§5.1 p.11)。工程细节:INT4 推理+量化感知训练(权重前向 INT4、梯度 BF16 累积)、截断重要性采样(clip 2.0)对付多轮交互的推理-训练失配、token-in-token-out 免重切分。先监督热启动(well-formed σ 与块集的演示)再 RL(p.8)——热启动数据规模未报(§九.4)。
5.4 机制四:实验读数与行为迁移(§5 p.11–12,Fig 2–5)
环境是改造版 ALFWorld,四处刀口都朝”逼记忆出场”:隐去合法动作清单(导航要探索)、隐去初始观测(位置 ID 必须主动 look)、look 每集限一次(位置 ID 之后只能靠 ReadExperience 找回——论文原话”creating an explicit dependency on the memory retrieval mechanism”,p.11)、摘要截断 300 token(ID 塞不进 σ,p.11)。这套改造本身就是一份”考卷工程”样本:把泛泛的”长程任务”钉成”证据在远处且必须逐字取回”的可控测量(§八.3 误读二会回来用它破一个流行误读)。
读数四组:①成功率 24.22%→85.61%(3.53×;Fig 4a),训练曲线从 ~20% 爬到 90%+(Fig 2);②峰值工作上下文 16934→9634(−43.1%,Fig 4b)——注意 9634 仍高于阈值 8000 达 20.4%,论文措辞”approaching the threshold”弱于实况(§十.2 P7.c);③罚总额 −0.4→−0.1(Fig 3);④行为迁移(Fig 5):Compress 6.5→3 次/集、Read 1→6–7 次/集——“从反复重写上下文转向构建可复用的索引化记忆”(p.12 原文)。这组行为读数是全文最被引用的图,但它的因果解读有一个未拆的混杂:成功率翻 3.5 倍意味着成功集变短,压缩次数 ∝ 集长(复现 P4.f),“6.5→3”里有多少是”压得更准”、多少是”活得短”——论文没拆(本站复现 P4.d 甚至在受控世界里把”软触发压得更少”这个预登记方向给否定了——详见 §十.4,这是本篇复现的最大真发现)。
最值钱的实验(Fig 4 双联图 + Fig 5):Fig 4 单独撑起”训练有效”这半边主张;但真正值得只看的一组是 Fig 5 的行为迁移——它把”RL 学到了记忆行为”从结果断言变成过程证据:如果只是任务能力变强,Read 次数没理由涨 6 倍;Read 涨、Compress 降的组合只有”学会用索引”一种解释方向(混杂项影响次数的量,不影响方向——Read 的方向与集变短无关,反而更难)。
六、数学展开
6.1 命题 1 的完整载荷分析(Proposition 1 + 附录 A.1)
命题(p.10):若每步 \sigma_t 都 B-界决策充分,则存在只用 σ、每步至多 B 次 ReadExperience 的策略 \pi_{\text{IEM}},使 J(\pi_{\text{IEM}}) = J(\pi^{*})。
证明(附录 A.1,三句话):定义 \pi_{\text{IEM}}(\cdot \mid \sigma_t, D_t) \triangleq \mu(\cdot \mid \sigma_t, \{D_t[i]\}_{i \in g(\sigma_t)})——按充分性定义,这恰等于 \pi^{*}(\cdot \mid M_t^{\text{full}});每步动作分布相同 → 轨迹分布相同 → 期望回报相同。∎
这个证明的构造性正是它的弱点所在:命题假设了 g 与 μ 的存在,然后只是”用了它们”——数学上无懈可击,信息量为零;全部重量压在 Definition 3 的存在性假设上。把它读成一条有用的定理的方式(补充):它是”失效边界定理”——充分性什么时候不成立?三个可枚举的破坏源:①任务的决策真正依赖 >B 件证据(复现 P3.a:一步两用、B=1 → 成功率 0);②σ 的索引表没有覆盖决策相关证据(选择器无解——wrong-selector 变体,P3.c);③μ 本身超出模型能力(σ+块都在场但模型用不好——这一条机器复现做不了,正是论文实验存在的理由)。论文自己的定位也诚实(p.9:“not meant to claim that MemexRL always learns such summaries…rather, it characterizes the regime”)——它给的是”体制”(regime),不是”保证”。
回到核心问题:命题 1 与”状态=充分统计量”的对读由此落定——σ 是可计算的充分统计量候选,充分性是否成立取决于摘要质量与任务的信息结构,且可证伪:构造一步多用的任务即可测 B-界(本站就是这么复现的)。
6.2 命题 2 的推导与三条界(Proposition 2 + 附录 A.2)
命题(p.10):若 |\sigma_t| \le \tau_\sigma、|I_t| \le B、|D_t[i]| \le L,则 C_t^{\text{work}} \le \tau_\sigma + BL \triangleq C_{\max}^{\text{work}},从而压缩比 \rho_t = C_t^{\text{full}} / C_t^{\text{work}} \ge C_t^{\text{full}} / C_{\max}^{\text{work}} \to \infty。
推导不跳步:工作上下文按定义是 C_t^{\text{work}} = |\sigma_t| + \sum_{i \in I_t} |D_t[i]|(p.10)——摘要加当步取回的块。逐项放缩:|\sigma_t| \le \tau_\sigma(假设一);\sum_{i \in I_t}|D_t[i]| \le |I_t| \cdot L \le BL(假设二×假设三,求和放缩为项数×上界)。相加即得。\rho 的下界是除法单调性:分母 ≤ 常数,分子增长,商 ≥ 常数倒数 × 分子。∎
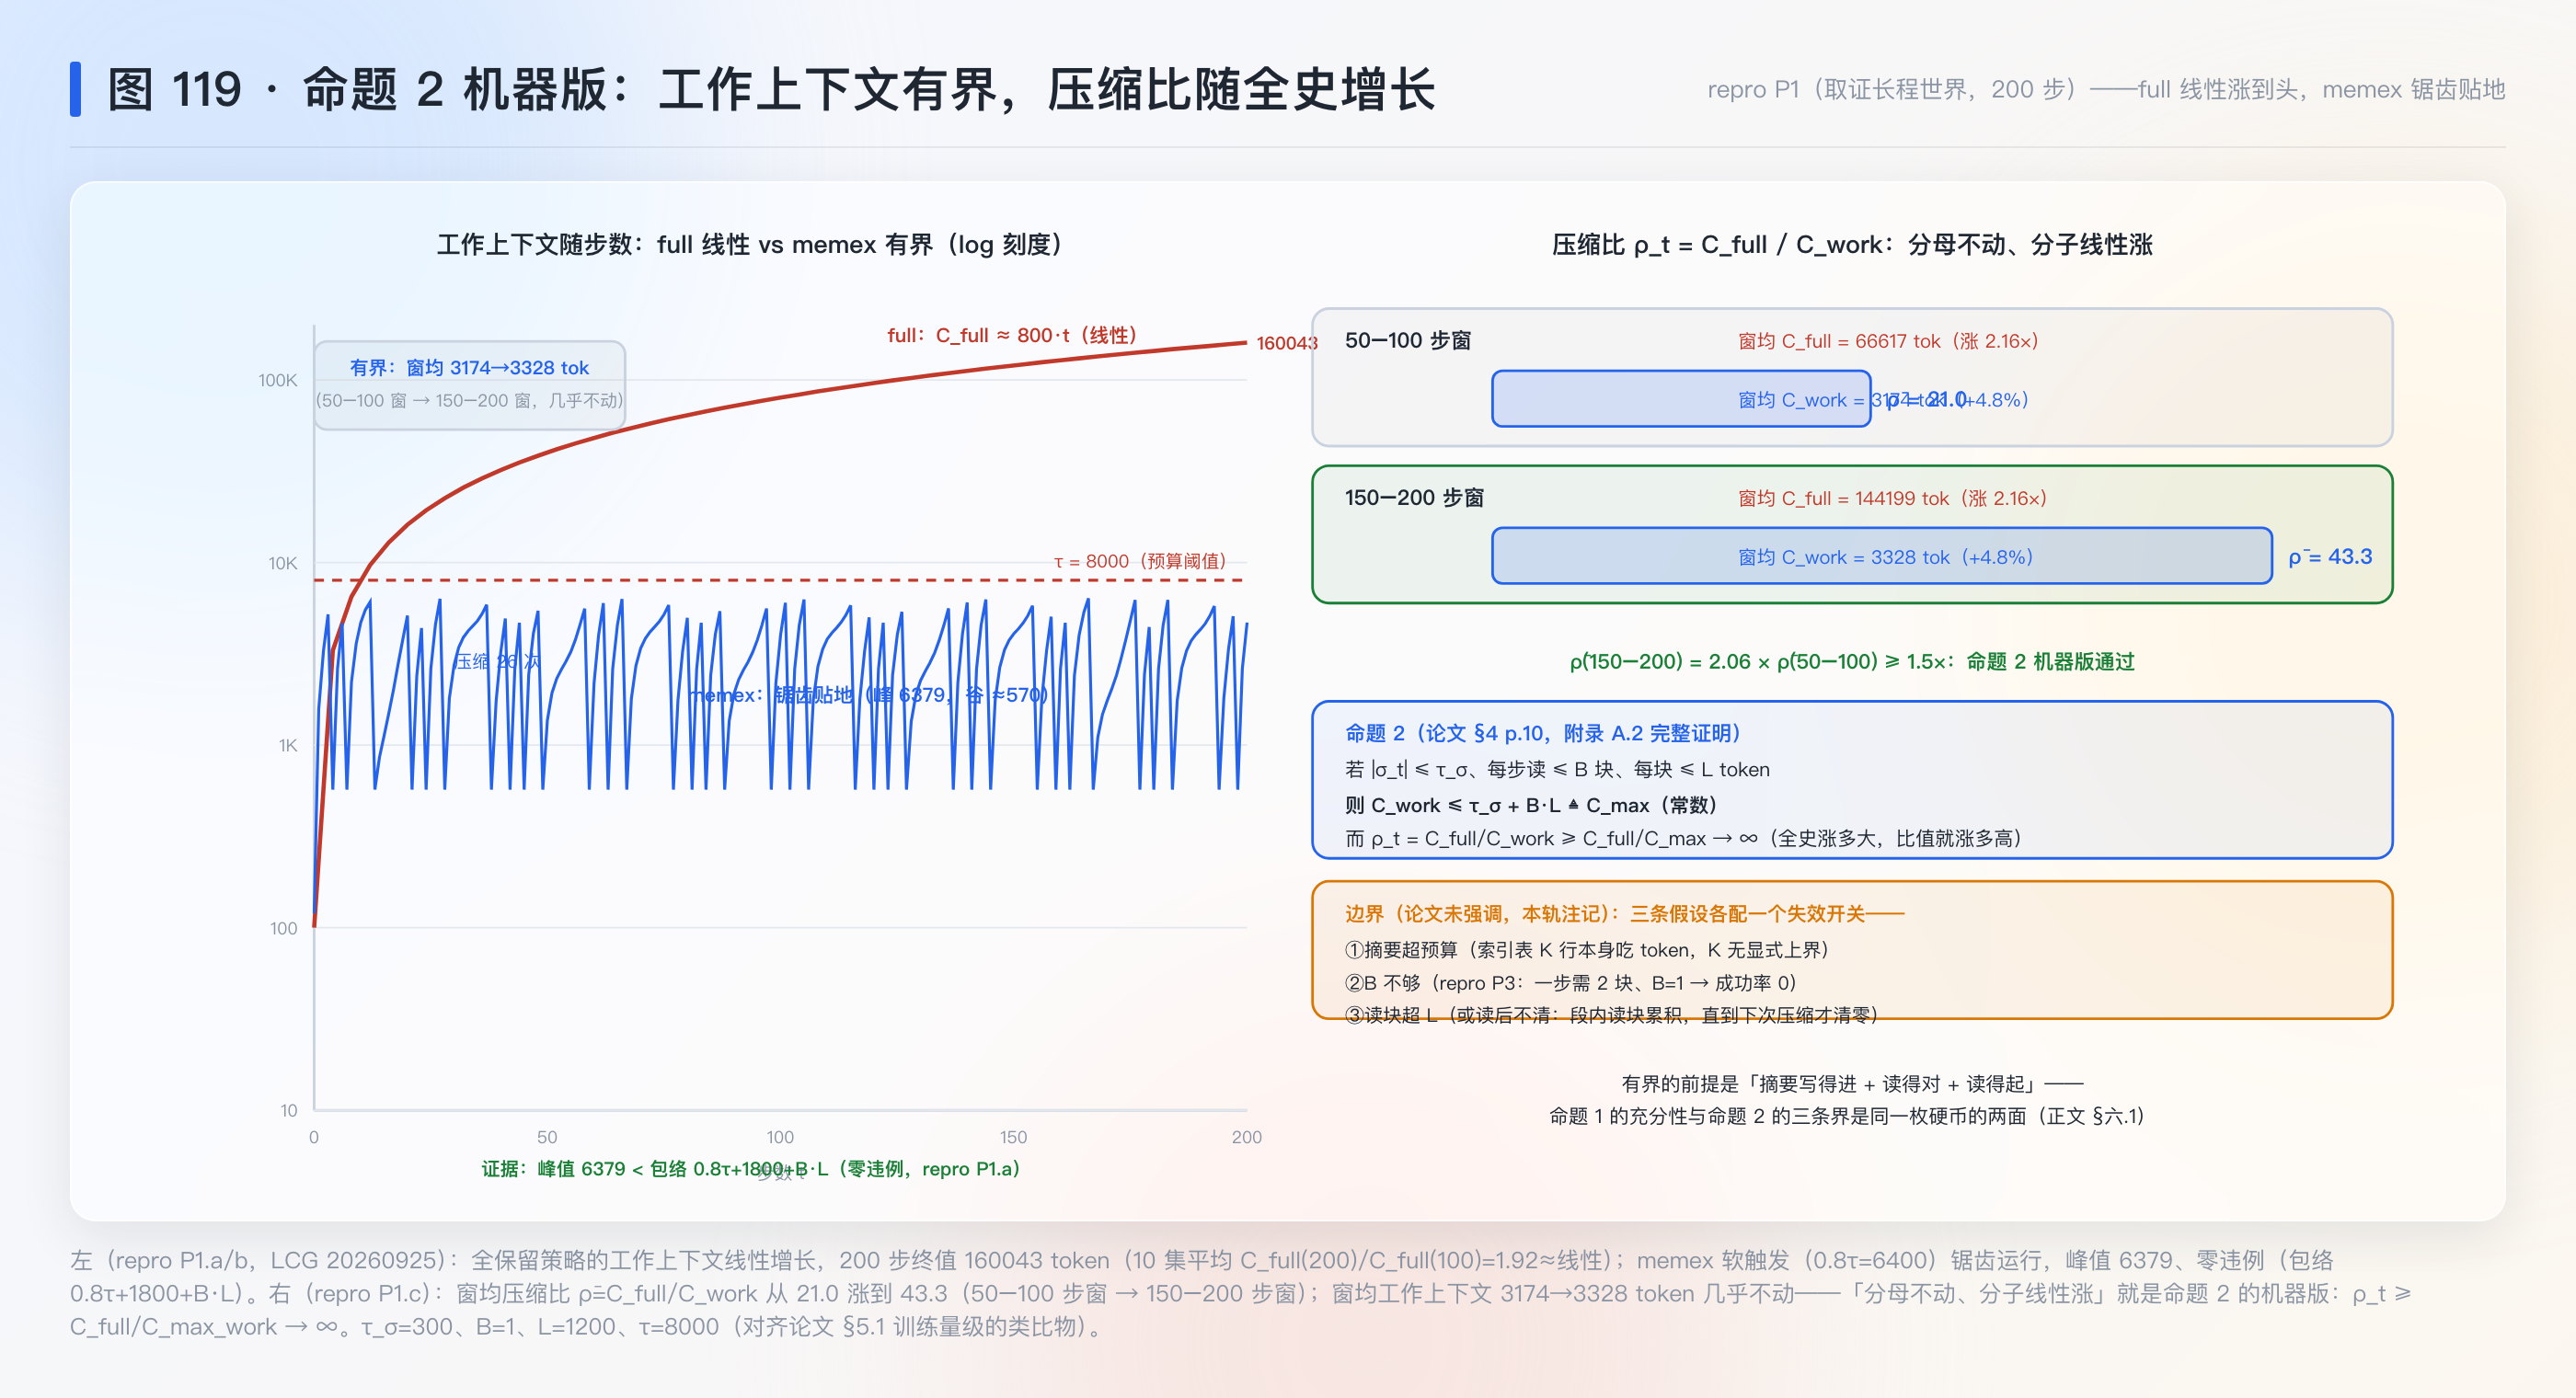
算术上这确实是”三行证明”,但把它当废话读就错过了它的结构价值:三条假设各配一个失效开关(补充):假设一破——索引表 K 行本身占 token,K 无显式上界,任务越长 K 越大,σ 可能顶穿 \tau_\sigma(论文用截断 300 硬扛,代价是长索引表被截——索引丢失即充分性破坏);假设二破——即 6.1 的 B-界;假设三破——单块超 L(或读后不清:段内多次读累积,直到下次清桌才归位,BL 变 B'L,B'=段内累计读数)。三个开关指向同一个结论:命题 1 与命题 2 不是两条独立的定理,是同一枚硬币——“读得起、读得对、写得进”——的质量面与效率面。复现 P1 把这条命题做成了 200 步的机器版(图 119):full 线性涨到 160043,memex 锯齿峰值 6379、窗均 3174→3328 几乎不动,压缩比 ρ̄ 从 21.0 涨到 43.3。
6.3 三罚的数值例与 P_context 的饱和(补充,Eq 1 的账)
用贯穿示例加两步虚构把三罚算活。设 τ=8000、T=60 步、一个”从不清桌”的 agent:每步平均长 800 token,C_t = 800t。溢出从 t=10(C_{10}=8000)开始累计:\sum_{t=10}^{60}(800t - 8000) = 800\sum_{t=10}^{60}t - 8000 \times 51 = 800 \times 1815 - 408000 = 1044000。归一化分母 \tau T = 480000——比值 2.18 > 1,被 \min\{1,\cdot\} 封顶到 1。这就是”饱和”:全保留策略的任务分满分,上下文罚也是满分,R = 1 − 1 = 0。归一化分母选 \tau T 的含义:哪怕全程两倍超限,罚也只到 1——三罚与任务分同量纲,不会一票否决到负无穷(与 PPO 裁剪同族的”破坏有界”设计)。
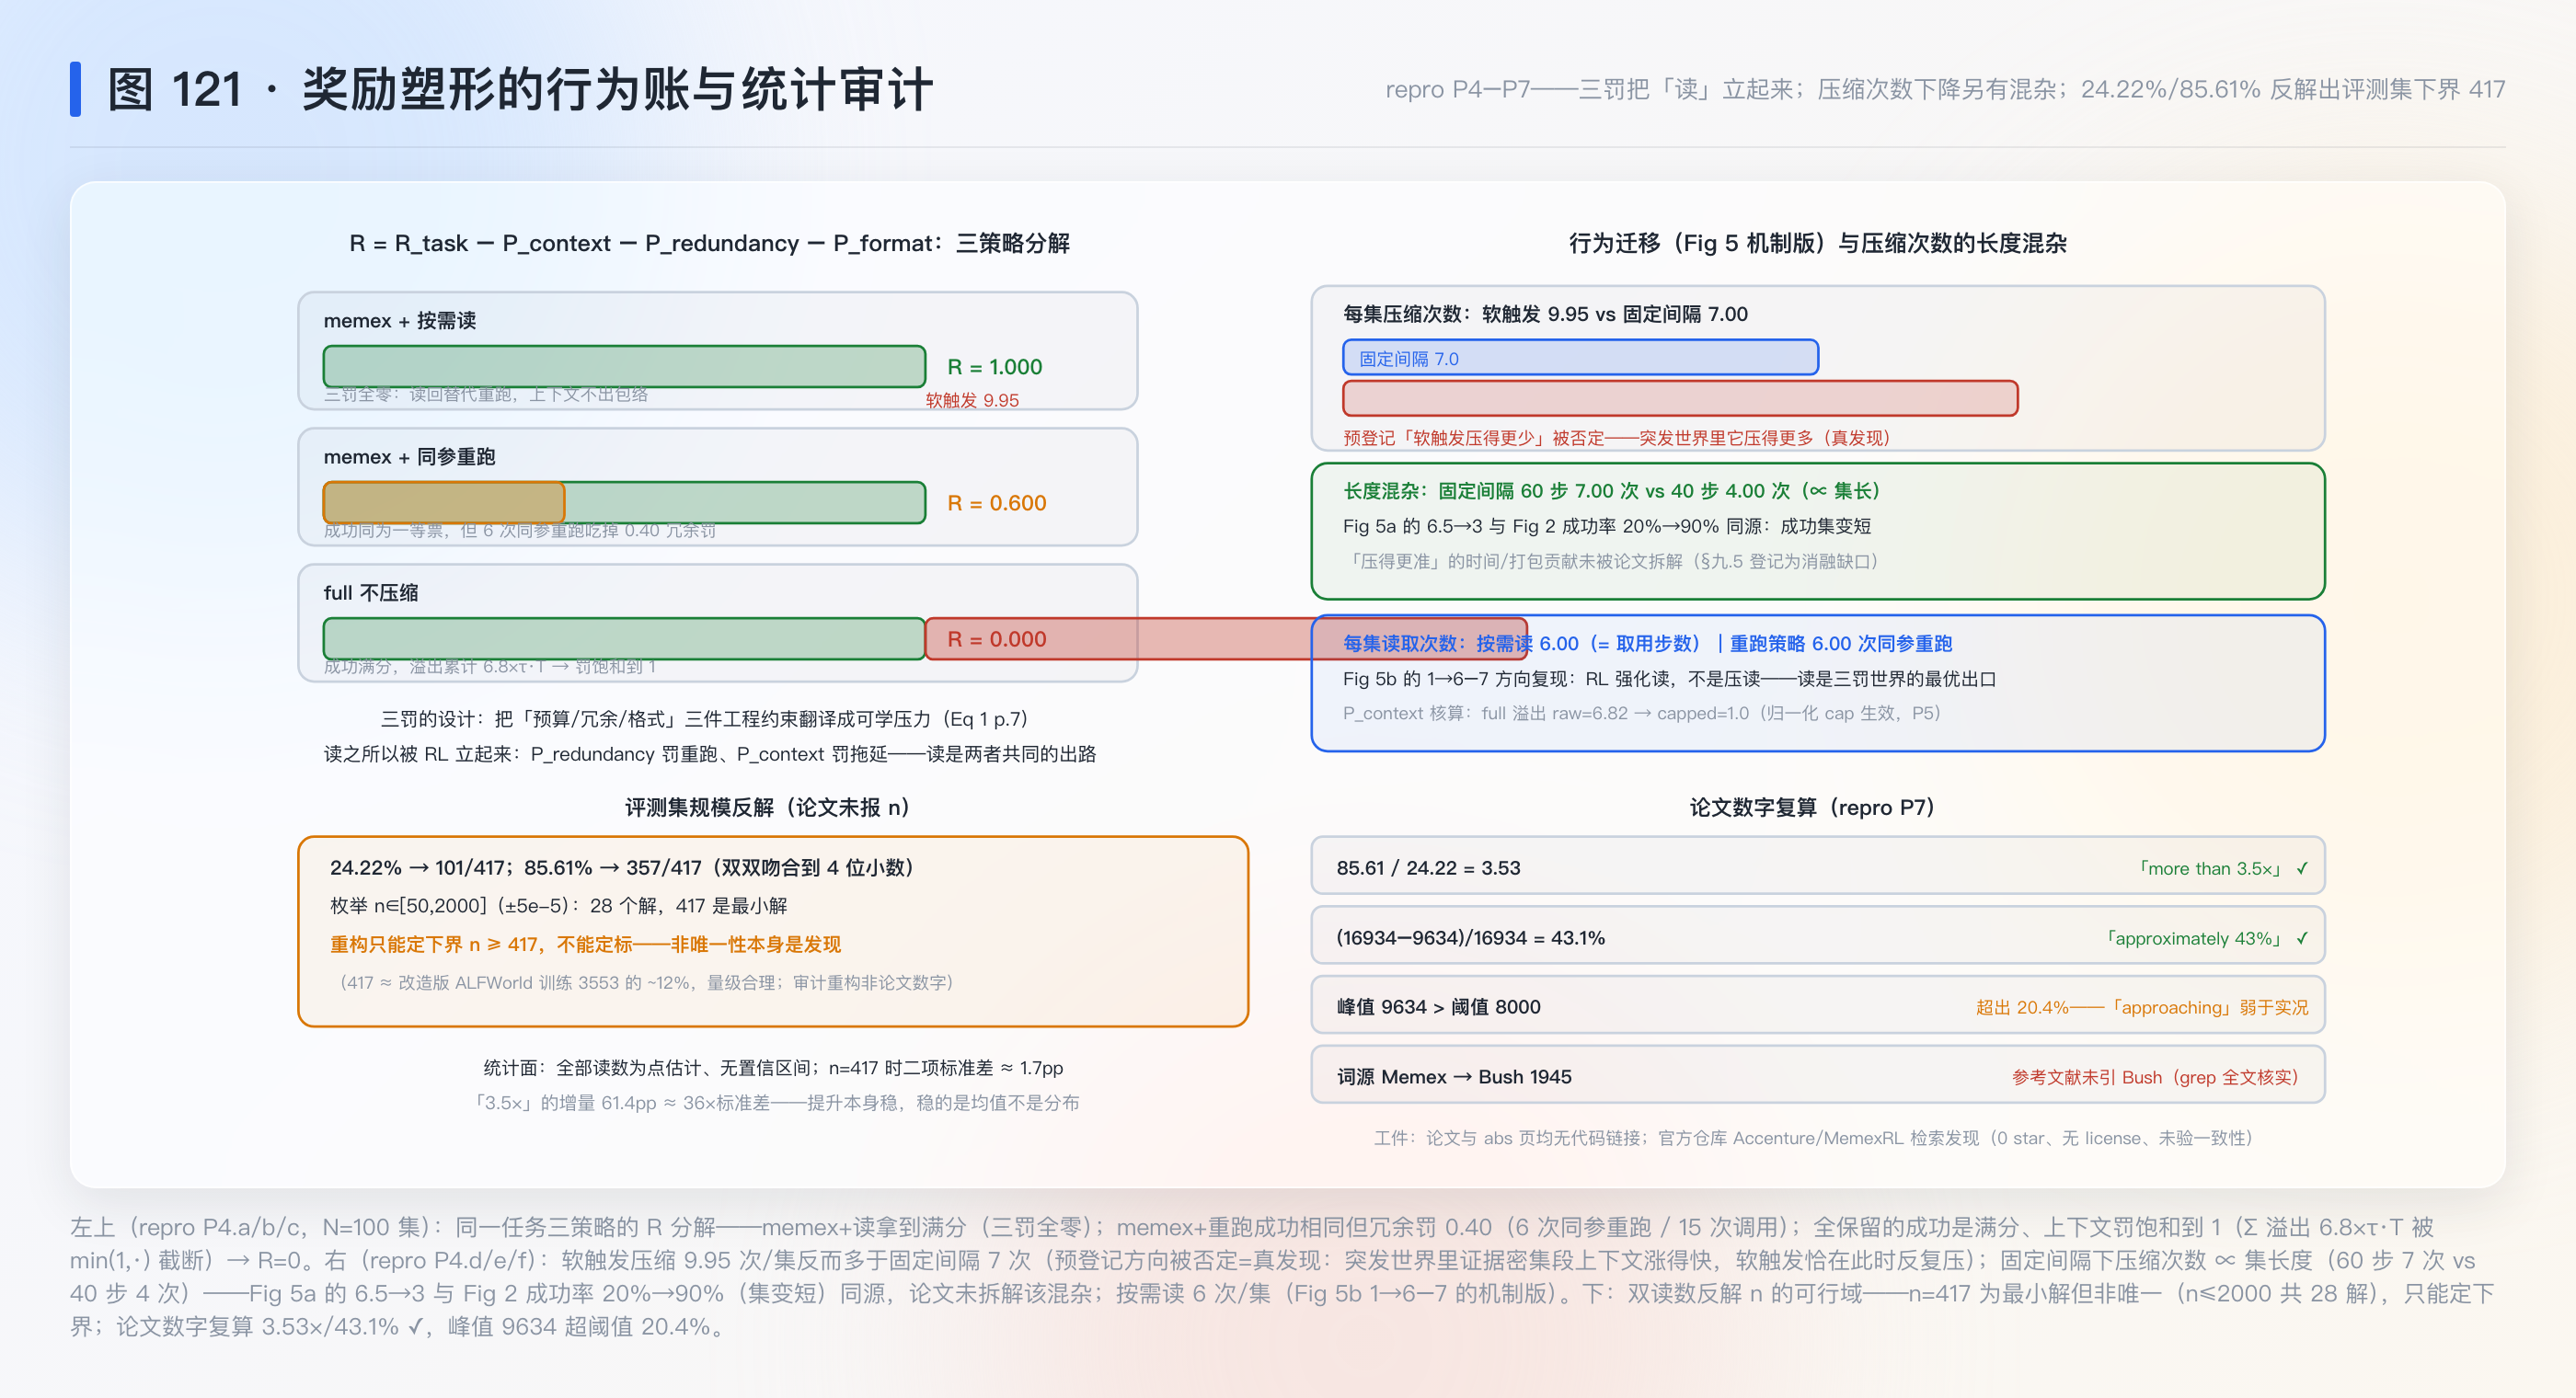
冗余罚的数值例:一集 15 次非记忆工具调用,其中 6 次是”同工具同参数且其间无状态改变”的重跑(比如第 20 步又 view 了一遍 line 140–206,因为第 6 步清桌后原件不在场了)——P_{\text{redundancy}} = 6/15 = 0.4。同一个 agent 若改用 ReadExperience 取件:免冗余罚,代价只是把块追加进上下文(吃一点预算)。0.4 的确定性罚 vs 一点预算占用——这就是”读被立起来”的算术。复现 P4 把三策略的 R 分解做成条形(图 121):读 1.000 / 重跑 0.600 / 不清桌 0.000。
6.4 分段信用的组相对论证与”读方向”的稳固性(补充)
分段共享终末奖励为什么能传信用(§5.3 的展开):GRPO 的优势是 rollout 级常数 A^{(g)},段只是把它摊到各自的 token 上——同一 rollout 的清桌 token 与执行 token 拿同一个 A^{(g)}。这牺牲了 token 级分辨(好清桌烂执行同赏),换来的是”跨段不塌”:常规多轮训练里第 1 段的历史在第 2 段的条件里消失,梯度天然断链;共享 R 让第 1 段的动作有机会被第 3 段的结果评价。与 MT-GRPO(种子 5)的树形重采样对照:同是”长程信用分配”问题,那边用同状态多分支造反事实对照(turn 级、代价 G^{K-1} 指数),这边用段切分+共享终末(rollout 级、代价是粒度)——两极之间还有 ATTC 的蒸馏桥。本站把三者的取舍记成一张账(§八.2)。
行为读数里哪个方向最稳固(P4.d 的教训反过来读):Compress 次数降有混杂(集变短),但 Read 次数升没有这个混杂——集变短只会让绝对次数变少,Read 从 1 涨到 6–7 只能解释为”取件取代了重跑/失明”。复现 P4.e 机器版:按需读次数 = 每集取用步数(6.00/集),方向与机制闭环。论文如果只报这一条行为证据,主张反而更干净。
6.5 整体收拢
数学展开四节:命题 1 的载荷分析把”理论近乎重言”转化为三源可枚举的失效边界(6.1)→ 命题 2 的三条界与三个失效开关对上(6.2)→ 三罚的数值账解释了行为为什么会长成那样(6.3)→ 分段信用的组相对论证补齐训练侧最后一块(6.4)。回到这篇:论文自己给了骨架(两个定义、两条命题、一个奖励),本节补的是血肉——每个形式件各自”什么时候不管用”。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| Context Rot / 上下文塞不下 | 🟡 部分(branch_context_rot) | 本篇是它的工程处方侧兑现 |
| 状态/充分统计量/马尔可夫分解 | 🟢 概念在(SA §6.5) | 本篇给出可计算版(B-界充分性);分支笔记仍欠 |
| GRPO 族(组相对优势/裁剪/KL) | 🟢 已学(种子 5/7/8 线) | Eq 2/3 是标准件;分段处理是新贡献 |
| fresh-context 执行器 | 🟢 已学(种子 1) | 丢弃 vs 归档+解引用——同一预算压力的两种回答(§8.1) |
| MemGPT / MEM1 / MemAgent / Memory-R1 / ReSum / FoldGRPO / AgentFold | 🔵 待补 | §2 转引的有损压缩同族;实验全未对照(§九.1 的批评点,也是下一批候选种子) |
| ALFWorld | 🔵 待补 | 实验基座(Shridhar et al. 2020 转引);四处改造比环境本身更有信息量 |
| 语义相似检索(embedding 检索) | 🟡 常识级 | 论文用它做反衬;Corley & Mihalcea 2005 转引 |
| Bush 1945 memex 词源 | 🔵 登记 | 原文未读;论文未引(§九.7) |
八、扩展与发散
8.1 连一连:同一预算压力的两种回答——fresh-context 丢弃 vs Memex 归档
发散:本站第一颗种子(LongHorizon-Harness)的 fresh-context 执行器,面对同一压力(上下文装不下长程轨迹)给出的是另一个极端:周期性丢到近乎全白的上下文,靠任务状态管理(三态生命周期)把”该留下的”结构化保留。两个方案在一根轴上排开:保留什么——fresh-context 留”判断为持久的状态”,Memex 留”摘要+全部原件的索引”;恢复力——fresh-context 丢了的就没了(靠状态前置避免需要恢复),Memex 什么都能按需恢复;代价——fresh-context 便宜(不维护库),Memex 付出维护索引与读取时延;失效面——fresh-context 怕”状态判定漏了关键事实”(一丢永失),Memex 怕”索引没挂对/读不起”(充分性破)。有趣的是两者的审计哲学同源:fresh-context 的 read-only 审计器”只信验证事实”,Memex 的索引”指向具体工件而非模糊匹配”(p.3 auditable)——都把”可核查”当第一公民。回到这篇:两篇合起来给 agent 记忆的设计空间画了两条边界线,中间的全部地带(选择性归档、部分可逆、按证据类型分级)还空着——这是 agent 线后续种子的地图。
8.2 读时机=分配问题:B 就是记忆版的影子价格
发散:执行侧测试时分配线(ATTC/LATTS/Damani)回答”算力怎么按需分配”,本篇回答”证据怎么按需取回”——结构同构到可以换符号:读取预算 B ↔︎ 算力预算;“哪一步值得花一次 ReadExperience” ↔︎ “哪道题值得多采一个样本”;溢出罚 P_{\text{context}} ↔︎ Damani 的总量约束、ATTC 的影子价格 λ(B 每加一,C_{\max}^{\text{work}} 涨 L——“多一件读取权值多少 token 预算”就是记忆世界的资源定价)。ATTC 的对偶恒等式在这里的对应物:软触发阈值 0.8τ 就是清桌的影子价格——工作上下文涨到它的那一刻,“再扛一步”的期望溢出罚开始超过”清桌一次”的代价。复现 P4.d 的否定恰好打了这条线的侧面:软触发阈值是静态价格,而最优时机应是任务语义的函数(论文 p.8 也这么主张),静态价格在突发世界里会过度触发(9.95 次 vs 固定 7 次)——“学习型定价”对”规则型定价”的优势在记忆世界与算力世界是同一个故事。回到这篇:B-界与三罚把记忆管理第一次接进了本站的分配族谱,ATLAS(2606.01667,登记未读)大概率是这条线的下一站。
8.3 常见误读(破)
误读一:“记忆库论”——把 Memex 读成又一个 RAG/向量记忆系统。 破:论文 §1 p.2 明写相似检索”does not specify how the agent should organize its own experience”——Memex 的全部设计在”组织”二字:索引是智能体自己写、自己维护、自己用的稳定引用(写什么、怎么命名、何时取都是学的),检索是按名取件不是按相似度猜。把 D 换成向量库、把 Read 换成 top-k 检索,命题 1 的 g 就从”确定性选件器”退化成”概率匹配”——充分性的存在性失去凭据。判断一个系统是不是这一类,只看一个问题:记忆的组织方式是不是可学的动作。
误读二:“记性好=考卷难”论——认为 85.61% 证明 Memex 记忆强。 破:考卷是自家改的,四处刀口(隐动作表、隐初始观测、look 限一次、摘要截断 300)全部朝”必须用 ReadExperience”设计(p.11 原话 creating an explicit dependency)。这没错——受控研究的本分——但读数的外推边界也就画在这里:在证据天然密集在近处、或 ID 可以安全转述的任务上,指针化的优势会缩小(截断/摘要未必输)。论文没有任何一条外部基线来标定这个边界(§九.1),85.61% 是”自造考卷上的自对照”,不是”记忆方法竞赛的名次”。
8.4 写作之维(论文怎样完成说服)
标题把贡献压成一个名词短语——“Indexed Experience Memory”占 C 位,Scaling 是承诺、via 是路径,读者进摘要前就接受了”记忆机制是长程扩展瓶颈”的框架。摘要的数字排布仍是收尾重锤:“improves task success while using a significantly smaller working context”——一句装下双指标,先质后量。Related work 的先破后立最见功力:先立”有损”靶子(truncation/summary 家族),再立”模糊”靶子(similarity 检索),自己的位置(precise, full-fidelity, deterministically revisitable)被两个靶子夹出来——p.4 一段连续四个 “lossy/fuzzy” 系形容词是修辞钉子。理论节的防御性措辞(“not meant to claim…rather, it characterizes the regime”)预先把”理论与实验脱节”的攻击面收窄。全文最诚实的一笔与最不诚实的一笔相邻:诚实——承认峰值 9634 只是”close to the threshold”(其实超了 20%);不诚实——实验一节没有任何一张对照表,相关工作里点名的方法一个都没比,“effectiveness”小节比的是训练前的自己。
九、局限与可疑处
- 零基线对照(最大缺口):§2 点名 MEM1/MemAgent/Memory-R1/ReSum/FoldGRPO/AgentFold 是有损同族,§5 一个都没比。24.22%→85.61% 是热启动 vs 训练后的自对照;“索引化优于有损摘要”这一核心主张在实验区没有直接证据(只有理论论证)。复现 P2 用合成世界补了机制方向(丢证据者全败),但那是演绎不是实验。
- 单环境单模型:改造版 ALFWorld + Qwen3-30B-A3B 一个组合;跨环境/跨模型的外推无凭据。且环境四处刀口全部为”逼记忆出场”而设计(p.11 自述),测量的是设计出来的依赖性。
- 评测集规模未报、全点估计:训练集 3553 给了,评测 n 没给;成功率与上下文读数无置信区间。本站反解 n=417 为最小解(28 个候选解,只能定下界,§十.2 P6);n=417 时二项标准差约 1.7pp,3.5× 的提升量级稳,但”43% 降幅”这类精细读数在无区间报告下只能算点估计。
- 热启动与消融全缺:SFT 演示数据规模、三罚各自的贡献、软触发 vs 硬触发(对 SUPO 的差异)、双模式内容的失败率——一个消融都没有。奖励设计三个超参(归一化分母 τT、冗余判定”其间无状态改变”、格式罚分母)各自敏感度未知。
- 分段信用的粒度代价未讨论:好清桌+烂执行的 rollout 整体低估、反之高估(§六.4);与 turn 级信用分配的取舍没有分析。
- 索引表规模的隐性失控:σ 截断 300 token 硬扛索引表增长(prompt 原文”include ALL previous indices in your new summary (copy them over)“),长集上索引表要么挤占摘要要么被截——命题 2 的 \tau_\sigma 假设在这个设计下最先破(§六.2 开关一)。
- 词源未引:标题 Memex 直指 Bush 1945 的 memex(常识级对应,Bush 原文本站未读、登记),参考文献无 Bush——以工程重名的方式用了一个有出处的历史名词而不给出处(小疵,但对一篇讲”索引”的论文有点讽刺)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需 30B MoE + 改造 ALFWorld + slime RL,不可本机重演;官方仓库存在但代码一致性未验。本复现是机制演绎 + 统计审计:在合成的”取证长程世界”(证据步早出、取用步晚至、间隔远超任何保留窗口;token 账按论文量级的类比物 τ=8000、τ_σ=300、L=1200、B=1)里,用脚本化策略(full/truncation/summary/memex,无 LLM)重演机制改变的东西;外加论文数字的算术复算与评测集规模反解。不冒充论文实验数字;论文数字只引用并注明出处。这与种子 19/25 的合成世界路线同族,且机制全解析、无世界校准问题。
10.2 可证伪预测与判据(运行前预登记,含形态与量级;三轮演化后定稿见 10.3)
- P0 贯穿示例算术:六步 thinking=1970、观测=3410、压缩比 5380/300≈17.9 落 [15,20]。
- P1 命题 2 机器版:memex 工作上下文全程 ≤ 0.8τ+1800+B·L(运行包络,零违例);10 集平均 C_full(200)/C_full(100)≈2.0(±12%);窗均压缩比 ρ̄(150–200) ≥ 1.5×ρ̄(50–100)。
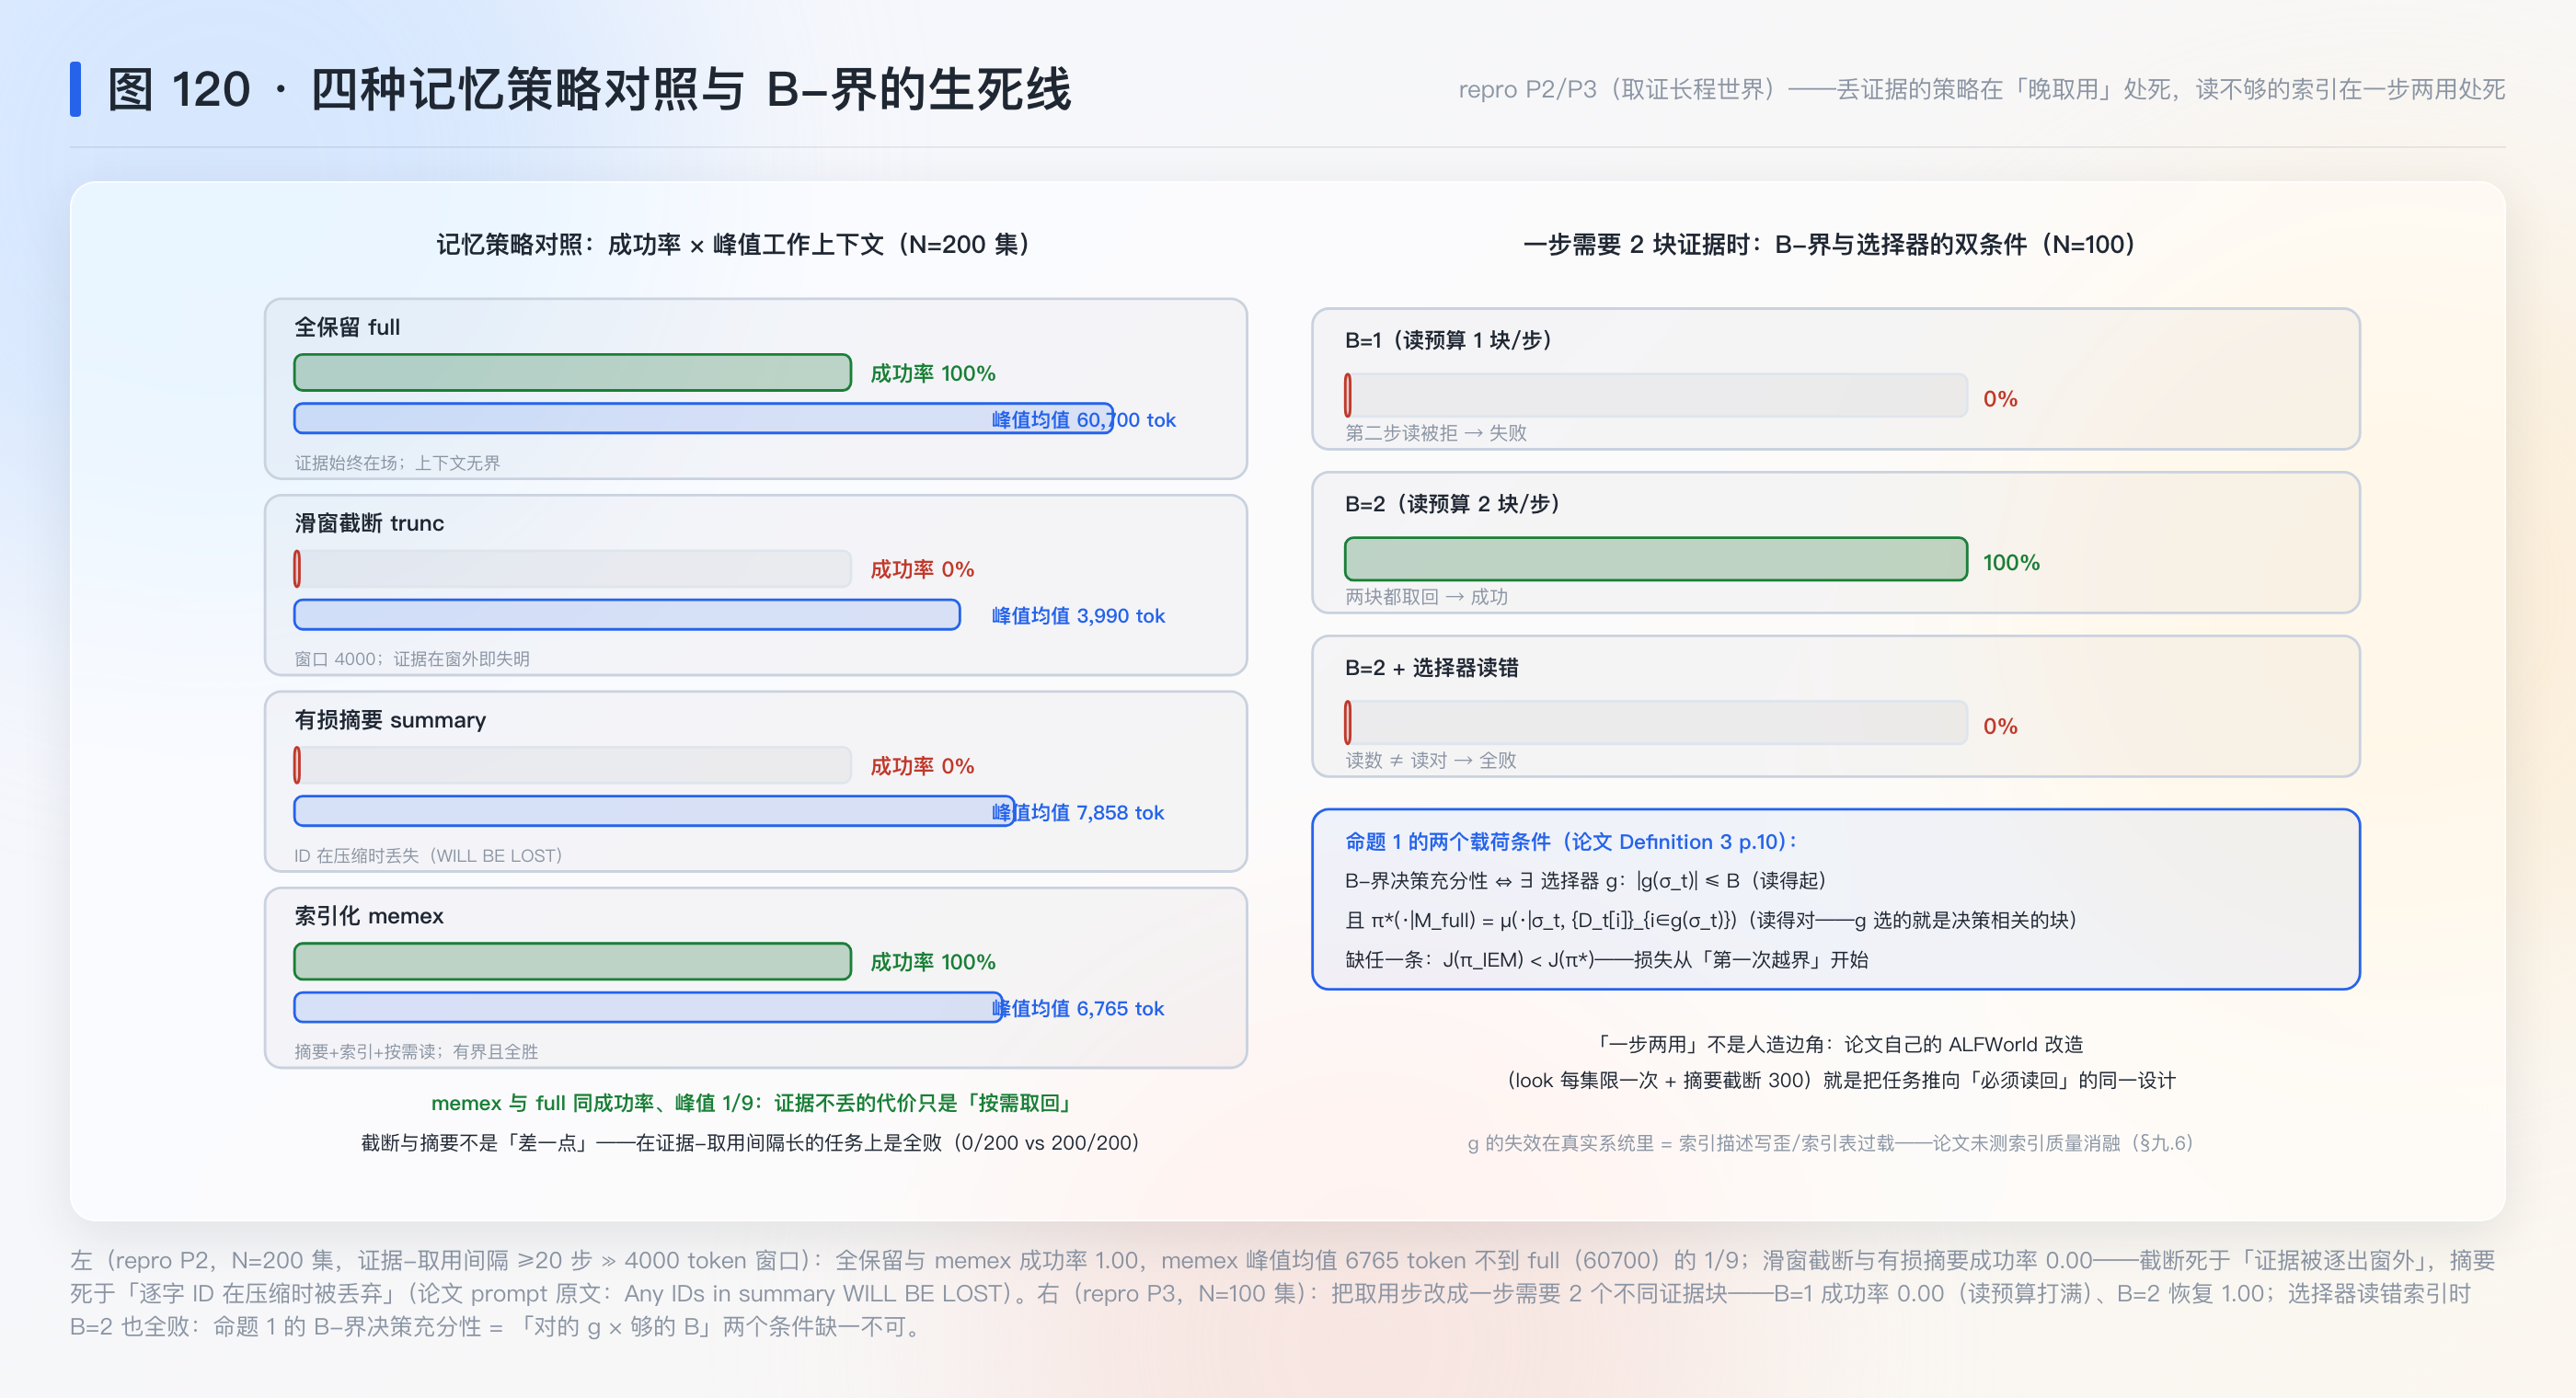
- P2 策略对照(N=200):full=memex=1.00;truncation∈[0,0.15];summary=0.00;memex 峰值 < full 最小峰值。
- P3 B-界(N=100):一步需两块时 B=1 成功率 0、B=2 成功率 1;wrong-selector 即便 B=2 也全败。
- P4 三罚行为账(N=100):R 排序 读>重跑>不清桌;P_context:memex≈0、full 饱和 1;重跑 P_redundancy>0.05;(d) 软触发压缩次数 < 0.6×固定间隔【预登记方向】;(e) 按需读≈取用步数 5–8 次/集;(f) 固定间隔次数 ∝ 集长(60/40 步 ≈1.5×)。
- P5 P_context 饱和:full 的 Σ溢出/(τ·T)>1 被 min 封顶。
- P6 评测集反解:枚举 n∈[50,2000],±5e-5 容差下 24.22%/85.61% 双吻合的解——【第一轮预登记”唯一解 417”被否定后降级】n=417 为最小解、非唯一(28 解)。
- P7 论文数字复算:3.53× ✓;43.1% ✓;峰值超阈 20.4%(措辞注记)。
10.3 实现演化(三轮,全部如实登记)
- 第一轮:22 项中 6 项 FAIL。 三个实现层问题:①LCG 模数笔误(0x 后 15 个 F ≈ 2^68 而非 2^64−59,uniform 返回 >1,世界 token 账失真——单步 token 冲到 4483,压缩次数 38 次/集);②Episode 布点的拒绝采样在拥挤配置下死循环(换等距槽位+抖动);③P4.a 元组解包错位(把 peak 当成功数传入 reward,R_full=54447)。另有三项预测域误设:P1.b 单集比值容差 ±2% 太紧(证据前载相位使单集 1.84);P1.c 用压缩周期内的点值比 ρ(周期噪声淹没趋势,改窗均);P6”唯一解”过强。
- 第二轮(修正后):LCG 换 MMIX 参数(模 2^64)、解包修复、P1.b 改 10 集均值、P1.c 改窗均——22 项里只剩 P4.d。
- P4.d 的否定立案:预登记”软触发压得更少”(对齐 Fig 5a 的 6.5→3)在受控世界里方向反了——突发世界(证据密集段)里软触发 9.95 次/集 > 固定间隔 7.00 次/集。诊断:触发方式只决定”何时压”,不决定”压几次”;次数由内容增长节奏与集长度决定。补 P4.f(次数 ∝ 集长,60/40 步 = 7.00/4.00)支持替代解释:Fig 5a 的下降与 Fig 2 成功率翻 3.5 倍(成功集变短)同源混杂,论文未拆解。预登记方向被否定=真发现,按纪律登记为产出而非失败。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_memex.py,真实输出
repro/repro_memex_output.txt。23
项断言 22 过 / 1
未过(P4.d,否定登记),[Re*];确定性审计两次运行 sha256
一致(fa133b74…)。
| 假说 | 论文锚点 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 贯穿示例 | §3.2 p.5 | thinking=1970、obs=3410 逐位 ✓;压缩比 17.933 ∈[15,20] ✓ | 全过——原文括号数字的机器复算 |
| P1.a 工作上下文包络 | Proposition 2 | 峰值 6379 ≤ 0.8τ+1800+B·L,200 步零违例、压缩 26 次 ✓ | 过——软触发的运行包络 |
| P1.b full 线性 | Proposition 2 | 10 集平均 C_full(200)/C_full(100)=1.92 ✓(容差 1.75–2.25) | 过——单集受证据前载相位影响,均值收敛 |
| P1.c 压缩比增长 | Proposition 2 | ρ̄ 21.0→43.3(2.06×)✓;窗均 C_work 3174→3328(+4.8%)vs C_full 66617→144199 | 过——“分母不动、分子线性涨”的机器版 |
| P2 策略对照 | §1 p.2(有损论证) | full=memex=1.00;trunc=0.00;summary=0.00;memex 峰值 6765 < full 最小 57827 ✓✓✓✓ | 全过——截断死于窗外、摘要死于 ID 丢失(prompt 原文 WILL BE LOST 的机器版) |
| P3 B-界 | Definition 3 + Prop 1 | B=1 成功率 0.00;B=2 =1.00;wrong-selector B=2 全败 ✓✓✓ | 全过——“对的 g × 够的 B”双条件 |
| P4.a R 排序 | Eq 1 | 读 1.000 > 重跑 0.600 > 不清桌 0.000 ✓ | 过——三罚定价的行为出口 |
| P4.b P_context | Eq 1 | memex 0.0000 / full 1.0000(饱和)✓ | 过——min 封顶生效 |
| P4.c 冗余罚 | Eq 1 | 重跑 P_redundancy=0.400(>0.05),读策略 0 ✓ | 过——“读被立起来”的制度根源 |
| P4.d 软触发少压 | Fig 5a 6.5→3 | soft 9.95 > interval 7.00 → 方向否定 ✗ | FAIL→真发现:触发≠次数;Fig 5a 与集变短混杂(论文未拆) |
| P4.f 次数∝集长 | (论文没有——本站补) | 60 步 7.00 vs 40 步 4.00(比 1.75)✓ | 过——混杂的替代解释成立 |
| P4.e 按需读 | Fig 5b 1→6–7 | 读 6.00/集(=取用步数);重跑策略同 6.00 次但吃罚 ✓ | 过——Read 方向无长度混杂,最稳固 |
| P5 饱和公式 | Eq 1 P_context | raw=6.82 → capped=1.0 ✓ | 过——归一化分母 τT 的设计意图 |
| P6 n 反解 | Fig 4a(n 未报) | 最小解 (417,101,357);28 解非唯一 ✓(降级断言) | 过(降级)——第一轮”唯一解”预登记被否定,重构只能定下界 |
| P7 数字复算 | §5.2 p.12 | 3.5347 ✓;43.11% ✓;9634>8000 超出 20.4% ✓ | 全过——措辞注记立案 |
算力与工作量:MacBook 纯 CPU,约 6 秒/轮;三轮演化 + 回填约 70 分钟(含一次死循环排查、一次 LCG 模数考古)。 What was easy:命题 1/2 全解析——断言天然二值;策略对照(P2/P3)一次通过;P0 五分钟。 What was difficult:①LCG 自造常数翻车(教训:确定性随机的常数也要照抄标准参数,别手写十六进制);②”行为方向”类预测(P4.d)最脆——论文图的因果解读(6.5→3 归因于”更准”)在受控世界里站不住,合成复现恰好能拆出这种混杂,这是它对读数型论文的独有价值。 给下一个复现者的建议:入口 P0(手算可查)与 P6(二十行枚举);做行为类断言前先把”次数/比例”与”集长度/任务难度”的混杂列出来——行为读数的方向比数值更容易被结构效应污染。
十一、方法论提炼与迁移
模式一:索引化无损压缩(Indexed Lossless Memory)
- 操作定义:面对”容量受限的工作区 + 不能丢失的累积证据”,把证据本体移出工作区、只在工作区保留 (进度摘要, 稳定索引表);访问走确定性解引用而非相似检索;整理(写索引/归档)与访问(解引用)做成与业务动作并列的一等操作,时机由约束压力(预算/冗余罚)学出而非规则定死。
- 成功判据:①远距离证据取用任务上,索引化策略成功率 = 全保留策略(无损);②工作区占用有界且与历史长度解耦(锯齿型而非单调型);③重复访问以解引用替代重执行(冗余重跑率趋零)。
- 迁移去向:①长会话编码代理的上下文管理(把旧对话轮归档为编号工件,替代截断);②数据分析工作台(中间表落盘编号,notebook 只留结论+表名,防 kernel 内存爆);③审计与法律工作底稿(结论页+编号索引+底稿柜——“结论可溯源到原件”的工程化)。
- 失效边界:一步决策需要 >B 件证据(B-界破);索引描述失真(选择器 g 失效——wrong-selector 全败);索引表本身超出摘要预算(K 无上界时 σ 顶穿);证据无法稳定命名(无 dom(D) 可言,如流式连续信号)。
- 方法卡:notes/method_indexed_lossless_memory.md(L1)
- 层级:L1 领域具体(记忆/信息管理)。底层原理:信号稳定性检验(MPERT)近亲——“存的名字与取的名字必须扰动下一致”;与”接口性质先行”(Cordis)同族——可交换性由接口(索引)决定而非内容。
模式二:分段共享终末奖励(Segment-Shared Terminal Reward)
- 操作定义:多段/多轮流程里,前段动作改变后段的条件前缀导致训练信用断链时——按前段动作的边界切段,各段独立作为训练样本(各自上下文各自损失),但共享同一条流程的终末结果信号,用组相对比较在段间摊信用。
- 成功判据:前段决策质量的变化能在该流程组的终末奖励差里显影(坏前段 → 整组各段优势同负);无信用断链(前段 token 能收到来自后段结果的梯度)。
- 迁移去向:①多阶段流水线的评估(阶段产物分片训练、端到端结果共享,如 CI 分阶段构建共享最终测试结论);②长篇内容的多轮编辑学习(按编辑轮切段、共享终稿质量分);③人机协作流程挖掘(按交接点切段、共享项目成败信号定位哪次交接最值钱)。
- 失效边界:信用需要 token 级分辨时粒度不够(好前段+烂后段互相污染);段数过多时组内 rollout 方差被段间差异淹没;终末信号本身稀疏/延迟过大时(稀疏奖励老问题在段结构上复活)。
- 方法卡:notes/method_segment_shared_terminal_reward.md(L1)
- 层级:L1 领域具体(训练/流程信用分配)。底层原理:归因靠对照(MATTRIB)——组间比较即”同 prompt 不同流程”的最小对照实验,与 MT-GRPO 树形重采样(种子 5)构成粒度两极。
归档(不另立卡)
三罚”约束→罚项→可学压力”的翻译手艺并入既有影子价格家族(ATTC λ / Damani b* / LATTS δ——本篇 P_context 的 0.8τ 是清桌时机的静态价格版),回写 method_acceptance_as_allocation.md 的家族实例行;零信号/冗余罚与 method_zero_signal_filter.md 同族但方向不同(它是”重复动作回收”不是”零信号组过滤”),只在卡内加一行参见。
十三、没搞懂的地方(未攻克登记)
- 索引描述的质量如何被监督:论文说 RL 让模型学到”how to index”,但索引描述的好坏只通过后续读取成功间接显影——有没有描述失败率、错读率的统计?补齐时机:读官方仓库 memory/mixin.py 的实现(工件已存在未验)。
- 锚点抽取的失败率:三锚点逐字匹配在长对话里的错位率、mid_anchor 校验的拦截率——论文只字未提。补齐时机:仓库实现或自造对话测。
- 热启动数据:SFT 演示的规模、来源(人工写 or 更强模型蒸馏)未报——RL 收益里有多少是 SFT 的底子。补齐时机:v2 或仓库训练脚本。
- 9634 > 8000 为何仍成立:训练后峰值超阈 20%,P_context 应有残余罚——为什么没有继续压下去?可能:溢出集中在个别难集(惩罚期望 vs 方差的取舍),论文无分布图。补齐时机:峰值分布而非均值。
- 分段切分对段内优势估计的偏置:段独立采样后组相对 std 是全组的还是段内的(实现细节决定信用尺度)——Eq 2 写的是组级,slime 实现待查。补齐时机:读仓库 training/ 目录。
- 与有损摘要的正面对决缺失:同预算下”摘要+无索引”到底差多少——理论说了方向,数量级没说。补齐时机:官方仓库有基线配置,或自造对照实验。
十四、可信度
- A 级(论文原文转录,逐节核对):§1–§6 全部、Definition 1–3、Algorithm 1 逐行、Eq 1–3、Proposition 1/2 与附录 A.1/A.2 证明、附录 B 全部 prompt(含 “WILL BE LOST” 与 “copy them over” 原句)、Fig 1–5 图注数字(24.22/85.61/16934.46/9634.47/6.5→3/1→6–7/−0.4→−0.1)。
- B 级(论文自报实验,无法独立验证):训练曲线(Fig 2/3 从图读)、行为计数(Fig 5)、训练超参(G=8、batch 32、INT4/TIS 等自述)、3553 训练任务。
- C 级(我的推导 + 复现程序化验证):§三 全部推导、§六.1 失效三源、§六.2 三条界与开关、§六.3 数值例、§六.4 组相对论证、§8.1/8.2 对读——复现断言见 §十.4(23 项 22 过)。
- D 级(我的推断,已标注):Fig 5a 长度混杂的替代解释(P4.d/f 支持)、9634>8000 的方差猜想(§十三.4)、“命题 1/2 同一枚硬币”的结构判断、误读二的考卷外推边界。
- 横向核实初核(2026-09-25):版本已核(abs 页提交史仅 v1,2026-03-04 提交,无更新版);录用未核(预印本,© Accenture,无会议字段);机构已核(PDF p.1);工件核查:论文与 abs 页均无代码链接,但 GitHub API 直查确认官方仓库 Accenture/MemexRL 存在(created 2026-04-09 晚于 v1 月余、pushed 2026-07-02、0 stars、无 license、含实质代码)——三态记”存在但未验一致性”;第三方:alphaXiv 讨论页 + X/LinkedIn 转述 + takase.com 独立分析存在(未深读,登记);引用约 11(搜索摘要级,未逐一核);统计审查:全部读数点估计无区间,评测 n 未报(本站反解 417 为最小解、28 候选非唯一——下界主张);43.1%/3.53× 复算 ✓;峰值超阈 20.4% 立案;引文元数据:Bush 1945 未被引(grep 核实)、其余转引未读(见文首核对状态块)。
- 实验充分性评价:不充分(对核心主张”索引化优于有损”而言)——训练有效性主张(RL 学得会这套动作)有三图支撑算部分充分;但比较性主张零对照、单环境单模型、无消融、n 未报——按本站 G8 标准缺四件。机制侧(命题+算法+prompt 全公开)倒是罕见地完整,可复算性好。
- 性能支撑目标检查:goal = “improves task success while using a significantly smaller working context”(摘要)——支持(85.61% 与 −43% 同集达成),但仅限自造环境自对照;“Scaling” 一词只有理论支撑(命题 2),无 horizon 扫描实验——标题的第三个词目前是期票。