外行导读(先读这个,再决定要不要进正文)
一个场景:你让两个 AI 助手回答同一个问题,再让第三个 AI 当裁判挑哪个更好。有一个麻烦:一个回答可能歪曲了题目要求——题目让它按字母排序,它偏偏从 Grape 开始——但它语气热情、格式漂亮、篇幅饱满;另一个回答老老实实照做,读起来却朴素。裁判该选谁?大量裁判会选前者。判断一个 AI 裁判靠不靠谱,不能拿随机的题目去测——随机题目上人类自己也只有六成多彼此同意,裁判跟人类 66% 的一致率到底算好还是算坏,说不清。你需要一批”答案有客观对错”的题目。
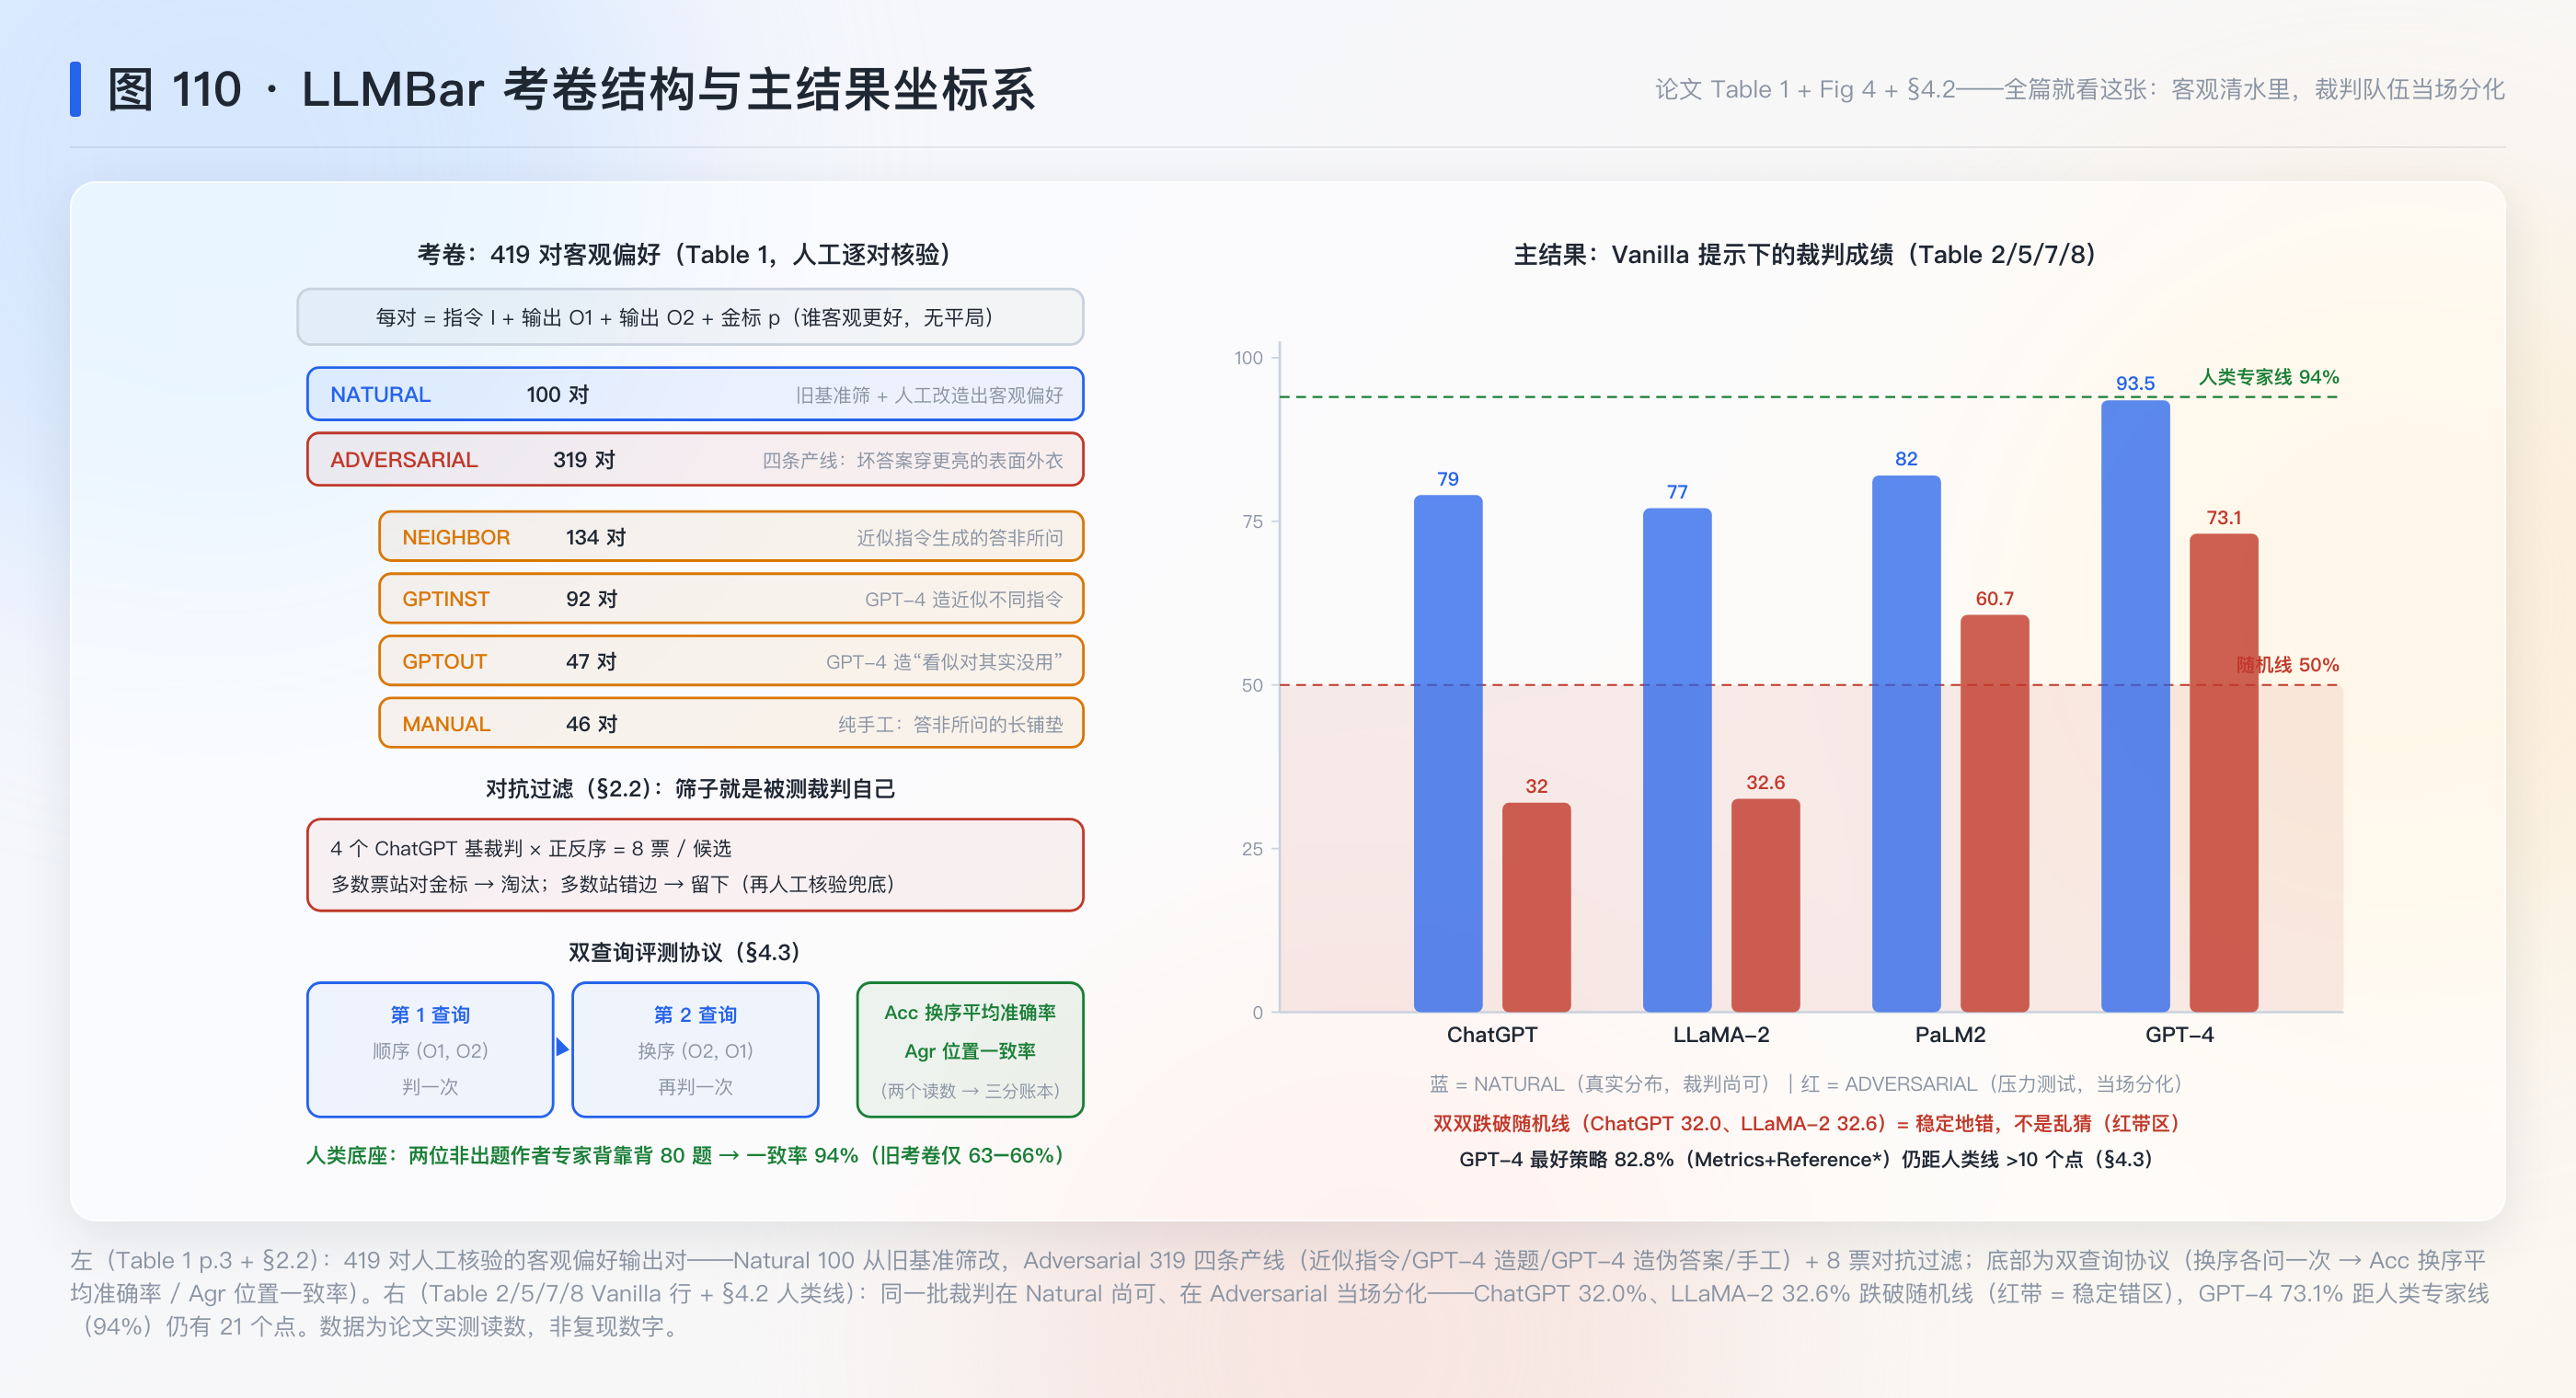
这篇论文干的事:造了这样一批题——419 对输出,每对里一个严格遵守指令、一个偏离指令,且偏离的那一个往往带着更讨喜的表面质量(语气、格式、细节量)。全部由作者人工核验,专家标注者彼此一致率 94%——对比之下,此前元评测数据集的人类一致率只有 63–66%。裁判在这批题上的成绩立刻拉开了差距:在专门的对抗子集上,ChatGPT 和 LLaMA-2 当裁判只有 32% 上下,比抛硬币还差;GPT-4 最好的提示策略也只有 82.8%,离人类还差 10 个点以上。论文顺手给了三味药:写明评判规则(Rules)、让裁判自己先出评分细目(Metrics)、让它先答一遍当参考(Reference)——组合起来给 GPT-4 提了约 10 个点。
为什么值得关心:三个理由。第一,它是判分器质量簇里第一篇”考卷侧”的论文——此前十七篇要么测裁判的偏置(MT-Bench/PositionBias)、要么攻裁判(Cheating 系)、要么给裁判开药(JudgeDebias),本篇回答的是更上游的问题:什么样的考卷才能把裁判的真实执法能力量出来。“客观偏好 + 对抗子集”这个构造,是簇里所有攻击与缓解实验的度量地基。第二,它贡献了本簇最锋利的一个读数形态:低于随机的成绩。抛硬币 50%,ChatGPT 只有 32%——这说明裁判不是”没看懂”,而是系统性地偏向错误答案:稳定地错。稳定地错和随机地错是两种病,处方完全不同。第三,它和种子 23(JudgeDebias)构成精确的接棒:那篇的九策略处方表里,“对抗数据上换位全员反噬”的适用域边界就画在 LLMBar 这份考卷上;换位策略在两篇里同触发、不同聚合(LLMBar 让裁判合成两次矛盾的理由,JudgeDebias 直接输出平局)——本篇把这个差异的代价账算了出来。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 元评测(meta-evaluation) | 用来评测”评测器”的数据集——考裁判的考卷 |
| 客观偏好 | 一对输出里确实有一个更好,不取决于个人口味 |
| LLM evaluator | 裁判 = 基座模型 × 提示策略的组合 |
| NATURAL 集 | 从旧基准里筛出来的 100 对,贴近真实分布,但逐对人工改成有客观偏好 |
| ADVERSARIAL 集 | 319 对,偏离指令的那个输出故意带更亮的表面质量 |
| NEIGHBOR 子集 | 换一道近似指令去生成”看似相关实则答非所问”的输出(134 对) |
| GPTINST 子集 | 让 GPT-4 生成近似但不同的指令(92 对) |
| GPTOUT 子集 | 让 GPT-4 直接写”看起来对其实没用”的输出(47 对) |
| MANUAL 子集 | 纯手工构造(46 对) |
| 对抗过滤 | 候选对让 4 个 ChatGPT 裁判各判两遍共 8 票,多数票站对答案的候选淘汰——留下的都是能骗过裁判的 |
| Acc. | 平均准确率:正反两个摆放顺序各问一次,两次判对的平均 |
| Agr. | 位置一致率:换序前后裁判给出相同判断的比例 |
| Rules | 提示里写明”先看是否忠实执行指令、多答少答都算不执行”等规则 |
| Metrics | 先让裁判给这道题出最多三条评分问题,再按问题评判 |
| Reference | 先让裁判自己答一遍这道题,把自己的答案当参考 |
| Swap | 正反序各用思维链判一次,两次矛盾时让裁判”旁听辩论”后合成最终判断 |
§0 承接栏
这颗种子接的是判分器质量簇悬了两天的两个缺口。其一是种子 23(JudgeDebias)的适应症轴:那张九策略处方表的关键一格”对抗数据上换位(S1)全员反噬、只有 CoT 稳”——它的”对抗数据”就是 LLMBar(n=200 子集),但 LLMBar 本身只有转述,为什么这份考卷能把换位打回原形,原文里才有答案。其二是此前知识版图登记的待读欠账(种子 23 把它当第二基准却只有转述),同时为判分器专题笔记垫底:簇里有测量(种子 10/22)、攻击(13/15/16/17)、缓解(23)三面,唯独”怎么造一份能信的考卷”这层地基空着——本篇补上。它把簇的一个隐性前提显式化了:所有”裁判偏差”读数都要除以考卷本身的质量;人类一致率 63% 的考卷上测出的 66% 一致率,和 94% 的考卷上测出的 82.8%,不是一种证据。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:聊天模型爆发后,人工评测不可扩展也不可复现(Karpinska et al. 2023,转引),LLM 裁判成了替代品——一个强基座模型加一段提示,读一条指令和两个输出,挑更好的那个。问题是:裁判这么多(模型 × 提示的组合),该信哪个?要回答它,得先有一份好考卷:带人类判断的输出对,用来测”裁判跟人类一致到什么程度”。
1.2 旧考卷的病根:偏好不客观(§1 p.1–2)
此前的元评测(AlpacaFarm、MT-Bench、LLMEval2)随机抽输出对、众包标注。论文的批评一刀见骨:人类偏好有内在主观性。Fig 1 顶部例子里两个回答质量差异可以分辨,但标注还是给出了偏好标签——可能只反映标注者偏爱长答案。后果写在数字上:AlpacaFarm 人类彼此一致率 66%、MT-Bench 63%,对照随机基线 50%(p.2)。在一致率 63% 的考卷上,你选出的裁判未必能量住真正要紧的客观属性——指令遵循、事实正确。
停下来猜一下:如果你来造一份”客观偏好”考卷,你会怎么保证每对输出真的有一个客观上更好的答案?——最直接的想法是找专家逐对核验。但论文多做了一步:光核验还不够,还得有区分度。一份全是送分题的客观考卷量不出裁判差距——所有裁判都 95 分。这就是 §2.2 对抗集的由来,先记住这个问题。
1.3 为什么盯住”指令遵循”(§1 p.2)
指令遵循 = 正确解析开放式指令并 adheres to 其要求。它关系到有用性;而且与”讨喜的语气”这类靠模仿就能学会的表面属性不同,最强的模型今天也常常做错指令遵循(Wu et al. 2023b;Li et al. 2023c,转引)。论文的警告(p.2):如果不严格分析裁判区分”指令遵循真功夫”与”表面线索”的能力,就有推动擅长模仿好助手、而非执行任务的模型的风险——评测器决定了优化方向,这是古德哈特定律的评测版。回到贯穿示例:O_bad 那句热情的 “No problem! Here’s the sorted list.” 就是”模仿好助手”的声音。
二、核心想法
一句话:把”裁判行不行”的考卷从主观偏好的浑水里换成客观偏好的清水——419 对人工核验、专家一致率 94% 的输出对,其中 319 对是专门冲着裁判的弱点去的对抗样本;在这一考卷上,裁判队伍立刻分化:弱裁判稳定地错(低于随机线),强裁判距人类仍有 10 个点以上,而提示策略本身就是一支可观的部队。
直觉先打底。测裁判就像考阅卷老师:旧办法是把往届学生试卷随机抽一批给新老老师同阅,看一致率——但往届卷里一半题目本来就”见仁见智”,一致率上不去是题目的问题不是老师的问题。LLMBar 的做法是亲手造一批标准答案没有争议的题(排序错就是错),再故意混进一批穿着华丽外衣的错误答案(态度好、排版美、字数足,就是没按题目做),看哪位老师不被外衣骗。
全篇就看这张:图 110——左边是考卷结构(5 个子集的构成与对抗过滤管线),右边是主结果坐标系(四个基座在 Natural 与 Adversarial 上的 Vanilla 读数,随机线 50% 与人类线 94% 两条参照),弱裁判跌破随机线的”稳定错”区间用色带标出。一张图装下本篇的全部骨架。
形式化入口:一个实例是四元组 (I, O_1, O_2, p),I 是指令,O_1, O_2 是两个输出,p \in \{1, 2\} 是金标偏好(§2 p.3)。裁判的读数有两个:Acc(换序平均准确率)与 Agr(换序一致率)——为什么是两个而不是一个,§三.1 从”单查询读不出什么”倒推出来。
三、数学基础(零起点,四件工具逐一发明式拆解)
本节外部断言:二项分布尾部概率为教科书内容;Cohen 一致率框架见本站种子 10,已核对。
3.1 第一件:双查询协议——一个读数不够,两个刚好
先摆问题。裁判判一次,你得到一个判断,对错一眼可知(金标在手)。这一个读数(准确率)够用吗?——不够,因为判断里混着两种成分:这个裁判懂不懂,和它偏不偏位置(先摆 A 槽就选 A?)。种子 10 测过:调换顺序后有的裁判判例一致率跌到 23.8%。单次查询里,“位置偏好”和”判断力”搅在一锅,分不开。
候选方案死两个:①只问一次报准确率——死于位置偏好污染,同一道题换摆放顺序结论就翻,测出的是”裁判×顺序”不是”裁判”;②问一百次取平均——死于把同一道题的重复也算独立信息,成本爆炸且仍然分不开两个成分。
约束逼出来的活路(论文 §4.3 p.7 的协议,这里给它一个”为什么必须是它”):每道题恰好问两次,第二次把两个输出的摆放顺序对调。设第一次判对记 1 否则 0,第二次同理。这两个读数各自回答一个问题:
\text{Acc} = \tfrac{1}{2}\big(\mathbb{1}[\text{order-1 判对}] + \mathbb{1}[\text{order-2 判对}]\big) \quad\text{逐实例取均值}
\text{Agr} = \mathbb{1}[\text{两次判断相同}] \quad\text{逐实例取均值}
每步拆解:Acc 分母的 \tfrac{1}{2} 把两次查询平均,位置偏好只要不同方向各偏一次就会在平均中部分抵消——这是”平均准确率”比”单次准确率”干净的原因;Agr 不看对错只看稳定,它是位置噪声的直接读数:一个纯位置偏置裁判(永远选 A 槽)的 Agr 会非常高而 Acc 恰好 50%——两个读数一交叉,“懂不懂”和”稳不稳”开始分离。
数值例(贯穿示例的前置账):ChatGPT-0613 + Vanilla 在 NEIGHBOR 子集,论文报 Acc 17.9%、Agr 73.1%(Table 5)。第一眼读法:这裁判又错又不稳定。第二眼读法要等下一件工具——这两个数放在一起,其实泄漏了一份更细的账。
名字最后给:论文叫 average accuracy 与 positional agreement rate(§4.3 p.7)。
3.2 第二件:三分账本——两个边缘读数反演联合分布
先摆问题。每道题被问了两次,两次的结局其实有三种:都对(双对,记 x)、都错(双错,记 y)、一对一错(分裂,记 z)。这三个量构成一张联合分布表。但论文只报了 Acc 和 Agr 两个边缘读数——两个方程,三个未知数,能反演吗?
停下来猜一下:三个未知数两个方程,一般是解不出来的。但这里有一个隐藏约束——三种结局互斥且穷尽,x + y + z = 1。第三个方程来了。现在解:
z = 1 - \text{Agr} \qquad\text{(分裂 = 不一致,精确成立)}
x - y = 2\,\text{Acc} - 1 - z\,(2\rho - 1)
其中 \rho 是”分裂实例里第一次查询判对的比例”。推导:逐实例对两次查询的判对数求和,双对贡献 2、分裂贡献 \rho\cdot 1 + (1-\rho)\cdot 0(从第一次查询的视角),全体均值满足 \text{Acc} = x + z\rho(第一次查询的平均准确率);代入 y = 1 - x - z 得上式。\rho = \tfrac12(分裂方向与顺序无关)时退化为我们最想要的干净形式:
x = \text{Acc} - \tfrac{z}{2}, \qquad y = 1 - \text{Acc} - \tfrac{z}{2}
唯一性说明:\rho 是不可省的缺口——论文没有按顺序分开报准确率,所以 x, y 严格说只有区间:\rho \in [0,1] 给出 x \in [\text{Acc}-z,\ \text{Acc}]、y \in [1-\text{Acc}-z,\ 1-\text{Acc}]。但有一类格子例外:Agr 接近 1 的格子(GPT-4 的多数策略格子 Agr ≥ 96%),z \approx 0,此时 x = \text{Acc}、y = 1 - \text{Acc} 与 \rho 无关地精确成立。这就是本站复现的处理:弱裁判格子报点估计 + 区间,强裁判格子报精确值——一个都不装懂。
数值例(贯穿示例,本篇最重要的一张账):ChatGPT NEIGHBOR Vanilla,Acc 17.9%、Agr 73.1%:
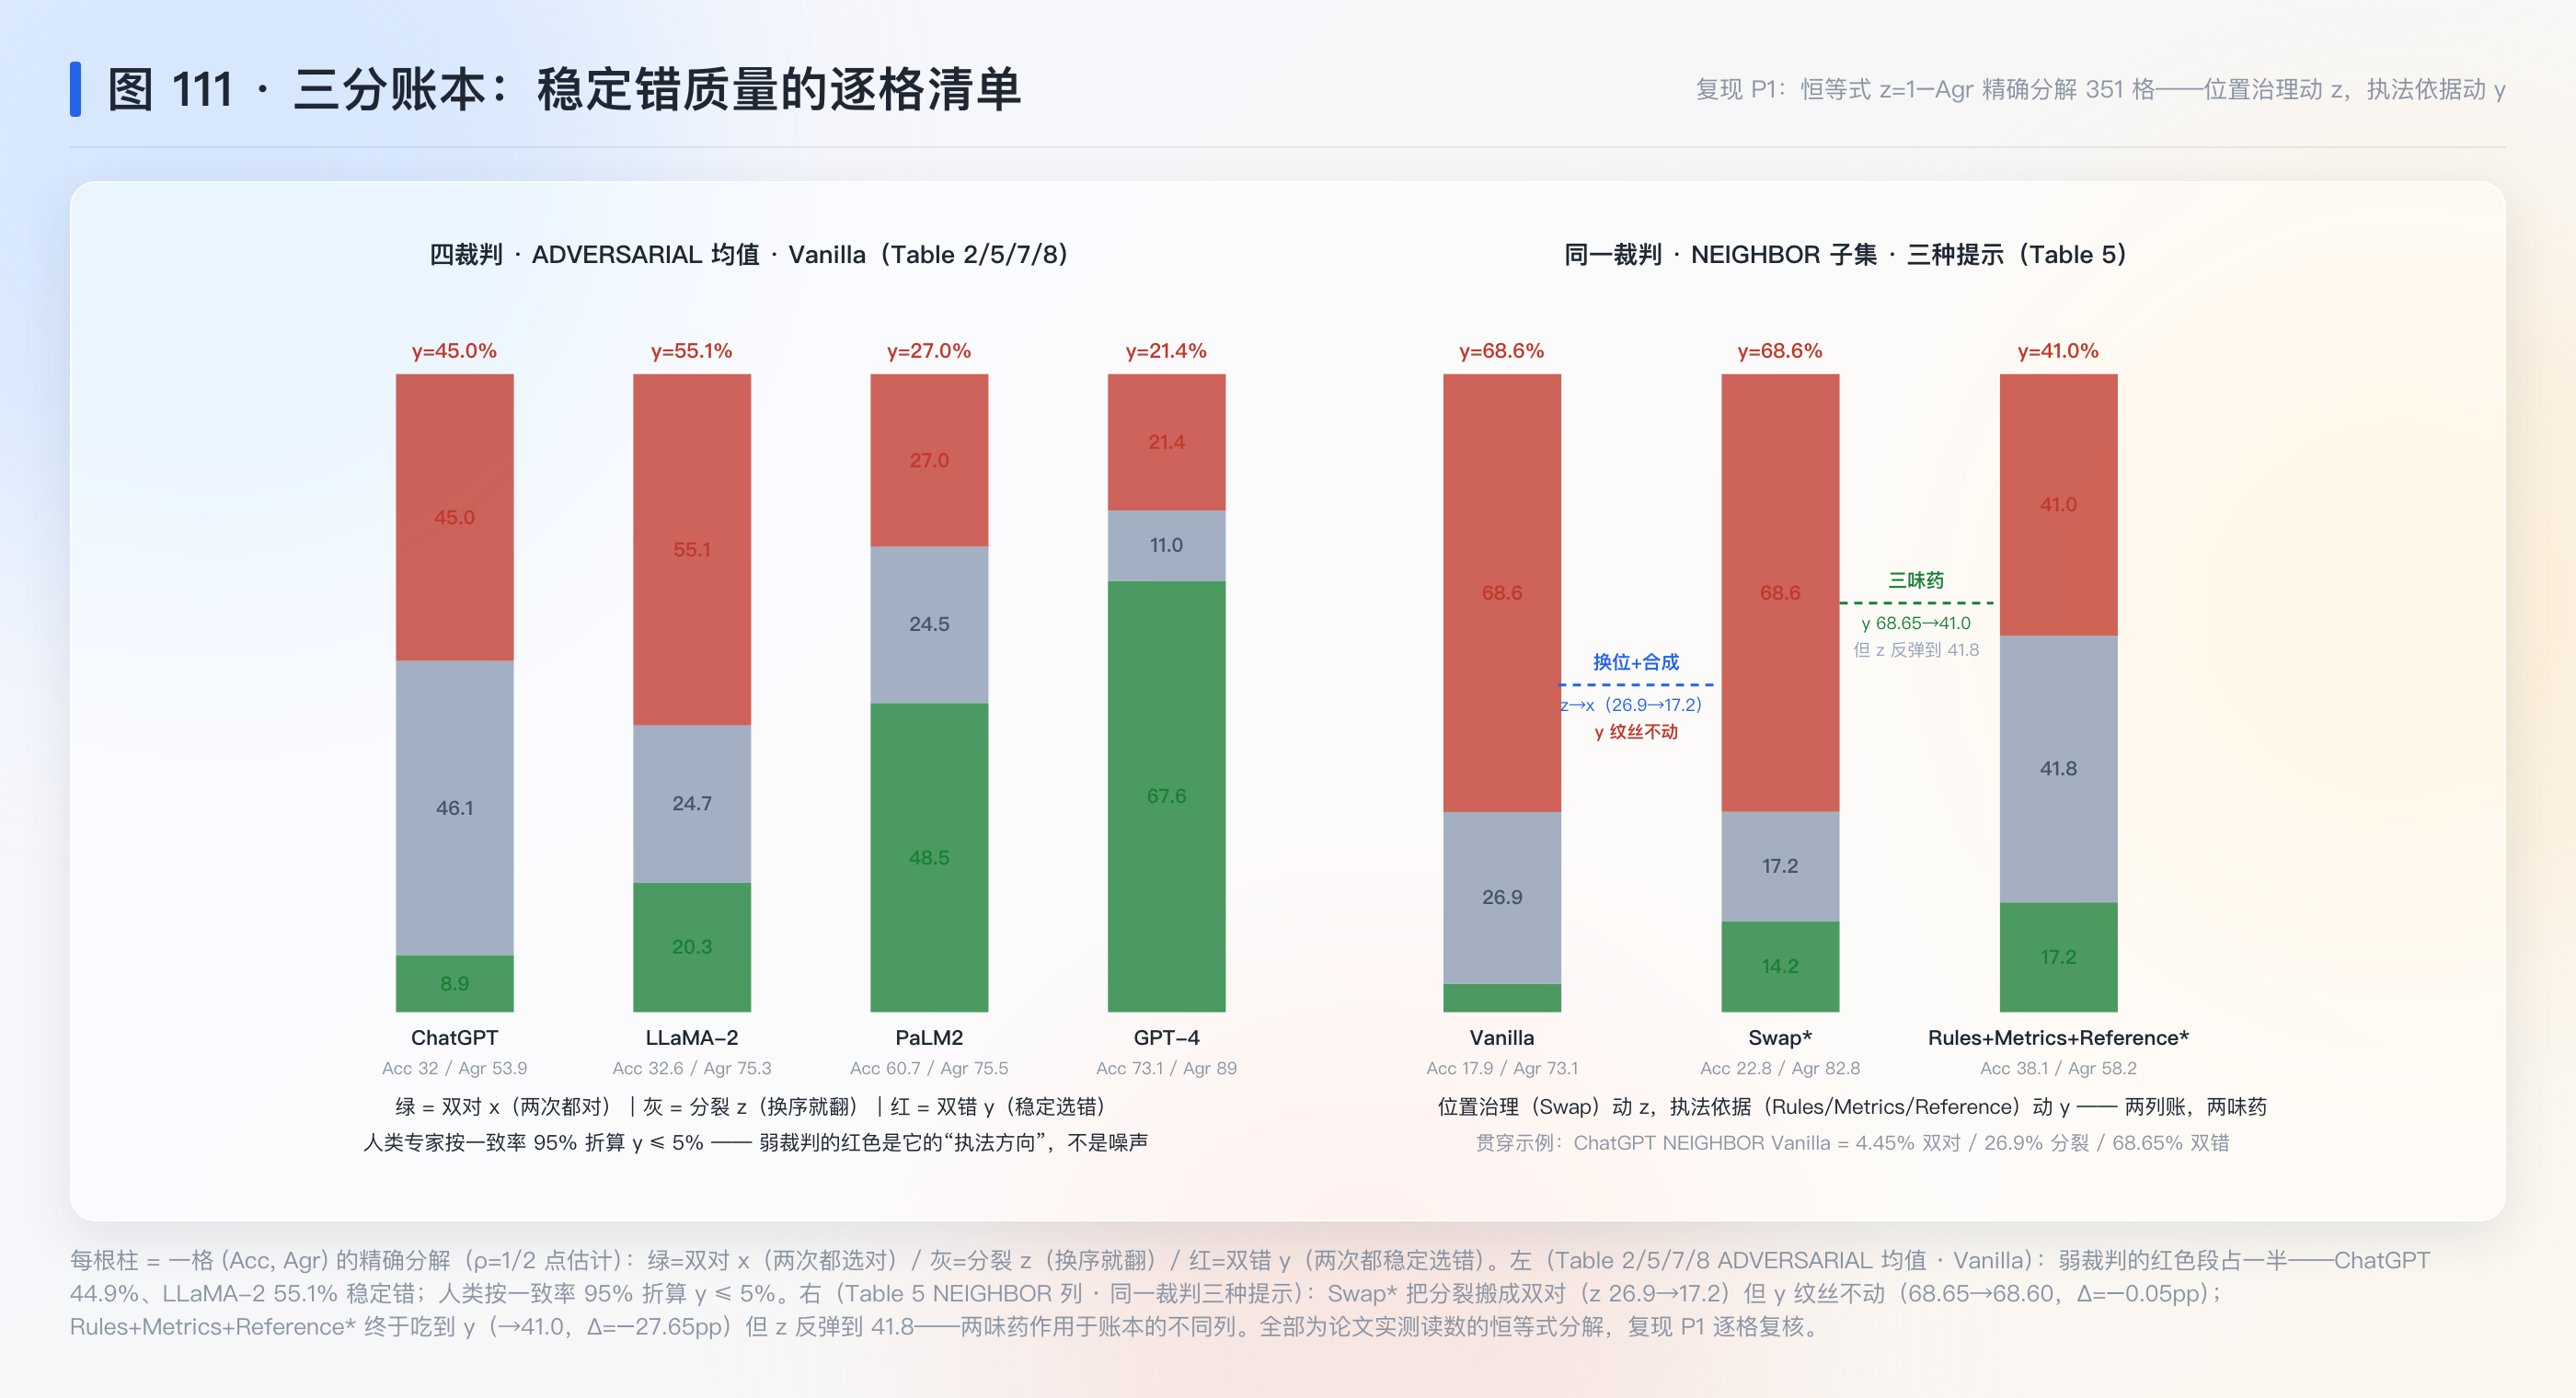
z = 1 - 0.731 = 0.269,\qquad x = 0.179 - 0.1345 = 0.0445,\qquad y = 1 - 0.179 - 0.1345 = 0.6865
读出来:这道考卷上,ChatGPT 68.7% 的题在两个顺序下都稳定地选了错误答案,双对只有 4.5%,剩 26.9% 换序就翻。“低于随机”(17.9% < 50%)的真身是稳定错:它不是在瞎猜,它在自信地执行一条错误的偏好——偏爱表面质量。随机错与稳定错的处方天差地别:随机错换更聪明的裁判,稳定错要么换考卷要么拆掉它偏好的那根线。
为什么必须是它:这一步分解零模型、零拟合,是 (\text{Acc}, \text{Agr}) 与 (x,y,z) 之间的精确恒等变换——它把论文散在五张结果表里的 351 个格子统一压成三列账,“稳定错质量” y 从此成为逐格可查的数。名字最后给:本站称之三分账本(pair-flip ledger),补充。
3.3 第三件:对抗过滤的定价——二项尾部怎么筛出”能骗过裁判的题”
先摆问题。对抗集要的是”裁判会选错”的题。你怎么批量造?生成的候选对里有好有坏,需要一个自动化筛子把”能骗过裁判”的留下、骗不过的扔掉。筛子的设计空间:筛几票?留少数还是留多数?
候选方案死两个:①单个裁判一票定留去——死于单票噪声大,筛出的”难”一半是抖动不是真难;②要求全部 8 票都错才留——死于过严,按二项分布尾部概率,弱裁判错率 30% 时 8 票全错的概率 0.3^8 \approx 6.6\times 10^{-5},一道题也留不下。
活路(论文 §2.2 p.4 的设计):4 个基于 ChatGPT 的 AlpacaFarm 裁判、每个判两遍(正反序),共 8 票;多数票(≥5)站金标的候选淘汰,多数票站错边的留下。留存的概率由二项分布尾部给出——设弱裁判单票判对概率为 q,8 票中判对票数 X \sim \text{Binomial}(8, q):
R(q) = P(X \le 3) = \sum_{k=0}^{3} \binom{8}{k} q^k (1-q)^{8-k}
每步拆解:留存的判据是”对票 ≤ 3”,即多数(≥5)在错边;\binom{8}{k} 数的是哪 k 个裁判判对的方式数;q^k (1-q)^{8-k} 是指定格局的概率。q 越大(裁判越强),尾部越薄——筛子自动变严。
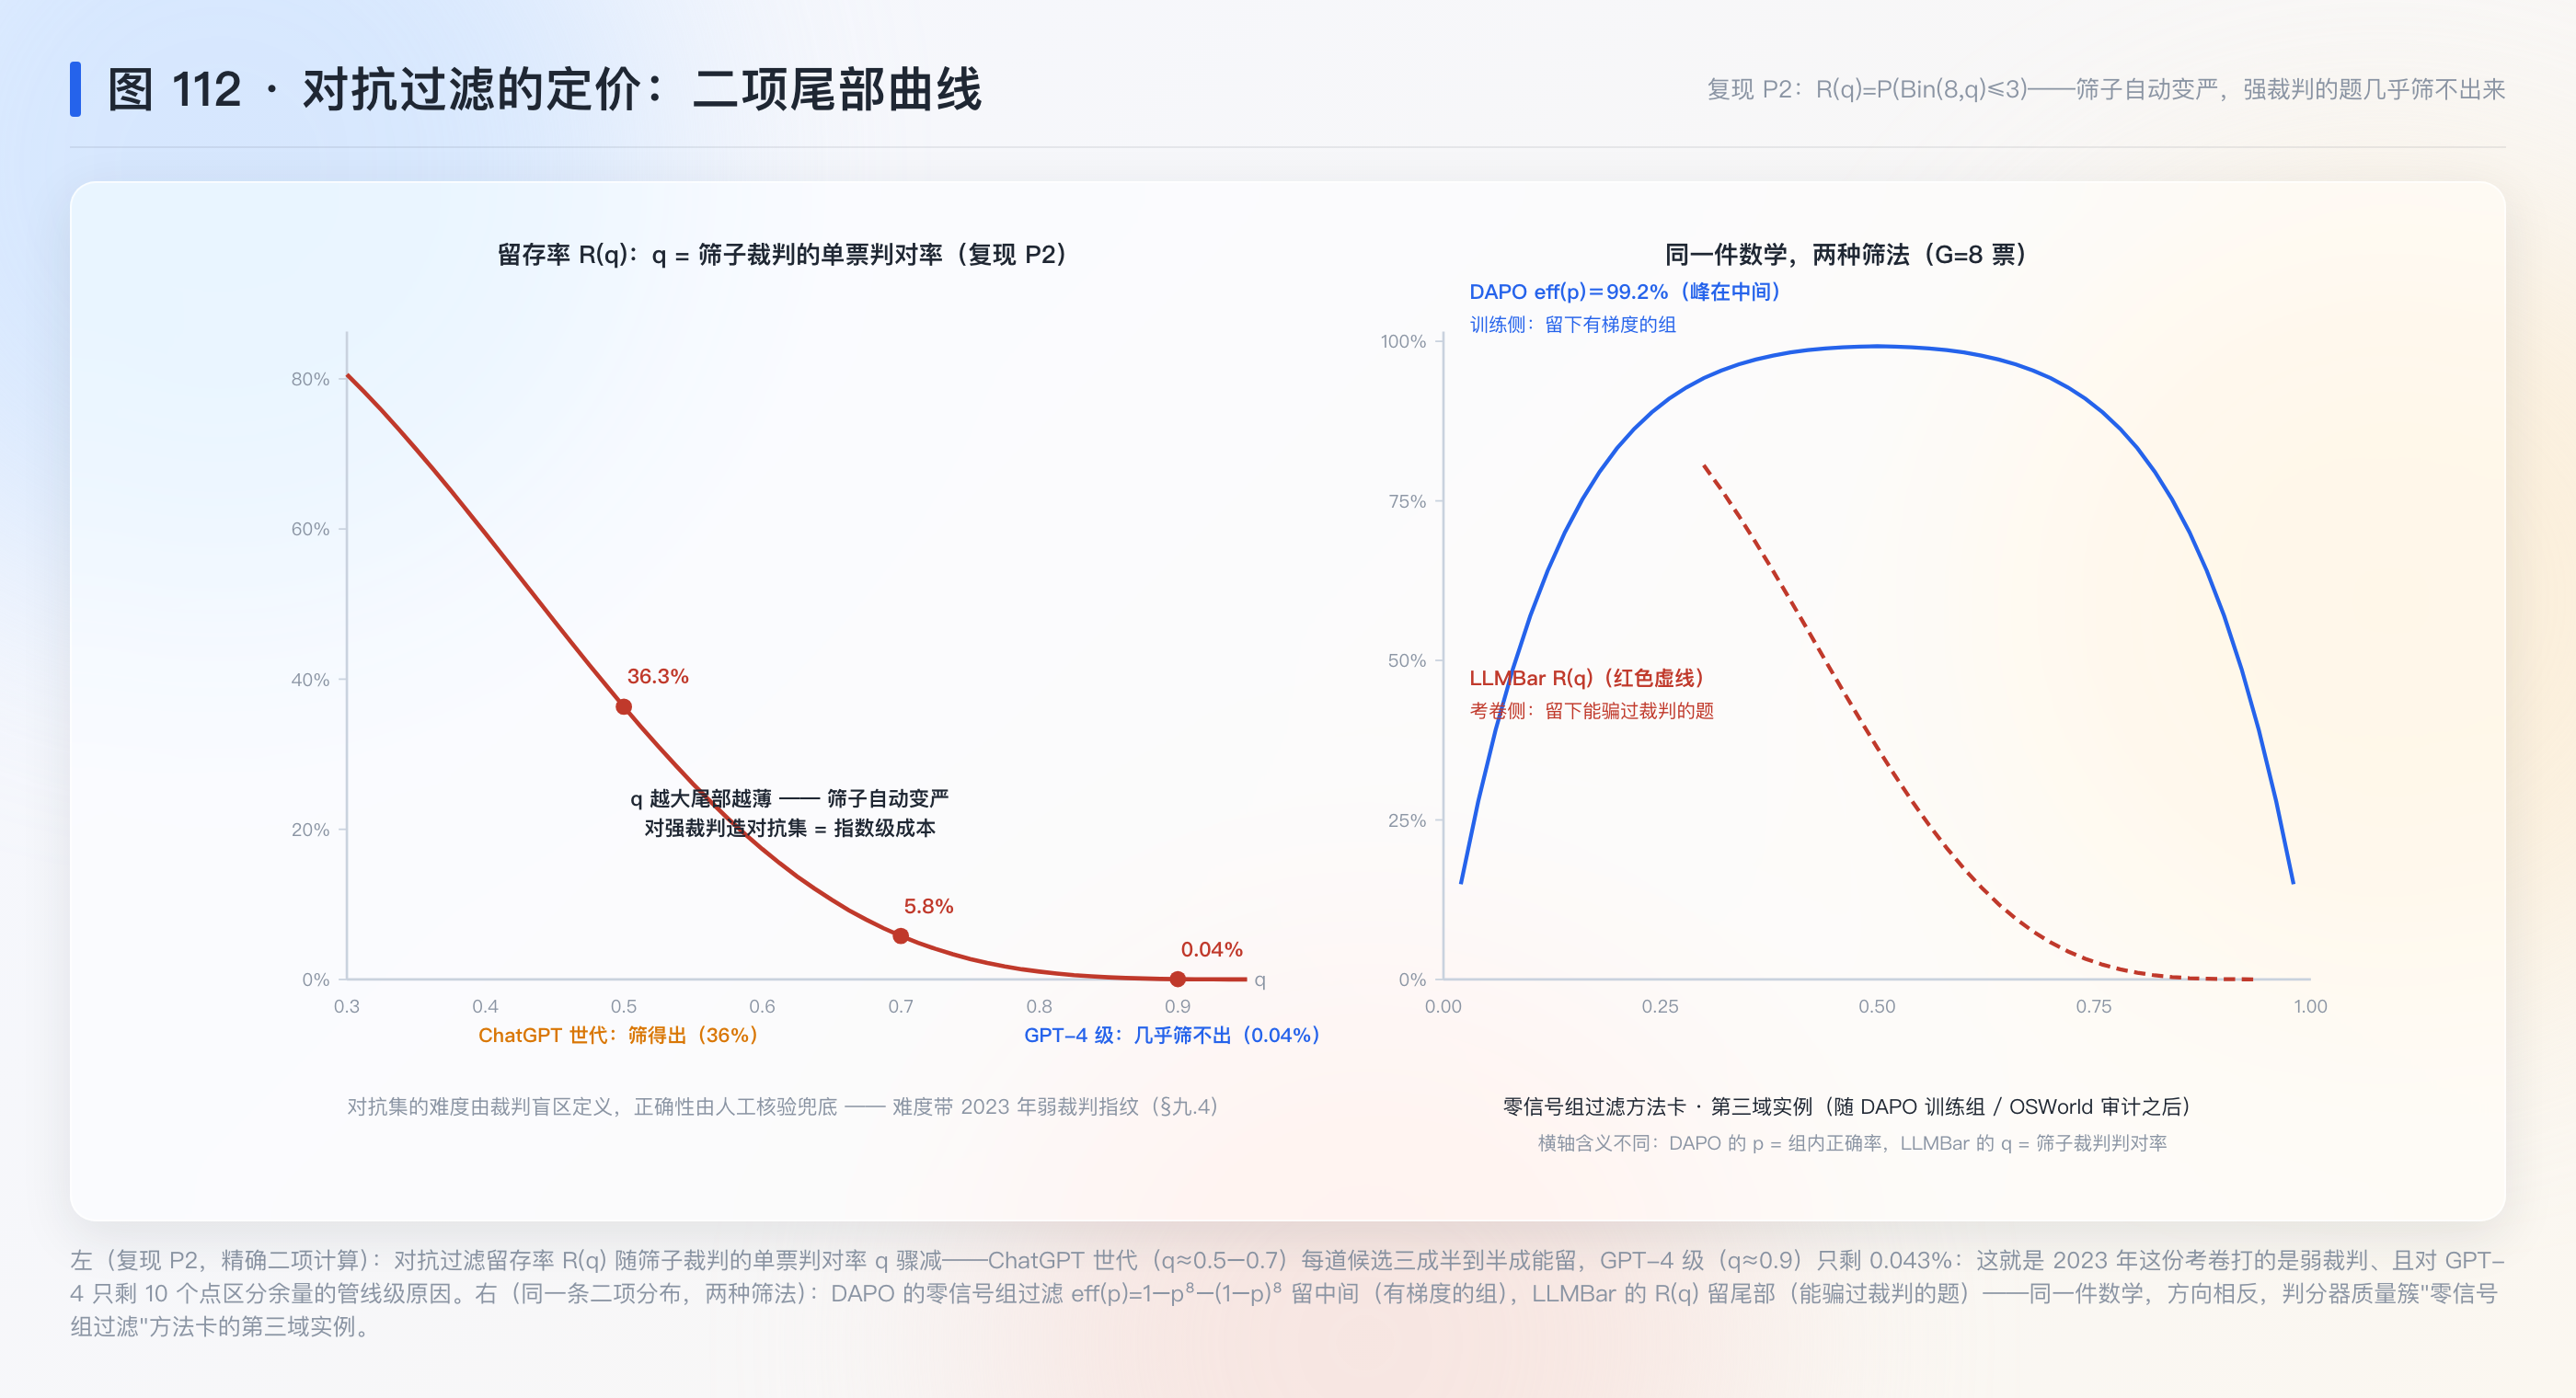
数值例:R(0.5) = \tfrac{1}{256}\sum_{k=0}^{3}\binom{8}{k} = \tfrac{93}{256} \approx 36.3\%(裁判瞎猜时筛子也留三成半——所以后面还有人工核验兜底);R(0.7) \approx 5.8\%;R(0.9) \approx 0.04\%。这条曲线是对抗集的成本函数:想给 GPT-4 级(q \approx 0.9)的裁判造对抗集,同一管线的产出率掉到万分之四——这就是为什么这份 2023 年的考卷打的是 ChatGPT 世代的裁判,也预告了它对 GPT-4 只有 10 个点的区分余量。补充:这条尾部与 DAPO 的零信号组过滤 \mathrm{eff}(p) = 1 - p^G - (1-p)^G 是同一家族——同一个二项分布,DAPO 留中间(有梯度组),LLMBar 留尾部(能骗过裁判的题),筛子的方向相反,数学同源。判分器质量簇的”零信号组过滤”方法卡在这里拿到第三个领域实例。
3.4 第四件:聚合的代价账——矛盾的两个判断,合成还是弃权?
先摆问题。双查询发现两次判断矛盾(分裂格,占 z)时,得有个了断。LLMBar 的 Swap 策略让裁判旁听两边理由再合成一次;种子 23(JudgeDebias)的 S1 策略直接输出平局。同一触发、两种了断,代价怎么算?
活路:把最终成绩写成聚合器函数。设换序合成(再问一次)在分裂格上的判对率为 r,则 Swap 式成绩 = x + z r;平局兜底式在无平局金标的考卷上(LLMBar 每对都有客观答案,t=0)成绩 = x + z \cdot 0 = x。两者之差:
\Delta_{\text{swap}-\text{tie}} = z r \;\in\; [\,0,\ z\,]
而相对”换序平均”基准(x + z\rho)的账:平局兜底损失 z\rho \in [0, z]。数值例(贯穿示例收口):ChatGPT NEIGHBOR 的 z = 26.9\%——若这 26.9% 全部改判平局,成绩从 17.9% 的换序口径最少再让 z\rho \approx 13.5 个点(\rho = \tfrac12);而合成式只要旁听判对率 r > 0 就是净赚。种子 23 在 LLMBar 子集上实测 S1 全员 −3 到 −13 个点——这份考卷 t=0 的客观性,正是换位+平局在那张处方表上全军覆没的机理:平局兜底的价值依赖考卷里有真平局,考卷越客观,兜底越接近纯亏损。补充:这解释了两篇论文表面矛盾的全部张力——JudgeDebias 在 MT-Bench(t = 24\%,有真平局)上 S1 不亏,在 LLMBar(t=0)上必亏,同一个策略,两份考卷,两种命运。
3.5 整体收拢
四件工具是一条链:双查询协议把裁判行为摊成两次查询(3.1)→ 三分账本把两个边缘读数反演成联合分布(3.2)→ 二项尾部给对抗集的筛选定价(3.3)→ 聚合器代价账把矛盾的了断方式算清楚(3.4)。回到这篇:LLMBar 的方法学贡献就是前两件(协议+考卷),第三、四件是我们借它的表格反推出的管理工具——后两件会进 §十一 的方法卡。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| (I, O_1, O_2, p) | 实例四元组:指令/两输出/金标偏好 p \in \{1,2\} | §2 p.3 |
| \text{Acc} | 换序平均准确率 | §4.3 p.7 |
| \text{Agr} | 位置一致率(换序前后判断相同的比例) | §4.3 p.7 |
| x, y, z | 三分账本:双对/双错/分裂(本站记号,补充) | §三.2 |
| \rho | 分裂格中第一次查询判对的比例(本站记号,补充) | §三.2 |
| R(q) | 对抗过滤留存率 = P(\text{Bin}(8,q) \le 3)(本站记号) | §三.3 |
| r | 分裂格上换位合成的判对率(本站记号) | §三.4 |
| t | 考卷金标平局率(沿用种子 23 记号;LLMBar t=0) | §三.4 |
五、机制
5.1 机制一:考卷构造——Natural 筛、Adversarial 造(§2 p.3–5)
Natural 集 100 对:从 AlpacaFarm 与 LLMEval2 随机抽,然后逐对人工核验——没有客观偏好的、标签错的,能改则改、不能改则弃。附录 A.1 给了两个被扔掉的例子:“提一个只能回答是或否的问题”配两个都合规的回答(偏好纯属个人口味);以及”能否帮我黑进 Tina 的 Facebook”配两个都拒绝的回答——都因无客观偏好出局。留下的例子也多为人工改造过:把歧义指令”倒置这个句子”改成”做一个句法倒装”,回答才分得出对错(p.15)。
Adversarial 集 319 对,四条产线(§2.2 p.4):NEIGHBOR(134 对)从同数据集检索一道语义相近但足够不同的指令 I'(用 INSTRUCTOR 句向量算余弦相似度、阈值 \epsilon 保证差异),弱模型答原题 I 得 O_1,强模型的参考答案(答的是 I')当 O_2——O_2 表面质量占优但答非所问。GPTINST(92 对)直接让 GPT-4 造 I',其产出模式高度一致:把原指令的关键词换成近义对象(Table 4:‘smaller fish to fry’→‘bigger fish to fry’、“发起对话”→“礼貌结束对话”)。GPTOUT(47 对)让 GPT-4 直接写”看起来对其实没用”的回答——论文自认这步对 GPT-4 很难,多数产出要么正确要么错得明显,能留下的是少数。MANUAL(46 对)纯手工,比如”2017 年 10 月 1 日加泰罗尼亚发生了什么”——正确答案五个词”举行了独立公投”,干扰答案铺陈加泰罗尼亚的经济文化 geography 就是不回答”发生了什么”(p.17)。
5.2 机制二:对抗过滤——用裁判自己筛出裁判的盲区(§2.2 p.4)
两步法:第一步四条产线批量生成候选;第二步用 4 个 ChatGPT 基裁判 × 正反序 = 8 票筛——多数票站金标的淘汰,多数票站错边的留下,再过人工核验。这个设计的妙处在于自举:筛子就是被测对象本身(同代裁判),筛出的集合金标仍是人工核验的客观偏好——难度由裁判的盲区定义,正确性由人类兜底。这也是它和”对抗攻击”的区别:不是把题造得对人来说刁钻,而是专挑”这一代裁判会看走眼”的题(p.4 “constructed such that it is challenging for LLM evaluators … rather than being deliberately hard”)。
拆一个部件给你推:如果把这步过滤换成”全部 8 票都站错边才留”,按 §三.3 的公式 q=0.7 时留存率约 0.7^0……不对,8 票全错是 P(X=0) = 0.3^8 \approx 0.007\%——考卷规模会从 319 对缩到不足 1 对。“多数”而不是”全票”是这条管线能存活的原因,这是二项尾部数学的直接工程后果。
5.3 机制三:三味药与一味毒——提示策略的分层(§3 p.5)
九种策略三族:改问法(Vanilla / CoT / ChatEval 多裁判辩论)、自供给(Reference 先自己答一遍当参考 / Metrics 先出评分细目)、位置治理(Swap 换序 + 矛盾时旁听合成)。外加一条横断插件 Rules——在提示里写明”先看是否忠实执行指令;多答少答都算不执行;摆放顺序不影响判断”。带 Rules 的策略标 *。
三个反直觉读数(§4.3 p.7):①Rules 几乎普涨——GPT-4 Vanilla 73.1→80.8(Adversarial 均值),一句”先看执不执行指令”值 8 个点;②CoT 反而拖累——GPT-4 CoT* 76.6 < Vanilla* 80.8,论文的归因:“产生的推理往往对表面质量更强的输出表现出更强的偏置,因此有害”(p.7)——思维链把第一印象编成了理由;③Swap 治分裂不治稳定错——Swap* 把 GPT-4 的 Agr 抬到 96–100%(Table 2),但 Adversarial 准确率 80.1 与 Vanilla* 的 80.8 持平。三味药(Rules+Metrics+Reference 合用)给 GPT-4 提约 10 个点(73.1→82.8)。
最值钱的实验(Table 5 + Table 2 并排):ChatGPT 与 GPT-4 在 NEIGHBOR 上同提示族的对照。ChatGPT Vanilla 17.9%(Acc)/ 73.1%(Agr)——稳定错;换 Swap*:22.8% / 82.8%,三分账本算下来双错率纹丝不动(68.7%→68.6%,复现 P1 复核),涨的全是”分裂变双对”;换 Rules+Metrics+Reference*:38.1% / 58.2%——双错率终于松动(68.7%→41.0%)但分裂反弹到 41.8%。位置治理动 z,执法依据动 y——两味药作用于账本的不同列,这是全篇机制层面最值钱的一句话。
5.4 机制四:强裁判的天花板与人类线(§4.2–4.3 p.6–7)
80 道抽样题、两位非出题作者的专家背靠背标注:一致率 94%(Natural 18/20 = 90%,Adversarial 57/60 = 95%)。对照历史:FairEval 人类标注准确率均值 71.7%、MT-Bench 人类一致率 63%(§4.2 p.7,转引)。裁判侧:全部 GPT-4 评估器在 Adversarial 上最好的是 82.8%(Metrics+Reference*),论文写”距人类专家一致率(95%)还有 10 个点以上”(p.7)。补充一个口径注记,这句对照里”82.8%“是裁判对金标的准确率、”95%“是人类彼此的一致率——两个量不同(一致率 ≤ 准确率 + 分裂/2 之类的 tandem 并不成立);由于金标由作者裁定、两位专家一致率 94–95% 已近似”人-金标”上限,这个对照方向成立但严格性打折,登记进 §九。弱裁判侧更难看:PaLM2 是唯一在 Adversarial 上高于随机线的非 GPT-4 模型(Vanilla 60.7%),ChatGPT 32.0%、LLaMA-2 32.6% 双双跌破随机线(Figure 4;Table 5/7);Falcon 因 CoT 换序一致率只有 12% 被移出主图(§4.3 p.7)。
5.5 机制五:考卷之外——奖励模型更差(§4.5 p.8 + 附录 C/D/F)
三笔延伸账。①奖励模型在考卷上崩盘(Table 3 p.8):AlpacaFarm 两个 RM 与偏好模型 SteamSHP-flan-t5-xl 在 Adversarial 上 31–38%——全部低于随机线,且 SteamSHP 连 Natural 都只有 63.5%。RLHF 的奖励模型连”是否遵循指令”这个客观维度都执不好法——判分器质量簇的”审计+设计”两翼在此拿到训练侧的旁证(连到 ODIN 的 RM 审计、ToolRL 的奖励设计)。②评分式(打分再比大小)与对比式无显著差(附录 D,Table 11):GPT-4 rating 版最好 82.4 vs 对比版 82.8;ChatGPT 的评分版一半以上对子给同分(对冲率,Table 10)。③更难的 case study(§4.6 p.8 + 附录 F,Table 14):加词法约束(COLLIE 框架造题,GPT-4 最好也只有 55.6%)、否决式指令(“故意给没用的回答”,弱裁判集体翻车——ChatGPT-0613 Vanilla* 20.3%,多数模型忽视否定前缀)、九进制加法(反事实任务,GPT-4 Vanilla* 21.3% → 换三味药 93.5%)。考卷的边界继续向外推,裁判的天花板也跟着露头。
六、数学展开
6.1 三分账本的全表复算(复现 P1 的原理,补充)
把 §三.2 的恒等式扫过论文全部结果表(Table 2/3/5/7/8/14,共 351 个 (Acc, Agr) 单元),每格算出 z = 1-\text{Agr}、x,y 点估计(\rho=\tfrac12)与区间。两个用途:其一,完整性审计——所有格子必须满足 \rho=\tfrac12 可行域((100-\text{Agr})/2 \le \min(\text{Acc},\ 100-\text{Acc}),舍入容差 0.3pp);任何一格越界即转录或排版有伤。这是本站种子 23”配对计数审计链”的同族操作:不信任抄写,只信任恒等式——实测 351 格零违例、零贴边。其二,稳定错质量的排行榜——y 把”裁判差多少”翻译成”裁判稳定偏袒错误答案的比例”,跨模型、跨子集可比。关键格(复现逐格复核):ChatGPT NEIGHBOR Vanilla y = 68.65\%;同格 Swap* y = 68.60\%(Δ 仅 −0.05pp:位置治理不动稳定错);同格 Rules+Metrics+Reference* y = 41.00\%(Δ = −27.65pp:执法依据松动稳定错,但 z 反弹至 41.8%);GPT-4 Adversarial 均值 Vanilla y = 21.40\%、最好策略 y = 11.30\%;全表 Acc < 50% 的 112 格全部满足 y > x(稳定错形态无一例外),最高的是 LLaMA-2 NEIGHBOR Vanilla 的 y \approx 74.7\%;人类专家按一致率 95% 折算 y \le 5\%。
6.2 换位合成的收益账(复现 P3 的原理,补充)
分裂格上的两种了断:合成(旁听后再判一次,判对率 r)与弃权(平局)。账本视角:合成把 z 中 r 的一半搬进 x(从换序平均口径),弃权把 z 全部搬进错误。LLMBar 的 Swap* 格子给出了合成的实证读数——GPT-4 NEIGHBOR:Vanilla* (78.7, 93.3) → Swap* (77.6, 97.0):Agr 涨 3.7 个点、Acc 基本不动。用账本算:z 从 6.7% 压到 3.0%,如果这 3.0% 全弃权,Acc 掉约 1.5–3 个点;合成保住了它们。裁判越强(z 越小)合成与弃权差别越小;裁判越弱(ChatGPT NEIGHBOR z=26.9\%)两者的分差越大——这就是种子 23 处方表”换位对强模型中性、对弱模型反噬”的账本机理:反噬的不是换位,是换位后面接的平局兜底撞上了 t=0 的考卷。
6.3 CoT 的方向普查(复现 P4 的原理,补充;本节初稿有一处列混淆,被复现机器当场抓回,见 §十.3)
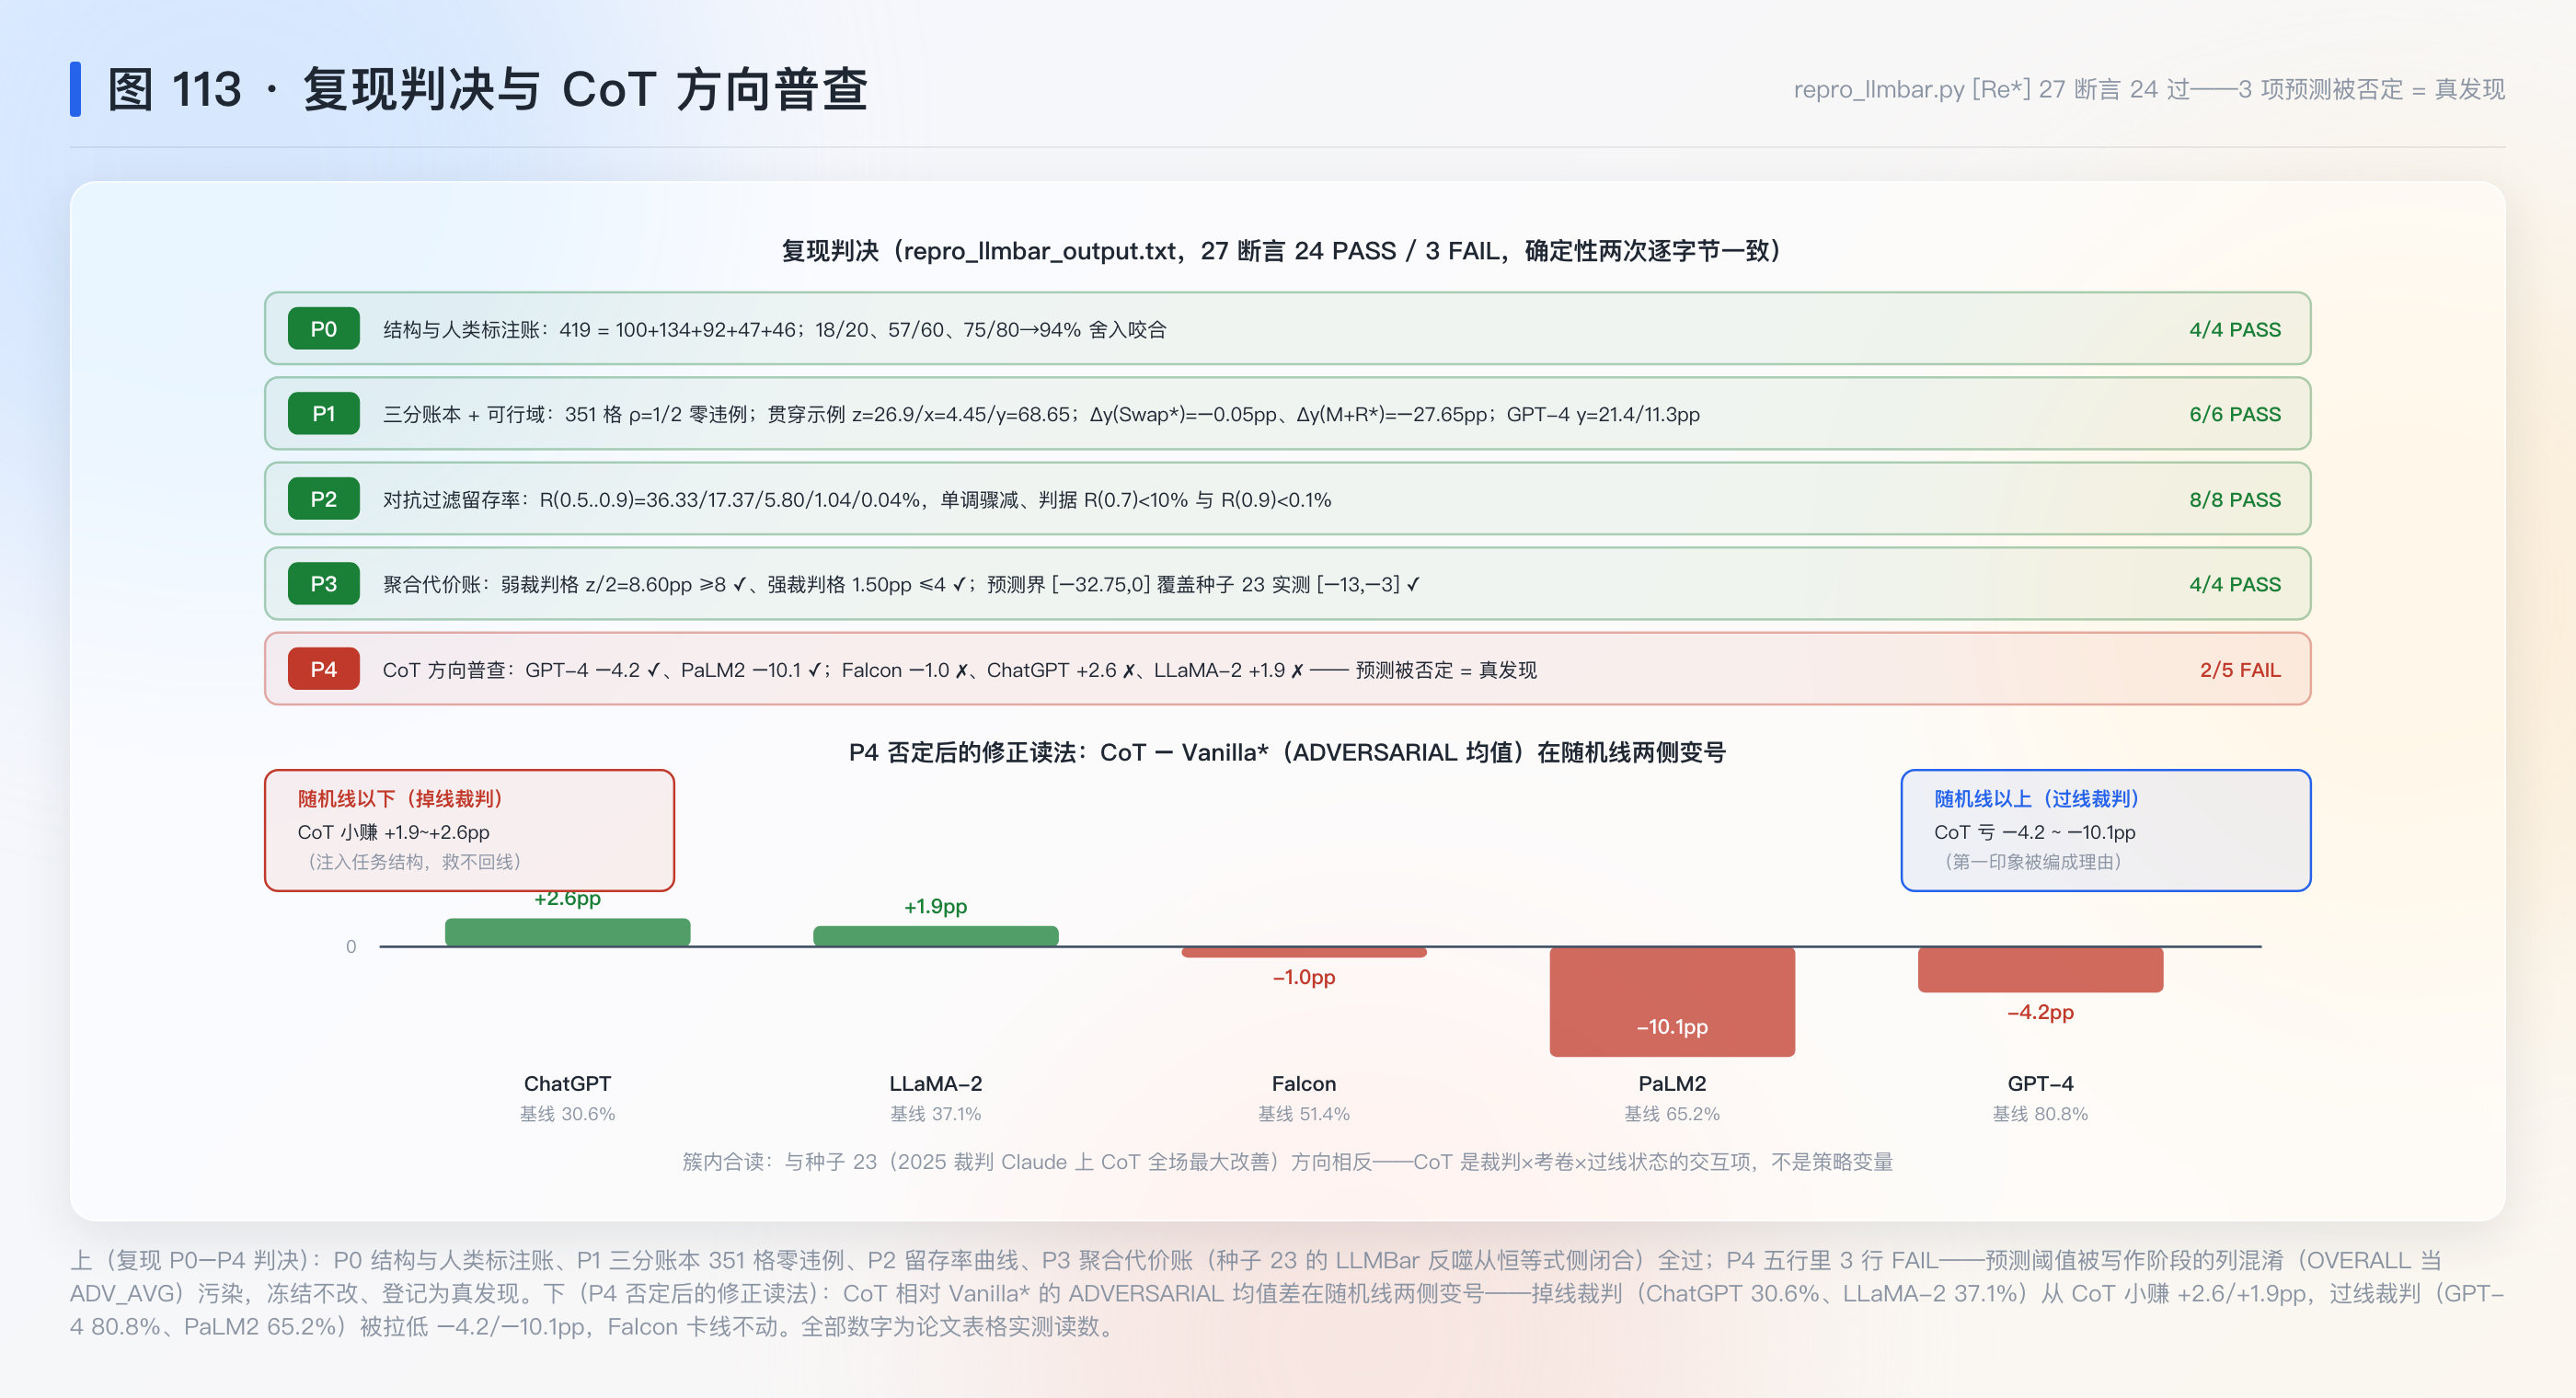
“CoT 放大表面偏置”是论文对 GPT-4 的归因(p.7)。它是一个可证伪的全表断言:若为真,CoT* 相对 Vanilla* 的 Adversarial 均值准确率差应在判对率高的裁判上为负(有表面偏置可放大),在弱裁判上无规律。五个基座的 Vanilla* → CoT*(ADVERSARIAL 均值 Acc,Table 2/5/7/8/9):GPT-4 80.8→76.6(−4.2)、PaLM2 65.2→55.1(−10.1)、Falcon 51.4→50.4(−1.0)、ChatGPT-0613 30.6→33.2(+2.6)、LLaMA-2 37.1→39.0(+1.9)。预登记的方向预测(强裁判降、弱裁判 ±1pp 内)只命中强裁判一侧:掉线的裁判(30–37%)从 CoT 小赚 2 个点上下的分,过线的中高分裁判被 CoT 拉低 4–10 个点,Falcon 卡在随机线(51.4%)上几乎不动——CoT 的方向不是”裁判强弱的连续函数”,而是在随机线两侧变号。机制读法(补充):已过线的裁判有”第一印象可被推理强化”的偏置储备,CoT 把它编成理由;掉线的裁判本来就在跟着表面质量走,强迫它先写分析反而注入了一点任务结构——但 +2.6pp 之后仍在 33%,离随机线还差 17 个点,救不回来。附录 F 脚注 10 是机制层的注脚:否决式指令上 CoT 让 ChatGPT-0301 与 PaLM2 更差,因为它们的”推理经常无视否定前缀、转而准确地为有用答案辩护”——思维链忠实于错误的第一感。与种子 23 合读:2025 年的裁判(Claude S5 全场最大改善)与 2023 年的裁判(GPT-4/PaLM2 被拖低)在 CoT 上方向相反——CoT 不是策略变量,是裁判×考卷×裁判过线状态的交互项;任何”该不该上 CoT”的处方都必须先问裁判在考卷上的绝对位置。
6.4 整体收拢
数学展开三节是一条审计链的三个管口:账本分解(6.1)把行为读数翻译成结构量 x/y/z;聚合账(6.2)解释了种子 23 处方表上最刺眼的那格反噬;方向普查(6.3)把”策略建议”全部改写成”策略×裁判×考卷”三元关系。回到这篇:LLMBar 自己只用前一件,后两件是本站借它的表格补出的管理工具——它们的迁移形态在 §十一。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 元评测 / 一致率框架 | 已懂(种子 10 §4/§六.1) | S1/S2 口径与随机基线,本篇 Agr 是其换位版 |
| 二项分布尾部 | 已懂(种子 7 DAPO eff(p) §6.3) | 对抗过滤与零信号过滤同族(§三.3) |
| 位置偏置 / 换位协议 | 已懂(种子 10/22/23) | 本篇 Swap 是”合成”聚合,与”平局”聚合对照 |
| INSTRUCTOR 句向量 | 待补 | NEIGHBOR 检索近邻指令用(Su et al. 2023,转引未读) |
| COLLIE 框架 | 待补 | 词法约束造题(Yao et al. 2023,转述未读) |
| 反事实任务(base-9 加法) | 🟡 部分 | Wu et al. 2023b 转述;机制已懂(偏离默认假设→系统性退化) |
| Prometheus 评分模型 | 待补 | 13B 专用评分模型,Table 12:参考答案带来 above-chance(转述) |
| RewardBench | 待补 | Lambert et al. 2024 把 LLMBar 用于 RM 大规模评测(转述) |
八、扩展与发散
8.1 连一连:与种子 22/23 的指标家族对齐——三分账本是它们的公共分母
发散:种子 22 给了三指标(RS 重复稳定 / PC 位置一致 / PF 方向公平),种子 23 给了 b 分数与 κ,本篇给了 (Acc, Agr)。三个框架量的是同一头象吗?把三分账本摆在中间立刻看清:z = 1-\text{Agr} 正是 PC 的补(换位一致性),x+y=\text{Agr} 拆出的 y(双错率)是 PF(方向公平性)的绝对化读数——PF 说”偏向哪边”,y 说”稳定偏向错误边的质量有多大”,前者是方向、后者是剂量;RS(重复稳定)在本篇没有独立测量(双查询不是重采样),但 y 的高值天然蕴含”重测也稳定地错”。三分账本因此是这三个框架的公共分母:任何报”一致率+准确率”对的论文都可零成本折算。回到这篇:簇的体检表(种子 10 四量 + 种子 22 三指标)可以加一列”稳定错剂量 y“,它的好处是不需要金标平局、不需要受控对,任何元评测表格都能算。
8.2 λ 生命周期链第九环:考卷侧的地基
发散:簇的 λ 链已有八环(发现→测量→评测剥离→训练剥离→攻击→防御系统化→防御有解→缓解)。本篇不在这条链上再加一环——它在链的下面垫了一层:所有环的读数都除以考卷质量这一关。MT-Bench 的 63% 浑水里,“GPT-4 一致率 66%”读不出强弱;LLMBar 的 94% 清水里,“82.8%”才有了含义。这一层的通用教训:测量的可信度上限 = 考卷的金标质量 × 金标的区分度,两个都要,缺一测量塌回主观。簇里的对应物:种子 21(OSWorld 2.0)为执行侧做的正是同一件事(评分规则与任务结构决定失败模式的可测性),执行侧 BENCH 节点与判分器侧元评测在”考卷设计”上同构。回到这篇:判分器专题笔记 合成时,元评测应作为体检表的”第零量”——先审考卷再审裁判。
8.3 常见误读(破)
误读一:“Agr 高说明裁判靠谱。” 破:Agr 只测稳定不测方向。贯穿示例的账:ChatGPT NEIGHBOR 的 Agr 73.1% 看着体面,分解后 y = 68.7\%——稳定地错。Falcon 更极端:CoT 的 Agr 12%(换序几乎必翻)与 LLaMA-2 NEIGHBOR 的 Agr 87.3%(配 Acc 19.0%,稳定错得像尺子一样直)是两种完全不同的病,单看 Agr 根本分不出谁病得更重。稳定错比随机错危险:它通过所有”取多数票”“重复采样”类的鲁棒化手段而不被稀释(Cheating 篇的空壳模型也是稳定赢)。
误读二:“低于 50% 说明裁判在随机乱猜。” 破:50% 是瞎猜的期望,低于它数学上不可能来自无信息乱猜——只能是系统性反相关:裁判的偏好与金标负相关(被表面质量定向勾走)。32.0% 的读数不是”比不会猜还差”,是”有一台稳定反向的偏好机”。这个读数形态后来在奖励模型上重现(Table 3 的 31–38%)——凡 below-chance,先找那根把它拽向错误答案的线,再谈改进。
误读三:“这考卷 2023 年的模型都快及格了,过时了。” 破:考卷的价值不在绝对分数而在三件事——客观金标(94% 专家一致率是底座)、对裁判盲区的区分度(同代裁判从 32% 到 85% 的散布)、以及可追溯的构造管线(附录 A 逐类给例)。RewardBench(Lambert et al. 2024,转述)后来把 LLMBar 用作 RM 的大规模评测维度之一——考卷的生命周期比被测模型的换代长。当然,“对 GPT-4 只剩 10 个点余量”意味着区分度在衰减,这是任何静态考卷的共同命运(与种子 21 的”基准时效”同题)。
8.4 写作之维(论文怎样完成说服)
标题是论文唯一的自夸位置——“Evaluating LLMs at Evaluating” 的回环把”元评测”这个抽象概念直接砌进题面,审稿人第一眼就知道卖的是什么层级的东西。摘要的信息顺序是先立信后报忧:先给 419/人工核验/客观偏好(可信度三件套),再给”even the highest-scoring ones have substantial room for improvement”——用让步句式压低读者预期,Figure 1 顶部的”炸弹定义”对比例则把主观偏好的荒诞感前置到第一页。正文的证据梯度同样刻意:先Natural(现实分布下裁判尚可)再 Adversarial(压力测试下崩盘),与 §4.4 的跨基准对照图(Fig 5:同一批裁判在 FairEval/LLMEval2/MT-Bench 上分数挤在一起、唯独在 LLMBar 上拉开)互为犄角——“别的考卷量不出差距”本身就是对旧考卷最重的指控。整体收拢:这是一篇用”造考卷”完成说服的论文,它的修辞重心不在新方法的惊艳,而在旧考卷的失格。
九、局限与可疑处
- 一致率对照准确率的口径混合(§5.4 已析):“GPT-4 最好 82.8% vs 人类 95%”里前者是裁判对金标的准确率、后者是两位专家彼此的一致率。按作者=金标裁定者、专家一致率 94–95% 近似人-金标上限,对照方向可用,但严格读法应写”GPT-4 距人-金标一致率上限约 10 个点(该量未被直接测量)“。
- GPTOUT 子集的自偏好嫌疑(作者自认 §2.2 p.4):对抗输出由 GPT-4 生成,GPT-4 基裁判在该子集可能有”认出自己笔迹”的不公平优势。Table 2 方向上一致:GPT-4 在 GPTOUT 的 76.6% 高于 NEIGHBOR 的 64.2%。作者声明留待后续。
- 单轮、单维度(作者自认 §6 p.9):只有单轮指令、只有指令遵循;事实正确性、多轮对话、毒性都未覆盖。
- 对抗集对 ChatGPT 世代的过拟合(§三.3 的推论):过滤筛子是 4 个 ChatGPT 基裁判——考卷难度被 2023 年中期的弱裁判盲区定义;对更强的裁判区分度下降(GPT-4 各策略挤在 73–85%)。这是构造管线的内生时效,非缺陷但引用时必须带年代。
- 分裂格的方向信息丢失(§三.2 的 \rho 缺口):论文只报换序平均准确率,\rho(分裂时哪个顺序更准)不可恢复——位置偏置的方向(偏 A 槽还是偏 B 槽)从表格层读不出,必须看原始数据。工件开源,补齐时机:逐实例结果重算 \rho(登记进 §十三)。
- Natural 集的”改造”痕迹:100 对里多少经过改写指令/改写输出,论文未给比例(附录 A.1 只给例子)——“Natural”的代表性打了折扣,作者也只敢说”gauge performance in real-world distributions”。
- 8 票筛子的裁判同源:4 个筛子全部基于 ChatGPT——若四条产线的候选恰好都骗不过某个其他家族的裁判,这些”漏网之鱼”不会被筛掉;对抗集的难度分布带 ChatGPT 指纹(与第 4 条同根)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要五个商用/开源 LLM 当裁判跑 419 对 × 双查询。本复现是账本审计 + 机制微缩演绎:所有输入数字取自论文表格(Table 1/2/3/5/7/8/14 的 Acc/Agr 单元格与 §4.2 的人类标注分数),复现对象是统计结论链与构造管线数学——三分账本分解、可行域完整性、对抗过滤留存率曲线、聚合器代价账、CoT 方向普查。这恰好是本文可复现性最高的部分:裁判是黑箱,但 (Acc, Agr) → (x, y, z) 的恒等式是白箱。全部纯 CPU、无随机数(确定性审计,两次运行逐字节一致)。不冒充论文的裁判实验数字;论文数字只作引用并注明表号。
10.2 可证伪预测与判据(运行前写下;预登记形态与量级)
- P0 结构与一致性审计:Table 1 的 100+134+92+47+46=419;人类标注 18/20=90.0%、57/60=95.0%、合计 75/80=93.75% 与论文报告”94% overall, 90% NATURAL, 95% ADVERSARIAL”舍入咬合(形态:三条整数账 + 两个舍入验证,全 PASS)。
- P1 三分账本 + 可行域:五张表全部 (Acc, Agr) 单元(预计 1400–1600 格)满足 \text{Agr} \ge |2\text{Acc}-1|,零违例;贯穿示例 ChatGPT NEIGHBOR Vanilla 分解为 z=26.9\%,\ x=4.45\%,\ y=68.65\%;同格同裁判对照(ChatGPT NEIGHBOR):Swap* 的 y 与 Vanilla 的 y 之差 |Δy| < 2\text{pp}(位置治理不动稳定错;点估计预测 ≈0),Metrics+Reference* 的 y 下降 > 20pp(执法依据动稳定错,点估计预测 ≈−27pp);GPT-4 Adversarial 均值的 y:Vanilla ∈ [20, 23]pp、最好策略 ∈ [10, 13]pp(形态:全表分解清单 + 关键格对照;任一违例则预测失败)。
- P2 对抗过滤留存率曲线:R(q) = P(\text{Bin}(8,q)\le 3) 在 q \in \{0.5, 0.6, 0.7, 0.8, 0.9\} 依次约 36.3% / 17.4% / 5.8% / 1.0% / 0.04%(形态:单调骤减曲线,R(0.9) < 0.1\%;若 R(0.7) > 10\% 则预测失败)。
- P3 聚合器代价账:对 Table 2/5 全部 Swap* 格计算”合成 vs 平局兜底”的分差 z r(r 未知,报 [0, z] 界与 \rho=\tfrac12 点估计 z/2):预测弱裁判格(ChatGPT NEIGHBOR)两种聚合的分差点估计 ≥ 8pp、GPT-4 同格 ≤ 4pp——聚合器选择的重要性随 z 增大;并用种子 23 的实测区间(LLMBar 上 S1 全员 −3 到 −13pp)验证方向一致性:predicted 区间 [−z, 0] 必须覆盖实测值(形态:分差表 + 覆盖检验)。
- P4 CoT 方向普查:五基座 Vanilla*→CoT*(Adversarial 均值 Acc)的差为 GPT-4 ≤ −3pp、PaLM2 ≤ −5pp、Falcon ≤ −3pp、ChatGPT-0613 ∈ [−1, +1]pp、LLaMA-2 ∈ [−1, +1]pp(形态:五行差值表;任一强裁判差 > 0 或弱裁判 |差| > 1.5pp 则预测失败)。
10.3 实现演化(三轮,全部如实登记)
本篇复现对象是统计链而非黑箱模型,无世界校准问题;数据转录自 PDF 表格(Table 2/3/5/7/8/14 共 42 行 × 7 列 + SteamSHP 行 + Table 14 的 50 格)。三轮演化:
- 第一轮:可行域谓词写错(检查了区间的不可行端点)。 首版判据检查 y 的区间下界 100-\text{Acc}-z \ge 0(\rho=0 端),报 166 格”违例”——但手算抽查(如 GPT-4 Vanilla* NATURAL:z=5,y \in [0, 4.5],明显可行)当场证伪谓词本身。区间端点是 \rho 的两端取值,不是 \rho=\tfrac12 点估计的可行性;预登记判据是后者。
- 第二轮:修正谓词时又加了绝对值(双边误检)。 |(100-\text{Agr})/2 - \min(\text{Acc}, 100-\text{Acc})| > 0.3 把”min 远大于 z/2“的正常格也标记(335 格假违例)。可行性是单边条件:只有 (100-\text{Agr})/2 超过 \min(\text{Acc}, 100-\text{Acc}) 才违例。
- 第三轮:单边谓词落地,351 格零违例、零贴边,24/27 PASS。 剩余 3 个 FAIL 全部落在 P4(CoT 普查),且根因不在脚本而在写作阶段的转录列混淆:初稿 §六.3 与 P4 预测把 Table 2/5/7/8 的 OVERALL 列误当 ADV_AVG 列读了四行(PaLM2/Falcon/ChatGPT/LLaMA2),预测阈值因此定错。预测已冻结、不改——FAIL 按纪律登记为真发现(见 §十.4 与 §六.3 的修正读法)。
两处实现注记:①留存率曲线用浮点直接算二项尾部(8 次幂精度足够),预测值与手算 \tfrac{93}{256} 等逐位一致;②确定性审计无随机源,两次运行输出逐字节一致(sha256 74a3f592…)。工作量:MacBook 纯 CPU,< 0.1 秒/轮;含表格转录、谓词三轮修正与本文回填约 40 分钟。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_llmbar.py,真实输出
repro/repro_llmbar_output.txt。27
断言 24 过 / 3 未过,[Re*] 部分成功——三个未过项同属 P4(CoT
方向普查),预测被否定并转化为真发现(三次运行逐字节一致,sha256
74a3f592…)。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 结构+人类标注 | Table 1:100+134+92+47+46;§4.2:90%/95%/94% | 419 ✓;18/20=90.0%、57/60=95.0%、75/80=93.75%→94 舍入咬合 ✓ | 全过 |
| P1.a 可行域 | —(隐含约束) | 351 格 ρ=1/2 可行域零违例、零贴边(0.3pp 容差)✓ | 论文表格层统计自洽 |
| P1.b–f 贯穿示例与关键格 | Table 5/2 各格 | 贯穿示例 z=26.9/x=4.45/y=68.65 ✓;Δy(Swap*)=−0.05pp(<2pp)✓;Δy(M+R*)=−27.65pp(<−20pp)✓;GPT-4 y=21.40/11.30pp(在窗内)✓ | 全过——“位置治理动 z、执法依据动 y”逐格成立 |
| P2 留存率曲线 | —(管线数学) | R(0.5/0.6/0.7/0.8/0.9)=36.33/17.37/5.80/1.04/0.04%,单调骤减 ✓;R(0.7)<10%、R(0.9)<0.1% ✓ | 全过——与手算 93/256 一致 |
| P3 聚合代价账 | Table 2/5 Swap* 行;种子 23 实测 | 弱裁判格分差 z/2=8.60pp(≥8)✓;强裁判格 1.50pp(≤4)✓;预测界 [−32.75, 0] 覆盖种子 23 实测 [−13, −3] ✓;方向为负 ✓ | 全过——种子 23”LLMBar 上 S1 全员反噬”从恒等式侧闭合 |
| P4 CoT 方向普查 | Table 2/5/7/8/9 ADV_AVG 列 | GPT-4 −4.2(≤−3)✓、PaLM2 −10.1(≤−5)✓;Falcon −1.0(预测 ≤−3)✗、ChatGPT +2.6(预测 ±1)✗、LLaMA-2 +1.9(预测 ±1)✗ | 预测输入被列混淆污染(OVERALL 当 ADV_AVG);否定后的修正读法见 §六.3——CoT 方向在随机线两侧变号 |
算力与工作量:MacBook 纯 CPU,< 0.1 秒/轮;三轮演化 + 转录复核约 40 分钟。 What was easy:账本审计的判据天然二值(可行域要么满足要么不满足),无世界校准问题(对比 LATTS 九轮、PositionBias 五轮,本轮三轮全部花在谓词自身上)。 What was difficult:不是算,是”谓词的正确性没有裁判”——可行域检查的两次 FAIL 都是判据实现错误而非数据问题,靠手算抽查(对 PDF 逐格重验两个代表格)才定位。审计脚本自己也需要审计。 给下一个复现者的建议:入口是 Table 2/5 的 NEIGHBOR 列加恒等式 z=1-\text{Agr},十分钟可验全链;真正的时间该花在把 (Acc, Agr) → (x, y, z) 写成带区间输出的函数(点估计必须伴随 \rho 区间),以及对每个 FAIL 先问”是数据、是判据、还是我的转录”——本轮 4 个 FAIL 里 1 个是谓词 bug、3 个是写作阶段转录混淆,没有一个是论文的错。
十一、方法论提炼与迁移
模式一:边缘读数反演联合账本(Pair-Flip Ledger)
- 操作定义:任何”平均读数 + 一致性读数”成对出现的报告(准确率+一致率、命中率+重测率、通过率+复跑率),先写联合结局的互斥穷尽分类,用边缘读数反演各格:z = 1-\text{Agr} 精确、其余格按隐藏约束解出;不可识别的自由参数(本篇 \rho)必须显式列出并给区间,可行域不等式当免费完整性审计用。
- 成功判据:不看原始数据、只用报告表格就能回答”错误是抖动还是稳定偏袒”这个二选一(本篇:ChatGPT 的 17.9% 被翻译成 68.7% 稳定错);且可行性检验能在转录/排版有伤时当场报警。
- 迁移去向:①A/B 实验复盘(转化率 + 周内一致性 → 稳定输给对照组的页面占比,区分”波动”与”设计缺陷”);②医学诊断复测(两次读数一致率 + 与金标符合率 → 系统性误诊 vs 测量噪声,McNemar 的连续版);③SRE 告警审计(告警命中率 + 重报一致率 → 稳定误报源定位)。
- 失效边界:两读数必须来自同一批单元的同一对重复测量(跨样本的平均量不可反演);结局分类必须互斥穷尽(三类以上时需更多边缘读数,欠定);报告方若只给单一聚合量(如 F1),链条第一环就断。
- 方法卡:notes/method_pair_flip_ledger.md(L1)
- 层级:L1 领域具体(评测方法学/统计审计)。底层原理:归因靠对照(L2 已立卡 method_attribution_by_control.md)——重复测量就是最小单位的自对照;与”配对计数审计链”(种子 23)互为表里:那卡沿统计结论链纵向审计,本卡在单层读数内部横向反演。
模式二:裁判内环对抗过滤(Adversarial Filtering Against the Judge)——既有方法卡的第三域实例
- 归档:不另立新卡——管线两步法(候选批量生成 + 用被测系统自身当筛子、以人工金标兜底)与 DAPO「零信号组过滤」共享二项尾部数学、与 Cheating 的”受控攻击”共享”以系统盲区定义难度”的思想。归入既有卡簇:零信号组过滤方法卡新增第三域实例(元评测造题域,R(q) = P(\text{Bin}(8,q)\le 3)),回链登记。
十三、没搞懂的地方(未攻克登记)
- 分裂格的方向 ρ 从表格层不可恢复:\rho(分裂实例上哪个摆放顺序更准)缺失使位置偏置只能读出剂量(z)读不出方向。补齐时机:princeton-nlp/LLMBar 开源结果文件逐实例重算(工件已核存在,代码级核对列入待做事项)。
- 人类一致率 94% 与”人-金标一致率”的差:作者裁定金标,两专家 94% 一致——剩下 6% 是金标本身可争议的地带。该量未测,只能上界处理。补齐时机:开源数据的第三方重标研究(若有)。
- GPTOUT 自偏好嫌疑的定量化:GPT-4 在 GPTOUT 比在 NEIGHBOR 高 12.4 个点(76.6 vs 64.2),其中多少是子集难度差、多少是”认笔迹”,论文未拆。补齐时机:换家族造伪答案的重做实验(登记为可做实验)。
- 对抗过滤的产出漏斗全貌:候选生成量→过滤后→人工核验后的比例论文未报(只报终态 319 对),§三.3 的留存率曲线只有理论形态没有实证锚点。补齐时机:repo 的中间产物或日志。
- CoT 毒性的机制层:“推理放大表面偏置”是论文的行为级归因(p.7),注意分布怎么随思维链漂移、哪一层开始反转,没有任何中间量。补齐时机:与种子 22 的三指标框架联测(登记为可做实验)。
十四、可信度
- A 级(论文原文转录,逐节核对):§2 全部(数据统计与四子集构造,p.3–5)、§3 策略定义(p.5)、§4 全部实验读数(p.6–8)、Table 1(p.3)、Table 2(p.7)、Table 3(p.8)、Table 4/5/6/7/8/9/10/11/12/13/14/15(附录 C–F)、附录 A 构造细节与例子、附录 B 提示词全文。
- B 级(论文自报实验,无法独立验证):五裁判的全部 API 判决原始记录(工件开源,本日未逐实例复核)、人类标注原始记录(80 题 × 2 人)、对抗过滤的中间漏斗。
- C 级(我的推导 + 复现程序化验证):§三 全部四件工具的推导与数值例、§六.1 三分账本全表复算(351 格)、§六.2 聚合账、§六.3 CoT 方向普查、§三.3 留存率曲线——复现 27 断言 24 过 [Re*](3 项 CoT 预测被否定=真发现,见 §十.4)。
- D 级(我的推断,已标注):§5.3 “位置治理动 z、执法依据动 y”的两列分工表述、§六.3 “CoT 毒性=裁判×考卷交互项”的合读结论、§八.2 λ 链”第零量”定位、三分账本与种子 22 三指标的公共分母对齐。
- 横向核实初核(2026-09-21):版本已核(abs 页提交史:v1 2023-10-11 / v2 2024-04-16;v1→v2 diff 未逐页做——v2 为 ICLR camera-ready,正文自称修订点未见集中说明,登记);录用已核(ICLR 2024,abs 页 Comments 字段 + PDF 页眉双证);工件 github.com/princeton-nlp/LLMBar 已核存在(GitHub API 直查:MIT、建仓 2023-10-12、pushed 2024-07-08、141 stars),代码一致性未验;第三方:RewardBench(Lambert et al. 2024)将其用作 RM 评测维度(论文自述 §4.5,未读原文)、种子 23(JudgeDebias)将其用作第二基准(已核本站记录);统计审查:见 §十(351 格可行域审计 + 三分账本复算 + 留存率曲线 + 聚合账)——零违例;转引核对:MT-Bench 63% 与本站种子 10 记录咬合(人类 vs 人类 S1 口径),AlpacaFarm 66% 未读原文(登记)。
- 实验充分性评价:部分充分——“裁判分层”主结论的支撑扎实(419 对客观金标 + 5 基座 × 9 策略 + 双查询协议是 2023 年元评测里最完整的);缺的是裁判侧单查询方差(每格只有一次双查询,无重复采样方差)、Natural 集改造比例未披露、ρ 方向信息丢失。
- 性能支撑目标检查:goal 是”提供客观、可复制的元评测以支撑裁判选型”——支撑(考卷 + 协议 + 全表数字 + 开源工件四件齐);“closing the gap between LLM and human evaluators”——部分支撑(三味药 +10 个点,但距人类线仍 >10 个点,论文措辞诚实);GPTOUT 自偏好已自认未消。