0. 你搭了一个 16 层网络。训练。底层权重几乎不动。
前七课解决了注意力的”怎么算”和”怎么学”。但六层、十六层地摞上去,新的问题出现了:你查看梯度——第一层的梯度范数只有 0.003,第十六层是 12.4。第一层几乎学不到东西。
你的第一反应:学习率太小?调大。loss 直接飞到 NaN。
这不是学习率的问题,是架构的问题。本课从 LN 的反传公式出发,解释为什么”归一化放在哪一层”会决定底层的学习信号是 2.30 还是 1267——一个 551 倍的差异。规矩不变:公式给演绎、结论机器验证。
1. LayerNorm 的反传:梯度净化器
LayerNorm 前向把每个向量”拉回稳定音量”——减均值、除标准差、再仿射。它的反向传播公式:
dx = \frac{\gamma}{\sigma}\Big(dy - \overline{dy} - \hat x\cdot\overline{dy\cdot\hat x}\Big)
这个公式读起来复杂,但它做的事很简洁:从上游梯度里精确滤掉两个分量——平移分量(减均值)和缩放分量(去 xhat 相关)。只留”纯形状变化”传下去。
为什么这重要?因为如果上游梯度里充满了”每层都在做同一种平移”的无信息分量,LN 把它们过滤掉,只让”有区分力的形状变化”通过。这就是”净化器”的含义:不是缩小梯度,是去掉无信息分量。
机器验证(P1):d = 16 全 entries 中心差分对照,最大偏差 4.9\times 10^{-9}。
2. post-LN vs pre-LN:551 倍的架构分离
LN 在层里的摆放位置有两种:
- post-LN:y = \mathrm{LN}(x + f(x))——先加残差,再归一。原始 Transformer 的做法。
- pre-LN:y = x + f(\mathrm{LN}(x))——先归一分支输入,再加残差。GPT-2 起的做法。
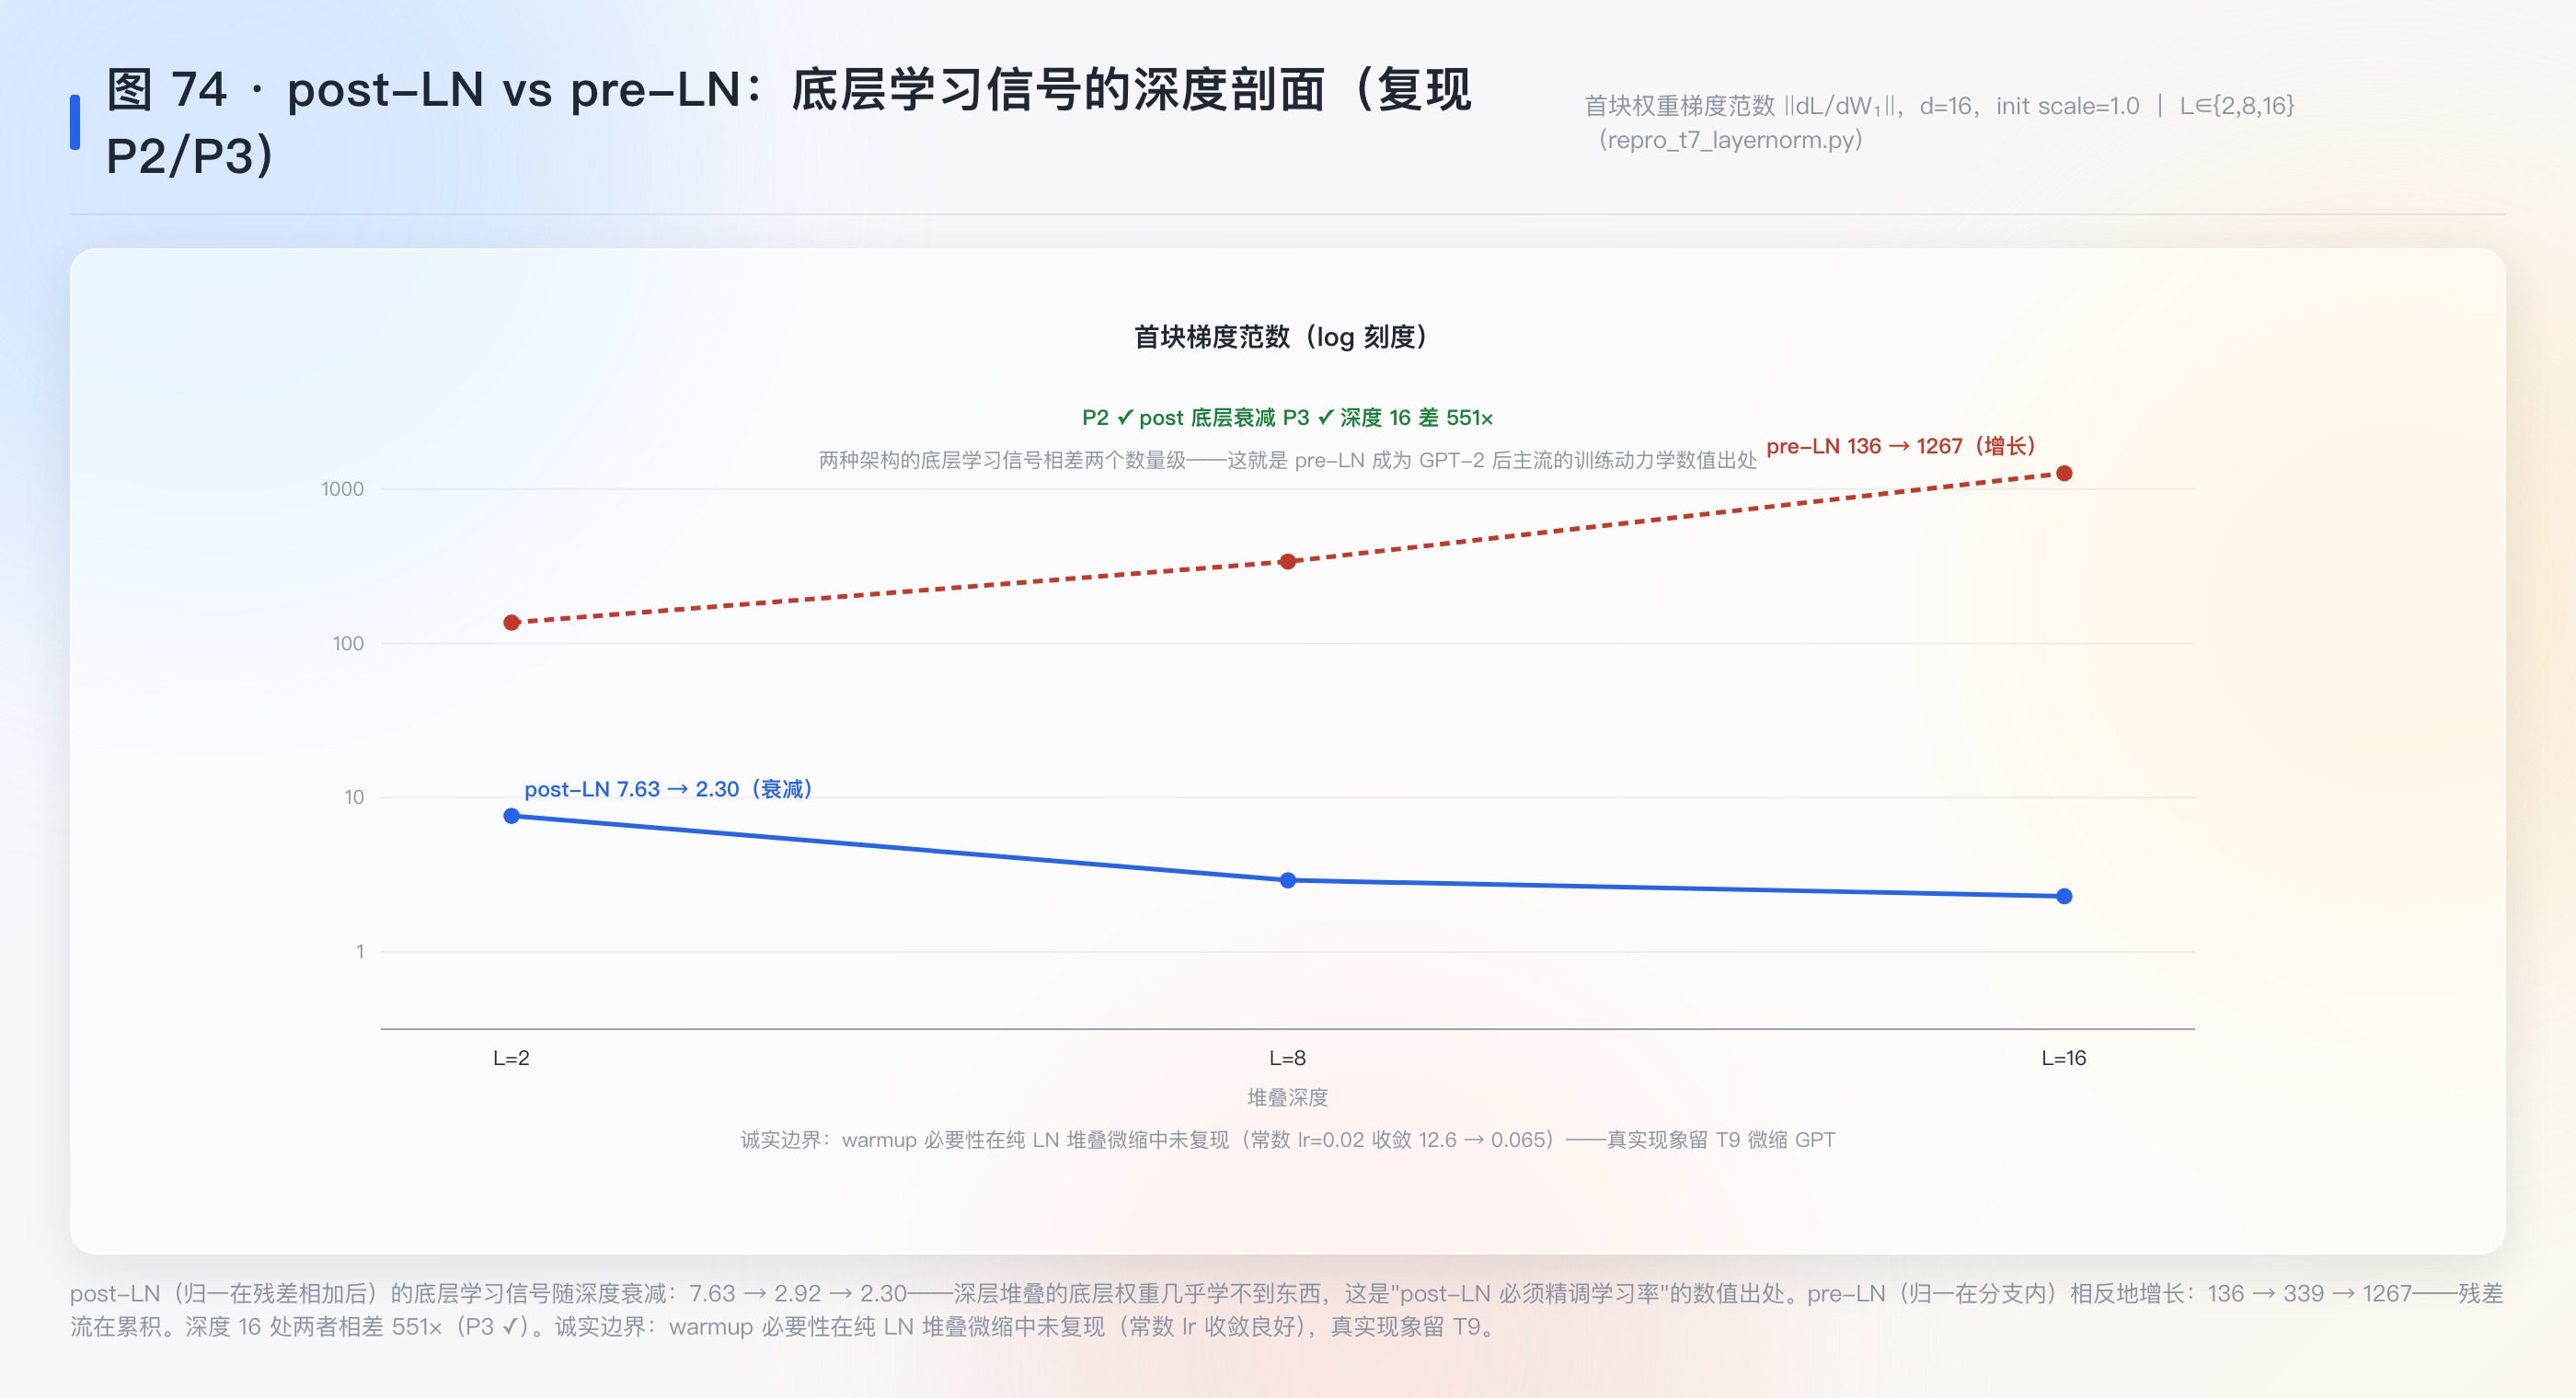
首块权重的梯度范数实测(P2/P3,d = 16):
| 深度 | post-LN | pre-LN | 比值 |
|---|---|---|---|
| L=2 | 7.63 | 136.3 | 18\times |
| L=8 | 2.92 | 338.9 | 116\times |
| L=16 | 2.30 | 1266.5 | 551\times |
post-LN 的底层信号随深度衰减(7.63 \to 2.30)——深层堆叠的底层权重几乎学不到东西。pre-LN 相反地增长(136 \to 1267)——残差流在累积。深度 16 处两者差 551 倍。这就是 pre-LN 成为 GPT-2 后主流的训练动力学数值出处。
3. warmup 的必要性:微缩中未复现
warmup 是 T1 式 (3) 里的一条神秘规则:学习率先线性爬升再衰减。论文没有解释为什么。
一个自然的假设:warmup 治的是 post-LN 的训练不稳定。但微缩实验给出一个诚实到有点尴尬的结果:16 块 post-LN 堆叠在常数 \text{lr} = 0.02 下 400 步收敛良好(12.6 \to 0.065,无发散)。warmup 版本也收敛。两者差异不大。
所以诚实的结论:warmup 的必要性在纯 LN 堆叠微缩中没有复现——不是”实验做错了”,是”玩具缺了真实 Transformer 的关键要素”——真实注意力算子的非线性、batch 噪声、Adam 二阶矩的相互作用、以及损失面的真实复杂度。这些要素的贡献留 T9 微缩 GPT(更大模型+真实任务)验证。
4. 机器验证汇总
随课断言在 repro_t7_layernorm.py 中独立重跑,4 项全过:LN 反传 4.9\times 10^{-9};post 底层衰减 < 1/2(P2);架构分离 > 100\times(P3,实测 551\times);微缩常数 lr 收敛(P4)。
5. 练习
- 推 LN 的 \beta 梯度:dL/d\beta = \sum_{\text{位置}} dy,并用差分器验证。
- 解释为什么 pre-LN 的残差流范数随深度增长而 post-LN 恒定(提示:post 每层把输出重新归一,pre 把 LN 后的输出加进未归一的流)。
- \gamma 初始化为 0 会发生什么?(该块在初始时是恒等映射——“LN 出厂即透明”,某些现代初始化策略正由此而来,登记。)
6. 下一课预告
L1-L7 到此线代教程七课齐。后续课程跟随 T 系列新实验日增补。
(汇编说明:本课素材汇编自研究轨 T7 实验日,断言见 repro_t7_layernorm.py 可独立重跑。)