0. 从一个”浪费”开始
前四课你造了一个单头注意力(L1 打分器、L2 记号、L3 定标、L4 位置)。一切正常。然后你读 GPT-2 的论文,发现它有 25 个头——不是 25 个模型,是同一个模型里并排放了 25 个注意力。
你的第一反应:这不是浪费吗?每个头都在看同一句话,25 双眼睛看同一份数据——不能让一个头多看几遍?
这个问题没有明显的答案。本课用两个实验回答它。规矩不变:概念被毛病逼出、结论机器验证、公式给演绎。前置:L2(矩阵的两种读法)。
1. 第一个实验:把打分矩阵”掰弯”——发现低秩
要理解多头,先回到单头的打分矩阵。L1 说过,单头的打分是 q \cdot k,而 q = xW^Q、k = xW^K。合在一起:
s(x_1, x_2) = x_1 \cdot (W^Q W^{K\top}) \cdot x_2^\top
把中间那个 M = W^Q W^{K\top} 单独拿出来看。它的形状是 d \times d(比如 48\times 48),看起来是一个全维的打分矩阵——但它的秩不超过 d_k = 6(两个因子的秩都不超过 6,乘积的秩不超过因子的最小秩)。
秩 6 的矩阵在 48 维空间里是什么概念? 它只能看到 6 个方向。剩下的 42 个维度上,M 的作用等于零。机器验证(P1,5 次随机实现):数值秩全部恰为 4(d_k = 4 时)——不是”接近 4”,是精确的 4。
这意味着:注意力的打分函数天生住在 d_k 维子空间里。 不管 W^Q 和 W^K 怎么训、训多久,它们的乘积永远只能看 d_k 个方向。
2. 从”浪费”到”设计”:为什么这是 feature 不是 bug
你可能觉得:这不是自残吗?明明可以用全维打分,为什么自己压到 6 维?
换个角度:如果你不用多头,而是用一个 d \times d 的全维矩阵做打分——你会得到什么?一个满秩的打分矩阵,每个方向都能提问。听起来更强?但实际上,不同类型的”问题”需要不同的方向:“这个名词的动词是什么”是一个方向;“这句话的语气是什么”是另一个方向;“代词指的是谁”是第三个方向。把它们混在同一个全维矩阵里,梯度会试图用同一组权重同时学所有类型的关系——互相干扰。
多头的设计:把不同类型的问题分给不同的头。每个头用自己的低秩子空间提问,互不干扰。数学上:25 个头,每个秩 6,合起来覆盖 150 维的子空间——不是用一个 48 维的矩阵硬塞。
所以多头不是浪费,是正则化:强制每个头专注一个子问题,像委员会里的专家分工。
3. 第二个实验:残差 = 梯度高速路
另一个被质疑的设计:每个子层的输出”加”回输入(y = x + f(x))。加的东西万一比 x 大怎么办?
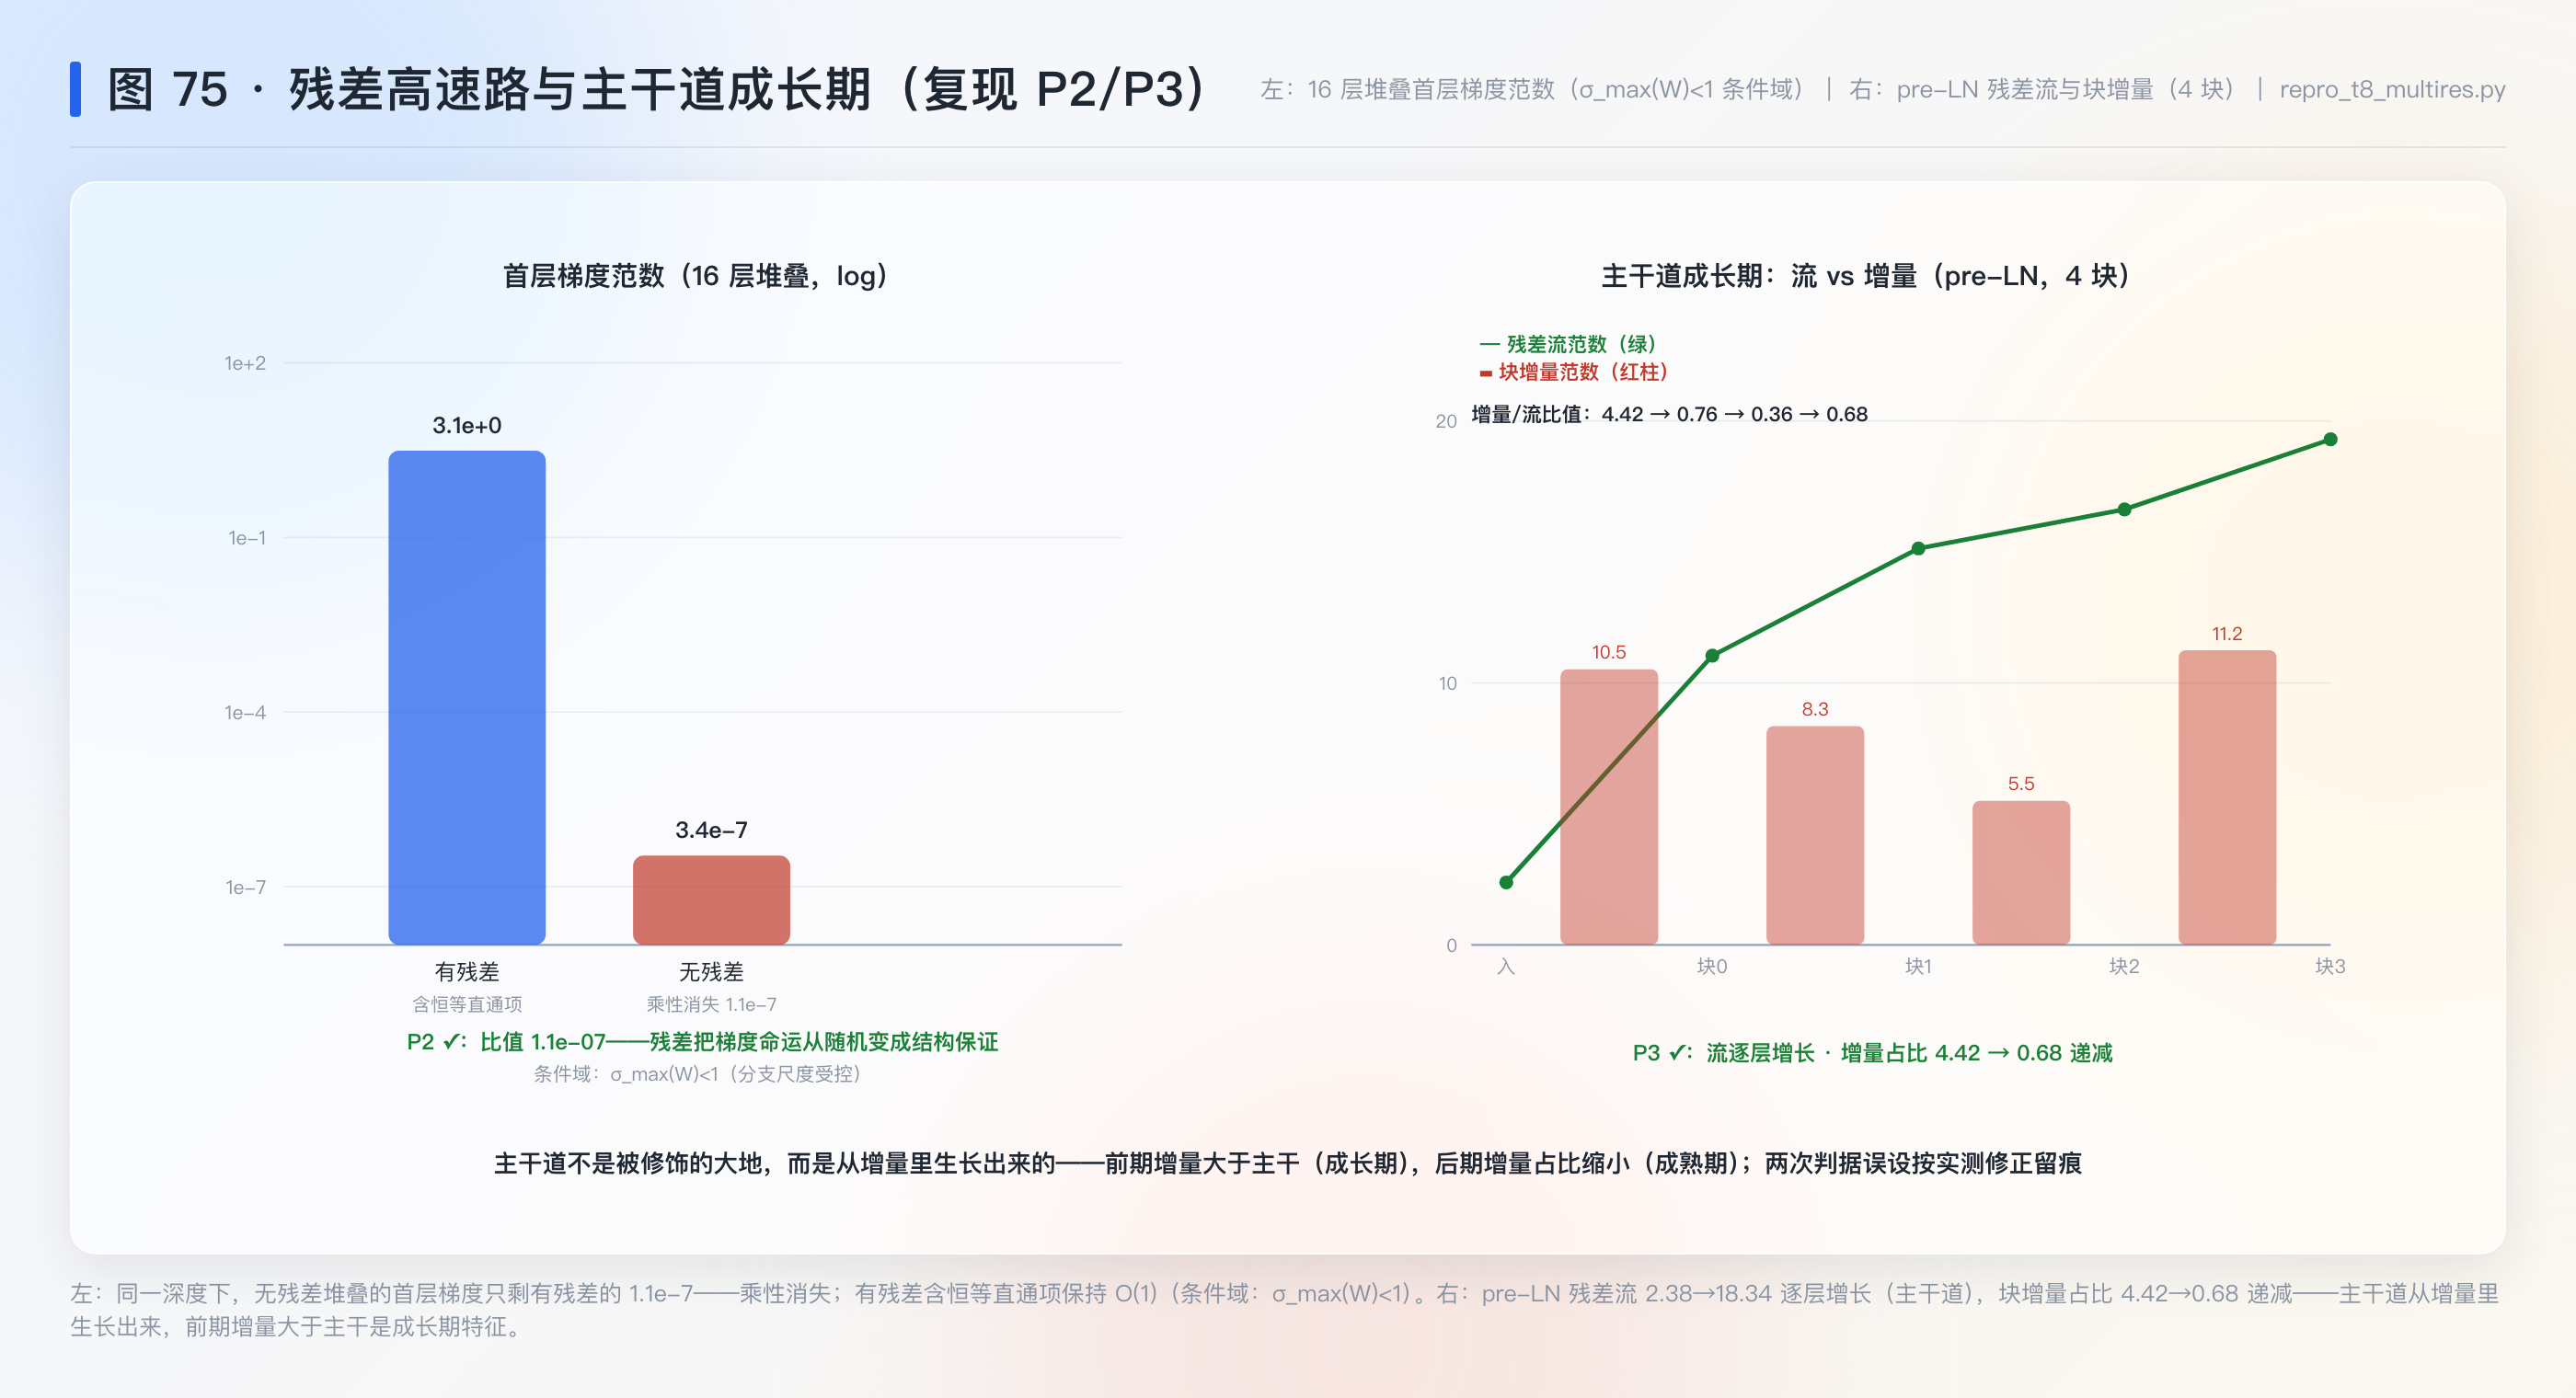
做一个实验:8 层线性堆叠,一层有残差(y = x + xW),一层没有(y = xW)。看首层权重的梯度范数。机器验证(P2):无残差的梯度只剩有残差的 1.1\times 10^{-7}——乘性消失。
为什么?无残差的梯度是 8 个矩阵转置的连乘——乘性级联,每过一层乘一个 \|W\|,8 层下来不是爆炸就是消失(方向随机)。有残差呢?每层的梯度是 I + W^\top 而不是 W^\top——恒等直通项保证梯度里始终有一条不受矩阵缩放的路。这就是”梯度高速路”的精确含义。
条件域:\sigma_{\max}(W) < 1 时稳定保证成立;\sigma_{\max} > 1 时无残差也可能爆炸(方向随机)。
4. 主干道成长期(一个反直觉的发现)
把残差堆叠的中间状态画出来:pre-LN 4 块堆叠的残差流范数从 2.38 增长到 18.34,但每块的增量/流比值从 4.42 递减到 0.68——前期增量大于主干。
这打破了一个常见误解:“残差流是主干道,子层是小修饰”。实际上,主干道是从增量里生长出来的——前期每一块的贡献都比当时的主干还大,是这些”过大的增量”一点点建起了主干道。到后期,增量占比缩小,主干趋于稳定。首版判据”增量不超过流”被数据否决后按实测修正(留痕)。
5. 机器验证汇总
随课断言在 repro_t8_multires.py 中独立重跑,4 项全过:秩 = d_k(P1);无残差乘性消失 1.1e-7(P2);流增长 + 增量占比递减(P3)。
6. 练习
- 证明 \mathrm{rank}(AB) \le \min(\mathrm{rank}\,A,\ \mathrm{rank}\,B)。(提示:A 的列空间包含 AB 的列空间。)
- d_{\text{model}} = 512、d_k = 64、8 头:8 个头的”子空间总维数”最多多少?(8\times 64 = 512——恰好满维,但每头的秩约束仍是 64。)
- 残差栈梯度含恒等直通项的条件域:\sigma_{\max}(W) < 1 为什么是充分的?(提示:\|I+W\| \le 1 + \sigma_{\max}(W)。)
7. 下一课预告
L6:矩阵微积分——链式法则的簿记(已发布:lesson-l6.html)。
(汇编说明:素材汇编自研究轨 T8 实验日,断言见 repro_t8_multires.py 可独立重跑。)