0. 你的 4 维玩具一切正常。换 64 维——机器失明。
L1 造出了打分器(内积),L2 给了它一次算完的记号(矩阵乘法)。玩具世界——4 维词向量——里一切正常:合拍分有区分度,softmax 出来的配比合理。
今天把尺寸换到真实宽度。现代模型的词向量是 64 维起步,128 维打底。你什么都不改——同样的打分函数、同样的 softmax、同样的初始化——只是把向量的长度从 4 换成 64。
然后你看结果:64 个键的注意力,79% 的权重压在一个随机选中的错键上,分布的熵只剩 0.59 nat(均匀是 4.16)。训练第 2 步发散。
你可能会猜:是不是代码写错了?
不是。代码一模一样。变的只有一件事:向量的长度。同样一个内积打分函数,4 维时工作正常,64 维时崩溃。这不可能没有任何数学上的原因。
本课的目标:找到那个原因,并且算出修复的剂量。你需要的全部工具只有一条:独立随机变量的方差可相加。
1. 先看看分数长什么样
打分函数 q\cdot k = \sum_{i=1}^{64} q_i k_i——64 项相加。每项是 q 的一个分量乘 k 的对应分量。
拿真实的 64 维随机向量算一下:分数在 ±8 的尺度上晃。4 维玩具时分数在 ±2 尺度。维度翻了 16 倍,分数翻了 4 倍。
这个”4 倍”不是随便一个数——它是 \sqrt{64} / \sqrt{4} = \sqrt{16} = 4。也就是说,分数的标准差正比于 \sqrt{d_k}。你可能会问:为什么是平方根?为什么不是 d_k 本身或者 d_k^2?
要回答”为什么是平方根”,你需要的工具只有一条:独立随机变量的方差可相加。
2. 硬币模型:方差可加律的发明
浮点数太滑,不好手算。用最粗的模型:假设 q 和 k 的每个分量都是一枚独立均匀的硬币,取 +1 或 -1,各半。
那么乘积 q_i k_i 也是一枚均匀硬币(同号 +1、异号 -1,各半)。单项的方差 = 1——它有时 +1、有时 -1,散布在 \pm 1 之间。
现在 64 枚独立硬币的乘积相加。方差怎么走?
先推可加律本身。两个独立随机变量 X 和 Y 相加,方差是什么?
\mathrm{Var}(X+Y) = \mathbb{E}[(X+Y)^2] - \mathbb{E}[X+Y]^2 = \mathrm{Var}(X) + \mathrm{Var}(Y) + 2\,\mathrm{Cov}(X,Y)
展开右边的平方:前两项和最后两项拼起来就是 \mathrm{Var}(X) + \mathrm{Var}(Y)。中间的交叉项 2(\mathbb{E}[XY] - \mathbb{E}[X]\mathbb{E}[Y]) = 2\,\mathrm{Cov}(X,Y)——这就是协方差。独立时协方差精确为零(X 的取值不影响 Y 的概率),交叉项消失。
方差逐项相加。 64 枚独立硬币的乘积求和:
\mathrm{Var}(q\cdot k) = \underbrace{1+1+\cdots+1}_{64} = 64
标准差 \sigma = \sqrt{64} = 8。分数变大不是玄学,是项数——分量方差是 1,项数是 64,和的方差就是 64。
3. \sigma = 8 意味着什么:饱和
分数在 ±8 尺度上晃。现在把这 8 个分数扔进 softmax,看它吐出什么。
softmax 里住着一个指数。指数的功能是把已有分差按幂放大:分差 1,权重比 e \approx 2.7;分差 3.2,权重比 24.5。
拿一组 \sigma = 8 量级的分数手算:(3.2, 0.1, -2.5, 0.4)。减最大值 3.2 得 (0, -3.1, -5.7, -2.8),取指数:(1, 0.045, 0.003, 0.061)。总和 1.109,除一下:(0.90, 0.041, 0.003, 0.055)。
90% 进了一个键。 机器大样本确认(P2,64 键 \times 2000 试验):不缩放时最大权重平均 0.787、熵 0.594 nat。缩放后(除 8):0.108、3.684——会议恢复。
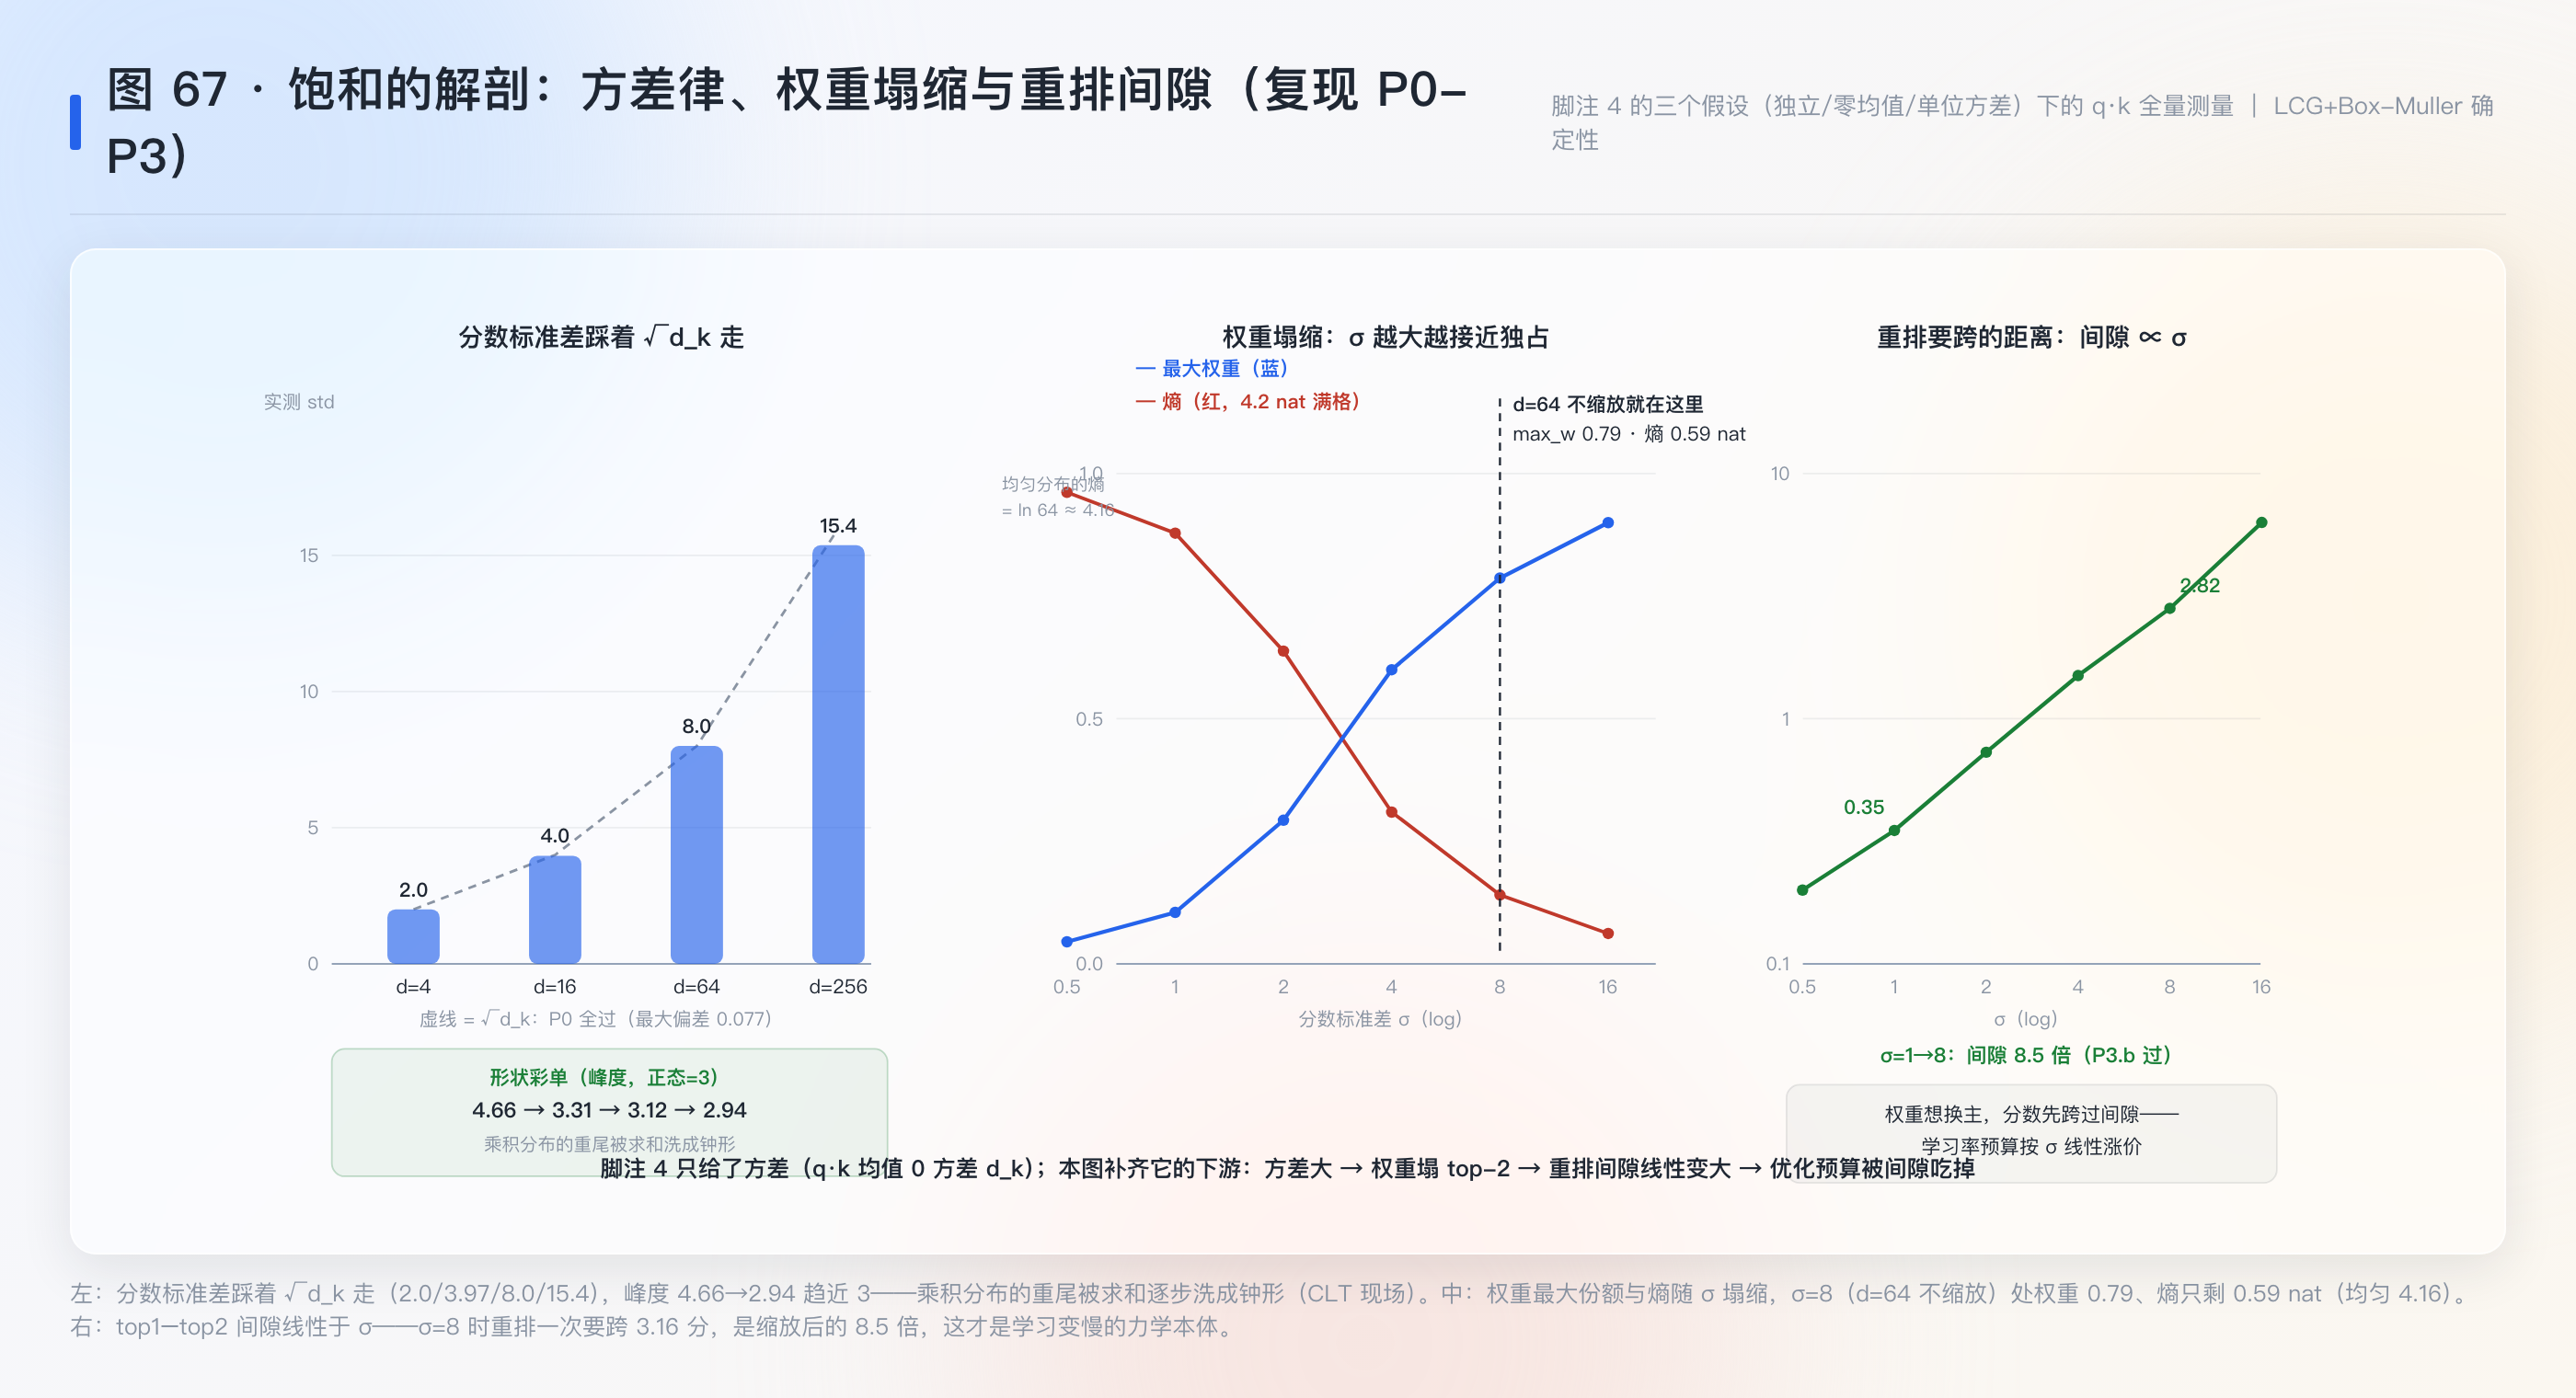
尖锐本身不是罪——训好的注意力目标格 >0.99 是好事。罪在开局:随机初始化的投影没有理由让错键夺冠,而饱和让这个错误无法被温和地纠正。
4. 拆账:到底什么”消失”了
论文脚注说”梯度极小”。拆开量。
loss 对分数的梯度有闭式 \partial L/\partial s = p - y。\sigma = 8、错目标行实测 \|p-y\| = 1.28——不但不消失,还更大(趋近 \sqrt{2})。“梯度消失”死了。
真凶是间隙:\text{top1} - \text{top2} 分差在 \sigma = 8 时是 2.95、\sigma = 1 时是 0.37——7.9 倍。优化器每步迈学习率那么大,路却在按 \sigma 变宽。
5. 补丁
除以 c,方差就除 c^2。要 \sigma 归一,就得 c = \sqrt{d_k}——唯一解。缩放后 \mathrm{max}_w 0.786 \to 0.108,熵 0.594 \to 3.684。
6. 验证
repro_t2_scaled_dotprod.py 10 断言全过。样本量 20000(P1)/2000(P2)/500(P3)。
7. 练习
- d = 2 硬币模型:列 4 种组合,验证均值 0 方差 2。
- 除以 d_k 而非 \sqrt{d_k},\sigma 变成多少?
- 分量方差是 4 时 \mathrm{Var}(q \cdot k) 变成多少?
8. 下一课
L4:旋转与正交矩阵。