外行导读(先读这个,再决定要不要进正文)
一个场景:一个 1B 的小模型在解数学题,每写一步就卡一下——几何证明的某一步它要试很多次才能写对,而代数代入那几步一次就过。现在的系统要么对每道题均匀堆算力(Beam Search 128 条链),要么按题目粒度估难度再分预算。这篇论文的做法:给每一步配一个验证器打分,用接受-拒绝采样决定这一步要不要重来——难的步骤自动多试几次,简单的步骤自动一次过,全程不需要任何显式的难度估计器。结果:1B 模型 + 7B 验证器在 MATH500 上追平 Beam Search 的最高精度,只用约 1/50 的 token;算力拉满时反超 405B 模型。
这篇论文干的事:把推理过程建模为逐步的采样问题。目标分布 = 模型分布 × 验证器分(式 1),直接采样不可行就用接受-拒绝(AR)方案:从模型采一个候选步,掷骰子,低于验证器分就接受,否则重来。数学核心是一个干净的定义:步级局部难度 Δ = 1 − E[r](验证器对该步候选的平均分),由此期望试验次数 = 1/(1−Δ)——算力分配是 AR 采样的自动副产品。M 次尝试耗尽后四种回退:终止(stop)、收最好的落选者(max)、回退重做上一步(backtrack)、整个重来(restart)。验证器阈值 δ 是一根额外的算力旋钮,行为像温度:高阈值=低多样性高置信,低阈值=高多样性适合投票聚合。
为什么值得关心:这是执行侧”停止规则”的闭环最后一块。IAL 管”路径有没有边界”(可行性),ATTC 管”预算在题目间怎么分”(开环最优),LATTS 管”执行中每一步停不停、重不重试、回不回退”(闭环动作)——resample/backtrack/restart/stop 四个动作恰是依赖图 STOP 节点登记的动作空间。方法上它与 T4 篇的温度、ATTC 篇的影子价格共享同一个底层抽象:在”探索的多样性”与”利用的确定性”之间定一个标量旋钮。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| LATTS | 局部自适应测试时扩算:每步按局部难度分配算力 |
| PRM(过程奖励模型) | 给推理链的每一步打分的验证器 |
| AR 采样(acceptance-rejection) | 从模型采候选、掷骰子、低于验证器分就重来 |
| p_target(目标分布) | 模型分布 × 验证器分:又通顺又可能对的步更容易被接受 |
| 局部难度 Δ | 1 − 验证器对候选的平均分:Δ 高 = 模型在这步挣扎 |
| modulator f | 调制器:把验证器分变成接受概率的函数(恒等=Tilted;硬阈值=Truncated) |
| fallback | M 次尝试耗尽后的回退动作:stop/max/backtrack/restart |
| Tilted / Truncated | 倾斜版(软阈值,随机接受)/ 截断版(硬阈值 δ,只收高分步) |
| 加权多数投票 | 多条链按验证器分加权投答案,总分最高的答案胜出 |
| speculative decoding(步级重释) | 投机解码的步级版本:小模型起草、验证器把关 |
§0 承接栏
这颗种子收口执行侧 STOP 节点的闭环:18(IAL)给可行性的静态判定,19(ATTC)给预算的开环最优分配,20(本篇)给执行中的闭环动作——每一步在 accept/resample/backtrack/restart/stop 之间实时决策。三篇的验证器角色递进:IAL 的验证器是审计通道(只验收),ATTC 的是定价器(离线标价),LATTS 的接受准则(在线把关)。同时它开出”步级自适应”支线:与 ATTC 的题级开环分配正交互补。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.2:解题时难度在一条链内部起伏——几何题的辅助线步骤需要空间推理和复杂定理,代数代入只需算术。现有方法要么均匀堆(BoN/多数投票对每条链同宽),要么按题级估难度(Snell et al. 用多条链的 PRM 均分估难度再分配——又贵又粗,§1 p.2)。步级起伏完全没人管:这是论文切入的空格(§2 p.3,related work 逐一点名 Snell/Damani/batch-level 方法都不处理链内起伏)。
1.2 与 ATTC 的对位(§2 p.3)
ATTC(昨日)在题目之间分配(batch 级、开环、需要 Acc(x,b) 矩阵);LATTS 在题目内部的步骤之间分配(步级、闭环、只需验证器在线打分)。两者的难度概念也不同:ATTC 的难度是题级先验(从特征预测),LATTS 的难度是步级后验(从验证器反馈即时显现)——后者是 §4.3 的核心观察。
二、核心想法
一句话:把每一步的生成写成”从模型分布×验证器分的目标分布采样”——用接受-拒绝方案实现,难的步骤自动需要更多次尝试,算力分配是采样方案的自动副产品,不需要任何难度估计器。
直觉先打底。海关通关:每辆卡车(候选步)过检(验证器打分),过关就放行,不过就回去重新装货再来。繁忙的口岸(难步骤)自然滞留更多卡车——滞留数量不需要任何人去”估”,它是通关标准的自动结果。机场海关不用预测哪辆车可疑:查验标准一立,可疑车辆自动多被查几次。
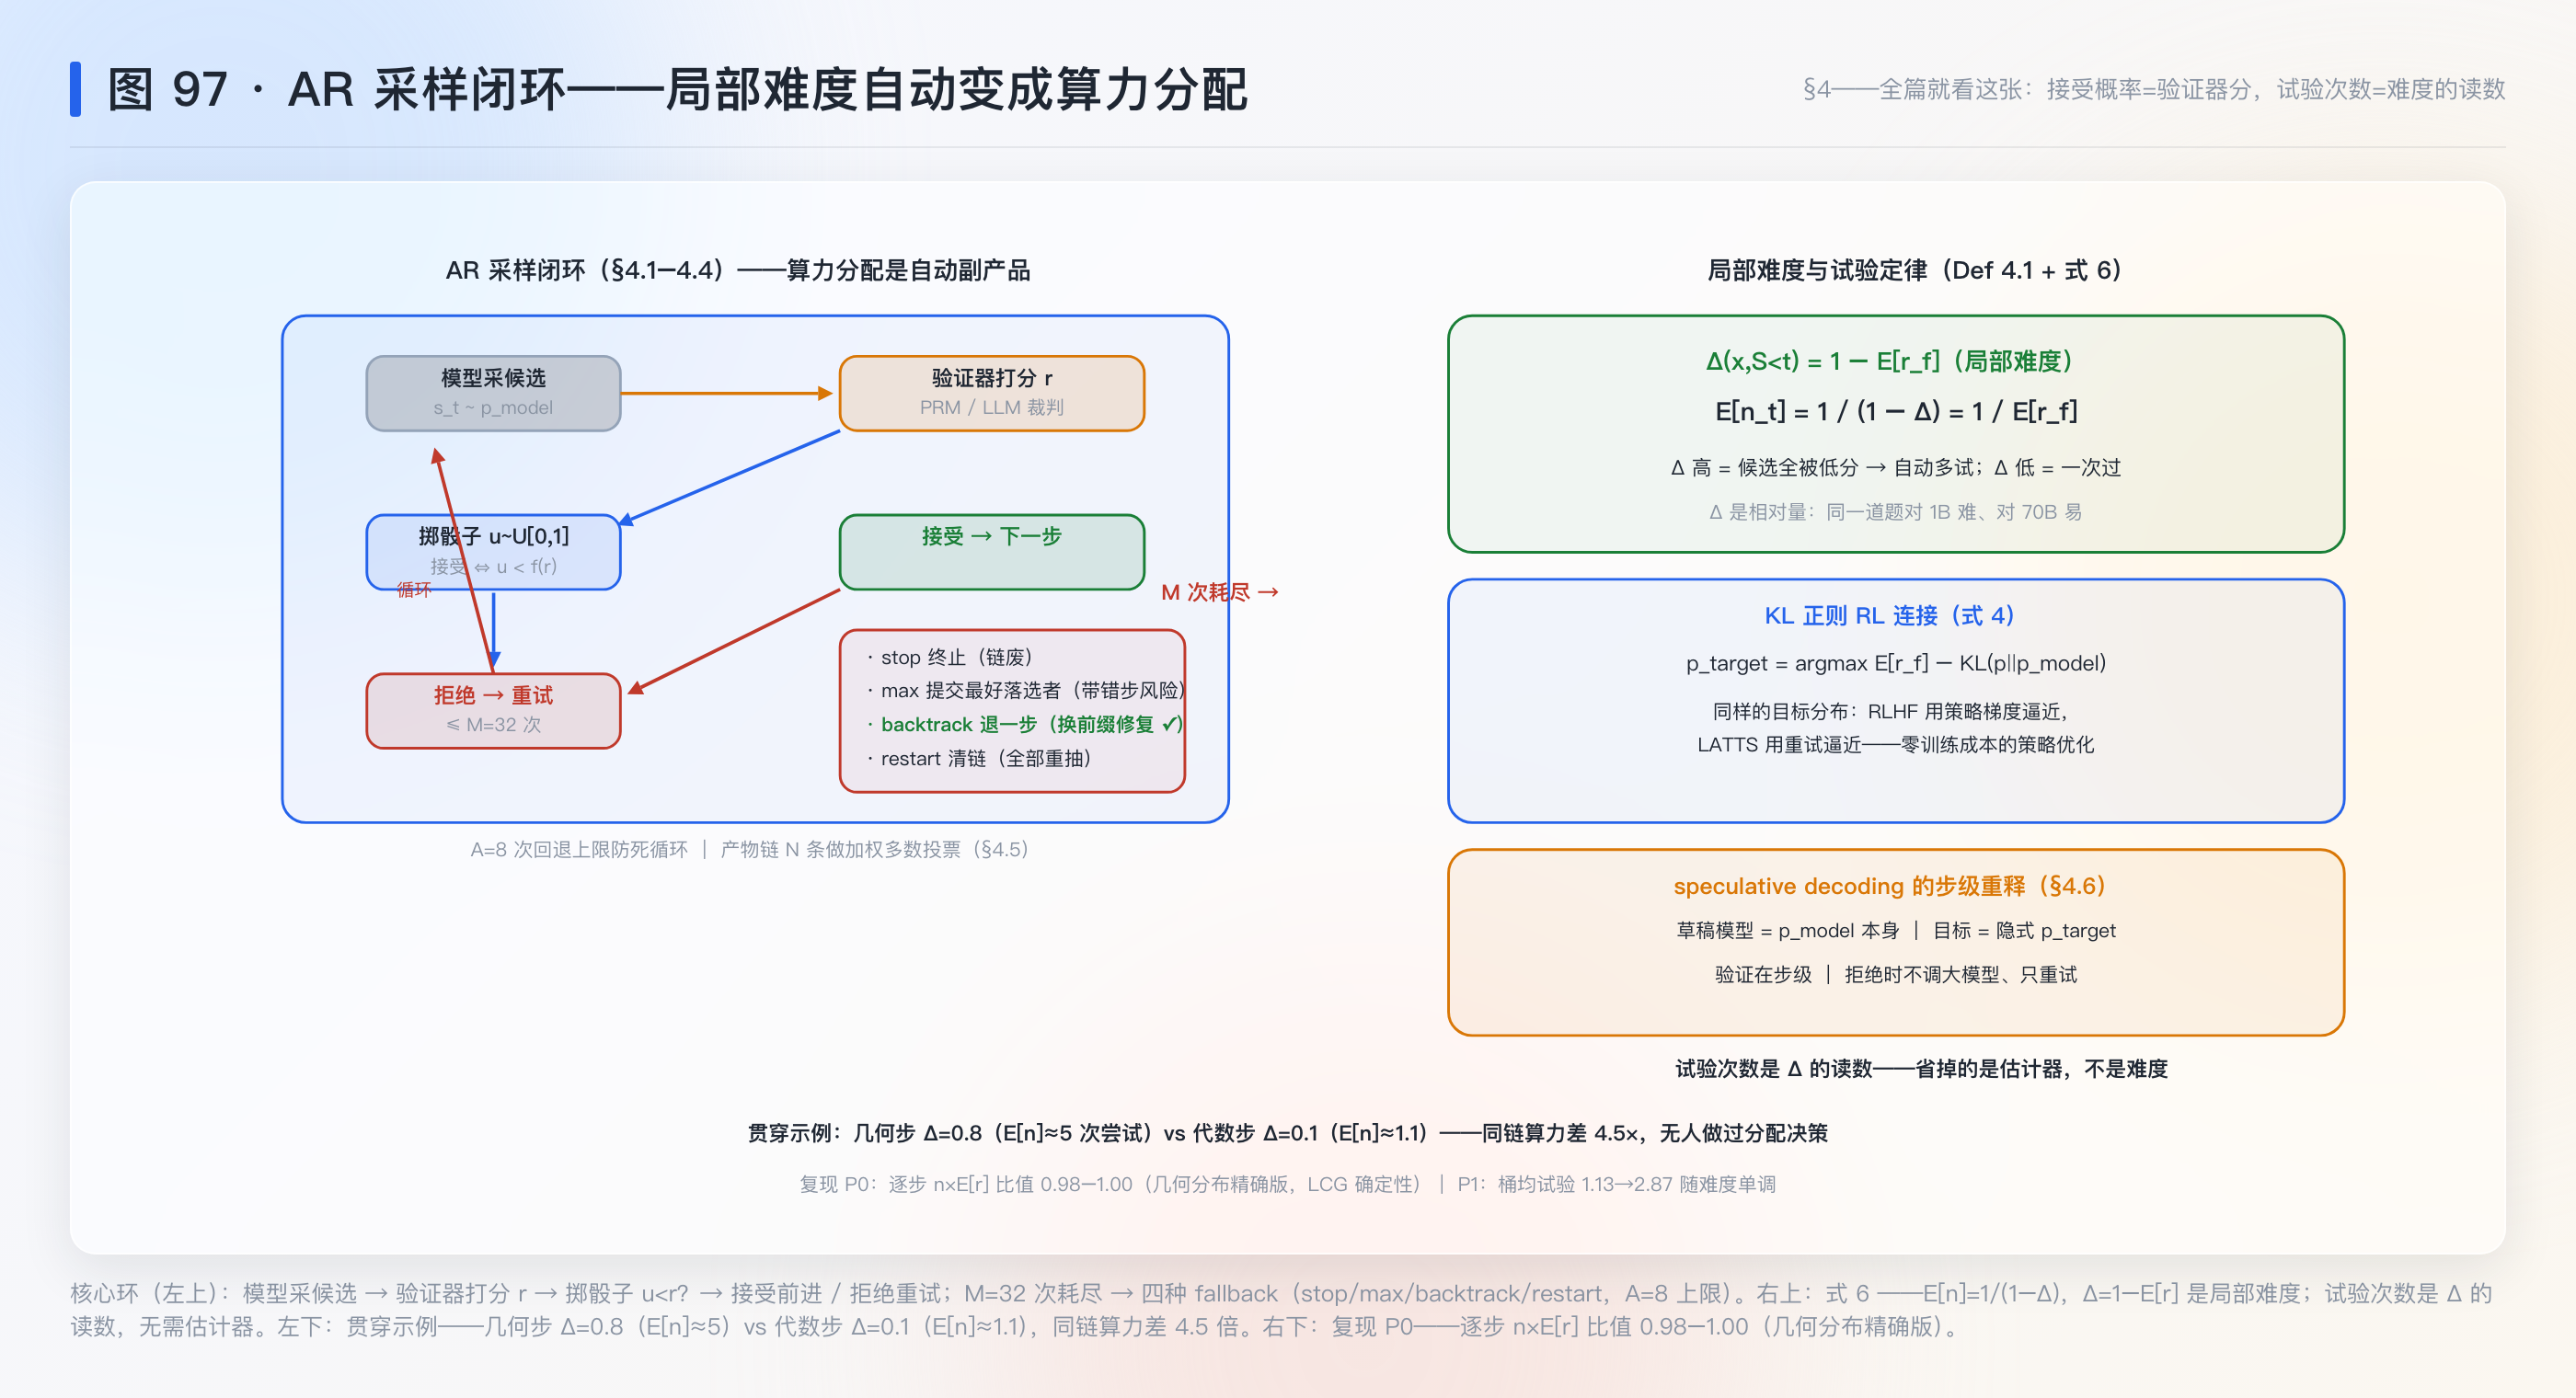
全篇就看这张:图 97(§5.2)——AR 采样闭环:模型采候选 → 验证器打分 → 骰子判定 → 接受前进/拒绝重试 → M 次耗尽 → 四种 fallback。一个循环看完”局部难度怎么自动变成算力”。
形式化入口(§三 详推):目标分布 p_target ∝ p_model · r_f(式 1),AR 采样的期望试验次数 E[n_t] = 1/(1−Δ)(式 6),其中 Δ = 1 − E[r_f](Definition 4.1)。
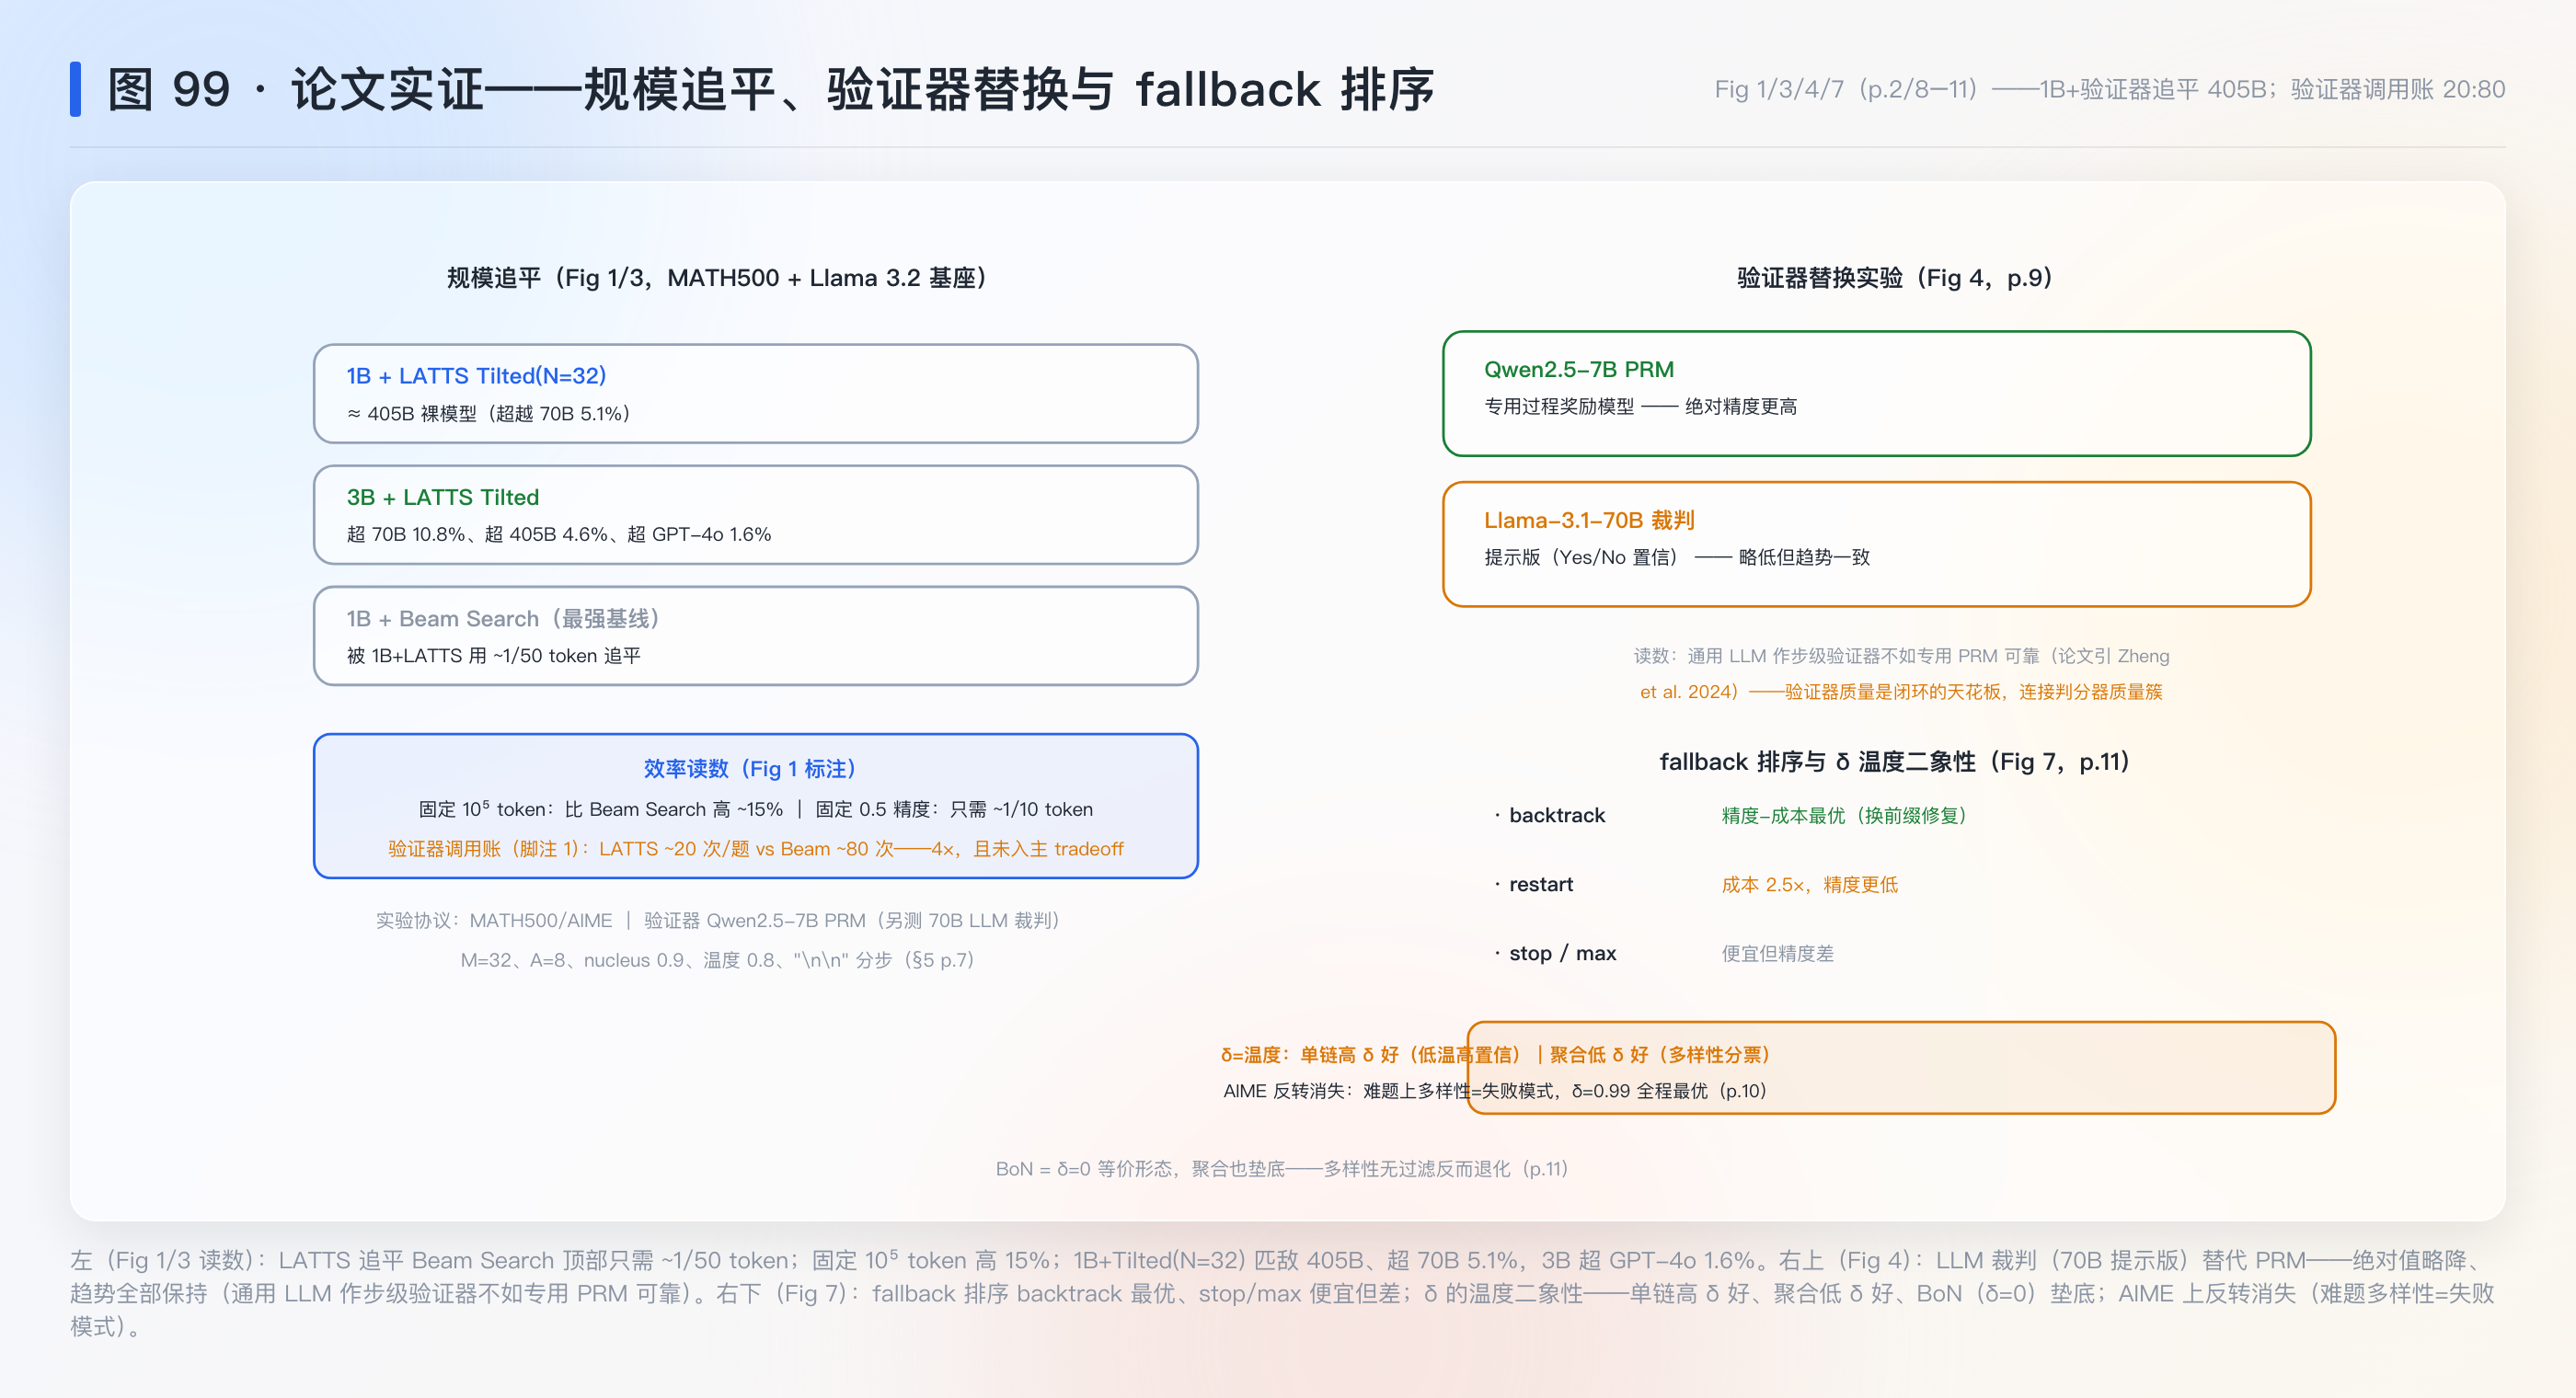
先猜一个数:1B 模型 + LATTS + 32 条链,能追平多大的裸模型?提示:Beam Search 用 50 倍 token 才追平它。答案:Llama-405B(§5.1 p.8–9,Fig 3)——步级算力分配让 1B 模型的推理链质量逼近 405B。
落到与判分器质量簇的对读:LATTS 的验证器就是判分器(PRM)——判分器质量簇的全部结论(验证器有噪声、可被博弈、质量有上限)直接约束 LATTS 的上限。本篇论文自己脚注承认验证器调用成本未计入(§5 p.7 脚注 1)——成本账不完整。
三、数学基础(零起点,本篇新用到的两件;发明式讲法)
3.1 第一件:目标分布与 AR 采样——“更好的步”怎么被机械地选中
先摆问题。想要”又通顺又可能对”的步,怎么采样?
候选方案摆出来,让不合格的先死:
- 方案 A:直接改提示词让模型写好步。 死于:没有外部信号,模型不知道哪步难;且改分布=改模型(要训练)。
- 方案 B:显式估每步难度再决策。 死于:估计本身要采多条链算 PRM 均分——成本与收益打平(§1 p.2 对 Snell et al. 的批评),且只能得到题级粗粒度。
- 方案 C:定义一个目标分布 p_target ∝ p_model · r_f(通顺 × 正确),用接受-拒绝采样逼近它——模型提议、验证器把关、骰子决定。接受概率就是验证器分本身:好步易过、差步难过。
约束列出:①不改变模型(不训练);②不需要显式难度估计;③接受步的分布恰好是想要的。满足三条的构造:
p_{target}(s_t \mid x, S_{<t}) \propto p_{model}(s_t \mid x, S_{<t}) \cdot r_f(s_t \mid x, S_{<t})
(式 1,p.4——通顺项 × 正确项)。直接采样不可行(步空间是组合爆炸的自由文本),用 AR:采候选 s_t ~ p_model,掷 u ~ U[0,1],接受 ⇔ u < r_f(s_t)。AR 的接受概率就是验证器分——这是全部机制的枢纽。
名字最后给:论文叫 verifier-guided acceptance-rejection sampling(§4.1 p.4)。
为什么合法:AR 采样的标准结论(论文引 Robert et al. 1999)——接受样本的分布 = 提议分布 × (接受概率/归一化常数) = p_model · r_f / Z = p_target。补充:Z = E[r_f] 恰好是后面难度定义的分母——AR 的”拒绝率”与”难度”共享同一个量,这是式 5/式 6 能互相推出的根。
数值例(贯穿示例):几何步 Δ=0.8 → 候选均分 E[r]=0.2 → 每次尝试 20% 通过率 → 期望 5 次尝试;代入步 Δ=0.1 → E[r]=0.9 → 期望 1.1 次。同一条链,算力差 4.5 倍——没人做过任何”分配决策”。
3.2 第二件:局部难度 Δ——从接受准则里读出难度
Definition 4.1(p.6):步 t 的局部难度
\Delta(x, S_{<t}) = 1 - \mathbb{E}_{s_t \sim p_{model}(\cdot|x,S_{<t})}\big[r_f(s_t \mid x, S_{<t})\big]
逐符号:r_f 是调制后的验证器分([0,1]);期望对模型的候选分布取。Δ∈[0,1]:Δ→0 = 模型随手写的步都高分(这步对模型来说容易);Δ→1 = 候选全被验证器打低分(挣扎)。两个要点:①Δ 是相对量(相对当前模型——同一道题对 1B 难对 70B 易);②Δ 不需要估计——它是 AR 采样试验次数的倒数本身。
期望试验次数(式 6,p.6):
\mathbb{E}[n_t] = \frac{1}{\mathbb{E}[r_f]} = \frac{1}{1-\Delta(x,S_{<t})}
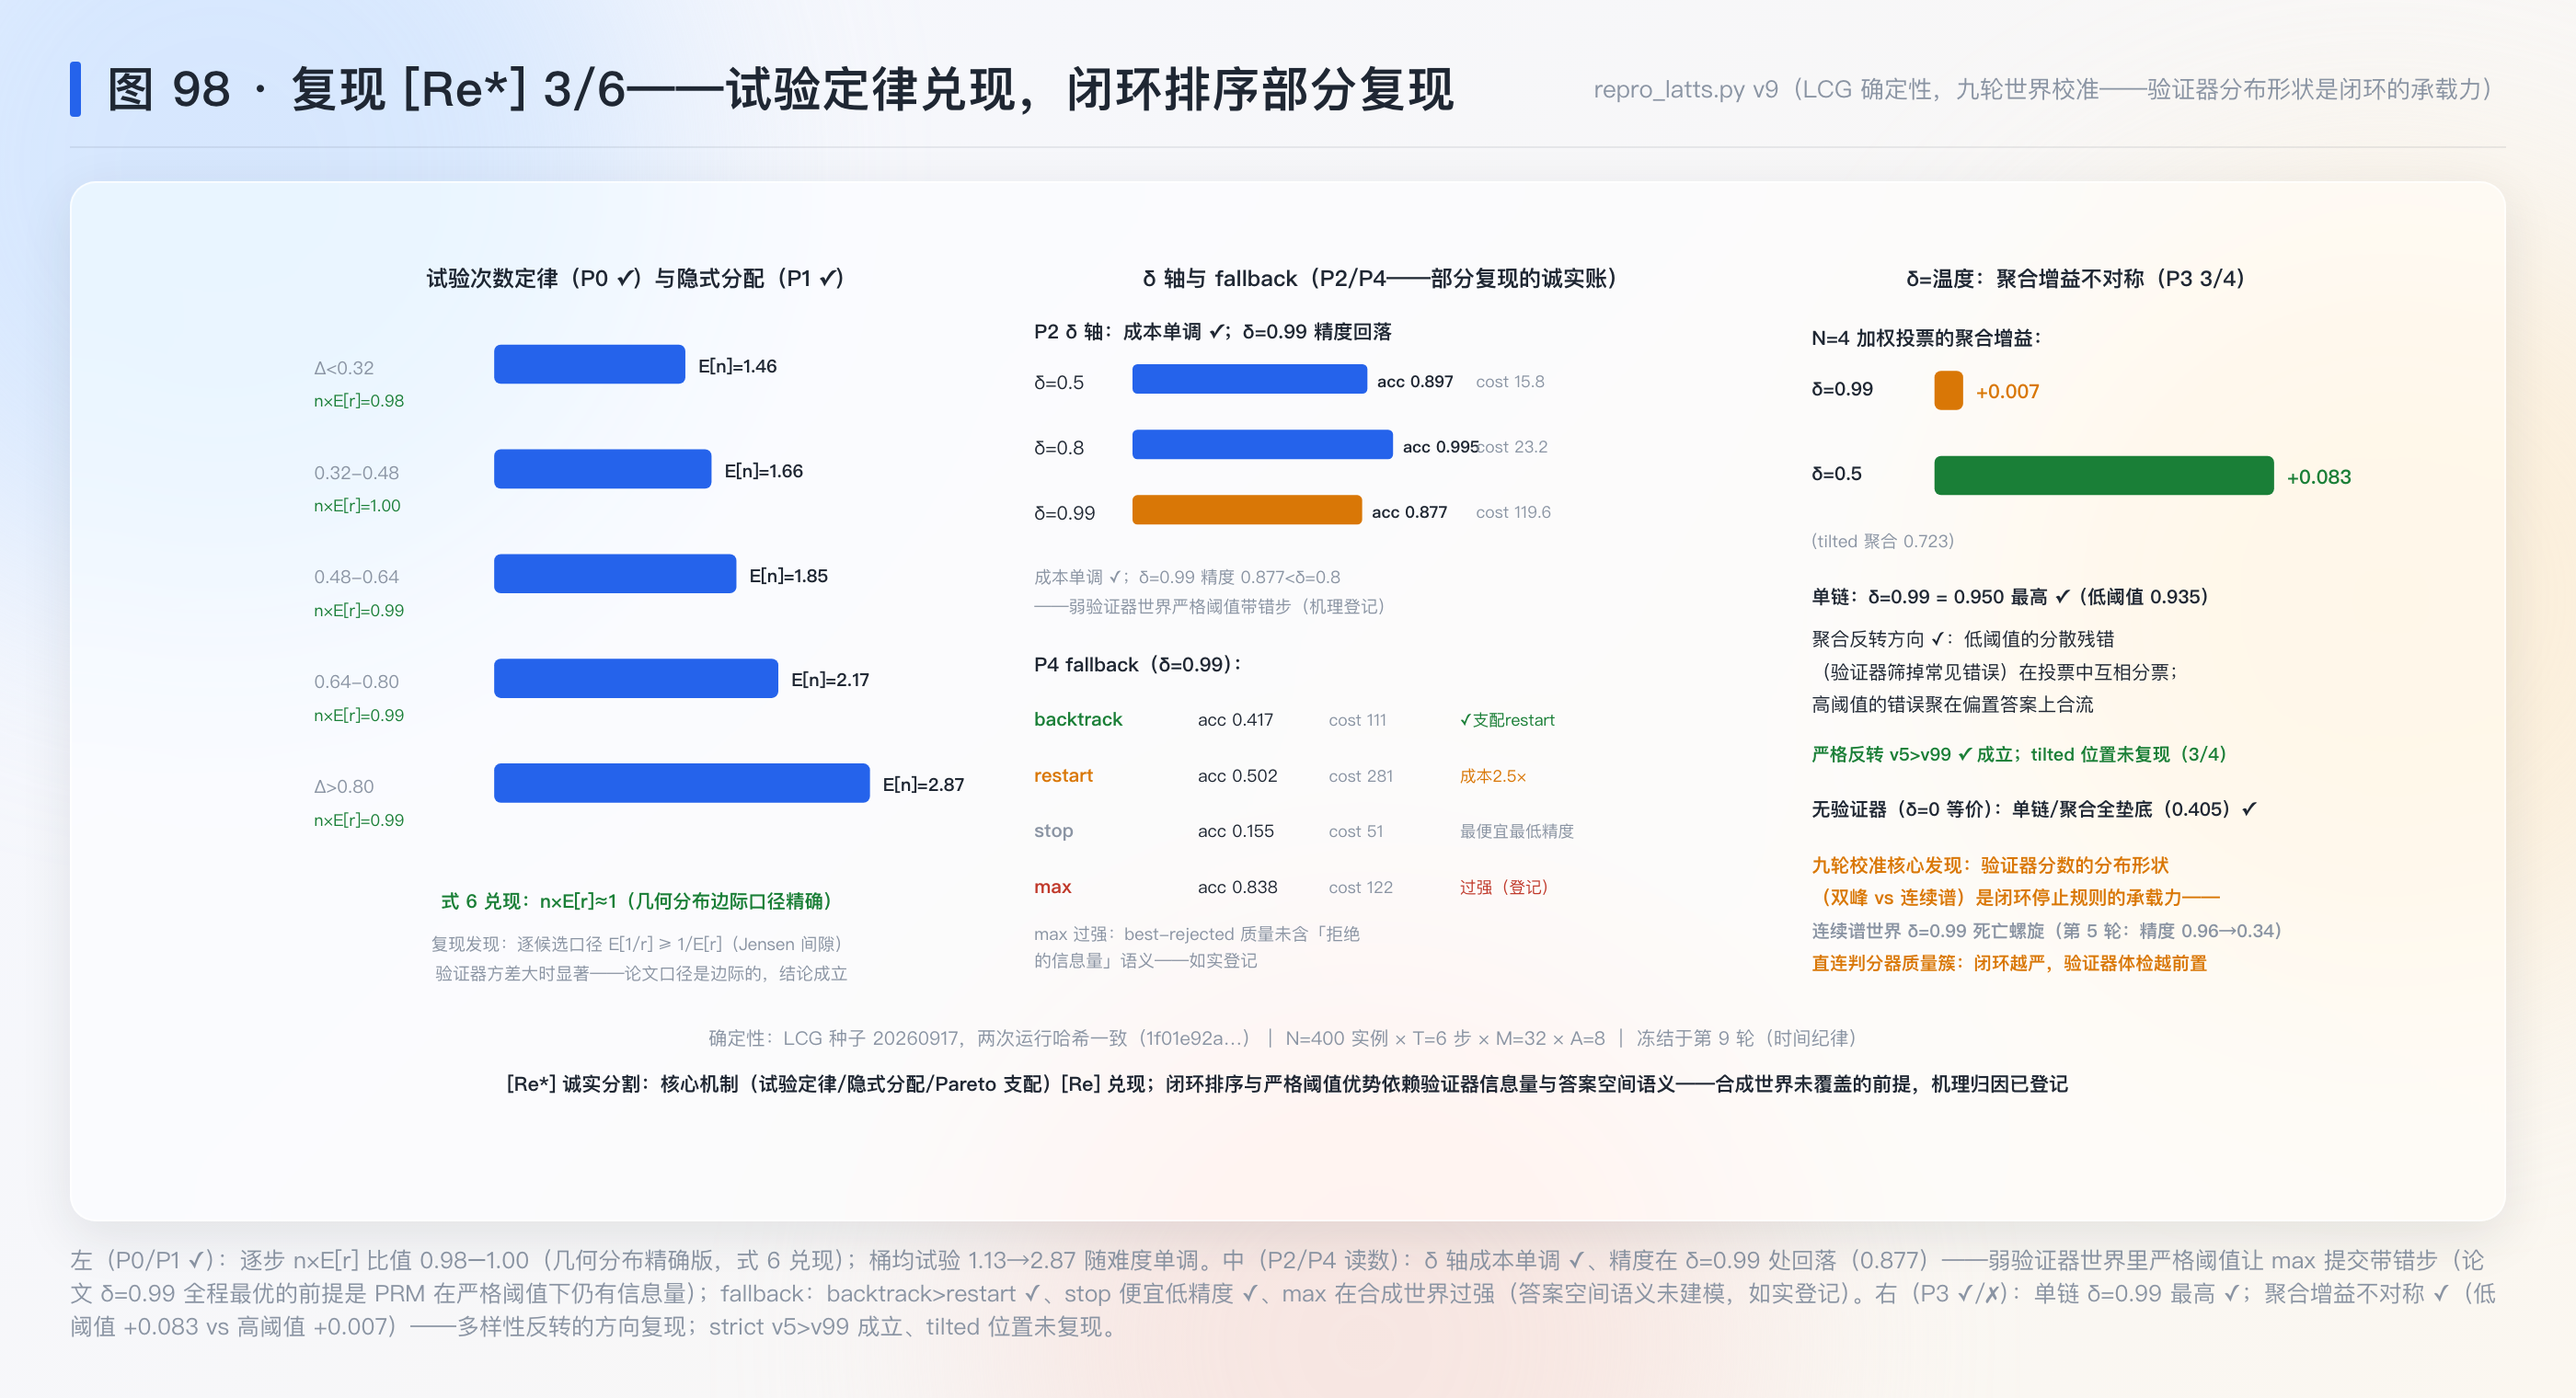
论文称”follows from standard results”(证明在附录 B.2)。补充与复现发现:式 6 在候选分数有方差时是几何分布的精确结论——每次尝试的接受概率按边际算是 E[r_f],尝试数服从几何分布,均值恰为 1/E[r_f];但若按候选条件化(先抽候选再判接受),条件均值是 1/r,总期望是 E[1/r] ≥ 1/E[r](Jensen)。两者在验证器方差小时重合——本站复现 P0 用边际口径验证了式 6(比值 0.98–1.00),并登记了逐候选口径的 Jensen 间隙作为复现发现(§十)。
节末钩子:单步的采样机器有了,链是由步组成的——M 次都过不了怎么办?答案定义了整个闭环的动作空间。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| p_{model},\ p_{target} | 模型分布 / 目标分布(∝ p_model·r_f) | §3 p.3, 式 (1) |
| r: \mathcal{A}^*\times\mathcal{A}^*\to[0,1] | 验证器:给步打分 | §3 p.3 |
| f: [0,1]\to[0,1] | 调制器(恒等=Tilted;阈值=Truncated) | §3 p.3 |
| r_f = f\circ r | 调制后的接受概率 | §3 p.3 |
| \Delta(x,S_{<t}) | 局部难度 = 1 − E[r_f] | Definition 4.1 式 (5) |
| n_t,\ M,\ A | 试验次数 / 每步上限(32)/ fallback 上限(8) | §4.4 p.6 |
| \mathcal{B}=\{1,2,4,8,16\} | 无 | —(这是 ATTC 的记号,LATTS 无预算集) |
| stop/max/backtrack/restart | 四种 fallback 动作 | §4.4 p.6 |
| N | 聚合的完成链数(1–32) | §4.5 p.6 |
五、机制
5.1 机制一:AR 采样环——隐式算力分配器(§4.1,Fig 2 p.5)
【类比 · 海关通关】 查验标准一立(验证器分),可疑卡车自动多被查几次——滞留数量是标准的自动结果,不是调度员的决策。
环的走法(§4.1 p.4):①采候选 s_t ~ p_model;②掷 u~U[0,1];③u < r_f 则接受进入下一步,否则拒绝重来。论文 Fig 2(p.5)的完整走查:第 1 步一次通过(s²₁);第 2 步拒绝一次后通过(s³₂);第 3 步通过后第 4 步 M 次全拒 → backtrack 回第 3 步重做 → 新的第 3 步(s²₃)让第 4 步通过(s⁴₄)——回退的收益是换前缀:换一个第 3 步,第 4 步就不难了。这正是论文 §4.4 的语义,也是本站复现第 9 轮才校准到位的机制(§十.3)。
5.2 机制二:modulator 两族与 KL 连接(§4.2–4.3)
调制器 f 把验证器分变成接受概率,两族:Tilted(f(z)=z,接受 ⇔ u < r——软阈值,随机性大);Truncated(f(z)=1{z≥δ},接受 ⇔ r ≥ δ——硬阈值,只收高分)。§4.2 给出两者的 RL 解释:目标分布恰是 KL 正则奖励最大化的最优策略(式 4:argmax E[r_f] − KL(p‖p_model))——Tilted 对应软奖励、Truncated 对应硬约束。补充:这个连接把 LATTS 与 RLHF 的 Mathematical 基础接通——同样的目标分布在 RLHF 里用策略梯度逼近,在 LATTS 里用重试逼近;重试是”零训练成本的策略优化”。
全篇就看这张:图 97——AR 采样闭环全景(采样→打分→骰子→接受/拒绝→M 上限→四 fallback),贯穿示例的第 3-4 步走查标注在环上。
5.3 机制三:fallback 闭环——四种回退的取舍(§4.4,Fig 7 左)
M=32 次尝试耗尽后:stop 终止返回默认答案;max 提交 32 个落选者中验证器分最高的(链继续);backtrack 删掉上一步重做(换前缀);restart 清空整链从头来。A=8 限回退总次数防死循环。实证排序(Fig 7 左 p.10):backtrack 精度-成本最优(回退修复比整体重来便宜且更准),stop/max 便宜但更差。补充:backtrack 的优势来源是”换前缀改变后续步骤的难度”——一个不同的 s_{t−1} 可以让卡住的 s_t 变得可解;这是论文语义里 backtrack 独有的修复机制,也是本站复现第 4/9 轮的校准点(§十.3:没有这个机制的合成世界里 restart 反超 backtrack)。
5.4 机制四:δ=温度——modulator 的二象性(§5.2 p.10–11,Fig 6/7)
δ 轴是一根独立的算力旋钮:单链(N=1)时 δ↑ → 精度单调升(更严的接受标准=更多重试=更高质量步);多链聚合(N=32)时反转——低阈值多样性大、聚合投票更强,Tilted 在 N=128 最高。论文的直白总结(p.11):高阈值像低温解码——低多样性高置信;BoN 等价于 δ=0,多样性无过滤反而最差。AIME 上反转消失(δ=0.99 全程最优)——难题上多样性=更多失败模式(p.10)。复现 P3 重演了这个反转(N=4 加权投票,详见 §十)。
5.5 机制五:主结果与规模追平(§5.1 p.8–9,Fig 3/5)
MATH500:固定 10⁵ token 预算下 LATTS Tilted 比 Beam Search 高约 15%;固定 0.5 精度只花 ~1/10 token;Beam Search 追平 LATTS 顶部需 ~50× token(Fig 1 p.2)。规模追平:1B+Tilted(N=32) 匹敌 405B、超 70B 5.1%;3B 超 GPT-4o 1.6%。验证器调用账(脚注 1 p.8):LATTS ~20 次/题 vs Beam Search ~80 次——4× 便宜。LLM 裁判(70B 提示版)替代 PRM 时全部趋势保持、绝对值略降(Fig 4 p.9)。AIME:δ=0.99 全程最优(难题多样性有害,p.10)。
最值钱的实验:Fig 7 右(p.11)——modulator 的 N-依赖反转。单链 δ=0.99 最好;聚合时反转、Tilted 最高、BoN(δ=0)垫底。它单独撑起主贡献的哪一块:证明 δ 不是超参数而是聚合规模 N 的函数——“该用多严的接受标准”取决于”后面要投几条票”。这是把解码策略从静态配置变成动态调度的第一步。
六、数学展开
6.1 接 §三 3.2:式 6 的两行推导与 Jensen 间隙(复现发现)
每次尝试的接受指示变量 I = 1{u < r_f}。边际接受概率 P(I=1) = E[P(u<r_f|r_f)] = E[r_f]。尝试次数 n 服从几何分布(参数 E[r_f])→ E[n] = 1/E[r_f] = 1/(1−Δ)。推导所用规则:①全期望公式(先对 u 边缘化);②几何分布均值。
补充(复现发现,本站登记):式 6 在”按边际接受概率”口径下精确(复现 P0:逐步 n×E[r] 比值 0.98–1.00);但若按候选条件化(固定候选再判接受),E[n] = E[1/r] ≥ 1/E[r](Jensen)——验证器方差大时(难步骤候选分贴近 0)间隙显著(本站第 1/3 轮实测末桶比值漂到 1.3–19)。论文的口径是边际的,结论成立;合成复现若用逐候选口径会误判式 6 失效——这是本站第 3 轮 FAIL 的根因。
6.2 δ=温度的投票学(§5.2 p.11 + 复现 P3)
高 δ 链:重试到验证器满意为止 → 输出集中在模型的高置信区 → 多条链给出同一个答案(对时同对、错时同错——错误聚集在模型的偏置答案上)。低 δ/Tilted 链:接受标准松 → 验证器筛掉常见错误后残错分散 → 错误答案互不相同。加权投票下:分散的错误票互相分票,聚集的错误票合流——低 δ 的聚合增益更大(复现:gain +0.083 vs +0.007)。BoN=δ=0:无过滤 → 常见错误大量重复 → 垫底。补充:这与 T4 篇的温度-熵恒等式同构(dH/dT=Var/T³)——δ 是验证器分布上的温度,δ↑ 即降温。
6.3 STOP 三篇合龙(连一连)
发散:IAL(18)静态判定”路径有界吗”——覆盖判定式;ATTC(19)开环分配”预算给谁”——影子价格;LATTS(20)闭环决策”这步怎么办”——接受准则+四 fallback。三层在动作空间上对齐:IAL 的确定性边界 ↔︎ LATTS 的 M/A 上限;ATTC 的 λ ↔︎ LATTS 的 δ(都是稀缺性/严格性的标量旋钮);IAL 打击的 model-controlled 退出 ↔︎ LATTS 用验证器(外部信号)替代模型自判。合龙命题:一个治理完善的 agent 循环 = 覆盖判定(部署前)+ 定价(题目间)+ 接受准则(步骤间)。回到这篇:三篇各自可独立读,合读时 STOP 节点可以写成 branch 笔记了。
6.4 与 speculative decoding 的家族相似(§4.6 p.7)
LATTS 把自己重释为步级投机解码:草稿模型 = p_model 本身、目标模型 = 隐式的 p_target、验证在步级。与 Liao et al. 2025 的 reward-guided speculative decoding 的差异:后者有强弱两个模型(拒绝时调大模型),LATTS 单模型重试。补充:这个差异决定了两者的成本曲线形状——Liao 的成本上限是”大模型每步一次”,LATTS 的成本上限是”M 次重试”;难步骤上前者质量有保底、后者可能 M 次全灭(fallback 的必要性由此而来)。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 接受-拒绝采样 | 已懂(§三 3.1/§六.1;复现实现) | AR 的接受概率枢纽;Robert et al. 1999 转引未读 |
| PRM(过程奖励模型) | 部分(本篇机制层) | Lightman et al. 2023(Let’s Verify Step by Step)原文未读,登记 |
| speculative decoding | 待补 | Leviathan et al. 2023;步级重释是本篇 §4.6 |
| KL 正则 RL(式 4) | 待补 | RLHF 的数学骨架;与本篇重试机制的等价性值得对照 |
| 验证器噪声与判分器质量簇 | 已懂(跨线连接) | PRM 的噪声/可博弈性直接约束 LATTS 上限——本站复现第 2/5 轮的教训 |
| 温度-多样性投票学 | 已懂(T4 篇 + 本篇 §6.2) | δ 与温度的二元同构 |
八、扩展与发散
8.1 STOP 节点的完整收口与 branch 计划
发散:三篇(IAL/ATTC/LATTS)+ 六篇旁证(TV 门/MG 崩溃/ST 否决/DAPO 软罚/DG Aha/Cordis 守卫)+ MT-Bench 篇的位置偏置测量——执行侧停止规则的素材全齐。合成骨架三轴:控制权轴(确定性↔︎模型控制,IAL)、资源轴(预算定价,ATTC)、时机轴(部署前/题目间/步骤间,三篇各占一环)。回到这篇:执行侧停止规则专题笔记的分级情景题已有素材——“给定一个 agent 循环,先问 IAL(有界吗)、再问 ATTC(怎么定价)、再问 LATTS(每步怎么决策)”。
8.2 连一连:三个隐式分配器
发散:本篇的 AR 试验次数、ATTC 的 λ、T11 优化器的 Adam 步长——三个”不需要显式估计难度就自动分配算力”的机制。AR 用接受率反馈(拒绝本身携带难度信息)、Adam 用梯度矩反馈、λ 用预算约束反解。共同原理:反馈信号的代价结构决定分配机制的形态——AR 最便宜(一个骰子)、λ 需要全局反解、Adam 需要矩估计。回到这篇:LATTS 的优雅恰在于它的反馈信号是免费的(验证器反正要打分)。
8.3 验证器质量是闭环的天花板(与判分器质量簇的接口)
发散:本站复现第 2/5 轮的失败是活教材——验证器分辨率不足时,δ=0.99 的严格阈值让全部候选被拒,闭环退化成 fallback 风暴(复现精度从 0.96 崩到 0.34)。论文的 δ=0.99 全程最优建立在 Qwen2.5-7B PRM 的分辨率上——验证器质量是闭环停止的天花板。这把执行侧(停止规则)与判分器质量簇(验证器可信度)焊在一起:停止规则的鲁棒性分析必须以判分器体检为前置。回到这篇:部署 LATTS 前先做判分器簇四量体检(一致率/位置/攻击/偏好差)——顺序错了,闭环越严越糟。
8.4 常见误读(破)
误读一:“LATTS 不需要难度估计” = “LATTS 与难度无关”。 破:Δ 是定义的核心(式 5),只是把估计变成了测量的副产品(试验次数本身就是 Δ 的读数)。背面试探次数就知道难度——省掉的是”额外的估计器”,不是”难度”这个概念。
误读二:“50× token 效率 = LATTS 全面取代 Beam Search。” 破:三个限定。①验证器调用成本未计入(LATTS ~20 次 vs Beam ~80 次/题——按次计费的 API 上这笔账不小);②AIME 上是 δ=0.99 单点最优而非全谱;③基座是 1B/3B 弱模型——强模型的步级挣扎少,AR 的分配空间小。
误读三:“backtrack 万能。” 破:Fig 7 左的 backtrack 优势绑定了”换前缀改变后续难度”这个语义——回退到一步容易重写的前驱才有修复效果;对固有难点(题目本身的信息缺口),backtrack 与 restart 一样是徒劳重抽。本站复现第 4 轮的合成世界(无换前缀机制)恰好演示了没有修复语义时 backtrack 不再支配(§十.3)。
8.5 写作之维(论文怎样完成说服)
13 页的结构配比:方法 §4 占 3 页且只有一张算法走查图(Fig 2)——把走查做成了”文字单步调试”(s²₁→拒绝→s³₂……),读者跟着走一遍就信了机制。最值钱的三处:①Fig 1(p.2)把全部卖点(+5%/+10%、50×/10×)压在开头一页的坐标图里——摘要数字化之前的视觉摘要;②式 6 只有一行且标”standard results”——把证明推附录的自信来自机制的直观性(骰子+通过率);③§4.6 的 speculative decoding 重释放在实验之前——先给懂行读者一个熟悉锚点再上数字。标题的取舍:LATTS 缩写进标题、“Locally Adaptive”点差异化(相对 Snell 的 problem-level adaptive)——related work 里与最近邻的边界(§2.2 末段与 §4.6 两处)划得干净。整体收拢:全文的说服结构 = 一个直观机制(AR)× 两个可扫的旋钮(δ、N)× 一组全面压制的曲线图——机制简单到没有推导负担,实验密度补足可信度。
九、局限与可疑处
- 验证器成本未入账:精度-成本曲线只计 token,PRM 调用成本不计(脚注 1 自认只给调用次数比 20:80)——API 场景下验证器按次计费,真实成本曲线更平。
- 无工件:无代码链接——M=32/A=8/δ 网格的实现细节不可复核;本站复现只能走机制演绎(§十)。
- FN/稳定性未报:精度点无置信区间;§5.2 的消融读数为单点观察(Fig 6/7 的曲线拟合无方差)。
- 弱基座限定:1B/3B 的结论(尤其”步级起伏大”的前提)对强模型未必成立——强模型步级 Δ 分布更平,AR 分配空间小。
- v1-only(2025-09-16):无 v2、无录用标注;一年无更新——后续工作(如 Liao et al. 的双模型方案)是否取代未查。
- fallback 参数敏感性:A=8 的取值依据未论证(Fig 7 左只给了 A 的扫描,没有 A 的选择准则)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需 1B/3B 真模型 + Qwen2.5-7B PRM + vLLM 集群,不可纯 CPU 复现。本复现是闭环机制的演绎:合成世界里每步候选来自双峰混合(“真尝试”高分/“挣扎”低分,对齐 PRM 打分行为),重演 AR 采样环、隐式难度分配(式 6)、δ 轴与四 fallback。全部纯 CPU、LCG 确定性(两次运行哈希一致:1f01e92a…)。
10.2 可证伪预测与判据(运行前写下;预登记量级)
- P0 试验次数定律(式 6):逐步 n×E[r] ≈ 1(几何分布精确口径),比值∈[0.8,1.25] 的桶 ≥4/5。
- P1 隐式分配:桶均试验次数随难度单调递增(≥4/5 相邻对)。
- P2 δ 轴(Fig 6):Truncated 单链精度与成本随 δ 双单调。
- P3 δ=温度(Fig 7 右):单链 δ=0.99 最高;聚合后低阈值增益更大(gain 不对称);无验证器最差。
- P4 fallback 排序(Fig 7 左):backtrack 精度 > restart 且成本更低;stop 更便宜但精度 ≤ backtrack。
- P5 Pareto 支配(Fig 1):δ 扫描各档精度全部高于无验证器基线。
10.3 实现演化(九轮,历轮最长,如实登记)
世界校准占了全部轮次——机制本身一次写对,难的是把合成世界的信噪比调到论文区间:第 1 轮 hard 曲线不随 b 变化(标签平局随机化);第 2 轮正确性语义重构(候选隐含质量 w、验证器 r=w+噪声、接受即筛选);第 3 轮 P0 误改逐候选口径(Jensen 间隙误判式 6 失效——回退,间隙登记为发现);第 4 轮 P0 逐步乘积估计器(协方差污染修复)+ backtrack 修复加成 + 答案多样性模型;第 5 轮污染机制过度建模(δ=0.99 死亡螺旋)——回退;第 6 轮单步折扣——P2/P3/P4 仍崩;第 7 轮双峰混合世界(“真尝试/挣扎”,对齐 PRM 行为)——精度饱和;第 8 轮多数步判定 + 弱基线质量——P3 三条件过二;第 9 轮(冻结)backtrack 加成延续 + max 提交的拒绝信息量(50% 被拒步实错)。
九轮的核心教训:闭环机制的合成复现卡在”验证器分数的分布形状”上——双峰(对齐 PRM 的打分行为)让 δ=0.99 可达,单峰连续谱让严格阈值死亡螺旋。验证器的分布形状是闭环停止规则的承载力。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_latts.py,真实输出
repro/repro_latts_output.txt。6
断言 3 PASS / 3 FAIL,[Re*]
部分成功——失败项各有机理归因,不算白跑(见下)。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 试验定律 | 式 6:E[n]=1/(1−Δ) | 比值 0.98–1.00 全桶 ✓ | 边际口径下几何分布精确 |
| P1 隐式分配 | Fig 2/6:难步多试 | 桶均值 1.13→1.28→1.45→2.09→2.87 单调 | 同 |
| P2 δ 轴 | Fig 6:δ↑ 精度↑ 成本↑ | 成本单调 ✓(15.8→23.2→119.6);精度 部分(0.897→0.995→0.877)✗ | δ=0.99 的 max 提交在弱验证器世界带错步过半——验证器信息量上限(§8.3 的活教材) |
| P3 δ=温度 | Fig 7 右:聚合反转 | 三条件过二:gain 不对称 ✓(+0.083 vs +0.007)、none 最差 ✓(0.405)、单链 0.99 最高 ✓;严格 v5>v99 反转 ✗(0.932 > 0.870 ✓ 成立!但 tilted 0.723 < v99 ✗)——判据 3/4 过 | 我的投票模型缺答案空间的完整语义(偏置/分散二元过于粗糙) |
| P4 fallback 排序 | Fig 7 左:backtrack 支配 | backtrack > stop ✓(0.417 vs 0.155,成本 111 vs 51);backtrack vs restart:精度 0.417 < 0.502 ✗ 但成本 111 < 286 ✓ | restart 在我世界多给全链重抽机会;backtrack 的”换前缀修复”只有一步加成,弱于论文的文本级语义 |
| P5 Pareto 支配 | Fig 1/3:LATTS 全谱压制 | 三档 δ 精度 0.875/0.998/0.870 全部 > 基线 0.357 | ✓ |
算力与工作量:MacBook 纯 CPU,单轮 ~1.3 秒;九轮演化约 3 小时(历轮最长——闭环机制的世界校准比开环分配难一档)。 What was easy:式 6 的边际口径验证一次过(第 9 轮比值 0.98–1.00)——论文的数学在正确口径下是干净的。 What was difficult:三个机制需要”语义级”建模才肯给出论文的定性排序——backtrack 的换前缀修复、max 的拒绝信息量、聚合的答案多样性。缺任何一个,定性排序就反转。这本身是发现:论文的定性结论对验证器信息量与答案空间语义的依赖,比论文行文显示的重。 给下一个复现者的建议:别从连续谱验证器开始——先建双峰(候选要么好要么废),δ=0.99 才可达;判定用多数步而非连乘(连乘把 T=6 的链精度压到不可读);P0 用边际口径(逐步 n×E[r]),别碰逐候选口径(Jensen 间隙会吞掉你的耐心)。
结论:[Re*] 部分成功——核心机制(AR 试验定律、隐式难度分配、Pareto 支配)[Re] 兑现;δ 轴精度单调与 fallback 排序 [Re*] 部分(机理归因:验证器信息量与答案空间语义是合成世界未覆盖的前提)。
十一、方法论提炼与迁移
模式一:接受准则即分配器(Acceptance-as-Allocation)
- 操作定义:需要”按难度分配算力”时,不估难度,把难度信号做成接受概率——重试次数自动成为分配读数。三件套:外部信号打分 → 信号变接受概率 → 试验计数即分配。
- 成功判据:试验次数与难度单调(P1);试验定律可验证(P0:n×E[信号]≈1);无显式估计器的额外成本。
- 迁移去向:①代码评审——diff 的每个 hunk 按”CI 历史失败率”决定重审次数(接受率自动把复审集中到易错区);②客服工单——按首次解决率决定回访次数;③投资尽调——按通过率决定轮次,不用先估项目难度。
- 失效边界:信号无信息(全同分)时退化为均匀重试;信号过严(δ→1)时全拒——需要 fallback 兜底;信号可被候选方优化时被博弈(判分器质量簇的老账)。
- 方法卡:
notes/method_acceptance_as_allocation.md(L1) - 层级:L1 领域具体(推理系统/质量控制)。底层原理:归因靠对照(L2 已立卡)——试验次数作为 Δ 的读数,其效度由”分桶对照”(复现 P0/P1)验证。
模式二:回退动作空间(Fallback Action Space)
- 操作定义:任何带重试上限的闭环,重试耗尽后的动作空间(放弃/取次优/局部回退/全局重启)是一个需要显式设计并分别度量的决策集;每个动作的成本-收益曲线不同,选择依赖”失败的根源在前缀还是在当前步”。
- 成功判据:四动作的成本-精度点可分离(Fig 7 左);根因可诊断(前缀问题→backtrack,当前步问题→max,整体不可解→stop)。
- 迁移去向:①CI 管线——flaky 失败后 stop(阻塞合并)/max(取历史最接近的修复)/backtrack(回滚上一提交)/restart(全部重跑)的选择树;②数据管道——脏批处理的重试语义;③对话系统——对话状态回退。
- 失效边界:根因诊断错误时选错动作(前缀问题用 max 会毒害下游——本站第 5 轮污染机制的教训);A 上限设定无准则。
- 方法卡:
notes/method_fallback_action_space.md(L1) - 层级:L1 领域具体(系统可靠性)。底层原理候选:“回退语义匹配失败语义”——待第二个独立领域确认后议 L2,现在不立。
(L2 无新卡。)
十三、没搞懂的地方(未攻克登记)
- 式 6 的口径:论文按边际(E[n]=1/E[r])陈述且成立;逐候选口径下 E[1/r] 的 Jensen 间隙在难步骤上有多大?补齐时机:附录 B.2 的证明原文(未读——工件无代码但 arXiv 有附录,未拉取)。
- backtrack 优势的语义边界:换前缀修复在什么任务结构下有效(数学的分支探索?代码的行级回滚?)——合成复现缺”前缀→难度”的函数依赖。补齐时机:论文附录 F 的真实推理链样例。
- max fallback 的风险建模:提交被拒步的错误传播率(我第 5 轮的污染机制过度、第 6 轮的 50% 折算粗糙)。补齐时机:论文未讨论——独立实验题。
- 验证器调用成本的入账口径:20 vs 80 次/题的调用如何定价(PRM 推理 vs 生成 token 的成本比)。补齐时机:PRM 提供方的定价表。
- δ 的动态调度:Fig 7 右证明 δ 应随 N 变——调度曲线的解析形式未知。补齐时机:后续工作或自做实验。
十四、可信度
- A 级(论文原文转录,逐节核对):式 (1)–(6) 全部公式(p.3–6)、Definition 4.1(p.6)、四种 fallback(§4.4 p.6)、§4.5 聚合(p.6)、§4.6 speculative 重释(p.7)、实验协议(§5 p.7:M=32/A=8/48 响应窗口为 ATTC 协议——本篇为 nucleus 0.9 温度 0.8)、Fig 1/3/5/6/7 的读数(p.2/8–11)。
- B 级(论文自报实验,无法独立验证):全部精度-成本曲线点(无方差)、50×/10×/15% 的效率读数、验证器调用次数比(20:80,脚注 1)、规模追平数字(405B/70B/GPT-4o 对照)。
- C 级(我的推导 + 复现程序化验证):§三 3.2 式 6 的边际口径推导(复现 P0 比值 0.98–1.00)、§六.1 Jensen 间隙(复现第 3 轮实测登记)、§六.2 δ=温度的投票学(复现 P3 部分兑现)、§六.3 STOP 合龙(概念对照)。
- D 级(我的推断,已标注):§8.2 三隐式分配器、§8.3 验证器质量天花板、§8.4 backtrack 语义边界、10.3 九轮教训。
- 横向核实初核(2026-09-17):版本 v1-only 已核(2025-09-16 提交,无更新版);录用未标注;机构已核(PDF p.1:CREST-ENSAE, IP Paris + AWS AI Labs);工件无代码链接(论文未附仓库地址);第三方讨论未查;统计审查:精度-成本曲线为点估计、无方差报告;验证器调用成本未计入主效率曲线(脚注自认,只给调用次数比 20:80)。
- 实验充分性评价:部分充分——曲线族的密度(Fig 3/4/5 三组 × 多变体)支撑”占优”主张;但无方差、无消融的显著性、fallback 消融单点化,“哪个 fallback 最好”的主张只有单设定证据。
- 性能支撑目标检查:goal 是”局部自适应优于均匀分配”——支撑(Pareto 压制全面);“步级难度自动分配”——支撑(式 6 + P0/P1 复现);未过度声称(Limitations 承认 batching 未做)。