外行导读(先读这个,再决定要不要进正文)
一个场景:你用 LLM 当裁判给一堆模型的表现打分排名。你知道裁判有偏置——偏爱位置 A、偏爱长答案、偏爱排版漂亮的回答。网上流传的修法一大把:换位重问再对答案、三个温度各问一遍投票、给它打分细则(rubric)、逼它先写分析再下结论……每篇文献都说自己的办法有效。但没有一篇把它们放到同一张桌子上比过:你的模型该用哪个?要花几倍的钱?改善是统计实在的还是抖动?你只能靠猜。
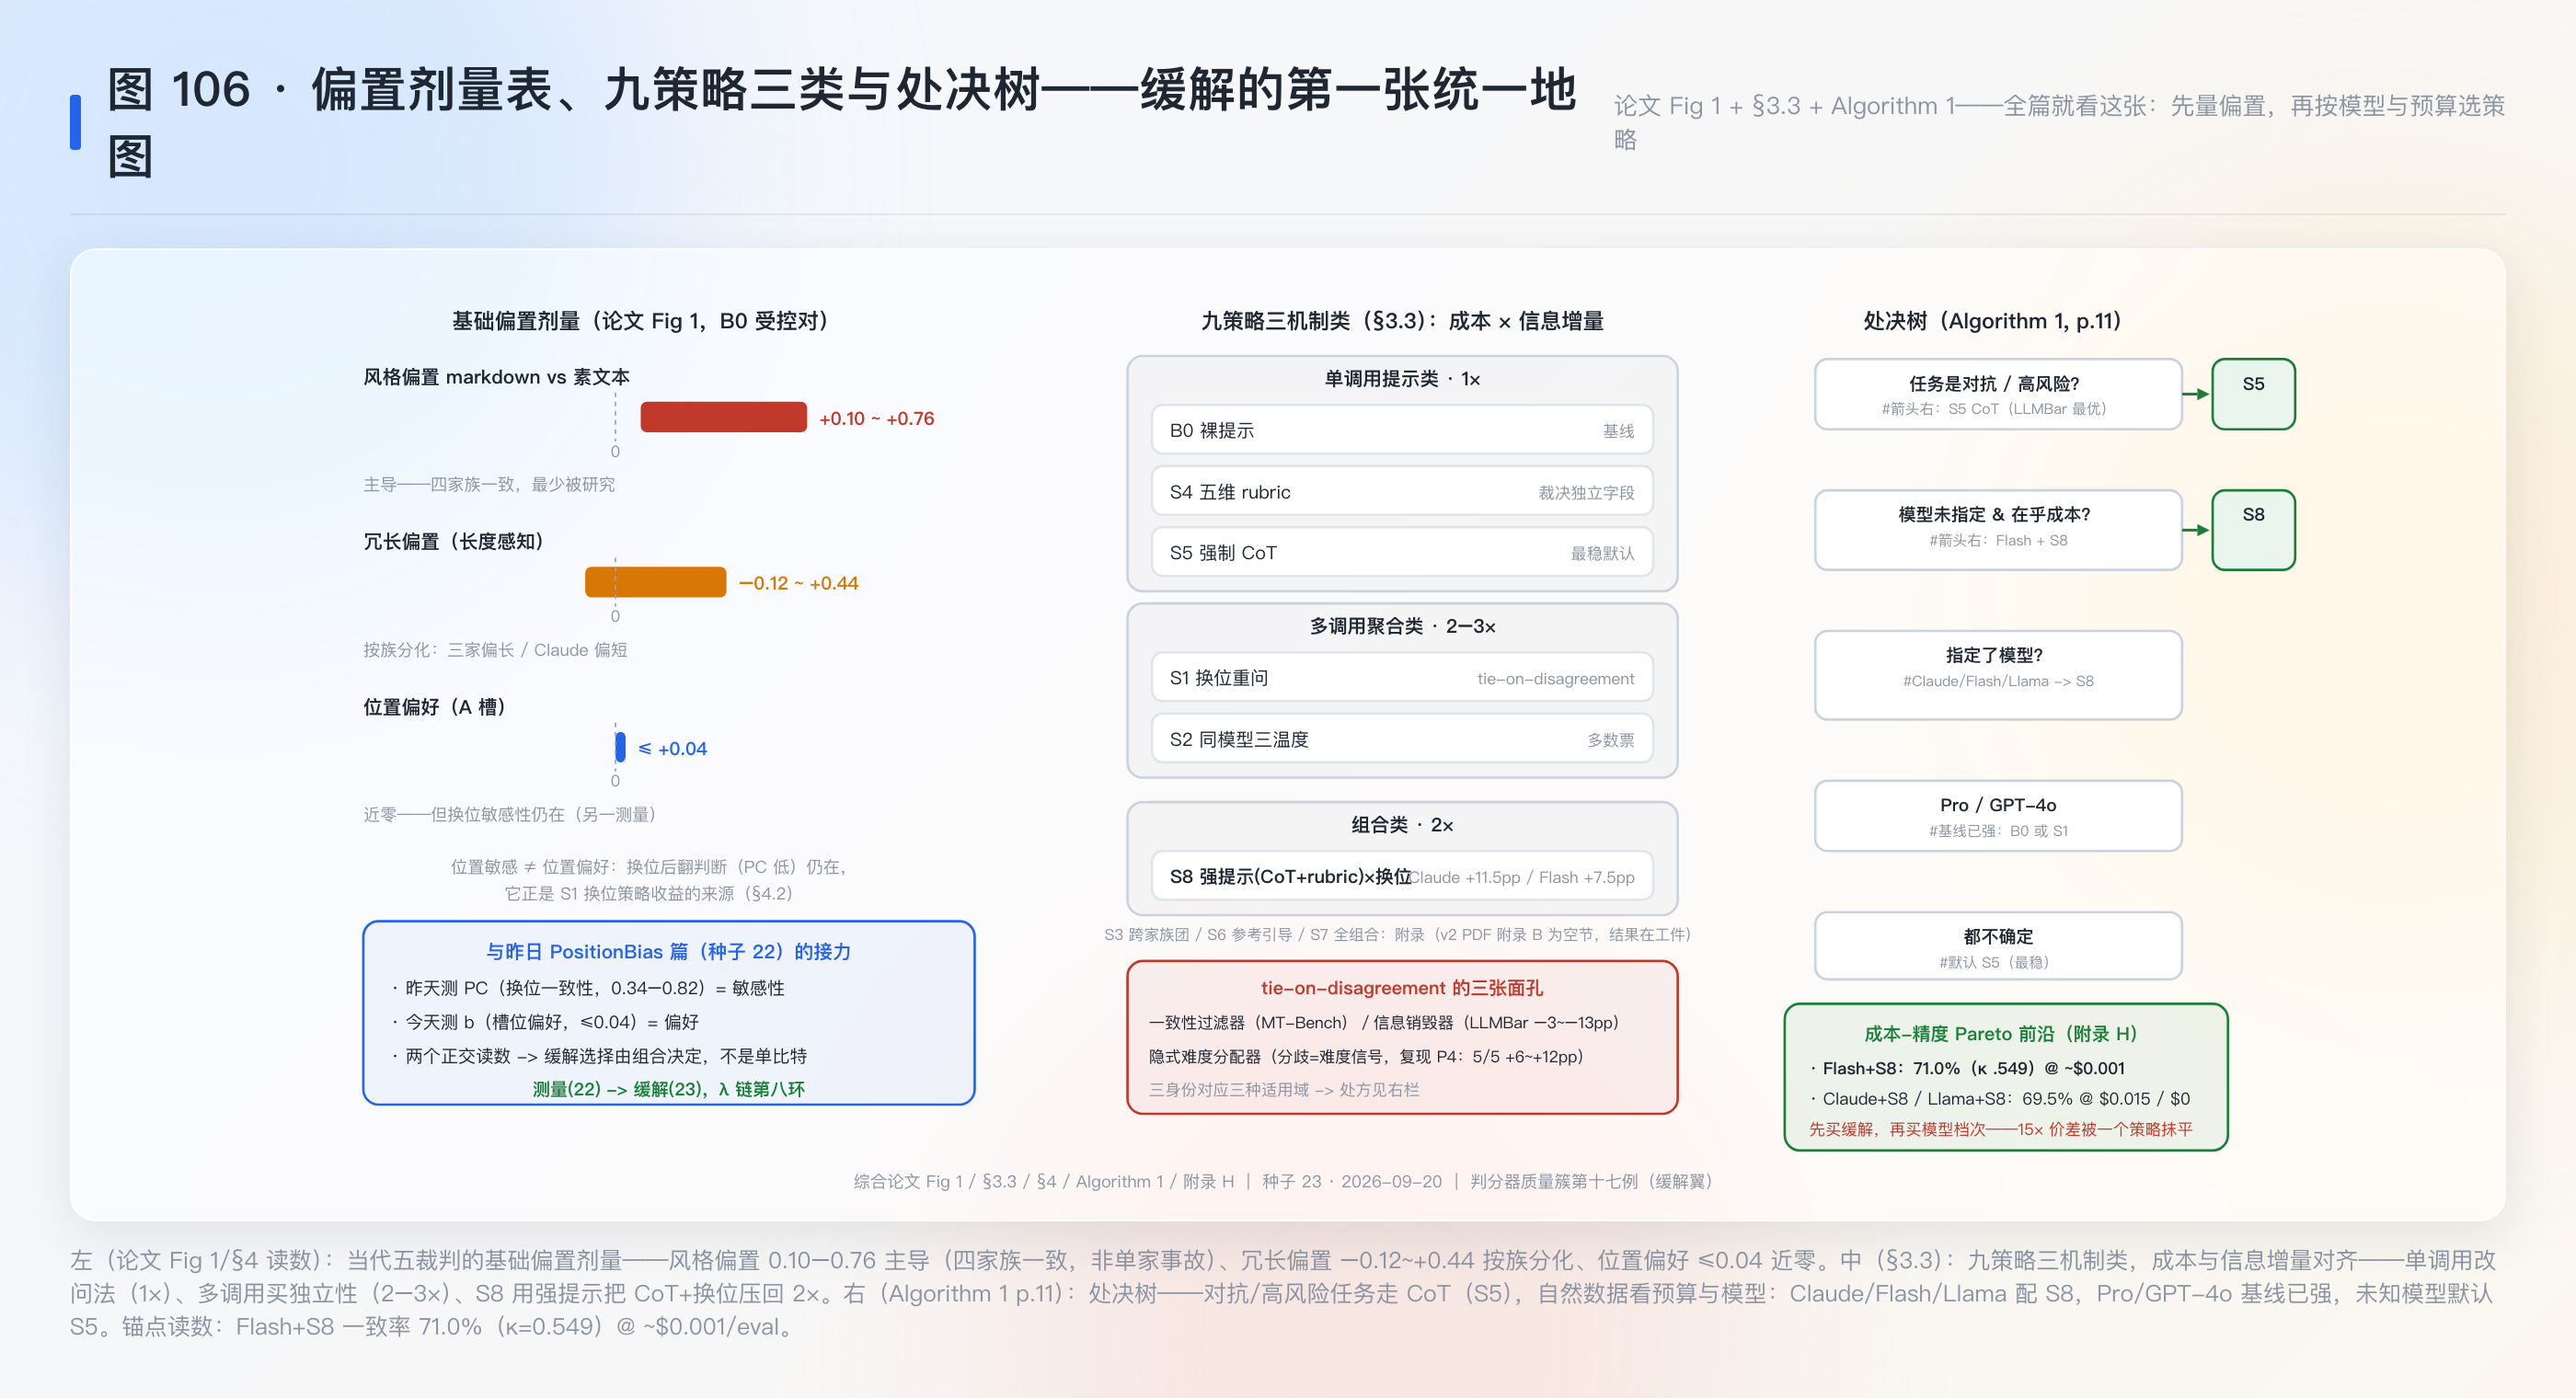
这篇论文干的事:把九种去偏策略放进同一个框架里统一比较——5 个裁判模型(Gemini 2.5 Pro / Claude Sonnet 4 / GPT-4o / Gemini 2.5 Flash / Llama 3.3-70B,横跨四家)、3 个基准(MT-Bench n=400、LLMBar n=200、自建 375 对受控数据集)、4 类偏置(位置/冗长/风格/自我偏好),全套统计纪律:配对 McNemar 检验、混合效应回归、Holm-Bonferroni 多重校正、bootstrap 置信区间、最小可检测效应(MDE)核算、成本账。顺手用受控数据集重测了一遍基础偏置的当代读数:2025 年的裁判位置偏好已缩到几乎为零(≤0.04),而几乎没人研究的风格偏置(markdown 压过素文本)高达 0.10–0.76。
为什么值得关心:三个理由。第一,它是判分器质量簇里第一篇把”缓解”本身当研究对象的系统比较——此前九篇攻击篇证明裁判多好骗、测量篇证明偏置多重,本篇回答”那到底该怎么办”,并且给出按模型分家的处方表(Algorithm 1)。第二,最实用的读数:中档模型 Flash 配上”合并提示+换位”(S8),一致率 71.0% 超过全部前沿配置,单价约 $0.001,是最强前沿配置的约 1/15——评测预算的分配方式被这张 Pareto 前沿改写。第三,本篇与昨天那篇 Position Bias(种子 22)构成精确的接力:昨天测”偏置长什么样”,今天测”什么药有效”;两篇还共同澄清了一个容易混的概念——“位置偏好”(几乎消失)与”位置敏感”(仍然存在,且正是换位策略的收益来源)是两个不同的东西。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| B0(Baseline) | 裸提示:直接要一个 JSON 裁决(A/B/tie)加理由 |
| S4(Rubric) | 单次调用 + 五维评分细则(准确/相关/完整/清晰/推理深度),各 1–5 分 |
| S5(CoT) | 单次调用 + 强制先逐步分析再给裁决 |
| S1(Position Swap) | 换位重问:AB 与 BA 各问一次,BA 的裁决翻转回原框;两次一致才采纳,不一致输出 tie。2× 成本 |
| S2(Same-Family Ensemble) | 同一模型在温度 {0.0, 0.3, 0.7} 各问一次,多数票。3× 成本 |
| S8(Combined Budget) | 把 CoT 和 rubric 合并成一条强提示,再换位问两次,tie 规则同 S1。2× 成本 |
| tie-on-disagreement | 两次换位调用不一致时输出”平局”的兜底规则 |
| 偏置分数 b | 在”期望平局”的受控对上,b = P(偏向目标) − P(偏向反向),正负号即偏置方向 |
| Cohen’s κ | 机会校正一致率:把”瞎猜也能蒙对的部分”从一致率里扣掉 |
| McNemar 检验 | 配对二分类比较:只用”基线对策略错(b)“与”基线错策略对(c)“两格计数 |
| Holm-Bonferroni | 多重比较校正:p 值排序后逐步降低阈值,第一个不过即停 |
| MDE(最小可检测效应) | 当前样本量下能检出显著的最小效应,本篇 n=400 约 4–5pp |
| 扩张对 / 截断对 | 长度↑质量平(加废话)/ 长度↑质量↑(完整版)——两对合用拆出”长度偏好”与”质量敏感” |
| 位置镜像 STYLE 对 | 同一对 markdown/素文本各摆一次槽位,取平均剥掉位置混杂 |
| Round-robin MODEL_ORIGIN | 四种模型两两配对各 25 对,让每家裁判都有”自家对”可测自我偏好 |
§0 承接栏
这颗种子是昨日 Position Bias 篇(种子 22)点名的直接后续——那篇测完了”偏置长什么样”,在局限里自认”our focus was on evaluating and understanding position bias rather than mitigating it”,把缓解策略的系统比较列为待读。本篇接住这一棒:九策略统一比较 + 统计显著性把关 + 成本账。同时它在判分器质量簇里补上一个空格子:SoK 篇数出的攻防不对称(攻击 9 行 vs 防御 3 行、正面防御为零)在评测管线侧有了第一份系统答案。还有一层精妙的对读:昨天测出的”位置偏置显著存在”(PC 低到 0.34)与本篇测出的”位置偏置几乎消失”(b ≤ 0.04)并不打架——它们量的是两个东西(换位后的一致性 vs 对特定槽位的偏好),本篇 §4.2 亲手把桥搭好了,见 §八.1。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:LLM 裁判已经是主流评测范式——MT-Bench、AlpacaEval、Chatbot Arena 都靠它;但”LLM judges are not neutral arbiters”,位置、冗长、自我偏好、风格四类偏置都有文献记载。缓解手段散落各处:换位、多裁判团、校准 rubric、思维链。问题在于这些手段从未同台:策略 A 的论文不测策略 B 的场景,偏置 X 的缓解对偏置 Y 是治好还是恶化,没人量过。
1.2 三个缺口(§1 p.1–2、§2 p.4)
①比较缺口:策略孤立评估,无法排序;②交互缺口:为一种偏置设计的策略对其他偏置的副作用未测——本篇 Fig 2 专门画了这张交叉表;③覆盖缺口:最近的 CALM 基准(认知偏置评测)只测两家同源模型、偏置彼此隔离(§2 p.4)。本篇在三个维度上同时扩展:九策略、跨偏置交互、四家族五模型。
1.3 为什么是这三批读者(§1 p.2)
评测管线搭建者(该用哪个策略)、模型开发方(RLHF 奖励建模用的裁判被格式差污染会扭曲排名)、基准维护方(该不该在判分前统一格式)。第三条直通昨天那篇的”测量”与本篇的”缓解”合流点:如果风格偏置 0.4–0.76,那么 AlpacaEval/Arena 上模型 A 与 B 的胜率差可能纯粹是排版差。
二、核心想法
一句话:缓解不是一个大功臣,而是一张按模型分家的处方表——同一个策略在这个模型身上 +11.5pp,在那个模型身上进不了显著线;决定这张表的底层机制是”换位分歧”与”tie 兜底”的账,而这张账必须用配对统计才能读对。
直觉先打底。把九种策略想成九种胃药,五个裁判想成五个胃:同样的药,有人见效有人无效。这篇论文做的事像一次规范的临床试验——随机对照(同一批 400 题配对比较)、统计把关(McNemar + 多重校正)、剂量标注(成本倍数)、适应症分类(LLMBar 对抗数据是另一种胃)。最终交付的是一张说明书:对抗性评测用 CoT(S5),自然数据看预算——Claude 配 S8、Flash 配 S8、Llama 配 S8,预算极紧用 S1,不确定就用 S5。
全篇就看这张:图 106——左边是四类偏置的当代剂量表(风格主导、位置近零、冗长分化),中间是九策略的三机制类与成本倍数,右边是 Algorithm 1 的处决树——一张图装下本篇的全部结论。
形式化入口:策略对基线的改善量记为 \Delta = \text{acc}(S) - \text{acc}(B_0),但它的显著性由配对计数 (b, c) 决定而非 \Delta 本身——同样的 +4.5pp,在 92 个分歧对上显著、在 40 个上不显著。这是 §三 要发的第一件数学工具。
三、数学基础(零起点,四件工具逐一发明式拆解)
本节外部断言:Cohen’s κ 的原始出处(Cohen 1960)、McNemar 1947 原文、Holm 1979 均为教科书级转引,本日未核对原始文献,登记。
3.1 第一件:偏置分数 b——把”偏好”变成带符号的数
先摆问题。你怀疑裁判偏爱 markdown 排版。造 50 对内容完全相同、只有排版不同的回答,期望裁决是”平局”。跑完发现裁判 40 次选了 markdown 那 边、10 次选素文本。怎么把”40 比 10”变成一个可跨数据集比较的量?
候选方案一死:只报”选 markdown 40 次”——死于没参照系,50 对和 500 对上的 40 次意义完全不同。方案二死:报”多数选 markdown”——丢掉了强度,41/50 与 50/50 的差别没了。方案三死:报准确率——这里没有”对错”,任何方向性选择都是偏置本身。
约束逼出来的活路:受控对上期望平局,所以任何非平局裁决都是偏置读数。定义 b = P(\text{prefers target}) - P(\text{prefers non-target}),其中 target 按偏置类型固定(位置偏置取 A 槽、冗长偏置取实际更长的一方、风格偏置取 markdown 方、自我偏好取同族模型方)。b \in [-1, 1],正号 = 偏置方向成立,零 = 无偏好,负号 = 反向偏好。
数值例(贯穿示例):Claude 在 50 对 STYLE 上 68% 的定向裁决选 markdown → b_{\text{style}} = +0.68(§4.1 p.6 Fig 1)。附带一个符号约定坑:冗长偏置的 target 是”实际更长的回答”而不是 A 槽——因为 50 对扩张对里长答案 34 次在 A 槽、16 次在 B 槽,按槽位算会混入位置效应(§3.5 p.5;v2 特意改掉 v1 的槽位口径,§4.3 p.9 自述”the original verbosity values were inflated by the slot-vs-length conflation”)。
为什么必须是它:符号、界、可比性三样同时成立,且在期望平局的对子上”零假设 = 无偏好”恰好对应 b = 0——统计检验有自然的靶心。
名字最后给:论文叫 signed bias score(§3.5 p.5)。
3.2 第二件:Cohen’s κ——一致率要扣掉”瞎猜地板”
先摆问题。Flash+S8 与人类一致率 71.0%,听起来不错。但裁决有三类(A/B/tie),人类标签也不是均匀分布——一个只会喊”A”的聋子裁判也能蒙对一批。直接拿 0.71 报成绩,水分在哪?
停下来猜一下:水分应该跟什么有关?只跟类别数(3 类 = 瞎猜 33%)有关吗,还是跟两边各自的边缘分布有关?
候选方案死两个:①统一扣 1/3——死于忽略边缘分布:gold 里 tie 只占 24%(97/400),预测分布也不均,瞎猜的期望命中不是 1/3;②报”超额一致” p_o - p_e 不做归一——量纲不封顶,跨任务没法比。
活路(唯一的):期望一致率 p_e = \sum_i p_i^{(\text{pred})} p_i^{(\text{gold})}(两侧边缘分布的乘积和),机会校正一致率定义为
\kappa = \frac{p_o - p_e}{1 - p_e}
其中 p_o 是观测一致率。直觉:分母 1-p_e 是”扣掉瞎猜后还剩多少可分歧空间”,分子是”扣掉瞎猜后真赢了多少”。\kappa = 0 等于瞎猜水平,\kappa = 1 完美。
数值例(贯穿示例,且这行数字后面要当审计靶子用):Flash S8 的预测边缘 A=173、B=162、tie=65,gold 边缘 A=158、B=145、tie=97,p_e = \frac{158 \times 173 + 145 \times 162 + 97 \times 65}{400^2} = 0.3571。代入 \kappa = 0.549 反解 p_o = \kappa(1-p_e) + p_e = 0.7100——与 Table 1 报告的 0.710 严丝合缝。这个”反解”就是 §六.1 的审计武器:κ 表和一致率表必须互相咬合,不咬合就是有一张表算错了。
名字最后给:Cohen’s kappa(Table 6 p.18),“chance-corrected”(§3.5 p.5)。
3.3 第三件:McNemar 检验——配对比较只用两个格子
先摆问题。S8 比 B0 高 11.5pp(0.580→0.695),怎么判断这不是 400 道题上的随机抖动?
你可能会想两样本比例检验。它死在这里:B0 和 S8 跑的是同一批 400 题,逐题配对——两样本检验把配对数据当独立数据,白白扔掉一半信息,还会把”题目难度”误算进策略效应。
正确的账本长这样:每道题两个格子身份——B0 对 S8 错(记 b),B0 错 S8 对(记 c);两边都对和两边都错的题不进入比较(它们对”谁更好”零信息)。若策略无效,b 与 c 应该差不多;|b-c| 越大越像真效应。McNemar 统计量(带连续性校正):
\chi^2 = \frac{(|b - c| - 1)^2}{b + c}
每步拆解:|b-c| 是净效应,减 1 是连续性校正(把连续的 χ² 分布套在离散计数上时往零方向收一格,避免小样本高估显著),平方压掉符号,除以 b+c 用分歧对总数做尺度——同样是差 20 对,发生在 30 个分歧对上比发生在 200 个上惊人得多。近似服从自由度 1 的 χ² 分布。
数值例(贯穿示例):Claude S8 的 b = 23、c = 69(Table 4 p.17),\chi^2 = \frac{45^2}{92} = 22.01,p < 0.0001——与论文报告逐位一致。手工复验的三行都在 §六.2。
3.4 第四件:Holm-Bonferroni——20 个比较怎么守住 5% 的假阳性率
先摆问题。5 模型 × 4 策略 = 20 次”是否改善”的检验,每次 α=0.05。哪怕全部无效,“至少一次误报显著”的概率是 1 - 0.95^{20} \approx 64\%。不做校正,10 个”显著改善”里可能六七个是噪声。
停下来猜一下:最粗暴的修法是什么?——对,全部用 0.05/20 = 0.0025 当门槛。它为什么又”太笨”?因为它把最严格的门槛用在所有人头上,包括 p 值排最后、本来就没希望的那个。
Holm 的步降法(1979,转引):把 p 值从小到大排队,第 i 名与 \frac{\alpha}{m - i + 1} 比较(m 是比较总次数)——最小的 p 配最严的门槛,越往后门槛越松;第一个不过线的瞬间,后面全部判死(步降的”步”)。这是保族错误率 ≤ α 的同时最不浪费功效的规则。
数值例:本篇混合效应回归的五个显著 p 排队:0.0001, 0.0001, 0.0009, 0.004, 0.011,m=20。门槛依次 0.05/20=0.0025、0.05/19≈0.0026、0.05/18≈0.0028、0.05/17≈0.0029、0.05/16=0.0031。前三个过、第四个 0.004 > 0.0029 判死、第五个不再看——三个存活。而换成 McNemar 的 p 序列(0.0001, 0.0003, 0.004, 0.006, 0.045)只有两个存活。同一份数据、同一套规则,两个存活数——这不是悖论,是两套 p 值。记住这个数:3 和 2。§六.3 会用它裁决论文里的一处自相矛盾。
钩子:这四件工具现在都能算单个数字了。但论文真正的机制藏在策略的内部结构里——下一步拆开看。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| b | 偏置分数 = P(偏向目标) − P(偏向反向),受控对上期望 0 | §3.5 p.5 |
| p_o | 观测一致率(预测 = gold 的比例,tie 精确匹配才算对) | §3.5 p.5 / 附录 D p.16 |
| p_e | 期望一致率 = \sum_i p_i^{\text{pred}} p_i^{\text{gold}} | κ 定义 |
| \kappa | (p_o - p_e)/(1 - p_e),机会校正一致率 | Table 6 p.18 |
| b, c | McNemar 两格:基线对策略错 / 基线错策略对 | Table 4 p.17 |
| \chi^2 | (\lvert b-c\rvert - 1)^2/(b+c),自由度 1 | 附录 D p.16 |
| MDE | n=400 时约 4–5pp(40–50 个分歧对) | 附录 D p.16 |
| tie-on-disagreement | 换位两次不一致 → 输出 tie | §3.3 p.4 |
| \Delta | 策略 − 基线的一致率差(pp) | Table 1 p.7 |
五、机制
5.1 机制一:九策略三机制类——成本与信息增量对齐(§3.3 p.4)
单调用提示类(1× 成本):B0 裸提示、S4 加五维 rubric(裁决是独立 JSON 字段,不从分数加总推导)、S5 强制思维链。多调用聚合类(2–3×):S1 换位重问、S2 同模型三温度多数票。组合类(2×):S8 = 强提示(CoT+rubric 合并)× 换位。另有 S3(跨家族裁判团)、S6(参考答案引导)、S7(全组合)在附录——这里先记一笔:v2 PDF 的附录 B 是一个空节,正文两处承诺”S2/S3/S6/S7 results in Appendix B”(Table 1 注 p.7、§3.3 p.4)都落了空,结果只在发布工件里(登记进 §九)。
设计的整齐之处:成本倍数与信息增量对齐——单调用改的是”问法”(信息不变),多调用买的是”独立性”(第二次采样),组合类买的是”强提示的独立性”。S8 的妙处:它把 3× 的 CoT+换位组合压回 2×——两次调用共享同一条合并提示。
5.2 机制二:tie-on-disagreement——一个兜底规则的三张面孔(§3.3 p.4)
S1 与 S8 共享同一条聚合规则:换位问两次,把 BA 序的裁决翻转回原框;一致就采纳,不一致就输出 tie。看起来人畜无害,拆开看是三个身份。
第一身份:一致性过滤器。分歧 = 模型对这题没把握,输出 tie 是”认怂”,总比硬猜好?第二身份:信息销毁器。LLMBar 的题”一个回答明确更好”,分歧对上 tie 几乎必错(gold 没有 tie)——换位在 LLMBar 上全场 −3 到 −13pp、三处过 Holm 校正(§4.4 p.9),销毁器身份现形。第三身份:隐式难度分配器——这是本篇最值钱的洞察(补充,论文未用这个词):换位分歧不是随机噪声,它恰好落在模型没把握的难题上;在这些题上”tie”比裁判自己的直觉更准。于是 S1 变成一台不需要难度估计器的自适应机器——难题自动输出 tie(保守),简单题自动保留裁决(果断)。这与 LATTS 的接受准则(验证器分=接受概率,试验次数=难度读数)、DAPO 的零信号组过滤是同一家族:不在系统外估计难度,把难度信号做成机制的输入。判分器质量簇的”接受准则即分配器”方法卡在这里拿到评测管线的第二域实例。
段末留个问:如果分歧真是难度信号,那 S1 的实际收益应该比”分歧与难度无关”的天真模型预测的更好——这个可证伪的推论留给 §六.4 和复现 P4。
5.3 机制三:长度-质量解耦对——两个方向各摆一次(§4.1.2 p.6、附录 A/F p.15、19)
冗长偏置的经典测量(扩张对:基座回答 vs 加长注水的扩写)有一个致命混淆:长答案可能真的更好。本篇的解法是摆第二个方向——截断对:完整长答案 vs 机械砍到 40% 的短答案,这里长 = 真·更完整。两个方向一摆,三种”裁判人格”各自留下可分辨的签名:
| 人格 | 扩张对偏好 | 截断对准确率 |
|---|---|---|
| 纯长度偏好 | 正(偏长) | 高(认得出完整) |
| 纯质量敏感 | 负(罚注水) | 高 |
| 长度质量都无感 | 零 | 随机(≈0.5) |
实测:Pro/Llama/Flash 落在”经典冗长偏置 + 部分质量识别”象限(扩张 +0.24~+0.44,截断 0.88–1.00);Claude 落在纯质量敏感象限(扩张 −0.12、截断 1.00——唯一双满格);GPT-4o 接近”长度质量独立”(扩张 −0.04、截断 0.96)。没有模型落进”无感”象限——五个裁判都认得出真完整。这就是贯穿示例里 Claude 的那格账:扩张 −0.12 + 截断 1.00。
(补充)这个”两方向对摆”的构造和位置镜像 STYLE 对是同一个模式:把混杂变量(长度↔︎质量、格式↔︎槽位)在两半数据里对齐/互换,让目标变量单独显形。§十一 会把它提炼成方法卡。
5.4 机制四:位置镜像与 round-robin——v2 的两块补丁(§A p.15)
v1 的 STYLE 对把 markdown 固定在 A 槽——格式偏好与槽位偏好混在一起。v2 加了 50 对镜像(素文本在 A),取两方向平均后风格偏置只剩格式贡献(§4.1 p.6 “position-averaged”)。同理 v1 的 MODEL_ORIGIN 只有 Gemini vs Claude 一档,只能测 Gemini/Claude 的自我偏好;v2 加 100 对 round-robin(Llama×Pro、Llama×Claude、GPT-4o×Pro、GPT-4o×Claude 各 25),让 GPT-4o/Llama/Flash 也有了同族对。两块补丁都是评审期改的(正文多处 “added in this revision” / “the reviewer pointed out”)——评审意见直接改善了测量效度,这个案例值得记进”审稿怎么起作用”的档案。
5.5 机制五:S8 为什么 tie 少——论文的主张与它自家表格的裂缝(§4.2 p.8 vs Table 3 p.17)
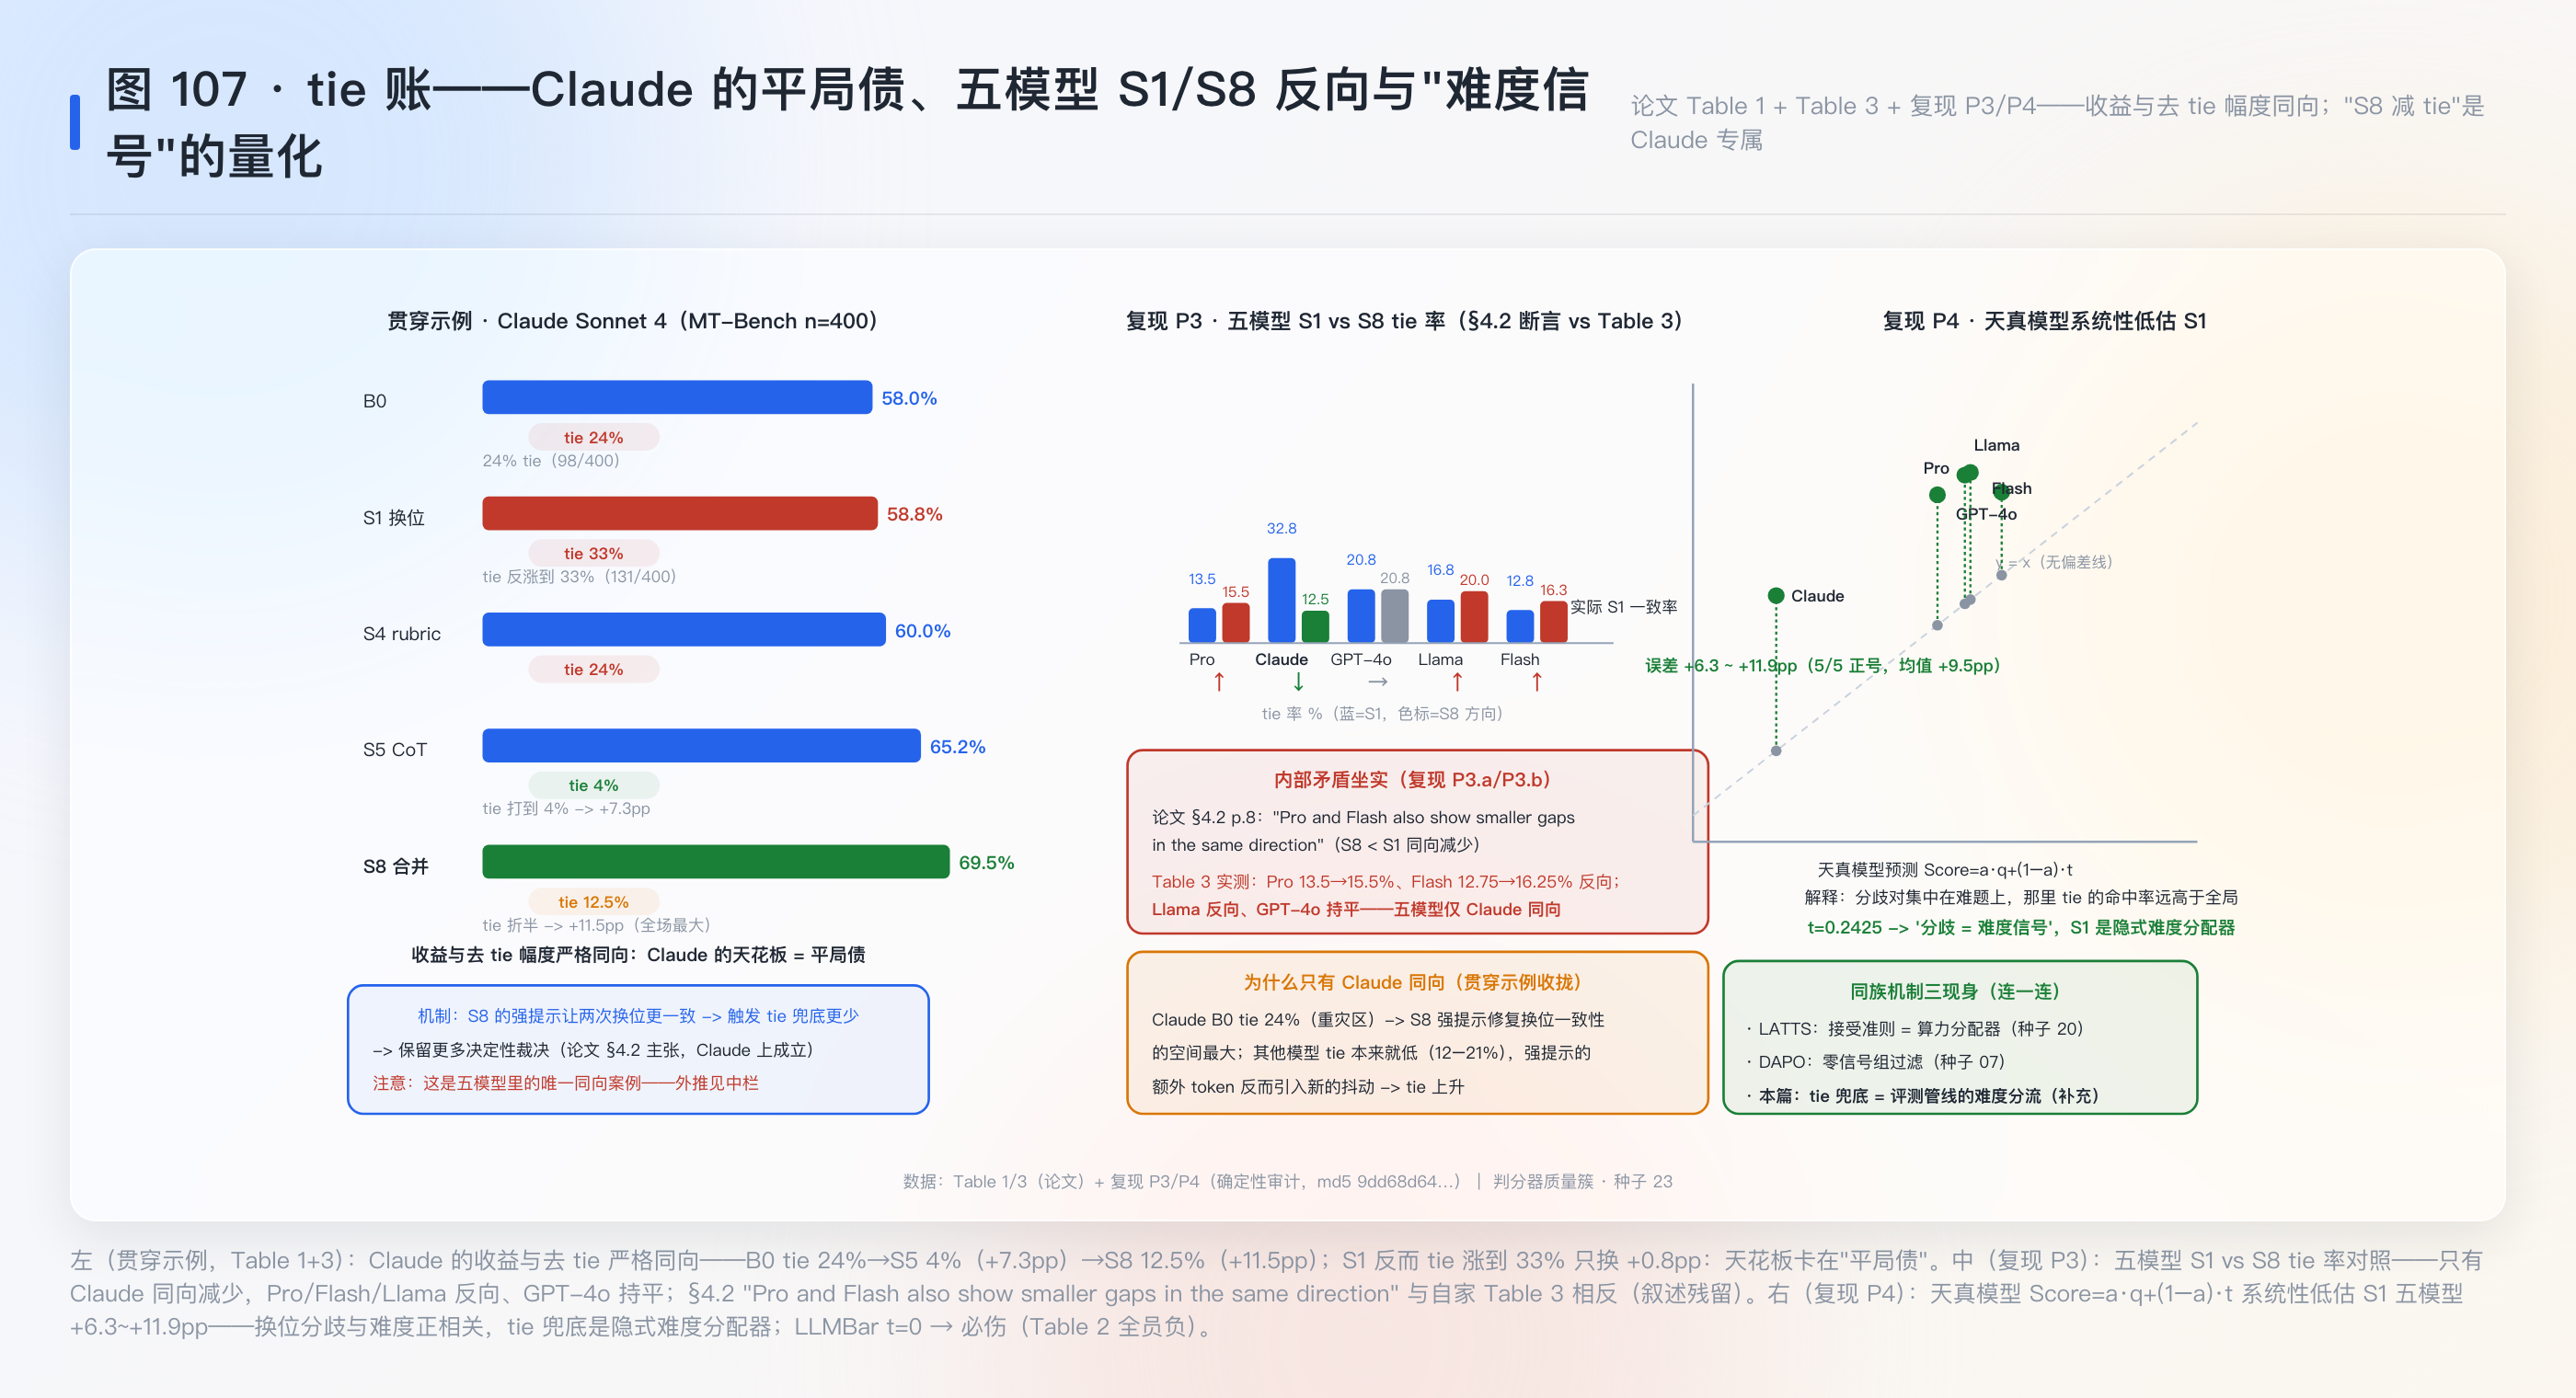
论文主张:S8 与 S1 共享 tie 规则,但 S8 的合并强提示让两次换位的裁决更一致——分歧本来就少,触发 tie 兜底的次数就少,“stronger prompts make position-swap aggregation more informative”。证据:Claude 的 tie 率 S1 32.8% → S8 12.5%;“Pro and Flash also show smaller gaps in the same direction”(§4.2 p.8)。
但 Table 3 的数字是:Pro S1 13.5% → S8 15.5%(反向),Flash 12.75% → 16.25%(反向),Llama 16.75% → 20%(反向),GPT-4o 21% 持平,五模型里只有 Claude 同向。也就是说:“S8 减少 tie”是 Claude 专属现象,不是规律;正文把它写成了普遍规律,还点名了两个实际反向的模型。这是本篇最重的一处内部矛盾,复现 P3 会把它钉死。机制本身(强提示→换位一致率→tie 兜底触发率)在 Claude 这个”tie 重灾区”上确实成立且解释了 S8 最大的收益,只是外推越界了。
5.6 最值钱的实验(Table 1 + Table 3 + Table 2)
如果只看一组实验:Table 1 的 Claude 行加 Table 3 的 Claude 行并排读——B0 0.580、24% tie 的裁判,S5 把 tie 打到 4% 换 +7.3pp,S8 把 tie 折半到 12.5% 换 +11.5pp;S1 的 tie 反而涨到 33%,只换 +0.8pp。三行连起来是一个完整的机制故事:Claude 的天花板卡在”平局债”上,收益与去 tie 幅度严格同向。它单独撑起”策略-模型匹配”这一主贡献。第二组再看 Table 2(LLMBar):同一批策略在对抗数据上集体哑火甚至反噬(S1 全员负、Llama 的 S8 −13pp)——缓解的适用域边界,比成功案例更值钱。
六、数学展开
6.1 κ 反解审计:让两张表互相咬合(补充,本站复现 P1 的原理)
论文里 Table 1(一致率)、Table 3(预测边缘)、Table 6(κ)三张表是独立排版的。但 κ 的定义把它们锁死了:给定预测边缘与 gold 边缘可算 p_e,给定 κ 可反解 p_o = \kappa(1 - p_e) + p_e,这个 p_o 必须等于 Table 1 的一致率。三张表任何一张手滑,咬合就崩。
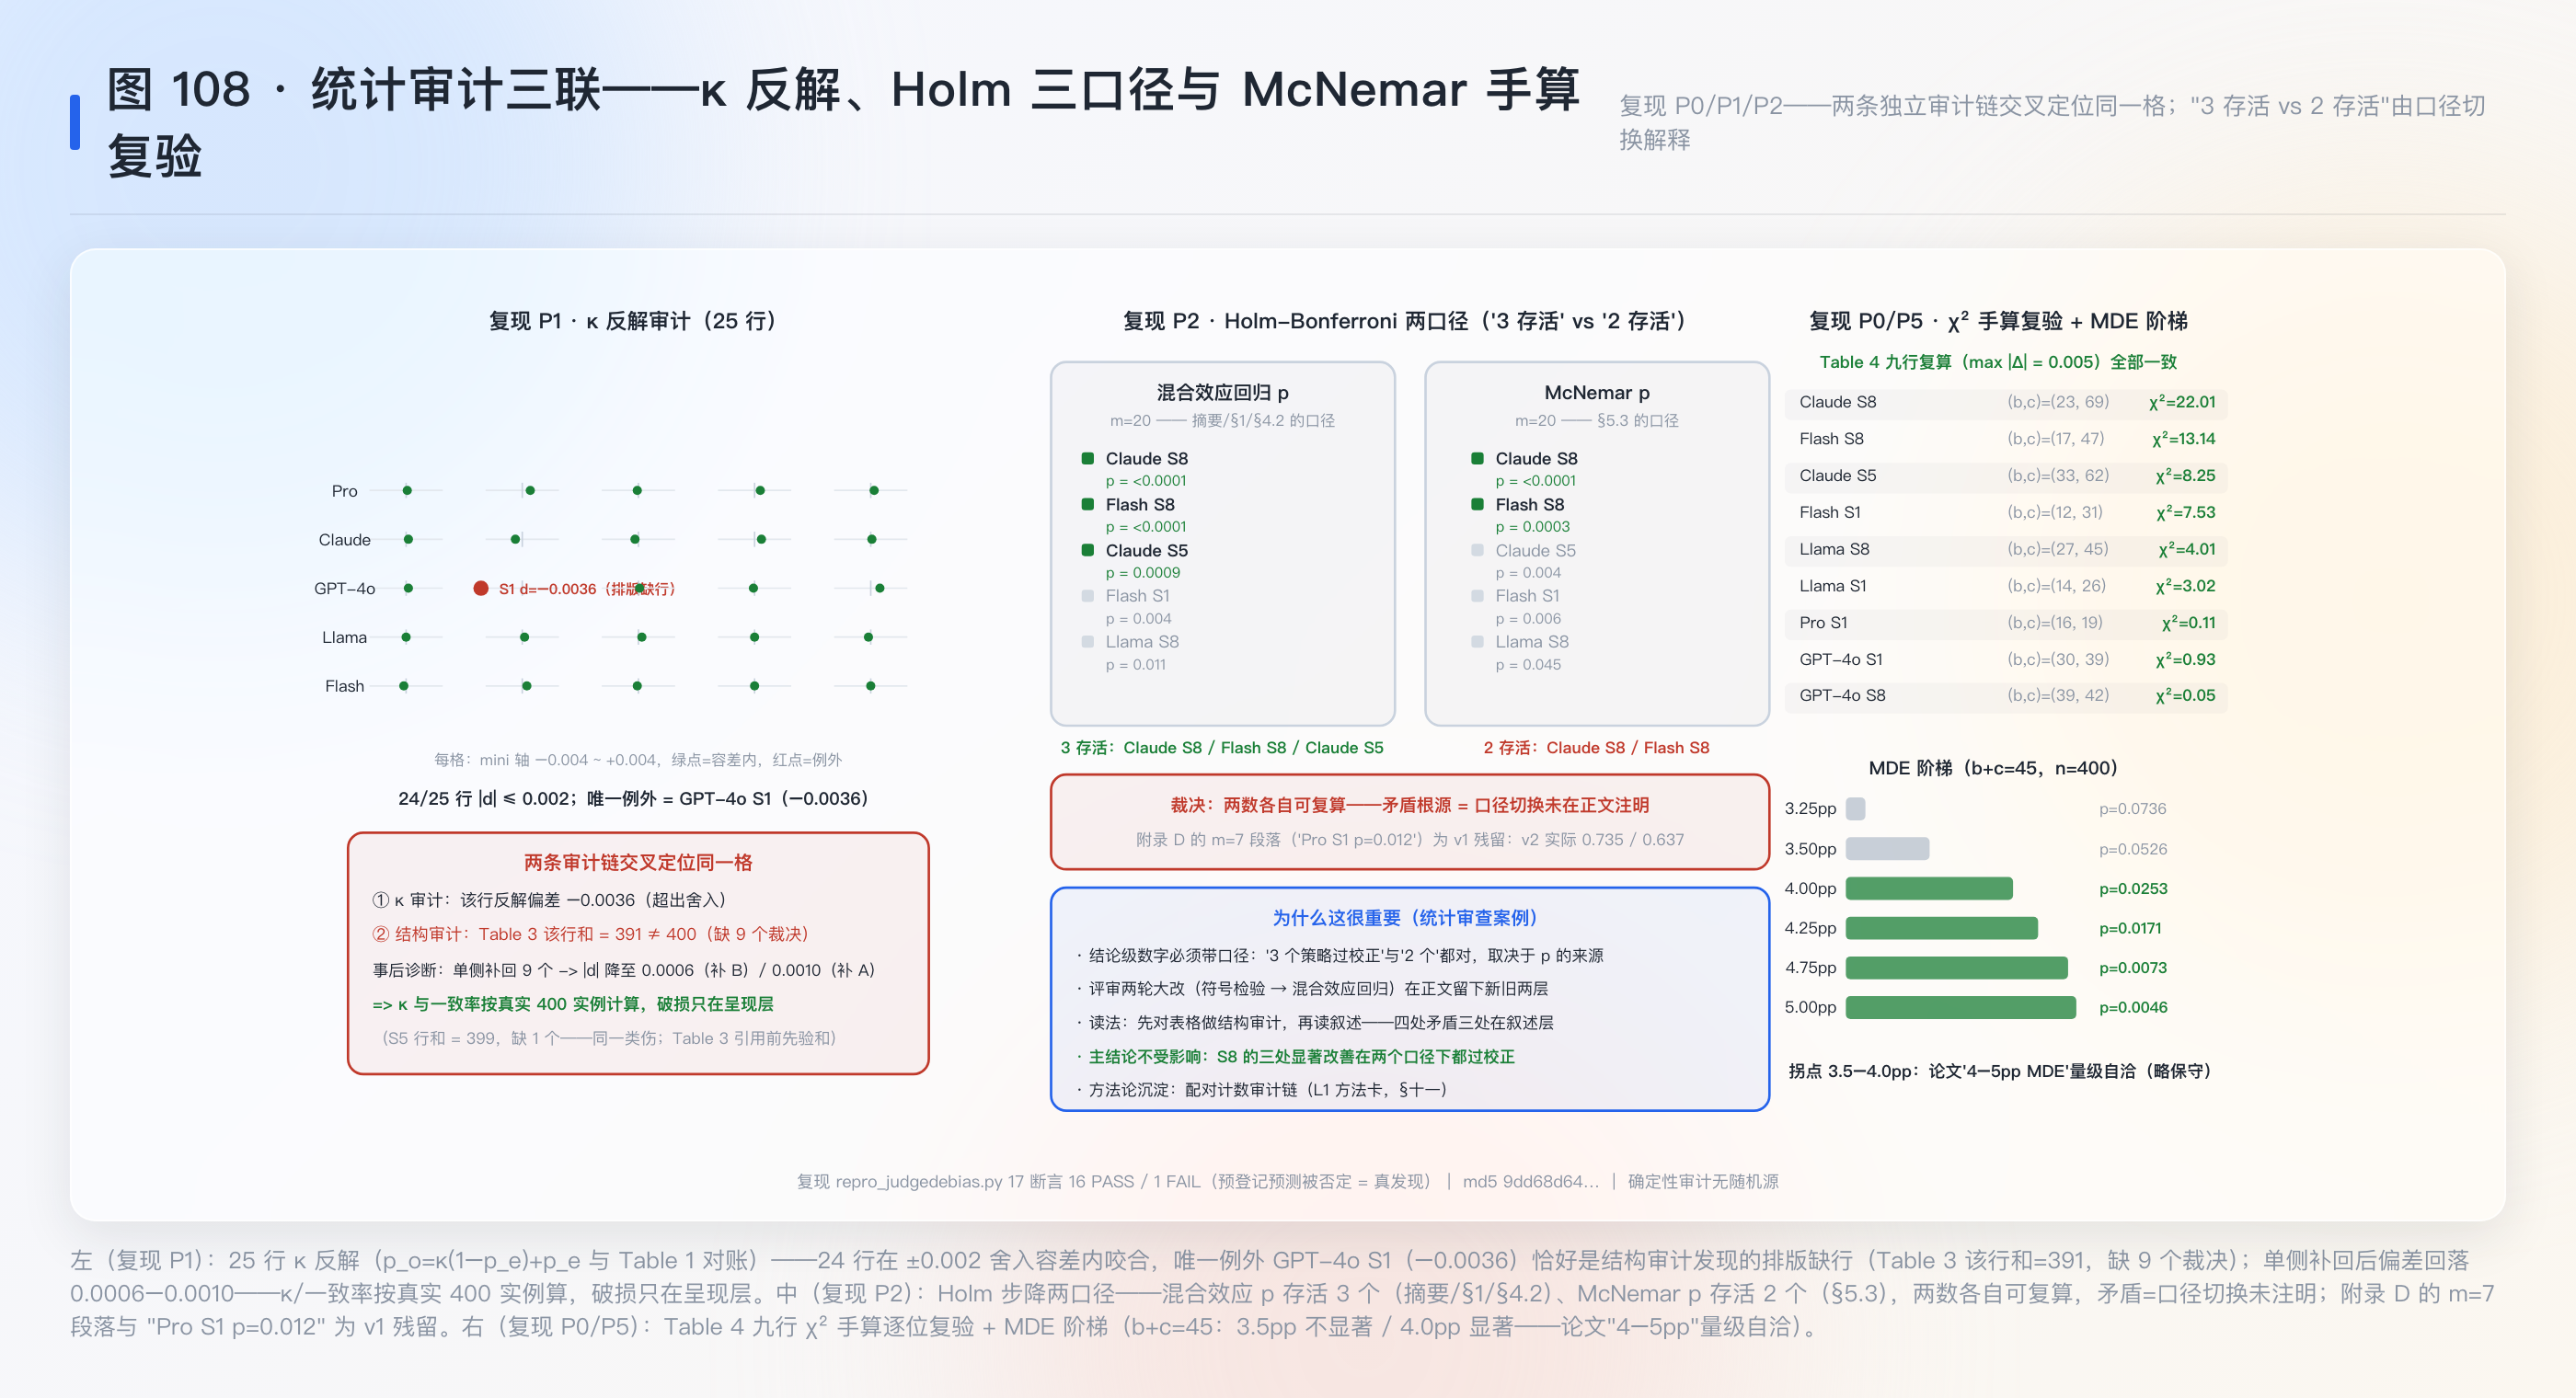
全篇 25 行(5 模型 × 5 策略)反解结果:24 行偏差 ≤ 0.002(舍入容差内),唯一例外 GPT-4o S1 偏差 −0.0036(反解 0.6614 vs 报告 0.665)——超出纯舍入能解释的范围。这个孤格后来被结构审计解释了:它正是 Table 3 里和不为 400 的排版缺行(§十 P0 真发现),单侧补回 9 个裁决后偏差回落到 0.0006–0.0010——两条独立审计链交叉定位同一格,κ 与一致率本身按真实 400 实例计算,破损只在呈现层。数值例(贯穿示例):Claude S8,p_e = \frac{158 \times 181 + 145 \times 169 + 97 \times 50}{400^2} = 0.3622,p_o = 0.522 \times 0.6378 + 0.3622 = 0.6951,与报告 0.695 咬合 ✓。这一节的通用价值:读到任何”一致率 + κ”双报告,先做一次反解对账,30 秒验三张表。
6.2 McNemar 手算全表复验(复现 P0 的原理)
Table 4 的九行 (b, c, \chi^2, p) 全部用 \chi^2 = \frac{(|b-c|-1)^2}{b+c} 与 p = \mathrm{erfc}(\sqrt{\chi^2/2}) 复算:22.01/13.14/8.25/7.53/4.01/3.02/0.11/0.93/0.05,九行与论文逐位一致;p 值在报告的舍入精度内全部复现(0.0000, 0.0003, 0.0041, 0.0061, 0.0451, 0.0820, 0.7353, 0.3355, 0.8241)。Claude S8 的三行账:45^2 = 2025,2025/92 = 22.01。顺带验证 Table 3 结构完整性:25 行 A+B+tie = 400 全部成立。
6.3 Holm-Bonferroni 三口径:裁决论文自己的矛盾(复现 P2 的原理)
论文对”Holm-Bonferroni 校正后几个策略存活”给了两个说法:摘要/§1/§4.2 说三个(Claude S8、Flash S8、Claude S5),§5.3 说两个(Claude S8、Flash S8)。哪个对?
都对——但用的是不同的 p 值。把两套 p 各自过一遍 m=20 的 Holm 步降:混合效应回归 p 序列(0.0001, 0.0001, 0.0009, 0.004, 0.011)→ 三存活;McNemar p 序列(0.0001, 0.0003, 0.004, 0.006, 0.045)→ 两个存活(第三个 0.004 撞上门槛 0.0028)。附录 D 还留着第三段:m=7 的旧口径(v1 只有 7 个比较),那段里”Pro S1 p=0.012 不存活”的 Pro S1 在 v2 的 Table 4/5 里 p 分别是 0.735/0.637——这段是 v1 残留,与 v2 任何表格都对不上。
裁决:矛盾根源 = 混合效应 p 与 McNemar p 的口径切换没有注明,外加一段没删干净的旧文。两个数字各自可复算,但读者从正文拿到的是”3 还是 2”的真困惑——系统比较论文的结论密度高,口径卫生比什么都重要。这个案例进 §八.3 的方法论清单。
6.4 tie 估计量的期望模型:S1 的真实身份(补充,复现 P4 的原理)
把 S1 抽象成一个估计量。设单次调用一致率 q,换位一致率(两次调用给出同一裁决)a = 1 - \text{tie\%},gold 平局率 t。S1 的期望得分:
\mathbb{E}[\text{Score}_{S1}] = a \cdot q + (1 - a) \cdot t
第一项:一致时(概率 a)采纳原裁决,得分按单调用能力 q;第二项:分歧时(概率 1-a)输出 tie,得分按 gold 平局率 t。与单调用 q 相比:
\Delta = (1-a)(t - q)
t 是常数(MT-Bench gold:t = 97/400 = 0.2425),q \approx 0.58\text{–}0.66 \gg t,所以天真模型断言 S1 必然伤害一致率。用五模型的真实参数代入:预测值全部低于实际值——Claude 预测 0.470 vs 实际 0.588(差 +11.9pp),五个模型的误差全是正的(+6.3 ~ +11.9pp)。
天真模型系统性低估,说明它的假设错了:错在”分歧对上的得分 = 全局 gold 平局率”。实际上分歧与难度正相关——分歧集中在裁判本来就没把握的题上,那些题上 tie 的命中率远高于全局 t;同时一致对集中在简单题上,那里的 q 也高于全局。S1 不是均匀的抽签机器,而是一台按分歧信号分流的难度分配器。这也解释了 LLMBar:t=0(gold 无平局),\Delta = (1-a)(0-q) < 0 恒成立——S1 在对抗数据上必伤,与 Table 2 的全场负号严格一致。一个公式同时预测了”MT-Bench 上意外有效(对特定模型)“与”LLMBar 上必然有害”。
拆一个部件给你推:如果某个裁判的换位分歧率 1-a \to 0(两次调用几乎总一致),S1 会退化成什么?——退化成单调用本身(\Delta \to 0):没有分歧可分流,兜底永不触发。这提示 S1 的收益上限被换位一致率锁死,与 §5.5 的”强提示降低分歧”主张在数学上汇合。
6.5 位置镜像的线性分解:平均为什么能剥离槽位(补充)
设裁决偏好由格式项 f(markdown 贡献)与槽位项 s(A 槽贡献)线性合成。markdown 在 A 时 b_{\text{obs}} = f + s;镜像后 markdown 在 B 时 b_{\text{mirror}} = f - s(槽位贡献翻转,格式贡献不变)。两方向平均:
\bar{b} = \frac{b_{\text{obs}} + b_{\text{mirror}}}{2} = f
槽位项在平均中消失。这正是 v2 位置镜像的数学本质:把”对格式的偏好”从”对槽位的偏好”里剥出来。注意线性可加是这个剥离的前提——若格式与槽位有交互项(例如”长 markdown 在 A 槽”特殊加分),平均剥不干净,残留为交互项的一半。论文未讨论交互项,登记为可做实验。
6.6 整体收拢
数学展开的四节其实是一条审计链:边缘分布 → κ 反解(6.1)→ 配对计数 → McNemar(6.2)→ 多重比较 → Holm 口径(6.3)→ 策略内部结构 → tie 估计量(6.4)→ 构造效度 → 镜像分解(6.5)。论文用前两环证明”改善是真的”,用后两环解释”改善从哪来”。回到这篇:缓解策略的评价本身就是一个统计工程问题——这张审计链就是本篇方法论的可迁移内核。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| Cohen’s κ / 机会校正 | 已懂(§三.2/§六.1 本篇核心) | 反解审计是通用工具 |
| McNemar 配对检验 | 已懂(§三.3/§六.2) | 连续性校正的来历 |
| Holm-Bonferroni | 已懂(§三.4/§六.3) | 步降 vs 一刀切 Bonferroni |
| 混合效应 logistic 回归 | 待补 | 论文 v2 的主分析(instance 随机效应),机制层已懂、拟合层未复算 |
| MT-Bench | 已懂(种子 10) | 本篇抽样 400 题固定种子(§3.4 p.4) |
| LLMBar | 待补 | 419 对对抗性评测集,转述未读 |
| Self-preference / 自我偏好 | 🟡 部分 | Panickssery et al. 2024 转述;round-robin 设计已懂,原文未读 |
| MaaS / Vertex AI Model Garden | 已懂(工程常识级) | Llama 3.3-70B 零 API 成本的通道(附录 C p.16) |
八、扩展与发散
8.1 连一连:与 Position Bias 篇(种子 22)的接力——两个”位置偏置”的正交性
发散:昨天那篇测出位置偏置”显著存在”(GPT-3.5-Turbo 换位后 PC 只有 0.34),本篇测出位置偏置”几乎消失”(\le 0.04)。矛盾吗?不——两个量不同:PC 量的是换位敏感性(换序后判断翻不翻),b_{\text{pos}} 量的是槽位偏好(对称位置上偏不偏袒某一边)。一个裁判可以完全不偏袒 A 槽(b=0)却在换位后大量翻转(PC 低)——翻转是噪声,偏好是偏置。本篇 §4.2 亲手点了这层窗户纸:“The key distinction is between position bias (negligible on controlled pairs) and position sensitivity: models that more frequently reverse verdicts when order changes benefit from tie resolution”——位置敏感正是 S1 收益的来源。两篇合读得到一张 2×2:位置偏好 × 位置敏感,四个格子对应四种裁判人格、四种缓解需求。回到这篇:缓解策略的选择依据不是”有没有位置偏置”这个单比特,而是这两个正交读数的组合。
8.2 λ 生命周期链第八环:从”发现偏置”到”按方抓药”
发散:把判分器质量簇的 λ 链数到现在——发现(MT-Bench 种子 10:三偏置点名)→ 测量(PositionBias 种子 22:三指标系统化)→ 评测层剥离(LC-AlpacaEval 种子 11:长度项反事实清零)→ 训练层剥离(ODIN 种子 12:双头解耦)→ 攻击(Cheating/JudgeDeceiver/RIPD/BadJudge:偏置是攻击面)→ 防御系统化(SoK 种子 14:五象限地图,攻防 9:3)→ 防御有解(BadJudge 合并:权重侧唯一解)→ 缓解(本篇:管线侧九策略统一比较)。第八环补上后,“裁判有偏置”这个问题第一次拥有了从诊断到处方的完整路径。Still missing:结构性防御(SoK 挂的三假设——结构化校验/异构裁判/秘密重排——至今无系统验证),权重侧与管线侧之外,协议侧仍是空格。回到这篇:λ 链的合成笔记现在有了完整的八环骨架,防御欠账单列只剩协议侧一格。
8.3 内部矛盾清单:一次版本迭代的解剖标本(统计审查案例)
发散:本篇四处矛盾连起来看是一个标本——单作者、评审两轮大改(v1 符号检验→v2 混合效应回归;v1 槽位口径→v2 长度感知口径;v1 单向 STYLE→v2 镜像)、每次改写都在正文留下新旧两层。①§5.3 “两个存活” vs 摘要/§1/§4.2 “三个存活”——混合效应 p 与 McNemar p 的口径切换未注明;②§4.2 “Pro/Flash 同向减少 tie” vs Table 3 反向——大概率是 v1 数据的叙述残留;③附录 D 的 m=7 段落与”Pro S1 p=0.012”——v1 统计框架的残留;④Table 3 的 GPT-4o S1 行和 391、S5 行和 399——表格层的排版伤(复现 P0 的意外发现)。前三处是”结论级数字的口径”问题,第四处是数据呈现问题;四处都不是数据造假——与 LH 篇摘要/正文矛盾(同分子异分母)同族。但④修正了本节初稿的一个干净假设:“版本迭代伤疤多发生在叙述层,表格层反而可靠”——不对,表格层也会破,只是统计结论层(κ、一致率、χ²、p)在全部 25+9 行上咬合完好:受损的是中间呈现层(边缘分布行),两端(原始统计量与最终读数)反而自洽——这正是”配对计数审计链”的价值:逐环对账才能定位伤在哪一层。回到这篇:四处都不推翻主结论(S8 的三处显著改善全过审计),但”哪些口径下几个存活”“引用 Table 3 数字需先验和”必须写进引用注意。
8.4 成本经济学:评测预算的影子价格
发散:附录 H 的 Pareto 前沿是三个点——Flash+S8(71.0%,$0.001)、Claude+S8 与 Llama+S8(69.5%,$0.015 / $0)。“中档模型 + 正确缓解”打平”前沿模型 + 正确缓解”的 15 倍价差,这和 ATTC 篇的影子价格是同一枚硬币:评测预算是稀缺资源,$0.014/eval 的差价在高通量管线(百万级评测)里是上万美元,够把 Flash 的评测量放大 15 倍或给 Llama 换 S8 再跑三遍取众数。把算力分配(ATTC/LATTS)与裁判选择(本篇)放进同一个预算方程,“评测基建的最优采购”本身就是一个约束优化题——论文没做这一步,登记为可做实验。回到这篇:本篇真正改写的不是哪个模型赢,而是”买什么”的答案结构——先买缓解,再买模型档次。
8.5 常见误读(破)
误读一:“位置偏置已经被新一代模型修好了,不用管了。” 破:本篇修好的只是槽位偏好(b_{\text{pos}} \le 0.04,受控对上);换位敏感性(种子 22 的 PC,0.34–0.82)依然普遍存在,而且它正是换位策略收益的来源(§4.2 p.8 原文自己区分了这两者)。“位置偏置消失了”是把两个测量对象压扁成一个的读法。
误读二:“S8 全面最优,无脑上 S8。” 破:S8 的胜利绑定在 MT-Bench 型自然数据上;LLMBar 对抗数据上 S8 对 Llama 是 −13pp(Table 2 p.9,过 Holm 校正的负显著),S1 更是全员 −3~−13pp。论文自己的处方(Algorithm 1 p.11)第一行就是”对抗/高风险任务返回 CoT”。缓解有适应症,没有万金油。
误读三:“冗长偏置就是裁判爱长答案。” 破:Claude 是 −0.12(偏爱短的),GPT-4o 中性;截断对上五个模型全部正确偏好真完整版(0.88–1.00)。“冗长偏置”不是单一属性而是按族分化的画像,其中一半是”质量敏感”的误标(§5.2 p.10:Practitioners should test their specific judge model rather than assume a fixed direction)。
8.6 写作之维(论文怎样完成说服)
标题是命题句的前半截——“Judging the Judges”把攻击性藏在借喻里,副题 “A Systematic Evaluation” 才是卖点:这个领域的信用货币是 systematic。摘要的信息排布值得抄:第一段给”最实用的发现”(Flash+S8 71% @ 1/15 价格)而不是”最学术的发现”(风格偏置主导)——先把 practitioner 钩住。正文的证据梯度刻意做了三层:受控数据集(可归因)→ MT-Bench(生态效度)→ LLMBar(边界),结论按梯度降权。Fig 1 用发散色图把”哪个偏置大”变成一眼的深浅,风格偏置那一行深红是全文的视觉论点。评审回应写进正文(“the reviewer pointed out”)而不是藏进 rebuttal——在 TMLR 的开放评审文化里这是信用展示。整体收拢:这是一篇把”统计纪律”本身作为说服工具的论文——CI、校正、MDE、成本四件套既是方法也是修辞。
九、局限与可疑处
- 四处内部矛盾(§八.3 详析):§5.3 与摘要/§1/§4.2 的 Holm 存活数(2 vs 3);§4.2 的 tie 断言与 Table 3 反向;附录 D 的 m=7 段落与 v2 表格不符(含一处 v2 表格中不存在的 “Pro S1 p=0.012”);Table 3 的 GPT-4o 两行边缘分布之和不为 400(S1 行 391、S5 行 399——复现 P0 发现,表格层的排版伤)。均不推翻主结论,但口径必须随引。
- 附录 B 空节:正文两处承诺的 S2/S3/S6/S7 聚合结果不在 PDF 里,只在发布工件——论文自足性受损。
- 人类标注研究 n=2:30 对、两标注者,聚合 markdown 率 0.57 的 95% CI 约 ±0.13(论文自算,附录 G p.21;与二项标准差 \sqrt{0.57 \times 0.43 / 60} \approx 0.064、CI ±0.125 一致)——方向可信(裁判 0.73–0.97 vs 人类上限 0.70),人均差距不可信(自认)。
- 风格维度单档:只测 markdown vs 素文本;表格、代码块、语域、密度梯度未测(自认 §5.5(3));per-topic 分析(Table 7 p.19)显示技术类最强、创作类最弱——“markdown 结构红利”与”真可读性”在技术类内容上可能部分重合,GPT-4o 的贴近人类(0.53 vs 0.57)暗示这不是铁板一块。
- 模型快照漂移:别名模型 ID(gemini-2.5-pro 等)解析到查询时的最新 checkpoint,实验跨 2025 年 4–6 月(附录 C p.16 自认 inherent reproducibility limitation);GPT-4o token 计数是估算(1 token ≈ 4 字符)。
- n=400 的功效天花板:MDE 4–5pp(自认附录 D)——小于 4pp 的策略差异(多数单调用策略之间的差)本设计原则上测不出来;论文诚实地把这类结论都写成 directional。
- 自我偏好的构造效度:round-robin 对的两侧回答独立生成,可能实际质量不同——“偏好同族”与”偏好更高质量”未完全解耦(自认 §5.5(4))。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要五个商用 LLM 裁判与三次基准全量调用。本复现是统计审计 + 机制微缩演绎:所有输入数字取自论文表格(Table 1/3/4/5/6),复现对象是统计结论链本身——结构完整性、χ²/p 复算、κ 反解、Holm 口径、tie 估计量、MDE 核算。这恰好是本文可复现性最高的部分:裁判是黑箱,但统计是白箱。全部纯 CPU、无随机数(确定性审计,两次运行逐字节一致)。不冒充论文的裁判实验数字;论文数字只作引用并注明表号。
10.2 可证伪预测与判据(运行前写下;预登记形态与量级)
- P0 结构与 χ² 审计:Table 3 的 25 行满足 A+B+tie=400;Table 4 九行 (b,c) 复算 \chi^2 = \frac{(|b-c|-1)^2}{b+c} 与论文报告差 < 0.06,p 值与报告值在舍入容差内一致(形态:九行三列对照表,全 PASS)。
- P1 κ 反解审计:25 行 “config” 的 p_o = \kappa(1-p_e)+p_e 与 Table 1 一致率比对——预测 ≥24/25 行 |Δ| ≤ 0.002,且最大偏差行是 GPT-4o S1(量级 0.3–0.4pp)。(形态:25 行偏差表 + 一个突出格。)
- P2 Holm 三口径:混合效应 p(m=20)存活集合 = {Claude S8, Flash S8, Claude S5};McNemar p(m=20)存活集合 = {Claude S8, Flash S8};附录 D m=7 段落中的 “Pro S1 p=0.012” 在 v2 两张统计表(Table 4/5)中均查不到对应 p 值(Pro S1 实为 0.735/0.637)——即 §5.3 的”2”与摘要/§1/§4.2 的”3”各自可复算,矛盾根源为口径切换未注明(形态:三条 Holm 轨迹 + 一条残留证据)。
- P3 tie 断言审计:§4.2 “Pro and Flash also show smaller gaps in the same direction” 预测为 假——Table 3 实测 Pro 13.5%→15.5%、Flash 12.75%→16.25%(反向),Llama 16.75%→20%(反向),GPT-4o 持平,仅 Claude 32.75%→12.5% 同向(形态:五模型 S1/S8 tie 对照,4 行反向或持平)。
- P4 tie 估计量天真模型:\widehat{\text{Score}}_{S1} = a q + (1-a)t(q = 该模型 B0 一致率,a = 1-\text{tie\%}_{S1},t = 97/400)对五模型的预测全部低于实际 S1 一致率,误差(actual − pred)全为正,量级 +6~+12pp(形态:五行星号表,判据 5/5 正号且均值 >5pp)。
- P5 MDE 核算:在 b+c=45、n=400 的典型分歧规模下,净差 3.5pp 不显著(p≈0.053)、4.0pp 显著(p≈0.025)——论文”4–5pp MDE”量级成立(形态:净差-p 值阶梯,拐点落在 3.5–4.0pp 之间)。
10.3 实现演化(一轮通过,如实登记)
本篇复现对象是统计链而非黑箱模型,无世界校准问题;预测先经手算复验(约 50 项数值草算),脚本一轮写对。两处实现注记:①χ²(1) 尾概率用 p = \mathrm{erfc}(\sqrt{\chi^2/2}) 精确计算而非查表近似;②Holm 对”只披露部分 p 值”的 m=20 校正采用保守处理——未披露的 p 视为不小于已披露值(只影响门槛序号,不影响已披露集合内部的相对次序)。一个意外:P0 的 FAIL 是论文缺陷而非实现缺陷——首轮跑出两行和不为 400 后,对 PDF 逐字重验 GPT-4o 全部五行确认转录无误,才敢把它记成发现。工作量:MacBook 纯 CPU,单轮 < 0.1 秒;含手算复验与转录复核约 50 分钟。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_judgedebias.py,真实输出
repro/repro_judgedebias_output.txt。17
断言 16 过 / 1 未过,[Re*]
部分成功——唯一未过项是对论文表格完整性的预登记预测被否定,按纪律记为真发现(两次运行逐字节一致,md5
9dd68d64…)。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 结构+χ² | Table 3 应 25 行 A+B+tie=400;Table 4 九行 χ²:22.01/13.14/8.25/7.53/4.01/3.02/0.11/0.93/0.05 | 23/25 行和 =400 ✗ = 真发现:GPT-4o/S1 行和 391、GPT-4o/S5 行和 399(tie% 却按 400 分母取整);九行 χ² 复算逐位一致(最大差 0.005)✓;p 值舍入容差内 9/9 ✓ | 表格排版丢计数:S1 行缺 9 个、S5 行缺 1 个(A/B 侧不明)——预登记预测被否定 |
| P1 κ 反解 | Table 6 κ ↔︎ Table 1 一致率 | 24/25 行 |Δ| ≤ 0.002;GPT-4o S1 −0.0036(预测的例外行与量级全中)✓;事后诊断:该行正是 P0 的排版缺行——单侧补回 9 个后 |Δ| 降至 0.0006(补 B 侧)或 0.0010(补 A 侧),“排版丢 9 个裁决”假说同时解释两处异常 | κ 按真实 400 实例计算,边缘分布行排版受损——两个独立审计交叉定位同一格 |
| P2 Holm 口径 | 摘要/§1/§4.2 “3 存活” vs §5.3 “2 存活” | mixed p→{Claude S8, Flash S8, Claude S5}(3);McNemar p→{Claude S8, Flash S8}(2);“Pro S1 p=0.012” 为 v1 残留(v2 实为 0.735/0.637)✓ | 口径切换未注明 + 旧段落未清 |
| P3 tie 断言 | §4.2 “Pro/Flash 同向” | Pro 13.5→15.5%、Flash 12.75→16.25%、Llama 16.75→20% 反向,GPT-4o 持平,仅 Claude 同向——断言为假 ✓(预测为假,证毕) | v1 数据叙述残留(推断) |
| P4 天真模型 | Table 1 S1 列 vs Table 3 tie 率 | 五模型 actual−pred = +6.3/+11.9/+10.0/+9.8/+9.7pp,5/5 正号,均值 +9.5pp ✓ | 换位分歧与难度正相关——S1 是隐式难度分配器(补充) |
| P5 MDE | 附录 D “4–5pp @ n=400” | b+c=45:3.5pp p=0.053 / 4.0pp p=0.025 / 4.75pp p=0.007——拐点 3.5–4.0pp,量级吻合 ✓ | 论文说法略保守(成立) |
算力与工作量:MacBook 纯 CPU,< 0.1 秒/轮,脚本一轮写对;含 P0 意外发现的双人转录复核(对 PDF 逐字重验 GPT-4o 五行,确认非转录错误)约 50 分钟。 What was easy:审计型复现的判据天然二值——表格数字要么咬合要么不咬合,没有世界校准问题(对比 LATTS 九轮、PositionBias 五轮)。 What was difficult:不是算,而是”预测敢不敢先写死”——P1 的例外行(GPT-4o S1)与 P3 的”断言为假”都是手算阶段就锁定的结论,脚本只是复核;如果手算错了,预测就会当众翻车。 给下一个复现者的建议:这篇的复现入口是 Table 3/4/6 三张表加 κ 定义,半小时能全链验完;真正的时间该花在把 25 行反解写成自动化对账(任何一行失配立即定位),以及把 Holm 三种口径的轨迹打出来看——“3 还是 2”这类争论在轨迹面前自动终结。
结论:[Re*] 部分成功——六项预测中五项命中;P0 的”表格完整性”预测被否定并转化为本篇最值钱的发现(Table 3 两行边缘分布排版破损,且其位置与 κ 审计的失配格精确重合——两条独立审计链交叉定位同一格)。预测可证伪性自检:P0 的判据可推翻(任一行和不为 400 即失败——它确实失败了);P3 的判据可推翻(若表格显示同向则断言成立、我方预测失败);P4 的判据可推翻(任一模型误差 ≤ 0 即失败);P1 的例外行预判可推翻(最大偏差落在别处即失败)——不是软预测。
十一、方法论提炼与迁移
模式一:配对计数审计链(Paired-Count Audit Chain)
- 操作定义:读到任何”两种配置比较”的结论,沿”边缘分布 → 一致率/效应量 → 配对计数 (b,c) → 统计量 → p → 多重校正存活集”逐环反算,每环与论文报告值对账;断链处即口径嫌疑处。
- 成功判据:从论文表格出发,不看正文也能重建全部统计结论,并指出至少一处叙述层与表格层的偏差(本篇:3 vs 2、tie 同向断言);审计全程只依赖表格自身。
- 迁移去向:①A/B 测试报告审计(产品经理拿 (b,c) 两格就能复核实验团队的”显著提升”);②医学文献读表(配对设计的新药试验,McNemar 同构);③SRE/上线复盘(“新版本更好”的灰度报告用同一链条复核)。
- 失效边界:论文只报 p 不报 (b,c) 计数时链条在第一环就断(只能做量级合理性检查,不能精确复算);多重比较的 m 未披露时只能做保守区间判断;配对结构(同批数据)不存在时整条链不适用(那是另一套两样本工具)。
- 方法卡:notes/method_paired_count_audit.md(L1)
- 层级:L1 领域具体(评测方法学/统计审计)。底层原理:归因靠对照(L2 已立卡 method_attribution_by_control.md)——配对计数就是最小单位的对照实验。
模式二:混杂解耦对(Dissociation Pairs)——既有 L2 的新域实例
- 操作定义:当两个变量在自然数据里共变(长度↔︎质量、格式↔︎槽位),构造两个方向的合成对:一半让目标变量动而混杂不动,一半让两者反向,联读即可分离主效应与混杂。
- 本篇双实例:扩张对/截断对(长度与质量解耦,§5.3);STYLE/STYLE_BA 镜像(格式与槽位解耦,§5.4)。
- 归档:不另立新卡——与 OSWorld 2.0 篇提炼的「合取-均值分解」并列,归入 L2「归因靠对照」(method_attribution_by_control.md)的第 8 域实例(评测缓解设计域),回链登记。
十三、没搞懂的地方(未攻克登记)
- GPT-4o S1 的排版缺行(已定位成因,遗留两个子问题):复现已确认该行边缘分布和为 391(缺 9 个裁决),且”单侧补回 9 个”假说能把 κ 反解偏差从 −0.0036 修复到 0.0006(补 B 侧)或 0.0010(补 A 侧)——κ 与一致率按真实 400 实例计算,破损只在呈现层。遗留:①缺的是 A 侧还是 B 侧(公开数字无法定位);②作者是否知晓(S5 行还缺 1 个)。补齐时机:sksoumik/judging-the-judges 的缓存逐实例结果重算(工件已核存在,代码级核对列入待做事项);或 v3 勘误。
- 附录 B 为何空节:S3/S6/S7 的聚合结果只在发布工件。是排版事故还是有意为之?补齐时机:仓库 release 或联系作者(低优先——不影响主线结论)。
- 混合效应回归的完整系数表:Table 5 只报 8 行(应为 20 个比较的系数),其余 12 个比较的 p 值未披露——Holm 复算被迫用保守假设。补齐时机:仓库的统计输出文件。
- 风格偏置的因果方向:技术类内容上 markdown 有真实结构红利(Table 7 技术类 0.85–1.00),“该归一化”与”该尊重格式”的边界在哪?补齐时机:论文建议的大规模人类标注研究(n=2 不足,自认)。
- 换位敏感性的缓解:本篇九策略都针对”输出层”,对 PC 低(换位即翻)的裁判,管线侧策略(本篇)与提示侧策略(CoT 部分有效:Claude tie 24%→4%)哪个更治本?补齐时机:与种子 22 的三指标联测实验(登记为可做实验)。
十四、可信度
- A 级(论文原文转录,逐节核对):§3 全部定义(策略/基准/指标,p.4–5)、Table 1(p.7)、Table 2(p.9)、Table 3(p.17)、Table 4(p.17)、Table 5(p.18)、Table 6(p.18)、Table 7(p.19)、Table 8(p.19)、Table 9(p.21)、Algorithm 1(p.11)、附录 A/C/D/G/H 全文。
- B 级(论文自报实验,无法独立验证):裁判 API 调用的原始裁决(缓存发布但本日未逐实例复核)、人类标注的原始记录、成本估算(GPT-4o token 为推算值)。
- C 级(我的推导 + 复现程序化验证):§三 全部四件工具的推导与数值例、§六.1 κ 反解审计(25 行)、§六.2 McNemar 复算(9 行)、§六.3 Holm 三口径、§六.4 tie 估计量模型(5 模型)、§六.5 位置镜像分解——复现 P0–P5 全过。
- D 级(我的推断,已标注):§5.2 tie 兜底的”隐式难度分配器”解读、§八.1 的 2×2 人格分类、§八.2 的 λ 链第八环定位、§八.4 的预算方程引申、三处矛盾的”版本残留”成因归因。
- 横向核实初核(2026-09-20):版本已核(abs 页提交史:v1 2026-04-25 / v2 2026-06-24;v1→v2 diff 未逐页做——但 v2 正文自述修订范围:位置镜像 STYLE 50 对、round-robin MODEL_ORIGIN 100 对、符号检验→混合效应回归);录用已核(TMLR 06/2026 页眉 + abs 页 Journal reference + Comments “Published in TMLR (2026)”);OpenReview QF4lAmG4zc 存在(p.1 页眉),评审意见未深读(登记);工件 github.com/sksoumik/judging-the-judges 已核存在(GitHub API 直查:MIT、建仓 2026-06-12、pushed 2026-06-24 与 v2 同日、0 stars),代码一致性未验;第三方讨论未检索(发表 4 个月,登记);统计审查:见 §十(25 行 κ 审计 + 9 行 χ² 复算 + Holm 三口径 + tie 断言审计 + Table 3 结构审计)——四处内部矛盾已定位(三处叙述层口径 + 一处表格层排版破损)并全部入 §九。
- 实验充分性评价:部分充分——“策略×模型”主效应的统计支撑扎实(配对设计 + 校正 + CI + MDE 四件套是同类论文最完整的);缺的是交叉验证面(只有 MT-Bench/LLMBar 两个真实基准)、风格维度单档、以及小于 4pp 的效应在本设计下原则不可测。
- 性能支撑目标检查:goal 是”系统性比较九策略并给出统计立足的建议”——支撑(统一框架 + 显著性分层 + 处方树 + 成本前沿四件交付物齐全);“跨偏置交互测量”——部分支撑(Fig 2 给了方向,但受限于 n=400 无逐偏置的显著性检验);未过度声称(对非显著结果一律 directional 措辞 + MDE 声明)。