外行导读(先读这个,再决定要不要进正文)
一个场景:你让 agent 帮你规划一次东京三日游。它调用大模型想计划、调用搜索引擎查机票、把结果写进对话历史、再调用大模型——某一步出了岔子,模型一直返回”我还要查”,于是这个循环永远不停:每一轮都烧 token、占模型服务、把对话历史撑得越来越大。代码里其实写着一个退出条件,但那个条件什么时候成立由模型说了算——它不停,条件就永远不满足。这不是假设:一篇 8 页的论文在 6,549 个真实开源 agent 项目里扫出了 68 个这样的缺陷,精确率 91.9%。
这篇论文干的事:给这类故障命名(Infinite Agentic Loop,IAL)并给出静态检测方案 IAL-Scan。三步:①把千奇百怪的框架代码归一成一套与框架无关的中间表示(Agent IR——模型调用、工具分发、状态更新、边界这些概念,在 LangChain/LangGraph/AutoGen/CrewAI 等八个框架里长得完全不同);②在中间表示上建一张”智能体环依赖图”(ALDG),把显式循环和框架 API 造成的隐式反馈路径都恢复出来;③在图上做强连通分量(SCC)分析找到候选环,然后问两个问题:这个环的继续执行由谁控制?有没有一条有效边界支配整条路径?判定规则一句话:有效边界 = 确定性守卫,且作用域覆盖反馈路径上的全部节点——内层循环的 max_tool_calls 管不住外层的反馈环。
为什么值得关心:这是执行侧”停止规则”欠账的正主。此前六篇旁证各自摸到了这条线的一角——LongHorizon 的”审计通道换掉自报通道”、Dr. GRPO 的”Aha 信号与止损非正相关”、SimpleTIR 的一票否决停、DAPO 的超长软罚、ToolVerse 的解锁门、Cordis 的守卫式撤销——这篇把它们的共同骨架抽了出来:看得见的退出 ≠ 能停;能停 = 确定性控制权 + 作用域支配。六篇的”模型自报不可信、确定性边界才可信”直觉,在这里变成了一个可以静态检查的性质。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| IAL(Infinite Agentic Loop) | 无限智能体循环:反馈路径无有效边界地反复触发高代价动作 |
| 反馈路径(feedback path) | 模型输出 → 状态更新 → 回到模型的那条回路(不一定有显式 for/while) |
| Agent IR | 与框架无关的中间表示:把八个框架的 API 都翻译成同一套执行概念 |
| ALDG | 智能体环依赖图:IR 事实建成的有向属性图,环分析在上面做 |
| SCC(强连通分量) | 图里互相可达的节点团——非平凡 SCC 就是候选反馈环 |
| 控制器(controller) | 决定环继续还是退出的节点;按守卫来源分六类 |
| guard source(守卫来源) | 退出条件的控制权在谁手里:确定性代码/模型输出/工具结果/异常/外部状态 |
| 有效边界(effective bound) | 能真停住的机制:确定性守卫 + 作用域支配整条反馈路径 |
| model_dependent_exit | 模型依赖退出:代码里看得见、但触发权在模型手里的退出条件 |
| BoundStatus | 边界状态五档:弱化版 = missing / weak / disabled / ineffective / bypassed |
| LLM-assisted pruning | 大模型辅助剪枝:LLM 只当”负向过滤器”剔除明显误报,不当判决者 |
§0 承接栏
这颗种子补的是此前知识版图上悬着的「停止规则」缺口:此前六篇(ToolVerse 解锁门、MT-GRPO 崩溃、SimpleTIR 一票否决、DAPO 软罚、Dr. GRPO 止损信号、Cordis 守卫)各自摸到了它的一角,一直缺一篇把停止规则当一等研究对象的论文。IAL 论文恰好从静态分析侧给出了统一框架:六篇各自的”停”机制都能映射到它的边界分类学上。同时它是执行侧线的第三颗(前两颗讲「运行时怎么组织」,本颗讲「什么时候必须停」)。
一、论文在解决什么问题
1.1 一个具体场景
§I 开篇的失败模式:agent 反复执行模型调用、工具、工作流转换或 agent 交接,因为反馈路径未被有效约束。后果四种——成本耗尽、模型拒绝服务、上下文膨胀、重复外部副作用(摘要 p.1)。主流框架都有边界机制:LangChain 的 max_iterations、LangGraph 的 recursion_limit、OpenAI Agents SDK 的 max_turns(超限抛 MaxTurnsExceeded)、CrewAI 的 max_iter(§II-A p.1–2)。但机制存在 ≠ 风险消失:开发者可能不写、写错、配置了无效值,或者把边界放在反馈路径之外(§I p.1)。社区issue里已有真实翻车记录:CrewAI 的 delegation 无限循环(引用 [4])、LangGraph 多智能体循环到撞 recursion_limit(引用 [14])。
1.2 与”普通死循环”的三点不同
IAL 不是普通编程死循环(§I p.1):它产生于 agent
逻辑、框架语义、运行时观测与终止机制的交互——环可以由显式循环构成,也可以由递归调用、工作流环、重试逻辑、工具重入、多智能体委托构成。最阴险的一类:代码里写着退出条件,但条件是否成立由模型输出决定——bisheng
案例的 finish_reason != "tool_calls"
就是这种,论文给它专门的名字:模型依赖退出(model-dependent
exit,§IV-C p.5)——看得见,停不住。
1.3 与簇内入口差
LongHorizon 篇立了”完成判定从自报通道换到审计通道”——IAL 论文在工程侧给了同一个命题的静态版本:模型依赖退出 = 自报通道,确定性边界 = 审计通道。区别在判定对象:LH 判”任务完成没有”(运行时),IAL 判”这条路径能不能停”(部署前)。Dr. GRPO 篇发现”Aha 时刻与真正止损非正相关”——那是模型控制退出的统计证据;IAL 把这类退出直接归类为非边界。两篇相隔两千里,说的是同一件事。
二、核心想法
一句话:环不可怕,可怕的是反馈路径上没有有效边界;而”有效”是可判定的——确定性守卫支配整条路径。退出条件的控制权在谁手里(六分类),比退出条件是否存在重要得多。
直觉先打底。游乐园的过山车安全不安全,不取决于车上有没有刹车把手(乘客拧不动等于没有),而取决于控制室的制动器是否覆盖整条轨道。bisheng
案例里,那个 finish_reason
条件就是乘客手里的刹车把手:它写在代码里、看起来像个边界,但触发权在模型(乘客)手里。IAL-Scan
做的事就是把每条轨道检查一遍:制动器在控制室吗?它管的路段覆盖这条轨道全程吗?
全篇就看这张:图 91(§5.2)——Agent IR → ALDG → SCC → 边界覆盖的完整判定链,加上贯穿示例的图形态。
先猜一个数:静态分析在 6,549 个仓库里报出 74 个候选,人工审查后确认了多少个真缺陷?给个精度百分比再往下读。答案:68/74 = 91.9%(§V-B p.6)——静态分析工具做到九成精度是罕见的,靠的是三道前置过滤(资格筛选、无害环剔除、边界覆盖检查),LLM 只负责最后的负向剪枝。
形式化入口(§三 详推):判定式一句话——\text{effective}(b) \iff \text{deterministic}(b.\text{guard}) \wedge b.\text{scope} \supseteq \text{path}。
落到与 LH 的对读:LH 的链式任务里一个假完成被后续步骤当前提、一错错一串——那是”该停没停”的信息层后果;IAL 是同一件事的资源层后果(烧钱、占服务)。两个合起来才是”停止规则”的完整账:停错的代价分两路,一路错进状态(LH),一路烧掉预算(IAL)。
三、数学基础(零起点,本篇新用到的两件;发明式讲法)
3.1 第一件:边界覆盖判定——“能停”怎么变成一个可检查的性质
先摆问题。你说”这个 agent 循环停不下来”——“停不下来”怎么变成部署前就能静态检查的条件?
候选方案摆出来,让不合格的先死:
- 方案 A:查有没有循环语法(for/while)。 死于:agent 的环大多不写在循环语法里——Table II 显示 68 例确认失败中 LangGraph + AutoGen 占 66.2%(p.6 Table II),两者的环都由 API 编码(add_edge/add_conditional_edges/GroupChat/initiate_chat),源码里根本没有 loop 关键字(§V-B p.6)。语法查不到它们。
- 方案 B:查有没有退出条件。 死于:bisheng
案例有退出条件(
finish_reason != "tool_calls"时返回),照样无限循环——条件是否触发由模型决定。可见的退出 ≠ 能停。 - 方案 C:查有没有边界参数(max_iterations 之类)。 死于两处:①边界可能存在但作用域不对——内层工具环的 max_tool_calls=2 管不住外层评估器反馈环(§IV-C p.5,论文挑战 3);②边界可能弱——守卫变量是模型自己写的计数器,等于乘客拧刹车。FP 分析(§V-C p.7)还给出第三处:六个误报全部是”真有反馈路径,但边界间接/依赖框架配置”——边界检查必须区分强边界与配置依赖边界。
约束列出:①对无显式语法的框架环有效;②区分退出的控制权;③检查覆盖而非存在。同时满足三条的判定:
\text{effective}(b,\,P) \iff \text{deterministic}(b.\text{guard}) \wedge b.\text{scope} \supseteq P
其中 b 是一个边界机制,P 是候选反馈路径上的全部节点集合。左边读作”边界 b 对路径 P 有效”;右边两个合取支:守卫来源是确定性代码(不是模型/工具/异常/外部状态),且边界的作用域包含路径上每一个节点。
名字最后给:论文管这个检查叫 bound coverage(边界覆盖,§IV-C p.5;Listing 3 给出状态分类:强边界 verified_bound / 框架默认边界 / 配置依赖边界;弱化的四档 = missing / weak / disabled / ineffective / bypassed)。
配对判定是控制器分类。环的继续执行由谁控制?论文分六类(§IV-C p.5):deterministic(确定性代码)、model-controlled(模型输出)、tool-controlled(工具结果)、external-state-controlled(远程状态)、exception-controlled(异常路径)、mixed(混合)。分类为什么重要:可见的退出条件在模型控制下不构成停止机制——这是整个 IAL 定义区别于普通死循环的关键一刀(§IV-C p.5)。
数值例(贯穿示例):bisheng 的外层环 P
= \{C_0, X_0, X_1, S_0,
S_1\}(循环、模型调用、工具分发、两次状态追加)。它有一个退出记录
T_0,守卫来源 = 模型控制 → 分类为
model-dependent exit,不算边界;也没有任何
max_iterations 之类的边界节点指向 C_0。判定:\text{Bound}(P) = \emptyset →
missing_bound → 报 IAL。加上一行 max_iterations=20
且作用域盖住五个节点后,同样的图判定为 covered → 不报。复现 P0/P3
分别重演这两步。
节末钩子:判定式有了,但”路径”和”作用域”得先有个地方放——答案是图。
3.2 第二件:ALDG 上的环发现——SCC 为什么是正确的刀
先摆问题。反馈路径分散在控制流边、调用边、框架转换边里,怎么机械地找出”能重复执行”的区域?
候选方案:①逐个 loop 语句分析——死于方案 A 同款(框架环无语法);②运行时追踪——死于静态分析定位(部署前)与路径爆炸;③把”可能参与重复执行的边”组成图,找强连通分量(SCC)——互相可达的节点团天然就是”能反复经过”的区域。论文 Algorithm 1(p.5):先保留控制流、调用、框架转换、工具分发、反馈回边五类边,剔除退出边与边界属性(它们描述停止而非重复——这个设计是复现第一版误设的根源,§十 详记),然后在环子图上算 SCC,保留非平凡分量(节点数 >1 或含自环)作为候选。
候选还要过资格筛:从 agent 入口可达(不分析死代码)、环内触达高代价调用或状态增长(无害环——分页、流消费、解析器、生命周期环——被这条与显式的良性过滤一起剔除,§IV-C p.5)。SCC 是图论标准工具,本篇的新意在边的选法:哪些边允许进环子图,决定了”重复”的定义。
节末钩子:环找到了、边界查过了,剩下的问题是——这套机器在真实世界里抓到什么?
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| G_A=(V_A,E_A,\alpha) | ALDG:节点、边、属性 | §IV-B Fig 4 |
| r,\ v_r | Agent IR 事实 / 它在 ALDG 里的节点 | §IV-B |
| C,\ I_{cost},\ S_{grow} | 控制器 / 高代价调用 / 状态增长更新 | §IV-B Fig 4 |
| \text{Feedback}(c) | 控制器 c 的环上反馈边种类 ∪ 守卫来源 | §IV-B Fig 4 |
| \text{Cost}(c),\ \text{Growth}(c) | 环体内高代价种类 / 是否状态增长 | §IV-B Fig 4 |
| \text{Bound}(c) | 约束 c 或其作用域的边界集合 | §IV-B Fig 4 |
| guard_source | 守卫来源六分类 | §IV-C |
| BoundStatus | covered / missing / weak / disabled / ineffective / bypassed | §IV-C Listing 3 |
| \Pi_L,\ \Theta_L | 候选 L 的性质集 / 拓扑集 | Algorithm 1 |
| ACC/精度 | 人工确认 68 / 报警 74 = 91.9% | §V-B |
五、机制
5.1 机制一:Agent IR——把八个框架翻译成一种话(§IV-A)
【类比 · 通关文牒】 八个框架像八个国家,同一个动作(“调模型”)有八种写法:AgentExecutor.invoke、Runner.run、GroupChat……IAL-Scan 先发一本通关文牒(Agent IR):所有动作翻译成六种事实(ExecutionUnit 执行域 / Controller 控制器 / Invocation 调用 / StateUpdate 状态更新 / Bound 边界 / ExitRecord 退出记录)加九种关系(owns/calls/updates/guards/exits/constrains/transitions/dispatches/aliases,§IV-A p.4 Listing 1)。翻译规则来自框架行为建模:LangGraph 的 add_edge 变成 workflow transition、OpenAI SDK 的 handoff 变成 reentry relation、CrewAI 的委托变成 agent 执行关系(§IV-A p.4)。
为什么必须先翻译:Table I(p.2)给出同一行为在不同框架的形态对照——模型调用、续行控制、工具分发、状态更新、边界五要素在每个框架的 API 名完全不同,而IAL 的判定要素(谁控制续行、边界盖不盖得住)在翻译之后才可见。消融数据(Table III p.7):去掉框架建模,静态候选从 340 涨到 910、报警从 74 涨到 276、真阳性覆盖从 68 掉到 61——没有通关文牒,既漏报又误报。
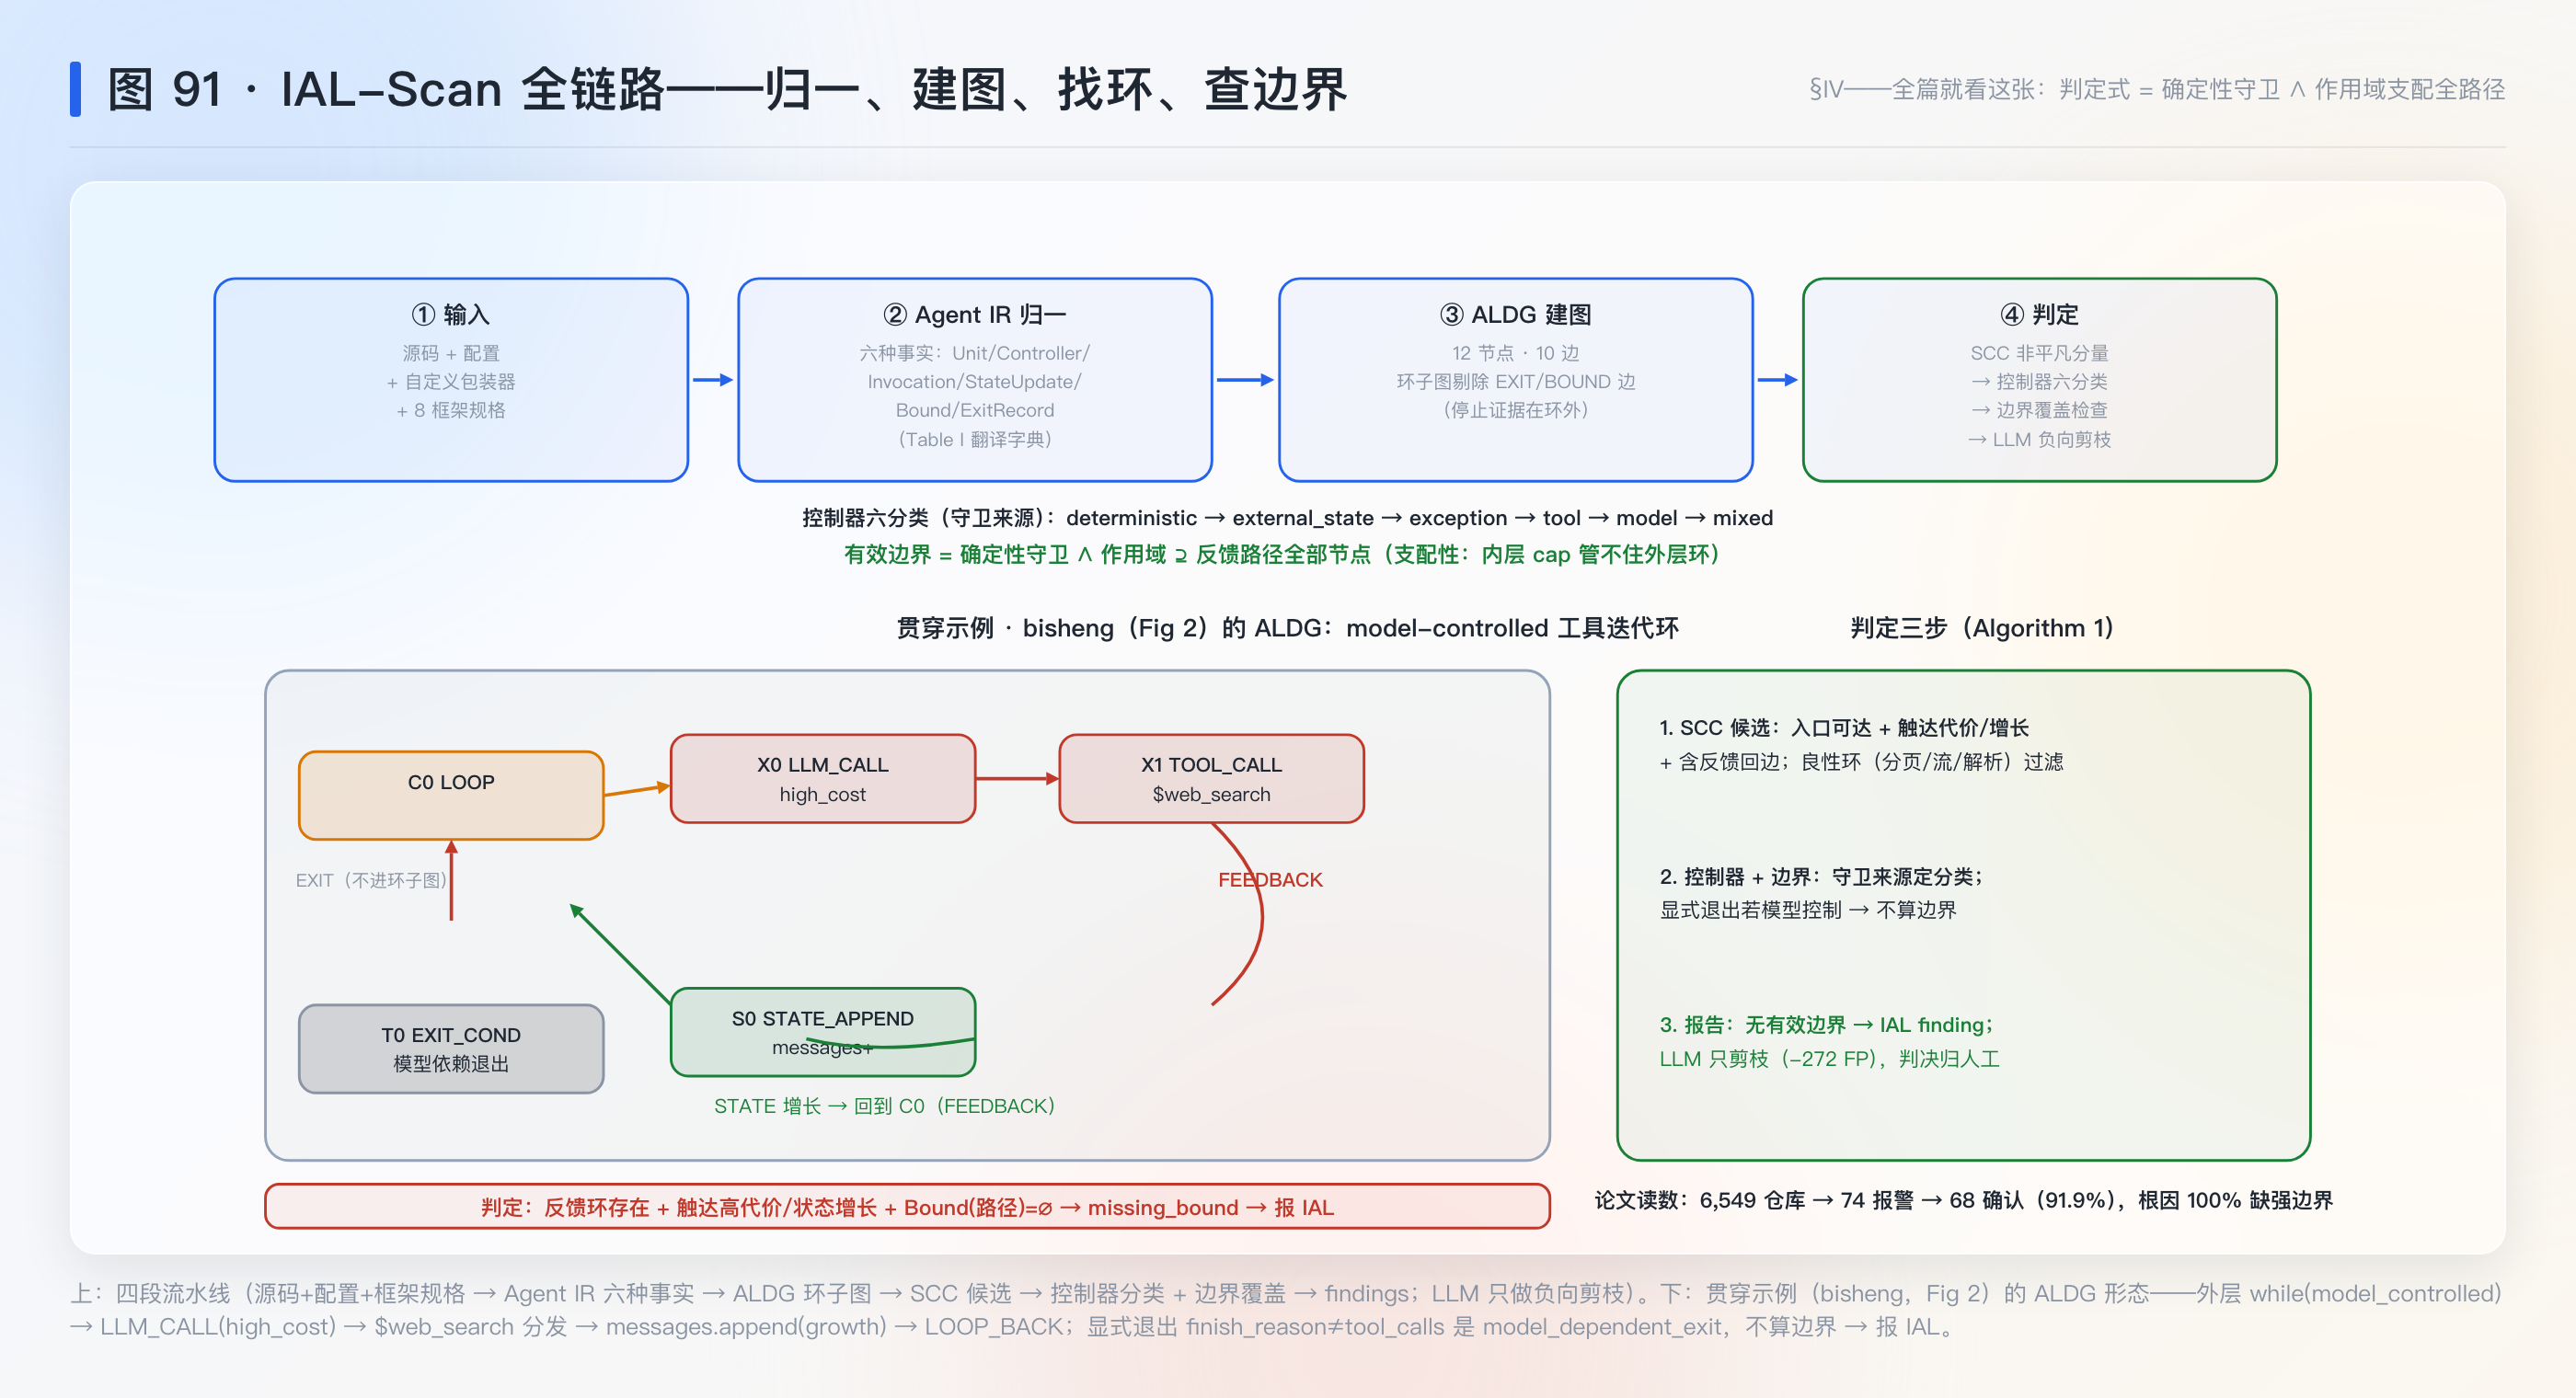
5.2 机制二:ALDG 与判定三步(§IV-B–C)
ALDG 只保留与环行为有关的事实(控制器、高代价调用、状态增长、执行域),12 种节点、10 种边。对每个控制器 c 注记四个环性质(Fig 4 p.4):Feedback(回边与守卫来源)、Cost(环体高代价)、Growth(状态增长)、Bound(候选边界)。判定三步(Algorithm 1 p.5):
- SCC 候选:环子图(去退出/边界边)上取非平凡 SCC,入口可达、触达代价或增长、含反馈回边者入选;良性环(分页/流/解析/生命周期/测试)显式过滤。
- 控制器 + 边界:选续行控制器,按守卫来源六分类;检查每个候选边界的守卫确定性与作用域支配性 → covered / missing / weak 三态。
- 报告:有反馈路径 + 触达高代价或增长 + 无有效边界 → IAL finding;置信度随模型控制续行、重复工具执行、状态增长上升,随确定性退出存在而下降。
贯穿示例的图形态(Fig 5 p.5):N_1(LOOP) → N_2(LLM_CALL, high_cost) → LOOP_BACK 回 N_1;N_5/N_6(STATE_APPEND, state_growth);显式退出 N_3 被标注为 CONDITIONAL_FALSE 且不计入边界(依赖模型输出)。
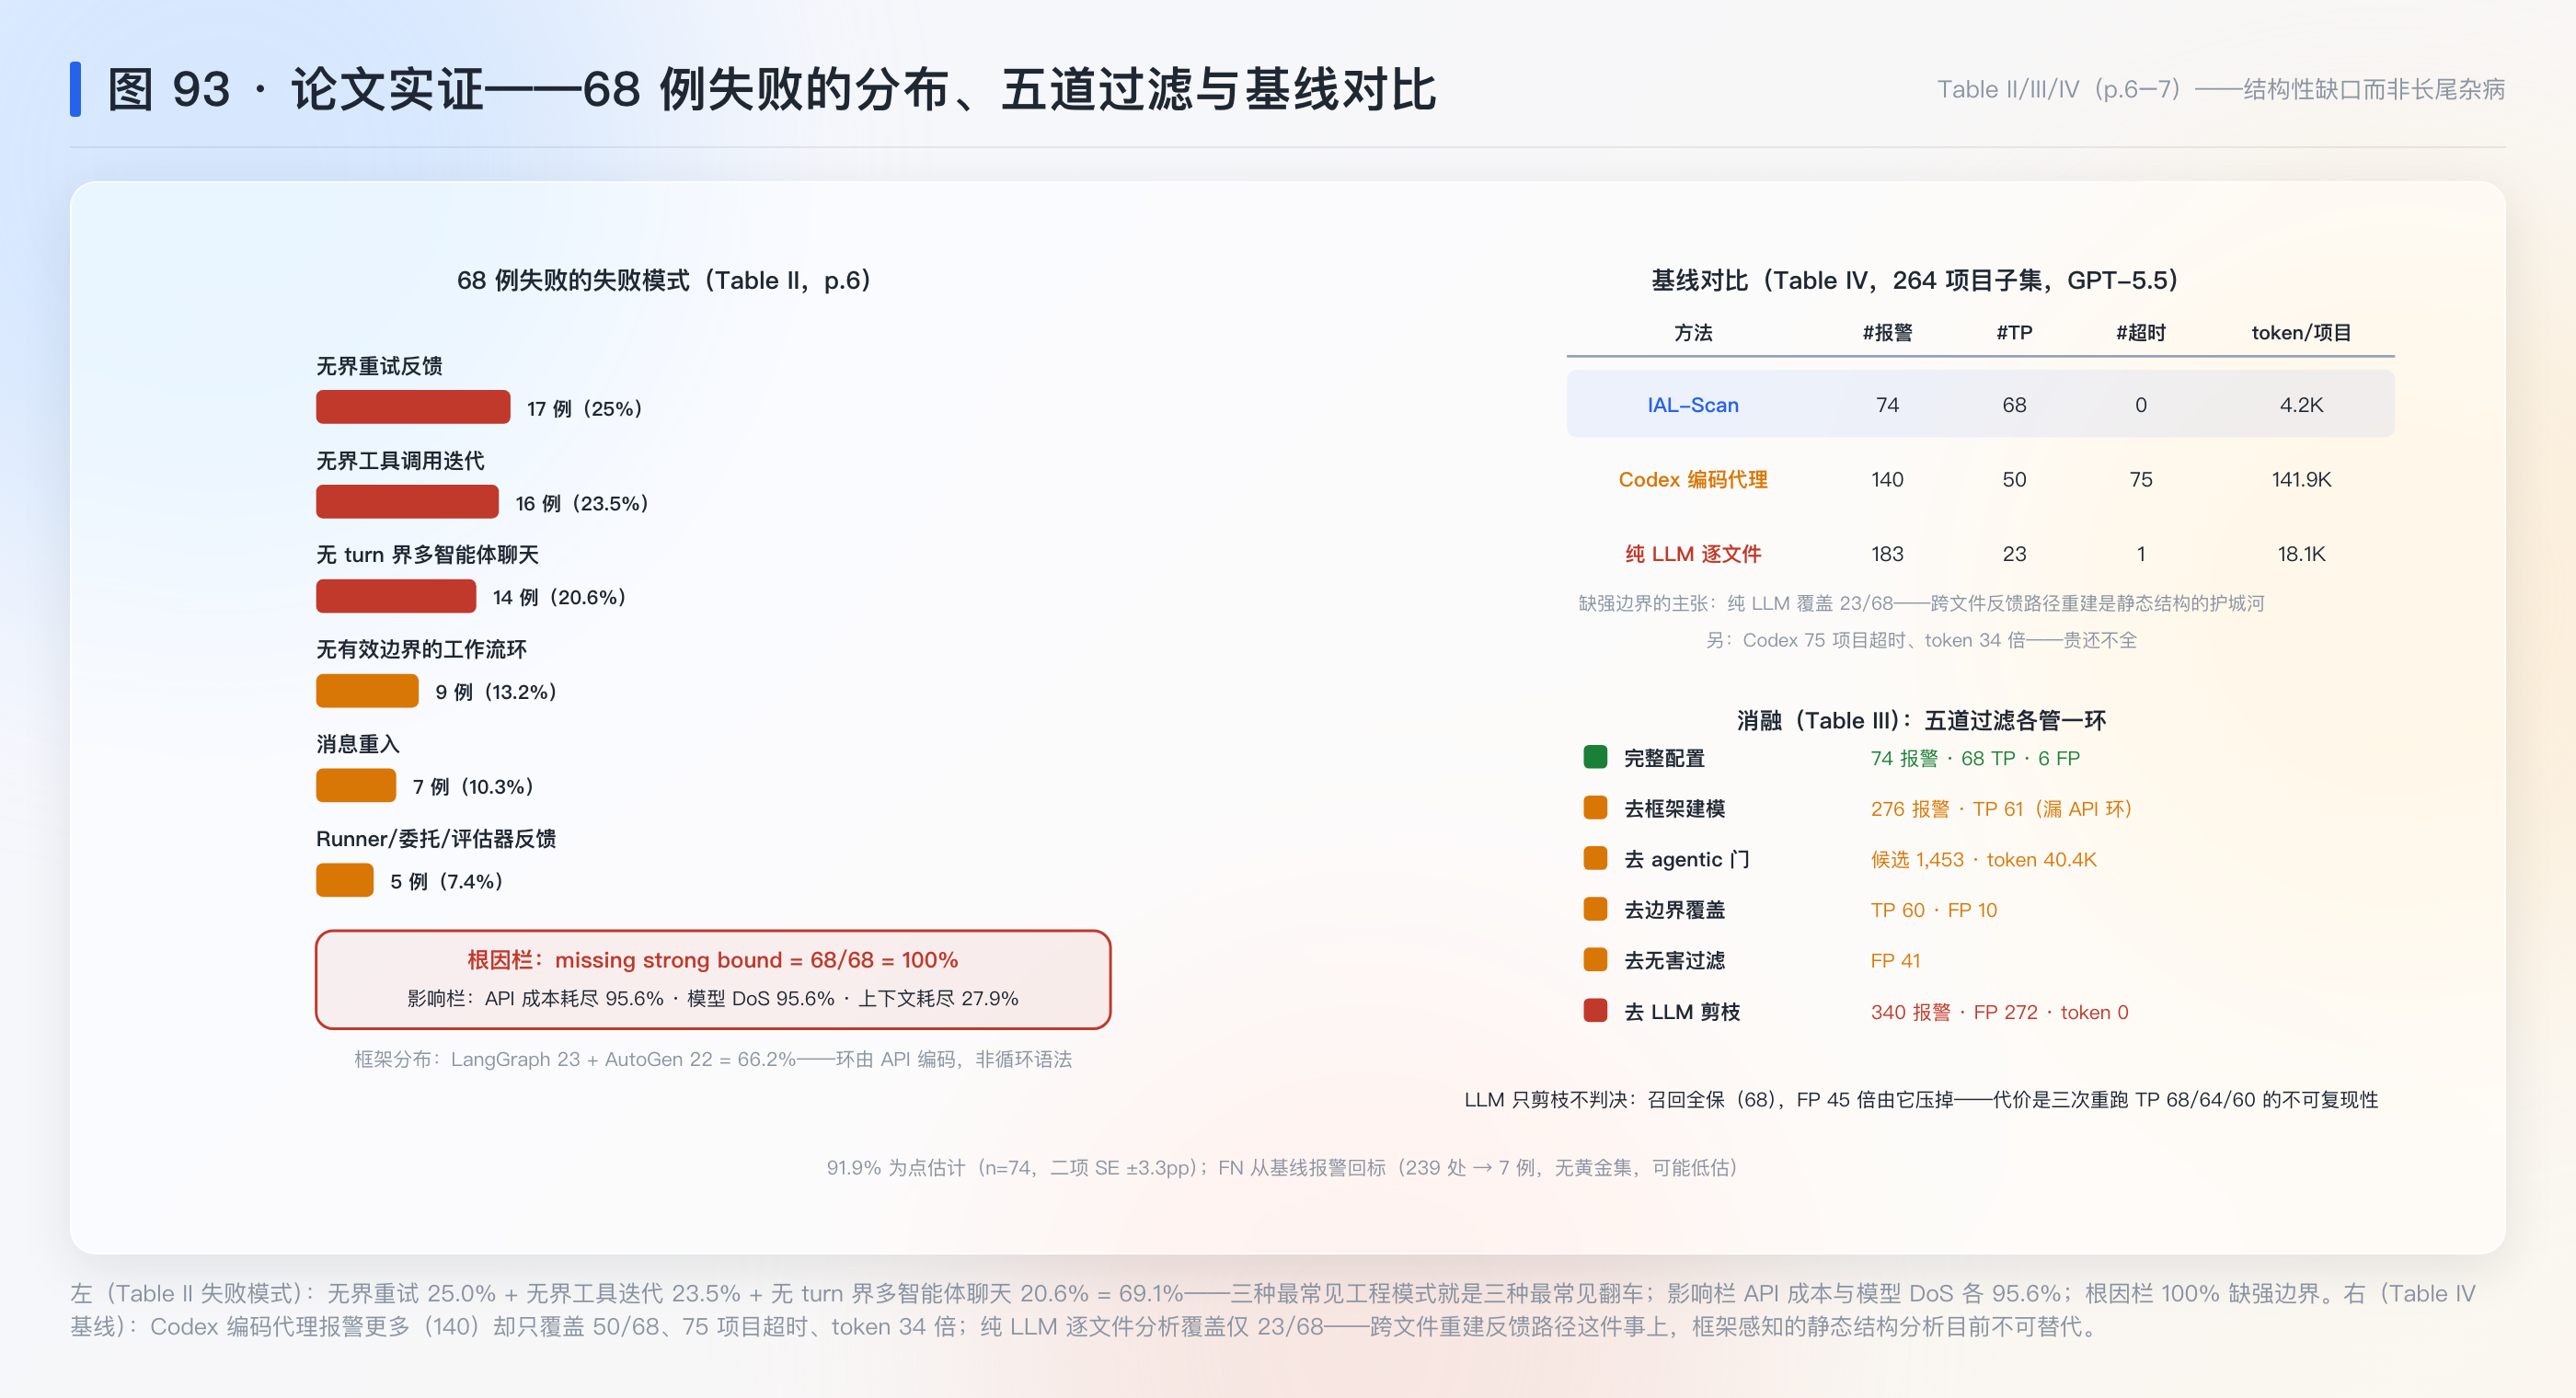
5.3 机制三:主结果——68 例失败的分布学(§V-B,Table II p.6)
6,549 仓库 → 340 静态候选(264 项目)→ 74 报警 → 68 确认 / 6 误报,精度 91.9%。分布四个维度:
- 框架:LangGraph 23(33.8%)+ AutoGen 22(32.4%)= 66.2%——两个最流行的框架贡献三分之二,且它们的环都由 API 编码而非循环语法。
- 失败模式:无界重试反馈 17(25.0%)+ 无界工具调用迭代 16(23.5%)+ 无 turn 边界的多智能体聊天 14(20.6%)= 69.1%——三种最常见的工程模式就是三种最常见的翻车方式。
- 影响:API 成本耗尽 95.6%、模型拒绝服务 95.6%(两者伴随)、上下文窗口耗尽 27.9%。
- 根因:缺强边界 68/68 = 100%。全部分享同一个根因,这是”结构性缺口而非长尾杂病”的直接证据。
先猜第二个数:把 IAL-Scan 换成”让 Codex 编码代理读整个仓库找这类问题”,你觉得它能抓住 68 例里的多少?提示:它报警更多。答案:50 例(Table IV p.7),报警 140 条、平均每项目烧 141.9K token、75 个项目超时;纯 LLM API 逐文件分析更惨——23 例、183 条报警。静态结构分析在”需要跨文件重建反馈路径”这件事上是 LLM 现阶段替代不了的。
5.4 机制四:两个 case 的解剖(§V-B p.6)
LiteRAG 重试环(Fig 6):嵌套
while not success 反复向 LLM 要计划;解析异常在 except
里被静默吞掉(L12–13),被拒绝的计划把 success 重置 False(L20–21)→
回到同一个 LLM 调用。无重试上限、无超时、无 token
预算。畸形或反复被拒的模型输出 → 无限重试。这是 exception-controlled
控制器的标本:异常本该是确定性的,吞掉异常的 except
把控制权让给了”模型什么时候肯输出能解析的东西”。
ai-virtual-assistant 工具迭代环(Fig
7):while True
绑定工具调用模型;模型输出为空或畸形时追加一条纠正提示(“Respond
with a real output.”)进状态再重试——模型输出 → 状态增长 →
回到模型。纠正提示让环更顽固:模型越答不好,喂给它的历史越长。
最值钱的实验:Table III 消融(p.7)——五个组件逐个拆:去框架建模(候选 340→910、报警 74→276、TP 68→61)、去 agentic 门(候选→1,453、token 4.2K→40.4K)、去边界覆盖(TP→60、FP→10)、去无害过滤(FP 6→41)、去 LLM 剪枝(报警 74→340、FP→272 但 token 归零耗时 3.8s)。它单独撑起主贡献的哪一块:证明 91.9% 精度不是单一组件的功劳,而是五个各管一环的过滤器的交集——特别是”LLM 只剪枝不判决”这个分工:去掉剪枝,召回不变(68 全保)、误报爆炸 45 倍;这给”LLM 参与静态分析”立了一个可抄的分工模板。
六、数学展开
6.1 接 §三 3.1:支配性为什么必须是合取支
边界覆盖判定的第二个合取支 b.\text{scope} \supseteq P(作用域支配)看起来多余——边界存在且确定性,为什么不判有效?Case C(复现 P2)给出反例:外层评估器反馈环 \{C_{out}, X_0, X_1, S_0\} 无界;内层工具环 \{C_{in}, X_2\} 有 max_tool_calls=2。内层边界 b 的作用域 = \{C_{in}, X_2\},b.\text{scope} \nsupseteq P_{outer} → 外层仍判 missing_bound。直觉版:内层的闸门关得再紧,水可以从外层的河道流。论文 FP 分析(§V-C p.7)从另一头印证:六个误报全是”边界其实在,只是作用域间接/依赖框架默认配置”——支配性检查松一点,FP 就从这里进来。
推导所用规则:①集合包含定义支配;②边界有效性对”路径”量化——同一边界对不同路径有效性不同(所以判定式必须带路径参数);③环子图删边规则(退出/边界边不进环)保证 SCC 描述”重复”而非”停止”。
6.2 控制器六分类的谱系:退出控制权的光谱
六分类不是并列的,按”离确定性的距离”排一个谱:deterministic(代码比较器)→ external-state(远程状态,可复现查询)→ exception(异常路径,取决于输入是否触发 bug)→ tool-controlled(工具结果)→ model-controlled(模型自由输出)→ 混合。越靠后,“退出条件存在”与”会退出”的距离越远。论文 Table II 的根因分布给出实证侧面:tool-controlled retry 41.2%、model-controlled termination 38.2%——确认失败里控制权在运行时输出手里的占绝对主导。补充:这个谱系是可迁移的判定工具——任何循环系统(训练循环、CI 重试、消息队列消费)的”会不会停”问题,第一步都是给退出控制权定位。
6.3 六篇旁证的汇合:STOP 节点收口(连一连)
把依赖图 STOP 节点的此前六篇的停止机制放到 IAL 的分类学上,各自归位:
| 旁证 | 它的”停”机制 | IAL 分类学位置 |
|---|---|---|
| LongHorizon(审计通道) | 只有环境验证过的事实进状态 | 确定性守卫;模型自报 = model_dependent_exit |
| Dr. GRPO(Aha 非正相关) | “顿悟”与真止损非正相关 | model-controlled 退出的统计证据——可见条件停不住 |
| SimpleTIR(void 一票否决) | 整轨弃权消梯度尖峰 | deterministic 边界(显式停机规则) |
| DAPO(超长软罚 ramp) | 越界软刹车 | 边界(预算型),且是”传播到反馈路径”的正面教材 |
| ToolVerse(解锁门) | 依赖图逐级解锁 | 确定性守卫支配路径(门=作用域全覆盖的边界) |
| Cordis(守卫撤销) | 还有活组件指着就不许撤 | 边界的作用域检查(守卫=支配性判定的运行时版) |
六篇各自发明了一个停止机制,IAL 论文证明这些机制可以按两个正交轴(守卫来源 × 作用域支配)统一编目。补充:这正是 STOP 节点从”散点旁证”升级为”可合成知识”的标志——此后的执行侧停止规则专题笔记,分类学骨架已经有了。
6.4 LLM 剪枝的分工界线(§V-C–D)
Table III 的 w/o LLM Pruning 行:报警 340(召回 68 全保)、FP 272、token 0、耗时 3.8s——静态阶段便宜、高召回、不精确。Table V 重跑三次:静态候选 340/340/340 完全可复现,LLM 剪枝后 74/73/70、TP 覆盖 68/64/60——变化全部来自 LLM 层。Table VI 换模型:gpt-5.5 剪到 74 报警保 68 TP;gpt-5.4-mini 保 136 报警只覆盖 41 TP——“保留更多候选不等于覆盖更高”。补充:这三张表合起来给出 LLM 参与静态分析的分工定律——LLM 放在剪枝位,代价是引入不可复现性(论文用”LLM 只当负向过滤器 + 结果以人工复审为准”来控制);放在判决位,代价是 FP 爆炸。这一定律直接适用于任何”静态规则 + LLM 过滤”的管线设计。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| SCC / Tarjan 环发现 | 已懂(§三 3.2/§六.1;复现实现) | 图论标准工具;本篇新意在环子图的边选法 |
| 反馈路径 / 控制流分析 | 已懂(本篇机制层) | 跨 wrapper 重建控制/调用/状态关系;全程序指针分析未用(轻量名字解析) |
| 框架语义建模 | 已懂(§5.1) | LangGraph/AutoGen 的 API 环;文档级规则表 |
| verify-retry 最优停止 | 部分(本篇补静态侧) | 动态侧(运行时该重试几次的最优停止)仍缺——STOP 节点剩余欠账 |
| AgentProof / Agent Audit 等同类分析 | 待补 | 论文 related work(§II-B)五篇,均转述未读 |
| 边界支配性(程序分析) | 待补 | 与编译器的支配树(dominator tree)关系值得对照 |
八、扩展与发散
8.1 执行侧线的第三块拼图
发散:执行侧 01/02 讲”状态怎么组织、验证怎么做”(运行时架构),本篇讲”什么时候必须停”(部署前检查)。三颗合起来是一个 harness 生命周期的三段:组织状态 → 验证事实 → 约束循环。第三段在此前六篇旁证里一直是散点(训练侧的停、运行时的门、评测的否决),IAL 给了它独立的论文锚点。回到这篇:执行侧的下一段自然是”动态侧的最优停止”——部署前知道路径有界,运行时还想知道”预算内停在哪最优”,那是 verify-retry 节点剩余的欠账。
8.2 连一连:自报通道的第三张面孔
发散:LH 立命题(自报完成不可信,审计通道换掉它)→ DG 给统计证据(Aha 与真止损非正相关——模型说”我懂了”不可信)→ 本篇给工程分类(model-dependent exit 不算边界)。三篇合读,“模型自报”在三个层面被同一把尺子打回:任务完成层(LH)、训练信号层(DG)、程序终止层(IAL)。共同原理:凡控制权在模型手里的”条件”,只能当证据,不能当边界。回到这篇:这个原理可以直接落成代码评审清单——review agent 代码时,每个 while/exit 条件问一句”谁控制它”。
8.3 与判分器线的暗线:成本攻击的另一半
发散:判分器质量簇九月的攻击线(Cheating/JudgeDeceiver)讲”别人骗裁判花你的算力”;IAL 讲”你自己的 agent 烧你的算力”——一个外因一个内因,后果同栏(成本耗尽+服务占用,JDEC 的 case study 与 Table II 影响栏几乎同词)。区别在防御形态:外因攻击要协议层防御(评测方做),内因缺陷要工程防御(开发者做)。IAL 的开发者清单(§VI-A p.7):turn/step 上限、重试路径带 cap 与超时、消息历史与状态带大小限制——三条全是确定性边界。回到这篇:两条线在”成本”处汇合,说明预算治理是评测与执行共享的基础设施。
8.4 常见误读(破)
误读一:“框架有 max_iterations,所以没事。” 破:Table II 的 68 例全部发生在”边界机制普遍存在”的八个框架生态里;根因栏 100% 是”缺强边界”——存在 ≠ 覆盖。FP 分析再补一刀:六个误报里有靠框架默认值(max_iterations=3)救回的——默认值一改就翻车,配置依赖边界是脆弱边界。
误读二:“91.9% 精度 = 静态分析很准。” 破:91.9% 是过了五道过滤后的末端读数;上游候选 340 个,误报/漏报压力只是被转移给了无害过滤与人工复审。且 FN 估计方法薄弱:7 例假阴性是从基线报警里回标出来的(239 处基线独有报警 → 7 FN),没有黄金标准集,真实漏报可能更高(论文自认 §V-C)。
误读三:“IAL 是安全攻击。” 破:威胁模型(§III-B p.3)里攻击者只能通过正常输入(prompt、文档、URL、工单)诱发循环,不能改代码改配置;论文明确排除网络层 DoS。它本质是可用性/成本缺陷(cs.SE),不是入侵(cs.CR)——攻击者只是扣动扳机,枪是开发者自己造的。
8.5 写作之维(论文怎样完成说服)
8 页短文的密度设计:一页威胁模型+定义(§III)、三页方法(§IV)、三页实验(§V)——方法部分三张图(管线/构造规则/示例 ALDG)各占半页,文字只讲图没讲的约束。最有说服力的三处:①Table I 的跨框架形态对照表(一页纸证明”必须有中间表示”,比任何论证都省力);②68/68 同根因的读数放在 Table II 最后一行(全表看完最后一行收口——“都是同一个病”);③消融表的 w/o LLM Pruning 行(token 0、3.8s、FP 272)——一行数字同时论证”静态层是召回的来源”和”LLM 层是精度的来源”。标题的写作动作:When Agents Do Not Stop 是场景句不是术语句——先给画面再给名词(IAL 在摘要才出现),这是安全类论文的常用钩子结构(对照 JudgeDeceiver 的命名先行,两种策略各自成立)。整体收拢:全文的隐含主张是”停止规则应该被静态验证”——所有实验都在为这一句服务。
九、局限与可疑处
- 工件未公开:IAL-Scan 无代码链接(论文未附仓库地址)——六个 FP 与七个 FN 的个案无法独立复核,复现只能走机制演绎(§十)。
- FN 估计薄弱:假阴性从基线报警回标(239 处 → 7 例),没有黄金集;LangGraph 工作流环”未识别的边界”被点名为漏报主类(§V-C p.7)——真实 FN 可能显著更高。
- LLM 剪枝不稳定:三次重跑 TP 覆盖 68/64/60 递减(Table V),四个模型覆盖 41–68 波动(Table VI)——端到端数字(91.9%)绑定 gpt-5.5 单模型单次运行,换模型/换运行读数会动。
- 覆盖面:Python + 八框架;高度自定义语义(项目自有调度器、外部状态停机逻辑、自然语言语义检查)支持有限(§VI-B 自认)。
- v1-only:2026-07-02 提交,无 v2;录用状态未标注(cs.SE 短文风格,可能投 workshop/期刊,登记待核)。
- 统计口径:91.9% 为点估计(n=74,二项标准差约 ±3.3pp);标注者非独立第三方(前两作者自标 + 第三作者仲裁)。
十、验证结果(最小复现)
10.1 范围声明
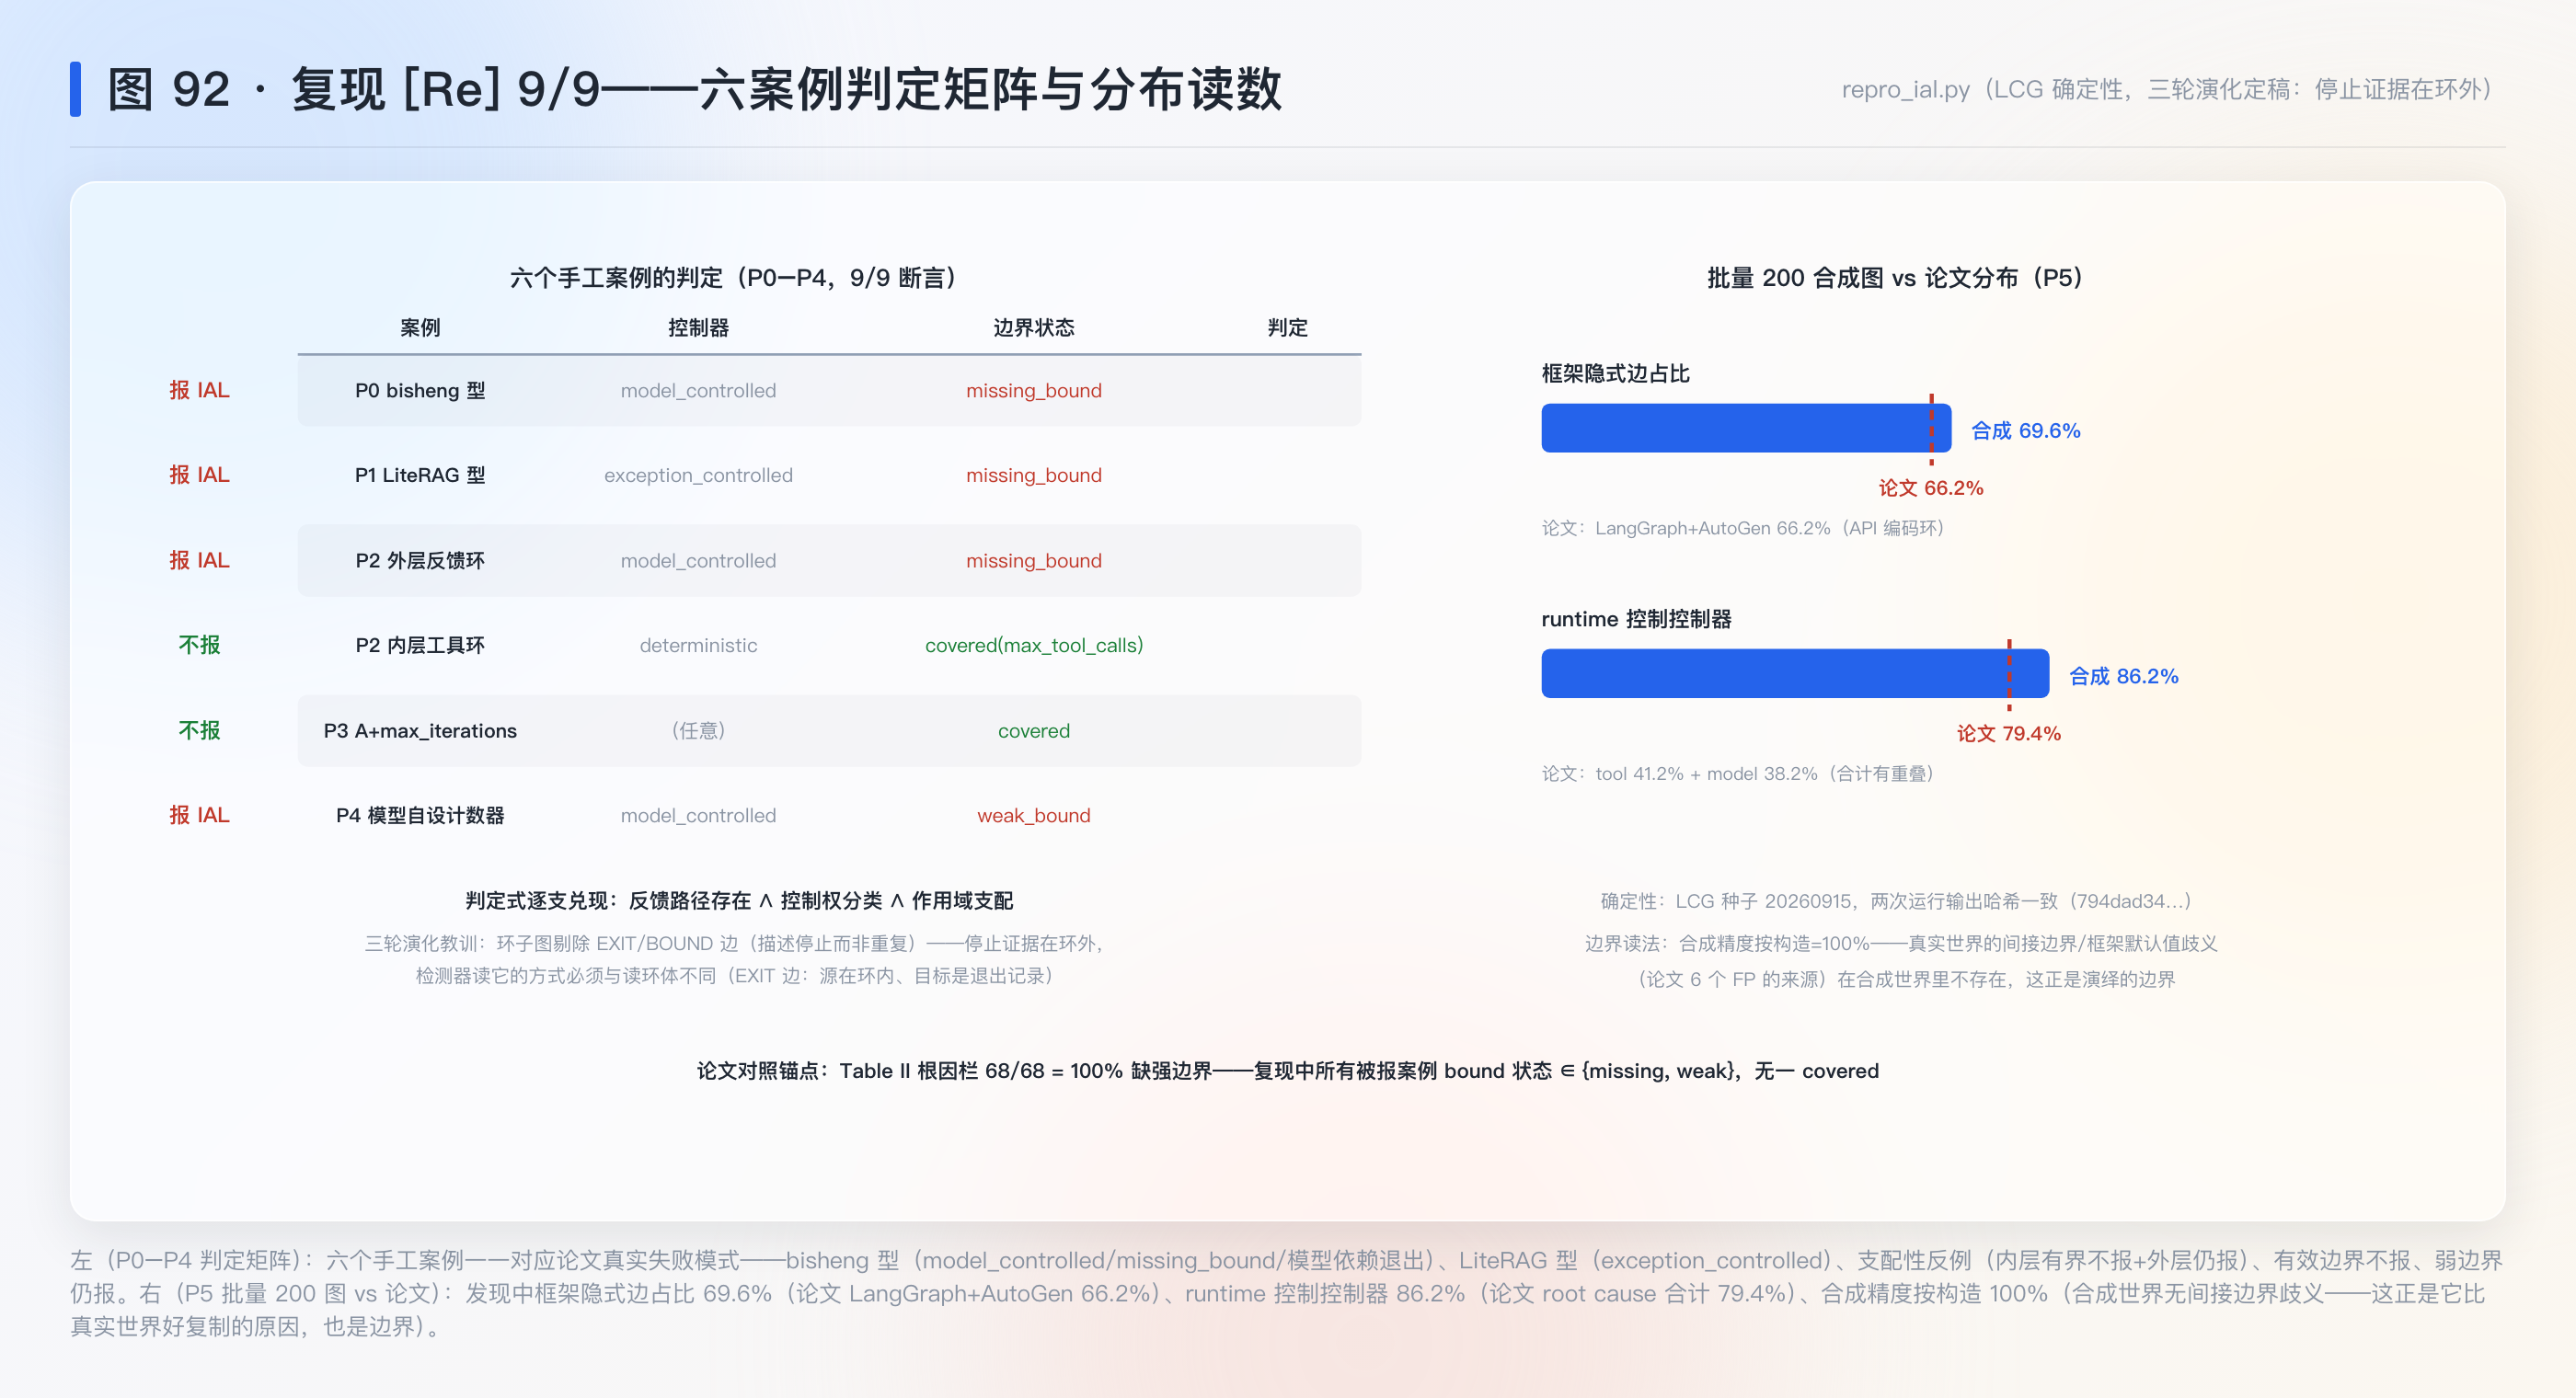
论文主实验是对 6,549 个真实仓库的静态分析 + 人工标注,不可且不应复现。本复现是检测机制的演绎:合成 Agent IR 图世界上重演 Algorithm 1 的三步(SCC 候选 → 控制器分类 → 边界覆盖),六个手工案例一一对应论文的真实失败模式,200 张随机合成图对照论文的分布读数。全部纯 CPU、LCG 确定性(两次运行输出哈希一致:794dad34…)。
10.2 可证伪预测与判据(运行前写下;预登记量级)
- P0(贯穿例 bisheng 型):报 IAL,控制器 = model_controlled,边界状态 = missing_bound,显式退出被归类为模型依赖(不算边界)。判据:四条全中。
- P1(LiteRAG 重试型):报 IAL,控制器 = exception_controlled,missing_bound。
- P2(支配性反例,论文挑战 3):内层有界不报 + 外层无界仍报。两条全中。
- P3(有效边界):Case A 加确定性 max_iterations 覆盖全环 → 不报。
- P4(弱边界):模型自设计数器 → 仍报,weak_bound。
- P5(批量 200 图,对照论文分布):合成精度 100%(按构造);发现中框架隐式边占比 ≥60%(论文 LangGraph+AutoGen 66.2%);runtime 控制控制器占比 ≥60%(论文 root cause 合计 79.4%)。
10.3 实现演化(三轮,如实登记)
第一轮:P0 FAIL——EXIT 边的检查方向写反(检查了边的源而不是目标)。第二轮:改方向后仍 FAIL——退出记录节点 T0 根本不在 SCC 里:环子图故意排除 EXIT/BOUND 边(它们描述停止而非重复),所以退出节点挂在环内控制器上、自身不构成环。第三轮:改为”EXIT 边的源在环内 + 目标是退出条件节点”→ 9/9 全过。教训:环子图的删边规则不只是实现细节,它决定了停止机制的证据在图上的位置——证据在环外,检测器读环外证据的方式必须与读环体不同。P5 生成器同步补了 15% 确定性控制器案例,避免 runtime 占比断言退化为平凡的 100%。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_ial.py,真实输出
repro/repro_ial_output.txt。9
断言 9 PASS,[Re] 全部通过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 bisheng 型 | Fig 2:model-controlled、无强边界、模型依赖退出 | ctrl=model_controlled / missing_bound / exit_dep=True | 机制一一对应 |
| P1 LiteRAG 型 | Fig 6:异常吞掉的重试无界 | exception_controlled / missing_bound | 同 |
| P2 支配性 | 挑战 3:内层 cap 不覆盖外层 | 内层不报 + 外层报 missing_bound | 集合支配判定的直接重演 |
| P3 有效边界 | Listing 3 covered 档 | 加边界后不报 | 同 |
| P4 弱边界 | weak/bypassed 档(FP 分析的镜像) | weak_bound 仍报 | 同 |
| P5.b 隐式环主导 | Table II:LangGraph+AutoGen 66.2%(API 编码环) | 69.6% | 生成参数 0.7 取隐式边,量级咬合 |
| P5.c runtime 控制主导 | Table II 根因:tool 41.2% + model 38.2% | 86.2%(含 exception) | 生成分布偏向 runtime 控制,方向一致 |
算力与工作量:MacBook 纯 CPU,单轮 <0.5 秒;三轮迭代约 30 分钟。 What was easy:六个手工案例一次设计到位——论文的 Fig 2/6/7 与挑战 3 给足了案例规格,案例→图的翻译是机械的。 What was difficult:三轮演化全花在退出记录的读取上(见 10.3)。合成世界的 SCC/支配判定本身一次写对——难的不是图算法,是”哪些边允许定义重复”这个领域决定。 给下一个复现者的建议:先抄 Fig 4 的四条环性质注记(Feedback/Cost/Growth/Bound)再写代码——判定要素在论文里是按”控制器的属性”组织的,跟着这个组织走,检测器的数据结构自己长出来。
结论:[Re] 全部通过——判定式的三个合取支(反馈路径存在、控制权分类、边界支配)与论文的真实失败模式一一咬合;分布读数方向与量级一致。论文的 91.9% 精度在合成世界对应”按构造 100%“——合成世界没有论文的歧义案例(间接边界/框架默认值),这正是它比真实世界好复制的原因,也标注了本演绎的边界。
十一、方法论提炼与迁移
模式一:边界覆盖判定(Bound-Coverage Judgement)
- 操作定义:判定一个循环系统能否停,不查”有没有退出条件/边界参数”,而查两条:退出条件的控制权在谁手里(守卫来源分类),以及边界的作用域是否支配整条反馈路径(\text{effective}(b,P) \iff \text{deterministic}(b) \wedge b.\text{scope} \supseteq P)。
- 成功判据:判定的三个合取支可分别独立证伪(路径存在性 / 控制权分类 / 支配性);反例可机械构造(内层 cap 不支配外层 = P2 型反例)。
- 迁移去向:①代码评审清单——review 任何循环(agent/CI 重试/消息消费)时对每个退出条件问”谁控制它、它盖住全程吗”;②基础设施容量审计——自动扩缩容的”边界”(max_nodes)是否支配所有可增长的反馈环(队列×重试×扇出);③个人工作流——deadline(确定性)与”感觉差不多了”(模型控制)哪个在支配你的反馈环。
- 失效边界:静态判定对间接/框架默认边界保守(FP 来自这里);语义性停机条件(“答案质量够了”)不可静态判定;控制权可运行时切换(混合控制器)时分类退化为谱系而非标签。
- 方法卡:
notes/method_bound_coverage_judgement.md(L1) - 层级:L1 领域具体(程序分析/agent 工程)。底层原理:归因靠对照(L2 已立卡)——边界是否”有效”必须在具体路径的对照下判定,脱离路径谈边界没有意义。
模式二:框架语义图归一(Framework-Semantics Lifting)
- 操作定义:分析异构框架上的系统行为时,先把各框架的 API 形态翻译成一套与框架无关的执行概念(中间表示),再在表示上做统一分析——Table I 式的形态对照表是翻译字典,消融(去框架建模候选 340→910)是翻译必要性的量化证明。
- 成功判据:翻译后概念覆盖所有框架的目标行为(Table I 五行全映射);去掉翻译层可测地变差(消融数字)。
- 迁移去向:①多云安全审计——AWS/Azure/GCP 的 IAM 概念归一成统一权限模型再查越权;②CI/CD 跨平台规则——GitHub Actions/GitLab CI/Jenkins 的执行语义归一再查供应链风险;③数据库方言分析——不同 SQL 方言的锁语义归一再查死锁。
- 失效边界:框架演化快于建模更新时漏报(论文 LangGraph “未识别的边界”即此类);无法翻译的语义(项目自有调度器)只能保守保留;翻译字典本身的维护是持续成本。
- 方法卡:
notes/method_framework_semantics_lifting.md(L1) - 层级:L1 领域具体(静态分析)。底层原理候选:“表示决定可判定面”——待第二个独立领域确认后议 L2,现在不立。
(L2 无新卡。)
十三、没搞懂的地方(未攻克登记)
- FN 的真实规模:7 例假阴性来自基线报警回标,没有黄金集。漏报率到底多少?补齐时机:IAL-Scan 若开源可直接在基准集上测;不开源则等独立复现。
- 支配性与支配树的关系:论文的作用域支配是集合包含判定,编译器的支配树(dominator tree)是标准算法——为什么不用?是工程简化还是语义差异(图含框架边、非纯控制流)?补齐时机:对照程序分析教科书/工具(CodeQL 的 dominator 查询)。
- 动态侧的最优停止:本篇解决”部署前判定路径有界”,不解决”运行时预算内停在哪最优”(重试几次、何时放弃)——STOP 节点的另一半。补齐时机:检索 test-time compute 分配线(LATTS 2509.20368 已在队列)。
- ** BoundStatus 的 disabled/bypassed 档**:论文 Listing 3 列了五档弱化边界,但正文案例只覆盖 missing/weak——disabled(被关闭的边界)与 bypassed(被绕过的边界)的真实案例长什么样?补齐时机:工件开源后看检测器实现。
- 框架默认边界的脆弱性:FP 分析里 OpenAI supervisor 靠默认 max_iterations=3 救回——默认值的安全声称有没有文档依据?补齐时机:核对 OpenAI Agents SDK 文档(论文引 [24][25][27],未逐一核)。
十四、可信度
- A 级(论文原文转录,逐节核对):IAL 定义与威胁模型(§III p.2–3)、Table I 跨框架形态对照(p.2)、Agent IR Schema(Listing 1 p.4)、ALDG 构造规则(Fig 4 p.4)、Algorithm 1(p.5)、BoundStatus 分类(Listing 3 p.5)、Table II 主分布(p.6)、Table III 消融(p.7)、Table IV 基线对比(p.7)、Table V/VI 稳定性与敏感性(p.7–8)、Fig 2/6/7 三个案例代码(p.2/6)。
- B 级(论文自报实验,无法独立验证):6,549 仓库的收集与过滤口径、人工标注细节、GPT-5.5 剪枝的提示词(称在 artifacts 中,工件未公开——不可核)、全部精度/覆盖数字。
- C 级(我的推导 + 复现程序化验证):§三 3.1 判定式的合取结构(复现 P0–P4 逐支兑现)、§六.1 支配性反例(复现 P2)、§六.3 六篇旁证的分类学归位(概念对照,无实验)、§六.4 LLM 分工定律(论文三表的综合读法)。
- D 级(我的推断,已标注):§8.2 “自报通道第三张面孔”的合流命题、§8.3 成本双线汇合、§8.5 写作分析、10.3 的教训提炼。
- 横向核实初核(2026-09-15):版本 v1-only 已核(2026-07-02 提交,无更新版);录用未标注;工件 IAL-Scan 未公开(论文未附代码链接);第三方讨论未查;统计审查:91.9% 为点估计(n=74,二项标准差约 ±3.3pp),标注一致性 94.6%/92.1% 有报告;假阴性估计方法依赖基线报警回标,无黄金集(§九.2)。
- 实验充分性评价:部分充分——主结果(规模 + 精度)与消融(五组件)支撑”工具有效”的主张;但无黄金集、FN 方法弱、剪枝层不可复现三点使”检测完备性”的主张只能算部分支撑;定义与分类学部分(IAL 定义、六分类、覆盖判定)论证自足,是该文最耐用的产出。
- 性能支撑目标检查:goal 是”定义 IAL + 部署前检测 + 真实世界发现”——三目标支撑(定义清晰可操作;精度 91.9% + 消融链完整;68 例分布给出结构证据);“防御”只是建议清单(§VI-A),无实证——论文没有过度声称,读时也不要期待防御方案。