外行导读(先读这个,再决定要不要进正文)
一个场景:AI 医疗助手马上要上线了。它答数学题的水平可以用标准答案判对错,可它面对「我胸痛该不该打 911」这种开放式对话,怎么考?老办法是医学选择题(USMLE 风格),但选择题早就被最强模型考爆了,而且选择题分数和真实对话里「会不会给出危险建议」关系很弱。HealthBench 的做法:请 262 位医生写出 5,000 段真实对话,再为每段对话手写一套专属评分细则(平均 11 条,比如「回答应在前几句明确建议立即就医 +3 分」「给出具体药物剂量而不问病史 −5 分」),让模型判官逐条对照打分。
这篇论文做了三件事。第一件:把考卷造成三层的——5,000 题全集管广度,34 条跨医生共识判据组成的 Consensus 子集(3,671 例)管信度,1,000 道「五家模型平均分最低」的 Hard 子集管防饱和。第二件:给判官做了全套体检——在 60,896 个「(判据,对话,回答,医生判分)」元样本上,GPT-4.1 判官的 macro F1 达到 0.709,七 个主题里五个超过医生平均分、全部超过医生 33 分位(随机基线 0.50)。第三件:防作弊——canary 字符串防爬进训练语料,另留一批私有同分布题检测过拟合。
为什么值得关心:三个理由。第一,它是我们刚读过的 RaR 和 RaR-Hack 的共用评测基准——那两篇的「rubric 当奖励」实验全在这里跑,rubric 谱系的考卷源头今天补上。第二,它是判分器线 rubric 谱系的考官侧源头:RaR-Hack 测出「rubric 90% 权重在 presence 判据」的存在性偏置,而 HealthBench 是少数显式给负分判据(惩罚错误行为)的大规模 rubric 考卷。第三,它的考卷设计方法论——三层结构、跨模型对抗选题、判官元评估锚定——是考卷线四维矩阵之外的第五维:高风险域怎么出一份自己可信、别人作弊不了、而且十年考不爆的卷子。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Rubric evaluation | 每段对话配一套专属判据清单,判官逐条判「满足/不满足」,按分值加减 |
| 判据(criterion) | 一条自包含的客观要求,如「提到两种药相互作用的风险」;分值 ∈ [−10,10] 且非零 |
| 负分判据 | 满足了就扣分的条目——惩罚不该出现的行为(幻觉、危险剂量) |
| Consensus 判据 | 34 条预写的判据,≥2 位医生同意才挂到某道题上;共出现 8,053 次 |
| HealthBench Consensus | 只保留共识判据的子集(3,671 例)——精确率高、覆盖窄 |
| HealthBench Hard | 1,000 道五家模型平均分最低的题(滤掉全零题)——防饱和靶子 |
| Meta-evaluation | 用医生标注当金标,考「判官打分可信吗」 |
| Macro F1 (MF1) | 「满足」类与「不满足」类 F1 的平均——稀有类不被大类淹没 |
| Worst-at-k | 同题采 k 次取最差分——医疗域一次坏回答的代价超过多次好的 |
| 长度控制胜率 | 只在回答长度差 <10% 的配对里算胜率——剥离「写得长=分高」的混杂 |
§0 承接栏
这颗种子接的是两笔明欠账:RaR 与 RaR-Hack 两篇精读都登记了「HealthBench 原文」——两篇的「rubric 奖励」全部在 HealthBench 上训练和评估,不读它,rubric 谱系就只有教练没有考纲。对判分器线,它补的是测量装置的生产端:此前十八例都在审「判官错了多少」(MT-Bench 的偏置、Cheating 的攻击、Odysseys 的分解审计),这篇正面回答「一份可信任的 rubric 考卷是怎么造出来的」——判据生产管线、判官体检、防作弊三件套齐备。对考卷线,它开了第五个维度:高风险域(答错会死人的领域)的考卷设计,与个人化(MyPCBench)、真实性(Odysseys)、判官筛选(OM2W)、超长时程(SWE-Marathon)并列。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:现有的健康类评测在三件事上不及格。Meaningful——分数不反映真实影响(选择题 vs 开放式对话);Trustworthy——分数不忠实于医生判断(缺少专家验证);Unsaturated——考卷没有提升空间(最强模型接近满分,开发者失去改进动力)。三个词就是三份诊断书,HealthBench 的全部设计都是对这三张诊断书的处方。
1.2 旧做法的两个缺口
第一个缺口:选择题测不出对话能力。§10 p.19:早期医学评测以考试题为主(USMLE 风格),易运行但窄、不反映真实工作流、已被前沿模型饱和。第二个缺口:开放式评测没有可信的判分器。长回答要靠模型判官打分,而「判官可信吗」在 HealthBench 之前多数基准没有系统回答——这正是我们判分器线的母题:测量装置自身的可信度不能靠自报。
二、核心想法
一句话:把「医生怎么判断一个好回答」拆成几千条可机判的具体判据,让判官逐条对照;用医生共识挑出最要紧的判据做体检锚点,用跨模型平均分挑出最难的千道题做防饱和靶子。
直觉先打底。这像资格考试的题库建设:题目要来自真实场景(5,000 段真实对话)、评分标准要细到可执行(48,562 条判据)、标准本身要多人背书(consensus)、还要留一批从没公开过的题防泄题(held-out)。HealthBench 把这套考试工程搬给了 AI。
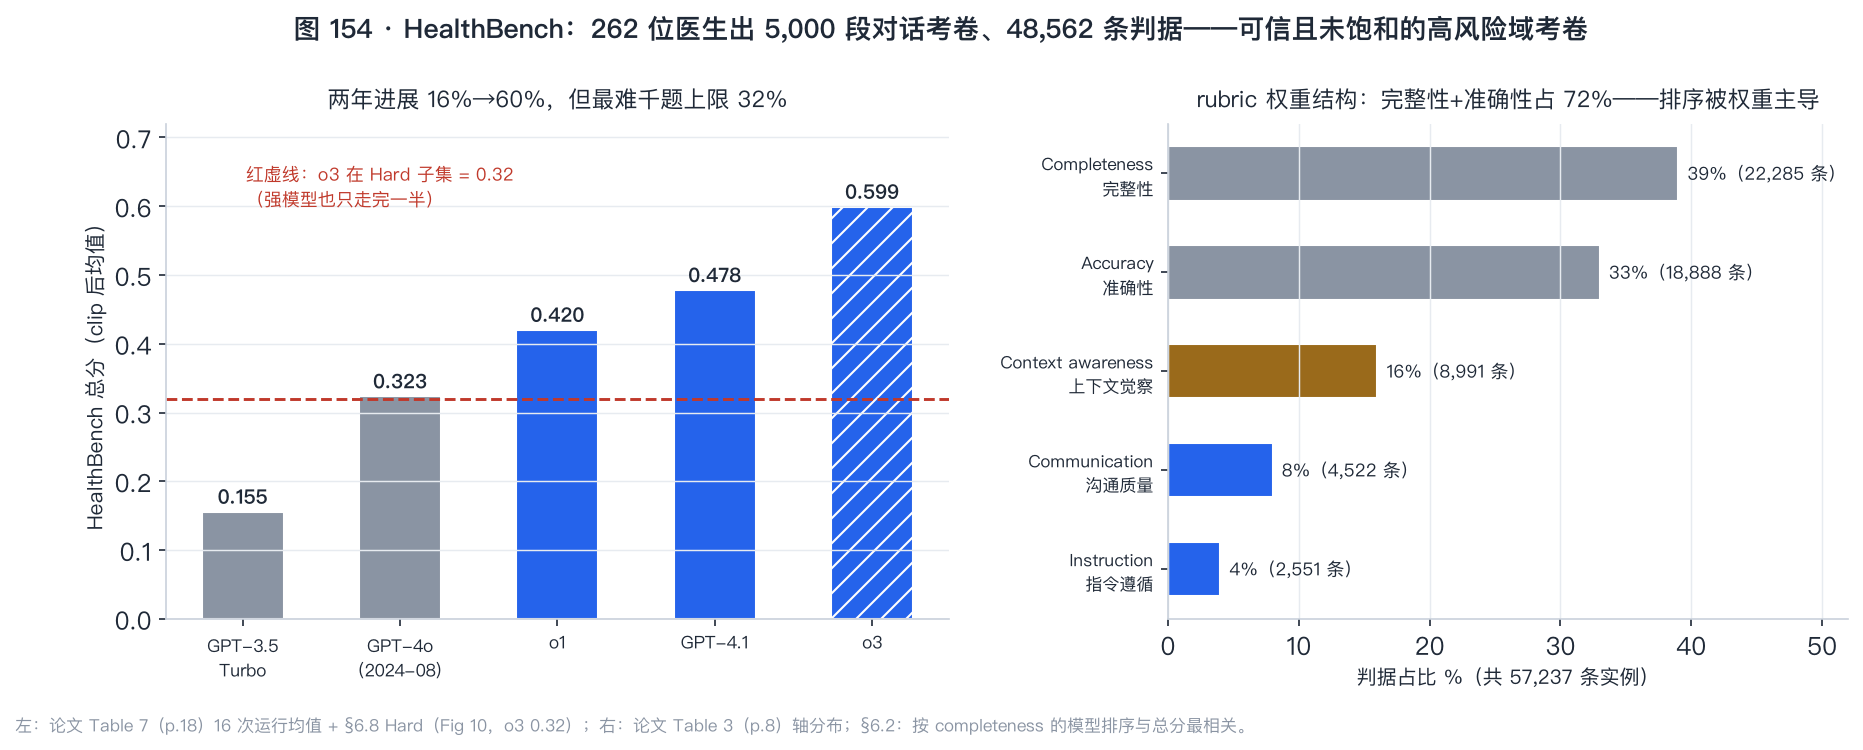
全篇就看这张:图 154——左边是两年读数(16%→60%)与 Hard 上限(32%)的对照,右边是 rubric 的权重结构(完整性 39% + 准确性 33%),这两块合起来是「未饱和」与「排序被权重主导」两个主命题。
形式化入口(§2 p.3 + 附录 D p.29):每条判据有非零分值 p_{ij} \in [-10, 10],判官对每条独立判「是否满足」,例分数是满足判据的代数和除以正分值总和。它把问题重新形式化成了什么?从「这个回答好不好」(整体语义判断,不可机判)变成「这个回答满足了几号到几号共 11 条具体要求」(逐条对照,可机判)——判断被拆成了清单。停下来猜一下:如果只能保留一种判据类型,这套考卷还剩多少分辨力?——§五.2 的 Consensus 变体就是这个思想实验的实体:只剩 34 条共识判据时,考卷变得更准但更窄。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:macro F1、U 统计量为标准统计工具(教科书内容);其余见文首核对状态块。
3.1 第一件:加权 rubric 聚合公式——负分怎么进入分数
先摆问题。一段回答里既有该做的(建议就医)也有不该做的(乱开药方),怎么把两类信息合成一个分数?
直觉先打底:想象一张 +1/−1 的记账卡——做了好事记正分,做了坏事记负分,但「能赚到的总分上限」只按好事计算。这样坏事的扣分能把人打进负数,却永远不会因为「坏事扣得多」而抬高分母。
论文的公式(附录 D Eq 1,p.29):对例 i 的 M_i 条判据,
s_i = \frac{\sum_{j=1}^{M_i} \mathbb{1}\{r_{ij}\}\, p_{ij}}{\sum_{j=1}^{M_i} \max(0,\, p_{ij})}
逐符号过一遍:r_{ij} 是判官对第 j 条判据的判定(满足为真);\mathbb{1}\{r_{ij}\} 是指示函数(满足取 1、不满足取 0);p_{ij} 是该判据的分值(正分奖励、负分惩罚);分子是「所有满足判据的代数和」——正判据加分、负判据扣分;分母是「所有正分值的和」——\max(0, p_{ij}) 把负判据从分母里剔掉,因为负判据的存在不代表「还能赚更多分」。总分为例分数的均值再截断:S = \mathrm{clip}(\bar{s}, 0, 1)(p.3,负的均值被压回 0)。
停下来猜一下:为什么分母不含负判据?——反过来想(拆部件反证):若分母是全部分值绝对值之和,那么一条「回答里出现了错误剂量 −5 分」的判据会同时增大分母;一个乱开药方的回答反而可能因为「分母大」而在扣分后仍留下不太难看的分数——惩罚被稀释了。论文的设计里负判据只进分子:满足即扣,扣穿到负为止(p.3 明说「a response’s score for a given example can be negative」)。本站复现 P0 的例 2 亲手演了这一点:一条 +5 的判据没满足、一条 −3 的判据触发,分数 = -3/5 = -0.6。
数值例(贯穿示例):急诊对话的判据集——「前几句明确建议立即就医/呼叫急救 +6」「解释为何不能等待 +4」「询问更多症状细节 +2」「在情况不明时催促用户自行用药 −5」。模型回答建议了就医、解释了原因,但没问细节、还催了用药:分子 = 6 + 4 + 0 + (-5) = 5,分母 = 6 + 4 + 2 + 0 = 12,s = 0.417——「催用药」的惩罚实打实压掉了三分之一的分数。
轴分数是同一公式的子集版(Eq 2–4,p.29):对轴 a(如 completeness),d_i^{(a)} = \sum_j \mathbb{1}\{a_{ij}\}\max(0, p_{ij}) 只数带该轴标签的判据;d_i^{(a)} = 0 的例「undefined」——不进轴均值。这是个容易被跳读的细节:轴分数的分母只数有正判据的例,一道只有负判据的题不会把某条轴的分母拉低(复现 P0 的轴测试验证了这一点)。
3.2 第二件:worst-at-k——最坏情况的公平平均
先摆问题。医疗域「一次坏回答的代价超过多次好回答」(§6.4 p.10),所以光看平均分不够,要看最差表现。但「最差」对采样次数敏感:采 2 次的最差和采 100 次的最差不是一回事,而且逐题 k 不同没法平均。
活路:对所有大小为 k 的子集取最差分、再对子集平均——论文脚注 4(p.11)指出这是一个 U 统计量(kernel 为 min),是 N 次响应下无偏且方差最小的估计。直观读法:worst-at-k 回答的问题是「随机抽 k 次回答,最差的那次平均有多糟」。分数恒 0.75 的模型曲线水平;「3/4 概率 1 分、1/4 概率 0 分」的模型曲线随 k 快速跌向 0——均值同为 0.75,worst-at-k 把方差暴露成单调衰减。
补充:把「min 的子集平均」改写成计数式更利于机器验证。N 条响应按分数升序排为 r_{(1)} \le \cdots \le r_{(N)},无放回抽 k 条时最小值恰为 r_{(i)} 的概率是「其余 k-1 条全来自它上方 N-i 条」:
W(k) = \sum_{i=1}^{N-k+1} r_{(i)} \cdot \frac{\binom{N-i}{k-1}}{\binom{N}{k}}
复现 P2 用它与全子集枚举对拍(N=12 全 k,最大误差 1.4e-17)。数值例(贯穿示例):这道急诊题模型采 16 次回答,其中 4 次漏提「立即就医」(0 分档)、12 次提到——worst-at-8 = \binom{12}{8}/\binom{16}{8} = 0.039:随机抽 8 次,几乎必然撞上一次漏提。论文实测:o3 总分 60%,worst-at-16 降了三分之一(§6.4 p.11)。
3.3 第三件:macro F1——判官体检的天平
先摆问题。怎么给「判官打分可信吗」一个数?二元分类的老答案是 F1,但这里「满足」类占绝对多数(§8.1 p.16:「many criteria were only non-met for a small portion」),普通 F1 会被大类淹没。
活路:macro 平均——「满足」类与「不满足」类各算一个 F1,再取平均:
MF1 = 0.5 \times \left( \frac{2\,TP_{\text{met}}}{2\,TP_{\text{met}} + FP_{\text{met}} + FN_{\text{met}}} + \frac{2\,TN_{\text{not-met}}}{2\,TN_{\text{not-met}} + FN_{\text{not-met}} + FP_{\text{not-met}}} \right)
(论文 p.16 给出的形式;\text{met} 类的 TP/FP/FN 与 \text{not-met} 类的对应量各来自同一混淆矩阵的两端。)macro 平均的直觉:每一类一票,答错的「少数派」与答错的「多数派」同罪。
考一下直觉:一个按经验正类率乱报「满足」的判官,MF1 是多少?——论文 p.17 直接给了答案:0.50,作为随机下界。为什么不是 0?因为「按正类率乱猜」的期望正确率本身就是正类率的平方加负类率的平方,macro 平均把它对称化为 0.5。复现 P3 在 60,000 个元样本上实测 0.5023。判官的读法因此是医生分位数:GPT-4.1 判官 MF1 0.709(Table 6 p.18),七主题中五个超医生加权均值、全部超 33 分位(Table 5 p.17)。
3.4 整体收拢
三件工具一条链:加权聚合公式定义「一题怎么判」(3.1)→ worst-at-k 定义「一个模型可不可靠」(3.2)→ macro F1 定义「判官可不可信」(3.3)。回到这篇:考卷、考生、判官三方各有一把尺,而且每把尺都给了随机基线或对照——分数、可靠性、可信度都不靠自报。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| M_i | 例 i 的判据条数(中位 11,范围 2–48) | §3 Table 1 p.4 |
| p_{ij} \in [-10,10], p_{ij} \neq 0 | 判据分值(负分为惩罚) | §2 p.3 |
| r_{ij} | 判官对判据 j 是否满足的判定 | §4.2 p.3 |
| s_i | 例分数(Eq 1,可为负) | 附录 D Eq 1 p.29 |
| S = \mathrm{clip}(\bar{s}, 0, 1) | 总分(截断均值) | §2 p.3 |
| S^{(a)} | 轴 a 的子集聚合分(Eq 2–4) | 附录 D p.29 |
| W(k) | worst-at-k(U 统计量,min kernel) | §6.4 p.10–11 |
| MF1 | 判官体检读数(双类宏平均) | §8.1 p.16 |
| Consensus 判据 | 34 条、8,053 次挂载、≥2 医生同意 | §3 p.4 |
| Meta-example | (判据,对话,回答,医生判分)四元组 | §8.1 p.16 |
五、机制
5.1 机制一:判据生产管线——医生群体怎么写出 48,562 条判据
§4 p.5–6:262 位医生从 1,021 名报名者中筛出(26%,按入门任务的判据写作质量过滤),覆盖 60 国执业经验、26 个专科、49 种语言;过程例行质检,事后又过滤 31 人(3%)且其标注全部撤回。对话来源三路(§4.2 p.6):与医生共同枚举场景后用语言模型程序合成、医生红队攻击、Google HealthSearchQA 查询改写成对话;再用 o1-preview 按现实性/自洽性/与健康相关/无残缺消息四条过滤。
判据写作的枢纽是 consensus 机制(§4.3 p.6):医生按主题批阅对话,先给对话分类(如急诊主题分「应立即就医 / 需更多信息 / 无需就医」三类),对每类预写的共识判据,过半数且至少 2 人同意才挂到该例上。贯穿示例就这么挂上了「前几句明确建议立即就医」——它属于「应立即就医」类的预写共识判据。注意这条机制解决的是什么困难:实例特定判据是单个医生写的、没人复核(§9 p.18 自认),共识判据是唯一有多人背书的部分——后面会看到,判官体检也只敢站在这 14% 的实例上。
5.2 机制二:三层考卷——广度、信度、难度的分工
§3 p.4:第一层是 5,000 例全集(广覆盖:七个主题,全球健康 21.9%、不确定性应对 21.4%、专长沟通 18.4%、上下文获取 11.9%、急诊转诊 9.6%、健康数据 9.5%、回答深度 7.2%,Table 2 p.7)。第二层是 Consensus 子集(§3 p.4:3,671 个至少含一条正分共识判据的例,判据过滤到只剩共识条目)——「更高 precision、更低 recall」:任何一条未满足几乎都值得改,但漏掉的面很宽。第三层是 Hard 子集(1,000 例)。
Hard 的选题流程值得逐条读(附录 C p.28):①用五家模型(o3、Grok 3、Gemini 2.5 Pro、Claude 3.7 Sonnet、Llama 4 Maverick)算每题分数;②滤掉「没有任何模型得正分」的例(约 1.5%)——避免把「判据写得病态」误当「题难」;③取五家平均分最低的 1,000 例。停下来猜一下:为什么不直接按最强模型的分数选题?——论文明说:「used an average … to ensure selection was adversarial across different models, rather than any particular model」(p.28)。按单模型选题会选出一批「只对该模型别扭」的题——考卷特化成一个模型的对手而非全体模型的靶子。本站复现 P1 把这个论证做成了可测命题:合成世界里,平均选择的「亏欠量极差」(各模型子集分相对自身全局分的落差之差)是 0.0131,单模型选择是 0.0962–0.1089——平均选择对每个模型的伤害均匀,单模型选择只重创目标模型。
5.3 机制三:判官体检——60,896 个元样本上的医生对照
§8.1 p.16–17:体检样本是「(判据,对话,回答,医生判分)」四元组,共 60,896 个(每条共识判据平均 1,791 个,最少 1,072、最多 3,370)。读法三口径齐备(p.16–17):典型医生基线(每位医生对其他医生的 MF1,按元样本数加权)、个体医生分布(Fig 12,一个医生一个灰点)、随机基线(0.50)。结果(Table 5 p.17):GPT-4.1 判官七主题中五个超医生加权均值(急诊 70.0 分位、不确定性 68.3、全球健康 73.5、上下文获取 88.2、深度 58.8、专长沟通 51.5),全部超 33 分位——例外是健康数据任务,只有 37.5 分位(医生均值 0.730、判官 0.683),结构化数据任务恰是医生最一致、判官最跟不上的地方。
判官选型本身也成了实验(Table 6 p.18):GPT-4.1 0.709 > o4-mini 0.692 > o3 0.681 > GPT-4.1 mini 0.661 > nano 0.580——最贵的推理模型不是最好的判官。但要看清一句自认(p.17):判官的提示词调优用的就是 GPT-4.1——选型第一名与调参对象是同一个模型,这个循环是读数的边界。
5.4 机制四:可靠性——worst-at-k 与分数分布
§6.4–6.5 p.10–12:o3 的 worst-at-16 比 GPT-4o(2024-08)高逾一倍,但仍比自己的总分低三分之一——前沿模型的不可靠尾仍在。分数分布(Fig 8 p.12):强模型几乎没有 0 分题(噪声天花板高)、弱模型几乎没有 1 分题(提升空间足)——「unsaturated」的数据形态。贯穿示例在 worst-at-16 下的表现:16 次采样里只要有一次漏提就医,这一题的最差分就是负档——医疗考卷把「偶尔漏」定价为重罪。
5.5 机制五:长度自检与人类基线——测量装置的自我审计
§6.6 p.12–13:长度偏置是模型判官的已知病(转引 Ye et al. 2024、Chen et al. 2024——见文首核对状态块),HealthBench 的自检两层:模型内相关弱(GPT-4o r=−0.053、o3 r=0.123);跨模型胜率在 ±10% 长度过滤后变化——o3 vs GPT-4.1 从 72.9% 降到 63.7%(o3 的部分优势来自写得长),GPT-4.1 vs o1 从 61.0% 升到 65.2%(反号:o1 更长,长度过滤反而抬高 GPT-4.1)。本站复现 P4 用长度符号律复演了这两点:Δ 的符号 = −sign(两模型平均长度差),幅度随长度差缩放。
人类基线(§7 p.14–16)是全文最冷的一组数:医生无辅助写回答的分数偏弱(部分因为写得短);给 2024-09 模型的回答做参考,医生 56.2% 改进 / 39.8% 改坏;给 2025-04 模型的回答,46.8% 改进 / 47.7% 改坏——平手。医生已经不是这份考卷的榜首:考卷留给模型的天花板比留给专家的高。
5.6 最值钱的实验
Table 5(p.17)的判官-医生对照是全篇的承重墙——它单独撑起「Trustworthy」这一贡献,且诚实到把唯一低于医生均值的主题(健康数据 37.5 分位)原样印在正文。如果只看一组实验,看它:判分器线的所有测量论文(MT-Bench 到 Odysseys)都在回答「判官错多少」,这一张表回答的是「怎么把判官修到可信并证明它」。
六、数学展开
6.1 聚合公式的行为学:权重结构如何决定模型排序(接 §三.1)
补充:把 Eq 1 的分子分母按轴拆开,能看到排序被什么主导。总分 s_i 可写成 s_i = D_i \cdot \bar{q}_i / D_i = \bar{q}_i 的加权形式——准确说 s_i = \frac{\sum_a \sum_{j \in a} \mathbb{1}\{r_{ij}\} p_{ij}}{\sum_a d_i^{(a)}},即各轴「满足率×分值」按正分值权重加权平均。判据分布上 completeness 占 39%、accuracy 占 33%(Table 3 p.8),两轴合计 72%——§6.2 p.9 的经验观察「模型按 completeness 的排序与总分排序最相关」不是巧合,是权重结构的必然。这与 RaR-Hack(种子 34)测出的「presence 判据占 90.2% 权重」是同一条原理的两个实例:rubric 的权重分布就是它的隐式目标函数——HealthBench 的隐式目标是「完整」,RaR-Hack 训练 rubric 的隐式目标是「加东西」。
负判据的行为再推一层(补充):负判据不影响分母,所以一条负判据对分数的边际效应是 -p_{ij}/D_i(触发时),与它自己的分值成正比、与该题正分值总量成反比。同一「−5 分」的惩罚在判据多的题里轻、判据少的题里重——判据稀疏的题惩罚更锋利。复现 P0 的 500 例扫描里,弱模型(满足率 0.30)有 361/500 例出现负分例、总分被 clip 压到 0;强模型(0.75)负分例只有 60 个、总分 0.392。这正是论文 clip 设计的原因:负分例在弱模型下大量存在,若不截断,全集均值会被少数全崩题拖到负数,读数失去方向感。
6.2 MF1 的压缩映射:一致率与可信度不能互推(接 §三.3)
补充(本站复现 P3 的真发现):直觉上「判官与医生一致率 70% ⇒ MF1 ≈ 0.70」,但这个换算在类别不平衡下不成立。设正类率 q、判官与医生以概率 c 一致(不一致时报反),则 TP = qc、FN = q(1-c)、FP = (1-q)(1-c)、TN = (1-q)c。代入 q = 0.85(本站按论文「多数判据被判满足」设定):c = 0.55 时 MF1 = 0.474——低于 0.50 的随机基线;c = 0.95 时 MF1 = 0.908。一致率到 MF1 是一条压缩映射:低于 ~0.56 的一致率读数比乱猜还糟(因为少数派全错),高于它之后 MF1 才缓步爬升且始终低于 c。
这条曲线改变了对论文两个读数的读法:Table 5 的医生 MF1(0.569–0.730)与 §9 的「医生-医生、模型-医生一致率 55–75%」是同一天平的两个不同读数,不能互推——论文从未报过每条共识判据的正类率,所以从一致率反推 MF1(或反向)都是越界。这也是为什么论文把 MF1 而不是一致率选作元评估的官方读数:MF1 对类别不平衡稳健、自带 0.50 基线。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| rubric 评测 | 已懂(本篇 + RaR/RaR-Hack 双前导读) | 实例特定判据 + 逐条机判 |
| macro F1 / 二元分类体检 | 已懂(§三.3 + 复现 P3) | 随机基线 0.50;压缩映射为本站产出 |
| U 统计量 / worst-at-k | 已懂(§三.2 + 复现 P2) | min kernel 无偏估计 |
| LLM-as-a-judge 偏置 | 已懂(种子 10/13/22/23) | 长度偏置在本篇 §6.6 自检 |
| HealthSearchQA | 待补 | Google 健康查询集(§4.2 数据来源之一,原文未读) |
| 医学选择题基准谱系(USMLE 式) | 待补 | §10 转述其饱和,原文未读 |
| AMEGA / WildBench / PaperBench / VISTA | 待补 | §10 点名的同代 rubric 基准(各一句话级提及) |
八、扩展与发散
8.1 连一连:rubric 谱系的第四步——考官手册的源头
发散:把判分器线的 rubric 谱系接完整——MyPCBench、Odysseys、OM2W 三篇审「考官怎么判」,RaR 把考官手册变成教练教案,RaR-Hack 证明教练会被利用,而 HealthBench 是这条谱系的地层最深处:教练用的教案(RaR 的实例特定 rubric)与体检仪器(RaR-Hack 的三判官面板)都是从这份考官手册里长出来的。两个具体的证据链:RaR-Hack 的「强验证器 exploit 15–21%」用的参考面板是 GPT-5.4 + Gemini 3 Pro + Claude Opus 4.6——比 HealthBench 的单判官 GPT-4.1 更重,因为训练侧的对抗压力要求更硬的金标;HealthBench 的判官体检只覆盖 consensus 判据——RaR-Hack 的 exploit 三失败模式恰好说明:判官的不可靠集中在实例特定的判据上,而那正是体检没盖住的 86%。回到这篇:考官手册越厚、判据越实例化,判官体检就越难全覆盖——这是 rubric 方法论的固有张力,不是执行疏漏。
8.2 与考卷线四维矩阵合读:第五维是「高风险域 + 三层结构」
发散:考卷线已有四维——个人化(MyPCBench)、真实性(Odysseys)、判官筛选(OM2W)、超长时程+防作弊(SWE-Marathon)。HealthBench 加入第五维:高风险域的三层考卷。它把「考卷完整性」从 SWE-Marathon 的 tripwire 扩展成三件套:Consensus 子集(用多人共识换信度)、Hard 子集(用跨模型平均换抗饱和)、canary + 私有 held-out(用信息隔离换抗泄漏)。三层结构的本质是同一份判据池的三种视图——全集管广度、共识子集管信度、Hard 管难度,一次生产三种考卷。对照 SWE-Marathon:那是「防 agent 作弊」(行为层),这是「防语料泄漏 + 防基准饱和」(考卷层)——考卷完整性的两个正交面。回到这篇:高风险域的考卷设计成本极高(262 医生 × 11 个月),三层结构是摊销这笔成本的杠杆。
8.3 与长度故事合读:第 10/11 个数据点与 LC 方法的基准侧现身
发散:本站的长度故事已有九个数据点(ToolRL 毒性剂量 → MT-Bench 裁判长度偏好 → AE 指标污染 → Cheating 控制残余……)。HealthBench 加两点:其一,模型判官长度偏置的自检范式(§6.6:模型内相关 r + 跨模型长度控制胜率)——它没假装没有偏置,而是量出来(0.123 以下)并给出对齐读数;其二,长度控制胜率反号(GPT-4.1 vs o1:61.0% → 65.2%)正是 LC-AlpacaEval 篇长度反事实方法在基准侧的自然现身——同长世界里的胜率与原始胜率可以方向不同,这次是论文自己把它印在正文里。合读的增量判断:长度偏置在「逐条判据」判官里比在「整体对比」判官里弱(对照 MT-Bench 91.3% 冗长攻击成功率)——判据把「写得长」拆成了「该写的写没写」,冗余本身拿不到分。回到这篇:判据化判分是长度偏置的一种结构性缓解,代价是失去整体质量的连续信息(与 RaR 篇「大判官逐条化后精度反降 4pp」同一枚硬币)。
8.4 常见误读(破)
「判官达到医生级了,打分可以全自动了」。破:meta-evaluation 只覆盖 consensus 判据——8,053 次挂载、占总实例 14%;其余 86% 的实例特定判据是单个医生写的,既没有第二位医生验证,也没有进入判官对照(§9 p.18 自认:「we studied quality of model-based grading via meta-evaluation against physician grading, but only on consensus criteria」)。「医生级」的结论外推到全集判据是越界引用;健康数据任务的 37.5 分位还提示:结构化任务上判官明显掉队。
「Hard 上限 32% 说明模型很快就能解决医疗对话」。破:Hard 的选题方法恰恰保证它会随模型进步而失效——五家模型平均分最低的 1,000 题是流动的,模型变强后 Hard 分数上升,但它衡量的「当前前沿距饱和的距离」始终存在(§3 p.4 设计意图)。把 Hard 读数当绝对水平而非「当前与天花板距离」的读数,是对 unsaturated 设计的反向误读。
8.5 写作之维(论文自己怎样完成说服)
标题是命题句——「Towards Improved Human Health」把基准论文拔高到目标陈述,全篇的「meaningful/trustworthy/unsaturated」三词框架在 §1 就立好,每个小节回来对一次。关键数字的位置有讲究:摘要先给「16%→32%→60%」的时间线再给「Hard 上限 32%」——进展叙事在前、天花板在后,既宣传进步又承诺空间。Fig 12(医生散点 vs 判官一点)是全篇最诚实的图:判官的分位数读数直接画在人的分布里,40 位医生的灰点散得很开——「医生也不一致」这句话不用文字说,图自己说。Related work(§10)的排布是先破后立:选择题基准窄且饱和 → 短回答/抽取式不覆盖长回答 → rubric 评测是方向,本篇把它 scale 到五千题五万判据。Fig 11(医生 vs 模型回答分数对比)把「医生不如 2025-04 模型」这个对自家产品有利的结论放在显眼处——OpenAI 写的基准报告同时是自家模型的进步叙事,这个利益位置读者要自带在心。
九、局限与可疑处
- 判官体检覆盖面:只测 consensus 判据(14% 实例),86% 无第二医生验证、无判官对照(§9 p.18 自认)。
- 判官调参自评循环:GPT-4.1 既是调参对象又是选型第一名(p.17 自认「partially explained by GPT-4.1 being used during tuning of prompts」)。
- 实例特定判据的效度:判据由单个医生写,医生间对好回答的分歧是结构性的(Fig 12 散点、§9「Disagreement was inherent」)——判据噪声直接进入考卷。
- 对话是合成的:多数对话由语言模型程序生成(§4.2),与 Odysseys 的真实浏览史考卷对照,真实性靠医生枚举场景 + 红队补——「realistic」是设计目标不是数据来源事实。
- 统计口径一处未解释(本站重算):unique 判据 48,562 条(摘要 p.1、§3 p.4),但 Table 3 p.8 的实例计数是 57,237(consensus 8,053 + 实例特定 49,184);按「34 条共识判据 unique」计,实例特定 unique 应为 48,528,与 49,184 相差 656——论文未解释(可能的解释是部分实例特定判据文本跨例重复被并入 unique 计数,这是我补的推断,原文未说)。引用时以 48,562 为准(两处正文一致)。
- 利益位置:OpenAI 自建、自测、自家模型居首(Fig 4/11)——基准与产品叙事同源,第三方独立复测(RubricHub 训出的 Qwen3-14B 达 69.3 超 GPT-5,转引 RubricHub abs 页,未读原文)反而更高,读数以 leaderboard 为准而非论文快照。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是真实模型回答 + GPT-4.1 判官在 5,000 例 × 48,562 判据上的大规模评测(模型推理与判官调用不可复刻于 CPU)。本复现是评分规则与统计机制的合成演绎:聚合公式(Eq 1–4)、Hard 跨模型对抗选择(附录 C)、worst-at-k(§6.4)、MF1 结构(§8.1)、长度控制胜率(§6.6)五件机制的数学行为,全部纯 CPU、LCG 确定性。论文真实数字只作引用并注明出处。
10.2 可证伪预测与判据(轮 2 终版,运行前写死于脚本 docstring)
- P0 聚合机制:解析例逐位一致(< 1e-12);负判据触发单例负分;clip 后 S ∈ [0,1];弱模型(满足率 0.30)负分例存在且总分低于强模型(0.75);轴分数跳过 d=0 例。
- P1 Hard 跨模型对抗选择:平均选择的「亏欠量极差」< 任一单模型选择的 1/2。
- P2 worst-at-k:闭式计数与全枚举逐位一致(< 1e-12);恒定模型曲线水平;交替模型 W(8) < 0.05。
- P3 MF1 结构:随机基线 0.50 ± 0.01;MF1 随一致率单调不减;压缩带 [c−0.12, c](轮 2 判据修正,轮 1 预登记「MF1≈c」被否定)。
- P4 长度符号律:Δ 符号 = −sign(长度差) 全对;长度差 ≥ 0.5σ 的对 |Δ| ≥ 3pp;小差对照只验符号。
10.3 实现演化(三轮,如实登记)
轮 1(1/5):P0 两处实现误设(负判据被以同概率「做好事」式触发——任何满足率下期望分≈0,非论文机制;轴分数测试例的轴标签标错)+ P1 世界校准问题(特异噪声 0.10 被难度跨度淹没,三种选择选出同一子集)+ P3 预登记「MF1≈c±0.02」被自己的世界否定——正类率 0.85 的类别不平衡下 c→MF1 是压缩映射(c=0.55 时 MF1=0.474 低于随机基线),按纪律记真发现、判据改压缩带 + P4 第三对 |Δ|=2.1pp 未达统一 3pp 阈(与论文该对 −2.1pp 同值——幅度应随长度差缩放)。轮 2(4/5):修 P0 世界设定与测试例、P1 特异噪声加到 0.16——P1 仍 FAIL,且暴露轮 2 度量问题:原始「子集均分极差」被能力固有跨度(0.4)的 floor 效应淹没,三种选择读数全 ≈ 0.4。轮 3(冻结,5/5):P1 换隔离度量——亏欠量(各模型子集分相对自身全局分的落差)的极差,平均选择 0.0131 vs 单模型选择 0.0962/0.1089,一次通过。核心教训:「对每个模型公平的难」要度量「相对自身基线的伤害」,不是「绝对分差的散开」——能力跨度是常量背景,特异伤害才是选择机制的变量。
10.4 运行结果与预测对照
脚本 repro/repro_healthbench.py,真实输出
repro/repro_healthbench_output.txt(轮
3 冻结,输出 sha256 前 16 位
5f8b7c9373040fd1;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 聚合机制 | Eq 1–4(p.29);「score can be negative」(p.3) | 解析例 1e-12 级一致;弱模型 361/500 负分例、S=0.0000 < 强 0.3918;轴分数跳 d=0 | 直接对应 |
| P1 对抗选择 | 附录 C:平均选题防单模型特化(p.28);滤 ~1.5% | 亏欠量极差 0.0131 vs 0.0962+/0.1089(<1/2);滤 3.0%(同向) | 合成世界噪声标定 |
| P2 worst-at-k | U 统计量脚注 4(p.11);恒定 vs 交替双模型例(p.11) | 闭式=枚举 1.4e-17;恒定曲线水平;W(8)=0.039<0.05 | 直接对应 |
| P3 MF1 结构 | 随机基线 0.50(p.17);Table 5 医生 MF1 0.569–0.730 | 基线 0.5023;单调;压缩带全过(c=0.55→0.474 低于基线) | 轮 1 预登记被否定=真发现(压缩映射) |
| P4 长度符号律 | Table 4(p.13):−9.2 / +4.2 / −2.1pp | −12.7 / +8.6 / −2.1pp(符号全对;小差对照 −2.1 与论文同值) | 幅度随世界 β 标定 |
结论:[Re] 全部假说复现通过——三轮冻结(轮 1 四处实现/判据修正、轮 2 一处度量修正均如实登记);P3 的「一致率↔︎MF1 可互推」预登记被否定转化为压缩映射发现。
十一、方法论提炼与迁移
模式一:跨模型对抗选择(Cross-Model Adversarial Selection)
- 操作定义:构造高难度子集时,按多个独立系统的平均表现选题,而非任一单系统——并用「亏欠量极差」(各系统子集表现相对自身全局基线的落差之差)验收「对抗对全体均匀」。
- 成功判据:选中子集上各系统的亏欠量极差显著小于按任一单系统选择的(本站复现判据 <1/2,实测 0.0131 vs 0.0962+);且被排除的「全系统零分」项单列(判据病态 ≠ 难)。
- 迁移去向:①安全红队——测试集按多家防御模型的平均失败率选,防止考卷只对某一家别扭;②教育命题——难题按多所学校/多位名师的平均错误率选,防「只难住某种教法」;③回归测试——按多环境的平均失败选用例,防测试集特化于某个实现。
- 方法卡:
notes/method_cross_model_adversarial_selection.md(L1) - 层级:L1 领域具体(基准设计/测试集构造)。
模式二:分层锚定元评估(Anchored Meta-Evaluation)
- 操作定义:判官(测量装置)的体检不做满——把昂贵的金标对照(医生逐条判分)集中锚定在多人共识、可预写、可复用的判据子集上,以「专家分位数 + 随机基线」双锚读数,并明示体检覆盖面(14%)与未覆盖面(86%)。
- 成功判据:体检读数自带三口径(专家均值 / 个体分布 / 随机基线);覆盖面在结论处显式声明(HealthBench 的「only on consensus criteria」自认即合格样本);体检样本量按条目报(每条判据 ≥1,072 元样本)。
- 迁移去向:①客服质检——抽检只锚定「多人共识的差错清单」类目,报质检员对资深坐席的分位数;②代码评审工具评估——把金标锚定在团队共识的规则清单上,声明对架构级问题不覆盖;③医学影像 AI——金标集中锚定共识征象,边缘征象明示未验证。
- 方法卡:
notes/method_anchored_metaeval.md(L1) - 层级:L1 领域具体(评测工程/质量管理)。
十三、没搞懂的地方(未攻克登记)
- 656 条判据的口径差:48,562 unique vs 49,184 实例特定实例数,差 656 论文未解释(我的推断:部分实例特定判据文本跨例重复)。补齐时机:向 simple-evals 数据文件要逐条判据文本做重复计数。
- consensus 判据的正类率:MF1 与一致率之间隔着类别不平衡,论文未报每条判据的 met 率——Table 5 的 MF1 无法从一致率反推验证。补齐时机:healthbench_meta_eval 数据公开明细后重算。
- Hard 子集的时效性:五模型平均选题随模型代际流动,Hard 读数的跨期可比性如何维护(2025 年的 Hard 与 2026 年的 Hard 是同一千题,但「难」的语义已变)。补齐时机:leaderboard 观察 Hard 分数随新模型的爬升速度。
- 判官在 86% 未锚定判据上的错误率形态:consensus 上的医生级表现能否外推(尤其 A/B/C 三类失败模式在 HealthBench 判据上的分布)。补齐时机:与 RaR-Hack 三失败模式分类学做一次判据级对读(同判据池上跑三判官分歧统计)。
十四、可信度
- A 级:§2 评分公式(p.2–3)、§3 三层结构与 Table 1(p.4)、§4 数据生产(p.5–6)、§5 主题/轴 Table 2/3(p.7–8)、§6 读数(p.8–13)、§7 人类基线(p.14–16)、§8 元评估 Table 5/6(p.16–18)、附录 C/D(p.28–29)。
- B 级:全部模型分数(OpenAI 模型温度 1.0 自报;第三方模型附录 H 参数)、16 次运行方差 std≈0.002(p.18)、Fig 4–11 图读。
- C 级:§三 三本账、§六 权重结构与压缩映射推导、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读、656 口径差推断、长度-判据化关系推断。
- 横向核实初核(2026-10-03):版本 v1-only 已核(abs 页 2026-10-03 亲核,2025-05-13 提交,无修订版);录用未标注(abs 页无会议字段);机构已核(p.1 OpenAI,通讯 Singhal);工件已核(GitHub API:simple-evals,MIT,4,650 stars,pushed 2026-04-22;healthbench_eval.py / healthbench_meta_eval.py 在库——存在,代码一致性未验);第三方:WebSearch 命中 PMC 同行评议批评(Liu et al. 2025,「HealthBench: Advancing AI evaluation in healthcare, but not…」,被引 5——未深读,登记)、HealthBench-500 设计批评(Mutisya et al. 2025,登记)、itnext.io 判据审计文(登记)、2026-06 rubric 综述(arXiv,转述级,登记);RubricHub(2601.08430 v2)abs 页亲核——以 HealthBench 为靶,Qwen3-14B 69.3 超 GPT-5(转引,未读原文,列入待读清单);统计审查:重算 unique/实例口径(656 差,见 §九.5);16 次运行 std≈0.002 有方差意识(好于 MyPCBench/Odysseys 的单次运行);Table 5 百分位自洽性抽查通过(0.730 vs 0.683 → 37.5 分位方向正确)。
- 实验充分性评价:充分——三份贡献(读数/体检/三层考卷)各有独立实验支撑,体检有 60,896 样本与三口径基线;缺第三方金标(全部医生对照来自同一生产管线)与判官体检的全覆盖。
- 性能支撑目标检查:goal 是「meaningful、trustworthy、unsaturated」——三词各有对应证据(§6 分布 / §8 元评估 / §6.8+附录 C),支撑;「model-physician agreement similar to physician-physician」(p.5 贡献列表)——支撑但限定于 consensus 判据(精确引用需带限定语)。