外行导读(先读这个,再决定要不要进正文)
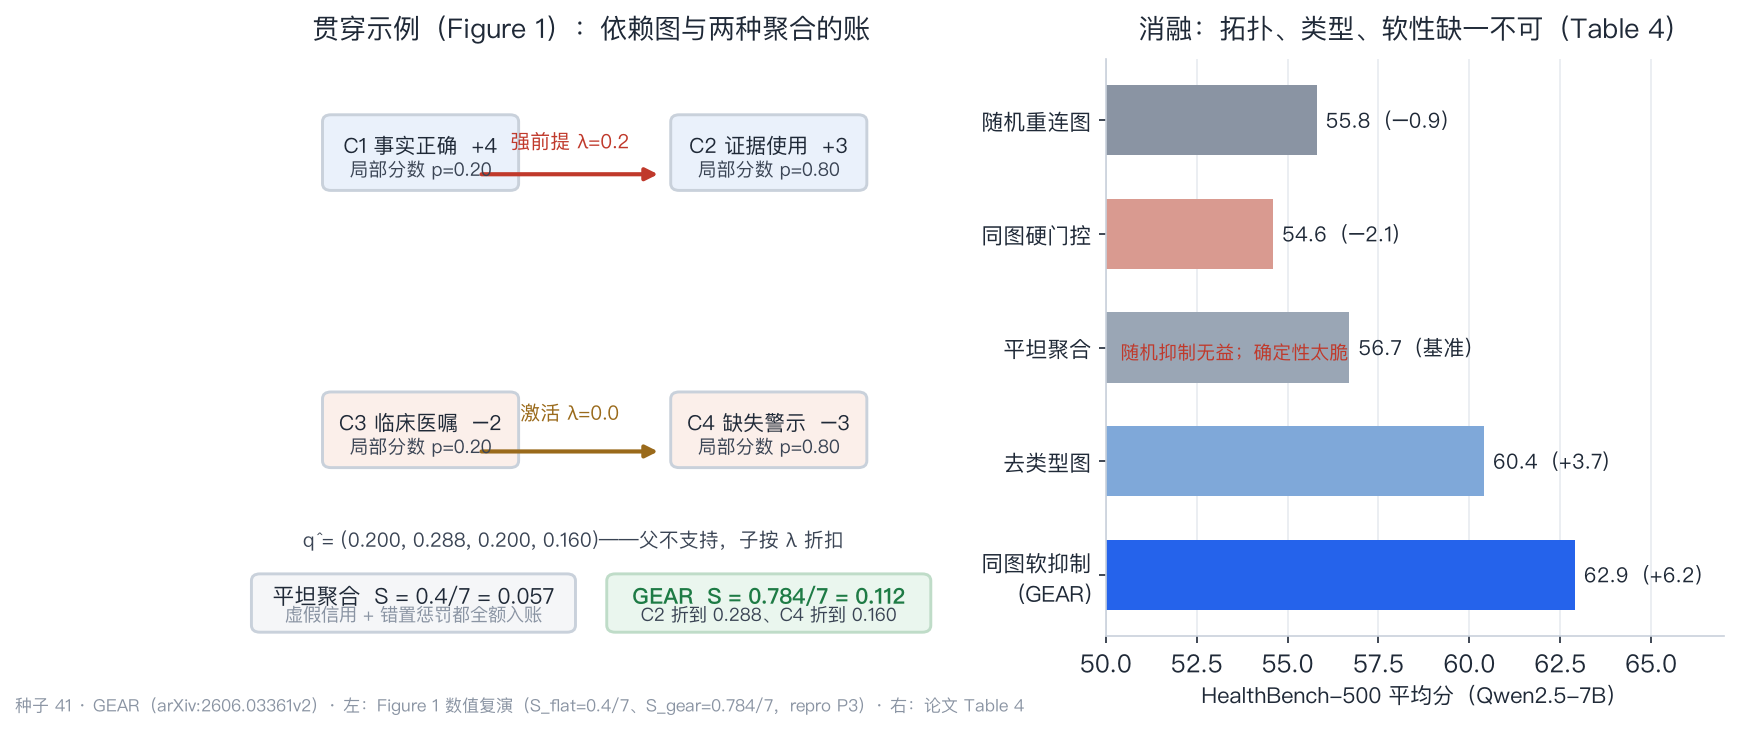
一个场景:你让助手总结一项关于降压药的研究证据。回答把结论说得过满(「证据强烈支持」「能降低重大心血管事件」),但没有给你个医嘱。评分表有四条:事实正确 +4、证据使用 +3、提供个人医嘱 −2、缺失不确定性警示 −3。逐条打分:事实正确性低(过满了)、证据使用高(确实引用了)、没给医嘱(−2 不触发)、缺失警示——高。平坦聚合把四条加起来:证据使用那 3 分照记(尽管它依附的「事实正确」根本没立住),缺失警示的 −3 照罚(尽管回答根本没进入「给医嘱」的语境,这个罚本不该激活)。每一项的局部打分都没错,加在一起却是记错了的账。论文给这个失效起了名字:False Credit Propagation——虚假信用传播。
这篇论文做了两件事。第一件:命名并形式化这个病理——判据的贡献(正分或罚分)被计入时,评分表里许可这个贡献的条件(前提不成立、或激活场景不存在)并不成立;它发生在聚合层,局部判官再准也防不住。第二件:GEAR——把评分表建成一张有类型的图(哪种判据是哪种判据的前提、哪种罚只在哪个场景激活),父事件不支持时子事件按保持因子打折(弱前提留 60%、强前提留 20%、激活边直接归零),拓扑序一遍算完,奖励 = 归一化期望符号效用,线性时间,PPO/GRPO 外层算法一行不用改。
为什么值得关心:三个理由。第一,它是聚合层的第二篇:上一篇 ProRubric 精读用「合取分组」给加法聚合打补丁,本篇把聚合层立成生成式的结构建模——判据间关系不是补丁,是奖励模型的一部分。第二,它的消融表回答了一个更细的问题:随机重连的图 −0.8(随便抑制没用)、去类型的图 +3.7(连接本身有信息)、同图硬门控 −2.1(确定性太脆)、同图软抑制 +6.2——拓扑、类型、软性三件缺一不可。第三,硬门控输给平坦聚合这个读数,与 AdvancedIF 精读「全或无奖励赢」拼在一起,给出一条层次规律:判据内的聚合宁严勿硬,判据间的许可宁软勿硬——两个「全或无」在不同层次命运相反。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| FCP(False Credit Propagation) | 虚假信用传播——判据的贡献被计入,但许可它的前提/激活条件不成立 |
| 平坦聚合(flat) | 逐判据独立加权求和再归一(Eq 2)——RaR 的默认做法 |
| 保持因子(retention factor λ) | 父不支持时子概率保留的比例:弱 0.6/强 0.2/激活 0(Table 7) |
| 前提边 vs 激活边 | 前提=下游信用靠它撑(证据使用靠事实正确);激活=条件性判据的适用开关(给医嘱才触发警示罚) |
| 拓扑序更新 | 按图的先后顺序一遍算出每个判据的折扣后概率(Eq 12),线性时间 |
| 均值场近似 | 多父相关时用「父概率的乘积」近似「父联合概率」——相关时才出误差 |
| LFCP / P | 泄漏率(违反依赖时下游效用被计入的量)/ 保存率(依赖满足时下游效用保住的比例)——双指标 |
| 角色四分类 | 判据角色:core(主要求)/bonus(加分项)/penalty(罚项)/activation(适用条件) |
§0 承接栏
这颗种子接的是三笔账。第一笔:ProRubric 精读收尾时把「聚合层同期三篇」列为下一步候选,本篇是首选归位。第二笔是聚合层自身的深化:ProRubric 精读把聚合立为第三个自由度(判据/判官/聚合),给的是确定性协议(合取分组+失败条款);本篇给的是概率图结构(typed 边+软抑制+期望效用)——同一个自由度上的两种解法,正好构成设计空间的两极,§八.1 展开。第三笔是判官噪声问题:RubricHub 精读测出判官误判率直接伤害训练,本篇的软抑制恰好是对判官噪声的结构鲁棒化——λ<1 给局部误判留缓冲,§八.3 展开。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:开放式后训练需要超越精确匹配的奖励信号,rubric 把「回答质量」分解成逐条判据。但把判据得分变成标量奖励时,通行做法是平坦加权和(本篇点名引用 RaR 的做法,§2 p.2)——每条判据被当成独立的效用源,只要局部判官给了高分就计入。真实评分表不是清单:证据使用的信用靠「事实正确」撑着,医疗警示的罚只在真给了医嘱时才该激活。
1.2 旧做法的缺口
§1 p.2:把依赖压平造成「局部判据满足」与「评分表级效用」的错位。在 RL 里这个错位不是被平均掉,而是成为标量奖励的一部分,直接塑造策略学到什么行为。虚假信用奖励「只在表面上满足下游判据」的回答,错置惩罚打击本来有效的回答。论文强调(§1 p.2):解决 FCP 需要的不是更好的局部判官,而是尊重依赖的聚合规则——并且这个规则必须同时满足三个需求:①依赖表示(前提+激活两类关系都要能表达);②不确定性感知(判官有噪声,硬门控太脆);③RL 兼容(每次打分的开销可预测,不能每步都跑贵推理)。
二、核心想法
一句话:把评分表建成有类型的依赖图,父事件不支持时子事件按保持因子软折扣,折扣后的边际概率加权求和——判据间许可关系从「注记」升格为「奖励模型的一部分」。
直觉先打底:一条判据的得分是判官对「这件事在回答里成立」的局部估计;但如果许可它的条件本身没成立,这个估计再高也不该全额入账。GEAR 做的事只有一件:入账前先按依赖结构打折——父事件成立的概率越低,折得越狠(激活边直接归零)。
全篇就看这张:图 178——左:贯穿示例的四判据依赖图与两种聚合的账本对比(平坦 0.057 vs GEAR 0.112,虚假信用与错置惩罚各被削掉多少可见);右:消融四行(随机图/去类型/硬门控/软抑制)证明增益不是「多抑制了就行」。
形式化入口(§3.1 p.4):给定 query x、回答 y、带符号权重的 query 特异评分表 R_x=\{(r_{x,i}, w_{x,i})\}_{i=1}^{K_x},局部判官给每条判据打分 p_i = J_i(x,y,r_i) \in [0,1],解释为 P(C_i=1 \mid x,y,r_i) 的局部估计——注意 p 是观测输入不是模型生成的变量(§3.3 p.5 自我声明:这是聚合外部判官分数的条件模型,不是分数的生成模型)。它把问题重新形式化成了什么?从「怎么把分数加权求和」变成「在依赖结构约束下,每个判据事件的后验边际是多少」——聚合变成了一个图模型上的推断问题。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:伯努利分布、贝叶斯网络的条件概率表、拓扑序为标准工具(教科书内容);其余见文首核对状态块。
3.1 第一件:单调抑制 CPD——折扣规则是被约束逼出来的
先摆问题。父事件 C_j 不支持时,子事件的概率 p_i 该怎么修正?停下来想一下:你会选加法还是乘法?
补充(发明式推演,论文只宣布了形式 Eq 7,这里把候选拆开看死因)。候选一:加法抑制 p_i - c\cdot(1-p_j)。死因有二——边界:p_i=0.2、p_j=0、c=0.3 时修正值是 -0.1,概率出了 [0,1];对称性:父越不支持罚得越狠是线性的,但「父概率从 0 升到 0.3」与「从 0.6 升到 0.9」对许可的意义完全不同(前者还没立住,后者已经立住),线性惩罚分不出这个差别。候选二:硬门控 p_i \cdot \mathbb{1}[p_j \ge 0.5]。死因也有二——它对判官噪声零鲁棒:父真值 0.51 与 0.49 的判官分数差 0.02,子判据从全额入账变成零入账;且它把「部分许可」压成「全有或全无」,丢了部分信用。候选三:乘法折扣 p_i \cdot \prod_j \lambda_{ji}^{1-C_j}——父支持(C_j=1)时因子为 1 不动父不支持时因子为 \lambda_{ji} \in [0,1]。它天然满足四条约束:值域安全(乘 [0,1] 不出界)、单调(父概率升 → 折扣轻 → 子概率不降,后面 P1 验证)、有界(子概率永不超过局部分数 p_i——图只能压分不能抬分,这是「抑制只能抑制」的单调 CPD,§3.3 p.4–5 的原话是 unsupported parent events can only suppress, not inflate)、部分信用(λ 可调)。论文的答案就是候选三(Eq 7):
\alpha_i(C_{Pa(i)}; p_i) = p_i \prod_{j \in Pa(i)} \lambda_{ji}^{1-C_j}.
逐项看:p_i 是局部分数(判官说了算的部分);\lambda_{ji} 是边 (j,i) 的保持因子——「父不成立时子还留几成」;指数 1-C_j 是开关:父成立取 0 次方(因子=1),不成立取 1 次方(因子=λ)。白话:入账比例 = 局部分数 × 各许可条件的留存率连乘。
λ 从哪来?论文给的是类型级固定映射(Eq 6 的最简实例,Table 7):弱前提 \lambda_{wk}=0.6、强前提 \lambda_{st}=0.2、激活 \lambda_{act}=0.0。三种边类型的语义(§3.2 p.4–5 与附录 A.4):弱前提=子有独立的部分信用(有父更好,没父也能活);强前提=子实质依赖父(父倒了子基本没意义);激活=父是适用开关(场景不在,判据根本不该入账)。猜一下为什么激活边是 0 而强前提是 0.2 不是 0?(reveal 附录 A.4 Table 7:激活的语义就是 full deactivation——「缺失不确定性警示」的罚在没给医嘱时不是「打折」而是「不存在」;强前提留 0.2 是承认判官可能连父都看错,留一条缝。)
3.2 第二件:拓扑序线性更新——什么时候精确、什么时候近似
先摆问题。每个判据事件的条件概率表(CPD)有了,怎么算每个判据的边际概率 q_i = P_{G_x}(C_i=1 \mid p)?精确算法(Eq 10)要对所有 2^K 个事件组合求和——指数级。猜一下论文的线性近似长什么样?
reveal(Eq 12,§3.4 p.5):按拓扑序(先算没有父的根节点,再算子节点)一遍更新:
\hat{q}_i = p_i \prod_{j \in Pa(i)} \left( \hat{q}_j + (1-\hat{q}_j)\lambda_{ji} \right).
和精确 CPD(Eq 7)对比只差一处:CPD 里的随机变量 C_j 换成了它的边际估计 \hat{q}_j。直觉:我们不知道父事件真的成没成立,只知道它成立的概率是 \hat{q}_j;于是「父不成立时才出现的折扣因子 λ」的期望就是 \hat{q}_j \cdot 1 + (1-\hat{q}_j)\cdot\lambda_{ji}——把随机开关换成它的期望值。
这个替换什么时候精确?(论文 §3.4 p.5–6 的原话+本站 P4 验证):父至多一个时精确;父多个但在条件模型下相互独立时精确;父多个且相关时,\mathbb{E}\left[\prod_j X_j\right] \ne \prod_j \mathbb{E}[X_j]——乘积的期望不等于期望的乘积,这就是均值场近似的误差来源(§六.1 展开算一个具体的)。每个父因子落在 [\lambda_{ji}, 1] 区间,所以整个更新有解析界(Eq 13):
p_i \prod_{j \in Pa(i)} \lambda_{ji} \le \hat{q}_i \le p_i.
白话:折扣后概率夹在「全部父都不支持」与「局部分数」之间——图只能压分,永远不能把分压过局部判官给的数,更不能抬分。论文在小图上对照了精确枚举(附录 B.2 Table 8):真实 rubric 图上边际平均绝对误差 0.0068(HealthBench,图最大最密)、奖励相关 0.9968——近似不改变排序。本站 P4 在合成图上复演了这个误差的结构:独立双父误差恰为 0、相关双父误差非零(6.19e-3,与论文真图同量级)。
3.3 第三件:泄漏-保存双指标——抑制型干预的验收为什么必须是两把尺子
先摆问题。怎么证明一个聚合规则「修好了 FCP」?只看泄漏率行不行?
活路:把抑制开到最大(全部 λ=0,任何有父的判据全清零),泄漏率确实归零——但依赖满足时下游信用也被清光了,奖励信号退化成「只有根判据算数」。论文的 FCP 诊断(§4.3 p.6,Eq 15/16)因此是两把尺子:
- 泄漏率 LFCP(Eq 15):在依赖违反的案例集 D 上(子局部支持 p_i \ge 0.5 且父不支持 p_j < 0.5),下游效用被计入的平均量——越低越好;
- 保存率 P(Eq 16):在依赖满足的案例集 S 上(父与子都局部支持),下游效用保住的比例——越高越好。
只报其中一把尺子都可以作弊:硬门控靠构造把泄漏做成 0(Table 2 里 LFCP=0.0000),但保存率塌到 0.1877;平坦聚合保存率 1.0000,泄漏 0.0922。GEAR 的位置是泄漏 0.0032、保存 0.2706——把泄漏压到接近硬门控的同时,保存率高出硬门控 44%。白话:好的抑制是「该压的压住、不该压的留下」,验收必须两把尺子一起看。这个双指标结构是本篇方法学上最可迁移的部件(§十一 方法卡二)。
3.4 整体收拢
三件工具一条链:单调抑制 CPD 给出「父怎么压子」的局部规则(3.1,乘法折扣从四条约束唯一逼出)→ 拓扑序更新把局部规则沿图传播成全局边际(3.2,单父/独立多父精确、相关多父均值场)→ 双指标验收证明传播的结果是「抑制而非清零」(3.3,泄漏 0.0032 vs 保存 0.2706)。回到这篇:聚合层的问题被转成一个图上的推断问题,而推断的代价是每次打分 O(K+|E|)——RL 训练里每步都要算,这个复杂度就是「能插进 PPO/GRPO」的全部代价(§3.5 p.6)。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| R_x=\{(r_{x,i}, w_{x,i})\} | query 特异评分表(判据+符号权重) | §3.1 Eq 1 p.4 |
| p_i = J_i(x,y,r_i) | 局部判官分数(观测输入,非生成变量) | §3.1 Eq 3 p.4 |
| G_x=(V_x, E_x) | query 特异 typed DAG(判据为节点) | §3.2 p.4 |
| E_x = E_x^{wk} \dot\cup E_x^{st} \dot\cup E_x^{act} | 边三分:弱前提/强前提/激活 | §3.2 Eq 4 p.4 |
| \lambda_{ji} = F(\cdot) \in [0,1] | 保持因子(类型级固定 0.6/0.2/0.0) | §3.3 Eq 6、Table 7 |
| \alpha_i | 依赖修正的伯努利参数(CPD) | §3.3 Eq 7 p.5 |
| \hat{q}_i | 拓扑序近似边际 | §3.4 Eq 12 p.5 |
| S_{GEAR} | 归一化期望符号效用(最终奖励) | §3.4 Eq 14 p.6 |
| LFCP / P | 泄漏率 / 保存率 | §4.3 Eq 15/16 p.6 |
五、机制
5.1 机制一:FCP 病理与三需求——问题被命名的那一刻
§1 p.2:FCP 的定义精确到字——「a criterion contributes reward or penalty without the rubric-level condition that licenses that contribution」。两个关键性质:①它可以在每个局部判分都合理时发生(错位在聚合,不在判官);②它对正贡献与惩罚对称地发生(虚假信用与错置惩罚,Figure 1 的 C2 与 C4 各是一例)。三需求(依赖表示/不确定性感知/RL 兼容)是后续所有设计选择的验收清单——λ 三值是为了可复现地隔离「依赖感知」本身的效果(附录 B.1:不按基准调 λ),拓扑近似是为了第三条需求。
5.2 机制二:建图管线——四个角色、两类候选约束、一次 DAG 投影
§3.2 p.4 + 附录 A p.15–17:图由 Qwen3-8B 在训练前离线构建(只看 query 与评分表,不看任何候选回答——所以图对同 query 的所有回答固定,不漏回答特异信息进奖励)。四步:①角色标注——每条判据归入四类:core(主要求)/bonus(加分项)/penalty(罚项)/activation(适用条件),附录 J.1 给了完整提示词与 few-shot;②候选生成——按角色规则出候选边,关键约束:core 可作 core/bonus/penalty 的前提;activation 可激活 bonus/penalty;bonus 与 penalty 不得作 core 的前提(防止「把可选修饰当地基」的荒唐边);③边标注——每个候选对判定 none/弱前提/强前提/激活,指示词是「仅当子明确依赖、特化或被父激活才加边,内容相似不是理由」;④验证与 DAG 投影——环与非法边剔除(0.42 条/评分表被清掉),91.84% 的评分表剩非空图(Table 3)。猜一下为什么角色约束要先筛候选再让模型判边,而不是让模型自由连边?(reveal 附录 A.3:候选约束「keeps the candidate graph aligned with the intended direction of rubric licensing」——先用规则把搜索空间压到语义合法的方向上,模型只做判别不做生成,错边率才可控。)
5.3 机制三:软抑制推理——一台只会压分的机器
§3.3–3.4 p.4–6:条件贝叶斯网络 P_{G_x}(c \mid p) = \prod_i P_i(c_i \mid c_{Pa(i)}, p_i)(Eq 9),每个因子是 3.1 的单调 CPD。整个模型的三条性质论文都给了证明级陈述:因子是合法伯努利 CPD(p、λ ∈ [0,1]);子概率对每个父状态单调;子概率以局部分数为上界。合起来:这台机器对下游事件的唯一动作是压——压多少由边类型与父的边际决定。
5.4 机制四:归一化期望符号奖励与两个极限
§3.4 Eq 14 p.6:S_{GEAR} = \sum_i w_i \hat{q}_i \,/\, \sum_{i:w_i>0} w_i。正权判据的分子按折扣后概率入账,负权判据的罚也按折扣后概率入账(错置惩罚同样被抑制——穿透示例里 C4 的 −3 被压到 −3×0.16)。分母只归一正效用质量,奖励落在约 [-1, 1]。两个极限(§3.4 末):λ 全 1 时 \hat{q}_i = p_i,退化为平坦聚合;选定边 λ=0 且父二值时,子被父确定性门控——硬门控是 GEAR 的一个极限点,不是对手方案。这个统一视角很重要:平坦、硬门控、GEAR 是同一个机制在 λ 参数轴上的三个点(γ 敏感性实验 §4.5 就是把这条轴参数化扫了一遍)。
5.5 最值钱的实验
Table 4(p.6,HealthBench-500 四行消融):平坦 56.7 / 随机重连图 55.8(−0.9) / 去类型图 60.4(+3.7) / 同图硬门控 54.6(−2.1) / 同图软抑制(GEAR)62.9(+6.2)。四行读出三件事:随机抑制无益甚至有害(「抑制了」本身不是价值);拓扑连接贡献一半以上增益(+3.7);类型化与软性再贡献另一半(+6.2−3.7=+2.5),而把软性换成确定性直接从 +6.2 掉到 −2.1。它单独撑起「FCP 是结构性问题、解法必须同时有信息与有弹性」的主张——本篇全部机制主张的四行压缩。
六、数学展开
6.1 均值场误差从哪来:一个能手算的相关双父(接 §三.2)
补充:Eq 12 把 CPD 的 C_j 换成 \hat{q}_j,等价于假设 \mathbb{E}[\prod_j \lambda^{1-C_j}] = \prod_j \mathbb{E}[\lambda^{1-C_j}]。父独立时乘积期望=期望乘积,精确;父相关时两者出现 Cov 项。构造最小例:祖 A → 父 j、k(各以弱前提),j、k → 子 i(各强前提)。\hat{q}_A = 0.6,则 j、k 的边际各是 \hat{q}_j = p_j(\hat{q}_A + (1-\hat{q}_A)\cdot 0.6)。取 p_j = p_k = 0.9:\hat{q}_j = \hat{q}_k = 0.9 \times (0.6 + 0.4 \times 0.6) = 0.9 \times 0.84 = 0.756。但 j 与 k 相关——共同祖先 A 不支持(概率 0.4)时两者同时被压:精确算联合,P(C_j=1, C_k=1) > 0.756^2 = 0.5715(A 支持的 0.6 概率分支里两者都高)。Eq 12 用 0.756^2 低估了联合支持——即均值场在共同祖先不稳时过度抑制子代。本站 P4 实测这个误差:独立双父恰为 0、相关双父 max|Δ| = 6.19e-3,200 个稠密合成图平均 0.0024——比论文真实图的 0.0068(Table 8)还小,因为真实图的判据数与边密度更高。方向性推论(本站):误差有系统性符号时,GEAR 的奖励对「共同前提不稳的判据簇」偏保守——这对奖励塑形是安全侧的偏差,但值得在图密度大的 rubric 里警惕。
6.2 双极限与合取分组:GEAR 参数轴上的三个点(接 §三.1)
补充:把 §5.4 的两个极限与本站聚合层第一篇对齐。ProRubric 精读的协议级合取分组是「组内判据全或无」——组内任一失败条款触发即清零。这正是硬门控语义(λ=0 + 二值判定)限定在组内的形态;本站 P0b 验证了 λ≡0 + 二值分时 GEAR 与级联硬门控逐位一致(200 图)。所以聚合层两篇的关系可以钉死:ProRubric 的合取分组 = GEAR 参数轴上「确定性端」的组内特例;GEAR 把这根参数轴显式化(γ 调定,Eq 17),并测出了甜点位置。γ 扫描(Table 18):γ=0(平坦)66.4、γ=0.5 得 70.7、γ=1(默认)72.6、γ=2 得 71.6、γ=4 得 68.0——分数先升后降,泄漏 LFCP 单调降(0.0922→0.0005)。甜点机制(§六.3 展开):泄漏的边际收益递减(γ=1 时已压掉 96.5%),而保存损失线性增长——两条曲线的差在 γ=1 附近最大。
6.3 硬门控为什么输给平坦:过抑制的账(接 §三.3)
补充:Table 1 里硬门控平均 64.0 低于平坦 66.4(−2.4),这是全篇最反直觉的一个读数——「堵住泄漏」怎么会比「放着泄漏」更差?账是这么算的:硬门控在违反案例上清零(省下错置惩罚与虚假信用),但在满足案例上,只要父的级联值掉到 0.5 以下(哪怕真值是 0.51,判官噪声或上游一次软抑制就能做到),子的全部信用清零。Table 2 保存率 0.1877:满足依赖的案例里平均只留 19% 的下游效用。训练信号变得极稀疏且高方差——RL 优化的是奖励的梯度,一个动辄清零的奖励面比一个有小泄漏的奖励面更难爬。对照 AdvancedIF 的全或无奖励赢了加权求和(58.1 vs 55.7,AdvancedIF 精读 Table)——两者矛盾吗?不矛盾,层次不同,§八.2 展开。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 贝叶斯网络/CPD/边际 | 已懂(教科书级,本篇 §3.3) | 条件模型 vs 生成模型的区分(p 是输入) |
| 拓扑序/均值场近似 | 已懂(本篇 §3.4 + 本站 P4) | 乘积期望≠期望乘积是误差来源 |
| GRPO/PPO 奖励接口 | 已懂(训练侧四篇旧识) | 奖励是标量,聚合层在判官之后、优势计算之前 |
| RaR 平坦聚合 | 已懂(本站精读) | 本篇 Eq 2 的点名出处 |
| ProRubric 合取分组 | 已懂(本站精读) | 聚合层第一篇,§八.1 对照 |
| MeRF / RuscaRL | 待补 | 两个 plug-in 宿主管线,本篇转引未读 |
| PaperBench 层级评分 | 待补 | 层级 rubric 前作(OpenAI),转引未读 |
| WritingBench / PLawBench | 待补 | 评测域本体,转引未读 |
八、扩展与发散
8.1 连一连:聚合层设计空间的两极——确定性协议 vs 概率图
发散:聚合层现在有两篇,解法构成一对映。ProRubric 精读把依赖写成协议:合取分组+失败条款,确定性执行,判据文本不动、只动怎么加;GEAR 把依赖写成图模型:typed 边+软抑制,概率执行,判据不动、只动怎么入账。两篇共享同一条设计哲学——合成的每一步别引入可被策略优化的自由度(ProRubric 精读的话):其失败条款是清零开关不是加减项,GEAR 的 λ 是固定类型值不学不调(附录 B.1 显式说这是为了把「依赖感知」的效果与「调参」的效果隔离)。分歧在硬度:协议端把违反当成确定事件(泄漏 0 但保存塌),图端把违反当成概率事件(泄漏近零且保存留下)。本站 P2 的边类型分解补了一个论文没给的观察:泄漏残留按 λ 序排列(act 0.0003 < st 0.0008 < wk 0.0016)——残留不是 bug 是 λ 语义本身,weak 前提的 0.6 就是「承认子有独立部分信用」。回到这篇:聚合层设计空间的第一根轴已经显形——违反的处理硬度,两篇各占一端,中间由 γ 连续连接(Eq 17)。
8.2 层次对照:判据内宁严勿硬 vs 判据间宁软勿硬
发散:现在有两个「全或无」读数摆在一起——AdvancedIF 精读的全或无奖励(对整个回答的 rubric 满足判定)赢过加权求和(58.1 vs 55.7);GEAR 的判据间硬门控输给平坦(64.0 vs 66.4)。矛盾吗?不——层次不同。AdvancedIF 的全或无作用在判据内聚合:单条判据的满足判定本身要严(部分满足的模糊给分是 exploit 面,RaR-Hack 的三失败模式都从这里进);GEAR 的门控作用在判据间许可:下游判据的入账要软(判官噪声与上游不确定让硬开关必然误触发)。合成的规律一句话:判定层要脆(明确的是/否),许可层要韧(渐变的留/压)——脆性给对抗者确定性信号(判据到底过没过),韧性给噪声缓冲(一次误判不清账)。可检验推论:把 GEAR 的 λ 全换 0(判据间也脆)应复现 Table 1 的 hard 行为;把 AdvancedIF 判据内二值判定换成软分数(frac 聚合 53.6)应复现它的垫底——两侧各有现成数据点,交叉预言成立。回到这篇:这解释了为什么 GEAR 的对抗面比 RaR-Hack 的聚合 hack 面小——软抑制没有「卡阈值」的可利用边界。
8.3 FCP 与 exploit:聚合层病理学的两面
发散:RaR-Hack 精读与本篇是聚合层病理的两个方向。RaR-Hack 的 exploit 是策略利用聚合:补偿结构让「表面满足多条易判据」比「真正满足一条难判据」更划算,策略学会钻;FCP 是聚合自伤:许可结构缺失让有效回答被错罚、表面回答被错奖,不需要策略主动钻,损失已经发生。两个方向共享一个前提:聚合层的自由度(怎么加、怎么门、怎么折)会被优化压力放大。防的方向也互补:AdvancedIF 精读的 anti-hacking 判据是写进判据层的对抗补丁,GEAR 的依赖图是写进聚合层的结构补丁。与 RubricHub 精读的判官噪声问题的接点:软抑制天然是判官噪声的缓冲——p 的局部误报被 λ 折扣稀释(P2 的泄漏残留分解就是这个稀释的定量面),这与 RubricHub 精读的「判官 30B 阈值」合读给出判官选型的另一维:判官可以弱一点,如果聚合层有结构缓冲。回到这篇:FCP 的命名让三篇精读的观察落在同一张病理地图上。
8.4 常见误读(破)
「GEAR 的提升来自多算了一个图」。破:Table 4 的随机重连图行(55.8,−0.9)——保持边数与类型频率、随机换连接对象,增益消失转负。提升不来自「做了抑制」这个动作,来自连接对不对;去类型行(+3.7)进一步说明类型信息再贡献一半。无信息的结构约束是负资产。
「硬门控更严格所以更安全」。破:Table 1 硬门控 64.0 < 平坦 66.4,且 Figure 3/Table 18 的 γ 扫描显示过强抑制(γ=4)68.0 同样低于默认。判据间许可的「严格」会把判官噪声放大成清零事件,训练信号稀疏化——泄漏是慢性病,过抑制是急性病,RL 的梯度两边都疼。
8.5 写作之维(论文自己怎样完成说服)
Figure 1 的三栏并排是全篇的修辞枢纽——平坦/FCP 病理/GEAR 三态并列,把「病理」画成一个有自己栏位的角色,命名的说服力在图上先于文字完成。标题把机制缩写藏进副词(「Probabilistic Graphical Reward Aggregation」)而把病理放在主干(「False Credit Propagation」)——先卖问题再卖方案,与 ProRubric 精读的标题策略同款。Table 2 的 0.0000 与 1.0000 两个端点值是精心安排的锚:硬门控和平坦各自占住一个极端,GEAR 的两个中庸数字(0.0032/0.2706)因此都显得「两头都占」。Limitations 五段全部自认(单调性限定/建图质量/λ 粗糙/域覆盖/人评是感知不是事实正确)——但「建图判官与训练奖励判官同为 Qwen3-8B」的自循环没有出现在 Limitations 里,这是本站在 §九 登记的最大遗漏。
九、局限与可疑处
- 单调关系限定:只建模「父不支持只能压子」的前提/激活关系——补偿、替代、互斥、非单调、环全部不在表达范围(§6 p.8 自认);判据遗漏也无法恢复(图只能用已有判据)。
- 建图自循环(本站登记,论文未提):图构建、训练奖励判官都是 Qwen3-8B,终评才是 Qwen3-32B(附录 D)。图的系统性偏差会以固定结构写进每一步奖励——等于给奖励函数加了一个未经审计的先验偏置。跨族复核(4.7 节换非 Qwen 全套保留 +5.9)部分缓解但未消除。
- 边精度 91.7%、recall 未测:180 边人审只查「留下的边对不对」(precision 91.7%、类型准确 87.3%、κ=0.80),漏掉的依赖有多少没人知道——漏边=FCP 原样保留(§6 p.8 自认「does not measure the recall of omitted dependencies」)。
- λ 三值 + 边类型分布未披露:0.6/0.2/0.0 是全局固定值(跨基准不调),但各基准的边类型构成论文没给——本站 P2 显示泄漏残留的构成完全由类型分布决定,96.5% 这个数的可迁移性存疑(G8 登记)。
- 域与规模:三域(医疗/写作/法律)+ 7B/8B backbone + 一个 30B 检查(单 run,附录 E.3);7B 级结论外推到前沿规模无数据。人评 250 对测的是「rubric 对齐感知」不是领域事实正确(§6 自认)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是 GRPO 真实训练(7×8 昇腾 910B、VERL、Qwen2.5-7B/Llama-3.1-8B、3 seeds)——不可复现。本复现是聚合机制的合成演绎:双极限等价、单调有界、泄漏-保存双指标、贯穿示例数值、均值场边界五件机制,全部纯 CPU、LCG 确定性。论文真实数字只作引用并注明出处(Table 1/2/8/18 与 Figure 1)。
10.2 可证伪预测与判据(轮 3 冻结版,运行前写死于脚本 docstring)
- P0 双极限等价:λ≡1 时 GEAR≡flat(200 随机图奖励逐位一致,tol 1e-12);p∈{0,1} 且 λ≡0 时 GEAR≡级联硬门控(200 图逐位一致)。
- P1 单调有界(Eq 13):200 图全部节点 p_i\prod\lambda \le \hat{q}_i \le p_i 零违例;任一父分数提升后子边际不减零违例。
- P2 泄漏-保存双指标(Eq 15/16,轮 2 世界修正:双峰判官分+强制先决链):lf_flat ≥ 2×lf_gear;泄漏残留严格序 act<st<wk(λ 序传导);wk 占比 ≥0.5;pr_gear > pr_hard;lf_hard = 0。
- P3 贯穿示例(Figure 1):p=(0.2,0.8,0.2,0.8)、C1→C2 强前提、C3→C4 激活、w=(4,3,−2,−3) 下 q̂=(0.2, 0.288, 0.2, 0.16)、S_flat=0.4/7≈0.05714、S_gear=0.784/7=0.112(全部 tol 1e-9);方向 S_gear > S_flat 且子判据被抑制。
- P4 均值场边界:独立双父 topological≡exact(<1e-12);相关双父(共同祖先)max|Δ|>1e-6;200 稠密图平均 |Δmarginal|<0.05(对照论文真图 MAE 0.0068)。
10.3 实现演化(三轮,如实登记)
轮 1(4/5):P2 双判据 FAIL——均匀 p~U[0,1] 让大量父分数贴着 0.5 阈值下沿(软抑制因子≈0.76,泄漏残留 65.6% 过判据),浅图让硬门控级联损失不显现(保存 0.56 反超 gear 0.50,与论文序相反)。根因=世界误设:真实判官分数两极化(HealthBench 判官输出 binary+置信度)、真实 rubric 图有深先决链(平均 1.37 父但连通)。轮 2(4/5):世界修正(双峰 p + 每图强制 3-5 先决链)后序全部恢复——泄漏降 5.5×、保存序与论文同向(hard 0.344 < gear 0.381),唯「wk 泄漏占比 >80%」FAIL(实测 59.8%)——判据误设:多父混杂下机制只能推出残留按 λ 序排列,推不出份额下限。轮 3(冻结,5/5):P2 判据改为机制级严格序断言(act<st<wk + wk 占比 ≥0.5)。核心教训:合成世界的判据要顺着机制的「必然产出」写(序、方向、恒等式),份额与数值带要对照论文有披露的量——论文没披露边类型分布,硬卡 80% 就是在没锚的地方立尺子。
10.4 运行结果与预测对照
脚本 repro/repro_gear.py,真实输出
repro/repro_gear_output.txt(轮
3 冻结,输出 sha256 前 16 位
abbd79ed5a9abe1e;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 双极限 | §3.4 极限陈述(文字) | λ≡1≡flat 与 λ≡0+二值≡硬门控各 200 图逐位一致 | 极限情形的机器验证 |
| P1 单调有界 | Eq 13(解析) | 12230 次检查零违例(界+单调) | 解析界的 MC 背书 |
| P2 双指标 | Table 2:0.0922/0.0000/0.0032;1.0000/0.1877/0.2706 | 0.1848/0.0000/0.0338;1.0000/0.3437/0.3809;残留序 act 0.0003<st 0.0008<wk 0.0016(占 59.8%) | 序与结构全对齐;数值幅度由边类型分布决定(论文未披露——G8 登记) |
| P3 贯穿示例 | Figure 1(定性三栏) | q̂=(0.2, 0.288, 0.2, 0.16)、S_flat=0.05714、S_gear=0.112 精确复演 | 数值例自洽 |
| P4 均值场 | Table 8:MAE 0.0068(HealthBench) | 独立双父 0、相关双父 6.19e-3、稠密图均 0.0024 | 误差只在相关多父出现——与理论条件一致 |
结论:[Re] 全部假说复现通过——三轮冻结(轮 1 世界误设、轮 2 判据份额误设、轮 3 机制序判据,均如实登记);轮 2 的泄漏类型分解转化为本站产出(残留按 λ 序排列=weak 前提 0.6 的语义本身)。
十一、方法论提炼与迁移
模式一:依赖感知聚合(Dependency-Aware Aggregation)
- 操作定义:把「条目间有许可关系」的加总问题建成 typed 图,每个条目的入账量 = 局部得分 × 各许可条件的留存率连乘;留存率按关系类型分档固定,不学不调。
- 成功判据:用了之后,「许可条件不成立时下游条目被计入的量」显著下降,同时「许可条件成立时下游条目保住的量」不低于某个预设线——两把尺子同动才算用对(只动一把=抑制开过头或没开)。
- 迁移去向:①代码评审门禁——「性能优化加分」以「测试全绿」为前提,测试红了加分项按 λ 折扣而非照计;②课程先修链——进阶题得分以基础题掌握度为前提,诊断报告里进阶分按先决掌握度打折;③医疗指南路径——用药推荐分以禁忌症筛查通过为激活条件。
- 方法卡:
notes/method_dependency_aware_aggregation.md(L1) - 层级:L1 领域具体(奖励工程/评分聚合)。底层原理:单源派生一致性(种子 29)的依赖版——许可关系写进聚合规则而不是散在判断里。
模式二:泄漏-保存双指标(Leakage-Preservation Pair)
- 操作定义:任何「抑制型」干预(过滤/门控/折扣/封禁)的验收必须同时报两个数——违规案例上的残留量(越低越好)与合规案例上的保有量(越高越好);只报残留量的方案一律视为未验收。
- 成功判据:用了之后能回答「压掉了多少不该压的」——若答不出,说明验收指标本身缺了一半;硬门控式方案(构造性零泄漏)必然在保有量上现形。
- 迁移去向:①告警系统降噪——漏报率与误报抑制后的真报保存率成对报;②权限收紧——攻击面缩小与正常用户完成率成对报;③内容审核——违规召回与正常内容误伤成对报。
- 方法卡:
notes/method_leakage_preservation_pair.md(L1) - 层级:L1 领域具体(评测方法学)。底层原理:前提-度量-方向三层指标(种子 22)的对偶版——每个「压」的方向都必须配一个「留」的方向做对照组。
十三、没搞懂的地方(未攻克登记)
- 建图自循环的量级:Qwen3-8B 既建图又当训练奖励判官——图的系统性偏差与判官偏差同源,会不会相互放大?跨族复核保留 +5.9 说明不是全部,但自循环份额未分解。补齐时机:跨族建图(GPT 系建图+Qwen 判官)的对照实验,或仓库内的图统计审计。
- 边类型分布:三基准各自动的弱/强/激活占比论文未披露——本站 P2 显示 96.5% 降幅对类型分布敏感。补齐时机:仓库数据统计或作者补充。
- Conditional Rewrite 与 GEAR 的差(70.2 vs 73.3,Table 5):把依赖写回判据文本再平坦聚合能挽回一半——归因是「分解判据保留」还是「显式聚合增量」,论文给了定性讨论没给消融。补齐时机:两因子 2×2(分解×显式聚合)实验。
- 相关多父在真实图中的占比:均值场误差(本站 6.19e-3)在真实 HealthBench 图(平均 1.37 父、24.4% 双父)上多大比例的节点受影响?Table 8 的 0.0068 是总量不是分布。补齐时机:仓库图数据按父相关结构分组复算。
- v1→v2 diff:2026-08-26 修订内容不明。补齐时机:arXiv diff。
十四、可信度
- A 级:§3 全部公式(Eq 1–17 逐条与 pdftotext 原文比对)、Table 1 主结果(±0.4–0.9 三 seed 方差)、Table 2 FCP 诊断、Table 4 消融、Table 7 保持因子、Table 18 γ 敏感性。
- B 级:Figure 1/2/3(图读);Table 3/16 效率统计;附录 B.2 精确推断一致性;4.7 跨族复核(5.9 单点);Table 15 30B 检查(单 run)。
- C 级:§三 三本账、§六 三段推导、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读、层次规律(判据内宁严勿硬/判据间宁软勿硬)、泄漏残留的 λ 序解释。
- 横向核实初核(2026-10-09):版本 v2 已核(abs 页 2026-10-09 亲核;v1 2026-06-02 / v2 2026-08-26;v1→v2 diff 未核——登记,§十三.5);机构已核(p.1 脚注北航/BAAI/清华+通讯邮箱 buaa.edu.cn;abs 页未列机构——登记);工件 github.com/LvCan926/GEAR 为摘要自述(本站未访问仓库——登记);资助信息在致谢节(NSFC 62401327/62672026+北京重大项目+BAAI);统计审查:主结果三 seed 有方差(±0.4–0.9),但 30B 检查与跨族检查为单点(登记);人评 250 对有 95% Wilson CI(66.7–78.3%)与 κ=0.72(全篇唯一置信区间);图构建统计只给均值(Table 3/16),无分布(登记)。
- 实验充分性评价:部分充分——三域×双 backbone×三管线×三 seed 的主矩阵扎实,消融四行把机制拆干净;缺:建图自循环消融、边 recall 审计、前沿规模验证。
- 性能支撑目标检查:goal「依赖感知的聚合修好 FCP 且不伤训练」——支撑(泄漏 −96.5%+保存优于硬门控+三管线即插即用);「拓扑/类型/软性三件必要」——支撑(Table 4 四行消融直接对应)。