外行导读(先读这个,再决定要不要进正文)
一个场景:你的智能体干活总是栽在同一些低级坑上——环境没装对、输出格式差一个字段、后台服务忘了关、命令写错一个字符。第二次遇到同类任务,它把上次的执行记录翻出来塞给它(「上次你是这么干的」),或者更进一步:让一个模型把那些记录蒸馏成一页「操作手册」(SKILL.md——装什么、按什么顺序调工具、查什么、避开什么坑)再塞给它。后者就是业界热起来的「技能(skills)」。但它到底为什么有用?多数研究只回答「有用没有」(成功率涨没涨),不回答「为什么有用、什么时候没用」。
这篇论文干的事:把同一批历史轨迹装进三种容器——原样、清洗过的轨迹记忆(Workflow Memory)、蒸馏过的一页技能(SKILL.md)——在 528 个「同任务三臂对照」里同测,再用判官模型给 1584 条轨迹逐条贴行为标签(12 种模式),最后把检索环节单独拎出来做池大小 5→100 的压力实验。三个答案:①技能有用的主机制是程序性锚定——它像清单一样稳住动作(占 65.7%),不是往模型里灌知识(只占 4.5%);②它的代价是新失败面——「误用/忽略技能」从 0.8% 涨到 10.0%;③检索准不准和任务做不做成是两本账——池子大了精确率崩到 3.3%,成功率纹丝不动。
为什么值得关心:三个理由。第一,它是 agent 技能线的地基测量——依赖图上「技能」从此有了机制标签而非只有成功率,Trace2Skill/SkillsBench 一族终于有了「为什么」这一层。第二,它与今早的 Memex(种子 26)构成同一枚硬币的两面:Memex 管「经验怎么存」(索引化无损),本篇管「经验怎么用」(蒸馏成锚)——两篇同日读,agent 经验管理的存/取/用三段第一次齐了。第三,它的账本结构是本站见过的最干净的一份:所有关键百分比在 528 基数上都有唯一整数分子(65.7%=347/528、4.5%=24/528),配对差 +6.06pp=(327−295)/528 逐位可复算——统计审计复现的满分载体。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Skill / SKILL.md | 一页标准化「操作手册」:做什么、按什么顺序、查什么、避开什么坑(Anthropic 2025 技能库的形态) |
| Workflow Memory(WF) | 清洗过的历史轨迹记忆——保留可复用步骤,也保留探索、失败分支与过程噪声 |
| Raw | 无先验的裸执行基线 |
| 轨迹混合 5s0f…0s5f | 蒸馏源里成功/失败轨迹的配比(5 成功 0 失败 … 0 成功 5 失败) |
| 配对三元组 | 同一任务 × 三臂(Raw/WF/Skill)的对照单元,共 528 个 |
| 程序性锚定(procedural anchor) | 技能给的是可用的步骤/顺序/清单/检查——稳动作 |
| 知识注入(knowledge injection) | 技能给的是原本缺的领域事实——补知识(少数派 4.5%) |
| SC1/SC2/SC3 | 成功类 / 执行与验证失败类 / 调用与边界失败类(12 模式的三大组) |
| 三臂检索实验 | Arm1 嵌入排序(不执行)/ Arm2 显式选择(不执行)/ Arm3 全池真执行 |
| 实际使用精确率 | 执行中真正查看/调用的技能里,属于标注正确技能的比例 |
| oracle 成功 | 判官按验证器口径计的成功(61.9% vs 分类学口径 61.7%,差 1 条轨迹) |
§0 承接栏
这颗种子接的是 agent 线的第二格,与今早闭环的 Memex(种子 26)是同一枚硬币的两面:Memex 回答「经验怎么存」——索引化无损、按需解引用;本篇回答「经验怎么用」——蒸馏成什么样的过程表征才稳得住执行。两篇在同一周出现不是巧合:记忆线(怎么存)与技能线(怎么提炼)在 2026 年同时撞上了「聚合成功率说不清机制」这堵墙。对判分器线它是正面旁证:本文的核心手艺就是「LLM 判官编码 + 人工校验 + 计数账本」,与本站 LLMBar 三分账本、JudgeDebias 配对计数审计同一族——只是判的对象从裁判输出换成了轨迹行为。它同时兑现依赖图上挂着的「技能」节点:从 Trace2Skill 候选池的旁注,升级为有 12 模式分类学与机制标签的测量地基。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:工具型智能体的重复失败多数不是高层推理缺货,而是「一再重新发现同样的过程细节」——装环境的顺序、依赖的绕法、输出的格式约定。技能的承诺正是压缩这种经验:比存原始轨迹短、比存工作流记忆标准、还可能跨任务迁移。但现有评价只看聚合成功率:技能组分数高就是好——至于它改变了行为的哪个部分、为什么同一个技能救了这个任务坑了那个任务,黑箱。
1.2 旧做法的病根:聚合成功率的三重盲(§1 p.2)
第一重盲:机制盲——成功率涨了,不知道是补了知识、稳了动作、还是单纯多喂了上下文。第二重盲:位置盲——「有没有用」是均值问题,「什么时候有害」是分布问题;0s5f(全失败源)的技能在均值里被 5s0f 淹没。第三重盲:管线盲——技能要经过「被检索→被理解→被调用→被适配」才落到执行,聚合成功率把四环的失效揉成一团。论文的处方:沿管线逐环受控测量 + 对照轨迹分析。
停下来猜一下(猜论文):先验上「技能为什么有用」有两个候选答案——A 它灌了模型缺的知识(像检索增强);B 它稳住了模型的动作(像检查清单)。你押哪个?猜完翻 §5.1——论文的答案是 65.7% 对 4.5%,压倒性的 B。但更有信息量的是 A 没死透(4.5%):两种机制并存、比例悬殊——「稳动作」是主菜,「补知识」是偶尔的配菜。
1.3 问题形式化的入口(§3.1 p.4)
四个 RQ 把「技能有没有用」拆成四个可测的子问题:RQ1 表征——同一批源轨迹,装成 WF 与 Skill 哪种容器更好用?RQ2 结果标注——蒸馏时看得见/看不见成败标签差多少?RQ3 跨框架——在 Codex 里蒸馏的技能,搬到 Gemini CLI 还灵不灵?RQ4 检索——池子变大变混,找得到、用得上吗?注意这四个问题共享同一个受控骨架(源轨迹池固定、混合比网格化、三臂同测),只在各自关心的维度上松一个旋钮——这是本站熟悉的「单变量对照」纪律(MATTRIB 的又一次现身)。
二、核心想法
一句话:别问技能有没有用——把同一批经验装进三种容器、在同一批任务上同测,再用判官给每条轨迹贴行为标签,让「有用」分解成「哪种机制、救了哪类失败、付了什么代价、卡在哪一环」。
直觉先打底。这像药品临床试验的双盲设计:病人(任务)随机分组但不比组间——每个病人先吃安慰剂(Raw)、再吃仿制药(WF)、再吃原研药(Skill),三个疗程的病情逐日记录(轨迹),最后由盲评医师(判官模型+人核)给每份记录贴标准化诊断(12 模式)。药效不是「治疗组平均多活几年」,而是「哪种病理环节被药物逆转、哪种没动、出了什么新副作用」。
全篇就看这张:图 122——左边是受控设计骨架(源轨迹六档混合 → 同池双蒸馏 → 三臂同测 → 528 三元组 → 分类学+机制标签+检索三臂),右边是四问四答的全部核心读数(+6.06pp / 65.7 vs 4.5 / 漏斗 29.6→3.3 配平坦 36.4→39.3)。
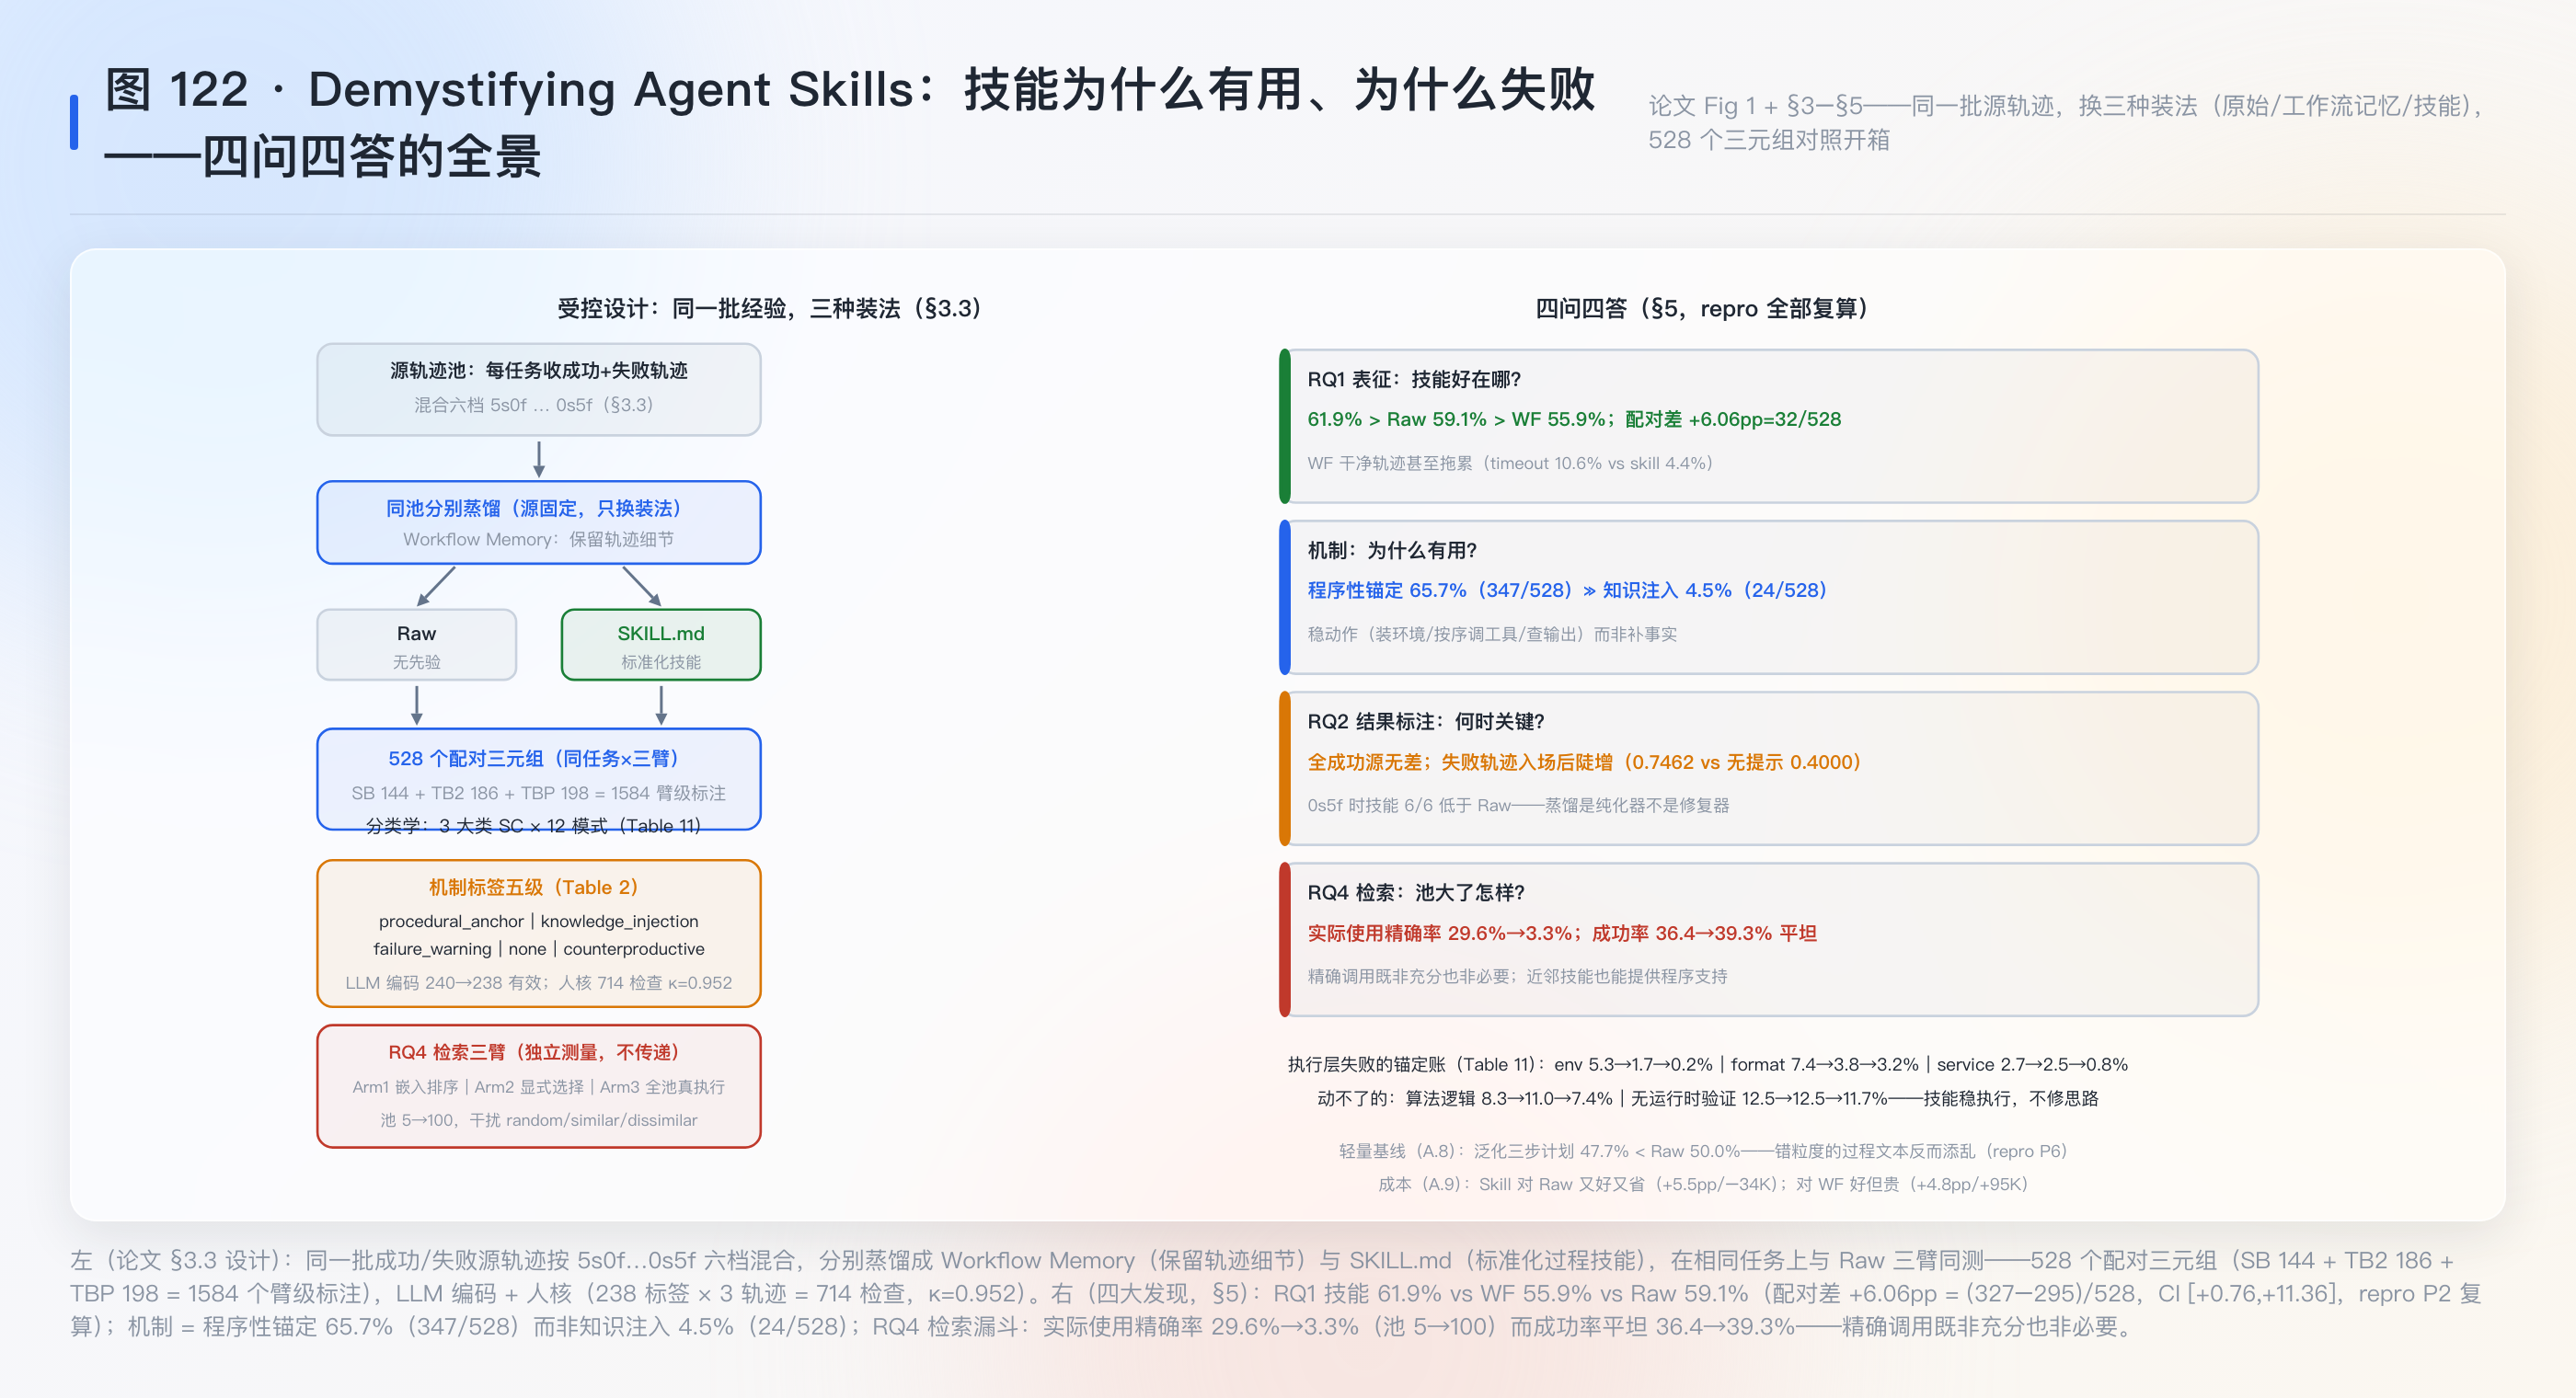
形式化入口:分析单元是配对三元组(task, arm∈{Raw,WF,Skill}, 模式标签)——528 个三元组给出 1584 个臂级标注;效应量的最小单位不是「组均值的差」而是「同一任务内两臂的模式迁移」(§4 p.7)。它把问题重新形式化成了什么?从「技能组的成功率」变成「三臂间的行为分布迁移」——成功率的 +6.06pp 只是这个分布账本的第一行汇总。
三、数学基础(零起点,四件工具逐一拆解)
本节外部断言:Cohen’s κ 为标准统计量;bootstrap CI 为标准方法;其余见文首核对状态块。
3.1 第一件:配对差账——为什么必须是 (327−295)/528 而不是两组均值相减
先摆问题。任务难度方差极大(Raw 从 40% 到 70% 不等),不配对的话,Skill 组与 WF 组若任务构成稍有不齐,「组差」里就混进任务间方差。配对三元组把任务因素全消掉:每个三元组内三臂吃的是同一个任务。
活路:净差 = (Skill 臂成功的三元组数 − WF 臂成功的三元组数)/ 三元组总数 = (327−295)/528 = 6.06pp(§5.1 p.8;repro P2 逐位复算)。注意分子是 32 对——它不是「Skill 赢的 32 对」,而是「Skill 赢对数与 WF 赢对数的净额」:可能有 100 对 Skill 赢、68 对 WF 赢,配对内部的迁移被净额抹平(补充——论文未给 win/loss/tie 明细,这是 CI 宽达 10.6pp 的镜像,见 §六.3)。
数值例(贯穿示例立账):61.9%−55.9%=6.0pp 是「四舍五入后相减」;(327−295)/528=6.06pp 是「先算分子再相除」——两位小数的差别提醒你:账本口径要一路抓到整数分子,不然每一层四舍五入都在漏账。§十.2 的复现 P2 就是抓这个的。
3.2 第二件:开放编码与分类学——12 个模式怎么来、怎么验
先摆问题。「行为改变」是定性材料(轨迹转录),要变成可统计的对象需要编码:开放式打标 → 归并成类目 → 校验编码稳定性。
论文的三步(§4 p.7):①归一 8135 条试验记录(任务/臂/验证器结果/注入物/轨迹),其中 7837 含转录;②开放编码抽样 240 条、留 238 个有效唯一标签;③归并成 3 SC × 12 模式。校验两步走(Table 3 p.7):每个标签配 3 条支撑轨迹人核(238×3=714 检查,全部确认标签有据);再由人独立把 238 个原始标签映射到 12 个规范模式——与 LLM 聚合比,95.8% 完全一致、Cohen’s κ=0.952。
你有没有注意到 κ=0.952 校验的是什么、不校验什么?它校验「人-LLM 在归类上一致」,不校验「标签与任务成败的真值一致」——效度与一致性是两码事(§九.2 登记)。这是所有判官编码研究的共同软肋(本站判分器线同款病根)。
3.3 第三件:机制标签——五级量表把「为什么」钉死
12 模式回答「发生了什么」,五级机制标签回答「注入物起了什么作用」(Table 2 p.7):procedural_anchor(给了可用步骤/顺序/清单/检查)、knowledge_injection(补了原本缺的领域事实)、failure_warning(预警了被避开的坑)、none(没有意义地用了一下)、counterproductive(把执行带沟里)。判官对每个三元组标注两臂间变化 + 机制归因。65.7% 对 4.5% 的主读数就出在这张量表上(§5.1 p.8)。
段末微问:量表为什么不并成三级(有用/没用/有害)?因为「有用的方式」正是研究对象——锚定与注入对技能设计的指示完全不同:前者要求把步骤写清楚,后者要求把事实写全。量表粒度=可行动性。
3.4 第四件:检索的三本账——精确率、召回率、成功率为什么必须分开记
先摆问题。「找到对的技能」直觉上该决定成败——但找到(offline 识别)、用上(执行时访问)、做成(验证器过)是三个环节,各有各的失败率。混在一起记就会得出「检索决定一切」或「检索无关」两个都错的结论。
论文的三臂(§3.3 p.6,RQ4):Arm1 嵌入排序(不执行,测识别)、Arm2 显式选择(不执行,测判断)、Arm3 全池真执行(测使用与完成)。三臂独立、结果不传递——这是设计上最要紧的一笔:Arm3 的 agent 从头到尾没见过 Arm1/2 的输出,池是全量给到的。指标按论文式 (1)(2)(p.21)逐记录计算再聚合:
P_i = \frac{|G_{b_i} \cap G_t|}{|G_{b_i}|}, \qquad R_i = \frac{|G_{b_i} \cap G_t|}{|G_t|}
其中 G_{b_i} 是第 i 条记录的预测技能集、G_t 是任务的标注技能集(|G_t| > 0,预测集为空则两项记零);聚合 P, R 取记录均值,F_1 = 2PR/(P+R) 由聚合值重算而非平均记录级 F_1——口径纪律,值得学(避免辛普森式的聚合错位)。
3.5 整体收拢
四件工具一条链:配对账消任务方差(3.1)→ 编码把行为变成可数对象(3.2)→ 机制量表把「为什么」变成标签分布(3.3)→ 三本账把管线各环节分开计量(3.4)。回到这篇:论文的数学不难(全是计数与比例),难的是口径纪律——每一步都在防「不同口径的数被拿来相减」。这正是审计型研究的核心手艺。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| 5s0f…0s5f | 源轨迹池的成功/失败配比(六档网格) | §3.3 p.5 |
| (task, arm, mode) | 配对三元组的臂级标注单元 | §4 p.7 |
| SC1/SC2/SC3 | 成功 / 执行验证失败 / 调用边界失败 三大类 | Table 11 p.22 |
| procedural_anchor 等 | 五级机制标签 | Table 2 p.7 |
| P_i=|G_{b_i}∩G_t|/|G_{b_i}| | 逐记录精确率(预测技能集对标注集) | Eq 1 p.21 |
| R_i=|G_{b_i}∩G_t|/|G_t| | 逐记录召回率 | Eq 1 p.21 |
| k ∈ {5,10,20,50,100} | 技能池大小 | RQ4 |
| random/similar/dissimilar | 干扰项采样三 regime | §3.3 p.6 |
| +6.06pp | 配对净差 =(327−295)/528 | §5.1 p.8 |
五、机制
5.1 机制一:程序性锚定——技能是检查清单不是百科(§5.1)
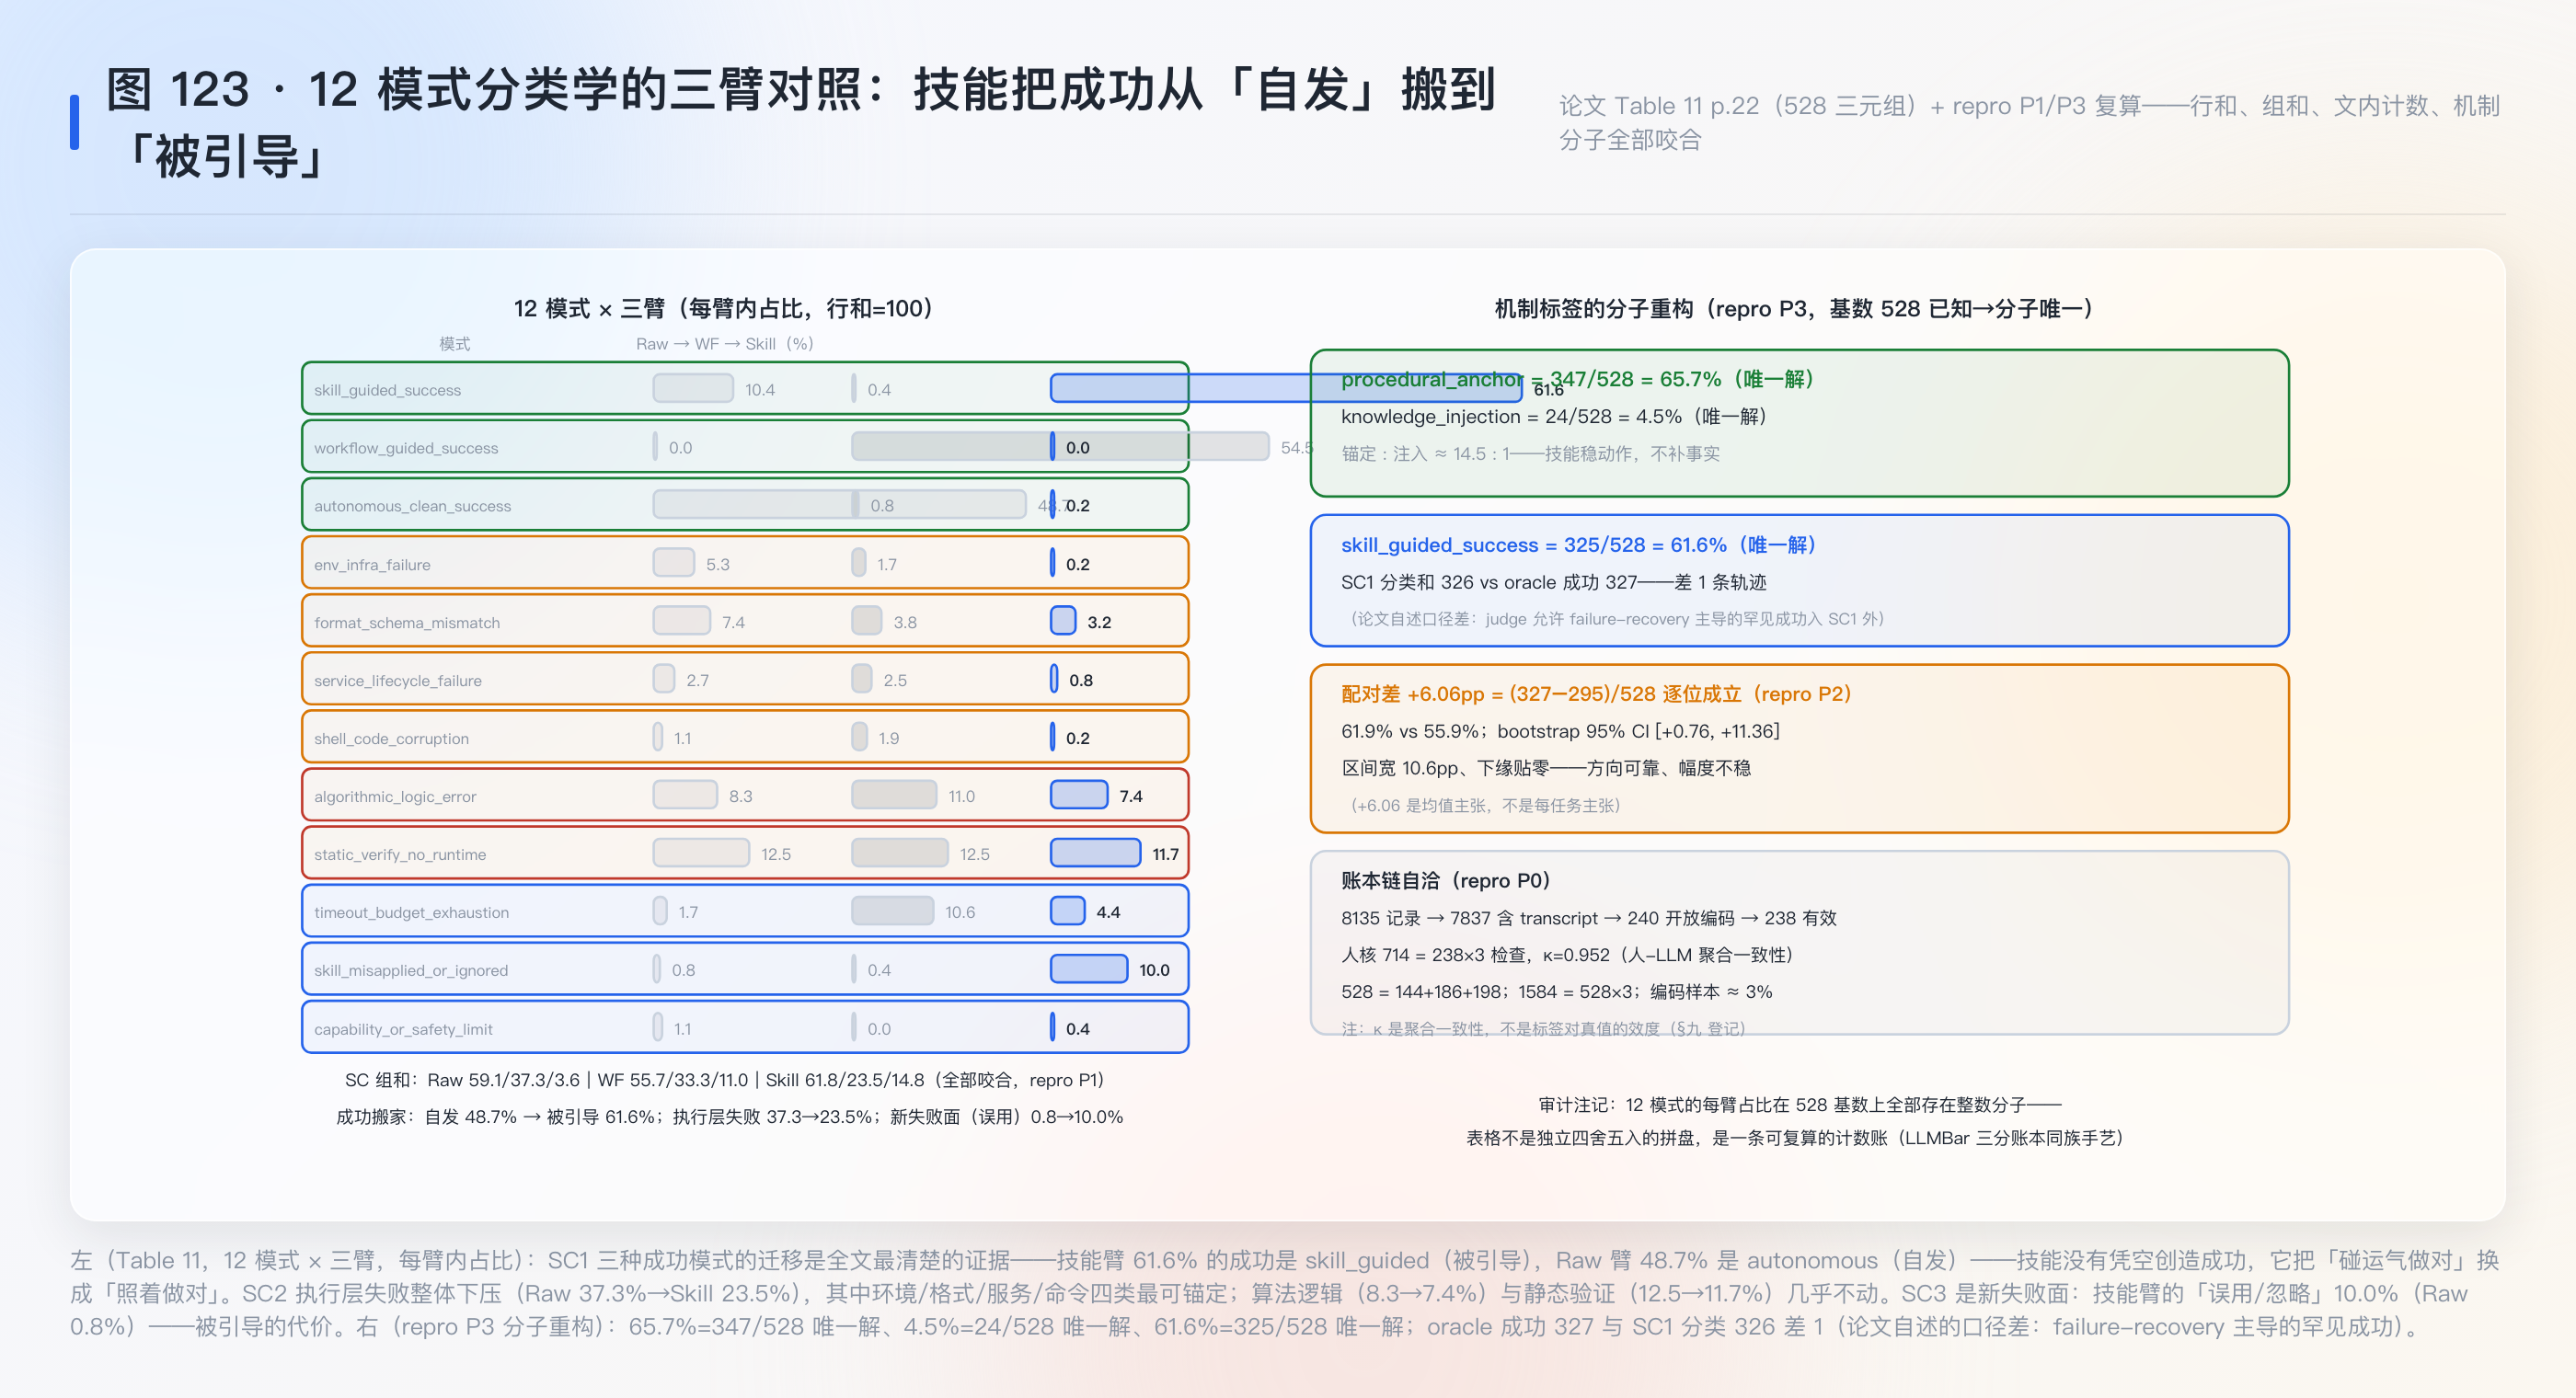
主读数三层:①成功率:Skill 61.9% > Raw 59.1% > WF 55.9%——注意排序!WF(干净轨迹记忆)居然低于裸跑,论文的解释是过程残渣(timeout 10.6% vs Skill 4.4%)——太长的先验把 agent 拖进无关细节(§5.3 p.9)。②机制归因:procedural_anchor 65.7%(347/528)对 knowledge_injection 4.5%(24/528)——技能通过「告诉它怎么做」而非「告诉它是什么」起作用(§5.1 p.8)。③成功模式搬家:Raw 的成功 48.7% 是 autonomous(自发做对),Skill 的成功 61.6% 是 skill_guided(照着做对)(Table 11 p.22;repro P3 分子重构 325/528)。
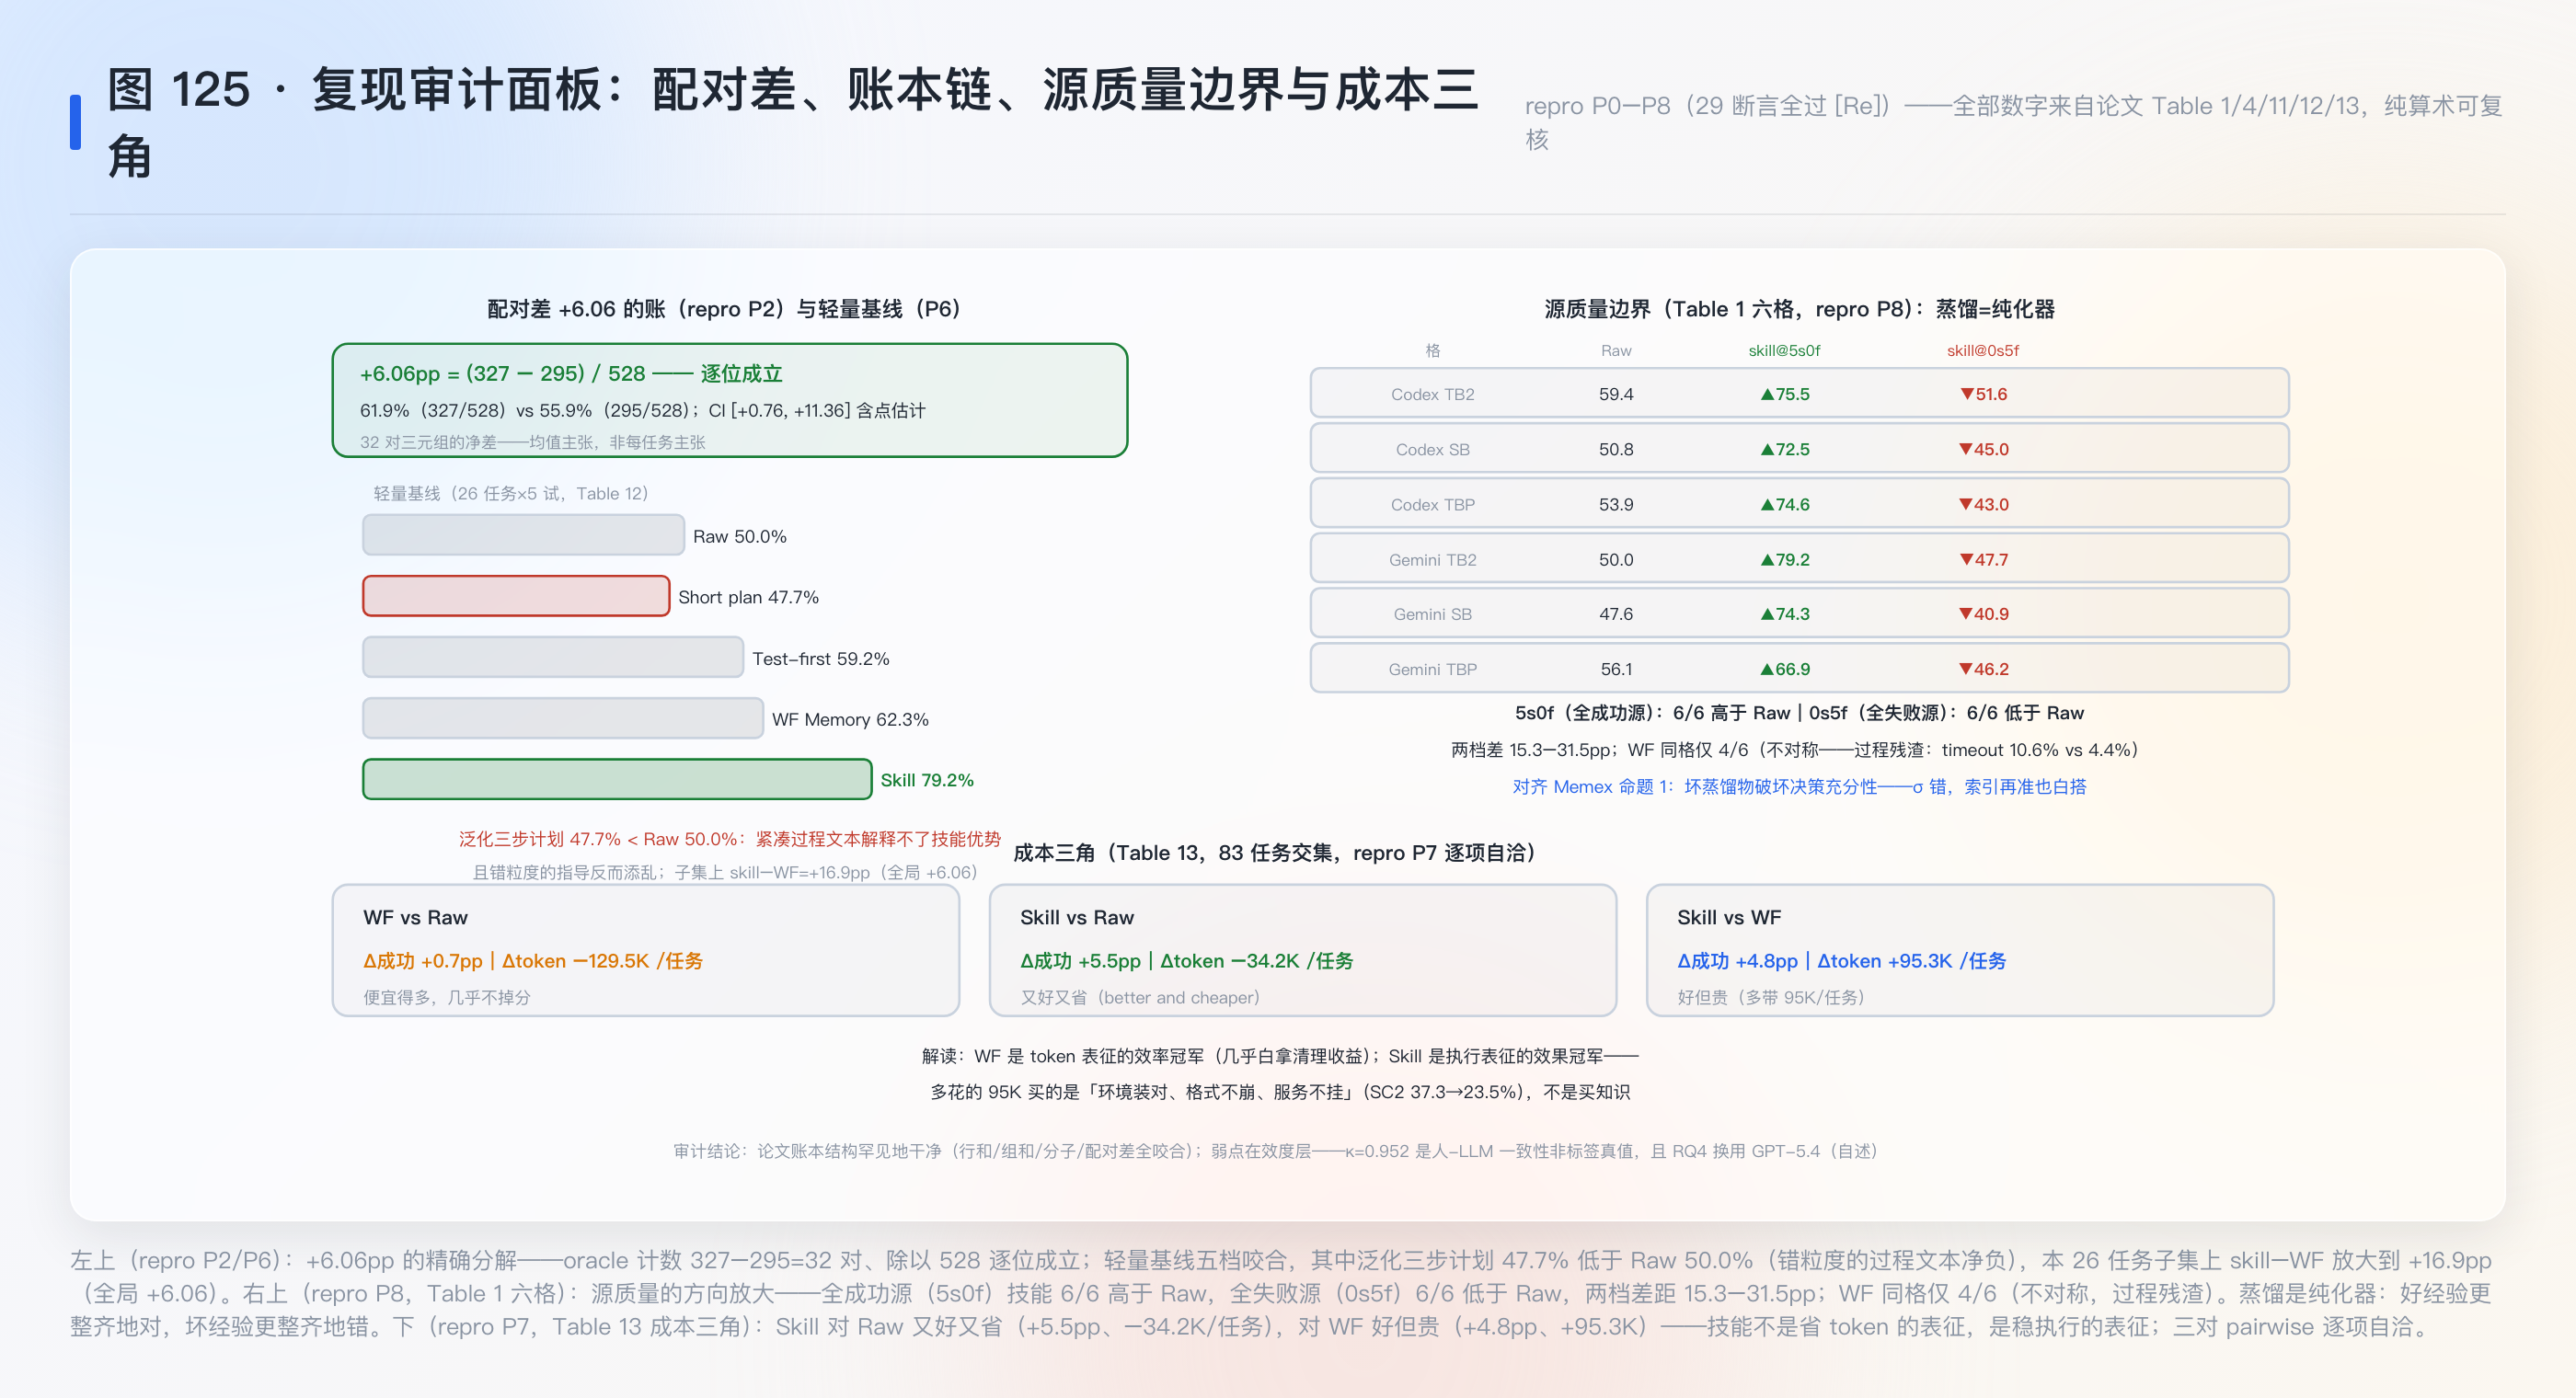
最值钱的实验(Table 12 轻量基线,A.8 p.22):为了排除「技能优势只是多了段紧凑过程文本」,论文加了两条便宜基线——指令派生的三步计划(47.7%)与工作流派生的测试优先模板(59.2%):都低于 WF(62.3%),远低于 Skill(79.2%)。泛化计划甚至低于 Raw(50.0%)——错粒度的过程指导是净负资产。这一张小表单独撑起「表征形式本身重要」的主张:内容相近、形态不对,效果反转。
5.2 机制二:锚定的边界——稳执行不等于修思路(§5.2)
SC2 执行层的账(Table 11,三臂 Raw→WF→Skill):环境设施失败 5.3→1.7→0.2%、格式失配 7.4→3.8→3.2%、服务生命周期 2.7→2.5→0.8%、命令损坏 1.1→1.9→0.2%——四类「可锚定」失败全线压低;但算法逻辑错误 8.3→11.0→7.4%(WF 反而更高——过程残渣挤占思考?补充推断)、静态验证缺失 12.5→12.5→11.7% 几乎不动。这两类是「需要重新表述问题或真跑运行时验证」的失败——检查清单管不了(§5.2 p.9 原文:skills do not automatically repair a wrong algorithm or force oracle-aligned validation)。
连一连(跨种子):这张「哪些失败可锚定」的账和 LongHorizon-Harness(种子 1)的完成判定结构是同一问题——MEA 循环里「执行层的坑」靠状态管理救、「验证层的坑」靠审计通道救。技能是执行层的救法,救不了验证层——两篇隔着两个月在同一个结论上会师。
5.3 机制三:新失败面与 WF 的另一种死法(§5.3)
SC3 的账:技能臂「误用/忽略指导」10.0%(Raw 0.8%、WF 0.4%)——被引导的代价;WF 臂「超时/预算耗尽」10.6%(Raw 1.7%、Skill 4.4%)——过程残渣的代价。两种表征各有各的死法:紧凑抽象死于用错场合,冗长痕迹死于拖垮预算(§5.3 p.9)。这组对称读数是「表征设计是权衡而非升级」的最硬证据。
5.4 机制四:RQ2/RQ3/RQ4——标注、迁移与漏斗(§5.4–5.5)
RQ2(结果标注):全成功源(5s0f)时有无成败标签几乎无差;失败轨迹入场后差距陡增——Gemini TB2 3s2f 档 0.7462(有标签)对 0.4000(无标签)(§5.4 p.10)。解读:标注的价值在排错——知道哪条路不通,蒸馏时才绕得开。0s5f 全失败源时技能 6/6 低于 Raw(Table 1 六格全数;repro P8)——蒸馏是纯化器不是修复器:坏经验被蒸馏得更整齐地错。
RQ3(跨框架,Fig 4 p.8):Codex 蒸馏的技能搬到 Gemini CLI 仍普遍有效(各混合档多在目标框架 Raw 线之上;0s5f 例外)。蒸馏态比原始痕迹更可移植——这是「技能=标准化接口」主张的实证面。
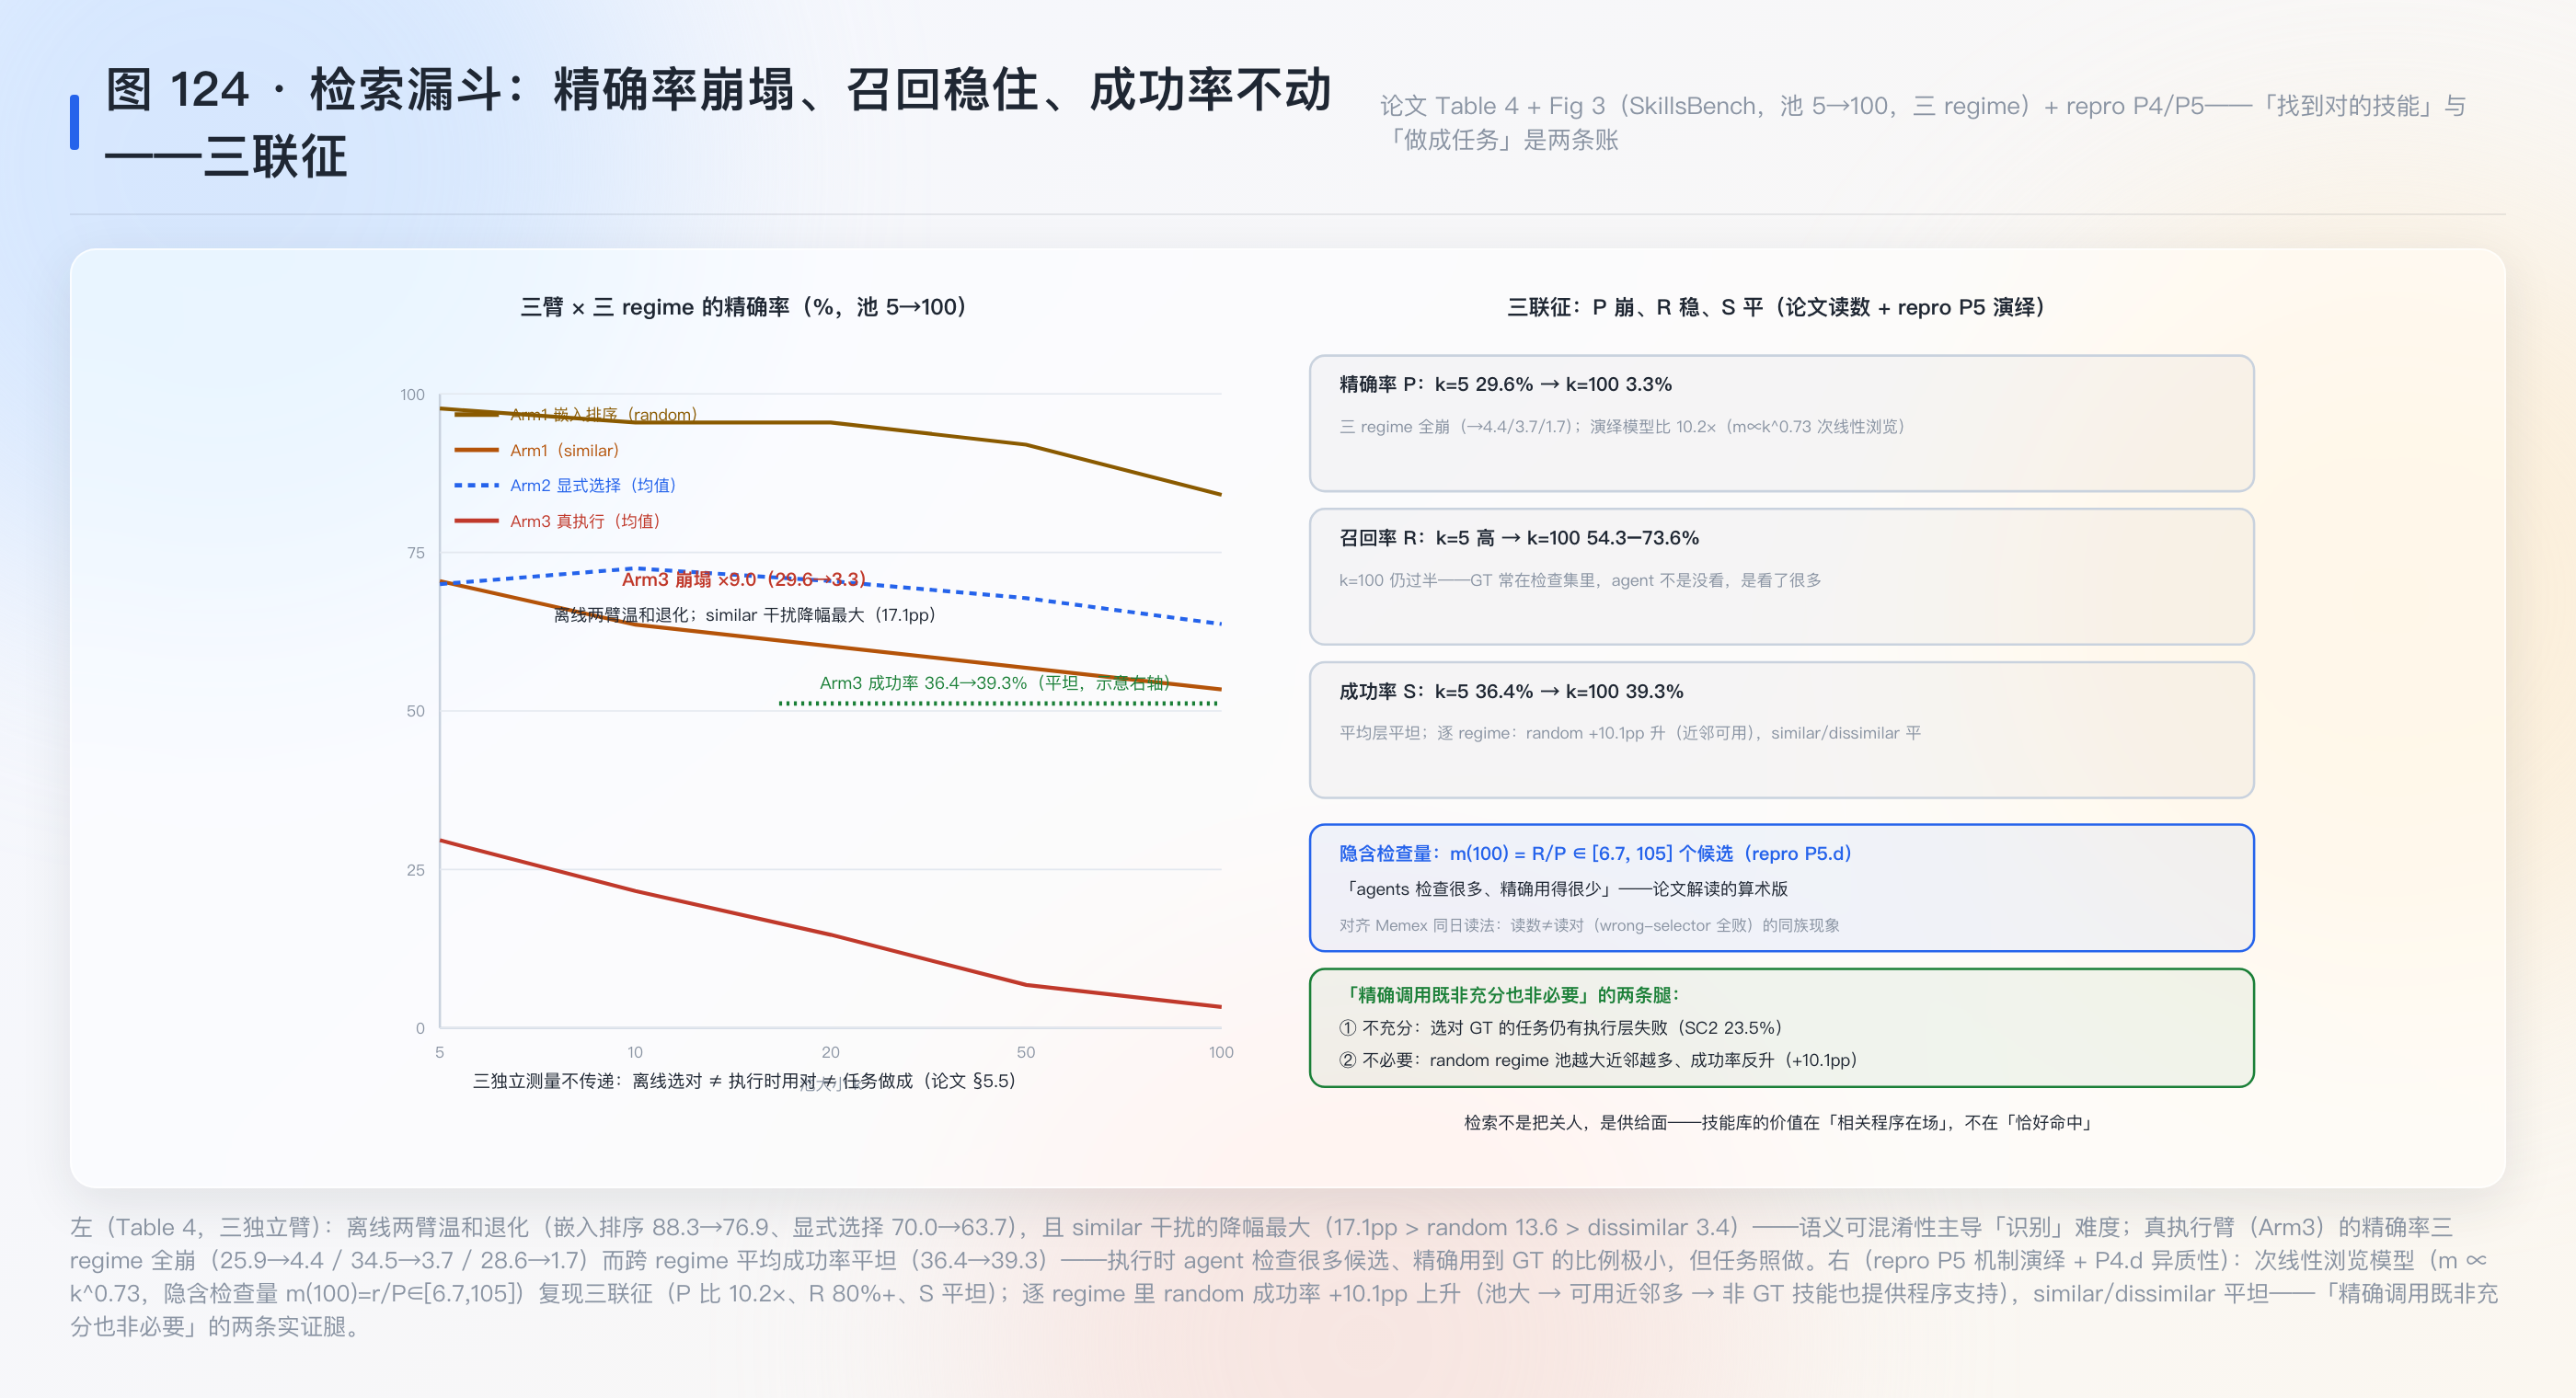
RQ4(检索漏斗,Table 4 p.11):三本账分道扬镳——离线识别温和退化(嵌入 88.3→76.9、选择 70.0→63.7,similar 干扰降幅最大 17.1pp);执行时精确率全崩(29.6→3.3,三 regime 终点 4.4/3.7/1.7);成功率平坦(36.4→39.3)。逐 regime 细看还有一个论文没有强调的读数(本站 P4.d):random regime 成功率从 31.8 升到 41.9(+10.1pp)——池越大、可用的非 GT 近邻越多、成功率反升——「相关技能也能提供程序支持」的最直接证据(similar/dissimilar 平坦:前者近邻与 GT 重叠、后者近邻不可用)。结论句(§5.5 p.10):exact ground-truth invocation is neither sufficient nor necessary。
六、数学展开
6.1 漏斗的机制模型:次线性浏览 + 隐含检查量(补充,复现 P5)
把 Arm3 的三联征写成模型。设池大小 k、agent 每次执行浏览 m(k) 个候选(按相似度顺序)、GT 进入浏览集的概率 r(k)。精确率 ≈ r(k)/m(k)(命中时 GT 占浏览集一份),召回率 ≈ r(k),成功率由「浏览集中含任一可用技能(GT 或近邻)× 执行质量」决定。论文数字代入:P 从 29.6% 崩到 3.3%(比 9.0),R 在 k=100 仍有 54.3–73.6%——反解隐含检查量 m(100)=R/P∈[6.7, 105]:agent 检查了很多候选、精确用到 GT 的比例极小(复现 P5.d)。合成版(m∝k^0.73、LCG 确定性)复现三联征:P 比 10.2、R 80%+、S 平坦(P5.a–c 全过)。这个模型把「精确率崩塌」从怪事变成必然:分子(命中)几乎不随池长,分母(浏览量)随池涨——只要 agent 的浏览量次线性增长而命中率不同比增长,精确率就必然按近 1/k^b 衰减。
6.2 锚定覆盖因子:从 Table 11 反解可锚定度排序(补充)
三臂对照给了每类失败一个「锚定弹性」读数:定义压缩比 c = Raw 率 / Skill 率。环境设施 c=26.5(5.3/0.2)、命令损坏 c=5.5、服务 c=3.4、格式 c=2.3——执行层四类高弹性;算法逻辑 c=1.1、静态验证 c=1.07——几乎无弹性。这个排序本身可迁移:给任何「指导注入」系统做体检,先测各类失败的 c 值——高 c 类值得写进技能,低 c 类写了也白写。与 Memex 的 B-界对读(跨种子):充分性的实用版不是「能不能恢复证据」而是「哪类失败可被过程指导覆盖」——两篇各给了一个充分性的可测量化。
6.3 配对设计的方差账:CI 为什么这么宽(补充)
+6.06pp 的 bootstrap 95% CI 宽达 10.6pp([+0.76, +11.36])——点估计只有区间宽度的 57%。为什么?配对净差的方差由「两臂结果不一致的三元组数」决定:若 528 对里只有 ~150 对两臂成败不同,每次重采样净额在 32 附近摆动 ±50 以上很正常(二项方差粗算:√150×0.5≈6 对,即 ±1.1pp 的 1σ…但 bootstrap 分布受少数极端任务影响更重——补充推断,论文未给 win/loss/tie 分解)。审计注记:均值主张可靠(CI 不含 0),幅度主张谨慎(下缘 0.76 贴零)——「技能优于 WF」是方向结论,不是每任务结论。这与 §1.2 的「均值盲」批评恰好构成自我提醒:本文自己最好的数字也在均值层。
6.4 源质量放大律:蒸馏是纯化器(复现 P8 的机制版)
Table 1 的六格读数排成一个 2×6 矩阵:5s0f 列 skill 全部高于 Raw(+16.2 到 +29.2pp),0s5f 列全部低于 Raw(−2.3 到 −13.1pp),两档差 15.3–31.5pp。写成律:蒸馏放大源质量的方向——好源更整齐地对,坏源更整齐地错。机制解释(补充):蒸馏是从轨迹池提取「该这么做」的过程;全成功池里提取的是正确步骤,全失败池里提取的是错误步骤的标准化复述——0s5f 的技能不是没有信息,是信息有毒且被格式放大了可信度(SKILL.md 的权威性外观)。对齐 Memex 命题 1:σ 的充分性以 σ 正确为前提——坏 σ 破坏充分性,索引再准也白搭。两篇在同一天给了「输入质量×表征形式」交互的两种测量。
6.5 整体收拢
数学展开四节:漏斗模型把「精确率崩塌」从怪事变成 1/k^b 的必然(6.1)→ 锚定覆盖因子给「哪类失败值得写进技能」一个可迁移的尺(6.2)→ 方差账提醒最好的点估计也住在区间里(6.3)→ 源质量放大律把「垃圾进垃圾出」量化成 6/6 的方向矩阵(6.4)。回到这篇:论文自己把账记到了分子级,本节补的是把这些分子放进最小模型——每个读数都有了「为什么必然是这个形状」的解释。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| Agent Workflow Memory(Wang et al. 2024c) | 🔵 待补 | 本篇的直接对照物与 WF 概念出处(2409.07429) |
| Anthropic Skills 库(2025) | 🟡 常识级 | 技能形态的工业出处,未访问 |
| SkillsBench / Terminal-Bench / SWE-Skills-Bench | 🔵 待补 | 基座与同类基准,转引未读 |
| Trace2Skill / SkillRL / EvoSkill / SkillX 技能生成线 | 🔵 待补(Trace2Skill 在候选池) | 自动造技能一族——本篇测的「人/模型手写技能」的下游 |
| LLM 判官编码 + 人核 | 🟢 已学(LLMBar/JudgeDebias 同族) | 本篇 κ=0.952 的手艺在判分器线已两次精读 |
| 配对计数审计 | 🟢 已学(method_pair_flip_ledger) | 本篇为其第二域实例(轨迹行为账) |
| 技能激活/选择(Xia/Zheng 2026) | 🔵 待补 | RQ4 的近邻问题(执行时选哪个技能) |
八、扩展与发散
8.1 连一连:Memex 与本篇——经验的存与用
发散:同日两颗种子在「经验管理」上互补到近乎刻意。Memex:保留全部证据、按索引取回、不蒸馏——怕丢;本篇:主动蒸馏、扔掉过程噪声、留一页清单——怕乱。取舍轴清晰:证据保真度 × 过程压缩率。Memex 的失效面是「读不起/读不对」(B-界、wrong-selector),本篇的失效面是「蒸馏坏了/用错场合」(0s5f、误用 10%)——两种方案的失效面几乎不重叠,这暗示混合设计(原始证据入 Memex 式档案柜 + 蒸馏技能做常用入口)能同时压两边:检索漏斗里 3.3% 的精确率问题,Memex 的稳定索引恰好是对症药——语义检索模糊,确定性解引用不模糊。回到本篇:技能线与记忆线在 2026 年的合流点大概就是「带索引的技能库」。
8.2 连一连:判官编码的效度问题——判分器线的老朋友
发散:本篇的方法论核心是「LLM 判官给 1584 条轨迹贴标签 + 人核 3% 样本」。判分器质量簇的全部病灶(位置偏置、冗长偏置、自我偏好)在这里全部适用:判官给 skill 臂贴 skill_guided_success 时,是否因为技能文本显眼而高估「被引导」?给 WF 臂贴 timeout 时是否因为轨迹长而高估「过载」?κ=0.952 防不住这些——人核者看到的也是同一批轨迹,共享同样的先验(共同方法偏差)。本站的处方老三样:换判官重测(扰动重测一致率)、盲化臂身份、对标签与独立结果(验证器)的交叉表。回到本篇:它的验证器口径(oracle 成功)与判官口径(SC1)差 1 条轨迹的咬合已经做了一半交叉验证——把另一半(机制标签对结果的交叉)补上,效度主张就闭环了。
8.3 常见误读(破)
误读一:「技能=知识库」论。 破:65.7% 对 4.5%——技能臂里注入领域事实起作用的案例不足二十四分之一。把技能写成百科条目(是什么)而不是操作规程(怎么做),是设计层面对机制证据的误用;轻量基线表里「三步计划 47.7% 低于 Raw」是同一误读的实验版——粒度错的过程文本净负。
误读二:「检索准确率决定论」。 破:池 5→100 精确率 29.6%→3.3% 崩了 9 倍,成功率 36.4→39.3% 反而微升;random regime 成功率 +10.1pp。把工程力气全花在「检索命中率」上,测错了瓶颈——真正的瓶颈在「调用与适配」(SC3:误用 10%)与「可锚定性」(算法逻辑 c≈1.1)。检索是供给面不是把关面。
8.4 写作之维(论文怎样完成说服)
标题用了个双关承诺句——“Why They Work—Until They Don’t”先给糖(有用)再给钩(会坏),读者带着「什么时候坏」的问题感进摘要,比平铺的 “An Empirical Study of Agent Skills” 强一档。摘要的数字排布有编排:先给最反直觉的机制对比(65.7% vs 4.5%),再给最吓人的漏斗(29.6%→3.3%),最后一句收在「neither sufficient nor necessary」的悖论式结论——三个记忆点各占一行。方法节的防御性设计藏在细节里:RQ4 换模型的段落在 §3.2 而非脚注(正面交代+限制解释范围,诚实);三臂不传递的设计反复强调两次(防「流水线误读」)。最弱的一笔是 related work 的技能生成线只罗列不对照——Trace2Skill/SkillRL 一族与本文的手写技能是什么关系(上游产物?竞争方案?)没说清,这恰好是审稿人会追的口子。
九、局限与可疑处
- 标签效度建立在一致性上:κ=0.952 是人-LLM 归类一致性,不是标签对真值的效度;共同方法偏差(人核者与判官看同一批轨迹)未隔离;机制标签(锚定/注入)无独立结果交叉验证(§8.2 处方)。
- 开放编码覆盖 3%:240/8135,论文自曝「稀有模式可能低代表」——12 模式里占比 <2% 的格(capability 0.4% 等)可能就是采样噪声。
- RQ4 单基准:检索结论只在 SkillsBench;技能库的构成(benchmark 自带标注技能)与真实技能库(自积累)的分布差异未讨论。
- RQ4 换模型:GPT-5.3-Codex 停用换 GPT-5.4,论文自述并限制为配对内比较(诚实),但 RQ1–RQ3 与 RQ4 的绝对值不可比——四问的「同构骨架」在最末一环断了模型一致性。
- CI 宽而无 win/loss/tie 分解:+6.06pp 的区间宽 10.6pp;配对内部的迁移结构(Skill 赢谁输谁)未报告——均值层的结论无法下沉到任务层。
- 无代码工件:「released artifacts」无链接;8135 记录与标注不可复算——本站审计只能到论文表格级(好在表格自洽性极高)。
- 「技能」形态单数化:全部实验用一种技能形态(SKILL.md 注入环境);技能的粒度、长度、结构化程度未扫——「表征形式重要」的结论本身没有被表征形式的变化测试过(形式单变量实际没松开)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验为双 agent×三基准 Docker 全量执行(8135 记录),不可本机重演;无代码工件。本复现是统计审计 + 机制演绎:论文全部关键数字在正文表格(Table 1/4/11/12/13 + §5 文内读数),账本结构(8135→238→528×3)与每个百分比的整数分子完全可复算;检索漏斗与「隐含检查量」另做合成机制演绎。论文数字只引用并注明出处。
10.2 可证伪预测与判据(运行前预登记;两轮定稿见 10.3)
- P0 账本链:8135/7837;240→238;714=238×3;528=144+186+198;1584=528×3;240/8135≈3%。
- P1 Table 11:三臂行和=组和=100±0.15;文内计数(326/294、124/197/176、78/19)逐格咬合。
- P2 配对差:(327−295)/528=6.06pp 逐位;327/528→61.9%、295/528→55.9%;CI 含点估计不含 0。
- P3 分子唯一性:65.7%→k=347 唯一;4.5%→k=24 唯一;61.6%→k=325 唯一;oracle 327 vs SC1 326 差 1(口径差登记)。
- P4 Table 4:跨 regime 均值四组与文内一致;similar 降幅>random>dissimilar;Arm3 P 三 regime 全崩 + 平均成功率平坦(|Δ|≤5pp)。
- P5 漏斗演绎:合成次线性浏览模型复现三联征——P(5)/P(100)∈[7,15];R(100)≥50%;|S(100)−S(5)|≤5pp;论文数字反解 m(100)=R/P∈[6.7,105]。
- P6 Table 12:五档咬合;short plan<Raw(净负);子集 skill−WF=+16.9pp(全局 +6.06 的放大)。
- P7 Table 13:三对 pairwise 逐项自洽(+0.7/−129.5K、+5.5/−34.2K、+4.8/+95.3K)。
- P8 Table 1 边界:skill@5s0f 6/6 高于 Raw;skill@0s5f 6/6 低于;WF 同格 4/6;两档差全>15pp。
10.3 实现演化(两轮,如实登记)
- 第一轮:28 项中 2 项 FAIL,均为断言书写误设而非机制或数据错误。 ①P4.c 把「平均层平坦」(论文口径 36.4→39.3)误设成「逐 regime 平坦」——random regime 实际 +10.1pp 上升;这不是数据矛盾而是新发现:池越大可用近邻越多、成功率反升,「非 GT 技能提供程序支持」的最直接证据。修正为平均层断言 + 单立 P4.d 登记异质性。②P5.a 把比值区间 [7,15] 写成了分数域 [1/15,1/7]——单位笔误,模型本身输出 10.2(恰在正确带内)。
- 第二轮:两项修正后 29/29 全过。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_demystify.py,真实输出
repro_demystify_output.txt。29 项断言 29
过,[Re](第二轮口径;第一轮 26/28
如实登记);确定性两次运行 sha256 一致(c5763601…)。
| 假说 | 论文锚点 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 账本链 | §4 p.7、Table 3 | 298 条无 transcript;238×3=714;144+186+198=528;2.95%≈3% ✓✓✓✓ | 全过——记录账逐环咬合 |
| P1 Table 11 | Table 11 p.22 | 三臂总和B 100.0/100.1/100.1;7 组文内计数全咬合 ✓✓ | 全过——计数账不是四舍五入拼盘 |
| P2 配对差 | §5.1 p.8 | (327−295)/528=6.0598→6.06 ✓;61.9/55.9 ✓;CI ✓ | 全过——精确到分子 |
| P3 分子唯一 | §5.1 p.8 | 65.7→[347];4.5→[24];61.6→[325] ✓✓✓;327 vs 326 差 1(论文自述口径差) | 全过——基数已知时分子唯一可证 |
| P4 漏斗表 | Table 4 p.11 | 四组均值全对(最大偏差 0.1);similar 17.1>random 13.6>dissimilar 3.4 ✓;P 全崩→4.4/3.7/1.7 ✓;平均 S 36.4→39.3 ✓ | 全过 |
| P4.d 异质性 | Table 4(论文未强调) | random S +10.1pp 升、similar −2.1、dissimilar +0.7 ✓ | 新发现(第一轮否定转化)——非 GT 近邻可用的直接证据 |
| P5 漏斗演绎 | §5.5 p.10 | P 比 10.2∈[7,15] ✓;R 80.5%≥50 ✓;S 33.8→36.2 平坦 ✓;m(100)∈[6.7,105] ✓ | 全过——「检查很多、精确用得少」的机制版 |
| P6 轻量基线 | Table 12 p.22 | 五档咬合 ✓;47.7<50.0 净负 ✓;+16.9pp 子集放大 ✓ | 全过 |
| P7 成本三角 | Table 13 p.23 | 三对逐项自洽(±0.05 内)✓✓✓ | 全过——「好但贵」的账面成立 |
| P8 源质量边界 | Table 1 p.5 | 6/6 与 6/6 与 4/6 ✓✓✓;两档差 15.3–31.5pp ✓ | 全过——蒸馏=纯化器 |
算力与工作量:MacBook 纯 CPU,<1 秒;两轮 + 回填约 40 分钟。 What was easy:论文表格自洽性极高——审计断言几乎一次全过;P3 的分子唯一性证明(枚举)五分钟写完。 What was difficult:难的不是算术是口径自觉——两处第一轮 FAIL 都是口径误设(平均层 vs 逐 regime;比值域 vs 分数域)。审计型复现的真正手艺是「先问这个数是哪一层的口径,再动笔」。 给下一个复现者的建议:入口 P2/P3(分子级复算是本篇独有乐趣);做行为类读数先列混杂(本篇的 random-regime 反升就是被「平坦」预登记逼出来的发现);审计完做一件事:把 Table 11 的 12 模式在你的任务域重标一遍——分类学的可迁移性只有重标才知道。
十一、方法论提炼与迁移
模式一:配对三元组对照(Paired-Triple Contrastive Design)
- 操作定义:测「某注入/干预为什么有用」时,把分析单元定为(同一对象 × 干预臂)的配对组(本篇三臂,可两臂):同对象内比臂间、跨对象只做汇总;效应量报到分子级(净差对数/总数),行为差异用标准化标签编码后按臂间迁移统计。
- 成功判据:①效应量能写成整数分子分母(如 (327−295)/528)且与各层汇总咬合;②对象间方差被消掉(每个对象自身做对照);③标签有独立口径交叉验证(判官口径 × 验证器口径互检)。
- 迁移去向:①A/B/C 三版提示词/界面的用户研究(同用户过三版,行为编码而非只留评分);②CI/CD 变更评估(同服务先后跑三配置,失败模式分类学对比);③医疗/教育干预的行为病理分解(同患者/学生多方案对照,按失败类别记账)。
- 失效边界:对象对干预敏感且干预有携带效应(先吃的药影响后吃的——本篇三臂是独立执行不受此限,重测同一 agent 会受);标签效度依赖编码者独立性(共同方法偏差);样本内多数对象三臂结果相同时净差信息稀薄(CI 变宽——本篇 CI 宽 10.6pp 即此)。
- 方法卡:notes/method_paired_triple_contrast.md(L1)
- 层级:L1 领域具体(受控评测/行为研究)。底层原理:归因靠对照(MATTRIB)——同对象配对是最小对照实验的又一种实现(前有树形重采样的同状态分支、受控攻击的单变量注水);与「配对计数审计链」(method_pair_flip_ledger,本篇为其第二域实例:从裁判输出账移到轨迹行为账)互为表里。
归档(不另立卡)
「LLM 判官编码 + 人核 + 计数账本」并入 method_pair_flip_ledger.md 第二域实例行;「锚定覆盖因子」(§六.2 的 c 值排序)暂不立卡——单篇提炼,待第二域(如 Trace2Skill 或 AWM 精读)出现同构再立(守 L2 纪律,L1 也需成功判据更成熟)。
十三、没搞懂的地方(未攻克登记)
- 65.7% 的分母口径:347/528 是 skill 臂全数还是「机制非 none 的案例」数?§5.1 措辞 “of skill mechanisms” 有歧义(若分母是 528−none 数,分子会变)——补齐时机:released artifacts 或 v2 给逐标签计数表。
- CI 的 bootstrap 细节:重采样单元(三元组 or 任务)、次数未报——影响区间可比性。补齐时机:同上。
- WF 为何在算法逻辑上更差(8.3→11.0%):过程残渣挤占思考是我的推断,论文未解释。补齐时机:轨迹级案例(附录 A.3 只有一个 skill 案例)。
- RQ3 迁移的混合档交互:Fig 4 显示 0s5f 档迁移后全面塌方,但 Codex 侧 3s2f 迁移后反高于本框架——迁移与源质量的交互未分析。补齐时机:数据表未给,只能等工件。
- SkillsBench 的 gold 技能标注质量如何(RQ4 的 ground truth 本身的可靠度)——论文当作无噪声前提。补齐时机:读 SkillsBench 原文(列入待读清单)。
十四、可信度
- A 级(论文原文转录,逐节核对):§1–§7 全部、Table 1/2/3/4/11/12/13 全部数字、Fig 2–5 图注、附录 A.7–A.9 设定、A.8 轻量基线、B prompt 清单存在性。
- B 级(论文自报实验,无法独立验证):8135 记录的归一过程、开放编码的原始标签、三臂执行的全部成功率、RQ2/RQ3 曲线读数(从图读)、κ=0.952 与 95.8% 一致率。
- C 级(我的推导 + 复现程序化验证):§三 全部推导、§六.1 漏斗模型、§六.2 锚定覆盖因子、§六.3 方差账、§六.4 放大律——复现断言见 §10.4(29/29)。
- D 级(我的推断,已标注):WF 算法逻辑变差的残渣解释、random regime 反升的近邻机制归因、528 对中不一致对规模的粗算、混合设计(Memex+技能库)的提议。
- 横向核实初核(2026-09-25):版本已核(abs 页仅 v1,2026-08-14 提交,无更新版);录用未核(预印本无会议字段);机构已核(PDF p.1 五机构);工件核查:论文与 abs 页均无代码链接,A.7 “released artifacts” 无 URL——三态「不存在/未公开」;第三方:HF Daily Papers 收录 + Elvis Saravia 周报(2026-08-23)+ themoonlight/devthrottle/znclabs/DeepContext 分析 + richhaase/toolshed 引用(未深读,登记);统计审查:+6.06pp 带 CI(本领域少见的好习惯);65.7/4.5/29.6→3.3 为聚合点估计;κ=0.952 一致性非效度;样本 8135/240/528/1584/130 全披露;RQ4 换 GPT-5.4 自述并限制口径(诚实);引文元数据:AWM/SkillsBench/Terminal-Bench/Trace2Skill 等转引未读(见文首核对状态块);MemGPT 引作 2024 与 Memex 篇引作 2023 的年份口径差异登记。
- 实验充分性评价:充分(对其主张范围而言)——受控设计(源固定换表征)、配对分析、机制标签三重交叉;每条核心主张有直接表源;边界自曝(3% 覆盖、单基准、换模型)诚实。缺:标签效度独立验证、win/loss 分解、表征形式扫描。
- 性能支撑目标检查:goal = “moving beyond aggregate success rates to when/why/where”(§1)——支持:12 模式+五级机制+三臂检索把 when/why/where 各配了可数测量;「until they don’t」的失效面(误用 10%、0s5f 6/6、漏斗崩塌)有专节证据。标题的每个词都兑了现。