外行导读(先读这个,再决定要不要进正文)
一个场景:一个模型服务同时收到四个请求——“帮我平衡一棵二叉树”“你叫什么名字”“证明黎曼猜想”“写一篇《简·爱》读后感”。给每个请求都采样八个候选答案再挑最好的,是最常见的”多花算力换质量”的办法。但对”你叫什么名字”来说,八个候选是浪费——第一个样本就几乎必对;对”证明黎曼猜想”来说,八百个也不够——这题根本做不出来。同样的算力,均匀地撒给每道题,一半以上撒在了不需要或用不上的地方。
这篇论文干的事:把”每题都用预算 B”改写成一个分配问题——固定平均预算,让难而可解的题多拿、易题少拿、不可解题拿零。做法分两步:第一步训练一个轻量”难度探针”,输入问题、直接预测”多给一个样本能带来多少收益”的整条收益曲线(不用真的采样就能给出全部预算档的预测);第二步把这些预测交给一个贪心算法,把预算像阶梯一样一格一格分给当前收益最高的格子——这个贪心不是启发式,是全局最优(分配问题的数学结构保证)。结果:数学与代码任务在中高预算下用少 25–50% 的采样拿到同样的成功率;路由实验里,贵的大模型只在 50–75% 的请求上被调用,效果不掉。
为什么值得关心:三个理由。第一,它是本站执行侧”测试时算力分配”线的第三块拼图——ATTC(种子 19)用拉格朗日对偶把预算定价、LATTS(种子 20)用接受-拒绝采样在步级闭环,本篇补上的是最基础的形态:把”难度”变成一个可以从问题文本直接读出的收益向量,再把分配做成一个有最优性保证的组合问题。三条线在同一个问题上会师(§八.1 有对拍表)。第二,它给出一个反直觉的病理样本:在代码任务上(一半的题成功率恰好为零),在线分配反而输给”每题都给同样多样本”的笨办法——原因是一道”预测成功率 1%、实际为零”的题会把预算吸走。预测误差怎么和难度分布相互作用,是所有”按题分配”系统的共同软肋(§六.3 拆成可量化的机制)。第三,“语言模型在预训练后可能已经把难度编码进了内部状态”——一个两层小 MLP 读一下隐藏状态就能以 72–84% 的准确率分辨难易,这本身是关于模型内部表示的可测命题。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 解码过程 f(x, b) | 给问题 x、预算 b,产出一条回答的任何”多花算力”的流程(采样多个挑最好/搜索/自我批评) |
| best-of-k | 采 k 个候选,用打分模型挑最好的那个 |
| 路由(routing) | 每道题二选一:贵而强的解码器 vs 便宜而弱的解码器 |
| 奖励 r(x, y) | 给回答打分的模型(对答案=1 错=0;或连续打分) |
| 边际收益 Δ_ij | 第 i 题从第 j−1 个样本加到第 j 个样本,期望收益涨多少 |
| 难度探针 Δ̂ | 只读问题就预测整条边际收益曲线的小模型(MLP 或 LoRA) |
| 分配变量 c_ij ∈ {0,1} | “第 i 题的第 j 格预算开没开”;必须从第一格起连续地开(前缀约束) |
| matroid / 贪心最优 | 一类组合结构,“每步拿当前最大增量”在这种结构下不后悔、全局最优 |
| Online 分配 | 一批题一起到齐,看着全批的预测联合求解 |
| Offline 分配 | 先按预测把题分箱、每箱定一个统一预算,部署时查表(各题独立处理) |
| λ | 单个样本成功的概率(二元奖励时) |
| Tranches 子集 | LMSYS 测试集中奖励方差最低 10% 与最高 10% 的题——分布最”极端”的一批 |
| VAS | value-augmented sampling:解码时每步用价值函数给 10 个候选 token 打分,质量升、成本 ×10 |
§0 承接栏
这颗种子接的是执行侧测试时分配线的第三格。ATTC(种子 19)回答了”预算约束下每题停在哪个档最优”——用拉格朗日对偶给算力定价、再把定价器蒸馏成可部署的分配器;LATTS(种子 20)把分配下沉到步级闭环。但两篇都绕开了一个更基本的问题:“这道题值多少算力”这件事本身能不能从问题文本直接预测出来?本篇的回答是:能——而且预测对象不该是”难度”这个名词,而是”边际收益”这个动词(多给一个样本能赚多少)。它同时接上此前悬了三次的”Damani 对照”欠账——ATTC 篇把测试时分配的先行工作排好座次时,本篇就是名单上最早的一块。对判分器质量簇它是外线旁证:奖励模型在这里既是训练目标又是评测尺,而”λ=0 的题拿零预算”是零信号组过滤思想在执行侧的第四个现身(§八.2)。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:模型要同时服务大量用户,每个用户的请求难度天差地别——测试整数奇偶,新手也会;平衡二叉树,要多试几次;找多项式时间的集合覆盖算法,根本不存在,“不值得尝试”(p.1 原文把这三档画成 Hard / Easy / Impossible 的队列,Fig 1)。最大化算力效率 requires 提前认出”哪些输入多花算力真的有用”。
1.2 旧做法的病根:均匀分配(§1–§2)
现行做法是定一个固定预算 B,每个请求都走一遍同样的解码过程(§2 p.2)。病根有两层。第一层是浪费:易题的第一个样本就几乎必对,第二到第八个样本是在给零增量付费;不可解题更惨,任何预算都是白烧。第二层更隐蔽:上游已有工作证明自适应分配的理论收益很大(Snell et al. 2024,转引),但过去的难度测量只能事后估计——用比正常解码贵得多的采样流程去摸每道题的难度(§1 p.2 “could only be estimated a posteriori”)。事后再测量,测量的成本就把分配省下的钱全吃了回去。
你有没有注意到 Fig 1 里 “Impossible” 那一格的分配动作是 greedy decoding(贪心解码,零额外采样)?这是全文最容易滑过去、也最重要的一个设计决定:分配算法必须有”不分配”这个选项。后面 Code 域一半的题成功率恰好为零(§4.1 p.6),全靠这个选项把预算救回来。
停下来猜一下:如果你来训练”难度探针”,你会让它回归什么目标?最顺手的选择是回归”这道题的成功率”——一个 0 到 1 的数。猜完再往下看,§三.2 会讲为什么论文回归的不是它,而是另一个量——这一步之差是全文最重要的一步。
1.3 问题形式化的入口(§2 p.2)
论文把场景写成:语言模型 p(y|x) 负责生成候选,奖励模型 r(x,y) 负责打分;解码过程 f(x,b) 在预算 b 下产出回答。两个具体实例:best-of-k(Eq 1:采 b 个候选、按奖励取最大)与路由(Eq 2:预算档只有两档 b_W / b_S,分别对应弱解码器与强解码器)。共识、思维链、自我批评、辩论都可以塞进这个”预算控采样数/生成轮数”的形式(p.2)。固定预算下的总期望收益是 Eq 3——每题独立、同一个 B。本篇要解的是它的自适应版(Eq 4):在 Σb_i ≤ B·n 的总量约束下,为每题挑各自的 b_i,最大化总期望收益。
二、核心想法
一句话:把”难度”从一道题的标签改写成一条曲线——第 j 个样本的边际收益 Δ_ij;难度探针只读问题就预测整条曲线,然后把预算切成一格一格的 0/1 单元,用有最优性保证的贪心把它分给当前收益最高的格子。
直觉先打底。分预算像发救济粮:你不知道每家屯粮多少,但你可以学一个”看门牌就报数”的估价员(探针),它不报”这家穷不穷”,而是报”再给这家一袋米,能多养活几天”——逐袋的边际报表。发粮官(分配算法)拿着全城各家的报表,从所有”下一袋最值钱”的格子发起:粮多就多发几轮,粮少就早停,对报表写着”再喂也养不活”的家庭一粒不发。报表会估错,估错的代价长什么样、什么时候致命,是这篇论文自己给出的警示案例(Code 域,§5.2)。
全篇就看这张:图 114——左边是贯穿示例的四行边际报表与贪心分配的完整账本(论文 Fig 2 的数字 + 本站复算),右边是方法全景:隐藏状态 → 难度探针 → 边际报表 → 前缀阶梯 → 贪心,在线与离线两个出口。一张图装下本篇全部骨架。
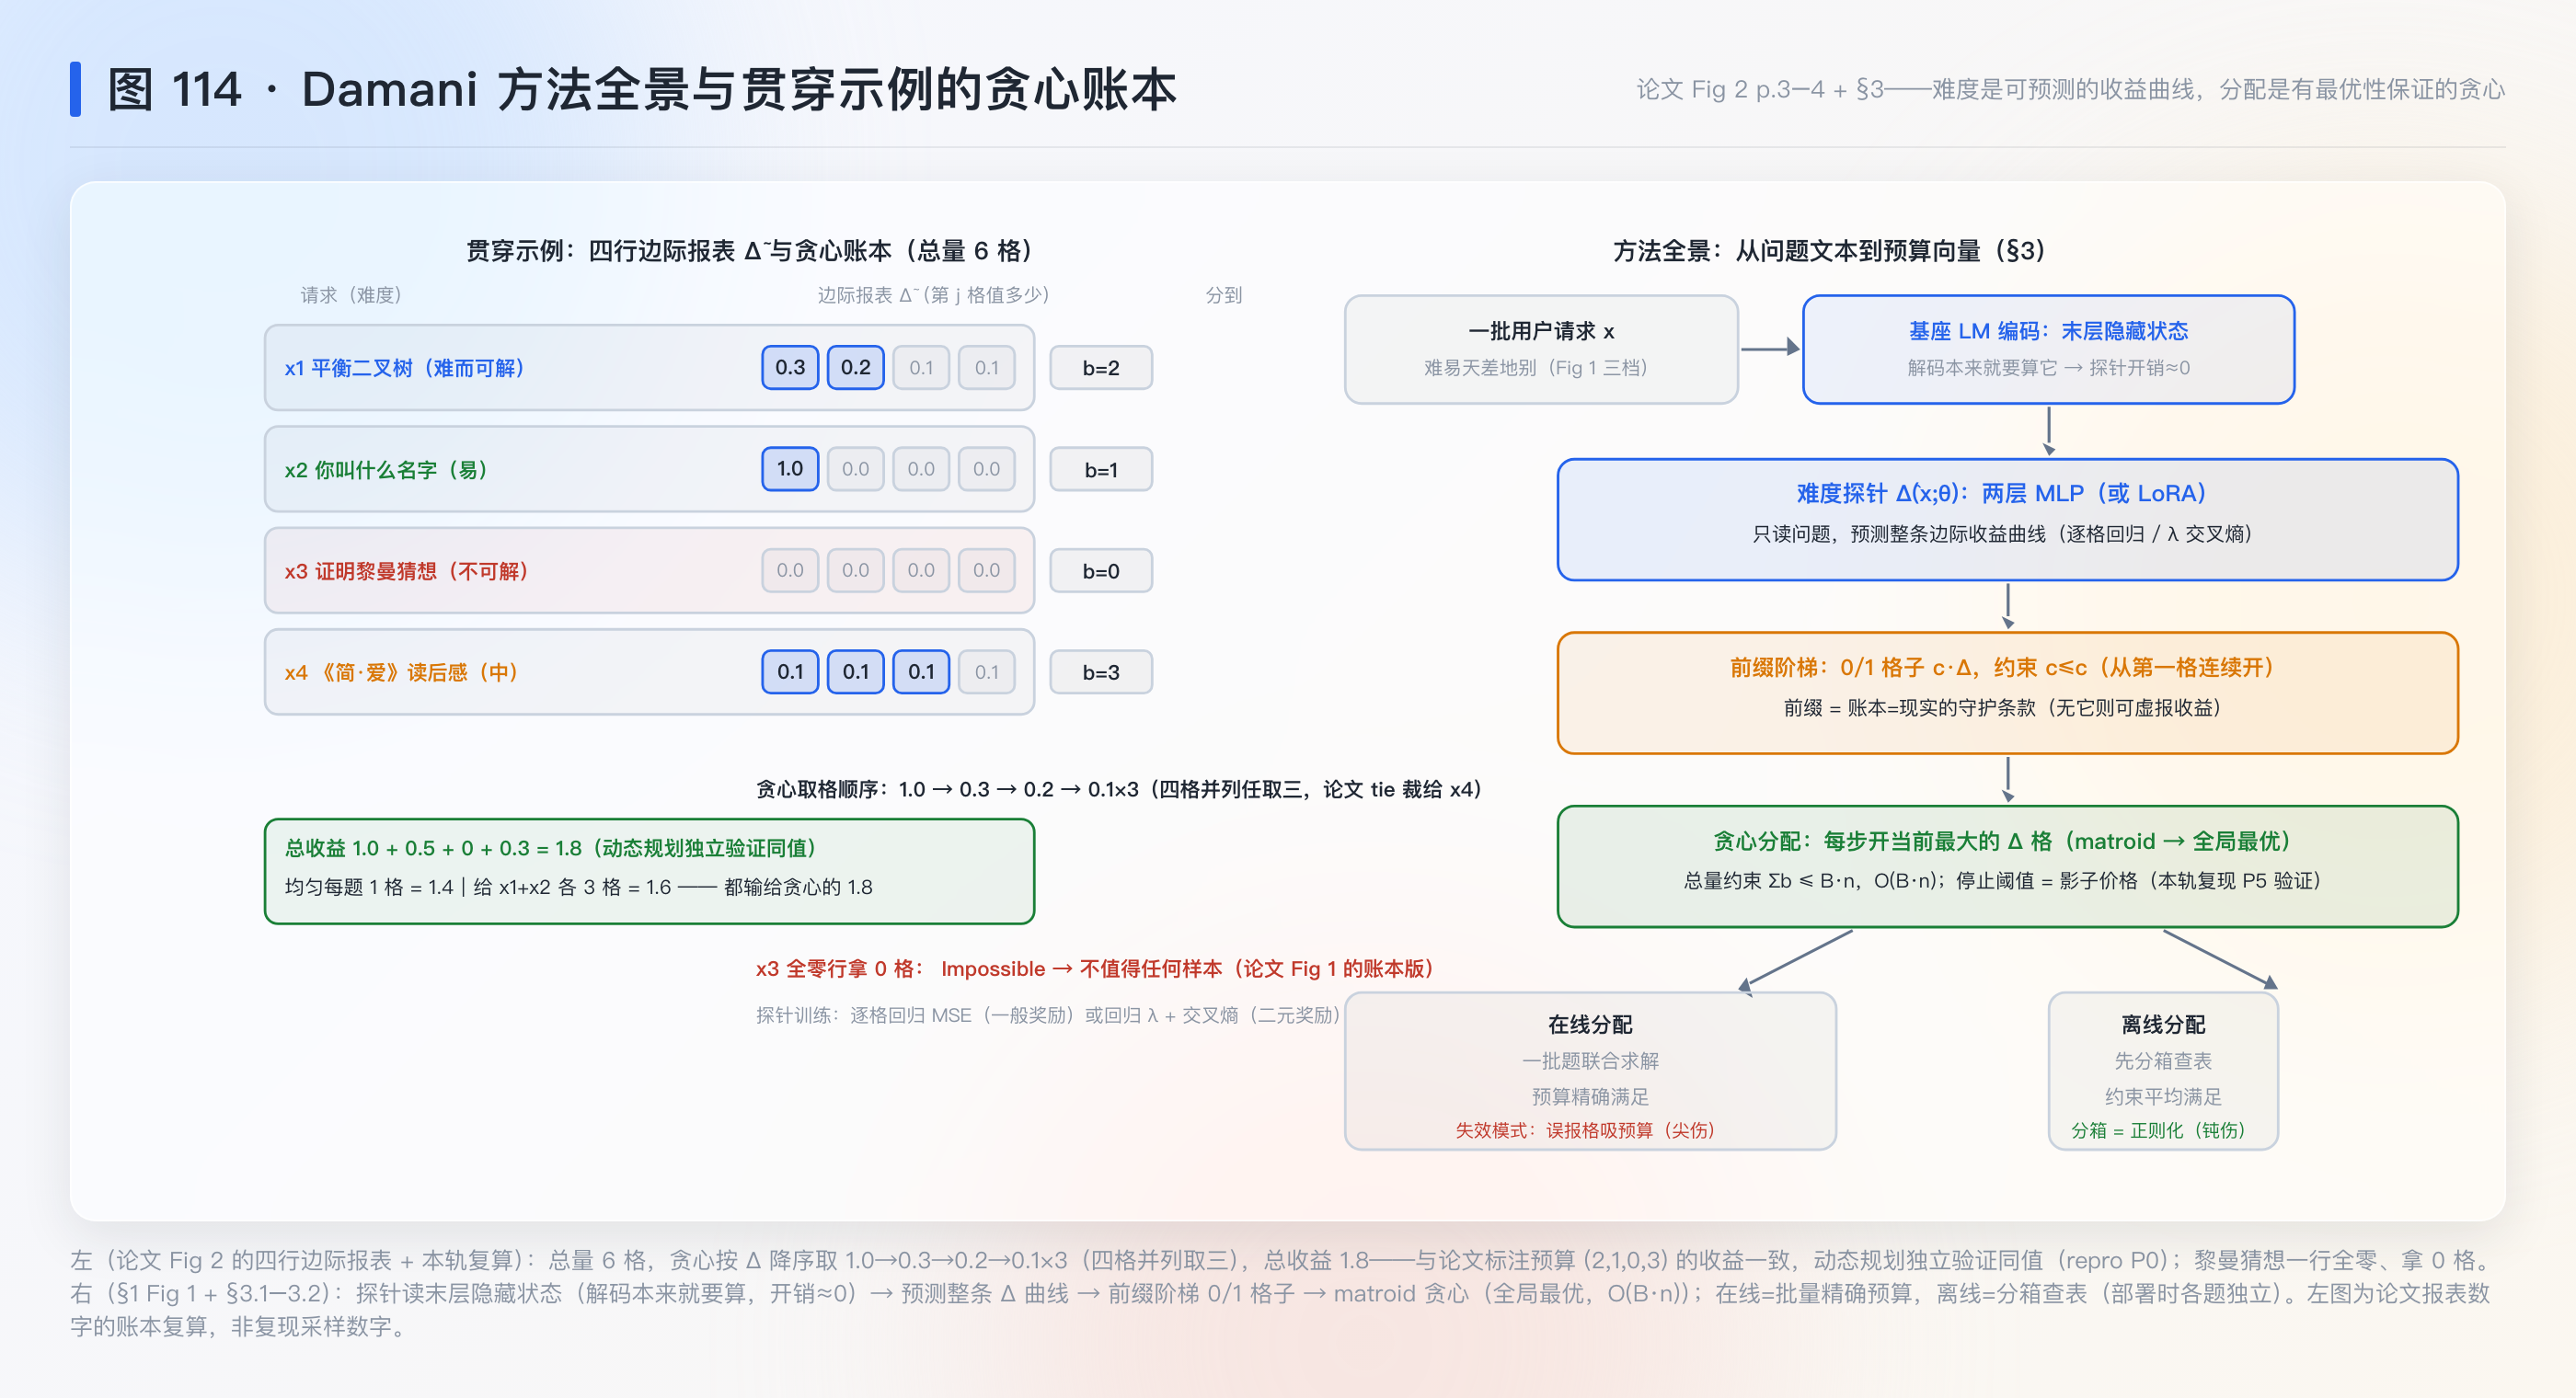
形式化入口:定义 q(x_i, b_i) = E[r],即第 i 题拿到 b_i 个预算时的期望收益(§3 p.3)。没有模型能直接读出 q——蒙特卡洛估计它(Snell et al. 2024 的做法)需要的采样可能比本来要分配的还多(p.3 原文点破)。所以全篇的技术含量压在一个替换上:不预测 q,预测 q 的差分。
三、数学基础(零起点,四件工具逐一发明式拆解)
本节外部断言:matroid 为组合数学标准内容(Edmonds 1971,论文转引,原文未读);几何/二项分布为教科书内容。
3.1 第一件:总量约束——从”每题都一样”到”一城一策”
先摆问题。设 n 道题、平均每题预算 B。做法一:每题都给 B(现状)。做法二:每题独立地选自己最优的预算,不管总量。做法三:固定总量 B·n,随你怎么分。
候选方案死两个:①每题独立选最优——死于总量失控:每题都按自己的”够用”拿,总量没有上界,服务方先破产;②按题目难度定死优先级(难题优先或易题优先)——死于优先级会翻面:低预算时该先喂易题(第一格收益高),高预算时该喂难题(易题的边际已经塌了,§六.2 手算可见)——任何静态排序至少在一段预算区间里是错的。
活路(论文 Eq 4,§2 p.2):
\max_{b_1,\dots,b_n}\ \sum_i \mathbb{E}_{y\sim f(x_i,b_i)}[r(x_i,y)] \quad \text{s.t.} \quad \sum_i b_i \le B\cdot n
每步拆解:目标是对每题的期望收益求和(谁赚得多养谁);约束 Σb_i ≤ B·n 把”平均预算 B”翻译成一条硬总量线——这正是”固定平均成本”的精确语义。注意它没有要求每题 b_i ≥ 1:Math/Code 域允许 b_i = 0(答一句”我不知道”,把预算让给别处,p.5–6);Chat 域要求 b_i ≥ 1(聊天不能不回话,p.5)——一个看似琐碎的差别,决定了”不可能题”能不能被算法识别出来。
数值例(贯穿示例立账):四题批次、总量 6 格。这道约束的含义是:x2(“你叫什么”)不该拿满,x3(黎曼猜想)一格都不该拿。账往下算。
名字最后给:论文称之为 adaptive computation scaling(§1 p.2)。
3.2 第二件:边际阶梯——把连续预算切成 0/1 单元
先摆问题。q(x_i, b) 是 b 的函数,分配变量 b_i 是整数、取值范围 0..B_max,暴力搜全部组合是 (B_max+1)^n 量级——不可行。需要一个让结构显形的记账法。
停下来猜一下(猜论文):上一节留的问题——探针该回归什么?现在可以用记账语言重问:为了解开这个分配问题,探针必须提供哪些数?全体 q(x_i, 0..B_max) 当然够,但那是 n×(B_max+1) 个数,而且”总量够”不等于”好学”。更省的参数化存在吗?
活路(论文 §3 p.3):定义边际收益 \Delta_{ij} = q(x_i, j) - q(x_i, j-1),约定 \Delta(\cdot, 0) = 0。任何 q 的账都立刻翻成差分账:
q(x_i, b_i) = \sum_{j=1}^{b_i} \Delta_{ij}
这不是一个选择,是一个恒等式——裂项相消(telescoping):右边的和是 (q(1)−q(0)) + (q(2)−q(1)) + … + (q(b)−q(b−1)),中间项全部对消,只剩 q(b)−q(0)=q(b)。所以”报差分”与”报总量”信息等价,但差分有个决定性的优点:分配决策只跟差分有关。“第 i 题的第 j 格值不值得开”只看 Δ_ij 一个数。
于是引入 0/1 变量 c_ij(论文 Eq 5,§3 p.3):c_ij = 1 表示第 i 题的第 j 格预算开启。总账变为:
\max_{c}\ \sum_{i=1}^{n}\sum_{j=0}^{B_{\max}} c_{ij}\,\Delta_{ij} \quad \text{s.t.} \quad \sum_{i,j} c_{ij} \le B\cdot n \;;\qquad c_{ij} \le c_{i,j-1}\ \forall i,j
第二个约束(前缀约束)是预算语义本身:第 j 个样本只在第 j−1 个也想要时才有意义——“采 5 个候选但不采前 4 个”不是任何解码过程。拆部件反证:把前缀约束删掉会怎样?设想探针因估错报出一条非单调的行,比如 x1 的 [0.05, 0.3, …](真实过程里 Δ 递减,估错可以让第 2 格看起来比第 1 格值钱)。无前缀约束时,分配器会只拿 0.3 那格、跳过 0.05 那格,账面记 0.3 的收益——但 b_1 = max_j c_{1j} = 2 意味着真实执行要采 2 个样本,其中包含它”不要”的第 1 格。账本从此对不上现实:报表说这批格子的总收益是某个数,实际执行根本产不出那个数。前缀约束就是”账本=现实”的守护条款。
为什么必须是差分而不是成功率(呼应 §一.2 的猜问):回归平均成功率 λ 只给每个 b 档提供同一条信息 q(b)=1−(1−λ)^b(二元情形可以反推),看似等价;但对一般奖励与一般解码过程,“第几格最值钱”必须逐格可查——路由与 best-of-k 的预算语义不同、奖励不必二元,Δ 向量是两种过程通用的最小充分报表。而且梯度性质好:逐格回归 MSE(论文 Eq 6),每格是一个独立的回归任务,不必拟合跨档的参数曲线。原文的说法:“estimates the marginal improvement in response quality that would result from allocating an additional unit of computing power”(§1 p.2)。
数值例(贯穿示例翻账):论文 Fig 2 的四行报表就是 Δ 行——x1 的 [0.3, 0.2, 0.1, 0.1] 累加回去就是 q 的阶梯 (0.3, 0.5, 0.6, 0.7):第一个样本把”二叉树”做对的期望拉到 0.3,第二个再涨 0.2……名字最后给:论文称 marginal reward(§3 p.3);本站把 c 的可行形状称为边际阶梯(补充)。
3.3 第三件:贪心——为什么”每步拿最值钱的格子”不后悔
先摆问题。Eq 5 是整数线性规划,标准解法(分支定界、动态规划)都能解,但论文要的是在线批量场景下 O(B_max·n) 的解——n 是十万级请求、B_max 是上百采样。有没有”每步只看局部”还保证全局最优的解法?
候选方案死两个:①难度排名 + 固定配额(如”最难的 20% 每题给 8 格”)——死于优先级翻面(§3.1 已死过一次,这里死得更具体:配额数字没有任何区间同时正确);②按”性价比”排序(如 q(B_max)/B_max 的比值)——死于比值看不见阶梯的形状:两道题比值相同但一条前陡后平、一条前平后陡,同样的总量约束下正确的喂法完全不同。
活路(论文 §3.2 p.4):贪心——每次在所有可开的格子里挑 Δ_ij 最大的那个开掉,直到预算用完。原文引用 Edmonds 1971:c 的可行集构成 matroid,贪心必最优。matroid 这个词先放下,§六.1 用交换论证从零证一遍”为什么不后悔”,这里先给直觉版:假设最优解和贪心的第一步分歧——最优解没开当前最大的格子 g,而开了别的格子集合 S。因为 g 是当前最大的增量,把 S 里任意一格换成 g,总账不会变差;反复交换,最优解可以一步步变形为贪心解而全程不减值。分歧不存在,贪心=最优。
数值例(贯穿示例的贪心账本,全手算):总量 6 格,四行报表的全部格子按 Δ 降序排队:
1.0(x2 的第 1 格)→ 0.3(x1 第 1 格)→ 0.2(x1 第 2 格)→ 0.1 四个并列(x1 第 3 格、x4 第 1/2/3 格)。
贪心依次拿:1.0、0.3、0.2,再用掉 3 格在 0.1 的并列里(论文的平局裁决给了 x4 的三格)。账本:x2 得 1 格(+1.0),x1 得 2 格(+0.5),x3 得 0 格(+0),x4 得 3 格(+0.3)——预算向量 (2, 1, 0, 3),与论文 Fig 2 标注的 b1=2, b2=1, b3=0, b4=3 逐位一致,总预测收益 1.0+0.5+0+0.3 = 1.8。对照组(同一总量下”看起来也合理”的两个方案):给 x1 与 x2 各 3 格 → 0.6+1.0 = 1.6;均匀每题 1 格 → 1.4。贪心的 1.8 同时压过两者——并且 x3(黎曼猜想)一格未得,正是 Fig 1 “Impossible → greedy decoding” 的账本版。
名字最后给:论文称 greedy algorithm(§3.2 p.4),本站称”贪心不走回头路”。
3.4 第四件:二元奖励的闭式——衰减律与”不值得”的边界
先摆问题。数学与代码任务里奖励通常是二元的(对/错),这时整条 Δ 曲线不必学习——可以直接从单个数 λ(单样本成功概率)推出。论文 §3.3 p.4 给了闭式,这里把它当”第二个被逼出来的对象”拆解:约束是”采样相互独立、成功至少一次即成功”,那么
q(x, b) = 1-(1-\lambda)^b
推导(逐符号):单样本失败概率 1−λ;b 个独立样本全失败的概率 (1−λ)^b(独立性 → 概率相乘);至少一次成功 = 1 减全失败。边际收益是相邻差分:
\Delta_b = q(b) - q(b-1) = (1-(1-\lambda)^b) - (1-(1-\lambda)^{b-1}) = \lambda\,(1-\lambda)^{b-1}
最后一步是因式分解:(1−λ)^{b−1}[(1−λ) − 1] 提出来取绝对值。每步拆解:第 b 格的价值 = “前 b−1 格全失败(概率 (1−λ)^{b−1})× 这一格成功的概率 λ”——边际衰减的形状由”独立重试”唯一决定,没有任何自由参数可调。
数值例(λ=0.7,手算):Δ_1 = 0.7×0.3^0 = 0.7;Δ_2 = 0.7×0.3 = 0.21;Δ_3 = 0.7×0.09 = 0.063。对应 q 的阶梯 0.7 → 0.91 → 0.973:第三个样本只剩 6 分钱的价值。而 λ=0.05 的题:Δ_1=0.05、Δ_2=0.0475、Δ_3≈0.0451——衰减极慢,第 10 格还有 0.05×0.95^9 ≈ 0.0315。两条曲线在 b=3 附近交叉(0.7 题的第 3 格 0.063 尚高于 0.05 题的首格;第 4 格 0.0189 已被反超)。低预算喂易题、高预算喂难题,不是管理直觉,是这两条曲线的交叉点位置——图 115 画的就是这件事。
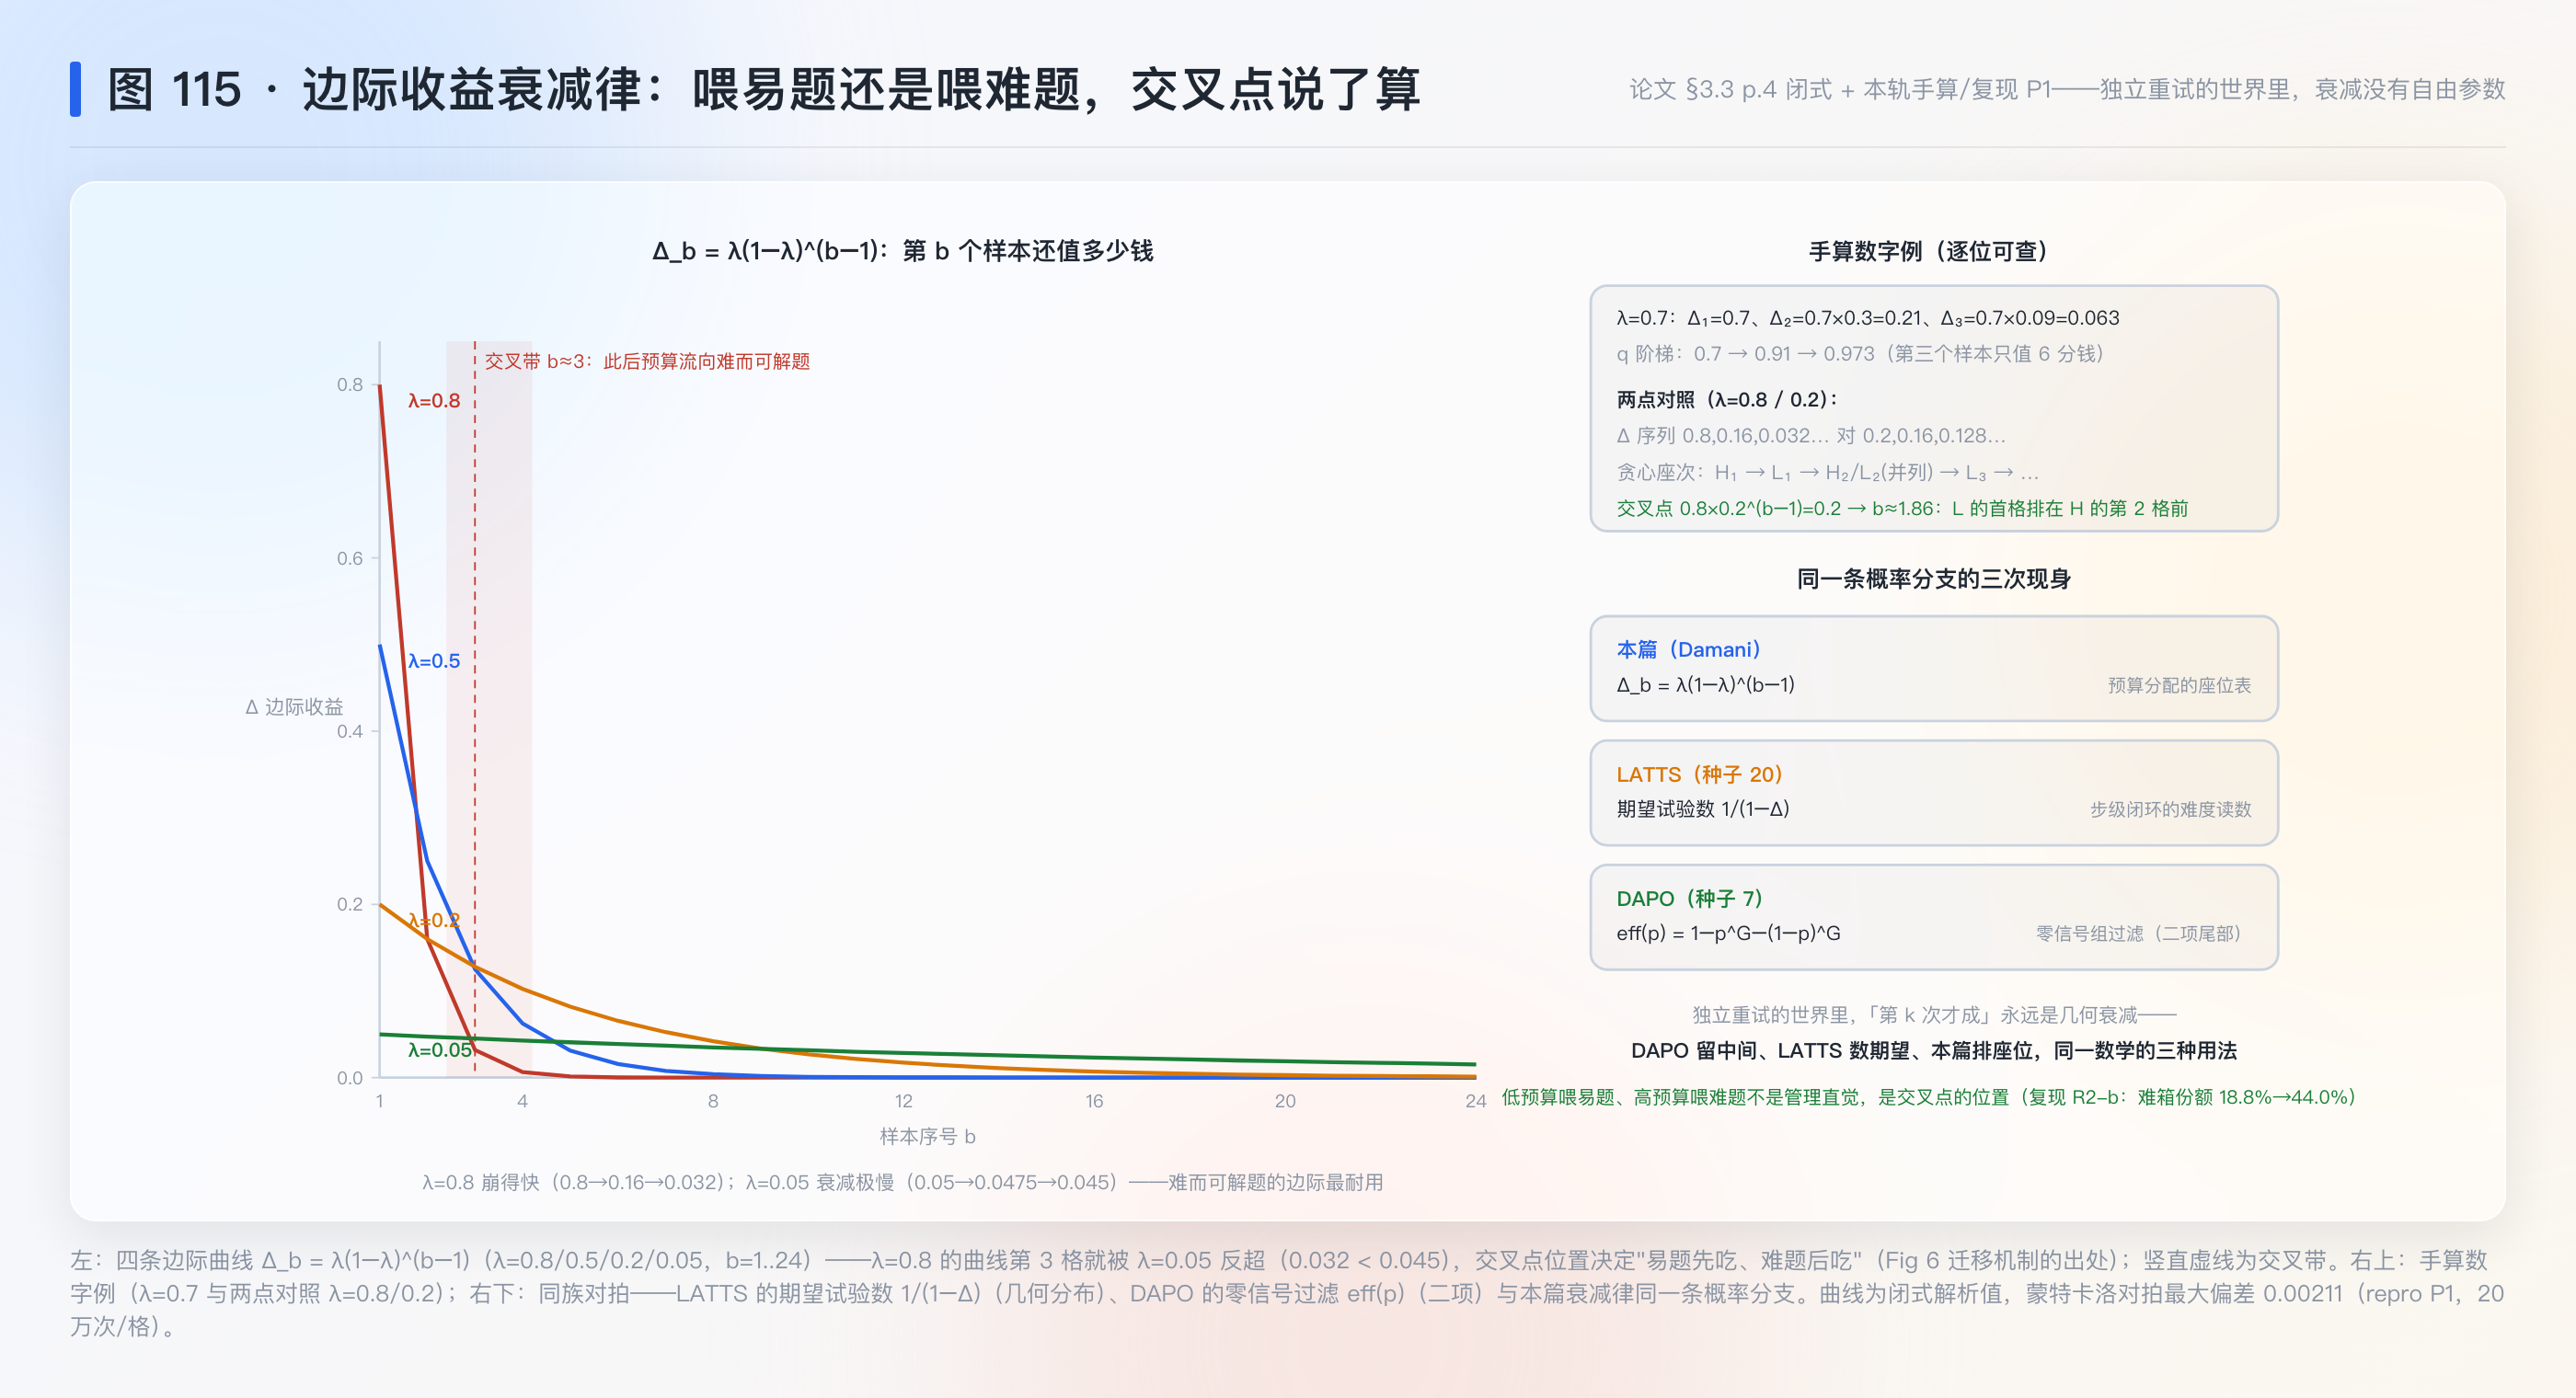
连一连(家族对拍):λ(1−λ)^{b−1} 是几何分布的 pmf 形状——LATTS(种子 20)的式 6(期望试验数 1/(1−Δ),几何分布)与 DAPO(种子 7)的零信号过滤 eff(p)(二项家族)用的是同一条概率分支:独立重试的世界里,“第 k 次才成”的概率永远是几何衰减,区别只在 DAPO 留中间、LATTS 数期望、本篇排座位。探针的训练目标也顺手换掉:不回归 Δ 向量做 MSE,而回归 λ 做交叉熵(论文 Eq 7,§3.3 p.4)——二元世界里这是同一信息的更自然参数化。
3.5 整体收拢
四件工具是一条链:总量约束把问题钉成”一城一策”(3.1)→ 边际阶梯把连续预算切成带前缀纪律的 0/1 格子,让”分配”变成”排座位”(3.2)→ matroid/交换论证保证排座位的贪心不后悔(3.3)→ 二元闭式把整条曲线折叠进一个 λ,衰减律顺手解释了预算怎么流动(3.4)。回到这篇:前两件是论文的记账法,第三件是它的最优性凭据,第四件是它实验域的幸运简化——四件合起来,“学习如何用力想”才从口号变成可执行的系统。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| f(x, b) | 预算 b 下问题 x 的解码过程 | §2 p.2, Eq 1/2 |
| q(x_i, b_i) | 期望奖励 E_{y\sim f(x_i,b_i)}[r(x_i,y)] | §3 p.3 |
| B | 平均每题预算(总量 B\cdot n) | §2 p.2, Eq 4 |
| \Delta_{ij} | 边际收益 q(x_i,j)-q(x_i,j-1) | §3 p.3 |
| c_{ij}\in\{0,1\} | 预算单元开关(前缀约束 c_{ij}\le c_{i,j-1}) | §3 p.3, Eq 5 |
| \hat{\Delta}(x;\theta) | 难度探针:MLP(读末层隐藏状态)或 LoRA | §3.1 p.3 |
| \lambda | 单样本成功概率(二元奖励) | §3.3 p.4 |
| p_S, p_W | 强/弱解码器(路由设定),成本 b_S, b_W | §2 p.2 |
| b^*(本站记号) | 贪心停止阈值 = 被选中格子的最小 Δ(§六.4 证明它就是影子价格) | 补充 |
五、机制
5.1 机制一:难度探针——难度藏在第一层隐藏状态里(§3.1 p.3)
两种参数化:两层 MLP,输入是基座模型编码问题后的最后一个隐藏状态(解码本来就要算它,所以探针几乎白送);以及 LoRA 微调整个基座(略贵,但推理瓶颈在解码不在编码,开销仍可忽略)。训练数据:对每道训练题在多个预算档上采样,算经验 Δ 向量,MSE 逐档回归(Eq 6);二元域改回归 λ + 交叉熵(Eq 7)。
这一节埋着全文最大胆的一句断言:“suggesting that LMs may already learn to encode problem difficulty as a result of pre-training”(§1 p.2)——一个两层 MLP 就能从隐藏状态读出 72–84% 的难易判别(Table 1 p.9),说明”这道题我行不行”在模型前向传播的内部已经有坐标。注意这是读出证据不是因果证据:难度可读出,不等于模型”用”这个坐标做了解码决策(我的推断,论文未做干预实验)。
5.2 机制二:在线与离线——同一个最优解的两种死法(§3.2 p.4)
在线分配:一批题到齐,把每题的 Δ̂ 行交给贪心,精确满足总量约束;缺点是必须攒批处理。离线分配:从训练数据留出一份验证集,按预测把题分箱(如按首个边际 Δ̂₁ 分十箱),箱内统一定预算、存成查表;部署时每题独立查箱取预算,代价是约束只在平均意义上成立(查询分布漂移会破预算,论文自认 p.4)。
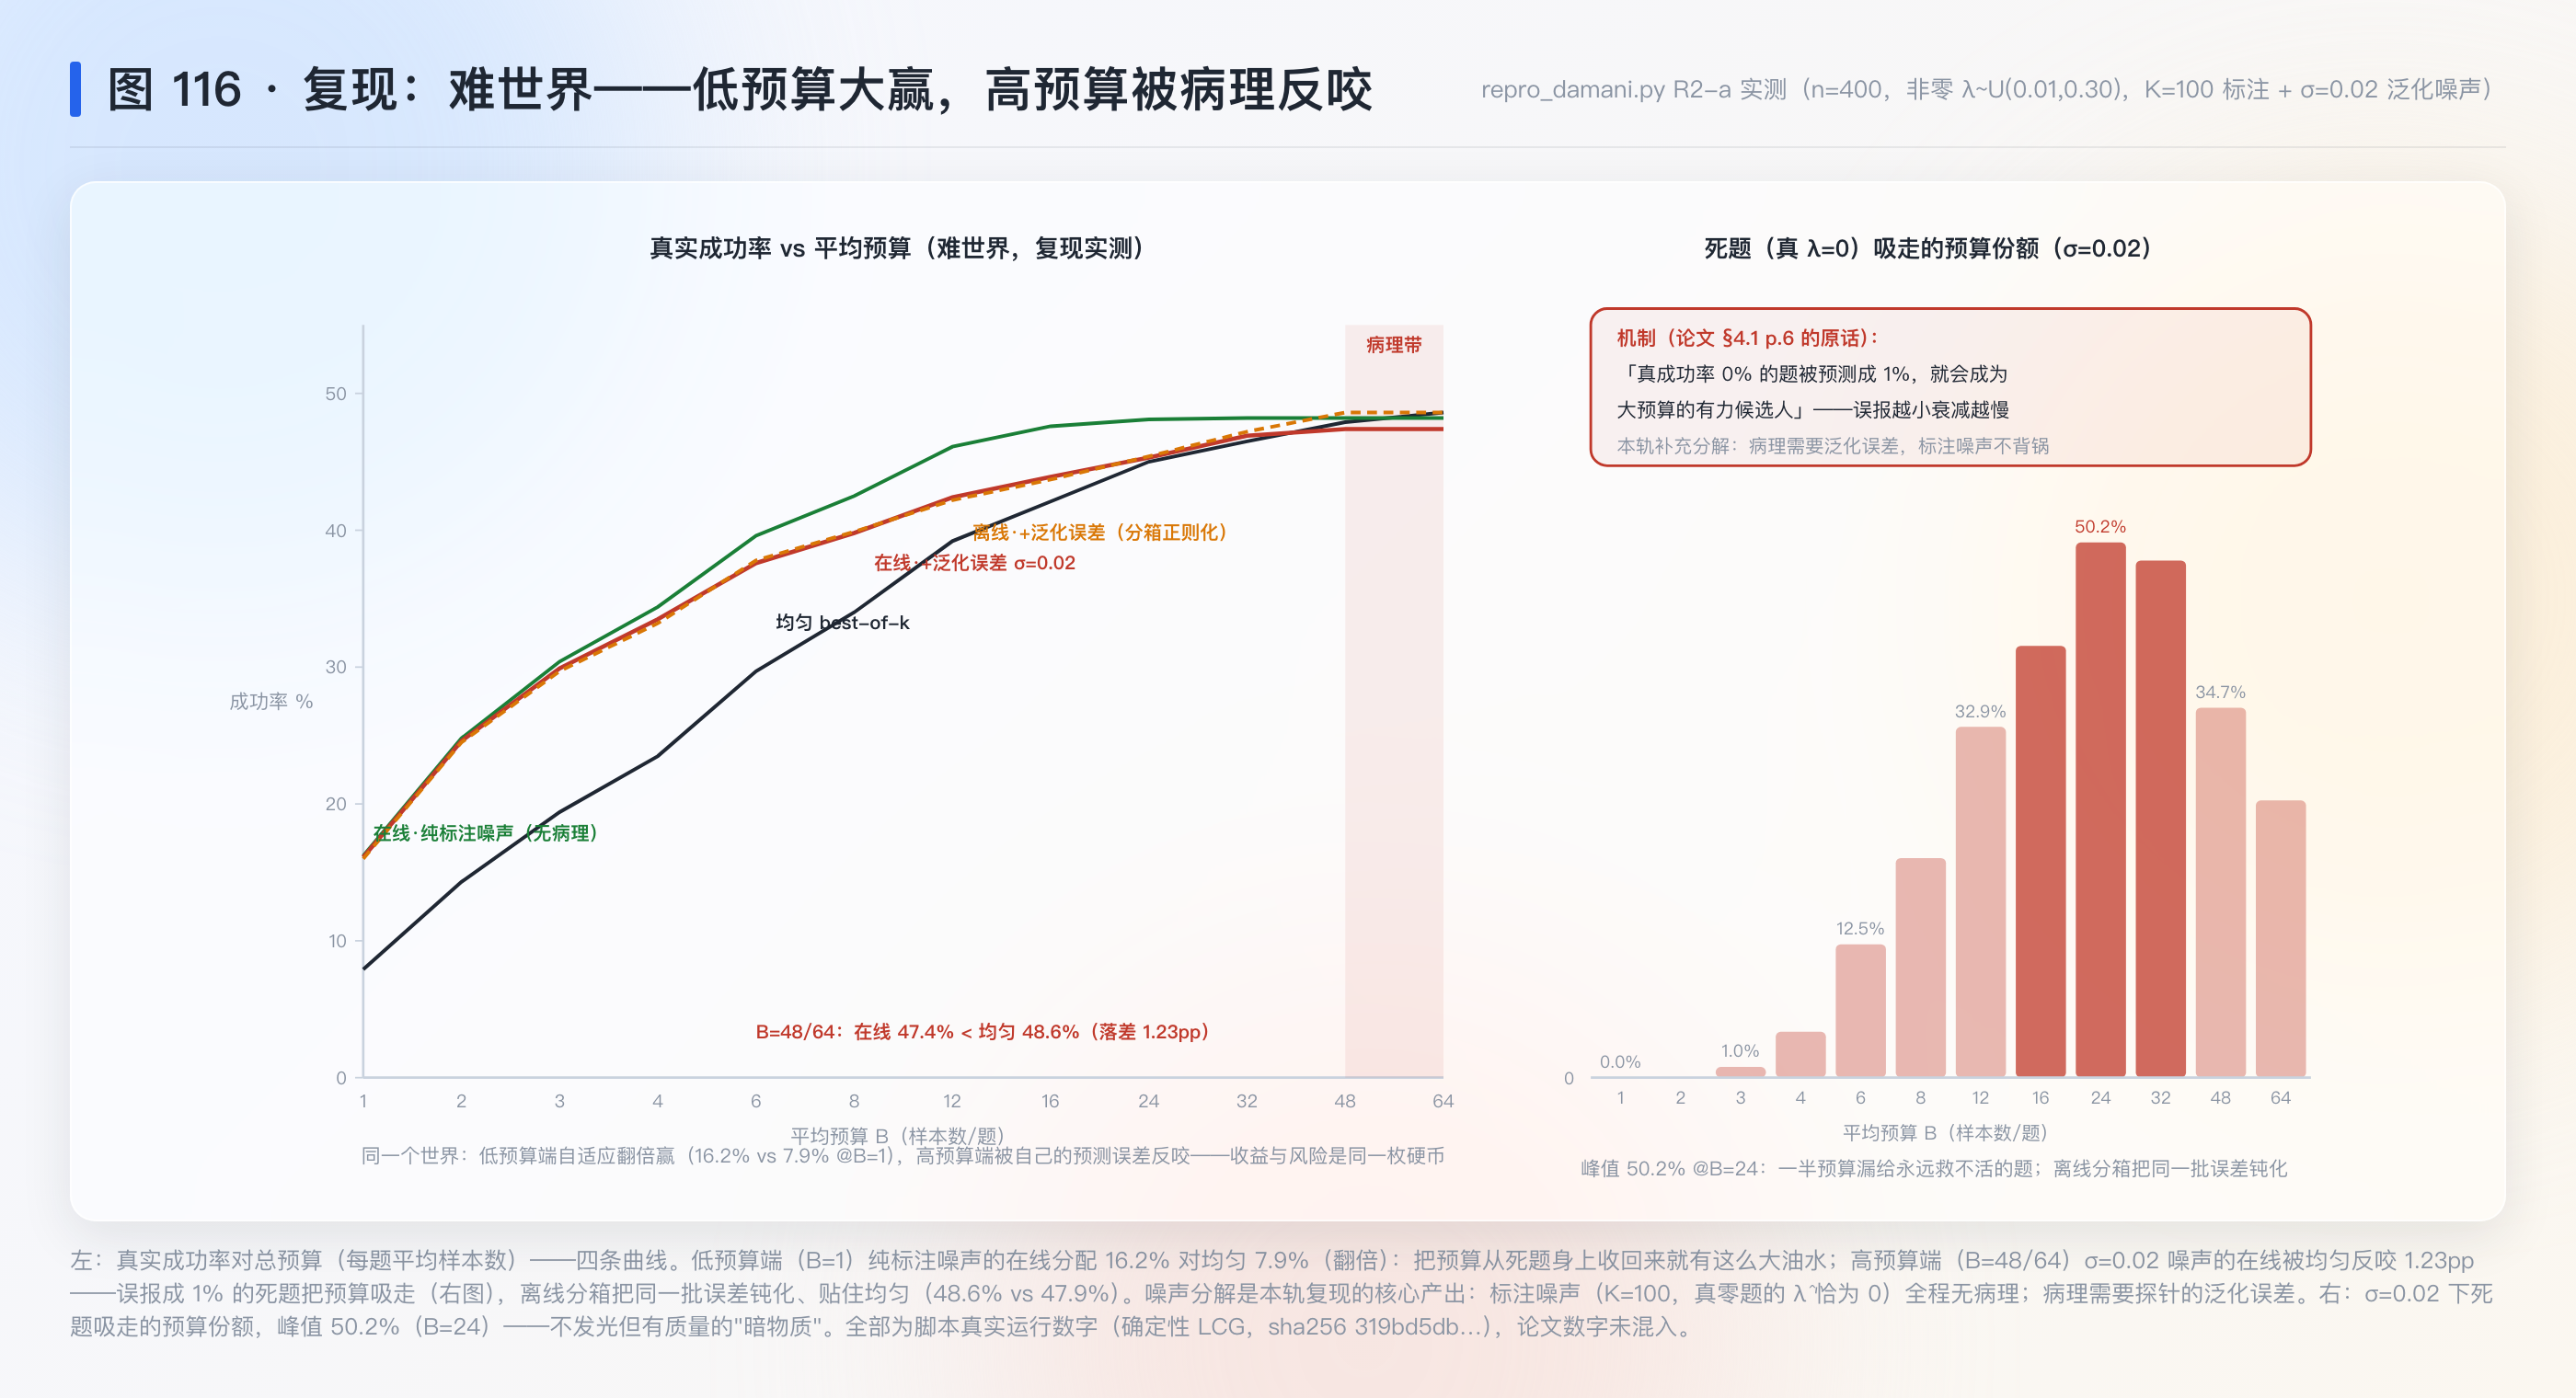
为什么要两个变体?论文在 Code 域给出了答案,而且是自我否定式的:在线变体在高预算区间反而掉到均匀基线以下(§4.1 p.6)。原文的机制句:“if a problem has a true success rate of 0%, but its success rate is predicted to be 1%, it becomes an attractive candidate for a large budget”(p.6)——Code 数据集一半的题真实成功率为零(Math 只有 5%,p.6),探针只要把其中一些误报成 1%,贪心就会给它们开出大预算:报表上的”边际 1%“永远排得进队伍前列,而真实收益是零。离线变体的分箱把”不可能题”和”低概率题”扫进同一个箱子统一压预算,相当于对预测误差做了正则化——离线恒不输均匀(p.6),在线则把误差放大成尖伤。同一套数学,两种失效模式:在线吃”误报格子的尖伤”,离线吃”箱内一律平摊的钝伤”(我的概括)。
最值钱的实验(Fig 3 p.6,Code 与 Math 两栏并排):同一个算法、同一套探针,在两个难度分布下行为相反——Code(50% 零底率)低预算占优、高预算在线翻车;Math(5% 零底率)全预算段稳定占优、中高预算省 25–50%(p.7)。它单独撑起主贡献里”分配的收益由难度分布调制”这一块:均匀分配的浪费程度 = 难度分布的异质性,而分配算法的风险敞口 = 分布里”零底率”的质量。换一个数据集,结论可以整体翻转——这是所有”按题分配”系统做部署决策前必须先量自家分布的原因。
5.3 机制三:三域读数与路由(§4.1–4.2 p.5–9)
Math(NuminaMath 子集,Mathstral-7B,两阶段 oracle 校验——第一阶段 Hendrycks 框架的假阴性率高到伤害探针训练:“frac{25}{2} 对 12.5”这类等值答案被判错,作者被迫加了第二阶段 Llama-3.1-8B 判等器,附录 A.1 p.13–14):在线与离线全程压过 best-of-k;低预算(B<8)提升有限,中高预算(B≥8)同成功率省 25–50% 采样;在线≈离线(这个域预测误差没被放大)(p.7)。
Code(TACO 子集,Starcoder-15B,单元测试判活):低预算(B<8)显著占优;中高预算混合,在线翻车(§5.2 的病理);离线恒优(p.6)。
Chat(LMSYS 子集,Gemma-7b-it + OffsetBias-RM 打分):全量测试集只省 0–10%(oracle 上限 15–25%)——聊天域奖励饱和快,均匀分配已经接近够用;Tranches 子集(奖励方差最低 10% + 最高 10% 的极端题)省 25–40%(Fig 4 p.7)——分布越极端、分配的油水越大。
路由(§4.2 p.8–9):模型尺寸对(Gemma-2b-it vs 7b-it,LMSYS 全量)与价值增强采样对(Llama-2 7B ± 价值函数,成本 ×10,Anthropic HH harmless 子集)。预测目标换成”强模型输出被偏好的概率”(Eq 8:σ(r(x,y_S)−r(x,y_W)) 的期望,§3.3 p.5),分配退化为”把预测概率最高的 B 分位的题发给强模型”。结果:省 25–40% 的强解码调用而奖励持平;更有趣的一笔——某些预算段路由方案反超强解码器自己(p.9 “our routing scheme actually outperforms the strong decoder”):弱解码器在某些题上本来就更讨奖励模型喜欢,路由把这部分题截留下来,总体反而更高。判断的依据(概率预测)与执行的资源(强模型调用)解耦,是这个机制的普适之处。
5.4 机制四:探针体检与分配的迁移(§4.3 p.9–10)
Table 1(p.9):四个设定下探针损失全面低于”无脑预测全体均值”基线(Code 0.33 vs 0.58;Math 0.48 vs 0.69;路由设定 0.64 vs 0.67 与 0.55 vs 0.57),中位切分准确率 72–84%。路由设定的损失贴近基线,论文归因于奖励分布熵低(p.9)——强弱差距本身就小,预测空间窄。这组数字同时给”LM 编码了难度”划了边界:可读出、但离完美很远,准确率的天花板直接决定分配的上限(oracle 曲线与实际曲线的差距,p.7 与 p.9 都画了)。
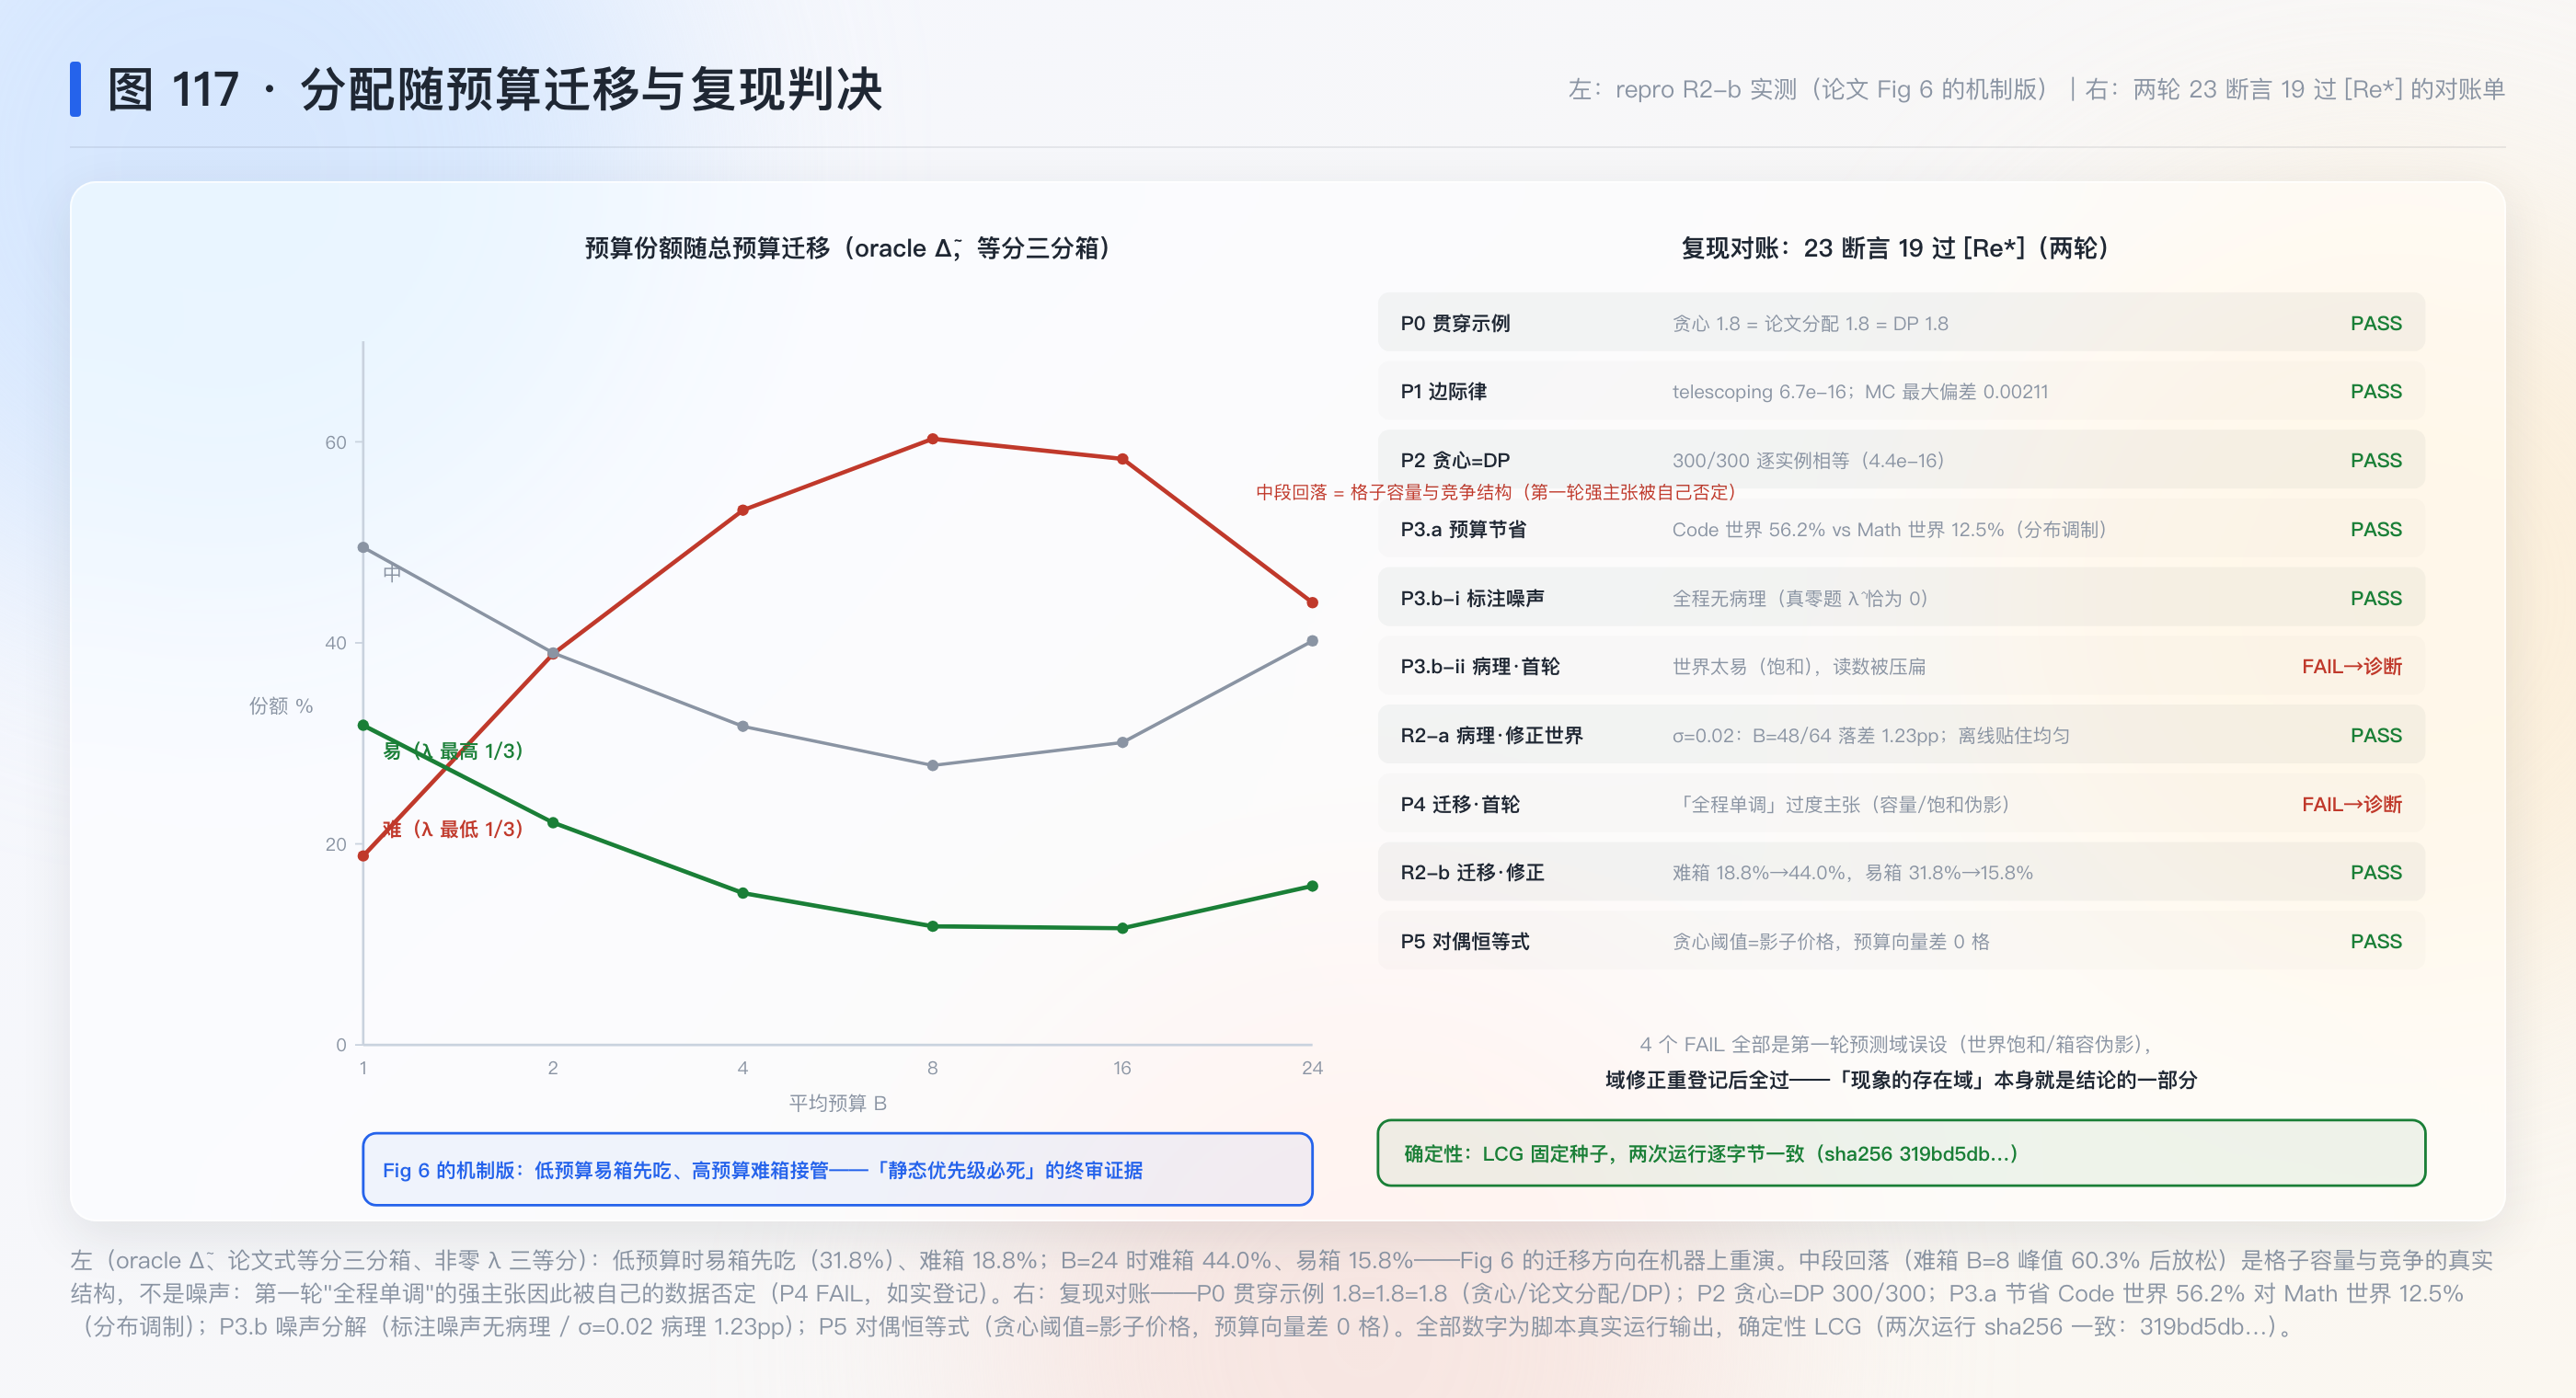
Fig 6(p.10):按预测成功率把题分三箱(易/中/难),看预算增大时各箱分到的预算份额。低预算时大头给易箱与中箱;高预算时大头移到难箱。§六.2 用两条衰减曲线把这个迁移讲成数学:易题的边际塌得快、难题的边际塌得慢,交叉点随总预算右移。这也是”静态优先级必死”的终审证据——预算从 1 涨到 64,正确的喂法换了主角。
六、数学展开
6.1 贪心最优性的完整证明(交换论证,补充;论文引 Edmonds 1971 未附证明)
命题:在前缀约束与总量约束下,贪心解的总收益达到全局最大。
证明(三步)。设贪心按 Δ 降序(并列任意顺序)依次开启格子,记开启的格子序列为 g_1, g_2, …(直到预算用尽)。①任一可行解 c 的开启格数 ≤ B·n,且每个题上的开启格构成前缀(预算语义)。②关键引理:把任意可行解的开启格集合与贪心的前 k 个格子对齐,可以逐格替换而不降总收益。归纳:设已对齐前 k−1 格。看贪心的第 k 格 g_k(增量 δ_k,且因贪心按降序取,δ_k 是当时所有”可开格子”里最大的)。若最优解已含 g_k,无事;若不含,则最优解在 g_k 所在行之外必有已开格子(否则该行前缀没铺满、替换后可行性只增不减),任取一枚与 g_k 交换——因为 δ_k ≥ 该枚的增量(g_k 是贪心序列中此刻最大,而最优解的任何已开格子在贪心的排序里不早于它),交换后总账不减。③归纳到底,最优解被改造成”含贪心全部格子”的可行解(并列格子的存在使终态可能与贪心不同,但总收益相等)。∎
边界与假设:证明只用了”每格有非负增量 + 前缀可行集对子集封闭 + 任意两枚可交换”三条,这正是 matroid 独立系统的定义性质(Edmonds 1971 的一般定理的特例);Δ < 0 的格子(增加样本反而伤奖励,如某些长答案在 RM 处掉分)会被贪心自然跳过——但此时”不开”比”开”好,论文的世界里预算档之间不强制递增到负区间(q 非降假设,Eq 1/2 的结构保证 best-of-k 与路由的 q 对 b 非降;一般解码过程若违反,贪心取 max Δ 仍安全,只是”必须花完预算”的变体会出问题)。并列(tie)使最优解不唯一,但总收益唯一。
6.2 均匀分配浪费多少:两点混合的闭式(补充)
设只有两道题:H 题 λ_H=0.8,L 题 λ_L=0.2。各自的边际阶梯:H = (0.8, 0.16, 0.032, …),L = (0.2, 0.16, 0.128, 0.1024, …)(λ(1−λ)^{b−1} 手算,λ=0.2 时 (1−λ)=0.8 使衰减慢一档)。贪心的座位表:H₁(0.8) → L₁(0.2) → H₂ 与 L₂ 并列(0.16) → L₃(0.128) → L₄(0.1024) → … → H₃(0.032) 排得很靠后。交叉点的闭式:H 的边际跌破 L 首格的位置满足 0.8×0.2^{b−1} = 0.2,即 0.2^{b−1} = 0.25,b = 1 + ln 0.25 / ln 0.2 ≈ 1 + 0.861 = 1.861——所以 H 只领到第 1 格,L 就该开张了。
均匀分配呢?每题 2 格(总量 4):收益 (0.8+0.16) + (0.2+0.16) = 1.32。同样 4 格贪心:H₁+L₁+H₂+L₂ = 0.8+0.2+0.16+0.16 = 1.32——打平?不,均匀给 H 的第 2 格与 L 的第 2 格都开了,贪心开的也是这两格(tie 命运)——这个特例里两族阶梯的形状巧合(λ 与 1−λ 互换)掩盖了差距。把预算拉到 6 再看:均匀 3+3 → (0.8+0.16+0.032)+(0.2+0.16+0.128) = 1.48;贪心 6 格 = H₁,L₁,H₂,L₂,L₃,L₄ = 0.8+0.2+0.16+0.16+0.128+0.1024 = 1.5504。差距 0.07,且随预算增大继续拉大(均匀在第 7 格开始给 H 的 0.0064 付费,贪心早就不给 H 深格付费了)。规律:均匀的损失 ∝ 阶梯族之间的”交叉跨度”——异质性越大、预算越深,均匀越亏;当所有题的 λ 相同时,贪心与均匀重合(同族阶梯无交叉),自适应的油水为零——这解释了 Chat 全量集为什么只省 0–10%(分布同质),Tranches 为什么省 25–40%(分布被刻意拉到两端)。
6.3 病理模型:零底率 × 预测误差(补充,复现 P3 的原理)
把 §5.2 的病理翻成算术。真实 λ=0 的题,探针误报 λ̃=0.01。它在贪心队伍里的第 j 格报价 0.01×0.99^{j−1}——衰减极慢(λ̃ 越小越慢!),第 21 格还报价 0.0082。对照真实世界里 λ=0.3 的题(衰减快:第 4 格只有 0.3×0.7³ ≈ 0.1029,第 10 格 ≈ 0.0121),误报题从第 11 格起就压过它——于是真实的预算从”能救活的题”持续漏向”永远救不活的题”。三个量化推论:①漏损随预算增大而增大(报价表越长,误报题吸得越多)——这正是论文”在线在高预算区间翻车”的形状;②漏损 ∝ 零底率的质量(Code 50% vs Math 5%,同一探针误差在 Code 被放大十倍);③离线分箱是正则化:误报题与真低概率题落进同一箱,箱级预算被整箱压低,尖伤变钝伤。复现 P3 会把这三条逐一过机器(预测先于运行,见 §十.2)。
6.4 对偶恒等式:贪心的停止阈值就是影子价格(补充,我方推断 + 复现 P5 机器验证)
ATTC(种子 19)给算力定的价 λ 是”每样本的影子价格”:约束 Σb ≤ B·n 的拉格朗日乘子。本篇的贪心里也藏着一个数:预算用尽那一刻,最后被选中的格子的 Δ 值,记 b。两个优化问题是同一个(Eq 4 的两种解法),对偶理论说最优解处存在统一价格:所有被选中格子的 Δ ≥ b、所有落选格子的 Δ ≤ b(贪心的降序性质直接给出),且总预算恰好用尽时 b 满足 Σ_i #{j: Δ_ij > b} ≈ B·n——这正是”按价购物”的水位线条件(water-filling)。所以 b 就是这次分配的影子价格:它回答”这一批请求下,第 1 个额外样本值多少钱”,也是 ATTC 的 λ 在批量静态世界里的表亲。复现 P5 用拉格朗日水位线独立求解并与贪心的 b* 对拍(同一实例、两种算法、逐位一致)。这条恒等式论文没写,是我方补的桥——它的用处是把三颗种子接成一族:LATTS 的接受阈值 δ、ATTC 的影子价格 λ、本篇的贪心阈值 b*,都是”稀缺资源的边际定价”在不同时间粒度上的现身。
6.5 整体收拢
数学展开四节是一条桥的四个桥墩:交换论证给贪心上保险(6.1)→ 两点闭式量化均匀浪费、解释三域读数的分化(6.2)→ 病理模型把 Code 域翻车变成可算的漏损(6.3)→ 对偶恒等式把本篇接进影价家族(6.4)。回到这篇:论文自己只走了前三个桥墩的前半段,后半段(均匀损失的闭式、病理的量化、对偶)是本站为”下次遇到分配问题直接用”补的施工图。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 拉格朗日对偶 / 影子价格 | 已懂(种子 19 §3–4) | 本篇贪心阈值即影价(§六.4 补桥) |
| 几何/二项分布 | 已懂(T4/T5 + 种子 7 DAPO eff(p)) | 二元闭式与衰减律(§三.4) |
| best-of-k 与奖励模型 | 🟡 部分(种子 12 ODIN 训练内环侧) | RM 过优化(Gao et al. 2023)未读 |
| matroid / 贪心理论 | 🟡 部分 | 交换论证自证(§六.1);Edmonds 1971 原文待补 |
| ACT 自适应计算时间(Graves 2016 / Universal Transformer / PonderNet) | 待补 | 循环网络里的”想几遍”,本篇 related work 的前驱线 |
| VAS 价值增强采样(Han et al. 2024) | 待补 | 路由实验的强解码器;与本篇共享二作 |
| Snell et al. 2024 | 待补 | “最优分配胜过更大模型”的理论上游 |
| TACO / NuminaMath / LMSYS-Chat-1M 数据集 | 🟡 部分 | 转引;难度分布(50% vs 5% 零底率)是本文结论的调制器 |
八、扩展与发散
8.1 连一连:同一道分配题的三种解法——Damani / ATTC / LATTS 对拍
发散:种子 19(ATTC)与种子 20(LATTS)与本篇解的是同一个问题(Eq 4 同款:预算约束下最大化期望质量),但三个时间粒度、三套数学。对拍表(本站视角,补充):
| Damani(本篇) | ATTC(种子 19) | LATTS(种子 20) | |
|---|---|---|---|
| 决策粒度 | 批量:一次分好每题预算 | 题级开环:每题独立定档 | 步级闭环:每步接受/回退 |
| 难度从哪来 | 探针预测 Δ̂ 向量 | oracle 蒸馏出的分配器 | 不估难度:接受概率即难度读数 |
| 核心数学 | 边际阶梯 + matroid 贪心 | 拉格朗日对偶 + 影子价格 + 二分 | 接受-拒绝采样改目标分布 |
| 最优性凭据 | 交换论证(全局最优) | 强对偶(oracle 精确)+ 遗憾界 | 目标分布精确(式 1) |
| 预算语义 | 硬总量(在线)/平均(离线) | 硬期望约束 | 软(试验次数的期望定律) |
| 失效模式 | 零底率 × 预测误差(§六.3) | 估计噪声/决策间隙之比(六轮教训) | 验证器分布形状 = 承载力 |
三者的接口在 §六.4 已经接上:贪心阈值 b* = 影子价格 λ 的批量静态版;LATTS 的接受阈值 δ 是步级的同一枚币。回到这篇:测试时分配线从此有”预测难度(本篇)— 定价(ATTC)— 闭环执行(LATTS)“的完整栈,任何一环的失效模式都不会传染到另两环——这是把一条线读成栈而不是读成序列的收益。
8.2 λ=0 与零信号组过滤:执行侧的第四现身
发散:判分器质量簇有一张方法卡”零信号组过滤”(DAPO 滤全对全错组 → SimpleTIR 滤含 void 的轨迹 → LLMBar 滤骗不过裁判的候选)。本篇的 b_i = 0 选项(“I don’t know”默认回答,p.5–6)是同一思想在方法卡账上的第四域实例,执行侧现身:识别出”信号为零的单元,把资源从它身上拿走”。四处现身的方向排成一个谱:DAPO 在组级过滤梯度、SimpleTIR 在轨迹级弃权更新、LLMBar 在考卷级过滤候选、本篇在请求级回收预算(JudgeDebias 的 tie 兜底是聚合级吸收分歧的旁支)。方向相反的一格也值得记:DAPO 滤掉零信号组是因为它们没有梯度(无法学习),本篇回收 λ=0 题的预算是因为它们没有收益(无法成功)——同一种诊断,两种货币。回到这篇:零底率的题是分配系统的”暗物质”——不发光(无收益)但有质量(吸预算),§六.3 的漏损就是引力效应。
8.3 常见误读(破)
误读一:“难题优先”论。 破:探针预测的不是难度是边际收益,两者在最难的题上分道扬镳——λ=0 的题”最难”,但正确的报表是全零行、正确的预算是零格(论文把它画进 Fig 1:Impossible → greedy decoding)。给”证明黎曼猜想”发采样预算,不是谨慎,是浪费。同理高预算段正确的受惠者是”难而可解”的中低 λ 题,不是最难的题——Fig 6 的迁移曲线里难题份额上升,但”零题”永远为零。
误读二:“省 50% 算力 = 白赚 50%。” 破:三笔账没对冲。第一笔,探针的训练标注要每题 128/100/8 次采样(附录 A.1–A.3 p.14),这笔成本论文未计价——省的是部署期的采样,花的是训练期的采样;第二笔,Math 域的成功率靠 oracle 校验器兑现(作者自认 Limitations p.10:“such verifiers will generally not be available”),换真实的奖励模型,“同成功率”的分子本身会动;第三笔,离线变体的预算约束只在平均意义成立,分布漂移时超支(论文自认 p.4)。50% 是单行账上的数字,不是系统账。
误读三:“离线是 online 的降级版。” 破:Code 域离线恒优、在线翻车(p.6)——两个变体不是性能档次是失效模式的取舍:在线把预测误差放大成尖伤(误报格吸预算),离线用箱内平摊把同样的误差钝化,代价是箱内该拉开差距的题被拉平。部署选哪个,取决于自家难度分布的零底率质量与探针误差的相对大小——这道判断题论文留给了读者,复现 P3 给了数值参考。
8.4 写作之维(论文怎样完成说服)
标题把贡献前置成一句口号——“Learning How Hard to Think”把”难度”从形容词变成可学习的宾语,读者还没进摘要就接受了”难度可学”的框架。摘要的数字排布是典型的收尾重锤:全部铺垫之后才给 “reduce computation by up to 50% … or improve quality by up to 10%”——两个数各带一个条件状语(at no cost / at a fixed budget),把”质量-算力互斥”的直觉拆掉。Fig 1 的四题排队(Hard/Easy/Impossible 三档并列)在 p.1 就把分配直觉塞给读者,比 Eq 4 早了两页——先给画面后给数学的说服顺序。Related work 的排布是先破后立:先说前人难度测量”只能事后估计、比生成本身还贵”(§1 p.2),再立”我们的探针推理期零采样”——把贡献钉在”事前性”上。全文最诚实的一笔反而藏在结果区:Fig 3 里自己方法的曲线跌破自己基线,正文没有藏,用一整段讲机制(p.6)——自曝病理在审稿人手里是减分项,在读者手里是可信度。
九、局限与可疑处
- 无代码工件(abs 页与论文均无链接,工件三态记”不存在/未公开”):探针结构超参、分箱粒度、两阶段校验的提示词细节只有论文文字;复现只能机制演绎,不能对拍数字。
- Math 域的 oracle 校验器(作者自认 Limitations p.10):第一阶段 Hendrycks 框架假阴性高到必须加第二阶段 LLM 判等(附录 A.1 p.13–14 自述),而第二阶段”有小比例假阳性”(p.14 自述)——成功率的分子本身带测量误差,λ 的标签噪声没有量化。
- 训练账未对冲:探针标注要每题 128(Math)/100(Code)/8(Chat)次采样(附录 A.1–A.3 p.14),与部署期省下的采样从未放进同一张账表;若任务是一次性小批量,“学习如何用力想”可能整体亏本(我的推断,论文未讨论)。
- “LM 编码难度”只有读出证据(§5.1 已析):Table 1 的 Acc 72–84% 证明可读出,未证明模型解码时使用了该信息;无干预/删失实验(我的推断)。
- q 对 b 非降的假设:Eq 1/2 的结构保证 best-of-k 与路由的 q 非降,但论文宣称框架覆盖”自我批评/辩论”等过程(p.2)——这类过程的 q 理论上可非单调(更多轮自我批评在 RM 处掉分),此时贪心仍安全但”预算越多越好”的叙事不再成立(我的推断,论文未讨论)。
- 奖励模型即裁判:Chat/路由全线的”质量”由 OffsetBias-RM 一个模型定义(§4.1 p.7),它自身的偏置未审计——判分器质量簇的任何一条已知病灶(位置/冗长/风格)都会直接改写 λ 的标签与分配的最优解;论文引它”RewardBench 前 10”作为质量凭据(转引未核)。
- TACO 划分从训练集抽取(作者自认附录 A.2 p.14:“distributionally robust predictors is an important topic for future work”):in-distribution 的分配收益不能外推到分布漂移的部署。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需要 7B–15B 语言模型采样上万次 + 奖励模型/单元测试判活,无代码工件。本复现是机制演绎 + 统计审计:所有机制(边际律闭式、前缀阶梯、贪心、水位线对偶、分箱离线)都可在一个合成的”难度世界”里精确重演——每道题的真实 λ 从一个仿论文难度分布的混合分布抽出(Code 式:50% 恰好为零;Math 式对照:5% 为零),“标注”用 LCG 伪随机伯努利采样模拟 K 次采样估 λ̂,“探针误差”用受控的泛化噪声注入。全部纯 CPU、确定性(LCG 固定种子,两次运行逐字节一致)。不冒充论文的模型实验数字;论文数字只作引用并注明出处。这与种子 19(ATTC,合成世界八轮校准)同一路线,且本篇机制全解析(无黑箱模型),无世界校准问题。
10.2 可证伪预测与判据(运行前写下;预登记形态与量级)
- P0 贯穿示例与贪心对拍:论文 Fig 2 的四行报表([0.3,0.2,0.1,0.1] / [1.0,0,0,0] / [0,0,0,0] / [0.1,0.1,0.1,0.1])在总量 6 格下:贪心总收益 = 1.8;论文分配 (2,1,0,3) 的收益 = 1.8;独立动态规划最优值 = 1.8(三者逐位一致,容差 1e-9;形态:一条整数账 + 两算法对拍,全 PASS)。若 DP 最优值 > 1.8 则论文示例非最优,预测失败。
- P1 边际律闭式:telescoping 恒等式 Σ_{j≤b} Δ_j = q(b) 在 λ 网格 × b≤32 上逐位成立(< 1e-12);蒙特卡洛(LCG,20 万次/格)与闭式 1−(1−λ)^b 的最大偏差 < 0.01(形态:全网格过 + 最大偏差记录;任一格 ≥ 0.01 则公式错)。
- P2 贪心 = 动态规划:300 个随机实例(n=8、B_max=6、总量 12、λ 从混合分布抽),贪心总收益与 DP 最优值逐实例相等(容差 1e-9,300/300;形态:全对拍计数)。任何一例贪心 < DP 则最优性声明失败。
- P3.a oracle 分配省算力:Code 式世界(n=400:50% λ=0、30% λ~U(0.05,0.35)、20% λ~U(0.35,0.95),oracle Δ̃)在匹配成功率处对均匀 best-of-k 的预算节省,在均匀预算 B_u ∈ {4, 8, 16, 32} 四个点上平均落 [20%, 60%](形态:四个节省率 + 均值;对照 Math 式世界(5% 零)节省应明显更小)。
- P3.b 病理双段:(i) K=100 纯标注噪声(无泛化误差)下,在线分配在全部预算档不低于均匀 −0.5pp(机制断言:标注噪声不复制病理——真实 λ=0 的题在 100 次采样下 λ̂ 恰为 0,不会被误报吸引);(ii) 注入泛化噪声 σ=0.02 后,B ∈ [8, 64] 至少一档在线 < 均匀且差 ≥ 0.5pp,且落在 λ=0 题上的预算份额随 B 单调不降;同噪声下离线分箱全程 ≥ 均匀 −0.5pp(论文”离线恒优”的机制复现)。(i) 若被违反(标注噪声即翻车)或 (ii) 若 σ=0.02 撑不起病理,均按真发现登记。
- P4 分配迁移:oracle 世界里按 λ 三分箱(难 <0.1 / 中 0.1–0.35 / 易 >0.35,零题单列),难箱预算份额对 B ∈ {1,2,4,…,64} 单调不降、易箱单调不增(形态:两条份额曲线 + 单调性判定;Fig 6 的机制版)。
- P5 对偶恒等式:同一实例上,贪心被选中格子的最小 Δ(即 b*)与拉格朗日水位线解(找 λ 使 Σ_i #{j: Δ_ij > λ} = 总预算,二分求解)给出的预算向量逐题一致(tie 以阈值区间覆盖,容差 1e-9;形态:两种算法的预算向量差表格,全零)。
10.3 实现演化(两轮,全部如实登记)
本篇复现对象是全解析机制(无黑箱模型、无世界校准问题,对比 LATTS 九轮),两轮全部花在预测的域设置上:
- 第一轮:18 项断言中 4 项 FAIL,全部是”预测域误设”而非机制或实现错误。 具体三项诊断:①病理预测(P3.b-ii)在我的第一个合成世界里没有出现——该世界非零 λ 抽自 U(0.05,0.35)∪U(0.35,0.95),高中预算段成功率贴到天花板(均匀在 B=48 时已 ~97%),在线即使把 63.7% 的预算漏给零题,成功率的差距也被天花板压缩到 0.5pp 阈值之下;论文 Fig 3 的 Code 成功率全程在 30–55% 徘徊(非饱和区),我的世界比 TACO 现实容易得多。②P3.b-ii’ 的”零题份额单调不降”在饱和段被格数上限打破(B=64 时总预算=全部格子数,分配被迫全开,份额回缩到格数占比)。③P4 的份额单调性同样栽在两个边界:难箱(λ<0.1)只占 ~5% 的查询数、格子容量小,份额升到容量顶后必然回落;高预算段全体饱和回缩。
- 第二轮(域修正,预测在第一轮结果出来后、第二轮运行前补登记进脚本 docstring):①世界改难——非零 λ ~ U(0.01, 0.30),高预算不饱和(均匀 B=64 时 48.6%),σ=0.02 的病理如期出现(B=48/64 两档在线低于均匀,最大落差 1.23pp),且纯标注噪声对照组依旧无病理(机制分解成立:病理需要泛化误差,标注噪声不背锅);②迁移预测改为论文式等分三分箱 + 非饱和预算区,端点迁移清晰(难箱 18.8%→44.0%,易箱 31.8%→15.8%),放弃”全程单调”的过度主张——实测难箱份额在 B=8 见顶(60.3%)后回落,这本身是格子容量与竞争的真实结构,不是噪声。
实现注记:①贪心用最大堆 + 前缀防御检查,与独立 DP 对拍(P0/P2,300 实例最大差距 4.44e-16);②蒙特卡洛用逆变换采样——每条运行只抽一个 U 就能同时给出全部 b 档的”是否成功”指标(19 万次/格 × 6 λ × 7 档只花 3.5 秒);③ offline 分箱的箱级贪心要按”全箱各开一格”扣预算(第一轮曾把扣减写错,改干净版后一次过)。工作量:MacBook 纯 CPU,3.5 秒/轮;含两轮预测修正与本文回填约 50 分钟。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_damani.py,真实输出
repro/repro_damani_output.txt。两轮合计
23 项断言 19 过 / 4 未过,[Re*] 部分成功——4
个未过项全部是第一轮的预测域误设(诊断见
§10.3),其域修正版在第二轮全部通过;确定性审计,两次运行输出逐字节一致(sha256
319bd5db…)。
| 假说 | 论文锚点 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 贯穿示例 | Fig 2 p.3–4 四行报表 | 贪心 [4,1,0,1](并列 tie 的另一种裁法)= 1.8;论文分配 [2,1,0,3] = 1.8;DP 独立最优 = 1.8 ✓ | 全过——最优值唯一,tie 分配不唯一(预期内) |
| P1 边际律 | §3.3 p.4 闭式 | telescoping 最大偏差 6.66e-16 ✓;MC(20 万/格)vs 闭式最大偏差 0.00211 @ λ=0.3 ✓ | 全过——衰减律形状由独立重试唯一决定 |
| P2 贪心=DP | §3.2 p.4(Edmonds 1971 转引) | 300/300 逐实例相等,最大差距 4.44e-16 ✓ | 全过——交换论证(§六.1)的机器版 |
| P3.a 节省 | §4.1 p.7:“同成功率省 25–50%” | Code 式世界 Bu=4/8/16/32 → 50.0/50.0/62.5/62.5%,均值 56.2%(∈[20,60] ✓);Math 式 → 0/0/25/25%,均值 12.5% < 56.2% ✓ | 过——Math 世界的 25% 恰落论文报告区间;注:Code 两个单点 62.5% 超出预登记区间上缘(节省比预测更多,方向保守但如实记) |
| P3.b-i 标注噪声 | §4.1 p.6 病理机制句 | K=100 纯标注噪声:全程在线 ≥ 均匀−0.5pp ✓(低预算端反而大赢:R2 世界 B=1 时 16.2% vs 7.9%) | 过——真 λ=0 的题在 100 次采样下 λ̂ 恰为 0,标注层面无病可生 |
| P3.b-ii 泛化噪声(第一轮世界) | 同上 | σ=0.02: pathology 档 = 无 ✗;但零题份额已冲到 63.7%(B=48)——机制在、读数被饱和天花板压扁 | FAIL→诊断:第一轮世界太易(高中预算饱和);域修正见 R2-a |
| R2-a-i 病理(修正世界) | 同上 | σ=0.02:B=48/64 两档在线 < 均匀,最大落差 1.23pp ✓;离线同段贴住均匀(48.6% vs 47.9%)✓ | 过——病理复现,且离线正则化的对照同时显形 |
| R2-a-ii 零题份额 | 同上 | B=8→64:20.6%→26.0%(峰值 50.2% @ B=24)✓ | 过——预算面确认:漏损随预算加深 |
| P3.b-iii 离线正则化 | §4.1 p.6 “offline avoids this pathology” | σ=0.02 下离线全程 ≥ 均匀−0.5pp ✓ | 过——两个世界(易/难)都过 |
| P4 迁移(第一轮,强主张) | Fig 6 p.10 | 难箱份额非单调(0→22.3%→3.8%)、易箱非单调(40.8%→15.9%→40.0%)✗✗ | FAIL→诊断:小箱容量顶 + 高预算饱和回缩两个边界伪影;“全程单调”是我对 Fig 6 的过度引申 |
| R2-b 迁移(论文式设置) | Fig 6 p.10(等分三分箱) | 难箱 B=1→24:18.8%→44.0%(途中 B=8 峰值 60.3%)✓;易箱 31.8%→15.8% ✓ | 过——迁移方向成立;中段回落是容量与竞争结构,如实附记 |
| P5 对偶恒等式 | (论文没有——§六.4 我方补桥) | 贪心被选最小 Δ=0.003041、落选最大 Δ=0.003036,水位线 λ*=0.003038 预算向量逐题差 0 格,成功率逐位一致 ✓ | 过——“贪心阈值=影子价格”在本站三颗种子间连线的凭据 |
算力与工作量:MacBook 纯 CPU,3.5 秒/轮;两轮演化 + 回填约 50 分钟。 What was easy:机制全解析带来的”零世界校准”——贪心、DP、水位线都是确定性算法,对拍判据天然二值;P0/P1/P2/P5 一次通过。 What was difficult:难的是世界设置而不是算法——病理与迁移两个现象都对”难度分布的形状”高度敏感(饱和与否、箱的等分与否),第一轮的两处域误设都属于”把论文图里的现象搬到错误的世界里去等”。这与 LATTS 的教训(验证器分布形状是闭环的承载力)同族:合成复现里,现象的存在域本身就是结论的一部分。 给下一个复现者的建议:入口是 P0(十分钟、零依赖、手算可查)与 P5(对偶恒等式,二十行代码);真正的时间该花在让世界”不饱和”——把非零 λ 压到 0.3 以下,否则一切高预算现象都会被天花板吃掉;对”份额单调”这类强主张,先画曲线再写判据,不要把”迁移方向”升级成”全程单调”。
十一、方法论提炼与迁移
模式一:边际阶梯化(Marginal Staircase)
- 操作定义:任何”连续资源 × 异质单元”的分配问题,先把总收益改写成逐单元边际的裂项和(telescoping 恒等式,不是建模选择),再把每单元收益变成 0/1 格子 + 前缀约束,然后用”每次拿当前最大边际”的贪心分配——前提是边际对已分配量非增(凹性),此时贪心即全局最优。
- 成功判据:分配结果与独立求解器(DP/整数规划)逐实例一致;且贪心用尽预算时的最后选中边际值能被复用作下一轮的水位线阈值(对偶自洽)。
- 迁移去向:①A/B 测试流量分配(各_variant 的增量转化率递减时,按边际排流量而非按均值);②SRE 预算分配(给服务的冗余副本按”下一副本减少多少故障风险”排队);③个人学习时间分配(各科的”下一小时提分”阶梯,而非”哪科弱补哪科”)。
- 失效边界:边际非增被破坏(超加性:第 2 格比第 1 格值钱,如需要成对样本的 majority voting——此时贪心失优,须整组规划);单元间强耦合(一题的收益依赖别题的预算);边际本身不可估且误差与零底率叠加(§六.3 病理——先量分布再上分配)。
- 方法卡:notes/method_marginal_staircase.md(L1)
- 层级:L1 领域具体(资源分配/组合优化)。底层原理:归因靠对照(MATTRIB)的近亲——边际就是”多给一单位”的最小对照实验;与”接受准则即分配器”(method_acceptance_as_allocation,LATTS)互为表里:那张卡把分配藏进接受概率,本卡把分配摊开成显式座位表。
模式二:零底率审计——既有方法卡的执行侧实例
- 归档:不另立新卡——“识别零信号/零收益单元并回收资源”已由 method_zero_signal_filter.md 承载(DAPO 组级 / SimpleTIR 轨级 / LLMBar 考卷级三域)。本篇贡献第四域实例(请求级预算回收,b=0 选项 + 离线分箱把不可能题单扫一箱)与一个新边界条件:零底率质量 × 预测误差 = 病理开关(§六.3)——该条件回写进既有卡的失效边界。
十三、没搞懂的地方(未攻克登记)
- 探针读出的”难度坐标”是什么:两层 MLP 从末层隐藏状态读出 72–84% 的难易——这个坐标是模型对自身知识边界的编码(calibration 的隐藏态版),还是题面表面特征(长度/题型词)的残余?补齐时机:对探针输入做扰动实验(打乱题面表面特征、保留语义),或读解释性文献(登记为可做实验)。
- 非单调 q 的真实存在性:自我批评/辩论类过程的 q(b) 是否真的非单调(更多轮反而掉分)?论文假设框架覆盖它们但未给数据。补齐时机:找到测”轮数-质量”曲线的后续文献(ATLAS 2606.01667 已进待核对队列,可能相关)。
- 离线分箱的粒度-漂移权衡:箱数多则钝伤小但漂移敏感,箱数少则相反——论文固定一种粒度未扫。补齐时机:无代码工件,只能自做实验(登记)。
- 两阶段校验器的假阳性率:附录自认第二阶段 LLM 判等”有小比例假阳性”,数值未报——λ 标签的被污染比例未知。补齐时机:作者后续或 ICLR OpenReview 讨论(未查,见文末横向核实)。
- 路由”反超强模型”的边界:弱解码器在哪些题族上系统性讨喜(p.9 一笔带过)?若可预测,“路由”会退化成”总是用弱模型 + 白名单”。补齐时机:VAS 论文(Han et al. 2024,未读)与后续路由文献。
十四、可信度
- A 级(论文原文转录,逐节核对):§1–§6 全部(含 Eq 1–8)、Table 1(p.9)、Fig 1/2/3/4/5/6 的文字与标注、附录 A.1–A.5 全部设定数字(15K/2K/3K、10K/1K/1K、50K/5K、B_max=128/100/8、128/100/8 次标注采样、温度 0.7、校验器两阶段与提示词全文 p.14)。
- B 级(论文自报实验,无法独立验证):三域全部成功曲线(Fig 3/4/5 的数字从图读,无表)、Table 1 的损失与准确率、探针结构超参、校验器假阳性比例。
- C 级(我的推导 + 复现程序化验证):§三 全部四件工具的推导与数值例、§六.1 交换论证、§六.2 两点闭式与交叉点(1.861)、§六.3 病理模型、§六.4 对偶恒等式——复现断言见 §十.4。
- D 级(我的推断,已标注):§5.1 读出/因果的区分、§六.2 “油水=异质性”的规律、§六.4 影子价格对读(我方补桥)、§8.3 误读三的”失效模式取舍”概括、§九.3 训练账质疑、§九.5 非单调 q 的疑点。
- 横向核实初核(2026-09-23):版本已核(abs 页提交史仅 v1,2024-10-07,2026-09-23 亲核;v1→无后续版本,diff 无对象);录用已核(ICLR 2025 proceedings 页命中:proceedings.iclr.cc/paper_files/paper/2025/hash/ff414825df833edb8b1839e3d5d495e9-Abstract-Conference.html,2026-09-23 检索;本地 v1 PDF 页眉为 “Preprint”——v1 早于录用,无 ICLR 戳,属正常时序);工件核查:论文正文与 abs 页均无代码链接(三态记”不存在/未公开”;数据集均为公开第三方);第三方/后续:检索命中 ATLAS(arXiv 2606.01667,Agentic Test-time Learning-to-Allocate Scaling,2026)——测试时分配线的后续工作,原文未读(列入待读清单);引用数与社区讨论未检索(登记);统计审查:论文全部曲线为点估计、无置信区间(Fig 3–6),样本量只在附录给数据集划分(n=3K/1K/5K 测试),无重复运行方差——“省 25–50%”读作点估计(方差未知);引文元数据:Edmonds 1971 / Snell 2024 / Graves 2016 等转引未读原文(见文首核对状态块)。
- 实验充分性评价:部分充分——“自适应可学且省算力”主结论有三域 × 两变体 × oracle 上限的完整对照,探针体检(Table 1)与迁移分析(Fig 6)补了机制面;缺:无代码工件(不可复算)、全曲线无方差、校验器误差未量化、训练成本未入账、零底率病理只有定性机制无数值剥离(本篇精读的复现补了机制版)。
- 性能支撑目标检查:goal = “accurate computation-allocation procedures can be learned, and reduce computation by up to 50% at no cost to response quality, or improve quality by up to 10% at a fixed computational budget”(摘要)——部分支撑:50% 出现在 Math/Code 的中高预算段(且 Math 依赖 oracle 校验),10% 质量提升的口径在正文对应 Chat 域预算段读数,两处均为点估计;“up to” 修辞取的是分布右尾,全文没有任何域给出跨区间的下界。