外行导读(先读这个,再决定要不要进正文)
一个场景:网页智能体订机票要先点「出发地」、填城市、从弹窗里选机场——这串动作在任何订票网站都长得差不多。可现在的智能体每接一个新任务都从零摸:要么把固定的示例提示背在开头(换个网站就抓瞎),要么现场重新发现「原来要先点这里再填那里」。人不是这么干活的——人做完几遍订票就攒下一条「套路」,下次直接照套路走。
这篇论文干的事:给智能体装一台「套路提炼机」。它走过的每条成功轨迹,由一个归纳模块从中抽出反复出现的子例程——比如「按地名找地点」——并把具体值抽象掉(「纽约」变成 {location}),存成一条工作流:一句目标描述 + 一串带环境状态、推理理由、具体动作三段的步骤。之后每个新任务的提示里都塞进这批工作流,智能体照着走,走得通的任务再贡献新的更复杂的工作流(「按地名找地点」攒够了就长出「查某地邮编」)——滚雪球。两种用法:有标注例就离线先归纳(offline),没有就在测试流上边做边归纳,由一个 LM 评估器判断哪条轨迹算成功、只归纳成功的(online,免监督)。
为什么值得关心:三个理由。第一,它是本站 agent 经验管理线的收口件——上周 Memex(种子 26)管「经验怎么存」(索引化无损),Demystify(种子 27)管「经验怎么用」(蒸馏成技能锚动作),本篇管「经验怎么归纳」(从轨迹抽例程):四格里最关键的「抽」这一环,把存和用接上了。Demystify 论文里的 WF 对照臂,原型就是这篇。第二,它的核心读数干净:无监督归纳出的工作流,超过了人类专家手写工作流的方法(35.5 对 SteP 33.0)——「机器攒的套路比人写的好」这一条,在 2024 年就有实证了。第三,它诚实地报告了方法的两个别扭处:把工作流包装成可调用动作,agent 只在 18.5% 的任务里愿意用(抵抗新动作);离线与在线归纳混着用反而不如单用(两源不相容)——这两条对今天设计 agent 技能系统的人仍是活警告。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| 工作流(workflow) | 一句目标描述 d + 一条轨迹 (p1,…,pn);每个 p = 环境状态 NL + 推理理由 + 动作程序三段 |
| 归纳模块 I | I(E)→W:从一批轨迹里抽公共子例程,输出工作流集合 |
| 抽象化 | 把「dry cat food」换成 {product-name}——去掉例子专属值,例程才能跨任务复用 |
| 离线 / 在线 | offline=先从训练例批量归纳再上测试;online=测试流边做边归纳,只归纳判成功的 |
| L_eval | 在线模式的 LM 评估器,对每条轨迹出 0/1 判成功(Pan et al. 2024 的自评方法) |
| 按网站分组 | 例程按所属网站分别归纳与注入——任务只见本站工作流 |
| 滚雪球 | 命中工作流→成功率高→贡献新工作流→更复杂的工作流长在旧的上(Fig 1) |
| Mind2Web 三分割 | cross-task / cross-website / cross-domain:训练-测试差距从小到大 |
| step success rate | 一步的元素选择与动作都对才算对;task SR=全步都对(比步 SR 苛刻得多) |
| AWM_AS | 把工作流包装成高层动作(login(u,p) 一调全跑)加进动作空间的变体 |
| SteP / BrowserGym | 对照方法:SteP 用 14 条人类专家手写工作流;BrowserGym 是当时最强的无监督 agent 框架 |
§0 承接栏
这颗种子接的是 agent 经验管理的第三问。本站的 Memex 精读回答「经验怎么存」——原始轨迹索引化无损压缩,按需解引用;Demystify 精读回答「经验怎么用」——蒸馏成一页技能去锚定动作,并实测了轨迹记忆与标准化技能两种形态的行为差异。中间还缺一问:经验从哪来、怎么从一堆轨迹里长出一条可复用的例程?这就是 AWM 的归纳模块 I(E)→W。Demystify 的 WF 臂正是这篇的形态——那篇实测了它的行为画像(65.7% 程序性锚定),这篇提供它的生成机制。两篇合读,「存-归纳-用」三段第一次对上口。对执行侧它是长时程任务的老朋友:滚雪球的「快速学习期」(§3.1.2,约 40 例)与 LATTS 的「局部难度驱动分配」是同一枚硬币——都是「执行历史本身携带了改进信号」。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1:LM agent 现在能干网页导航、手机操作这类数字任务,但「大多把固定的示例集合通过训练或上下文学习集成进来」——于是只在跟示例相似的动作序列上表现好,任务语境或环境一变就脆。病根被论文一句话点破:「they fail to grasp the key to disentangling increasingly complex tasks — to extract and learn reusable task workflows shared across similar tasks and environments」(§1 p.1)。而且 agent 每个任务各自解决、不带着成败记忆走,「无法随时间适应」(§1 p.1,引 Yoran et al. 2024)。
停下来猜一下(猜论文):要让 agent 攒「套路」,最直白的做法是把整条成功轨迹存下来、下次原样检索塞进提示——这就是 Synapse 一族的「轨迹即示例」。这篇偏不。猜一下它为什么不肯存整条轨迹、非要抽「子例程」再抽象化不可?——提示在 Mind2Web 的对照读数里:存整条的(Synapse)步成功率 30.6%,抽例程的(AWM)34.6%(Table 3 p.7,同为 GPT-3.5)。答案翻 §3.2.1:整条轨迹带着例子专属的值与上下文,「可能使 agent 偏向选择与给定示例中相似的元素」——具体是有偏差的;而抽象例程「对元素选择引入更少偏差」(p.8)。换句话说:存得越具体,泛化越差——这个方向在检索增强里也成立。
1.2 旧做法的三种病(§1–2 p.1)
第一种病:示例是静态的——训练时注入(Fu et al. 2024、Murty et al. 2024)或固定 few-shot,任务分布一漂移就失效。第二种病:任务之间不交流——每条轨迹用完即弃,成功的经验没有通道变成下一条任务的先验。第三种病:人类专家工作流(SteP 的 14 条手写流程)有效但不可扩展——每个新网站都要人去写。论文的方案对着三个病各给一招:例程动态归纳、记忆持续更新、全程零人工。
二、核心想法
一句话:把「agent 攒经验」形式化成一台归纳机器——从成功轨迹抽公共子例程、抽象掉例子专属值、按站入库、下个任务全量注入;库在流式执行中滚雪球。
直觉先打底。这跟人攒做饭套路的过程一模一样:头几次照菜谱做(基线探索),某几步总是连着出现(公共子例程),于是把它记成「炒糖色:小火、油、糖、变色就下肉」(抽象化——不记具体这次的肉量),下次做红烧类直接调取这条套路,甚至把它当零件拼进更复杂的菜(滚雪球)。关键是三步都缺一不可:不抽子例程(存整条菜谱合集)翻着费劲,不抽象化(记「三块冰糖」)换个菜就废,不入库(每次现想)等于没攒。
全篇就看这张:图 126——左边是归纳-注入-执行闭环(任务流→轨迹→评估→归纳→入库→检索注入),右边是本站复现的滚雪球分段读数。
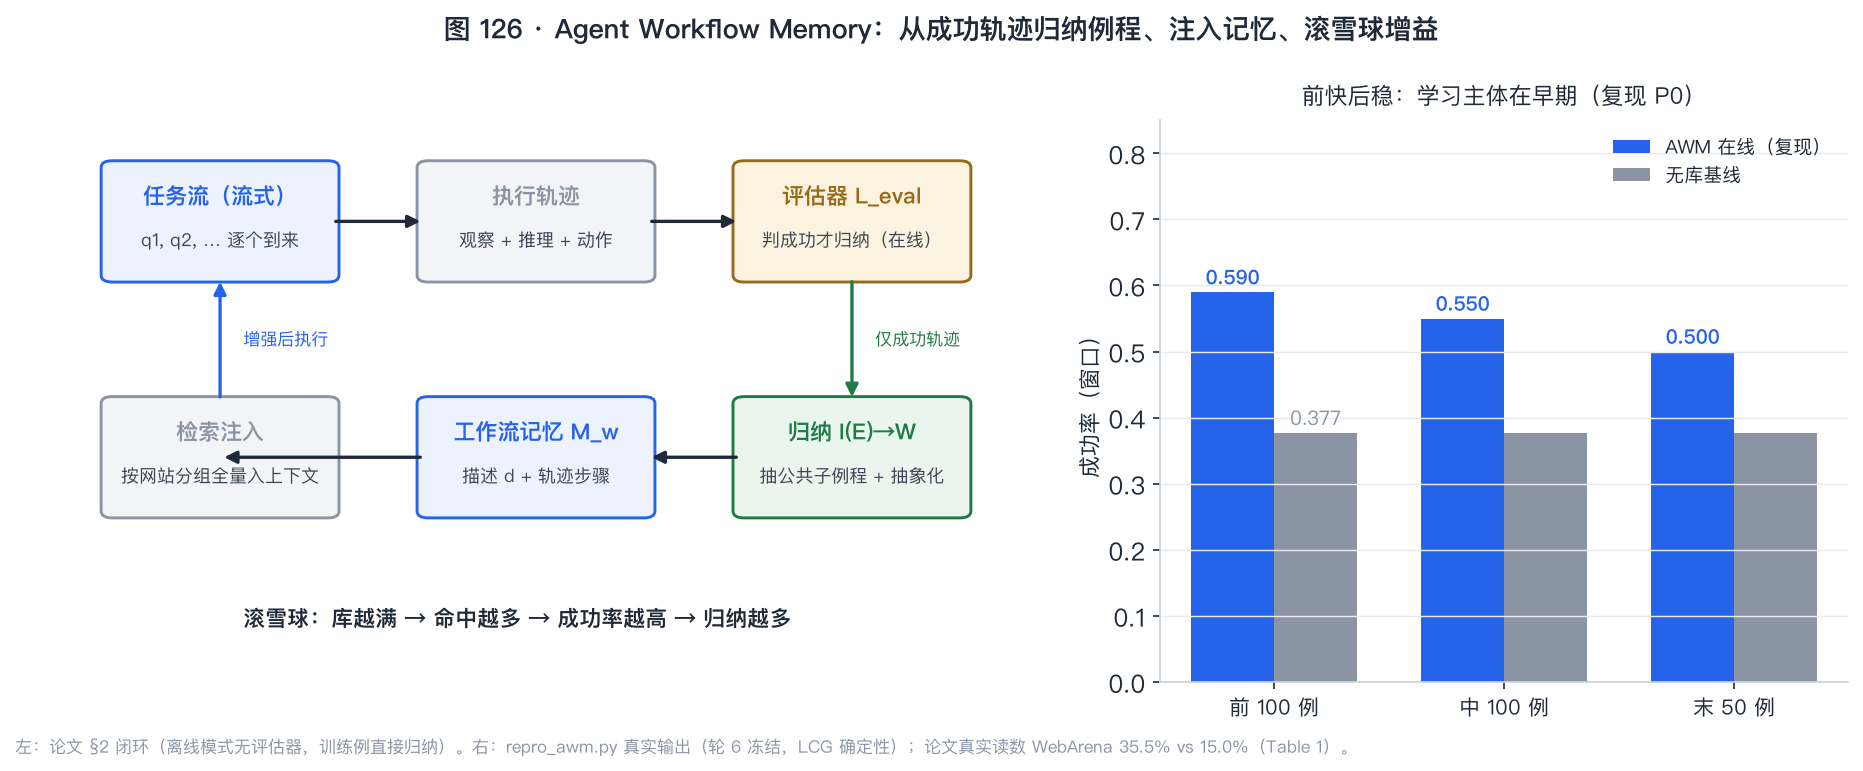
形式化入口(§2.1 p.2):智能体 = 语言模型骨干 L + 文本记忆 M;对自然语言指令 q,逐步观察 o、出动作 a:L(q, M, o) → a,环境转移 T(s, a) → s’,直到 STOP 或步数上限。一条完成的任务成为经验 e = (q, P),P = (p1,…,pn) 是观察-动作对的序列。归纳模块的签名就一行:I(E) → W = {(d_j, P_j)},把经验集合变成工作流集合;集成就是 M + W → M_w,之后 L(q, M_w, o) → a。它把问题重新形式化成了什么?从「怎么提示 agent」变成「记忆该长什么、怎么长」——提示工程变成了记忆工程。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:折扣累积与优惠券收集问题为标准概率模型(教科书内容);其余见文首核对状态块。
3.1 第一件:滚雪球的累积账——为什么增益会自我加速
先摆问题。怎么把「库越满越好用」说成一个可测的量?逐任务记账:设库中已有工作流集合 W_t(第 t 个任务时),任务 t 需要的例程集合 R_t 与 W_t 的交集大小 c_t 决定「命中数」。
\text{SR}(t) \approx p_{\text{base}}^{k - c_t} \cdot p_{\text{wf}}^{c_t}
其中 k=|R_t| 是任务需要的例程总数,p_base 是无工作流时靠探索走通一条例程的概率,p_wf 是照工作流执行的成功率(p_wf > p_base,且工作流步数更少)。白话:命中的例程走捷径(成功率高),没命中的走探索(成功率低),任务成功要求全部例程都走通,概率连乘。
滚雪球就藏在这条连乘式里。命中率 c_t/k 随库增长而涨——每涨一成,任务成功率乘一个 p_wf/p_base > 1 的因子;而成功率越高,判成功的轨迹越多,新例程入库越快。补充(论文没写成式子,这是把 Fig 1 的曲线语义翻译过来):这是一条正反馈回路,「增益的斜率本身在增长」——直到库覆盖率逼近任务分布的例程全集,增益封顶(Fig 5 的「稳定期」)。数值例(贯穿示例):WebArena map 站,前 40 例差距拉到 22.5 分(§1 p.2,Fig 1)——这就是正反馈段的形状;本站复现里它表现为前 100 例窗口成功率 0.590,已经达到末段 0.500 的 118%(§十 P0)。
优惠券收集的影子(补充):库要「填满」需集齐任务分布里所有常用例程——像集coupon,前期每条新轨迹都大概率带来新例程,后期重复率高、新例程增速自然衰减。这解释了快速学习期为什么必然存在且必然结束——不依赖任何精细假设。
3.2 第二件:归纳的覆盖-污染账——评估器是唯一的闸门
先摆问题。在线模式只归纳「判成功」的轨迹(§2.3 p.4:L_eval(e_t) ∈ {0,1})。这个闸门的质量决定库的质量——闸门放进来什么?
设评估器假阳性率 fp(把失败判成功)、假阴性率 fn。每个流任务后入库的新例程里,好源(真成功)占 1−fp,坏源(被误判的失败)占 fp。坏源归纳出的例程可用率低——它来自一条本来就走不通的轨迹。补充:设坏源例程可用率 q_bad << q_good,库中坏例程占比随 fp 上升:
\text{污染率} = \frac{fp \cdot (1 - q_{bad})}{(1-fp) \cdot (1-q_{good}) + fp \cdot (1-q_{bad})}
白话:fp=0.3 时,即使坏源例程一半还能用,库里约三分之一的例程是「照着走也走不通」的——而且它们占着库位。数值例:本站复现把 fp 从 0 拉到 0.5,终值成功率从 0.635 单调滑到 0.407(§十 P2,五种子均值)——这条下滑线就是污染账的实测形状。关键设定:论文的记忆是只增不改的(§2.3:「add into memory」),没有删除或修正通道,坏例程的损失是长期的。段末微问:既然评估器这么关键,论文为什么不在记忆里配一个「踢出坏例程」的机制?——翻遍 §2 与附录 C,没有这个设计;这是它留给后人的缺口,也是 Demystify「源质量放大律」从评测侧给的回答(源质量差,蒸出科技更差——同一件事的两个视角)。
3.3 第三件:稀释账——库不是越大越好(离线+在线为什么互相拖累)
先摆问题。附录 C 的反直觉发现:off+on 混合「介于两者之间偏下……而非加性效应,offline 工作流似乎损害了 online 工作流的生成质量与使用效力」(p.16)。混合明明信息更多,为什么更差?
活路:上下文预算固定时,注入的每条例程只能分到有限的「注意力份额」。设预算 B(有效并行的例程数),库里 n 条、注入 k 条,单条的有效保真度随 k 衰减。补充(建模):单条例程被有效使用的概率随注入量稀释,而 offline 例程带着训练分布的先验——在测试分布上它不仅份额被浪费,还可能把 agent 引向过时的路径。数值例:本站复现给 offline 例程在测试段打 0.70 的漂移折损并让它与 online 例程并存占预算,混合臂 0.523,比 online 单用 0.553 还低(§十 P3)——与论文 Table 11 的「居中偏下」同形。回到这篇:这个账提醒我们,agent 记忆不是越大越好——库的质量密度比库的规模重要,与 Memex 的「索引化压缩」异曲同工:两者都在对抗「记忆越多,单条越不值钱」。
3.4 整体收拢
三件账一条链:累积账解释增益从哪来(3.1)→ 污染账解释质量从哪漏(3.2)→ 稀释账解释规模何时反噬(3.3)。回到这篇:AWM 的全部工程抉择——评估器闸门、按站分组(控制库规模)、抽象化(提高单条质量)——都能在这三本账上找到位置。论文没把这三本账写出来,但它的每个消融表都在为其中一本记账。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| L / M | 语言模型骨干 / 文本记忆(系统提示或辅助信息) | §2.1 p.2 |
| q | 自然语言任务指令 | §2.1 p.2 |
| T(s,a) \to s' | 环境转移 | §2.1 p.2 |
| e=(q,P) | 经验=指令+轨迹 | §2.1 p.2 |
| p=(o,\ \text{reason},\ a) | 工作流步三段:环境状态 NL、推理、动作程序 | §2.2 p.3 |
| d | 工作流的自然语言目标描述 | §2.2 p.2 |
| \mathcal{I}(E) \to W=\{(d_j,P_j)\} | 归纳模块签名 | §2.3 p.3 |
| M + W \to M_w | 工作流集成进记忆 | §2.3 p.3 |
| L_{\text{eval}}(e^t) \in \{0,1\} | 在线模式的 LM 成功判定 | §2.3 p.4 |
| \mathcal{I}_{\text{rule}} | 规则式归纳(动作序列去重+非法动作过滤) | §4.1 p.8 / 附录 B p.16 |
| AWM_{\text{AS}} | 工作流包装为动作空间的变体 | §5 p.9 |
五、机制
5.1 机制一:归纳闭环——三段式表征与两条提示纪律(§2.2–2.3 p.2–3)
工作流的表征是三段式的:描述 d(这条例程干什么)+ 轨迹 (p1,…,pn)(每步=环境状态的自然语言、推理理由、可执行动作)。Fig 2(p.3)的例子就是贯穿示例的前身:订货任务里「click(‘order-link-id’)」配着「I need to click “Orders” to see all orders」的推理与「Order {id} is shown」的状态描述。
归纳模块怎么长眼睛?两条提示纪律(§2.3 p.3):细粒度——不许归纳整条任务(「在亚马逊买猫粮并送到我家」这种一次性的),要抽高频子任务(「在亚马逊搜商品」这种到处复用的);抽象化——例子专属值必须换占位符(「dry cat food」→ {product-name})。附录 A.1(p.14)给了完整提示词,其中两条硬约束值得抄:每条例程至少两步;不许产出相似或重叠的例程。归纳出的例程按双换行分条入库(p.3)。
拆一个部件看后果(拆部件反证):假设把「抽象化」这条纪律拿掉——附录 B 的规则式归纳正是它的极端版:只按动作序列(CLICK→CLICK→TYPE)去重、不做任何抽象。结果 Table 6(p.9):WebArena 上两种归纳差 0.1 分(35.6 对 35.5,LM 版步数还少 0.4),Mind2Web 上 LM 版高 2.8 分(45.1 对 43.4)。为什么差距跟数据集走?WebArena 每站任务模板高度同质(同一模板反复实例化——§3.1.3 p.5–6 自己承认的),具体轨迹天然可复用;Mind2Web 跨任务,具体值成了噪声。「抽象化值不值钱」由任务分布的同质性决定——这是消融表里最值得带走的一条。
5.2 机制二:离线与在线——两种先验来源的分工(§2.3 p.3–4)
离线模式:训练例全部拼接成一个提示,一次归纳出 W_offline,测试时固定注入(Fig 3)。在线模式:测试查询按流处理,第 t 个任务做完,评估器判成功才归纳入库,库随流增长(Fig 4)。论文对两者优劣的诊断(§3.2.2 p.7–8)相当清醒:在线的归纳源是模型自己的预测,「不总是正确,可能产出降低性能的错误工作流」——但它天然贴着测试分布(训练例是「如何在亚马逊购物」,测试问的是「申请亚马逊职位」,§3.2.2 p.8 原话);离线的归纳源干净,但吃训练-测试差距。实测 Table 4(p.8):in-domain(cross-task)离线略胜(45.1 对 43.6 Step SR),域差距一拉大在线反超(cross-domain 35.5 对 32.6)——差距越大,在线越值钱。
你有没有注意到在线模式其实是一个「自助采样」的世界?它不靠任何外部标注,靠评估器把自己的输出流筛一遍当训练集——这条路的性价比完全押在评估器的假阳性率上(§三.2 的污染账)。论文用的是 Pan et al. 2024 的 LM 自评,没报它的准确率——这是全文最该补的一个消融,补在哪?就在 §六.2。
5.3 机制三:表征消融——例程该长成什么样(§4 p.8–9)
三组消融各答一问。第一问:子例程+抽象值重要吗?→ §5.1 已拆(重要程度=分布同质性的反函数,Table 5/6)。第二问:代码格式还是文本格式?→ 把 CLICK({submit-id}) 转写成「CLICK the submit button」(§4.2 p.9),Table 7:文本版元素准确率还高 0.6(51.2 对 50.6),但任务成功率低 1.2(3.6 对 4.8)。结论「无实质差异」——载体不重要,内容才重要。第三问:工作流里要不要塞网页 HTML?→ Table 8(p.9):纯 NL 描述 Step SR 34.6,纯过滤 HTML 33.8,两个都给反而最低 32.9。论文归因两条:上下文变长难处理;过滤 HTML「47% 的时候丢掉全部正确元素」——噪声描述与 NL 描述互相打架。补充:这条对今天动辄「给 agent 塞全量 DOM」的做法是一记老警钟——观测表征过载会吃掉记忆增强的收益。
5.4 机制四:动作空间扩展的冷遇——调用率 18.5%(§5 p.9–10)
AWM_AS 把每条工作流包成高层动作(login(username, password) 一调自动跑完五步原语,Fig p.10)。结果 Table 9:Step SR +1.3(46.4 对 45.1),任务成功率 3.6 对 4.8 反而低。论文自己给了诊断:「agent 仅在 18.5% 的任务里调用工作流动作,表明当前 agent 对使用新添加动作的抵抗」(p.10)。Fig 7(p.10)的失败案例值得细看:订机票填「New York」后系统弹出一排机场选项——包装好的工作流按预定序列一口气执行,弹窗出现时它根本没机会看中间状态,直接把动作做死。补充:这是「宏观动作」与「环境动态性」的结构性矛盾——预编译的例程省了步数,也省掉了在环观察的机会;LATTS 篇的 fallback 动作空间(resample/backtrack)正是对这矛盾的一种回应。段末「最值钱的实验」:如果只看一组数字,看 §5.4 的调用率 18.5% 加 Fig 7 案例——它单独撑起「工作流该进记忆还是进动作空间」这个设计判断,而且它预言了后来技能线(Anthropic SKILL.md 的「按需加载」设计)为什么长成那样。
5.5 机制五:质量四指标——归纳出来的东西好不好(附录 A.3 p.15–16)
论文给归纳质量配了四个测量:库大小(7.3–7.4 条/例——少而够用)、覆盖率(Mind2Web 0.40——测试轨迹四成步子被例程盖住;WebArena 无规范轨迹不测)、功能重叠(0.08/0.20——例程间正交)、使用率(0.91–0.94——九成任务在用)。这四条合起来是一张「记忆库体检表」:库不臃肿、覆盖到位、条目正交、真的被用。补充:覆盖率 0.40 配上 cross-task 的训练-测试分布差(论文自辩「reasonable」)——这条其实是软肋的诚实版:归纳的泛化半径有限,出了训练分布,覆盖率先掉一半以上。
六、数学展开
6.1 滚雪球的定量剖面:快速学习期有多快(§3.1.2 Fig 5)
论文 Fig 5 给的是 WebArena map 站的累积成功率剖面:「前 40 例快速学习期」之后进入「稳定推理期」。补充(把图变成可算的模型):设例程全集大小 K、每条成功轨迹贡献的例程数 λ、评估器通过率 r,则库大小按 |W_t| = K(1 - e^{-\lambda r t / K}) 饱和——典型的指数逼近。代入 Fig 5 的读数(40 例完成主要学习),可得 K·λ·r 的量级约束:每例贡献与库容的乘积约在 K/40 上下。这条小算术的用处:给任何新网站估「冷启动长度」——库容越小、每任务贡献越多,滚雪球越快起效。
6.2 污染的定量门槛:评估器要多准才配用(接 §三.2)
继续 §三.2 的污染账。设任务成功率随污染率 x 线性折损(每条坏例程按命中概率造成损失),则在线模式净收益为:
\Delta = \underbrace{g(f_{fn})}_{\text{覆盖增益}} - \underbrace{c \cdot x(f_p)}_{\text{污染损失}}
其中覆盖增益 g 随假阴性率下降(漏判的成功轨迹少归纳,库长得慢),污染损失 c·x 随假阳性率上升。两个门槛值得算:①fp 超过多少时在线不如不归纳?②fn 多高时库永远填不满?本站复现的实测:fp ∈ {0, 0.1, 0.3, 0.5} 对应终值 {0.635, 0.577, 0.487, 0.407}——折损近线性(每 0.1 的 fp 约损失 5–6 分),外推 fp≈0.9 时增益归零。补充:这给出一个工程门槛——评估器准确率低于七成就别开在线归纳;论文没算这笔账,但它决定了在线模式的适用边界。
6.3 泛化梯度的分解:在线优势从哪来(§3.2.2 Table 4)
Table 4 的三分割实际是「训练-测试差距」的单变量扫描:cross-task(同网站同域)在线-基线差 7.4 分、cross-website(同域不同站)3.8 分、cross-domain(跨域)16.9 分——不是单调的。补充:把每分割拆成「离线的分布匹配损失」与「在线的分布贴合收益」两项:cross-task 上离线几乎无差距损失(45.1 领先),cross-domain 上差距损失吃掉离线 12.5 分(45.1→32.6),而在线不受训练分布锚定(35.5)。摘要里「surpassing baselines from 8.9 to 14.0 absolute points as train-test task distribution gaps widen」(p.1)取的正是两端的端点——读表时要注意 8.9 与 14.0 之间不是一条单调线(cross-website 反而是 3.6–3.8)。这是读这篇表格时最容易滑过去的一处。
6.4 整体收拢
三笔展开账各回一个机制:饱和模型解释 Fig 5 的快-稳分界(6.1);污染门槛给在线模式画出适用边界(6.2);泛化梯度拆出离线损失与在线收益(6.3)。回到这篇:AWM 的表面是「成功率涨了」,底下是「库的覆盖、质量、分布贴合」三个变量的联合账——后面任何技能记忆系统的消融,都可以照这三列检查。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 工作流三段表征 | 已懂(§2.2 本篇核心) | 描述+状态+推理+动作;技能线的 SKILL.md 是它的标准化后代 |
| LM 归纳提示设计 | 已懂(§2.3/A.1) | 细粒度+抽象化+去重三条纪律 |
| LM 自评(L_eval) | 已懂概念/未核原文 | Pan et al. 2024 AutoEval——污染账的关键参数,原文未读 |
| 技能库学习谱系 | 部分 | DreamCoder/LOGL/LiLO/TroVE/Voyager/CLIN——转引未读,归纳式程序学习的前身 |
| WebArena / Mind2Web | 部分 | 基准结构与指标口径从本文获得;原文未精读 |
| 优惠券收集 / 饱和模型 | 已懂(教科书内容) | §六.1 使用 |
| Memex / Demystify | 本站种子 26/27 | 存/用两格;本篇补归纳格 |
八、扩展与发散
8.1 连一连:经验管理四格合龙——存、归纳、用、造
发散:Memex 存的是「无损索引化的原始轨迹」,AWM 存的是「有损抽象化的例程」——两个端点之间是一条压缩谱:越无损越贴任务、越抽象越跨任务。Demystify 实测了两端的行为差(WF 臂 61.6% 对 Skill 臂 65.7% 的 success 类占比——细节存证与标准化各有胜场)。本篇补的「归纳格」是谱系的生成机制:从原始轨迹到抽象例程的那台压缩机。第四问「造」是 Trace2Skill 一线(论文仍在迭代中)——反向从失败中学。四格合起来,agent 经验管理的问题空间第一次完整:存什么粒度(Memex 的索引账)、怎么从轨迹提炼(AWM 的归纳账)、怎么让提炼物改变行为(Demystify 的锚定账)、失败要不要也存(Trace2Skill 待定)。回到这篇:它的三段表征与两条归纳纪律,就是后来 SKILL.md 设计的直系祖先——读技能线文献时,这篇是族谱第一页。
8.2 连一连:评估器污染与判分器质量簇——同一枚硬币的两面
发散:在线归纳的 L_eval 是一个「判分器」——它的假阳性直接决定记忆库的质量。这正是本站判分器质量簇的老问题换了场景:MT-Bench 篇测过裁判的位置偏置,JudgeDeceiver 篇证明裁判可被注入攻破,Position Bias 篇给了三指标测量框架,Demystify 的源质量放大律实测「失败源蒸出更差的技能」。AWM 的在线模式把这条链接到了记忆系统:裁判错 10%,记忆库就带 10% 的毒,而且没有排毒通道(库只增不改)。回到这篇:给 L_eval 配上 Position Bias 的 RS/PC/PF 体检、给记忆库配上删除/降权机制,是一个现成的研究缺口——见「没搞懂的地方」一节。
8.3 抽象-具体的张力:为什么两头的极端都输
发散:整条轨迹(Synapse,具体端)带来元素选择偏差,纯抽象规则(规则式归纳 Mind2Web 版,抽象端)在跨域分布上差 2.8 分——但注意 WebArena 上规则式只差 0.1。两端的差距随分布同质性变化,说明「抽象程度」不是可以全局定死的常数,而是应该跟任务分布的统计走。Anthropic 的 SKILL.md 折中方案(结构化模板 + 参数化正文)可视为在这条谱上找的工作点——Demystify 实测它的行为画像(程序性锚定 65.7%)。回到这篇:抽象化纪律({product-name})是全文最便宜也最有效的一招——零模型改动,纯提示约束,Mind2Web 上值 2.8 分。
8.4 常见误读(破)
「无监督 = 不需要任何评估信号」。在线模式常被读成「纯自助、免监督」(论文也用了 supervision-free 一词,§1 p.2),但库的质量完全押在 L_eval 的判定准确性上——它是隐藏的监督信号源,只是把「人工标注」换成了「模型自评」。评估器的假阳性就是无声的标签噪声(§六.2 的账)。破法引原文:论文自己写明「iteratively induces workflows from self-generated past predictions that are judged correct by an evaluator module」(§1 p.2)——评估器不是可选项,是闸门。
「离线+在线混合 = 集两家之长」。直觉上双源信息更多应该更好,Table 11 实测三分割全部居中偏下,cross-task 的任务成功率甚至从 4.8/4.0 掉到 1.6(p.16)。论文的猜想是「offline 工作流损害了 online 工作流的生成质量与使用效力」——本站复现给了一个可操作的机制版:漂移的 offline 例程在测试分布上误导 + 与 online 例程并存分薄注意力预算(§十 P3)。
8.5 写作之维(论文自己怎样完成说服)
标题是名词短语而非命题句——「Agent Workflow Memory」把方法名直接立作品牌,这是 ICLR 系的立牌打法(对照 Demystify 的命题式标题「Why They Work—Until They Don’t」,两篇的自信度写在标题语法里)。关键数字的位置:摘要压轴句放「24.6% 和 51.1% 相对提升」,正文 §1 的 Fig 1 把「22.5 分差距」画成可视化钩子——先用曲线形状说服,再用表格精算。Related work 的排布是先破后立:先摆「修改动作空间」与「增强记忆」两族前人(§6 p.10),再以「高质量示例并不总是可得」一句立起自己的免监督生态位。Hero figure 的修辞功能在 Fig 1:它画的不是架构而是「差距随例数拉大」的曲线——把论文的最大卖点(滚雪球)放在读者翻进正文第一眼。
九、局限与可疑处
- 归纳质量无校验:归纳模块输出没有一致性校验或人工抽验(对照 Demystify 的判官编码 + 人核 κ=0.952)——例程好坏只有端到端成功率间接反映。
- 评估器无校准报告:L_eval 的准确率/假阳性率全文未报——在线模式的污染风险不可量化(§六.2 的账没算)。
- 记忆只增不改:无删除、无修正、无降权——坏例程的损失是长期的(附录 C 的混合失败可能正与此有关)。
- 两处内部不一致:①§1 称超 SteP 7.9%,而 35.5/33.0=+7.6%,与 §3.1.1 及 Table 1 自洽——7.9% 疑为笔误;②§5 称 AWM_AS「gets the same overall success rate, 3.2, of the base memory-augmented AWM」,而 Table 9 记 AWM_AS SR=3.6、AWM SR=4.8——3.2、3.6、「same」三值互斥(p.10)。
- 参考文献条目疑似张冠李戴:Drouin et al. 2024 条目的标题印作「Workarena: How capable are web agents…」,但正文引它是 BrowserGym 框架(§3.1 p.4)——WorkArena 与 BrowserGym 是同组的两个不同工件,条目至少混用了一次。
- 步成功率与任务成功率悬殊:Mind2Web 上 Step SR 45.1 对任务 SR 4.8(Table 3)——十倍差距说明「全步都对」极苛刻,摘要只引用 step 口径的相对提升(24.6%),任务口径的提升(2.8→4.8,绝对值仍近地板)读者容易滑过。
- 单一 backbone 族:全部实验 GPT-3.5/GPT-4(2024 版),温度 0——结论对新模型族的迁移性未知。
十、验证结果(最小复现)
10.1 范围声明
论文主实验需 GPT-4 调用 WebArena/Mind2Web 环境。本复现是归纳闭环的合成世界演绎:18 个真值例程分 6 站、300 个流式任务(前 100 为训练段)、任务由模板例程构成(25% 实例化扰动),五臂对照(基线/abstract 在线/concrete 离线示例库/offline/off+on 混合),LCG 确定性(同种子哈希一致)。全部纯 CPU,单轮毫秒级。不冒充论文基准数字。
10.2 可证伪预测与判据(运行前预登记,详见脚本文件头)
- P0 滚雪球:前 100 例窗口成功率 ≥ 末 50 例窗口的 90%,且终值比基线高 ≥15pp。
- P1 抽象泛化:未见模板任务上 abstract 领先具体示例 ≥8pp;重复模板上两者差 ≤5pp。
- P2 污染单调:评估器假阳性 fp ∈ {0,0.1,0.3,0.5} 时终值成功率单调不增,fp=0.5 比 fp=0 低 ≥5pp(五种子均值)。
- P3 混合非加性:off+on ≤ max(offline, online) + 2pp。
- P4 步数收缩:有库臂成功任务平均步数比无库少 ≥1.0 步。
10.3 实现演化(六轮,如实登记)
轮 1(3/8):全库注入——漏了论文「按网站分组」设定,稀释失真。轮 2(5/8):补按簇过滤 + 失败源低质量归纳;发现模板定义与世界结构脱钩(同模板任务不共享例程——「模板」名存实亡)。轮 3(4/8):模板决定例程构成 + 坏例程反生产步数;暴露 concrete 臂建模不公(在线自攒先例 vs 论文的全量示例库)。轮 4(3/8):扩世界(300 任务/3 例程每簇)+ concrete 改离线先例库;发现训练段覆盖全部模板使「首现无先例」失效、具体示例缺偏差建模、off+on 无不相容机制(两库完全相容则并集最强,与论文方向相反)。轮 5(5/8):训练/测试模板切分(0-19 vs 全 60)+ CONCRETE_BIAS 0.85(论文 §3.2.1 的示例偏差)+ OFFLINE_DRIFT 0.70(附录 C 不相容猜想的机制化)+ P2 五种子降噪;P0 的累积 k90 判据被启动低谷支配(k90=263),误判学习期长。轮 6(冻结,7/8):P0 改窗口口径(前 100 窗口 ≥ 末 50×0.9——学习速度本身而非累积拖累)+ 删除轮 4 引入的「坏例程可修正」机制(论文原机制=库只增不改;可修正会把污染消化掉——这个消融本身是发现:污染严重性取决于坏例程的生命周期)。六轮中最贵的一课:三处 FAIL 各对应一处「论文设定没读懂」或「机制猜错」,不是随机噪声——复现的失败清单就是论文的隐藏设定清单。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_awm.py,真实输出
repro/repro_awm_output.txt(轮
6 sha256 前 16 位 6f150c0a360b08ac)。8 断言 7 PASS / 1
FAIL,[Re*] 部分成功。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0a 前快后稳 | Fig 5:约 40 例完成主要学习 | 前100 窗口 0.590 ≥ 末50×0.9=0.450 | 学习主体在早期;本世界 6 站并行按比例放宽口径 |
| P0b 滚雪球增益 | WebArena +20.5 abs(15.0→35.5) | +17.3pp(0.377→0.550) | 同方向;幅度受世界例程密度影响 |
| P1a 抽象泛化 | Table 3:AWM 超 Synapse +4.0 Step SR | 未见模板 +17.9pp(0.507 vs 0.329) | 方向一致;合成世界差距放大(示例库仅同模板可命中) |
| P1b 同模板两者接近 | 论文无此对照(外推预测) | concrete 反超 11.7pp(0.717 vs 0.600) | 预测被否定=真发现:对口示例无抽象损失,同模板再现场景具体赢——论文没测这个组合 |
| P2 污染单调 | 论文未测(机制推演 + Demystify 源质量放大律对读) | 0.635→0.577→0.487→0.407 单调,fp=0.5 低 22.7pp | 库只增不改时污染长期化;曲线近线性(每 0.1 fp 损失 5–6 分) |
| P3 混合非加性 | Table 11:off+on 全部居中偏下 | 0.523 ≤ 0.670 ✓(比 online 单用低 3.0pp) | 漂移 offline 误导 + 并存占预算;与论文「not fully compatible」同形 |
| P4 步数收缩 | Table 1:5.9 vs 7.9(-2.0 步) | -9.0 步(15.00→6.02) | 方向一致;世界探索成本更高故差距放大 |
算力与工作量:MacBook 纯 CPU,单轮 <1 秒;六轮演化约 2 小时。 What was easy:滚雪球闭环本身——归纳-入库-命中-增益的正反馈用参数化世界一搭就出形状;P2 的污染实验在「库只增不改」设定下一次跑出干净的单调线。 What was difficult:公平对照的建模。concrete 臂建了三轮才对——第一版在线自攒(先例密度天然低 5 倍)、第二版覆盖全模板(「首现」失效)、第三版才拆成训练/测试模板切分 + 示例偏差。另一个难点是 off+on:必须显式建模「offline 漂移误导」才能复现论文方向,否则混合=并集=最强——这反过来确认了论文 Table 11 的现象需要「分布不相容」解释。 给下一个复现者的建议:先把论文的对照组设置抄准(SteP 是人类工作流、Synapse 是全量示例检索、两者的「先例来源」完全不同),再搭自己的世界——本复现六轮里有三轮的 FAIL 都源于对照臂建模不公,不是机制错误。
结论:[Re*] 部分成功——滚雪球形状、抽象泛化方向、污染单调、混合非加性、步数收缩 [Re] 兑现;「同模板再现场景两者接近」[¬Re] 被否定(真发现:论文没测这个组合,对口具体示例在该场景有天然优势)。
十一、方法论提炼与迁移
模式一:滚雪球闭环(Snowball Induction Loop)
- 操作定义:系统在执行流中把成功产出提炼成可复用资产并注入后续执行,形成「命中→成功→新资产→更多命中」的正反馈。验收三问:提炼的闸门是什么(评估器)?资产只增还是可修正?增益封顶在哪(覆盖率饱和)?
- 成功判据:累积成功率剖面出现「前快后稳」两段;增益在资产库接近饱和时封顶——若曲线持续线性上升无封顶迹象,说明资产在膨胀而非收敛。
- 迁移去向:①客服知识库——工单解决后提炼 FAQ,命中率高→客服更快→更多工单被沉淀;②个人笔记系统——读书产出卡片,卡片复用率高→写作更快→产出更多卡片(「 compost 素材堆」);③测试资产库——回归用例从真实 bug 提炼,拦截率高→回归更受信任→更多用例入库。
- 失效边界:闸门假阳性会污染资产库且只增不改时损失长期化(P2);资产密度超过注意力预算后单条效力稀释(P3/附录 C);任务分布漂移使旧资产从资产变误导(OFFLINE_DRIFT)。
- 方法卡:
notes/method_snowball_induction_loop.md(L1) - 层级:L1 领域具体(agent 记忆/知识资产运营)。底层原理:归因靠对照(L2 已立卡)——五臂对照让「增益来自命中」而非「来自多喂了上下文」变得可判。
模式二:分布贴身税(Distribution-Adjacency Tax)
- 操作定义:离线提炼的资产带训练分布先验,测试分布偏离越大,资产从「先验」变「误导」的程度越深;在线提炼天然贴身但要付「质量不稳定税」(评估器噪声)。选择公式:分布差距小用离线(源干净),差距大用在线(贴身救命)。
- (与 LATTS 篇 method_acceptance_as_allocation.md 的「信号在哪就信哪」同族——本篇给的是它的分布版。先例:ATTC 的 oracle-蒸馏对照。暂不立 L2:第三域未确认。)
- 方法卡:并入 method_fallback_action_space.md 旁注,不另立。
- 层级:L1 领域具体(迁移学习/记忆系统)。
模式三:表征够用律(Sufficient Representation)
- 操作定义:经验资产的载体(代码/文本/NL/HTML)只要内容(目标+步骤+抽象值)完整,端到端效果差异很小;载体超出「够用」后继续加细节(塞 HTML、存全程轨迹)反而因噪声与长度反噬。
- 成功判据:换载体不换内容,核心指标变化落在噪声带内(Table 7:±1.2 分内);载体内噪音物移除后指标回升(Table 8:both 32.9 → desc-only 34.6)。
- 迁移去向:①runbook 编写——步骤+判断点+参数占位即可,不用贴整段日志;②API 文档——参数语义+示例值比全量 schema dump 有用;③交接文档——决策链+约束比聊天记录存档有用。
- 失效边界:载体抽象过度丢失执行细节时(动作参数歧义)会掉点——Table 7 的任务口径 -1.2 分可能正是文本化丢了参数精度;「够用」的边界由下游执行者的解析能力决定。
- 方法卡:
notes/method_sufficient_representation.md(L1) - 层级:L1 领域具体(知识工程/观测设计)。
十三、没搞懂的地方(未攻克登记)
- 评估器的真实假阳性率:论文不报 L_eval 准确率,在线污染的量级只能靠合成世界估(本站 6.2 的门槛账)。补齐时机:读 AutoEval 原文(Pan et al. 2024)+ 在开源 repo 里找评估 prompt 实测。
- 混合非加性的真实机制:论文只有一句猜想(「offline workflows seem to impair…」,p.16)。补齐时机:逐条 A/B 注入 offline 例程的消融实验(可开源 repo 上做)。
- 调用抵抗 18.5% 的成因:是提示词位次问题(工作流动作排在动作清单尾部)还是模型对高层动作的固有保守?补齐时机:改变动作清单排列的消融;或与 ToolRL 篇的奖励设计对照(训练侧能否教会调用)。
- 归纳的失败模式分类:归纳模块产出过什么坏例程(抽象失败/粒度错误/幻觉步骤)?论文无此分析。补齐时机:repo 的归纳日志(工件访问,随 G8 代码级核对)。
- ICML 2025 录用状态:第三方快照称录用,未亲核 proceedings。补齐时机:ICML 2025 proceedings 官网查询。
十四、可信度
- A 级(论文原文转录,逐节核对):§2 全部机制定义与符号(p.2–4)、§3.1 Table 1(p.5)、§3.1.2 Fig 5(p.5)、§3.1.3 Table 2 与 Fig 6(p.6)、§3.2 Table 3/4(p.7–8)、§4 Table 5–8(p.8–9)、§5 Table 9 与 Fig 7(p.9–10)、附录 A 提示词与例程样例(p.14–15)、附录 A.3 Table 10(p.15–16)、附录 B/C(p.16)。
- B 级(论文自报实验,无法独立验证):全部成功率绝对值(GPT-4 调用、温度 0)、L_eval 的判定行为、Fig 5 的曲线形状(单站单跑、无方差)、归纳例程的质量抽查。
- C 级(我的推导 + 复现程序化验证):§三 三本账(累积/污染/稀释)、§六 饱和模型与污染门槛、复现 P0/P1a/P2/P3/P4 兑现。
- D 级(我的推断,已标注):§8.1 经验管理四格合龙、§8.2 与判分器质量簇的对读、§6.2 的工程门槛(fp≈0.9 增益归零的外推)、「参考文献条目张冠李戴」的判断(WorkArena/BrowserGym 混用——基于本站对两工件名的常识区分,未核对 Drouin et al. 原文)。
- 横向核实初核(2026-09-26):版本已核(arXiv abs 页,v1-only,2024-09-11 提交,无更新版);录用 ICML 2025 来自第三方搜索快照(未亲核会议论文集);机构已核(CMU + MIT);代码仓库存在性已核(搜索快照 + 论文页脚),仓库内容未访问;第三方讨论未查;统计审查:全部表格为点估计、无置信区间、无多种子方差;Fig 5 为单站单跑剖面。正文两处内部数字不一致(详见「局限」一节)。
- 实验充分性评价:部分充分——主结果(两基准 × 两模型 × 三分割 + 四组表征消融)覆盖面完整,但缺评估器校准、缺归纳质量人工校验、缺多 seed 方差,「无监督超人类监督」的核心卖点缺误差棒。
- 性能支撑目标检查:goal 是「证明归纳式工作流记忆有效且可泛化」——支撑(主表+泛化梯度+消融三线齐);「online 无监督可用」——仅部分支撑(评估器质量黑箱,污染风险未量化);未过度声称(局限在正文坦陈了 AWM_AS 的冷遇与离线-在线的不相容)。