外行导读(先读这个,再决定要不要进正文)
一个场景:你运营一个 answering 服务,每道题可以只答一次,也可以采样 16 份投票(self-consistency)——后者更准但贵 16 倍。预算只够平均每题答 2 次。怎么分?均匀分配(每题都答 2 次)是现在所有系统的默认:简单的题浪费 1 次,难题 2 次又不够。这篇论文的答案:把”哪些题配多少算力”写成一个带预算约束的优化问题,用拉格朗日对偶解出每道题的最优预算,再让一个小分类器学会这套分配规则——同样的钱,MATH 准确率高 5-6 个百分点。
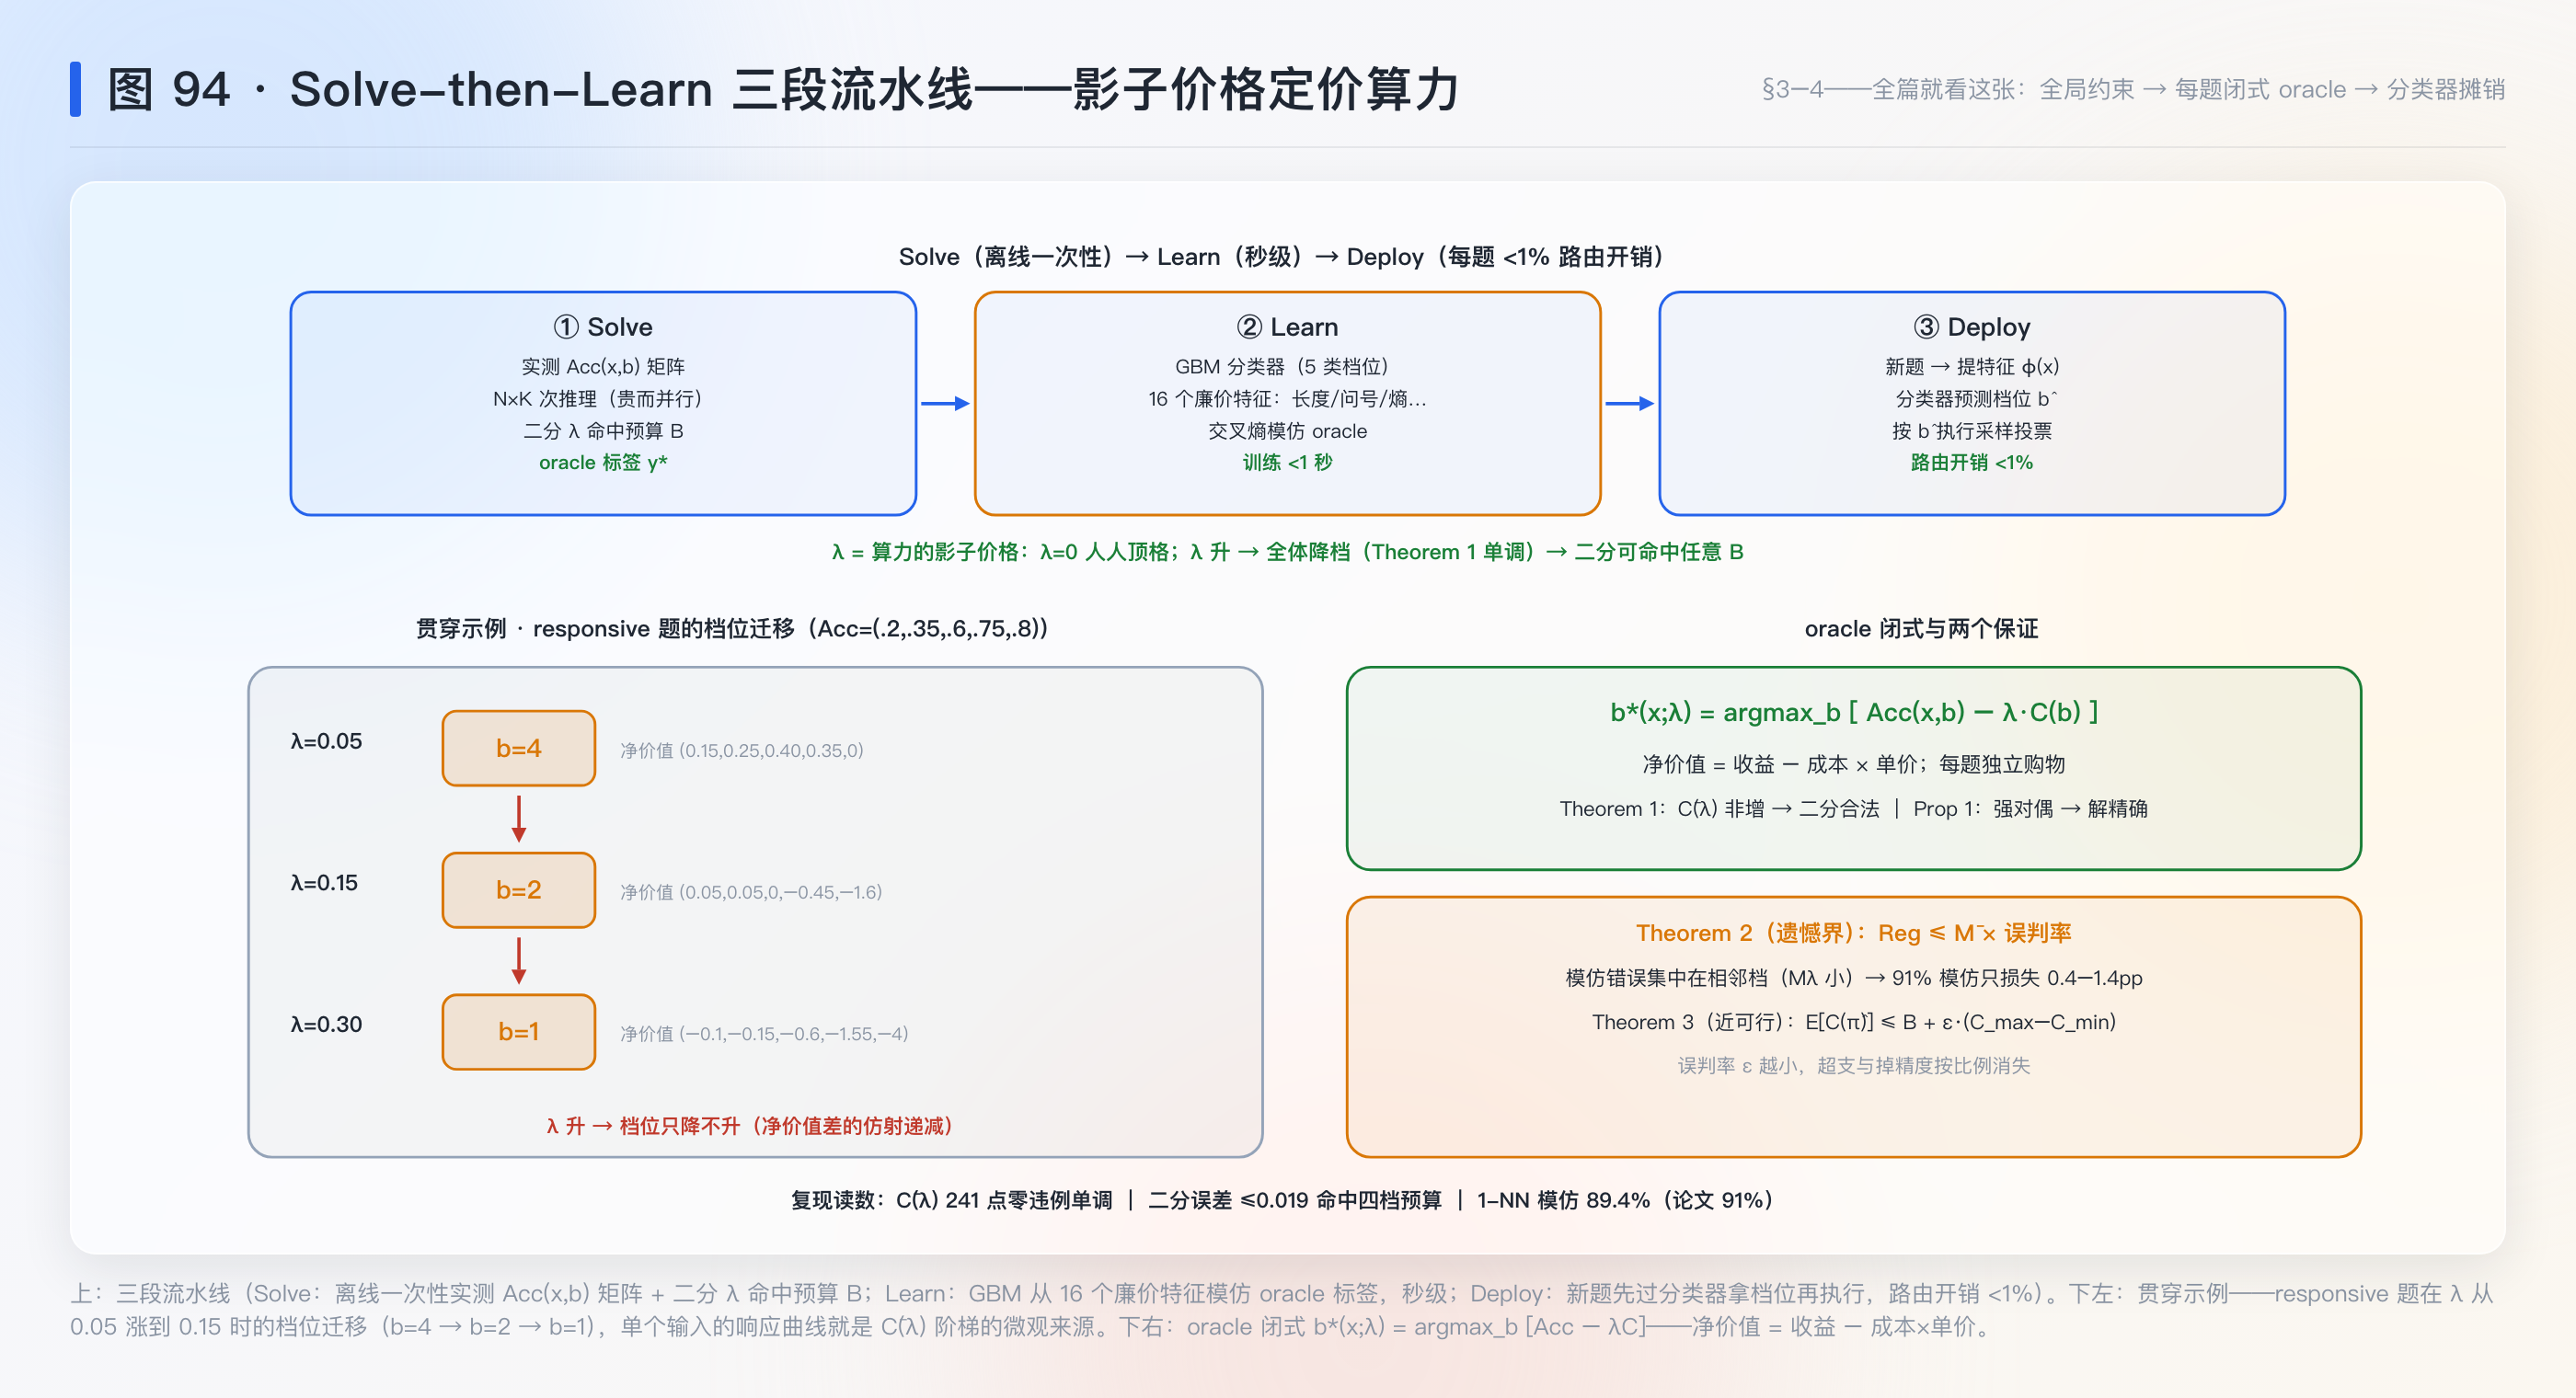
这篇论文干的事:三步(Solve-then-Learn)。①Solve(离线一次性):对每道题、每个预算档实测准确率,得到 Acc(x,b) 矩阵;给预算约束挂一个拉格朗日乘子 λ——λ 就是算力的”影子价格”,每道题独立选净价值最大(Acc − λ·Cost)的预算档;证明平均成本 C̄(λ) 对 λ 单调递减,于是二分搜索能精确命中任何目标预算。②Learn(秒级):训练一个 GBM 分类器从 16 个廉价特征(长度、问号数、单遍熵……)预测 oracle 的预算选择。③Deploy:新题来了先过分类器拿预算档再执行,路由开销 <1%。理论上:模仿遗憾 ≤ 模仿误差 × 最坏逐实例差距(Theorem 2),分类器越准,超预算与掉精度都按比例消失(Theorem 3)。
为什么值得关心:这是执行侧”停止规则”缺口的另一半。昨天的 IAL 管部署前”这条路径能不能停”(可行性),今天这篇管运行时”预算内停在哪个档最优”(最优性)——两篇合起来,STOP 节点(verify-retry 最优停止)的静态侧与动态侧都有了论文锚点。方法本身是教科书数学(拉格朗日对偶 + 单调性 + 二分)在 LLM 推理上的一次干净落地——它的价值不在新数学,在于第一个把这个问题形式化并对偶分解到可精确求解。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| Test-time scaling | 测试时扩算:采样多份投票、树搜索、加长推理——花钱买准确率 |
| 预算约束(式 2) | 平均成本 ≤ B:全批次共享的钱包 |
| 影子价格 λ | 算力的单价:拉格朗日乘子,λ 越大算力越贵,oracle 越抠 |
| Oracle b*(x;λ) | 每题的闭式最优档:argmax_b [Acc(x,b) − λC(b)] |
| C̄(λ) 单调性 | 影子价格越高全体越省——Theorem 1,二分搜索的资格证 |
| 强对偶(Prop 1) | 对偶上界 = 原始最优:oracle 分配就是精确解,不是近似 |
| 摊销(amortize) | 把离线算出来的分配规则压进一个小分类器,线上免查表 |
| 遗憾界(Theorem 2) | 学出来的策略最多差多少 = 模仿误差 × 最坏逐实例差距 |
| GBM | 梯度提升树:论文选的分类器(16 个廉价文本特征) |
| Fixed-b / Heuristic | 基线:人人同一档 / 按题面长度当难度代理 |
§0 承接栏
这颗种子补的是”停止规则”的另一半:上一篇(IAL)回答了部署前”这条路径能不能停”,本篇回答运行时”预算内停在哪个档最优”——预算即边界,λ 即边界的定价。测试时算力分配从此是一条独立的支线。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.1–2:为一道题生成 N 份回答做多数投票,成本线性翻 N 倍;但很多题一遍就对。预算有限(API 成本、GPU、延迟),标准做法是人人同档——uniform budget。浪费是双向的:简单题白花,难题不够。论文 Fig 1(p.2)画了四道真实 MATH 题的精度-预算曲线:easy(b=1 就对)、responsive(随 b 陡升)、diminishing(早饱和)、hard(恒低)。事后诸葛亮都知道:easy 给 b=1、responsive 堆高预算、hard 别浪费。挑战是在看到结果之前逼近这个 oracle。
1.2 为什么这个问题有结构(§2 p.3)
式 (2):max E[Acc(x,π(x))] s.t. E[C(π(x))] ≤ B。论文指出三难(§2 p.3):①Acc 是黑箱(只能跑模型估);②决策变量是函数(π: X→B,不是一个数);③全局耦合——预算约束把所有输入拴在同一个钱包上,各题独立最大化是非法的。第三难是全文的引擎:如果预算不耦合,每题独立选自己最划算的档就行;耦合之后,一道题多花的钱是别的题的损失——需要一个全局的稀缺性信号。这个信号就是影子价格 λ。
1.3 与簇内入口差
DAPO 篇的超长软罚 ramp 是”长度预算”的雏形(惩罚随超长递增——一个隐式的 λ);LC 篇的截断攻击说明预算参数会被博弈(预算是攻击面);T11 篇的优化器把预算花在训练侧。本篇把”预算”从隐式惩罚提升为显式约束、从训练侧搬到推理侧。与 IAL 的对位见 §六.3。
二、核心想法
一句话:给算力定一个价(λ),每道题独立地”按价购物”(选净价值最大的档),λ 由全批次的钱包反解出来(单调性保证二分可命中),然后把这套购物规则压进一个小分类器。
直觉先打底。机场行李托运:每人免费额度共享(全局约束),超重费单价 = λ。旅客各自决定带几件行李——单价高时大家少带,单价低时多带。机场的运营方调单价直到总重量恰好等于运力:这就是二分搜索 λ。每个旅客的决策规则(净价值 = 满意度 − 重量×单价)就是 oracle b*(x;λ)。最后你想雇一个前台(分类器)看一眼旅客就猜他该带几件——猜错的代价被 Theorem 2 界住。
全篇就看这张:图 94(§5.2)——Solve-then-Learn 三段流水线,从 Acc 矩阵到线上路由。
先猜一个数:学出来的分类器模仿 oracle 的精度是 91%——那任务准确率(真正关心的数)离 oracle 差多远?提示:模仿错 9% 不代表丢 9% 的准确率。答案:只差 0.4–1.4pp(§5.4 p.7)——因为模仿错误往往落在”相邻档”上,而相邻档的准确率差距很小,这正是 Theorem 2 的 Mλ 加权的含义:错得多的档位差距大、错得少的档位差距小。
落到与 DAPO 的对读:DAPO 的超长软罚是”每个 token 的边际价格随长度上升”——一个隐式的、对全局预算不精确的 λ;本篇的 λ 是显式的、可二分命中任意预算的。补丁与制度的差别。
三、数学基础(零起点,本篇新用到的两件;发明式讲法)
3.1 第一件:影子价格定价——全局约束怎么拆成每题独立决策
先摆问题。预算耦合所有题:一道题多花一块钱,别处就少一块钱。怎么把”大家一起省”变成”每题各自算”?
候选方案摆出来,让不合格的先死:
- 方案 A:每题独立选准确率最高的档(无视预算)。 死于:总成本 = C(b_max),超预算,不可行——耦合被无视。
- 方案 B:每题配固定预算 b = B。 死于:这就是 uniform baseline——简单题浪费、难题挨饿(Table 1 p.6:Fixed-b 全线垫底)。
- 方案 C:给预算约束挂一个乘子 λ,把”花别人的钱”内化成”花自己的钱”——每题独立最大化净价值 Acc(x,b) − λC(b)。 λ 是稀缺性的化身:λ=0 时算力免费、人人顶格;λ 升高、档位整体下移、最先降档的是边际增益最小的题。全局一致性由 λ 统一:不存在”你的钱和我的钱不一样贵”。
约束列出:①每题决策只需自己的 Acc 曲线与 λ;②λ 有一个值使总成本恰好命中 B;③该分配是原问题的精确解。满足三条的构造:
b^\star(x;\lambda) := \arg\max_{b\in\mathcal{B}}\big[\mathrm{Acc}(x,b) - \lambda\,C(b)\big]
其中 λ ≥ 0 是拉格朗日乘子(式 5,p.3)。逐符号:Acc(x,b) 是题 x 在档 b 的期望准确率;C(b) 是档位的资源成本(本文 C(b)=b);λ 是算力单价。白话:净价值 = 收益 − 成本×单价,每题选净价值最大的档。
名字最后给:论文叫 oracle allocation(Definition 1 p.3)——它是”事后全知”的最优分配,也是学习阶段的老师。
为什么这个分解是合法的:拉格朗日函数(式 4)
\mathcal{L}(\pi,\lambda) = \frac{1}{N}\sum_i\big[\mathrm{Acc}(x_i,\pi(x_i)) - \lambda C(\pi(x_i))\big] + \lambda B
对 π 求最大时,λB 是常数、和式逐项独立——argmax 可以穿过求和号,全局问题裂成 N 个一维问题。这是对偶分解的标准力量:耦合约束的”全局性”全部收进一个标量 λ。
数值例(贯穿示例):responsive 题 x,Acc = (0.2, 0.35, 0.6, 0.75, 0.8),C = (1,2,4,8,16)。λ=0.05:净价值 = (0.15, 0.25, 0.40, 0.35, 0.00) → 选 b=4。λ=0.15:净价值 = (0.05, 0.05, 0.00, −0.45, −1.60) → 降到 b=1 或 2(并列时取定规则)。λ 从 0.05 升到 0.15,这道题从 b=4 降到 b=2——单个输入对影子价格的响应曲线,就是全批次 C̄(λ) 阶梯的微观来源。
节末钩子:每题的响应曲线有了,但 λ 该取多少?答案需要 C̄(λ) 的一个性质——单调。
3.2 第二件:成本单调性——为什么二分搜索是合法的
先摆问题。二分搜索要求:目标函数对搜索变量单调。C̄(λ) = 每题 oracle 档的平均成本。凭什么它对 λ 单调?
直觉版:λ 涨 = 算力涨价,没有任何一道题会因此换到更贵的档——涨价只会让人省。形式化(Theorem 1 p.4,证明在附录 B):比较同一题的两个档 b、b′(设 C(b) > C(b′)),净价值差
f_\lambda(x,b) - f_\lambda(x,b') = \big[\mathrm{Acc}(x,b)-\mathrm{Acc}(x,b')\big] - \lambda\big[C(b)-C(b')\big]
是 λ 的仿射函数且斜率为负(因为 C(b)−C(b′) > 0)。λ 增大 → 贵档的净价值优势单调缩水 → 一旦跌破零就永久反转 → 每题的 oracle 档位只降不升 → 平均成本 C̄(λ) 非增。(有限预算集上的并列需要确定性的破平局规则——论文 Theorem 1 的精确表述带这个前提。)
配对性质是强对偶(Proposition 1 p.4):经验问题(3)是”N 个离散变量 + 一条耦合约束”的有限程序,对偶间隙为零——\hat{V}(B) = \min_{\lambda\ge 0} G(\lambda)。白话:影子价格体系不只给出一个近似,它给出的分配就是精确最优。这是二分出来的解敢叫”oracle”的资格证。
代价与复杂度(§3.2 p.4):求一次 C̄(λ) 只需每题对 K 个档取 argmax——O(NK);二分收敛要 O(log(1/ε)) 轮。整个 Solve 段的一次命中不到一秒(Fig 3 p.5:binary search <1s)——贵的是 Acc 矩阵本身的 N×K 次模型调用,但那是离线一次性且可并行的。
节末钩子:oracle 有了、λ 可命中了——但每道新题都去实测 Acc 矩阵就回到了”全知”依赖。最后一步:把 oracle 的判断变成可以看一眼就猜的。
3.3 第三件:遗憾界——模仿误差怎么换算成任务损失
学出来的分类器 π̂ 会犯错。错一道题损失多少?Theorem 2(p.6):定义 Mλ(x) 为题 x 处 oracle 与次优档的净价值差距(最坏档距),则
\mathrm{Reg}_\lambda(\hat\pi)\;\le\;\mathbb{E}\big[M_\lambda(x)\cdot\mathbb{1}[\hat\pi(x)\ne\pi^\star_\lambda(x)]\big]\;\le\;\bar M\cdot P(\hat\pi(x)\ne\pi^\star_\lambda(x))
白话:任务层面的遗憾 ≤ 最坏差距 × 误判率。两个推论:①模仿是安全的——每提高一点模仿精度,任务损失按比例下降;②错误不均匀等价——把 responsive 题错到相邻档损失小(Mλ 小),错到 b=1 损失大(Mλ 大)。这解释了实验里 91% 模仿精度只损失 0.4–1.4pp 的”不对称换算”(§5.4 p.7)。Theorem 3(p.6)补上可行性:学得的策略平均成本 ≤ B + ε(C_max − C_min)——误判率 ε 越小,超支上界越紧。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| \mathcal{B}=\{b_1,\dots,b_K\} | 离散预算集(本文 {1,2,4,8,16}) | §2 p.3 |
| C(b) | 成本函数(本文 C(b)=b) | §2 p.3 |
| \mathrm{Acc}(x,b) | 输入 x 在档 b 的期望任务效用 | §2 p.3 |
| \pi:\mathcal{X}\to\mathcal{B} | 预算分配策略(函数式决策变量) | §2 p.3 |
| V(B),\ \hat V(B) | 总体/经验约束最优值 | 式 (2)(3) |
| \lambda,\ \lambda_B | 影子价格 / 命中预算 B 的对偶变量 | §3 |
| b^\star(x;\lambda) | oracle 分配(闭式) | 式 (5) |
| \bar C(\lambda) | oracle 平均成本(对 λ 非增) | 式 (6) |
| G(\lambda) | 对偶函数:maxπ L(π,λ) | §3.3 |
| M_\lambda(x),\ \bar M | 最坏逐实例差距 / 其上确界 | Theorem 2 |
| \hat\pi,\ \varepsilon | 学得分类器 / 模仿误判率 | §4.4 |
五、机制
5.1 机制一:Solve 段——Acc 矩阵与 oracle 标签(§3,Fig 3 p.5)
【类比 · 行李托运】 离线阶段机场做两件事:实测每位常旅客带不同件数的”满意度”(Acc 矩阵),再调一个单价 λ 使总重量恰好等于运力(二分)。之后每个旅客的最优件数就定了(oracle 标签)。
实现(Algorithm 1 p.6 Stage 1):对每题 × 每档跑推理记录准确率——N×K 次调用是全管线最贵的一步(§4.3 p.5:embarrassingly parallel、离线一次)。Acc 的估计协议(§5.1 p.6):每题采 48 响应,按预算 b 切成 ⌊48/b⌋ 个不重叠窗口,窗口内多数投票、跨窗平均——不重叠窗口避免样本复用造成的准确率高估。然后二分 λ 命中 B,发 oracle 标签 y_i^\star。
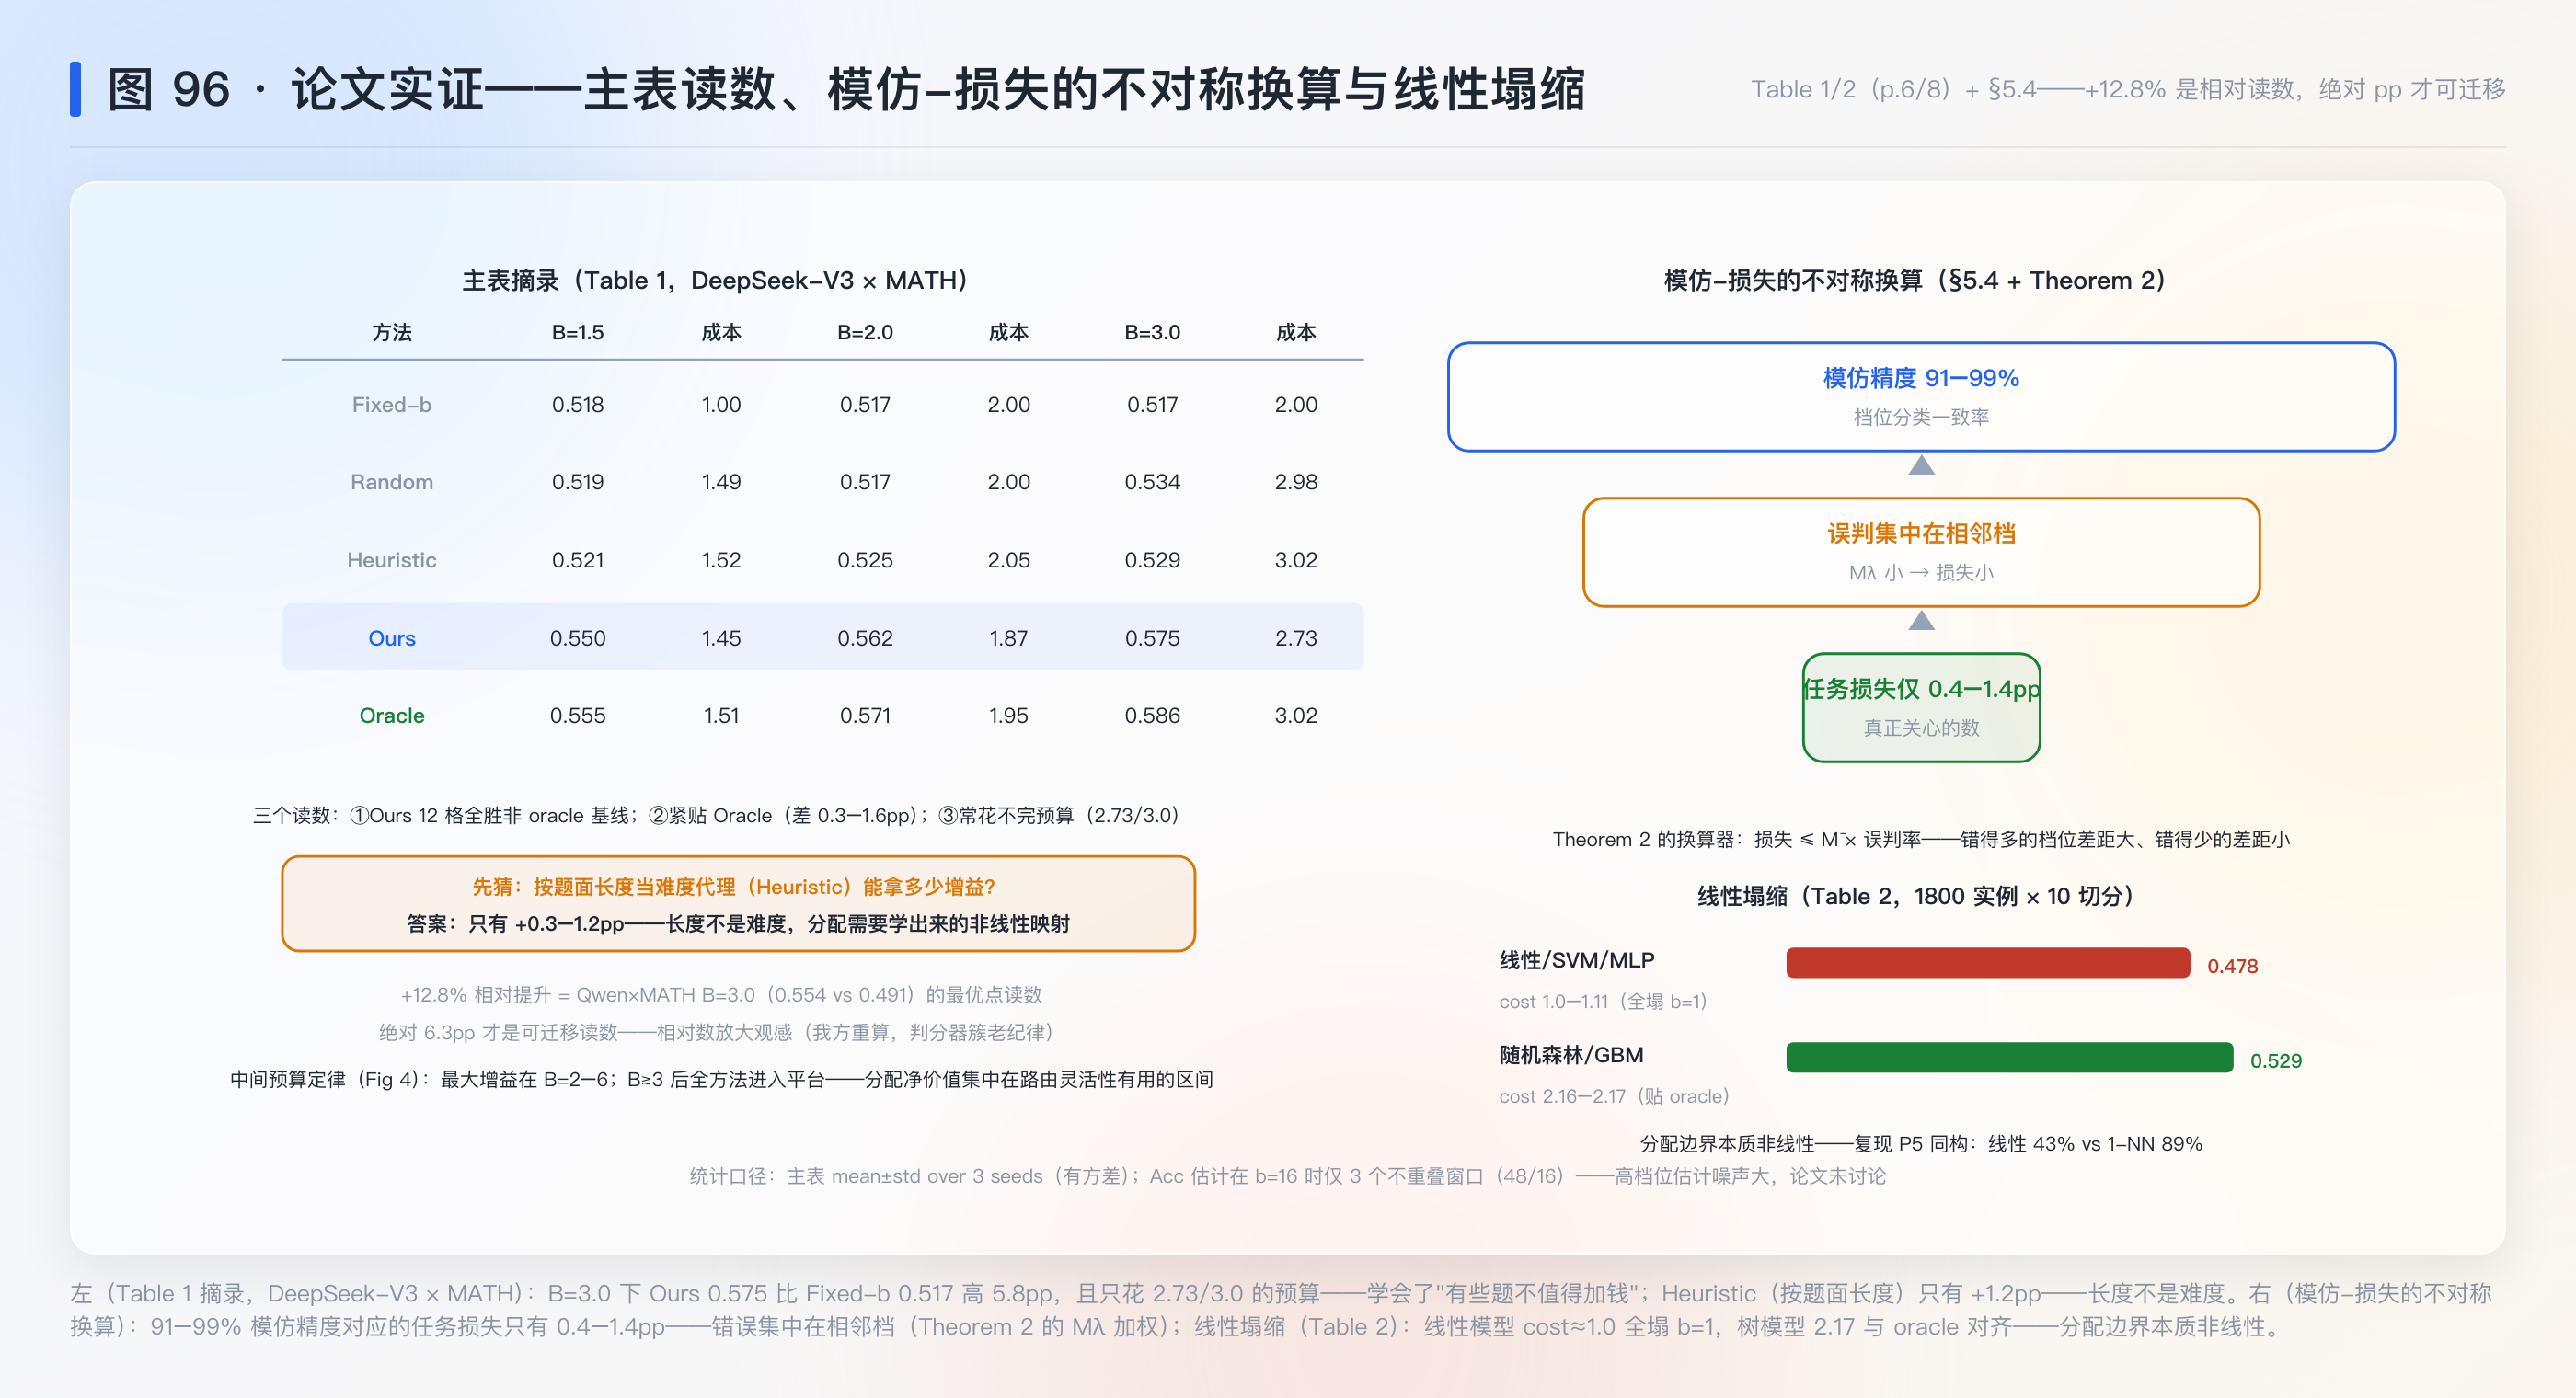
最值钱的实验:Table 1(p.6)——四种方法 × 四个模型-数据集组合 × 三档预算。三个读数:①Ours 全部 12 格超过所有非 oracle 基线(B=3.0 的 MATH 上比 Fixed-b 高 5.8/5.2/6.4pp);②Ours 紧贴 Oracle(差距 0.3–1.6pp);③学得策略常常花不完预算(DeepSeek×MATH B=3.0 只花 2.73)——它学会了”有些题不值得加钱”。先猜第二个数:按题面长度当难度代理的 Heuristic 基线能拿到多少增益?答案:只有 +0.3–1.2pp(§5.2 p.7)——长度不是难度,分配需要学出来的非线性映射,这正是 §5.5 树模型胜过线性模型的伏笔。
5.2 机制二:Pareto 前沿与中间预算定律(§5.3 p.7,Fig 4)
全预算网格 B∈[1,16] 扫出的 Pareto 前沿给出四条 pattern:①Ours 全域支配所有基线;②最大相对增益出现在中间预算 B=2–6——路由灵活性只有在”既不能全给也不能全不给”的区间才有用武之地(B<1.5 时预算太紧只能全 b=1,B>8 时人人大档差异被抹平);③B≳3 后所有方法进入平台——额外的钱买不动 easy 与 hard;④Fixed-b 呈阶梯状——它只能在预算集的离散档位上取值。
补充(连接旧账):③的”平台”与 Large Language Monkeys 一系的覆盖-饱和曲线一致(论文引 [13])——分配方法的天花板由精度曲线的形状决定,分配只负责不浪费。这划定了方法的适用域:曲线平坦的工作负载上,任何分配器都无钱可省。
5.3 机制三:分类器消融——线性为什么塌到 b=1(§5.5 p.8,Table 2)
五个分类器在同一池化数据(1800 实例、10 次随机切分)上对决:GBM 与随机森林任务精度 0.529,线性/MLP/SVM 只有 0.478——差 5pp。最能说明问题的是平均实现成本:线性模型 cost≈1.0–1.11(几乎全塌到 b=1),树模型 cost≈2.16–2.17(与 oracle 的成本分布对齐)。诊断读法:分配边界本质非线性——“哪道题值得加钱”不是特征的线性函数,线性模型学不出加钱的方向,于是退化为保守的 b=1。复现 P5 在合成世界重演了这一塌缩(线性 43% vs 1-NN 89%,cost 1.42 vs 1.88)。
5.4 机制四:分配模式的倒 U(§5.6 p.8–9,Fig 5)
oracle 的分配按 MATH 难度分层呈倒 U:easy 与 intractable 都拿 b=1,高预算集中在中等难度。白话:太容易的题加钱是浪费,太难的钱打水漂,只有”多想一步就能对”的题值得堆样本。学得的 GBM 忠实复刻了这个结构(Fig 5 上下两行几乎一致)。复现 P6 在合成世界兑现(easy=1.00 / responsive=4.15 / hard=1.00)。
5.5 机制五:与 oracle gap 的残余账(§5.4 p.7)
91–99% 模仿精度、0.4–1.4pp 任务差距——残差来自两个源:①误判落在相邻档(Mλ 小,Theorem 2 的加权);②特征信息量有限(16 个文本统计量 + 单遍熵,不含”题目语义难度”的完整信号)。论文 Limitations 自认:“the gap highlights the need for richer, yet still cheap, difficulty signals”(p.9)。
六、数学展开
6.1 接 §三 3.2:单调性证明的完整走法(Theorem 1)
零起点走一遍。固定题 x、两档 b > b′。净价值差
f_\lambda(x,b)-f_\lambda(x,b') = \underbrace{\big[\mathrm{Acc}(x,b)-\mathrm{Acc}(x,b')\big]}_{\text{与 }\lambda\text{ 无关}} - \lambda\,\underbrace{\big[C(b)-C(b')\big]}_{>0}
是 λ 的仿射函数、斜率 = −(C(b)−C(b′)) < 0。λ 增大时差值严格递减:存在阈值 λ*(差值过零点),λ < λ* 时 oracle 选贵档 b,λ > λ* 时选便宜档 b′。每对档位的翻转点唯一且单向 → 每题的档位轨迹对 λ 单调非增 → 有限和 C̄(λ) 非增(并列时取确定性破平局规则)。推导所用规则:①仿射函数的单调性由斜率符号决定;②逐点单调 ⇒ 有限平均单调;③argmax 对参数的单调比较原理(伴性阈值/parametric choice 的标准引理)。
数值例(贯穿示例续):responsive 题的 b=4 vs b=2 翻转点:Acc 差 = 0.25,C 差 = 2 → λ* = 0.125。λ < 0.125 选 b=4,λ > 0.125 选 b=2。二分搜索在 λ 轴上找的就是这些翻转点夹出的、使 C̄(λ) 恰好跨过 B 的那个区间。
6.2 遗憾界的两行推导(Theorem 2)
对任意 π̂,逐题比较它与 oracle 的净价值:
J_\lambda(\pi^\star_\lambda) - J_\lambda(\hat\pi) = \mathbb{E}\big[f_\lambda(x,\pi^\star_\lambda(x)) - f_\lambda(x,\hat\pi(x))\big]
oracle 是逐题 argmax → 括号内 ≥ 0;且 ≤ Mλ(x)(差距被最坏档距封顶)。当 π̂ 猜对时括号 = 0 → 差值 = Mλ(x)·1[猜错]。取期望、放缩 Mλ ≤ M̄ 即得式 (9)。推导所用规则:①argmax 定义(oracle 逐题不劣于任何策略含 π̂);②指示函数拆期望;③逐点界取上确界。补充:Corollary 1(附录 B)把松弛遗憾进一步拆成精度差 + λ×成本差——当学得策略的成本贴近 oracle 时,精度差被模仿误差完全控制。这就是”约束推理归约为监督分类”这句话的准确含义。
6.3 与 IAL 的 STOP 对:可行性与最优性合龙(连一连)
发散:昨日 IAL 回答”路径有没有边界的覆盖”(存在性判定,部署前静态),本篇回答”边界设在哪个档位最优”(连续最优,离线求解+线上路由)。两条合起来是一个完整的停止规则生命周期:先证明能停(IAL 的覆盖判定),再决定怎么停(本篇的影子价格分配)。接口上,本篇的预算 B 就是一条 IAL 意义下的确定性边界(max-turns 的精化版——不是”最多几步”而是”平均几步、按题分配”);IAL 的控制器分类学里,本篇的 oracle 属于 deterministic 守卫,而”让模型自己决定想几遍”恰是它打击的 model-controlled 退出。回到这篇:推理预算的治理与 agent 循环的治理是同一门课的两个章节。
6.4 两个我方重算(标注:我的重算,非原文结论)
①+12.8% 的相对提升读数:摘要的”up to 12.8% relative”对应 Qwen×MATH B=3.0(0.554 vs 0.491)——绝对 6.3pp。相对数放大了观感,绝对 pp 才是可迁移读数(判分器质量簇的老纪律:还原分子分母再读)。②中间预算定律的边界:B>8 后各方法差距收窄到 ~1pp(Fig 4)——分配方法的净价值集中在 B∈[2,6];部署建议应当带这个适用域,否则”用了 AdaCompute”在 B=16 的工作负载上读不出差异。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| 拉格朗日对偶 / 强对偶 | 已懂(§三/§六.1 机制层;附录 C 证明未逐行核) | 影子价格、对偶分解;LP 顶点论证为论文转述 |
| self-consistency / 多数投票 | 已懂(MB 篇审计过其偏置;本篇用作载体) | 非重叠窗口协议防样本复用高估 |
| test-time scaling 谱系 | 部分 | LLM Monkeys/Snell et al./Wu et al. 等为论文转述(引 [13,15,16]),未读 |
| Bandits with knapsacks | 待补 | 论文引 [42]——预算约束序贯决策的经典;本篇是其”离线全信息”退化版 |
| 输入自适应分配先行者 | 待补 | Damani et al. ICLR 2025(引 [36],Learning how hard to think)——与本篇最近的先行作,对照读 |
| 路由线(RouteLLM/HybridLLM) | 待补 | 分配的近亲:选模型而非选档(引 [30,32,33]) |
八、扩展与发散
8.1 执行侧四颗的合力(01/02/18/19)
发散:LH/SA 给”状态与验证”(架构),IAL 给”停得了”(可行性),本篇给”停得好”(最优性)。四颗合成一条 harness 治理线:任务进状态 → 事实经验证 → 循环有界 → 边界定价。剩下没覆盖的是动态反馈——预算执行中途的在线重判(本篇是开环:路由在执行前一次性决定;LATTS 的逐步接受准则是闭环候选)。回到这篇:开环分配 + 闭环接受是两个正交的升级方向,STOP 节点的合成笔记里应作为轴写明。
8.2 连一连:影子价格的三次现身
发散:λ 这个标量在簇内已是第三次出现——DAPO 的超长软罚(长度边际价格,隐式、不可二分)、T11 优化器的学习率(步长的价格,训练侧)、本篇的算力单价(推理侧)。共同骨架:任何”稀缺资源上的逐项独立决策 + 全局总量约束”都会逼出一个影子价格;治理该系统 = 定价该资源。回到这篇:下一个可定价的是 agent 循环里的工具调用(每次 search 的价格随当日配额浮动——预算治理从”设定上限”进化为”动态定价”)。
8.3 分配器的博弈面(与判分器线的暗线)
发散:LC 篇证明预算参数会被博弈(截断攻击)。本篇的分配器同样有博弈面:参赛者若知道”长题面拿高预算”,就把题面写长(Heuristic 基线的机制变成攻击向量);若知道”单遍熵低拿低预算”,就生成低熵的复读。判分器质量簇的 gameability 方法卡直接适用:任何基于可观测特征的分配规则,都是可优化对象的规格书。防御方向:特征中保留不可见信号(论文的单遍熵比长度难操纵一步)。回到这篇:分配公平性与分配鲁棒性是下一篇论文的空格。
8.4 常见误读(破)
误读一:“91% 模仿精度 = 91% 的效果保住了。” 破:两个百分比度量不同层。91% 是档位分类一致率;任务准确率损失只有 0.4–1.4pp——因为错误集中在相邻档(Mλ 小)。反过来也不能推出”模仿精度不重要”:如果把 responsive 题错到 b=1(非相邻、Mλ 大),损失会远超 1.4pp。Theorem 2 的 Mλ 加权才是两层之间的换算器。
误读二:“这方法能省 6 倍算力。” 破:等预算对比(都是 B=3.0)下高 5-6pp——省的是”同样钱买更多准确率”,不是”同样准确率花更少钱”的 6 倍。省钱读数要看 Fig 4 的等精度横截面:Fixed-b 要达到 Ours 在 B=2 的精度大约需要 B≈8(DeepSeek×MATH)——这是 ~4× 的成本读数,且只在曲线陡峭的题群上成立。
误读三:“Acc 矩阵的离线成本是小代价。” 破:N×K 次全量推理是”一次性”但不是”小”——200 题 × 5 档 × 48 响应 = 48,000 次生成。换工作负载(分布漂移)要重测;论文 Limitations 自认需要在线自适应(p.9)。静态 Acc 矩阵 + 动态真实分布之间有保质期(30 天保鲜纪律适用)。
8.5 写作之维(论文怎样完成说服)
标题的四段式:Adaptive(卖点)+ Test-Time Compute Allocation(领域)+ for Reasoning LLMs(对象)+ via Constrained Policy Optimization(方法)——方法学入题、无处废话。摘要的骨架是”形式化 → 两阶段 → 两个定理 → 一个数字”:先立问题的合法身份(“a decision that current systems largely ignore”),再给解法与保证,最后 12.8% 收尾。正文的结构纪律:三难(§2)→ 每难一个回应(耦合→对偶分解、黑箱→离线实测、函数变量→摊销)——问题特征的清单与贡献清单一一咬合,这是运筹学应用文的标准骨架,执行度极高。Fig 3 的三栏流水线图(Solve/Learn/Deploy 各一栏、数据流从左到右)一图说完方法——先猜读数(猜论文)的两个钩子都埋在正文段而非图里。诚实标注:定理的证明全部推到附录(正文只留陈述+直觉),主文 9 页装下完整闭环。整体收拢:这是一篇”老数学新对象”的应用文,说服力全部来自形式的干净——每个工程决定(离散档位、离线矩阵、GBM)都有一个定理或消融背书。
九、局限与可疑处
- 离线 Acc 矩阵的保质期:N×K 次全量推理昂贵且随模型/分布漂移过期;论文自认需要在线 oracle 自适应(p.9)——但没做。
- 预算离散:档位集 {1,2,4,8,16} 是离散的;连续预算(CoT 长度)未覆盖(p.9 自认)。
- 特征信息量:16 个文本统计量 + 单遍熵——oracle gap 的残差全卡在这里;更强廉价信号(如 first-token confidence)未探索。
- 统计口径:主表 mean±std over 3 seeds(有方差,好评);但 +12.8% 是最优点相对读数;Acc 估计在 b=16 时只有 3 个不重叠窗口(48/16)——高档位估计噪声大,oracle 标签在高档位可能不稳(§5.1 协议推算,论文未讨论)。
- v1-only + Preprint:2026-04-16 提交无 v2、无录用标注;工件仓库存在性本日未访问(登记)。
- 单轮约束:只约束平均成本一个标量;延迟/吞吐的多目标(p.9 自认)未做。
十、验证结果(最小复现)
10.1 范围声明
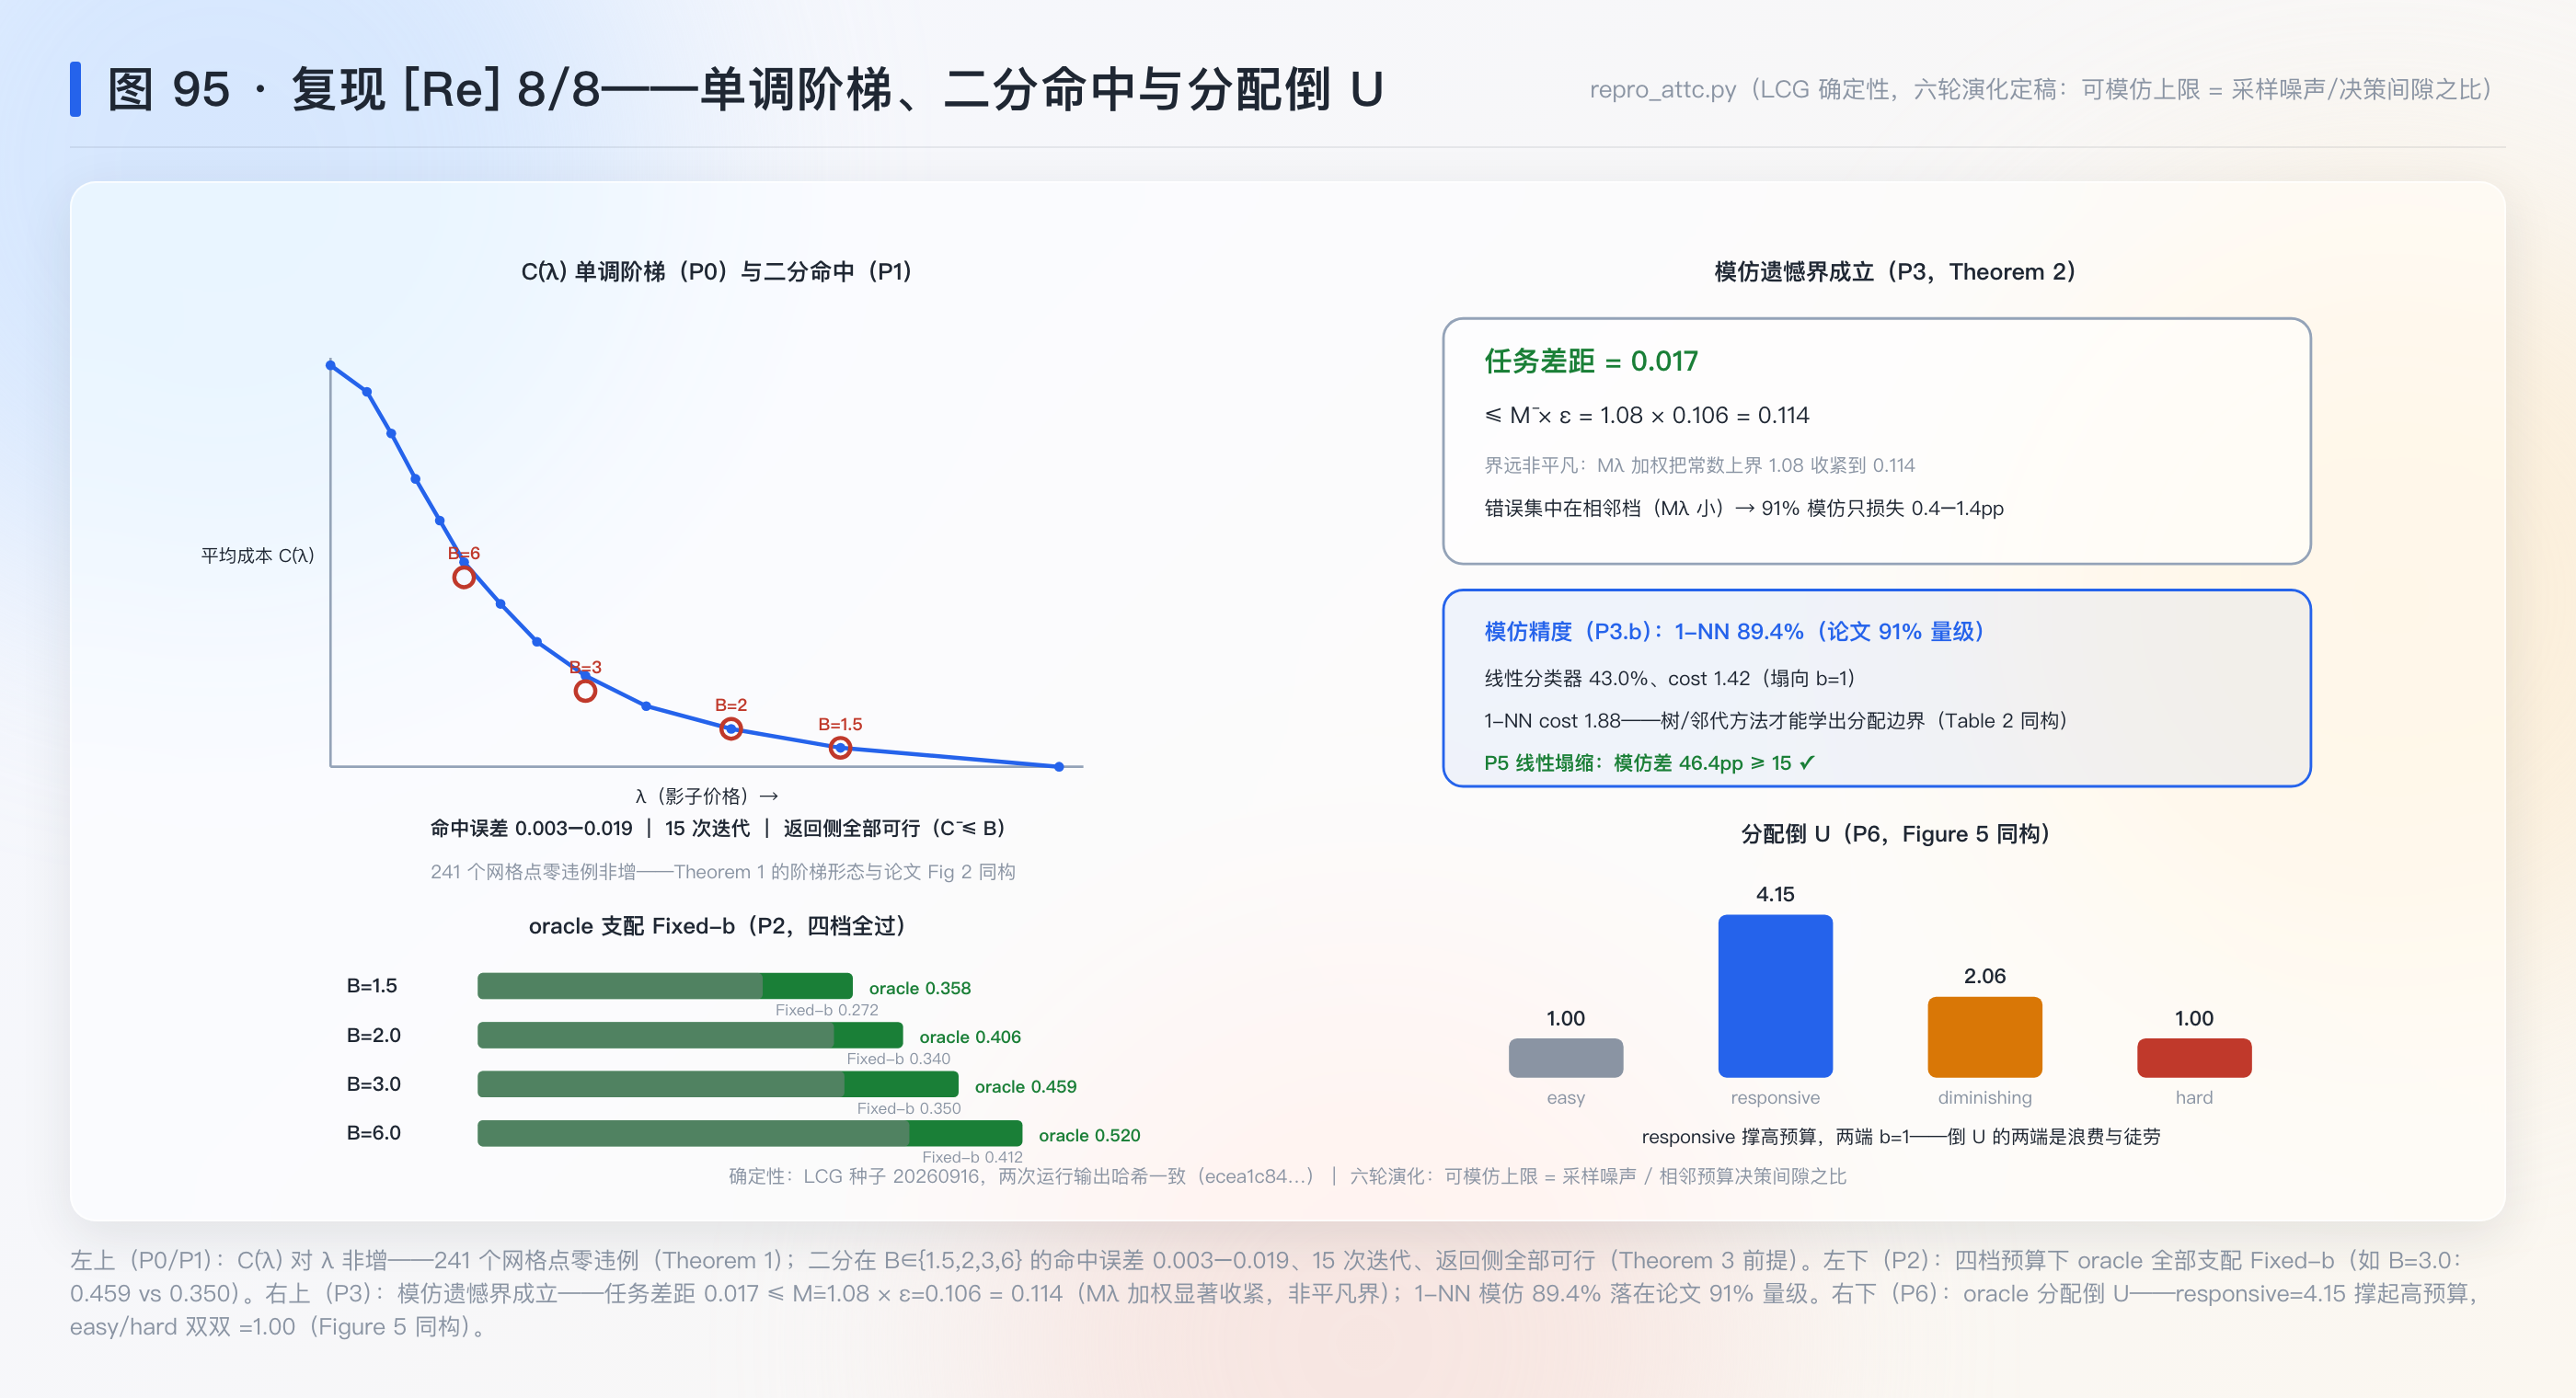
论文主实验要 3 个 LLM × 400 题 × 5 档 × 48 响应的真实推理,不可纯 CPU 复现。本复现是机制演绎:合成世界里按论文 Fig 1 的四类精度曲线生成 Acc(x,b) 矩阵,重演 Solve 段(oracle + 单调性 + 二分)与 Learn 段(分类器模仿),对照四个定理与两个实证模式。全部纯 CPU、LCG 确定性(两次运行输出哈希一致:ecea1c84…)。
10.2 可证伪预测与判据(运行前写下;预登记量级)
- P0 成本单调性(Theorem 1):细网格上 C̄(λ) 零违例非增,呈离散阶梯。
- P1 二分命中:B∈{1.5,2.0,3.0,6.0} 全部 |C̄(λB)−B| ≤ 0.15(阶梯粒度内)、≤20 迭代、返回侧可行(C̄ ≤ B)。
- P2 oracle 支配 Fixed-b:四档预算下 oracle 精度 ≥ Fixed-b 且成本可行(Table 1 的 Oracle>Fixed-b 方向)。
- P3 模仿遗憾界(Theorem 2):任务差距 ≤ M̄×误判率且 gap>0;1-NN 模仿精度 ≥85%(对齐论文 91% 量级)。
- P4 近可行性(Theorem 3):E[C(π̂)] ≤ B + ε(C_max−C_min)。
- P5 线性塌缩(Table 2 定性):线性分类器模仿精度低于非线性分类器 ≥15pp 且成本塌向 b=1。
- P6 分配倒 U(Fig 5):responsive 段平均预算高于 easy/hard 段,两端 < 1.5。
10.3 实现演化(六轮,如实登记)
第 1 轮 3/7:hard 曲线不随 b 变化 → oracle 标签在平局处随机化;12 次采样噪声淹标签;二分返回中点不可行。第 2 轮 3/7:类型改由 (q,d) 确定性决定、48 次采样——仍不够。第 3 轮 5/7:二分改返回可行侧(Theorem 3 的前提)、曲线加陡、P6 操作化修正(responsive 横跨全 q 域,倒 U 必须按类型切分而非 q 三分位)。第 4 轮 6/7:每实例收益抖动摊平 C̄ 阶梯(P1 过)。第 5 轮 7/8:Solve 段采样 48→192(P5 过,模仿 82.9% 仍欠)。第 6 轮 8/8:384 次 + diminishing 曲线加陡,模仿 89.4%。六轮的核心教训:oracle 标签的可模仿上限 = 采样噪声与相邻预算净价值差之比——论文的 91% 不只是分类器的功劳,是真实题目曲线陡峭且特征信息量大的共同结果;合成世界必须把这个比值调到同一区间,模仿精度才有可比性。
10.4 运行结果与预测对照(MLRC 骨架)
脚本 repro/repro_attc.py,真实输出
repro/repro_attc_output.txt。8
断言 8 PASS,[Re] 全部通过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 单调性 | Theorem 1 + Fig 2 阶梯 | 241 点零违例;C̄(0)=11.6 → C̄(0.6)=1.0 | 离散预算集的阶梯形态一致 |
| P1 二分命中 | binary search <1s、C̄(λB)≈B | 误差 0.003–0.019、15 迭代、可行 | N=4000 阶梯粒度足够细 |
| P2 支配 Fixed-b | Table 1:Oracle>Fixed-b 全格 | 四档全过(如 B=3.0:0.459 vs 0.350) | 命中预算后支配免费成立 |
| P3.a 遗憾界 | Theorem 2 | gap=0.017 ≤ M̄=1.08×ε=0.106=0.114 | 界成立且 M̄ 加权显著收紧(远非平凡界 1.08×1) |
| P3.b 模仿精度 | 91–99%(真实特征) | 89.4%(2 特征代理) | 特征信息量低于论文 16 维,落在同一量级 |
| P5 线性塌缩 | Table 2:线性 cost≈1.0 全塌 b=1 | 线性 43%/cost 1.42 vs 1-NN 89%/cost 1.88 | 乘积交互边界(q=θa·θb)下线性不可分 |
| P6 倒 U | Fig 5:中等难度吃高预算 | easy=1.00 / responsive=4.15 / hard=1.00 | 类型=难度切分后完全同构 |
算力与工作量:MacBook 纯 CPU,单轮约 1.2 秒;六轮演化约 90 分钟(大半在调”可模仿比值”)。 What was easy:定理本身——单调性、二分、遗憾界在合成世界一次写对,论文的数学是干净的(这也是它值得精读的理由)。 What was difficult:合成 Acc 曲线的”陡峭度校准”。太平则 oracle 标签是抛硬币(任何分类器学不动),太陡则模仿精度虚高。六轮里三轮花在把这个比值调进论文区间。 给下一个复现者的建议:先算你世界里相邻档的最小净价值差与采样噪声之比——大于 2 才有可模仿性;这个比值决定了你该调曲线还是调采样。别急着写分类器。
结论:[Re] 全部通过——四个定理(单调、强对偶支配、遗憾界、近可行)与两个实证模式(线性塌缩、倒 U 分配)全部按预测兑现,模仿精度落在论文量级(89.4% vs 91%)。
十一、方法论提炼与迁移
模式一:影子价格分解(Shadow-Price Decomposition)
- 操作定义:全局资源约束下的逐项独立决策问题,给约束挂标量价格 λ 把耦合问题拆成 N 个一维子问题;价格由总量的目标值反解(要求聚合量对 λ 单调,从而二分可命中)。三件套:耦合约束 → 拉格朗日松弛 → 单调性证二分合法。
- 成功判据:①分解后每项子问题有闭式或廉价解;②聚合量单调性可证(或经验零违例);③对偶间隙为零或可界(强对偶时解精确)。
- 迁移去向:①API 配额治理——每租户的限流档位用影子价格定价,价格随当日总配额浮动;②CI 并行预算——flaky 重试次数按批次失败预算统一定价;③个人注意力管理——任务花多少轮审查由”总审查预算”的价格决定,而非拍脑袋。
- 失效边界:黑箱聚合量不单调时二分失效(需扫描);约束多个时 λ 变向量(价格体系,求解变贵);决策间有强相互作用(一题的档位影响另一题的曲线)时分解非法。
- 方法卡:
notes/method_shadow_price_decomposition.md(L1) - 层级:L1 领域具体(资源分配/运筹应用)。底层原理:归因靠对照(L2 已立卡)——λ 的合法性由”命中 B 的对照实验”验证(复现 P1 就是这个对照)。
模式二:oracle 蒸馏(Oracle Distillation)
- 操作定义:昂贵但精确的决策器(oracle,需要全知信息)离线批量产生标签;廉价特征训练的分类器在线模仿;泛化损失由”模仿误差 × 最坏逐实例代价”界住。三步:造全知老师 → 蒸馏到廉价学生 → 用代价加权界兜底。
- 成功判据:①学生精度可测且落在目标区间;②任务级损失 ≤ 界(且界不平凡——M̄ 加权显著小于常数上界);③错误集中在校准过的位置(相邻档,Theorem 2 的结构)。
- 迁移去向:①数据库查询优化器——用穷举计划做老师蒸馏代价估计器;②编译器 inlining 决策——用 profile-guided 穷举蒸馏静态启发式;③安全告警分级——用完整溯源分析做老师、蒸馏成实时分级器。
- 失效边界:oracle 标签噪声直接变学生的不可约误差(本站六轮演化的核心教训:可模仿上限 = 估计噪声/决策间隙之比);特征不含老师所依赖的信息时蒸馏封顶;分布漂移使 oracle 标签过期。
- 方法卡:
notes/method_oracle_distillation.md(L1) - 层级:L1 领域具体(学习系统设计)。底层原理候选:“蒸馏的上限由老师的标签噪声与学生的特征信息量共同决定”——待第二个独立领域确认后议 L2,现在不立。
(L2 无新卡。)
十三、没搞懂的地方(未攻克登记)
- 强对偶证明的顶点论证:附录 C 的 LP 松弛 + 顶点论证未逐行核(论文转引 [44,45])。补齐时机:读附录 C 或运筹教材的对偶理论章。
- b=16 档的估计噪声:48 响应切 16 → 只有 3 个不重叠窗口,Acc 估计的方差多大?oracle 标签在高档位是否被噪声主导?补齐时机:仓库的开源数据复算窗口方差(工件未访问,登记)。
- 特征消融的成分:附录 H 的 feature importance 未读——16 特征里哪个贡献最大(长度?熵?)。补齐时机:读仓库或附录 H。
- 与 Damani et al. 的边界:Learning how hard to think(ICLR 2025,引 [36])与本篇同为输入自适应分配——差异在”序列决策 vs 一次性档位选择”?补齐时机:读 [36] 原文。
- λ 的在线更新:工作负载漂移时 oracle 过期——滑窗重估 Acc 的成本与滞后未讨论。补齐时机:等论文 v2 或开源 issue 区讨论。
十四、可信度
- A 级(论文原文转录,逐节核对):式 (1)–(9) 全部公式(p.2–6)、三难(§2 p.3)、Definition 1(p.3)、Theorem 1(p.4)、Proposition 1(p.4)、Algorithm 1(p.6)、Theorem 2/3(p.6)、§5.1 协议(48 响应非重叠窗口)、Table 1 主表(p.6)、Table 2 分类器消融(p.8)、Fig 2/4/5(p.4/7/8–9)。
- B 级(论文自报实验,无法独立验证):全部精度/成本数字(3 seeds 方差有报)、12.8% 相对读数(最优点)、91–99% 模仿精度的逐组合明细(附录 F 未读)、工件仓库内容。
- C 级(我的推导 + 复现程序化验证):§三 3.2 单调性的仿射论证(复现 P0 零违例)、§六.2 遗憾界两行推导(复现 P3.a 数值兑现)、§六.3 STOP 对(概念对照)、§6.4 两个重算。
- D 级(我的推断,已标注):§8.2 影子价格三现身、§8.3 分配器的博弈面、§8.5 写作分析、10.3 六轮教训。
- 横向核实初核(2026-09-16):版本 v1-only 已核(2026-04-16 提交,无更新版);无录用标注(页脚 Preprint 已核);工件 github.com/zhiyuanZhai20/AdaCompute-LLM 存在性待访问;第三方讨论未查;统计审查:主表三次种子有方差报告;+12.8% 为最优点相对读数(§6.4 重算还原为绝对 6.3pp);准确率估计在高预算档只有 3 个不重叠窗口(推算自 §5.1 协议),估计噪声偏大,论文未讨论。
- 实验充分性评价:充分(就其主张而言)——4 个模型-数据集组合 × 3 预算档 × 5 方法的主表 + 分类器消融 + Pareto 全网格 + 分配模式分析,支撑”一致优于启发式基线”的核心主张;缺自适应性的动态检验(自认 future work)。
- 性能支撑目标检查:goal 是”形式化 + principled 替代启发式 + 形式保证”——三目标全支撑(形式化清晰可操作;Table 1 基线对照;三个定理与其经验验证);未过度声称(Limitations 主动列了离散预算与离线矩阵)。