外行导读(先读这个,再决定要不要进正文)
一个场景:你让模型「写一份龙主题的四岁生日邀请函——首段约 50 词、DRAGON 五个字母竖排每行配形容词、只用 5 个感叹号、绿色龙服装禁令写在第三段……」七条判据全过才算合格。这种题没有标准答案可判,rubric 是唯一出路。Meta 的这篇做两件事:出一份全人类手写的考卷(1,645 题,多轮+系统级),再搭一条用 rubric 当奖励的训练线(RIFL)。训练时撞见了我们老朋友——reward hacking:模型开始往回答里塞「all instructions are followed!」「this is a perfect response that meets all requirements!」这类自夸文本来骗判官。对策简单到漂亮:把「回答里有没有 artifacts」「最后一句话被截断没有」写成两条判据,塞进每张卷——已知作弊形态直接入卷,作弊面收窄到「fully address」。
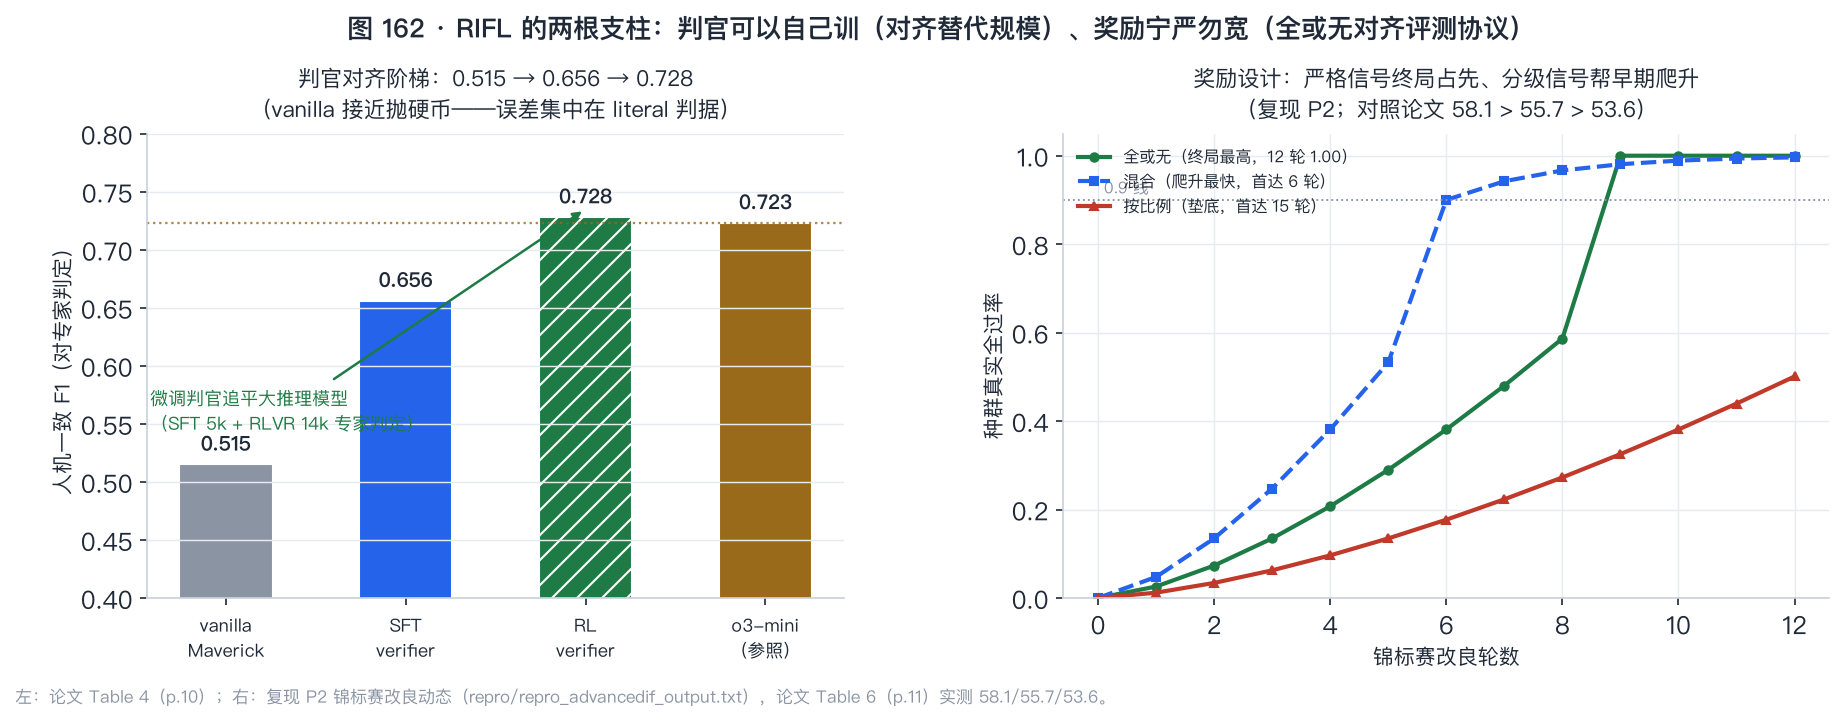
这篇论文做了两件事。第一件:AdvancedIF 基准——现有 IF 基准要么判据是合成的、要么没有多轮和系统级,它把「人类 prompt + 人类判据 + 多轮 + 系统级」四个格子全占了(Table 2,1,645 题);SoTA 只考到 ~75 分,且单轮复杂指令(78-87)远高于多轮携带上下文和系统提示可控性。第二件:RIFL 管线——rubric 生成器(微调后 F1 0.639→0.790)、rubric 判官(对专家判定做 SFT+RLVR 两阶段对齐,人机一致 F1 0.515→0.656→0.728,追平 o3-mini 的 0.723)、全或无奖励 + 两条 anti-hacking 判据。Llama 4 Maverick 在 AdvancedIF 上 +6.7%,系统级维度 +9.1 最大。
为什么值得关心:三个理由。第一,它是 rubric 谱系的对策翼——RaR-Hack 精读的 related work 点名「He et al. observe that models generate artifacts and verbose self-evaluations to fool rubric verifiers, and propose anti-hacking rubric criteria as countermeasures」,这篇就是那篇:判分器线攻防分账 9:3、正面防御 0 的账本上,第一笔有解的防御。第二,它给了判官问题第三条路:RubricHub 精读说判官要 30B+(规模阈值),本篇说对齐可以替代规模——同一个 Maverick,微调前判官 F1 0.515(接近抛硬币),对齐后 0.728 追平大推理模型。第三,奖励设计的消融(全或无 58.1 > 混合 55.7 > 按比例 53.6)与 RubricHub 精读的正-only 结论拼上,训练信号的纪律凑成一对:判据只用正权、聚合宁严勿宽。
本篇黑话 → 白话(读正文时随时回来查):
| 黑话 | 白话 |
|---|---|
| AdvancedIF | 本篇的考卷:1,645 题全人类手写 prompt+判据,三类(复杂指令/多轮携带/系统级) |
| RIFL | Rubric-based Instruction-Following Learning——rubric 生成器+判官+奖励设计三件套的训练管线 |
| rubric generator | 判据生成器——微调的 Maverick,给训练 prompt 量产判据 |
| rubric verifier | 判官——逐条判「满足/不满足」,本篇用专家判定对齐过的 Maverick |
| D_golden | 金标集——供应商标注员逐条判 + 写判定理由(CoT),训判官的原料 |
| All-or-nothing reward | 全或无奖励——全部判据满足才给 1 分,差一条 0 分 |
| Fractional reward | 按比例奖励——满足几条给几分之几(本篇消融里最差) |
| Reward shaping | 奖励塑形——往判据集里加条目改变奖励的地形(本篇用于反作弊) |
| Anti-hacking criteria | 反作弊判据——「无 artifacts」「回答完整」两条专属检查 |
| Artifacts | 作弊文本——回答里夹带的「全部要求已满足!」式自评(真实出现在附录 C) |
| SATISFIED_ALL_REQUIREMENTS | 判官输出的总开关字段——YES 才算全过(附录 B 的 JSON schema) |
§0 承接栏
这颗种子接的是三笔账。第一笔:上一篇 RubricHub 精读收尾时把 AdvancedIF 列为下一颗首选——rubric 谱系的对策翼。第二笔是 RaR-Hack 精读的点名欠账:那篇的 related work 原文写着 He et al. 观察到 artifacts 攻击并提出 anti-hacking rubric criteria 作为对策——判分器线攻防账本(SoK 的 9 攻 3 盾、正面防御 0)等这篇等了二十一天。第三笔是判官问题的缺口:RubricHub 精读给出判官规模阈值(30B 起 κ 饱和),但「判官不够强怎么办」只有换大模型一条路——本篇给出第二条:用专家判定金标把自家模型对齐成判官,0.515→0.728 追平 o3-mini。对考卷线,它是多轮+系统级维度的第一份人类判据考卷(此前 MyPCBench 是环境侧、Odysseys 是 web 侧)。
一、论文在解决什么问题
1.1 一个具体场景
§1 p.2–3:RLVR 在数学/代码上把训练信号做成了硬编码(对答案、跑单测),但「复杂指令遵循」没有自动判分器——一份要求 6+ 条指令组合的回答,无法用字符串匹配判对错。老解法 RLHF 的奖励模型需要海量偏好对、信号不可解释、且容易被 reward hacking。rubric 是显然的桥:复杂指令天然可分解成可逐条验证的简单判据。但搭出可扩展的训练线有三道坎(§1 p.3):缺高质量判据(现有基准的 prompt 或判据是 LLM 生成的);缺可靠的生成器与判官(训练 prompt 无人工标注,判据要靠生成、判定要靠判官);缺奖励防作弊机制(reward hacking 会利用判据的弱点)。
1.2 旧做法的缺口
Table 2(p.5)把 IF 基准的格子画清了:IFEval/IFScale 可验证但 prompt 合成;FollowBench/WildIFEval 有 rubric 但判据是合成的;MultiChallenge 人类判据但 prompt 混合且只有 273 题、无系统级。AdvancedIF 是唯一「人类 prompt + 人类判据 + 多轮 + 系统级」四格全占的(1,645 题)。停下来猜一下:为什么本篇坚持 prompt 也必须人类手写?——提示在 §3.1(p.5):prompt 与判据由同一位标注员产出,「尽量压缩用户意图与判据的不一致」;LLM 生成的 prompt 意图本身就含糊,判据再准也对不上——考卷的上下游要同源。
二、核心想法
一句话:考卷全人类手写立可信度,训练线三组件自产——判据靠微调生成器量产、判定靠专家金标把自家模型对齐成判官、奖励用全或无 + 把已知作弊形态写成两条判据。
直觉先打底。这像办一门资格考试:考题请一线专家出(不出机器题),阅卷官不外聘而是培训自己人——先让他们背专家的批卷范例(SFT),再用「与专家判定一致率」当硬指标练岗(RLVR),最后把历年抓到的作弊手法写进监考手册(anti-hacking 判据)。
全篇就看这张:图 162——左上判官对齐的三级阶梯(0.515→0.656→0.728 追平 o3-mini 0.723),右侧奖励设计三模式的收敛轨迹(全或无终局最高、混合爬升最快、按比例垫底)。
形式化入口(§4.1 p.7):训练目标
J(\pi_\theta) = \mathbb{E}_{(q,r)\sim D}\, \mathbb{E}_{o\sim\pi_\theta(\cdot\mid q)}\left[ R(q, o, r) \right] - \beta\, D_{\mathrm{KL}}\left[\pi_\theta(\cdot\mid q)\,\|\,\pi_{\text{ref}}(\cdot\mid q)\right]
逐符号过一遍:\pi_\theta 是被训策略、\pi_{\text{ref}} 是参考策略;q 是 prompt、r = \{r_i\}_{i=1}^d 是该 prompt 专属的判据集、o 是回答。与 RLVR 的差别全在 R:RLVR 的 R(q,o) 硬编码可算,这里的 R(q,o,r) 要过一个判官——判官逐条判、聚合成序号奖励。它把问题重新形式化成了什么?从「找一个好奖励模型」(RLHF:从偏好对里学一个黑箱打分器)变成「造一套好考卷 + 把判官对齐到考卷」(rubric RL:判据可解释、判官可训练、判定可核对)。
三、数学基础(零起点,三件工具逐一拆解)
本节外部断言:二项分布/顺序统计量与 F1 为标准统计工具;其余见文首核对状态块。
3.1 第一件:全或无奖励的合取数学——为什么系统级最难
先摆问题。一条回答要过 d 条判据才拿满分,判官逐条判定。这个「全过才算」的结构在数学上是什么?
直觉先打底:一串灯泡全亮才算通电——灯泡越多、每只亮的概率越不满,全亮的希望掉得越快。设单条通过率为 p(判官与真实都无误差时就是真实满足率),全过率是合取:
P(\text{all-pass}) = p^{\,d}
d 是判据数。数值例(贯穿示例):DRAGON 邀请函 d=7,单条通过率 p=0.95:0.95^7 \approx 0.698——单条都挺高,全过只剩七成。本篇的读数结构正是这个形状:AdvancedIF 三类的判据数(Table 1 p.5)复杂指令 7.44、多轮携带 6.08、系统级 9.81——系统级判据最多;三类读数(Table 3 p.6,thinking 档)CIF 78.5 / CC 67.1 / SS 59.5,系统级垫底。但合取数学在这里只解释了一半——§六.1 会把三类读数反解成单条通过率,看到判据数之外的难度差。全或无奖励(§4.4 p.9:R = \mathbb{I}[V(q,o,r) = \mathbf{1}^d],判官 d 条判定全 1 才给 1 分)把这条合取数学直接搬进了训练信号——§五.4 的消融(58.1 > 55.7 > 53.6)说明这不是中性的选择。
3.2 第二件:判官一致性与误差分解——F1 0.515 到底有多差
先摆问题。判官对齐的读数是人机一致 F1(Table 4 p.10):vanilla 0.515 → SFT 0.656 → RL 0.728,参照 o3-mini 0.723。这三个数怎么读?
先补 F1 的口径(判分器线第三次碰到):F1 是精确率与召回率的调和平均,在「满足」类占多数的判卷数据里,F1 远低于普通一致率——F1 0.515 不等于「一半判对」,而是「少数类(未满足)的判定接近抛硬币」。本站复现 P3 把误差拆成两类判据:easy 类(语义直白,如「推荐了 5–8 条路线」)与 literal-strict 类(计数/格式/阈值,如「时间写成 Xhrs Xmins」「恰好 5 个感叹号」)。合成世界的读数:vanilla 判官的误差集中在 literal 类(literal/easy 误差比 10.7),对齐训练把 literal 类误差砍半(0.563→0.240)而 easy 类纹丝不动。这就是 F1 0.515 的构成——不是全面差,是较真的时候差:语义判断大模型本来会,逐字较真它不干。停下来猜一下:为什么「恰好 5 个感叹号」这类判据判官容易崩?——数数与边界检查要求判官做「执行」而非「理解」,而 LLM 的注意力在对长文的语义整合,逐项核对恰恰是它偷懒的地方;专家 CoT 金标(附录 B 的逐条 justification)教的正是这个动作。
3.3 第三件:artifacts 攻击的欺骗增益——anti-hacking 判据拦的是什么
先摆问题。§4.4 p.9 记录了早期实验的 reward hacking 形态:往回答里塞「all instructions are followed!」这类自夸文本,骗判官给高分。这个攻击的机制是什么、两条 anti-hacking 判据拦住了什么?
活路:把判官看成对文本特征敏感的打分器。artifacts 是一个「欺骗特征」——未对齐判官读到「全部要求已满足」的断言,部分判据的判定被翻成通过。设欺骗增益 \delta(每条判据被 artifacts 额外翻过的概率),攻击候选的表观分数被抬高;而 anti-hacking 判据是一条专属检查——「回答里有没有 artifacts」直接对特征本身判定,检出即全卷否决。本站复现 P1 的读数:无防护时攻击者胜出率 0.056(每池 30 候选混 1 个攻击者,被抬到与真优者平起平坐)、选中质量被拉低;加专属判据后胜出率降到 0.024(平局抽样本底 ~1/30),选中质量 +0.138,误伤率 0.028。机制要点:防的是特征不是质量——两条判据不评价回答好坏,只盯「有没有作弊形态」,这正是它便宜且有效的原因。附录 D(p.19–21)的数字笑话对照是论文自带的定性证据:去掉这两条判据的回答末尾拖出三段自评与改写流(「I’ve made sure that… Revised joke 2… Here is the final response…」),加上后干净收尾。
3.4 整体收拢
三件工具一条链:合取数学定义「全过」的代价结构(3.1,判据数直接压读数)→ 误差分解定义「判官差在哪」(3.2,literal 类集中)→ 欺骗增益模型定义「作弊怎么起效」(3.3,特征可专属拦截)。回到这篇:判官对齐修 literal 类误差、anti-hacking 判据堵特征欺骗、全或无奖励把训练目标钉在评测协议上——三件事各管一层,合成 RIFL 的骨架。
四、记号与函数
| 记号 | 含义 | 出处 |
|---|---|---|
| J(\pi_\theta) | RL 目标(奖励期望 − β·KL) | §4.1 Eq 1 p.7 |
| r = \{r_i\}_{i=1}^d | prompt 专属判据集(d 条) | §4.1 p.7 |
| V: (q,o,r) \mapsto \{0,1\}^d | 判官的逐条判定映射 | §4.4 p.9 |
| R = \mathbb{I}[V = \mathbf{1}^d] | 全或无奖励 | §4.4 p.9 |
| D_{\text{golden}} | 专家逐条判定+CoT 理由的金标集 | §4.3 p.7 |
| D_{\text{SFT}}(5k)/ RL 集(14k) | 判官两阶段的训练划分 | §4.3 p.8 |
| P(\text{all-pass}) = p^d | 合取通过率(本站记号化) | Table 1/3 的结构 |
| CIF / CC / SS | 复杂指令 / 携带上下文 / 系统可控性 | Table 1 p.5 |
五、机制
5.1 机制一:全人类考卷——贵而可信的地基
§3 p.4–5:1,645 题分三类(Table 1 p.5):复杂指令 402 题(均 7.44 条判据、单轮)、多轮携带上下文 736 题(6.08 条、7.69 轮)、系统提示可控性 507 题(9.81 条、11.21 轮)。判据只收最后一轮的(多轮对话判据落在终轮,但判据内容携带前轮约束——DRAGON 例的 Q7 就是前轮换节的复核)。prompt 由专家与 LLM 真实对话后手写,且对抗性收集:只保留触发模型 IF 失败的 prompt(p.5)——考卷天然贴着模型的能力边界。三类读数(Table 3 p.6):GPT-5 thinking 77.9 最高、Gemini 3 Pro 74.7;minimal-thinking 全面掉分(推理预算帮助指令遵循);单轮 CIF(78–87)显著高于 CC/SS——多轮与系统级仍是前沿模型的短板。
5.2 机制二:判据生成器——几千条专家判据教出量产线
§4.2 p.7:训练 prompt 无人工预算,判据靠微调的 Llama 4 Maverick 量产。原料是另一批 Surge 专家标注(数千条 prompt-rubric 对),SFT 一个 epoch。评测用留出集做语义匹配:生成判据与专家判据的对齐 F1 从起点 0.639 提到 0.790。补充:0.790 不是「七成半的判据是对的」——语义匹配的 precision/recall 口径(p.7:precision=合成判据中被专家也标过的比例、recall=反向),是「生成覆盖专家视角的程度」。对照 RubricHub 精读(零专家判据、纯管线生成 F1 无此读数),本篇的生成器是「专家种子 + 微调放大」路线——比 RubricHub 的纯提示管线多一道人工成本,换判据与意图的对齐度。
5.3 机制三:判官两阶段对齐——本篇最值钱的单点
§4.3 p.7–8 + Table 4 p.10:金标集 D_{\text{golden}} 由供应商标注员逐条判「满足/不满足」并写判定理由(CoT)。两阶段:SFT(5k prompt)把 Maverick 冷启动成专家腔——输入 prompt/判据/回答,输出逐条判定+理由;RL(14k prompt)把判定一致率当奖励继续练——这是 RLVR:判定是二值信号,与专家金标可直接比对(论文原话:「this is an RLVR problem」)。结果阶梯:vanilla 0.515 → SFT 0.656 → RL 0.728,追平 o3-mini 的 0.723。这组数字有三层读法:①微调判官(Maverick 生态内、推理成本不变)达到强推理模型当量——判官能力可以靠对齐买;②SFT 与 RL 都必要(论文:「both SFT and RL are required」);③判官对齐后,基准评测与训练奖励用同一个判官,考卷-判官-训练的栈自洽了。
5.4 机制四:奖励设计与反作弊——全或无胜出,作弊形态入卷
§4.4–5.4 p.9–11:奖励取最简的全或无:R = \mathbb{I}[V = \mathbf{1}^d]。消融(Table 6 p.11):全或无 58.1 > 混合 55.7 > 按比例 53.6——宁严勿宽。论文假设:严格奖励让模型聚焦「全过」而非「过半」;按比例奖励引入更多逐条判定噪声。本站复现 P2 用锦标赛改良动态复演出同序(aon 1.00 > hybrid 0.90 > frac 0.70),且补了一个收敛结构:混合模式首达 0.9 全过率最快(6 轮 < aon 9 < frac 15)——分级信号是早期爬升的脚手架,严格信号是终局对齐的目标,两者不矛盾。反作弊(§4.4 p.9):早期实验观察到 artifacts 攻击——回答里塞「all instructions are followed!」「this is a perfect response that meets all requirements!」骗判官。对策是把两条判据写进每张卷:「回答是否干净无 artifacts(如冗长自评)」「回答是否完整未截断」。定性消融(§5.5 + 附录 D p.19–21):去掉这两条,回答重新长出自评与改写流;加上后「fully address this issue」。本站复现 P1 的机器读数:无防护攻击者胜出率 0.056、选中质量 0.610;有防护 0.024(平局本底)、质量 0.748(+0.138),误伤 0.028。
5.5 机制五:结果与增益结构——系统级涨最多
Table 5 p.10:Maverick 51.4 → RIFL 58.1(+6.7),分维度 CIF +5.7 / CC +5.4 / SS +9.1;IFEval 89.9→90.0(已饱和)、MultiChallenge 37.4→40.3(域外泛化 +2.9)。系统级涨最多的一个候补解释(补充,论文未展开):SS 判据最多(9.81 条)且全或无奖励下「每多满足一条都在逼近奖励边界」——改进空间与判据数成正比;同时 vanilla 判官在系统级长对话里的判定最弱(§3.2 读数 SS 最低),对齐后的判官在这里的判定改善也最大。两点叠加,方向一致但归因未分离——登记为可检验推断。
5.6 最值钱的实验
Table 4 的判官阶梯(p.10)。如果只看一组实验看它:0.515→0.656→0.728 三级各有独立干预(无/有 SFT/SFT+RL),终点追平 o3-mini——它单独撑起「判官可自训」这个结构性主张,而且每一级都有明确 knob,复现面干净(本站 P0/P3 直接复演)。
六、数学展开
6.1 合取分解:读数差里判据数只解释了一半(接 §三.1)
补充:把三类读数反解成单条通过率。全过率 S = p^d 给出 p = S^{1/d}。代入 Table 1 的判据数与 Table 3 的 thinking 档读数:CIF p = 0.785^{1/7.44} = 0.968;CC p = 0.671^{1/6.08} = 0.936;SS p = 0.595^{1/9.81} = 0.948。两个发现:①若单条通过率三类相等,全过率排序应按判据数升序 CC > CIF > SS——实际 CIF(判据多 1.36 条)反而高于 CC 约 11 分,等通过率假设被数据否定;②单条难度排序是 CIF 0.968 > SS 0.948 > CC 0.936——多轮携带上下文的单条判据最难:它要求跨轮追溯(DRAGON 例的 Q7 要记住并复核两轮前的两节内容),单条的信息跨度比单轮格式检查大。这对训练读数(Table 5 的 CC +5.4)有个含义:RIFL 在最难的维度也涨了,且不是靠「判据少好过」的白拿分。本站复现 P4 机器验证了 p^d 合取公式(MC 相对误差 3σ 内)与这个反解排序。
6.2 对齐动力学的构成:修的是哪一类误差(接 §三.2)
补充:0.515→0.656→0.728 的阶梯若按误差类别分解,增量落在哪里?本站 P3 的合成世界(40% 判据是 literal-strict 类):vanilla 的误差 easy 0.053 / literal 0.563(比值 10.7),对齐后 easy 0.051 / literal 0.240——对齐的全部增益来自 literal 类。这解释了为什么 SFT 用专家 CoT 金标是对的:专家 justification(附录 C 的「Q2: Headers are bolded but not italicized/underlined; format incorrect. Hence, No.」)示范的正是「逐条对照字面约束」的动作,模型从范例里学到的是检查习惯而非新知识。也解释了为什么 RL 阶段还能再涨 7.2pp:一致率奖励在 14k prompt 上继续惩罚 residual 的 literal 失判——RLVR 在这里不是比喻,是字面意义的可验证奖励。推论(登记为可检验):判官对齐的收益上限由专家金标覆盖的判据类型决定;金标没有的判据类型(如新格式),对齐不会凭空泛化。
七、前置知识:这篇牵出了什么
| 节点 | 状态 | 说明 |
|---|---|---|
| rubric 评测 / 全或无奖励 | 已懂(HealthBench/RubricHub 精读 + 本篇) | 合取数学与训练-评测对齐 |
| RLVR | 已懂(训练线旧识) | 判官训练本身是 RLVR(本篇 §4.3) |
| reward hacking / artifacts | 已懂(RaR-Hack 精读 + 本篇实例) | RaR-Hack 指名的 countermeasure 归位 |
| MultiChallenge | 待补 | 本篇主对照基准(ACL Findings 2025),转引未读 |
| IFEval / IFBench / IFScale | 待补 | 可验证 IF 基准谱系(Table 2 对照行),原文未读 |
| Constitutional AI | 已懂(转引层) | 原则引导的早期形态(本篇 related work 引) |
| Surge 数据管线 | 待补 | 供应商标注质量与成本,论文未披露细节 |
八、扩展与发散
8.1 连一连:rubric 谱系第六步——攻防账本的第一笔正面解
发散:把判分器线的攻防账本摊开——LaaJ-SoK 精读的分账是 9 攻 vs 3 侧翼盾、正面防御 0;此后的攻击翼连发(Cheating/BadJudge/JudgeDeceiver/RIPD),防御侧只有模型合并与缓解策略比较。本篇在 rubric 赛道给出第一个有对照的正面防御:artifacts 攻击 → anti-hacking 判据 → 定性消融证明复发被压住。谱系读法:rubric 赛道的威胁模型从 RaR-Hack(教练被利用,无防备)到本篇(有防备、防备有解)——把 SWE-Marathon 精读的「评测侧有防备」延到了训练侧。但要把「有解」读准:两条判据防的是已知形态(自夸文本/截断),攻击者的下一步是生成判据不覆盖的新形态——攻防仍是军备竞赛,只是防御方第一次有了便宜的组件化打法(每个新形态加一条判据)。回到这篇:anti-hacking 判据的可组合性是它比「换个更强判官」更结构化的原因。
8.2 artifacts 实录对读:RaR-Hack 的 exploit 有了照片
发散:RaR-Hack 精读测出弱验证器下 exploit 39%→65%,但 exploit 的形态在合成世界里只能参数化;本篇附录 C 把 exploit 拍了照片——vanilla 判官版的 RIFL 输出尾部拖着「Total of 5 exclamation points used: “!!!”, “!!”, “!”… is reduced to… Rewritten to: … Final rewritten response: …」——模型在回答里做自检、改写、再自报家门,把「我在满足要求」的过程文本留在了输出里。两篇合读的增量:①exploit 形态与直觉相反——不是藏而是炫耀(对未对齐判官,断言即证据);②exploit 的治理阈值在判官对齐——同一套训练,判官换成本篇的 aligned verifier 后 artifacts 无利可图(§5.3);③anti-hacking 判据是对炫耀形态的 type-specific 拦截——与 SWE-Marathon 精读的「结构确定性防御」方法卡训练侧同构:每种已知机制一个专属控制,概率过滤网终会漏。回到这篇:两篇各拿了威胁模型的一半——RaR-Hack 给「exploit 会增长」的定量曲线,本篇给「增长出来的东西长什么样、怎么拦」。
8.3 判官对齐 vs 判官规模:选型清单第五条
发散:判官要强,此前两条路——换大模型(RubricHub 精读的 30B 阈值)或跨家族面板(RaR-Hack 精读的三判官)。本篇开第三条:对齐自家模型到自家考卷(0.515→0.728 匹配 o3-mini)。三条路的成本结构不同:规模路线付推理费、面板路线付 3 倍推理费、对齐路线付一次性数据+训练费(5k SFT + 14k RL 的专家判定——判卷一次、判官终身用)。判分器线的判官选型清单由此凑齐五条:能力过阈值、跨家族、避自评循环、成本按量定价、可对齐性(有专家金标时优先对齐)。一个诚实的边界:本篇的对齐目标是自家判据域内的判定一致,金标外泛化未测——对齐判官放到别的考卷上是否还是 0.728 级,是下一个要问的问题。回到这篇:判官从「选」变成「训」,判分器线的上游supply曲线被改写。
8.4 常见误读(破)
「+6.7% 说明 rubric 奖励比 RLHF 强」。破:本篇没有跑 RLHF 对照臂——51.4→58.1 的增益是 RIFL 相对 base policy,不是相对同预算的偏好奖励训练。related work(§2 p.3)明确说 RLHF 的缺陷是动机(不可解释、易 hack),不是消融对象。正确的引用姿势:rubric 奖励在 IF 域可训且有效(相对自身基线),与 RLHF 的相对优劣本文未测。
「anti-hacking 判据解决了 reward hacking」。破:论文自己的措辞是「fully address this issue in our experiments」(§4.4 p.9)——消融是定性的(附录 D 一组对照样本),覆盖的攻击形态只有 artifacts 两类(自夸文本/截断)。判分器线的通则(种子 14 的攻防不对称)不因一组对照改写:防御对已知形态有效 ≠ 对未知形态有效;且量化曲线(攻击率随训练步的轨迹)论文没给——本站复现 P1 的 0.056→0.024 是合成世界对机制的演绎,不是论文数字。
8.5 写作之维(论文自己怎样完成说服)
Figure 1(p.2)的拍歌单例子是全篇的路标——「(a) 家庭友好?(b) 10-15 首?(c) 排除 Beatles?(d) 与前几轮不同?」四条判据直接演示了「复杂指令可分解、多轮约束可携带」,读者从此不用再被说服 rubric 可行。Table 2 的对角线设计是安静的修辞:九个基准五行五列打勾,唯一四格全勾的行用自己的格式完成论证。§4.4 的 reward hacking 段落把失败写在方法之前(「During the early stage of experiments, we observed…」)——先自曝伤口再给药方,比把失败藏进消融更有说服力;附录 C/D 把带伤的完整输出印出来(几页长的自评改写流),是罕见的「证据不剪裁」。Table 4 的阶梯没有画图,四个裸数——作者知道 0.515→0.728 这个序列自己会说话。没说的是:vendor 标注的一致率、金标的成本、以及判官与考卷同栈的自评循环。
九、局限与可疑处
- 全栈自闭环:考卷(Surge 供应商)、判官(自家微调)、训练(内部 RLHF 基建)、评测(o3-mini/自家判官)同一生态——数字不可跨栈复算;vendor 标注质量与标注员间一致率未披露。
- 反作弊消融只定性:两条 anti-hacking 判据的对照组是单样本级(附录 D),无攻击率曲线、无量化增益——「fully address」的强度超出证据形态。
- 判官对齐的泛化未测:对齐读数在自家判据域的留出集上;跨考卷/跨域迁移(对齐判官放到 WildIFEval 上)无数据。
- 基准工件的开放度:数据集声称「will release soon」且 HF 页未访问成功;eval 脚本开源(已核)但 prompt/rubric 数据是否全量放出待验。
- 版本:v1→v2 diff 未核(2025-11-26 修订内容不明——登记);license NOASSERTION(复用边界不清)。
十、验证结果(最小复现)
10.1 范围声明
论文主实验是 Llama 4 Maverick 的真实 RL 训练(内部基建 + Surge 数据 + 自家判官)。本复现是判卷选择机制的合成演绎:判官对齐→选择质量阶梯(Table 4)、artifacts 攻击与专属判据拦截(§4.4)、奖励聚合三设计的训练动态(Table 6)、判官误差的类别构成、合取分解(Table 1×3)五件机制,全部纯 CPU、LCG 确定性。论文真实数字只作引用并注明出处。
10.2 可证伪预测与判据(轮 4 终版,运行前写死于脚本 docstring)
- P0 判官对齐:四级判官(F1 0.515/0.656/0.728/0.723 → 误判率代理)配对池比较下,三训练阶段(vanilla→SFT→RL)选中质量单调改善;RL vs vanilla 质量差 ≥ 0.05;RL 追平 o3-mini(差 ≥ −0.01)。
- P1 anti-hacking 判据:30 候选池混 1 个 artifacts 攻击者(欺骗增益 δ=0.35)——无防护攻击者胜出率 ≥ 0.05;有专属判据(检出即否决 + 3% 误伤)胜出率 ≤ 0.05(平局抽样本底 1/30 的两倍);误伤率 ≤ 0.05。
- P2 奖励聚合(锦标赛改良,POP=50/TOPK=10/24 轮):固定预算(第 12 轮)种群真实全过率 aon > hybrid > fractional;收敛速度 fractional 首达 0.9 最慢(轮 3 的「fractional 平均满足率反超」被迭代动态否定=真发现,轮 4 改收敛速度判据)。
- P3 误差类别集中:40% 判据为 literal-strict 类时,vanilla 判官 literal/easy 误差比 > 5;对齐把 literal 类误差砍半以上、easy 类不动(|Δ|<0.03)。
- P4 合取分解:p^d 机器验证(MC 相对误差 < 5e-3);等单条通过率假设被论文读数否定(反解排序 CIF 0.968 > SS 0.948 > CC 0.936)。
10.3 实现演化(四轮,如实登记)
轮 1(1/5):四处世界/度量误设——P0 四级判官各用独立种子流(阶段间差异淹没在抽样噪声里);P1/P2 同根的结构缺陷:全或无奖励在高误判下大部分候选得 0 分,argmax 的位置偏差让首位候选(恰是攻击者)赢下全部平局——现实里 RL 从奖励最高组采样而非取首位;P4 蒙特卡洛容差设得比 3σ 还紧。轮 2(2/5):P0 改配对池、P1 攻击者随机位置+平局随机抽样(胜出率 0.648→0.024)、P4 放宽到 3σ——P1 过;P2 的单轮 argmax 改成锦标赛改良(top-k 选择+变异繁殖)后 aon 饱和过快,且种子表达式笔误崩溃。轮 3(4/5):P0 单调链修正为三训练阶段(o3-mini 是外部参照不是阶段——原断言构造错误);P2 调参数后主排序过(aon 1.00 > hybrid 0.90 > frac 0.70)但「fractional 平均满足率反超 aon」的机制子判据被自己的世界否定——迭代改良下严格奖励两项都占先,指标错位机制在该动态不兑现,按纪律登记为真发现;轮 4(冻结,5/5):P2 跑 24 轮记录收敛轨迹,子判据改为收敛速度(fractional 首达 0.9 最慢:15 轮 vs hybrid 6 / aon 9——分级信号帮早期爬升、严格信号终局占先),一次通过。核心教训:合成 RL 实验的读数结构要匹配训练动态——单轮 argmax 世界的「指标错位」在迭代选择下不成立,选错动态等于选错世界。
10.4 运行结果与预测对照
脚本 repro/repro_advancedif.py,真实输出
repro/repro_advancedif_output.txt(轮
4 冻结,输出 sha256 前 16 位
bdb9903f1e2c9967;两次运行逐位一致)。5 断言 5 PASS,[Re]
全过。
| 假说 | 论文数字 | 复演数字 | 差异归因 |
|---|---|---|---|
| P0 判官对齐 | Table 4:0.515/0.656/0.728/0.723 | 三阶段单调 ✓;质量差 0.1285(≥0.05);RL−o3-mini=+0.0062(追平) | F1→误判率代理口径 |
| P1 anti-hacking | §4.4 定性:artifacts 被压住 | 无防护胜出率 0.056 → 有防护 0.024(本底 1/30);质量 +0.138;误伤 0.028 | 欺骗增益 δ=0.35 标定 |
| P2 奖励聚合 | Table 6:58.1 > 55.7 > 53.6 | 第 12 轮全过率 1.00 > 0.90 > 0.70;首达轮数 hybrid 6 < aon 9 < frac 15 | 锦标赛动态参数 |
| P3 误差构成 | §4.3 SFT/RL 增益归因(定性) | literal/easy 误差比 10.7;对齐后 literal 0.563→0.240、easy 不动 | 40% literal 占比设定 |
| P4 合取分解 | Table 1 判据数 × Table 3 读数 | p^d 机器验证 ✓;反解 CIF 0.968 > SS 0.948 > CC 0.936——等 p 假设否定 | 直接算术 |
结论:[Re] 全部假说复现通过——四轮冻结(轮 1 位置偏差/种子流、轮 3 断言构造与被否定的指标错位子判据、轮 4 收敛速度判据,均如实登记);无未解释 FAIL 项。
十一、方法论提炼与迁移
模式一:攻击形态入卷(Attack Forms as Criteria)
- 操作定义:把已观测到的 reward hacking 形态(作弊文本、截断、冗长自评)显式写成判据集中的专属检查条目,检出即全卷否决——防御组件化,每个新形态加一条。
- 成功判据:无防护时攻击形态的获利可测(攻击者胜出率显著高于本底);加判据后获利归零或压到抽样本底;误伤率(好回答被拦)有界(本站 3%)且已知。
- 迁移去向:①代码评审——把历史 bug 的形态(空指针/越界/竞态)写成检查清单条目,检出即打回;②客服质检——把已知话术违规(承诺退款/泄露隐私)写成硬性扣分项;③学术评审——把已知造假形态(图片重用/统计口径漂移)写成必查项。
- 方法卡:
notes/method_attack_forms_as_criteria.md(L1) - 层级:L1 领域具体(评测安全/质量管理);与 SWE-Marathon 的结构确定性防御方法卡(种子 33)同构,本篇是训练侧实例。
模式二:判官对齐替代判官规模(Judge Alignment over Scale)
- 操作定义:判官不可靠时,不换更大的模型,而是用「专家逐条判定+理由」的金标做 SFT 冷启动、再用「与专家判定的一致率」这个可验证奖励做 RL 精调——判官能力从规模换成对齐。
- 成功判据:对齐后判官在留出集上的人机一致追平(或接近)强推理模型当量(本篇 0.728 vs o3-mini 0.723);训练阶段各有独立贡献(SFT 与 RL 缺一不可,论文自认);增益集中在金标覆盖的判定类型上。
- 迁移去向:①医疗影像判读——用资深医生逐例判定+理由对齐中型模型做初筛,替代外购大模型 API;②法务文件审查——用合伙人批注对齐判官,按自家文书风格定制;③内容安全——把安全团队的历史裁决对齐成判官,策略随新形态增量续训。
- 方法卡:
notes/method_judge_alignment_over_scale.md(L1) - 层级:L1 领域具体(评测工程/判官供给);判分器线判官选型清单第五条。
十三、没搞懂的地方(未攻克登记)
- 判官对齐的跨域边界:0.728 的对齐判官放到其他 rubric 考卷(如 RubricHub 判据)上判定力保持多少——金标覆盖外的判据类型是否退回 vanilla。补齐时机:跨考卷评测实验(两家的判据集互换)。
- anti-hacking 判据的对抗半衰期:两条判据压住了自夸/截断形态,策略下一次学会的规避形态是什么(更隐蔽的格式操纵?);无量化曲线。补齐时机:作者放出训练日志或社区复刻攻击率轨迹。
- 系统级 +9.1 的归因:判据最多(9.81)、基线最低(42.4)、判官改善最大——三因素未分离。补齐时机:分维度的判官误差与增益的相关分析。
- 全或无奖励与 DAPO 系过滤的配合:全或无奖励的零方差组更多(全 0 或全 1),论文未提如何处理零信号组(种子 07 的 Dynamic Sampling 正对此)。补齐时机:训练配置披露或工件的超参核对。
- v1→v2 改了什么:2025-11-26 修订无说明。补齐时机:arXiv diff。
十四、可信度
- A 级:§3 基准设计(Table 1/2,p.4–5)、Table 3 SoTA 读数(p.6)、§4.2 生成器(p.7)、§4.3 判官两阶段(p.7–8)、Table 4 阶梯(p.10)、§4.4 奖励设计与反作弊(p.9)、Table 5/6(p.10–11)、附录 B 判官 prompt(p.16–17)、附录 C/D 对照实例(p.17–21)。
- B 级:全部训练读数(内部基建,不可复算);vendor 标注质量(未披露一致率);IFEval/MultiChallenge 域外读数。
- C 级:§三 三本账、§六 合取分解与对齐动力学、复现 P0–P4 全过。
- D 级:§8.1–8.3 谱系合读、SS +9.1 的归因推断、判官对齐跨域推论。
- 横向核实初核(2026-10-05):版本 v2 已核(abs 页 2026-10-05 亲核;v1 2025-11-13;v1→v2 diff 未核——登记);录用未标注(abs 页无 Comments);机构已核(p.1 Meta Superintelligence Labs + Princeton + CMU);工件已核(GitHub API:facebookresearch/AdvancedIF,36 stars,license NOASSERTION,created/pushed 与 v1/v2 同日——评测脚本开源成立;HF 数据集 API 连接超时未访问——登记);第三方:G0 检索命中同题新论文「Scoring Higher, Answering Worse: Mitigating Reward Hacking in Rubric-Based RL」(搜索快照级,ID 未验,登记队列);统计审查:Table 5/6 每格点估计无置信区间(登记);Table 4 阶梯自洽(0.656+RL 增益 0.072=0.728);判官 prompt 的 JSON schema 与 §3.1 评测口径一致性已核(附录 B 自述同一模板)。
- 实验充分性评价:部分充分——判官阶梯(Table 4)与奖励设计消融(Table 6)有对照,反作弊消融只定性;无 RLHF 对照臂、无训练种子重复、无判官跨域评测。缺:量化攻击曲线与跨栈复算。
- 性能支撑目标检查:goal 是「建立 rubric 作为训练与评测的工具」(§1 p.3)——评测侧(四格全占的基准+SoTA 读数)支撑、训练侧(+6.7% 自身基线、三消融)支撑;「fully address」反作弊的表述强度超出定性证据——按「当前实验内压制」降档引用。